Acelere o llama.cpp no NVIDIA Jetson AGX Orin com MTP
Introdução
Este wiki explica como o Multi-Token Prediction (MTP) funciona e como ativá-lo no llama.cpp no NVIDIA Jetson AGX Orin com Qwen3.5-4B. Siga a configuração e compare o desempenho com MTP ligado/desligado usando uma demonstração local de monitoramento de multidões.
Primeiro, veja os resultados reais do teste. Pedimos ao LLM para gerar um script Python para calcular a sequência de Fibonacci e comparamos a velocidade de geração com e sem o modelo MTP ativado.
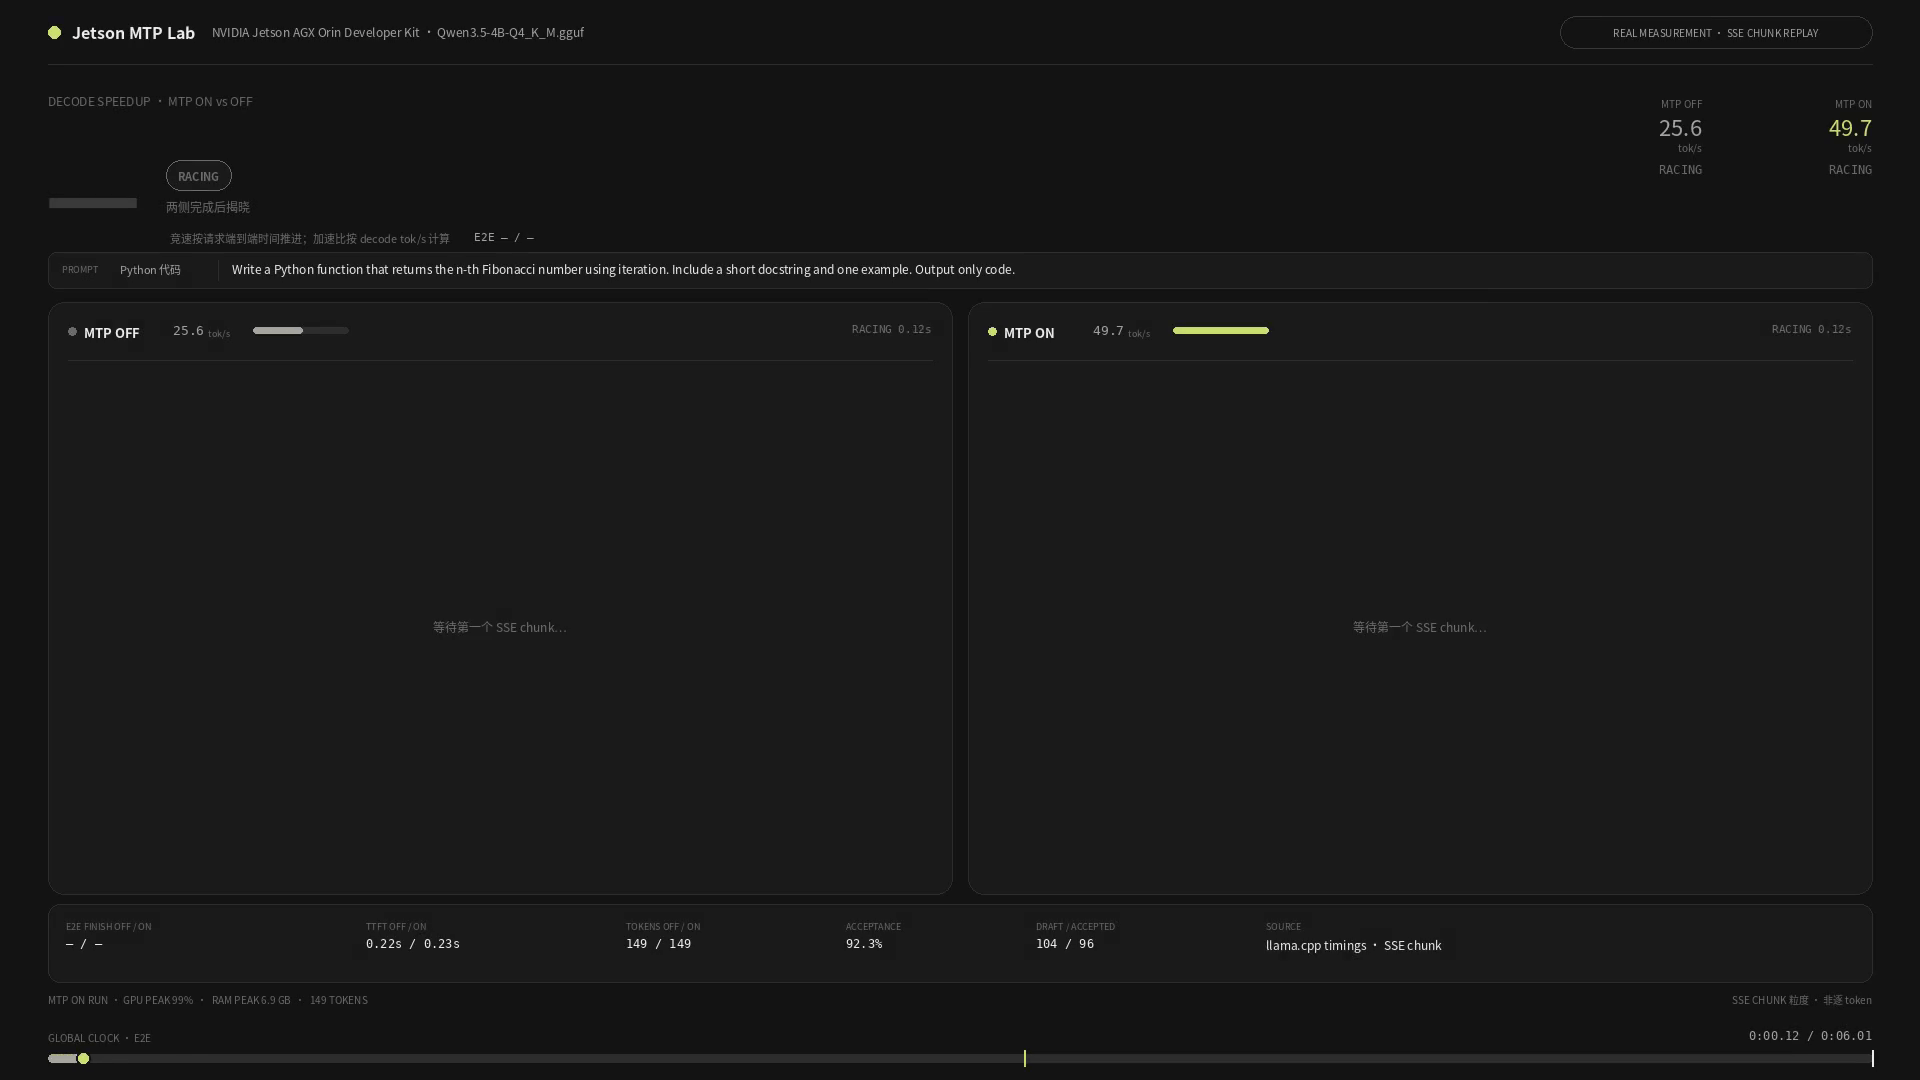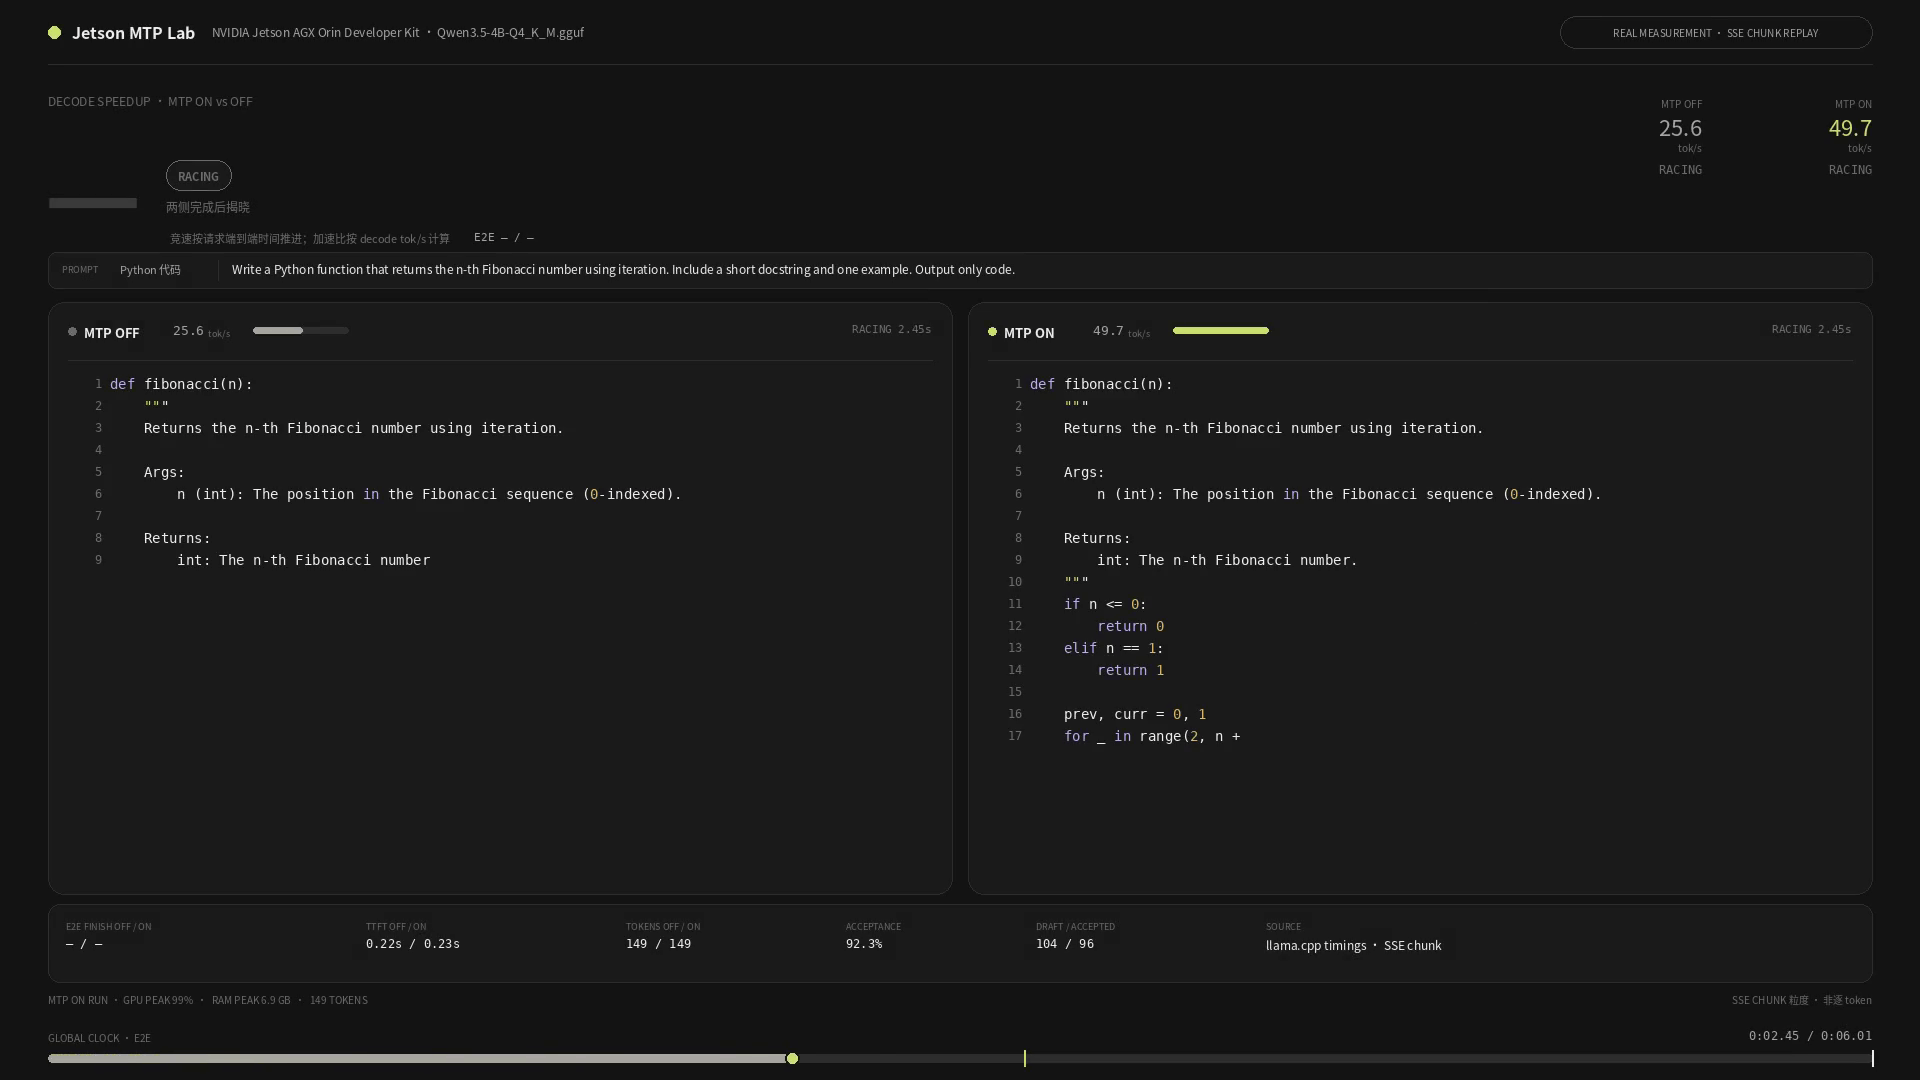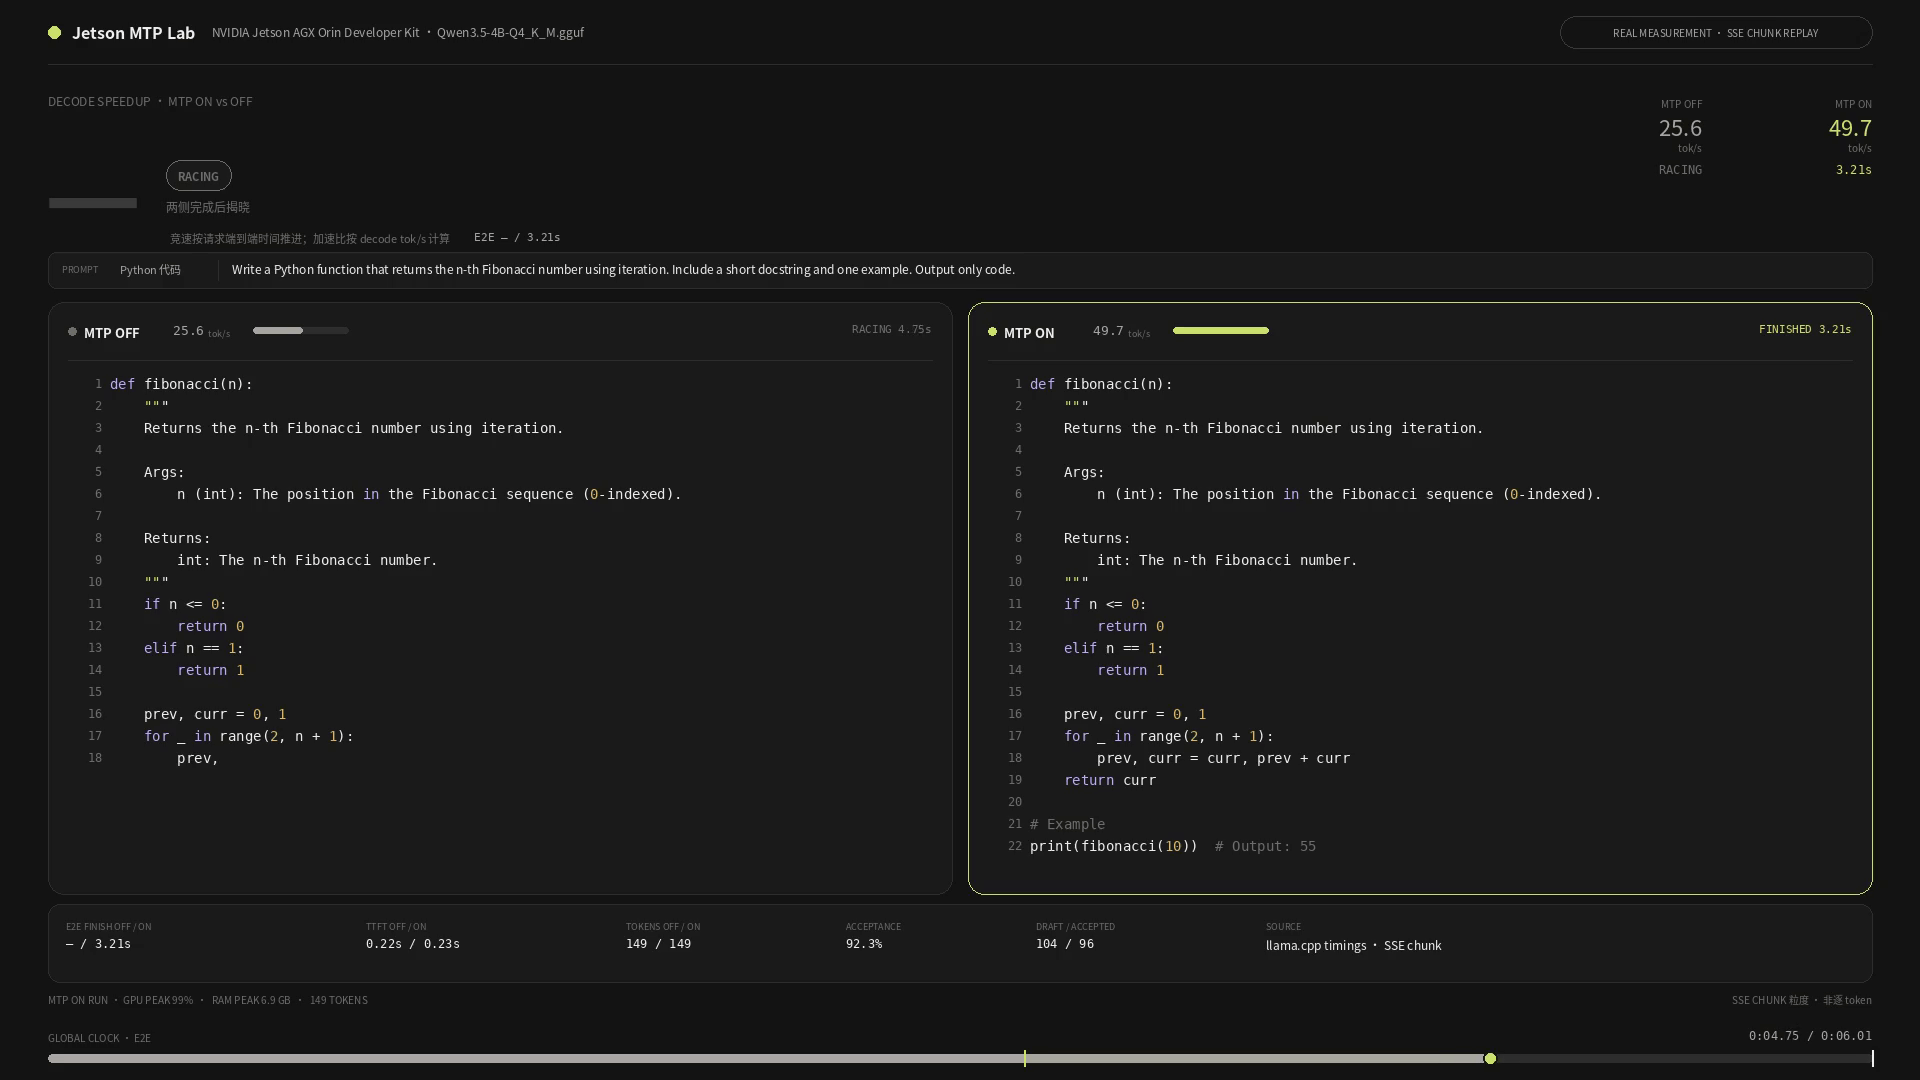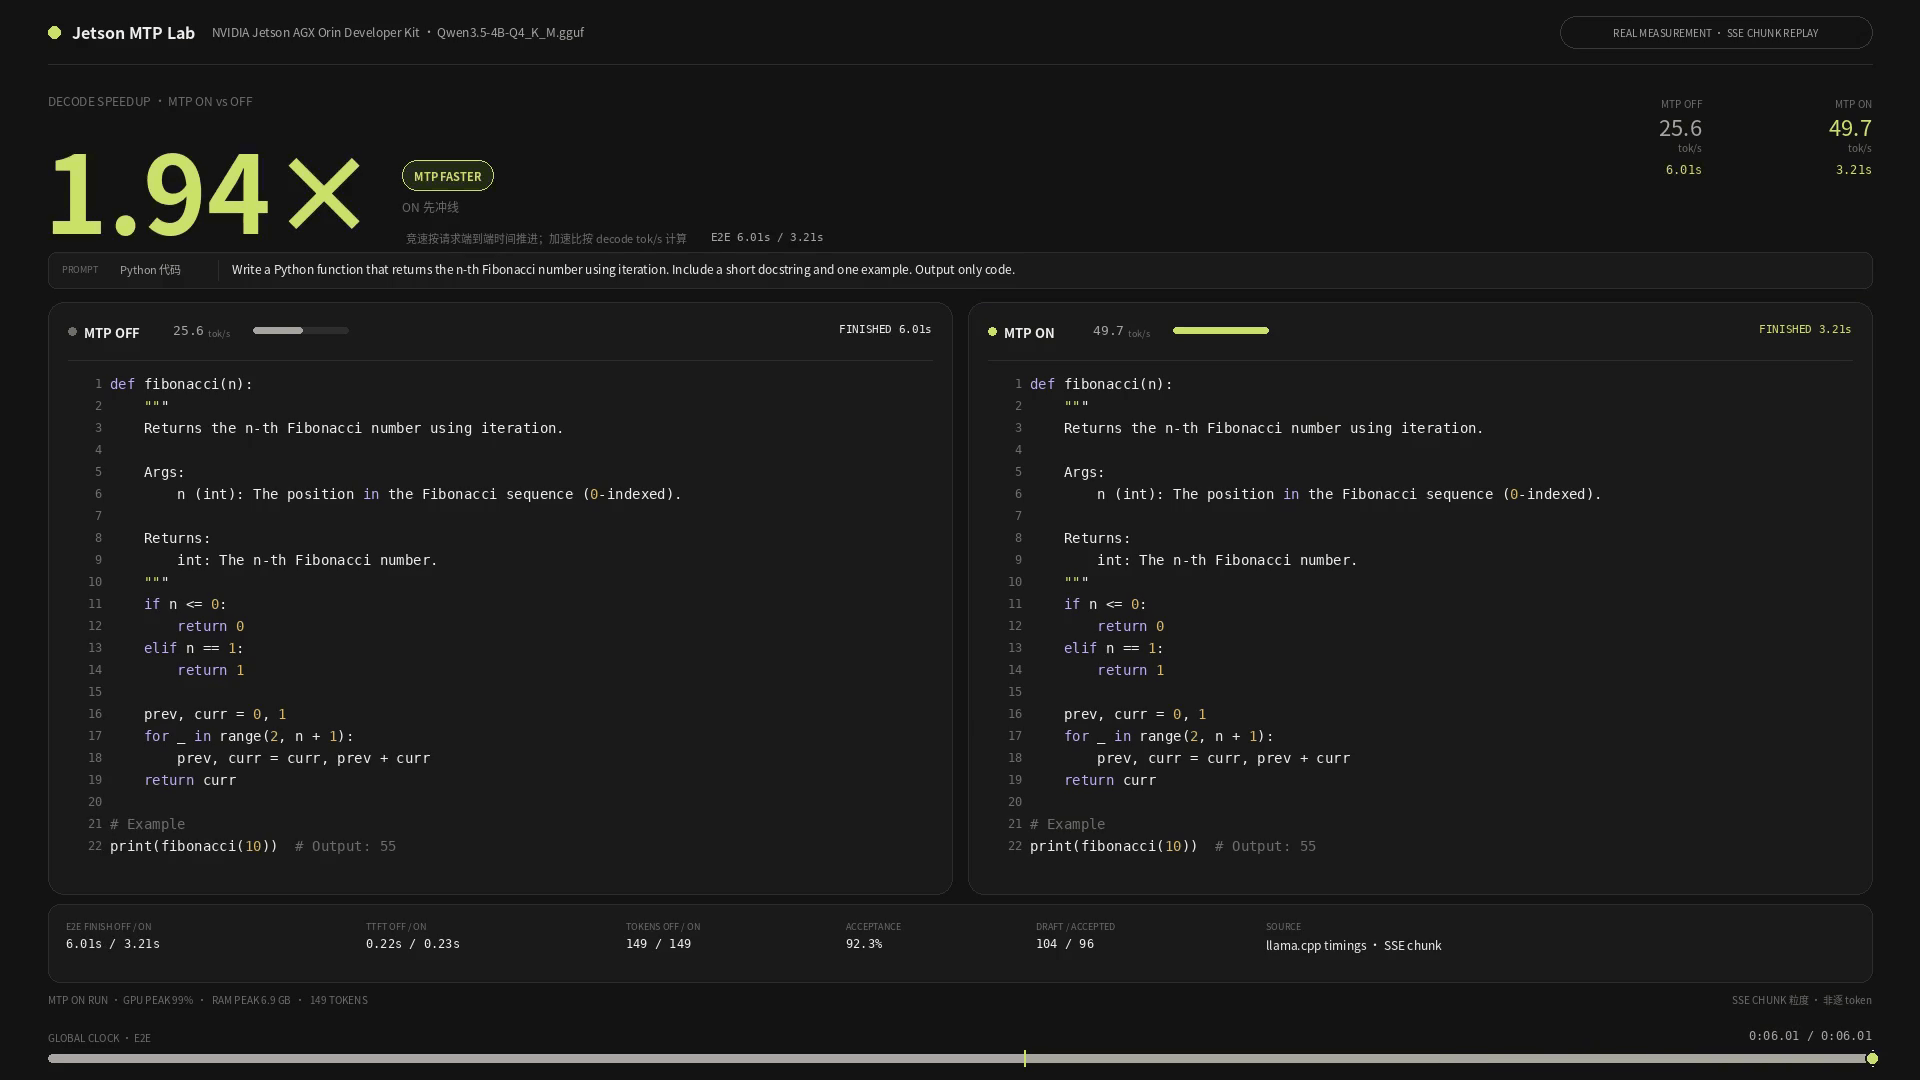
Sem o modo MTP ativado, o modelo Qwen3.5 4B gera tokens a uma taxa de cerca de 25,6 tokens/s, enquanto com o modo MTP ativado, o mesmo modelo no mesmo dispositivo atinge uma velocidade de geração de 49,7 tokens/s. Pode-se ver que, para esse tipo de conteúdo relativamente determinístico, a velocidade de geração do modelo praticamente dobra. Isso nos dá uma percepção: para algumas tarefas relativamente rotineiras, ativar o modo MTP pode trazer ganhos de desempenho bem interessantes!
Veja outro cenário de análise visual: defina uma região de ROI e monitore se a contagem de pessoas na ROI permanece em cinco ou mais pessoas por 1,5 segundo; se sim, chame o LLM para análise e diagnóstico de anomalias. Vamos ver o quanto fica mais rápido com o modo MTP ativado no cenário de análise visual!
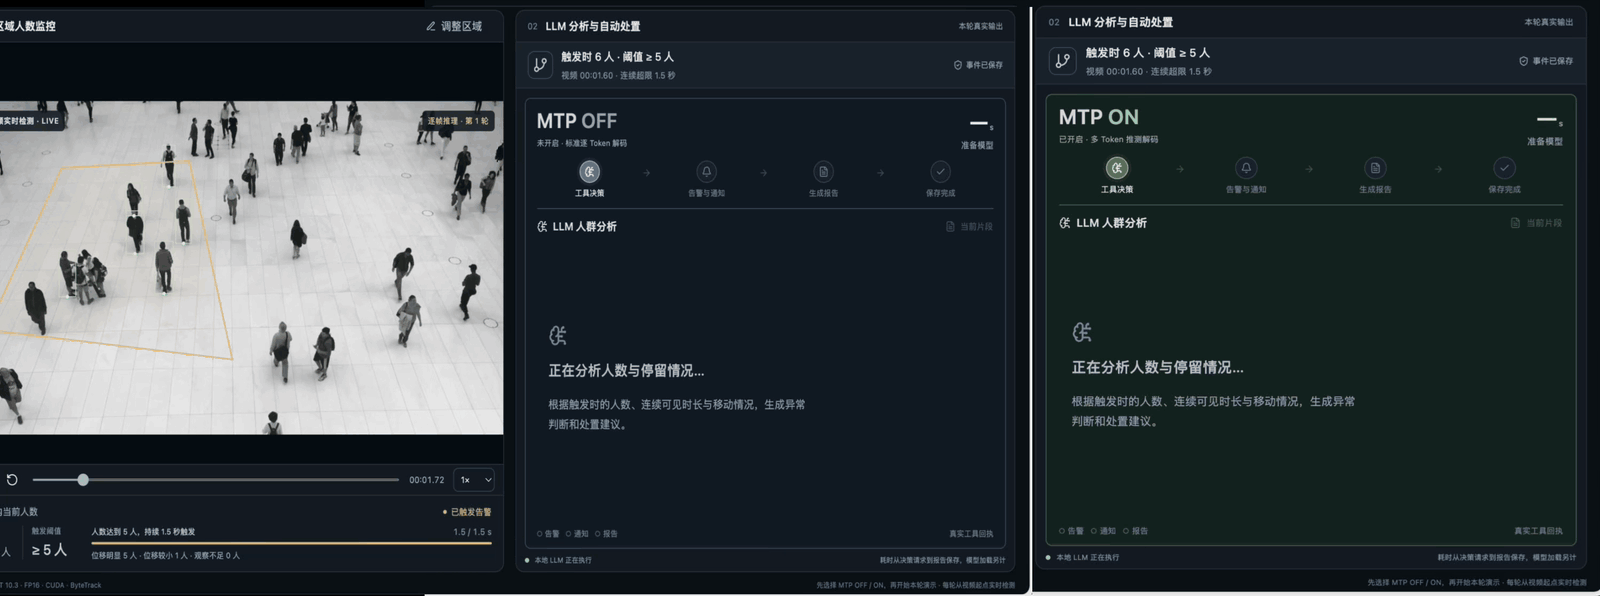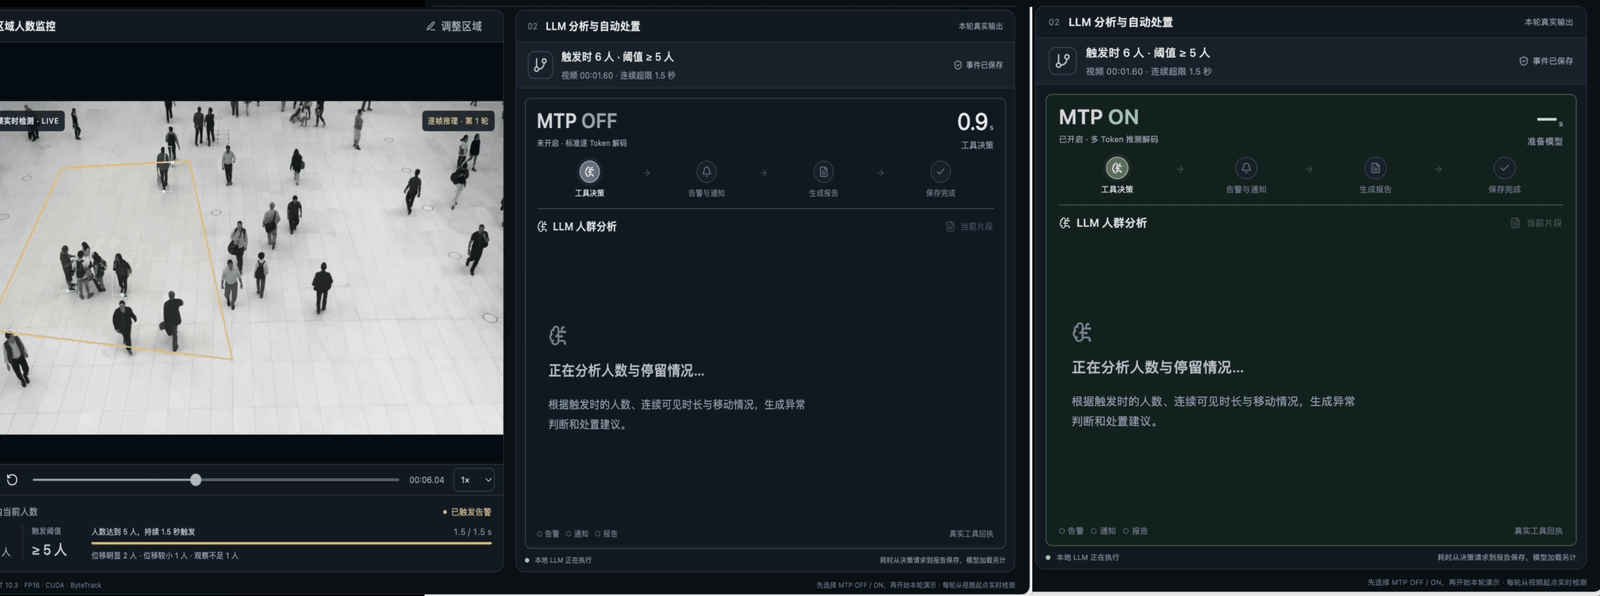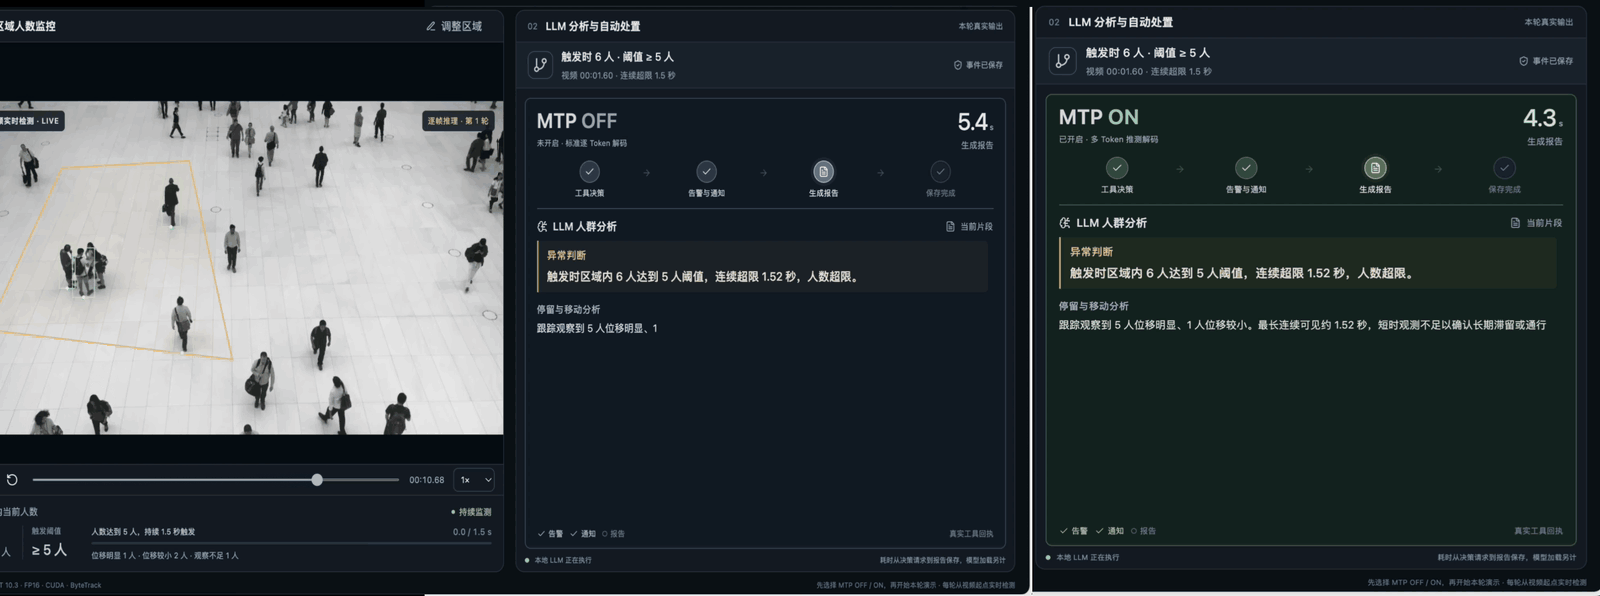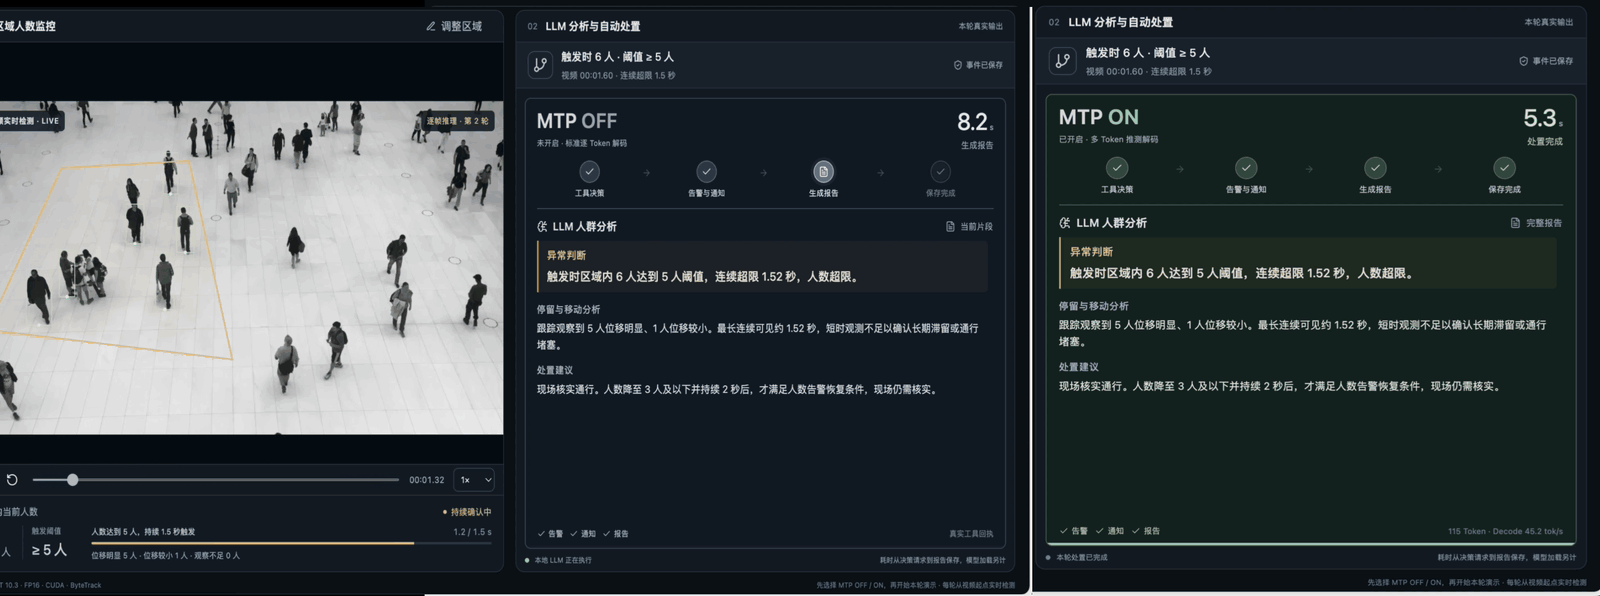
Como pode ser visto, para o cenário acima, ativar o modo MTP pode encurtar nosso tempo de conclusão da tarefa em cerca de 3 segundos — essa otimização é bastante significativa!
Por que a geração de texto de LLM leva tempo?
Um token por vez
Pergunte a um modelo onde o NVIDIA Jetson pode ser usado, e ele pode responder com robótica, visão industrial e monitoramento de borda. A frase aparece gradualmente porque um LLM autorregressivo prevê um token, o adiciona ao contexto e usa esse contexto para prever o próximo.
Um token pode ser uma palavra, parte de uma palavra ou um sinal de pontuação. Cada nova previsão depende do que veio antes, então o modelo repete esse processo até que a resposta esteja completa.
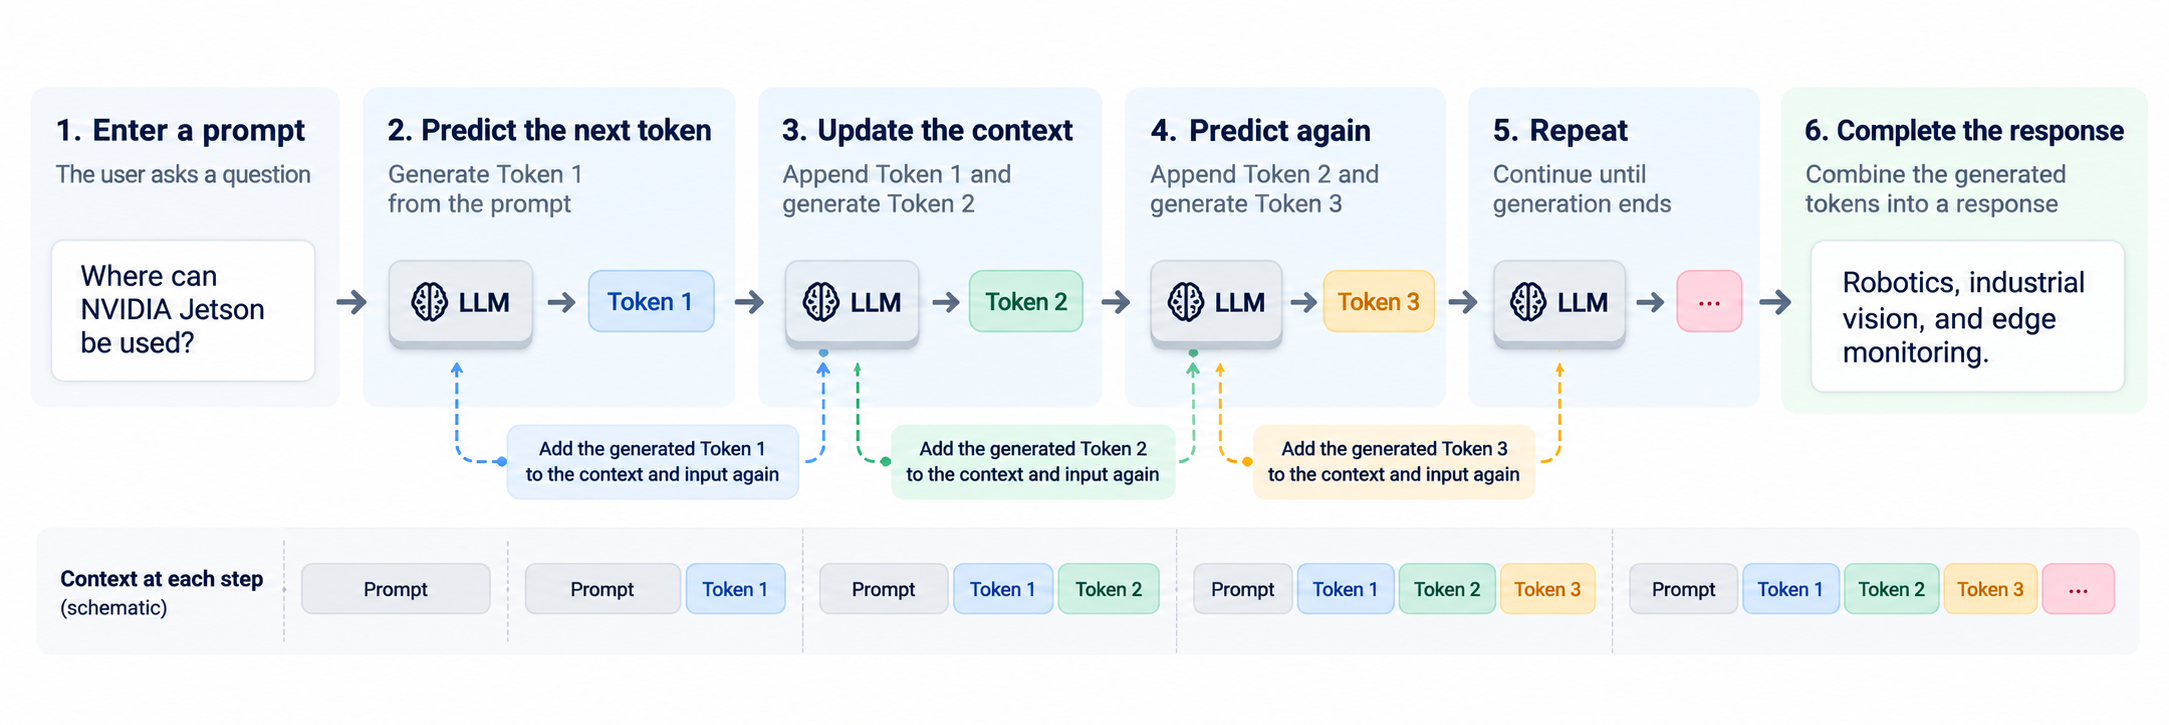
A 20 tokens/s, gerar 500 tokens leva cerca de 25 segundos de tempo de decodificação. Essa espera se torna perceptível quando um assistente local escreve código ou um relatório.
Prefill e decodificação
A inferência de LLM tem duas etapas principais.
| Etapa | Tarefa principal | Característica |
|---|---|---|
| Prefill | Ler o prompt e construir o estado de contexto | As posições de entrada podem ser processadas em paralelo |
| Decodificação | Gerar a resposta | Tokens posteriores dependem da saída anterior |
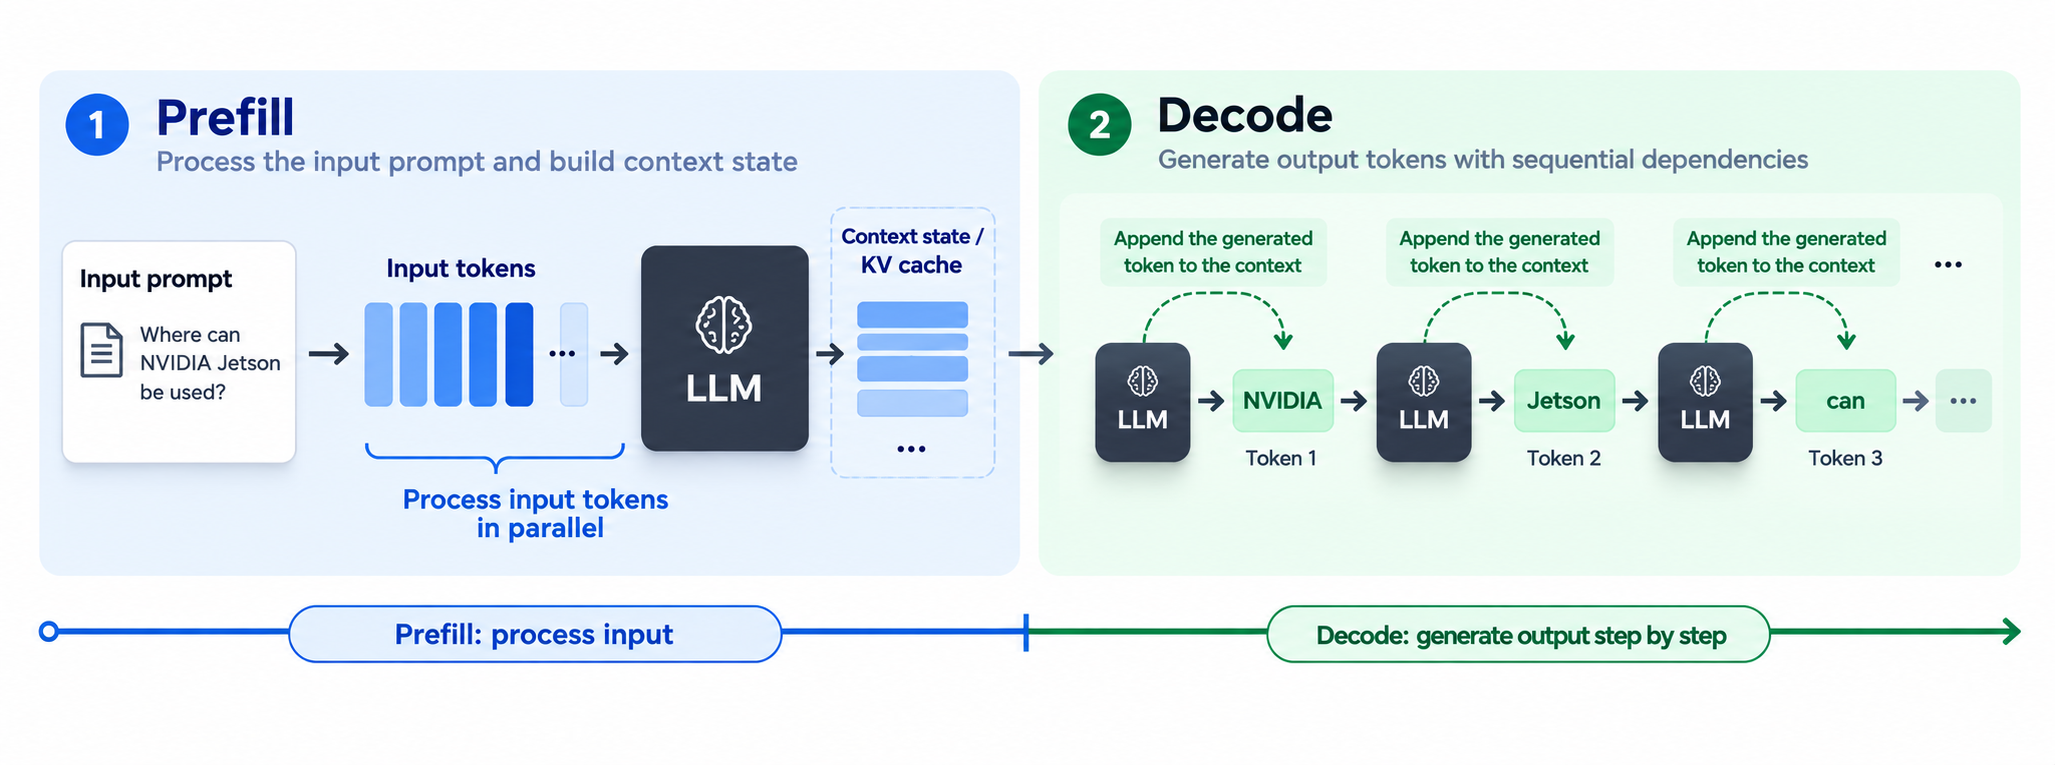
Para um LLM de usuário único no Jetson, a decodificação frequentemente gasta grande parte do tempo lendo pesos do modelo e contexto em cache da memória. A GPU tem capacidade de computação paralela, mas uma sequência de etapas de token único pode fazer uso limitado dela. O MTP tem como alvo principalmente essa etapa de decodificação.
O que é Multi-Token Prediction?
Multi-Token Prediction treina cabeças ou camadas de previsão adicionais para propor tokens futuros. Esses candidatos podem então ser usados em speculative decoding, onde o modelo alvo verifica várias posições juntas antes de aceitar a saída.
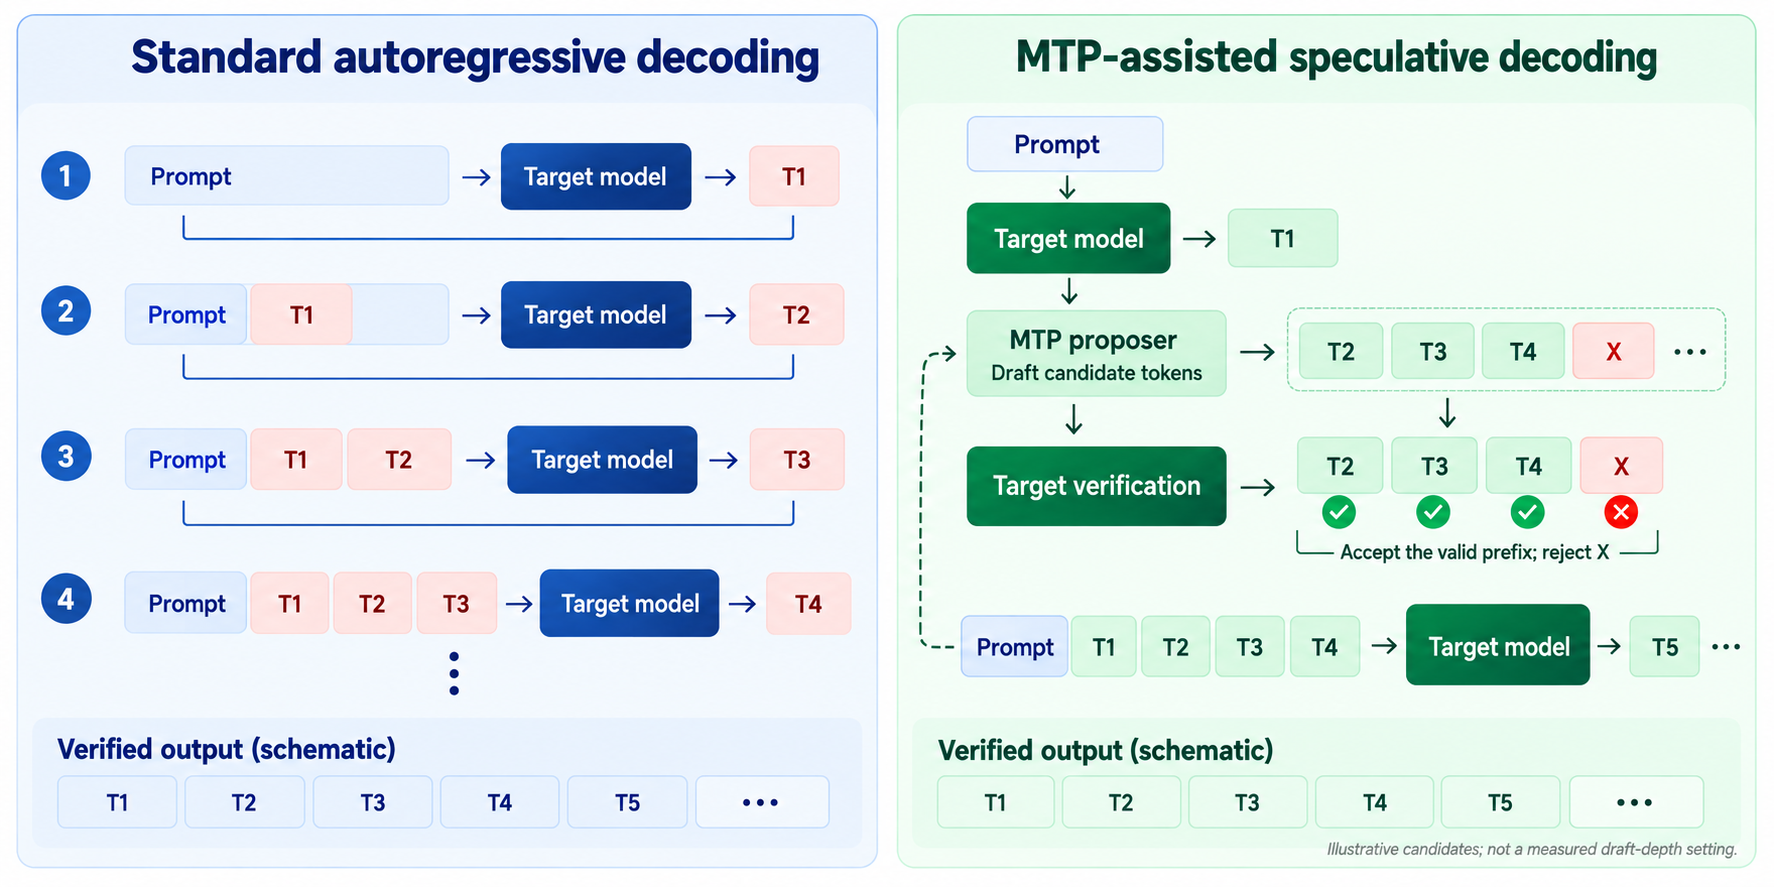
Quando vários candidatos passam na verificação, a resposta avança por múltiplos tokens em uma única passagem do modelo alvo. Se um candidato falhar, o runtime mantém o prefixo aceito e descarta o candidato rejeitado e o restante do rascunho. O modelo alvo continua a partir desse ponto.
Isso reduz o número de passagens de decodificação em série quando as propostas são suficientemente precisas. O modelo alvo ainda verifica a saída. Um speculative decoding sem perdas e correto preserva seu resultado ganancioso (greedy) ou distribuição de amostragem, embora quantização e diferenças numéricas de runtime possam afetar o comportamento prático.
O artigo de multi-token prediction explica a ideia de treinamento. A documentação de speculative decoding do llama.cpp descreve seu uso durante a inferência.
Por que o MTP pode ser mais rápido?
Mais saída útil por verificação
A verificação em lote permite que o modelo alvo verifique vários candidatos juntos. Em uma carga de trabalho limitada por largura de banda de memória, isso pode custar menos do que gerar os mesmos tokens por meio de passagens seriais separadas.
A elaboração e a verificação também consomem tempo. O MTP acelera a geração apenas quando o trabalho economizado excede esse custo extra. Um diagnóstico útil é a taxa de aceitação do rascunho, calculada como tokens de rascunho aceitos divididos por tokens de rascunho gerados. Meça também o quanto cada verificação avança a resposta e quanto tempo leva a requisição completa.
A profundidade do rascunho precisa ser testada
O comprimento máximo do rascunho é controlado por --spec-draft-n-max. Um rascunho mais longo dá ao modelo alvo mais candidatos para verificar, mas candidatos posteriores podem ser menos precisos. Descartá-los pode superar o benefício de um lote maior.
Comece com uma profundidade pequena e compare em seus próprios prompts. A comparação do Edge Crowd Agent usa profundidade 2. Uma configuração que funciona bem para formatos regulares de código ou relatório pode se comportar de forma diferente em outra carga de trabalho.
Ative o MTP no llama.cpp no Jetson
As demonstrações usam a seguinte configuração.
| Componente | Configuração |
|---|---|
| Hardware | NVIDIA Jetson AGX Orin 32GB |
| JetPack | 6.2.1 |
| Runtime | llama.cpp com CUDA |
| Modelo | Qwen3.5-4B com tensores MTP |
| Quantização | Q4_K_M GGUF |
| Comparação | MTP desligado / MTP ligado |
Compile o llama.cpp com CUDA seguindo as instruções oficiais de compilação. Escolha o Qwen3.5-4B GGUF com MTP ativado e verifique se a saída de ajuda do seu binário lista draft-mtp.
Quando o runtime estiver pronto, o comando de inicialização com MTP é curto.
llama-server \
  -hf unsloth/Qwen3.5-4B-MTP-GGUF:Q4_K_M \
  -ngl 99 -c 8192 -np 1 \
  --spec-type draft-mtp \
  --spec-draft-n-max 2
Use o binário llama-server da sua compilação. Para um modelo baixado, substitua -hf por -m seguido do caminho local do GGUF.
--spec-type draft-mtp ativa o MTP; --spec-draft-n-max controla sua profundidade. Para a comparação com MTP desligado, use --spec-type none e mantenha o modelo e as configurações compartilhadas inalterados.
Após a geração, verifique o log de inicialização em busca dos tensores MTP carregados e das estatísticas de aceitação de rascunho do servidor. Use um slot e requisições somente de texto para esta configuração; consulte as instruções do publicador do modelo para as restrições de compatibilidade atuais.
Onde o MTP é útil?
Relatórios de inspeção e monitoramento
Um Jetson pode coletar detecções, leituras de sensores e logs de equipamentos e então pedir a um LLM local para escrever um relatório de inspeção. Campos e descrições recorrentes tornam essa uma carga de trabalho útil para testar a aceitação de candidatos. O benefício é uma espera menor pelo relatório escrito; controle em tempo real e proteção permanecem separados.
Assistentes de programação locais
Scripts Python, comandos de shell e arquivos de configuração de dispositivos frequentemente produzem respostas relativamente longas com sintaxe regular. O exemplo de Fibonacci na Introdução mostra o potencial neste dispositivo. O código gerado ainda precisa ser verificado e testado.
Assistentes de voz offline e robôs
Um assistente de voz passa a fala reconhecida para o LLM local e então envia sua resposta para texto‑para‑fala.
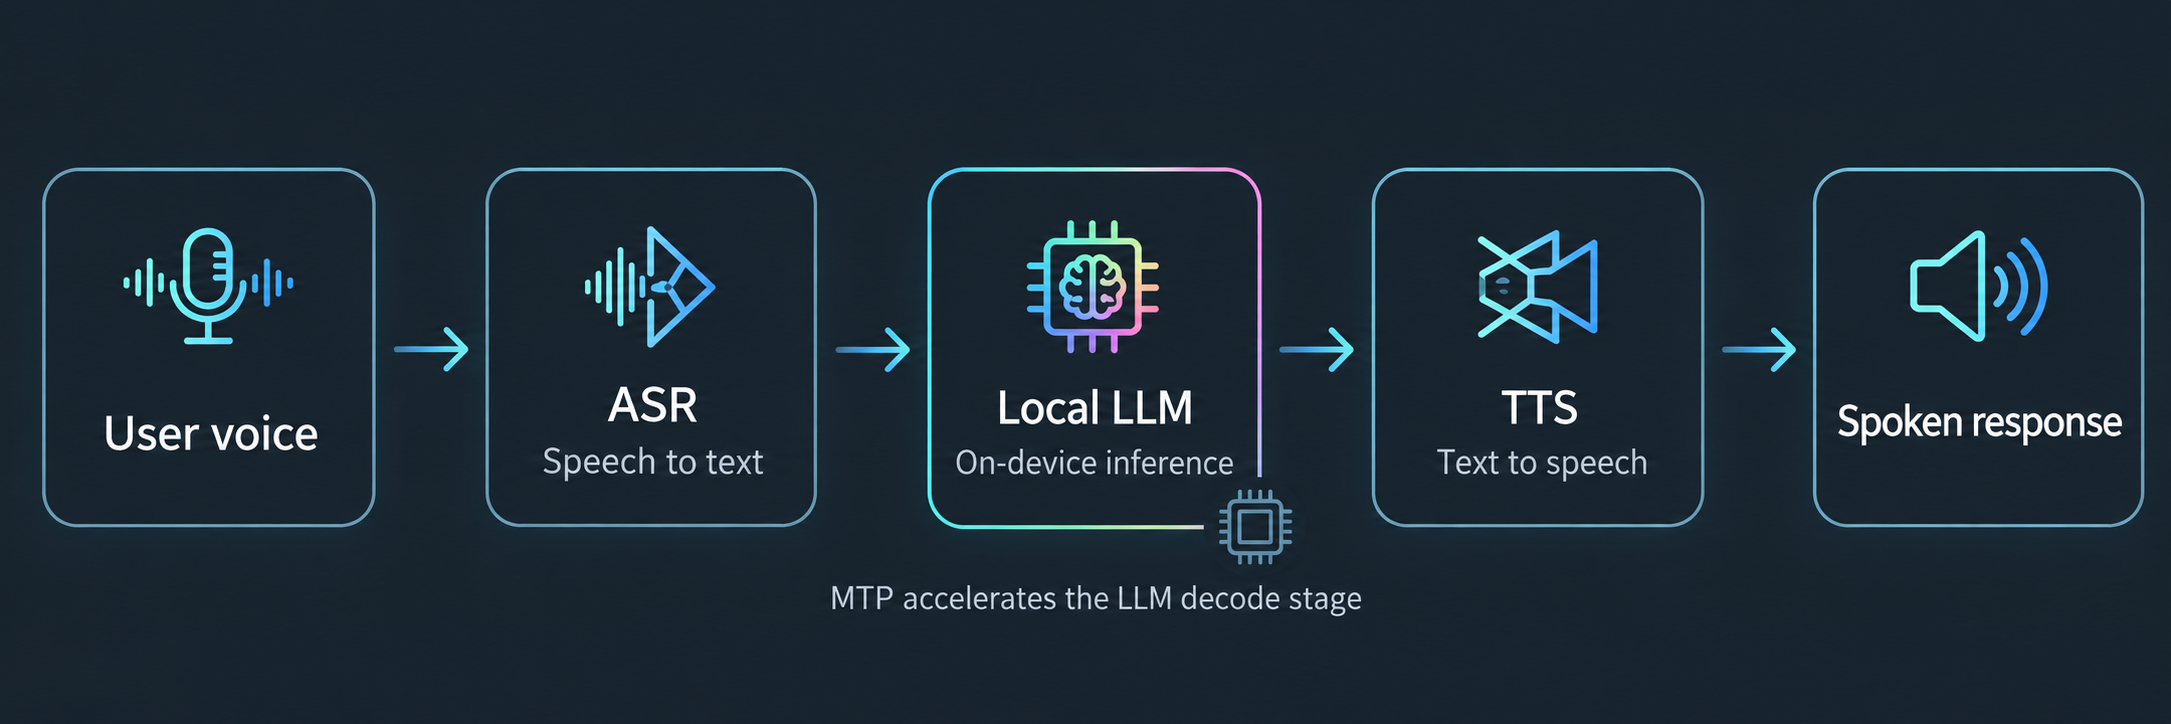
O MTP pode encurtar a etapa de decodificação do LLM para respostas mais longas. Reconhecimento de fala, síntese e streaming determinam quando o usuário realmente ouve uma resposta, então meça o tempo até a primeira fala utilizável, bem como o tempo de resposta completo.
Conhecimento local e explicações técnicas
Instruções de solução de problemas e respostas longas baseadas em logs de dispositivos podem gastar bastante tempo gerando saída. Vale a pena testá-las. Para um documento longo que precisa apenas de uma resposta de uma linha, o processamento do prompt pode dominar e deixar pouco tempo de decodificação a ser economizado.
Quando vale a pena ativar o MTP?
Um modelo compatível é o primeiro requisito. O runtime deve suportar seus componentes de previsão, e o trabalho extra de elaboração precisa se pagar no seu hardware e prompts. Maior aceitação e saídas mais longas geralmente ajudam, enquanto baixa aceitação ou respostas muito curtas podem tornar o MTP mais lento.
Compare o tempo que sua aplicação realmente precisa. Uma decodificação mais rápida não reduz o processamento de imagem, a execução de ferramentas ou o carregamento de modelos pelo mesmo fator. Mantenha o modelo, os limites de entrada e saída e as configurações de amostragem consistentes e, em seguida, decida com base no resultado medido.
Experimente a demonstração de monitoramento de multidões
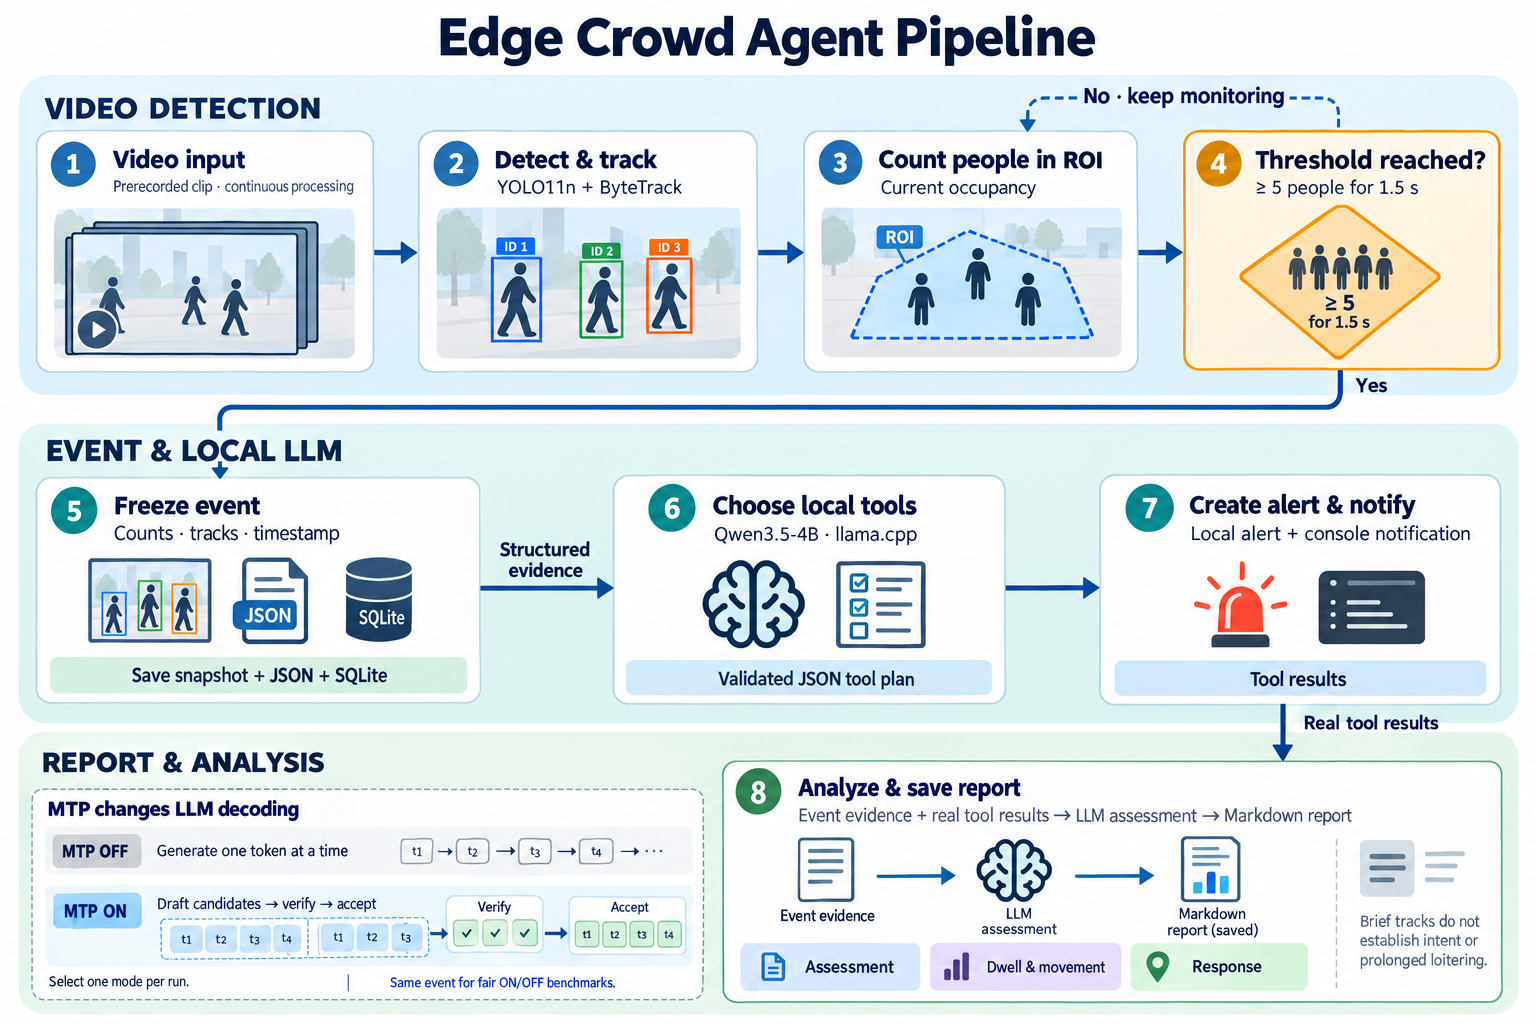
A fonte da demonstração de abertura é o Edge Crowd Agent. YOLO11n e ByteTrack medem a ocupação atual da ROI, e um LLM local explica a contagem salva e as evidências de movimento quando um evento é acionado.
Siga Start on Jetson in the README para dependências, caminhos de modelos e vídeos, verificações de ambiente e inicialização. O projeto usa uv com o Python 3.10 do sistema para manter o acesso às bindings do TensorRT do JetPack.
Após a inicialização, escolha MTP OFF ou ON e selecione Start demo. A detecção de vídeo permanece à esquerda, com a análise e o progresso das ferramentas à direita. O guia de gravação explica como executar ambas as demonstrações.
A condição de evento padrão é de pelo menos 5 pessoas na ROI por 1,5 segundo de tempo contínuo de vídeo. O LLM recebe evidências estruturadas em vez de pixels de vídeo; rastros breves sustentam uma avaliação de ocupação, mas não podem estabelecer intenção ou permanência prolongada.
Para uma comparação controlada, use o mesmo evento congelado em vez de duas gravações separadas. A seção de benchmark do README fornece o método de teste e os resultados medidos, com o carregamento do modelo listado separadamente.
Referências
- Código-fonte e uso do Edge Crowd Agent
- Registros de benchmark do Edge Crowd Agent
- Tutorial de decodificação especulativa do Jetson AI Lab
- Documentação de decodificação especulativa do llama.cpp
- llama.cpp SPEED-Bench
- Modelo Qwen3.5-4B MTP GGUF
- Better & Faster Large Language Models via Multi-token Prediction
Suporte Técnico e Discussão de Produtos
Obrigado por escolher nossos produtos! Estamos aqui para oferecer diferentes tipos de suporte para garantir que sua experiência com nossos produtos seja a mais tranquila possível. Oferecemos vários canais de comunicação para atender a diferentes preferências e necessidades.