15. Modelo ACT e Fracionamento de Ações
Capítulo 15 do Curso para Iniciantes em IA Física da Seeed — entrada e saída do ACT, a estrutura ResNet e Transformer, intuição sobre atenção, CVAE, bloco de ação vs horizonte de ação, defesas contra acúmulo de erro e limites de capacidade do ACT.
15.1 De Clonagem Comportamental a ACT
15.1 De Clonagem Comportamental a ACT: Só Precisamos de um "Bom Modelo"
O Capítulo 9 abordou a clonagem comportamental: gravar demonstrações de teleoperação como um conjunto de dados e deixar o modelo aprender a "fazer o que você vê". Isso deixou uma pergunta — que modelo é digno desses dados? Um modelo de política implantável precisa superar pelo menos três obstáculos:
- Entender imagens.
- Pensar de forma coerente.
- Resistir ao erro acumulado.
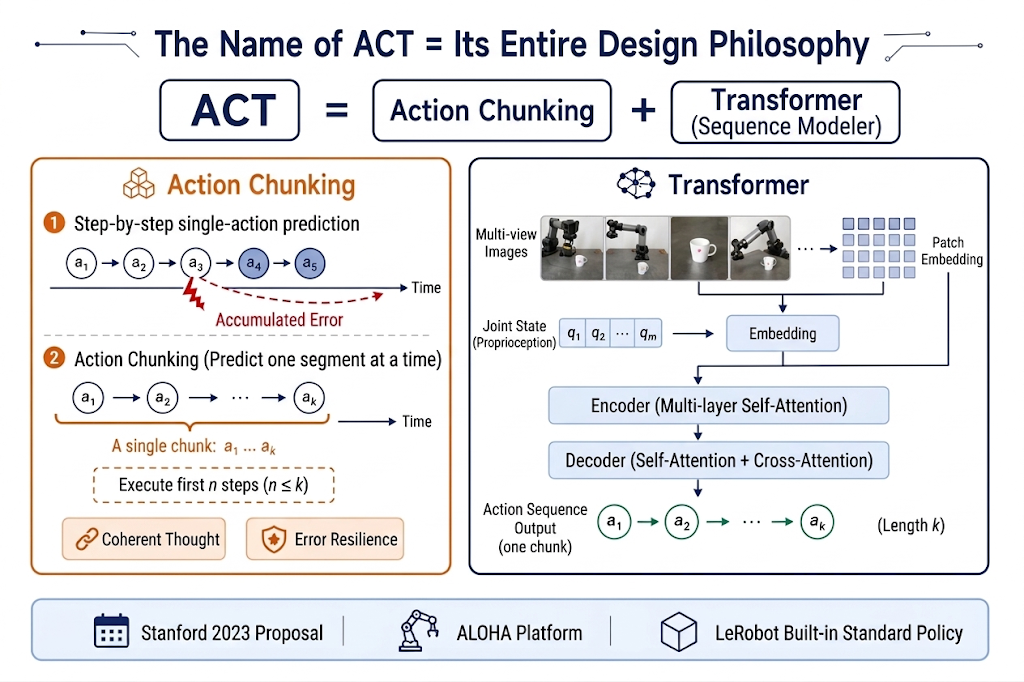
ACT (Action Chunking with Transformers) é o modelo de política construído para superar esses três obstáculos. Proposto por uma equipe de Stanford em 2023, ele primeiro ganhou fama na plataforma de baixo custo ALOHA de dois braços realizando tarefas delicadas como abrir tampas de copos e selar sacos; depois, o Mobile ALOHA demonstrou tarefas complexas como cozinhar camarão. Hoje ele está incorporado ao LeRobot como uma das políticas padrão — e é o modelo que você vai treinar e implantar na prática neste estágio.
O nome do ACT É toda a sua filosofia de design: Action Chunking + Transformer (modelador de sequência). O restante deste capítulo destrincha esses dois termos.
15.2 Entrada e Saída do ACT
15.2 Entrada e Saída do ACT: Veja Primeiro as Duas Pontas
A maneira mais confiável de entender qualquer modelo é olhar primeiro para sua "interface" — o que ele recebe, o que ele produz.
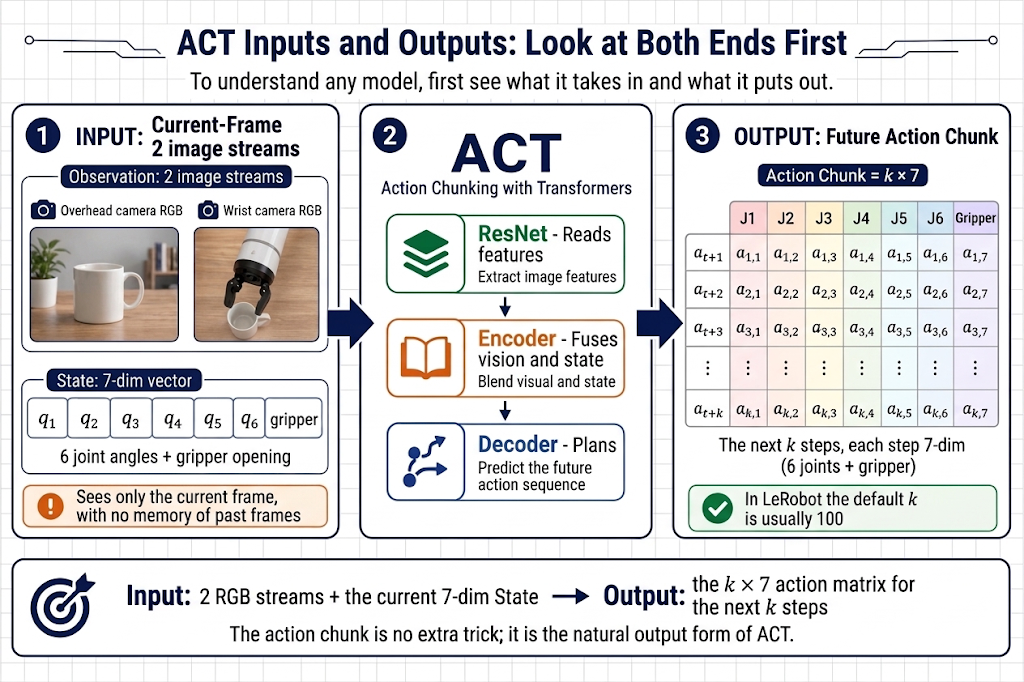
Entrada: Observação Atual
Durante a inferência, o ACT recebe um quadro de observação contendo dois tipos de informação:
| Entrada | No reBot Arm | Dimensionalidade |
|---|---|---|
| Imagens (Observação) | Fluxos RGB duplos de vista superior + punho | 2 × imagens |
| Estado das juntas (Estado) | 6 ângulos de junta + abertura do gripper | Vetor de 7 dimensões |
Observe que o ACT é apenas por quadro: ele não lembra quadros passados; cada decisão é baseada em "o que vê agora + onde as juntas estão agora".
Saída: Bloco de Ação para uma Janela Curta de Futuro
A saída do ACT não é a próxima ação, mas sim um bloco inteiro de sequência de ações (Action Chunk):
Input: 2 image streams + 7-dim joint state (current frame)
Output: action sequence for next k steps, each step 7-dim (6 joints + gripper)
      i.e., a k × 7 action matrix
Na configuração padrão de ACT do LeRobot, k (tamanho do bloco) é tipicamente 100 — uma inferência fornece um plano de ação completo para cerca de 100 passos futuros no tempo. Isso responde à antecipação do Capítulo 9: Action Chunk não é um truque abstrato de otimização; é a forma natural de saída do ACT.
15.3 Estrutura Interna do ACT
15.3 Estrutura Interna do ACT: Três Oficinas em Uma Linha de Montagem
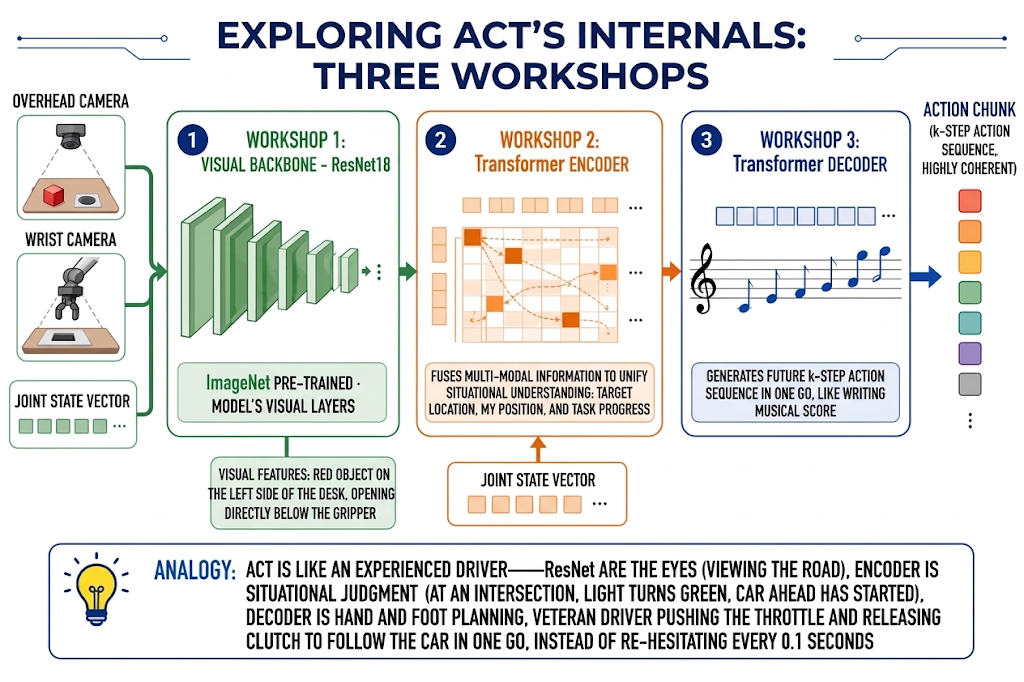
Oficina 1: Espinha Dorsal Visual (ResNet) — De Pixels a Recursos
As imagens das câmeras de vista superior e de punho passam cada uma por uma ResNet18 (uma CNN pré-treinada no ImageNet), comprimidas em um conjunto de recursos visuais. Pense na ResNet como o "córtex visual" do modelo: pixels brutos não significam nada para ele; ela extrai informações estruturadas como "há um objeto vermelho à esquerda da mesa" ou "há uma abertura diretamente abaixo do gripper".
Oficina 2: Codificador Transformer — Entendendo "o Presente"
Recursos visuais + vetor de estado das juntas se unem e entram no codificador Transformer. O trabalho do codificador é fundir múltiplos fluxos em um entendimento unificado da situação atual: "onde está o alvo, onde estou, em que ponto a tarefa está".
Oficina 3: Decodificador Transformer — Planejando "o Futuro"
O decodificador pega o entendimento do codificador e gera a sequência de ações para os próximos k passos de uma só vez. Ele não cospe ações uma a uma; como escrever uma partitura, ele compõe todo o "movimento futuro" em um só fôlego — essa é a razão fundamental pela qual blocos de ação são internamente tão coerentes.
15.4 O Que é um Transformer
15.4 O Que é um Transformer: Intuição por Trás da Atenção
As oficinas 2 e 3 do ACT são ambas Transformers, mas o que É um Transformer?
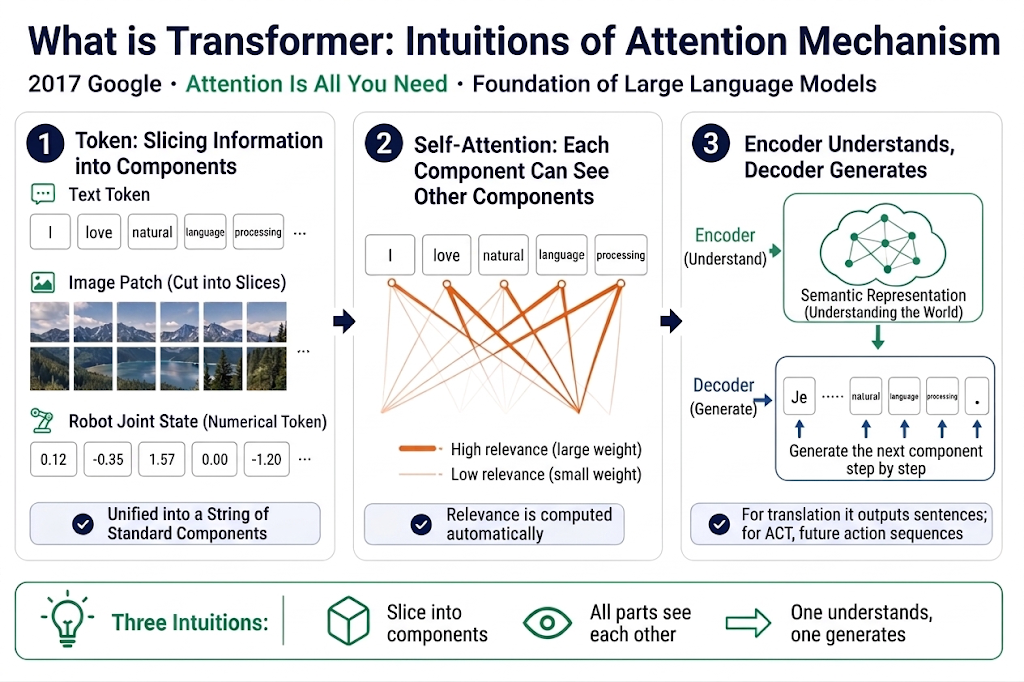
Ele foi proposto pelo Google em 2017 para tradução automática; o artigo se chama "Attention Is All You Need" e mais tarde se tornou a arquitetura fundamental dos grandes modelos de linguagem. Sem precisar de fórmulas — três intuições bastam:
- Token: cortar a informação em "partes". Transformers não processam frases brutas ou pixels brutos diretamente; primeiro cortam a entrada em partes padronizadas (tokens) — uma frase em palavras, uma imagem em patches, um vetor de estado de juntas também pode ser um token. Uma vez que toda a informação é unificada em "uma sequência de partes", o mesmo mecanismo as processa todas.
- Autoatenção: cada parte pode "ver" todas as outras partes. Este é o núcleo do Transformer. Ao processar cada parte, ele calcula sua relevância para cada outra parte e se concentra em absorver informações das mais relevantes — "para onde olhar" não é prescrito por humanos; o modelo aprende isso.
- Codificador e Decodificador: um entende, o outro gera. O Codificador funde uma sequência de entrada de partes em "um entendimento da situação atual"; o Decodificador pega esse entendimento e gera uma nova sequência de partes de saída — em tradução, é a frase no idioma-alvo; no ACT, é a sequência de ações futuras.
15.5 Como o Transformer é Usado no ACT
15.5 Como o Transformer é Usado no ACT
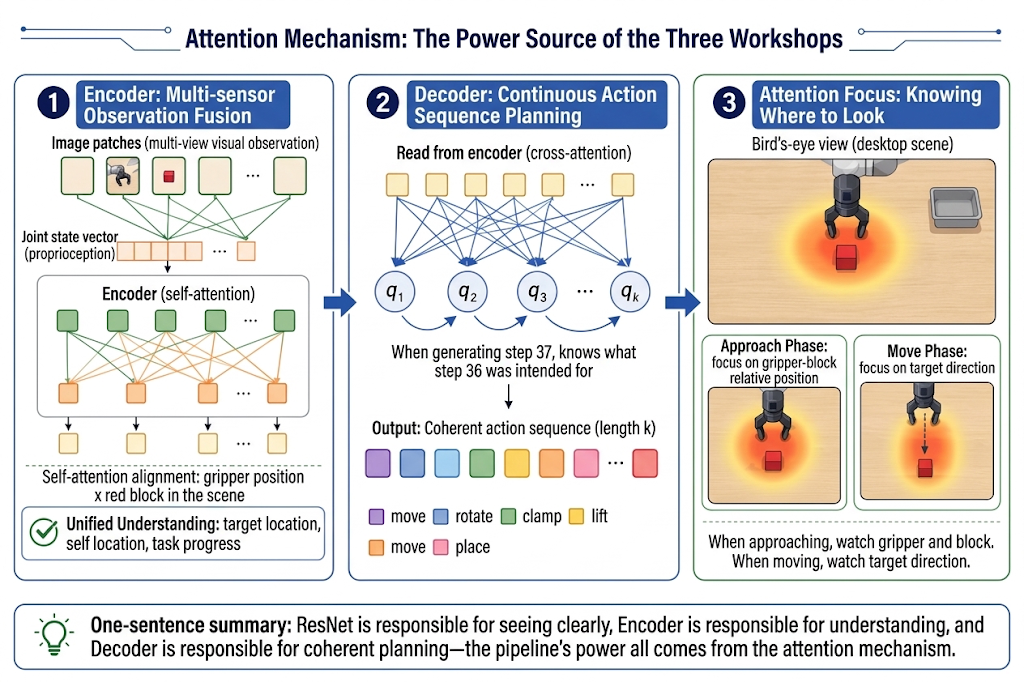
- No codificador: fundindo múltiplas observações. Patches de recursos visuais de ambas as imagens (via ResNet) mais o vetor de estado das juntas tornam-se todos tokens alimentados no codificador. A autoatenção os alinha — "a posição atual do gripper" e "aquele bloco vermelho na imagem" são conectados em um entendimento unificado: onde está o alvo, onde estou, em que ponto a tarefa está.
- No decodificador: planejando toda a sequência de ações de uma vez. O decodificador usa k vetores de consulta correspondentes a k passos futuros de ação; essas consultas extraem informações do entendimento do codificador enquanto também se coordenam entre si via autoatenção — a ação no passo 37 "sabe" o que o passo 36 pretende fazer. O bloco de ação inteiro é, portanto, um todo coerente, não 100 decisões isoladas.
- No foco da atenção: saber para onde "olhar". Ao gerar cada ação, o modelo automaticamente foca nas regiões da imagem mais relevantes para a ação atual — ao se aproximar do alvo, ele foca na posição relativa gripper-bloco; enquanto se move, foca na direção do alvo — em vez de tratar todas as regiões igualmente.
Resumo em uma frase: a ResNet "vê com clareza", o codificador Transformer "entende", o decodificador Transformer "planeja de forma coerente" — tudo movido a atenção.
15.6 O Que é CVAE
15.6 O Que é CVAE
CVAE (Conditional Variational Autoencoder). O ACT do LeRobot na verdade é treinado com isso, você só não vê isso na linha de comando lerobot-train --policy.type=act.
Que Armadilha Ele Evita: A Média Erra
O trabalho do CVAE não é "reduzir o humano a uma única resposta correta", mas reconhecer: dada a observação atual, as ações podem ter múltiplos estilos; durante o treinamento, ele primeiro identifica qual estilo é este, depois reproduz aquela sequência de ações.
O artigo fez comparações (em tarefas simuladas):
- Se as demonstrações são roteirizadas (apenas uma forma), remover o CVAE mal afeta a taxa de sucesso.
- Com dados humanos, removê-lo derruba o sucesso de ~35% para 2%.
Portanto, o CVAE não existe para deixar as fórmulas mais bonitas; ele existe para permitir que o modelo lide com dados em que "humanos mudam de abordagem e têm mãos trêmulas".
"Condicional" significa: as ações geradas devem estar ancoradas no que é visto atualmente — seja um lagostim ou um bloco na mesa, ele não pode inventar coisas. CVAE é "dado o que você vê, componha como se mover em seguida".
15.7 Bloco de Ação vs. Horizonte de Ação
15.7 Bloco de Ação vs. Horizonte de Ação
Estes são os dois conceitos mais precisamente diferenciados neste capítulo; eles são dois parâmetros ajustáveis de forma independente:
- Action Chunk: o comprimento da sequência de ações que o modelo prevê em uma única passada forward, ou seja, o número de linhas k na matriz de saída. No LeRobot, o ACT usa por padrão chunk de tamanho 100.
- Action Horizon: depois de prever esses 100 passos, quantos são realmente executados em malha aberta, antes de observar novamente e voltar a prever.
A relação é: o chunk previsto pode ser longo, mas a cada vez apenas o primeiro pequeno segmento é confiável.
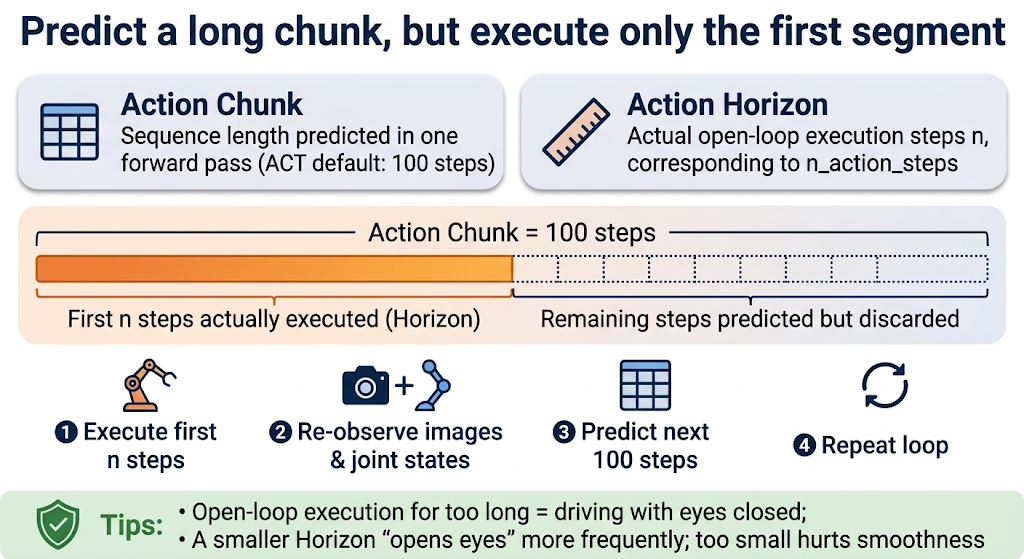
Por que não executar todos os 100 passos? Porque as previsões se tornam menos confiáveis quanto mais longe vão — o ambiente muda, objetos podem ser esbarrados e, na segunda metade, a "situação presumida" pelo modelo já se desviou da realidade. Executar em malha aberta por tempo demais = dirigir de olhos fechados. Quanto menor o Horizon, com mais frequência o modelo "abre os olhos para conferir", tornando-se mais robusto a perturbações; mas se for pequeno demais, perde-se a suavidade obtida com o chunking.
É como usar navegação por celular enquanto dirige. A navegação (o modelo) calcula toda a rota (chunk) de uma vez, mas você não trava o volante — a cada alguns quilômetros você dá uma olhada no trânsito em tempo real (re-observa) e a navegação refaz o plano conforme necessário (re-prediz). A distância em que você "confia na rota antiga e continua dirigindo" é o Horizon.
15.8 Continuidade da Ação e Acúmulo de Erros
15.8 Continuidade da Ação e Acúmulo de Erros: Duas Linhas de Defesa do ACT
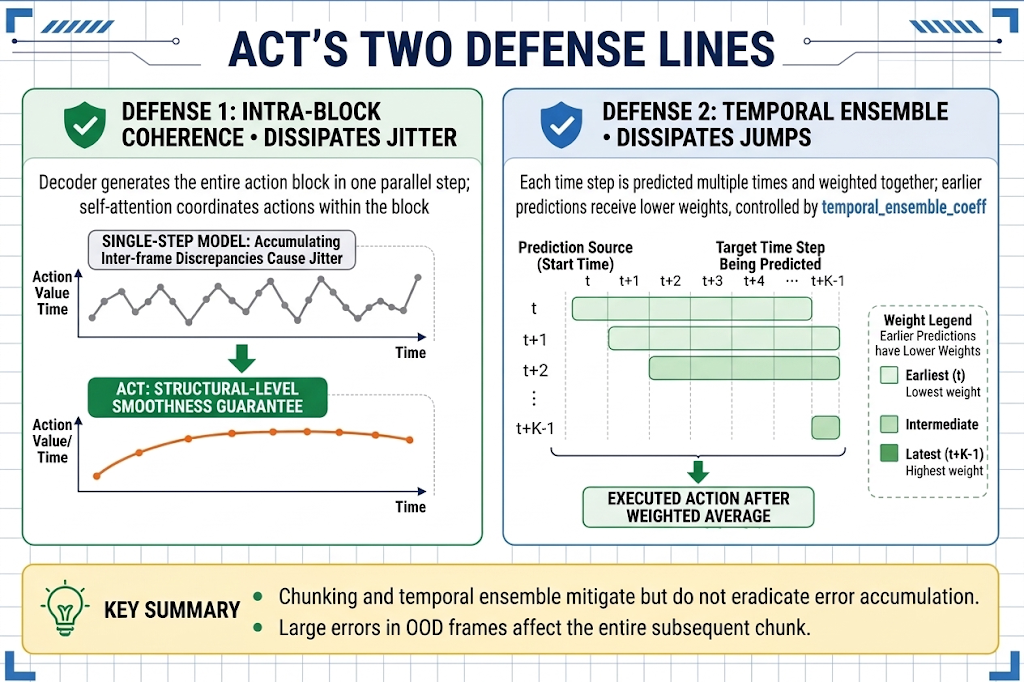
O Capítulo 9 deixou duas ameaças à estabilidade de robôs reais: jitter de ação e acúmulo de erros. Agora vamos ver como o ACT lida com elas usando métodos estruturados.
- Defesa 1: coerência intra-chunk corrige o jitter.
- Defesa 2: ensemble temporal corrige descontinuidades.
15.9 Para Quais Tarefas o ACT é Adequado?
15.9 Para Quais Tarefas o ACT é Adequado?
Dadas as características de projeto do ACT, sua "zona de conforto" é bem clara:
| Adequado para | Motivo |
|---|---|
| Manipulação em bancada (agarrar, colocar, organizar, conectar/desconectar) | O ACT se originou nessas tarefas; as necessidades de dados e o tamanho do modelo são compatíveis |
| Tarefas únicas ou poucas tarefas | Clonagem comportamental aprende mapeamentos específicos de tarefa; mais tarefas = mais dados necessários |
| Tarefas curtas (segundos até ~1 minuto) | O erro se acumula ao longo do tempo; tarefas mais curtas são mais estáveis |
| Tarefas com informação visual suficiente | Cenas em que câmeras dupla superior + de punho cobrem as informações principais |
| Hardware com recursos limitados | O ACT tem relativamente poucos parâmetros; GPUs de consumo podem treinar e inferir; CPU também pode inferir |
15.10 Limites de Capacidade do ACT
15.10 Limites de Capacidade do ACT
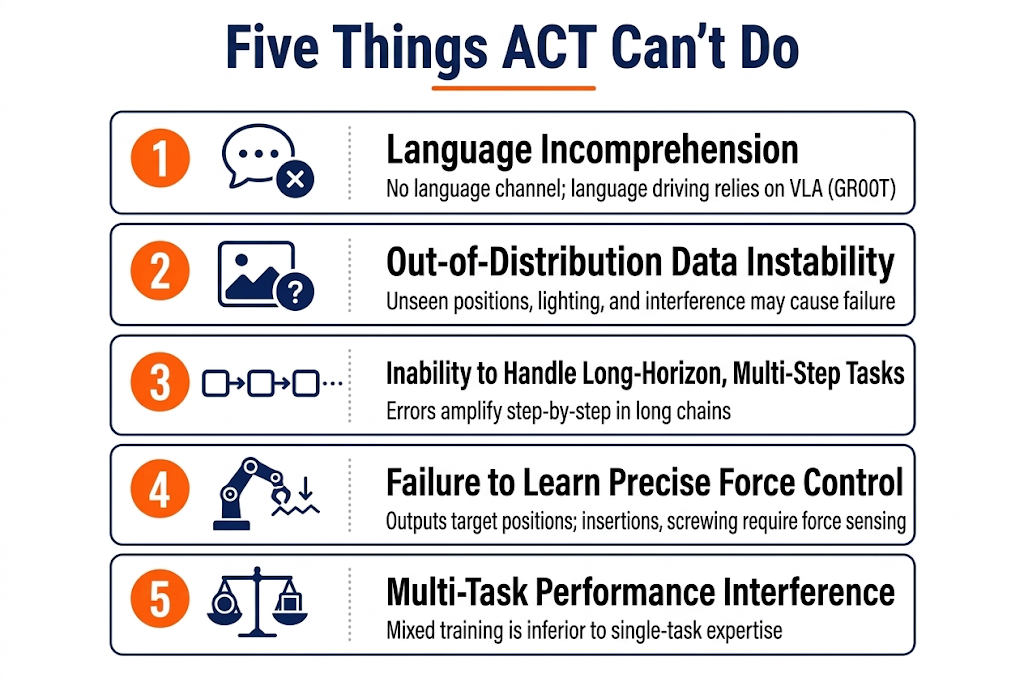
Igualmente importante é saber o que ele não consegue fazer: