18. Aprendizado Multimodal e Fundamentos de VLA
Capítulo 18 do Curso para Iniciantes em IA Física da Seeed — visão/linguagem/ação, VLM vs VLA, ACT vs VLA, tarefas condicionadas por linguagem, tarefa única vs múltiplas tarefas vs generalização, ações contínuas vs tokens de ação, e capacidades e limitações de VLA.
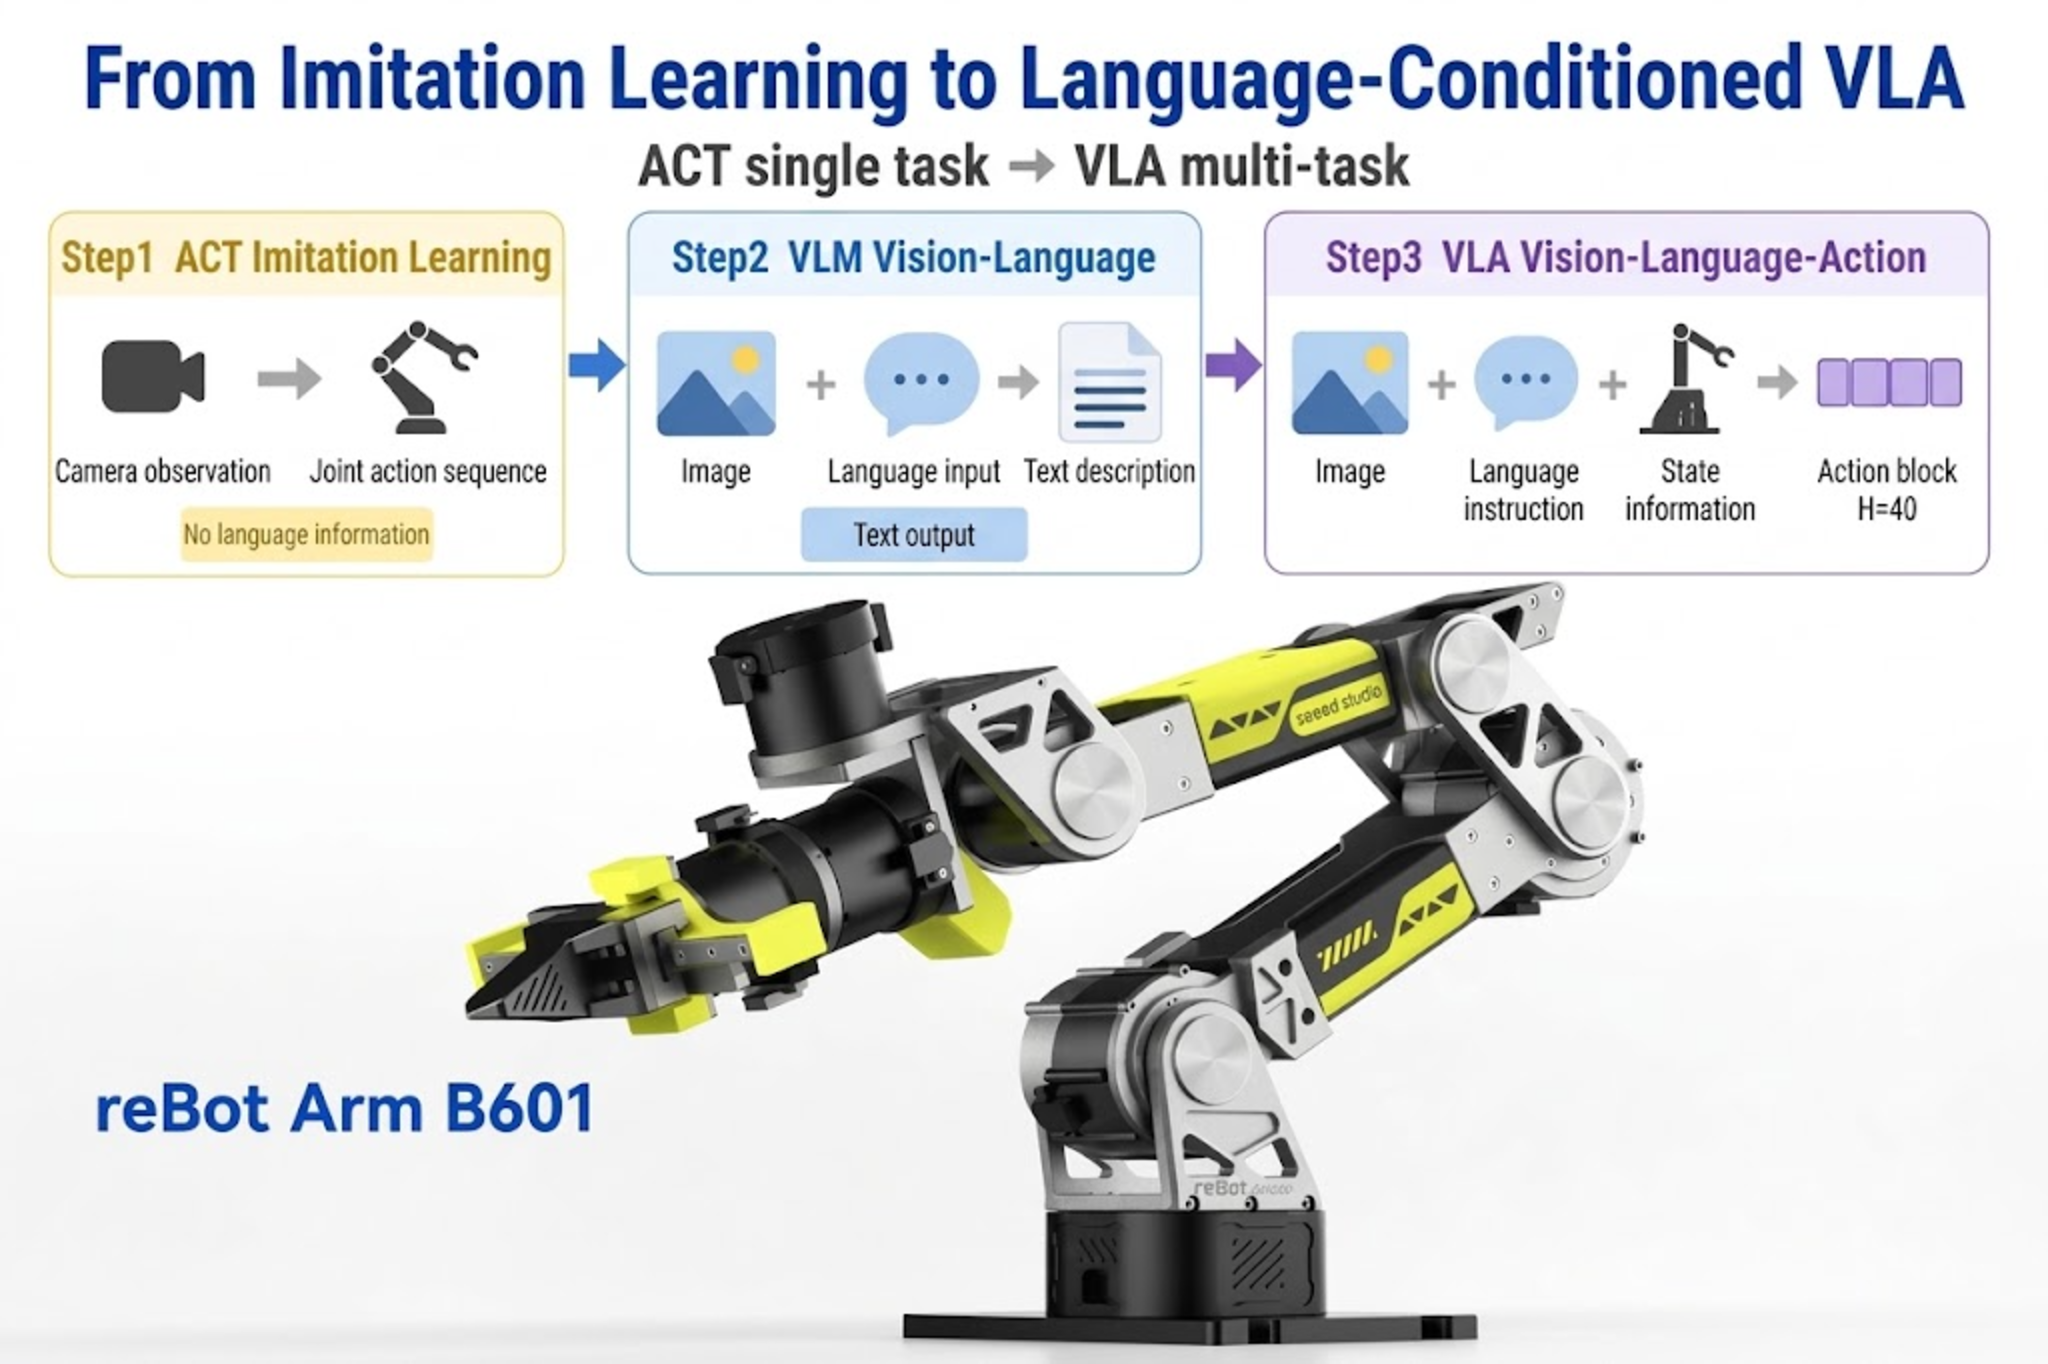
Nos capítulos anteriores, você utilizou políticas como ACT (Action Chunking with Transformers) no reBot Arm para concluir aprendizado por imitação que "olha para uma imagem e gera ações das juntas". Esses métodos geralmente são treinados para uma única tarefa: o modelo aprende apenas o comportamento único de "colocar o cubo vermelho na caixa", e trocar de tarefa exige coletar dados novamente e retreinar.
Este capítulo apresenta a ideia central de VLA (Vision-Language-Action): permitir que o robô não apenas "veja", mas também "entenda" instruções em linguagem natural, e compartilhe uma única rede de política entre múltiplas tarefas.
18.1 Modelos Multimodais
18.1 O que é um Modelo Multimodal?
Um modelo multimodal funde mais de um tipo de informação — imagens, texto e estado do robô — em uma única decisão unificada. No contexto de VLA, as três modalidades abaixo são combinadas e decodificadas em ações do robô.
18.2 Visão, Linguagem e Ação
18.2 Visão, Linguagem e Ação
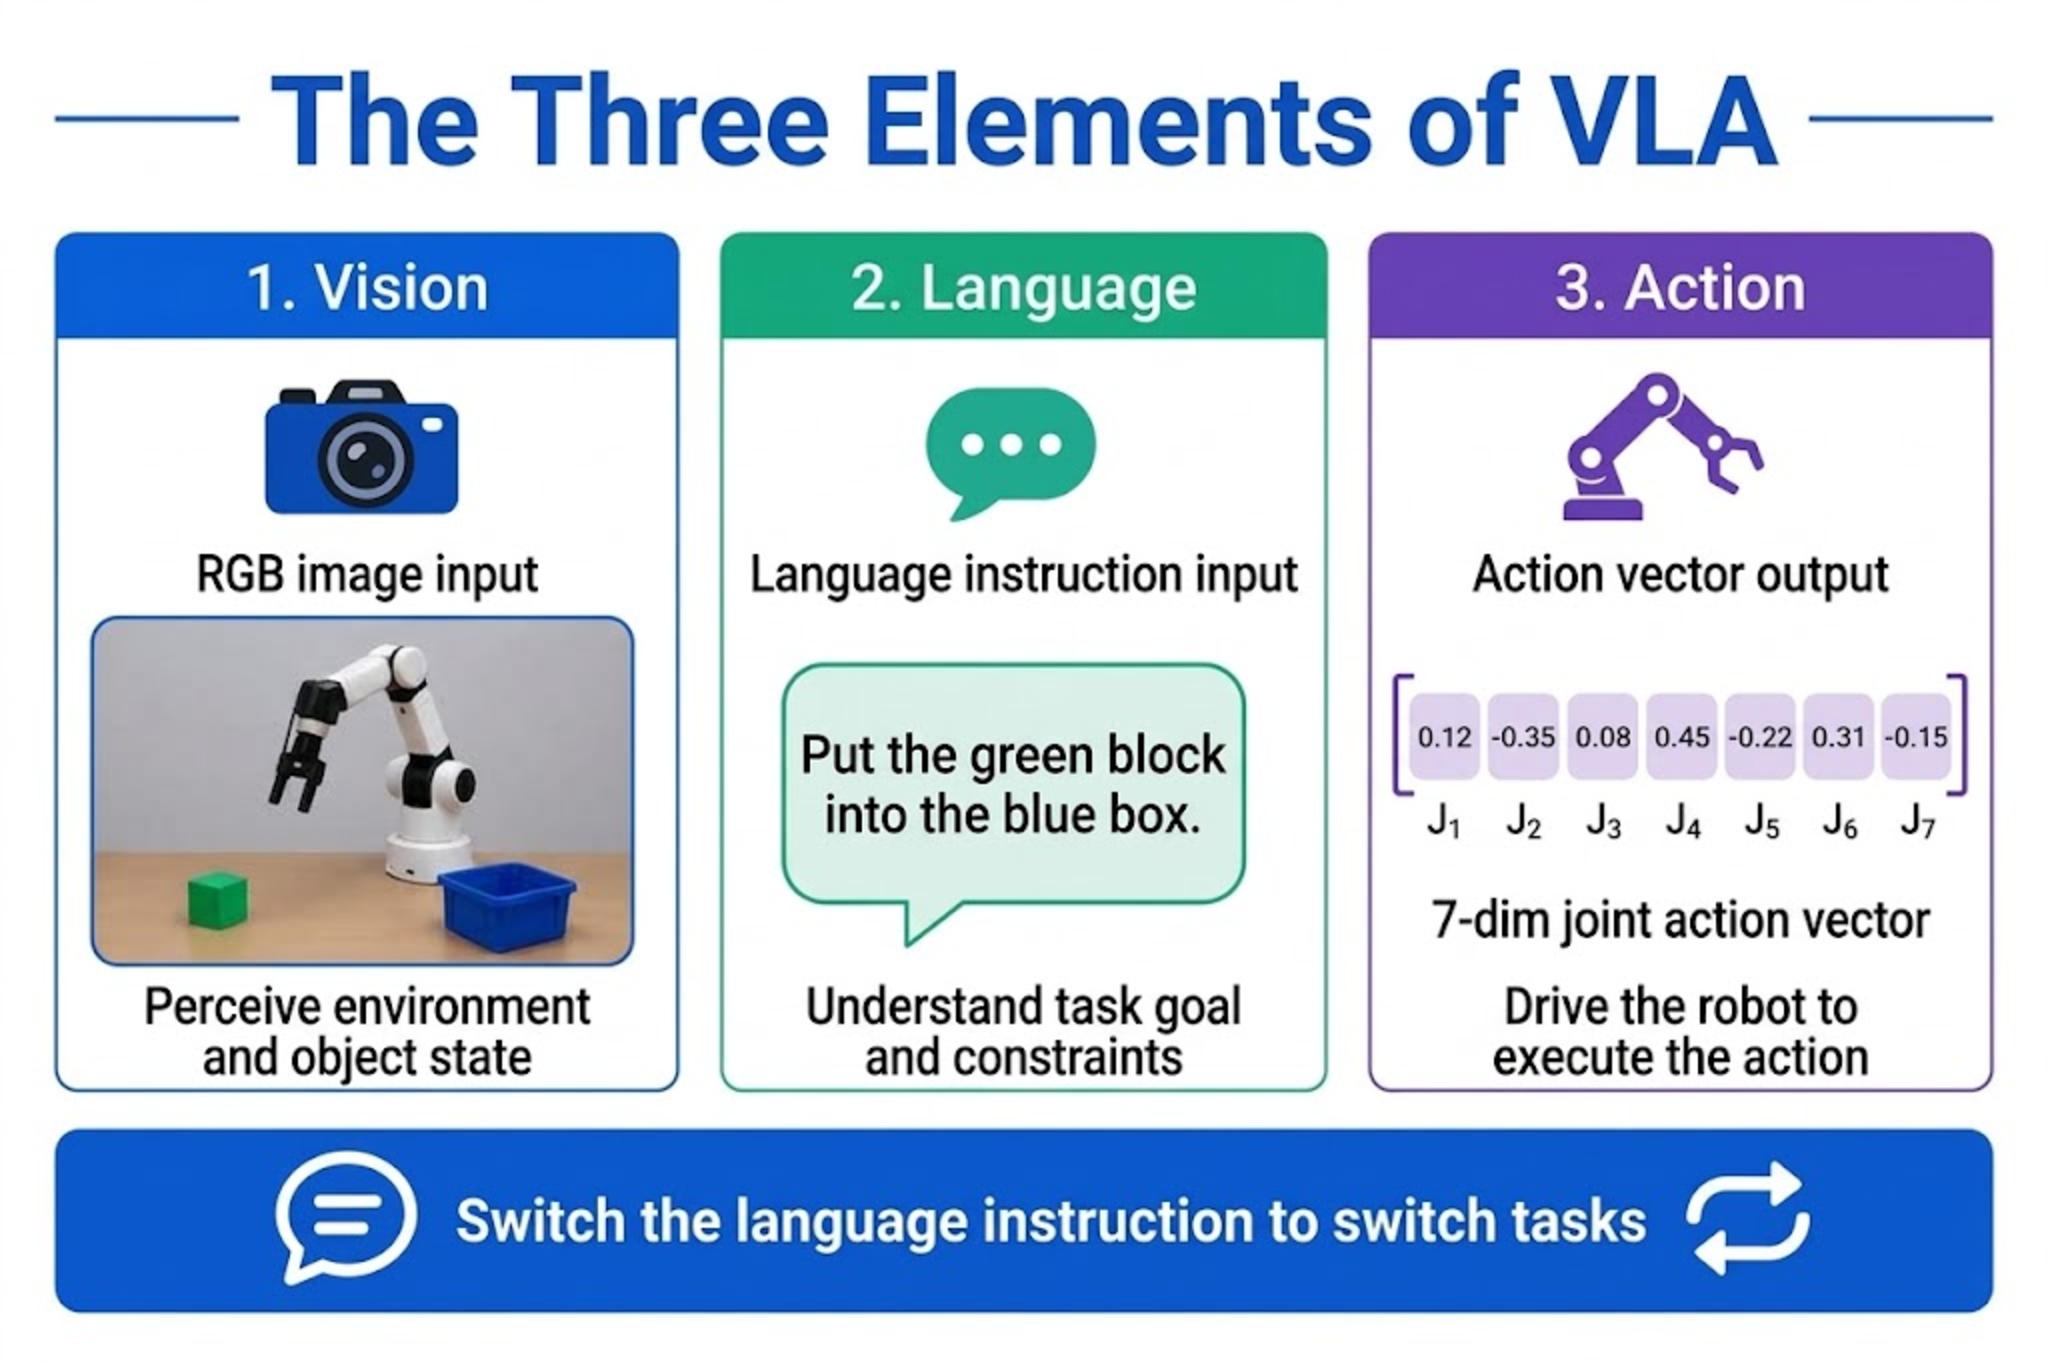
No framework VLA, as três modalidades têm cada uma uma divisão de trabalho clara:
| Modalidade | Significado | Fonte típica no reBot Arm |
|---|---|---|
| Visão | Imagens RGB capturadas por câmeras externas e câmeras de pulso | Câmera frontal, câmera de pulso RealSense / USB |
| Linguagem | Descrição em linguagem natural da tarefa | "Coloque a chave de fenda na caixa de ferramentas" |
| Ação | Os comandos de controle que o robô deve executar | Ângulos alvo de cada junta, largura de abertura/fechamento da garra |
Estado geralmente aparece em par com Ação: Estado descreve "onde o robô está agora", e Ação descreve "para onde ir em seguida". Em conjuntos de dados LeRobot, eles são armazenados nos campos observation.state e action; no GR00T eles são ainda divididos via meta/modality.json em subchaves como single_arm e gripper.
A principal diferença entre VLA e políticas puramente visuais: a linguagem se torna uma variável de condicionamento. Durante o treinamento, cada trajetória de demonstração é vinculada a uma descrição de tarefa; na inferência, o usuário só precisa mudar o texto da instrução, sem alterar os pesos do modelo (dentro da cobertura dos dados).
18.3 Diferença Entre VLM e VLA
18.3 Diferença Entre VLM e VLA
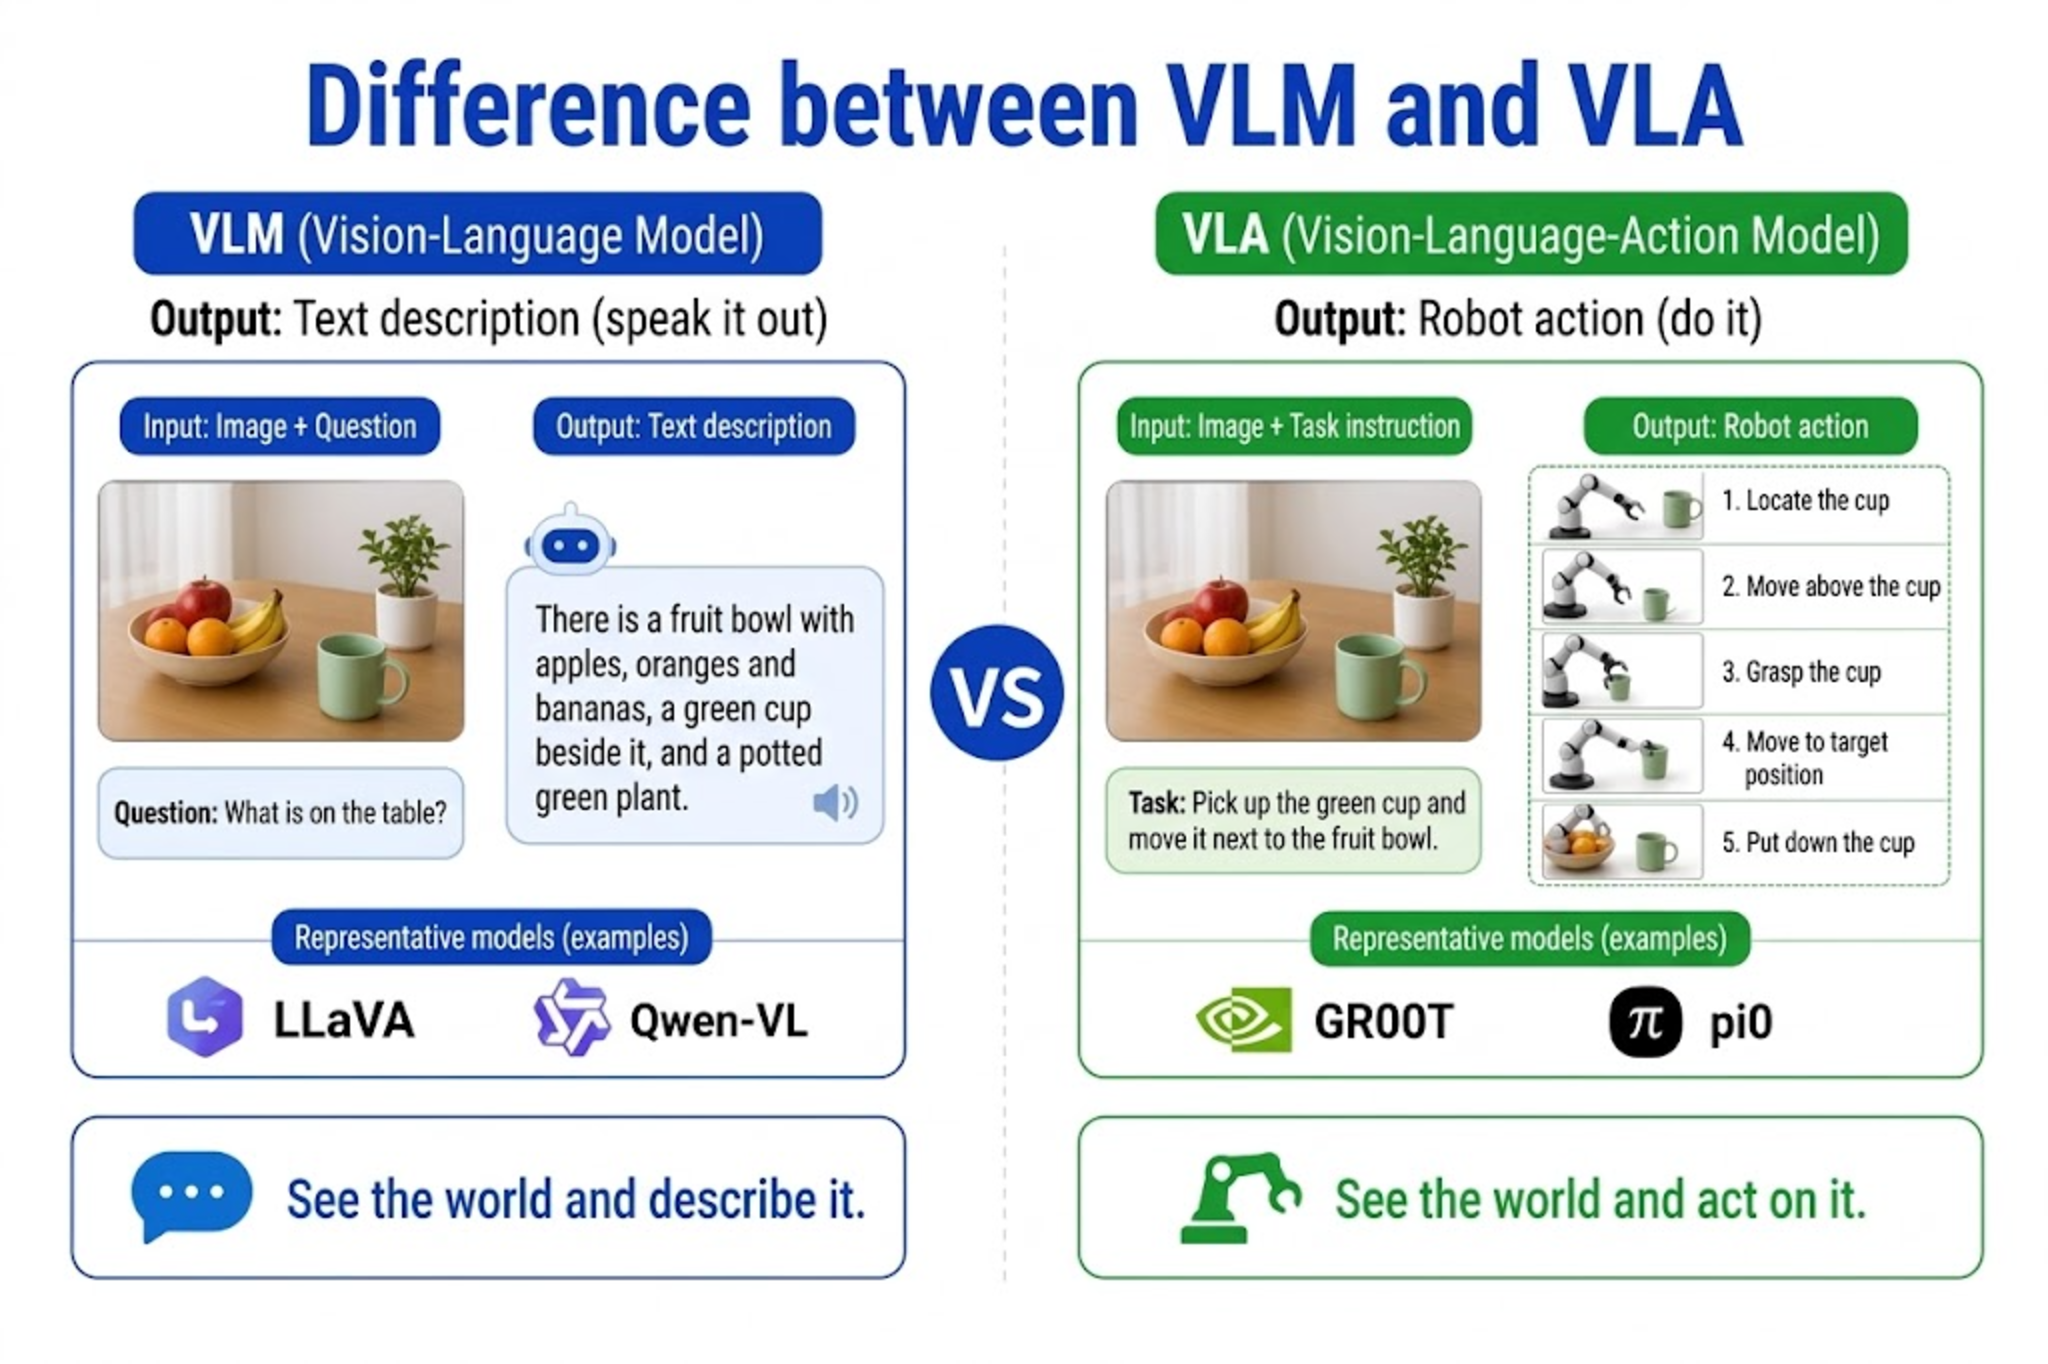
| Aspecto | VLM (Vision-Language Model) | VLA (Vision-Language-Action) |
|---|---|---|
| Saída | Texto, descrições, resultados de raciocínio | Sequência de ações do robô |
| Uso típico | Perguntas e respostas sobre imagens, compreensão de cena, legendagem | Pegar, colocar, abrir/fechar portas e outras manipulações |
| Modelos representativos | LLaVA, Qwen-VL, Cosmos-Reason2 | GR00T, pi0, OpenVLA |
| Relação com o robô | Pode auxiliar no planejamento, não aciona motores diretamente | Gera comandos de controle de ponta a ponta |
Pode-se entender de forma simples como: VLM é responsável por "entender o mundo e falar sobre ele", enquanto VLA é responsável por "entender o mundo e agir".
Isaac GR00T N1.7 reutiliza capacidades de VLM na arquitetura: seu backbone é o Cosmos-Reason2-2B (baseado na arquitetura Qwen3-VL, substituindo o backbone Eagle do N1.6), responsável por codificar imagens e linguagem, seguido por uma cabeça de ação Diffusion Transformer (DiT) que decodifica representações semânticas em blocos de ações contínuas. Portanto, o GR00T é ao mesmo tempo um VLA e incorpora fortes capacidades de representação de VLM.
18.4 Diferença Entre ACT e VLA
18.4 Diferença Entre ACT e VLA
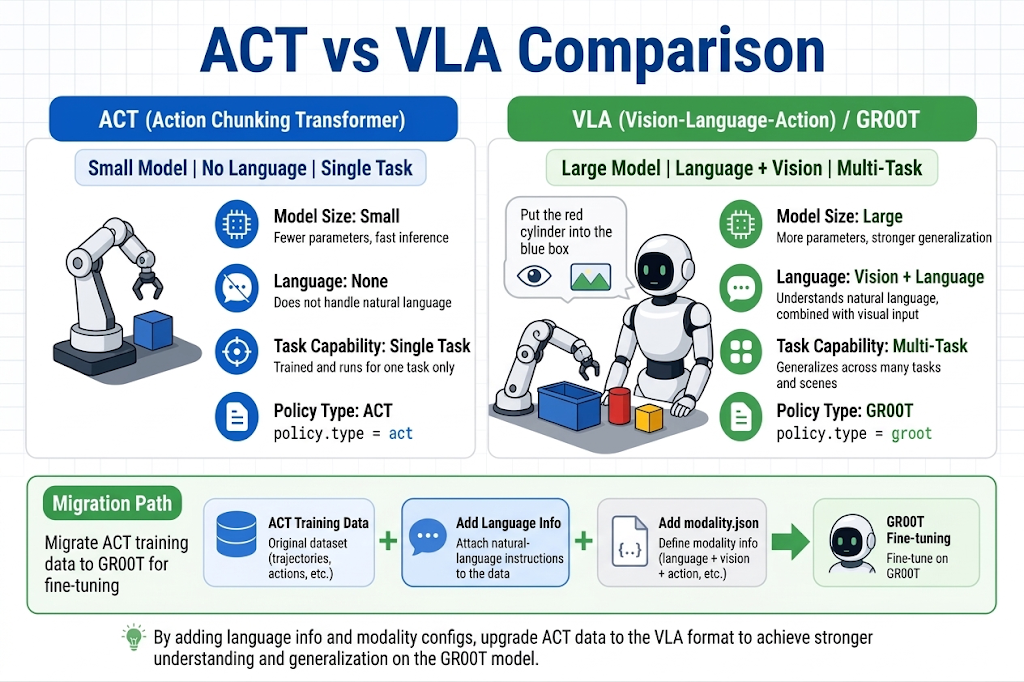
O ACT que você encontrou nos capítulos anteriores e o VLA deste capítulo pertencem ambos à família de aprendizado por imitação (Behavior Cloning), mas seus objetivos de projeto são diferentes:
| Aspecto | ACT | VLA (GR00T como exemplo) |
|---|---|---|
| Condição de tarefa | Geralmente sem linguagem, tarefa única implícita | Linguagem + visão, múltiplas tarefas explícitas |
| Tamanho do modelo | Menor (dezenas de milhões de parâmetros) | Maior (modelo base com bilhões de parâmetros) |
| Método de treinamento | Treinar do zero ou leve fine-tuning | Pré-treinamento de modelo base + fine-tuning em tarefas downstream |
| Representação de ação | Bloco de ação (action chunk) | Bloco de ação + denoising por Flow Matching |
| Generalização | Bom desempenho dentro da distribuição; retreinar ao trocar de tarefa | Condicionamento por linguagem suporta transferência zero/few-shot |
| Tipo de política no LeRobot | act | groot |
A técnica central do ACT é o Action Chunking: prever vários passos futuros de ação de uma vez para reduzir o erro acumulado da inferência passo a passo. O GR00T também prevê blocos de ações, mas o comprimento da janela varia por versão:
- N1.5 / N1.6:
action_horizon = 16 - N1.7:
action_horizonse expande de 16 para 40, e a dimensão máxima do espaço geral de estado/ação pré-treinado se expande de forma correspondente (o reBot na prática usa apenas 7 dimensões; as dimensões restantes são automaticamente preenchidas com zero) - Política
grootdo LeRobot: código-fonte usa por padrãochunk_size=50,n_action_steps=50
Este tutorial segue o exemplo oficial de fine-tuning do N1.7, usando chunk_size=40 durante o treinamento para alinhar com a janela de ação pré-treinada. Não fique preso em 16 — uma janela incompatível degrada os resultados do fine-tuning. action_horizon é gravado na cabeça de difusão durante o treinamento e não pode ser ampliado arbitrariamente na inferência.
Caminho de migração: se você já tem um conjunto de dados ACT para o reBot Arm (formato LeRobot v2), o Capítulo 20 exige apenas adicionar anotações de linguagem e configuração de Modalidade antes que ele possa ser usado para fine-tuning do GR00T, sem precisar recolher todas as demonstrações.
18.5 Tarefas de Robô Condicionadas por Linguagem
18.5 Tarefas de Robô Condicionadas por Linguagem
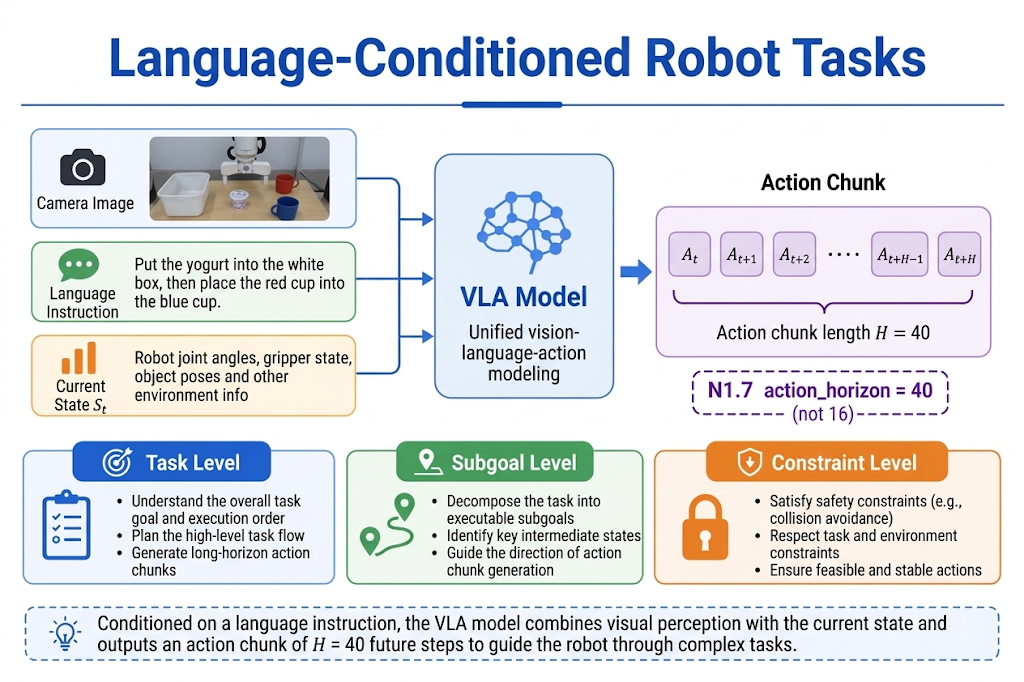
A forma padrão de uma tarefa condicionada por linguagem é:
Input: image I_t + language instruction L + current state S_t
Output: actions A_{t:t+H} (action chunk for the next H steps)
A granularidade da instrução pode variar:
- Nível de tarefa: "coloque o cubo vermelho na caixa azul" (uma frase compartilhada por toda a trajetória)
- Nível de subobjetivo: "primeiro aproxime-se do objeto" -> "depois feche a garra" (anotação segmentada, cenários avançados)
- Nível de restrição: "coloque suavemente", "evite obstáculos" (modifica como a ação é executada)
Em conjuntos de dados LeRobot, a linguagem geralmente é escrita no campo meta/tasks.jsonl ou annotation. O GR00T a lê por meio da chave annotation em modality.json; duas formas comuns são:
| Nome da chave | Conjuntos de dados típicos | Recomendação para reBot |
|---|---|---|
human.task_description | SO-100, cube_to_bowl e outras tarefas simples de mesa | Recomendado: consistente com o exemplo do Capítulo 20 |
human.action.task_description | LIBERO, SimplerEnv e outros benchmarks de simulação | Use apenas se seus dados vierem desses benchmarks |
Ambas as chaves são válidas, mas devem corresponder aos campos reais no conjunto de dados; não as misture entre treinamento e inferência.
Recomendações práticas (reBot Arm):
- Ao gravar cada demonstração, descreva a tarefa em uma frase curta, começando com verbo, em chinês ou inglês.
- Mantenha a formulação consistente para tarefas semelhantes, por exemplo, use de forma uniforme "coloque X em Y".
- Evite que um único ponto de dado corresponda a múltiplas formulações; quanto mais consistente, melhor nos estágios iniciais de fine-tuning.
18.6 Tarefa Única, Múltiplas Tarefas e Generalização
18.6 Tarefa Única, Múltiplas Tarefas e Generalização
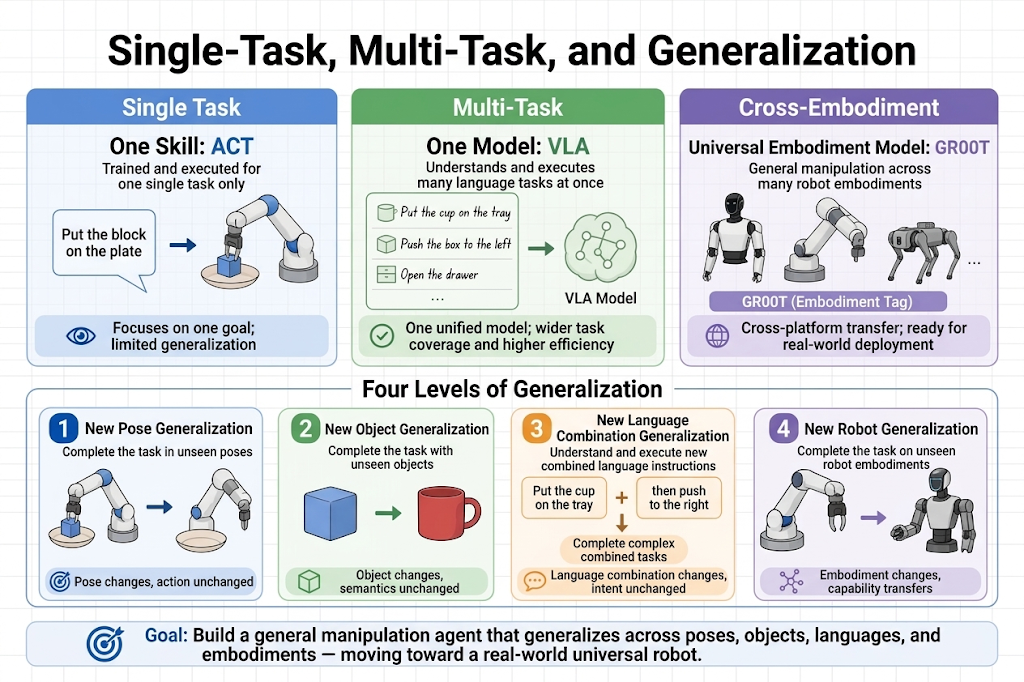
| Paradigma de treinamento | Descrição | Cenários adequados |
|---|---|---|
| Tarefa única | Aprende apenas uma habilidade | Padrão do ACT; poucos dados, objetivo claro |
| Multitarefa | O mesmo modelo aprende múltiplas habilidades, diferenciadas por linguagem | Fine-tuning de VLA; organização de mesa, classificação etc. |
| Generalização entre corpos | Diferentes robôs compartilham um modelo de base | Pré-treinamento do GR00T; adaptado via embodiment_tag |
"Generalização" em VLAs tem vários níveis — não os confunda:
- Mesma tarefa, nova pose inicial: ainda consegue agarrar quando a posição do cubo muda — o ACT geralmente também consegue fazer isso.
- Novos objetos, novos recipientes: depende de generalização visual — requer diversidade suficiente nos dados de treinamento.
- Novas combinações de instruções em linguagem: "coloque A em B" nunca visto antes, mas o padrão da frase é familiar — a vantagem de condicionamento por linguagem do VLA.
- Novo corpo de robô: ainda utilizável ao trocar de braço — requer a camada de projeção de embodiment do GR00T mais uma pequena quantidade de dados de fine-tuning.
Para usuários do reBot Arm, a expectativa realista é: após o fine-tuning, você pode alternar entre as múltiplas tarefas em linguagem já coletadas; para objetos totalmente novos ou padrões de frase totalmente novos, ainda são necessários dados adicionais de demonstração.
18.7 Ações Contínuas e Tokens de Ação
18.7 Ações Contínuas e Tokens de Ação
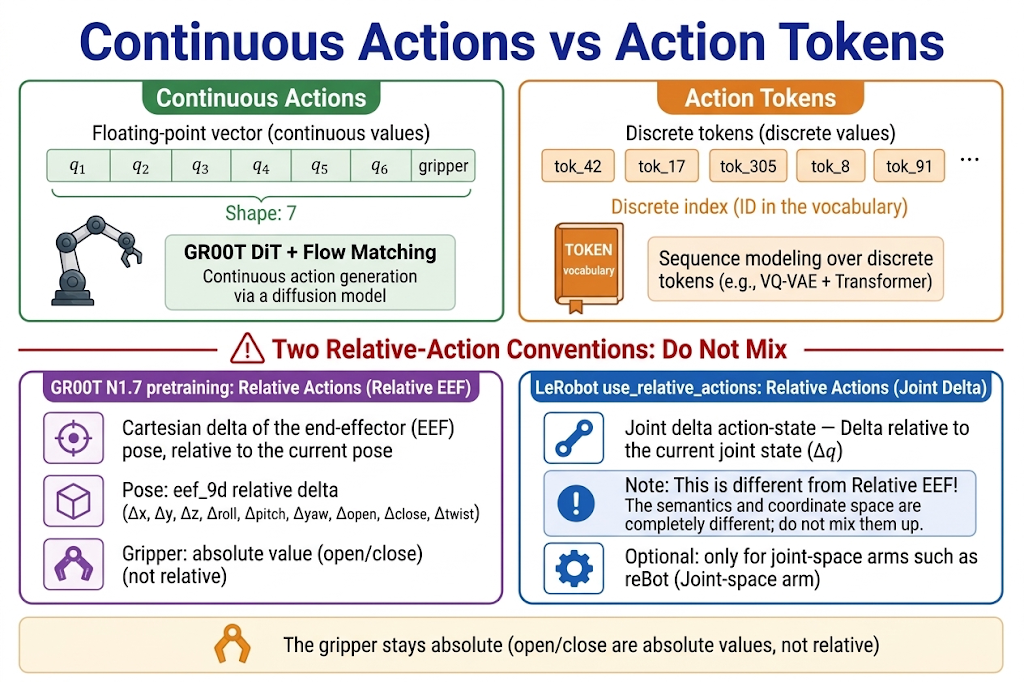
Existem duas representações principais para comandos de controle de robô:
Ações Contínuas
Produz diretamente um vetor de ponto flutuante, por exemplo, 6 ângulos de junta + 1 valor de abrir/fechar do gripper:
action = [q1, q2, q3, q4, q5, q6, gripper] # shape: (7,)
- Vantagem: alta precisão, consistente com a interface real do motor.
- Desvantagem: regressão em espaço de alta dimensão é difícil.
- GR00T usa: DiT + Flow Matching para remover ruído em espaço contínuo, produzindo blocos de ação.
Tokens de Ação (Ações Discretizadas)
Quantiza valores contínuos em símbolos discretos, como um modelo de linguagem prevendo o próximo token:
action_tokens = [tok_42, tok_17, tok_89, ...]
- Vantagem: pode reutilizar arquiteturas LLM autorregressivas; adotado por alguns VLAs como o pi0-FAST.
- Desvantagem: perda por quantização, design de vocabulário complexo.
Ações relativas vs. absolutas:
- O núcleo do pré-treinamento do GR00T N1.7 é o espaço de ação Relative EEF (end-effector relativo): as ações são representadas como incrementos cartesianos relativos à pose atual do end-effector, em vez de incrementos de ângulo de junta. Incrementos do end-effector têm semântica mais consistente entre diferentes robôs (até mesmo vídeo humano), o que é fundamental para a generalização entre corpos do N1.7. O código oficial configura isso por grupo de ação:
eef_9dusa end-effector relativo,joint_positionusa junta relativa, egripper_positionpermanece absoluto. - O
--policy.use_relative_actions=truedo LeRobot é uma chave em nível de framework: aplica uma transformação relativa deaction - stateàs dimensões de junta. Isso não é o mesmo que o Relative EEF do artigo, nem é "a recomendação padrão do N1.7." Quando o reBot Arm roda em espaço de juntas (NON_EEF), essa chave é apenas uma etapa opcional de pré-processamento do LeRobot; não a descreva como "consistente com o design de pré-treinamento do GR00T." - Quantidades que não são de junta, como o gripper, comumente usam
relative_exclude_jointspara manter o controle absoluto. Trajetórias relativas de junta são mais suaves, mas a execução de longo prazo pode derivar.
18.8 Capacidades e Limitações do VLA
18.8 Capacidades e Limitações do VLA
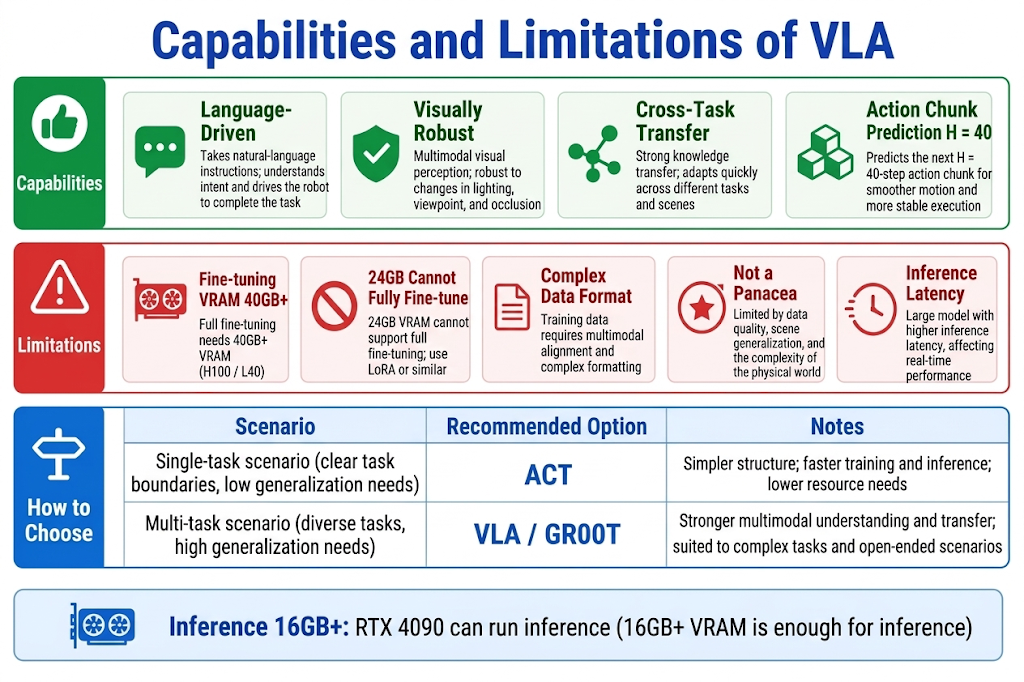
Capacidades
- Guiado por linguagem: um modelo, muitas tarefas; altere o comportamento mudando a instrução.
- Robustez visual: pré-treinamento em larga escala traz melhor compreensão de cena do que um ACT pequeno.
- Transferência entre tarefas: representações podem ser compartilhadas entre padrões de frase semelhantes e objetos semelhantes.
- Predição de blocos de ação: uma inferência produz múltiplos passos, adequado para controle em tempo real (com política de inferência RTC).
Limitações
- Alta demanda computacional: N1.7-3B recomenda 40 GB+ de VRAM para fine-tuning (H100 / L40; treinar apenas o projetor + cabeça DiT atinge pico em torno de 35 GB; o tutorial oficial de fine-tuning em simulação requer ≥ 48 GB). Inferência precisa de apenas 16 GB+ (uma RTX 4090 consegue rodar a inferência). Fine-tuning completo em uma placa de 24 GB é basicamente inviável, a menos que se use fine-tuning eficiente como LoRA / PEFT.
- Formato de dados mais complexo: além dos campos padrão do LeRobot, são necessários um
modality.jsone uma tag de embodiment. - Não é uma panaceia: objetos, instruções e layouts de estação de trabalho não cobertos pelo conjunto de treinamento ainda podem falhar.
- Latência: a inferência de modelos grandes é mais lenta que ACT; configure
n_action_stepse parâmetros de RTC adequadamente. - Gap sim-para-real: os dados de pré-treinamento são dominados por plataformas humanoides/específicas; braços de mesa exigem fine-tuning suficiente.
Quando Escolher ACT, Quando Escolher VLA?
| Cenário | Recomendação |
|---|---|
| Tarefa repetitiva única, dispositivo de borda, baixa latência | ACT |
| Multitarefa, interação em linguagem, disposto a investir em GPU e anotação | VLA / GR00T |
| Já possui dados de ACT, quer expandir para multitarefa | Adicionar linguagem aos dados LeRobot existentes -> fine-tuning do GR00T |
18.9 Resumo do Capítulo
18.9 Resumo do Capítulo
- Modelos multimodais fundem visão, linguagem e estado em decisões unificadas.
- VLA adiciona saída de ação em cima de VLM, suportando manipulação condicionada por linguagem.
- ACT é uma solução leve de tarefa única; GR00T é uma solução VLA de pré-treinamento em larga escala + fine-tuning.
- O pré-treinamento N1.7 usa Relative EEF e
action_horizon=40; ações relativas de junta no LeRobot são uma etapa opcional de pré-processamento separada — não confunda as duas. - O próximo capítulo apresenta como aplicar o VLA geral neste corpo específico, o reBot Arm.