19. Corporificação de Robôs e Arquitetura do Sistema GR00T
Capítulo 19 do Curso para Iniciantes em IA Física da Seeed — o que é uma corporificação, definições de juntas/estado/ação, modalidades de câmera e linguagem, as janelas de observação e ação, ajuste fino do modelo base, a pilha LeRobot e a posição do reBot Arm no GR00T.
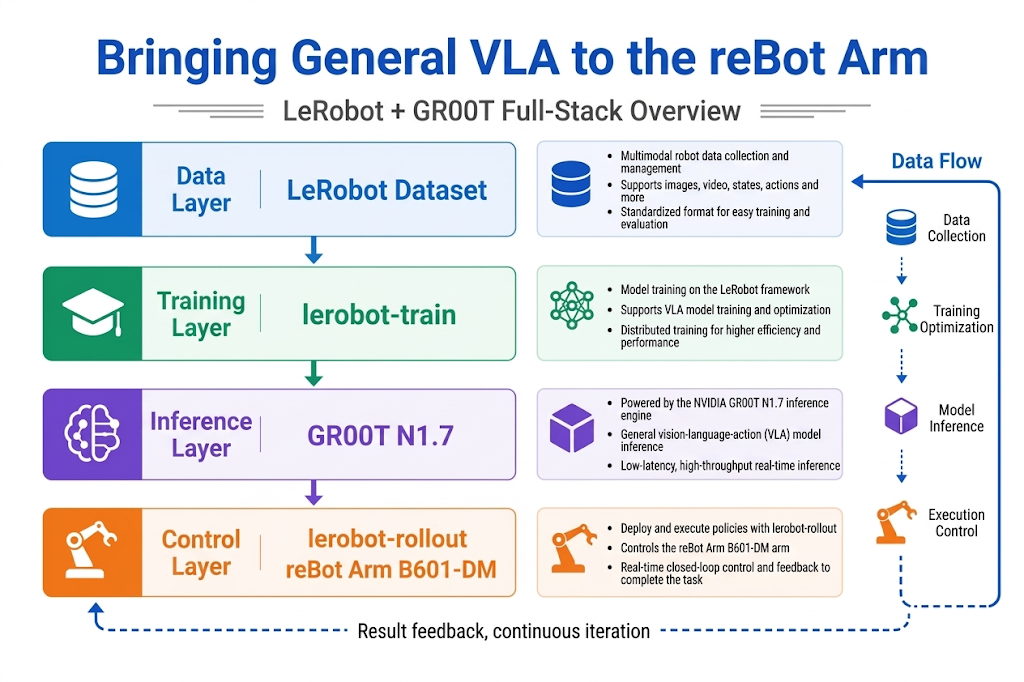
GR00T é um modelo base multi‑corpos: ele é pré-treinado em múltiplos conjuntos de dados de robôs e distingue diferentes hardwares por meio de Embodiment Tags e configuração de modalidades. Este capítulo explica onde o reBot Arm se encaixa na pilha LeRobot + GR00T e como os componentes colaboram no momento da inferência.
19.1 O que é a Corporificação de um Robô?
19.1 O que é a Corporificação de um Robô?
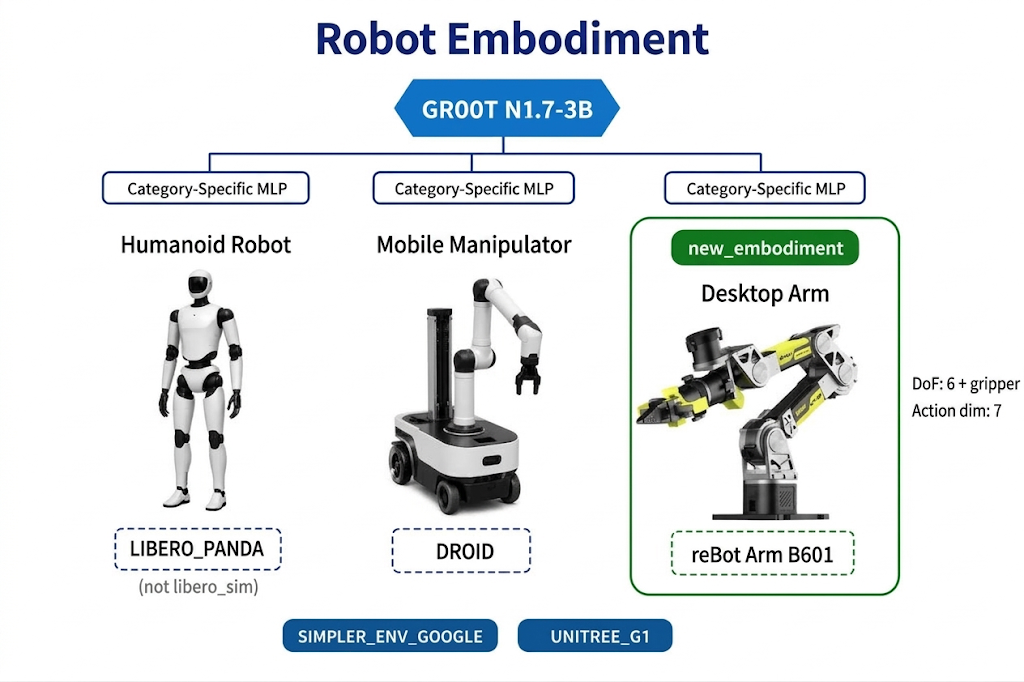
Corporificação descreve a "identidade física e de controle" de um robô, incluindo:
- Número de graus de liberdade (DoF) e ordenação das juntas
- Limites das juntas, relações de engrenagem, modo de controle (posição/torque)
- Número de câmeras, posições de montagem e resolução
- Definição do espaço de ação (espaço de juntas vs. espaço cartesiano do efetuador final)
- Tipo de garra e faixa de abertura/fechamento
O mesmo modelo base GR00T não pode aplicar diretamente o vetor de juntas de 6 dimensões do SO-101 ao reBot Arm. Internamente, o modelo usa um MLP específico por categoria (camada de projeção por corporificação) para mapear estado/ação de diferentes dimensões para um espaço latente compartilhado e, em seguida, mapear de volta para as dimensões de ação de cada corporificação.
No LeRobot / GR00T, a corporificação é especificada via embodiment_tag. As tags oficiais de pré-treinamento (EmbodimentTag) incluem:
LIBERO_PANDA,DROID,SIMPLER_ENV_GOOGLE,UNITREE_G1,OXE_WIDOWX, etc.- Novo hardware:
new_embodiment/NEW_EMBODIMENT(usado ao ajustar finamente o reBot Arm).
Não existe uma tag oficial chamada libero_sim. Não aplique tags de pré-treinamento a dados do reBot.
--policy.embodiment_tag=new_embodiment
Isso informa ao GR00T: os dados atuais vêm de um novo robô não visto durante o treinamento; use a camada de projeção de nova corporificação para o ajuste fino.
19.2 Definições de Juntas, Estado e Ação do Robô
19.2 Definições de Juntas, Estado e Ação do Robô
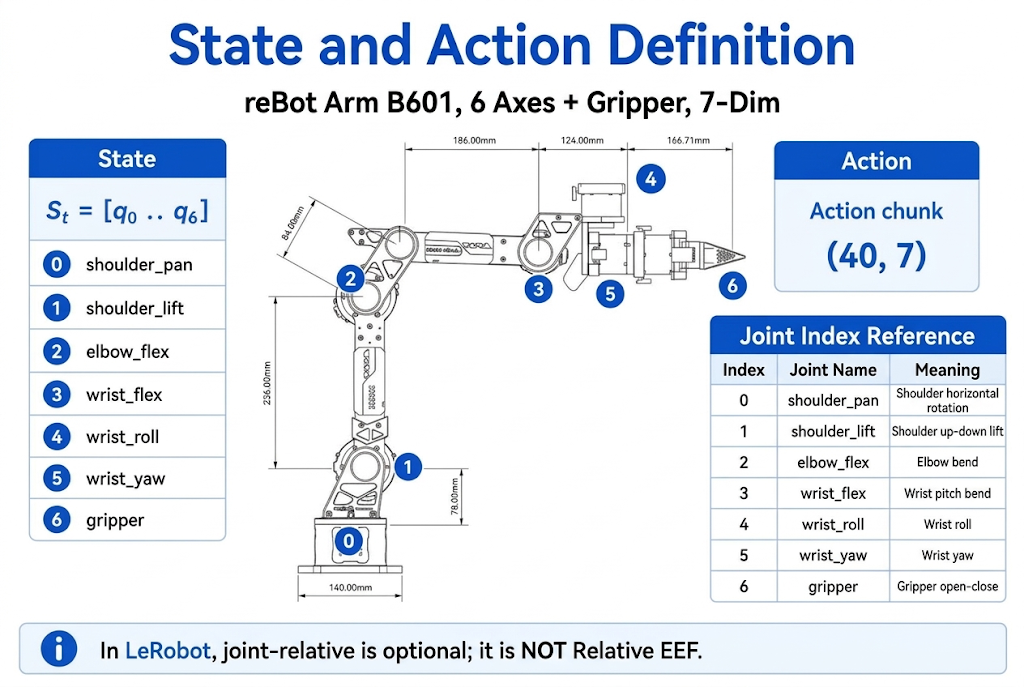
Tomando o reBot Arm B601 (6 eixos + garra) como exemplo:
Juntas e Estado
Estado (estado de observação) é uma das entradas da política, representando a configuração atual do robô:
observation.state = [q1, q2, q3, q4, q5, q6, gripper_pos]
                     └──────── 6 joint angles ─────┘  └ gripper ┘
- Unidade: ângulos de junta geralmente são radianos (rad) ou graus (deg); devem ser consistentes dentro do conjunto de dados.
- Ordem: deve ser exatamente consistente com o script de gravação,
modality.jsone o cliente de inferência. - Em
meta/modality.json, pode ser dividido em:state.single_arm-> índices 0-5state.gripper-> índice 6
Ação
Ação é a saída da política, executada pelo controlador de baixo nível:
action = [target_q1, ..., target_q6, target_gripper]
GR00T N1.7 gera um bloco de ações de H passos por vez (pré-treinado com action_horizon=40; o groot do LeRobot usa por padrão chunk_size=50). Este tutorial alinha o treinamento com o N1.7, usando H=40:
action_chunk.shape = (40, 7) # 40 steps x 7 dimensions
O laço de controle geralmente pega uma linha do bloco e a envia para o motor a cada passo ou a cada k passos; o rollout do LeRobot usa n_action_steps para controlar quantos passos são executados por inferência.
19.3 Modalidade de Câmera
19.3 Modalidade de Câmera
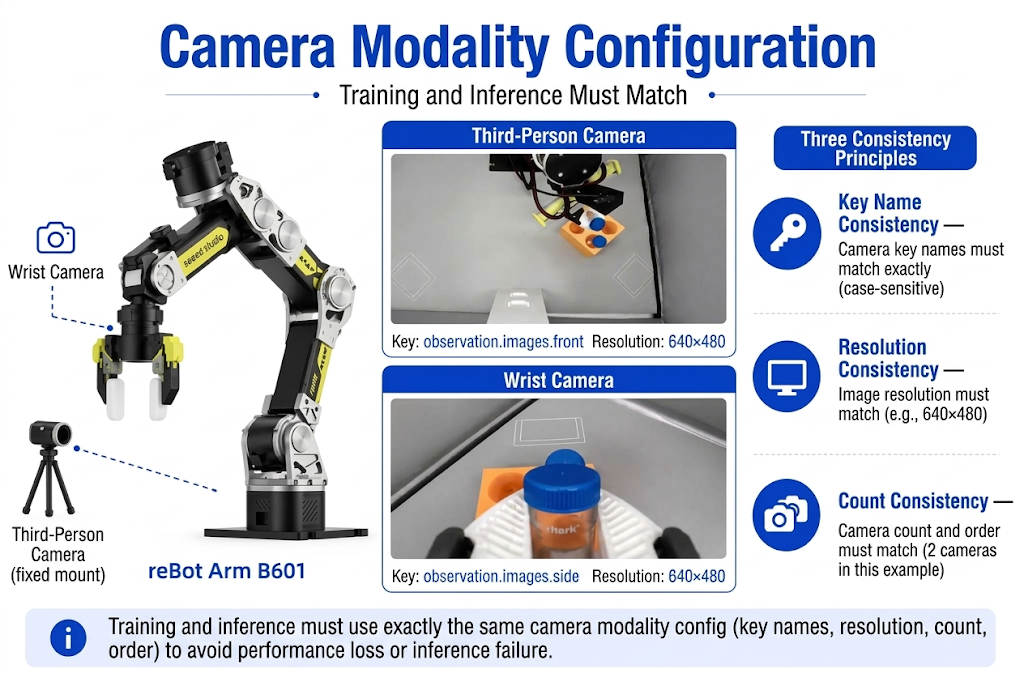
GR00T usa visão como principal, linguagem como auxiliar e estado como complementar. A configuração da câmera deve estar estritamente alinhada com os dados de treinamento.
Layouts de câmera comuns (reBot Arm)
| Nome da chave (exemplo) | Posição | Finalidade |
|---|---|---|
front | Câmera de grande angular montada no suporte | Cena global, localização do objeto alvo |
side / wrist | Câmera de pulso | Mira em close, cenas ocluídas |
Em conjuntos de dados LeRobot, os vídeos são armazenados como observation.images.<camera_name>; no campo video de meta/modality.json, a resolução e o índice de cada câmera são declarados.
Observações
- Nomes de chave de câmera, quantidade e resolução devem ser idênticos entre treinamento e inferência.
- O backbone do GR00T suporta proporções nativas, mas é recomendado unificar para 640x480 ou para a resolução acordada do conjunto de dados.
- Durante o ajuste fino, ative
dataset.image_transforms(variação de brilho, contraste) para melhorar a robustez. - Encontre o índice local da câmera com
lerobot-find-cameras opencv.
19.4 Modalidade de Linguagem
19.4 Modalidade de Linguagem
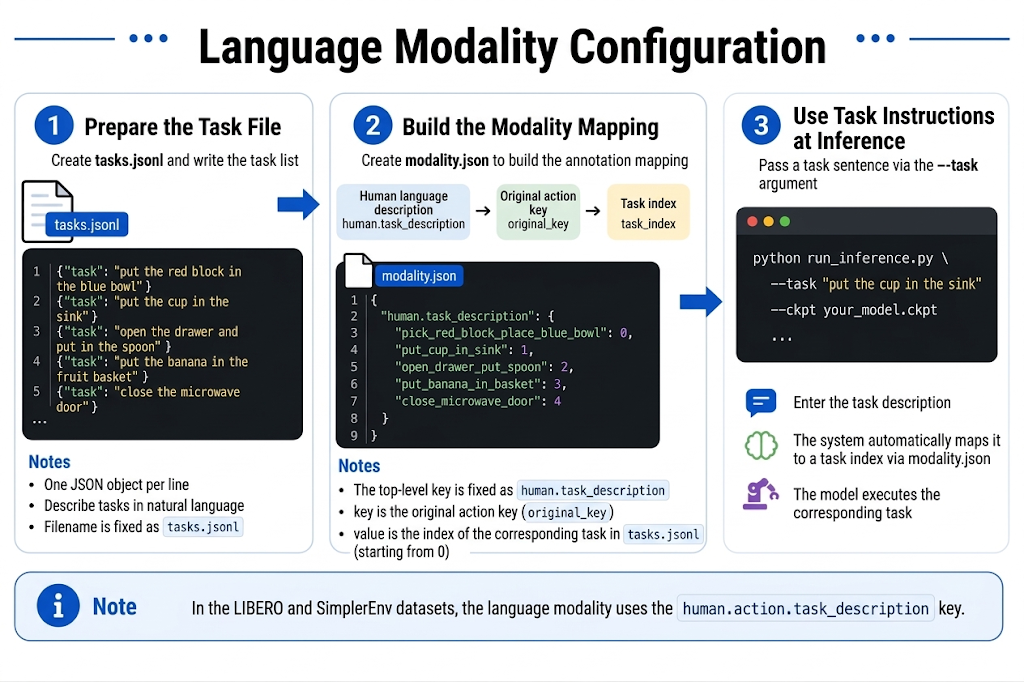
No pipeline do GR00T, a linguagem atua como uma entrada de condicionamento, alimentada no backbone VLM junto com os tokens de imagem.
Lado dos dados
- LeRobot:
meta/tasks.jsonlou anotação em nível de episódio - Extensão GR00T:
meta/modality.json-> campoannotation
Exemplo de trecho de modality.json (tarefas de desktop do reBot usam human.task_description):
{
  "annotation": {
    "human.task_description": {
      "original_key": "task_index"
    }
  }
}
Se os dados vierem de LIBERO / SimplerEnv, use human.action.task_description em vez disso. O nome da chave deve corresponder ao modality.json completo do Capítulo 20.
Lado da inferência
Ao executar lerobot-rollout, passe via --task:
--task="place the red cube on the blue tray"
Essa string é codificada e alimentada no modelo junto com a imagem e o estado atuais. Use um estilo de linguagem e padrão de frase semelhantes aos dos dados de treinamento.
19.5 Janela de Observação e Janela de Ação
19.5 Janela de Observação e Janela de Ação
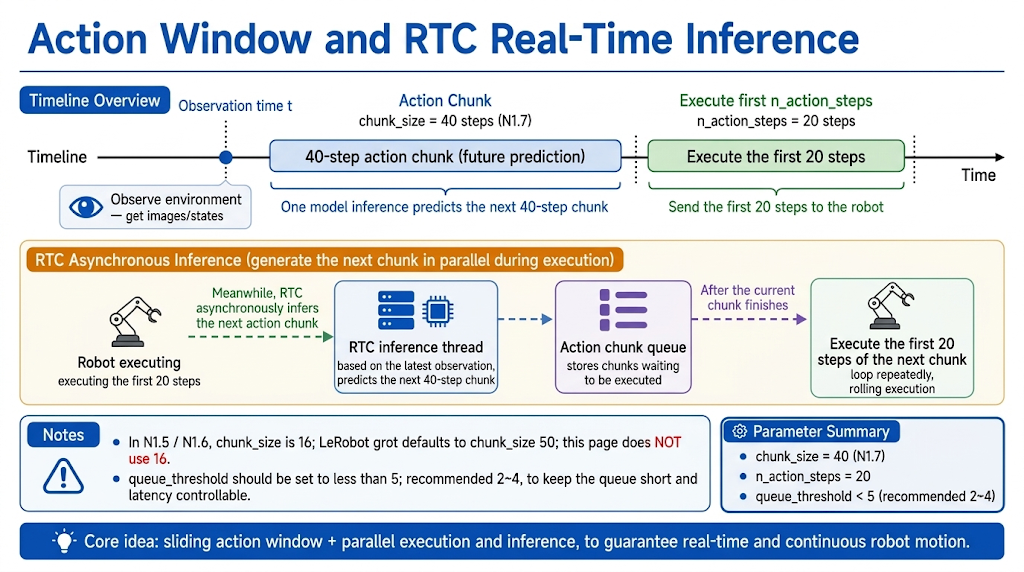
A inferência VLA não é "olhar um quadro, gerar uma ação"; ela envolve um desenho de amostragem na dimensão temporal:
Time axis ─────────────────────────────────────────────►

Observation window:  [t-k ... t-1, t]     ← historical image frames (optional)
State:              S_t
Language:           L
Action prediction window:    [A_t, A_{t+1}, ... A_{t+H-1}]
                              └── H = chunk_size / action_horizon
| Parâmetro | Valor típico (N1.7) | Significado |
|---|---|---|
chunk_size / action_horizon | 40 (alinhado com N1.7; o código-fonte groot do LeRobot usa por padrão 50; N1.5/N1.6 é 16) | Número de passos de ação previstos por inferência |
n_action_steps | 8-40 | Passos realmente executados por inferência, deve ser ≤ chunk_size |
n_obs_steps | 1 | Quantos quadros históricos de imagem usar |
RTC (Real-Time Chunking): quando o tempo de inferência se aproxima do período de controle, o LeRobot oferece suporte à política RTC, que calcula de forma assíncrona o próximo bloco enquanto executa o atual, reduzindo pausas. No rollout, ative via --inference.type=rtc; queue_threshold indica quantos passos restam na fila de ações antes de disparar uma nova inferência, recomendado entre 2-5; defini-lo como 0 faz com que a reinferência ocorra toda vez, o que tende a aumentar o tremor.
19.6 Modelo Base e Ajuste Fino
19.6 Modelo Base e Ajuste Fino
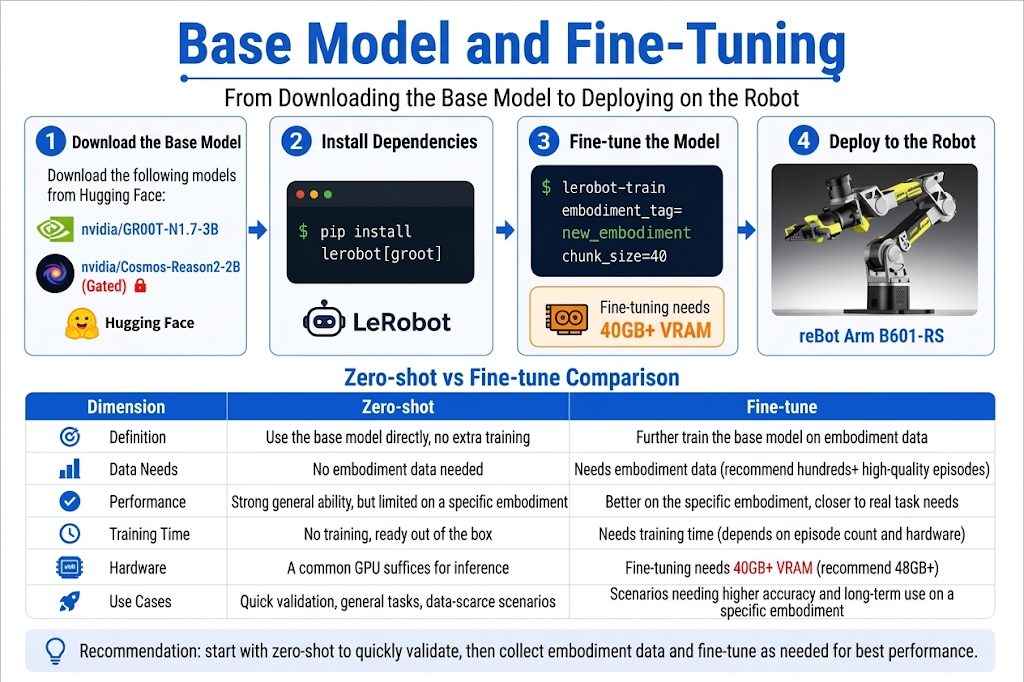
Modelo Base
NVIDIA GR00T N1.7-3B é pré-treinado em dados de múltiplas corporificações em larga escala e possui capacidades gerais de visão-linguagem-ação. Ele pode ser obtido via Hugging Face:
nvidia/GR00T-N1.7-3B
LeRobot instala o suporte a GR00T:
pip install "lerobot[groot]"
# or from source:
pip install -e ".[groot]"
Consulte a documentação de instalação do LeRobot para mais detalhes.
Fine-Tuning
O fluxo de trabalho típico no reBot Arm:
- Prepare o dataset LeRobot v2 +
meta/modality.json(Capítulo 20). - Especifique
embodiment_tag=new_embodiment. - Inicie o treinamento com
lerobot-train --policy.type=groot(Capítulo 21). - Envie o checkpoint para o Hugging Face Hub ou salve-o localmente em
outputs/.
Durante o fine-tuning:
- O backbone VLM é o Cosmos-Reason2-2B; o fine-tuning padrão geralmente congela o LLM e foca em treinar o projetor + cabeça DiT (pico em torno de 35 GB).
- A cabeça de ação DiT e a camada de projeção de embodiment se adaptam às dimensões de estado/ação do reBot.
- Recomendação de volume de dados: pelo menos 50 demonstrações bem-sucedidas por tarefa, e mais para multi-tarefa.
- VRAM: 40 GB+ para fine-tuning; para placas de 24 GB use LoRA/PEFT, ou execute apenas inferência.
Zero-Shot vs. Fine-Tuning
| Método | Descrição |
|---|---|
| Zero-shot | Use GR00T-N1.7-3B diretamente; pode funcionar apenas quando a tarefa é extremamente semelhante a um embodiment pré-treinado |
| Fine-tuning | O caminho recomendado para o reBot Arm; uma pequena quantidade de dados de manipulação em desktop melhora significativamente a taxa de sucesso |
19.7 Arquitetura do Sistema GR00T (Pilha LeRobot)
19.7 Arquitetura do Sistema GR00T (Pilha LeRobot)
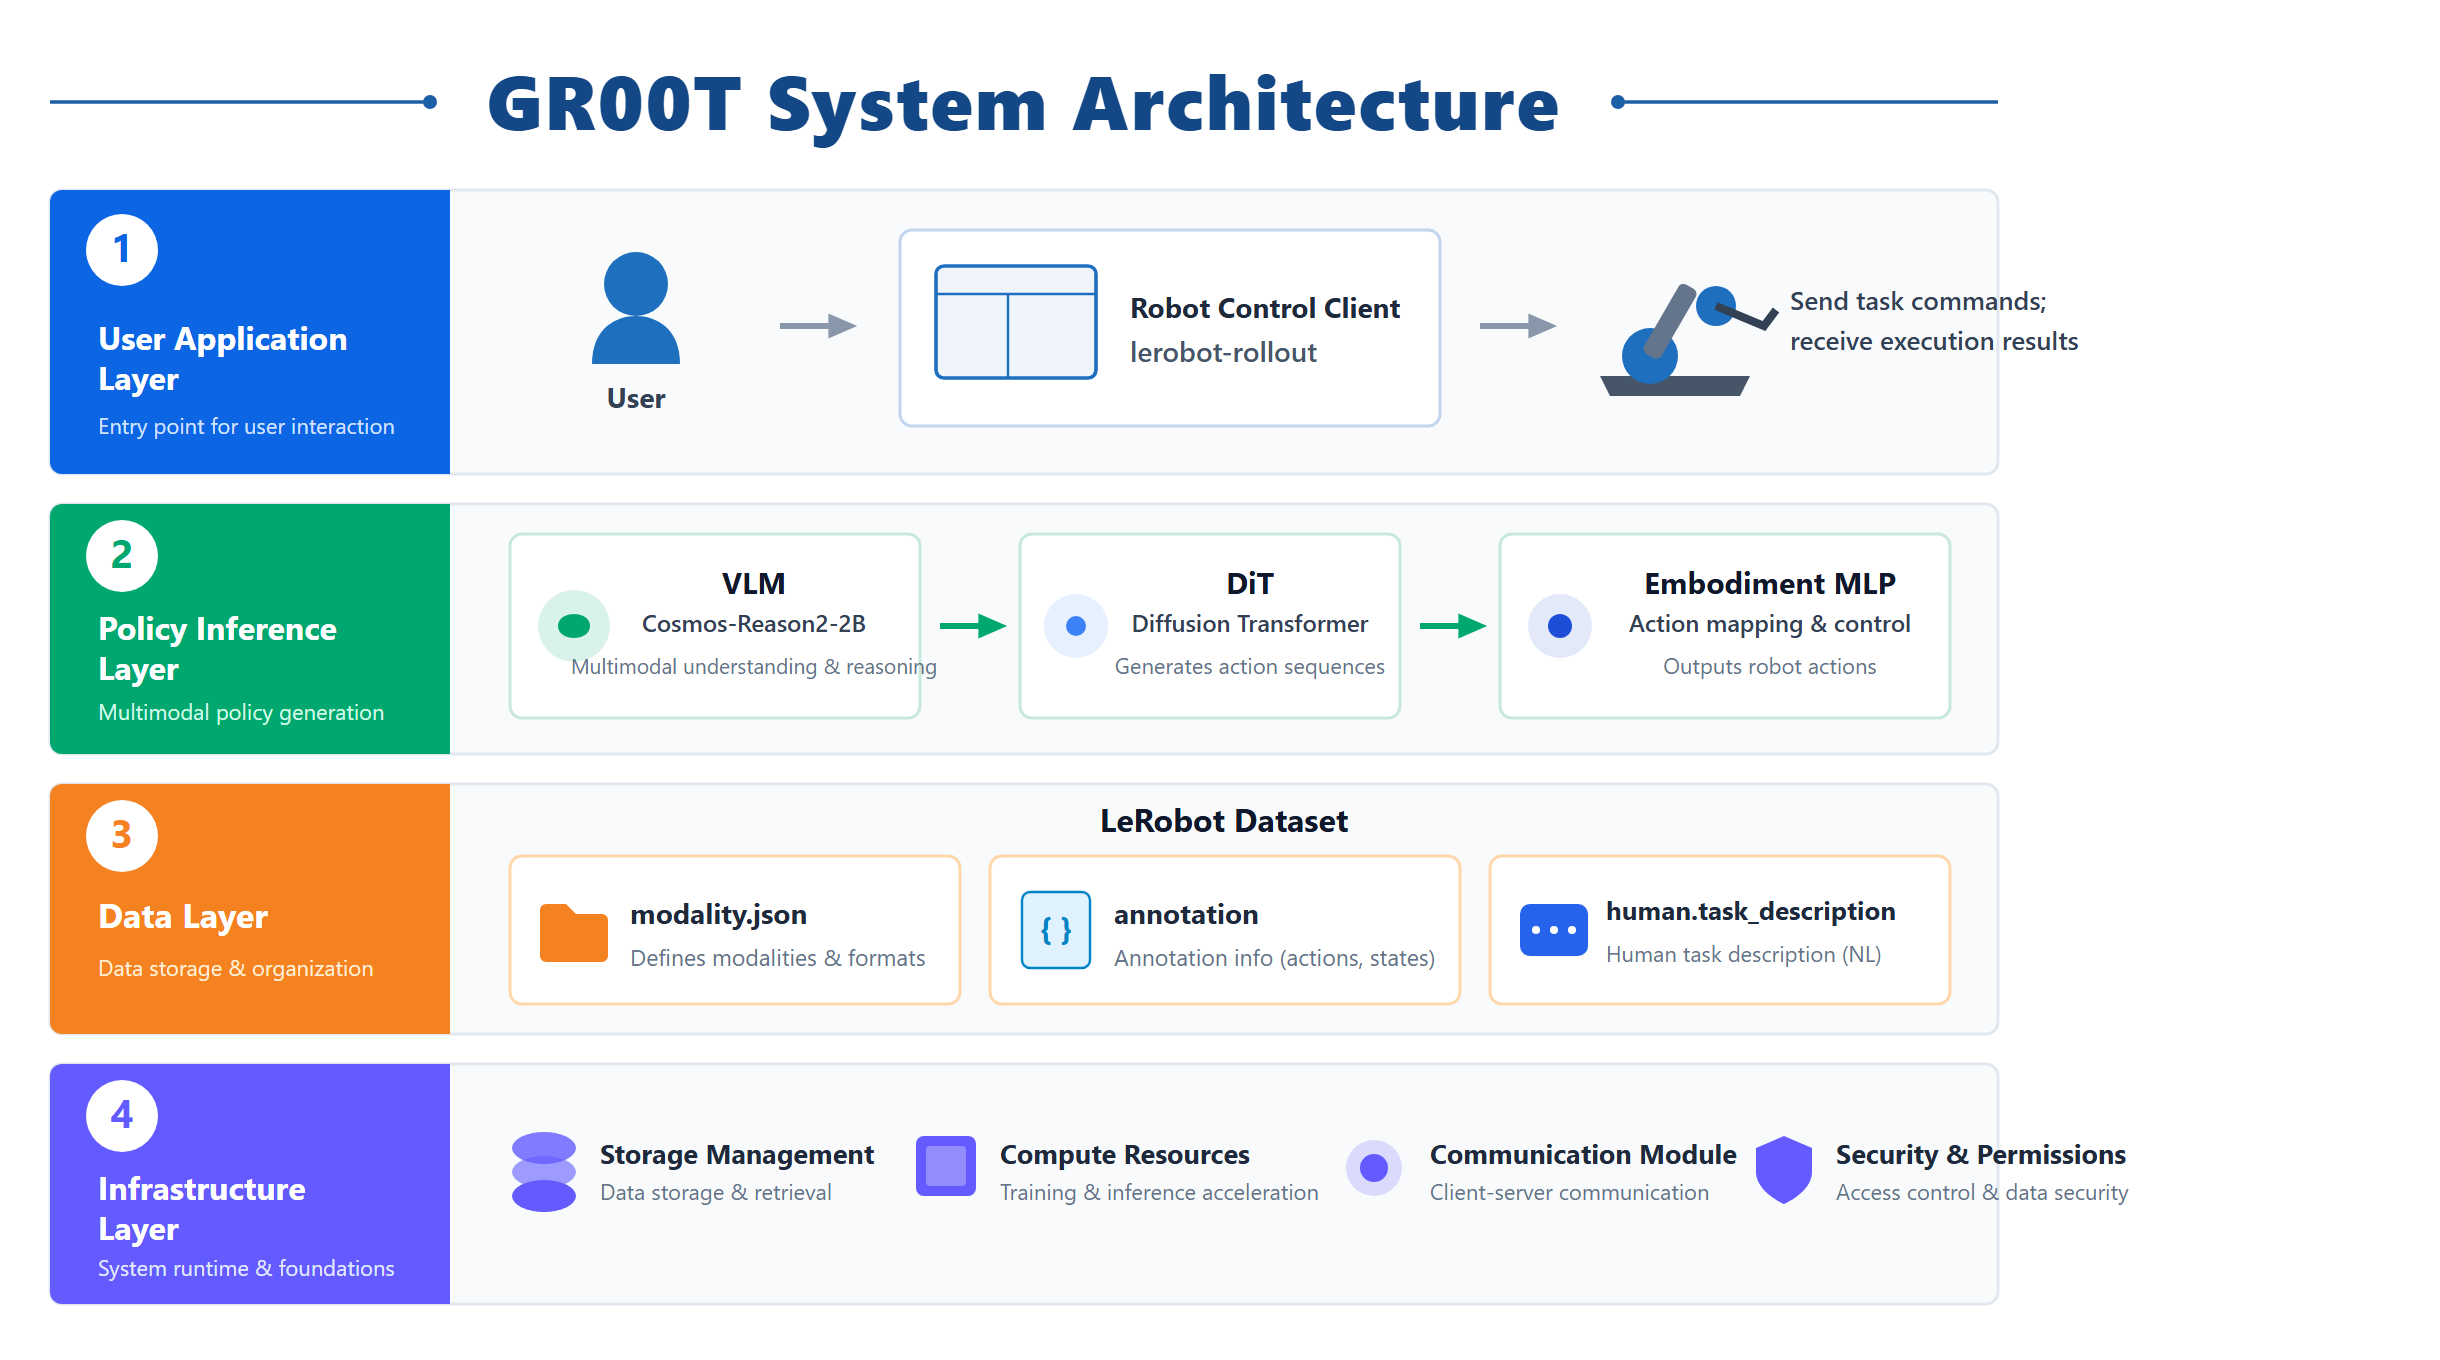
O sistema reBot GR00T baseado em LeRobot pode ser dividido em quatro camadas:
┌────────────────────────────────────────────────────────────┐
│                    User / Application Layer                 │
│         Natural language task  +  start rollout / teach UI  │
└────────────────────────────┬───────────────────────────────┘
                             │
┌────────────────────────────▼───────────────────────────────┐
│              Robot Control Client (LeRobot Rollout)         │
│  - Capture camera images, read joint state                  │
│  - Send observation to policy, receive action chunk        │
│  - Execute actions via reBot driver (serial/CAN)            │
│  lerobot-rollout --policy.type=groot --robot.type=...      │
└────────────────────────────┬───────────────────────────────┘
                             │ observation / action
┌────────────────────────────▼───────────────────────────────┐
│              Policy Inference (GR00T N1.7)                 │
│  ┌──────────────┐  ┌─────────────┐  ┌──────────────────┐ │
│  │ VLM Backbone │→ │  DiT Head   │→ │ Embodiment MLP   │ │
│  │ Cosmos-Reason2-2B │  │ Flow Match  │  │ decode to 7-DoF  │ │
│  └──────────────┘  └─────────────┘  └──────────────────┘ │
│  Can be in the same process as rollout, or split into a     │
│  separate GPU inference service (advanced deployment)       │
└────────────────────────────┬───────────────────────────────┘
                             │
┌────────────────────────────▼───────────────────────────────┐
│              Data and Training Layer (LeRobot Dataset v2)   │
│  episodes / videos / meta/modality.json / tasks.jsonl      │
│  lerobot-train / lerobot-record / lerobot-replay           │
└────────────────────────────────────────────────────────────┘
Fluxo de dados interno do modelo (simplificado)
- Imagem -> codificador visual VLM -> tokens visuais
- Instrução em linguagem -> tokenizador de texto -> tokens de linguagem
- Estado -> MLP de codificação de embodiment -> tokens de estado
- Fusão de tokens multimodais -> DiT denoising iterativo -> variáveis latentes de ação
- MLP de decodificação de embodiment ->
action_chunk (H x action_dim)
19.8 Servidor de Inferência GR00T e Cliente de Controle do Robô
19.8 Servidor de Inferência GR00T e Cliente de Controle do Robô
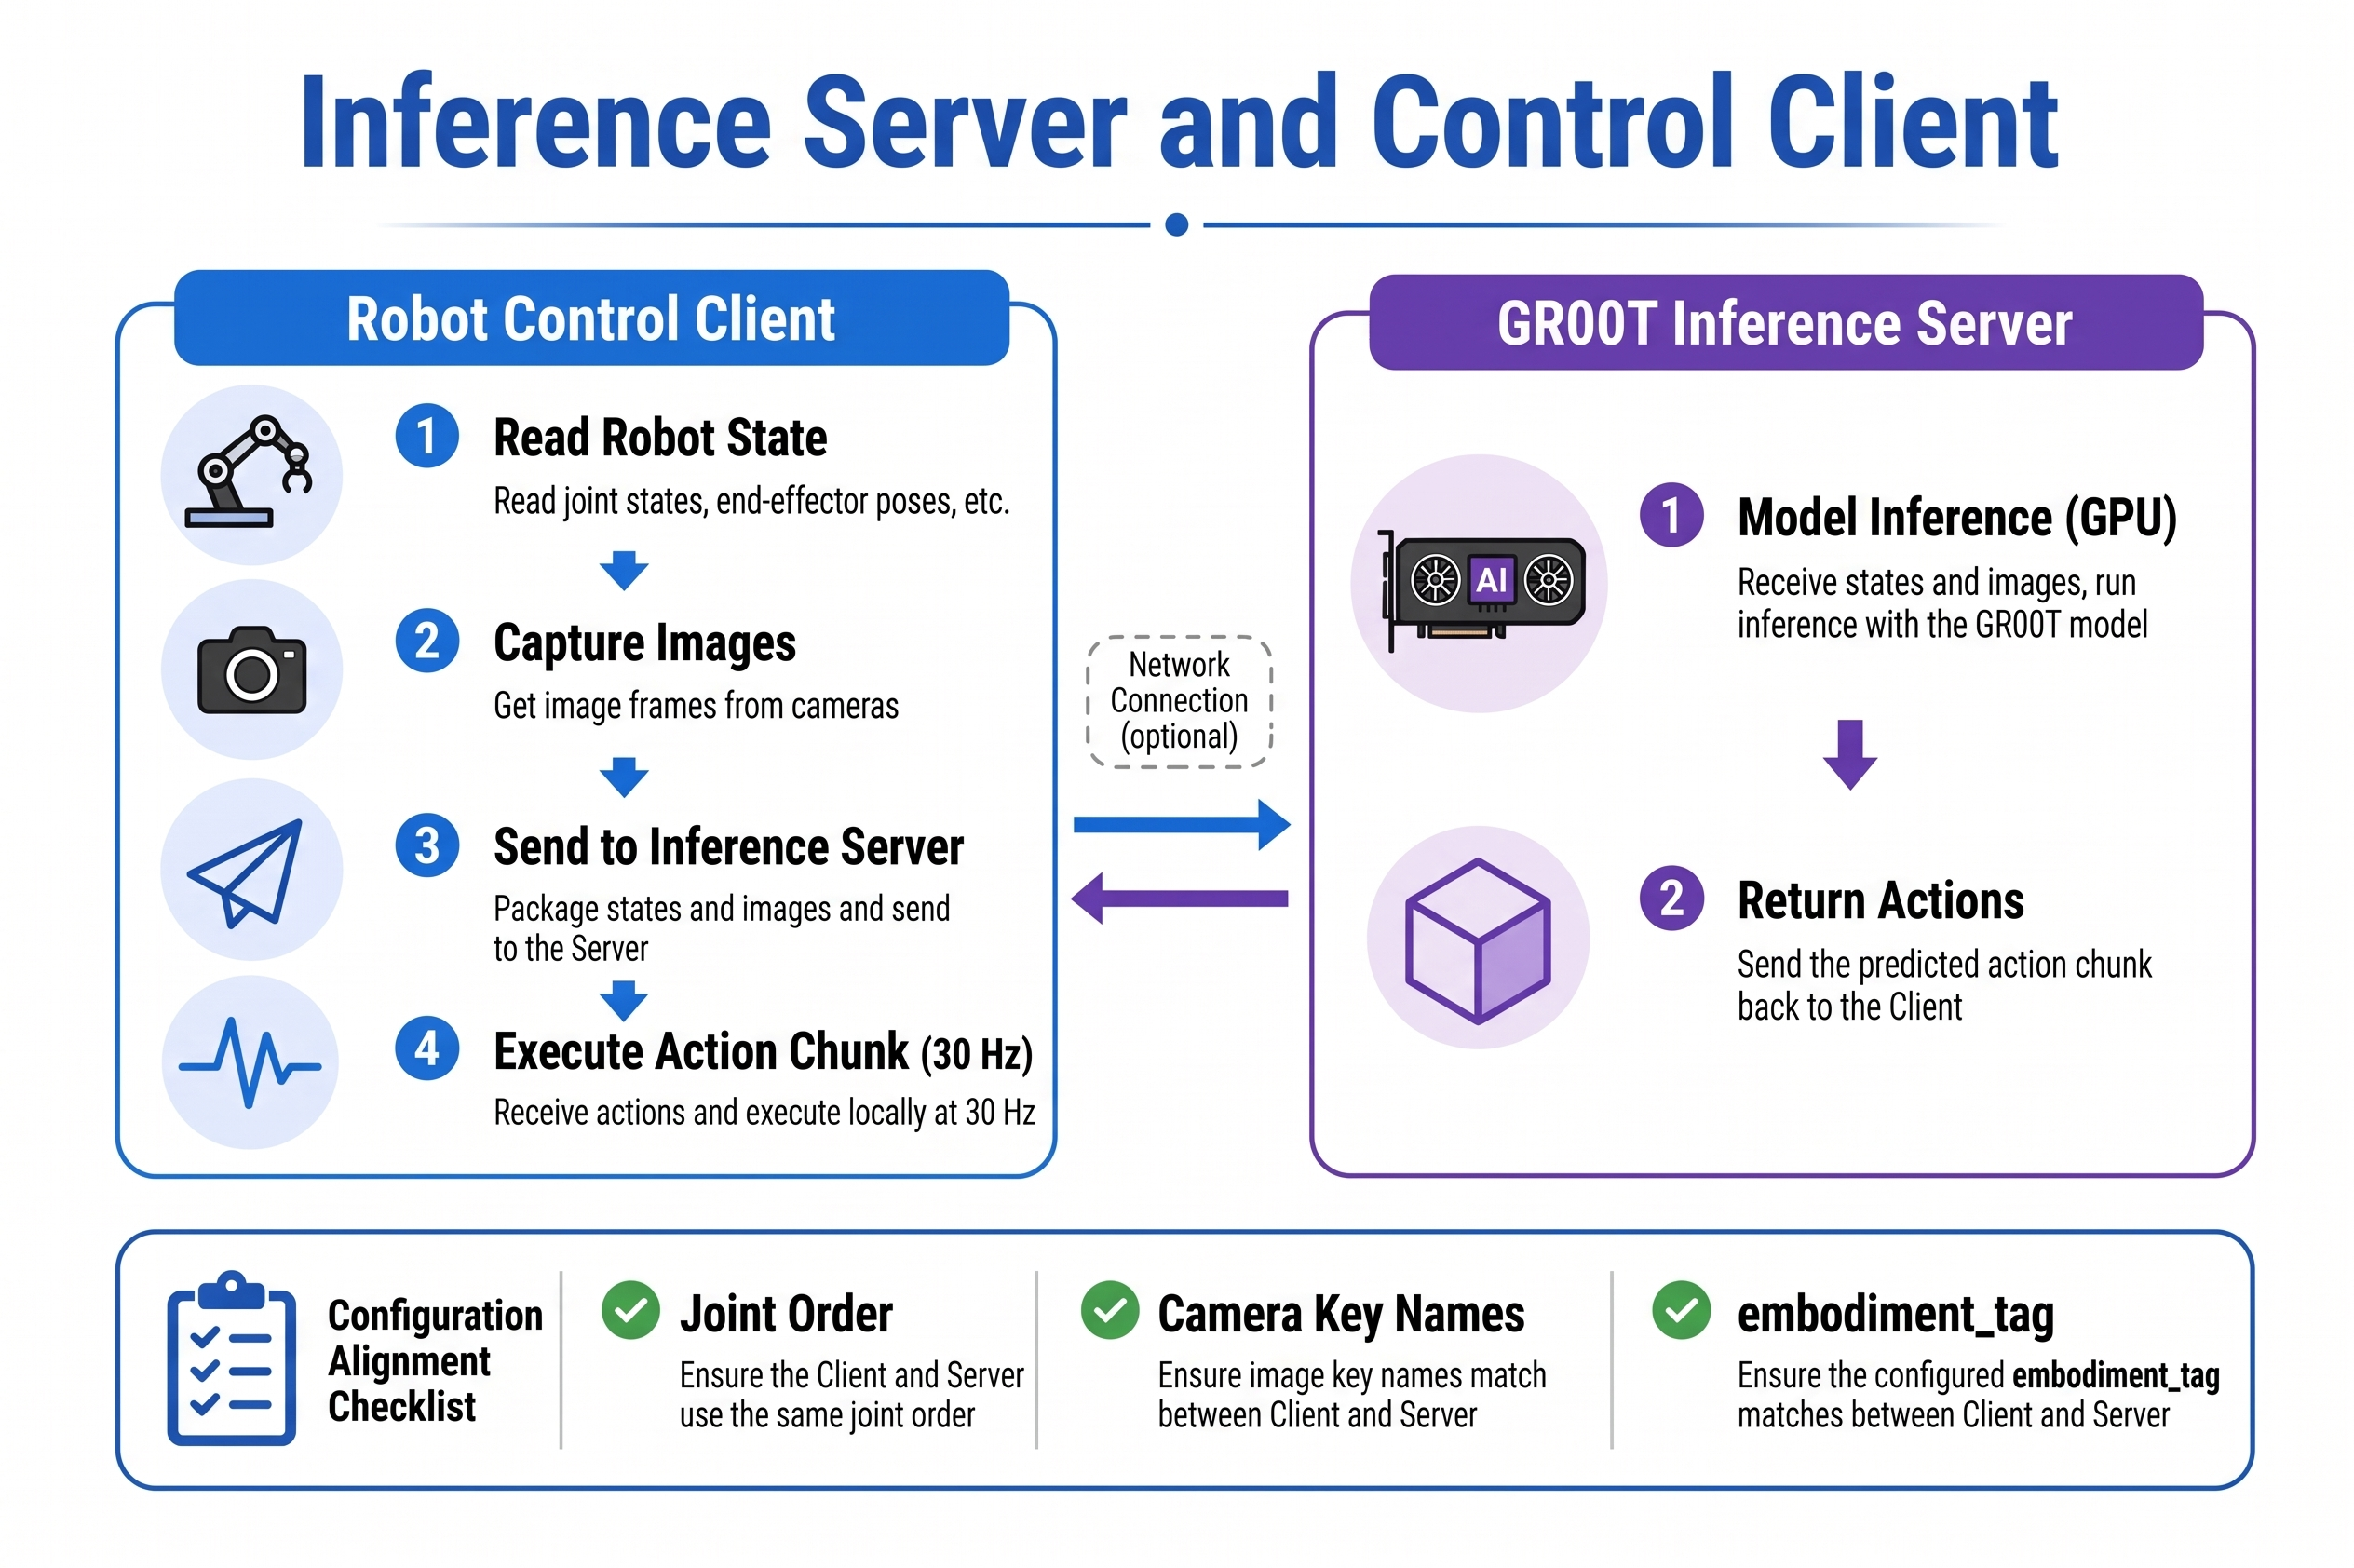
Ao colocar as coisas para rodar em uma placa de desenvolvimento, é comum separar a computação pesada do controle em tempo real:
Cliente de Controle do Robô
Responsabilidades:
- Ler o estado das juntas do reBot Arm em uma frequência fixa (por exemplo, 30 Hz)
- Capturar a imagem mais recente da câmera
- Enviar
{images, state, task}para o lado de inferência - Receber
action_chunke desdobrar as ações para o motor de acordo comn_action_steps - Monitorar limites de segurança e e-stop
No LeRobot isso corresponde a lerobot-rollout, configurado com robot.type, port, can_adapter do reBot e o dicionário de câmera cameras. RS usa can0 + socketcan; DM usa /dev/ttyACM0 + damiao.
Servidor de Inferência GR00T (opcional)
Quando a GPU está em uma máquina desktop e o braço está em campo, a política pode ser implantada como um serviço independente:
- O cliente envia JSON / tensores de observação pela rede
- O servidor carrega
policy.pathebase_model_pathe retorna os chunks de ação - Reduz a pressão de computação no lado do braço
O LeRobot coloca inferência e rollout no mesmo processo por padrão (--device=cuda), adequado para depuração em máquina única. Para produção, consulte os exemplos de deployment no repositório Isaac GR00T e encapsule a inferência como um serviço HTTP/gRPC; a interface principal do modelo é consistente com a política groot do LeRobot.
Checklist de Integração
| Item de verificação | Descrição |
|---|---|
| Ordem das juntas | dataset = modality.json = driver de rollout |
| Unidade de ângulo | rad e deg não devem ser misturados |
| Nomes de chave da câmera | front, wrist, etc. devem corresponder ao treinamento |
embodiment_tag | Tanto o fine-tuning quanto a inferência usam new_embodiment |
base_model_path | Na inferência, geralmente ainda é necessário nvidia/GR00T-N1.7-3B como base de configuração |
| Chunk e RTC | n_action_steps ≤ chunk_size; limite da fila RTC ≤ 5 |
19.9 A Posição do reBot Arm no GR00T
19.9 A Posição do reBot Arm no GR00T
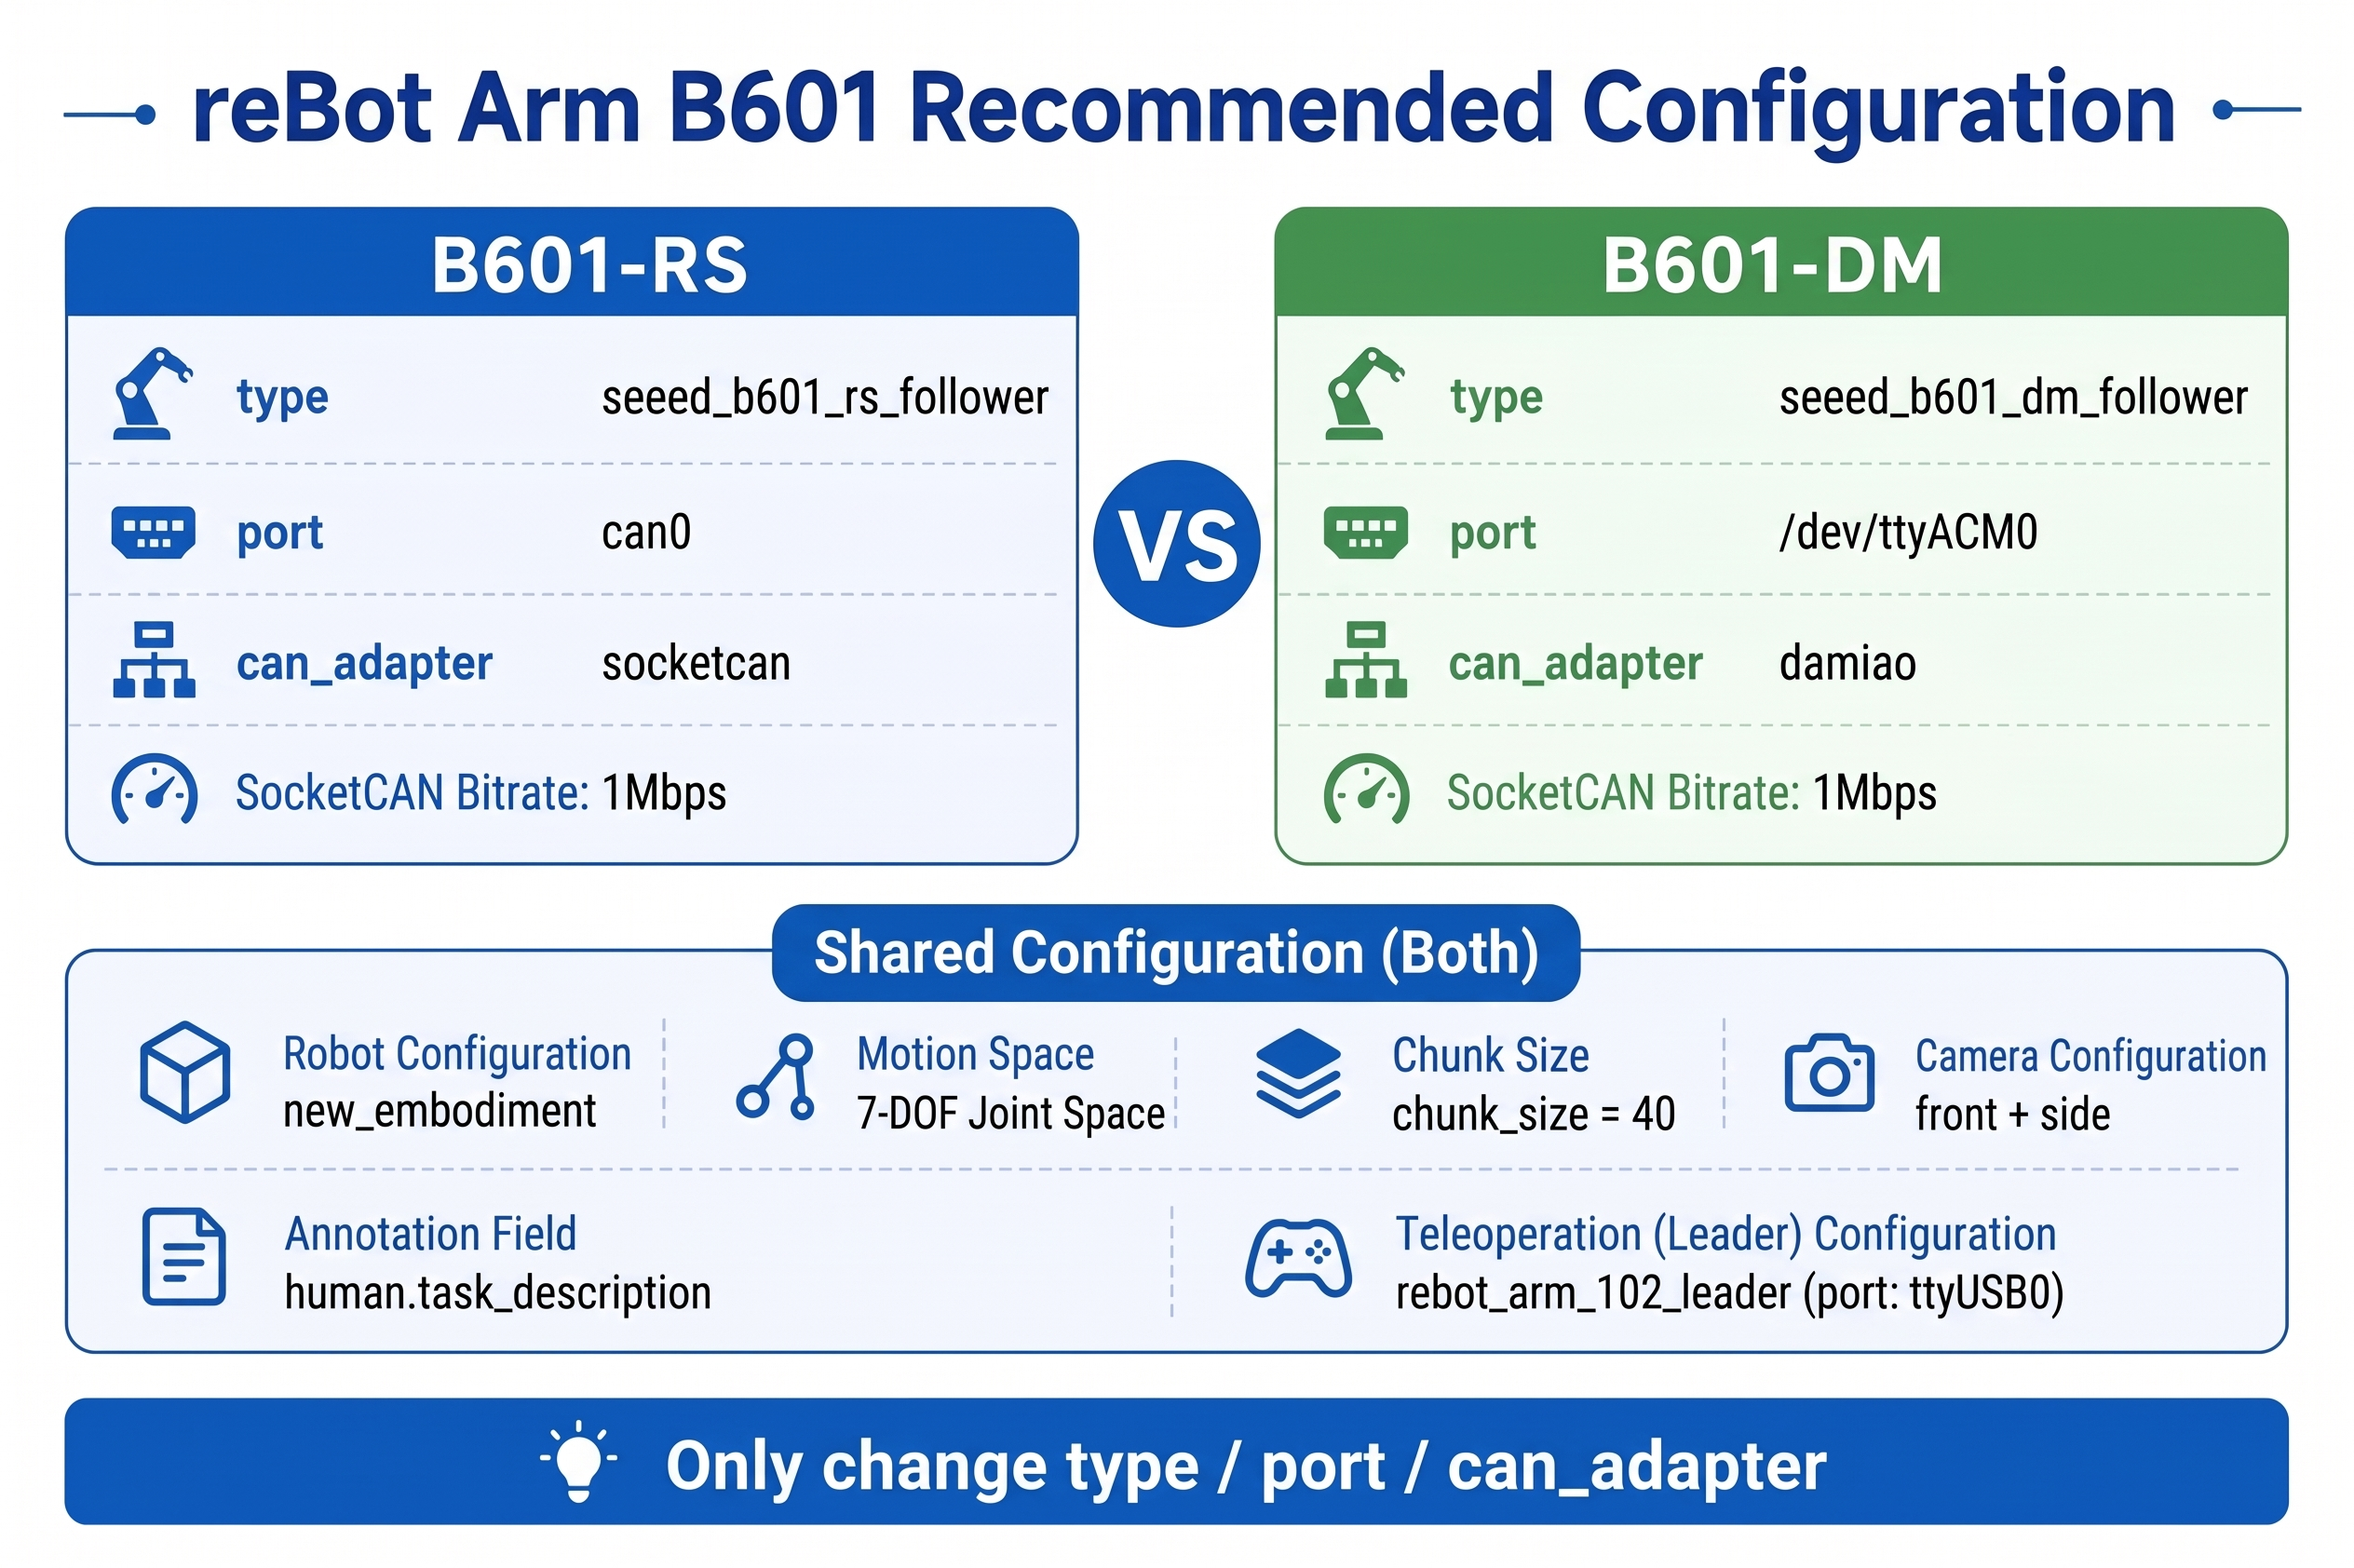
| Item | Configuração recomendada do reBot Arm B601 |
|---|---|
embodiment_tag | new_embodiment |
| chaves de estado | single_arm (6) + gripper (1) |
| chaves de ação | Alinhadas com o estado, 7 dimensões |
| tipo de ação | Espaço de juntas NON_EEF. Opcionais do LeRobot use_relative_actions=true (relativo à junta, não EEF Relativo) |
| Janela de ação | Treinamento chunk_size=40 (alinhado com o action_horizon do N1.7) |
| Câmeras | Pelo menos 1 stream; recomendado frontal + punho / lateral |
| Linguagem | Uma descrição de tarefa por episódio; anotação usa human.task_description |
| Interface de controle | Veja a tabela abaixo: RS usa SocketCAN; DM usa serial Damiao |
Diferenças de driver entre B601-RS e B601-DM (altere apenas estes três nos comandos do LeRobot):
| Versão | robot.type | robot.port | robot.can_adapter | Referência |
|---|---|---|---|---|
| B601-RS | seeed_b601_rs_follower | can0 | socketcan | B601-RS LeRobot Wiki |
| B601-DM | seeed_b601_dm_follower | /dev/ttyACM0 | damiao | B601-DM LeRobot Wiki |
Ambos são 6 eixos + gripper, estado/ação de 7 dimensões; o lado de teleop é sempre --teleop.type=rebot_arm_102_leader --teleop.port=/dev/ttyUSB0. Antes de usar RS, configure o CAN: sudo ip link set can0 type can bitrate 1000000 && sudo ip link set can0 up.
O Capítulo 20 irá percorrer passo a passo a organização de dados existentes de aprendizado por imitação no formato acima; o Capítulo 21 se baseia nisso para concluir o fine-tuning com lerobot-train.
19.10 Resumo do Capítulo
19.10 Resumo do Capítulo
- Embodiment define a interface física e de controle do robô; o reBot Arm entra no GR00T como
new_embodiment(não use tags de pré-treinamento comoLIBERO_PANDA/DROID). - Estado / Ação devem ser estritamente consistentes em todo o dataset, configuração de modalidade e cliente de inferência.
- Visão e linguagem são as duas modalidades de condicionamento de um VLA; a anotação do reBot usa
human.task_description. - Janela de ação:
action_horizon=40do N1.7, juntamente com o RTC, determina o desempenho em tempo real. - Variante de modelo: B601-RS (SocketCAN) e B601-DM (serial Damiao) diferem apenas em
type/port/can_adapter. - LeRobot fornece uma cadeia de ferramentas unificada para dados, treinamento e rollout; GR00T fornece capacidades VLA pré-treinadas.
- O próximo capítulo entra na prática: preparando o conjunto de dados VLA do reBot.