20. Preparando o Dataset reBot VLA
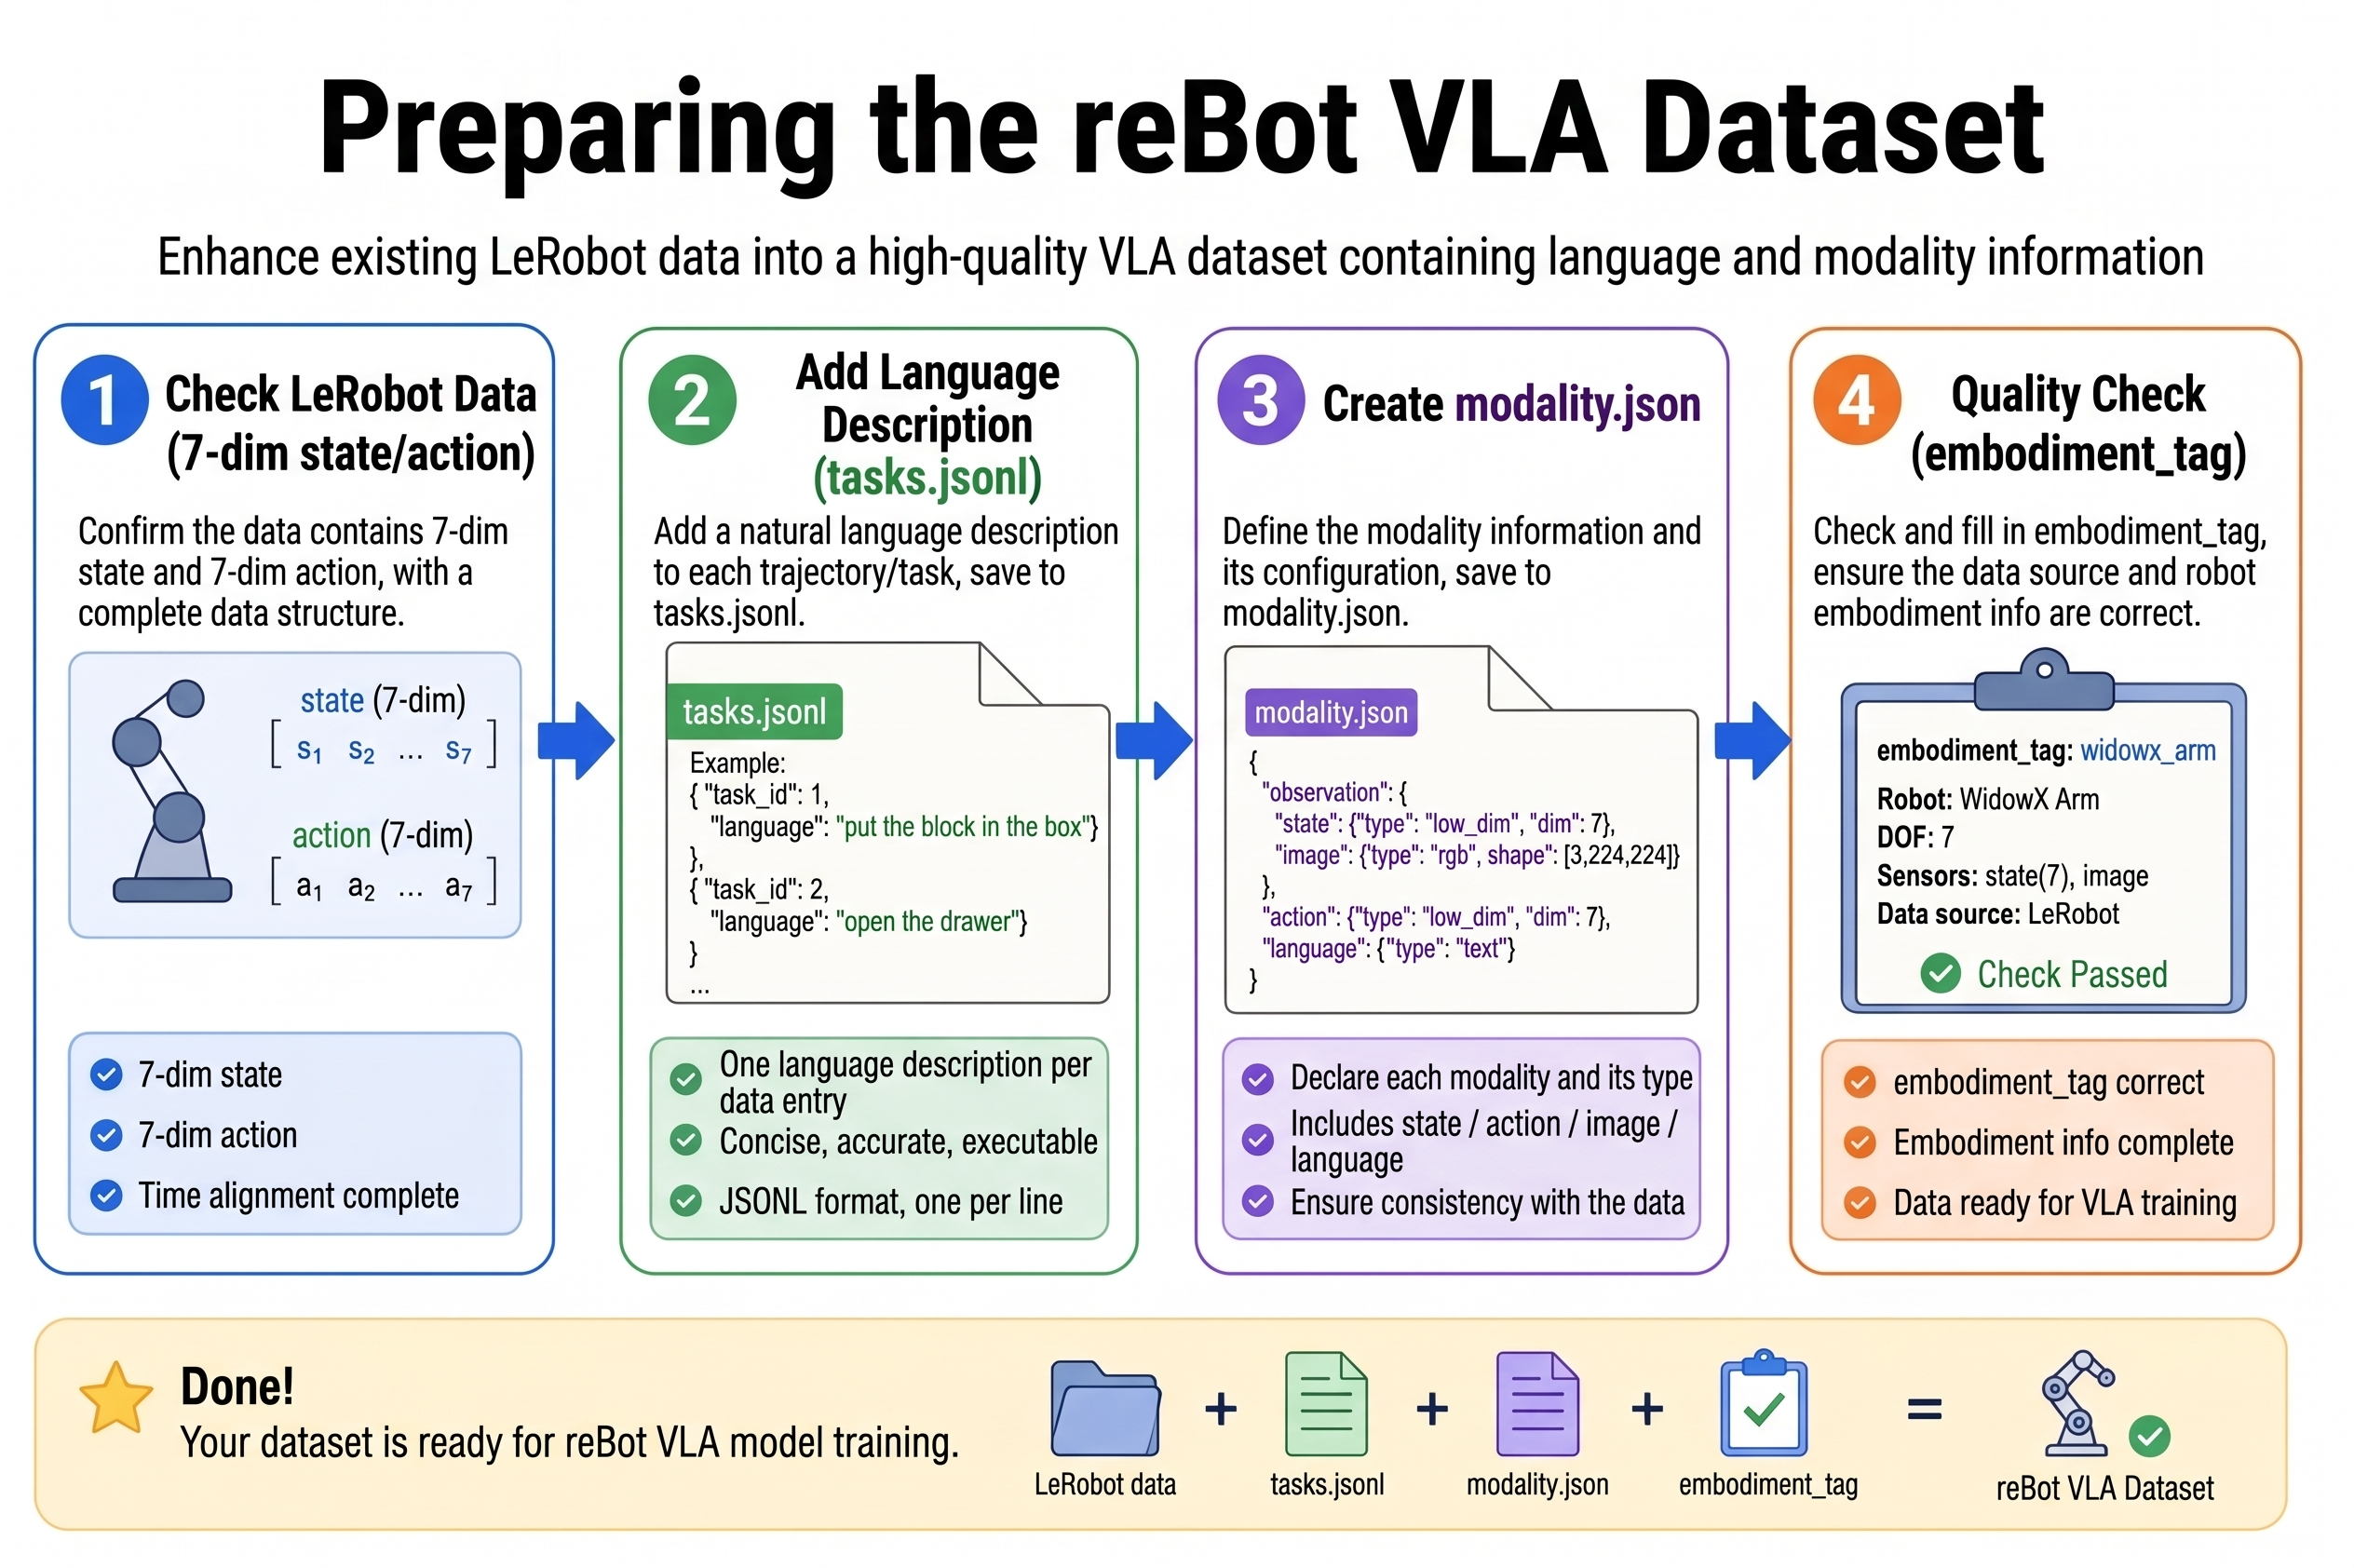
Capítulo 20 do Curso para Iniciantes em IA Física da Seeed — pré-requisitos, checando o dataset LeRobot, adicionando descrições de tarefas em linguagem natural, configurando chaves de estado/ação/câmera, criando meta/modality.json, definindo a tag de embodiment, verificando a ordem das juntas e dimensões, e organização multi-tarefa.
GR00T usa o formato LeRobotDataset v2/v3 no LeRobot, e adicionalmente requer meta/modality.json para descrever a divisão semântica de estado, ação, vídeo e anotação. Este capítulo assume que você já coletou dados ACT no reBot Arm via lerobot-record; em seguida vamos atualizá-los para dados de treinamento VLA.
20.1 Pré-requisitos
20.1 Pré-requisitos
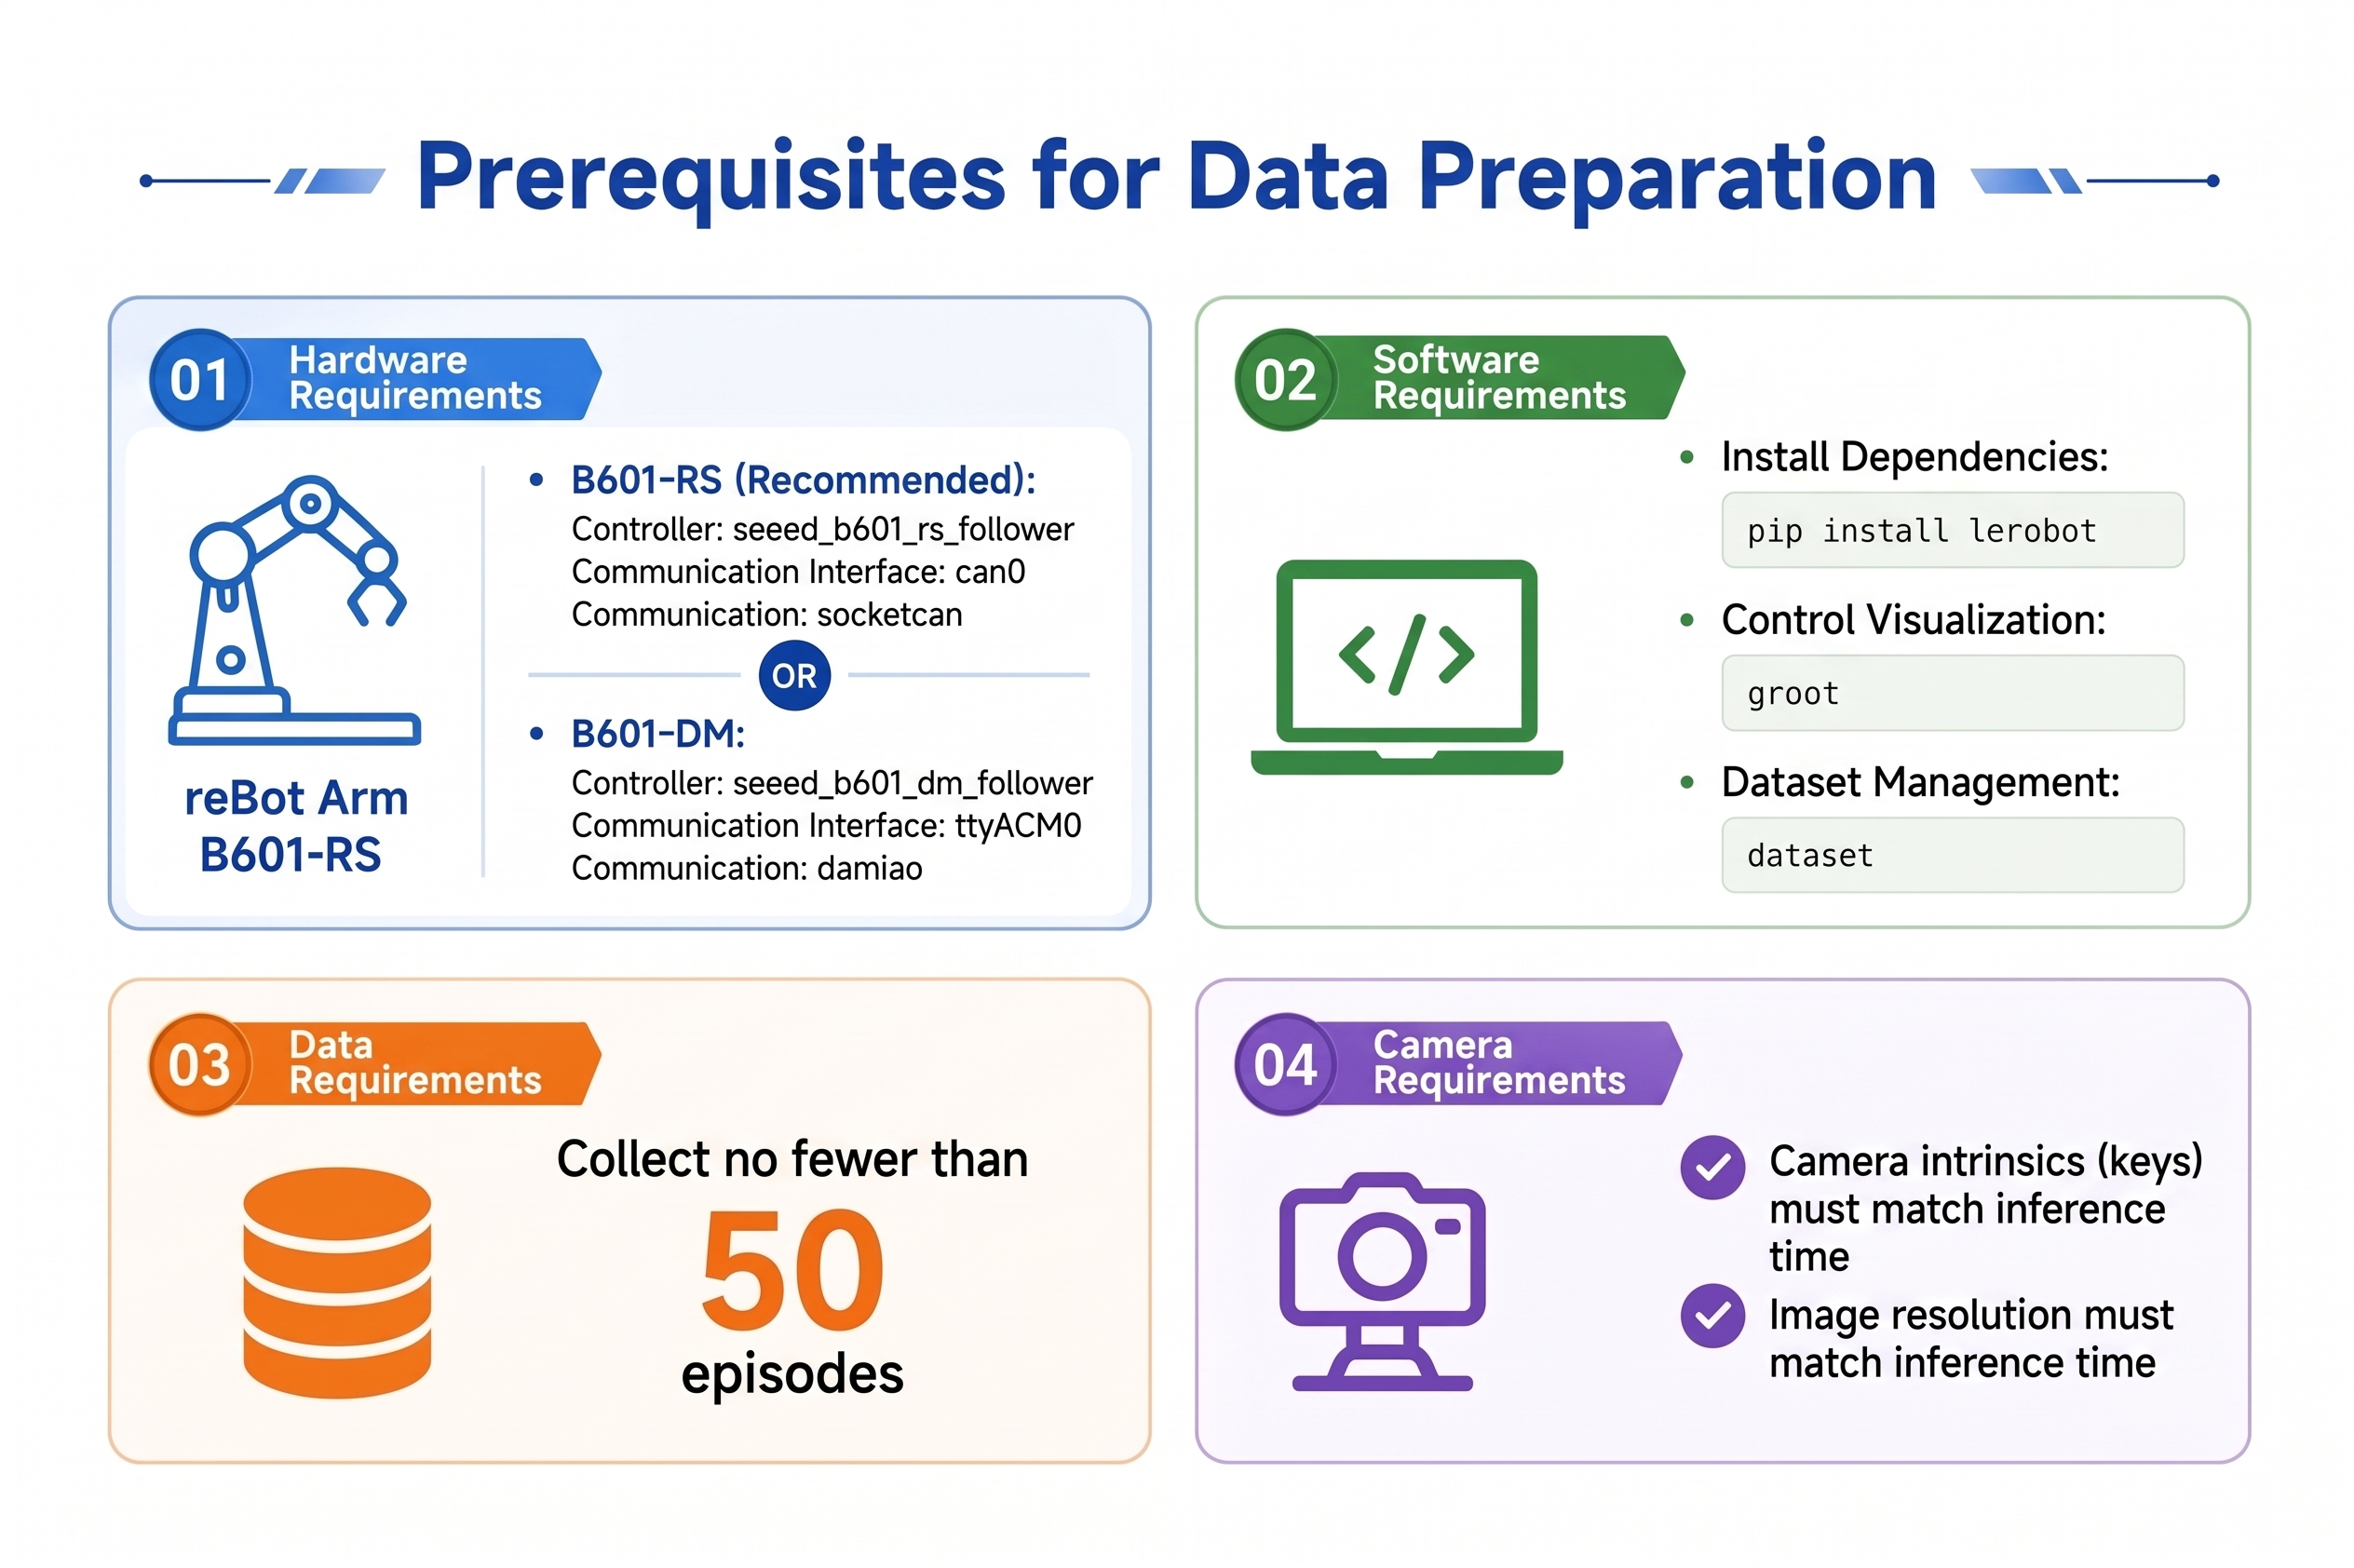
| Item | Requisito |
|---|---|
| Hardware | reBot Arm B601-RS ou B601-DM calibrado (veja a tabela abaixo) |
| Software | LeRobot instalado; recomendado pip install "lerobot[groot,training]" |
| Dados | Pelo menos 50 demonstrações bem-sucedidas para uma tarefa; para multi-tarefa, ≥ 30 por tarefa |
| Câmera | Treinamento e inferência usam os mesmos nomes de chave, resolução e quantidade |
Referência de variante de modelo (apenas altere estes três em todos os lerobot-record / lerobot-rollout subsequentes):
| Versão | robot.type | robot.port | robot.can_adapter | Wiki |
|---|---|---|---|---|
| B601-RS | seeed_b601_rs_follower | can0 | socketcan | Getting Started with LeRobot |
| B601-DM | seeed_b601_dm_follower | /dev/ttyACM0 | damiao | Getting Started with LeRobot |
Antes de usar RS, configure o CAN: sudo ip link set can0 type can bitrate 1000000 && sudo ip link set can0 up. O lado de teleop é sempre rebot_arm_102_leader, normalmente na porta /dev/ttyUSB0.
Documentos de referência:
20.2 Verificando o Dataset LeRobot
20.2 Verificando o Dataset LeRobot
Estrutura de Diretórios do Dataset
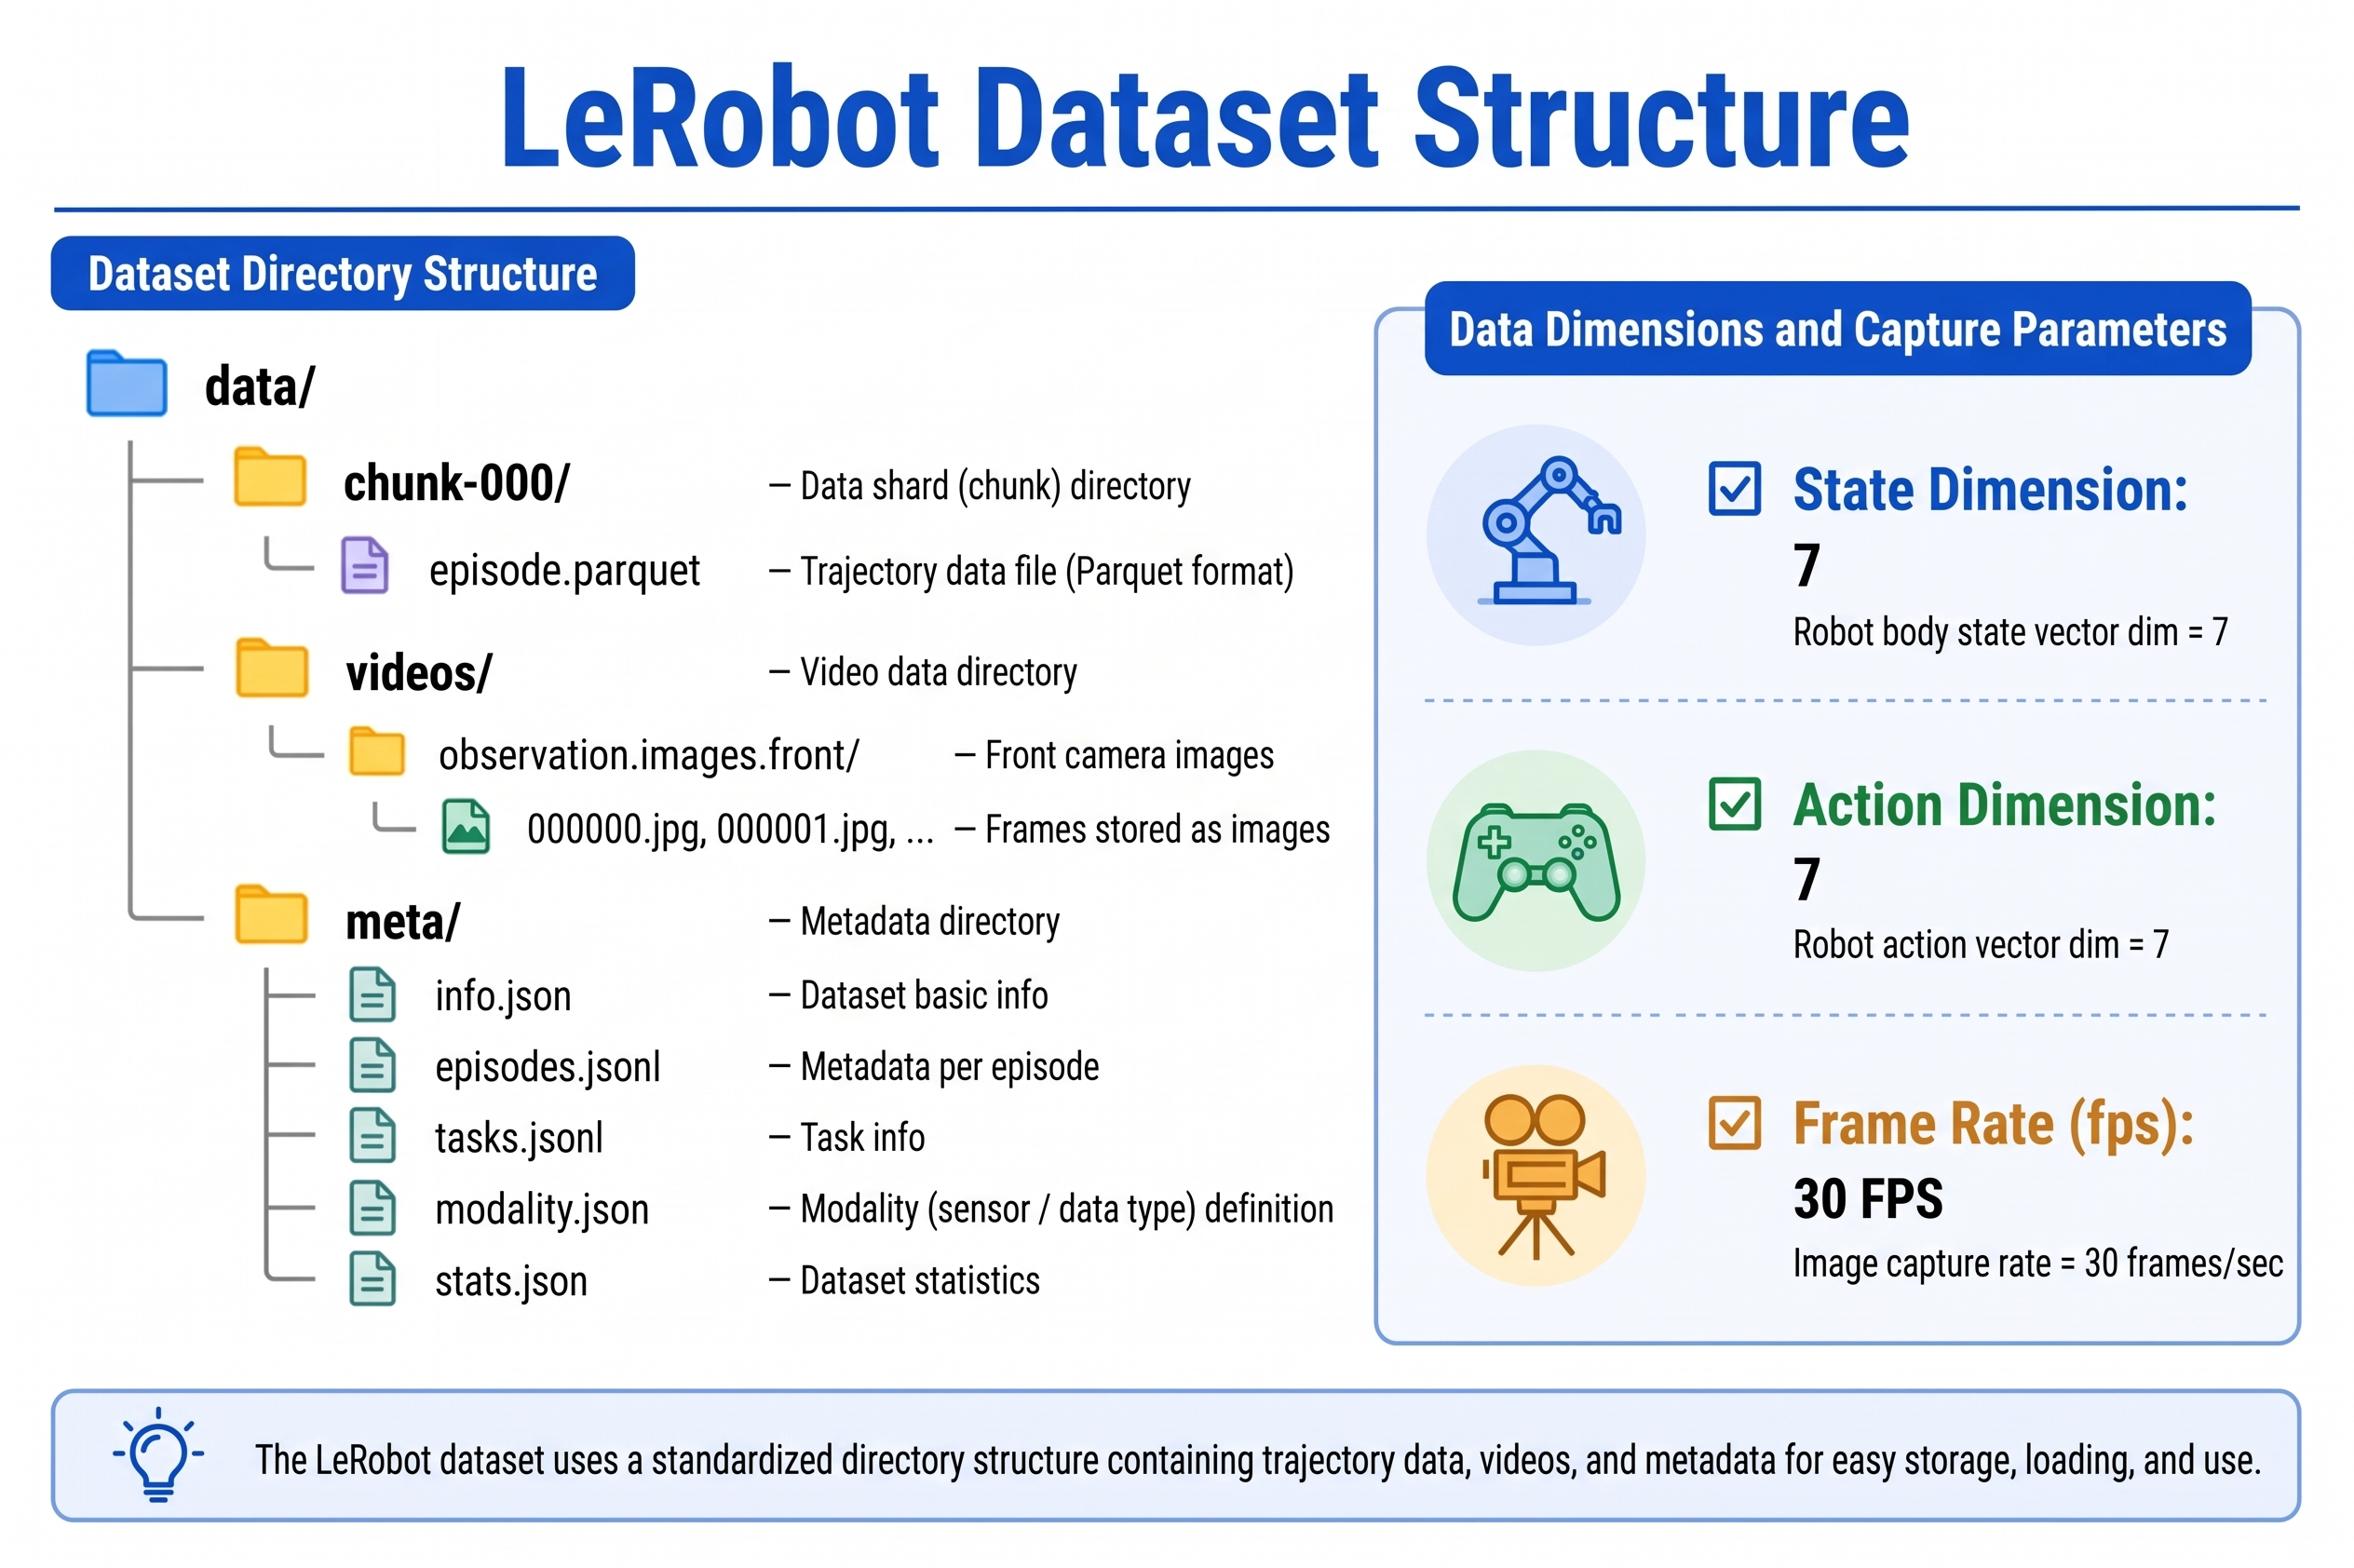
Os datasets locais ficam localizados por padrão em:
~/.cache/huggingface/lerobot/<repo_id>/
├── data/
│   └── chunk-000/
│       └── episode_*.parquet
├── videos/
│   └── chunk-000/
│       └── observation.images.<camera_name>/
├── meta/
│   ├── info.json
│   ├── episodes.jsonl
│   ├── tasks.jsonl          ← language task descriptions
│   ├── stats.json
│   └── modality.json        ← required by GR00T, create or verify manually
Verificação Rápida com Python
from lerobot.datasets.lerobot_dataset import LeRobotDataset

dataset = LeRobotDataset("seeed_rebot_b601_rs/pick_cube")  # RS example; for DM use seeed_rebot_b601_dm/pick_cube
print(dataset)
print("Feature keys:", dataset.features.keys())
print("Frame 0 state shape:", dataset[0]["observation.state"].shape)
print("Frame 0 action shape:", dataset[0]["action"].shape)
Checklist Necessário
| Item de verificação | Valor esperado (reBot B601-RS / B601-DM braço único) |
|---|---|
Dimensão de observation.state | (7,) - 6 juntas + 1 garra |
Dimensão de action | (7,) - alinhada com o estado |
| Chaves de vídeo | por exemplo, observation.images.front, observation.images.side |
| FPS | Normalmente 30 |
tasks.jsonl | Cada task_index tem uma descrição de linguagem correspondente |
| Episódios com falha | Excluídos ou marcados para evitar poluir o treinamento |
Se estado/ação não for 7-dimensional, a configuração do robô durante a gravação estava errada; volte ao lerobot-record para solucionar. Não force a edição de modality.json para preencher dimensões.
20.3 Adicionando Descrições de Tarefas em Linguagem Natural
20.3 Adicionando Descrições de Tarefas em Linguagem Natural
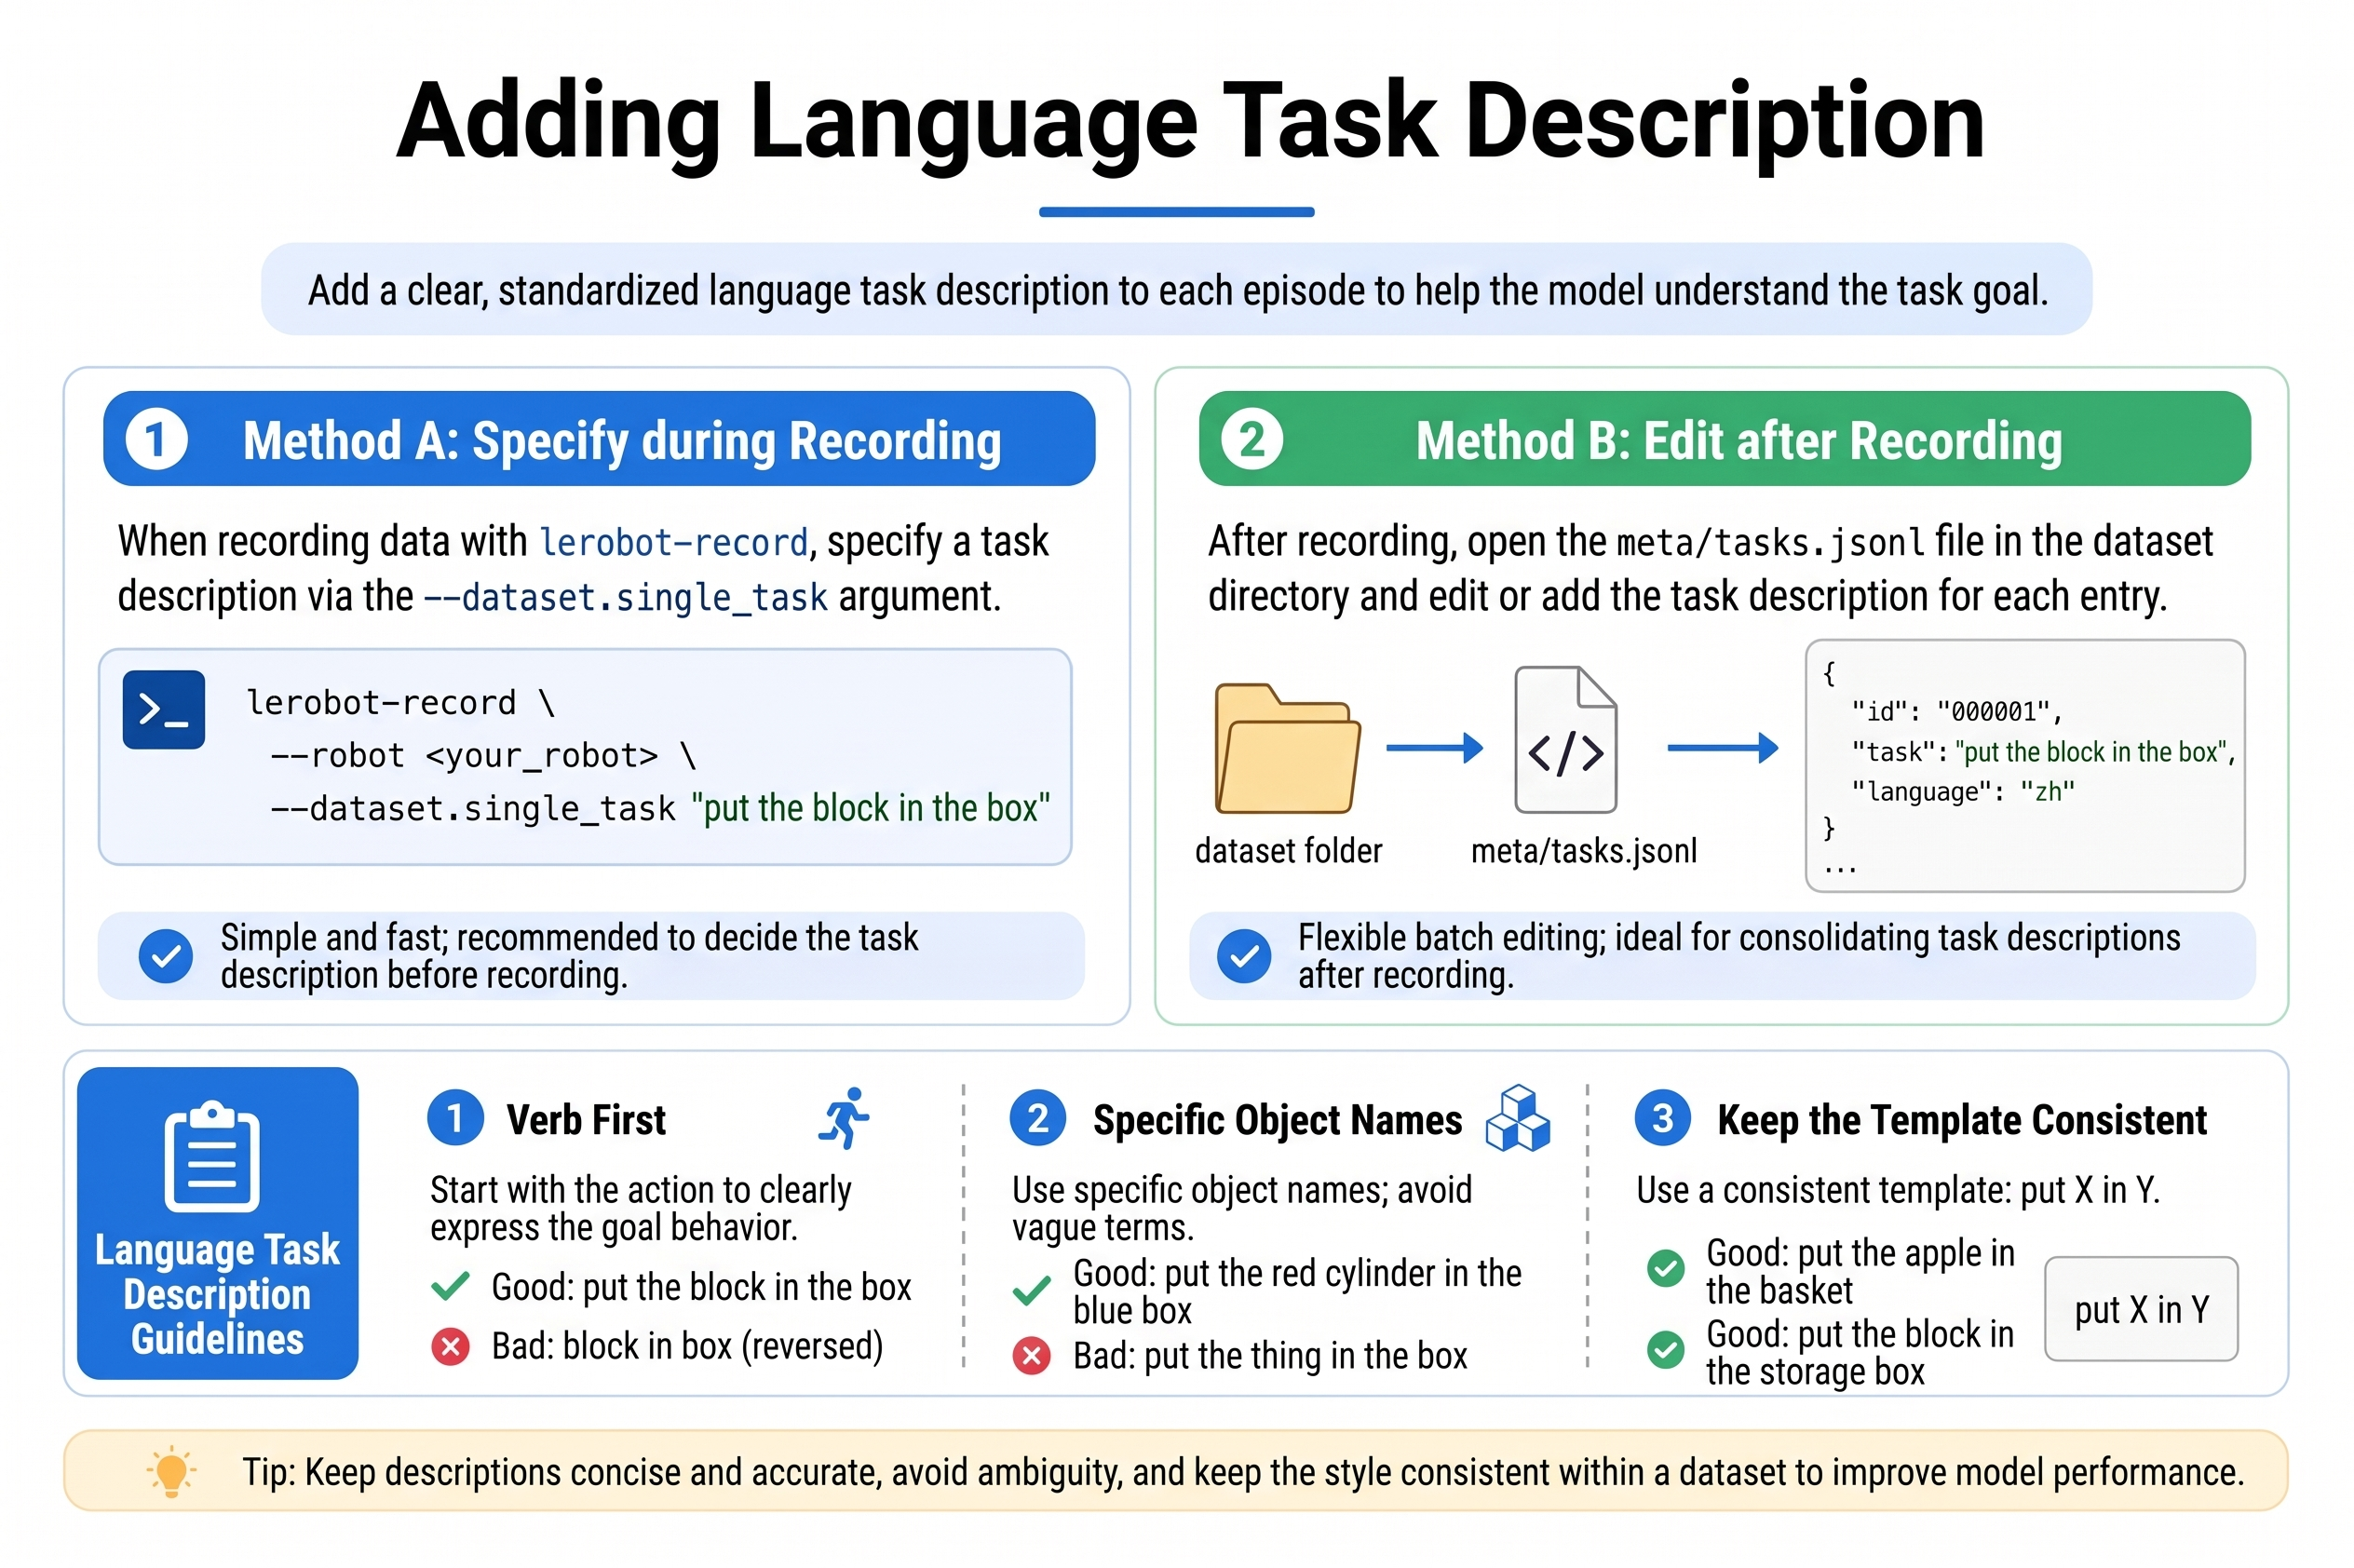
O treinamento VLA requer condicionamento por linguagem. Há duas maneiras:
Método A: Escrever diretamente durante a gravação (recomendado)
Cada episódio é gravado com --dataset.single_task. O exemplo a seguir usa B601-RS (Wiki); usuários DM substituem type / port / can_adapter por seeed_b601_dm_follower, /dev/ttyACM0, damiao.
# RS: bring up CAN first
sudo ip link set can0 down 2>/dev/null
sudo ip link set can0 type can bitrate 1000000
sudo ip link set can0 up

lerobot-record \
  --robot.type=seeed_b601_rs_follower \
  --robot.port=can0 \
  --robot.id=follower1 \
  --robot.can_adapter=socketcan \
  --robot.cameras="{ front: {type: opencv, index_or_path: 0, width: 640, height: 480, fps: 30, fourcc: "MJPG"}, side: {type: opencv, index_or_path: 2, width: 640, height: 480, fps: 30, fourcc: "MJPG"}}" \
  --teleop.type=rebot_arm_102_leader \
  --teleop.port=/dev/ttyUSB0 \
  --teleop.id=rebot_arm_102_leader \
  --display_data=true \
  --dataset.repo_id=${HF_USER}/rebot_vla_pick_cube \
  --dataset.num_episodes=50 \
  --dataset.single_task="put the black cube on the blue tray" \
  --dataset.push_to_hub=false \
  --dataset.episode_time_s=30 \
  --dataset.reset_time_s=20
Método B: Preencher depois meta/tasks.jsonl
Se os dados ACT existentes não tiverem linguagem, edite meta/tasks.jsonl:
{"task_index": 0, "task": "put the black cube on the blue tray"}
{"task_index": 1, "task": "put the screwdriver into the toolbox"}
Em um dataset multi-tarefa, diferentes episódios são associados a diferentes descrições via o campo task_index. Todos os episódios da mesma tarefa devem compartilhar o mesmo task_index.
Diretrizes para Anotação em Linguagem
- Verbo primeiro, descrevendo a ação alvo: "agarrar...", "colocar...", "empurrar...".
- Seja específico sobre os nomes dos objetos: "cubo preto" é melhor do que "objeto".
- Mantenha os padrões de frase consistentes: para multi-tarefa, use o mesmo modelo, por exemplo, sempre "colocar X em Y".
- Tanto chinês quanto inglês funcionam, mas a linguagem deve ser consistente entre treinamento e inferência.
- Evite múltiplas formulações para um mesmo ponto de dado (especialmente durante o ajuste fino inicial).
20.4 Configurando Chaves de Estado e Chaves de Ação
20.4 Configurando Chaves de Estado e Chaves de Ação
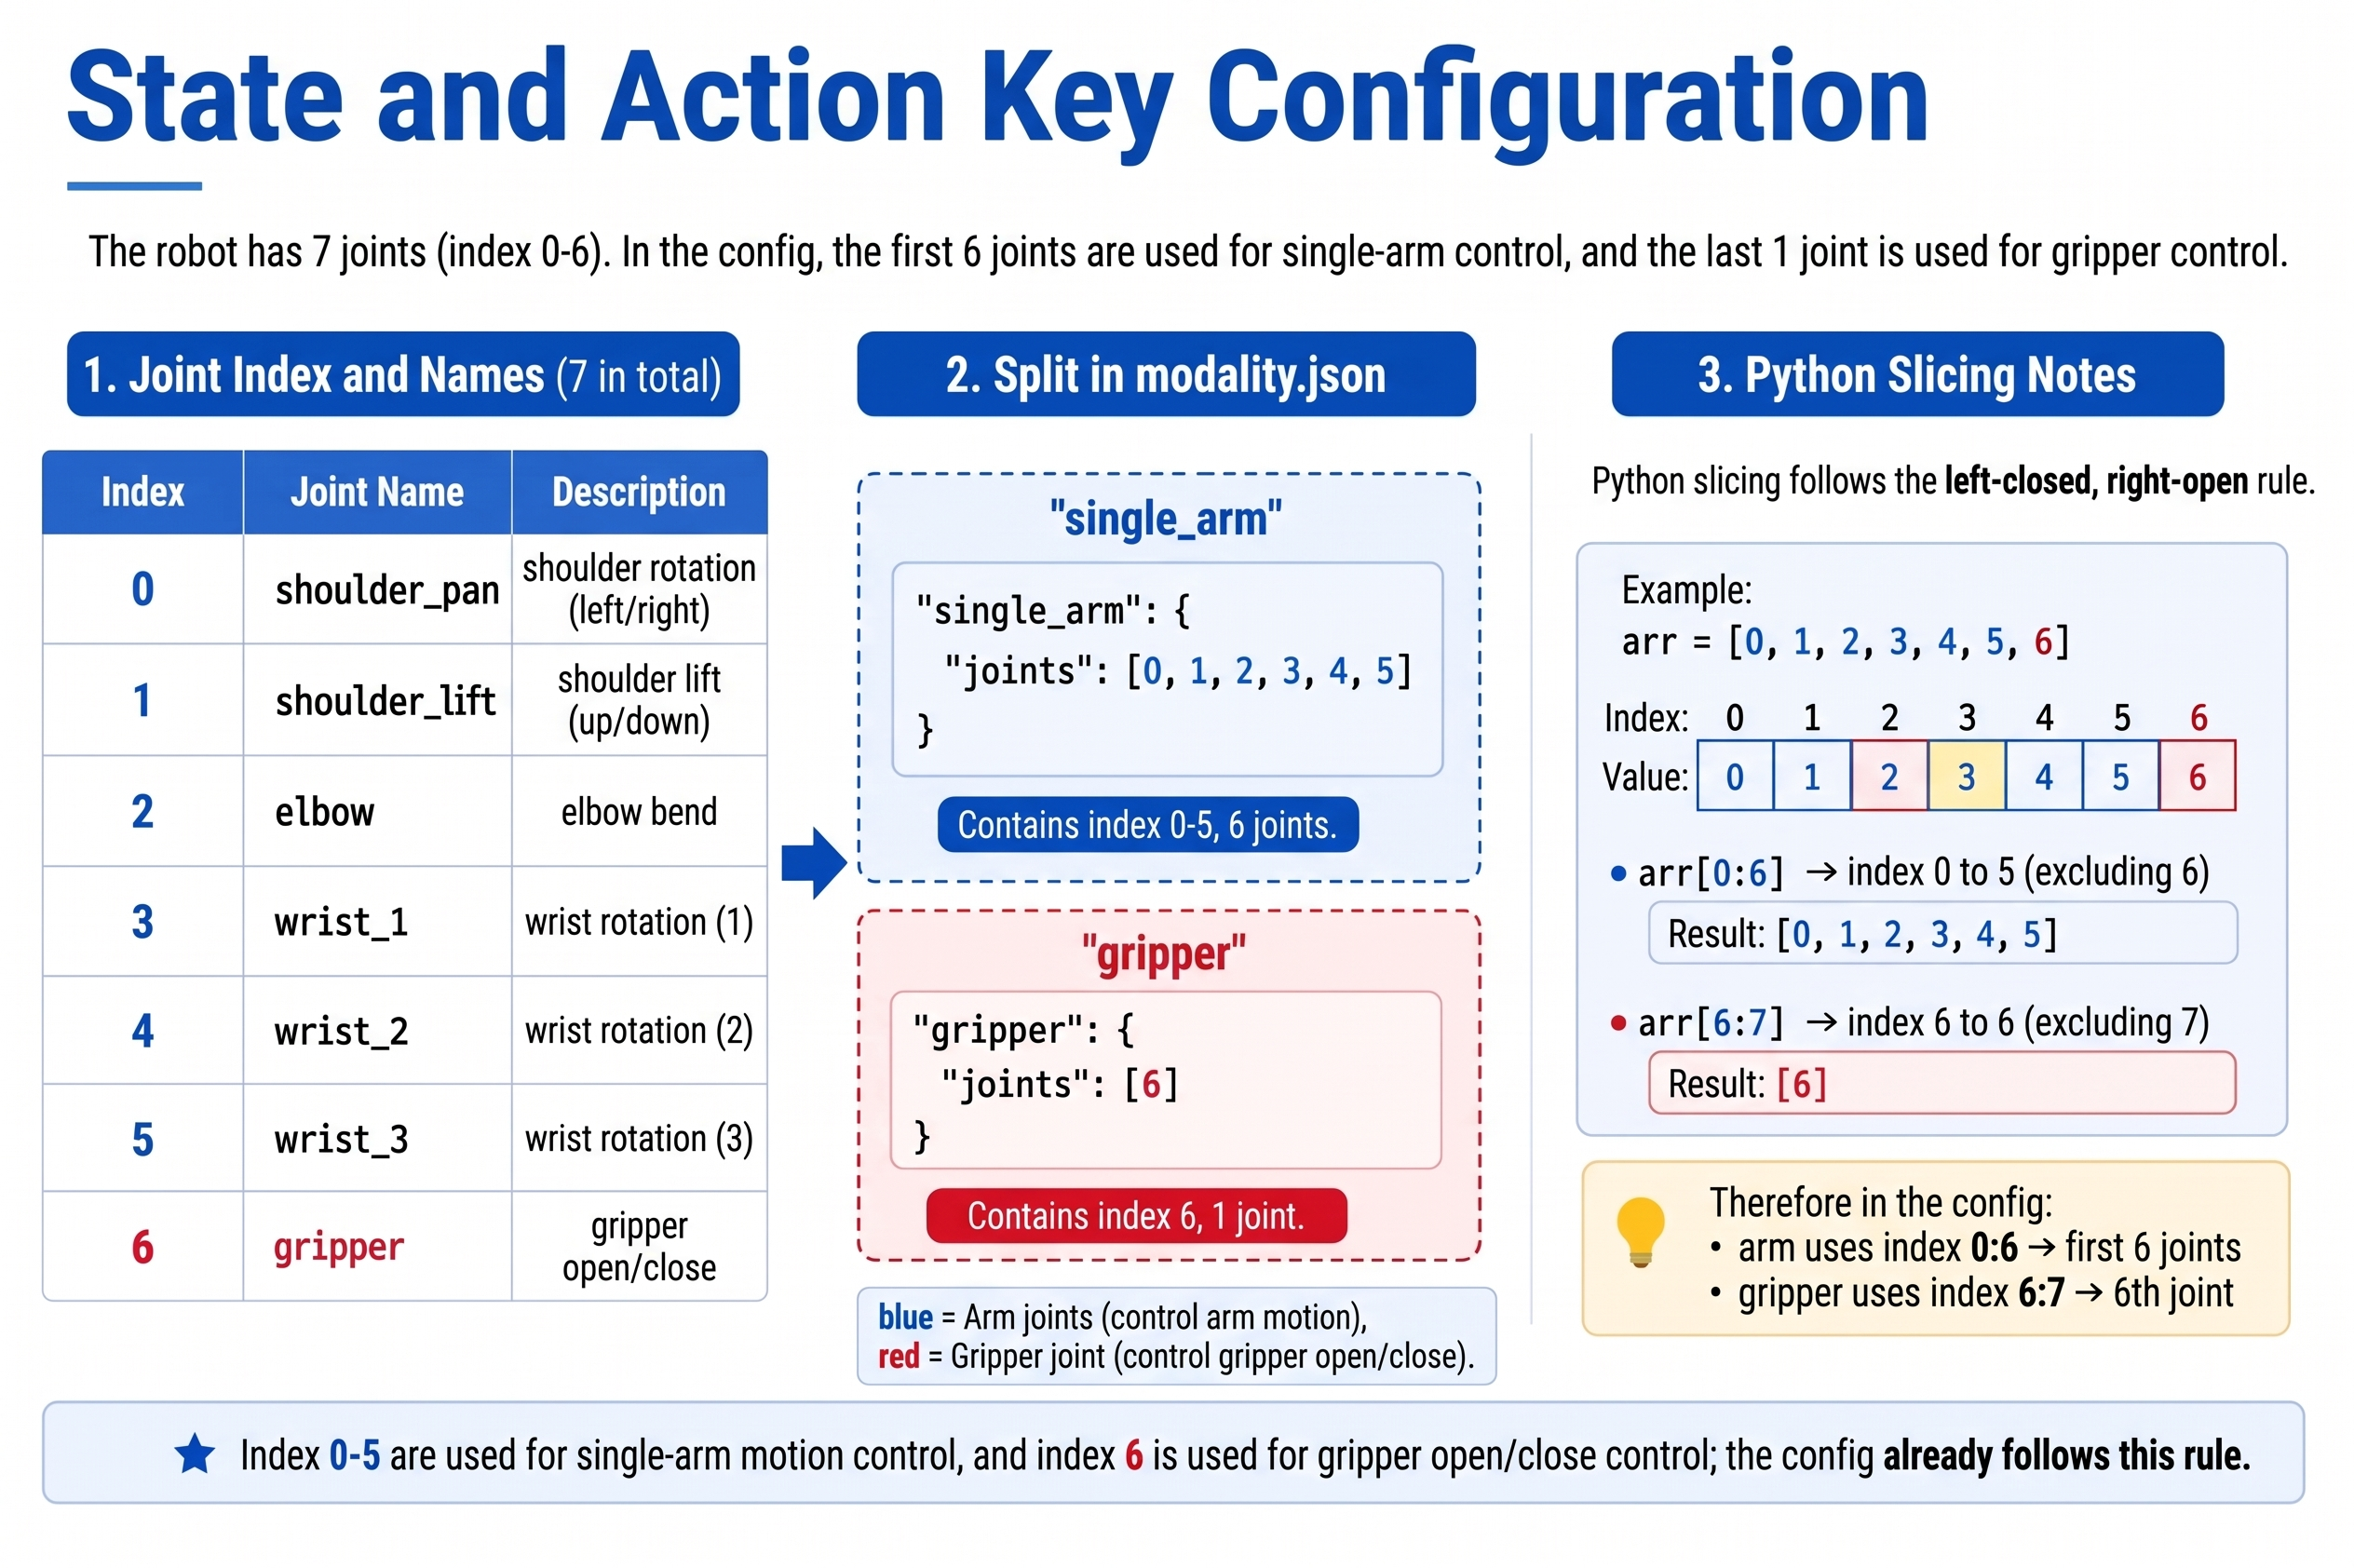
O vetor de 7 dimensões do reBot Arm B601-RS / B601-DM é concatenado na seguinte ordem de juntas (consistente com o driver LeRobot):
| Índice | Nome da chave (semântico) | Significado |
|---|---|---|
| 0 | shoulder_pan | Rotação do ombro |
| 1 | shoulder_lift | Elevação do ombro |
| 2 | elbow_flex | Flexão do cotovelo |
| 3 | wrist_flex | Flexão do pulso |
| 4 | wrist_yaw | Guinada do pulso |
| 5 | wrist_roll | Rolagem do pulso |
| 6 | gripper | Abrir/fechar a garra |
No modality.json do GR00T, as 7 dimensões acima são divididas em duas chaves semânticas:
single_arm: índices 0-5 (6 juntas)gripper: índice 6 (garra)
O fatiamento em Python é semiaberto: "end": 6 significa até o índice 5, e "start": 6, "end": 7 significa índice 6.
20.5 Configurando Chaves de Câmera
20.5 Configurando Chaves de Câmera
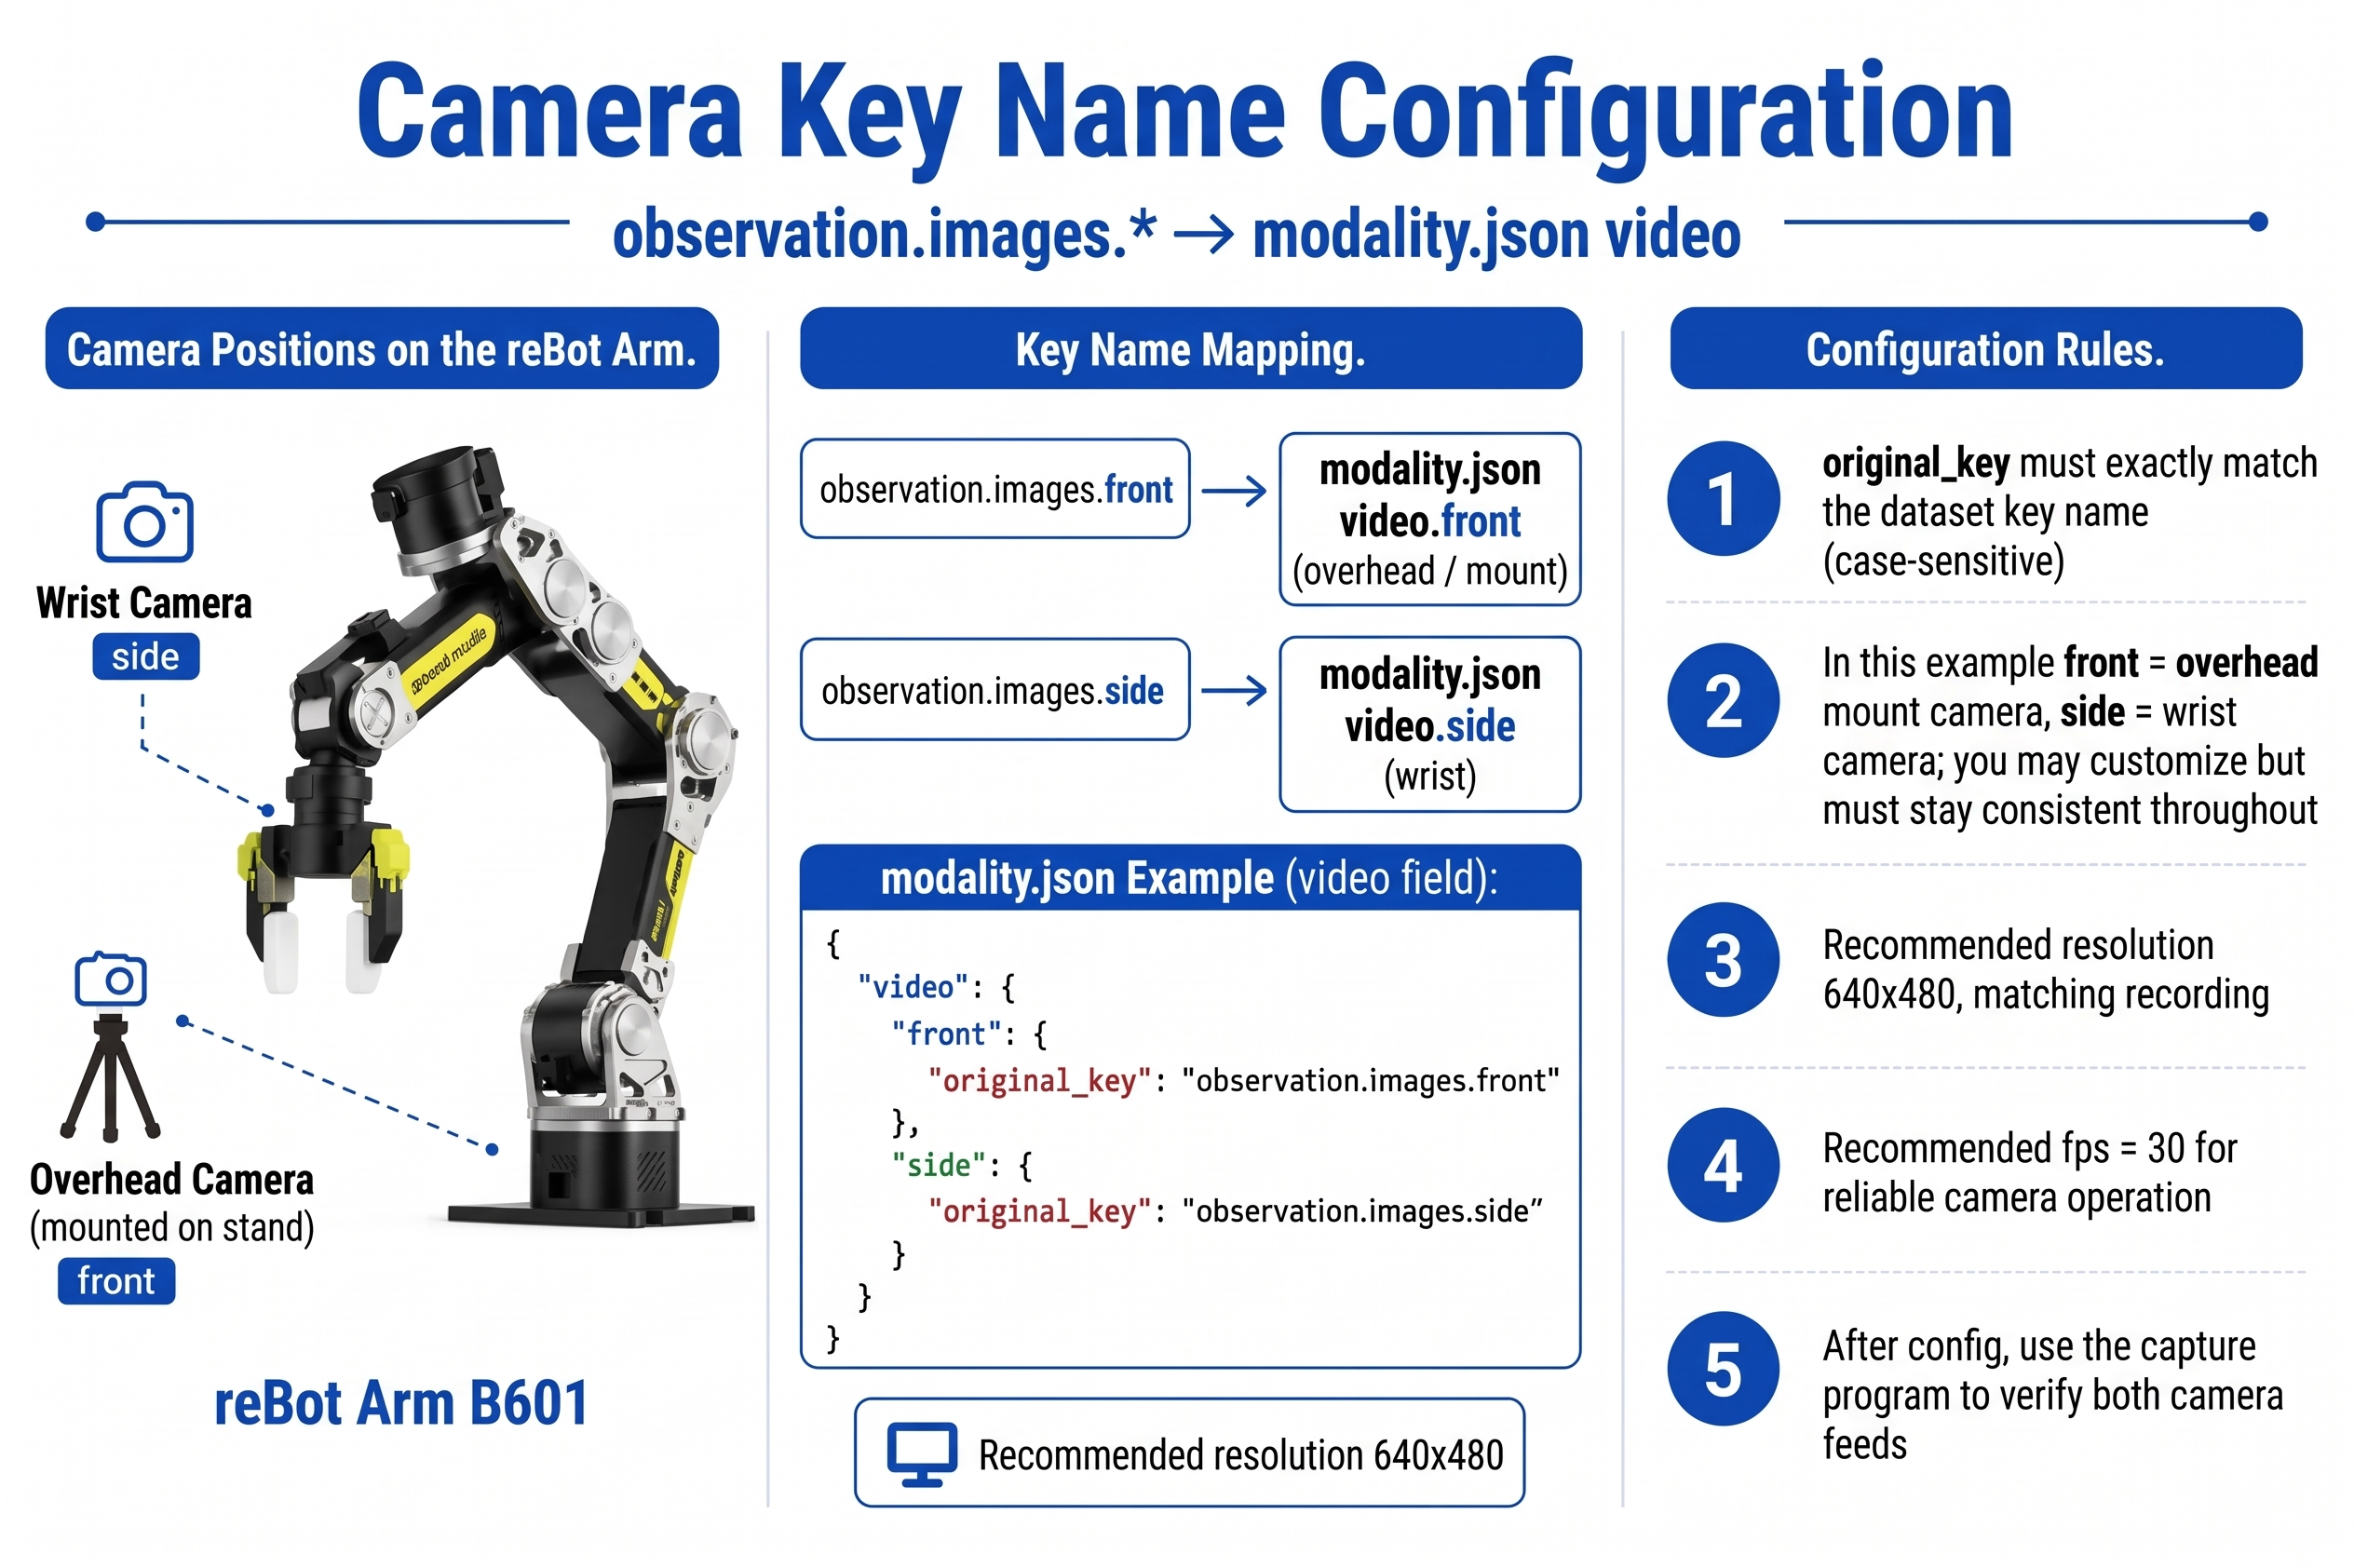
GR00T mapeia chaves de câmera originais no dataset para nomes de chave padrão via o campo video de modality.json.
Layouts de câmera comuns do reBot
Chave do dataset (original_key) | Chave padrão de modality | Uso recomendado |
|---|---|---|
observation.images.front | front | Visão ampla montada no suporte |
observation.images.side | side | Close-up do punho |
Exemplo: se as chaves de câmera durante a gravação forem front e side:
"video": {
  "front": {
    "original_key": "observation.images.front"
  },
  "side": {
    "original_key": "observation.images.side"
  }
}
Princípios-chave:
original_keydeve corresponder exatamente à chave real no conjunto de dados.- As chaves padrão no lado esquerdo da modalidade (
front,side) serão usadas de forma uniforme durante o treinamento e a inferência. - Uma única câmera pode treinar, mas duas câmeras geralmente apresentam melhor desempenho.
- A resolução recomendada é uniformemente 640x480, consistente com os parâmetros de gravação.
Encontre o índice da câmera local:
lerobot-find-cameras opencv
20.6 Criando meta/modality.json
20.6 Criando meta/modality.json
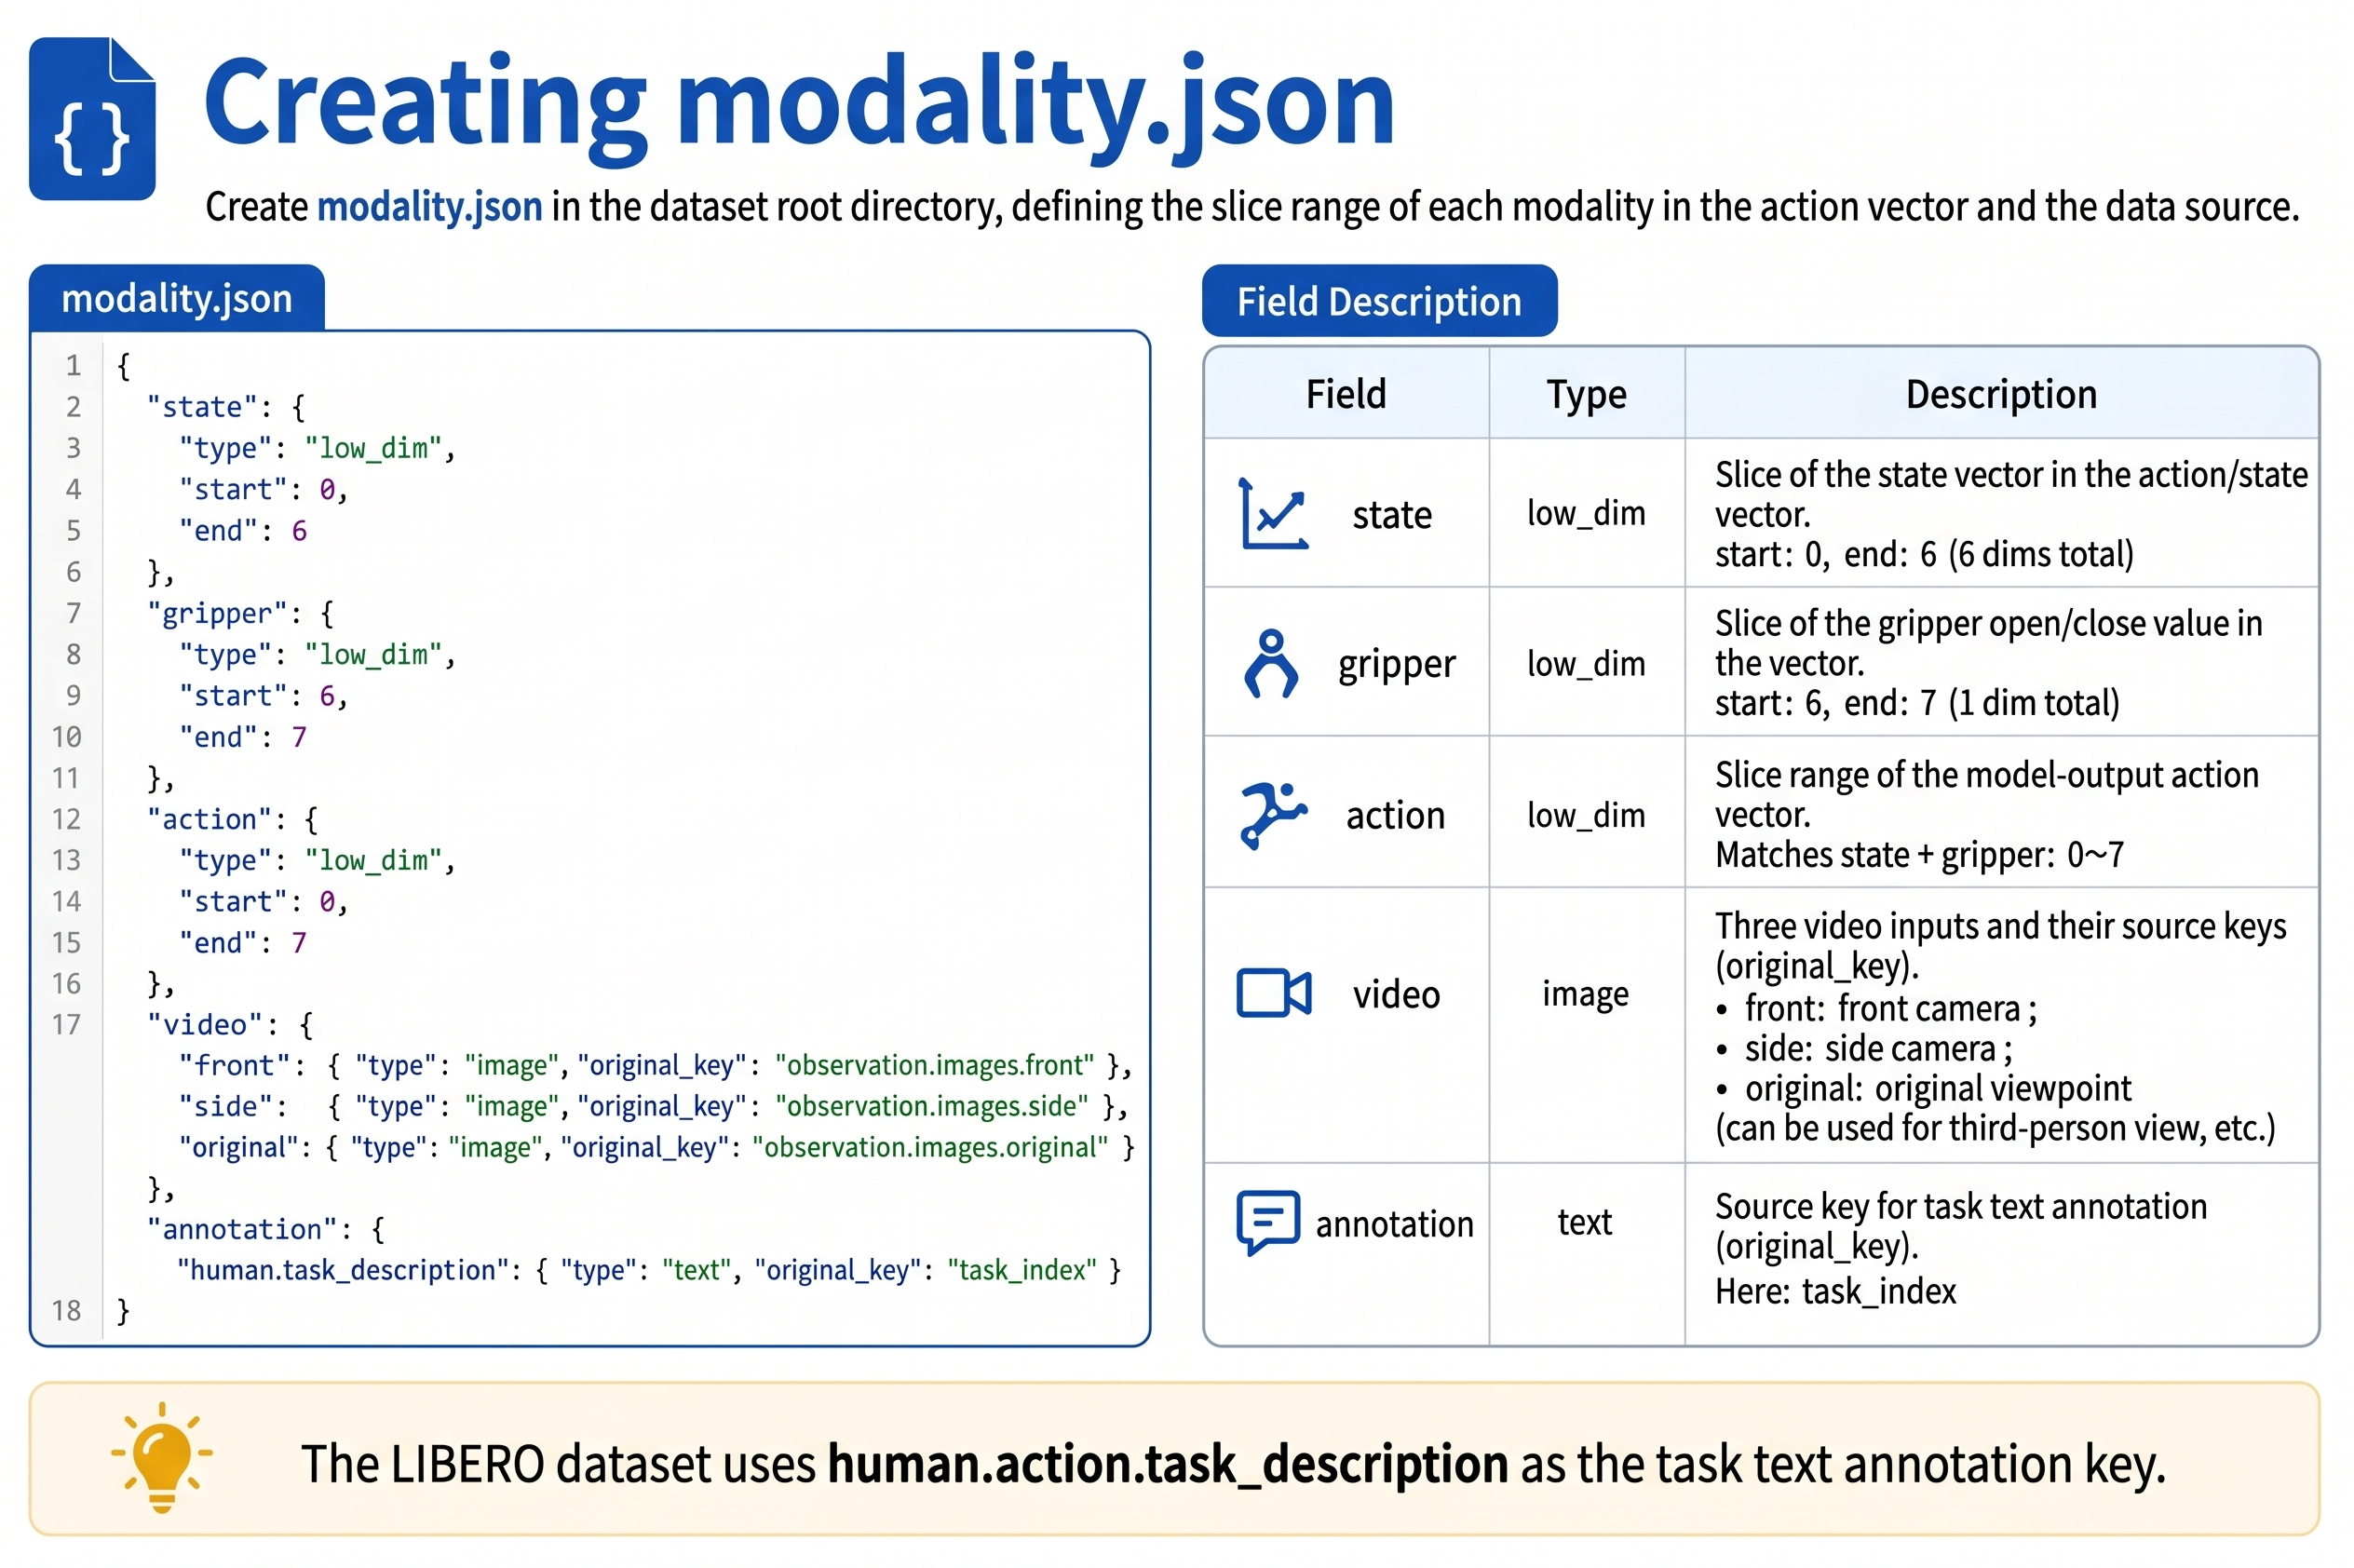
Crie modality.json no diretório meta/ do conjunto de dados. Abaixo está o exemplo completo para o espaço de juntas de 7 dimensões de um único braço do reBot Arm B601 (idêntico para RS / DM):
{
  "state": {
    "single_arm": {
      "start": 0,
      "end": 6
    },
    "gripper": {
      "start": 6,
      "end": 7
    }
  },
  "action": {
    "single_arm": {
      "start": 0,
      "end": 6
    },
    "gripper": {
      "start": 6,
      "end": 7
    }
  },
  "video": {
    "front": {
      "original_key": "observation.images.front"
    },
    "side": {
      "original_key": "observation.images.side"
    }
  },
  "annotation": {
    "human.task_description": {
      "original_key": "task_index"
    }
  }
}
Descrição dos campos
| Campo | Finalidade |
|---|---|
state / action | Definir o intervalo de índice de cada segmento no vetor concatenado |
video | Mapear as chaves de vídeo do LeRobot para os nomes de câmera padrão do GR00T |
annotation | Associar task_index com tasks.jsonl. reBot usa human.task_description; LIBERO / SimplerEnv usam human.action.task_description |
Se o conjunto de dados tiver apenas uma tarefa e nenhum campo task_index, primeiro certifique-se de que o lerobot-record gravou tasks.jsonl, caso contrário o GR00T não poderá ler a condição de linguagem.
20.7 Definindo a tag de Embodiment
20.7 Definindo a tag de Embodiment
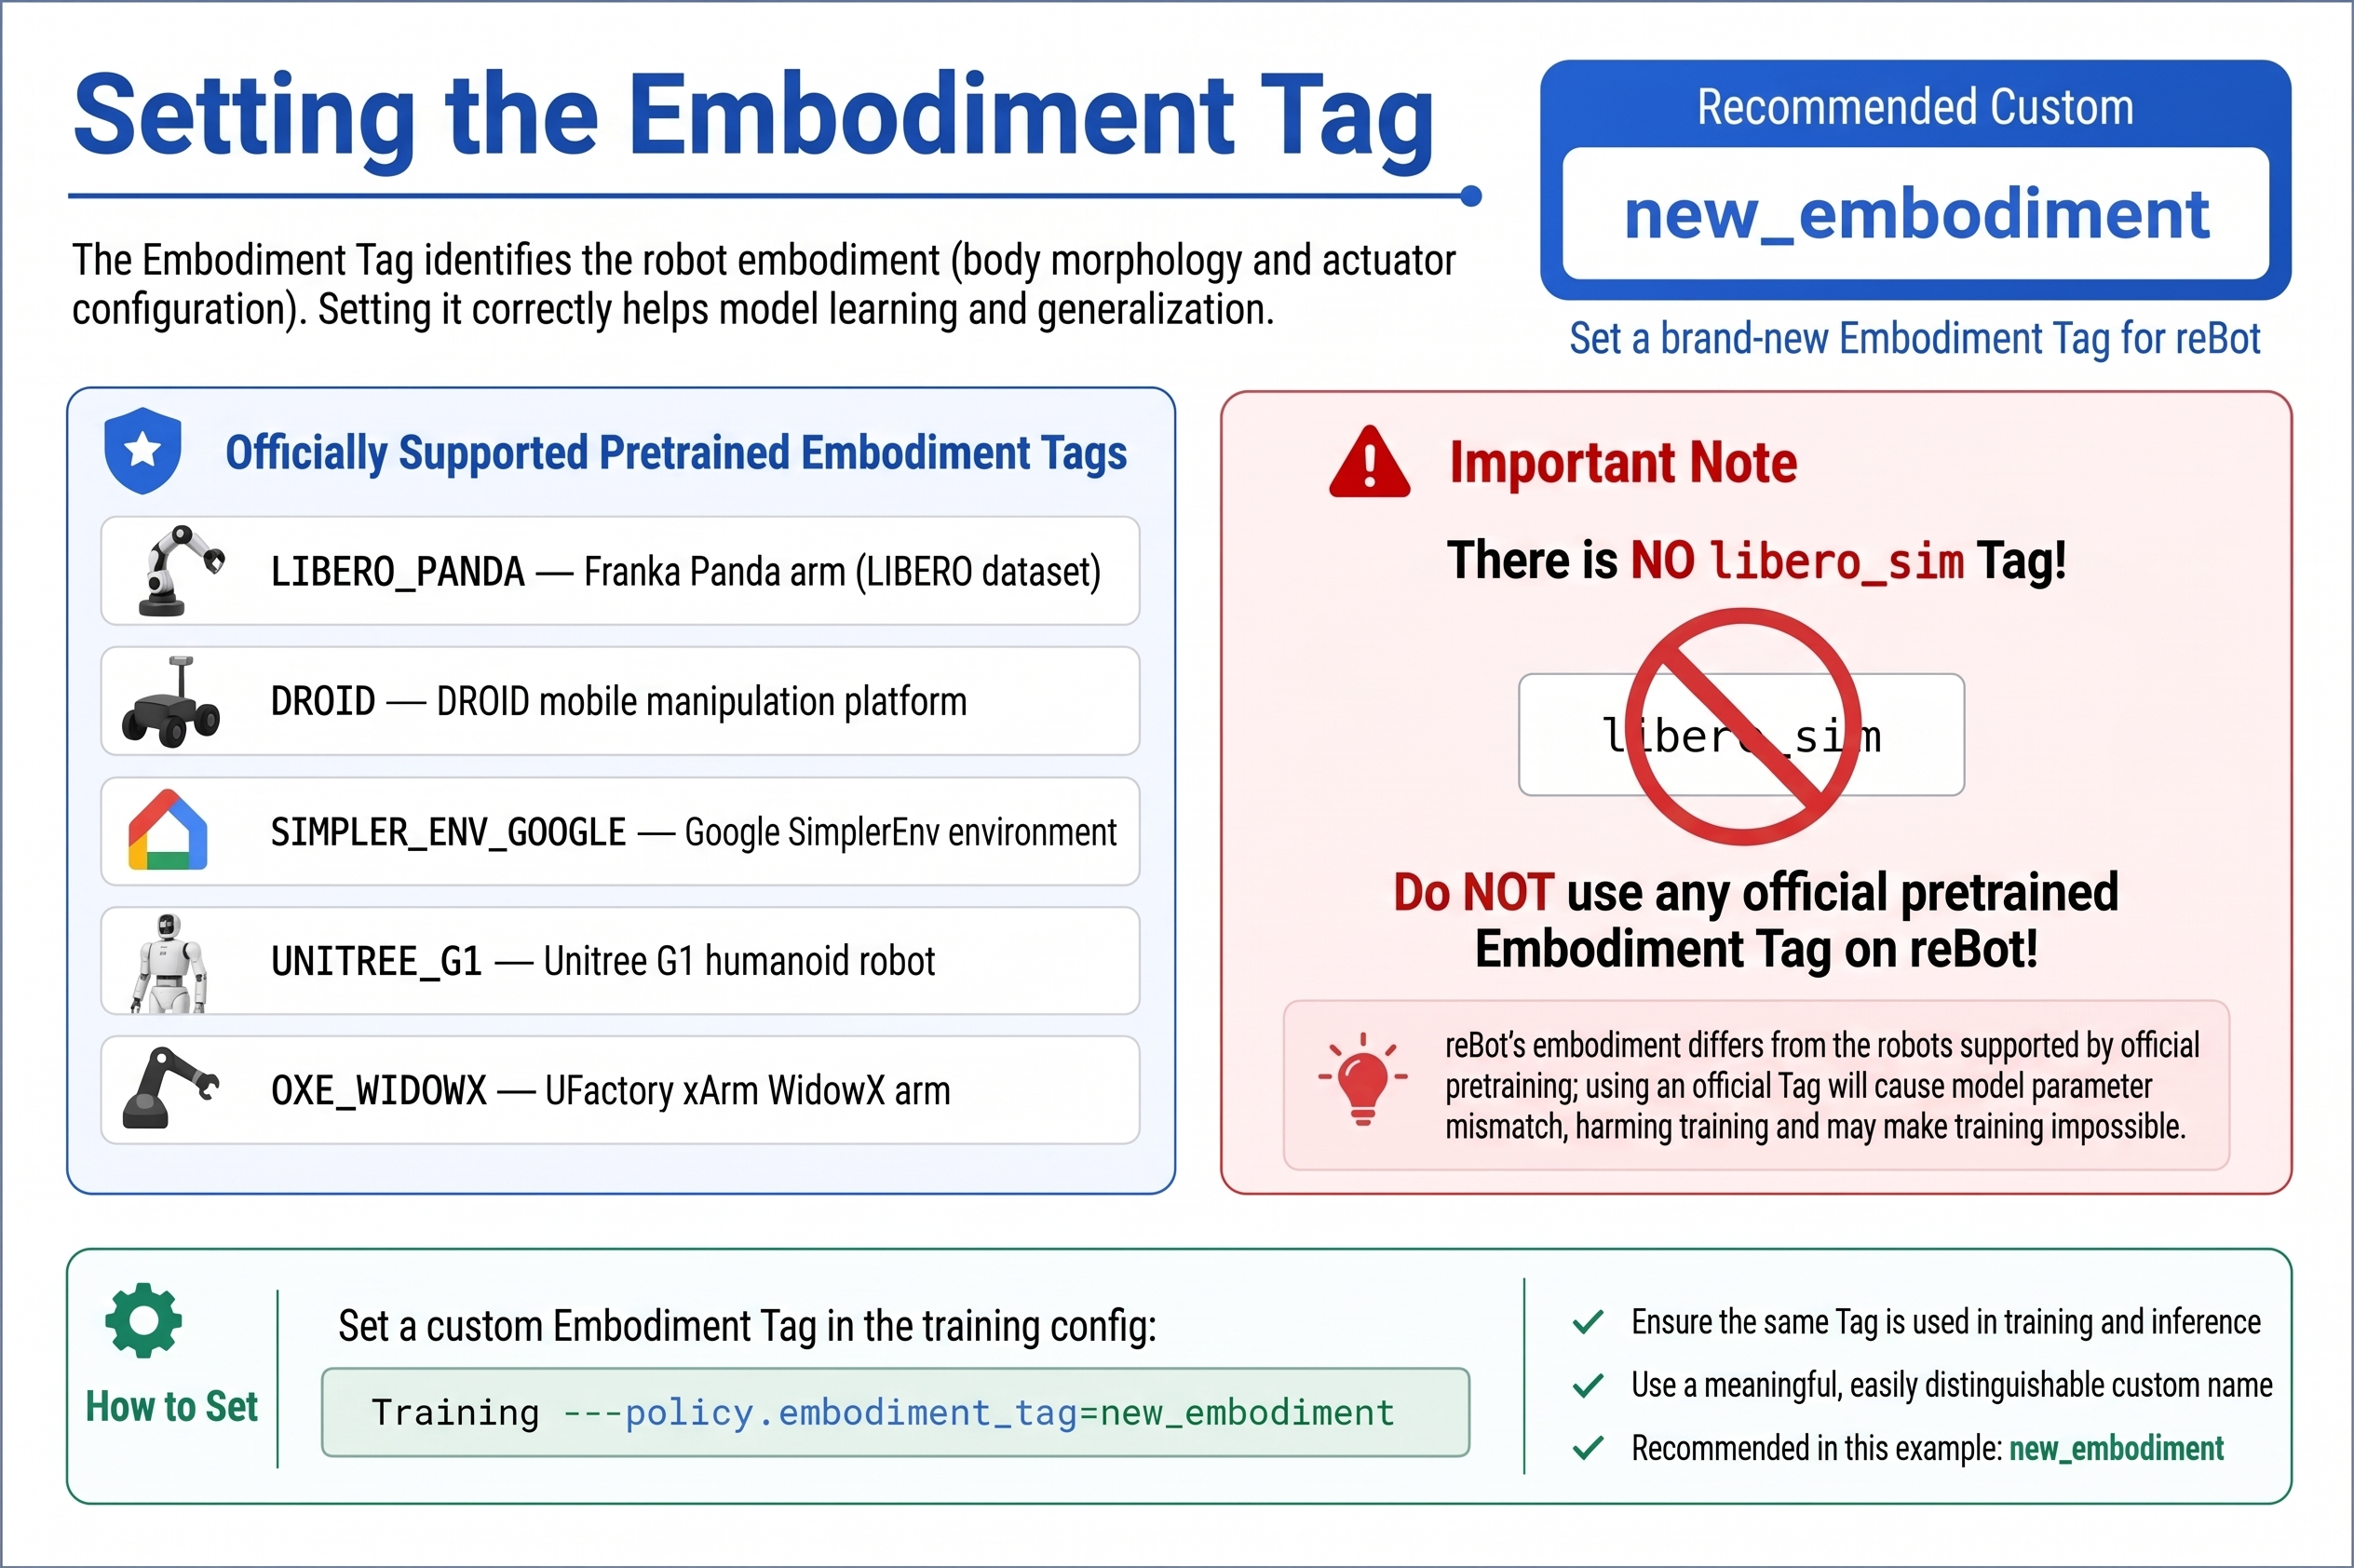
Para robôs personalizados como o reBot Arm, use a mesma configuração tanto para treinamento quanto para inferência:
embodiment_tag = new_embodiment
Significado:
- Diz ao GR00T para usar a camada de projeção de new-embodiment, sem reutilizar as dimensões de estado/ação do humanoide pré-treinado.
- Parâmetro de treinamento do LeRobot:
--policy.embodiment_tag=new_embodiment. - O checkpoint ajustado salva a configuração de modalidade correspondente, que é carregada automaticamente no momento da inferência.
Não use tags de pré-treinamento como LIBERO_PANDA, DROID, SIMPLER_ENV_GOOGLE em dados do reBot — suas dimensões e semânticas de estado/ação não correspondem ao reBot. Também não existe uma tag oficial chamada libero_sim.
20.8 Verificando a ordem das juntas e as dimensões dos dados
20.8 Verificando a ordem das juntas e as dimensões dos dados
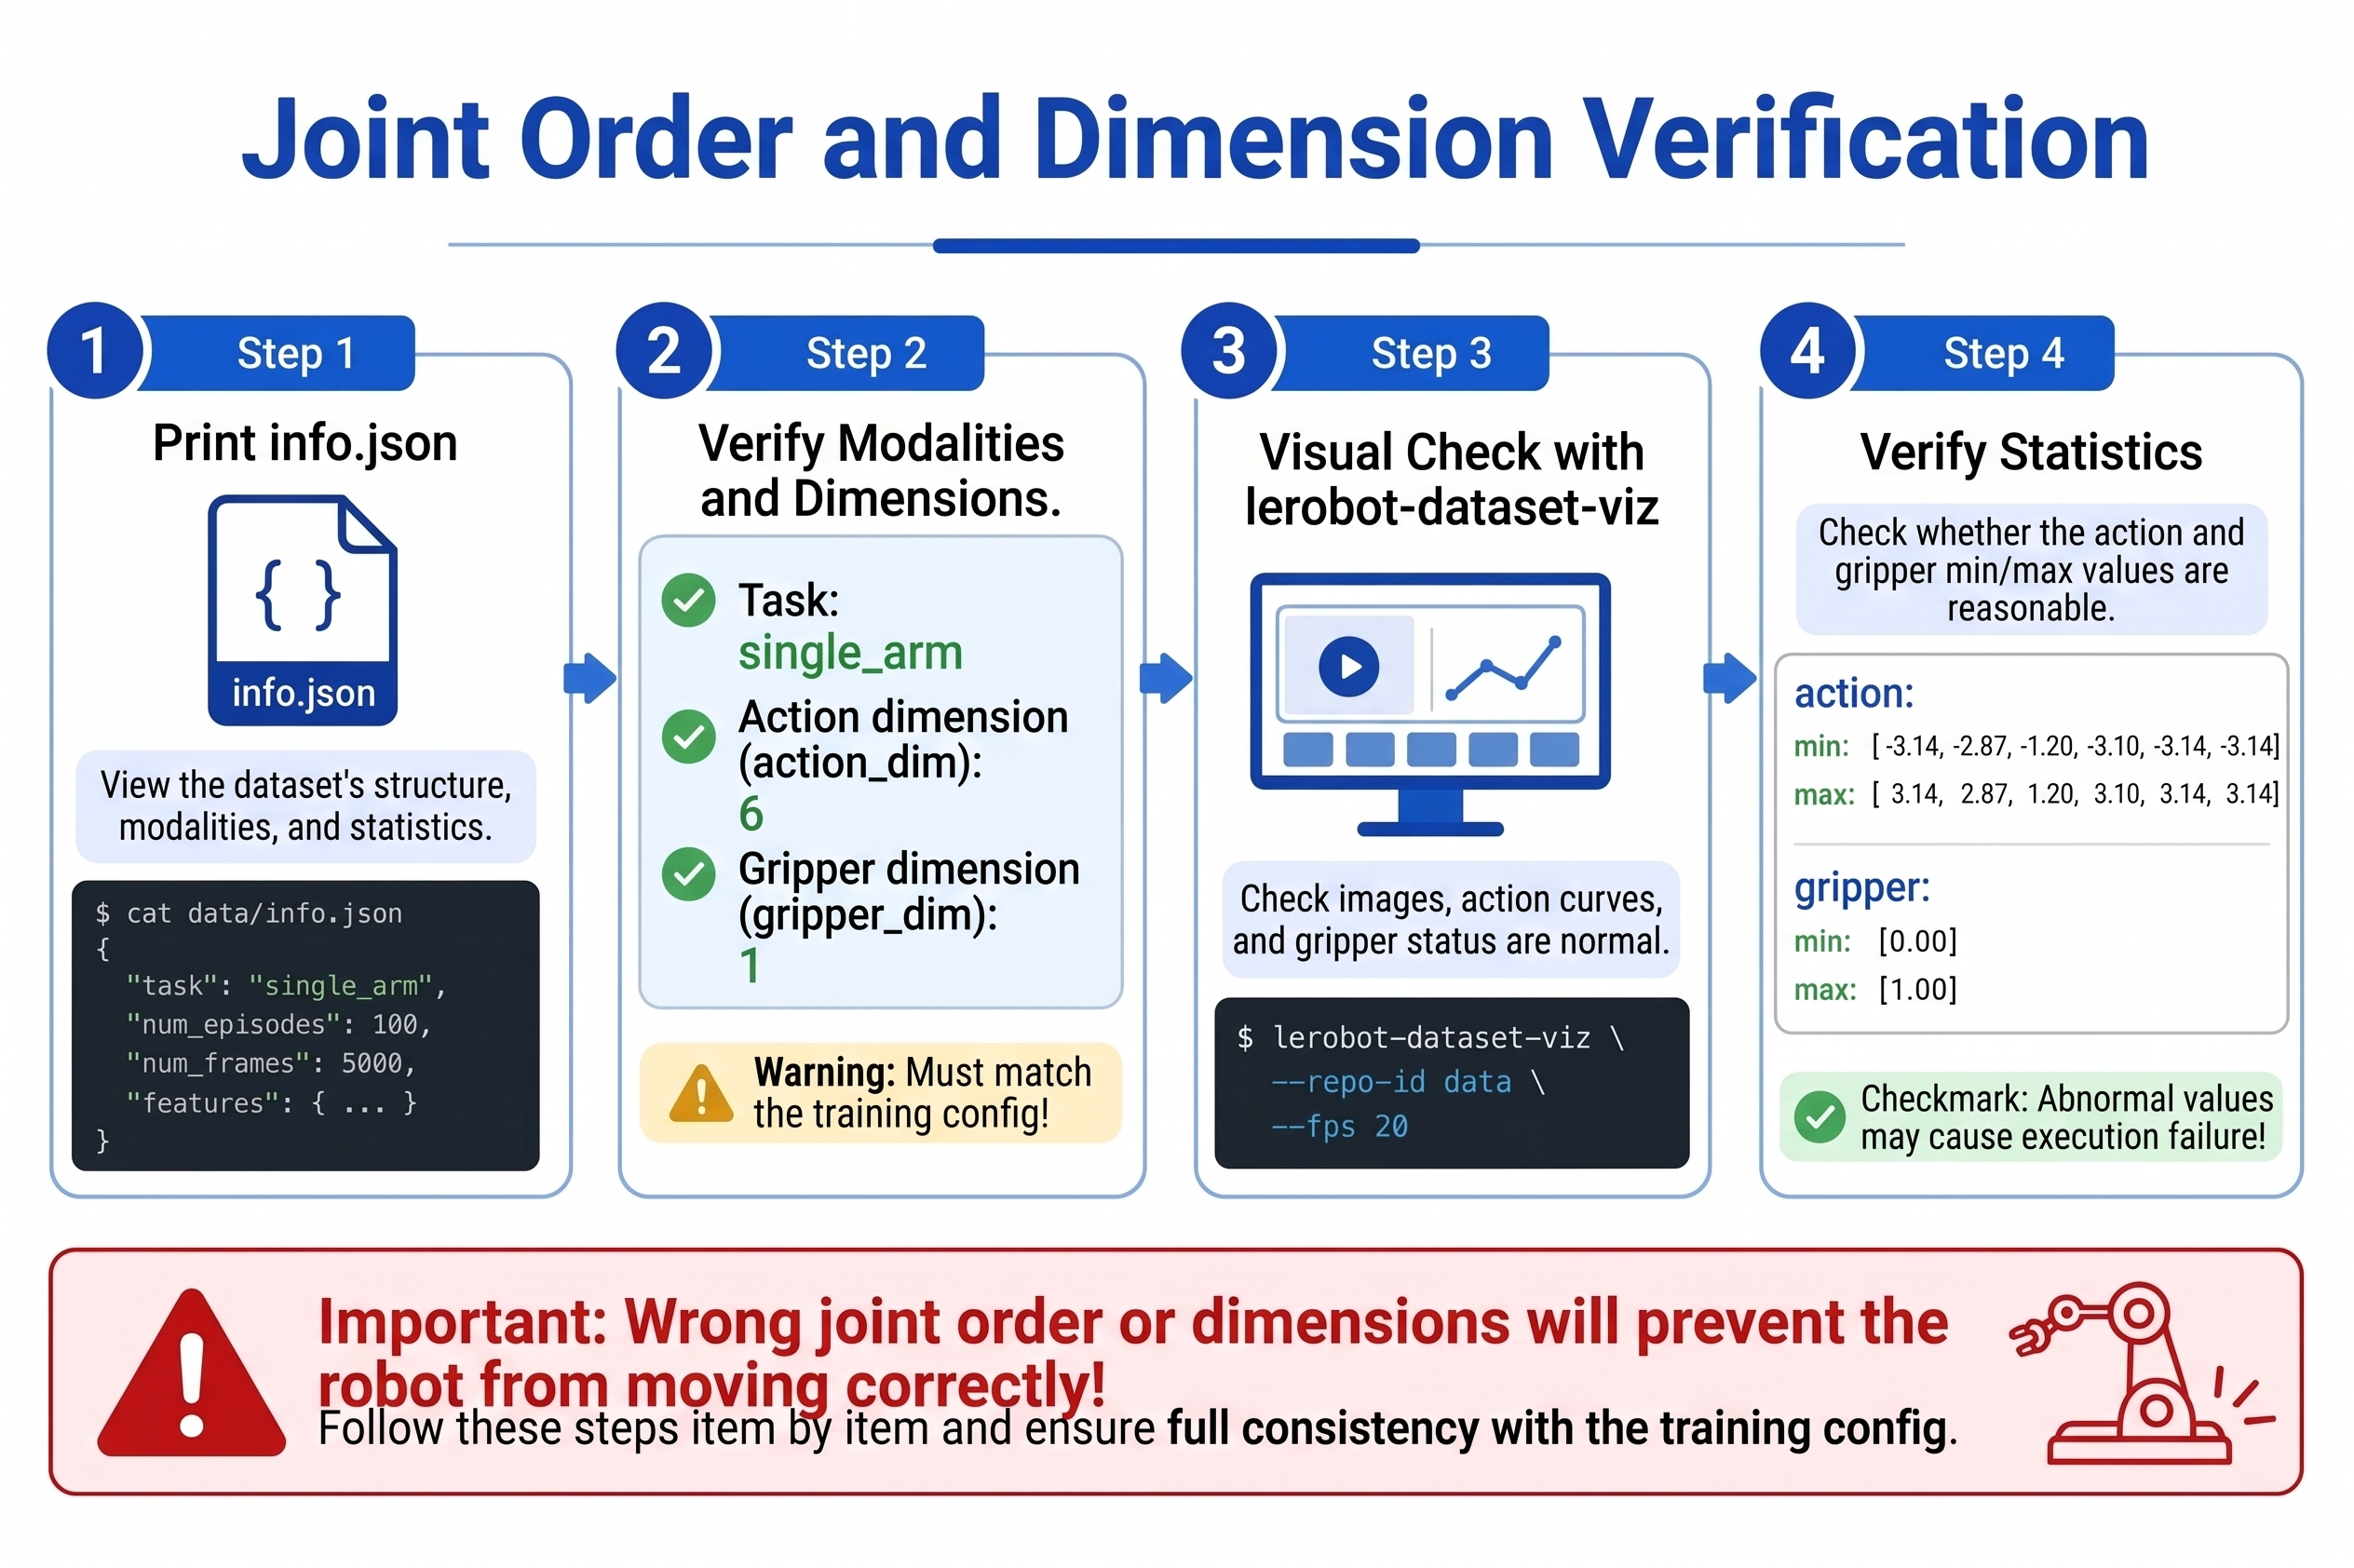
Esta é a causa mais comum de “a perda de treinamento diminui, mas o robô real não se move”. Verifique item por item:
Etapa 1: Imprimir meta do conjunto de dados
import json
from pathlib import Path

meta_dir = Path.home() / ".cache/huggingface/lerobot/seeed_rebot_b601_rs/pick_cube/meta"
print(json.dumps(json.loads((meta_dir / "info.json").read_text()), indent=2))
print((meta_dir / "modality.json").read_text())
Etapa 2: Verificar o fatiamento da modalidade
import numpy as np
from lerobot.datasets.lerobot_dataset import LeRobotDataset

ds = LeRobotDataset("seeed_rebot_b601_rs/pick_cube")
s = ds[0]["observation.state"].numpy()
mod = json.loads((meta_dir / "modality.json").read_text())

arm = s[mod["state"]["single_arm"]["start"]:mod["state"]["single_arm"]["end"]]
grip = s[mod["state"]["gripper"]["start"]:mod["state"]["gripper"]["end"]]
print("single_arm:", arm.shape)  # expect (6,)
print("gripper:", grip.shape)    # expect (1,)
Etapa 3: Visualizar os dados
lerobot-dataset-viz --repo_id=seeed_rebot_b601_rs/pick_cube --episode-index=0
Observe:
- As imagens estão sincronizadas com o movimento das juntas?
- A dimensão
grippermuda quando o gripper abre/fecha? - A descrição em linguagem corresponde ao conteúdo visual?
Etapa 4: Verificações estatísticas
print(ds.meta.stats["observation.state"])
print(ds.meta.stats["action"])
Se alguma dimensão tiver min == max (sem variação), aquela junta não se moveu nos dados; considere excluí-la do treinamento ou regravar.
20.9 Organização de conjuntos de dados multi-tarefa
20.9 Organização de conjuntos de dados multi-tarefa
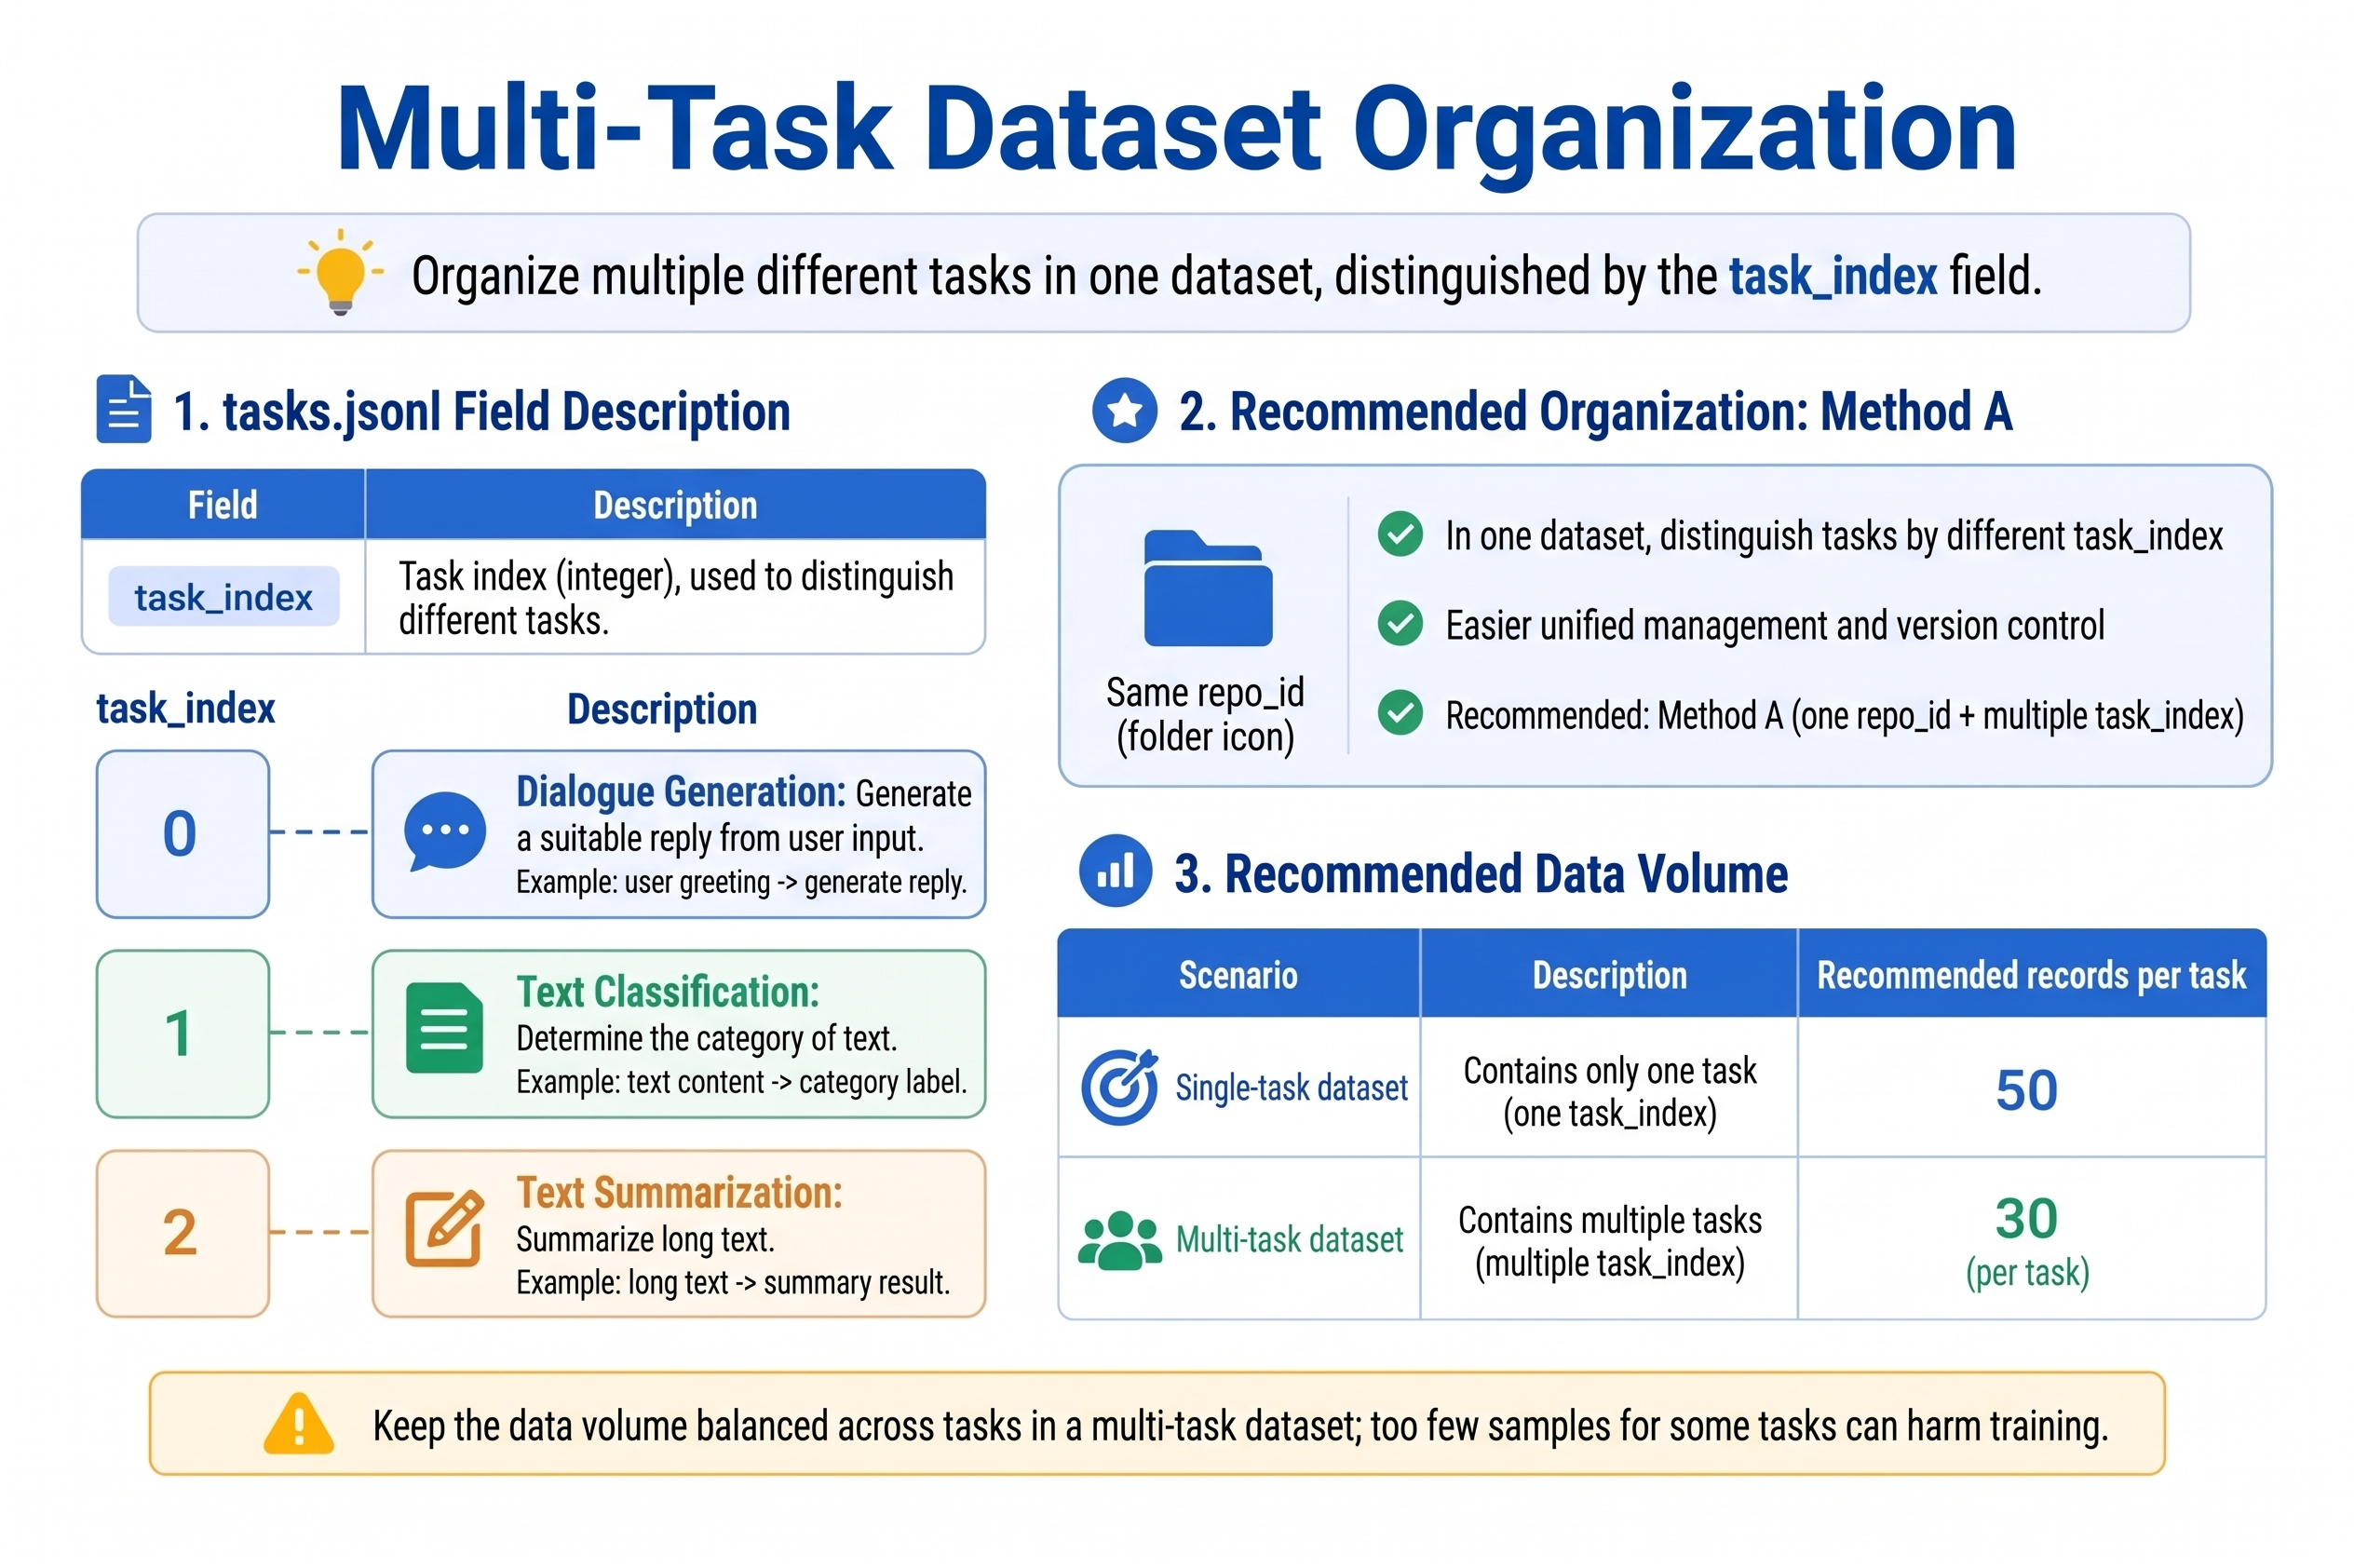
Para treinar “um modelo, múltiplas tarefas de linguagem”, duas abordagens são recomendadas:
Método A: Mesmo repo_id, múltiplos task_index (recomendado)
{"task_index": 0, "task": "put the black cube on the blue tray"}
{"task_index": 1, "task": "put the screwdriver into the toolbox"}
{"task_index": 2, "task": "push the red cup to the left side of the table"}
Alterne --dataset.single_task durante a gravação, ou grave em lotes e faça o merge no mesmo conjunto de dados.
Método B: Unir múltiplos conjuntos de dados
LeRobot oferece suporte a treinamento com múltiplos conjuntos de dados (dependendo da versão); a abordagem mais simples é usar um único repo_id durante a gravação e distinguir as tarefas por task_index.
Recomendações de volume de dados
| Cenário | Recomendação |
|---|---|
| Iniciante de tarefa única | 50 episódios |
| Tarefa única estável | 100-200 episódios |
| Multi-tarefa (3 tarefas) | ≥ 30 episódios cada |
| Generalização de posição | ≥ 10 episódios por variante de posição |
20.10 Checklist de qualidade dos dados
20.10 Checklist de qualidade dos dados
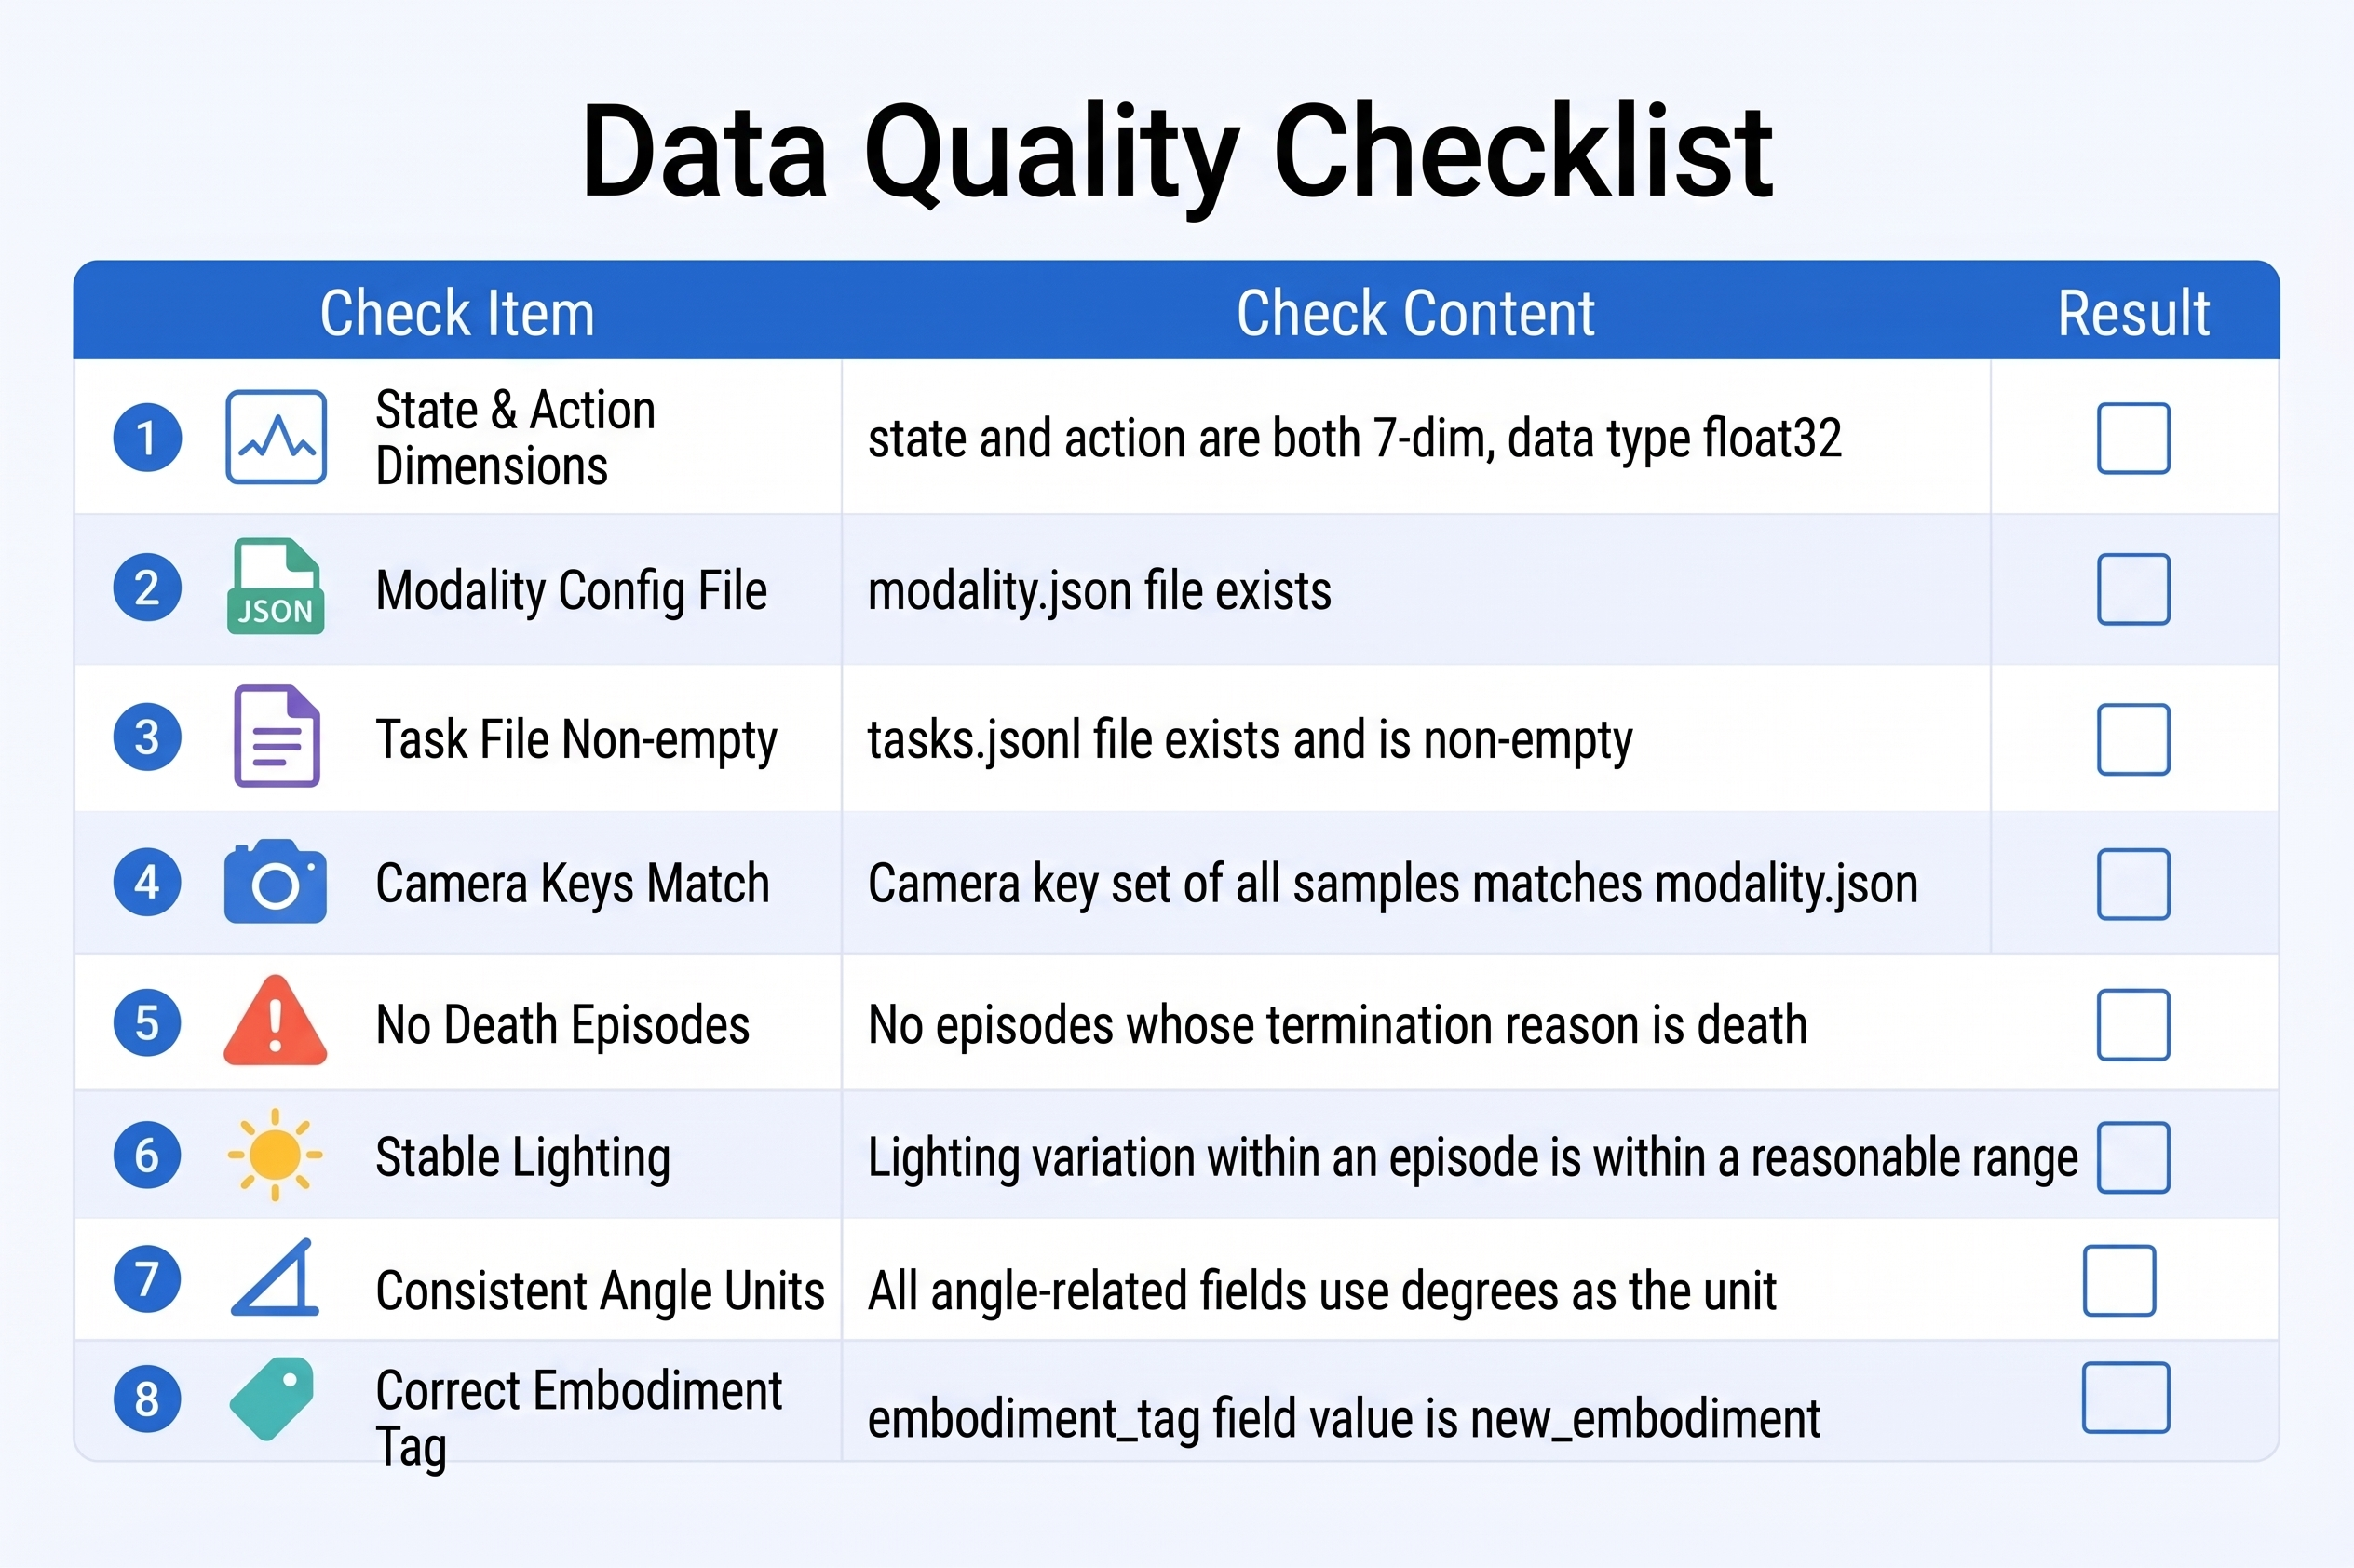
Antes de enviar para o Hub ou iniciar o treinamento, confirme:
-
observation.stateeactionsão ambos float32 de 7 dimensões -
meta/modality.jsonexiste e o fatiamento de índices está correto - Cada
task_indexemmeta/tasks.jsonltem uma descrição não vazia - Os nomes das chaves de câmera correspondem entre
modality.jsone o conjunto de dados - Nenhum episódio de desperdício totalmente zerado / ocioso
- Câmeras fixas, objetos no campo de visão, iluminação estável
- Unidades de ângulo unificadas (a API de motor de baixo nível do reBot usa graus; o driver do LeRobot converte internamente para radianos; o conjunto de dados e o treinamento/inferência devem permanecer consistentes)
- Planeja usar
new_embodimentparaembodiment_tag
Enviar para o Hugging Face Hub (opcional)
huggingface-cli login
lerobot-record ... --dataset.push_to_hub=true
# or upload manually
huggingface-cli upload ${HF_USER}/rebot_vla_pick_cube ~/.cache/huggingface/lerobot/seeed_rebot_b601_rs/pick_cube
20.11 Resumo do capítulo
20.11 Resumo do capítulo
- O GR00T precisa de dados padrão do LeRobot +
meta/modality.json. - O vetor de 7 dimensões do reBot é dividido em
single_arm(6) +gripper(1); RS / DM têm as mesmas dimensões, apenas os parâmetros do driver diferem. - A linguagem é conectada via
tasks.jsonl+annotation.human.task_description. - Os nomes das chaves de câmera devem estar alinhados entre gravação, modalidade e inferência.
- O próximo capítulo usa os dados preparados para iniciar
lerobot-train --policy.type=groot.