21. Ajuste fino do reBot Arm com Isaac GR00T
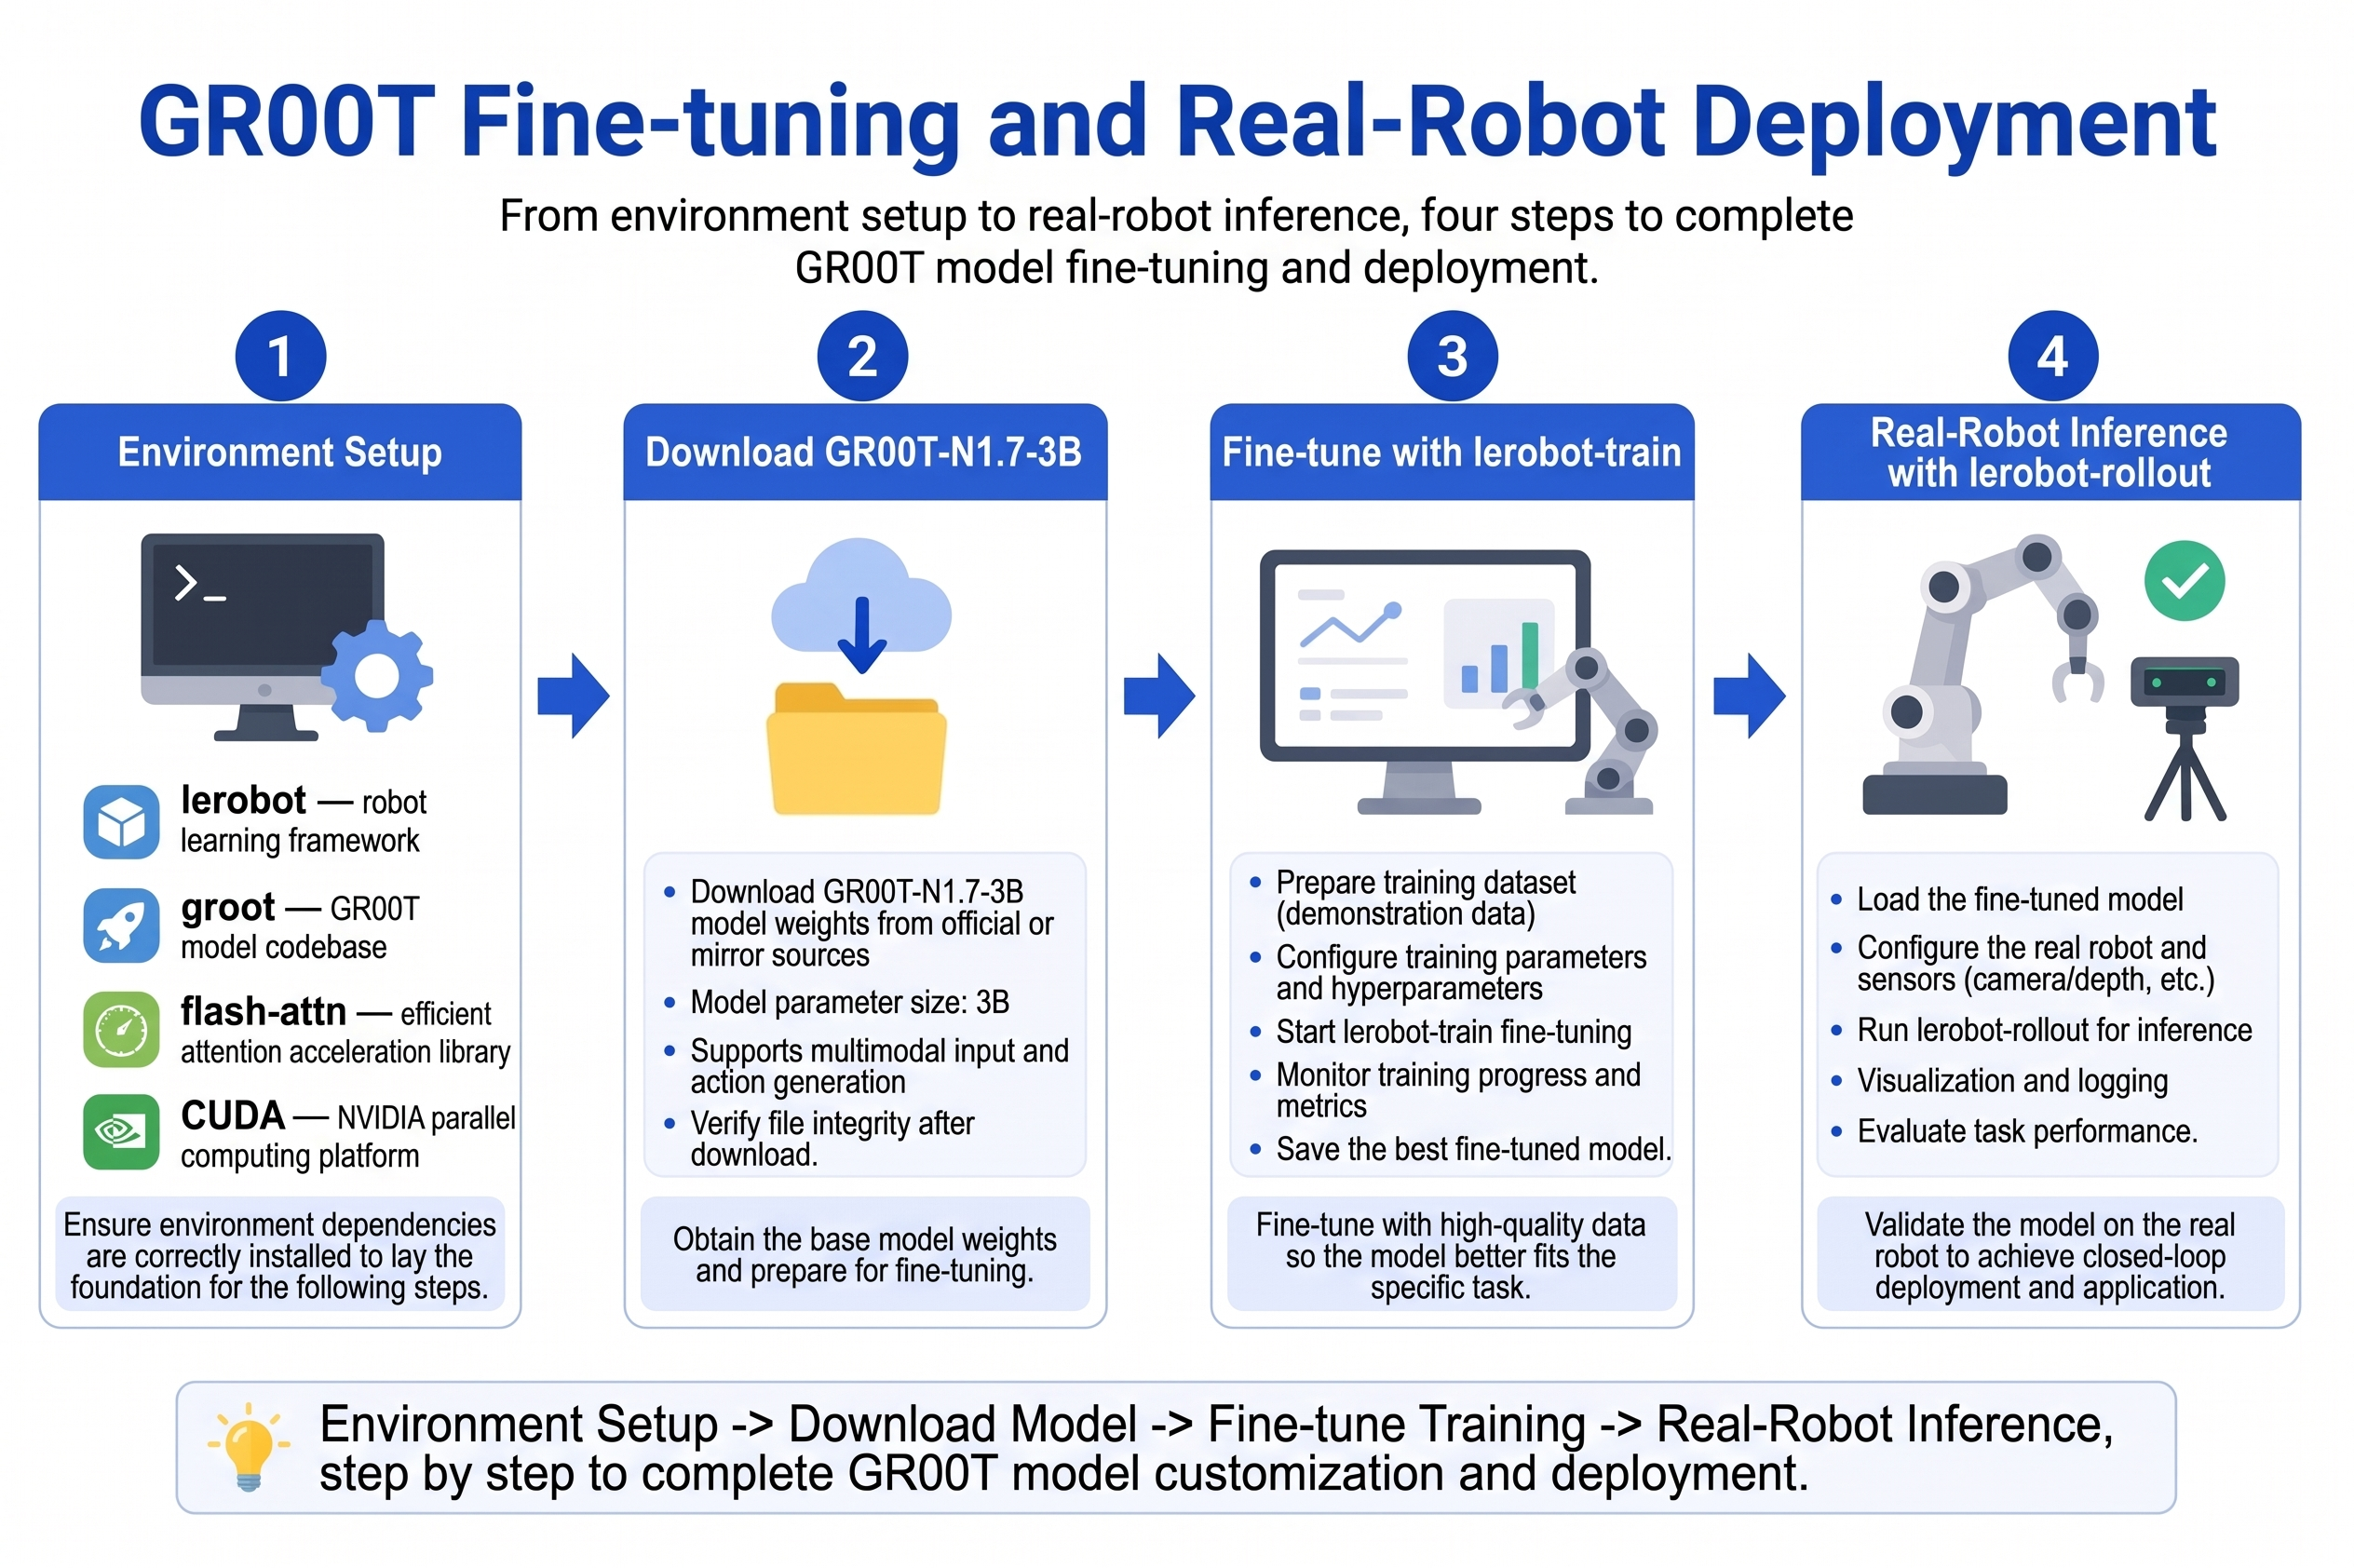
Capítulo 21 do Curso para Iniciantes em IA Física da Seeed — configuração do ambiente, download do modelo base, caminho do conjunto de dados, ajuste fino com GPU única e múltiplas GPUs, monitoramento de VRAM e loss, salvamento de checkpoints, inferência em robô real, solução de problemas e dicas de treinamento.
Este capítulo é baseado em LeRobot + GR00T N1.7 (nvidia/GR00T-N1.7-3B). Certifique-se de que o conjunto de dados do Capítulo 20 esteja pronto.
21.1 Configuração do ambiente
21.1 Configuração do ambiente
Hardware recomendado
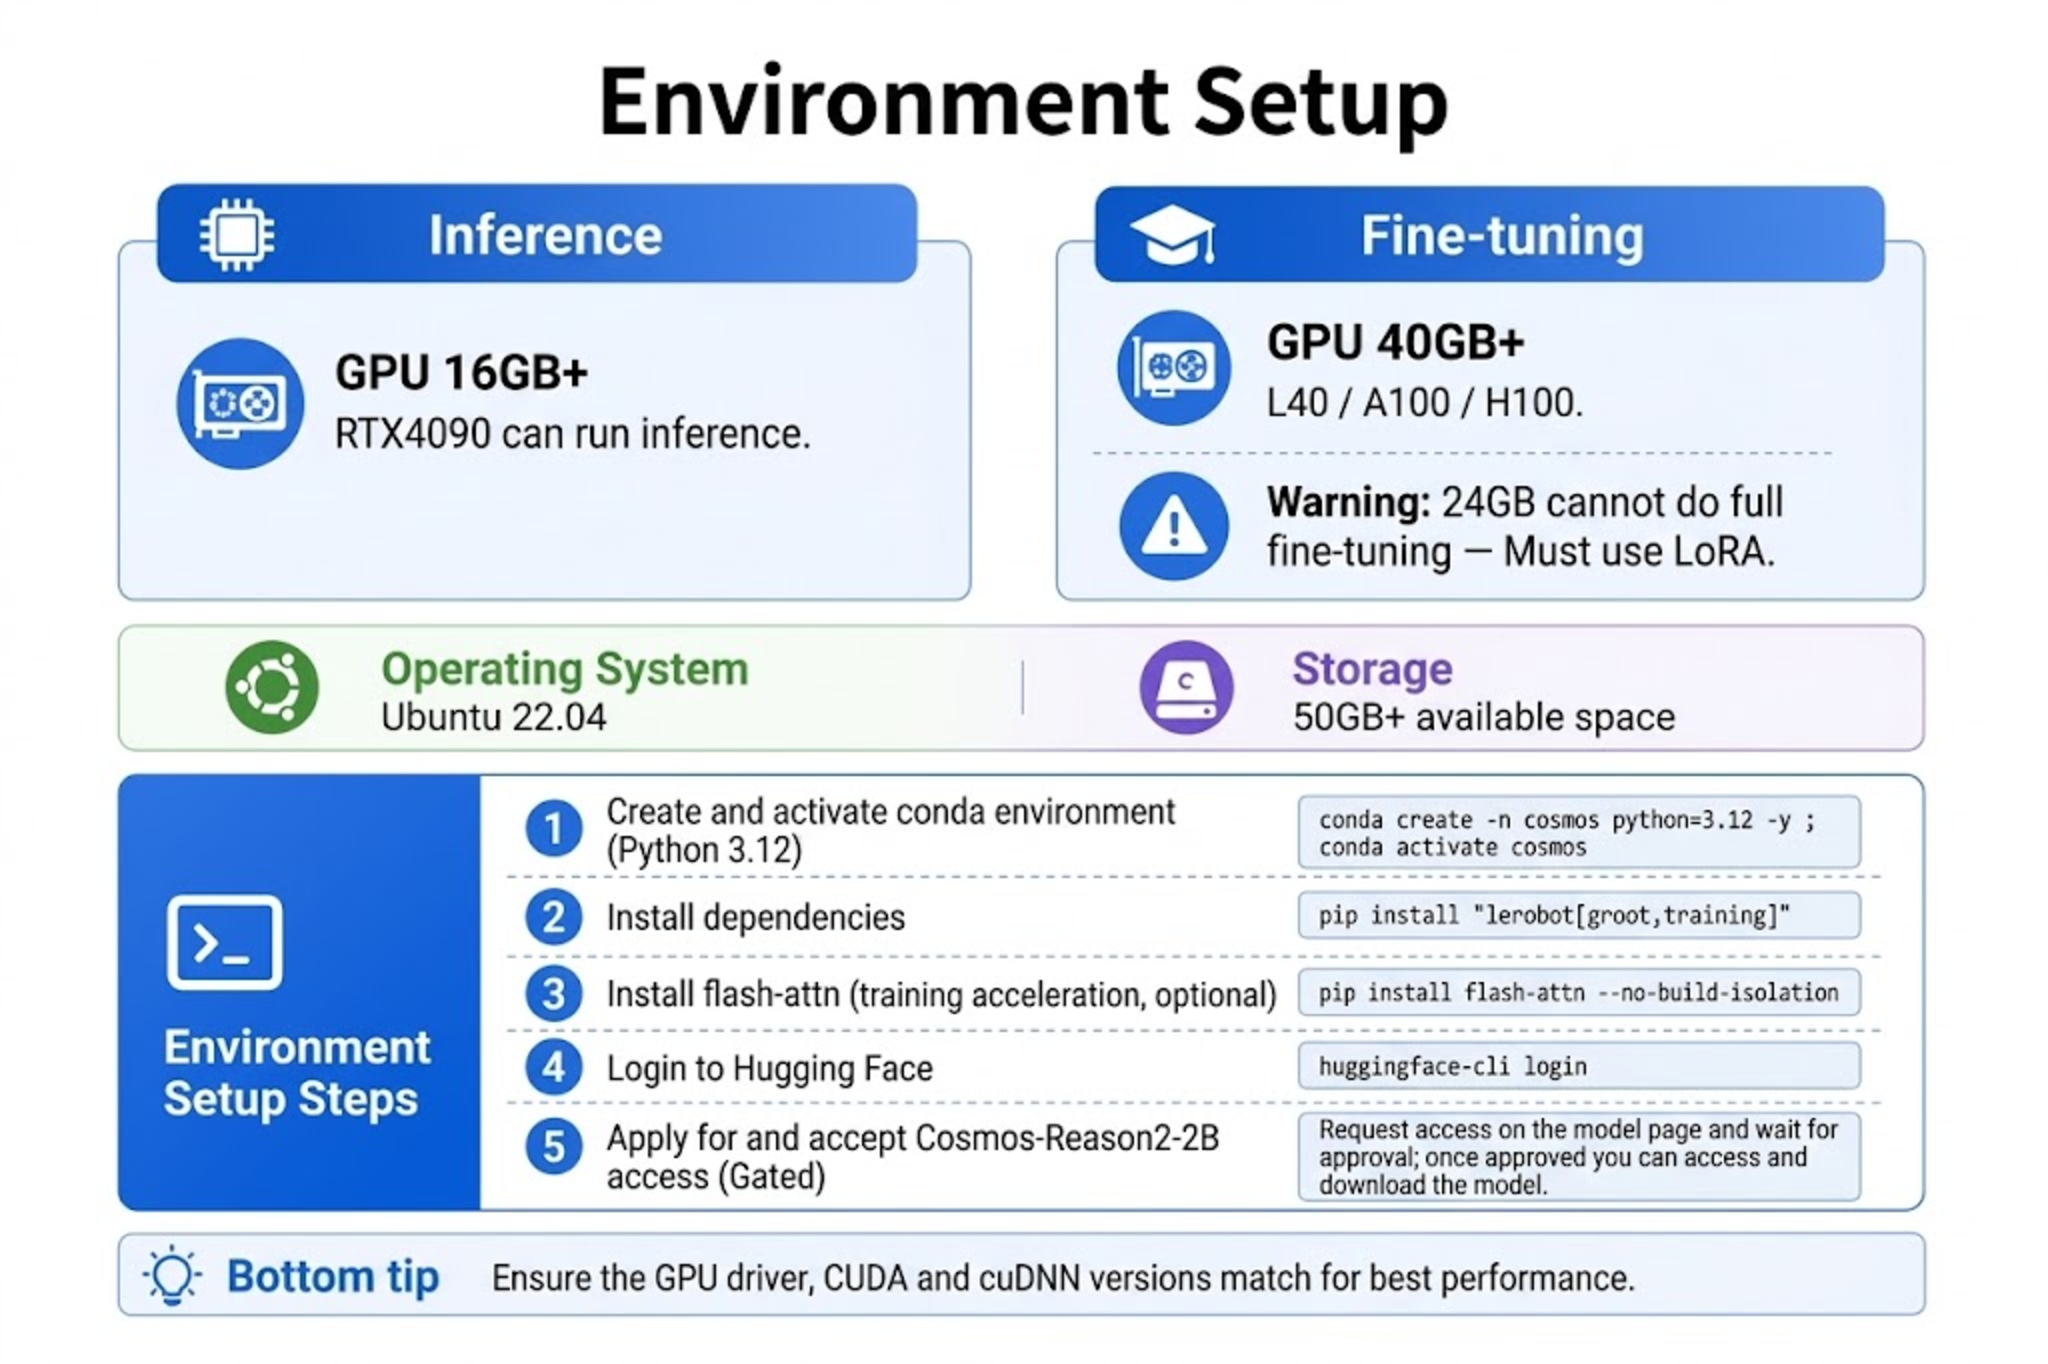
| Configuração | Mínimo para inferência | Recomendado para ajuste fino |
|---|---|---|
| GPU | 16 GB+ (RTX 4090 pode executar inferência) | 40 GB+ (L40 / A100 80GB / H100); o ajuste fino oficial em simulação requer ≥ 48 GB |
| Sistema | Linux (Ubuntu 22.04+) | Linux nativo ou WSL2 |
| Armazenamento | 50 GB de espaço livre | 100 GB+ (incluindo cache de modelo) |
GR00T requer uma GPU CUDA; treinamento apenas em CPU não é suportado. O ajuste fino padrão (projector + cabeça DiT) atinge um pico de cerca de 35 GB. RTX 4090 / 24 GB não consegue fazer ajuste fino completo e é adequada apenas para inferência; se você precisar treinar em 24 GB, use LoRA / PEFT (pip install "lerobot[peft]"), cujos resultados não são diretamente comparáveis ao ajuste fino completo oficial.
Instalando LeRobot e dependências do GR00T
Após criar um ambiente Python 3.12 conforme a documentação de instalação do LeRobot:
conda create -y -n lerobot python=3.12
conda activate lerobot

# Install ffmpeg (video decoding, Linux + TorchCodec)
conda install ffmpeg -c conda-forge

# Install LeRobot + GR00T + training tools
pip install "lerobot[groot,training]"
Flash Attention (Importante)
GR00T N1.7 depende de Flash Attention para aceleração. Recomenda-se instalar primeiro o PyTorch compatível com sua versão de CUDA e, em seguida, instalar o flash-attn:
# Example: CUDA 12.8 + PyTorch 2.7 (RTX 50 series can reference this combo)
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu128

pip install ninja "packaging>=24.2,<26.0"
pip install "flash-attn>=2.5.9,<3.0.0" --no-build-isolation

python -c "import flash_attn; print(f'Flash Attention {flash_attn.__version__} OK')"
Se a compilação do flash-attn falhar, causas comuns:
- Versões de PyTorch e CUDA incompatíveis -> reinstale o wheel correspondente.
- Ferramentas de compilação ausentes ->
sudo apt install build-essential. - VRAM/memória insuficiente -> feche outros processos de GPU e tente novamente.
Fazendo login no Hugging Face e W&B
huggingface-cli login
wandb login   # optional, for training curve visualization
21.2 Download do modelo base
21.2 Download do modelo base
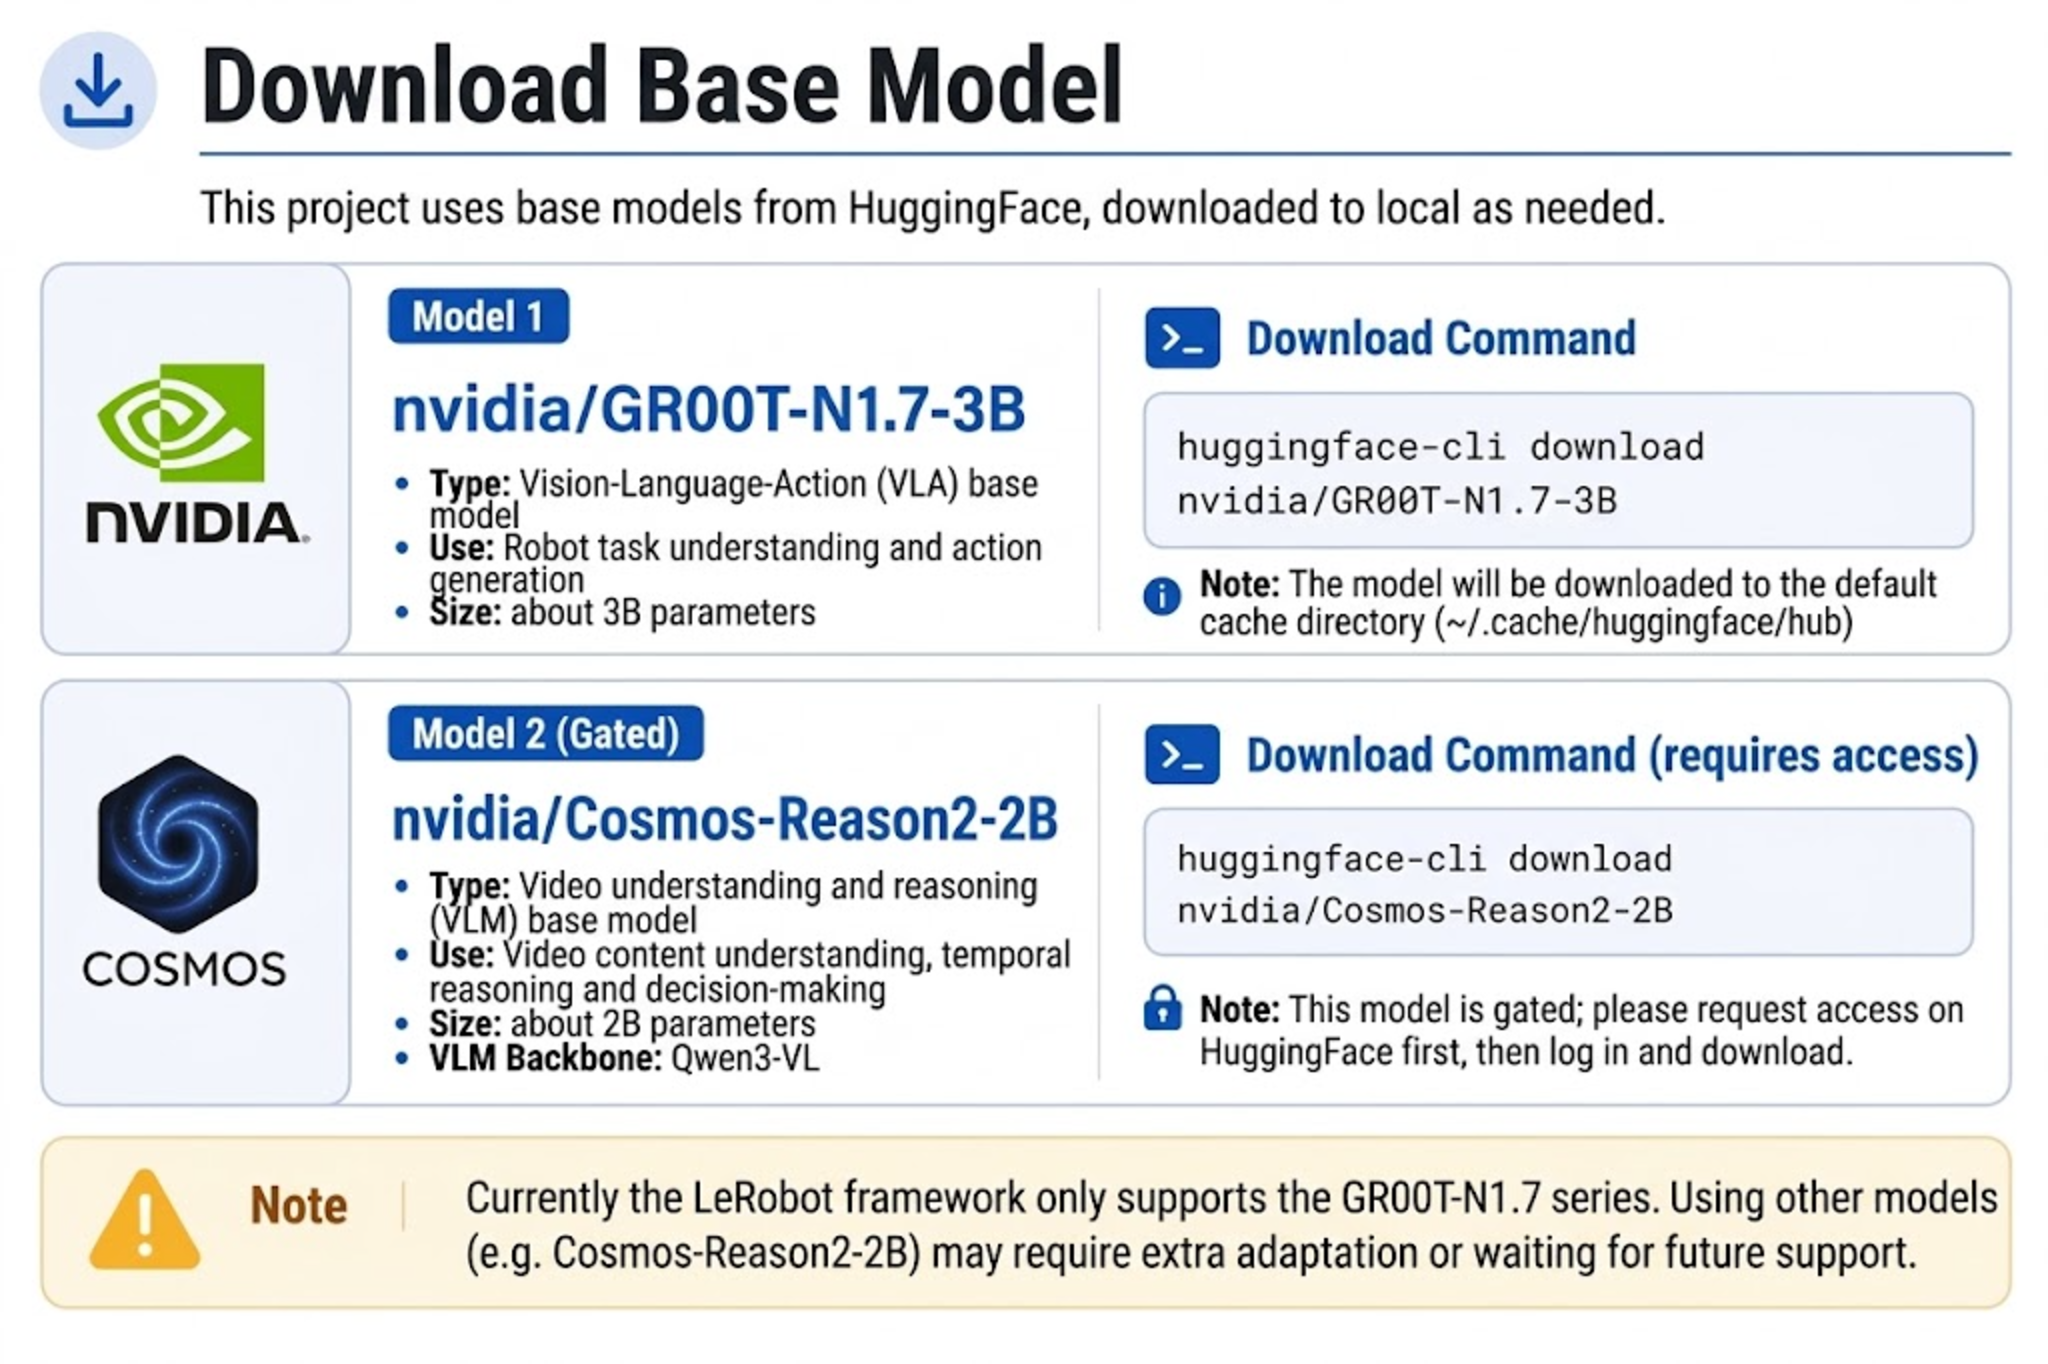
O modelo base está hospedado no Hugging Face:
nvidia/GR00T-N1.7-3B
No primeiro treinamento, o LeRobot faz o download automático para ~/.cache/huggingface/hub/. O backbone VLM do N1.7, nvidia/Cosmos-Reason2-2B, é um modelo restrito; você deve aceitar os termos no Hugging Face antes de executar huggingface-cli login. Você também pode fazer o pré-download manualmente:
huggingface-cli download nvidia/GR00T-N1.7-3B --local-dir ./models/GR00T-N1.7-3B
huggingface-cli download nvidia/Cosmos-Reason2-2B
Especifique nos argumentos de treinamento:
--policy.base_model_path=nvidia/GR00T-N1.7-3B
O LeRobot atual só oferece suporte ao GR00T N1.7. N1.5 requer fixar a versão antiga lerobot==0.5.1, o que não é abordado neste tutorial.
21.3 Configurando o caminho do conjunto de dados
21.3 Configurando o caminho do conjunto de dados
Conjunto de dados local
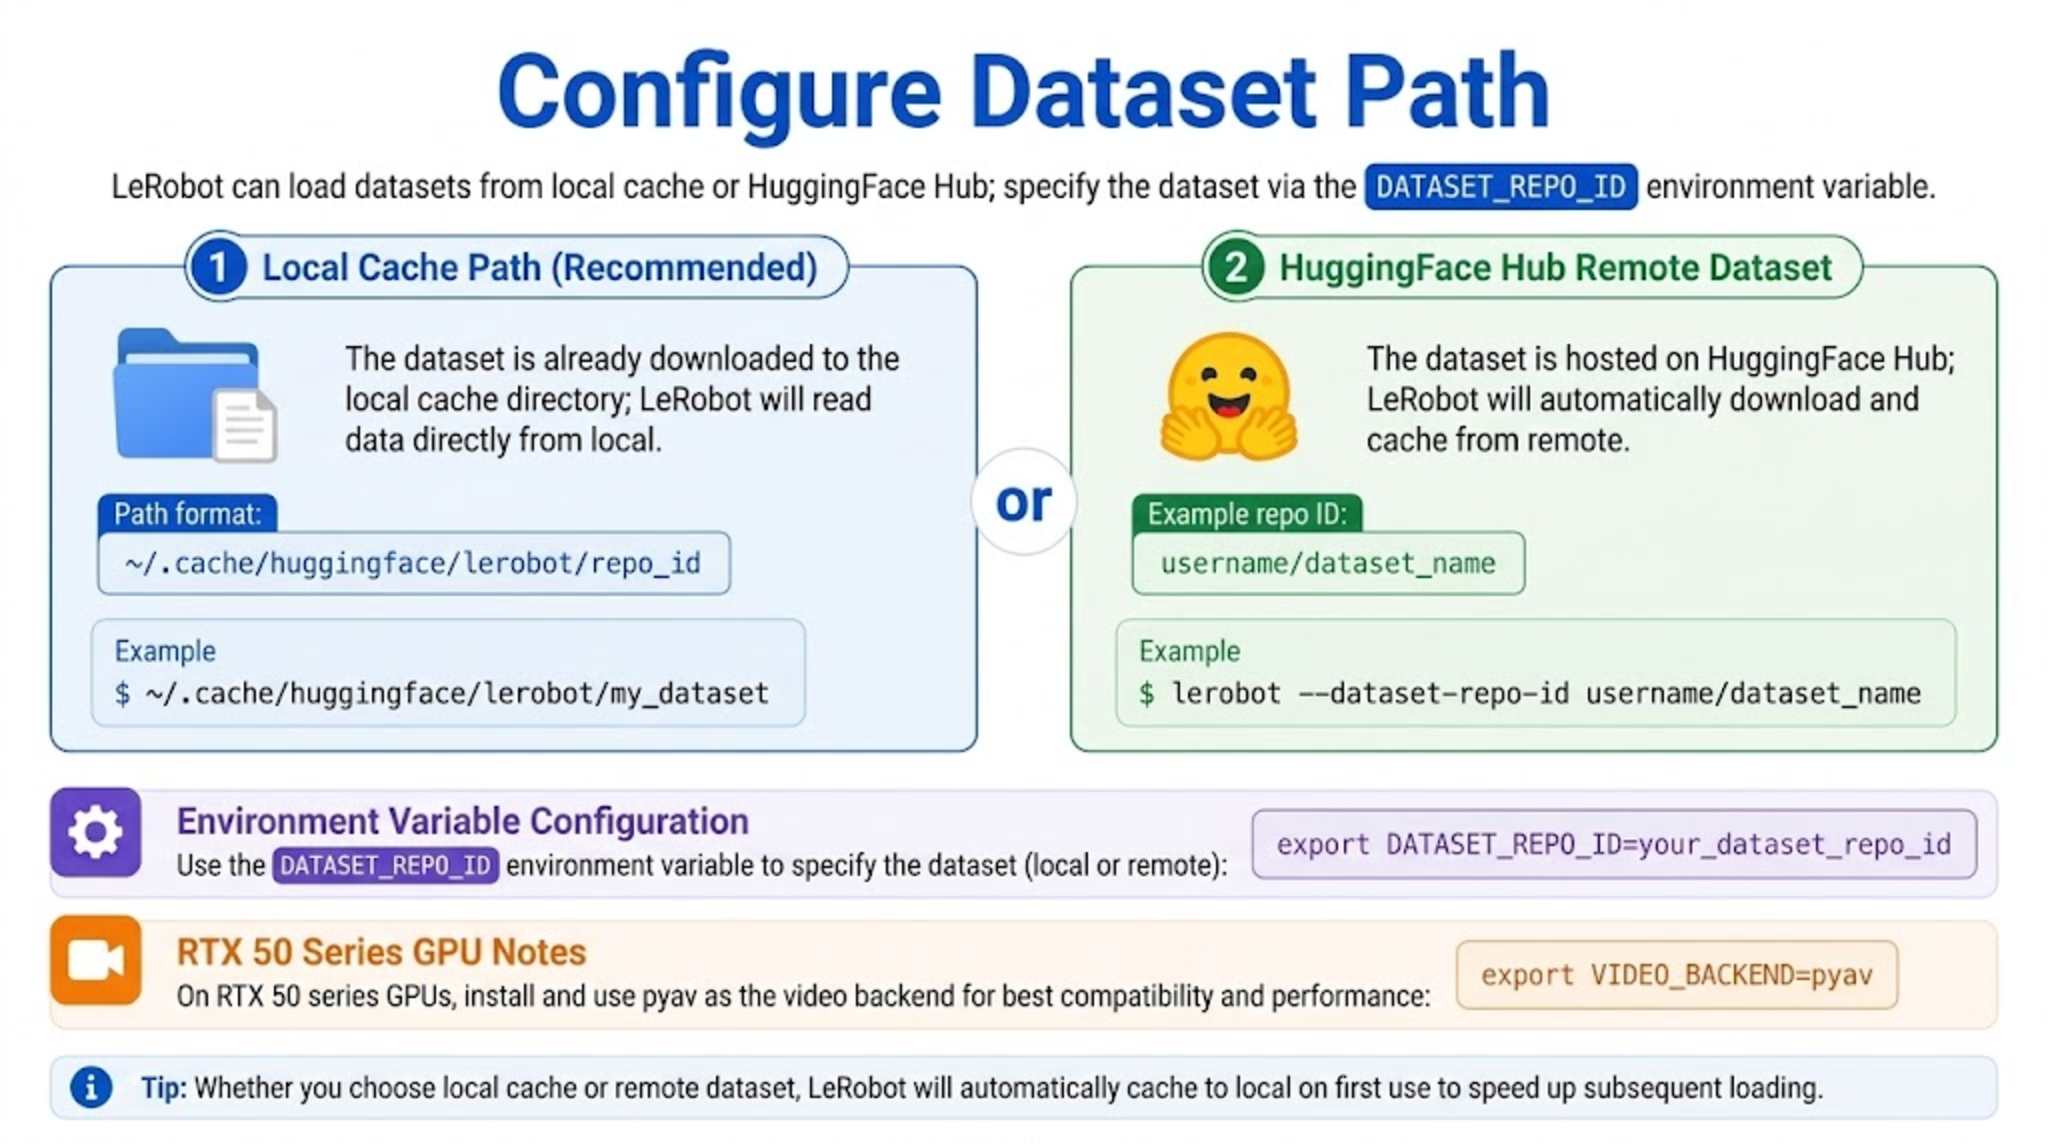
Se os dados estiverem no cache local (não enviados para o Hub), repo_id deve corresponder ao usado durante a gravação:
export DATASET_REPO_ID="seeed_rebot_b601_rs/pick_cube" # for DM: seeed_rebot_b601_dm/pick_cube
O LeRobot carrega automaticamente de ~/.cache/huggingface/lerobot/.
Conjunto de dados no Hub
export HF_USER="your_hf_username"
export DATASET_REPO_ID="${HF_USER}/rebot_vla_pick_cube"
Certifique-se de que o conjunto de dados no Hub inclua meta/modality.json (criado no Capítulo 20).
21.4 Iniciando o ajuste fino com GPU única
21.4 Iniciando o ajuste fino com GPU única
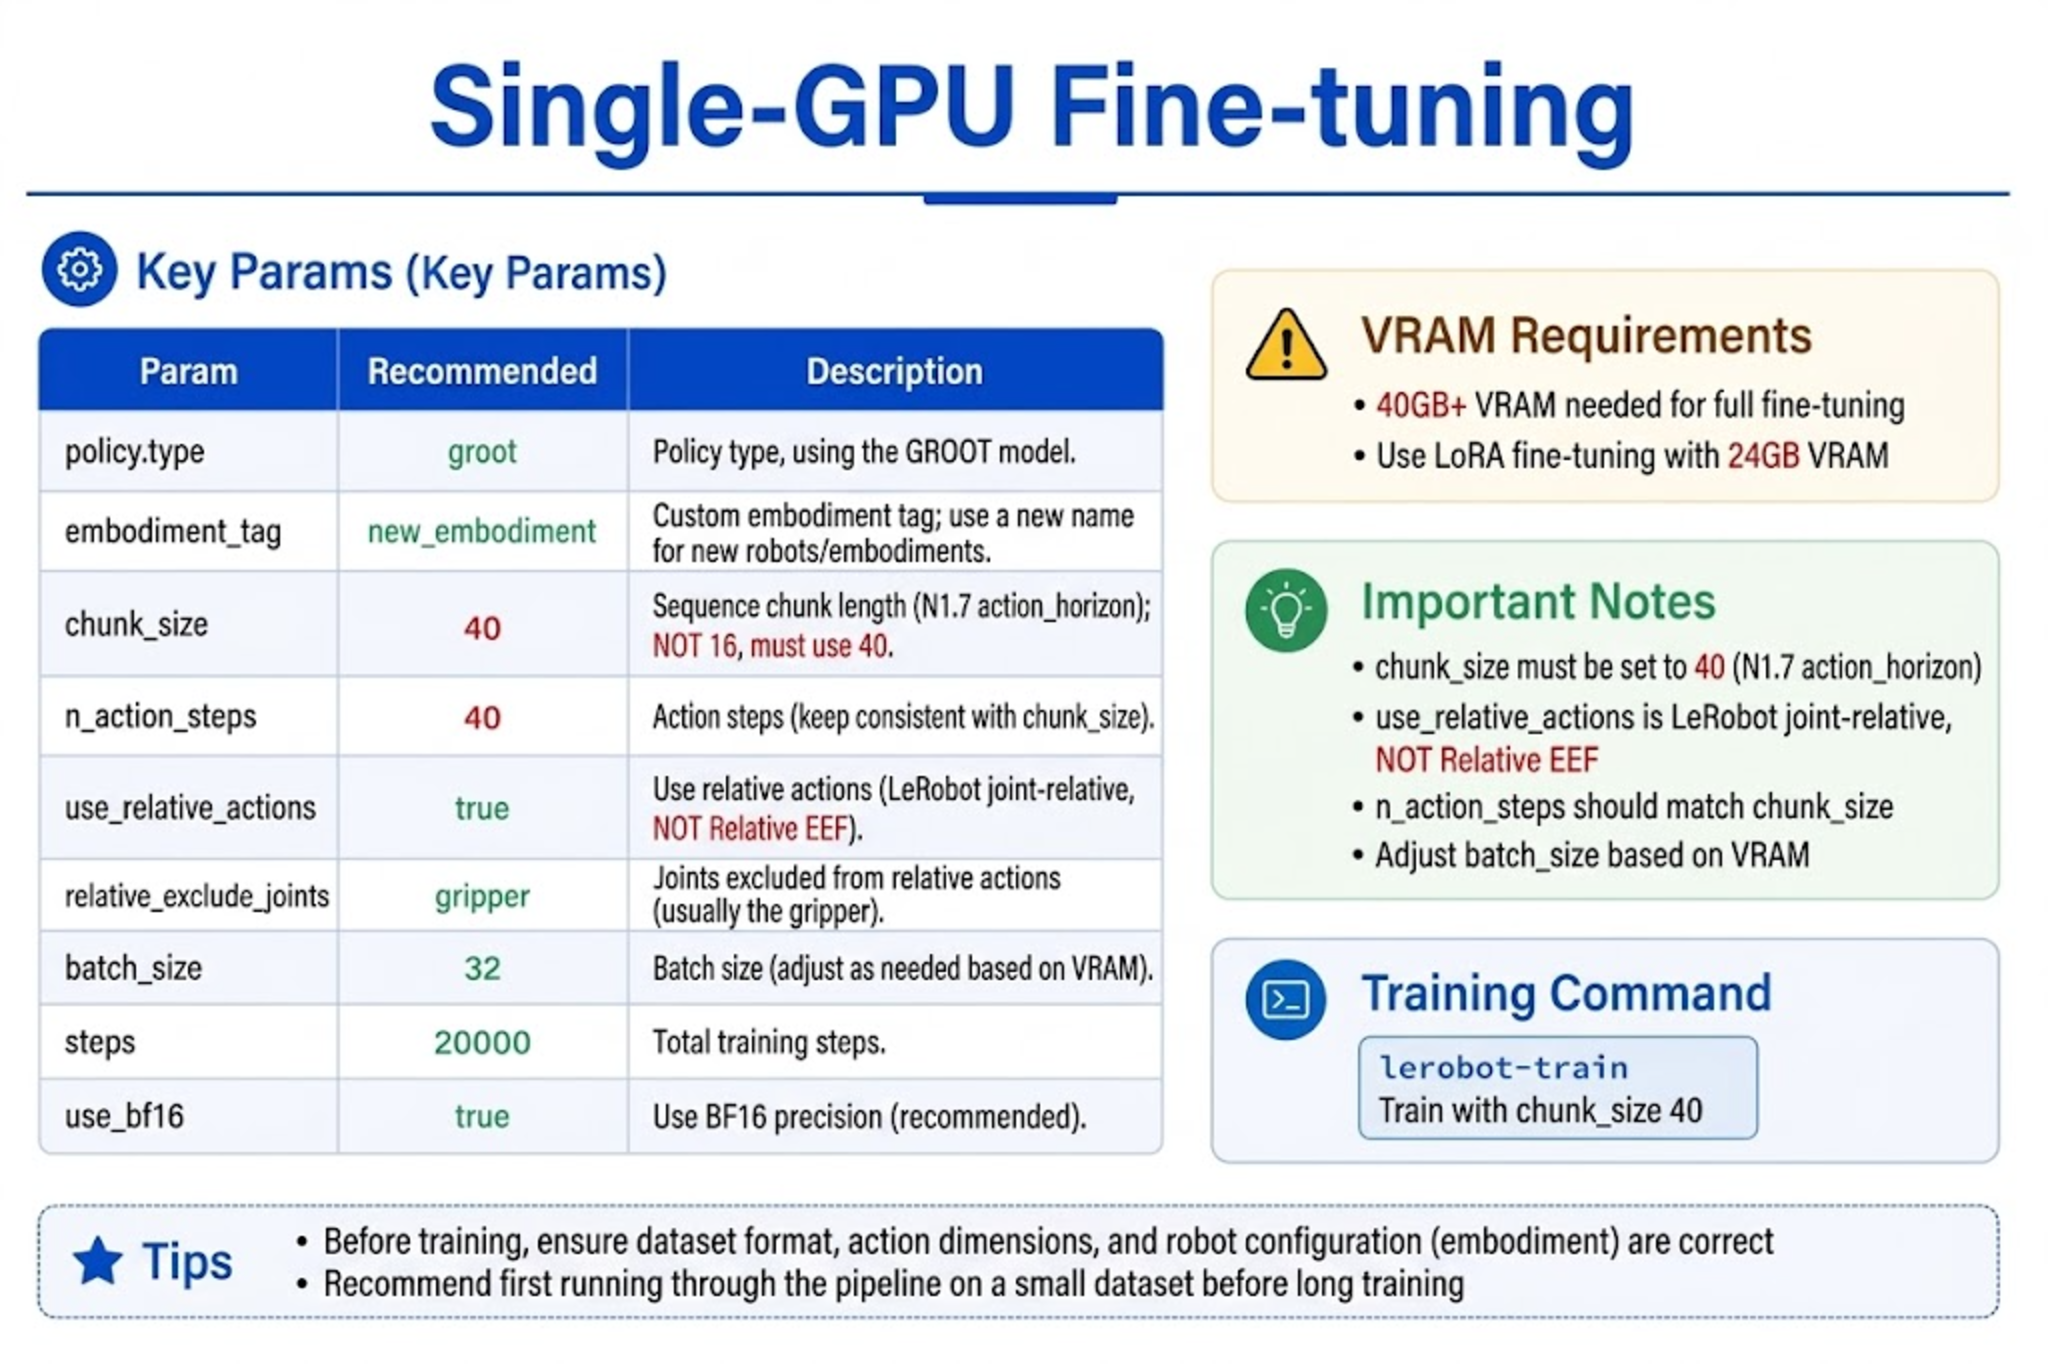
O comando a seguir tem como alvo o reBot Arm braço único, new_embodiment (substitua o repo_id do conjunto de dados para RS/DM). chunk_size=40 está alinhado com o action_horizon oficial do N1.7; o código-fonte groot do LeRobot usa 50 por padrão, ambos bem maiores que 16 do N1.5/N1.6 — não use 16.
export HF_USER="your_hf_username"
export DATASET_REPO_ID="seeed_rebot_b601_rs/pick_cube"   # local or Hub; for DM use b601_dm
export REPO_ID="${HF_USER}/rebot_groot17_pick_cube"      # uploaded model name after fine-tuning
export OUTPUT_DIR="outputs/train/${REPO_ID}"

lerobot-train \
  --dataset.repo_id=${DATASET_REPO_ID} \
  --dataset.image_transforms.enable=true \
  --policy.type=groot \
  --policy.device=cuda \
  --policy.base_model_path=nvidia/GR00T-N1.7-3B \
  --policy.embodiment_tag=new_embodiment \
  --policy.chunk_size=40 \
  --policy.n_action_steps=40 \
  --policy.use_relative_actions=true \
  --policy.relative_exclude_joints='["gripper"]' \
  --policy.use_bf16=true \
  --policy.push_to_hub=true \
  --policy.repo_id=${REPO_ID} \
  --seed=42 \
  --batch_size=32 \
  --steps=20000 \
  --save_checkpoint=true \
  --save_freq=5000 \
  --use_policy_training_preset=true \
  --env_eval_freq=0 \
  --eval_steps=0 \
  --log_freq=10 \
  --output_dir=${OUTPUT_DIR} \
  --job_name=rebot_groot_finetune \
  --wandb.enable=true \
  --wandb.disable_artifact=true
Parâmetros principais
| Parâmetro | Valor | Descrição |
|---|---|---|
--policy.type | groot | Usar a política GR00T |
--policy.embodiment_tag | new_embodiment | Embodiment personalizado do reBot |
--policy.chunk_size | 40 | Alinhado com N1.7 action_horizon=40 (não use 16) |
--policy.n_action_steps | 40 | Normalmente corresponde ao chunk durante o treinamento; pode ser reduzido na inferência |
--policy.use_relative_actions | true | Pré-processamento relativo de juntas do LeRobot, não EEF relativo |
--policy.relative_exclude_joints | ["gripper"] | Manter o gripper em controle absoluto |
--policy.use_bf16 | true | Precisão mista, economiza VRAM |
--batch_size | 32 (ajustável) | 32 em uma placa de 40 GB; reduza para 8 ou 16 se ocorrer OOM |
--steps | 20000 | Passos de ajuste fino; pode ser reduzido para 10000 com poucos dados |
--save_freq | 5000 | Salvar um checkpoint a cada 5000 passos |
Para salvar apenas localmente sem enviar para o Hub:
--policy.push_to_hub=false
21.5 Iniciando o ajuste fino com múltiplas GPUs
21.5 Iniciando o ajuste fino com múltiplas GPUs
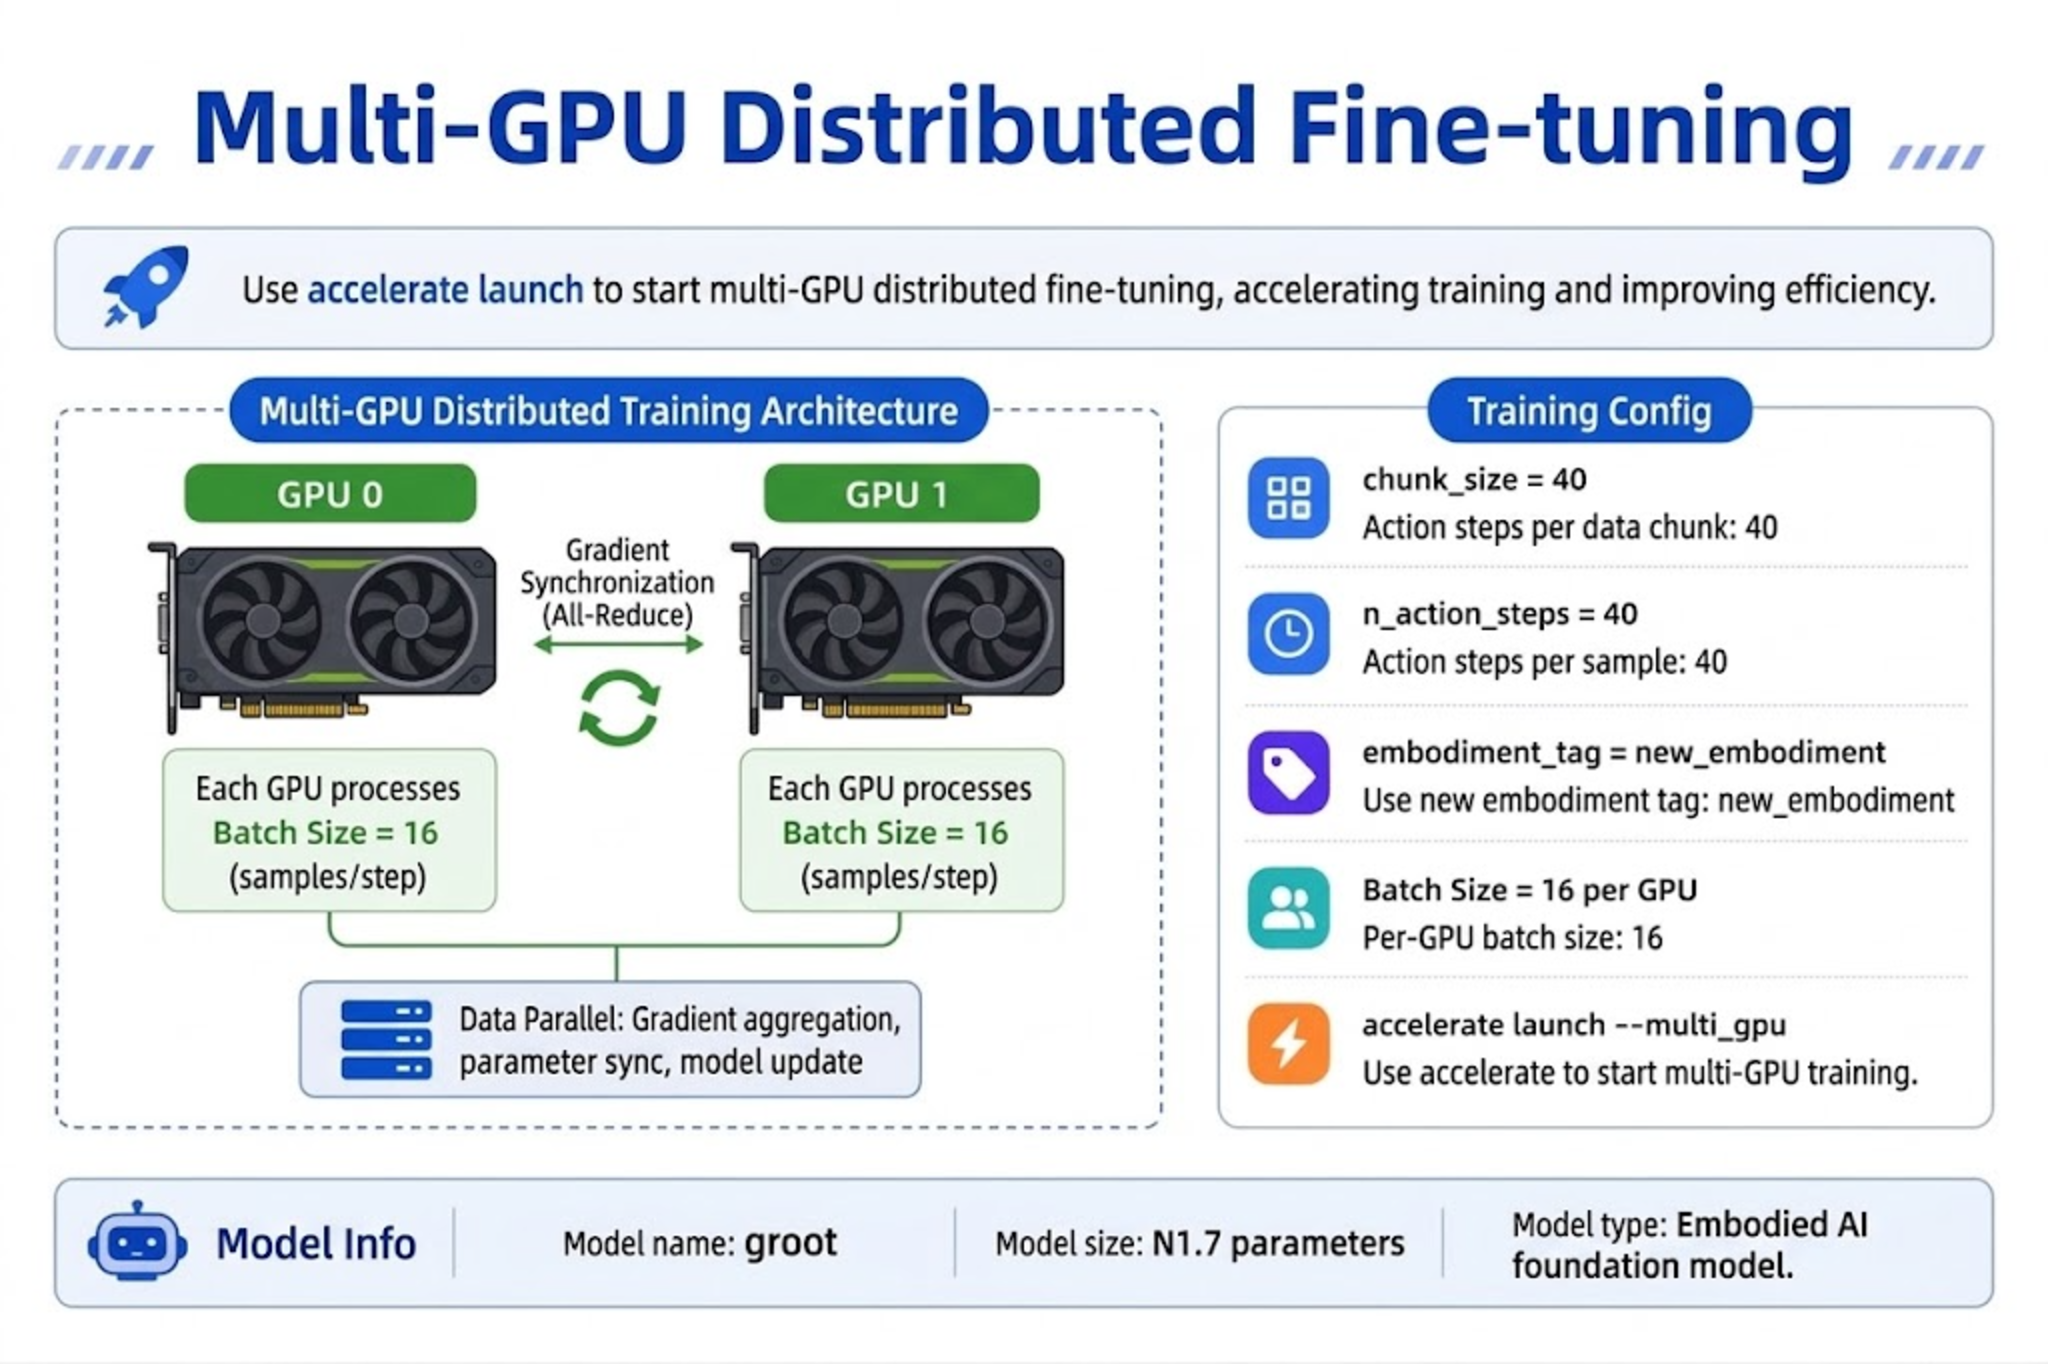
Para ambientes com múltiplas GPUs, use accelerate:
export NUM_GPUS=2
export BATCH_SIZE=16        # per-GPU batch; total batch = 16 x num GPUs
export NUM_STEPS=20000
export SAVE_FREQ=5000
export LOG_FREQ=10
export DATASET_REPO_ID="seeed_rebot_b601_rs/pick_cube"
export REPO_ID="${HF_USER}/rebot_groot17_pick_cube"
export OUTPUT_DIR="outputs/train/${REPO_ID}"

accelerate launch \
  --multi_gpu \
  --num_processes=${NUM_GPUS} \
  $(which lerobot-train) \
  --dataset.repo_id=${DATASET_REPO_ID} \
  --dataset.image_transforms.enable=true \
  --policy.type=groot \
  --policy.device=cuda \
  --policy.base_model_path=nvidia/GR00T-N1.7-3B \
  --policy.embodiment_tag=new_embodiment \
  --policy.chunk_size=40 \
  --policy.n_action_steps=40 \
  --policy.use_relative_actions=true \
  --policy.relative_exclude_joints='["gripper"]' \
  --policy.use_bf16=true \
  --policy.push_to_hub=true \
  --policy.repo_id=${REPO_ID} \
  --output_dir=${OUTPUT_DIR} \
  --save_checkpoint=true \
  --batch_size=${BATCH_SIZE} \
  --steps=${NUM_STEPS} \
  --save_freq=${SAVE_FREQ} \
  --log_freq=${LOG_FREQ} \
  --use_policy_training_preset=true \
  --wandb.enable=true \
  --wandb.disable_artifact=true \
  --job_name=rebot_groot_multi_gpu
21.6 Monitorando VRAM, Loss e Logs de Treinamento
21.6 Monitorando VRAM, Loss e Logs de Treinamento
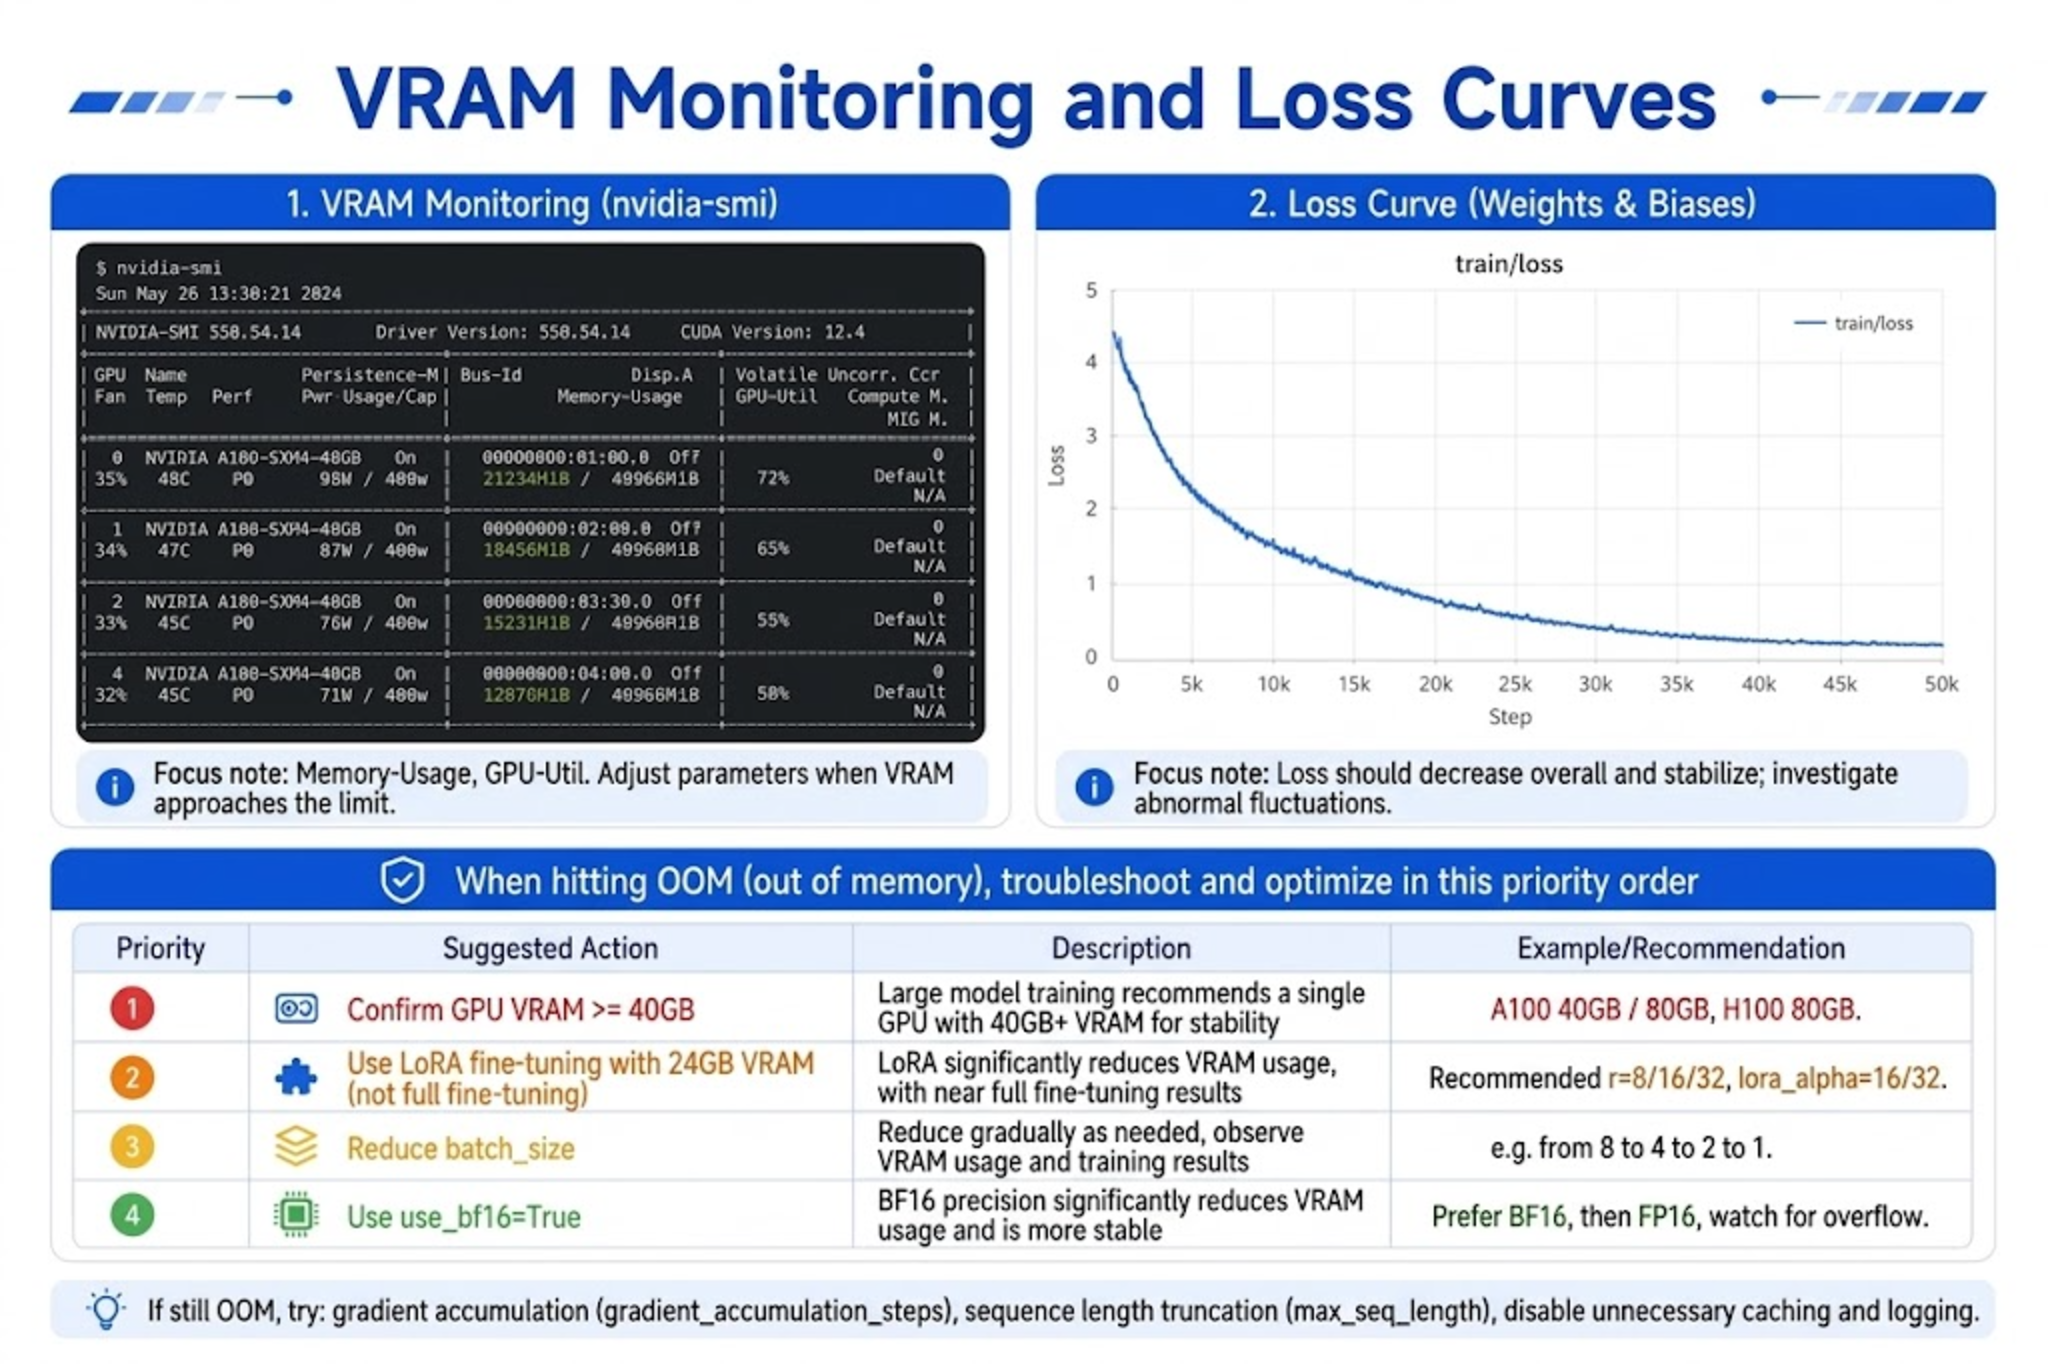
Monitor de VRAM
Em um terminal separado:
watch -n 1 nvidia-smi
| Sintoma | Ação |
|---|---|
| OOM (out of memory) | Primeiro confirme GPU ≥ 40 GB; depois reduza --batch_size e mantenha --policy.use_bf16=true. Em 24 GB, use LoRA/PEFT em vez de forçar um batch menor para fine-tuning completo |
| Folga de VRAM disponível | Aumente batch_size de forma apropriada para acelerar o treinamento |
| Baixa utilização | Verifique num_workers; confirme que os dados estão em um SSD local |
Curva de Loss
Após habilitar o W&B, observe na web a tendência de queda de train/loss. Um fine-tuning saudável:
- A loss cai rapidamente nos primeiros 1000 passos.
- Entra em platô após 5000 passos.
- Se a loss não diminuir: verifique
modality.json, dimensões dos dados e anotações de linguagem.
Logs Locais
tail -f ${OUTPUT_DIR}/logs/*.log
Ou visualize o dashboard offline/online do W&B.
21.7 Salvando Checkpoints
21.7 Salvando Checkpoints
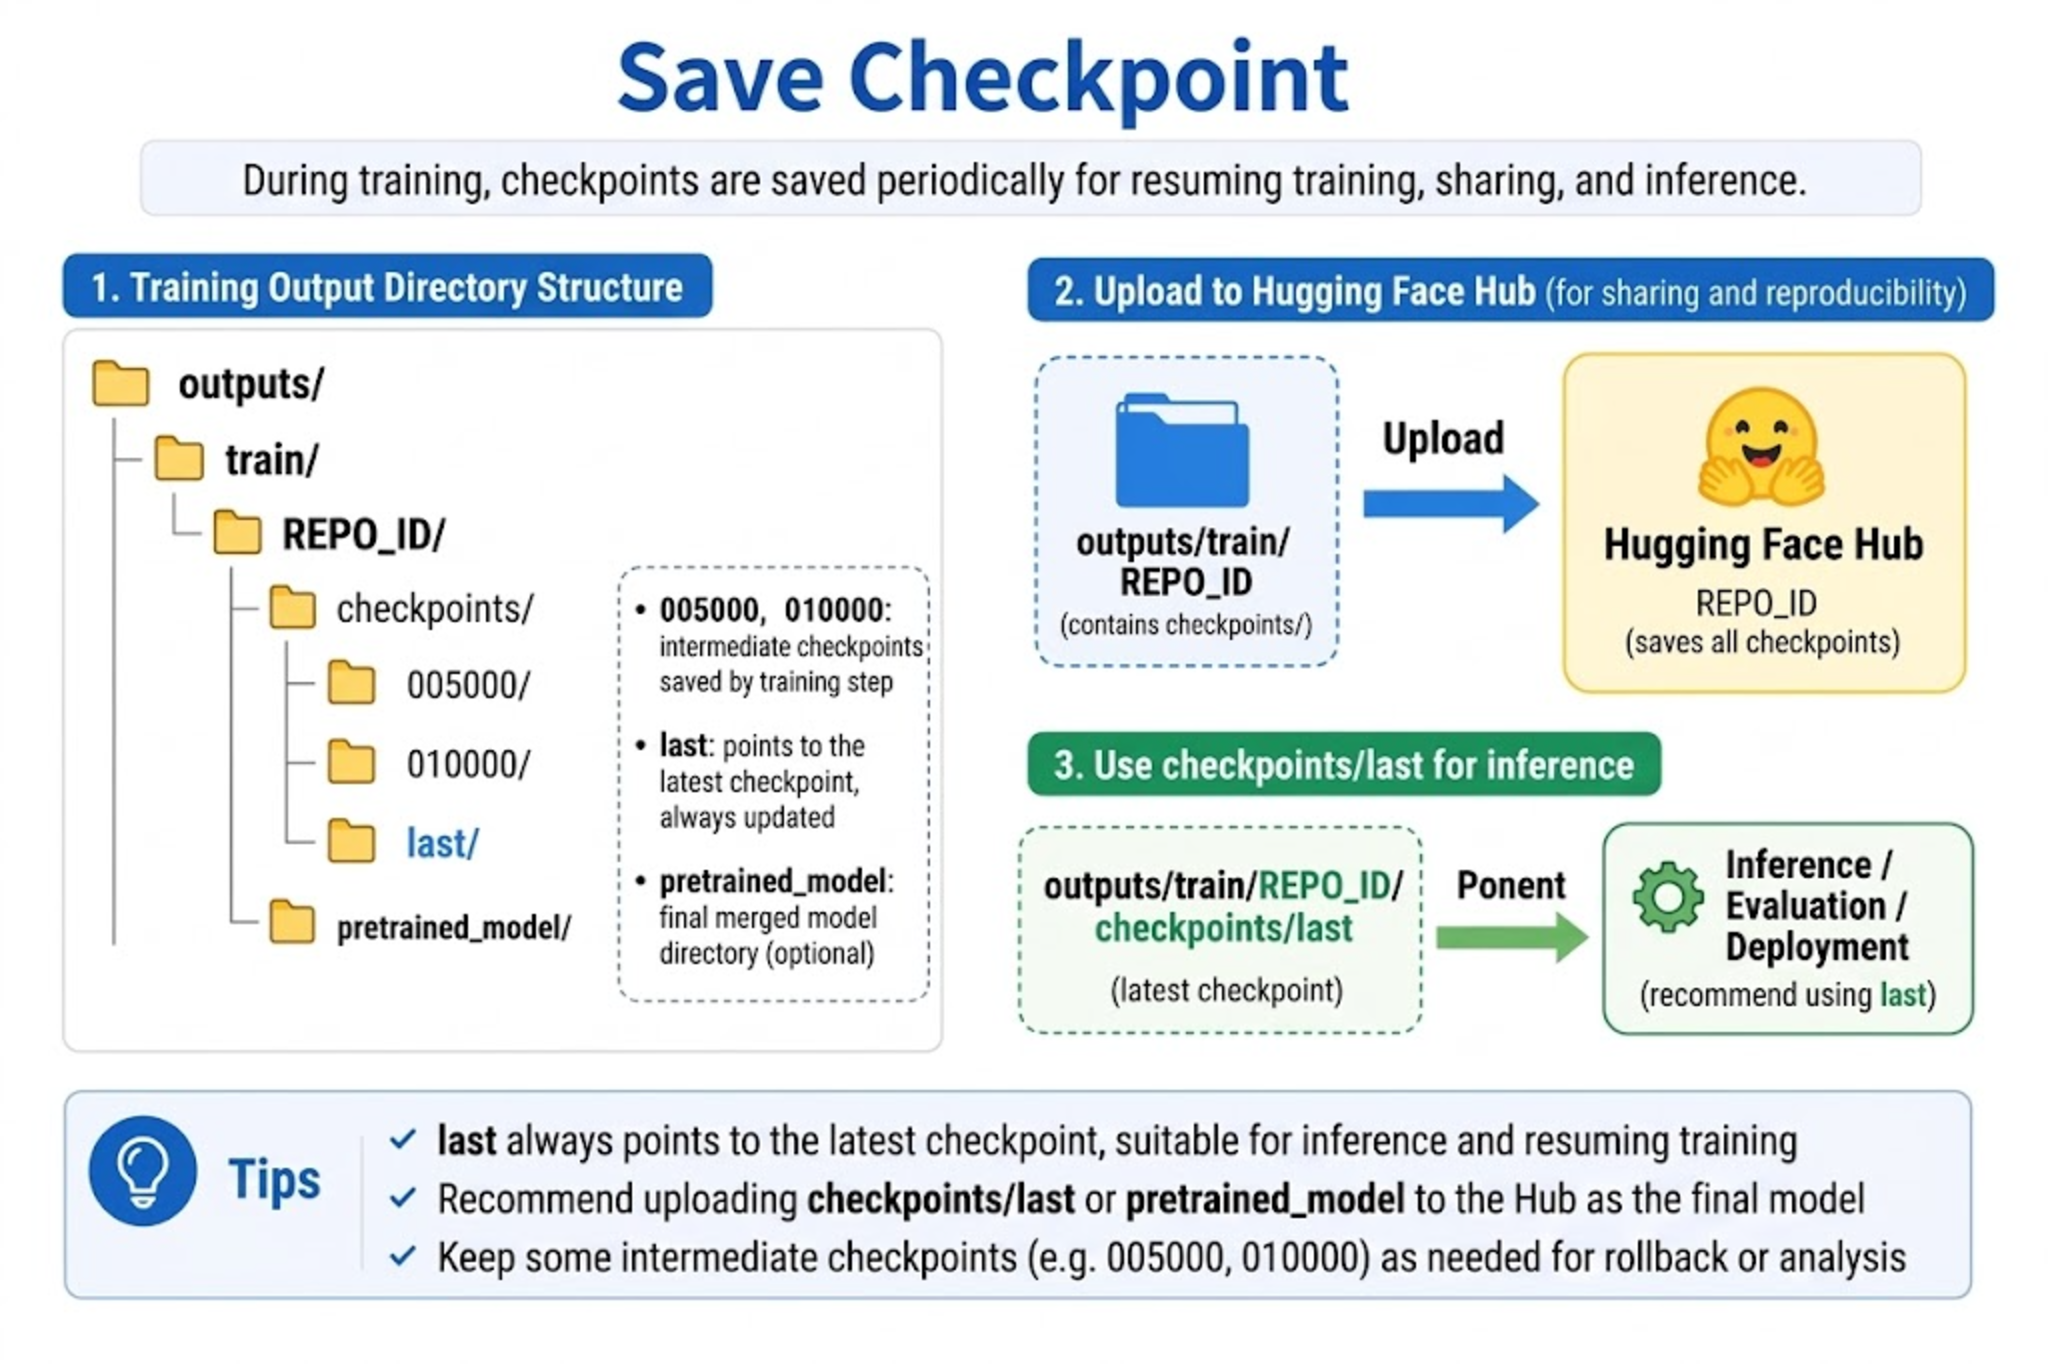
Durante o treinamento, os checkpoints são salvos em:
outputs/train/<REPO_ID>/
├── checkpoints/
│   ├── 005000/
│   │   └── pretrained_model/
│   ├── 010000/
│   ├── 015000/
│   ├── 020000/
│   └── last/
│       └── pretrained_model/    ← latest weights, use this for inference
└── logs/
Inferência com um checkpoint específico
--policy.path=outputs/train/${REPO_ID}/checkpoints/010000/pretrained_model
Enviando para o Hub
Se --policy.push_to_hub=true, o envio acontece automaticamente ao final do treinamento. Upload manual:
huggingface-cli upload ${REPO_ID} \
  outputs/train/${REPO_ID}/checkpoints/last/pretrained_model
21.8 Inferência e Avaliação em Robô Real
21.8 Inferência e Avaliação em Robô Real
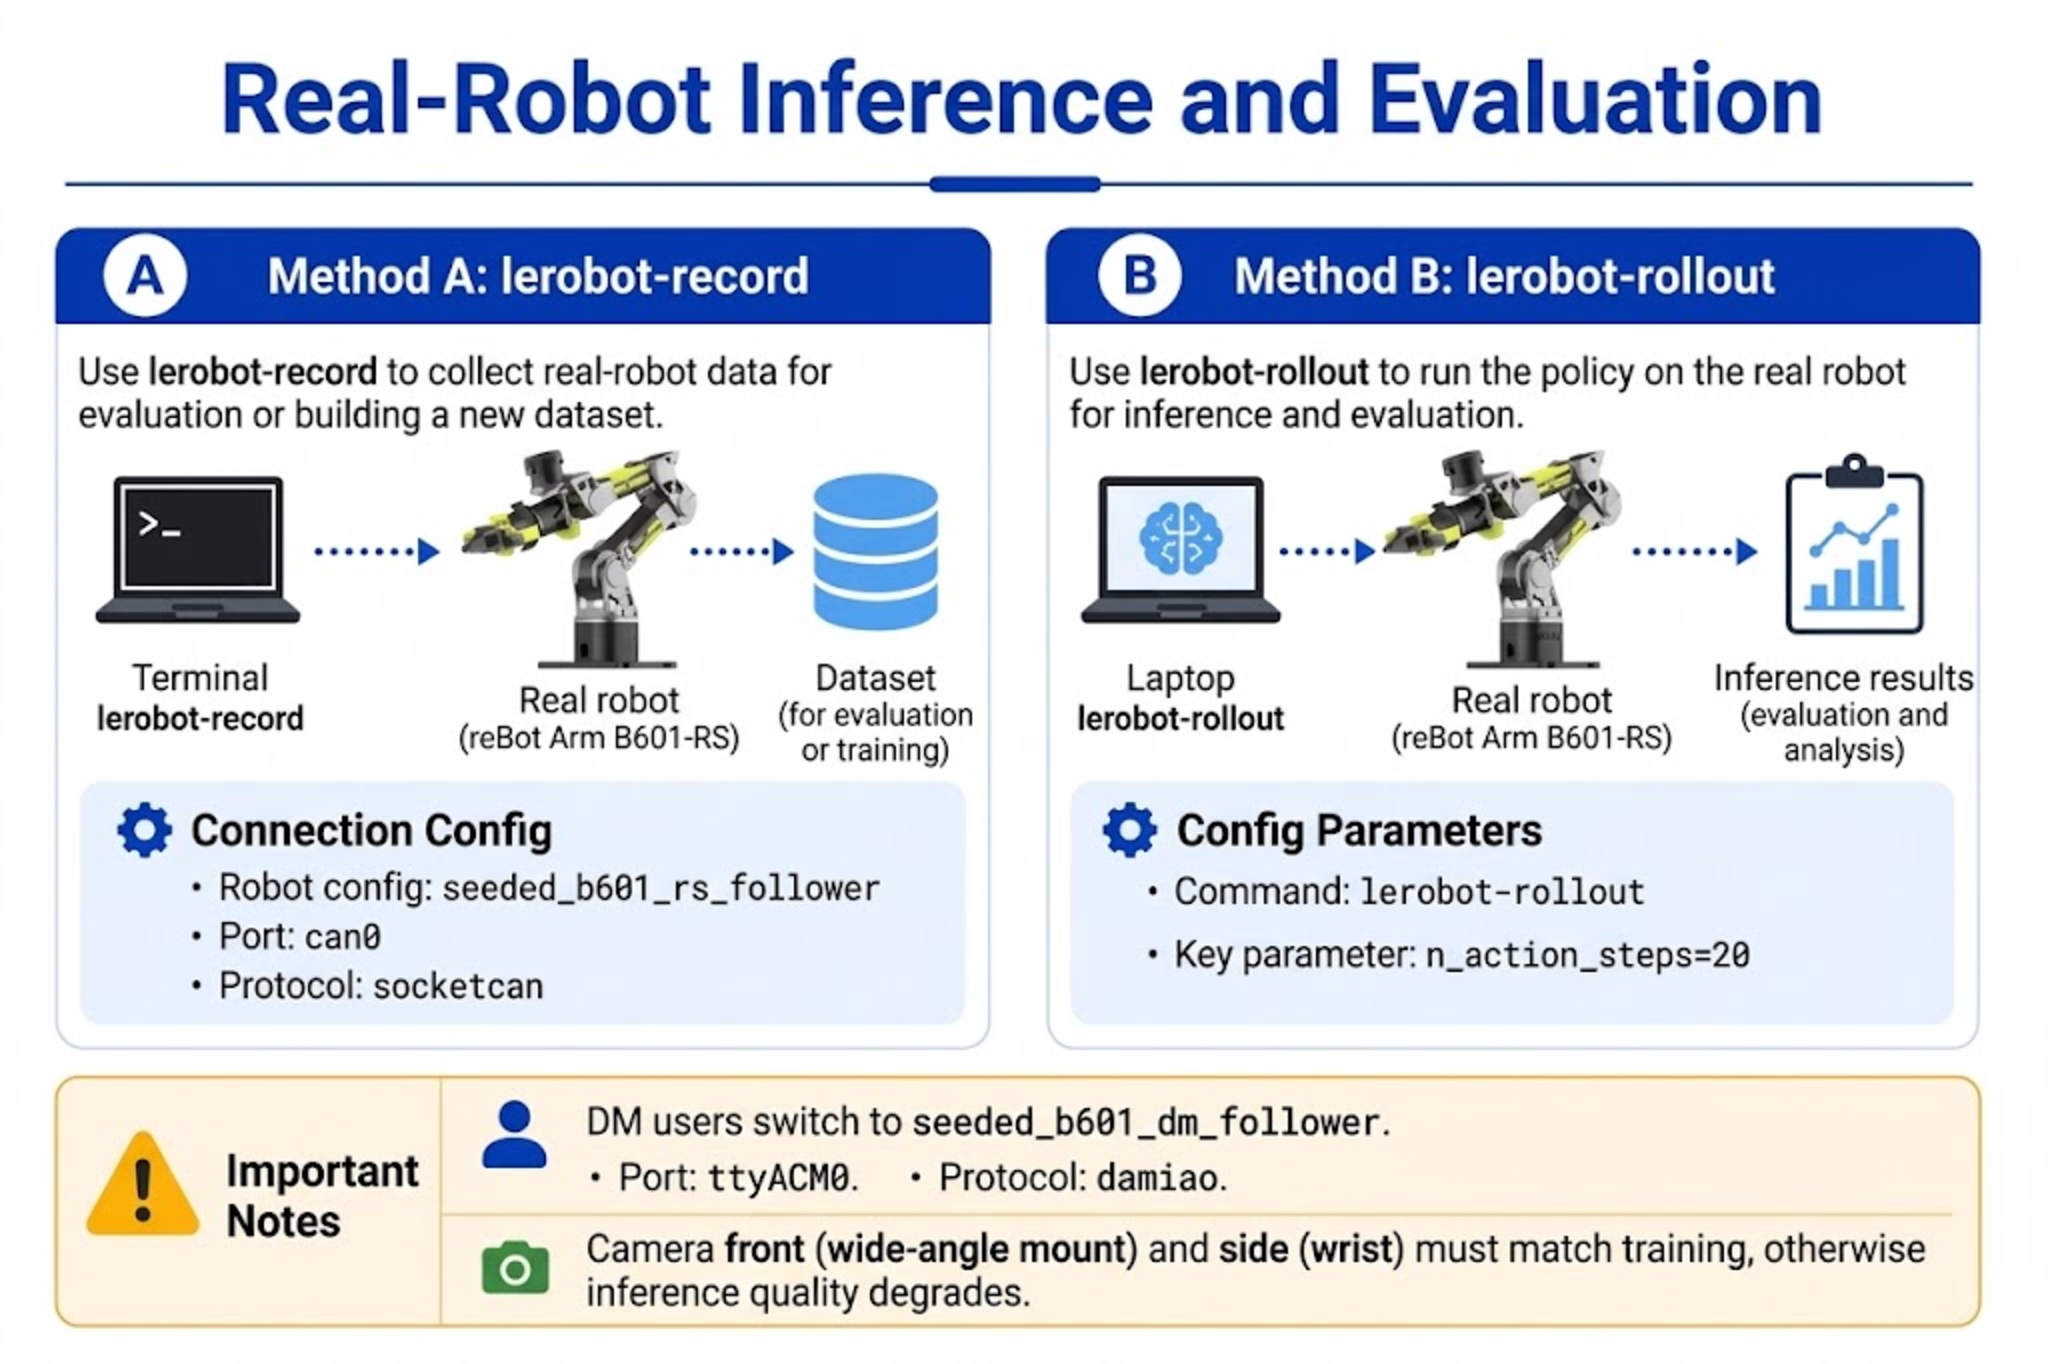
Método A: lerobot-record com gravação de política (recomendado para iniciantes)
Igual ao fluxo de avaliação ACT, apenas troque pelo checkpoint GR00T. Abaixo usamos B601-RS como exemplo; DM substitui type / port / can_adapter.
export HF_USER="your_hf_username"
export MODEL_PATH="${HF_USER}/rebot_groot17_pick_cube"   # Hub or local path

# RS CAN
sudo ip link set can0 down 2>/dev/null
sudo ip link set can0 type can bitrate 1000000
sudo ip link set can0 up

lerobot-record \
  --robot.type=seeed_b601_rs_follower \
  --robot.port=can0 \
  --robot.id=follower1 \
  --robot.can_adapter=socketcan \
  --robot.cameras="{ front: {type: opencv, index_or_path: 0, width: 640, height: 480, fps: 30, fourcc: "MJPG"}, side: {type: opencv, index_or_path: 2, width: 640, height: 480, fps: 30, fourcc: "MJPG"}}" \
  --display_data=true \
  --dataset.repo_id=${HF_USER}/eval_groot_rebot \
  --dataset.num_episodes=10 \
  --dataset.single_task="put the black cube on the blue tray" \
  --dataset.episode_time_s=30 \
  --dataset.reset_time_s=15 \
  --policy.path=${MODEL_PATH} \
  --policy.base_model_path=nvidia/GR00T-N1.7-3B \
  --policy.embodiment_tag=new_embodiment
Os front e side em --robot.cameras devem corresponder aos nomes de chave do conjunto de dados de treinamento.
Método B: implantação em tempo real com lerobot-rollout (avançado)
Adequado para controle em malha fechada de baixa latência; oferece suporte a RTC (Real-Time Chunking):
export MODEL_PATH="${HF_USER}/rebot_groot17_pick_cube"

lerobot-rollout \
  --strategy.type=base \
  --policy.path=${MODEL_PATH} \
  --policy.base_model_path=nvidia/GR00T-N1.7-3B \
  --policy.embodiment_tag=new_embodiment \
  --policy.chunk_size=40 \
  --policy.n_action_steps=20 \
  --policy.use_relative_actions=true \
  --policy.relative_exclude_joints='["gripper"]' \
  --robot.type=seeed_b601_rs_follower \
  --robot.port=can0 \
  --robot.id=follower1 \
  --robot.can_adapter=socketcan \
  --robot.cameras="{ front: {type: opencv, index_or_path: 0, width: 640, height: 480, fps: 30, fourcc: "MJPG"}, side: {type: opencv, index_or_path: 2, width: 640, height: 480, fps: 30, fourcc: "MJPG"}}" \
  --task="put the black cube on the blue tray" \
  --duration=60 \
  --device=cuda \
  --display_data=true \
  --inference.type=rtc \
  --inference.rtc.enabled=true \
  --inference.rtc.execution_horizon=20 \
  --inference.queue_threshold=2
Se o RTC causar jitter, defina --inference.rtc.enabled=false. queue_threshold é recomendado em 2-5 (definir como 0 dispara reinferência com muita frequência e tende a causar jitter).
21.9 FAQ de Solução de Problemas
21.9 FAQ de Solução de Problemas
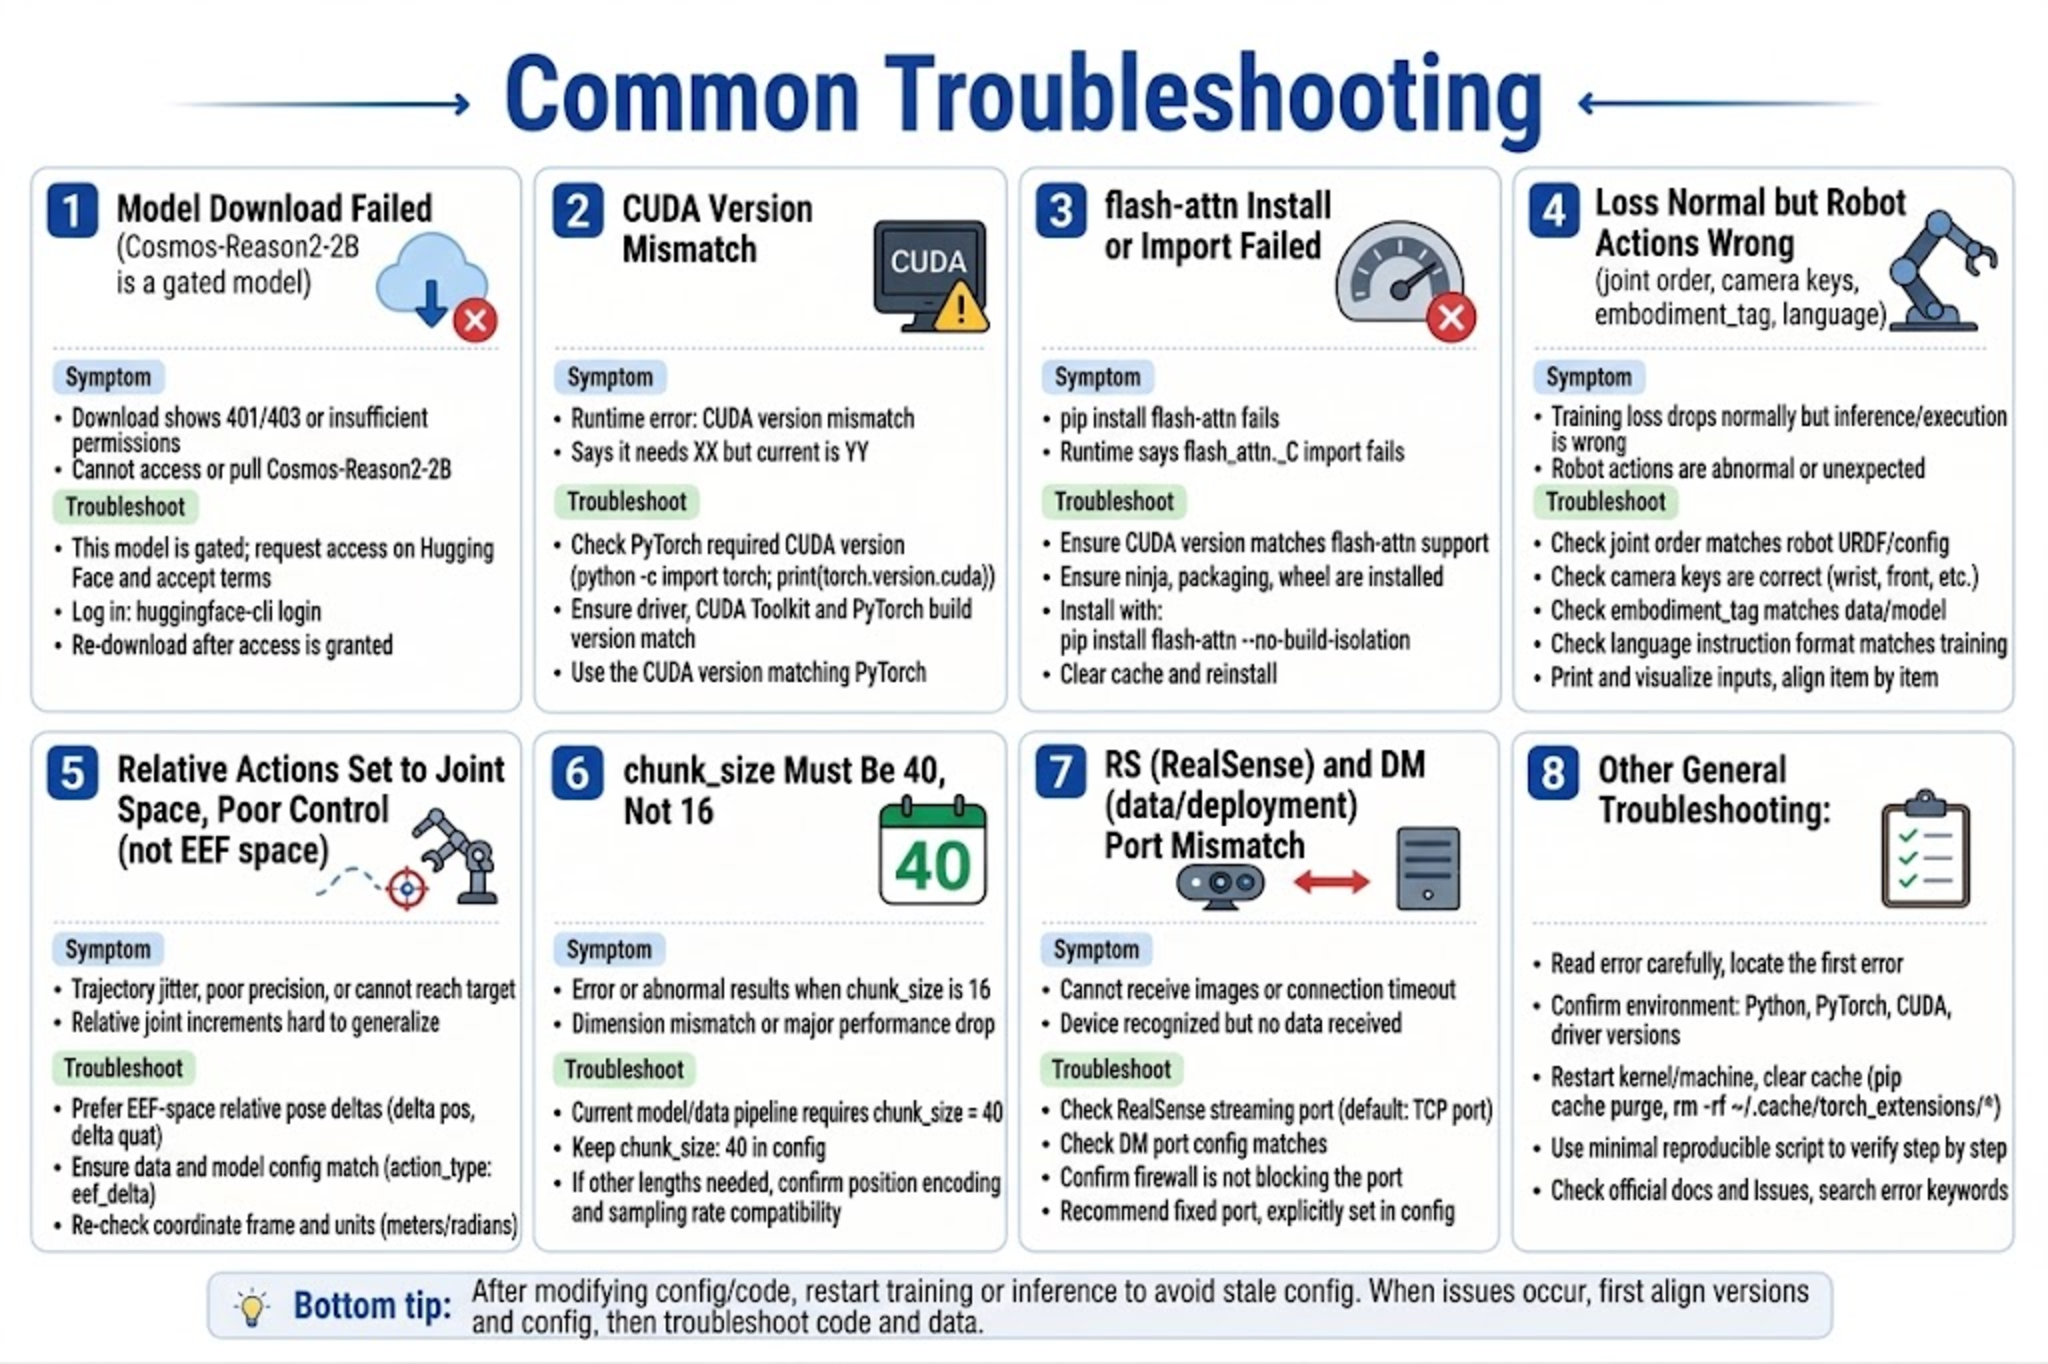
Falha no download do modelo
# Set mirror or proxy and retry
export HF_ENDPOINT=https://hf-mirror.com   # optional
huggingface-cli download nvidia/GR00T-N1.7-3B
huggingface-cli download nvidia/Cosmos-Reason2-2B   # gated; accept terms on HF first
Incompatibilidade de versão CUDA / PyTorch
python -c "import torch; print(torch.__version__, torch.cuda.is_available(), torch.version.cuda)"
nvidia-smi
Garanta que a versão do driver atenda aos requisitos de CUDA do PyTorch.
Falha na instalação do Flash Attention
- Confirme que
nvcc --versioncorresponde ao CUDA do PyTorch. - Tente um wheel pré-compilado:
pip install flash-attn --no-build-isolation. - A série RTX 50 pode tentar:
pip install flash_attn==2.8.0.post2 torch==2.7.1 --no-build-isolation. - Se ainda falhar, consulte a documentação oficial do Isaac GR00T.
A loss de treinamento é normal, mas o robô real se move de forma errática
| Possível causa | Investigação |
|---|---|
| Ordem de juntas inconsistente | Compare os metadados do conjunto de dados com --robot.cameras / driver |
| Unidade de ângulo incorreta | Confirme se deg/rad é consistente entre treinamento e inferência |
| Incompatibilidade no nome da chave da câmera | front/side alinhados com os dados de treinamento |
embodiment_tag incorreto | Deve ser new_embodiment |
| Incompatibilidade na instrução de linguagem | O padrão de frase de --task corresponde aos dados de treinamento |
| Ações relativas não restauradas corretamente | Confirme se use_relative_actions corresponde entre treinamento e inferência; isto é relativo à junta, não ao EEF relativo |
Erro mean is infinity
Geralmente causado por nomes de chave de câmera no momento da avaliação que não correspondem aos do treinamento. Verifique os nomes de chave em --robot.cameras.
21.10 Sugestões de Melhoria de Treinamento
21.10 Sugestões de Melhoria de Treinamento
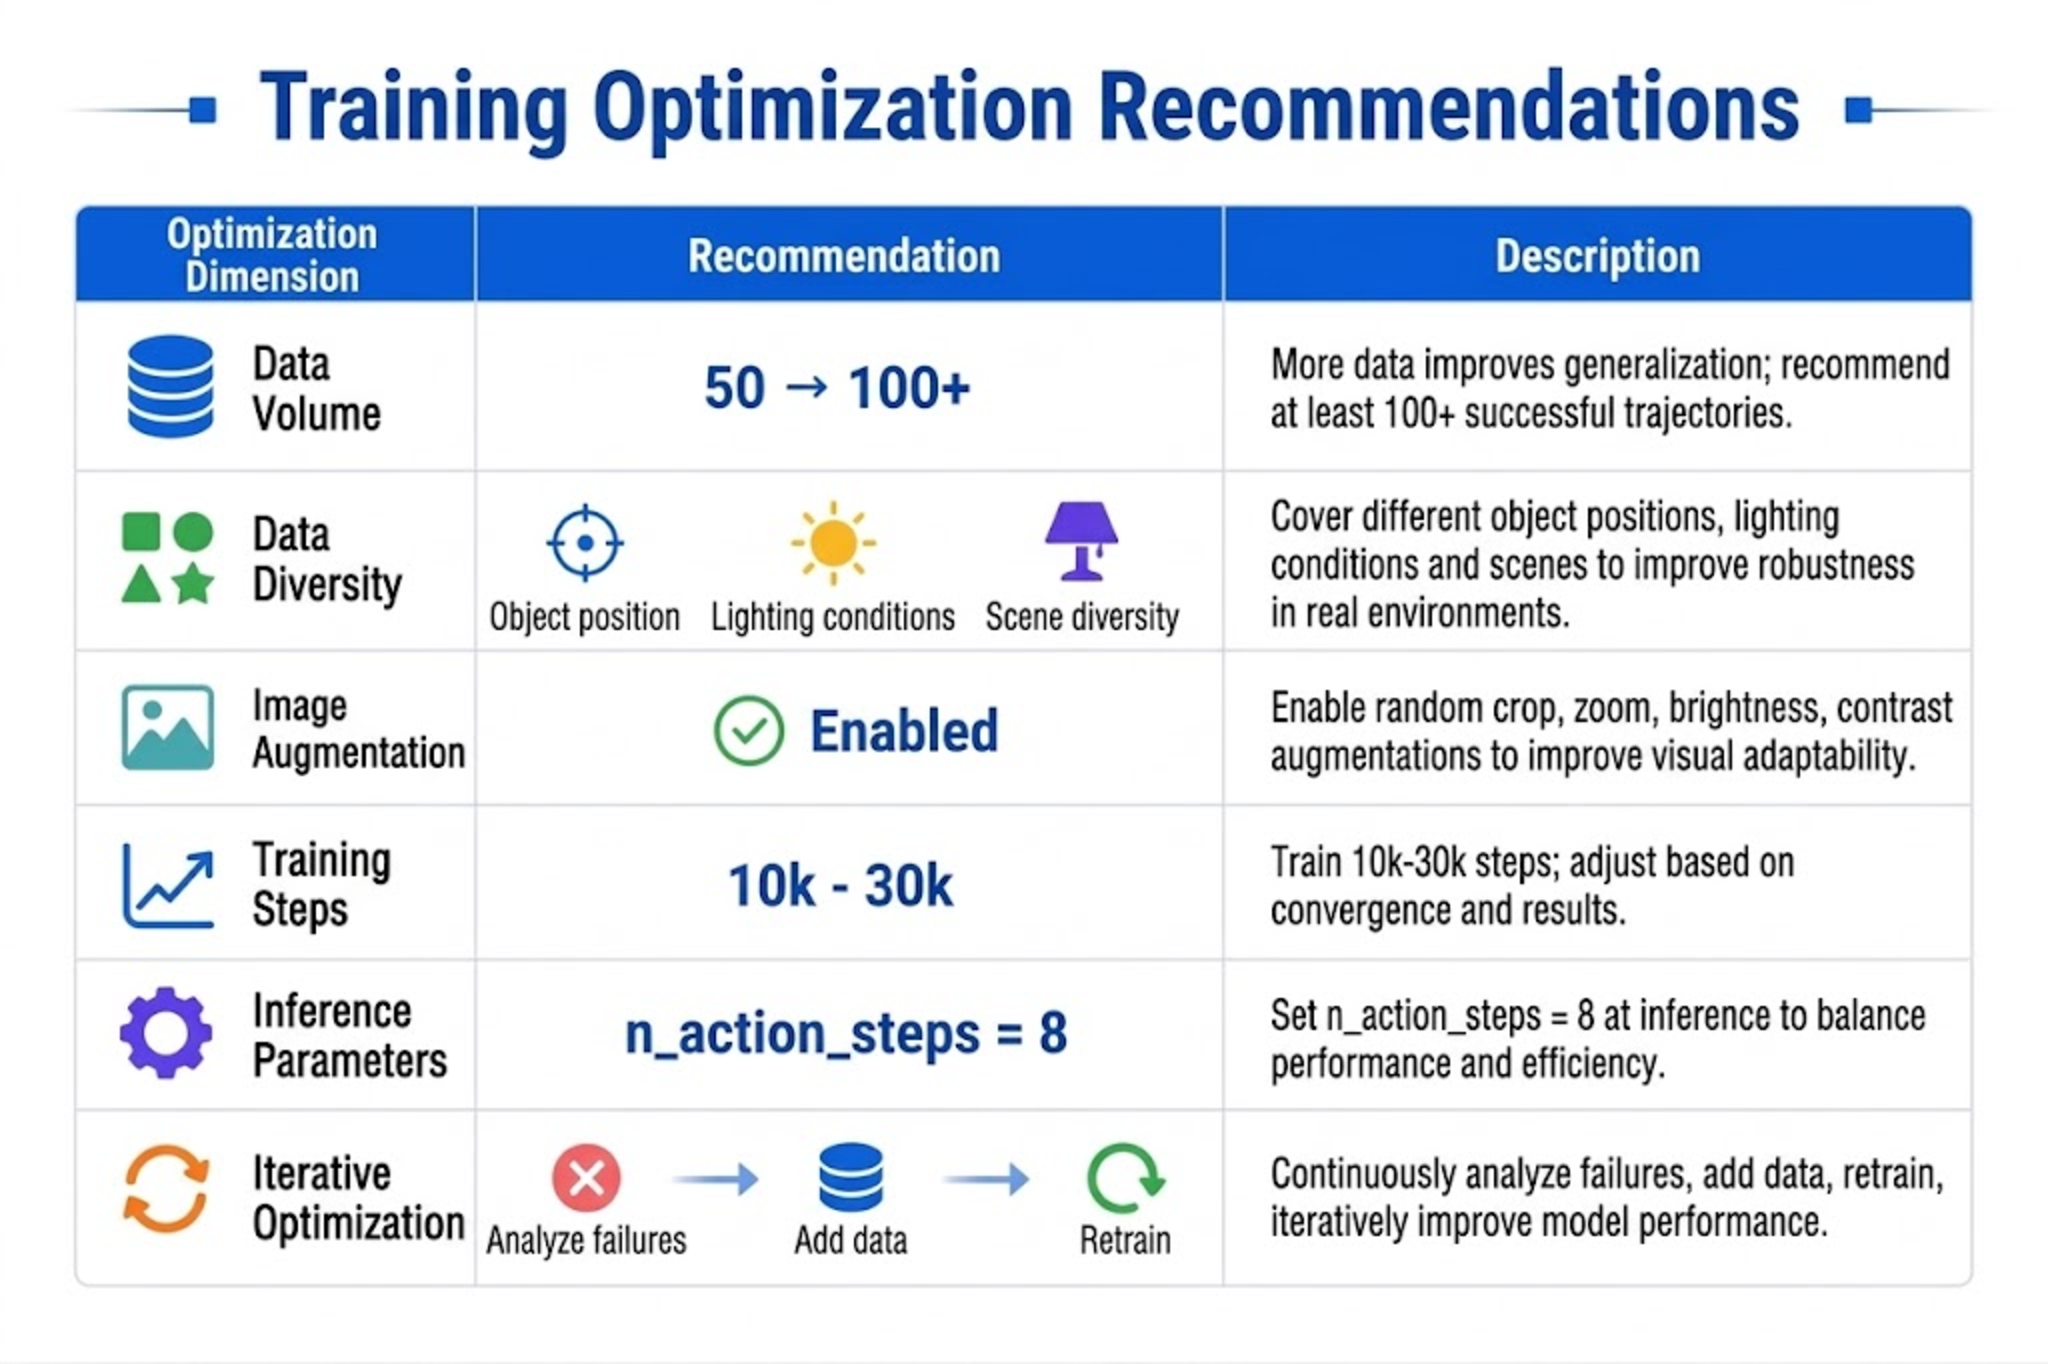
| Direção | Sugestão |
|---|---|
| Volume de dados | Comece com 50 episódios para uma única tarefa, depois expanda para 100+ |
| Diversidade de dados | Varie posições de objetos, iluminação e poses iniciais |
| Aumento de dados | Mantenha --dataset.image_transforms.enable=true |
| Passos | 10k-15k com poucos dados; 20k-30k com mais dados |
| Inferência | Primeiro tente n_action_steps=20 (deve ser ≤ chunk_size=40 de treinamento), depois ajuste o RTC |
| Iteração | Coletar dados para casos de falha -> mesclar conjuntos de dados -> continuar o fine-tuning |
21.11 Resumo do Capítulo
21.11 Resumo do Capítulo
- Ambiente:
pip install "lerobot[groot,training]"+ Flash Attention + GPU de 40 GB+ para fine-tuning (16 GB apenas para inferência). - Modelo base:
nvidia/GR00T-N1.7-3B(backboneCosmos-Reason2-2B). - Treinamento:
lerobot-train --policy.type=groot --policy.embodiment_tag=new_embodiment. - Configuração-chave do reBot: espaço de juntas + ações relativas às juntas opcionais do LeRobot (gripper absoluto) +
chunk_size=40(alinhado com N1.7). - Variante de modelo: RS usa
seeed_b601_rs_follower+can0+socketcan; DM usaseeed_b601_dm_follower+/dev/ttyACM0+damiao. - Avaliação:
lerobot-recordoulerobot-rollout; câmeras e linguagem devem estar alinhadas com o treinamento. - O checkpoint está em
outputs/train/<REPO_ID>/checkpoints/last/pretrained_model.
Após concluir este capítulo, você deverá ser capaz de acionar a política VLA no reBot Arm com instruções em linguagem natural. Se os resultados não forem satisfatórios, primeiro volte ao Capítulo 20 para verificar a qualidade dos dados, depois aumente a quantidade de demonstrações e itere o fine-tuning.