22. Inferência GR00T e Implantação em Robô Real
Capítulo 22 do Curso para Iniciantes em IA Física da Seeed — o loop ponta a ponta, o desacoplamento entre inferência e controle, máquina única vs distribuída, entradas de câmera/estado/linguagem, saída em blocos de ações, latência, buffer de ações e RTC, limites de segurança, avaliação e o projeto de estágio.
O Capítulo 21 abordou o fine-tuning e os comandos básicos de robô real; este capítulo aprofunda em implantação de inferência: como o lado de inferência e o lado de controle são desacoplados, como escolher entre máquina única e distribuída, como alinhar entradas/saídas, além de latência, buffer assíncrono, limites de segurança e avaliação de tarefas. Por fim, o projeto de estágio “colocar o tubo de ensaio no suporte esquerdo” percorre todo o pipeline.
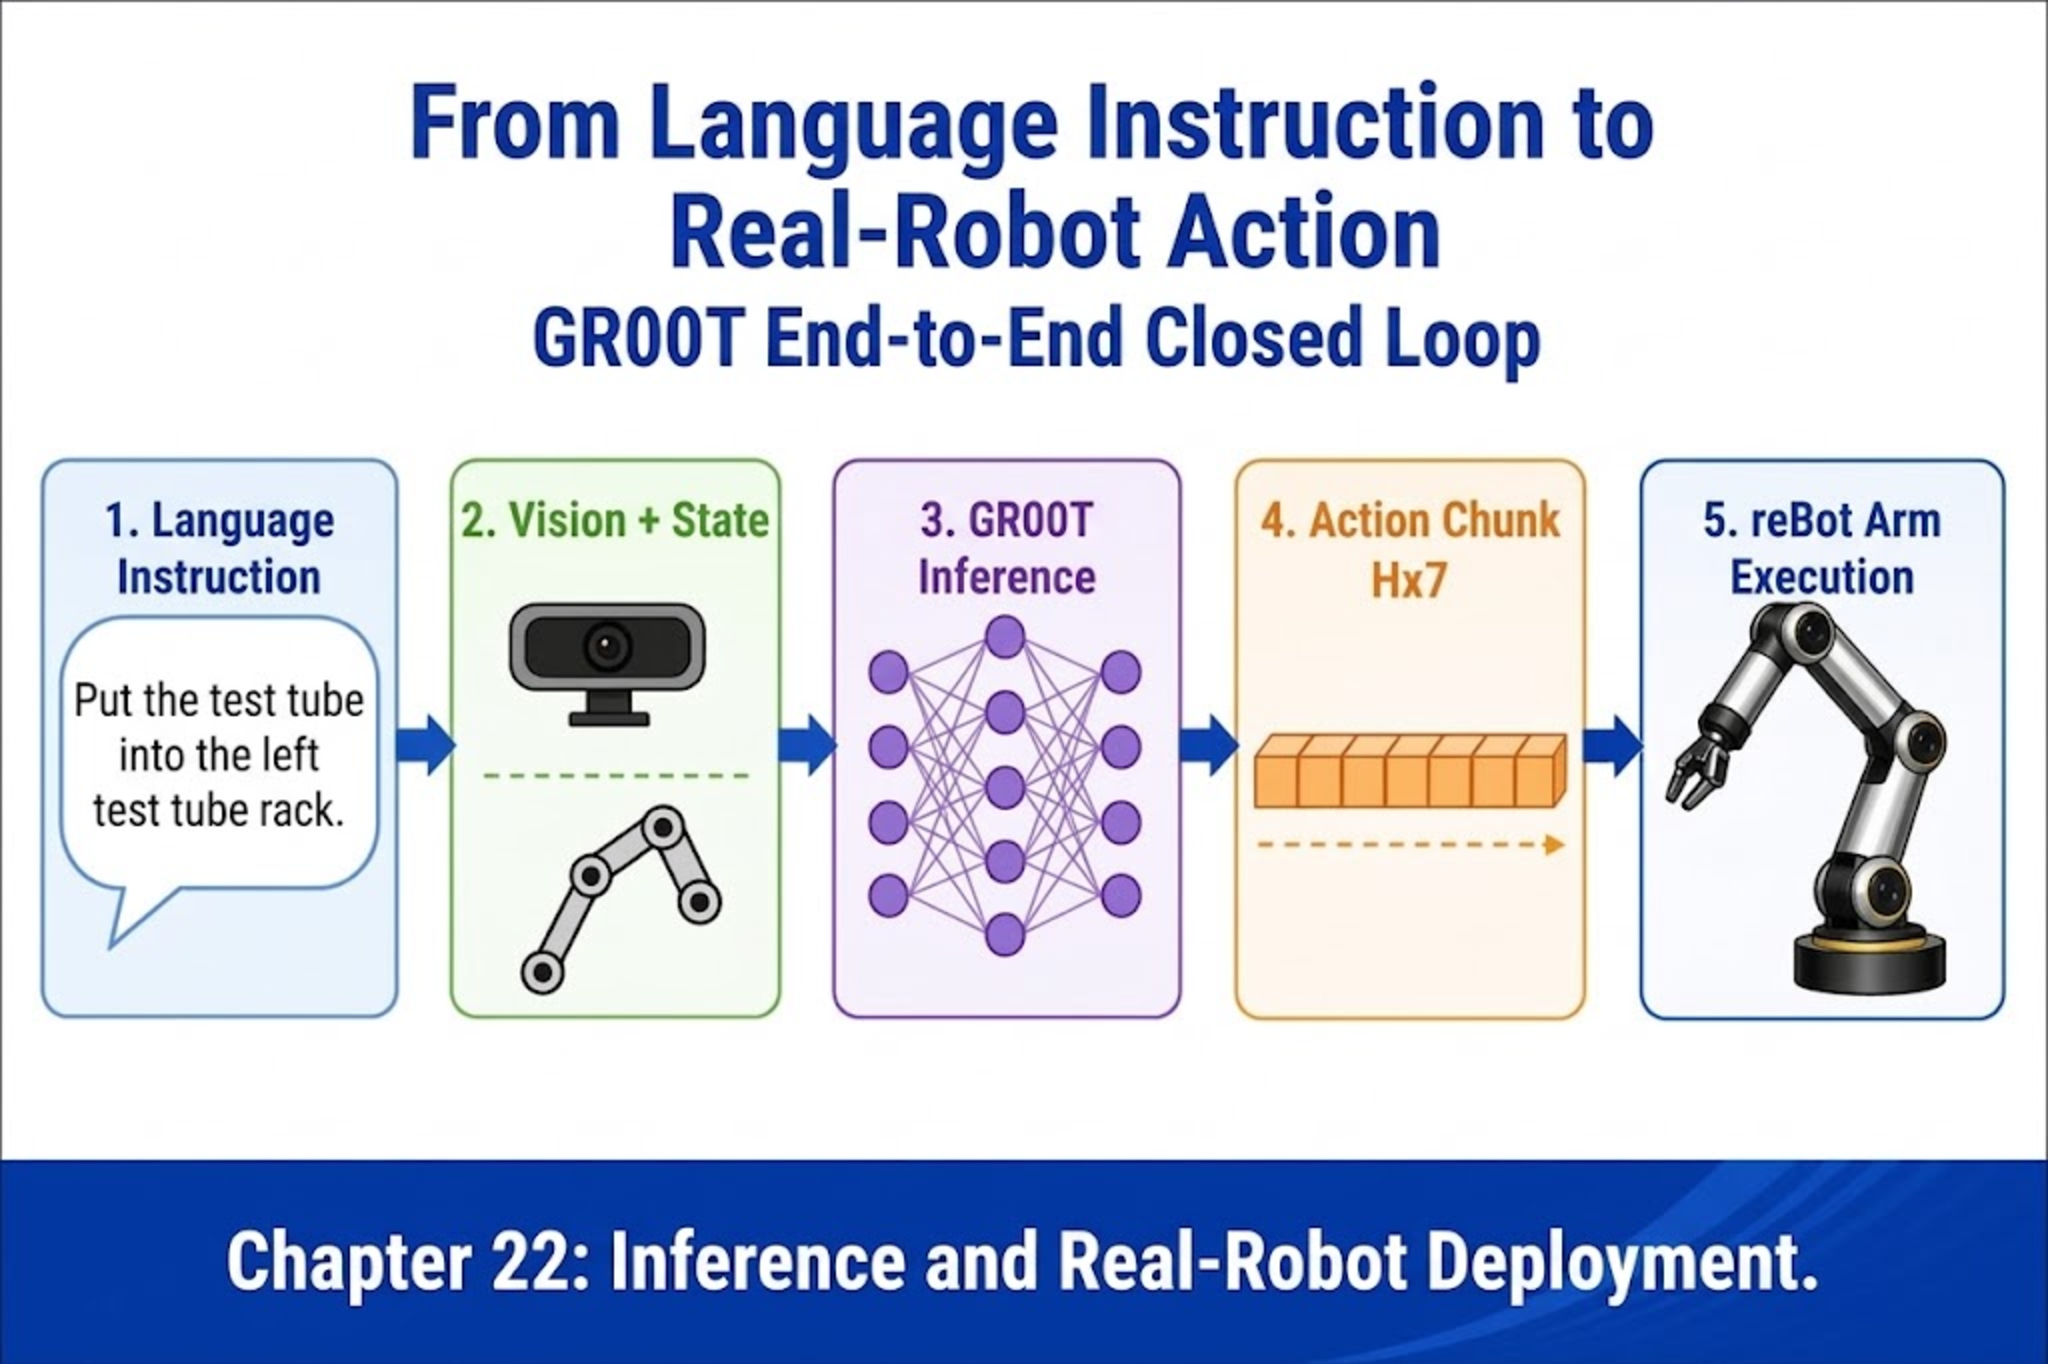
22.1 Como é o Loop Ponta a Ponta?
22.1 Como é o Loop Ponta a Ponta?
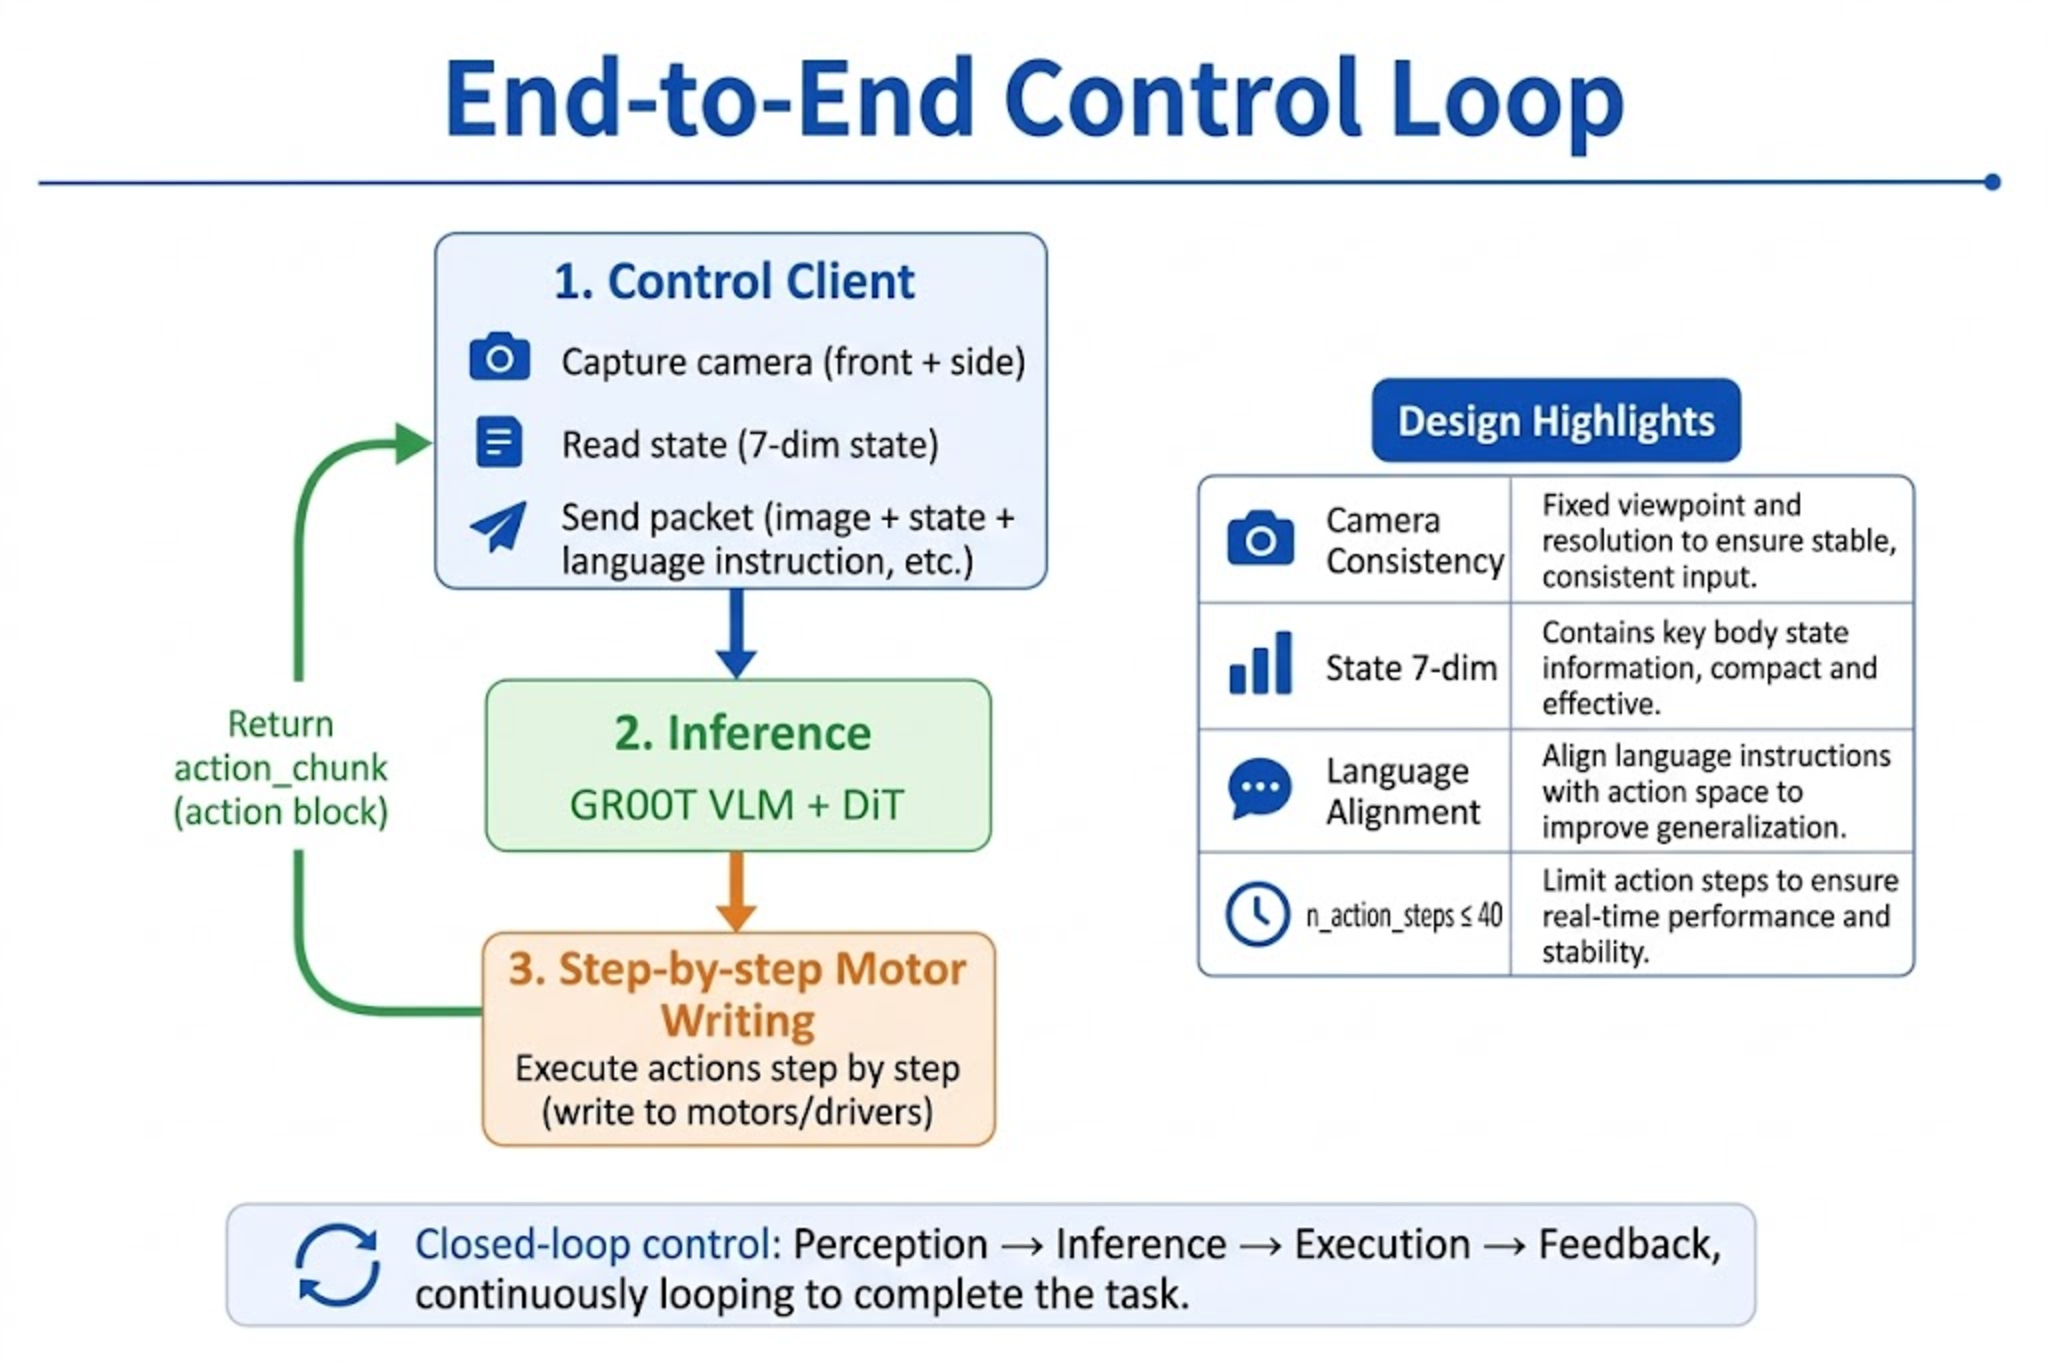
Um episódio bem-sucedido de robô real VLA pode ser abstraído como um loop de controle de frequência fixa:
User language instruction L (e.g. place the test tube into the left rack)
        |
        v
+---------------------------------------+
|  Control Client (Robot Control)        |
|  1. Capture cameras: front + side      |
|  2. Read joint state (7-dim)          |
|  3. Pack observation -> send to infer |
+-------------------+-------------------+
                    |  images + state + task
                    v
+---------------------------------------+
|  Inference side (GR00T Policy/Server)|
|  VLM + DiT -> action_chunk (H x 7)    |
+-------------------+-------------------+
                    |  action chunk
                    v
+---------------------------------------+
|  Control side executes                |
|  Write motors step by n_action_steps  |
|  (optional RTC: async prefetch next)  |
+---------------------------------------+
| Etapa | Restrição principal |
|---|---|
| Câmera | Nomes de chave, resolução e quantidade compatíveis com o treinamento (front suporte visão ampla / side punho) |
| Estado | Ordem 7-dim compatível com modality.json; unidade de ângulo consistente entre treinamento e inferência |
| Linguagem | Padrão de frase de --task próximo às anotações de treinamento |
| Ação | n_action_steps ≤ chunk_size de treinamento (N1.7 comumente 40) |
22.2 Desacoplando o Lado de Inferência e o Lado de Controle
22.2 Desacoplando o Lado de Inferência e o Lado de Controle
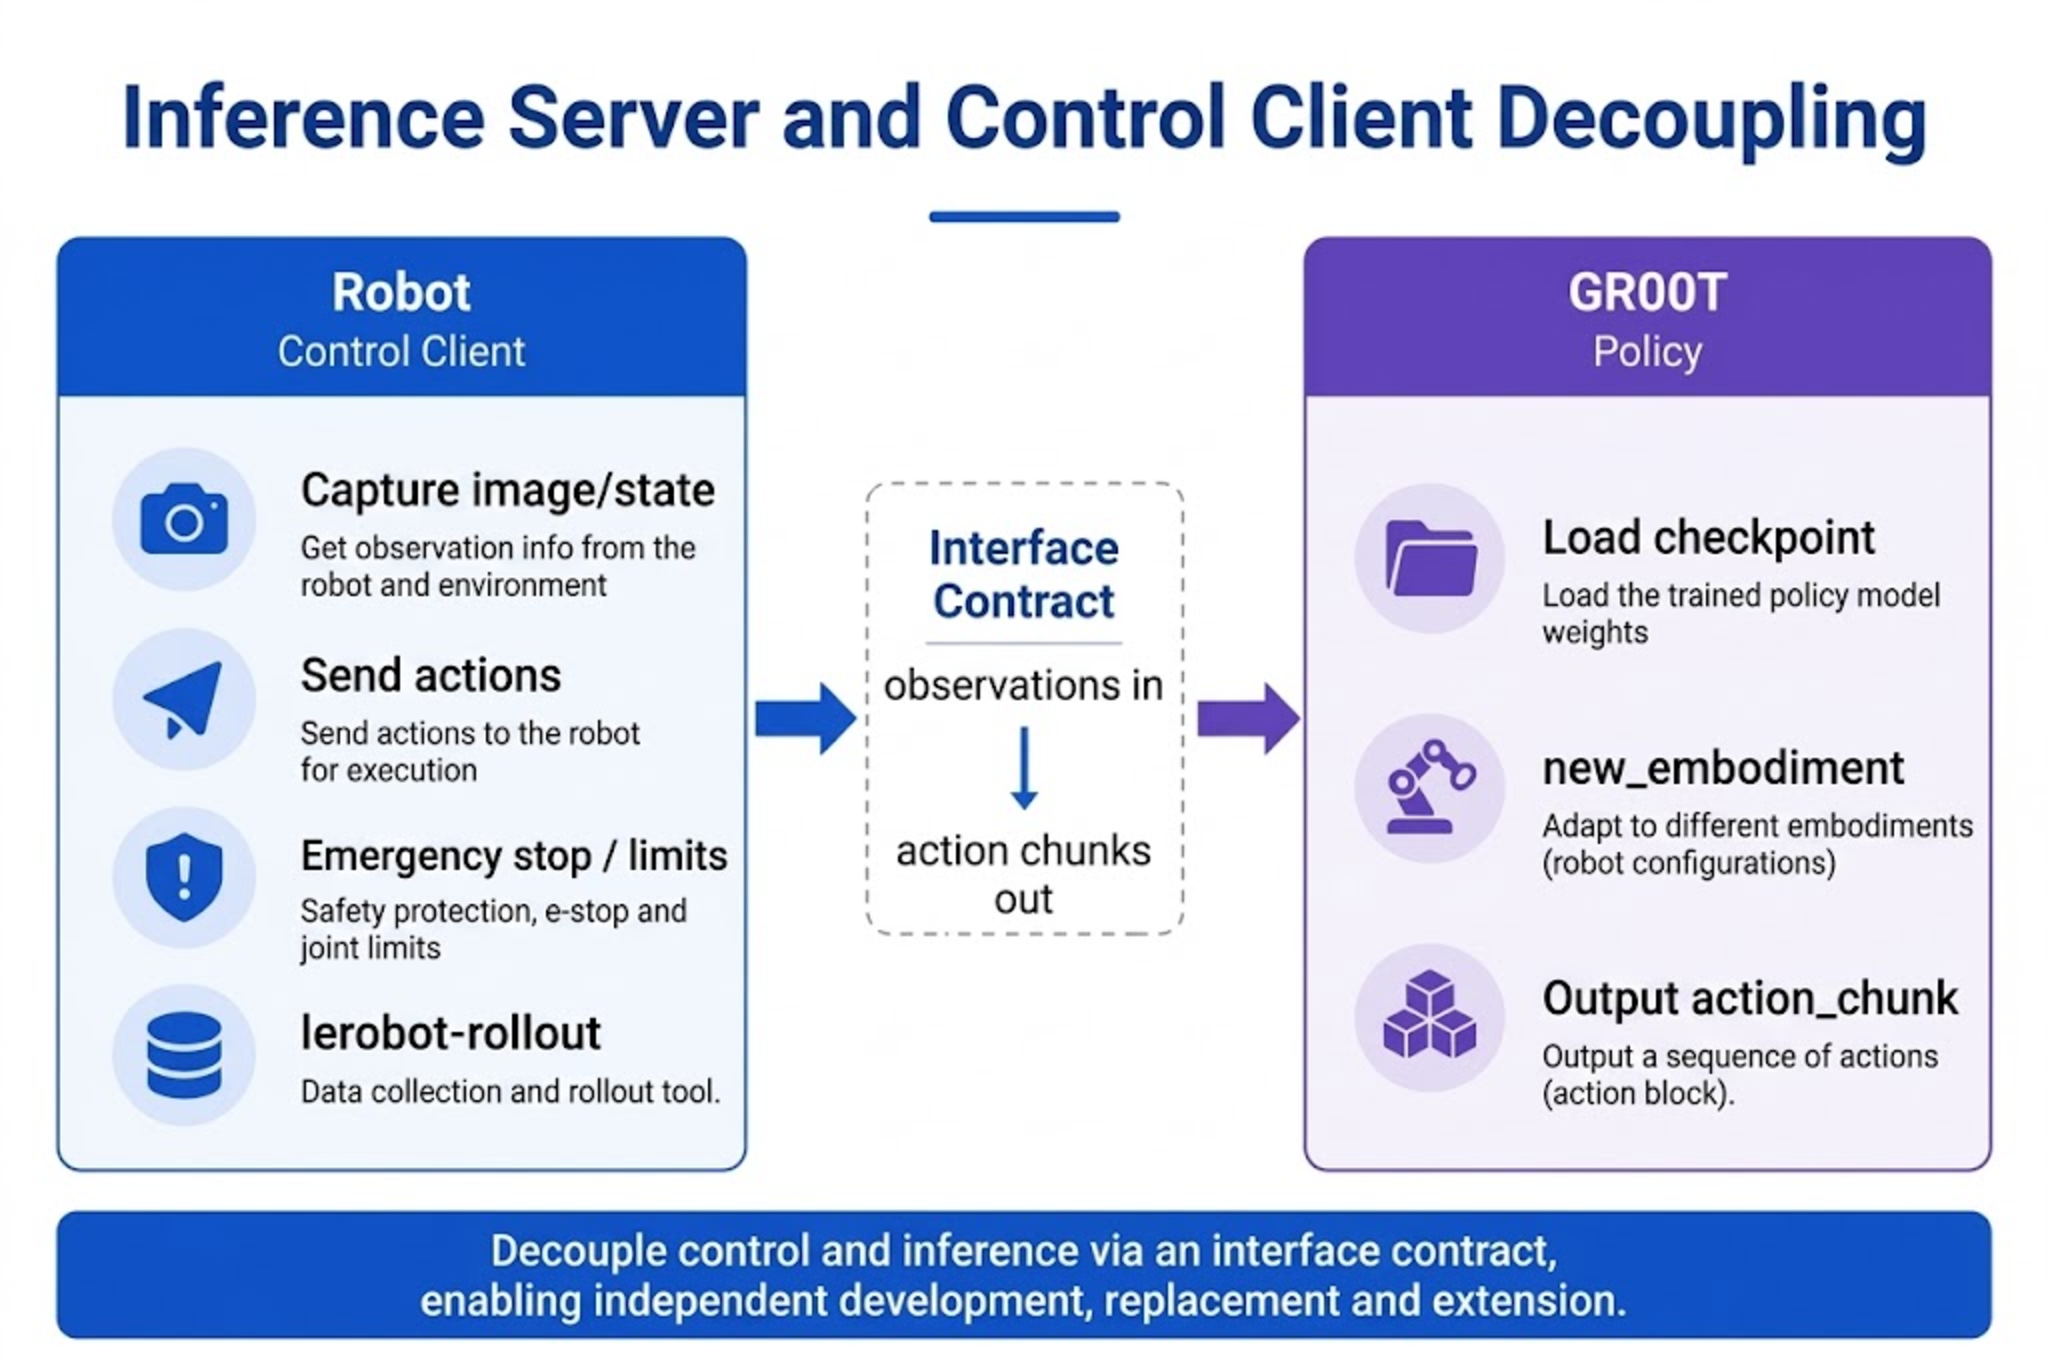
Dividir o sistema em dois lados impede que controle em tempo real e cálculo pesado se prejudiquem mutuamente:
Responsabilidades do lado de controle
- Capturar imagens e estado das juntas em frequência fixa (por exemplo, 30 Hz)
- Montar o pacote de observação
{images, state, task} - Receber
action_chunke despachar passo a passo para o driver do reBot - Executar e-stop, limites suaves e proteção por timeout
Ferramentas correspondentes: lerobot-rollout / lerobot-record (com --policy.path).
Responsabilidades do lado de inferência
- Carregar
policy.path(checkpoint com fine-tuning) ebase_model_path=nvidia/GR00T-N1.7-3B - Decodificar o espaço de ação do reBot com
embodiment_tag=new_embodiment - Retornar um bloco de ações com forma aproximada
(H, 7)(H determinado porchunk_sizede treinamento)
Forma correspondente: por padrão a policy groot em processo; uso avançado pode ser um serviço HTTP/gRPC independente (consulte os exemplos de implantação no repositório Isaac GR00T).
Princípio de desacoplamento: o lado de controle não conhece a estrutura interna do modelo; o lado de inferência não opera motores diretamente. O contrato de interface é apenas “observação entra, bloco de ações sai”.
22.3 Implantação em Máquina Única vs. Distribuída
22.3 Implantação em Máquina Única vs. Distribuída
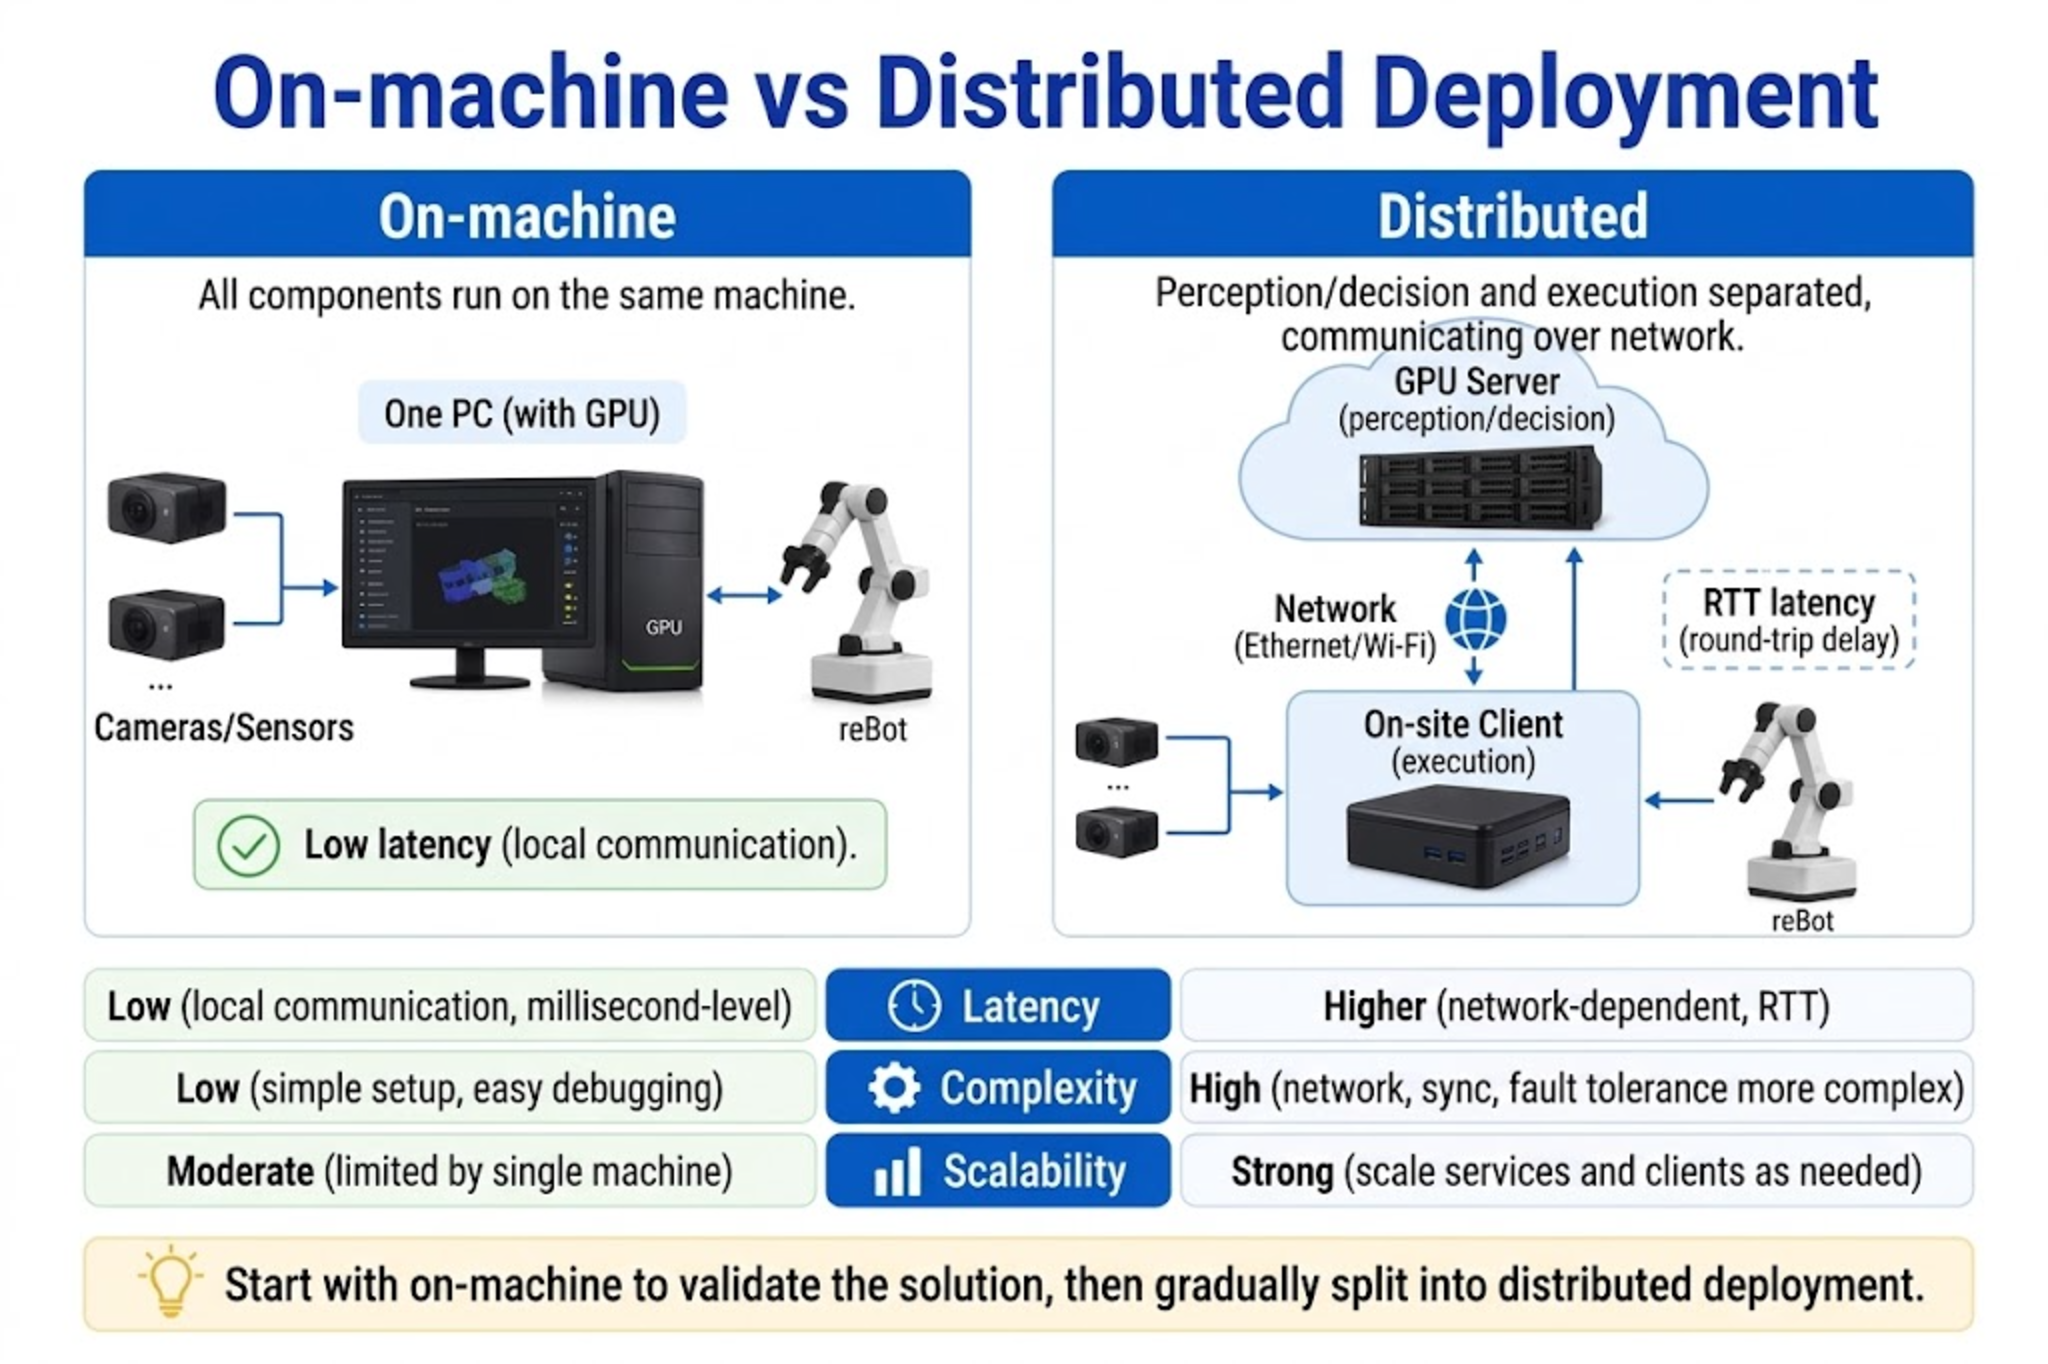
Implantação em máquina única (recomendada para iniciantes)
A estação de trabalho com GPU conecta câmeras, CAN/serial e o braço ao mesmo tempo:
lerobot-rollout \
  --policy.path=${MODEL_PATH} \
  --policy.base_model_path=nvidia/GR00T-N1.7-3B \
  --policy.embodiment_tag=new_embodiment \
  --device=cuda \
  --robot.type=seeed_b601_rs_follower \
  ...
Prós: sem ida e volta de rede, depuração conjunta simples. Contras: um host com GPU precisa estar no local.
Implantação distribuída (avançada)
| Nó | Localização |
|---|---|
| Máquina GPU | Servidor de Inferência (carrega GR00T) |
| On-site / IPC | Cliente de Controle (câmeras + driver do reBot) |
Cenários adequados: GPU de laboratório separada do braço em produção, múltiplos braços compartilhando um pool de inferência.
| Comparação | Máquina única | Distribuída |
|---|---|---|
| Latência | Principalmente tempo de inferência | Inferência + RTT de rede |
| Complexidade | Baixa | Necessita convenções de serialização, timeout, reconexão |
| Escalabilidade | Uma máquina, um braço | Um serviço, múltiplos clientes |
Conselho de escolha: primeiro faça o projeto de estágio rodar em uma única máquina; após confirmar a taxa de sucesso, divida para distribuída.
22.4 Entradas de Câmera, Estado e Linguagem
22.4 Entradas de Câmera, Estado e Linguagem
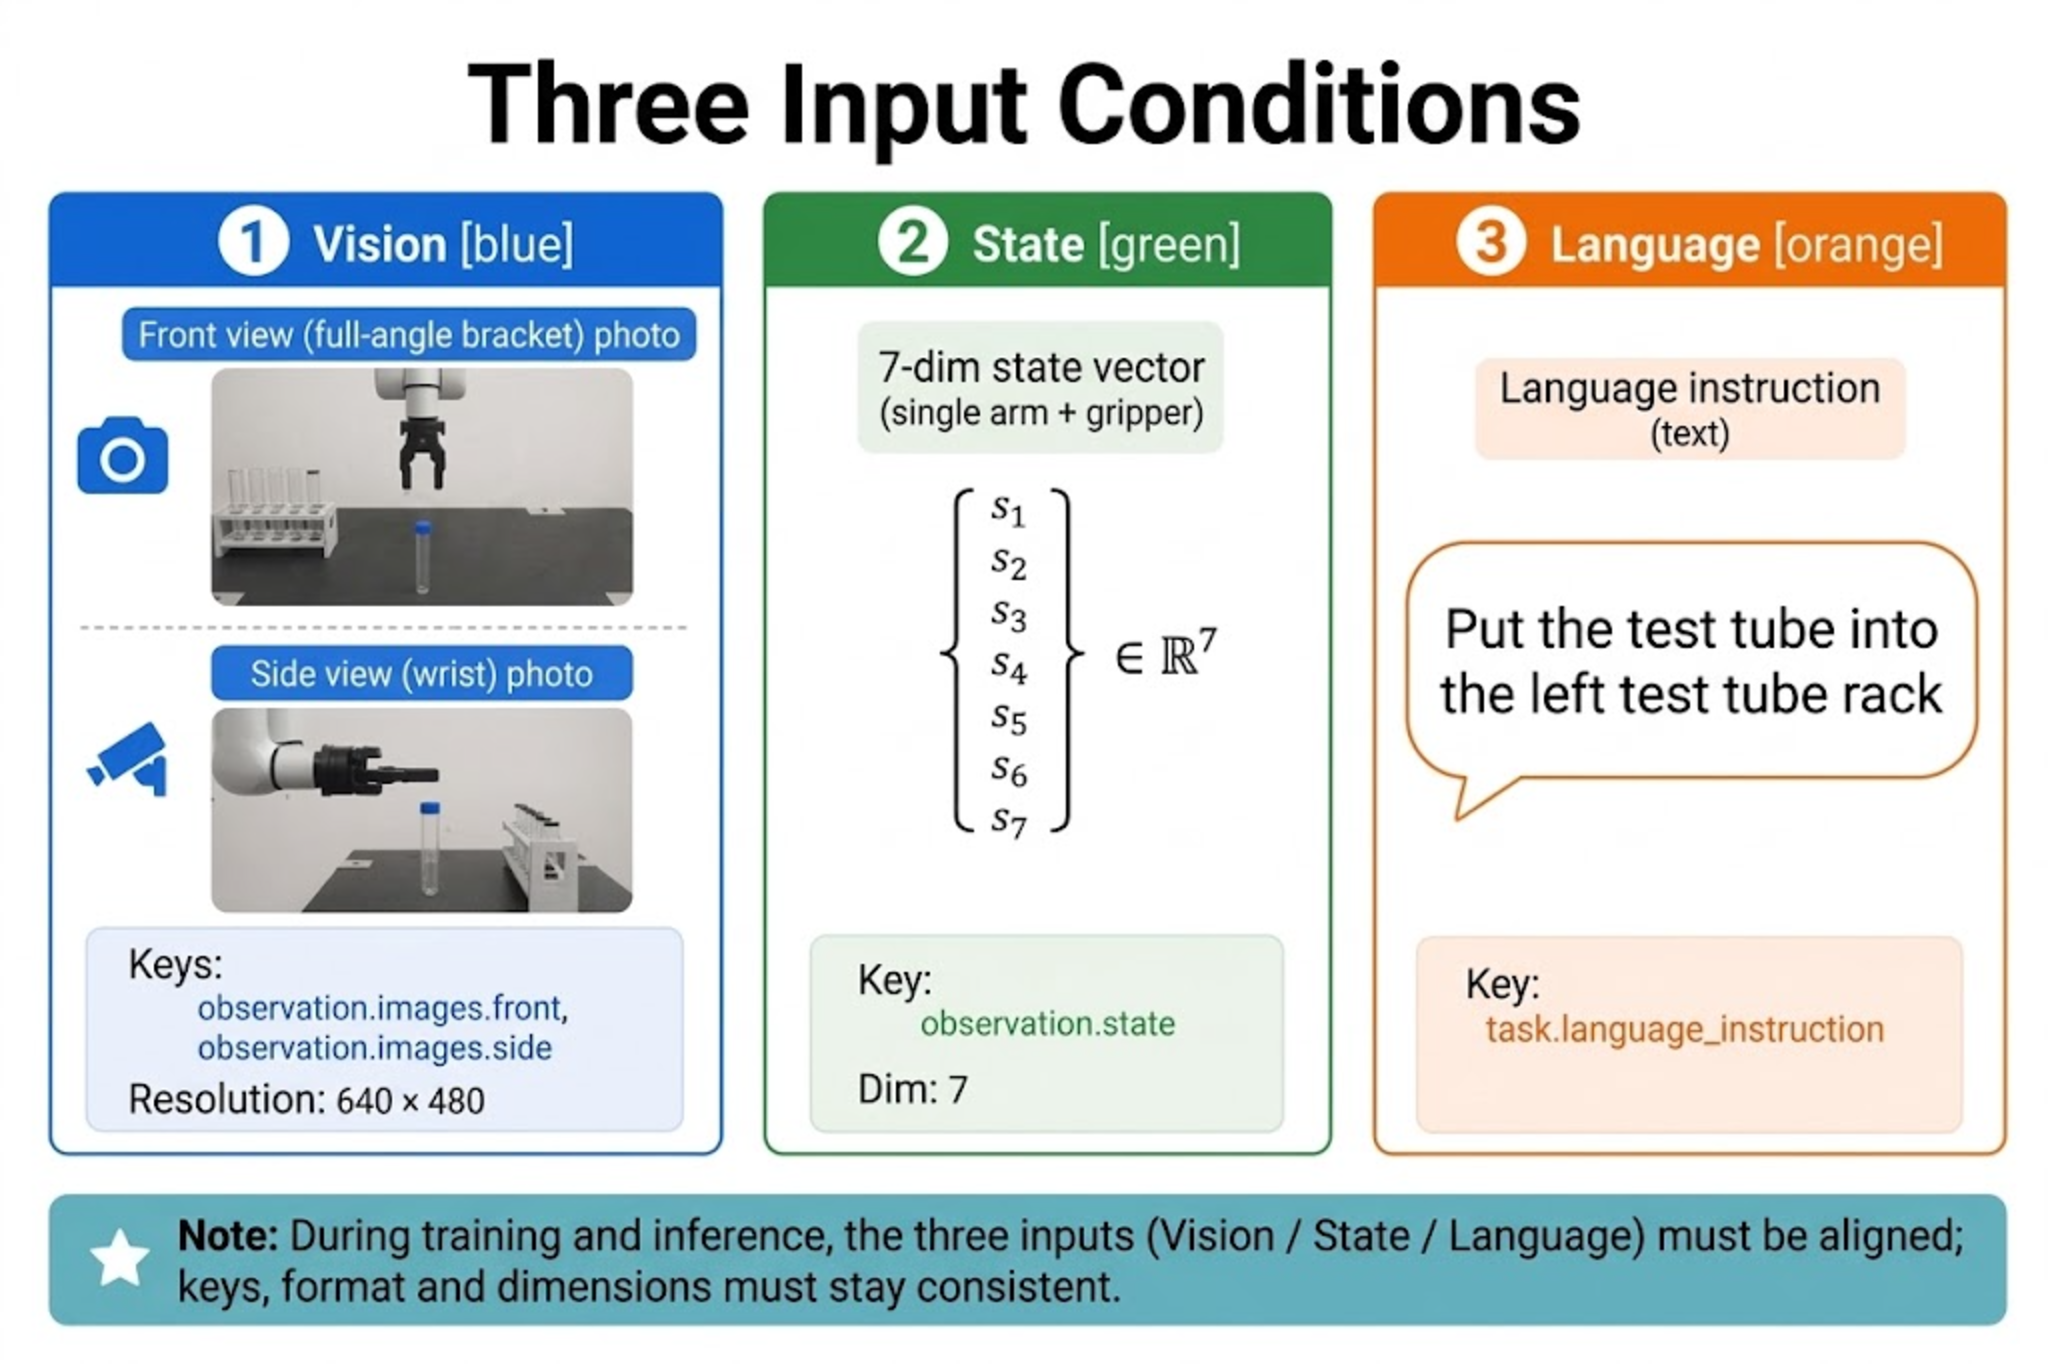
Cada chamada de inferência requer três entradas condicionais, todas essenciais (ou consistentes com o que foi declarado durante o treinamento):
1. Câmera (Visão)
| Nome da chave | Montagem | Finalidade |
|---|---|---|
observation.images.front -> front | Suporte visão ampla | Localização da cena e do alvo |
observation.images.side -> side | Punho | Mira em close, agarrar/colocar |
Resolução recomendada 640x480; treinamento e inferência devem coincidir.
2. Estado
reBot Arm: single_arm 6-dim + gripper 1-dim = 7 dimensões, ordem consistente com os Capítulos 19/20. O lado de controle lê os ângulos de junta mais recentes a cada ciclo de controle antes de enviar para a inferência.
3. Linguagem
Injetada via --task / dataset.single_task. Exemplo:
Place the test tube into the left rack.
Requisitos:
- Mesma língua e estilo de frase de
tasks.jsonl/human.task_descriptionde treinamento. - Referência de objeto clara (“suporte esquerdo” deve ser visualmente distinguível).
- Não mude de repente para uma instrução composta complexa nunca vista no treinamento.
22.5 Saída em Bloco de Ações
22.5 Saída em Bloco de Ações
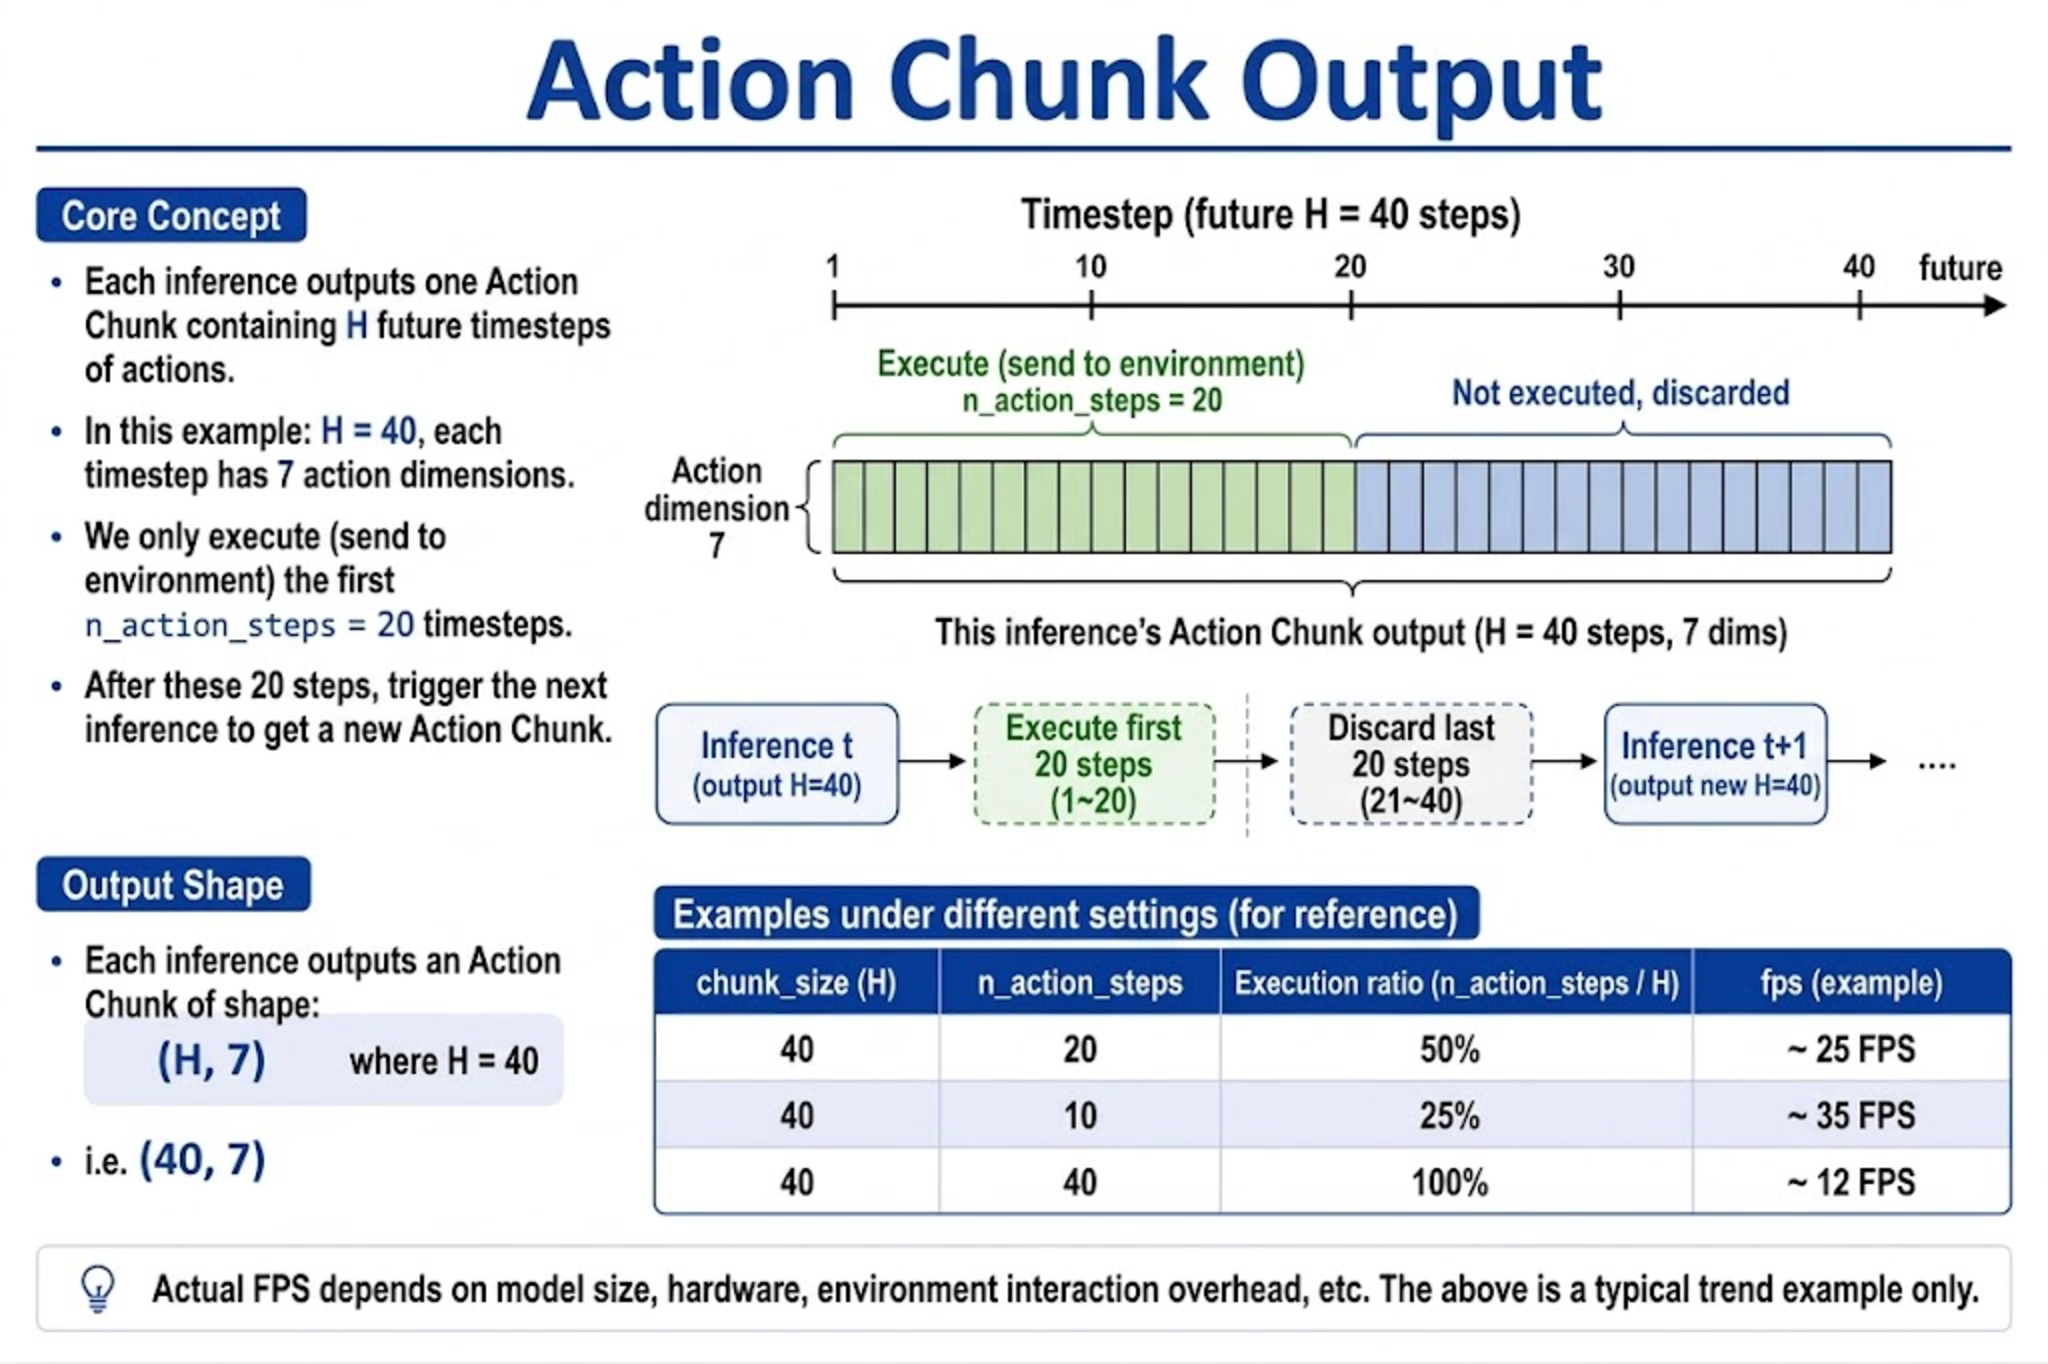
Uma única inferência GR00T não gera um comando instantâneo de junta, mas sim um bloco de ações:
action_chunk.shape ~= (H, 7)
H = chunk_size / action_horizon   # N1.7 fine-tuning commonly 40
each row 7-dim = 6 joints + gripper
Estratégia de execução do lado de controle:
| Parâmetro | Sugestão | Descrição |
|---|---|---|
chunk_size | 40 no treinamento | Determina quão à frente o modelo pode prever; não aumente arbitrariamente na inferência |
n_action_steps | Comece com 20 | Passos realmente executados nesta rodada, deve ser ≤ chunk_size |
| Frequência de execução | Próxima ao fps de gravação (por exemplo, 30 Hz) | Rápido ou lento demais desvia da distribuição de treinamento |
Se ações relativas estiverem habilitadas (use_relative_actions), o lado de controle deve restaurá-las para comandos absolutos de junta usando as mesmas regras do treinamento; o gripper geralmente é excluído de relativo.
22.6 Latência de Rede e de Inferência
22.6 Latência de Rede e de Inferência
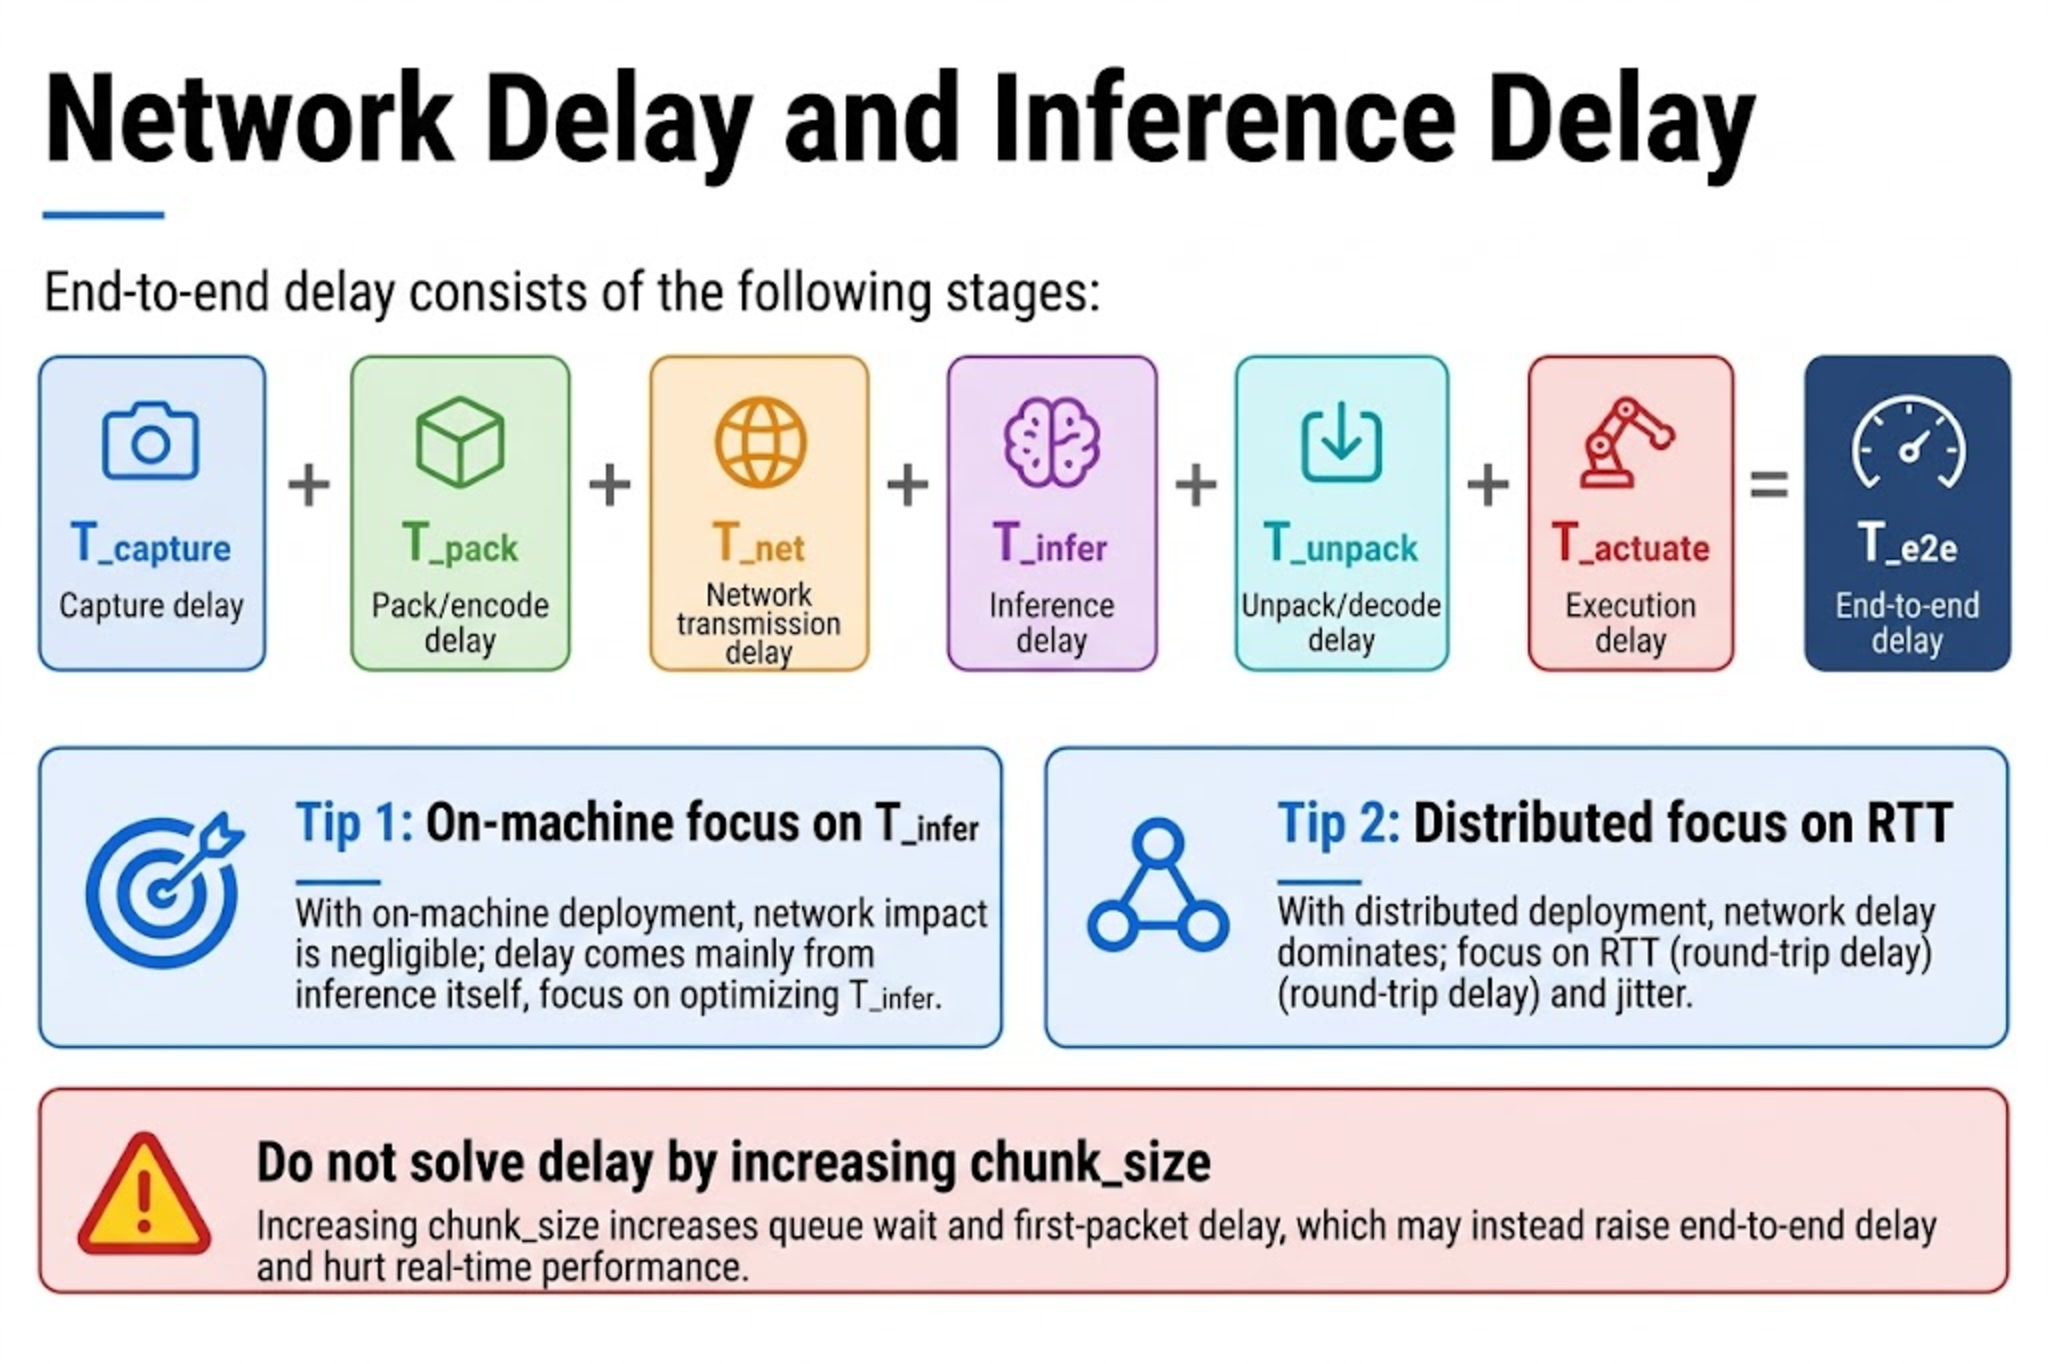
A latência ponta a ponta é aproximadamente:
T_e2e ~= T_capture + T_pack + T_net + T_infer + T_unpack + T_actuate
| Componente | Fonte típica | Mitigação |
|---|---|---|
T_capture | Exposição da câmera/USB | MJPG, resolução fixa, evitar pré-processamento extra |
T_infer | VLM + DiT | bf16, batch=1, Flash Attention |
T_net | RTT distribuído | Gigabit, mesmo datacenter, comprimir observações |
T_actuate | Ciclo de escrita CAN/serial | Manter a frequência de controle próxima ao treinamento |
Regras práticas:
- Máquina única: o gargalo geralmente é
T_infer; usen_action_stepsmenor + RTC para mascarar travamentos. - Distribuído: se o RTT for instável, primeiro desative o RTC para depuração síncrona, depois ative o assíncrono gradualmente.
- Não resolva latência "aumentando
chunk_size" — a janela é fixa pelo treinamento.
22.7 Bufferização de Ações e Inferência Assíncrona
22.7 Bufferização de Ações e Inferência Assíncrona
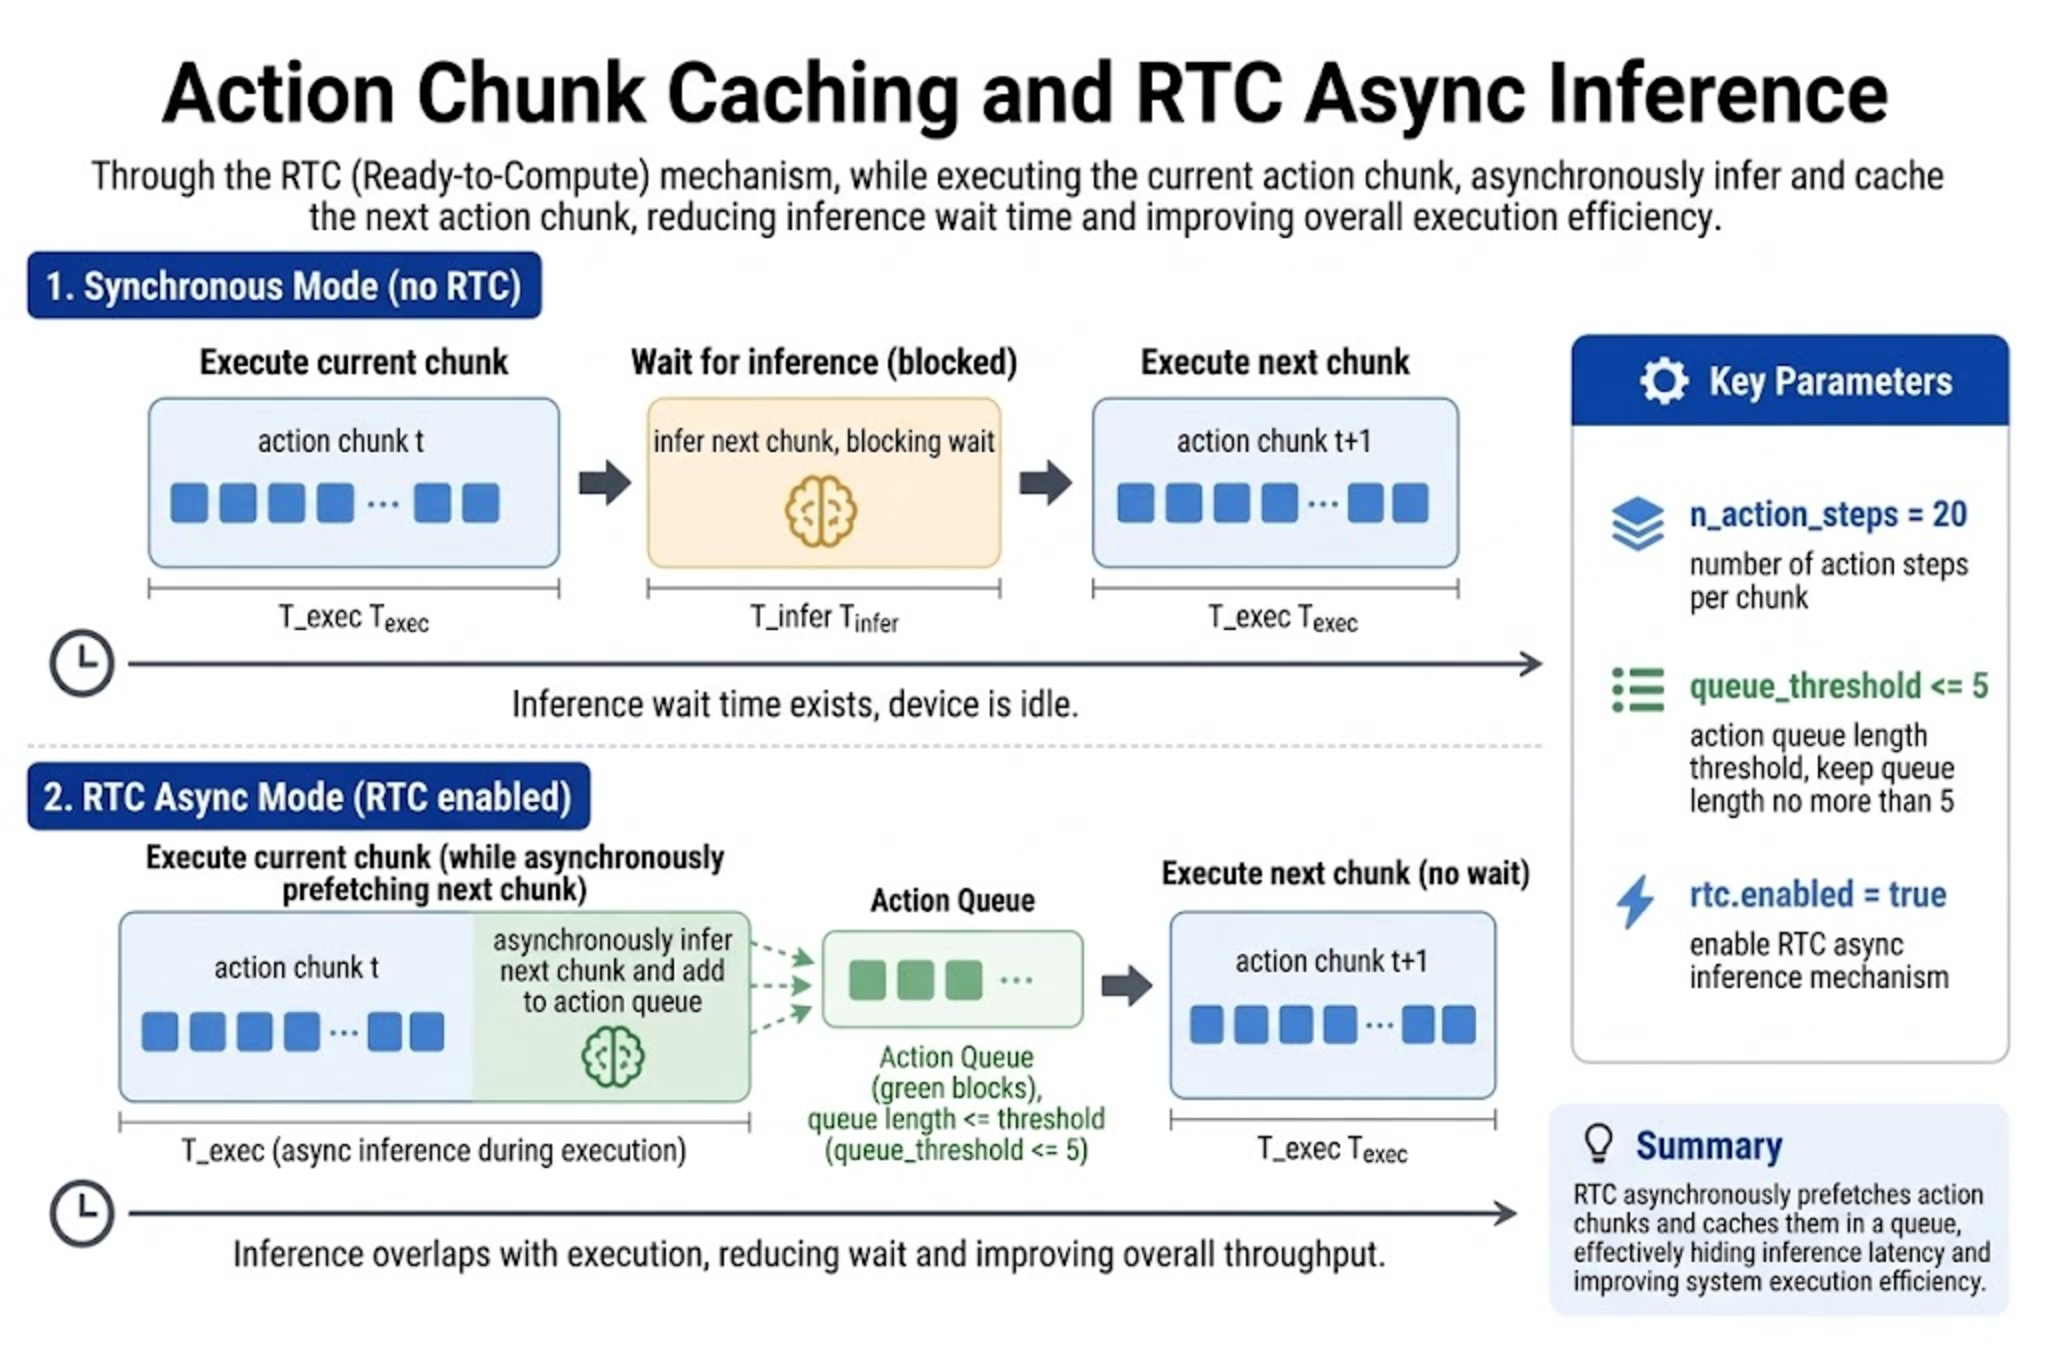
Fila de ações
O lado de controle escreve o action_chunk recebido em uma fila e o remove a cada ciclo de controle. Se o próximo chunk não tiver chegado antes de a fila esvaziar, o braço irá pausar ou reutilizar a última ação — o que é exatamente o que a inferência assíncrona evita.
RTC (Real-Time Chunking)
Enquanto executa o chunk atual, o backend solicita o próximo chunk com a observação mais recente:
lerobot-rollout \
  ... \
  --policy.n_action_steps=20 \
  --inference.type=rtc \
  --inference.rtc.enabled=true \
  --inference.rtc.execution_horizon=20 \
  --inference.queue_threshold=0
| Parâmetro | Sugestão |
|---|---|
n_action_steps / execution_horizon | Comece em 20, depois ajuste para jitter |
queue_threshold | Recomendado ≤ 5; muito grande acumula ações obsoletas |
Se aparecer jitter/soluços, primeiro defina --inference.rtc.enabled=false, confirme que o caminho síncrono está saudável e então ative o RTC.
22.8 Limites de Segurança em Robôs Reais
22.8 Limites de Segurança em Robôs Reais
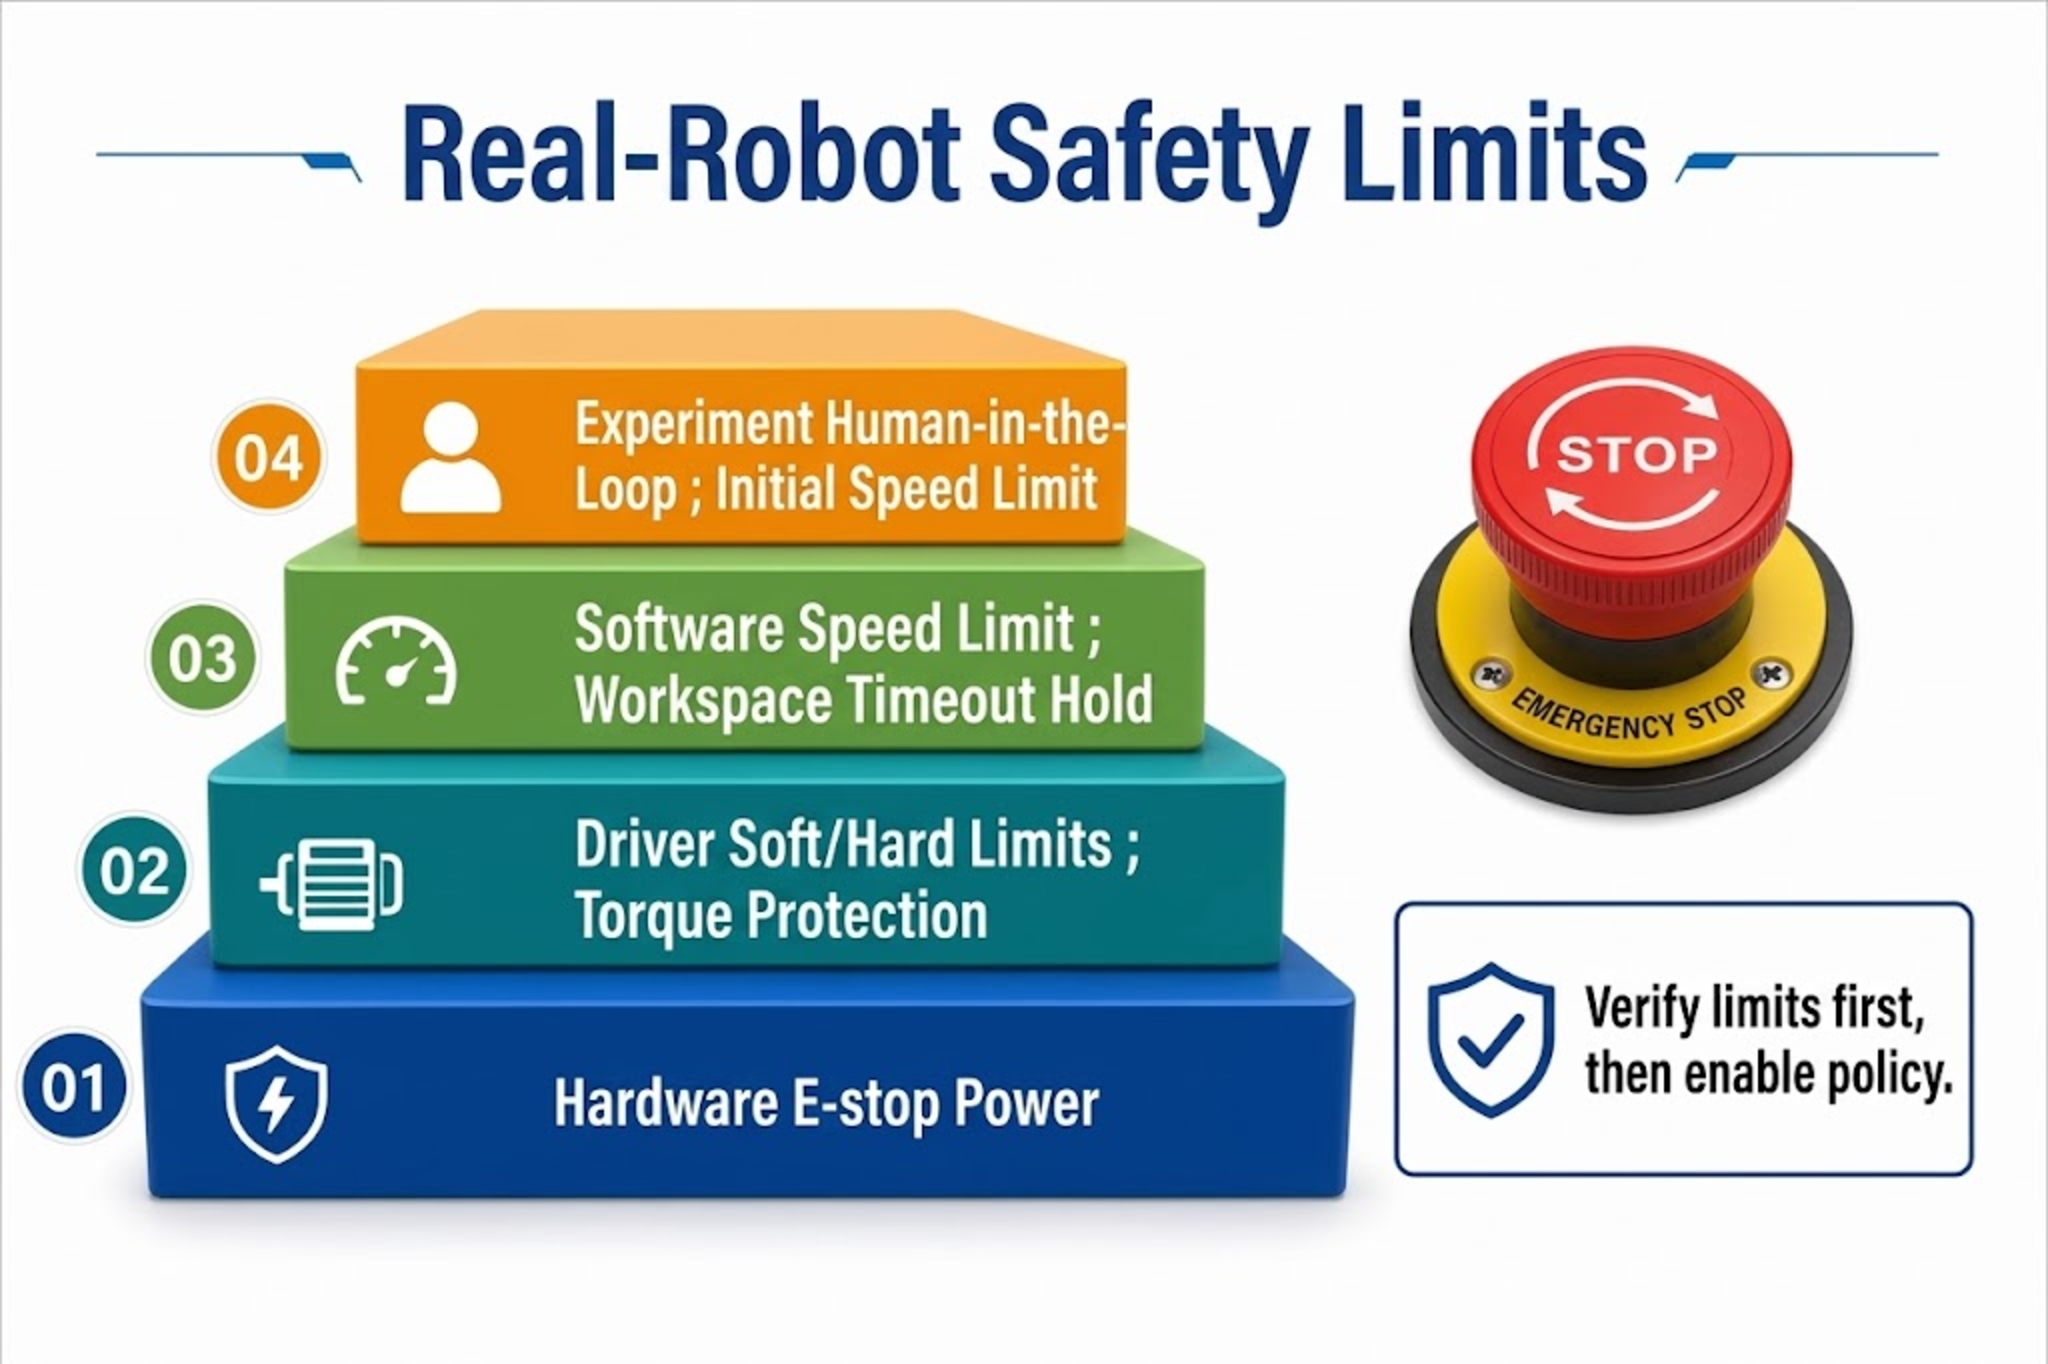
A saída do VLA não traz garantias físicas, portanto a segurança deve ser aplicada pela camada de controle:
| Camada | Medida |
|---|---|
| Hardware | Botão de parada de emergência (E-stop), corte de energia, gerenciamento de cabos para evitar emaranhamento |
| Driver / firmware | Limites suaves/duros de junta, proteção de corrente/torque |
| Controle por software | Limitação de velocidade/aceleração, caixa de workspace, manter ou mover para pose segura em caso de timeout |
| Fluxo experimental | Reduzir ganho/velocidade na primeira inferência; humano no loop; remover obstáculos não relacionados da mesa |
Checklist de depuração:
- Antes de carregar a política, use modo manual/teleop para confirmar que os limites são efetivos.
- No rollout da política, primeiro use um
--durationcurto para confirmar que não há fuga descontrolada. - Em movimento anormal, acione o E-stop imediatamente, registre o
taskatual, quadros da câmera e estado, depois revise os dados e a modalidade.
22.9 Avaliação de Tarefas VLA
22.9 Avaliação de Tarefas VLA
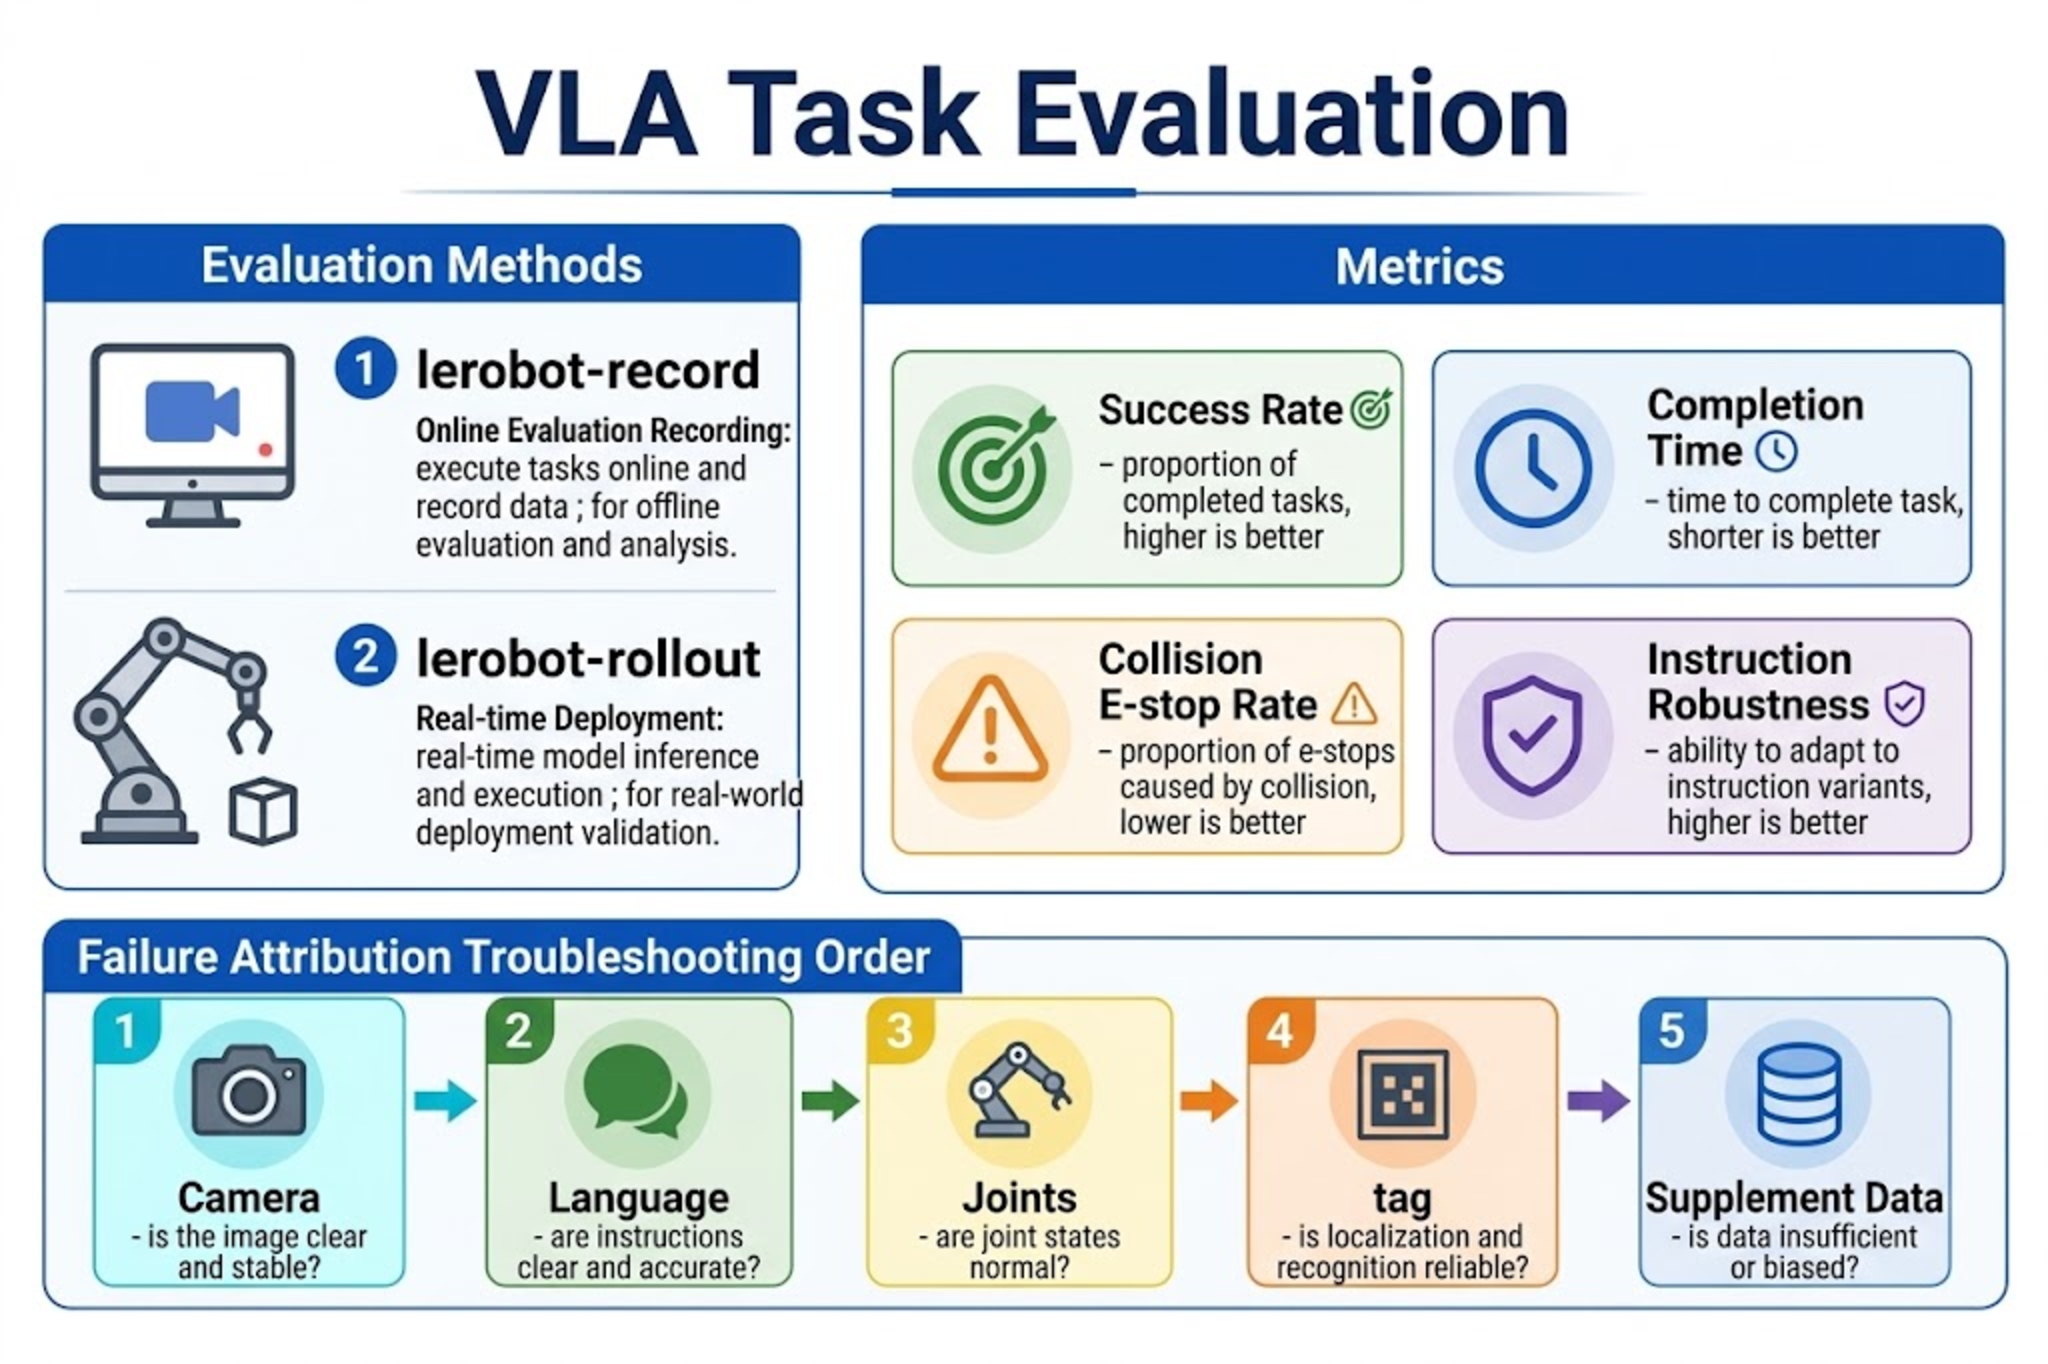
Métodos de avaliação
| Método | Ferramenta | Objetivo |
|---|---|---|
| Gravação de avaliação online | lerobot-record + --policy.path | Salvar episódios de falha/sucesso para replay |
| Implantação em tempo real | lerobot-rollout | Testar latência, RTC, estabilidade em horizontes longos |
Métricas sugeridas
| Métrica | Descrição |
|---|---|
| Taxa de sucesso | Sob condições iniciais e instruções fixas, sucessos / total (recomendado ≥ 20 execuções) |
| Tempo de conclusão | Segundos do início até o término da colocação |
| Taxa de colisão / E-stop | Proporção de colisões fora da tarefa ou intervenções manuais |
| Robustez da instrução | Uma instrução levemente reformulada para a mesma tarefa ainda tem sucesso (apenas dentro da distribuição de treinamento) |
Ordem de atribuição de falhas
- Os nomes de chave / resolução da câmera são consistentes com o treinamento?
- O padrão de frase em linguagem se desvia das anotações?
- Ordem das juntas e unidades.
embodiment_tag, chave de ação relativa.- Cobertura de dados insuficiente -> volte ao Capítulo 20 para coletar mais.
22.10 Projeto de Etapa: Colocar o Tubo de Ensaio no Suporte Esquerdo
22.10 Projeto de Etapa: Colocar o Tubo de Ensaio no Suporte Esquerdo
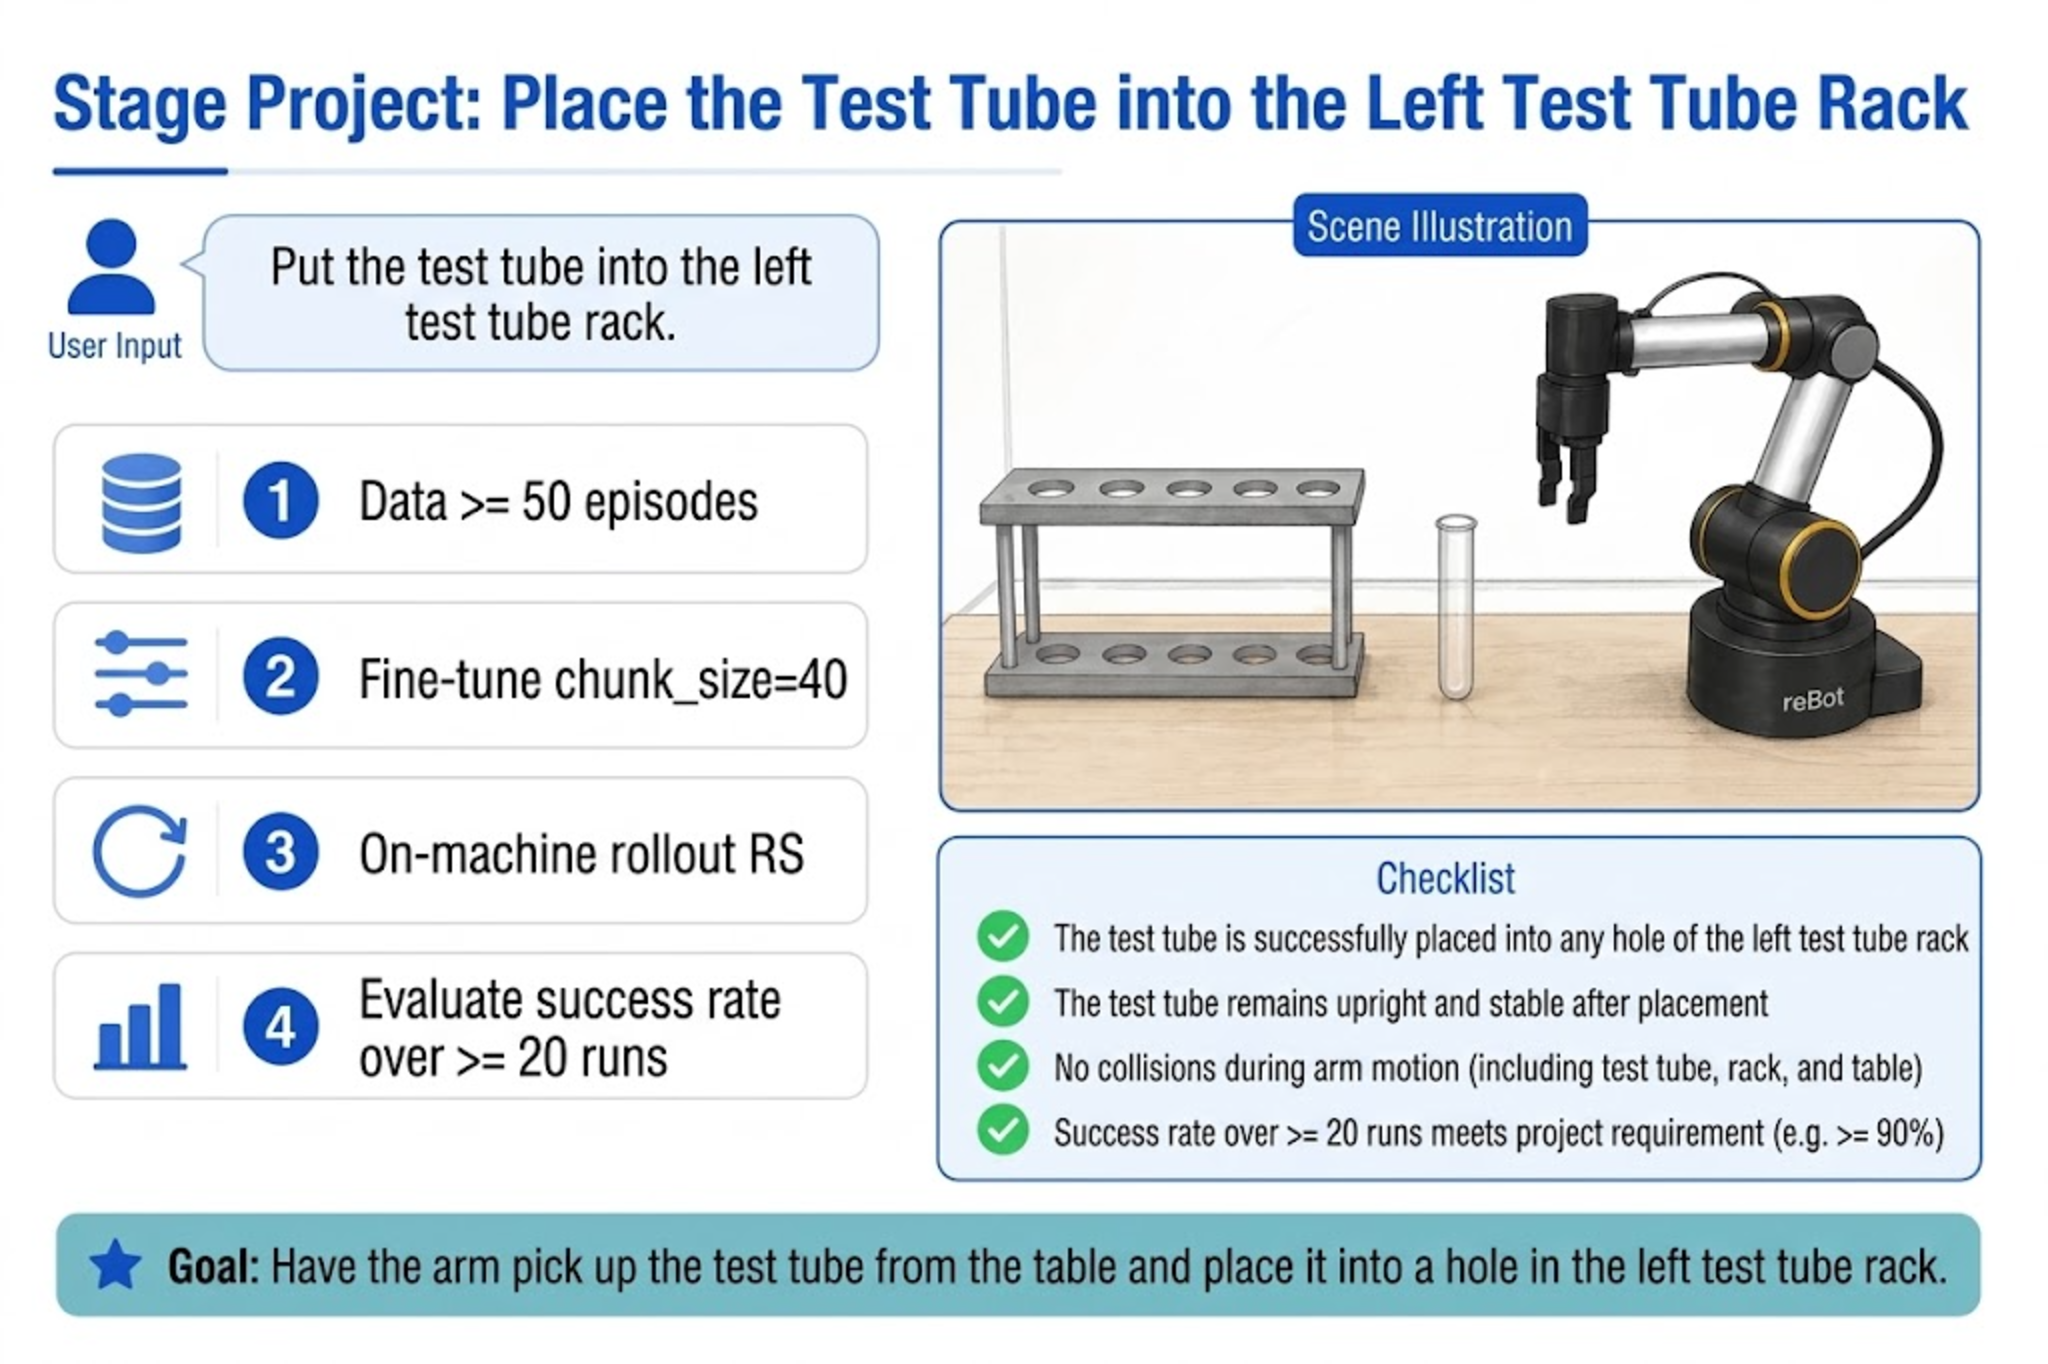
Objetivo do projeto
| Item | Conteúdo |
|---|---|
| Entrada do usuário | Place the test tube into the left rack. |
| Entrada do sistema | Visão ampla front + punho side + estado atual de 7 dimensões |
| Saída esperada | O braço completa pegar o tubo -> mover para o suporte esquerdo -> colocar -> soltar o gripper |
Etapas de implementação
-
Dados (se ainda não cobrirem esta tarefa)
- Coletar ≥ 50 demonstrações bem-sucedidas; anotar de forma uniforme usando o padrão de frase acima.
- Escrever
meta/modality.json(front/side,single_arm+gripper,human.task_description).
-
Fine-tuning (Capítulo 21)
embodiment_tag=new_embodiment,chunk_size=40.- Obter
checkpoints/last/pretrained_model.
-
Inferência em implantação em máquina única (exemplo B601-RS; para DM altere
type/port/can_adapter)
export MODEL_PATH="outputs/train/${REPO_ID}/checkpoints/last/pretrained_model"

# RS CAN
sudo ip link set can0 down 2>/dev/null
sudo ip link set can0 type can bitrate 1000000
sudo ip link set can0 up

lerobot-rollout \
  --strategy.type=base \
  --policy.path=${MODEL_PATH} \
  --policy.base_model_path=nvidia/GR00T-N1.7-3B \
  --policy.embodiment_tag=new_embodiment \
  --policy.n_action_steps=20 \
  --robot.type=seeed_b601_rs_follower \
  --robot.port=can0 \
  --robot.id=follower1 \
  --robot.can_adapter=socketcan \
  --robot.cameras="{ front: {type: opencv, index_or_path: 0, width: 640, height: 480, fps: 30, fourcc: "MJPG"}, side: {type: opencv, index_or_path: 2, width: 640, height: 480, fps: 30, fourcc: "MJPG"}}" \
  --task="Place the test tube into the left rack." \
  --duration=90 \
  --device=cuda \
  --display_data=true \
  --inference.type=rtc \
  --inference.rtc.enabled=true \
  --inference.rtc.execution_horizon=20 \
  --inference.queue_threshold=0
- Avaliação
- Fixar o layout da mesa, repetir ≥ 20 vezes, registrar a taxa de sucesso.
- Arquivar episódios de falha com
lerobot-record; analisar se o erro está na localização, na pega ou na colocação.
Critérios de aceitação
- Dada a instrução "Place the test tube into the left rack.", a tarefa pode ser executada ponta a ponta.
-
front/sidecorrespondem ao treinamento, sem erros de chave do tipomean is infinity. - E-stop e limites suaves funcionam; o movimento pode ser interrompido manualmente em comportamento anormal.
- Registrar a taxa de sucesso e decidir se o próximo passo é mais dados ou ajuste de
n_action_steps/ RTC.
22.11 Resumo do Capítulo
22.11 Resumo do Capítulo
- Desacoplamento: o lado de controle lida com captura e execução, o lado de inferência lida com o forward pass do VLA; a interface é observação -> Action Chunk.
- Implantação: comece em máquina única, depois vá para distribuído conforme necessário; distribuído exige atenção extra à latência de rede.
- Entradas: câmeras + estado + linguagem devem se alinhar estritamente com o treinamento.
- Saída: consumir o action chunk por
n_action_steps; o RTC usa uma fila para mascarar o tempo de inferência. - Segurança: limites, E-stop e limitação de velocidade são aplicados pela camada de controle.
- Avaliação: taxa de sucesso + atribuição de falhas; o projeto de etapa valida o loop fechado "linguagem -> ação em robô real".
Você agora completou todo o caminho desde teoria de VLA, dados, fine-tuning, até implantação em robô real GR00T. Para iterações futuras, priorize coletar dados para cenários de falha em vez de aumentar cegamente os passos de treinamento.