9. Fundamentos de Aprendizado de Robôs e Aprendizado por Imitação
Capítulo 9 do Curso para Iniciantes em IA Física da Seeed — por que o braço precisa de aprendizado, controle baseado em regras vs. baseado em aprendizado, observação/estado/ação, blocos de ação, distribuição de dados e as três fases de treinamento, inferência e avaliação.
9.1 Por Que Braços Robóticos Precisam de Aprendizado?
9.1 Por Que Braços Robóticos Precisam de Aprendizado?
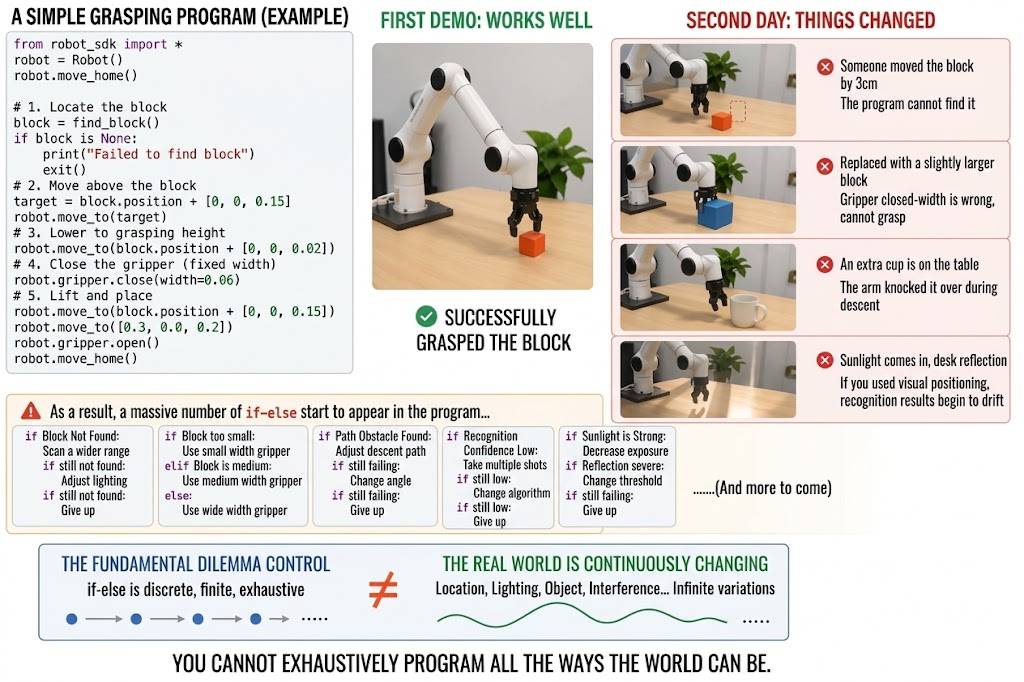
No Estágio 2, você já consegue controlar o braço robótico com o SDK em Python: ler ângulos das juntas, enviar posições alvo, abrir e fechar a garra. Então é natural pensar — é só escrever um programa que faça o braço pegar automaticamente os blocos na mesa, certo?
Então você escreve esse programa. Na primeira demonstração no laboratório, o programa funcionou muito bem. Mas no dia seguinte, as coisas mudam — e você vai perceber que, para lidar com essas mudanças, cada vez mais instruções "if" são adicionadas ao programa, até que ele se torna um enorme catálogo de casos especiais que ninguém consegue manter.
Este é o dilema fundamental do controle programático tradicional: o mundo real muda continuamente, enquanto if-else é discreto. Você não consegue enumerar todos os possíveis estados do mundo.
Permitir que braços robóticos adquiram habilidades dessa forma é justamente o que o Aprendizado de Robôs busca resolver. E o aprendizado por imitação abordado neste estágio é a abordagem mais madura e mais fácil de implantar em hardware real.
9.2 Controle Baseado em Regras vs. Controle Baseado em Aprendizado
9.2 Controle Baseado em Regras vs. Controle Baseado em Aprendizado
Antes de continuar, vamos colocar lado a lado as duas abordagens de controle e enxergá-las com clareza.
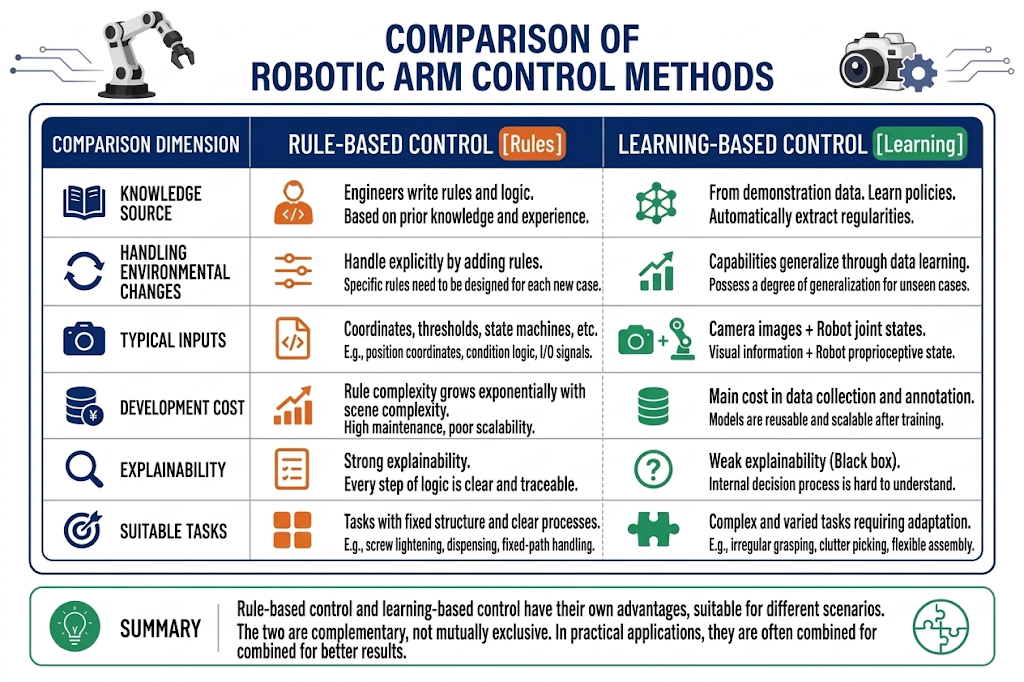
Os Estágios 3 e 4 deste curso seguem o caminho do "controle baseado em aprendizado". Mas lembre-se: mesmo no futuro, seus sistemas de aprendizado ainda manterão um grande número de regras — como limites de juntas e restrições de velocidade segura. Aprendizado e regras são complementares.
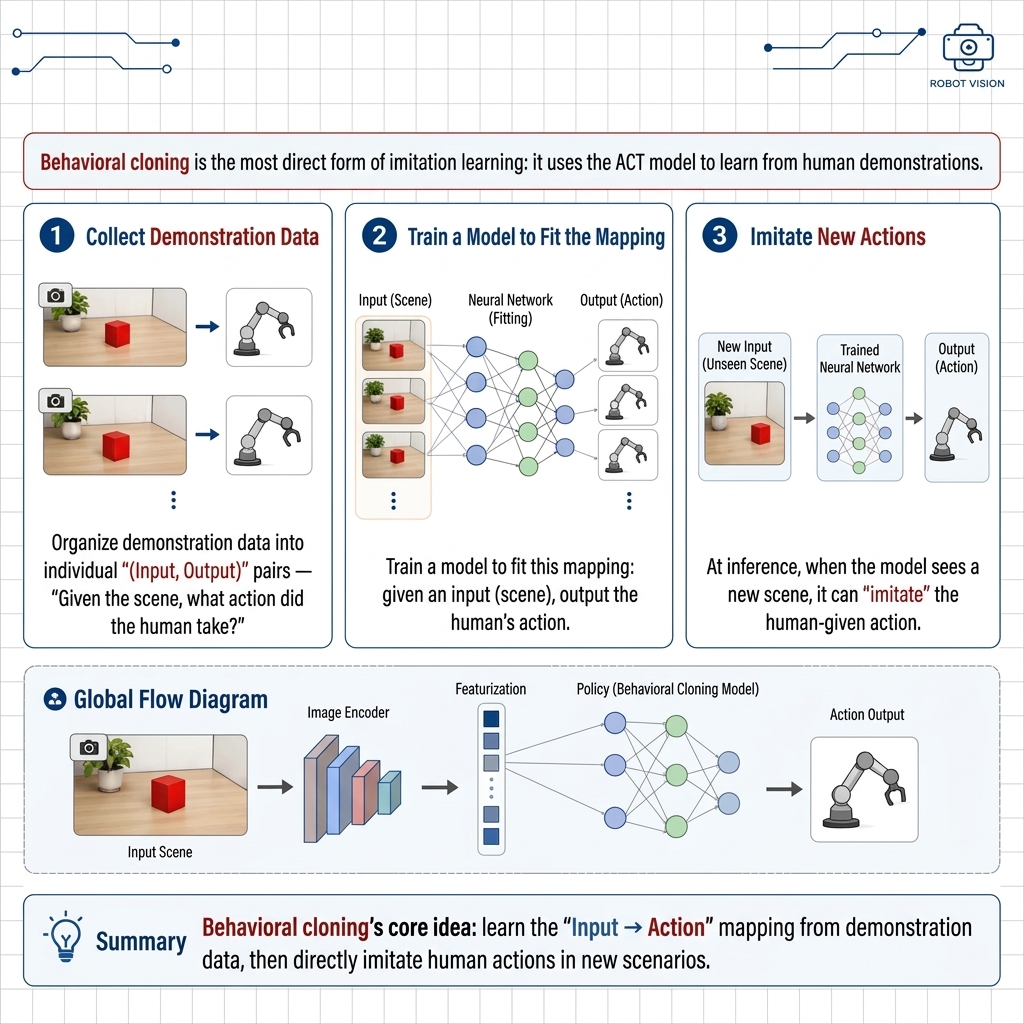
9.3 Aprendizado por Imitação e Behavioral Cloning
9.3 Aprendizado por Imitação e Behavioral Cloning
O Que é Aprendizado por Imitação
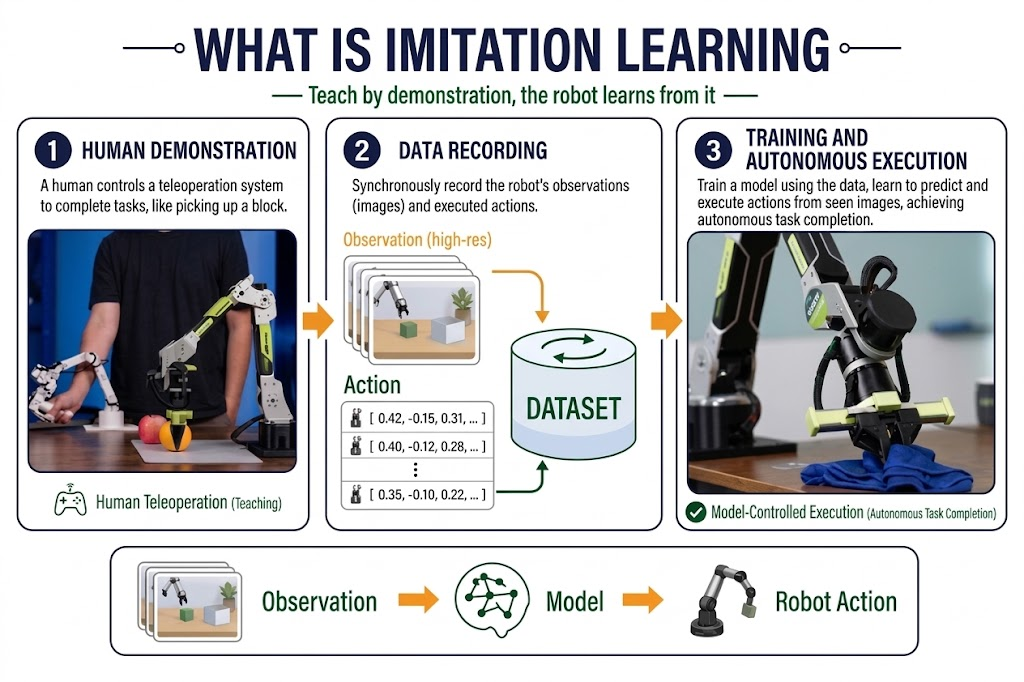
O Que é Behavioral Cloning
9.4 Observação, Estado e Ação
9.4 Observação, Estado e Ação
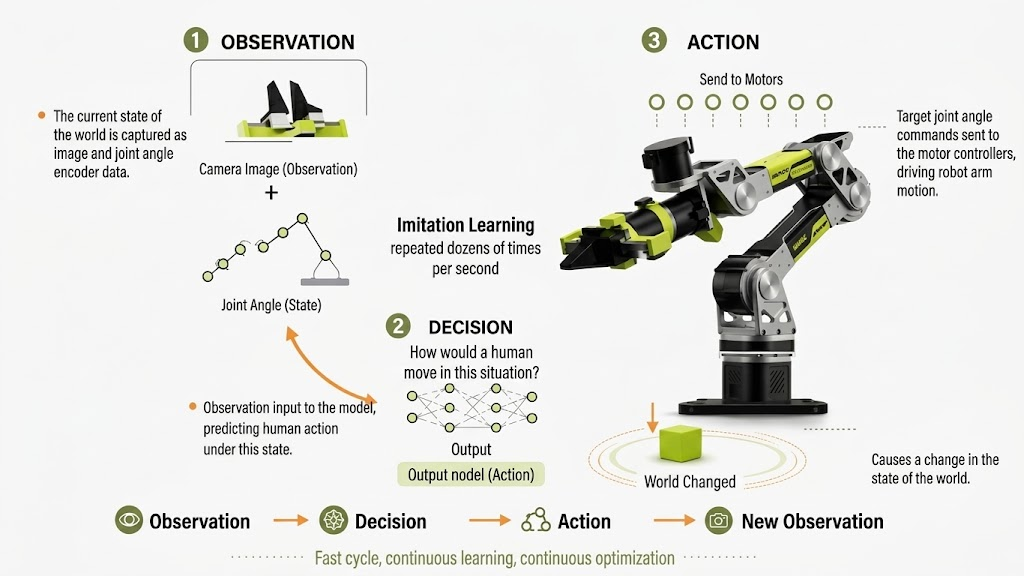
Todos os dados em aprendizado por imitação podem ser categorizados em três conceitos. Esses três termos aparecerão repetidamente em todos os capítulos seguintes, então construa aqui uma intuição precisa.
- Observação: o mundo que o robô "vê".
- Estado: a condição "própria" do robô.
- Ação: o que o robô "vai fazer".
9.5 Ações de Único Passo vs. Blocos de Ação
9.5 Ações de Único Passo vs. Blocos de Ação
- Ação de único passo: uma decisão por quadro.
- Bloco de ação: prever de uma vez uma sequência de ações.
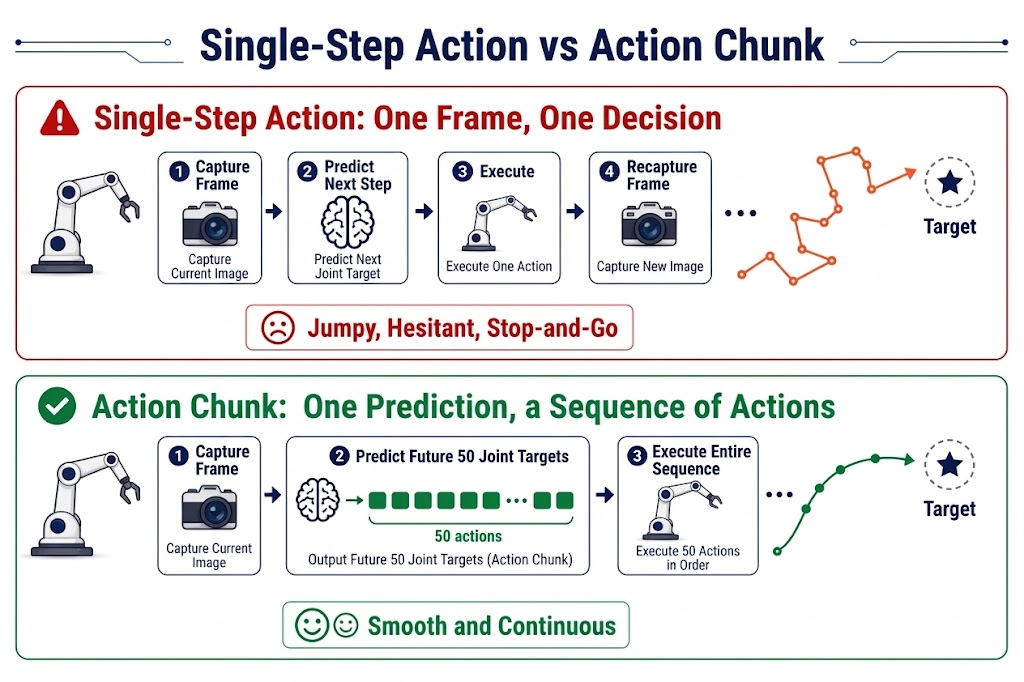
Claro, blocos de ação mais longos nem sempre são melhores. Prever muito à frente significa que o ambiente pode mudar no meio da execução (por exemplo, um objeto é esbarrado), enquanto o braço ainda está executando ações "desatualizadas". Sistemas reais usam um compromisso: executar em malha aberta por um curto segmento, depois reobservar e voltar a prever.
9.6 Distribuição de Dados e Generalização do Modelo
9.6 Distribuição de Dados e Generalização do Modelo
Esta é a seção mais importante deste capítulo, e a que iniciantes mais facilmente ignoram, mas que determina o sucesso ou fracasso na prática. Guarde primeiro esta frase:
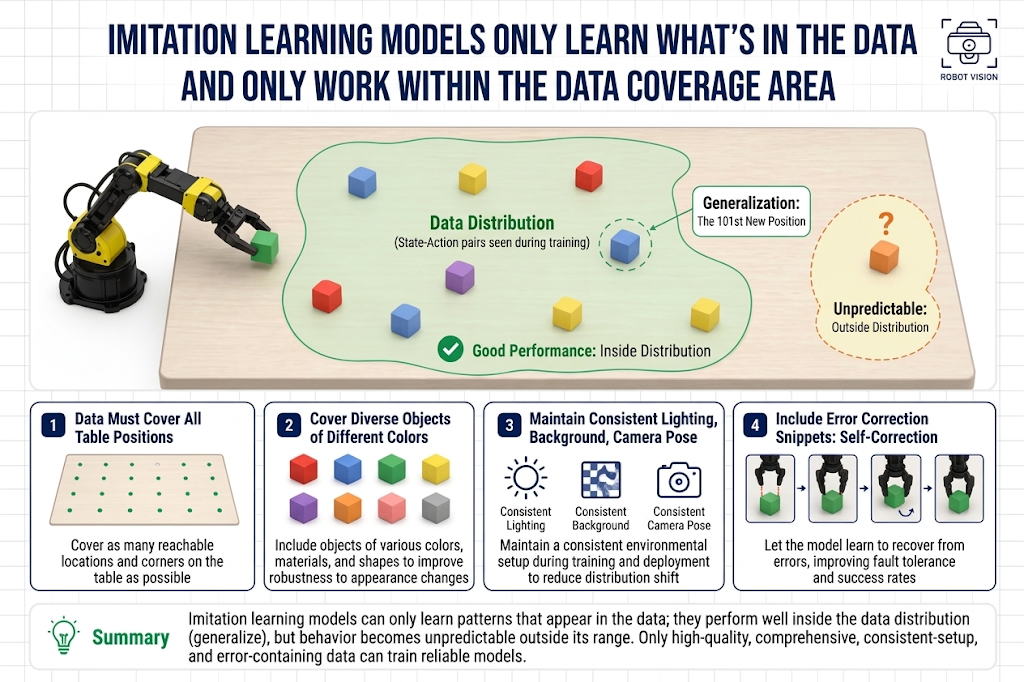
Um modelo de aprendizado por imitação só consegue aprender o que está nos dados e só consegue funcionar dentro do intervalo coberto pelos dados.
- Todos os pares (observação, ação) que o modelo viu durante o treinamento constituem uma Distribuição de Dados. Durante a inferência, se as imagens e estados que o braço encontra caírem dentro dessa distribuição, o modelo geralmente se comporta bem; uma vez que saiam da distribuição, a saída do modelo perde sua base e o comportamento se torna imprevisível.
Isso leva a várias implicações bem práticas:
- Se você quer que ele pegue blocos em qualquer posição da mesa, os dados precisam cobrir todas as posições da mesa — se você só coletar dados no centro da mesa, o modelo só vai pegar no centro.
- Se você quer que ele pegue objetos de cores diferentes, os dados precisam conter cores diferentes — caso contrário, uma nova cor é um mundo desconhecido para ele.
- Iluminação, fundo e posição da câmera devem permanecer o mais consistentes possível com a coleta de dados — um modelo treinado com dados coletados à tarde pode falhar completamente sob iluminação interna à noite.
E generalização é a capacidade do modelo de aplicar padrões aprendidos a partir dos dados a novas situações dentro da distribuição que ele não viu individualmente. Por exemplo, se no treinamento ele viu blocos em 100 posições diferentes, e durante a inferência um bloco aparece na 101ª posição (ainda sobre a mesa), o modelo ainda consegue pegá-lo — isso é generalização. Generalização não é mágica; ela vem da diversidade dos dados: quanto mais rica e contínua for a cobertura dos dados, menores serão as "lacunas" dentro da distribuição e melhor será a generalização.
O limite superior do aprendizado por imitação é essencialmente determinado no momento em que os dados são coletados. O treinamento apenas realiza esse limite superior.
9.7 Treinamento, Inferência e Avaliação
9.7 Treinamento, Inferência e Avaliação
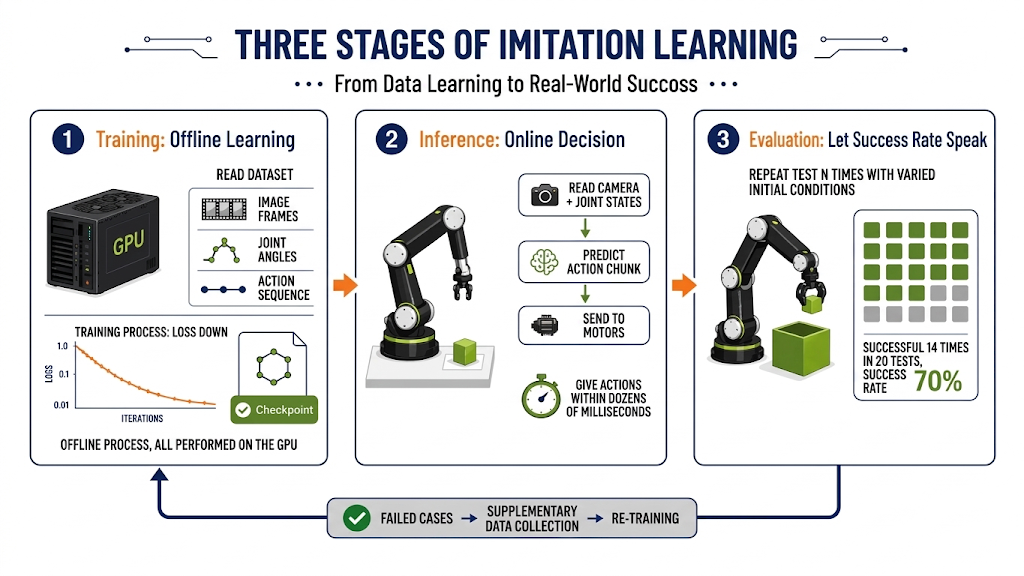
Treinamento: Aprendizado Offline
O treinamento acontece depois que a coleta de dados é concluída; é um processo offline: o braço pode ser desligado e deixado de lado; todo o trabalho é feito na GPU.
- Input: conjunto de dados coletado (séries temporais de imagens, State e Action);
- Processo: o modelo lê repetidamente os dados, ajustando continuamente seus parâmetros internos para que suas Actions previstas se aproximem cada vez mais das demonstrações humanas;
- Output: um arquivo de modelo treinado.
A qualidade do treinamento é observada principalmente por meio da Loss: à medida que a Loss diminui, as ações previstas pelo modelo se tornam cada vez mais parecidas com as demonstrações humanas.
Inferência: Tomada de Decisão Online
Inferência é o processo em que o modelo é implantado no robô real e funciona em tempo real: ler câmera e estados das juntas → o modelo prevê um Action Chunk → enviá-lo para os motores para execução. A inferência tem requisitos de tempo real — o modelo precisa gerar ações em dezenas de milissegundos, caso contrário o braço vai engasgar.
Avaliação: Julgada pela Taxa de Sucesso
O modelo foi treinado, a Loss está baixa — ele realmente consegue fazer o trabalho? Não necessariamente.
Loss baixa só significa que o modelo é "parecido com o humano", não que ele "consiga completar a tarefa". O único método de avaliação confiável é o teste em robô real:
- Definir critérios claros de sucesso da tarefa (por exemplo, "o bloco termina dentro da caixa");
- Variar as condições iniciais (posição do bloco, iluminação), repetir o teste N vezes;
- Calcular a taxa de sucesso da tarefa — por exemplo, 14 sucessos em 20 testes = 70% de taxa de sucesso.
Casos de falha encontrados durante a avaliação não são pontos finais; eles são insumo para a próxima rodada de coleta de dados — onde quer que ocorram falhas, colete dados adicionais ali e então retreine. Este é o ciclo de iteração de dados, e é a rotina diária de projetos reais de aprendizado de robôs.
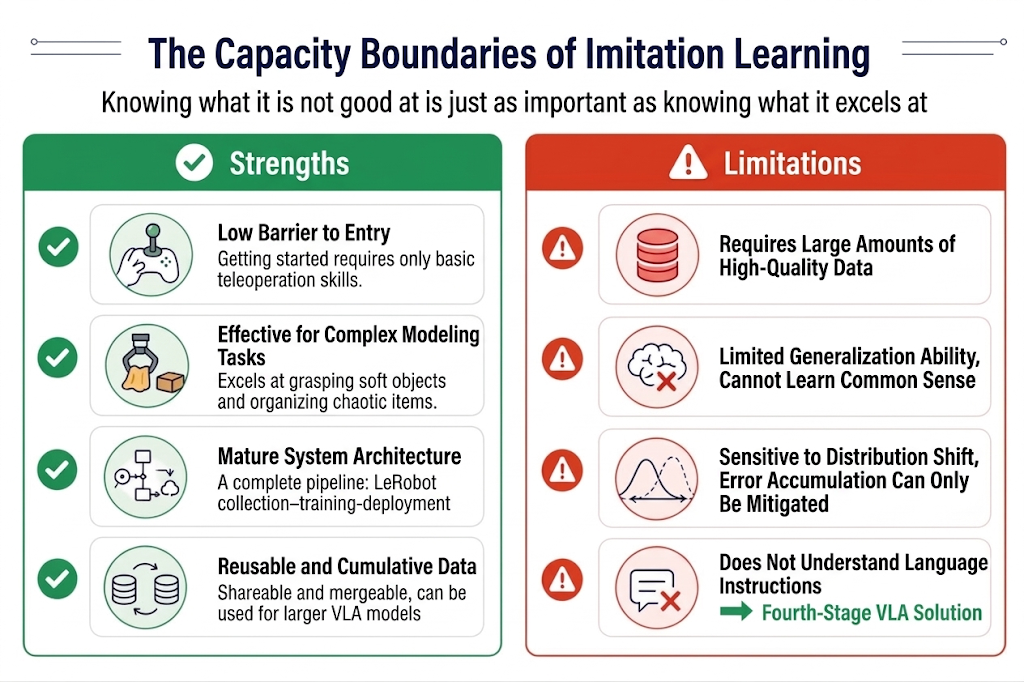
9.8 Vantagens e Limitações do Aprendizado por Imitação
9.8 Vantagens e Limitações do Aprendizado por Imitação