Arquitetura do Sistema de Chat com IA do reSpeaker Clip
Um guia em linguagem simples sobre como funciona o sistema de chat do Agente de IA do reSpeaker Clip. Tudo aqui é derivado do README e do código real em backend/.
1. Visão geral
O sistema é um assistente de IA com foco em voz, construído em Flask + LangGraph + Groq. Você fala ou digita uma mensagem, o agente decide como lidar com ela, opcionalmente chama ferramentas, produz uma resposta e fala a resposta de volta para você.
A pipeline em resumo:
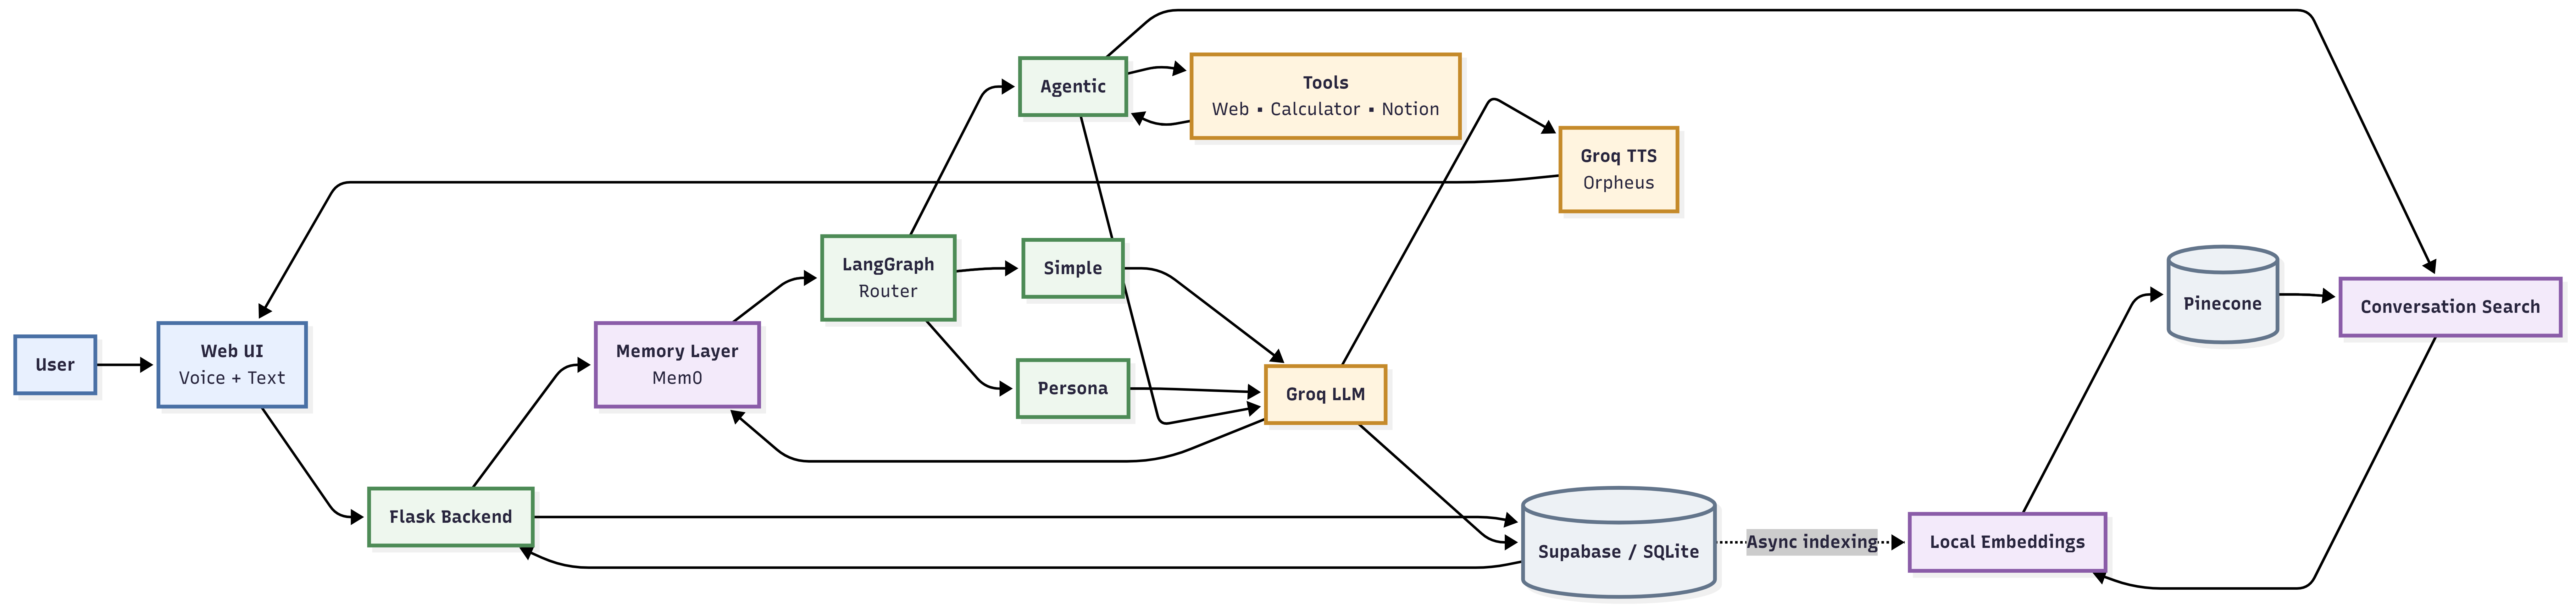
Três ideias fazem isso funcionar:
- Um roteador classifica cada requisição em um de três caminhos.
- Um agente em um desses caminhos pode chamar ferramentas (busca na web, calculadora, Notion, busca em conversas passadas).
- Um armazenamento vetorial + camada de memória permite que o agente relembre suas conversas passadas e fatos de longo prazo.
2. Diagrama da Arquitetura do Sistema
As partes se encaixam assim:
- Flask é a superfície de API (chat, streaming, voz, TTS).
- LangGraph é a máquina de estados que roteia a requisição e executa o nó escolhido.
- Groq fornece o LLM, speech-to-text (Whisper) e text-to-speech (Orpheus).
- Mem0 fornece memória de longo prazo; Pinecone + embeddings locais fornecem busca em conversas passadas.
- Supabase (com um fallback em SQLite) armazena conversas, mensagens e resumos.
3. Os Três Caminhos de Roteamento
Cada requisição é roteada para exatamente um de três nós. O código mapeia a string de rota para um nó em backend/graph/graph.py:
simple — Chat sem contexto
- Uma resposta simples de LLM. Sem ferramentas, sem personalidade especial.
- Usado para perguntas gerais, explicações e conversa normal.
- Nó:
simple_node(backend/graph/nodes/simple.py), LLM = o modelo principal da Groq.
context — Agente (com ferramentas)
- A requisição pode precisar de informações externas ou de uma ferramenta (web, matemática, Notion, conversas passadas).
- Este nó constrói um agente LangChain com
create_agente permite que o modelo chame ferramentas em um loop. - Nó:
agentic_node(backend/graph/nodes/agentic.py), LLM = um modelo dedicado a chamadas de ferramentas (gpt-oss-20b).
persona — Estilizado
- O usuário pede explicitamente um estilo, personalidade, papel ou estilo de ensino.
- Mesma mecânica que
simple, mas com um prompt de sistema diferente que diz ao modelo para adaptar seu tom. - Nó:
persona_node(backend/graph/nodes/persona.py), LLM = o modelo principal da Groq.
4. Lógica de Classificação
O roteamento acontece em router_node (backend/graph/router.py) usando uma pré-verificação de palavras-chave seguida de uma classificação por LLM.
-
Pré-verificação de palavras-chave (caminho rápido). A transcrição é analisada em busca de palavras-chave de ferramentas. Se alguma corresponder, a rota é forçada para
contexte o LLM é totalmente ignorado:notion, to-do, todo, task list, to do list, calendar,
schedule, reminder, note down, create a task, add a taskExemplo: "add a task to my to-do list" nem chega ao classificador.
-
Classificação por LLM. Caso contrário, a requisição é enviada para o modelo principal da Groq com o
ROUTER_PROMPT, que é um prompt de classificação que retorna exatamente uma palavra:Rota Entrada que dispara simplePerguntas gerais, explicações, conversa normal, sem necessidade de ferramentas/persona contextPode precisar de informações/ferramentas externas, gerenciamento de dados (Notion/calendário), perguntas sobre o dispositivo/arquivos/informações armazenadas do usuário personaUsuário pede explicitamente um estilo, personalidade, estilo de ensino, papel ou comportamento -
Fallback. A saída é convertida para minúsculas e aparada. Qualquer coisa que não esteja em
{simple, context, persona}volta parasimple.
5. Sistema de Ferramentas do Agente
Como funciona a chamada de ferramentas
O caminho context usa create_agent do LangChain (backend/graph/nodes/agentic.py). O loop se parece com:
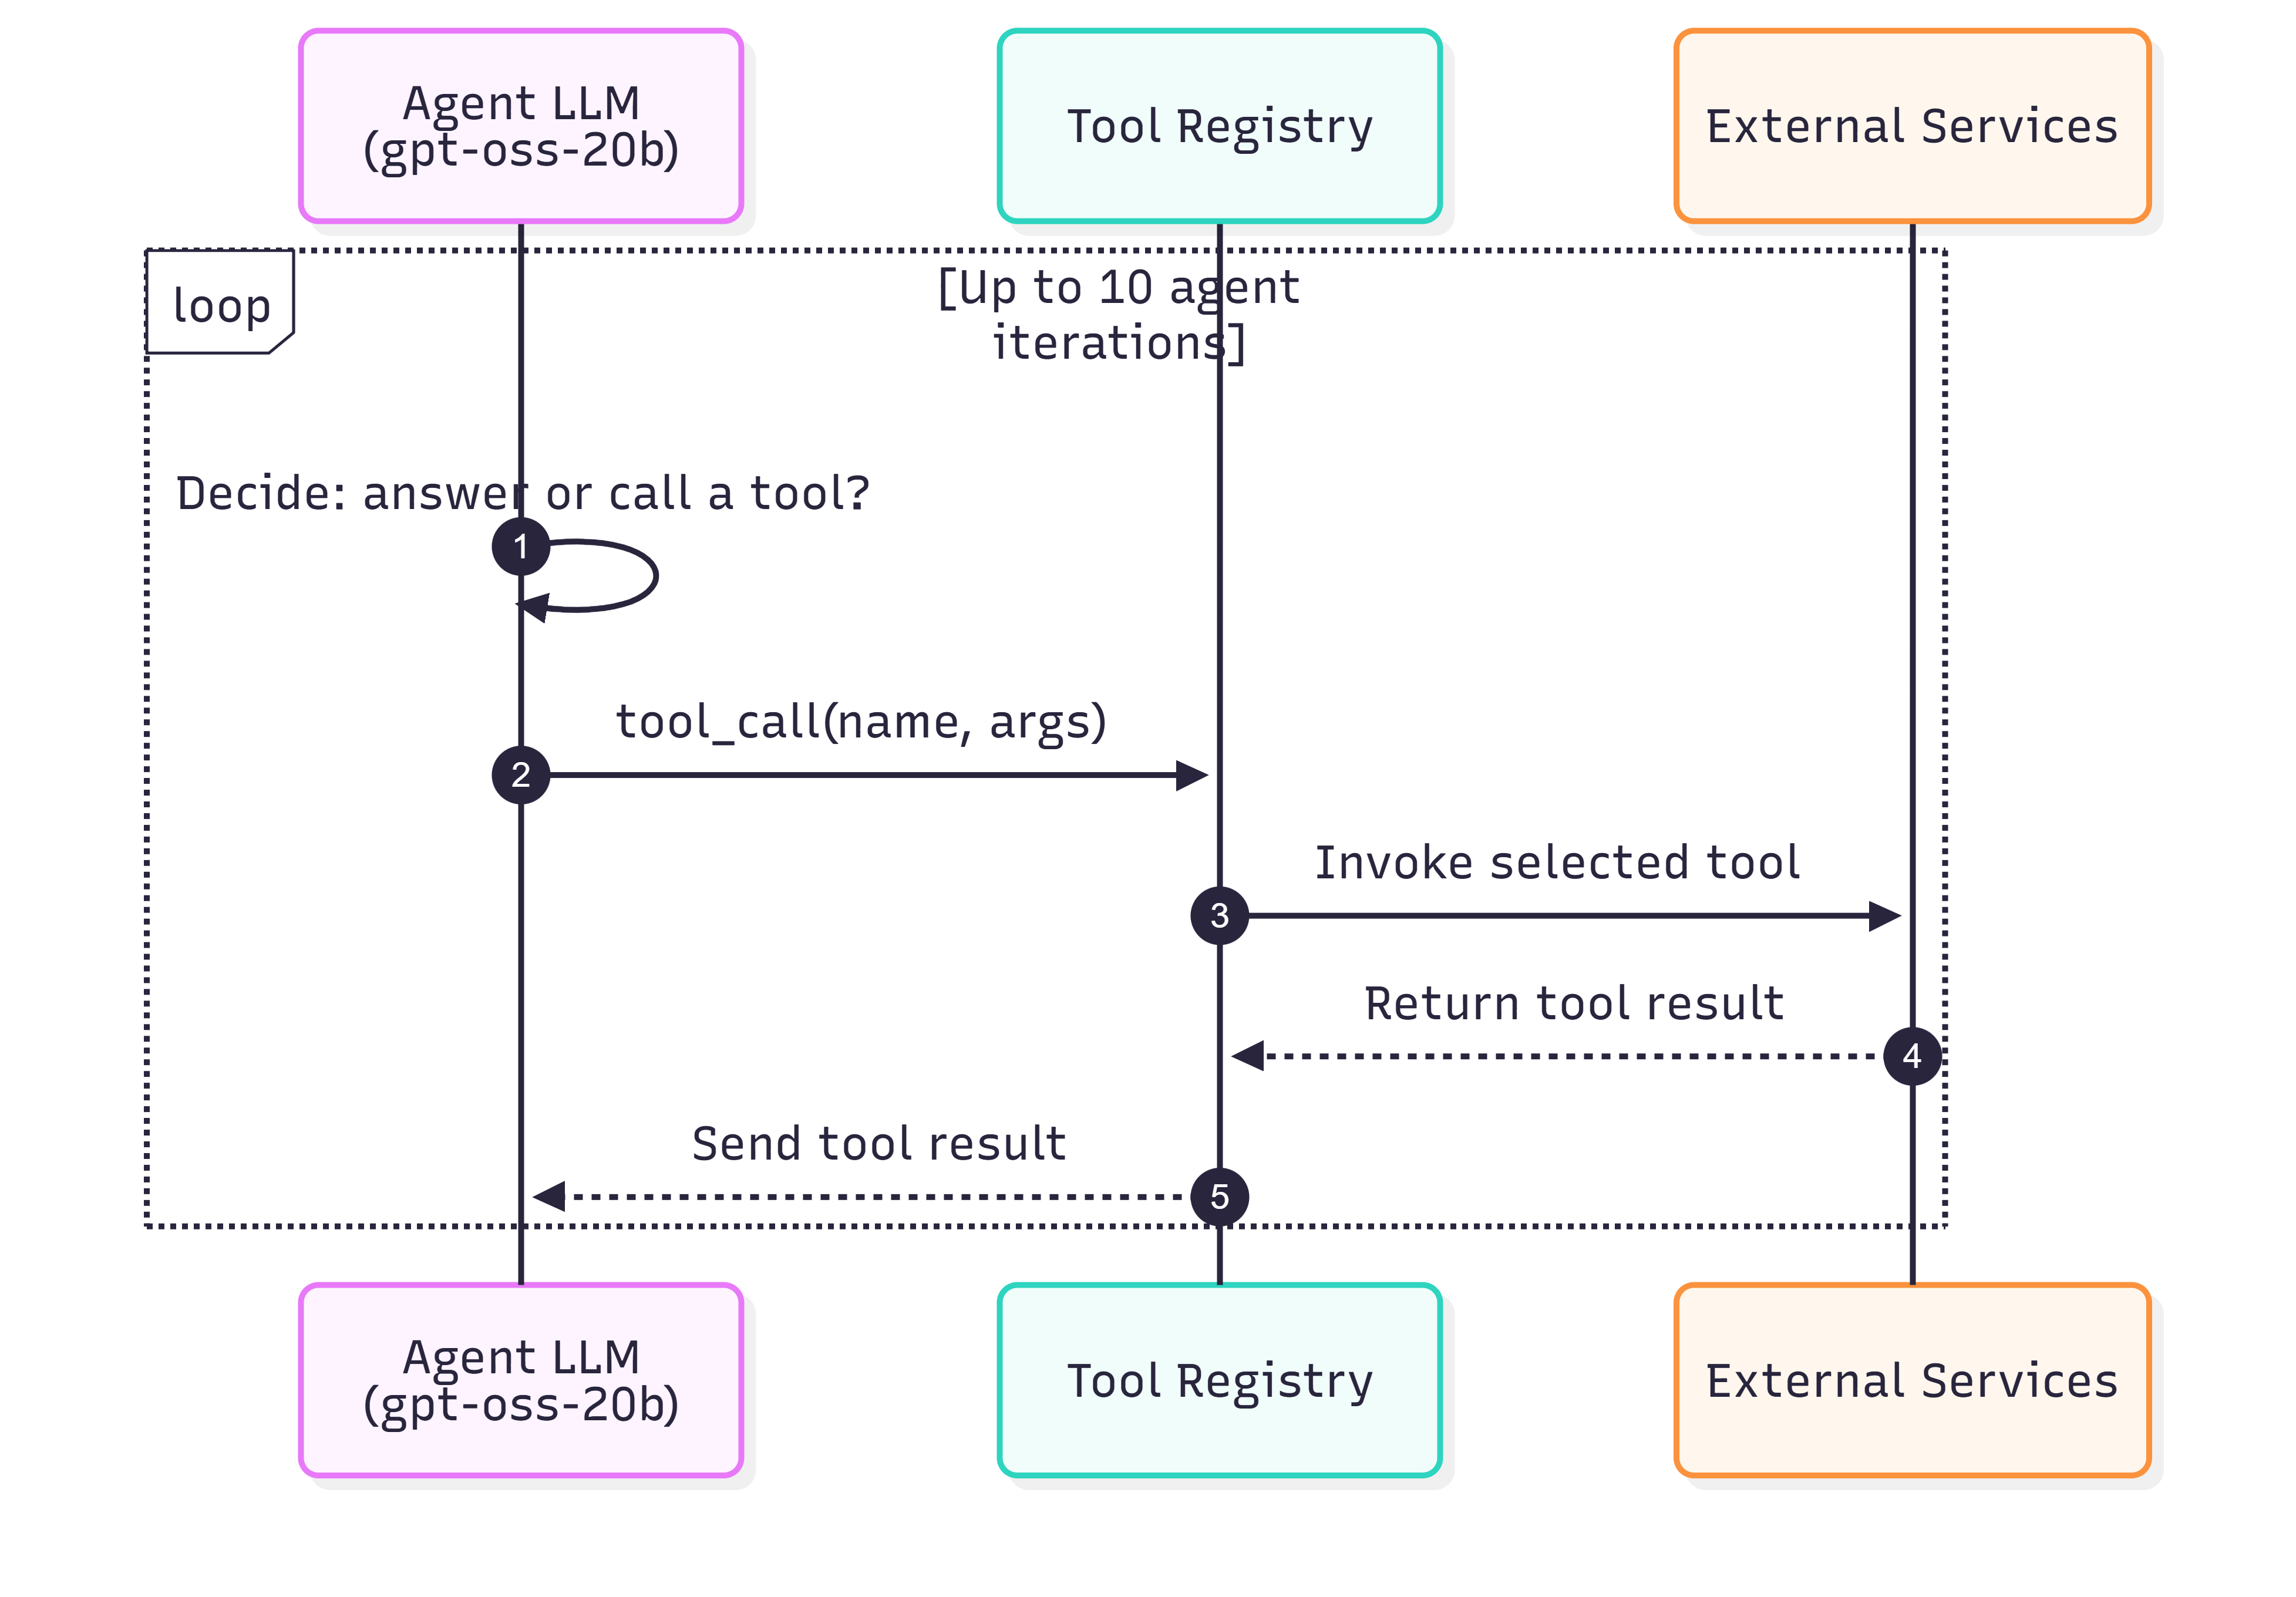
Detalhes que valem notar:
- O agente é armazenado em cache e reconstruído apenas se a assinatura das ferramentas mudar (
_get_agent). - Lógica de nova tentativa: até
MAX_RETRIES = 3tentativas; erros transitóriostool_use_failedsão tentados novamente com uma espera de 1s. - Trilho de segurança: a recursão é limitada a
MAX_AGENT_ITERATIONS = 10. Se o limite for atingido, o agente retorna uma mensagem fixa "I hit my limit…" em vez de travar. - O prompt de sistema diz ao modelo para usar o número mínimo de chamadas de ferramentas e responder assim que tiver informação suficiente.
- Durante o streaming SSE, cada chamada de ferramenta é exibida na interface como um evento
thinking({"tool": "web_search"}).
Ferramentas disponíveis
get_available_tools() (backend/tools/registry.py) retorna tudo o que o agente pode chamar:
| Ferramenta | Serviço de suporte | Finalidade | Chave(s) de configuração |
|---|---|---|---|
calculator | local, avaliação AST segura | Matemática via um avaliador com lista branca de + - * / ** % | — (sempre disponível) |
search_conversations | Pinecone + embeddings locais | Encontrar as próprias conversas passadas do usuário por relevância | PINECONE_API_KEY |
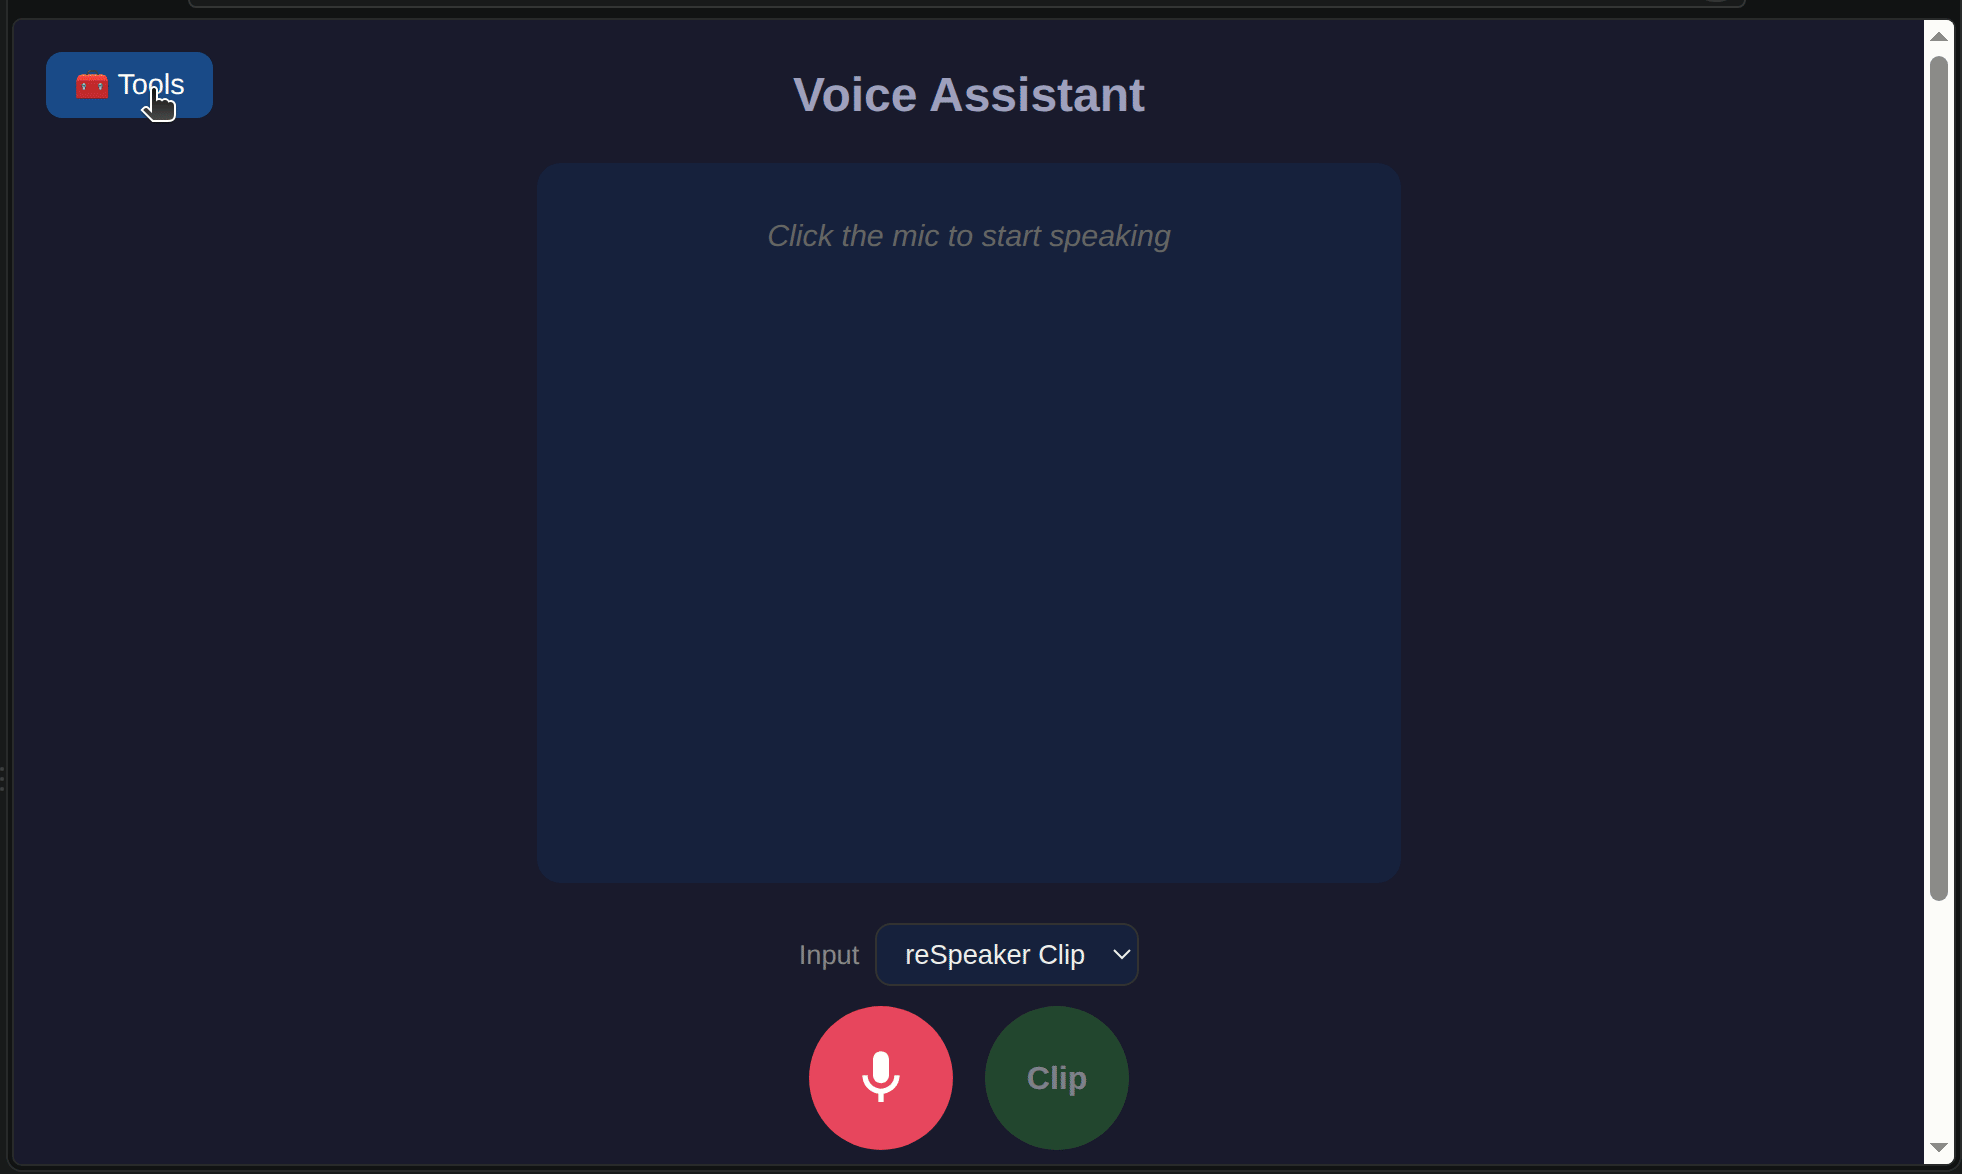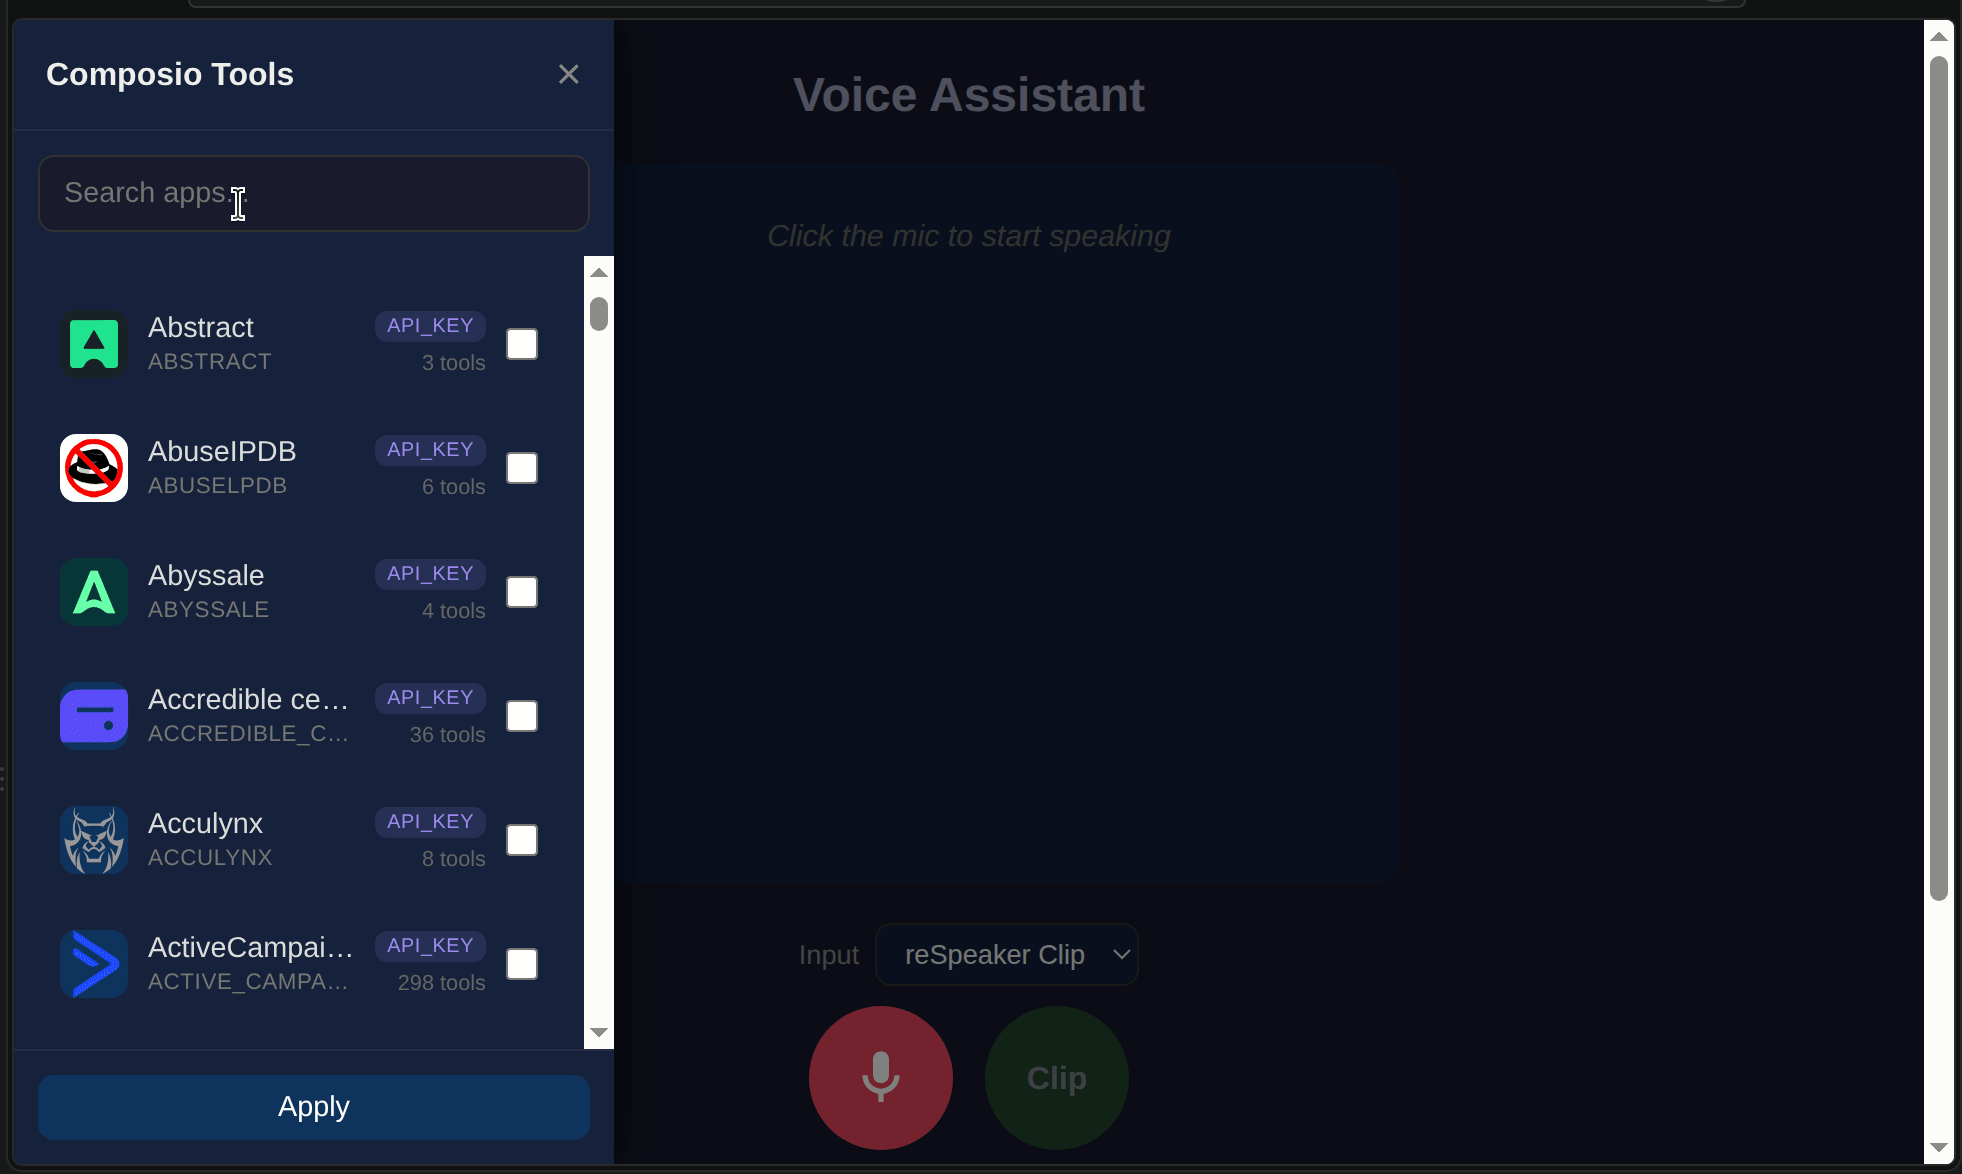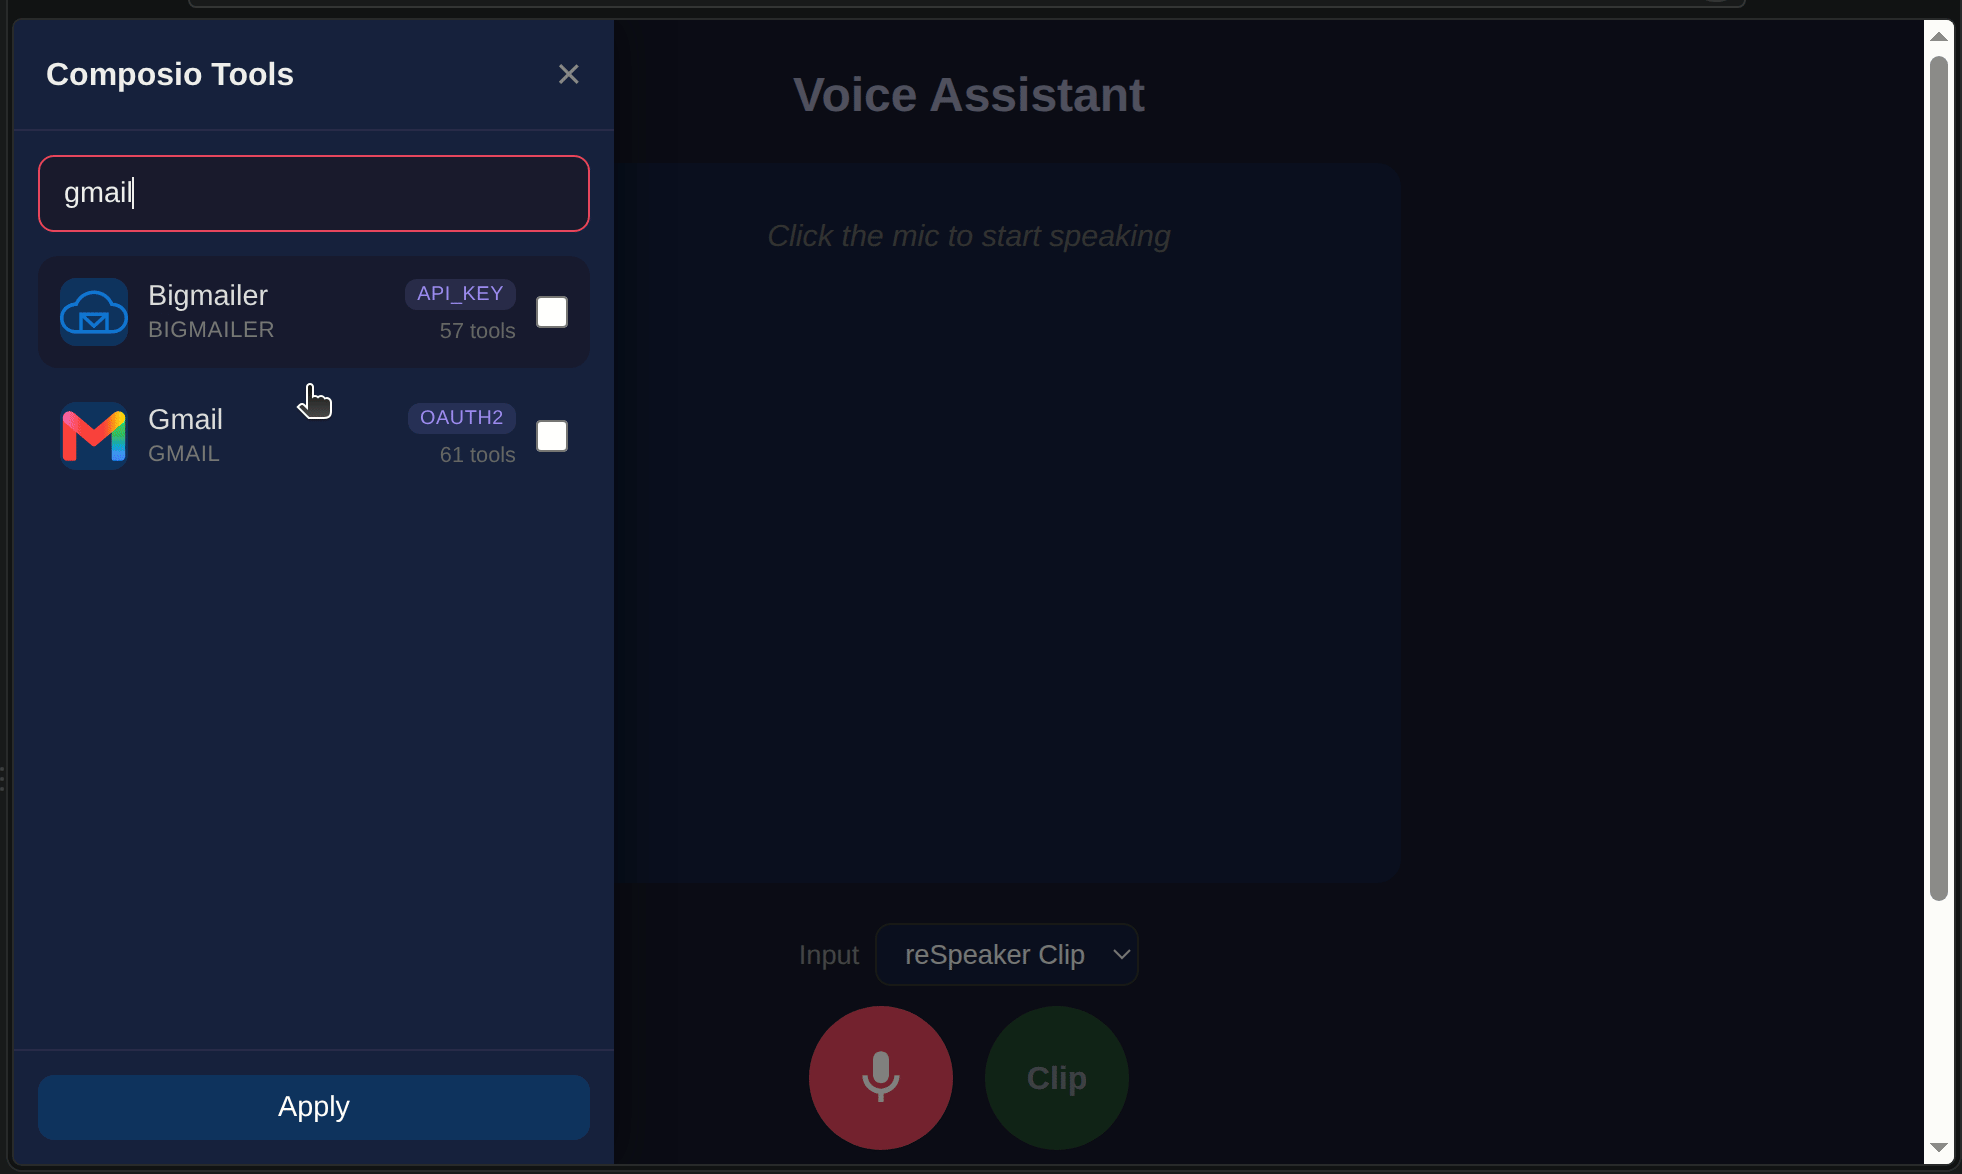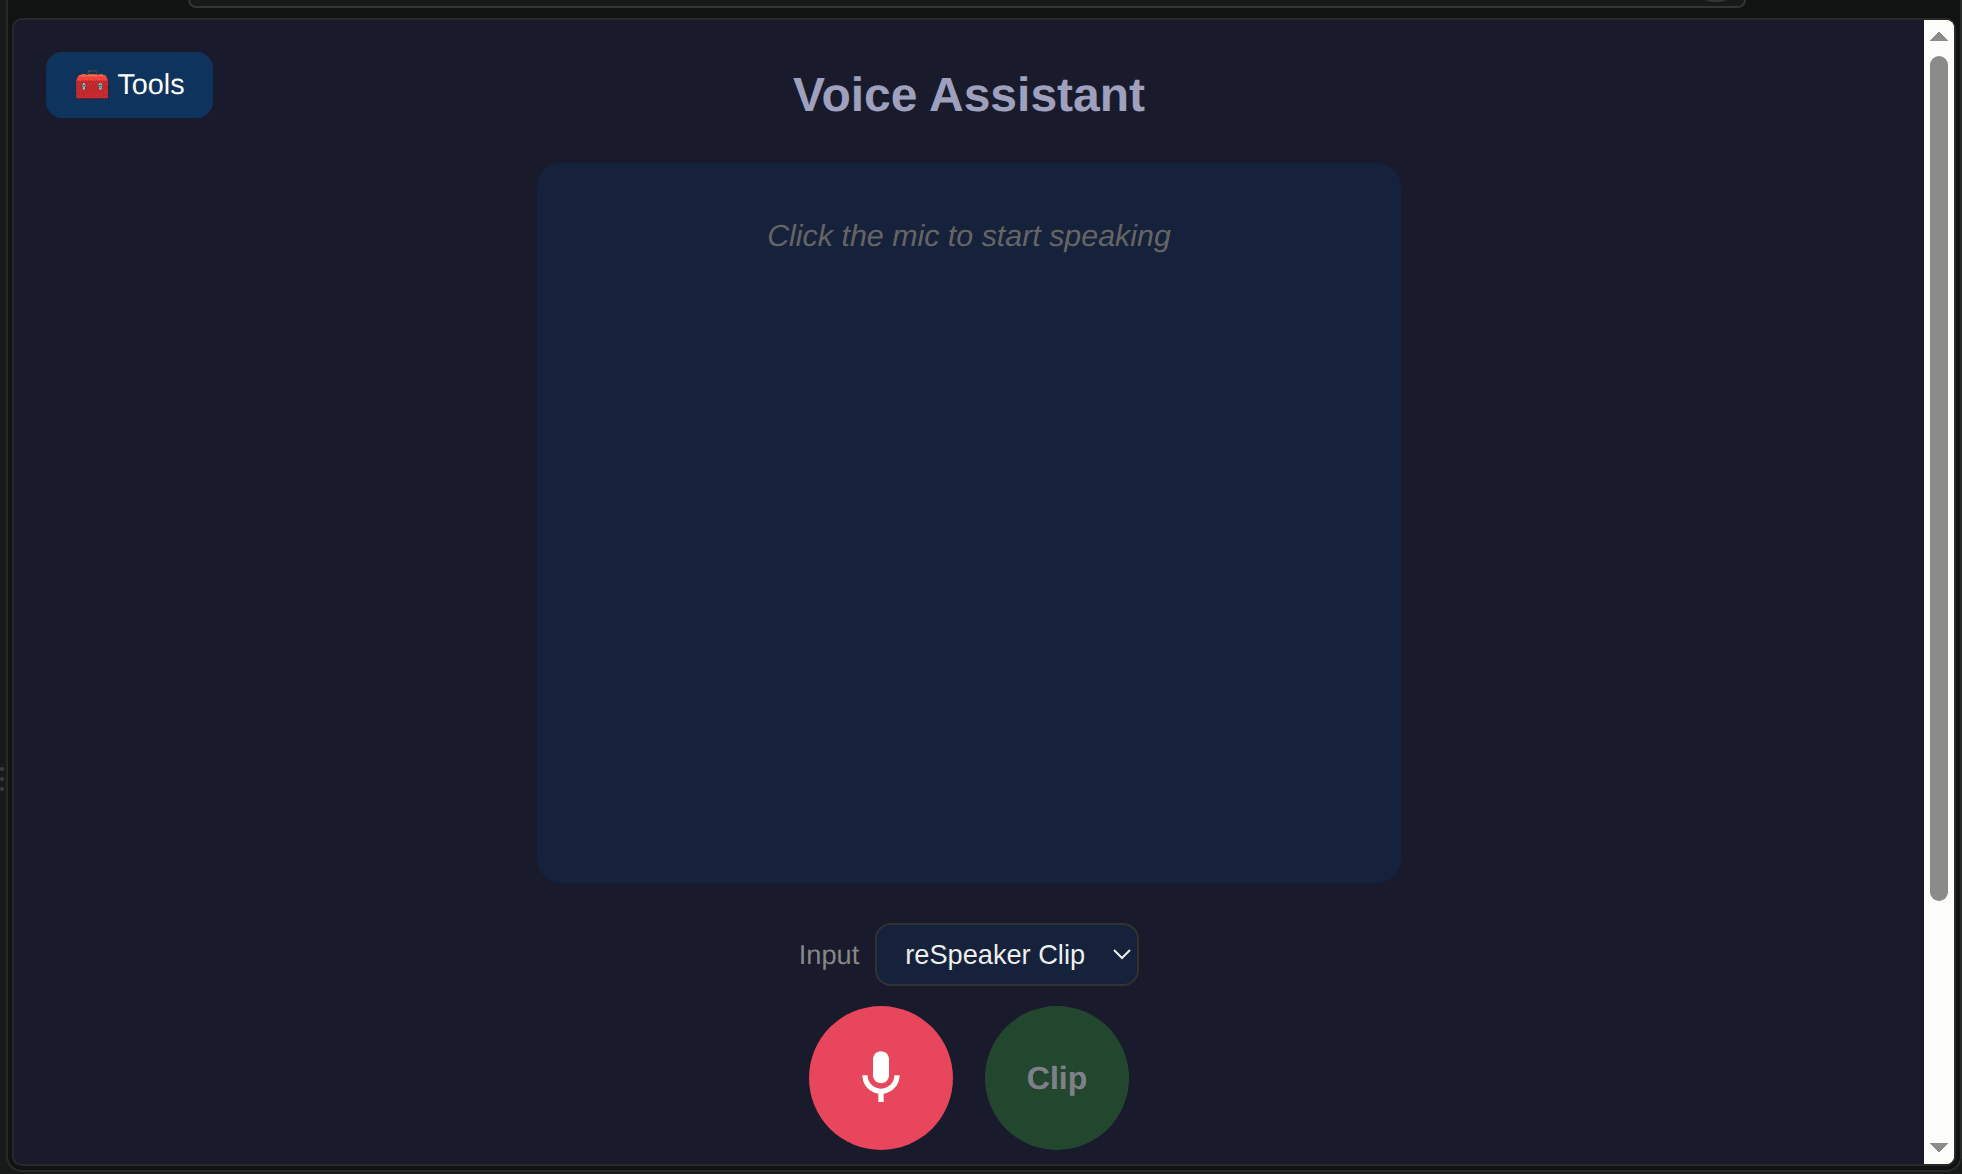
composio_search | Composio | Buscar ferramentas de app Composio que correspondam a uma requisição em linguagem natural | COMPOSIO_API_KEY |
composio_execute | Composio | Executar uma ferramenta correspondente por slug com argumentos JSON | mesma |
composio_connect | Composio | Autorizar um toolkit (por exemplo, github) via um Connect Link | mesma |
web_search | Tavily | Informações atuais/ao vivo da web (notícias, firmware, detalhes de produto) | TAVILY_API_KEY |
add_todo | Notion | Adicionar uma tarefa à lista de afazeres | NOTION_API_KEY / NOTION_DATABASE_ID |
list_todos | Notion | Listar tarefas com status | mesma |
complete_todo | Notion | Marcar uma tarefa como concluída (corresponde por nome/palavra-chave) | mesma |
delete_todo | Notion | Excluir uma tarefa (corresponde por nome/palavra-chave) | mesma |
- As ferramentas do Notion só são adicionadas se o Notion estiver configurado.
- Ferramentas não configuradas retornam uma mensagem amigável (por exemplo, "Web search is unavailable…"), então o sistema degrada de forma elegante.
Ferramentas configuradas
6. Análise Detalhada da Busca Vetorial
Configuração
Todas as configurações vetoriais ficam em config.py / .env:
| Configuração | Padrão | Significado |
|---|---|---|
PINECONE_API_KEY | — | Habilita a busca vetorial |
PINECONE_INDEX_NAME | conversations | Nome do índice Pinecone |
PINECONE_CLOUD | aws | Provedor serverless |
PINECONE_REGION | us-east-1 | Região serverless |
EMBEDDING_MODEL | all-MiniLM-L6-v2 | Modelo local de sentence-transformers |
EMBEDDING_DIM | 384 | Dimensão do vetor (deve corresponder ao índice) |
Na inicialização, init_index() cria automaticamente o índice Pinecone se ele não existir (dimensão 384, métrica cosine, serverless).
O que é incorporado vs. armazenado como metadados
O design mantém os vetores pequenos e coloca todo o resto em metadados:
- Incorporado (vetor):
"<title>\n\n<overview>"— um breve resumo semântico da conversa. - Metadados:
user_id,conversation_id,title,created_at. - Não está no armazenamento vetorial: a transcrição completa. As falas reais da conversa vivem no Supabase/SQLite e são buscadas por id após uma correspondência.
O id vetorial é "{user_id}-{conversation_id}", então é estável por usuário por conversa.
Criação de vetores (caminho de escrita)
Após cada turno de chat/voz, o sistema dispara uma thread em segundo plano (index_conversation_async → summarize_and_index em backend/services/conversation_service.py):
Detalhes:
- Conversas com menos de
MIN_TURNS = 2turnos são ignoradas. - O título/visão geral é gerado pelo LLM principal da Groq usando um prompt de duas linhas (
Title:/Overview:). - As embeddings são normalizadas (amigáveis a cosseno).
- Tudo isso é assíncrono (uma thread daemon), então a resposta ao usuário nunca é bloqueada pela indexação.
Consulta vetorial (caminho de leitura)
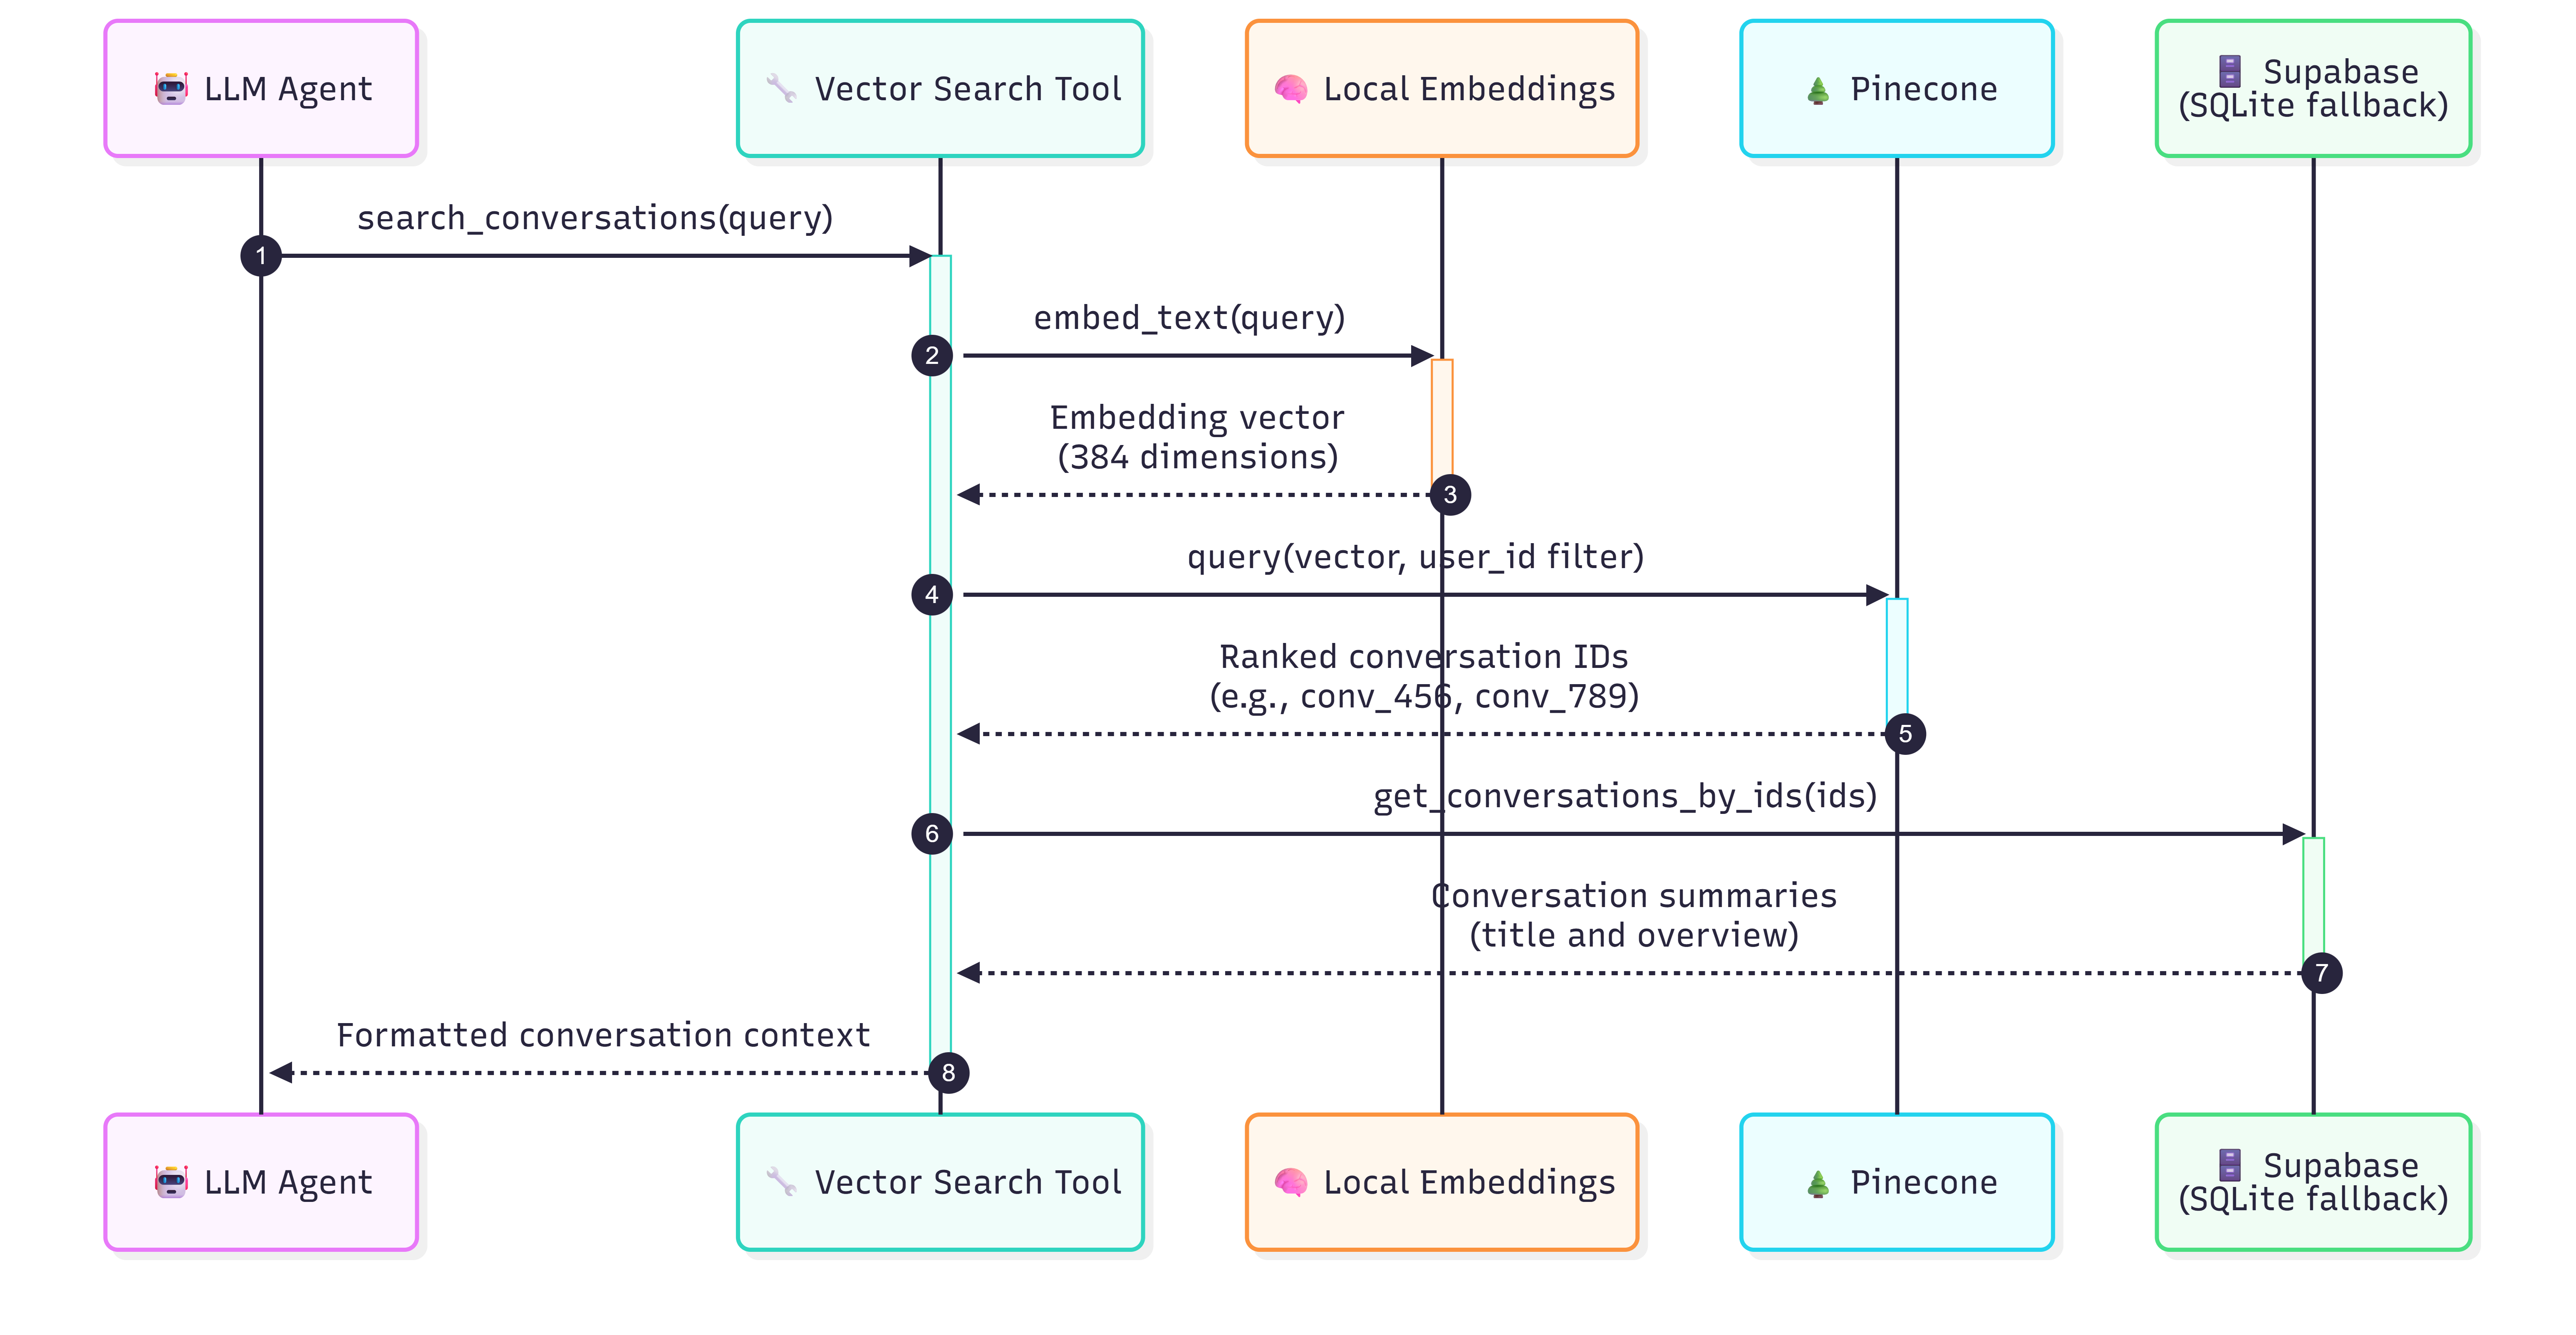
Quando o agente chama search_conversations, o fluxo é:
Pontos principais:
- A consulta é incorporada com o mesmo modelo local e então buscada com um filtro de
user_idpara que os usuários só vejam suas próprias conversas. - A correspondência retorna id + pontuação + metadados; os resumos completos são obtidos do armazenamento relacional por id.
- As correspondências são formatadas com sua pontuação de similaridade para que o agente possa julgar a relevância.
7. Sistema de Memórias
A memória de longo prazo usa Mem0, com escopo para um único usuário (MEM0_USER_ID, padrão user-1).
Categorias de memória
Não há compartimentos fixos no código; em vez disso, MEM0_CUSTOM_INSTRUCTIONS diz ao Mem0 quais fatos duráveis extrair, em ordem de prioridade:
- Restrições de saúde e alergias — especialmente qualquer coisa que um médico tenha recomendado (interpretado como se aplicando ao usuário).
- Agenda — reuniões, compromissos, lembretes.
- Preferências e detalhes pessoais.
Explicitamente excluídos: as próprias respostas/receitas/explicações do assistente e pedidos pontuais e transitórios.
Recuperação de memória no chat
A recuperação proativa acontece em toda requisição, antes do roteamento (recall(text) em backend/routes/chat.py):
-
A mensagem recebida é enviada para a busca semântica do Mem0 (
top_k = 5). -
Os resultados são filtrados por uma verificação de relevância em duas camadas na decomposição da pontuação:
semantic ≥ 0.28→ manter, OUsemantic ≥ 0.24ebm25 > 0.01(um acerto reforçado por palavra-chave) → manter.
-
As memórias que restarem são ordenadas por
created_at(mais recentes primeiro) e formatadas como:Relevant context from your past conversations:
- <memory text> (created 2026-08-30) -
Esse bloco é adicionado antes da mensagem do usuário, antes que ela chegue a qualquer nó — assim o LLM o vê como contexto, mas é instruído a usá-lo apenas quando for diretamente relevante ao tópico.
A gravação acontece após cada troca (save_exchange): o par usuário/assistente é enviado ao Mem0 com as instruções personalizadas. O salvamento e a recuperação de memória falham de forma segura (registradas em log, ignoradas) se a chave do Mem0 estiver ausente.
8. Sessão de Chat e Contexto
Estrutura da sessão
Uma "sessão" é uma conversa armazenada de forma relacional (Supabase PostgreSQL ou fallback em SQLite). O esquema:
users—id,email(usuário único,user-1, pré-carregado).conversations—id,user_id,title,overview,action_items, timestamps.messages/turns—conversation_id,role(user/assistant),content, timestamp.
Fluxo para um turno:
- Criar (ou reutilizar) uma conversa →
conversation_id. - Carregar contexto: memórias de
recall()+ histórico deget_recent_messages(conversation_id, 10). - Construir o
AgentStatee executá-lo pelo LangGraph. - Após a resposta: salvar ambos os turnos, salvar a troca no Mem0 e iniciar a indexação vetorial assíncrona.
Janela de contexto
O contexto montado para o LLM é intencionalmente pequeno e em camadas:
| Componente | Fonte | Tamanho |
|---|---|---|
| System prompt | constante por caminho (simple/persona/agent SYSTEM_PROMPT) | fixo |
| Histórico da conversa | get_recent_messages(conversation_id, 10) | últimos 10 turnos (10 mensagens de usuário + 10 de assistente), em ordem cronológica |
| Memórias recuperadas | Mem0 recall(), top-5, filtradas | até 5 memórias |
| Mensagem atual do usuário | format_memories(...) + transcript | a solicitação |
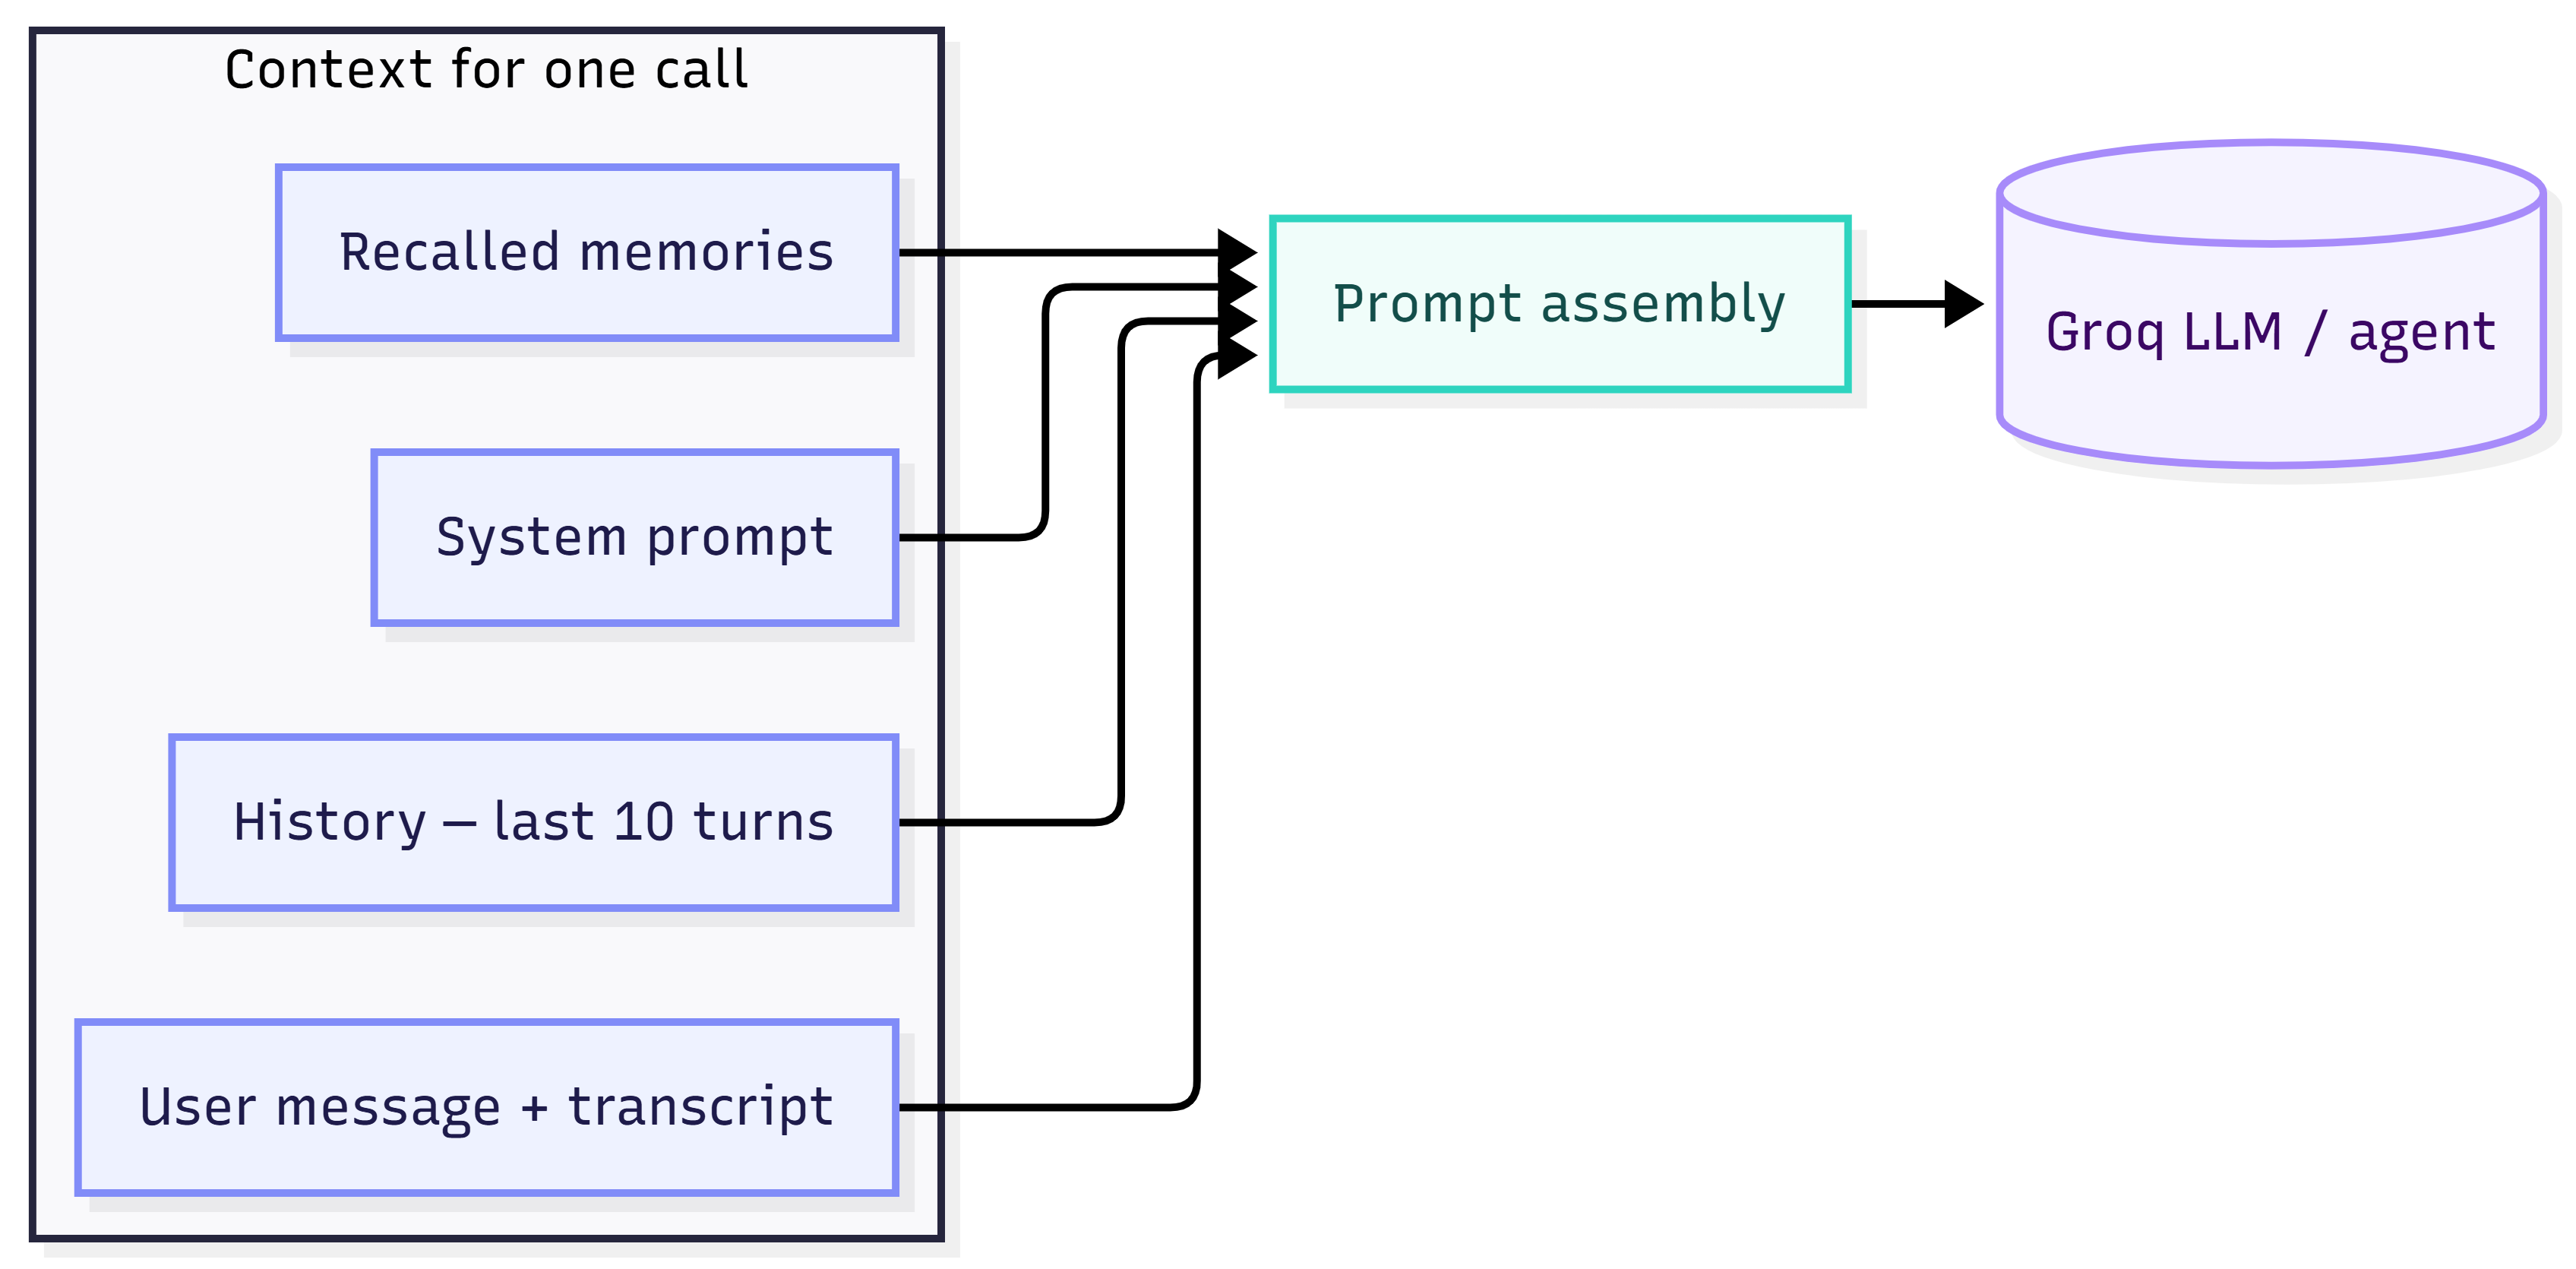
Observações:
- O histórico vem do armazenamento relacional, não do armazenamento vetorial (o armazenamento vetorial guarda resumos, não turnos).
- As memórias são injetadas em linha com a mensagem do usuário, então o modelo as trata como "contexto relevante de suas conversas passadas".
- O caminho do agente constrói as mensagens como
[history..., ("user", memories + transcript)]e permite que o agente faça loop com ferramentas.
9. Estrutura do System Prompt
Existem quatro system prompts:
| Prompt | Onde | Usado por | Função |
|---|---|---|---|
ROUTER_PROMPT | backend/graph/router.py | classificação do roteador | Retorna uma palavra: simple / context / persona |
SIMPLE_PROMPT (simple.py) | backend/graph/nodes/simple.py | simple_node | Assistente de voz prestativo, chat simples |
PERSONA_PROMPT (persona.py) | backend/graph/nodes/persona.py | persona_node | Igual ao simple, mas adapta o estilo/ensino ao pedido do usuário |
SYSTEM_PROMPT (agentic) | backend/graph/nodes/agentic.py | agent | Assistente com ferramentas habilitadas; explica cada ferramenta e quando usá-la |
Os prompts simple, persona e agentic compartilham um sufixo comum de estilo:
- Responda em no máximo 2–3 frases curtas.
- Apenas texto simples — sem markdown, sem asteriscos, sem emojis.
- As memórias recuperadas são usadas apenas quando diretamente relevantes ao tópico (a separação entre agenda e comida é explicitamente aplicada).
- Em caso de conflitos, confie na memória criada mais recentemente.
- Quando o usuário declara um novo fato, reconheça apenas esse fato — não repita memórias não relacionadas.
O prompt agentic adicionalmente:
- Nomeia as ferramentas (
web_search,calculator,search_conversations, ferramentas do Notion). - Instrui a fazer chamadas de ferramenta mínimas — pare assim que informações suficientes forem coletadas.
- Mantém o formato de resposta curta em texto simples.
10. Modelos de LLM Utilizados
Todos os modelos rodam no Groq. Definidos em backend/llm/client.py, config.py e groq_client.py:
| Função | Variável de ambiente | Modelo padrão | Temperatura | Observações |
|---|---|---|---|---|
| LLM principal (router, simple, persona, resumos) | GROQ_LLM_MODEL | qwen/qwen3.6-27b | 0.7 | Instância ChatGroq llm |
| LLM do agente / chamadas de ferramenta | GROQ_AGENT_MODEL | openai/gpt-oss-20b | 0.0 | Instância ChatGroq agent_llm, usada por create_agent |
| Speech-to-text | GROQ_STT_MODEL | whisper-large-v3 | 0.0 | Transcrição com Whisper |
| Text-to-speech | GROQ_TTS_MODEL | canopylabs/orpheus-v1-english | — | Voz = TTS_VOICE (autumn) |
| Embeddings (local, não Groq) | EMBEDDING_MODEL | all-MiniLM-L6-v2 | — | sentence-transformers, 384 dimensões, normalizado |
Padrões de inferência do LLM (via groq_client.chat): max_completion_tokens = 2048, top_p = 1.0, temperatura sobrescrevível.
11. Demonstração de Chamada de Agente
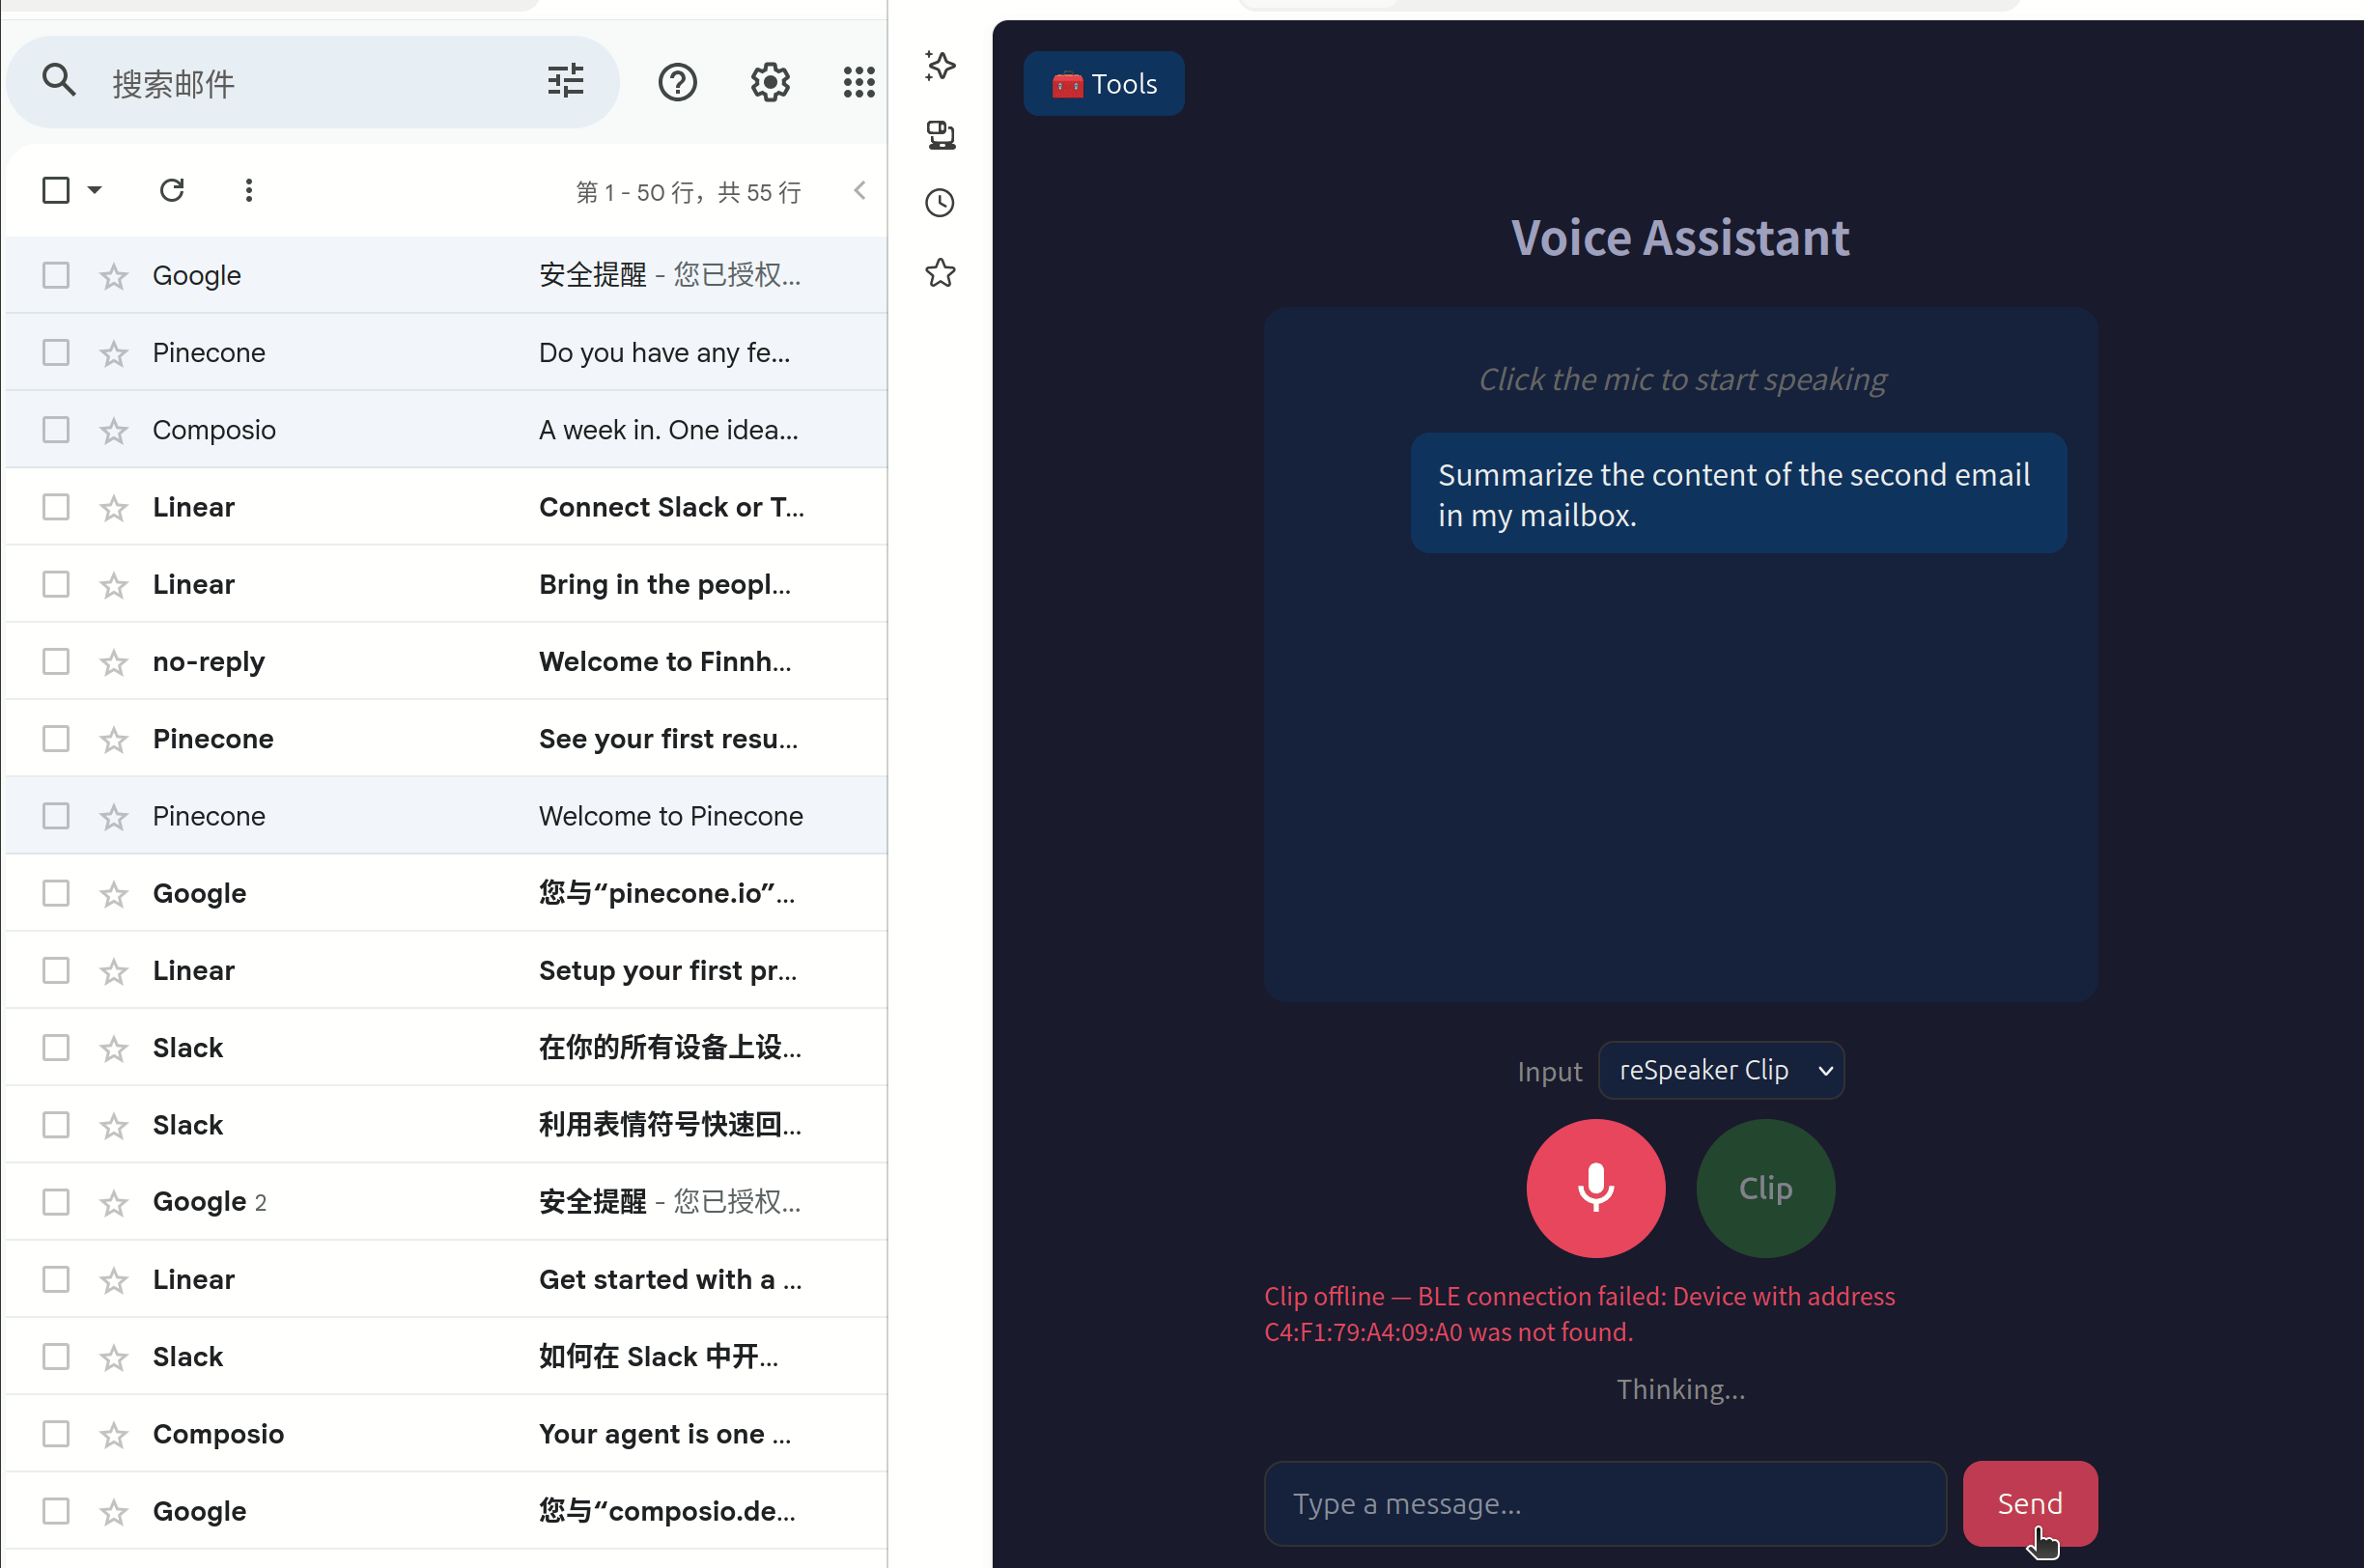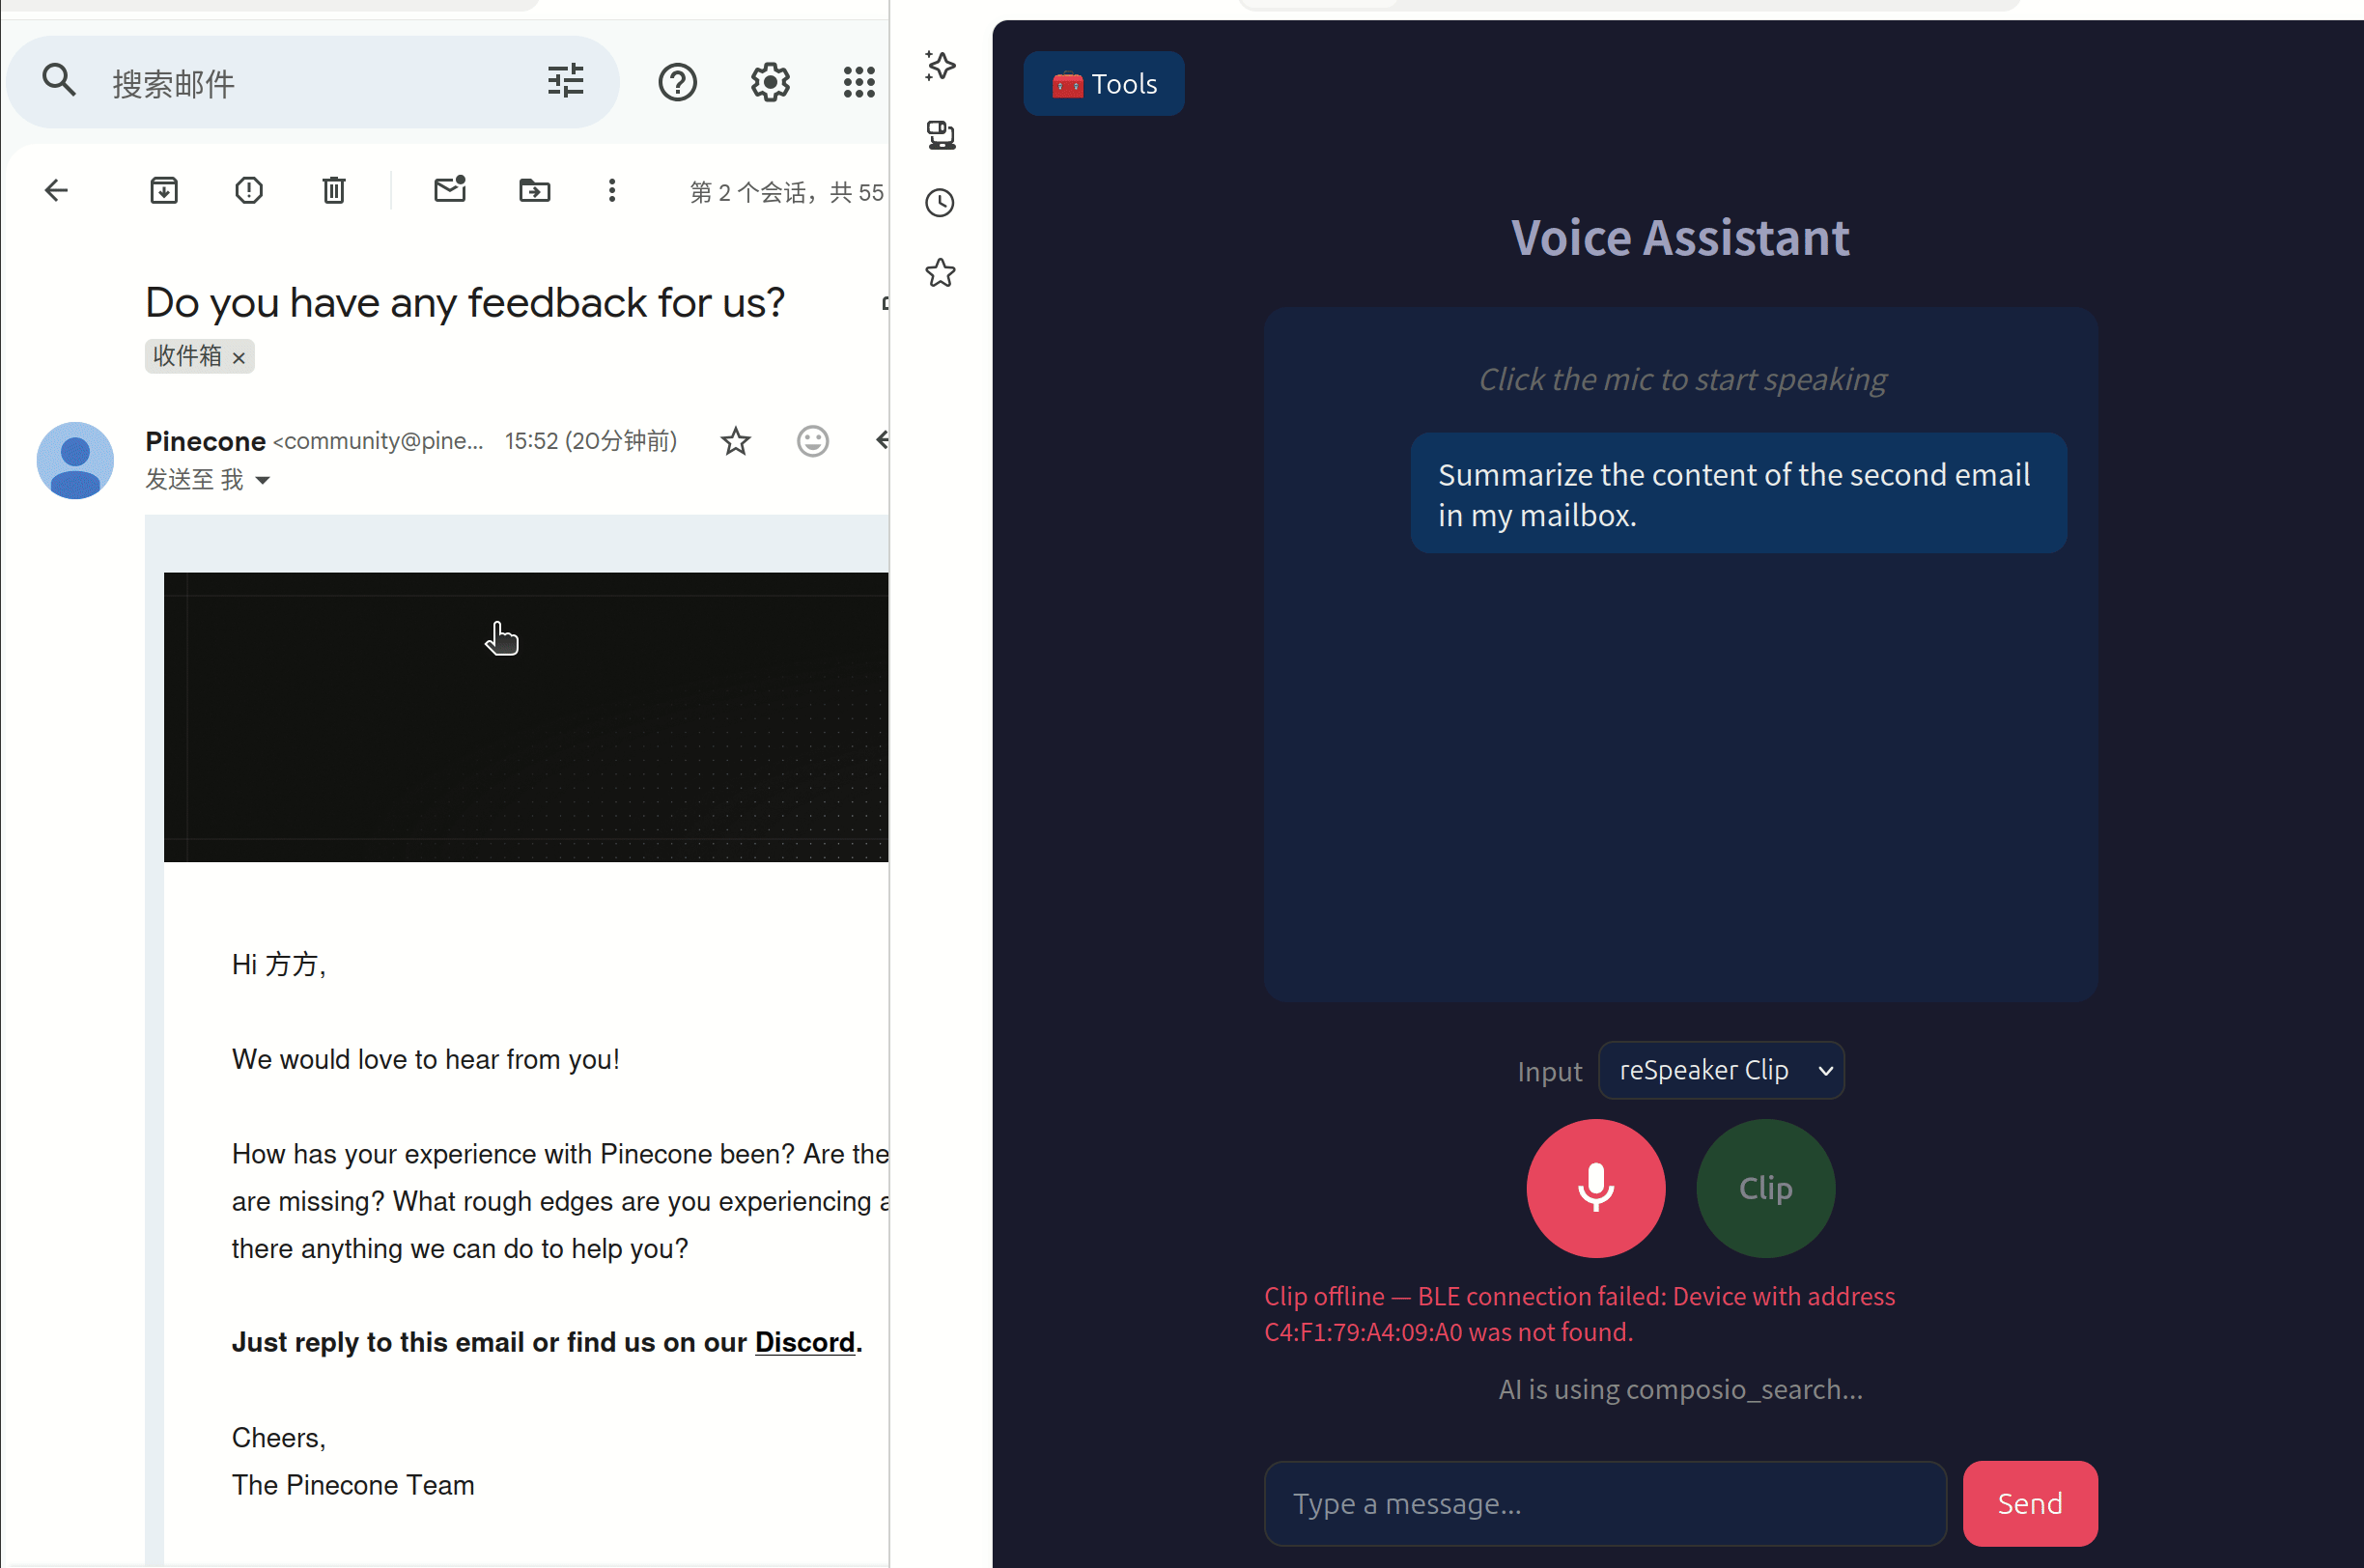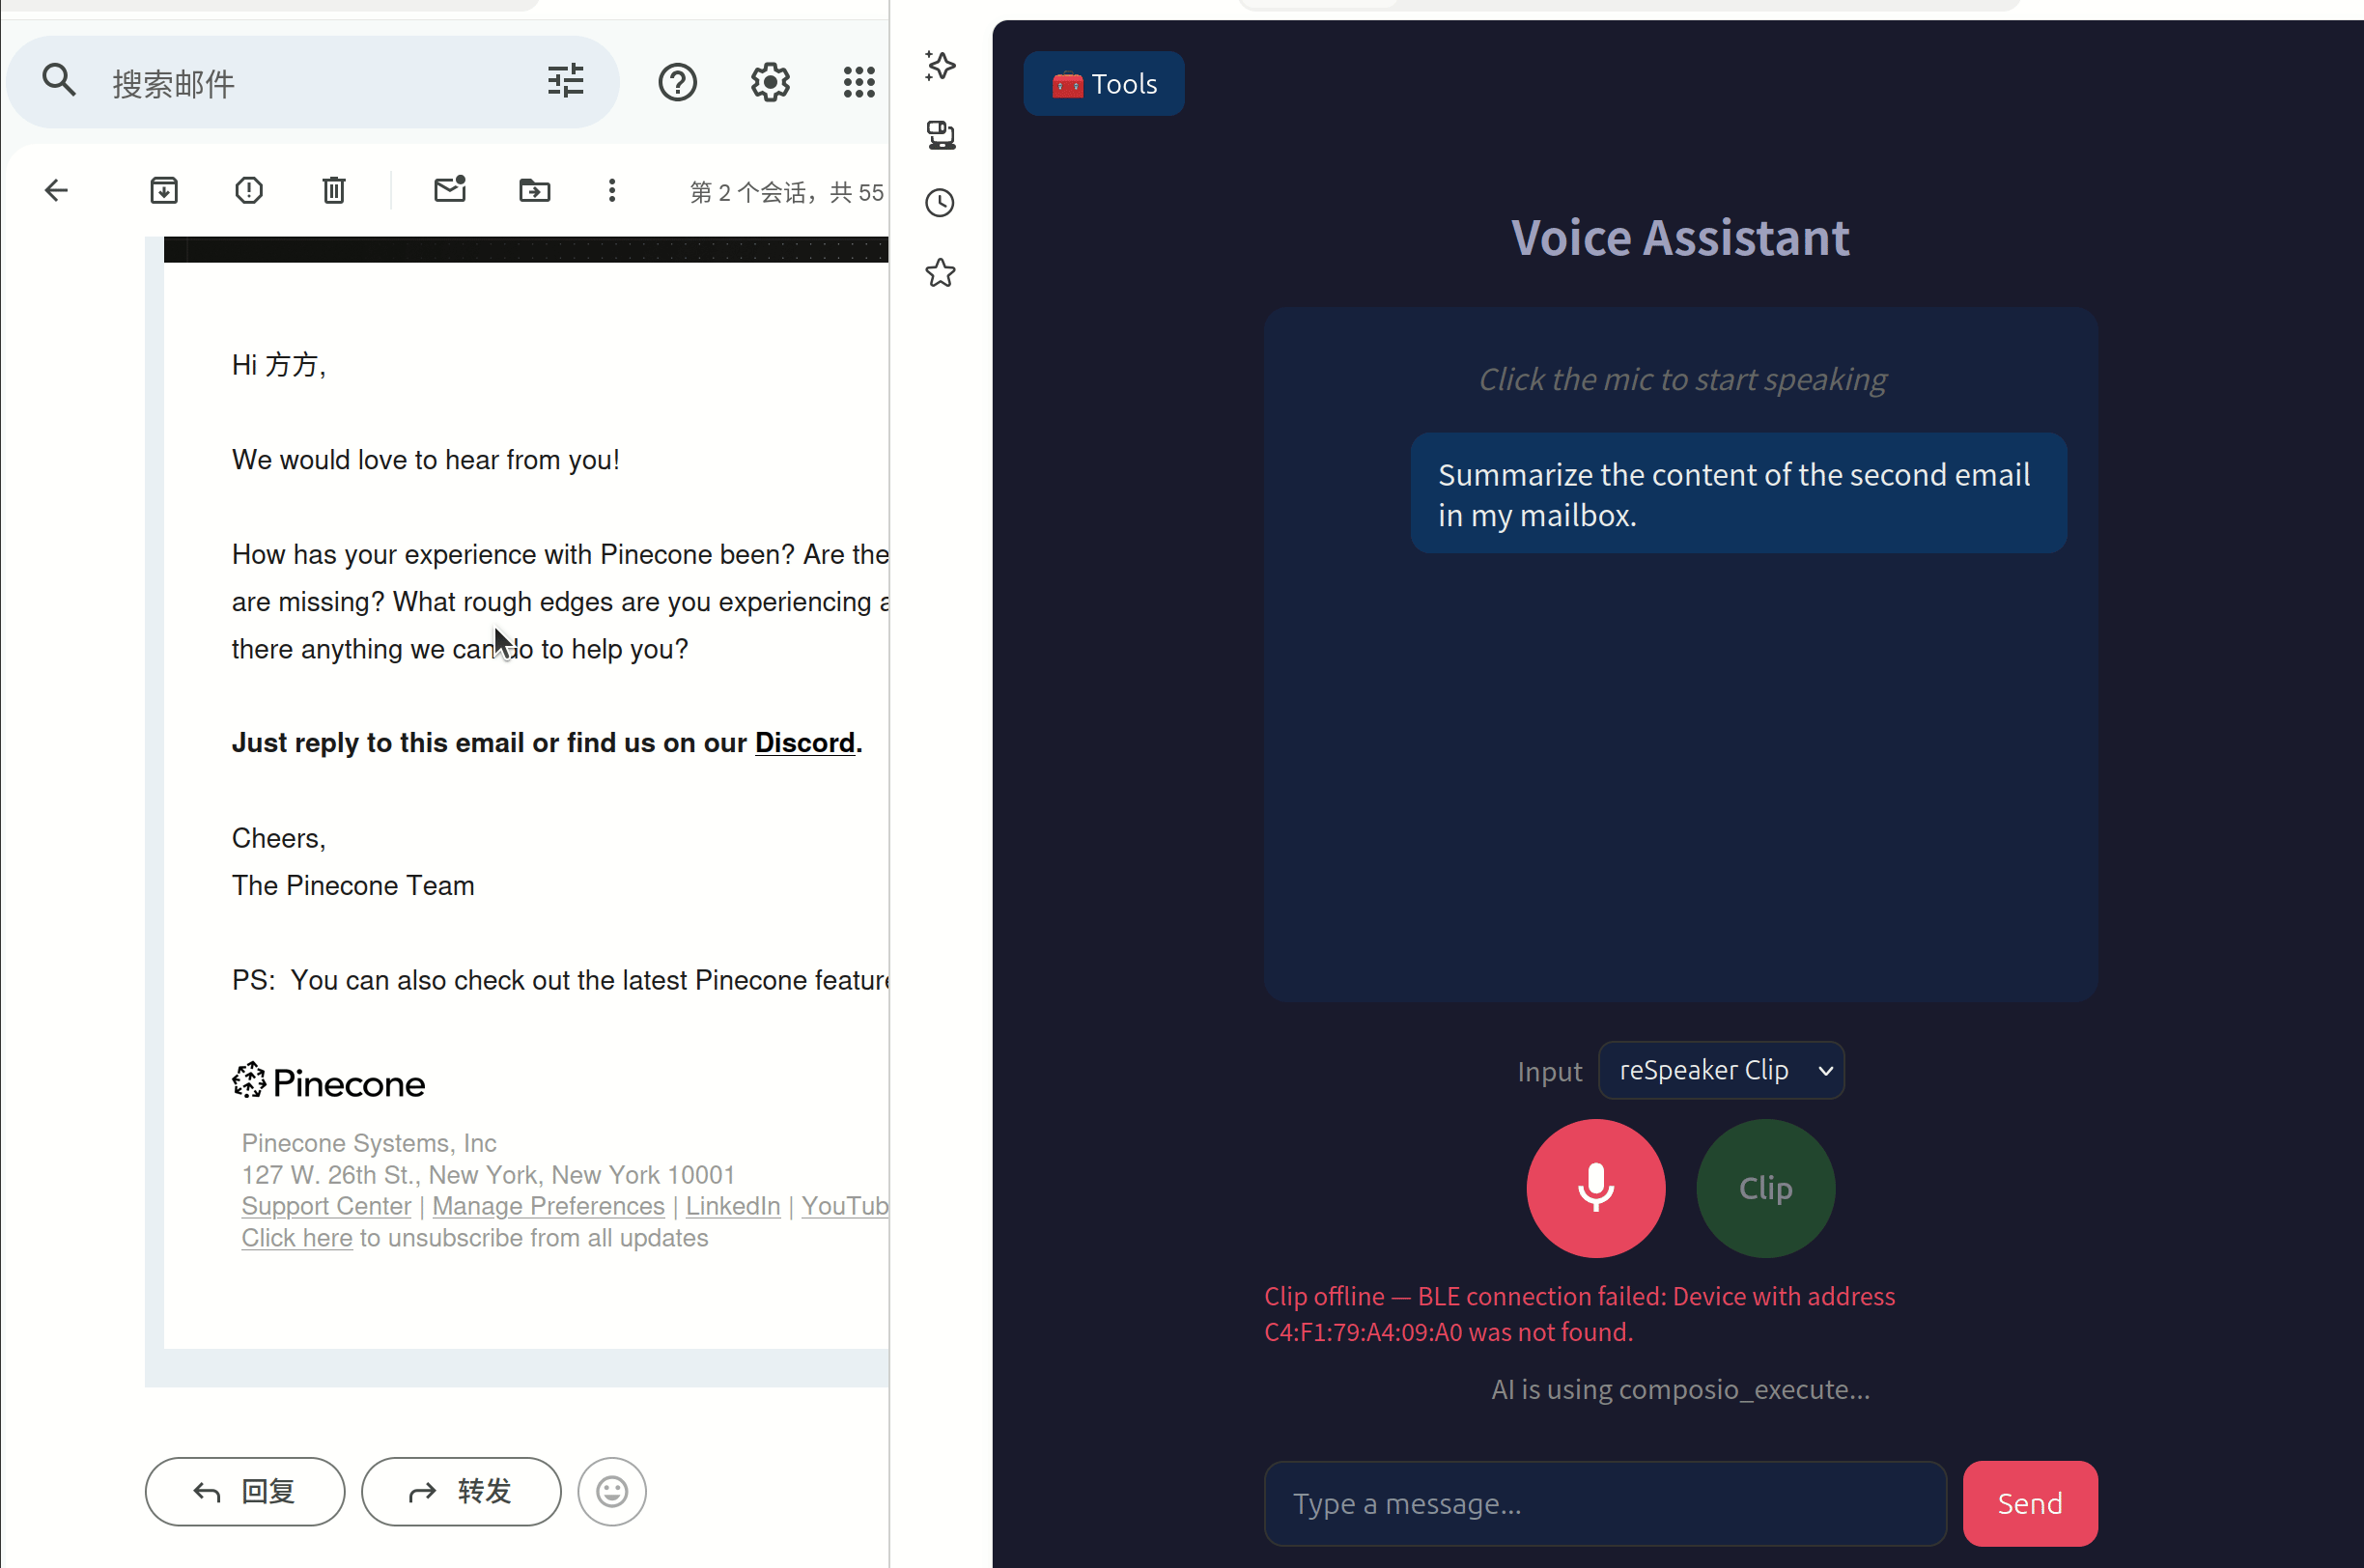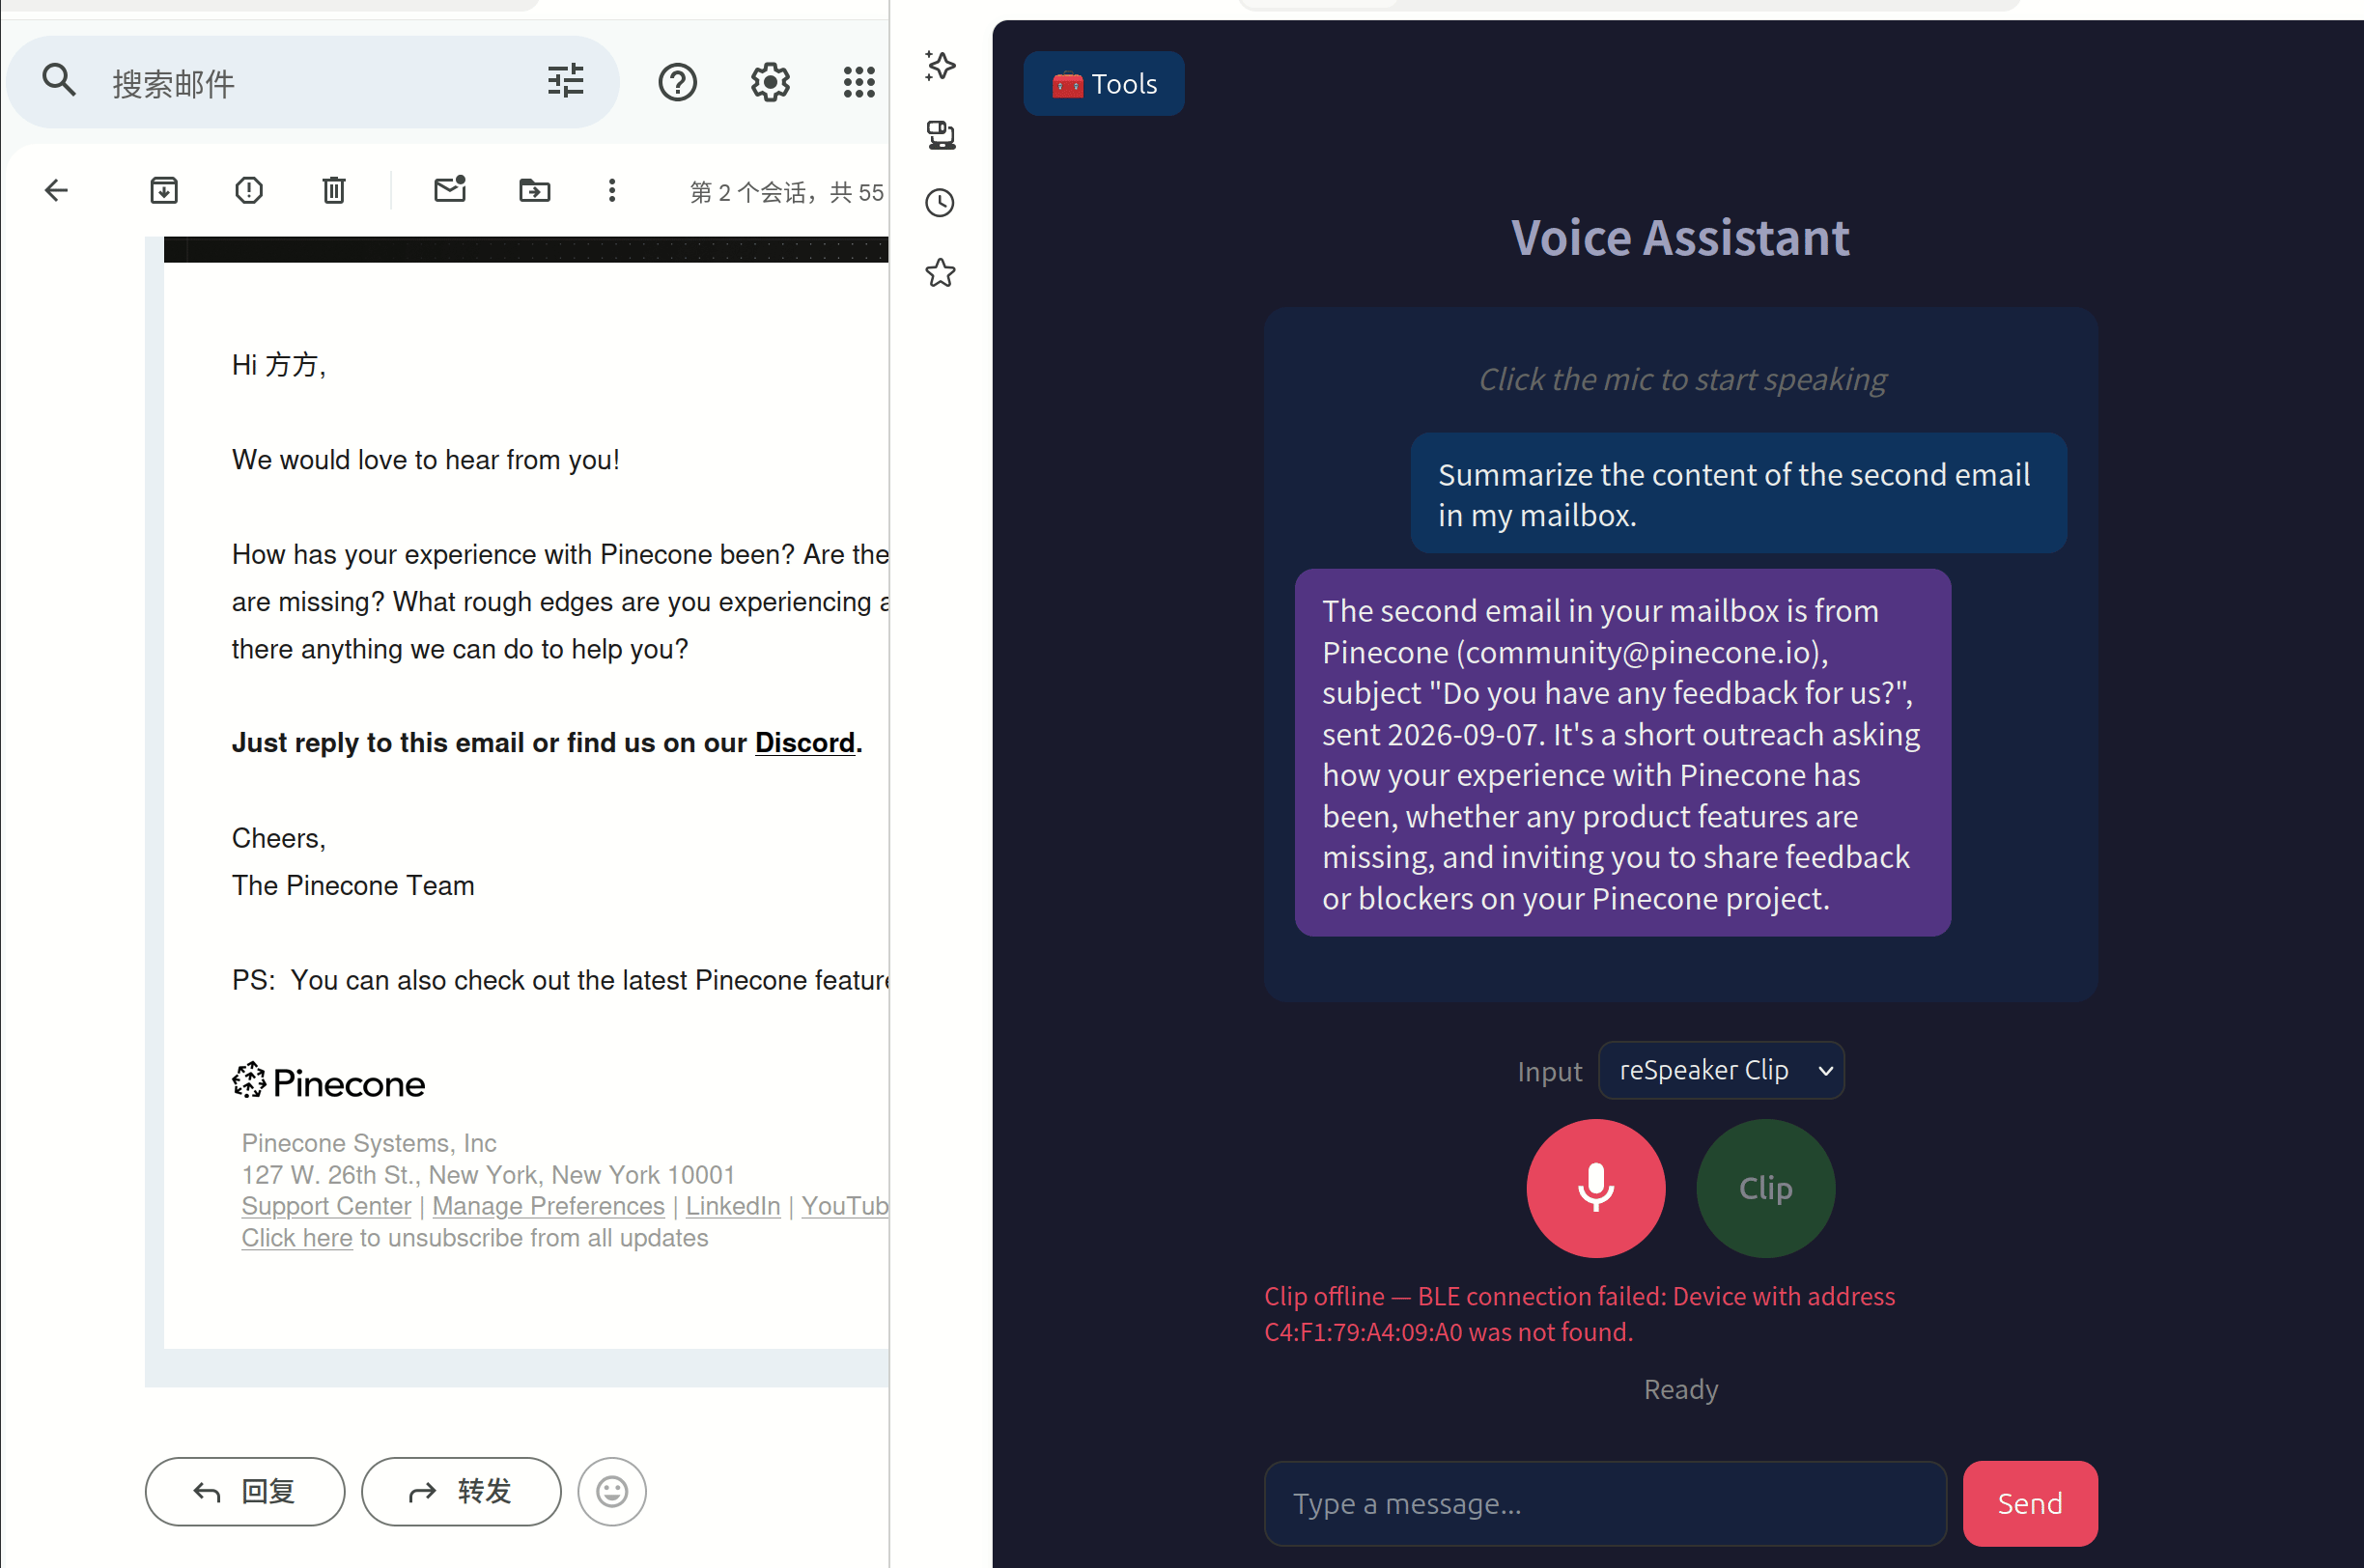
Ler Email
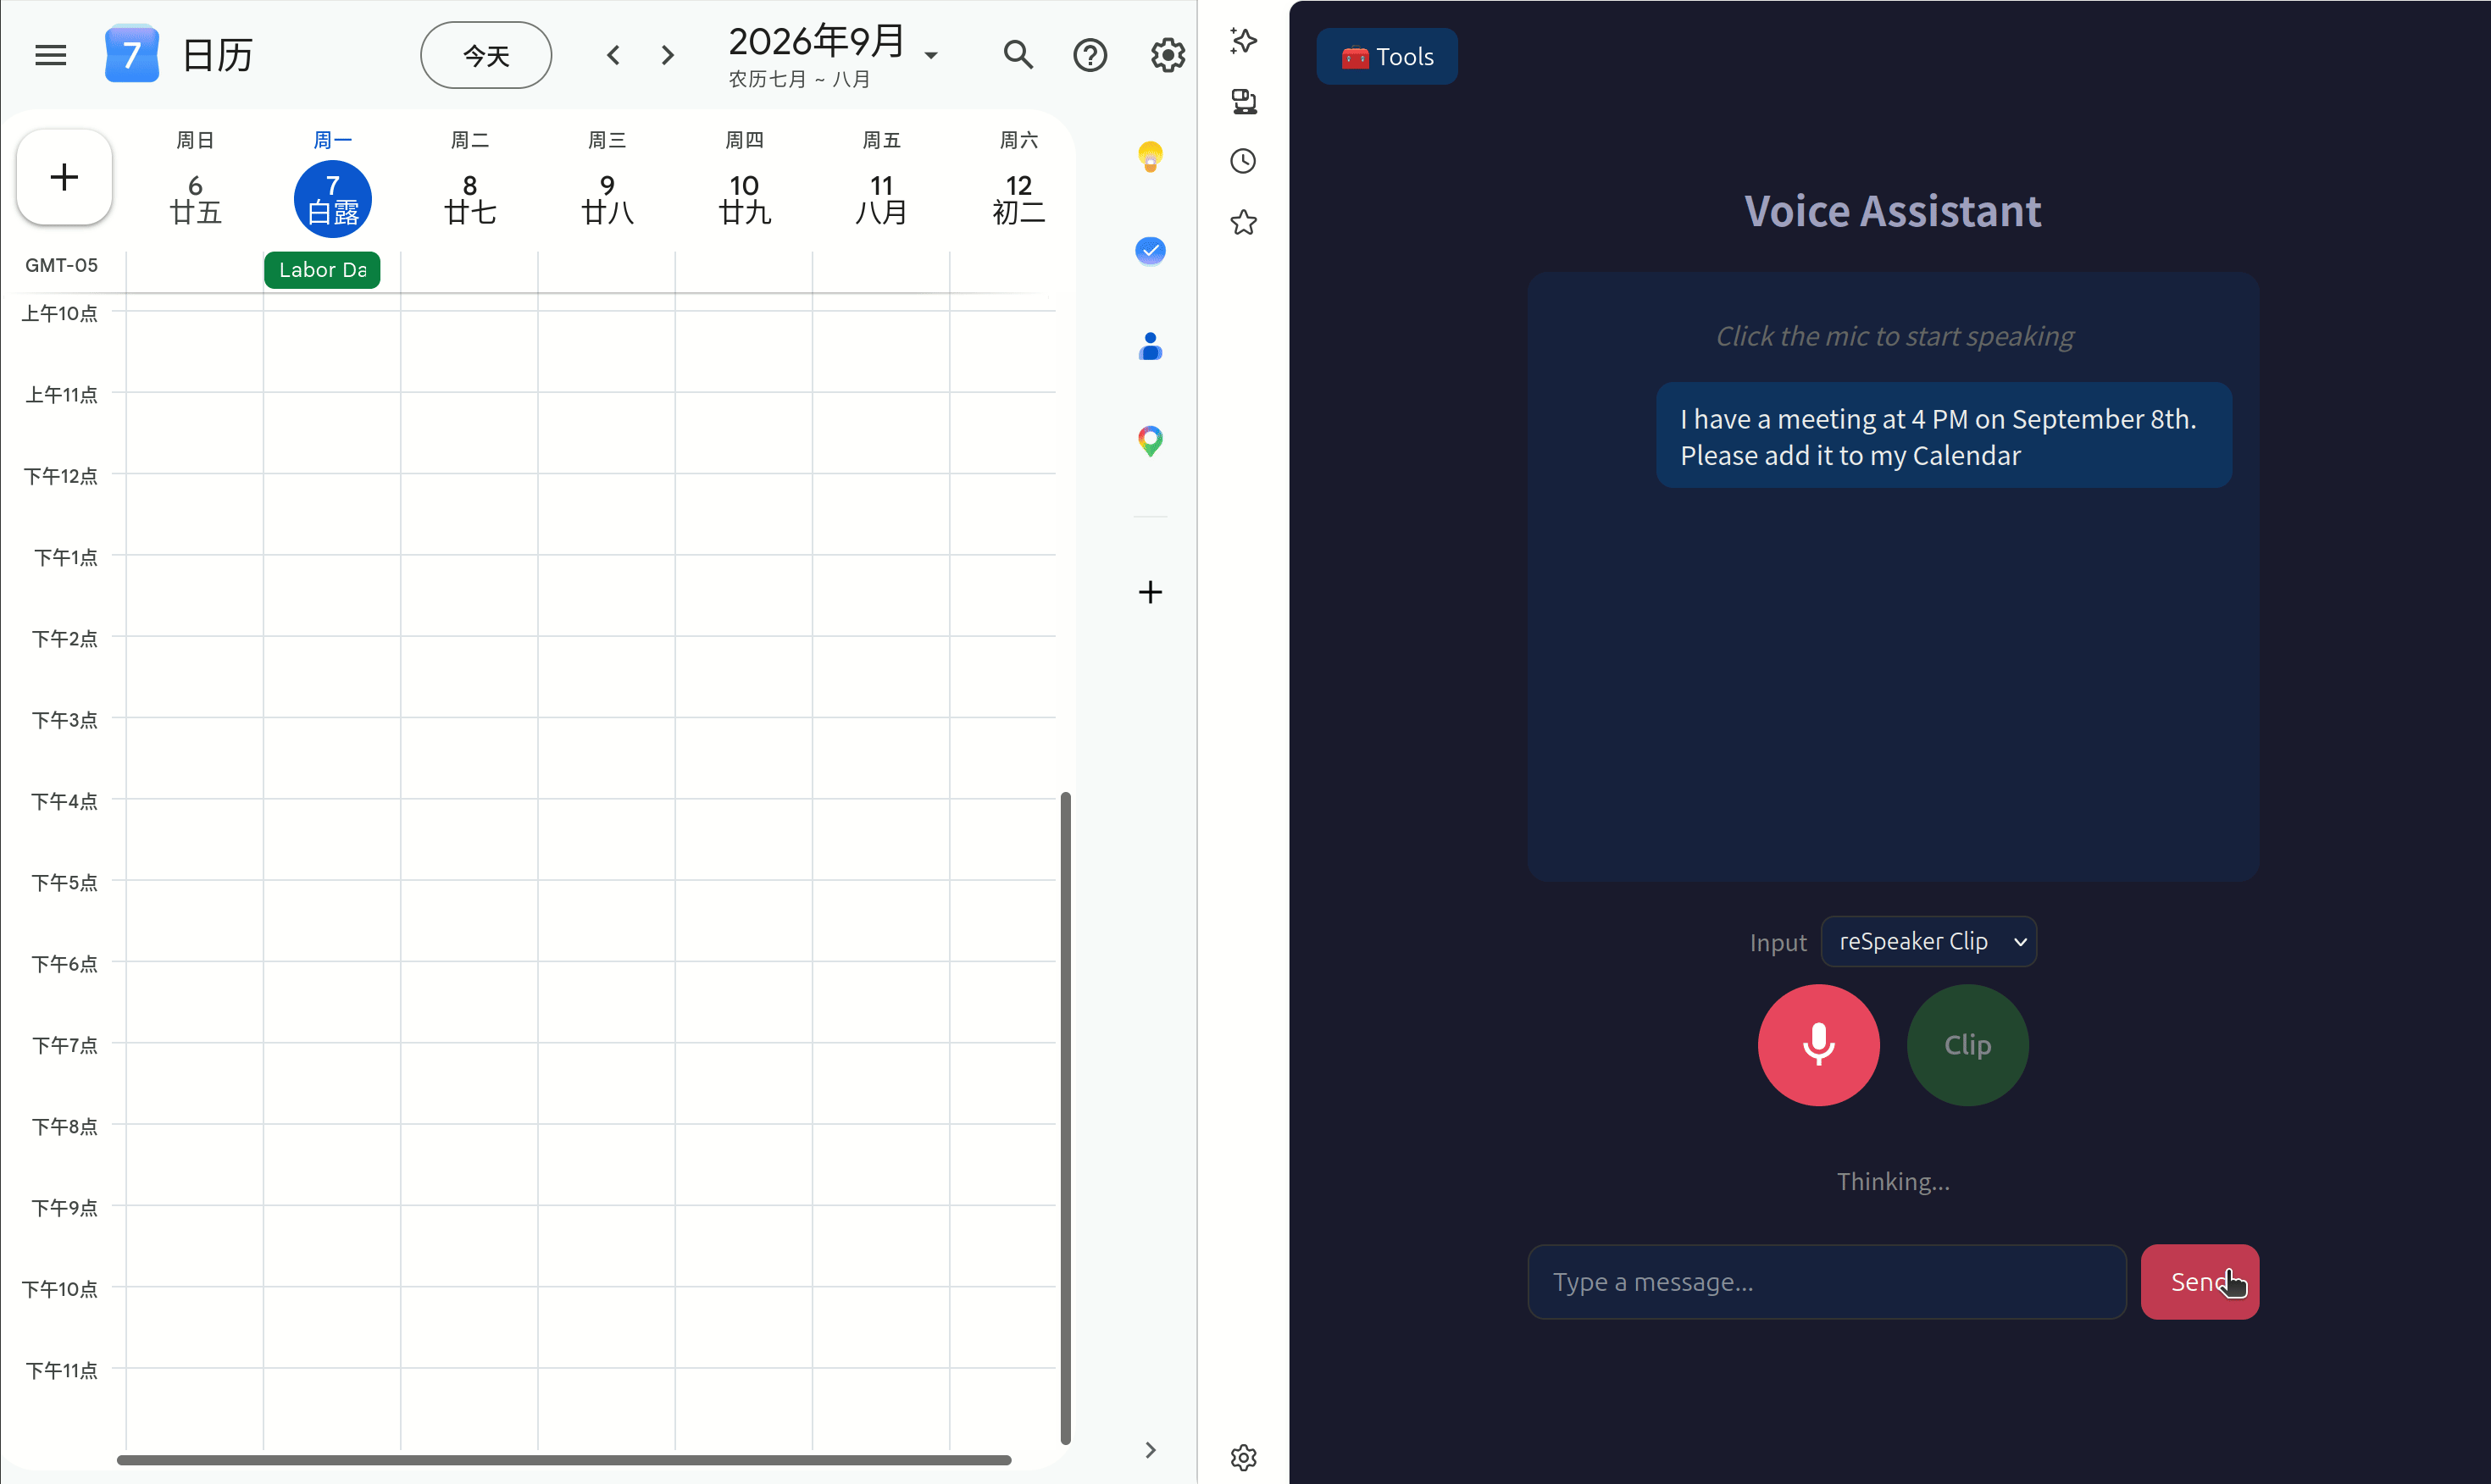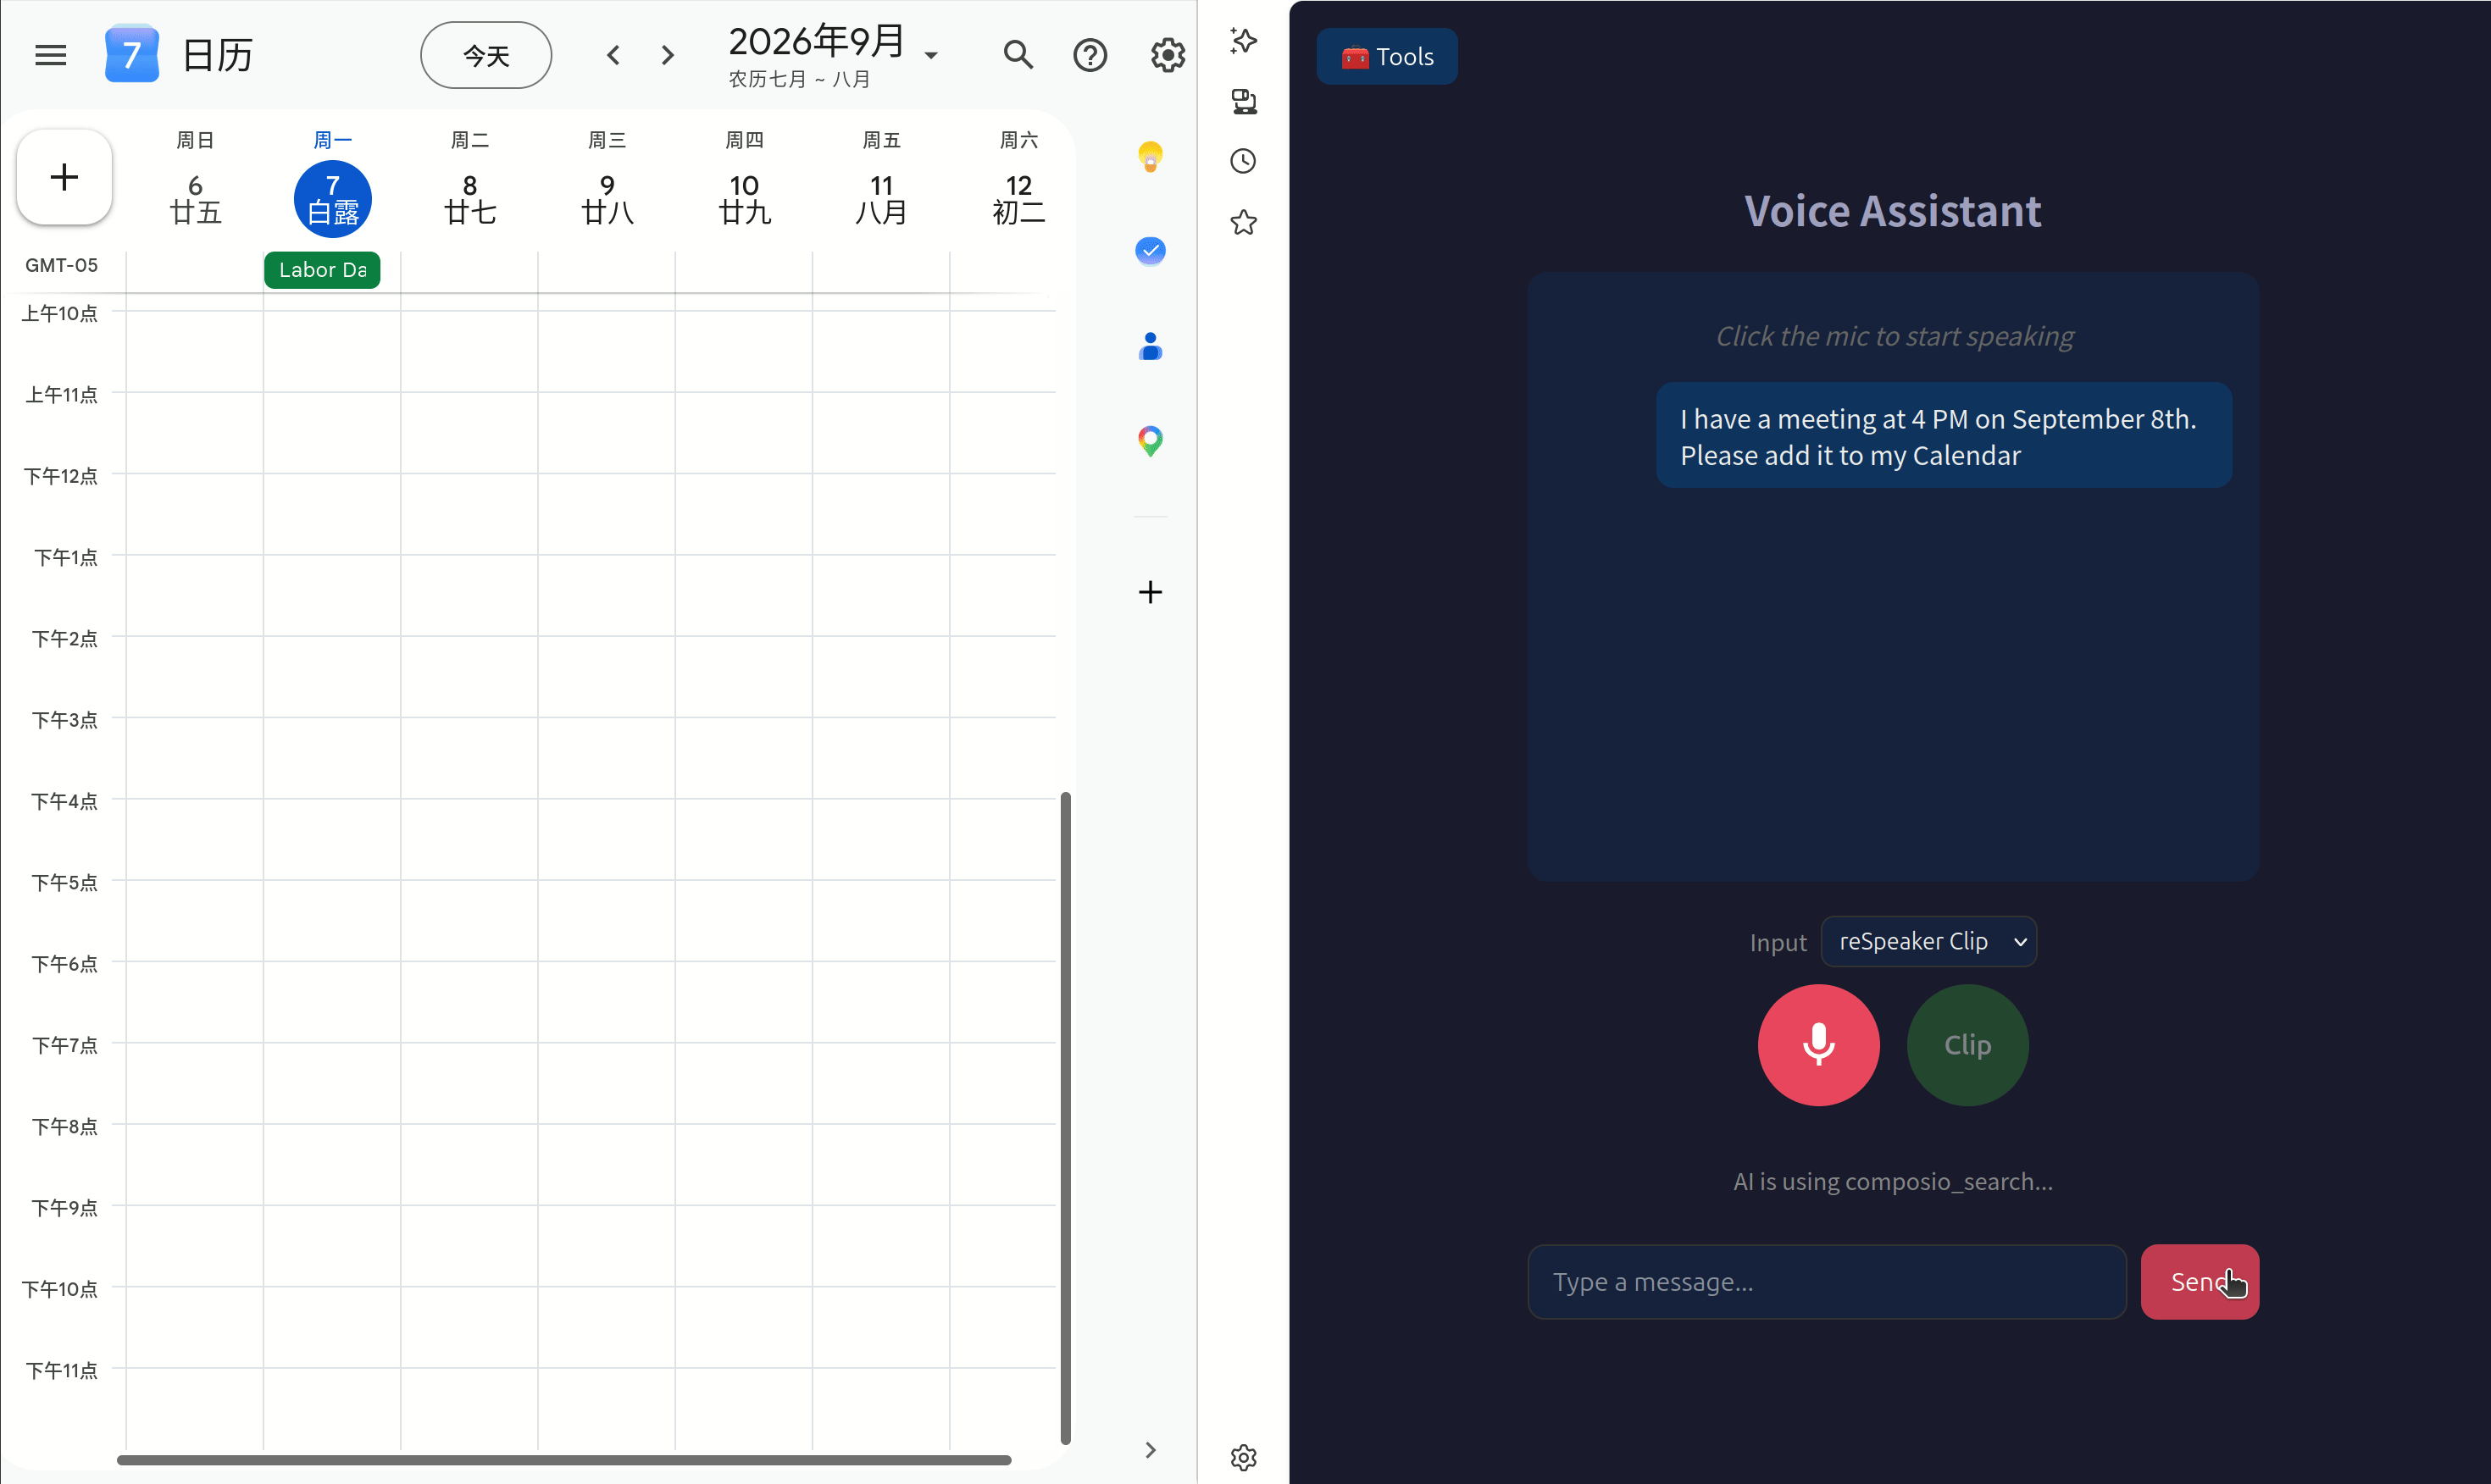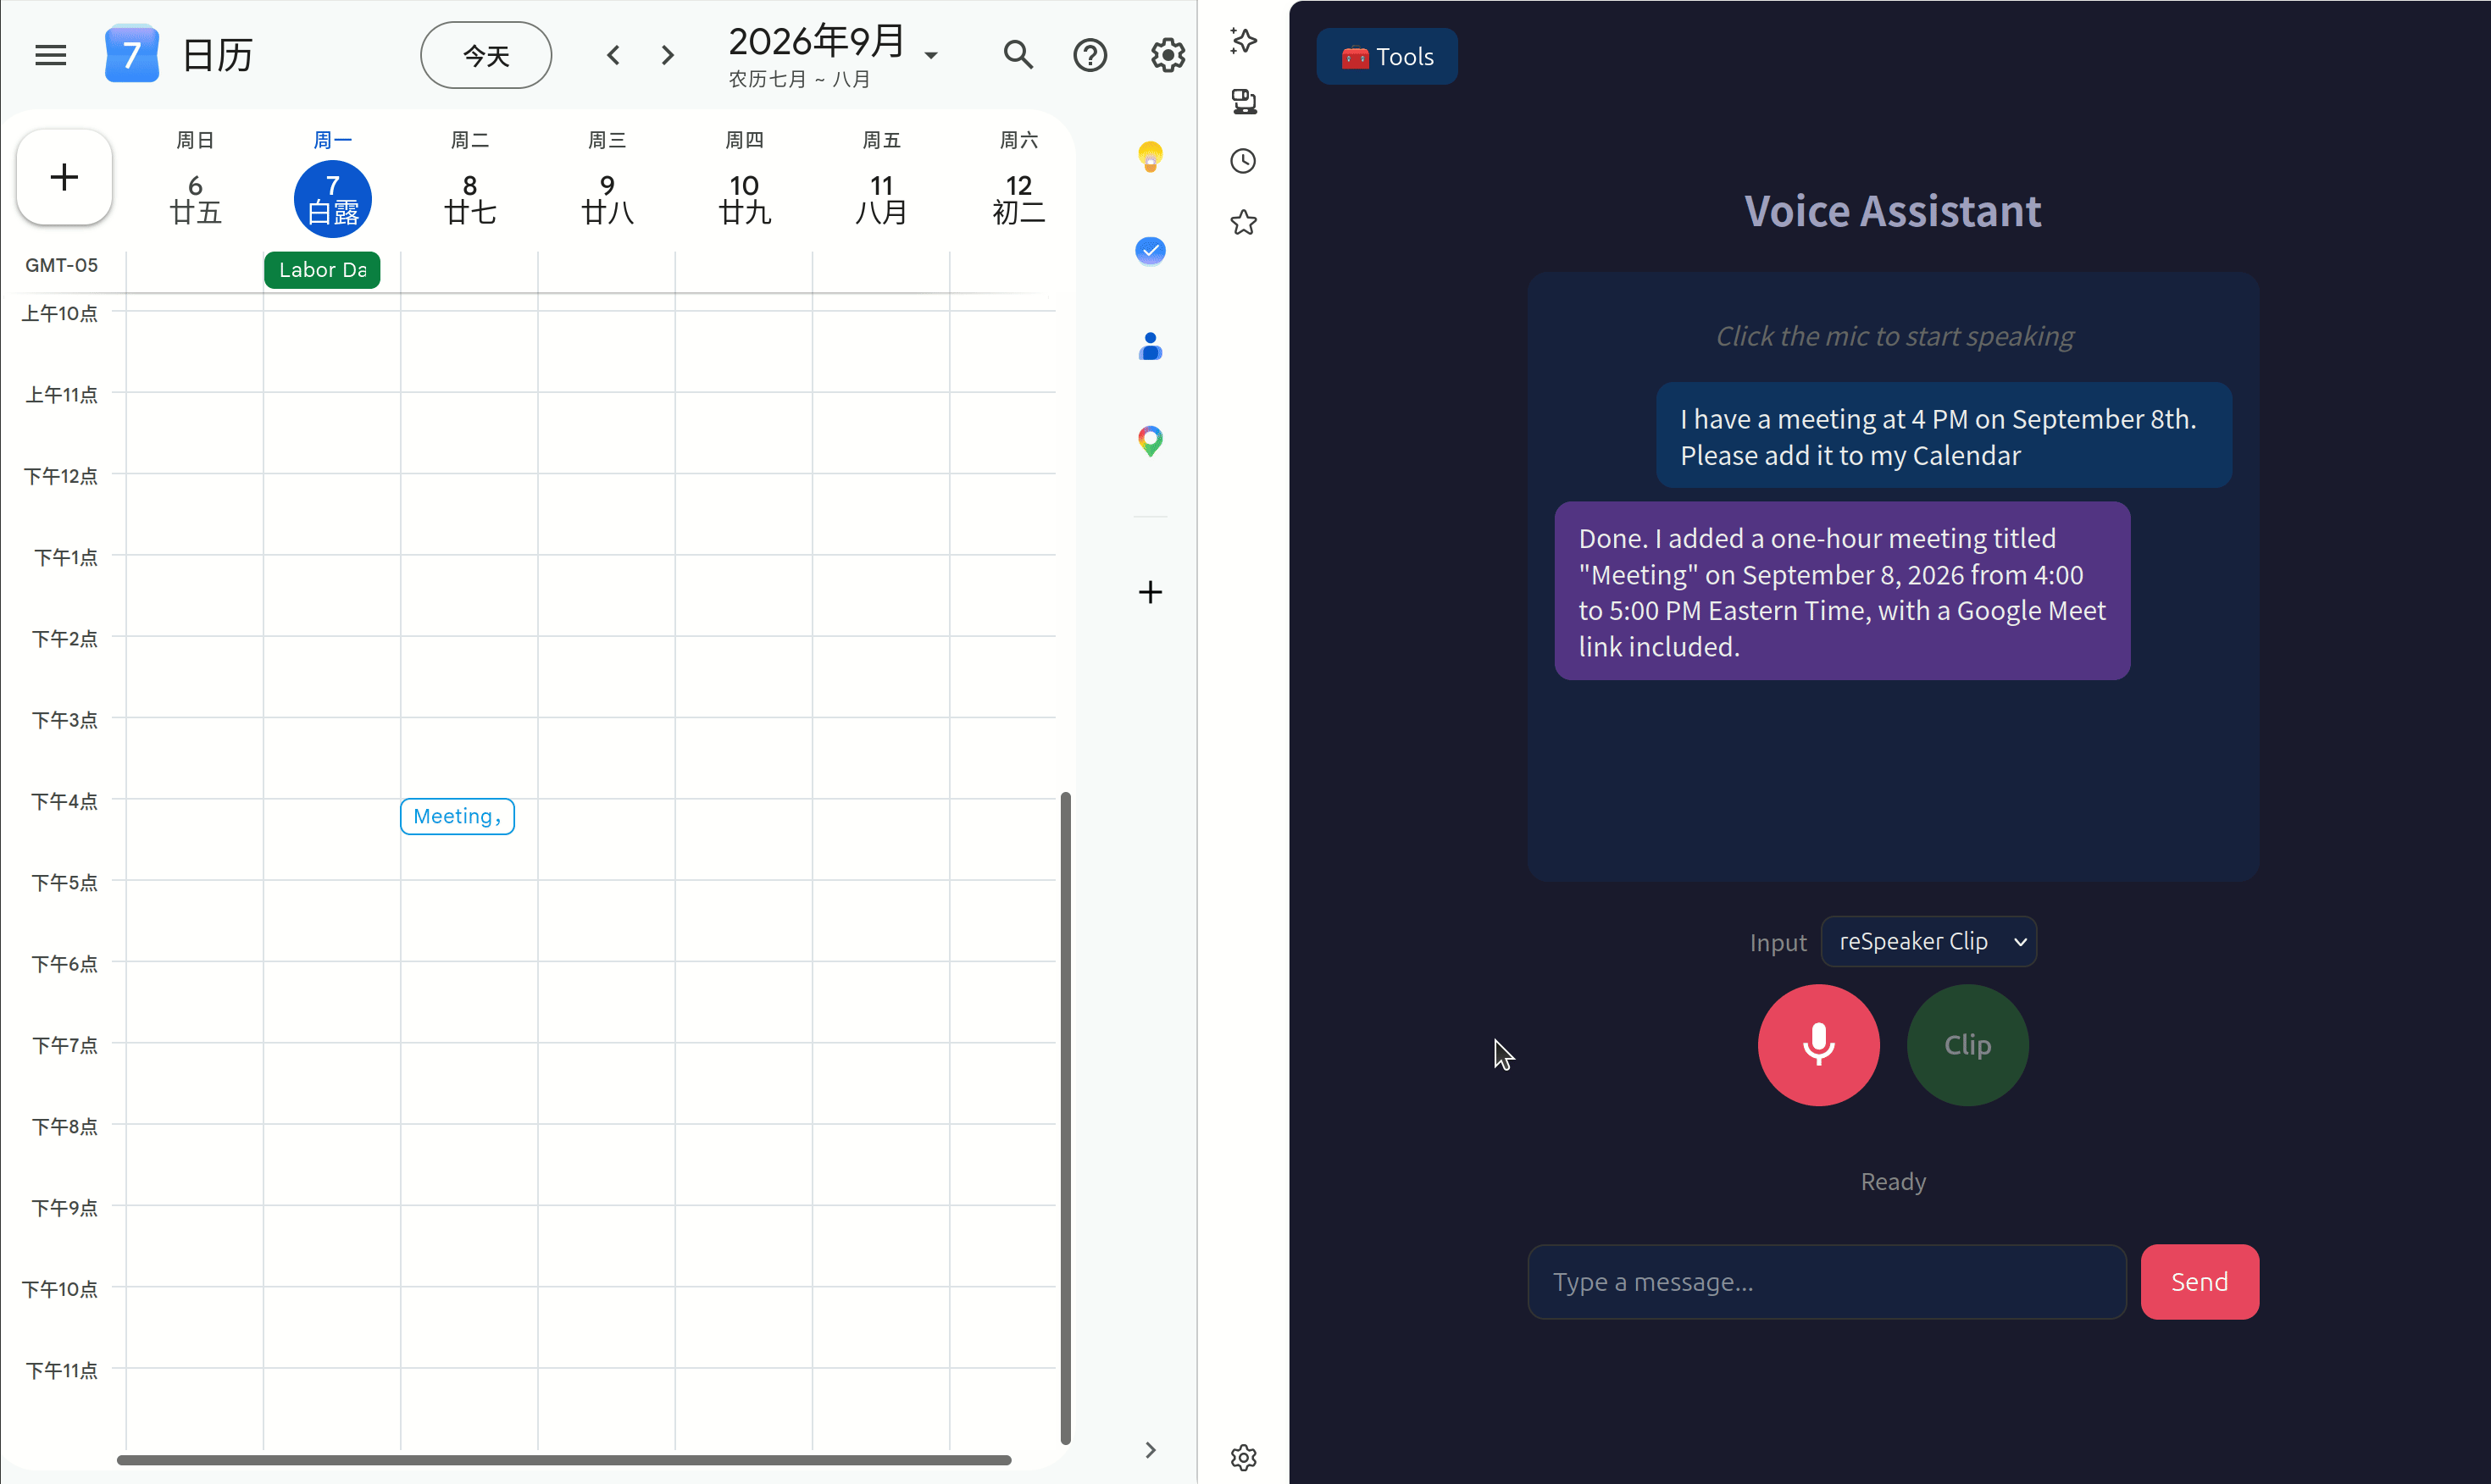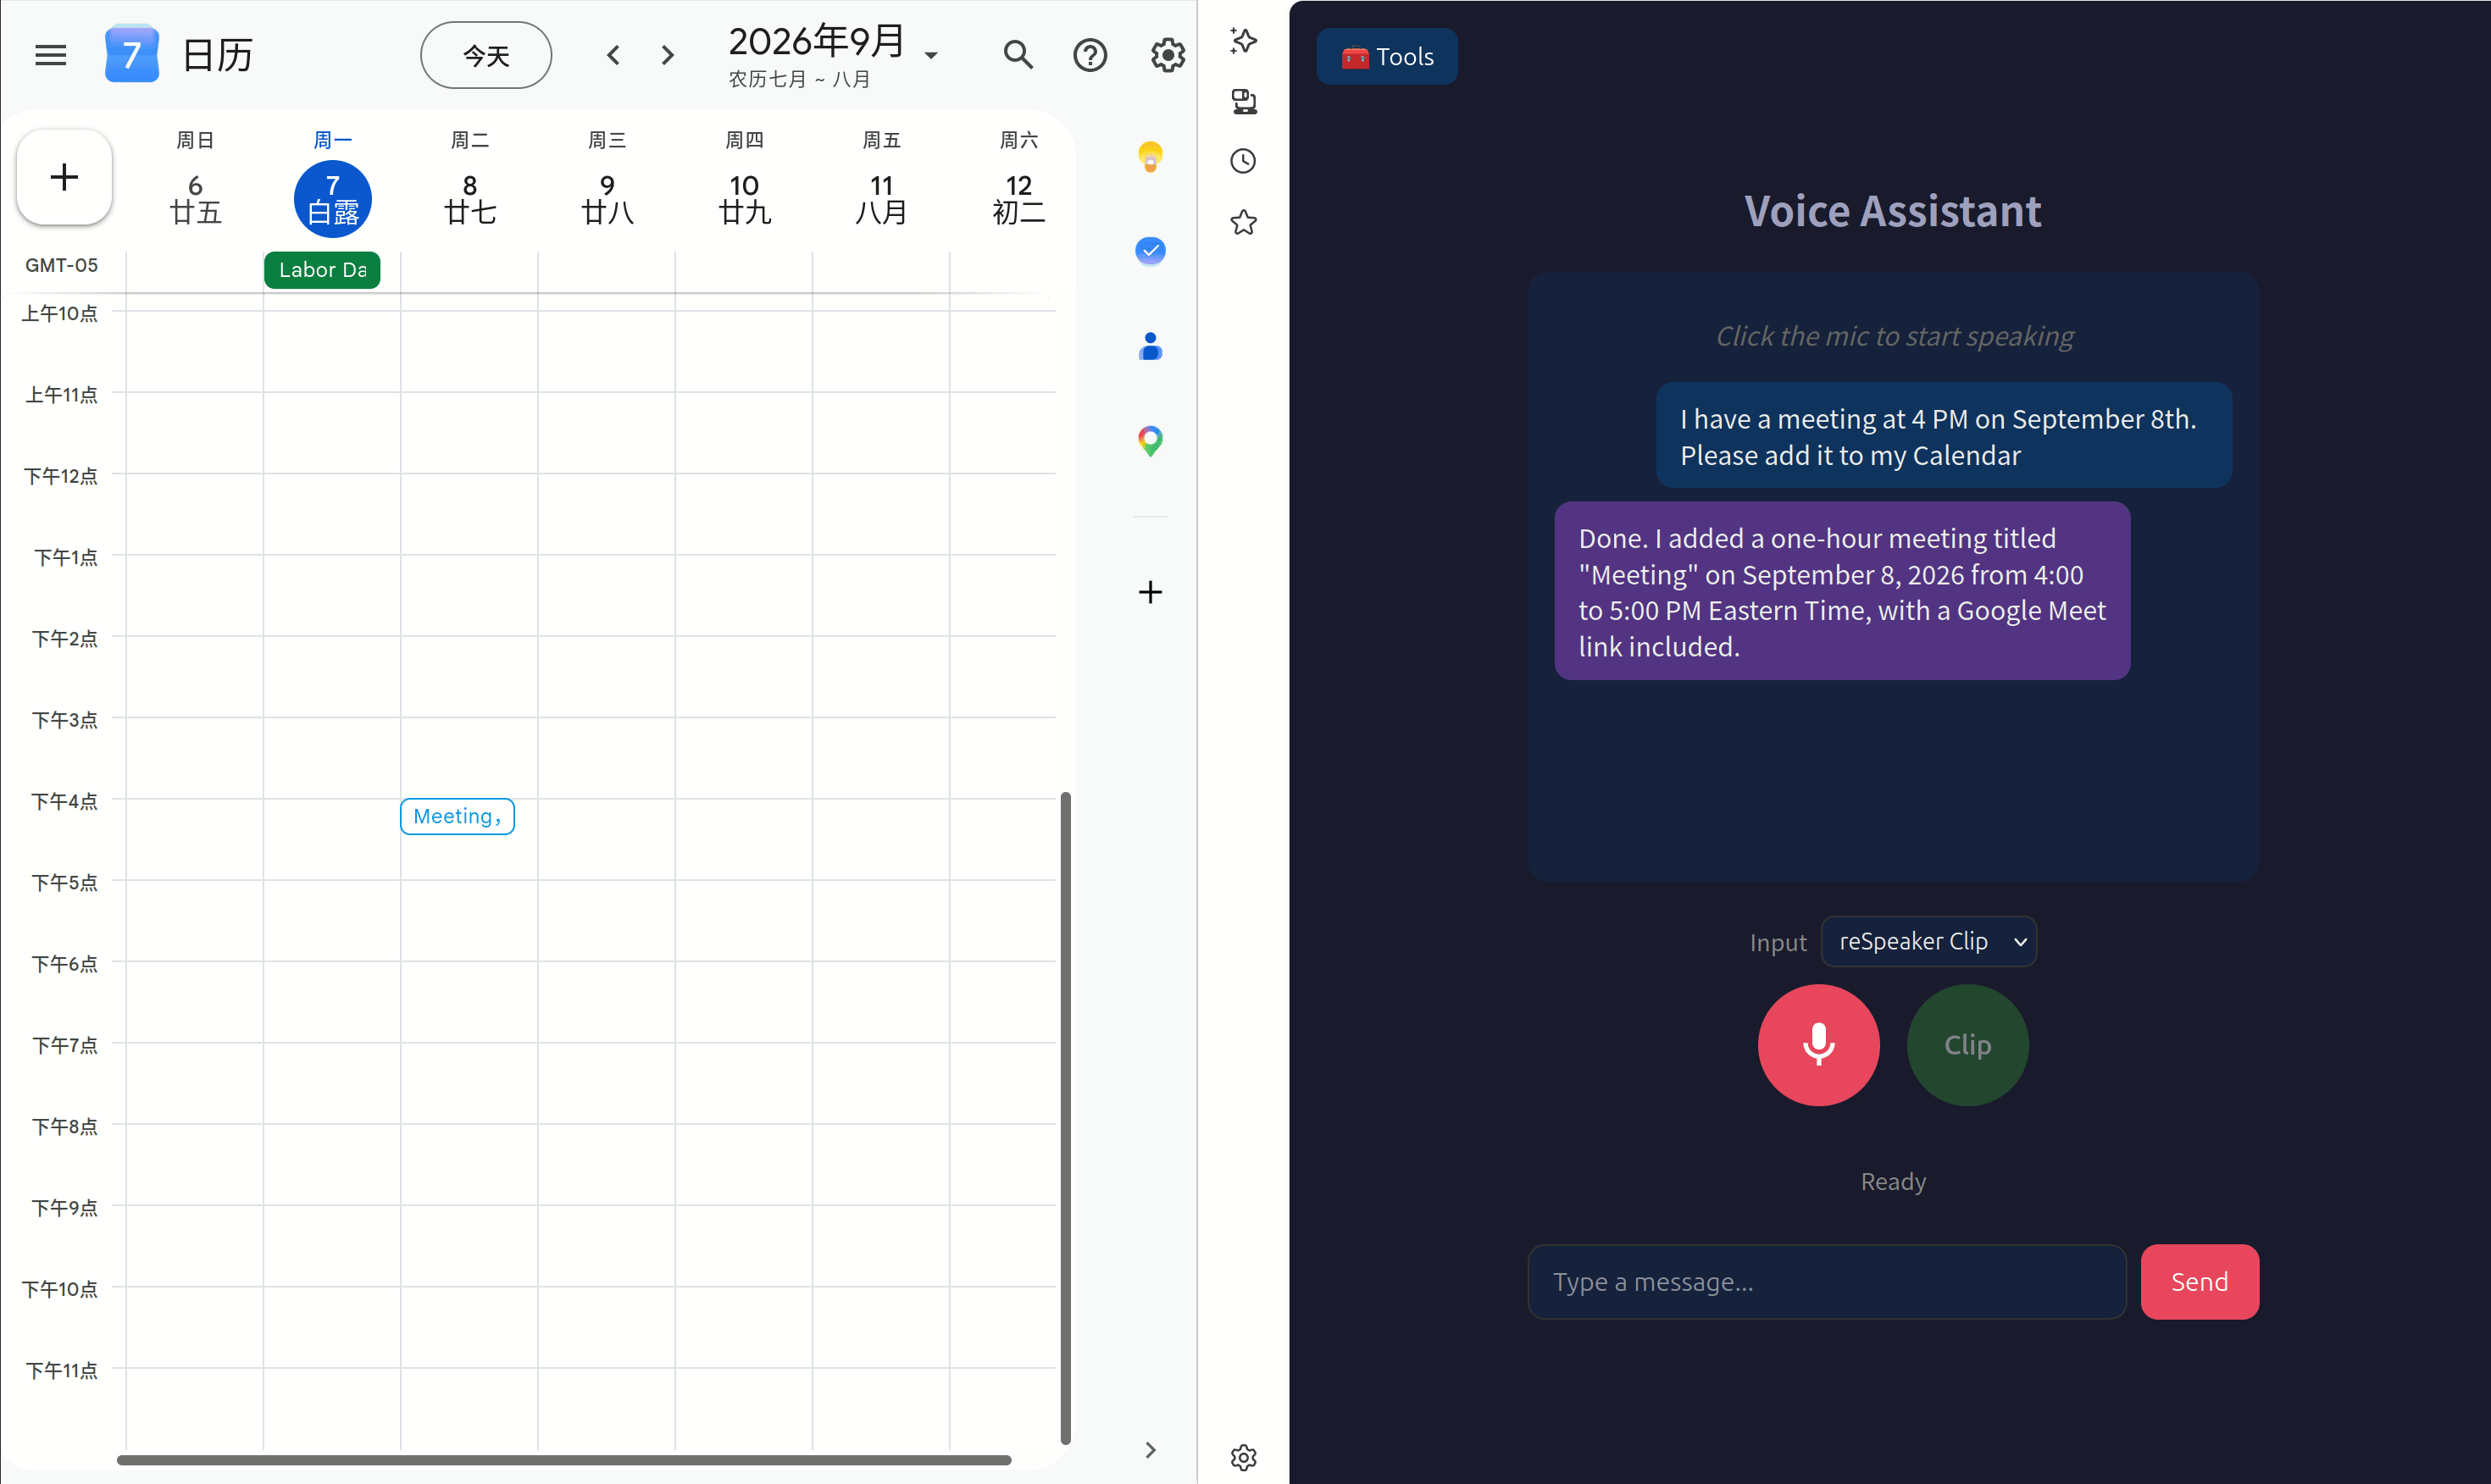
Adicionar Calendário
Suporte Técnico & Discussão de Produto
Obrigado por escolher nossos produtos! Estamos aqui para oferecer diferentes tipos de suporte para garantir que sua experiência com nossos produtos seja a mais tranquila possível. Oferecemos vários canais de comunicação para atender a diferentes preferências e necessidades.