ACT: Como a Segmentação de Ações Possibilita Manipulação Bimanual de Baixo Custo
Aprendizado de Manipulação Bimanual em Detalhe com Hardware de Baixo Custo
- Aprendizado por imitação
- ALOHA
- Segmentação de ações
- Combinação temporal
Pré-requisitos
O que é aprendizado por imitação?
-
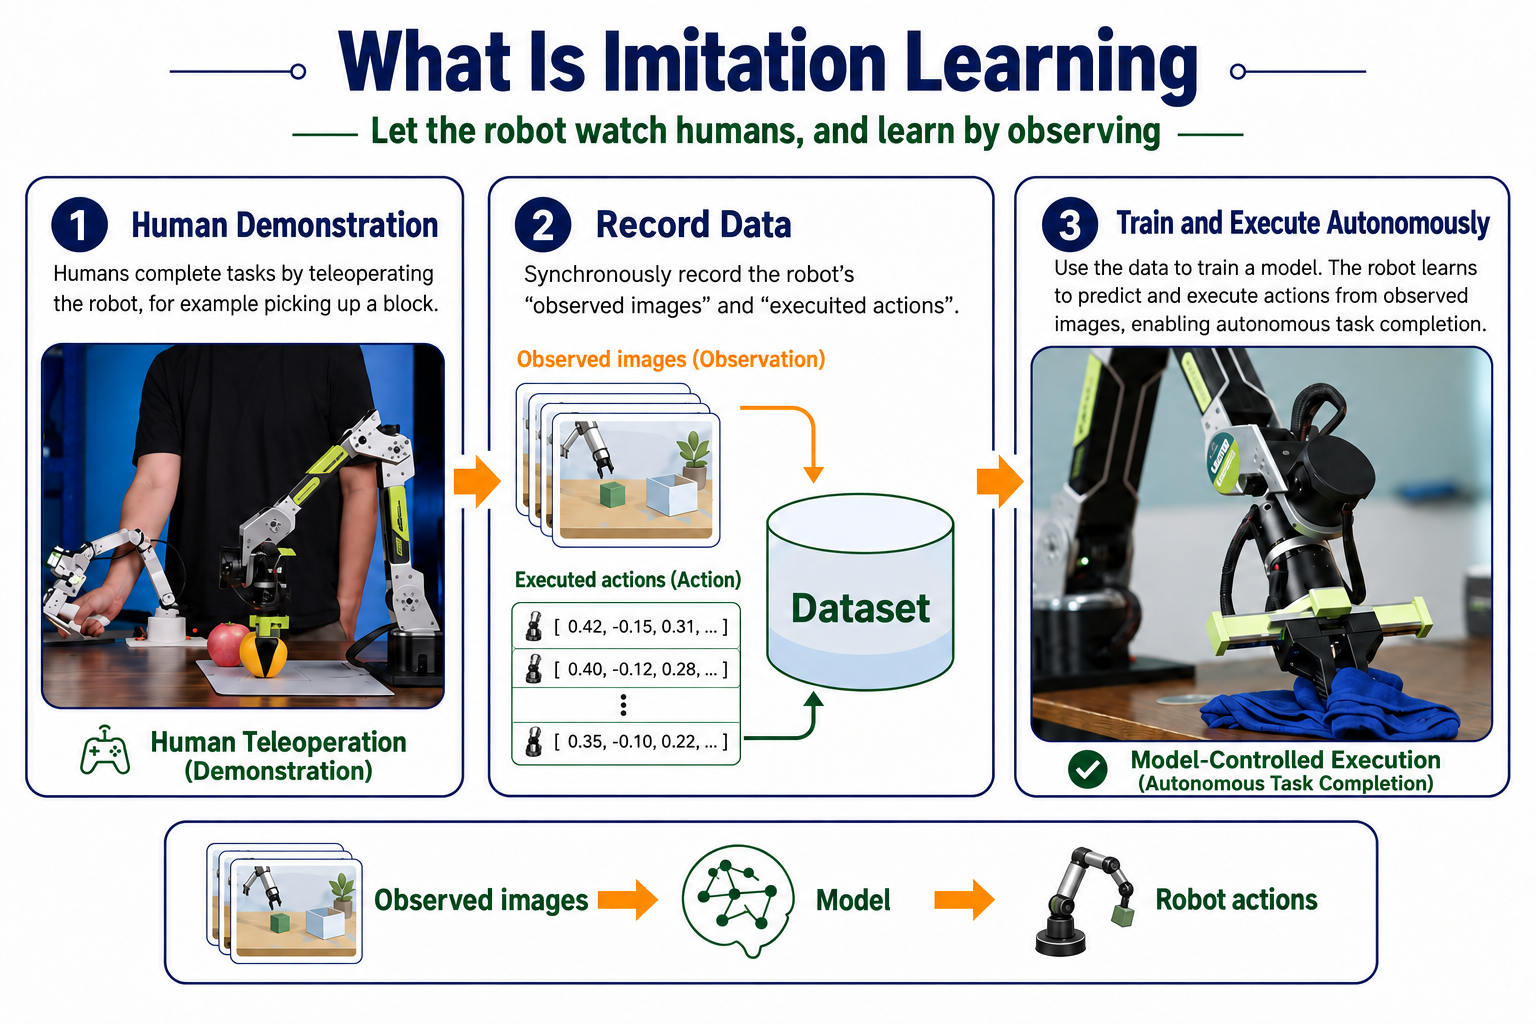
Aprendizado por imitação começa com uma ideia simples: demonstre a tarefa e deixe o robô aprender a imitá-la.
- Um humano teleopera o braço enquanto o sistema registra observações das câmeras e as ações executadas. Essas demonstrações treinam um modelo que depois pode agir a partir de imagens sem um operador humano.
Observação: o mundo que o robô vê
-
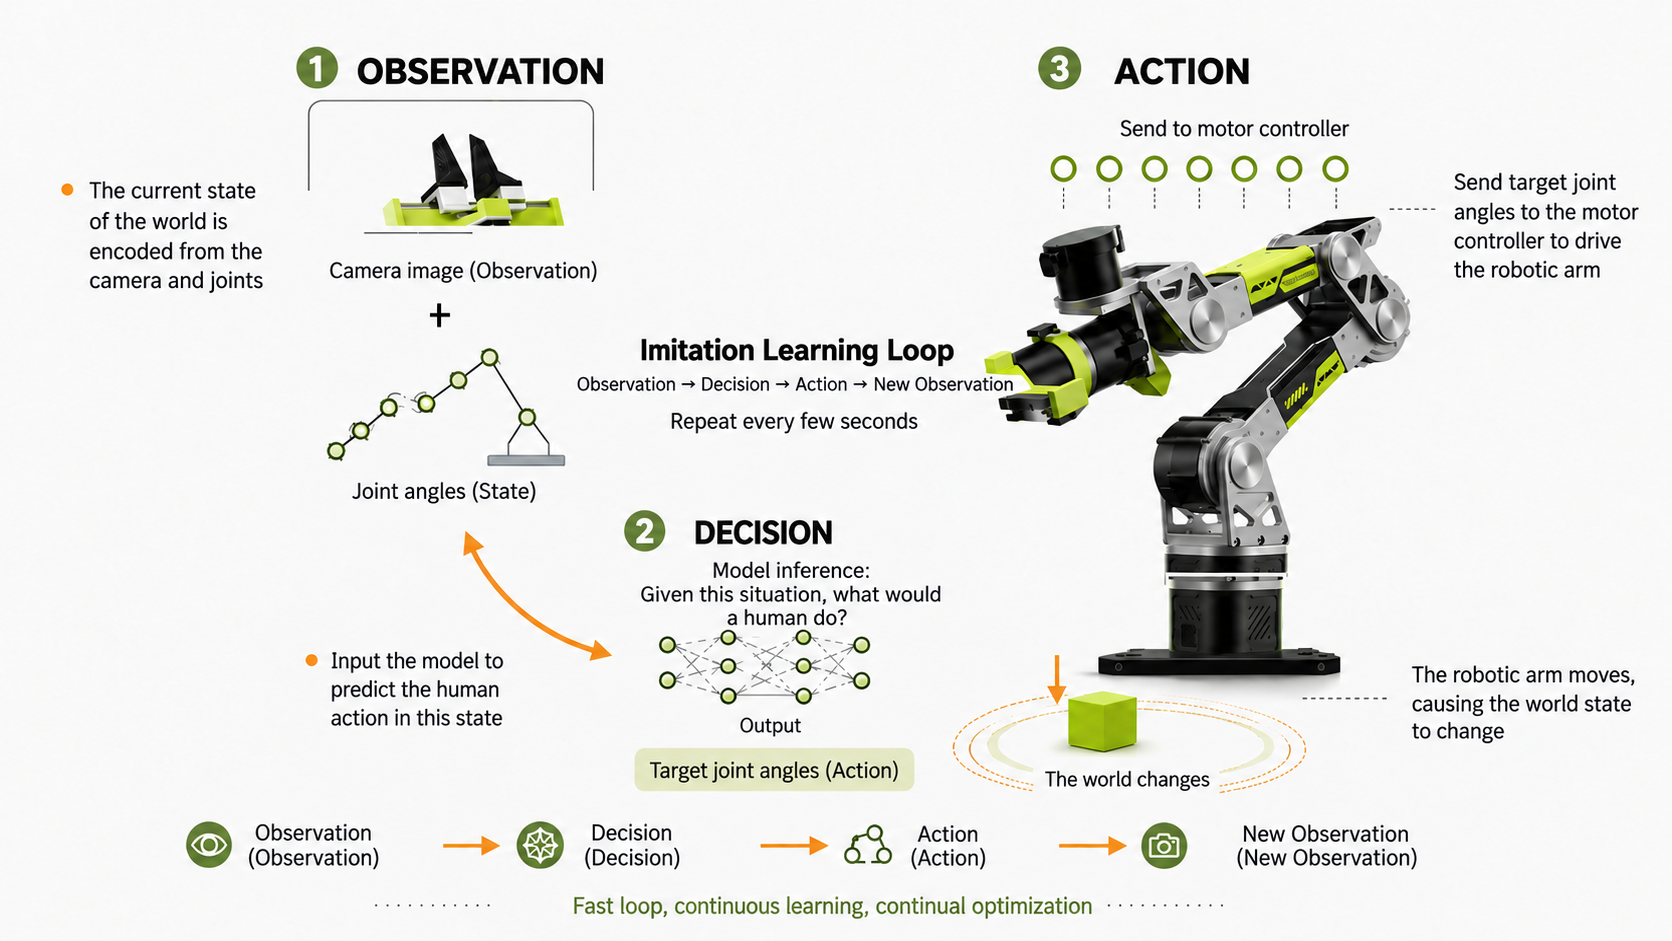
Uma observação é informação sobre o ambiente obtida por sensores: os olhos do robô. Para o reBot Arm, isso inclui:
-
A visão global da câmera frontal / superior dos objetos e suas posições na mesa.
-
A visão em close da câmera de punho da relação entre a garra e seu alvo.
-
Estado: a própria configuração do robô
-
Estado descreve o próprio robô em vez de seu entorno. É análogo à propriocepção: saber onde está sua mão ou o quanto seu cotovelo está dobrado com os olhos fechados. Para o reBot Arm, o estado inclui:
-
Ângulos atuais das seis juntas.
-
A abertura atual da garra.
-
Ação: o que é comandado ao robô fazer
-
Uma ação é o comando de saída do modelo para o braço. No reBot Arm, estado e ação têm a mesma dimensionalidade: seis juntas mais uma garra. O estado descreve a configuração atual; a ação especifica a configuração alvo:
-
Ângulos alvo para as seis juntas.
-
Abertura alvo da garra.
-
Ações de passo único e blocos de ações
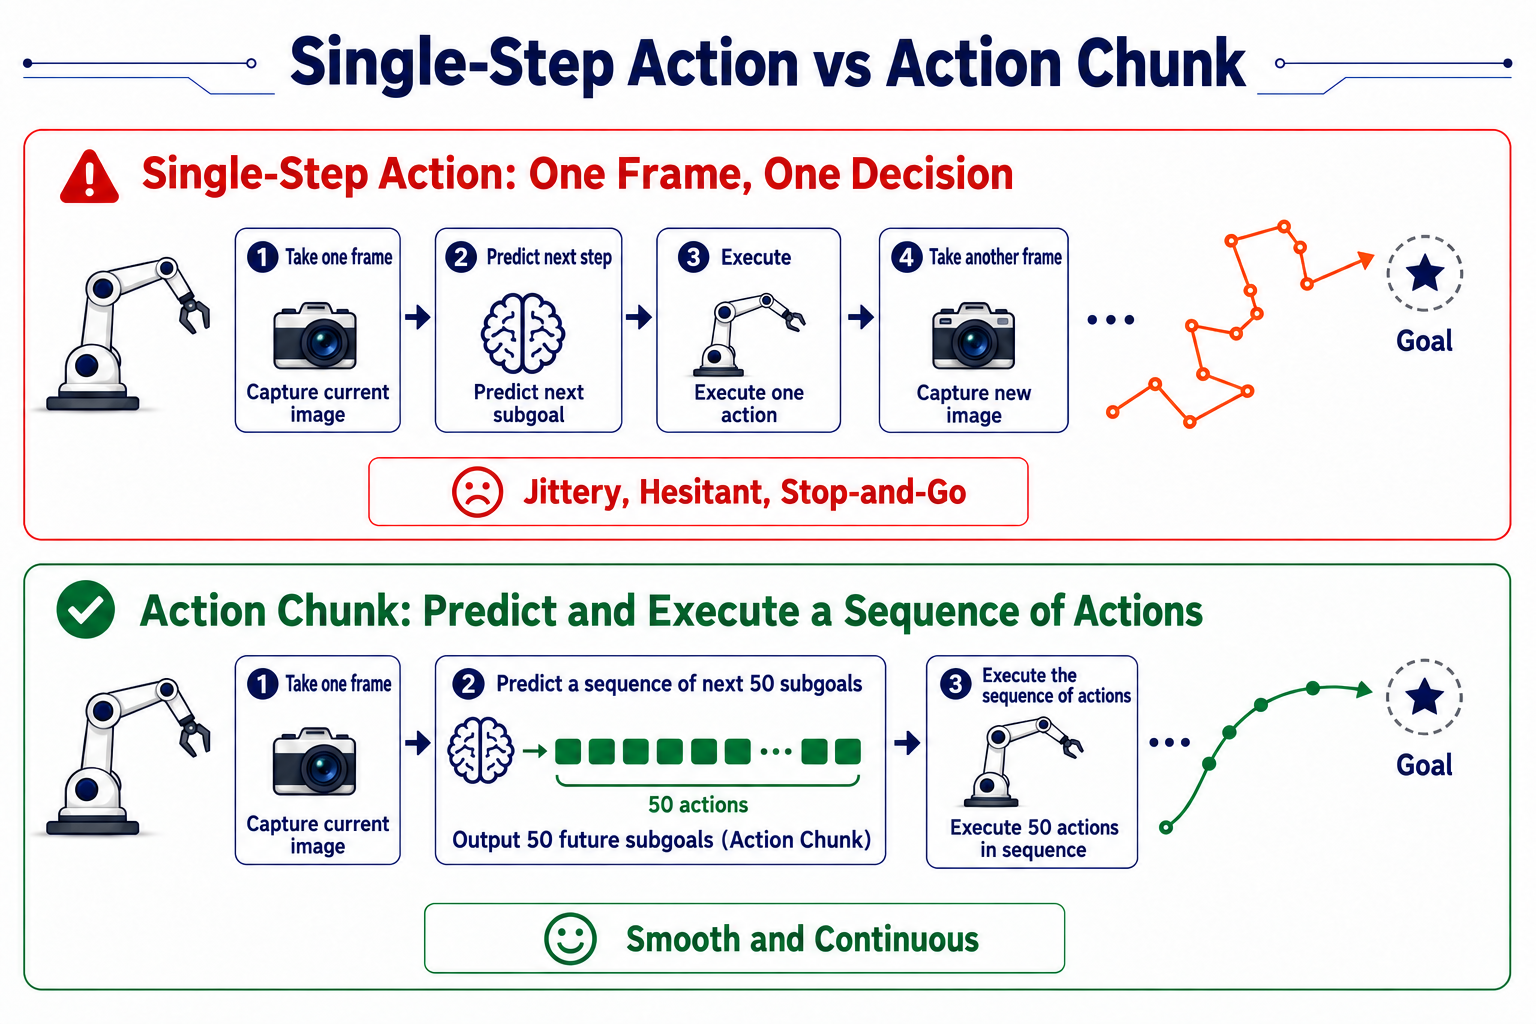
Ações de passo único: uma decisão por quadro
-
Para cada imagem, prever os próximos alvos das juntas, executá-los e obter outra imagem para a próxima previsão.
- Pequenos erros de previsão mudam a posição do braço e podem afastar as observações subsequentes da distribuição de treinamento. Erros posteriores então crescem. No robô, isso aparece como trepidação, hesitação e paradas repetidas, como reconsiderar seu próximo passo no meio de cada passada.
Blocos de ações: prever uma sequência de uma vez
-
Prever uma sequência curta de futuro, como 50 alvos de juntas ao longo do próximo segundo, em vez de apenas a próxima ação.
-
Menores requisitos de taxa de inferência. Uma previsão cobre um intervalo curto, permitindo um movimento mais suave mesmo quando a inferência é relativamente lenta, o que importa para implantação em hardware modesto.
-
Mais estrutura temporal. Prever várias ações futuras incentiva o modelo a representar a sequência pretendida, tornando menos provável que distrações momentâneas o desviem.
-
Movimento mais suave e coerente.
-
Blocos mais longos nem sempre são melhores. Se um objeto se mover durante a execução, previsões distantes podem ficar desatualizadas. Sistemas práticos equilibram isso executando parte de um bloco em malha aberta, depois observando e prevendo novamente.
Treinamento, inferência e avaliação
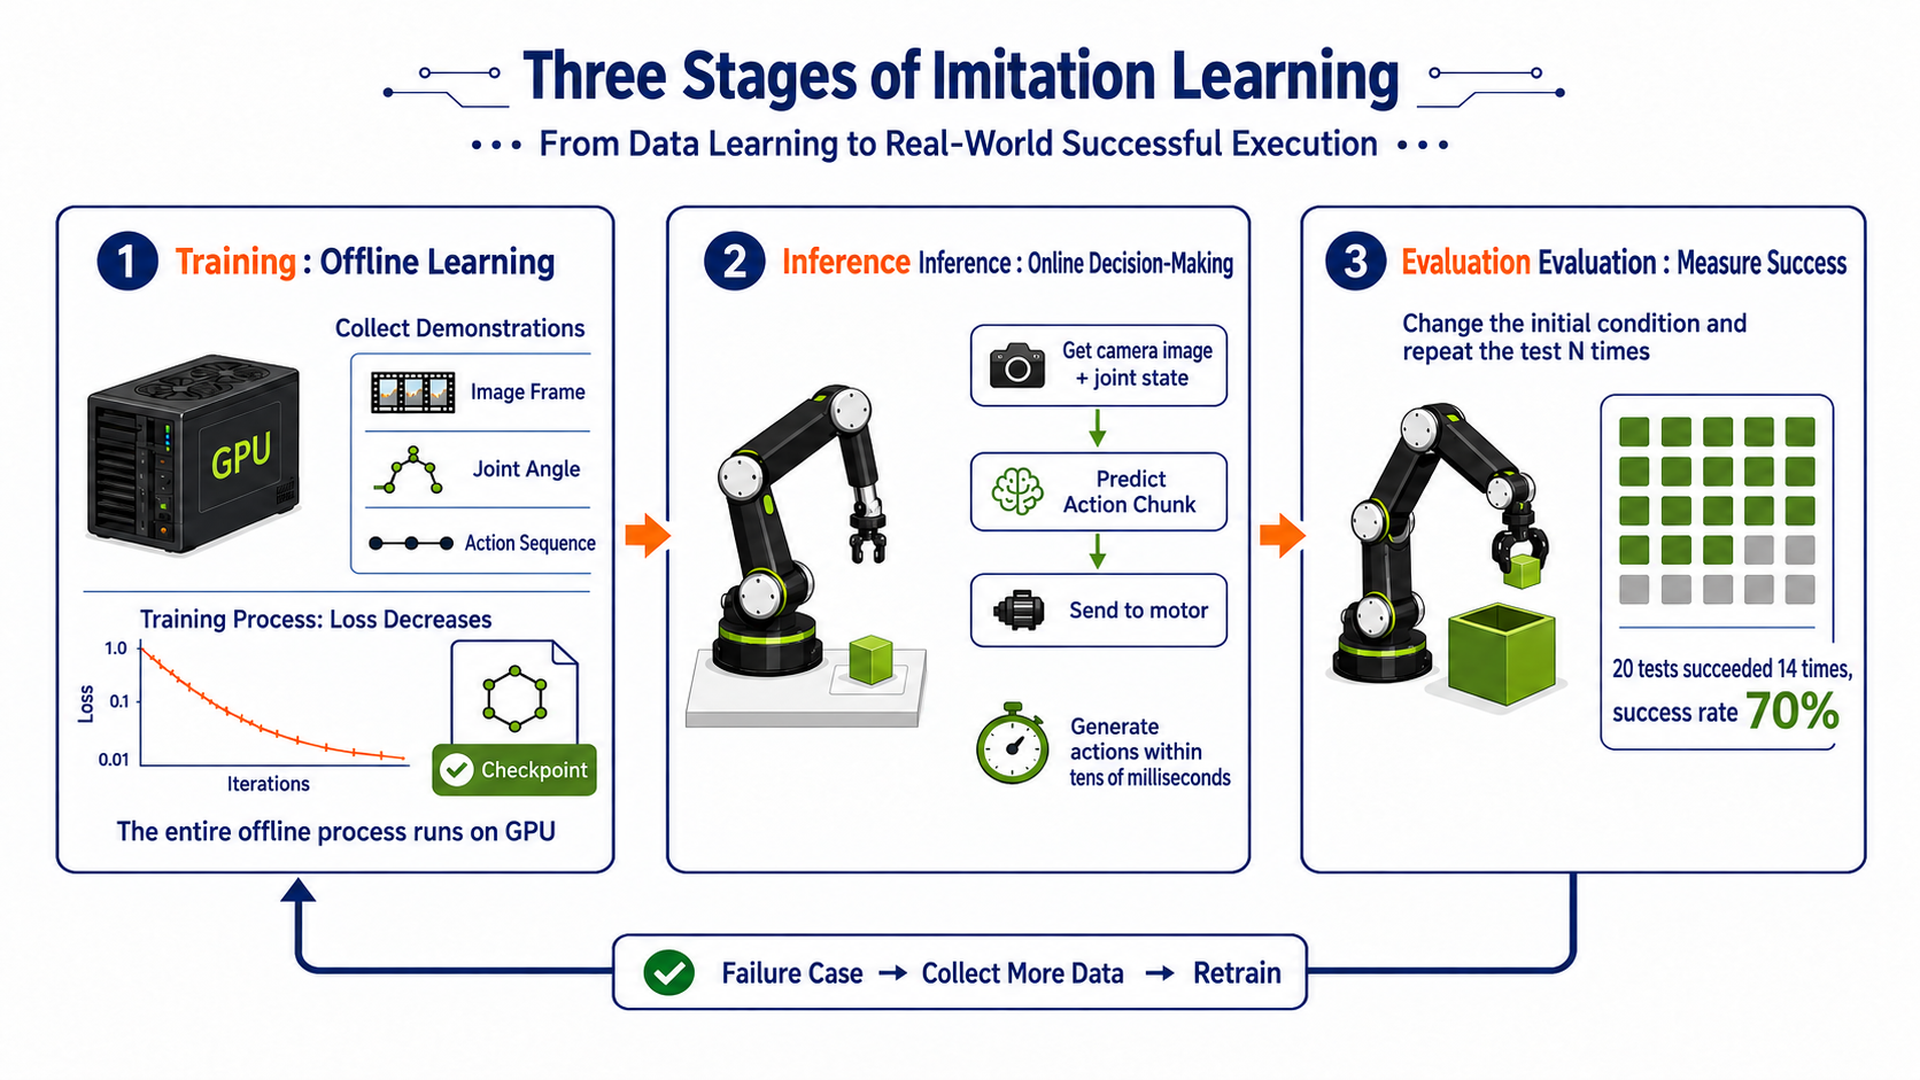
Treinamento: aprendizado offline
O treinamento é um processo offline após a coleta. O braço pode estar desligado enquanto a GPU faz o trabalho.
-
Entrada: sequências gravadas de imagens, estados e ações.
-
Processo: ajustar repetidamente os parâmetros do modelo para aproximar as ações previstas das demonstrações humanas.
-
Saída: pesos do modelo treinado.
A loss acompanha o ajuste do treinamento: loss decrescente significa que as previsões estão se tornando mais semelhantes às demonstrações.
Inferência: decisões online
- Inferência é implantar o modelo no robô real para trabalhar em tempo real: ler imagens das câmeras e estados das juntas → prever um bloco de ações → enviá-lo para os motores. As previsões devem chegar em dezenas de milissegundos, ou o braço irá engasgar.
Avaliação: medir o sucesso da tarefa
Um modelo treinado com baixa loss ainda pode falhar na tarefa. Baixa loss mede a precisão da imitação, não a conclusão da tarefa. Avalie no robô real:
-
Defina critérios claros de sucesso, como o bloco terminar dentro da caixa.
-
Varie as condições iniciais, incluindo posição do objeto e iluminação, ao longo de N tentativas.
-
Meça a taxa de sucesso: 14 sucessos em 20 tentativas resultam em 70%.
Falhas se tornam entrada para a próxima rodada de coleta. Adicione demonstrações para as situações que falham e então treine novamente. Isso fecha o ciclo dados–treinamento–avaliação usado em aprendizado de robôs na prática.
Contexto do artigo
Autores: Tony Z. Zhao¹, Vikash Kumar³, Sergey Levine², Chelsea Finn¹. Afiliações: ¹ Universidade de Stanford; ² UC Berkeley; ³ Meta.
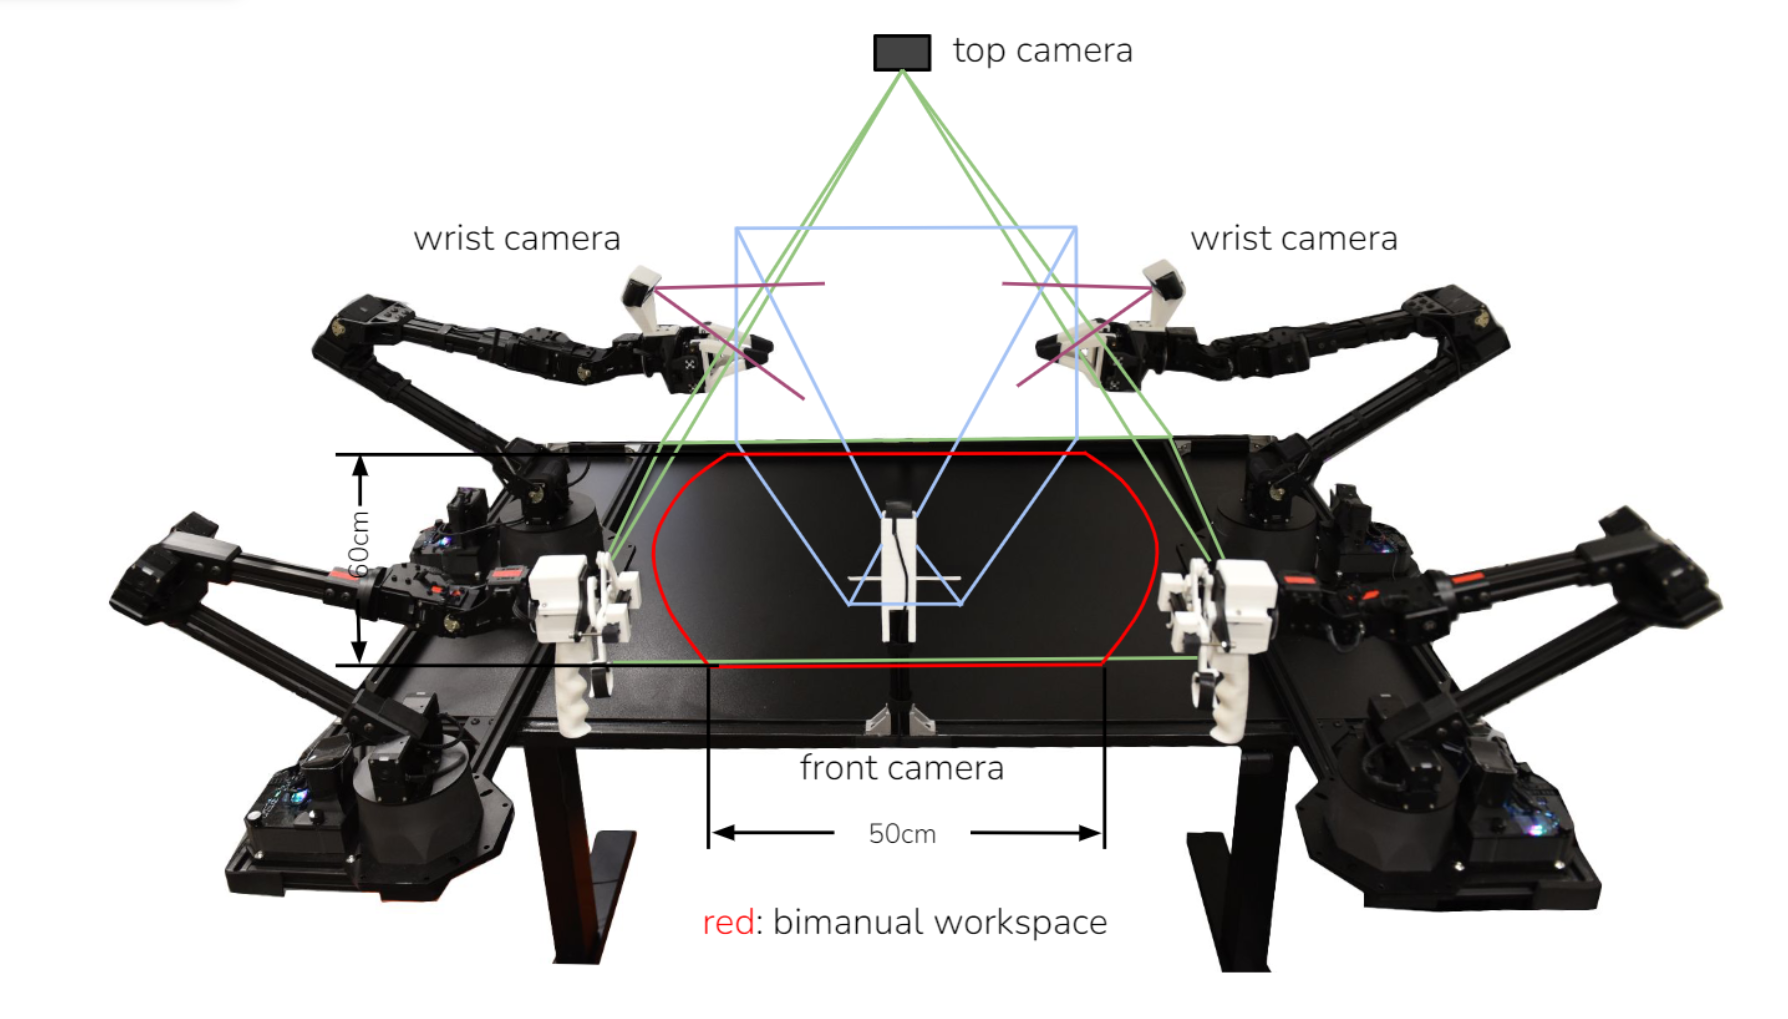
Contexto do artigo: publicado em 2023 por uma equipe conjunta de Stanford e Berkeley, este algoritmo leve de aprendizado por imitação combina redes convolucionais e Transformers. A plataforma experimental é o sistema de teleoperação bimanual ALOHA de seis DoF, com câmeras monoculares nos dois garras e uma câmera monocular global superior.
Resumo
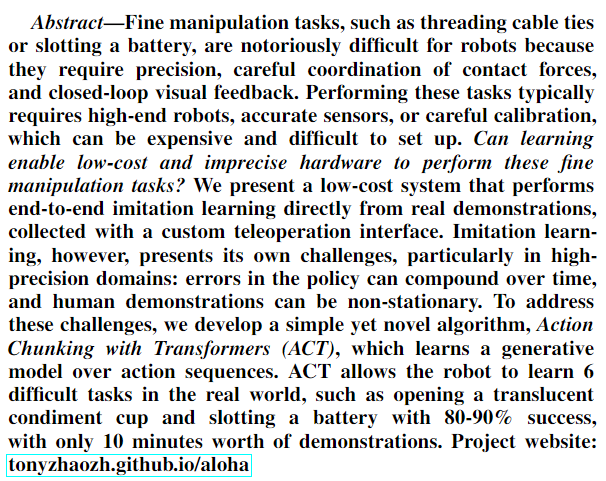
- Explicação:
Manipulação fina, como passar um lacre de cabo ou inserir uma bateria, é difícil para robôs. Ela exige precisão, forças de contato coordenadas e feedback visual em malha fechada. Soluções convencionais muitas vezes dependem de robôs caros, sensores precisos ou calibração cuidadosa. O aprendizado pode permitir que hardware barato e menos preciso execute essas tarefas?
O artigo apresenta um sistema de baixo custo que coleta demonstrações reais por meio de uma interface de teleoperação personalizada para aprendizado por imitação direto de ponta a ponta. Os desafios incluem erros de política acumulados e demonstrações humanas não estacionárias, especialmente em tarefas de alta precisão. O algoritmo proposto, Action Chunking with Transformers (ACT), aprende um modelo generativo de sequências de ações. Com apenas 10 minutos de demonstrações, o robô consegue executar seis tarefas desafiadoras do mundo real, como abrir copos translúcidos de condimentos e inserir baterias, com taxas de sucesso chegando a 80–90%.
- Comentário:
O aprendizado por imitação convencional frequentemente repete “observar → prever uma ação → executar → observar novamente”. Em tarefas de precisão, mesmo um pequeno erro pode levar o robô a um estado ausente das demonstrações, fazendo com que previsões posteriores se desviem ainda mais. Isso é erro acumulado.
A ideia central do ACT é a segmentação de ações (action chunking): gerar uma sequência contínua de futuro em vez de uma ação por vez. Isso dá suporte à continuidade temporal e reduz o horizonte efetivo de decisão ao longo do qual os erros se acumulam.
Transformers são bem adequados para relações em sequência: eles podem aprender como as ações se relacionam ao longo do tempo, em vez de considerar apenas o que o robô deve fazer no instante atual.
ACT permite que o robô preveja uma sequência curta de ações de uma só vez.
Introdução
-
Parágrafo 1: o problema. Tarefas delicadas que envolvem pinçar, alavancar ou rasgar, como abrir um copo ou inserir uma bateria, exigem feedback visual preciso e coordenação mão–olho para que as ações possam ser ajustadas conforme o ambiente muda.
-
Parágrafo 2: limitações anteriores e a abordagem proposta. Trabalhos como Grasping with Chopsticks e Goal-conditioned dual-action imitation learning dependem de hardware caro ou calibração cuidadosa. Os autores, em vez disso, buscam um sistema acessível, disponível e reprodutível: imagens RGB comuns → rede neural → ações do robô.
-
Parágrafo 3: a plataforma. O hardware experimental custa menos de US$20.000.
-
Parágrafo 4: o ACT aborda erros acumulados em aprendizado por imitação.
Mesmo com boas demonstrações, as previsões de ações podem conter pequenos erros. Em tarefas de precisão, um erro pode levar o robô a um estado diferente daqueles do treinamento, tornando as previsões subsequentes progressivamente menos confiáveis.
Os autores se inspiram em action chunking na psicologia: as pessoas organizam movimentos contínuos em unidades coerentes em vez de tratar cada instante como uma ação independente.
Aprendizado por imitação convencional: observação atual → próxima ação.
ACT: observação atual → ações para os próximos k passos de tempo.
Prever uma sequência curta efetivamente encurta o horizonte de decisão por um fator k, reduzindo o efeito de erros que se acumulam ao longo de decisões individuais.
O chunking também ajuda a explicar irregularidades em demonstrações humanas, como pausas. Um modelo de sequência pode interpretar uma pausa no contexto dos movimentos antes e depois dela, em vez de tratar uma observação instantânea como suficiente para explicá-la.
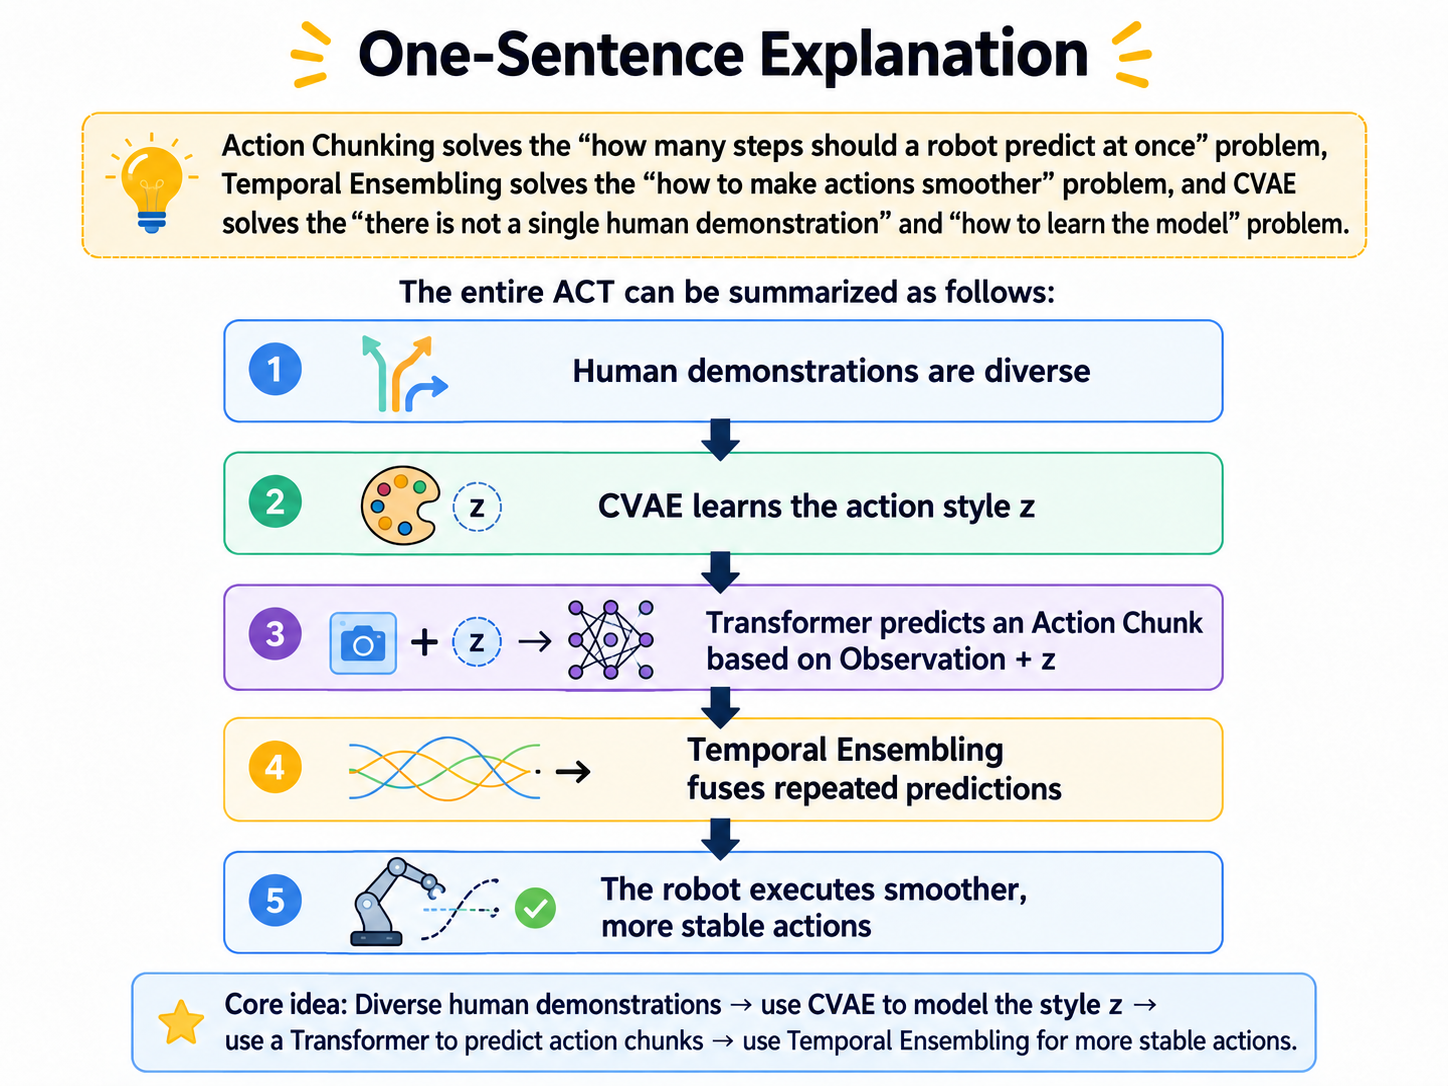
Para uma execução mais suave, o temporal ensembling combina chunks sobrepostos previstos em momentos diferentes. Em vez de escolher apenas uma previsão para o instante atual, o ACT as combina com pesos, reduzindo tremores.
A arquitetura usa um Transformer para sequências de ações e um VAE condicional (CVAE) para variabilidade das demonstrações. Uma tarefa pode ter várias trajetórias, velocidades ou ordens de ações válidas; o CVAE modela essa distribuição em vez de assumir uma única sequência correta.
Action Chunking with Transformers: ACT.
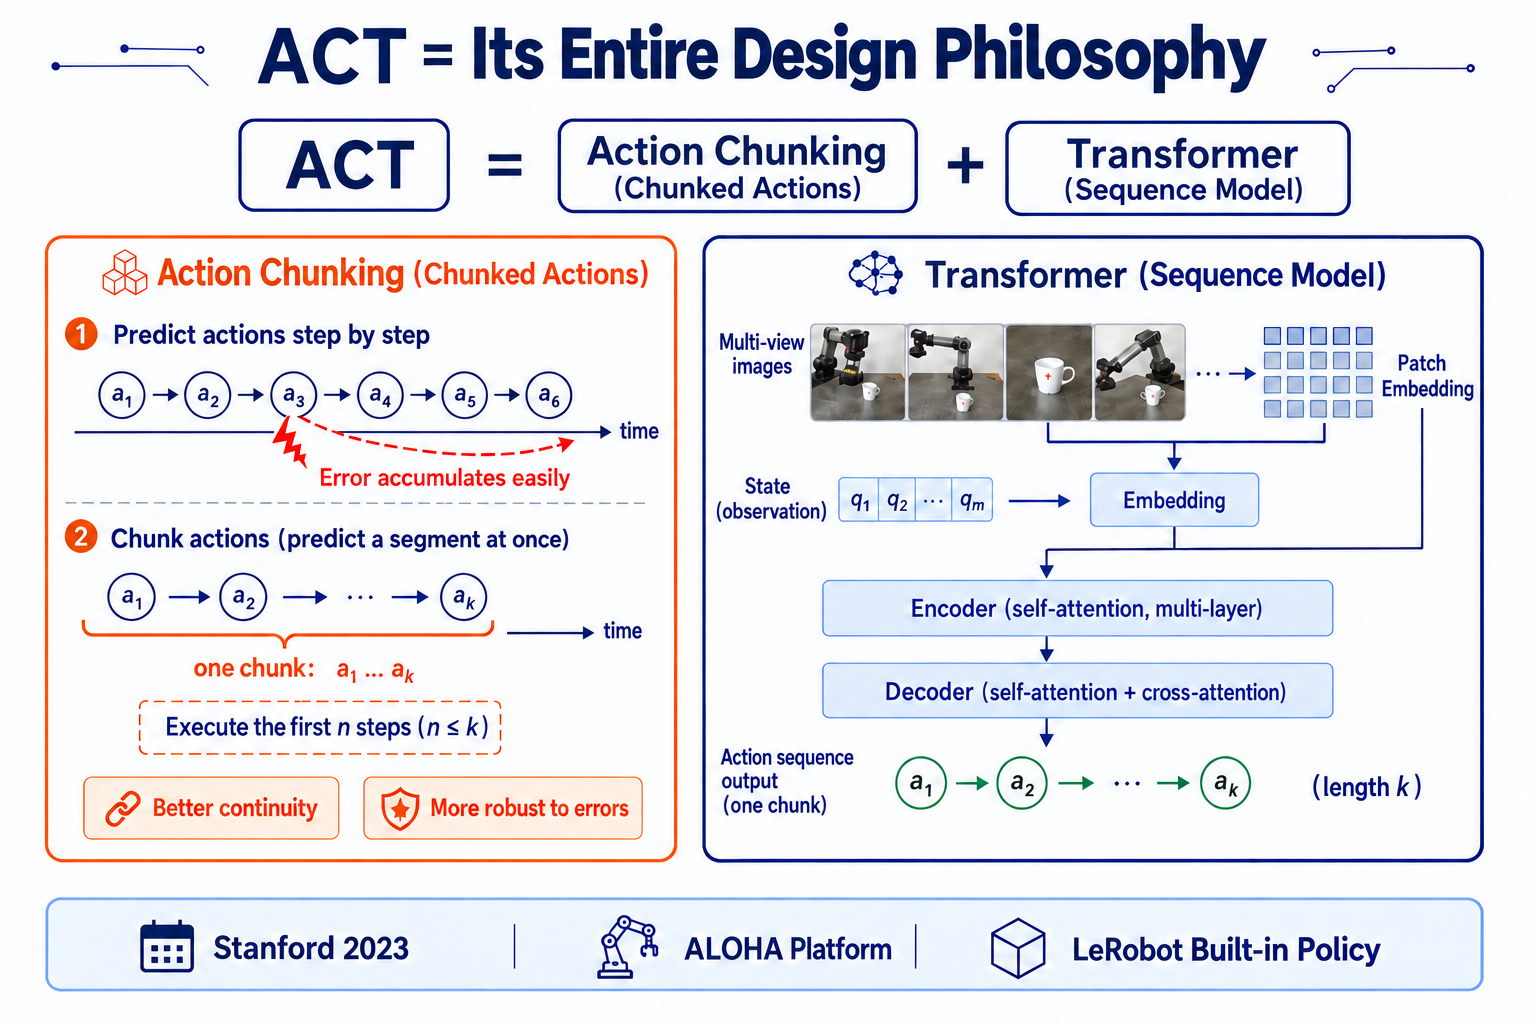
- Parágrafo 5: as duas contribuições são uma plataforma de teleoperação de baixo custo e o algoritmo ACT.
O artigo aborda dois problemas conectados de aprendizado de robôs:
1. De onde vêm as demonstrações?
Um sistema de teleoperação de baixo custo permite que pessoas realizem manipulação fina diretamente e coletem demonstrações de alta qualidade de forma eficiente.
2. Como o robô aprende a partir delas?
ACT combina chunks de ações, Transformers, um CVAE e temporal ensembling para aprender manipulação fina com feedback visual. A contribuição é a combinação de hardware e aprendizado: teleoperação humana → demonstrações → treinamento do ACT → execução autônoma do robô.
Com aproximadamente dez minutos, ou cerca de 50 trajetórias humanas, o sistema aprende seis tarefas reais de manipulação fina, incluindo abrir potes de condimentos e inserir baterias. Algumas tarefas alcançam 80–90% de sucesso.
Trabalhos Relacionados
Esta seção revisa abordagens anteriores de clonagem comportamental e suas limitações. Leia-a para contexto; ela é opcional para os objetivos práticos de aprendizado deste guia.
ALOHA: Um Sistema de Teleoperação Bimanual de Baixo Custo
Objetivos de Projeto e Hardware
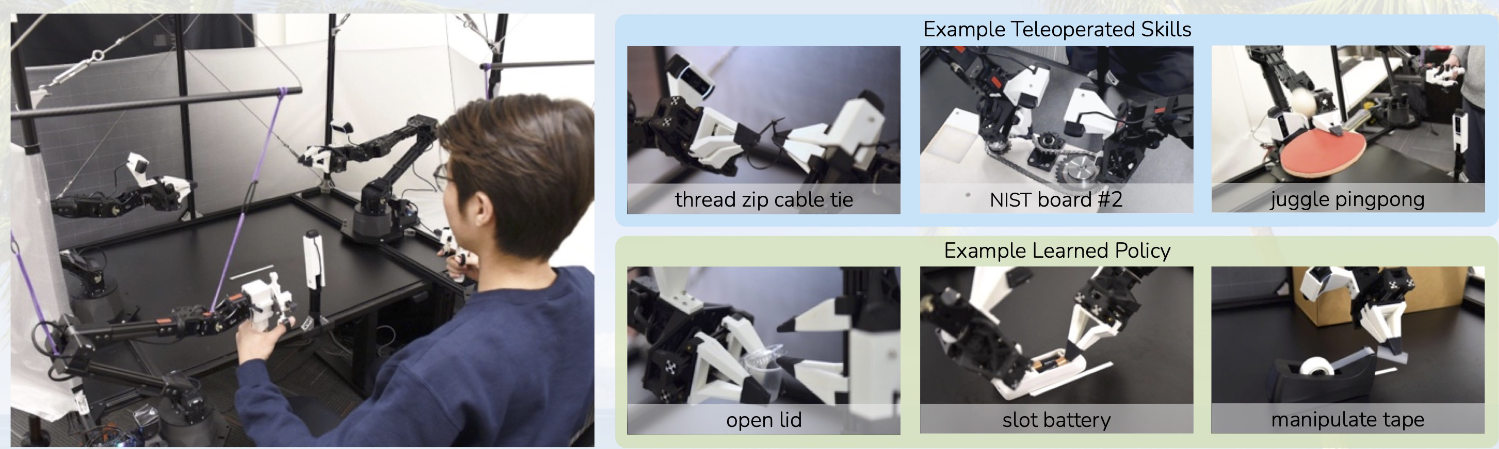
Os autores definem cinco princípios de projeto para dar suporte à manipulação fina enquanto reduzem a barreira de reprodução em laboratórios comuns.
ALOHA usa dois braços ViperX 6-DoF como robôs seguidores, em vez de braços industriais caros. Cada ViperX custa cerca de US$5.600 e tem precisão de posicionamento de aproximadamente 5–8 mm.
Teleoperação Líder–Seguidor
Uma escolha central de projeto é a teleoperação líder–seguidor. O operador move o líder com a mão, enquanto o seguidor ViperX acompanha seu movimento articular.
Mover o líder → Ler seus ângulos de junta → Mover o seguidor de forma síncrona → Executar a tarefa.
Isso é um mapeamento no espaço de juntas, com várias vantagens:
-
Nenhum cálculo frequente de cinemática inversa.
-
Comportamento mais estável próximo a singularidades cinemáticas.
-
Menor latência de controle.
-
Um mapeamento direto do movimento do operador para o robô.
Câmeras, Coleta de Dados e Capacidades
ALOHA registra as demonstrações usando quatro câmeras RGB comuns:
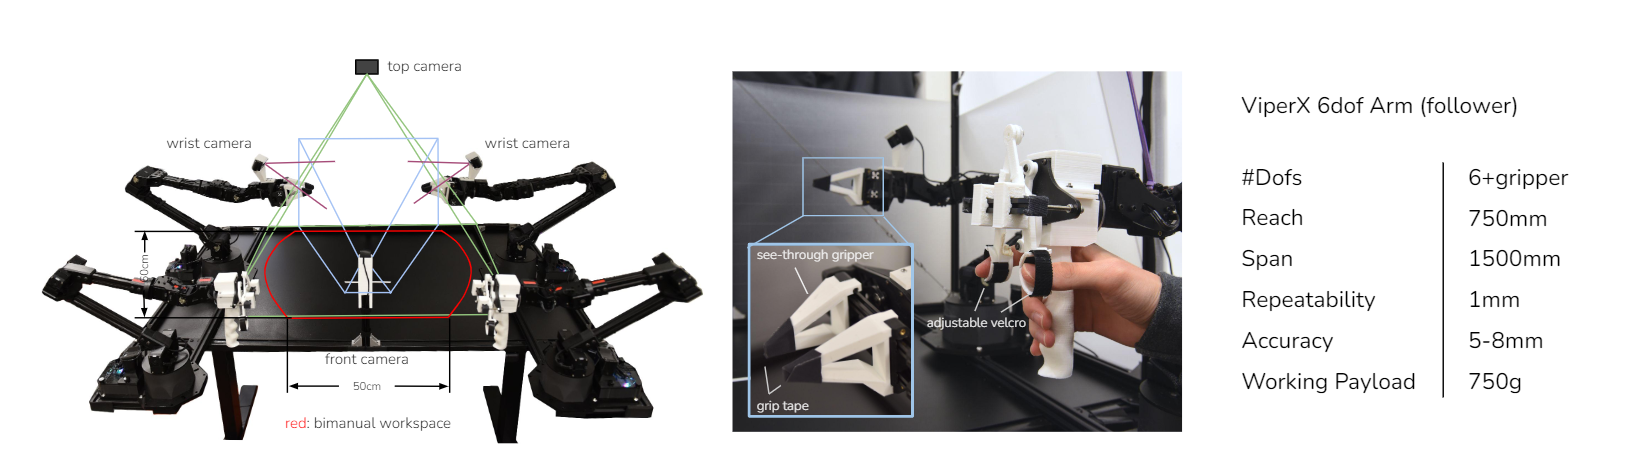
Os autores agrupam amplamente as tarefas em três categorias:
Action Chunking e Temporal Ensembling
Action Chunking: Prever uma Sequência Curta
O aprendizado por imitação convencional prevê uma próxima ação a partir do estado atual: mover um pouco para frente, depois um pouco para baixo. Um pequeno erro pode mudar a próxima observação e se acumular até a falha da tarefa. Action chunking é a resposta central do ACT para esse problema.
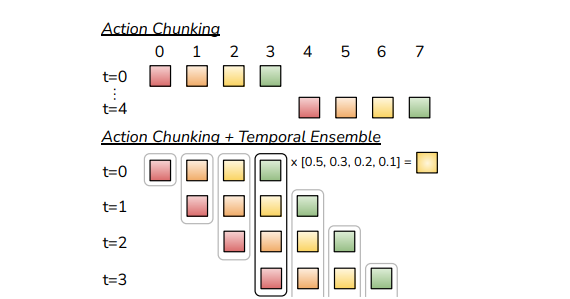
Prever uma sequência contínua futura em vez de uma única ação. Com chunk_size = 4, uma política de passo único toma decisões em t=0→a0, t=1→a1, t=2→a2, t=3→a3; o ACT prevê [a0,a1,a2,a3] em t=0. Essa sequência é um chunk de ações. A política muda de πθ(at|st) para πθ(at:t+k|st), onde k é o comprimento do chunk.
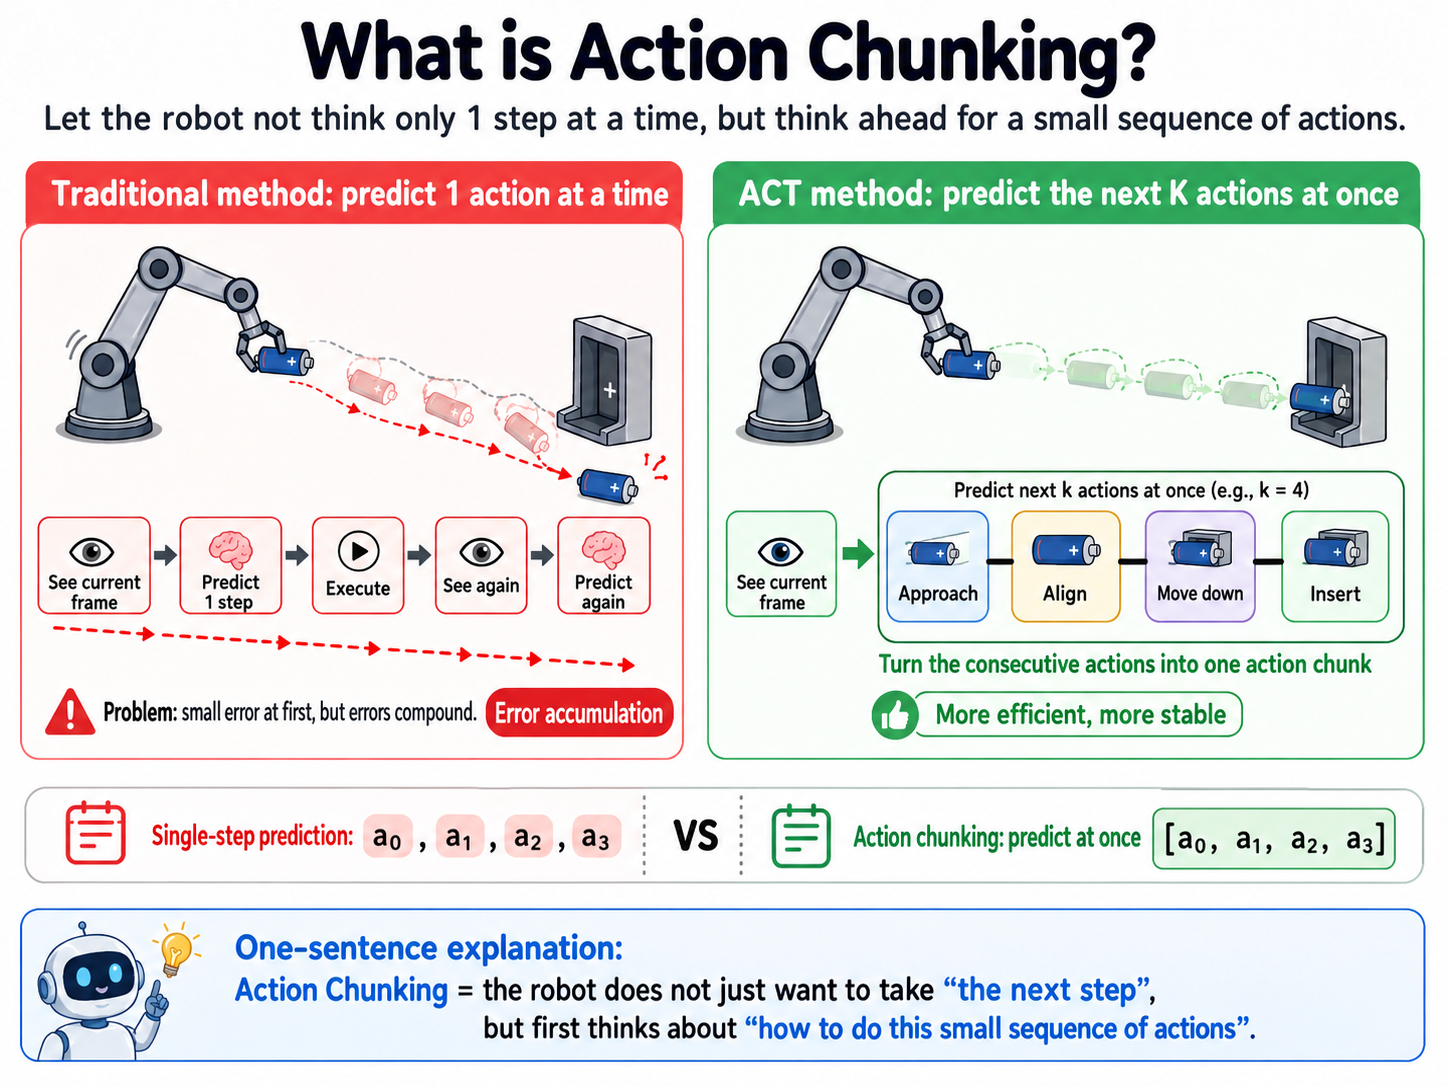
A intuição é considerar uma sequência curta em vez de improvisar a cada instante. Ao inserir uma bateria, as pessoas naturalmente organizam “aproximar → alinhar → inserir” como um movimento coerente em vez de uma longa lista de correções de um milímetro. O chunking ensina essa estrutura ao robô.
Ele também reduz o horizonte efetivo por um fator k. Uma tarefa de 100 passos de tempo exige 100 decisões de passo único; com chunk_size=10, ela pode ser considerada como menos segmentos contínuos. Olhar vários passos à frente torna um pequeno erro isolado menos propenso a descarrilar imediatamente o restante da sequência.
Demonstrações humanas também incluem pausas, hesitação e mudanças de velocidade. Aprender “aproximar → pausar → ajustar → inserir” como uma sequência torna essas relações mais fáceis de representar do que aprender instantes isolados.
https://github\.com/huggingface/lerobot/blob/main/src/lerobot/policies/act/modeling\_act\.py
Temporal Ensembling
ACT prevê uma sequência futura curta, mas o que acontece se o ambiente mudar enquanto ela está sendo executada?
Com temporal ensembling, o ACT observa e prevê um novo chunk a cada passo de tempo, em vez de executar cegamente um chunk inteiro. Para chunk_size = 4, as previsões podem ser assim:
t=0 → [a0, a1, a2, a3]
t=1 → [a1', a2', a3', a4']
t=2 → [a2'', a3'', a4'', a5'']
O mesmo instante futuro, portanto, recebe múltiplas previsões. Em t=2, por exemplo:
a2, prevista em t=0.
a2', prevista em t=1.
a2'', prevista em t=2.
Em vez de selecionar apenas uma, o ACT faz uma combinação ponderada de previsões para o mesmo passo de tempo para obter a ação executada. Isso é o temporal ensembling.
O modelo revisita a mesma ação futura em momentos diferentes usando observações diferentes e então combina essas estimativas.
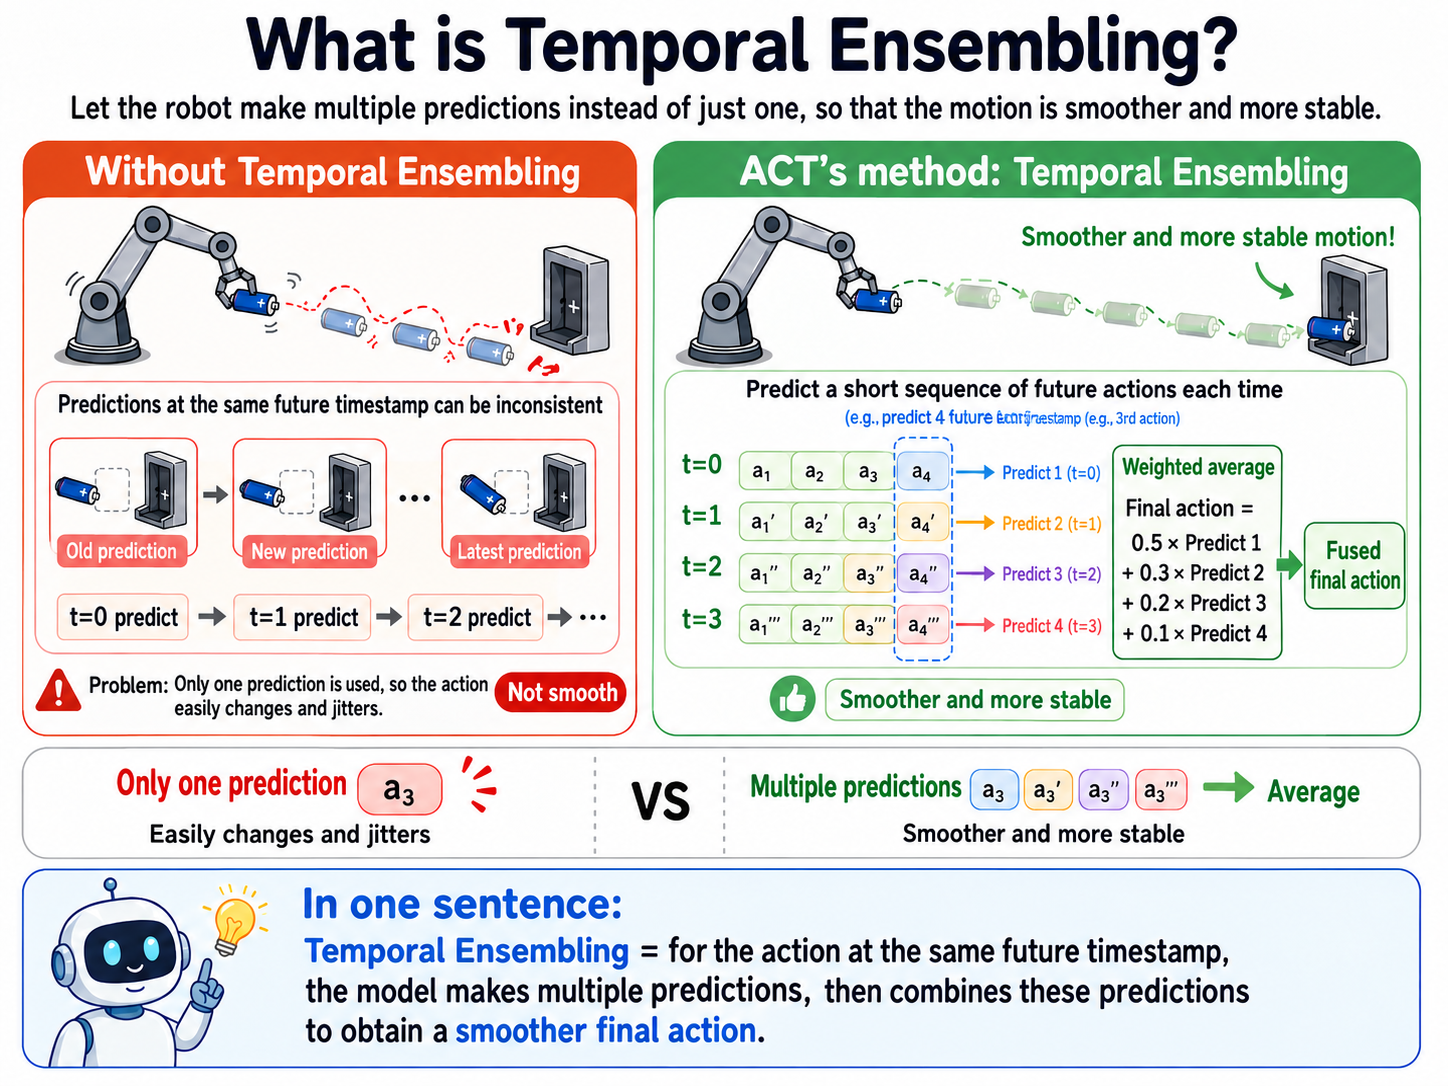
Seguir apenas a previsão mais recente pode causar saltos bruscos. A média ponderada suaviza a execução. Ela aborda principalmente dois problemas:
O artigo usa pesos exponenciais:
Action chunking olha vários passos à frente. O temporal ensembling observa e prevê repetidamente e então combina suavemente estimativas sobrepostas.
Modelando Demonstrações Humanas com um CVAE
Action chunking prevê uma sequência e o temporal ensembling suaviza a execução, mas outro problema permanece: demonstrações humanas não são idênticas.
Ao inserir uma bateria, diferentes operadores podem:
-
Se aproximar por ângulos diferentes.
-
Se mover em velocidades diferentes.
-
Ajustar para a esquerda antes de inserir.
-
Alinhar diretamente e inserir.
Mesmo a mesma pessoa produz trajetórias diferentes em tentativas repetidas. Uma dada observação, portanto, não tem apenas uma sequência de ações correta. Assumir que
“Esta imagem deve produzir exatamente uma trajetória de ação”
pode incentivar a média entre estratégias distintas. Considere duas demonstrações:
Demonstration A: go around the left → insert
Demonstration B: go around the right → insert
Uma média simples poderia se tornar:
Go straight through the middle
Mas pode haver um obstáculo no meio.
O objetivo é aprender:
Quais sequências de ações razoáveis uma pessoa poderia usar no estado atual.
Isso motiva o autoencoder variacional condicional (CVAE).
Como o CVAE Funciona no ACT
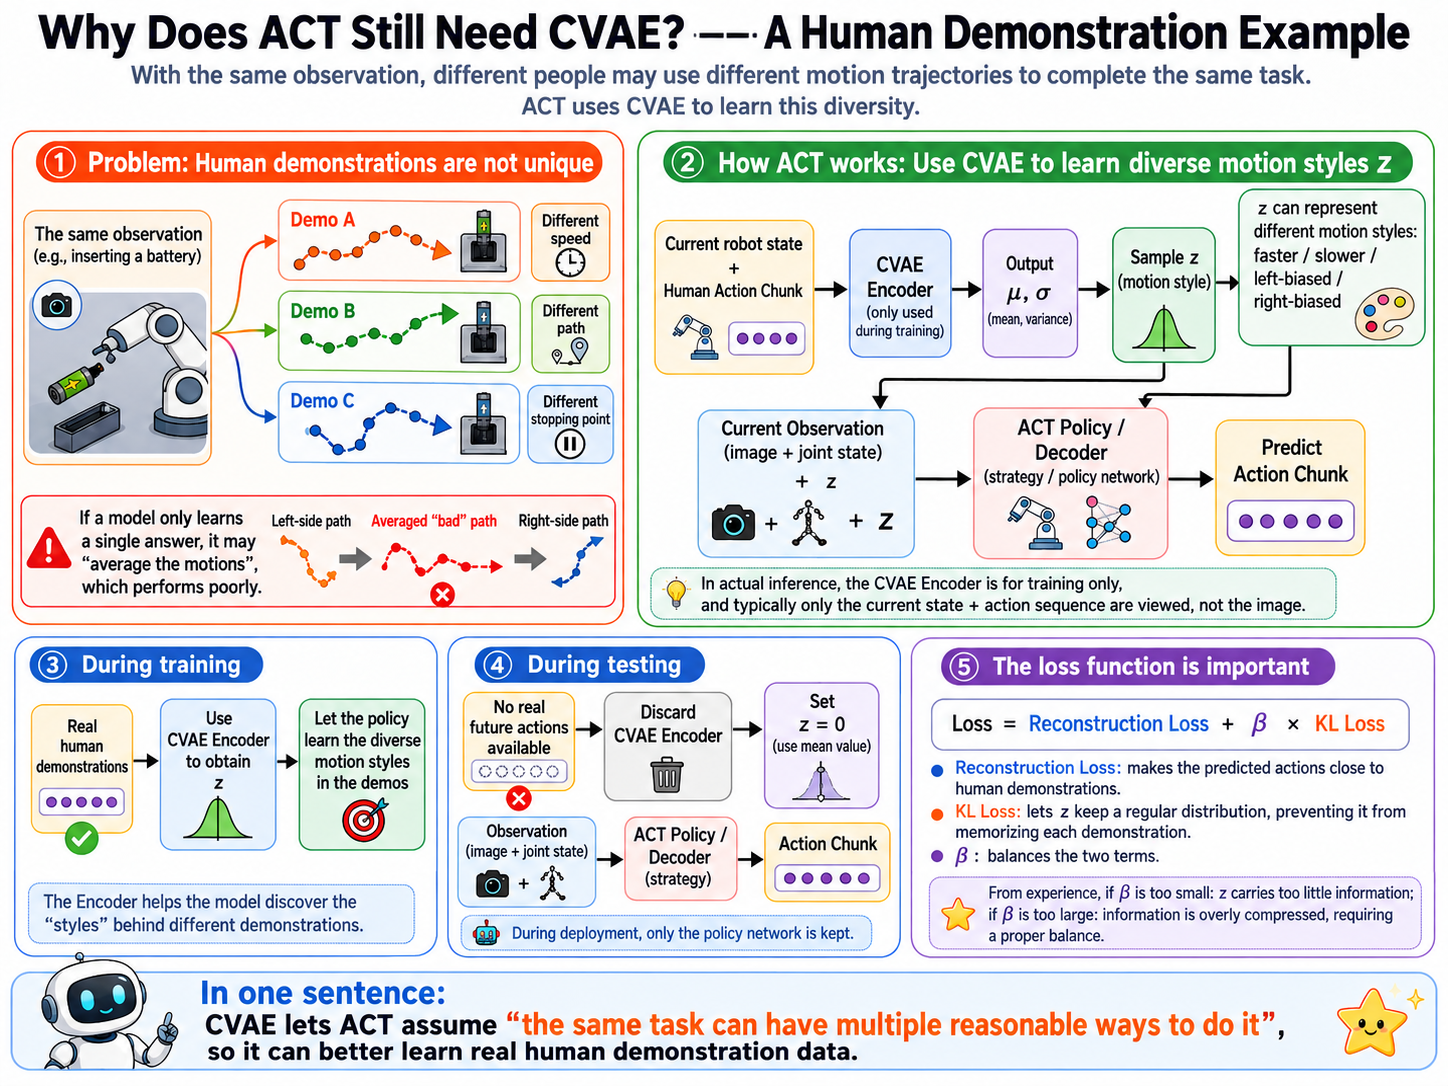
O CVAE tem dois componentes principais:
O codificador usa:
-
O estado atual do robô.
-
A sequência de ações demonstrada.
Ele infere um “estilo de movimento” latente. Em vez de produzir um único fixo, ele prevê parâmetros de distribuição Gaussiana :
-
Uma média.
-
Variância.
A amostragem de a partir dessa distribuição permite que o modelo represente incerteza sobre o estilo da demonstração em vez de atribuir um valor rígido. Essa é uma ideia central de VAEs.
Em princípio, o codificador de CVAE em tempo de treinamento poderia receber:
Image + Robot State + Action Sequence
Para um treinamento mais rápido, os autores omitem imagens do codificador do CVAE.
Suas entradas reais são:
Robot State + Action Sequence
        ↓
   CVAE Encoder
As imagens ainda entram na política ACT que prevê ações. Assim:
O codificador do CVAE extrai o estilo da demonstração; a política de previsão de ações ainda usa imagens de câmera para decidir o que o robô deve fazer.
A Rede ACT Completa
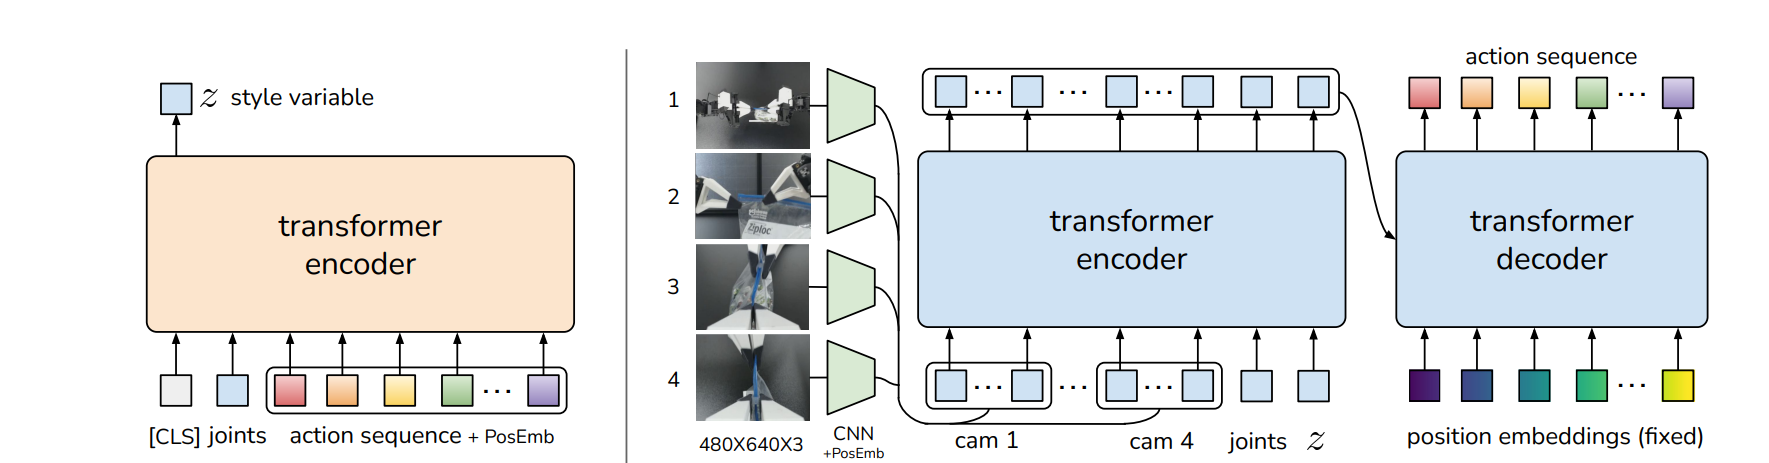
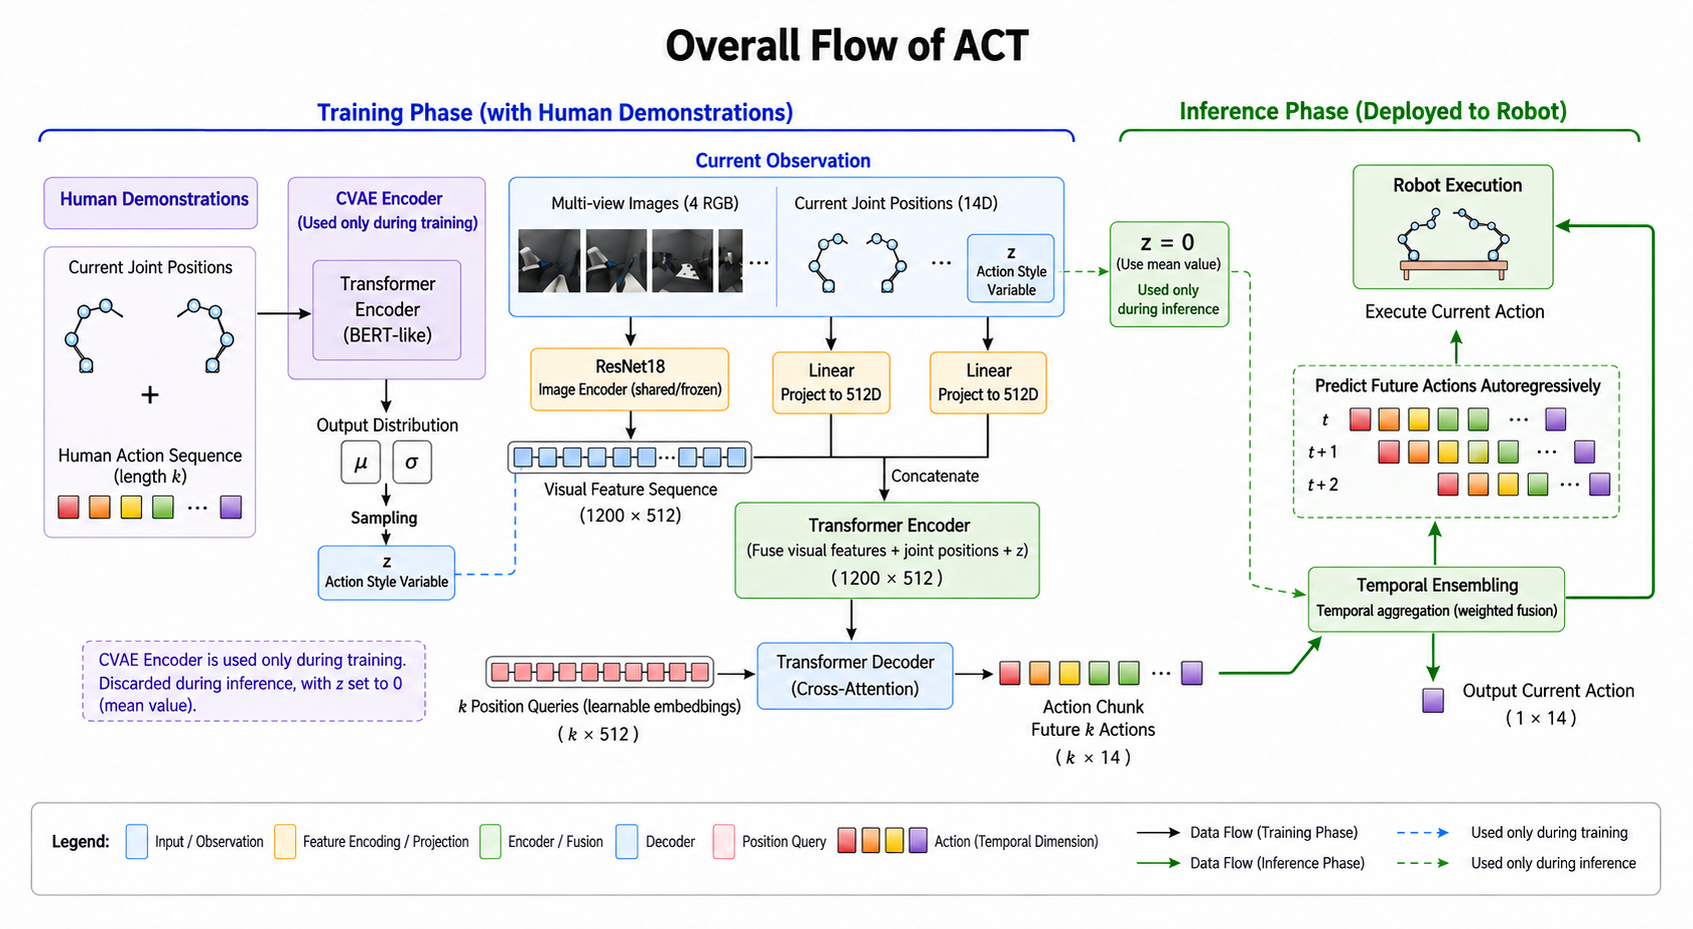
As posições das juntas e o trecho de ação demonstrado primeiro entram no codificador CVAE para representar diferenças no estilo da demonstração, produzindo os parâmetros Gaussianos e uma variável latente de estilo . Esse codificador processa estados das juntas e sequências de ações em vez de imagens de câmera.
Alimentar imagens RGB brutas de em um Transformer seria caro. ResNet18 primeiro converte cada imagem da câmera em um mapa de características de , achatado em uma sequência de características de . As quatro câmeras do ALOHA, portanto, geram tokens visuais.
O modelo projeta separadamente a posição articular de 14 dimensões e o estilo latente em 512 dimensões e as concatena com as características visuais. O codificador Transformer recebe:
1200+1+1=1202
Isso resulta em uma sequência de . O codificador funde três tipos de informação: o que o robô vê, sua configuração atual e o estilo de movimento da demonstração.
Um decodificador Transformer então usa consultas posicionais, uma para cada passo de tempo futuro. A atenção cruzada recupera informações do ambiente a partir da saída do codificador e prediz todas as ações juntas. Os dois braços do ALOHA têm, no total, 14 dimensões controladas de juntas/garra, resultando em:
Para chunk_size = 100, uma inferência prediz 100 passos de tempo × 14 posições de juntas: o trecho de ação completo.
O treinamento compara os trechos previstos com as demonstrações humanas usando uma perda de reconstrução L1, além de uma perda KL do CVAE que regulariza a distribuição latente.
Na implantação não há trecho de ação futura demonstrada, então o codificador CVAE é removido e . Imagens e posições atuais das juntas geram novos trechos; o agrupamento temporal combina previsões sobrepostas, e a ação atual é enviada ao robô.
O fluxo completo é:
Treinamento: demonstração → CVAE aprende → imagens + juntas + → Transformer → trecho de ação
Inferência: imagens + juntas + → Transformer → trecho de ação → agrupamento temporal → robô
Lembre-se dos papéis separadamente:
A segmentação de ações determina quantas ações futuras são previstas juntas; o agrupamento temporal suaviza a execução; o CVAE modela o fato de que várias demonstrações podem ser válidas para a mesma tarefa.
O pipeline do ACT agora se encaixa: