DM0.5: Historical Context and Trajectory Alignment for the Open World
DM0.5: Um Modelo Fundamental de Mundo Aberto para Inteligência Incorporada de Propósito Geral
- Contexto histórico
- Raciocínio incorporado
- Alinhamento de trajetória
- Ações contínuas
Um robô recebe a instrução: “Pegue a xícara, limpe a mesa embaixo dela e coloque a xícara de volta.” Depois que a xícara se move, a imagem atual pode não mostrar mais onde ela começou. Segurar a xícara parece semelhante antes e depois de limpar, mas a próxima ação é diferente. Pausas e mudanças no ritmo do demonstrador também complicam o aprendizado de ações.
DM0.5 resolve esses problemas usando contexto histórico, aprendendo o progresso da tarefa e alinhando trajetórias de demonstração. Este artigo usa o blog técnico oficial da Dexmal e a implementação pública para explicar os três mecanismos.
Arquitetura do Modelo: Do Entendimento da Cena à Geração de Ações
Um modelo visão-linguagem-ação (VLA) transforma imagens, instruções e estado do robô em ações de controle. DM0.5 usa um VLM (Vision-Language Model) de 4B e um Action Expert de 680M. O VLM representa a cena e a tarefa, e o Action Expert gera ações contínuas do robô.
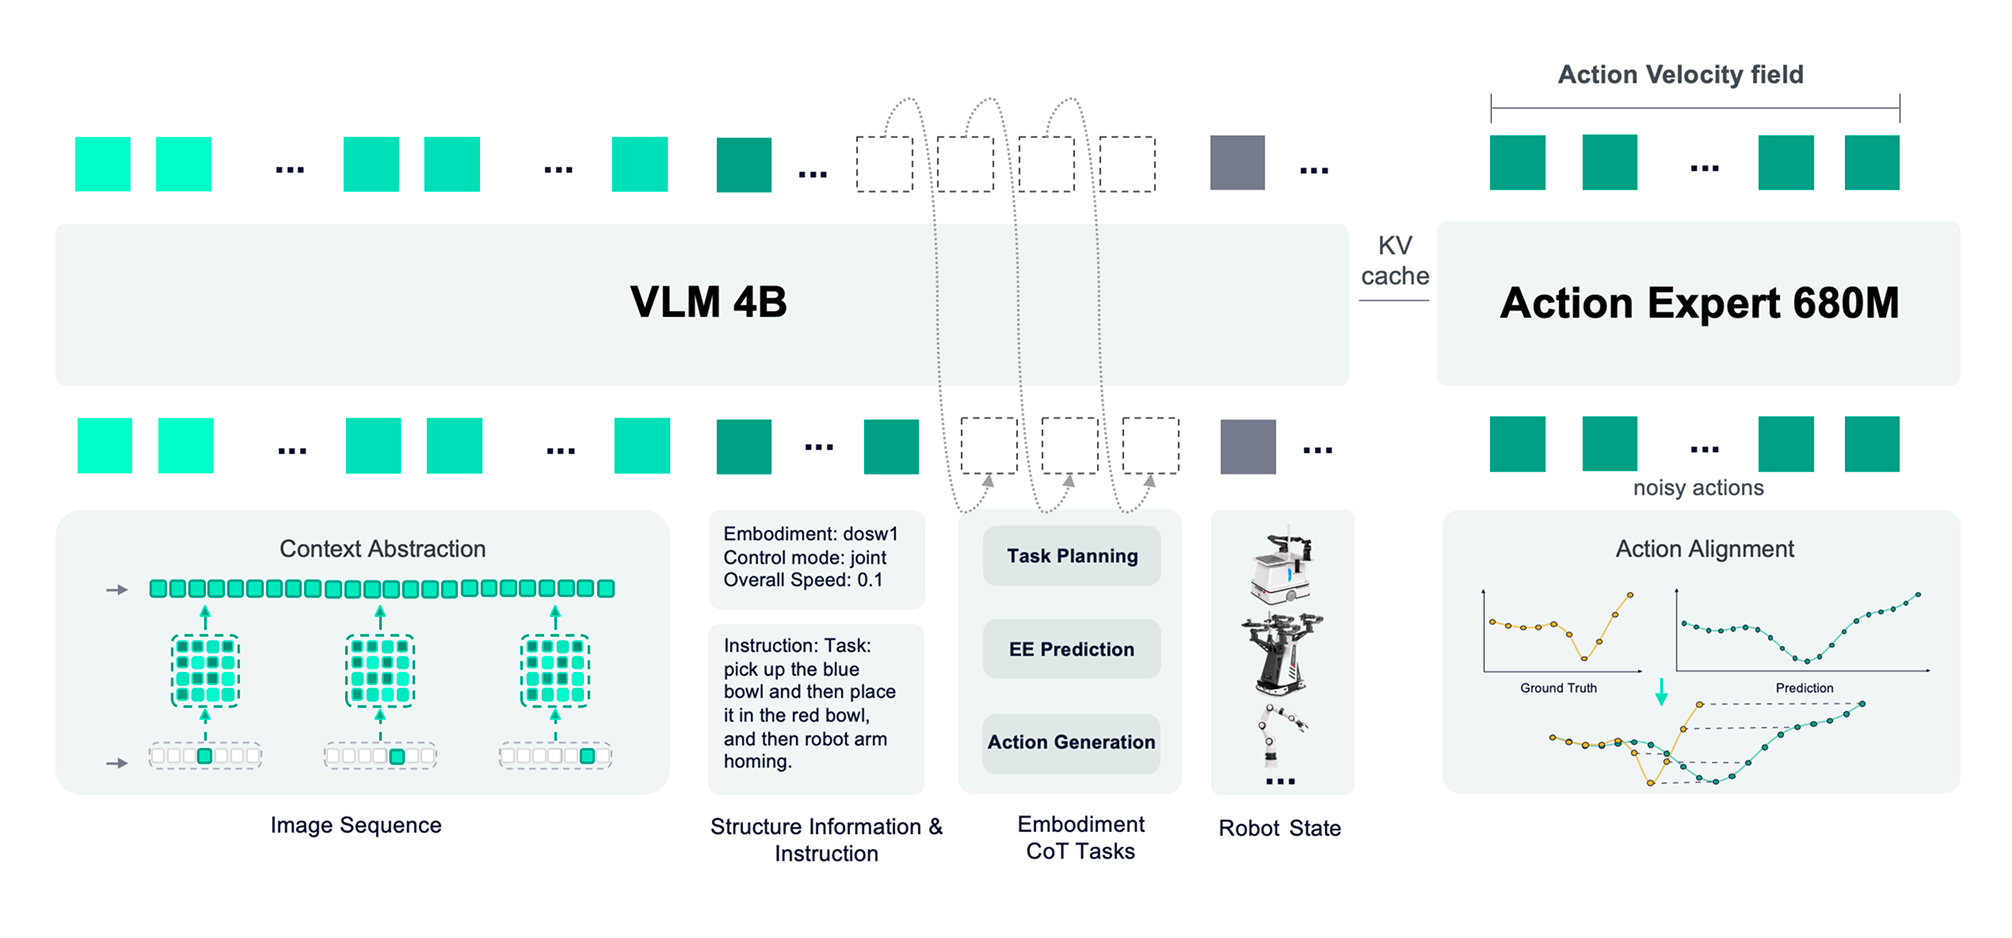
Fonte: seção Model do blog oficial. Compressão de histórico, raciocínio incorporado e alinhamento de trajetória melhoram as entradas e a supervisão de treinamento.
Quando chega a hora de devolver a xícara, quadros históricos mostram onde ela começou, a imagem atual mostra a xícara e a mesa como estão agora, e a instrução especifica para onde a xícara deve ir. O VLM codifica essas entradas como condições de ação. O Action Expert lê essas condições e gera uma sequência de movimentos para carregar e posicionar a xícara.
O modelo prevê uma sequência de ações futuras chamada de action chunk. O cache KV na figura da arquitetura reutiliza computação para entradas de imagem e texto. O histórico da tarefa tem um propósito diferente: ele fornece observações passadas reais para o modelo.
Camada de Abstração de Contexto: Fusão de Contexto Histórico
Para colocar a xícara de volta, o modelo precisa tanto de uma visão de antes de a xícara ser pega quanto da visão atual. Alimentar um vídeo longo diretamente aumentaria o custo computacional.
A Camada de Abstração de Contexto do DM0.5 amostra quadros do passado e comprime cada slot histórico em um número fixo de tokens visuais. O modelo processa esses tokens junto com as observações atuais. Na implementação pública de memória, o average pooling bidimensional reduz o tamanho espacial da grade de recursos visuais.
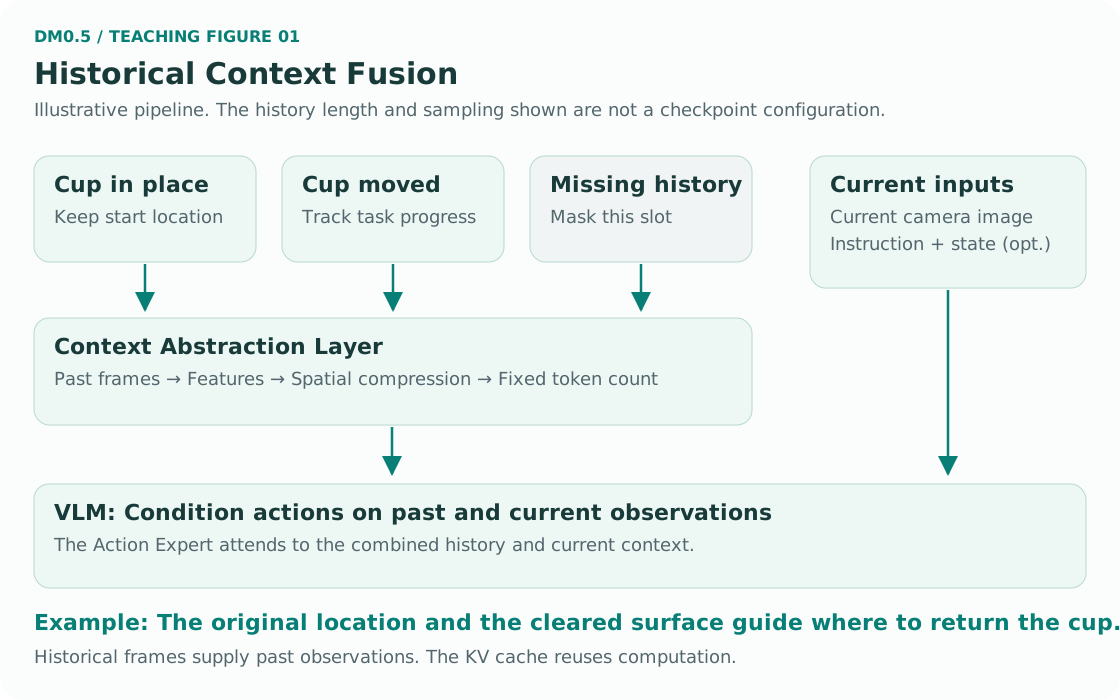
Ilustração: o histórico vem apenas de antes do timestep atual. O slot cinza representa histórico ausente.
O blog relata suporte para até cerca de 60 segundos de histórico da tarefa. Se o modelo consegue recuperar a localização original da xícara depende de quais quadros foram amostrados e de quanta informação espacial sobrevive à compressão. Amostrar um quadro por segundo, por exemplo, pode perder um detalhe que esteve visível apenas brevemente.
O checkpoint e o pipeline de entrada também precisam oferecer suporte a histórico. A integração padrão do LeRobot revisada aqui não expõe a entrada separada de imagem histórica do OpenDM. As opções do LIBERO acima não podem testar diretamente a capacidade de memória do modelo.
Tarefas Embodiment CoT: Raciocínio Incorporado Amplo
Rótulos de ação dizem ao modelo como se mover em um dado momento. Eles não necessariamente identificam o que já foi feito ou o que deve acontecer em seguida. DM0.5 adiciona 11 tarefas autoregressivas ao treinamento em dados de robô. Prever respostas em texto token por token fornece supervisão extra para estágios da tarefa, eventos e intenção de ação.
O blog oficial agrupa essas Tarefas Embodiment CoT em três categorias:
| Categoria | O que o modelo aprende | Exemplo de ensino: limpar a mesa |
|---|---|---|
| Planejamento de Tarefas | Estágio atual da tarefa e próximos passos | A xícara foi movida; limpe a mesa em seguida. |
| Predição de Eventos e Ambiente | Mudanças na cena e eventos-chave | A área deve estar limpa após a limpeza. |
| Geração de Ações | Ações futuras ou um resumo da intenção de ação | Devolva a xícara à sua localização anterior. |
Esses exemplos ilustram a supervisão; eles não são amostras de treinamento publicadas. O histórico fornece evidências do que aconteceu, e a supervisão semântica ajuda o modelo a conectar essas mudanças ao progresso da tarefa e à seleção de ações. Este é um objetivo de treinamento. Ele não exige que o modelo produza um traço de raciocínio legível antes de cada ação.
Camada de Alinhamento de Trajetória: Correspondência Dinâmica de Ações
Dois operadores demonstram a mesma sequência: aproximar, fazer contato, assegurar a preensão e então erguer. Um deles faz uma pausa de meio segundo antes do contato. Se os alvos forem pareados em deslocamentos de tempo fixos, o mesmo slot de predição pode acabar supervisionando estágios diferentes do movimento.
A Camada de Alinhamento de Trajetória do DM0.5 associa uma predição de ação de comprimento fixo a pontos âncora em uma trajetória de ground truth mais densa. As correspondências devem preservar a ordem temporal. Programação dinâmica encontra uma sequência de correspondências com menor custo geral.
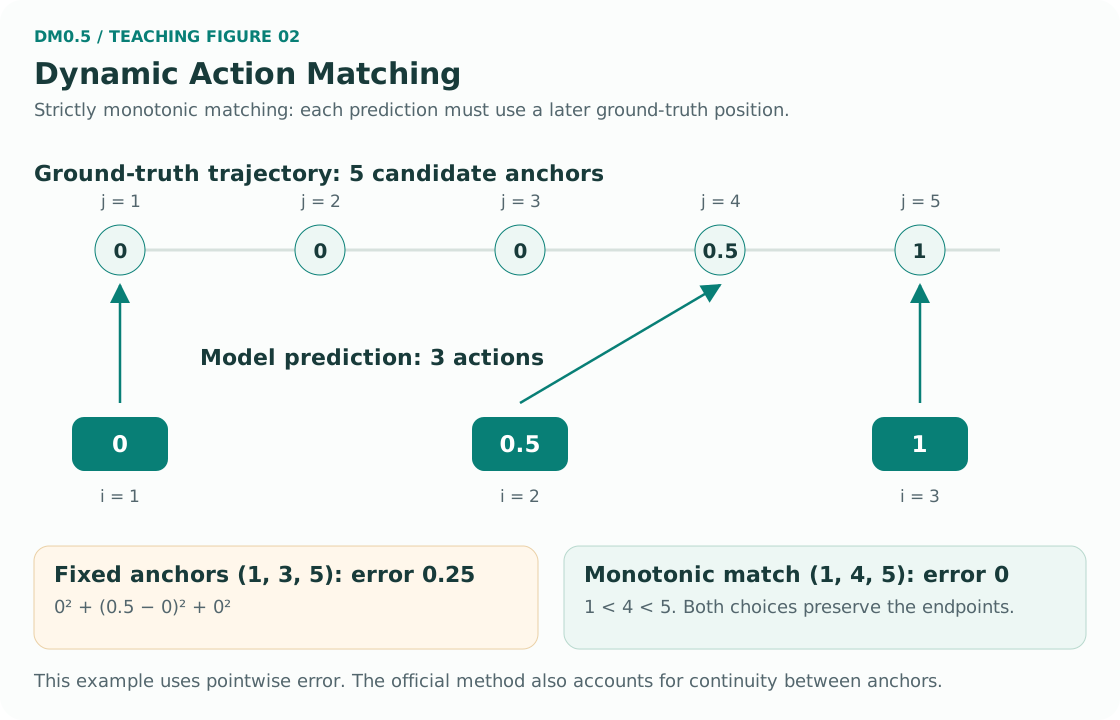
Ilustração: os números representam um componente de ação normalizado. O custo simplificado inclui apenas erro ponto a ponto.
Considere uma trajetória de ground truth de [0, 0, 0, 0.5, 1] e uma predição de [0, 0.5, 1]. Se âncoras igualmente espaçadas forem fixadas nas posições 1, 3 e 5, os alvos são [0, 0, 1], resultando em um erro quadrático de 0² + (0.5 − 0)² + 0² = 0.25. Uma correspondência monótona nas posições 1, 4 e 5 dá um erro de 0. Ambas as escolhas preservam o início e o fim da trajetória. A diferença é se a predição do meio é pareada com o movimento após a pausa. As âncoras fixas são uma comparação didática, não a receita oficial de treinamento.
A correspondência apenas pelo menor erro pontual pode ignorar uma etapa de contato importante. O blog, portanto, descreve uma restrição de continuidade de trajetória entre âncoras, mas não fornece sua fórmula completa. O exemplo ilustra o pareamento monótono. O alinhamento muda quais ações supervisionam o modelo durante o treinamento; o controlador ainda determina o tempo das ações durante a implantação.
Geração Contínua de Ações com Flow Matching
Observações históricas e instruções condicionam o modelo, e o alinhamento de trajetória associa previsões à supervisão. O Action Expert gera ações numéricas com Flow Matching.
A implementação pública padrão de fine-tuning supervisionado (SFT) mistura o bloco de ação ground-truth A com ruído Gaussiano ε de mesma forma:
A variável s varia de 0 a 1, interpolando da ação para o ruído. O Action Expert recebe as ações ruidosas, s, e as condições de imagem e linguagem, depois aprende a prever a direção de atualização U. Para um valor de ação de 0.6, ruído −0.2 e s=0.5, o valor misturado é 0.2 e a direção alvo é −0.8.
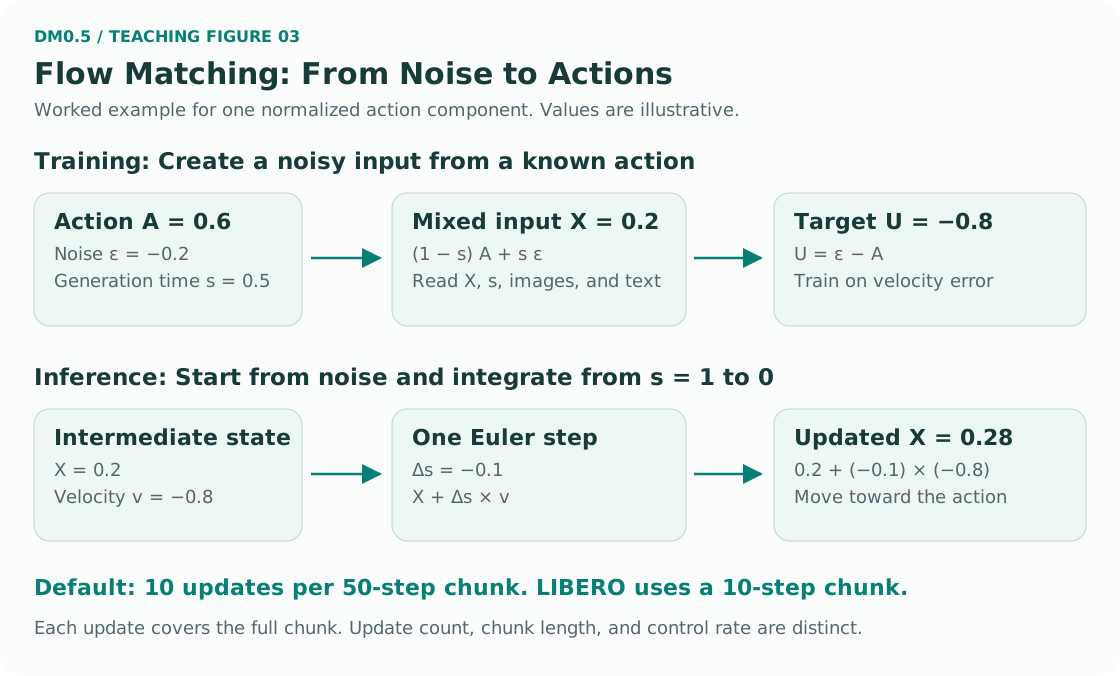
Ilustração: as etapas internas de geração são distintas das posições de controle em um bloco de ações.
Na inferência, o modelo começa a partir de ruído e diminui s de 1 para 0. Continuando o exemplo, em 0.2 com direção prevista −0.8, um passo de −0.1 produz 0.28, mais próximo do valor de ação 0.6. As ações geradas são desnormalizadas e passadas para o controlador. A próxima rodada usa uma nova observação.
O padrão do blog é 10 atualizações internas para gerar um bloco de ações de 50 passos. O número de ações executadas antes da próxima observação depende da receita de implantação. O SFT padrão do LeRobot usa a perda de Flow Matching; ele não reproduz automaticamente o conjunto completo de tarefas de raciocínio do blog nem o treinamento com alinhamento de trajetória.
Dados e Treinamento: O Que o Modelo Aprende
DM0.5 combina manipulação robótica, navegação incorporada, manipulação humana egocêntrica e dados gerais de imagem e vídeo. As trajetórias de robôs fornecem supervisão de ações, enquanto outras fontes ampliam a cobertura semântica, espacial e temporal. Vídeo humano não fornece diretamente alvos de juntas de robôs.
A limpeza de dados remove segmentos anômalos e longos períodos ociosos, verifica a sincronização entre imagens e ações e corrige rótulos de tarefas. Gravações confiáveis vêm primeiro. O alinhamento de trajetória pode então lidar com a variação no ritmo das demonstrações.
Durante o treinamento base, o VLM usa uma taxa de aprendizado menor para preservar as capacidades de imagem e linguagem, enquanto o Action Expert usa uma taxa de aprendizado maior para aprender controle. Os pesos base podem então ser adaptados a tarefas ou robôs específicos. Entradas de câmera, semântica de estados e ações e normalização precisam permanecer consistentes.
Experimentos: O Que os Resultados Sustentam
Generalização Zero-Shot
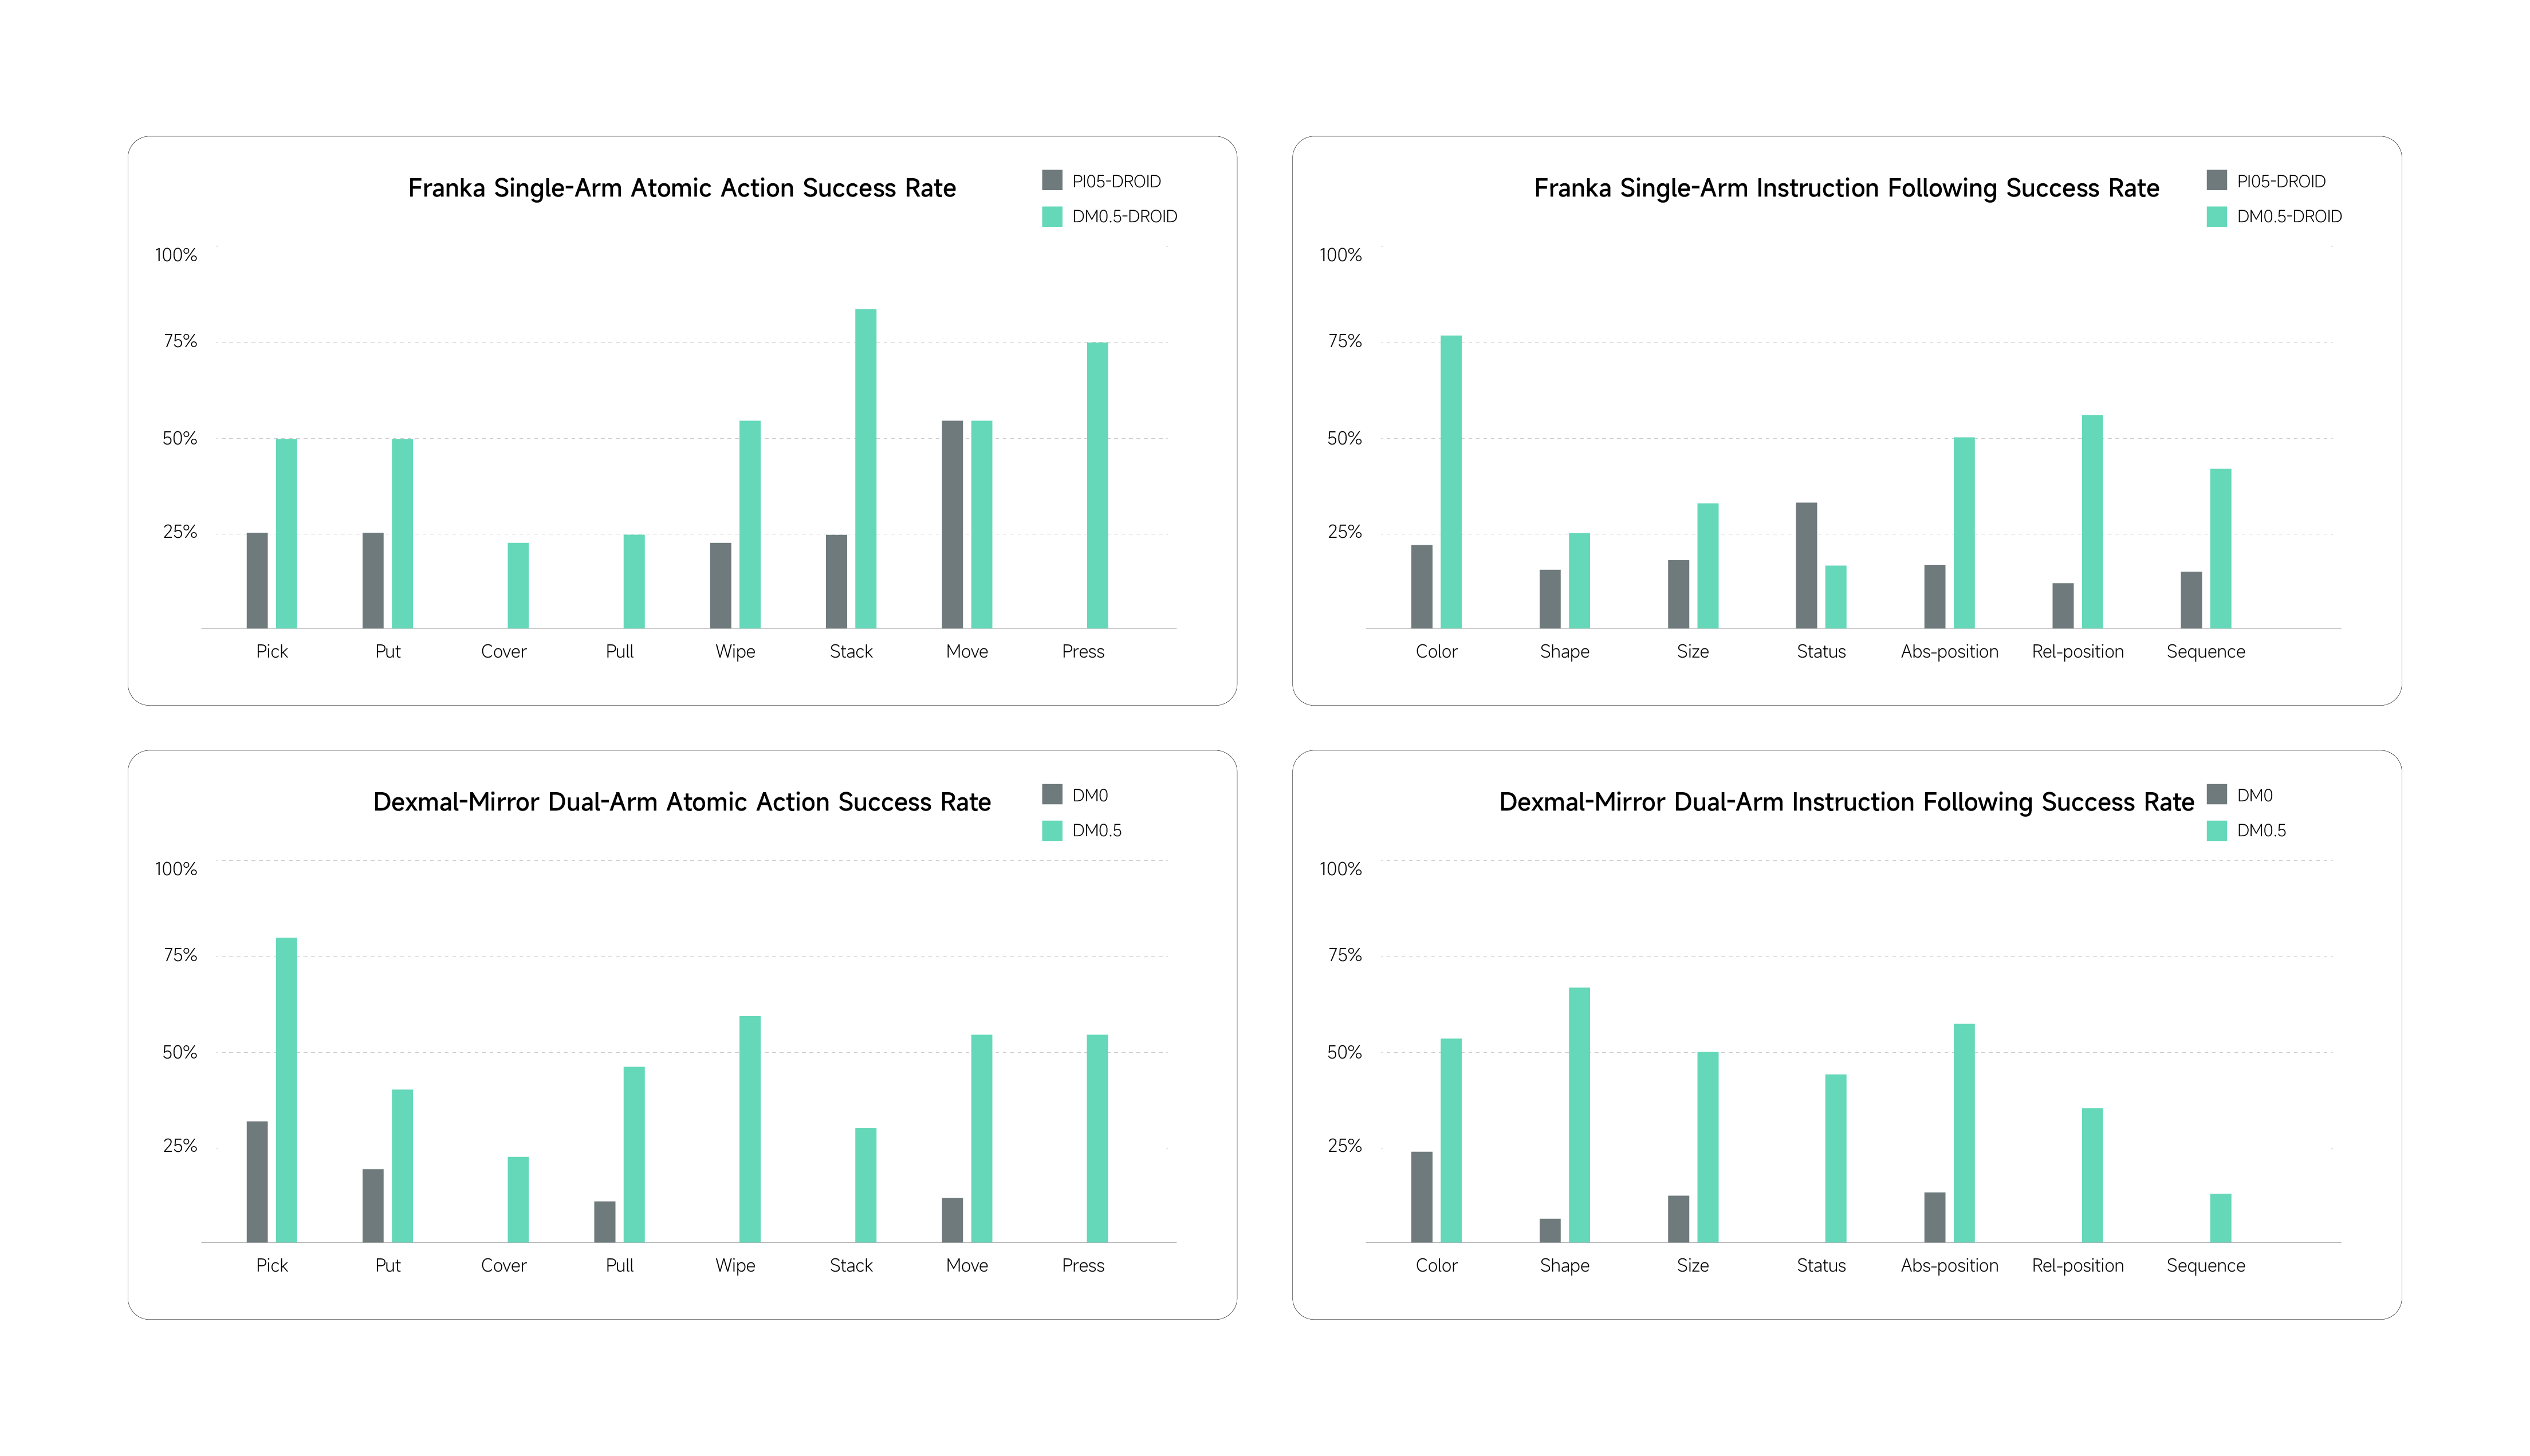
Fonte: Zero-Shot Generalization no blog oficial. A linha superior compara DM0.5-Droid e π0.5-Droid no Franka. A linha inferior compara DM0.5 e DM0 no Dexmal-Mirror. O eixo vertical mostra a taxa de sucesso.
DM0.5 tem desempenho melhor na maioria das categorias de ações e de restrições semânticas. No Franka, ele empata em “Move” e tem desempenho pior em restrições de “Status”. Os ganhos, portanto, se aplicam à maioria das condições testadas, e não a todas as instruções. As comparações devem permanecer dentro de cada plataforma. Aqui, zero-shot se refere a configurações de tarefas não vistas e ainda depende da experiência prévia de treinamento.
Capacidade de Fine-Tuning e Manipulação em Robôs Reais
LIBERO é um benchmark de simulação para manipulação com um único braço. Spatial, Object, Goal e Long enfatizam, respectivamente, relações espaciais, variação de objetos, objetivos de tarefas e sequências de longo horizonte. RoboTwin2.0 avalia manipulação com dois braços. Clean usa cenas mais simples; Randomized varia fundos, iluminação, desordem e outras condições ambientais para testar a execução sob randomização de domínio.
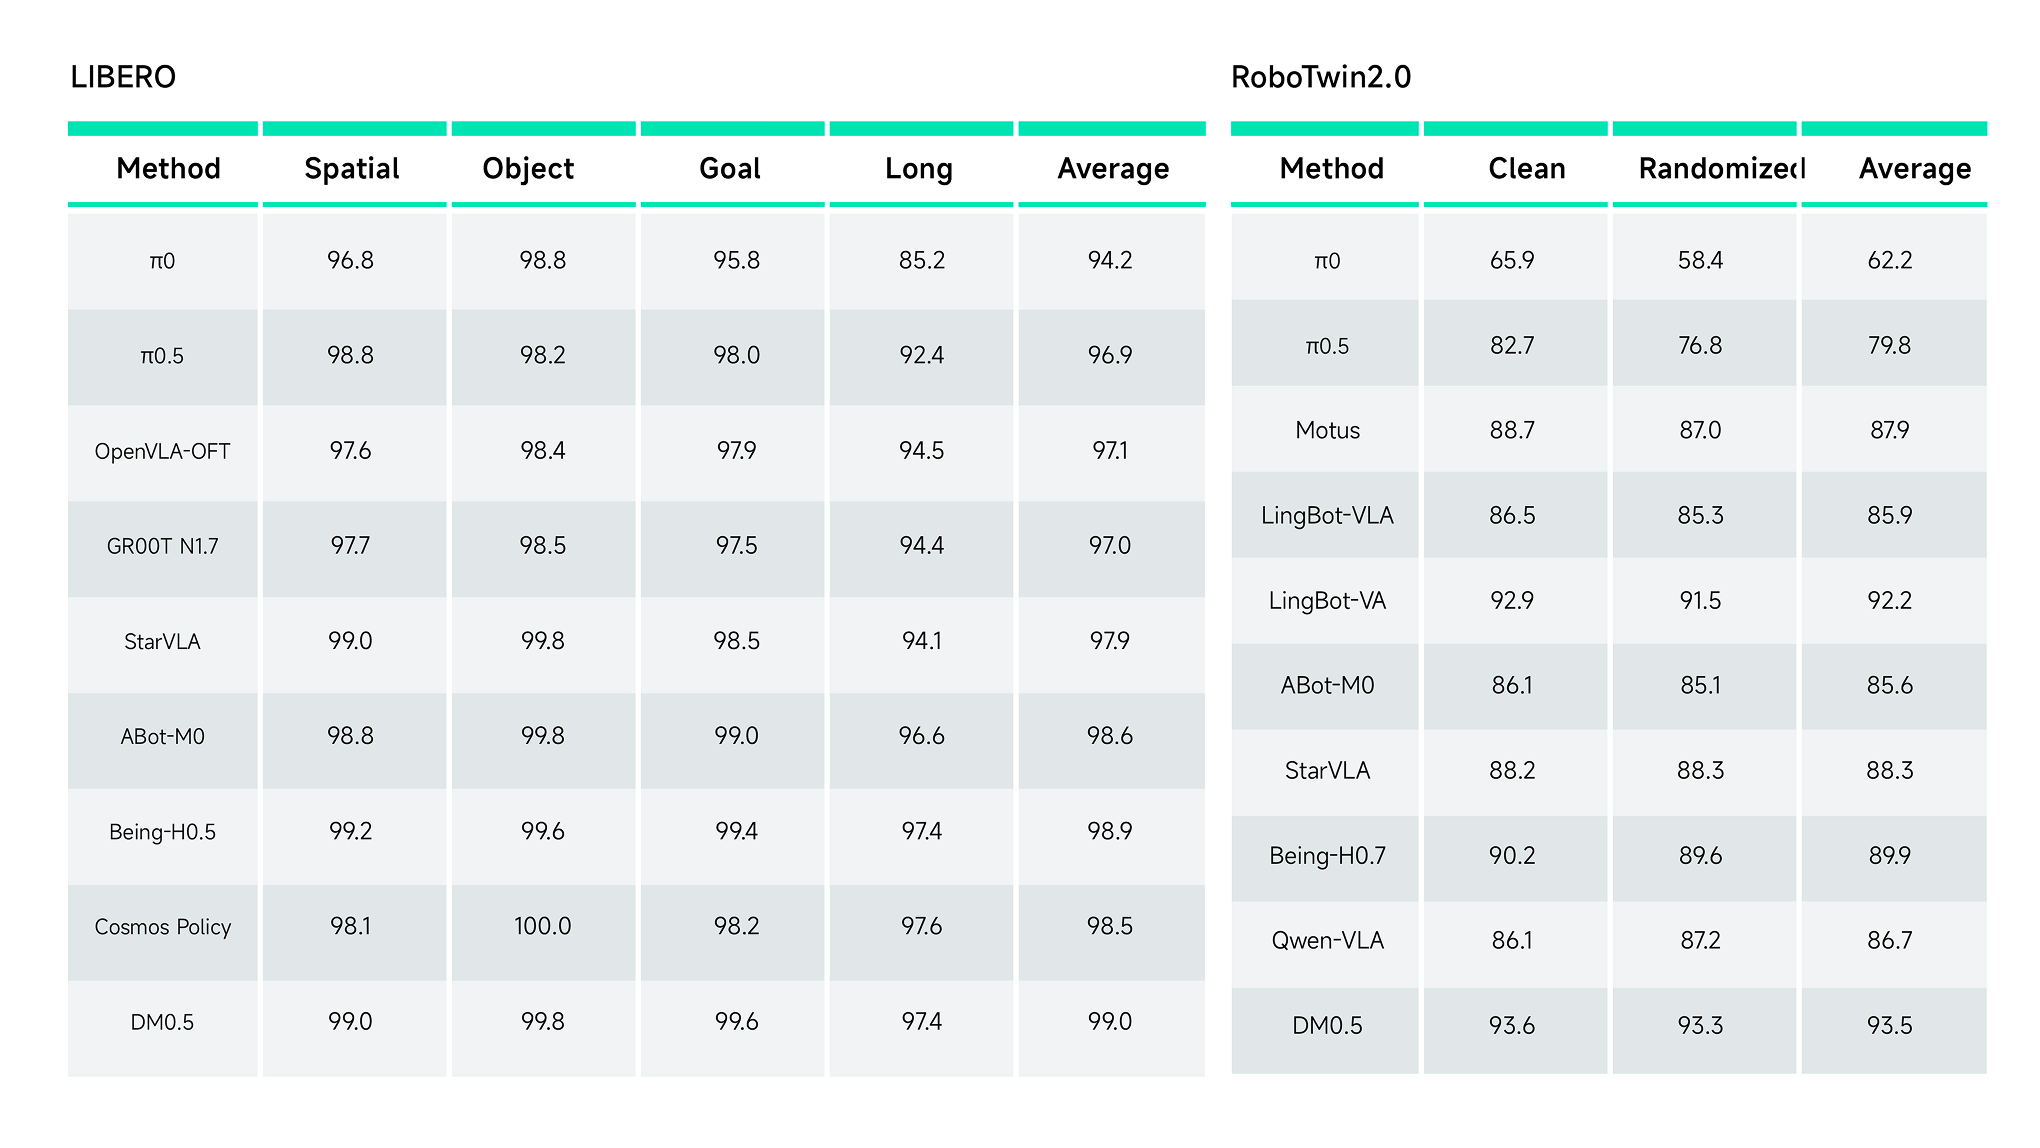
Fonte: Fine-Tuning Capability no blog oficial. As taxas de sucesso na tabela são porcentagens.
Nos quatro conjuntos LIBERO, DM0.5 tem média de 99,0% de sucesso contra 96,9% para π0.5 na mesma tabela. No RoboTwin2.0, DM0.5 alcança 93,6% em Clean e 93,3% em Randomized, em comparação com 82,7% e 76,8% para π0.5. Os resultados sustentam o DM0.5 como um forte ponto de partida para adaptação de tarefas.
No benchmark RoboChallenge Table30 v2 com robô real, os autores treinam uma política multitarefa para cada corpo avaliado. A taxa de sucesso na tarefa completa é de 43,0%, e a pontuação geral (Score) é 54,42. São métricas distintas. Altas pontuações em simulação não eliminam falhas no hardware.
Para memória, o blog mostra o robô devolvendo um copo à sua posição original e seguindo uma regra de posicionamento de bateria após assistir a uma pessoa demonstrá-la. Em testes de perturbação de câmera, a câmera de pulso permanece fixa enquanto duas câmeras externas variam em nove configurações. Há 10 tentativas por configuração, com taxas de sucesso de 80% a 100%. Perturbações humanas são mostradas principalmente por meio de demonstrações comportamentais.
Esses resultados descrevem o sistema completo. Eles não isolam as contribuições do contexto histórico, das tarefas de raciocínio e do alinhamento de trajetória. As demonstrações de memória e de perturbações humanas também carecem de controles quantitativos abrangentes, portanto não estabelecem confiabilidade em tarefas arbitrárias de longo horizonte ou sob perturbações.
Conclusão
Durante o treinamento, o raciocínio incorporado fornece supervisão semântica para o progresso da tarefa e a intenção da ação, enquanto o alinhamento de trajetória associa alvos de ação para reduzir o ruído de tempo das demonstrações. Durante a execução, observações históricas e atuais se combinam com a instrução para condicionar as ações contínuas do Action Expert.
Ao aplicar o DM0.5 ao seu robô, primeiro determine se a tarefa realmente depende de observações passadas. Em seguida, verifique se o checkpoint aceita essas observações e se a interface de ações corresponde ao seu hardware. Use comparações controladas na tarefa-alvo para julgar se o método ajuda.