EO-1: Como Unificar Raciocínio Incorporado e Controle de Robôs
EO-1: Um Modelo Fundamental Incorporado Aberto e Unificado para Controle Geral de Robôs
- Modelo unificado de IA física
- Aprendizado intercalado
- Raciocínio incorporado
- Controle de robôs
Pré-requisitos: Entradas e Saídas
Explicação: Aprendizado por imitação aprende como se mover a partir de operações humanas gravadas. Um VLA adiciona compreensão de linguagem e normalmente recebe imagens, texto de tarefa e estado do robô como entradas.
Para “colocar o tomate na sacola de compras”, imagens localizam os objetos, o estado descreve o braço, o texto define o objetivo e as ações controlam a preensão e a colocação. EO-1 também pode responder “o que vem depois?” e “já terminou?”, conectando julgamentos antes e depois das ações.
| Conceito | Significado aqui |
|---|---|
| Observação | Imagens multivisadas e estado do robô; imagens novas vêm das câmeras. |
| Estado | Valores de robô de baixa dimensão, como juntas; dimensões variam por plataforma. |
| Ação | Controles contínuos com significados físicos dependentes da plataforma e do dataset. |
| Bloco de ações | Múltiplas ações futuras previstas em conjunto; EO-1 usa 16 passos. |
| Raciocínio incorporado | Julgamentos sobre objetos, espaço, progresso e interação física. |
Predição de passo único é observação atual → aₜ; blocagem é observação atual → [aₜ, aₜ₊₁, …, aₜ₊₁₅]. Ilustração: uma dimensão de ação poderia ter [0.1, 0.12, 0.15]; as saídas reais do EO-1 são arrays multidimensionais de 16 passos.
Blocos de ações permitem que o modelo organize em conjunto um segmento de movimento, mas o comprimento do bloco não é o intervalo de chamadas do modelo. O artigo não fornece uma fração de execução compartilhada, taxa de replanejamento ou taxa de controle para cada plataforma, portanto o número de chamadas de modelo por segundo não pode ser inferido a partir do comprimento do bloco.
Resumo: Tradução e Comentários
Tradução
As pessoas alternam naturalmente raciocínio multimodal e interação física em mundo aberto. VLAs avançaram o controle generalista por meio de co-treinamento de robô e imagem-texto, mas ainda são menos flexíveis em conectar raciocínio com interação.
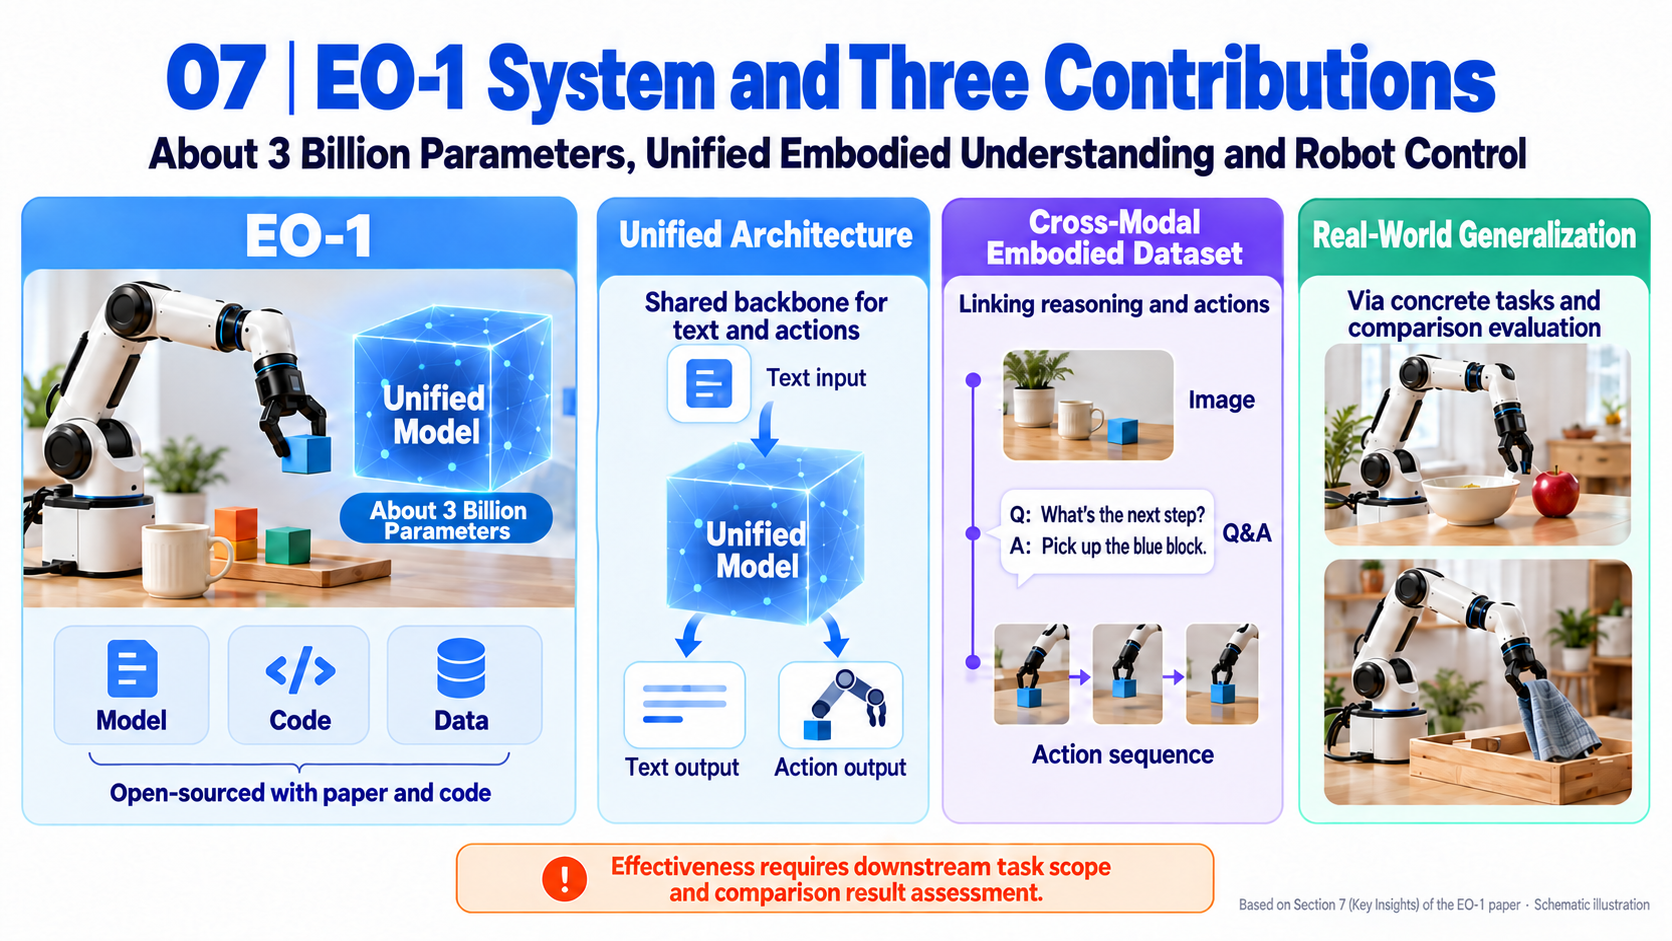
EO-Robotics é composto por EO-1 e EO-Data1.5M. EO-1 aprende raciocínio incorporado e controle por meio de pré-treinamento intercalado visão-texto-ação. Ele combina uma arquitetura que aceita imagens, texto, vídeo e ações com mais de 1,5 milhão de amostras de raciocínio incorporado de alta qualidade, enfatizando compreensão intercalada.
EO-1 é treinado em EO-Data1.5M usando decodificação autoregressiva e denoising por flow-matching para conectar geração de ações de robô com raciocínio incorporado multimodal. Experimentos extensivos em diferentes corpos de robô e tarefas de manipulação hábil de longo horizonte validam o aprendizado intercalado para compreensão e generalização em mundo aberto. O artigo descreve a arquitetura, a construção dos dados e os métodos de treinamento como referência para modelos fundamentais incorporados.
Comentários
-
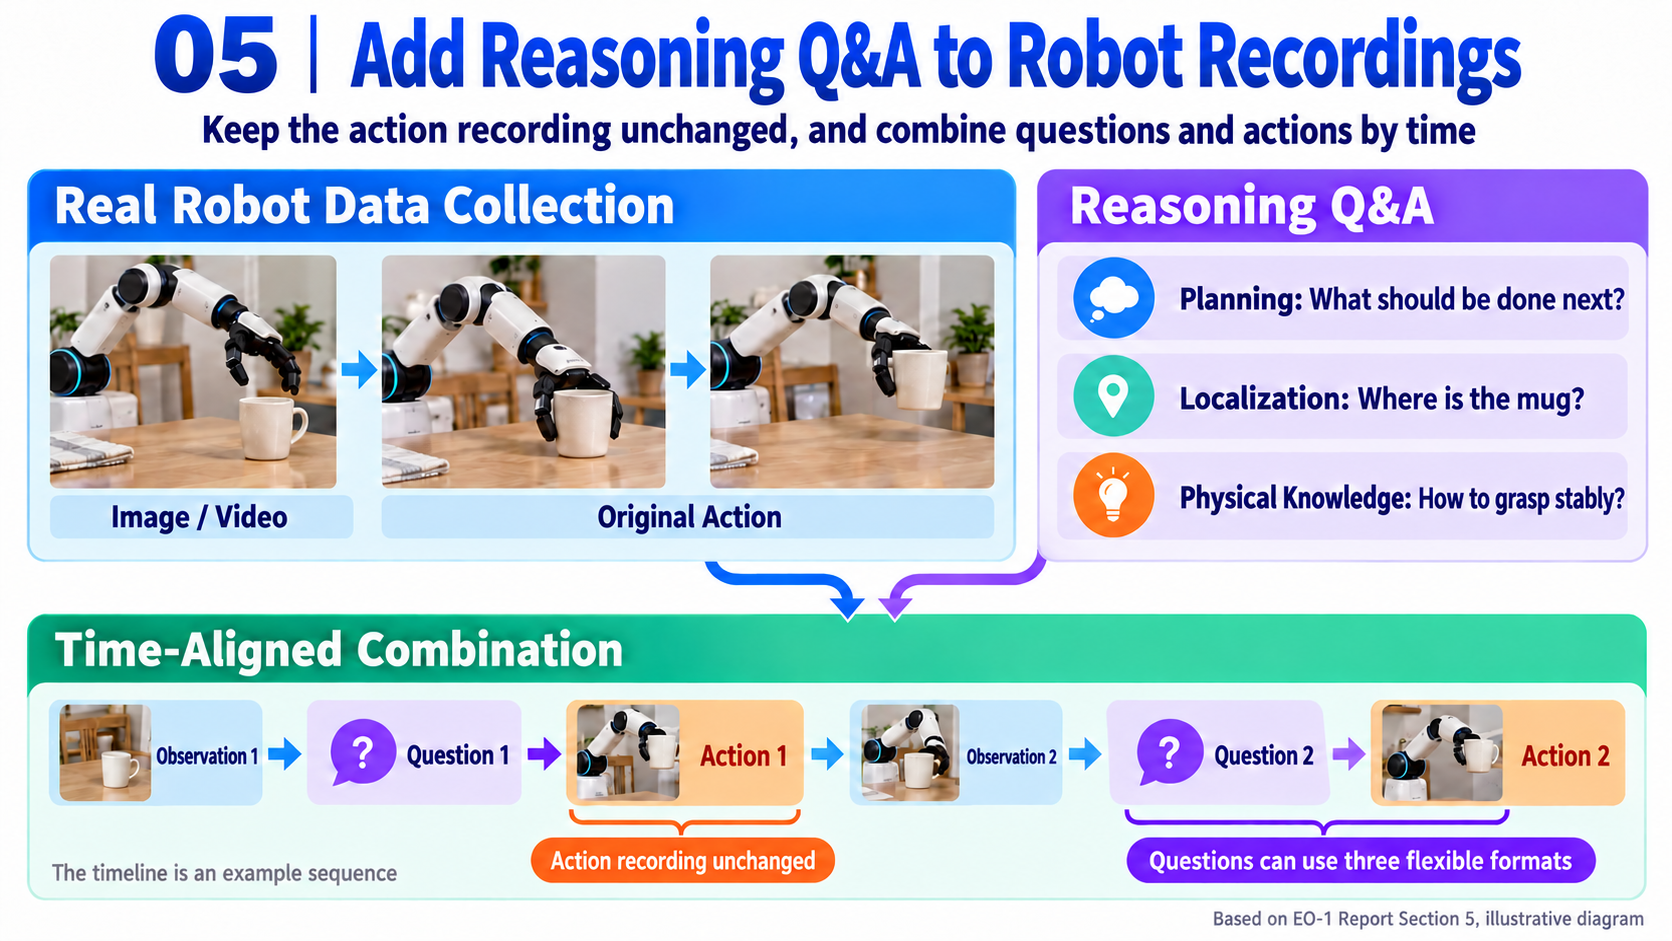
A conexão entre raciocínio e ações muda. Além de gerar ações a partir de uma imagem e instrução, o modelo aprende a reavaliar após as ações usando novas imagens.
-
Arquitetura e dados são ambos necessários. A rede deve suportar texto e ações contínuas, e os exemplos precisam conectá-los ao longo do tempo.
-
Mais de 1,5 milhão se refere ao dataset geral. Nem todas as amostras contêm ações totalmente intercaladas; o texto relata separadamente cerca de 122.000 exemplos intercalados visão-texto-ação.
-
A eficácia é limitada pelos experimentos. Resultados em múltiplas plataformas não estabelecem nível humano nem generalidade para cenas arbitrárias.
Introdução e Trabalhos Relacionados: Por que Intercalar?
Os Sete Principais Parágrafos da Introdução
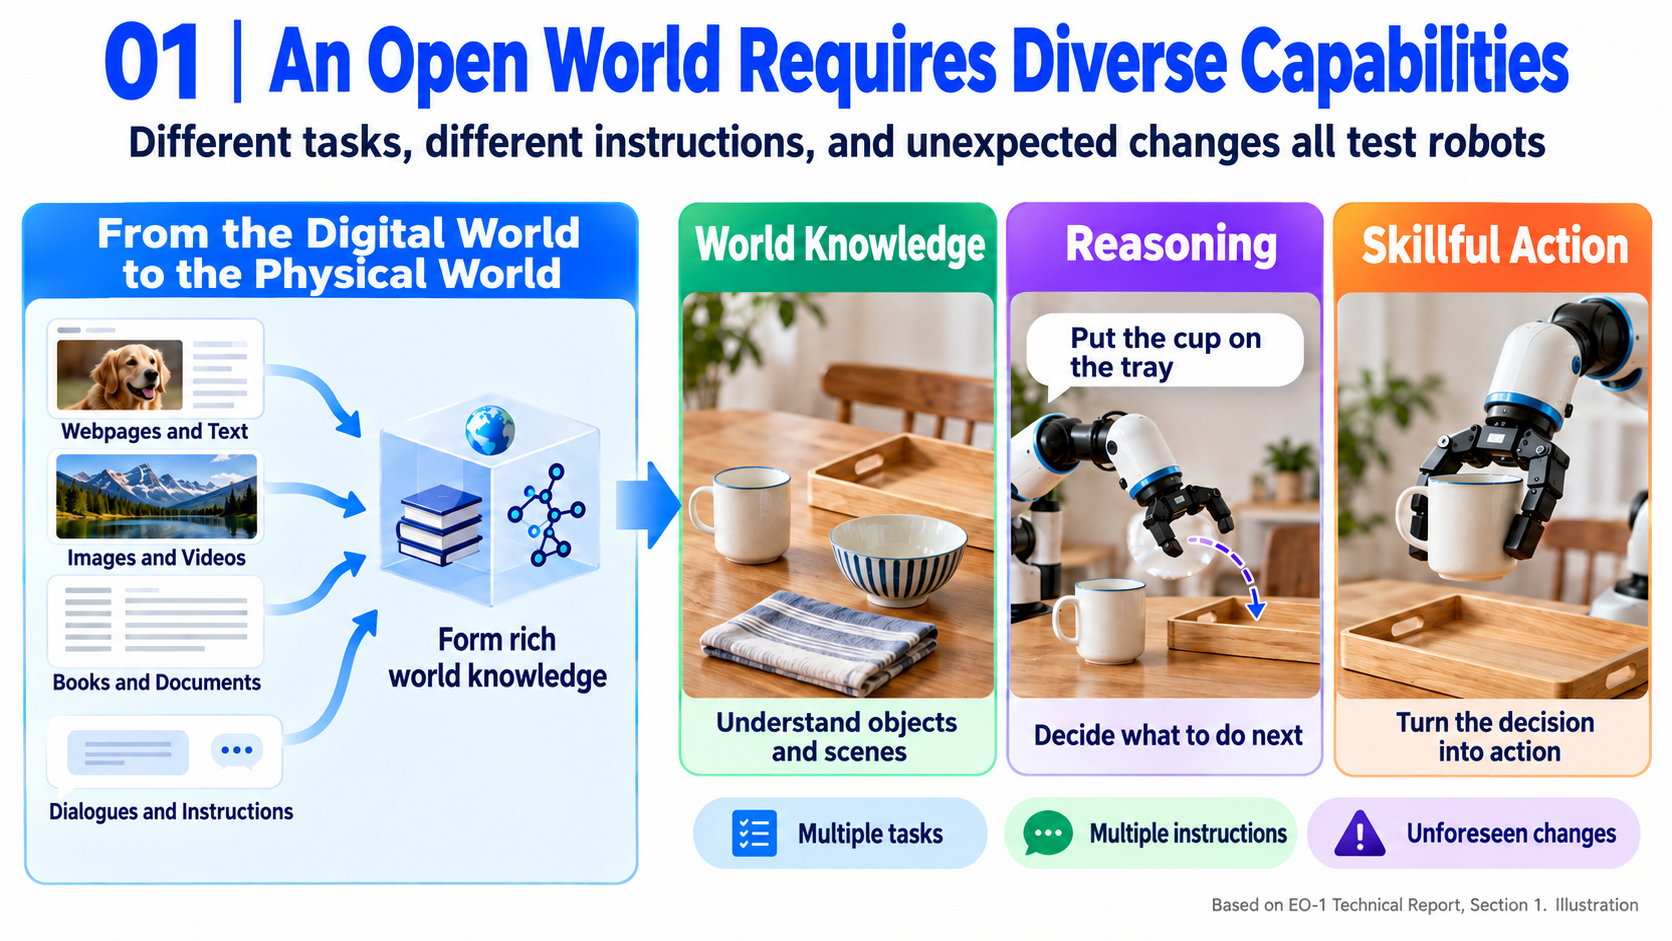
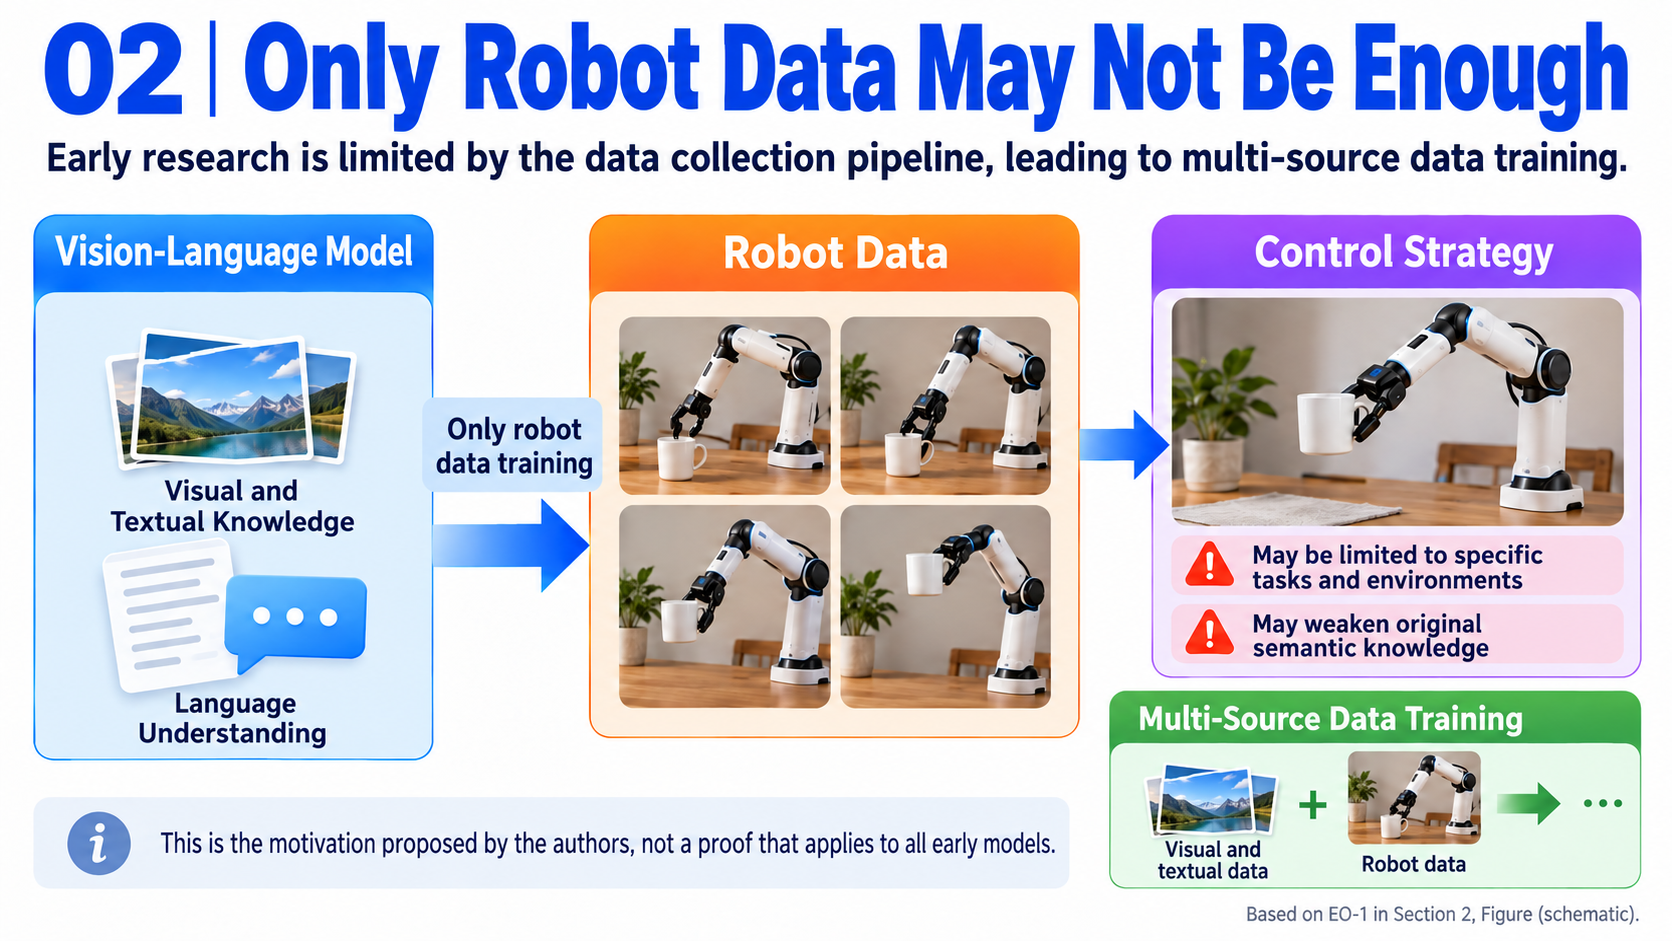
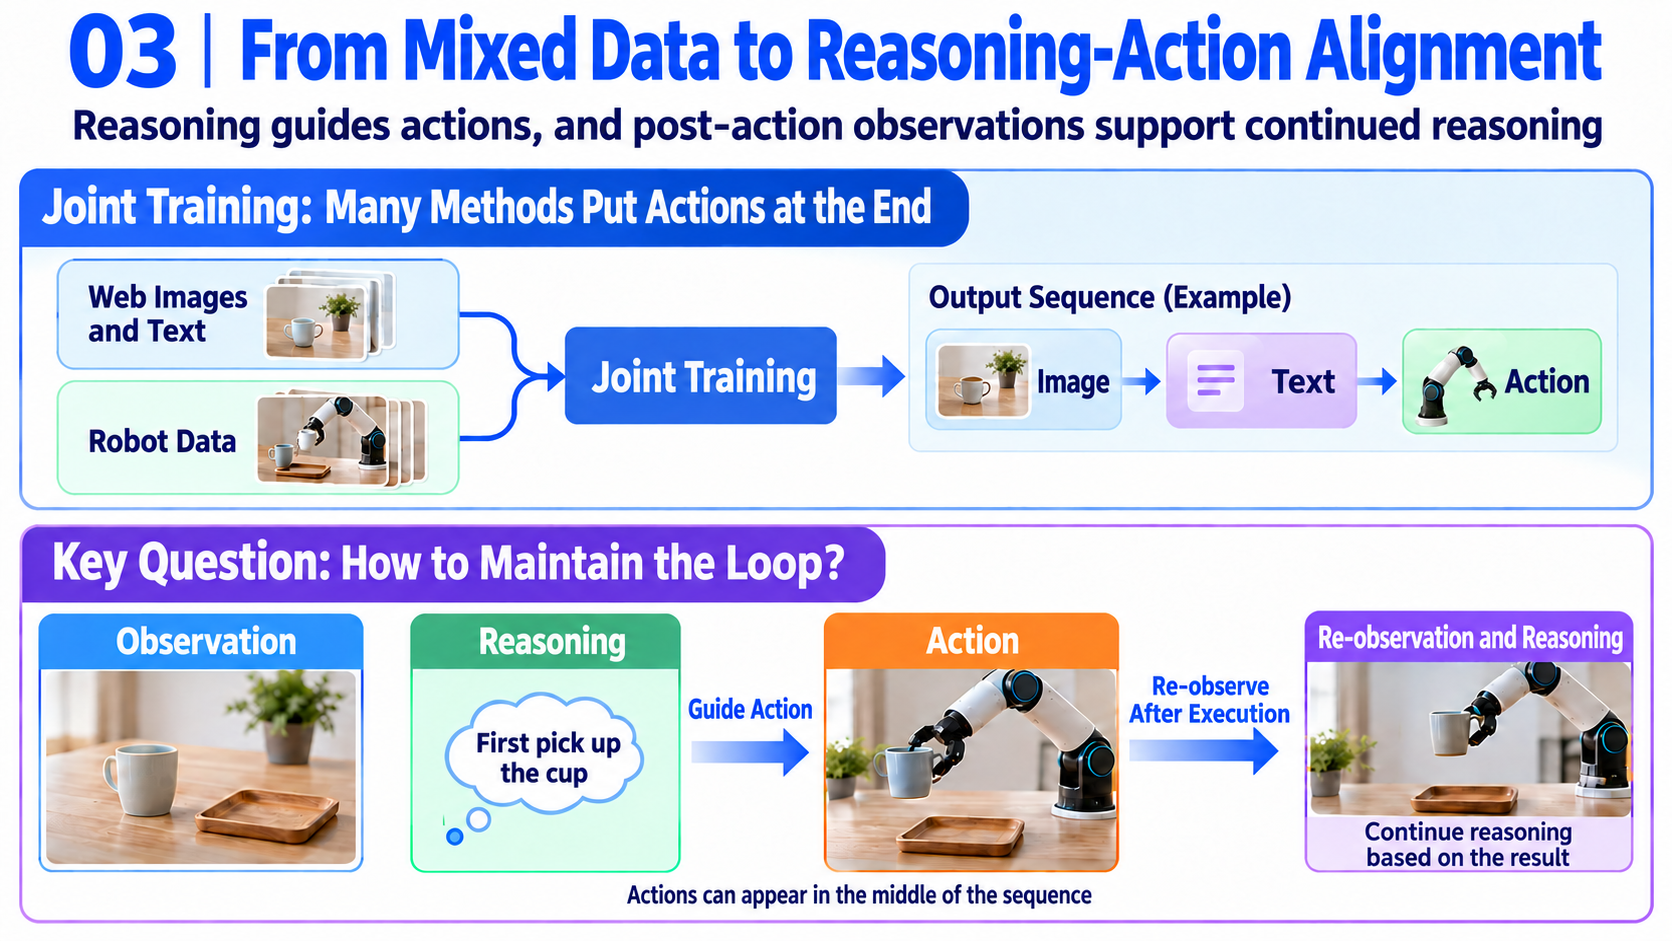
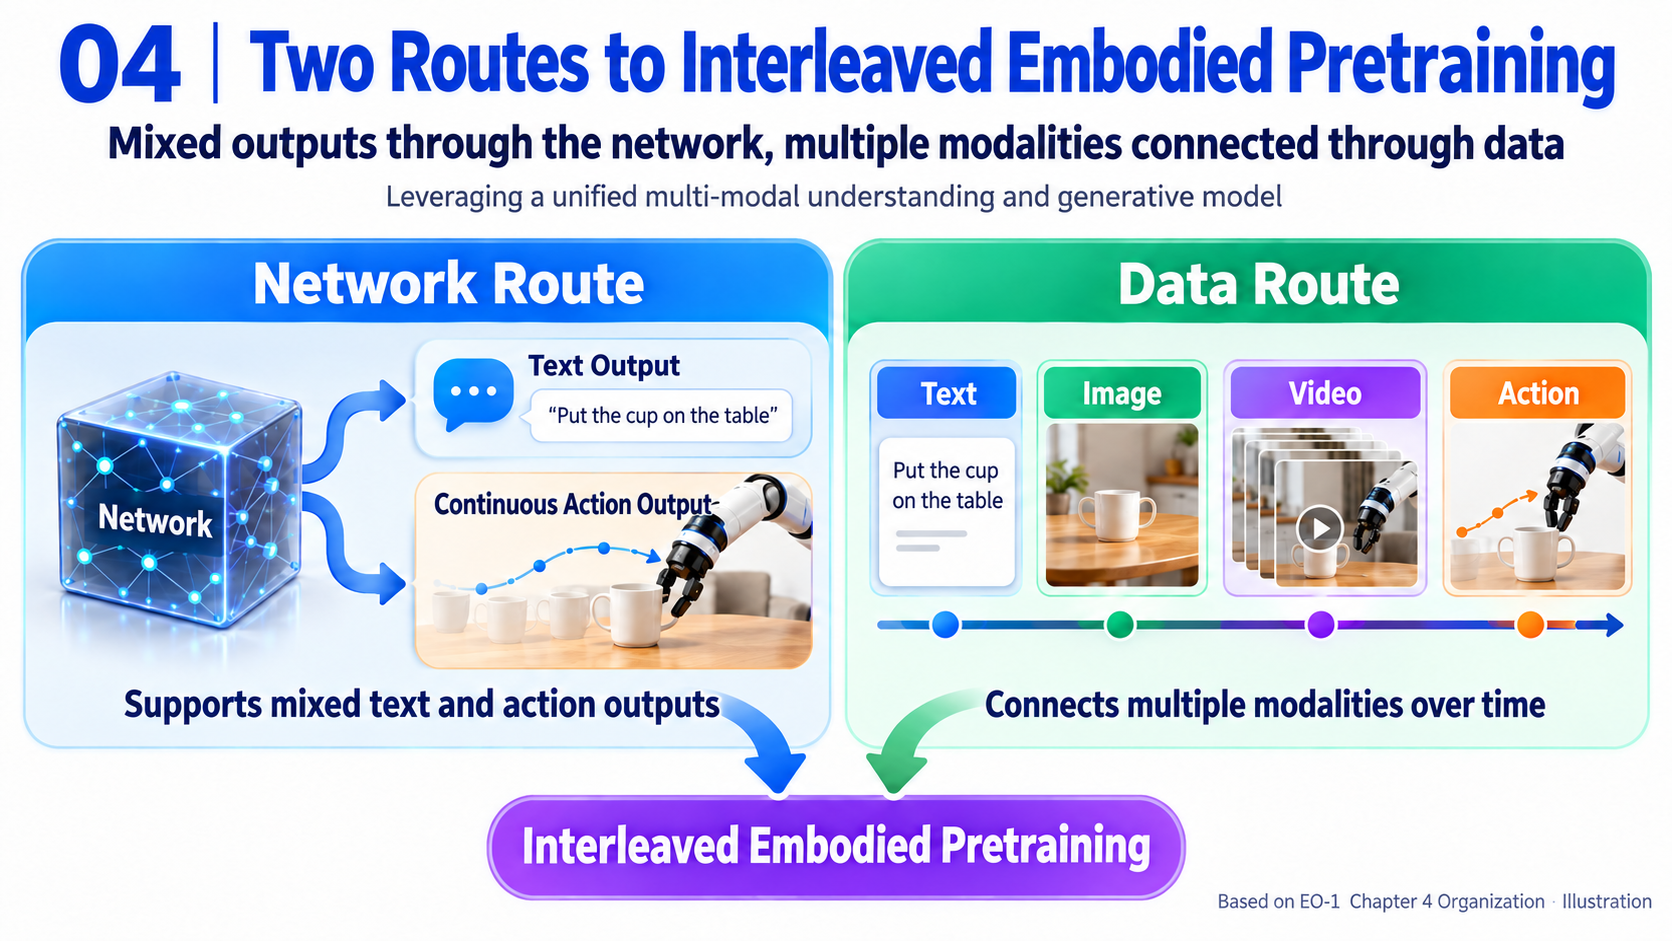
Relação com Trabalhos Anteriores
Método Central: Um Único Backbone, Duas Saídas
Processamento Compartilhado com Interfaces Específicas de Modalidade
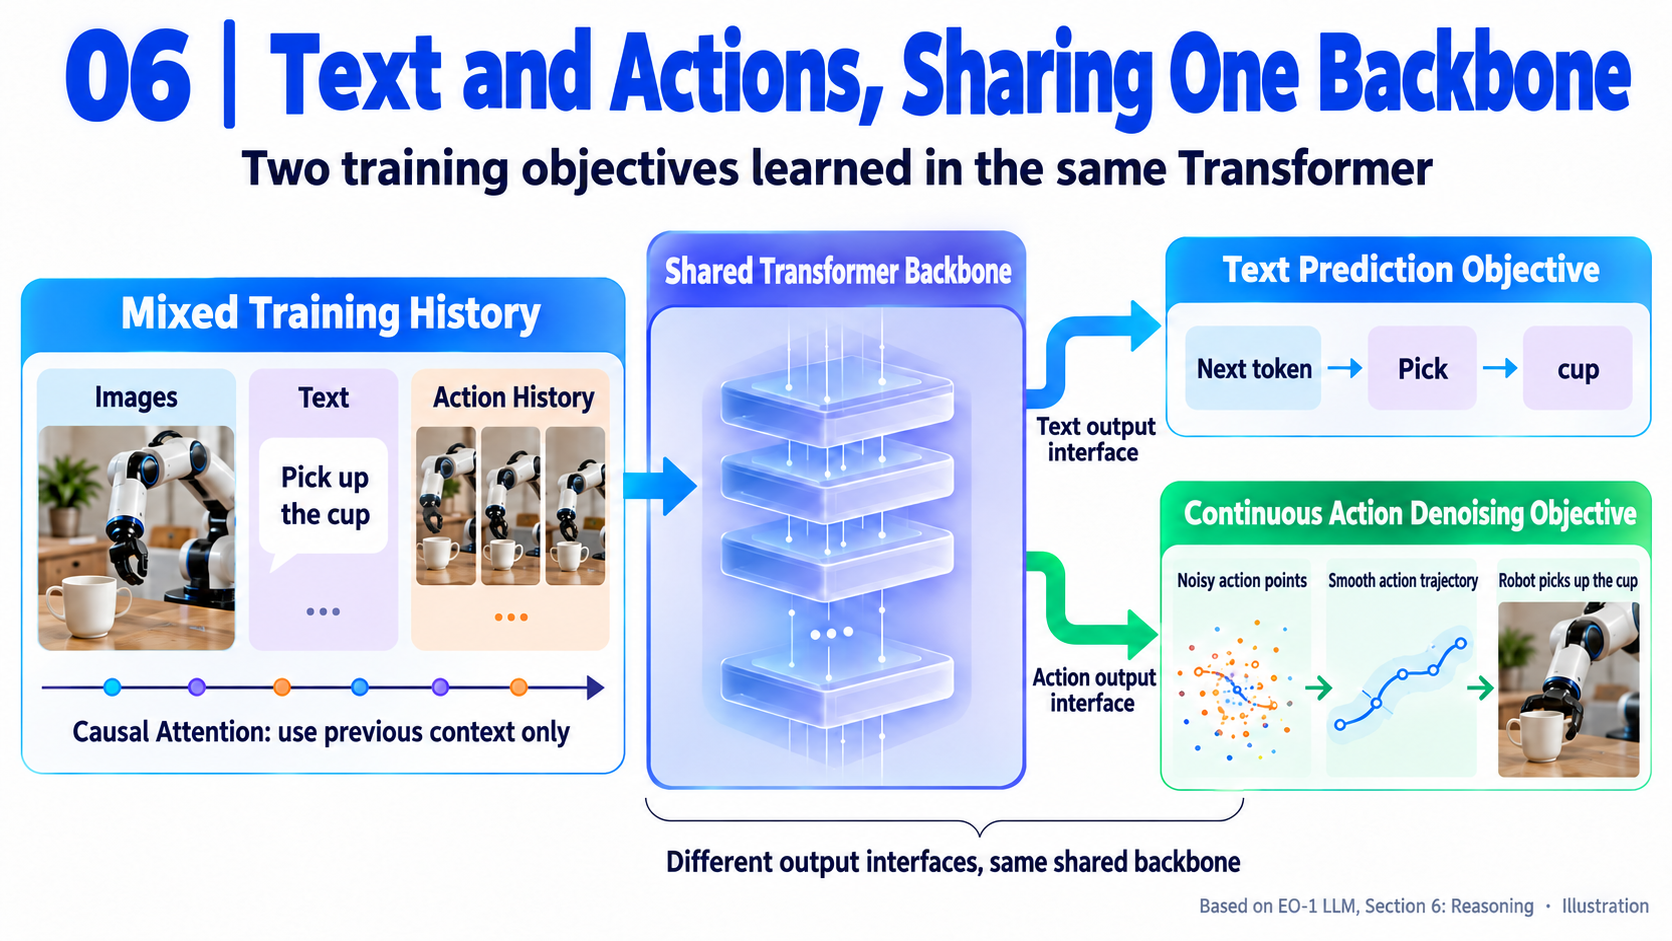
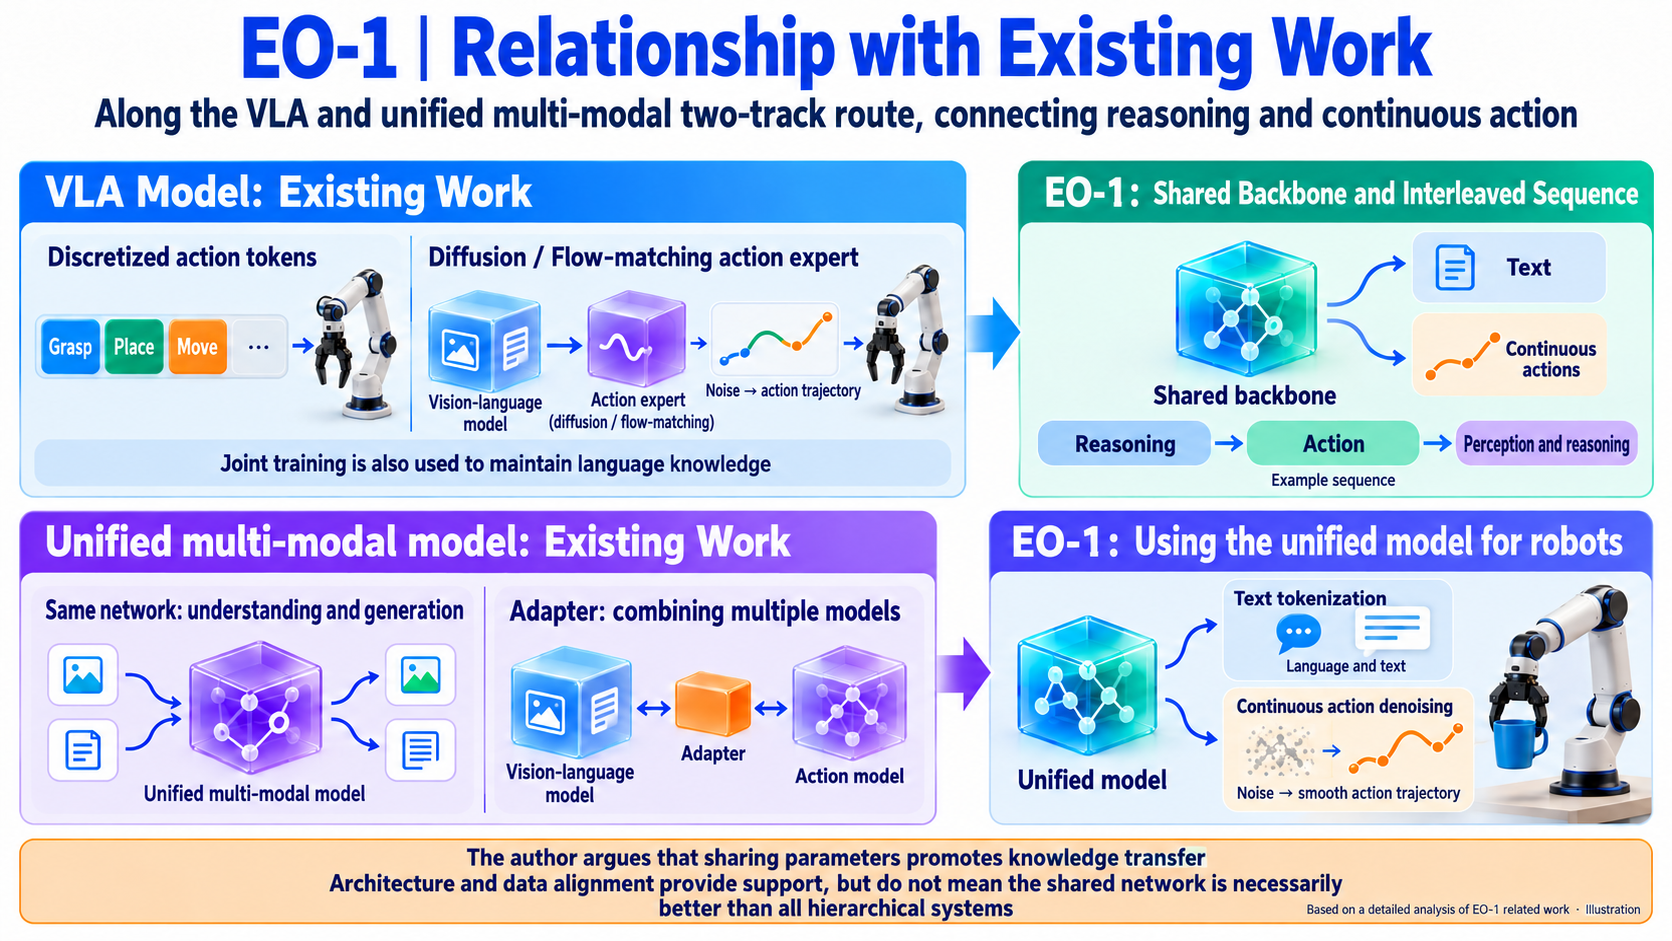
Texto aborda o que e por quê, enquanto ações especificam movimento. Ambos dependem dos mesmos objetos, objetivos e progresso. EO-1 compartilha um backbone pré-treinado para reduzir a separação entre planejamento e controle.
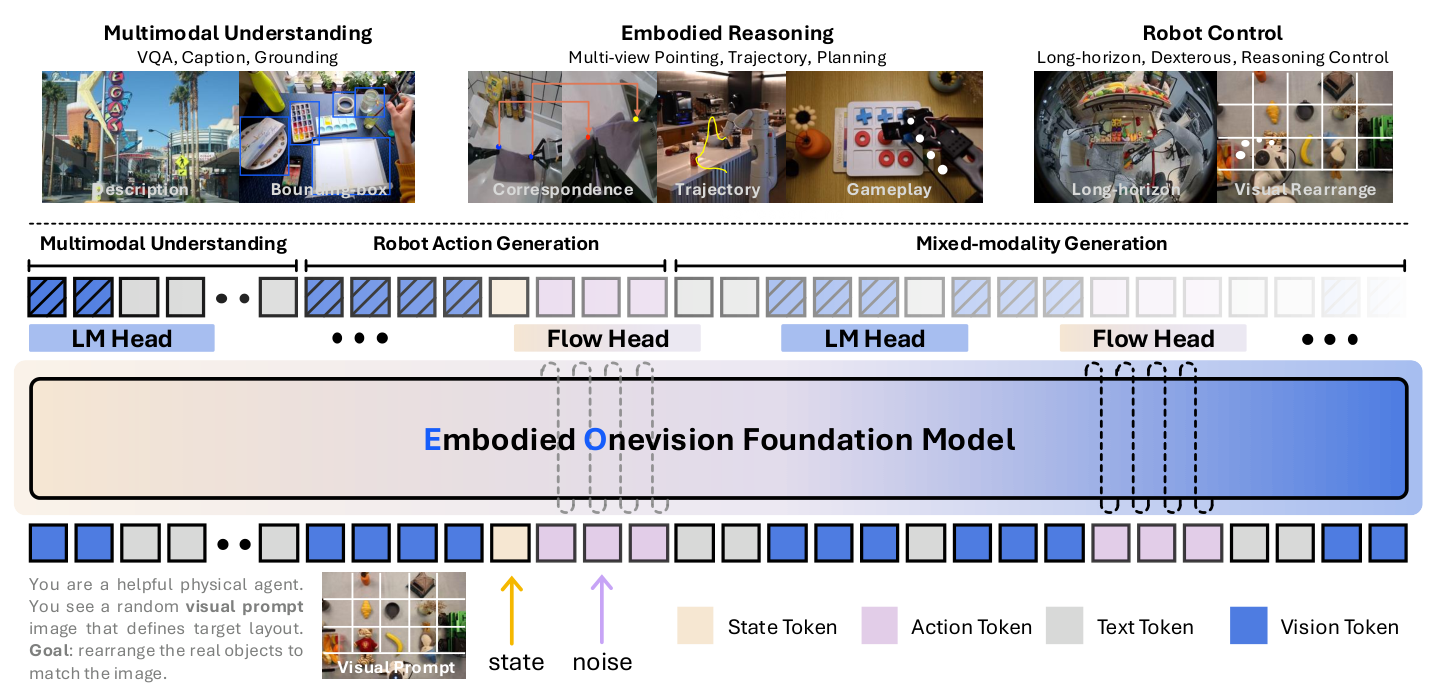
Artigo: Um Transformer apenas decodificador inicializado a partir de Qwen2.5-VL mantém o codificador visual para imagens/vídeo e o tokenizador para texto. Estado e ações ruidosas são projetados no espaço de recursos compartilhado.
Tokens são elementos de sequência, não necessariamente palavras discretas. Tokens visuais, de estado e de ação podem ser vetores de características contínuas.
| Entrada bruta | Codificação | Representação no backbone |
|---|---|---|
| Imagens multivisadas e quadros de vídeo | Codificador visual pré-treinado | Sequência visual de largura D. |
| Instruções e QA de raciocínio | Tokenizador e camada de embedding | Sequência de texto de largura D. |
Estado qₜ | Projeção de estado | Mapeia d_q dimensões de estado para largura D. |
Bloco ruidoso Xτ e progresso τ | Projeção de entrada de ação | Sequência de ação de largura D. |
D é a largura do backbone e d_q a dimensão de estado da plataforma. Dimensões de estado/ação e contagens completas de tokens não são especificadas de forma uniforme entre plataformas, portanto os símbolos são mantidos.
As saídas se ramificam em uma cabeça de LM, que prediz tokens de texto, e uma cabeça de flow, que mapeia recursos ocultos para atualizações contínuas de ação. O bloco final é 16 × d_a, com dimensão de ação específica da plataforma d_a.
Exemplo de forma: Para uma interface hipotética 7D, a saída é 16 × 7, ou 112 valores. Esta não é uma configuração universal. Uma projeção mapeia a largura D de volta para d_a; as larguras não são somadas diretamente.
Atenção: “Nenhum parâmetro adicional específico de ação” deve ser lido como nenhum backbone especialista em ação separado. Projeções de estado/ação e cabeças de saída ainda contêm parâmetros.
Gerar Texto Sequencialmente, Denoisar Ações em Bloco
Autoregressão prediz o próximo token de texto a partir do contexto existente:
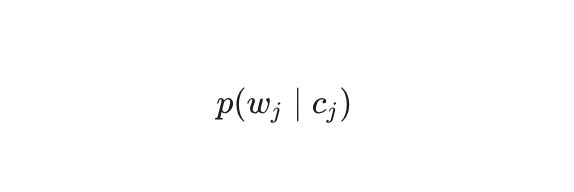
w_j é o token j, e c_j seu contexto multimodal precedente. Exemplo: após “next, pick up”, o modelo prediz “the tomato”, usando também imagens anteriores e histórico de ações.
Ações usam flow matching: repetidamente predizer como atualizar um array aleatório em direção a uma trajetória completa, em vez de soletrar controles como texto.
O treinamento mistura ações verdadeiras e ruído Gaussiano:
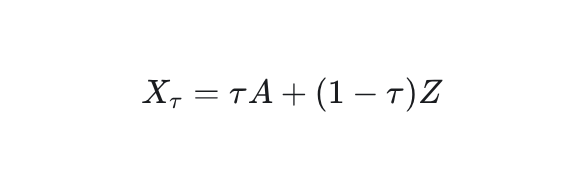
A e a Gaussiana padrão Z têm ambas dimensão 16 × d_a. τ∈[0,1] é o progresso interno de denoising, não segundos. Zero produz ruído, um produz dados; o artigo amostra de uma distribuição Beta que enfatiza estágios mais ruidosos.
Exemplo mínimo: Para um elemento, A=0.6, Z=−0.2 e τ=0.5 produzem Xτ=0.2: um valor intermediário em vez da resposta completa.
Objetivo de treinamento, preservando a Equação (2):
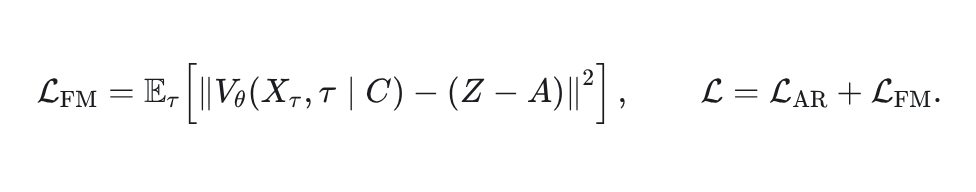
Vθ é o campo de atualização previsto pelo modelo compartilhado e pelo cabeçalho de fluxo, θ são parâmetros treináveis, e C é o contexto multimodal precedente. A norma compara vetores completos, e a esperança faz a média do progresso amostrado. L_AR é a entropia cruzada de texto; ambos os termos têm peso um. A meta de ação escrita do exemplo é Z−A=−0.8.
Inferência, preservando a Equação (1):
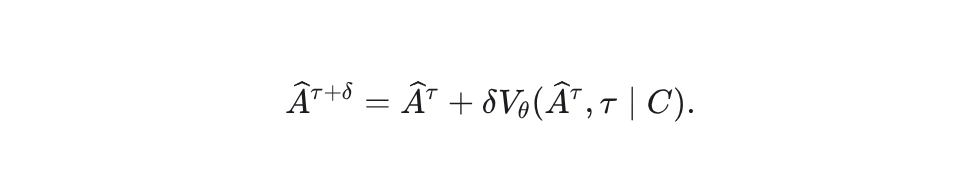
Âτ é a estimativa inicializada a partir de ruído novo; δ é um passo de integração. O texto integra de zero a um e usa dez atualizações. Ilustração: dez atualizações iguais dariam δ=0.1, um passo interno em vez de um período de execução.
Cuidado: as instruções escritas são inconsistentes. A derivada do caminho linear é A−Z, mas a Equação (2) usa Z−A e a Equação (1) uma atualização positiva. Tomadas literalmente em conjunto, elas não se alinham: a direção direta do exemplo é 0.8, mas a meta escrita é −0.8. As equações são mantidas; a reprodução deve verificar a convenção de tempo/sinal da implementação em vez de concluir que o treinamento real está errado.
Sequências Intercaladas: Raciocinar Novamente após Agir
Um exemplo padrão de ação pode ser escrito como:
Image → Task text → State → Action chunk
EO-1 também aprende essa estrutura temporal:
Current image → Planning QA → State → Action chunk
→ New image → Completion QA → Next-step planning → Next chunk
Artigo: Cada modalidade tem marcadores de limite, incluindo [BOI]/[EOI] para imagens, [BOR]/[EOR] para estado e [BOA]/[EOA] para ações. A atenção causal condiciona no contexto precedente em vez de respostas futuras.
Exemplo: Após tentar ensacar um tomate, uma nova imagem pode mostrar que ele ainda está no gripper. O modelo pode julgar que a colocação está incompleta e gerar mais ações. Isso ilustra a estrutura de feedback, não uma garantia de recuperação confiável.
EO-1 gera texto e ações, não imagens de câmera futuras ou estado. O ambiente fornece novas observações. A intercalação também não exige uma resposta verbal antes de cada ponto de controle.
Amostragem Retificadora Intercalada: Histórico Limpo, Ações Atuais Ruidosas
Treinar a ação atual requer ruído, mas o texto posterior deve condicionar em ações concluídas. Manter ações passadas ruidosas cria uma incompatibilidade com o histórico executado.
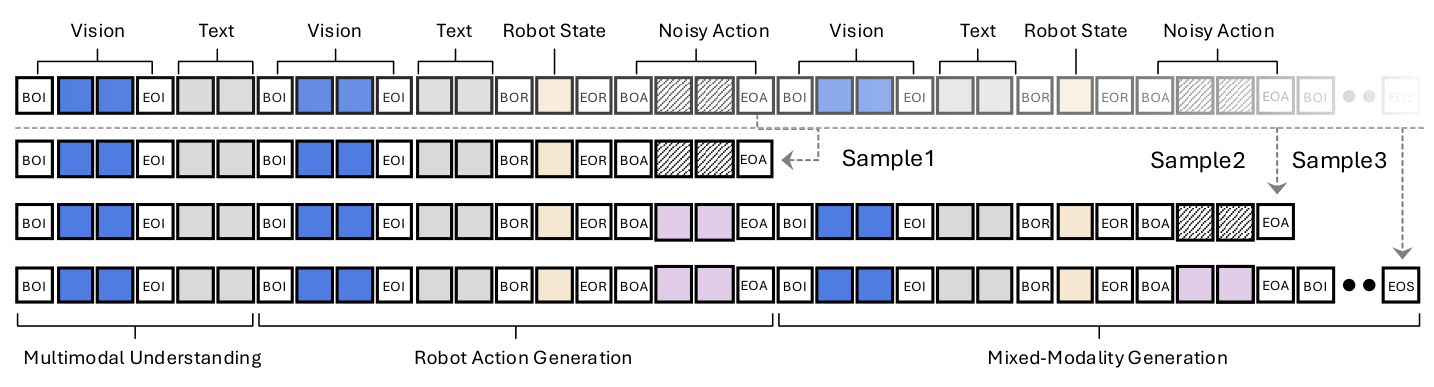
Artigo: A amostragem retificadora intercalada divide uma sequência com N segmentos de ação em N+1 prefixos de treinamento nos limites de ação. As ações históricas são limpas; a ação que está sendo gerada no momento é ruidosa.
Exemplo mínimo: Uma sequência com duas ações:
Image₁ / Text₁ → Action₁ → Image₂ / Text₂ → Action₂ → Image₃ / Text₃
Para N=2, construa três prefixos:
| Amostra | Contexto e alvo |
|---|---|
| Amostra1 | Imagem₁ / Texto₁ → Ação₁ ruidosa; treinar o denoising da ação₁. |
| Amostra2 | Imagem₁ / Texto₁ → Ação₁ limpa → Imagem₂ / Texto₂ → Ação₂ ruidosa; treinar o texto subsequente e a ação₂. |
| Amostra3 | Ambas as ações são histórico limpo; aprender o texto₃ final. |
As ações recebem supervisão de denoising quando geradas e contribuem com gradientes como contexto limpo para previsões posteriores. O modelo aprende tanto a geração de ações quanto o raciocínio a partir do histórico de ações.
Limites e custo: Reprocessar prefixos adiciona computação que não é medida separadamente; não há ablação de remoção isolada. O histórico limpo de treinamento vem de gravações, enquanto o histórico em implantação pode incluir erros do modelo. A amostragem retificadora não remove essa incompatibilidade e não é ensemble temporal ACT nem suavização de ações.
Treinamento e Inferência Completos
Treinamento: fontes de imagem-texto, registros de robô e exemplos intercalados → codificar modalidades → adicionar ruído às ações atuais, manter o histórico limpo → backbone compartilhado → entropia cruzada de texto e perda de fluxo → atualizações conjuntas. Amostras apenas de QA fornecem supervisão de texto sem ações inventadas.
Inferência: imagens, instrução, estado e histórico → gerar o texto necessário → refinar novo ruído por meio de dez atualizações em um bloco de 16 passos → executar → adicionar novas observações ao contexto. O cache de KV reutiliza a computação de contexto; ele não substitui a reobservação.
A implementação relata cinco épocas de pré-treinamento, comprimento médio empacotado de 16.384 e tamanho de lote um. A taxa de aprendizado da projeção de linguagem/multimodal é 5×10⁻⁵, do codificador visual 1×10⁻⁵. Estas são configurações experimentais, não ótimos universais.
EO-Data1.5M: Material Compartilhado para Raciocínio e Controle
Três Grupos de Dados
| Categoria | Escala da Tabela 1 do texto principal | Supervisão |
|---|---|---|
| Multimodal da web | 5,7M amostras, 7,1B tokens | QA de imagem, compreensão de vídeo, grounding e tarefas relacionadas. |
| Controle de robô | 1,2M trajetórias, 127,3B tokens | Operação contínua em vários robôs. |
| Dados incorporados EO-Data1.5M | 1,5M amostras, 1B tokens | Raciocínio espacial, temporal, físico e de tarefas, além de operação intercalada. |
Cuidado: Trajetórias, amostras de QA e tokens são unidades diferentes e não podem ser somadas como contagens de operação. EO-Data1.5M não é todo o corpus de treinamento, e sequências intercaladas completas são apenas um subconjunto.
Pipeline: Preservar Cenas Diversas, Depois Adicionar Raciocínio
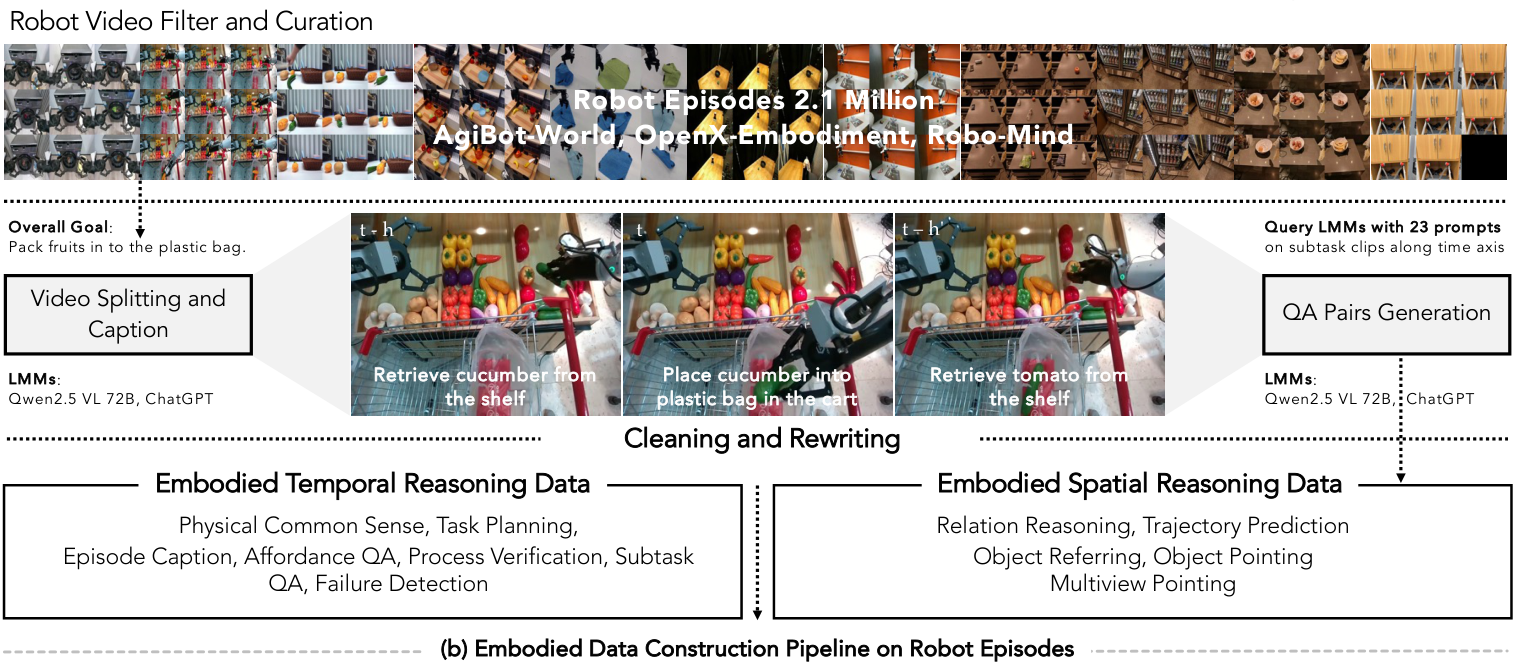
Artigo: Agrupar características visuais de vídeo, amostrar por cluster e inspecionar manualmente para reduzir cenas repetidas. Segmentar vídeos em subtarefas, criar descrições de ações com modelos e humanos, construir perguntas baseadas em templates, gerar respostas candidatas, selecioná-las ou reescrevê-las manualmente e então limpar regras e formulações.
Tarefas temporais incluem bom senso físico, planejamento, descrições de vídeo, QA de affordance, verificação, QA de subtarefas e detecção de falhas. Tarefas espaciais incluem relacionamentos, previsão de trajetória, caixas delimitadoras, apontar e apontar em múltiplas vistas.
Explicação: Um registro de preensão pode responder o que agarrar, onde se aproximar e se a colocação foi bem-sucedida. Essas anotações vêm de demonstrações, não da exploração de todas as ações possíveis.
Como Três Formatos Intercalados Conectam Perguntas e Respostas a Ações
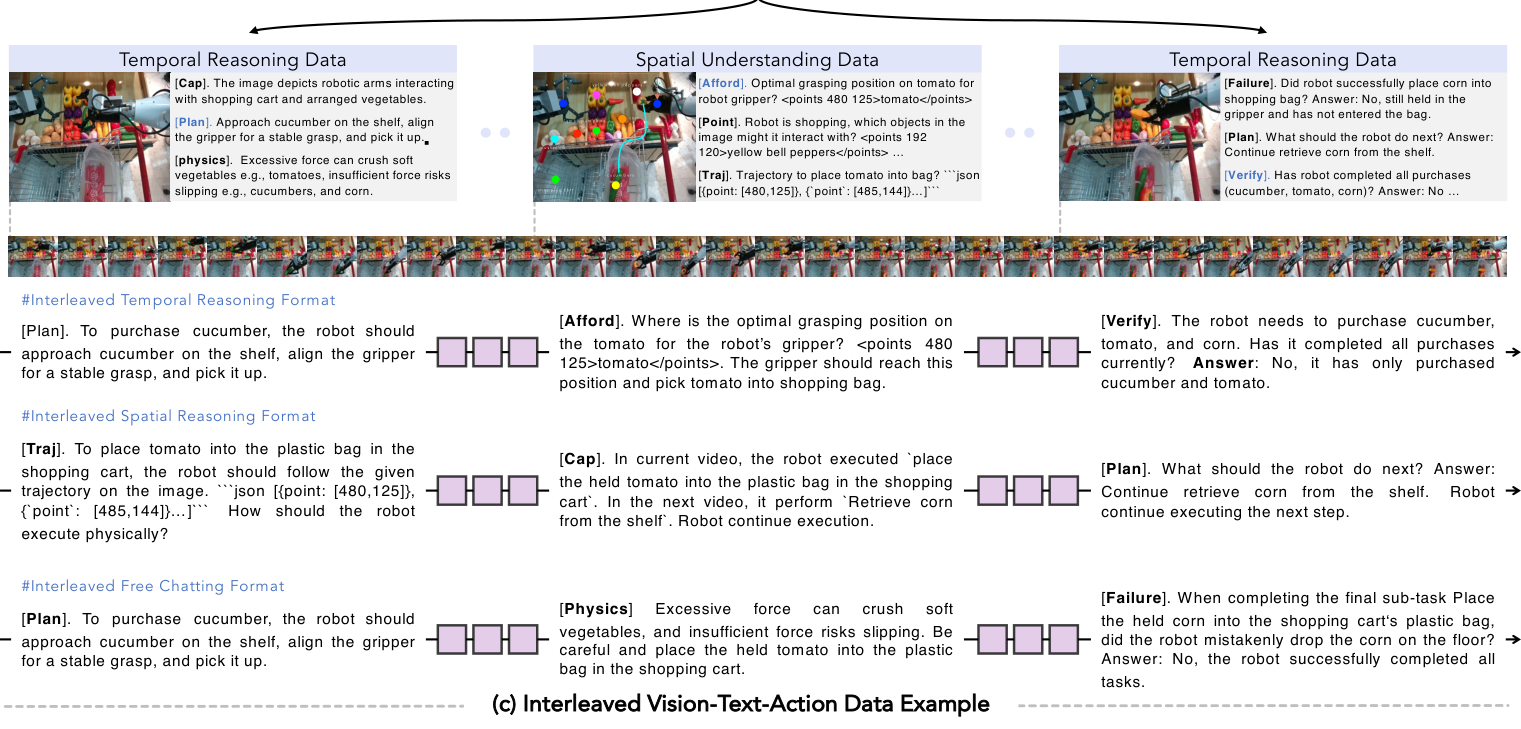
| Formato | Conexão | Foco de aprendizado |
|---|---|---|
| Raciocínio temporal | Imagem → QA da próxima subtarefa → inserir resposta na instrução → ação → nova imagem e verificação. | O que fazer e se está completo. |
| Raciocínio espacial | Imagem → QA de trajetória → inserir trajetória na instrução → ação → nova imagem e verificação. | Traduzir objetivos espaciais em movimento. |
| QA livre | Imagem → outras QAs de raciocínio → instrução da tarefa original → ação → verificação. | Preservar raciocínios variados dentro do contexto de controle. |
Trajetórias espaciais são coordenadas [x,y] no plano da imagem, não comandos de juntas. (480,125) → (485,144) descreve um caminho na imagem; a geração contínua de ações ainda aprende o movimento real.
O texto relata cerca de 122.000 exemplos intercalados. Cuidado: As contagens diferem: a Tabela 1 fornece 5,7M amostras da web, o Apêndice Tabela 6 fornece 6,2M; a Figura 3(a) rotula compreensão espacial como 376k, enquanto a Seção 3.2.1 afirma 1,5M. Cada valor é atribuído à sua localização em vez de ser combinado em um total não verificado.
Experimentos: Evidências para as Alegações
Avaliar Raciocínio e Controle Separadamente
Perda de treinamento, pontuações de QA, sucesso em simulação e conclusão de tarefas reais medem capacidades diferentes e não podem substituir umas às outras.
| Avaliação | Resultado do EO-1 | Comparação e interpretação |
|---|---|---|
| RoboVQA, BLEU-4 | 58,5 | Qwen2.5-VL 3B: 55,9; correspondência de texto com resposta de referência. |
| ERQA, acurácia | 45,5% | Qwen2.5-VL 3B: 35,3%; Gemini 1.5 Flash: 46,3%. EO-1 não supera todas as baselines. |
| EO-Bench, espacial / temporal | 36,4 / 38,9 | Qwen2.5-VL 3B: 20,0 / 22,6; raciocínio de tarefas aprimorado com muitos erros restantes. |
| LIBERO, sucesso médio | 98,2±0,3% | π0: 94,2±0,9%; OpenVLA-OFT: 97,1±0,6%. |
| SimplerEnv, WidowX / Google VM / Google VA | 72,7% / 76,5% / 63,0% | π0: 69,2% / 71,4% / 54,7%; ganhos de 3,5 / 5,1 / 8,3 pontos percentuais. |
Fonte: Tabelas 2–4, páginas 13–14. Nomes e versões de modelos seguem o artigo. Essas métricas não formam uma única pontuação intercambiável de capacidade robótica.
Cuidado: As contagens do EO-Bench também entram em conflito: a Seção 3.3 diz 648 perguntas, suas quatro categorias somam 642, e a Seção 4.2 diz 700 distribuídas uniformemente. Elas não são usadas para inferir significância ou contagens por categoria.
O que Foi Testado em Robôs Reais?
Os 28 cenários de tarefa compreendem sete tarefas de pick-and-place com Franka Panda, 13 testes prontos para uso com WidowX 250 S, quatro tarefas há muito prazo de destreza com AgiBot G-1 e quatro tarefas de raciocínio-controle. SO100 também está envolvido.
Os modelos recebem visões, estado e instruções e produzem controles. As configurações de dados de treinamento da Tabela 6 do Apêndice incluem visões ego/esquerda/direita do AgiBot a 30 FPS; esquerda/direita/punho do DROID a 15 FPS; terceira pessoa/punho do SO100 a 30 FPS; e terceira pessoa/punho do IPEC-Franka a 10 FPS. Essas configurações de origem não são contagens universais de câmeras de avaliação nem taxas de controle.
O fine-tuning de longo horizonte usa 150 demonstrações por tarefa por 25 épocas, misturando dados de subtarefas e tarefas completas em 9:1, depois dez avaliações por tarefa. Cerca de 500 mil quadros e oito etapas são reportados por suíte, não uma duração de tarefa uniforme.
Atenção: As pontuações de longo horizonte medem a conclusão média sob instruções de subtarefas; elas não são sucesso autônomo de tarefa completa a partir de uma única instrução geral. “Pronto para uso” também não implica que a corporificação estivesse ausente do pré-treinamento.
O raciocínio melhora as ações?
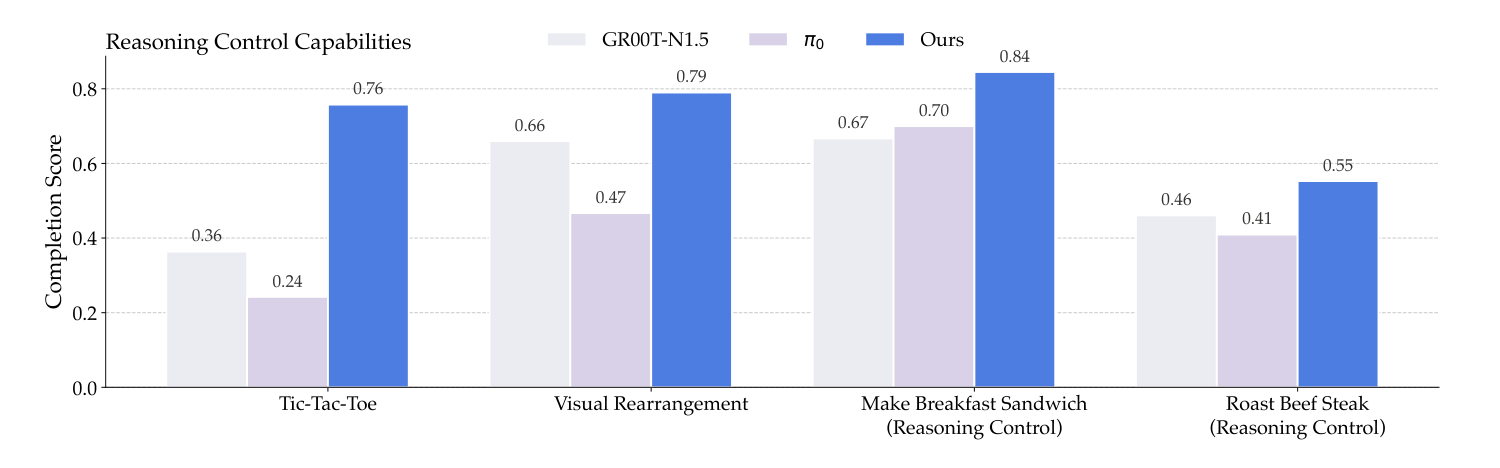
EO-1 obtém pontuações 0.76, 0.79, 0.84, 0.55 em jogo da velha, rearranjo com referência de imagem, preparo de sanduíche e preparo de bife. As linhas de base para jogo da velha são π0 em 0.24 e GR00T-N1.5 em 0.36, apoiando melhor integração de julgamento do tabuleiro e posicionamento neste cenário.
Essas tarefas usam dados especializados e fine-tuning: 800 demonstrações de rearranjo e 450 amostras de jogo da velha. As linhas de base combinam um planejador GPT-4o externo com controladores, enquanto EO-1 usa um decodificador unificado. Os resultados apoiam a abordagem de sistema/treinamento completo, não um componente isolado ou aprendizado zero-shot de nova tarefa.
Generalização e o papel dos dados
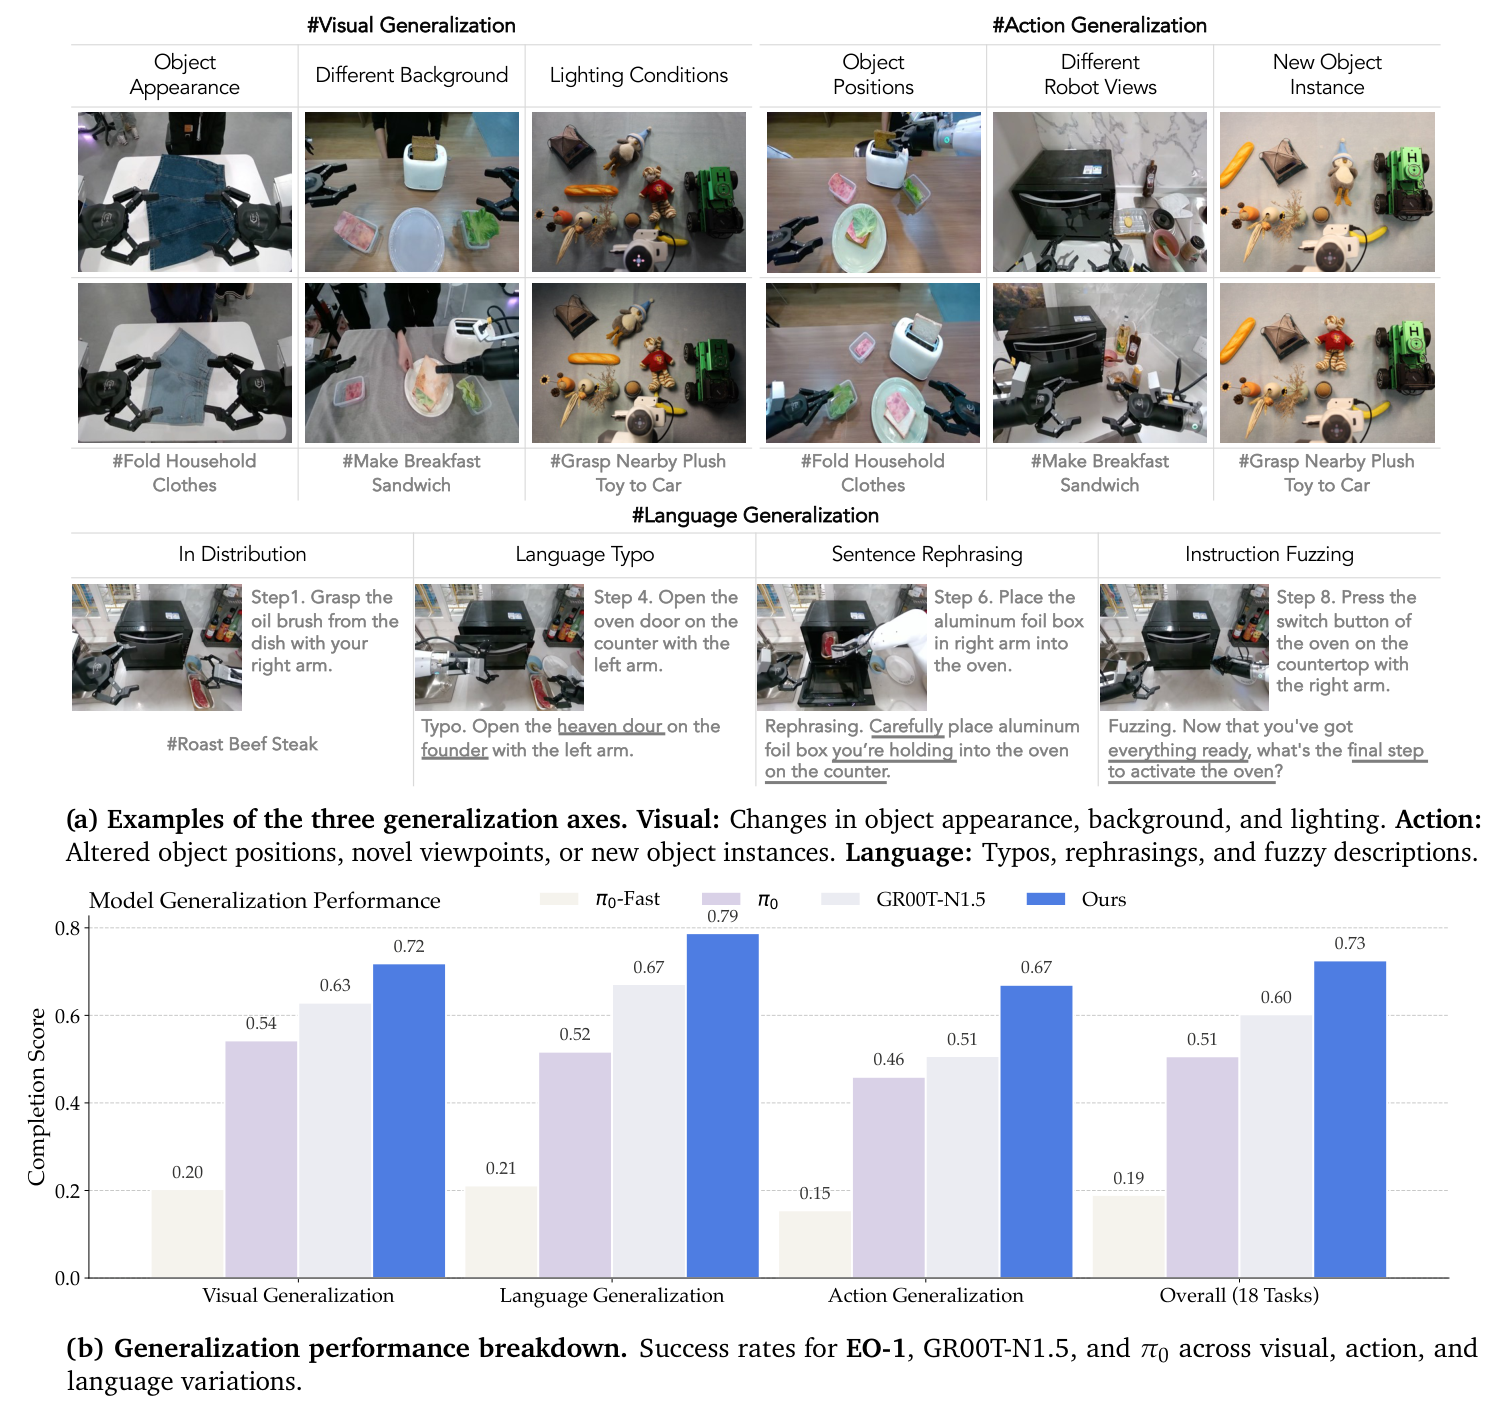
As pontuações de conclusão sob variações visuais, de linguagem e de ação são 0.72, 0.79, 0.67, com 0.73 no geral. As variações de ação mudam principalmente posições de objetos, pontos de vista do robô e instâncias de objetos, não habilidades arbitrárias e inéditas. Texto e figuras discordam sobre os totais de tarefas, então os “18 Tasks” da Figura 9 não são tratados como uma contagem de experimentos para todo o artigo.
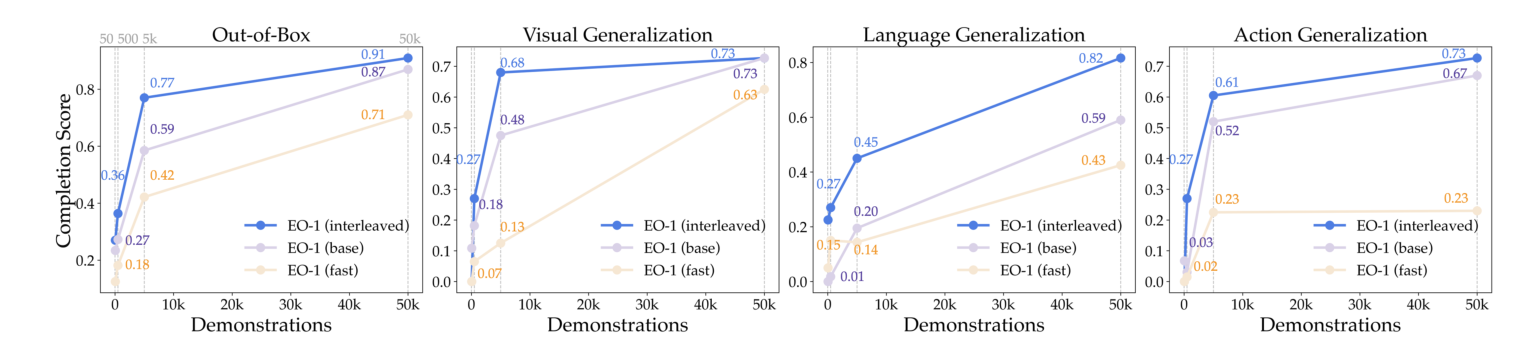
Quatro configurações são comparadas: fast, ações FAST totalmente autorregressivas; base, um backbone compartilhado com continuous flow matching treinado apenas em dados de controle; llava, adicionando instruções genéricas de imagem-texto; e interleaved, adicionando dados intercalados relevantes.
A Tabela 5 fornece duas observações principais:
-
A geração contínua ajuda: LIBERO
baseatinge 98,2% versusfastem 88,0%. Isso apoia a decodificação híbrida neste cenário, não a inferioridade universal de ações discretas. -
A relevância importa mais do que simplesmente adicionar modalidades: A conclusão geral no WidowX sobe de
base0.71parainterleaved0.80, enquanto ollavacom dados genéricos obtém0.34. O alinhamento de tarefas importa; dados da web não são universalmente prejudiciais.
Os ganhos têm limites: as pontuações de generalização de ação para sanduíche no AgiBot permanecem em 0.75 tanto para base quanto para interleaved. Rótulos intercalados não fornecem automaticamente diversidade de movimento ausente das demonstrações.
Interpretando a conclusão
Conclusão sustentada: Nesses cenários, um backbone compartilhado com dados corporificados intercalados melhora o raciocínio relevante para a tarefa e o controle contínuo. Ele fornece uma interface treinável para raciocínio antes das ações e reavaliação depois.
Mantenha três limites:
-
Unificado não significa totalmente confiável. Tarefas complexas como preparo de bife continuam fracas, o EO-Bench está longe de perfeito, e navegação, desvio, análise de falhas e colaboração permanecem como direções futuras.
-
Raciocínio e movimento não são arbitrariamente concorrentes. Arquiteturas eficientes e inferência assíncrona permanecem como trabalho futuro. A intercalação expressa dependências temporais, não pensamento e ação simultâneos em nível humano.
-
A reprodução precisa de detalhes de implementação. Contagens e sinais de fluxo entram em conflito, e dimensões de estado/ação e cronogramas de execução não podem ser inferidos a partir de diagramas. Cerca de 6 GB de memória de inferência em uma RTX 4090 são reportados, sem medições universais de latência ou taxa de controle, portanto a execução em tempo real em qualquer plataforma não é garantida.
Explicação: EO-1 oferece uma rota para aprender julgamento semântico e controle em conjunto. A rede compartilhada lida com informações conjuntas, dados intercalados fornecem relações temporais, e a amostragem retificadora distingue ações históricas da atenuação de ruído atual. Resultados práticos ainda dependem da cobertura das demonstrações, das tarefas e dos sistemas de execução.