Evo-1: Como Modelos VLA Leves Preservam o Alinhamento Semântico
Evo-1: Modelo Leve de Visão-Linguagem-Ação com Alinhamento Semântico Preservado
- VLA leve
- Alinhamento semântico
- Cross-attention
- Treinamento em duas etapas
Pré-requisitos: De Instruções a Ações
O que um VLA aprende?
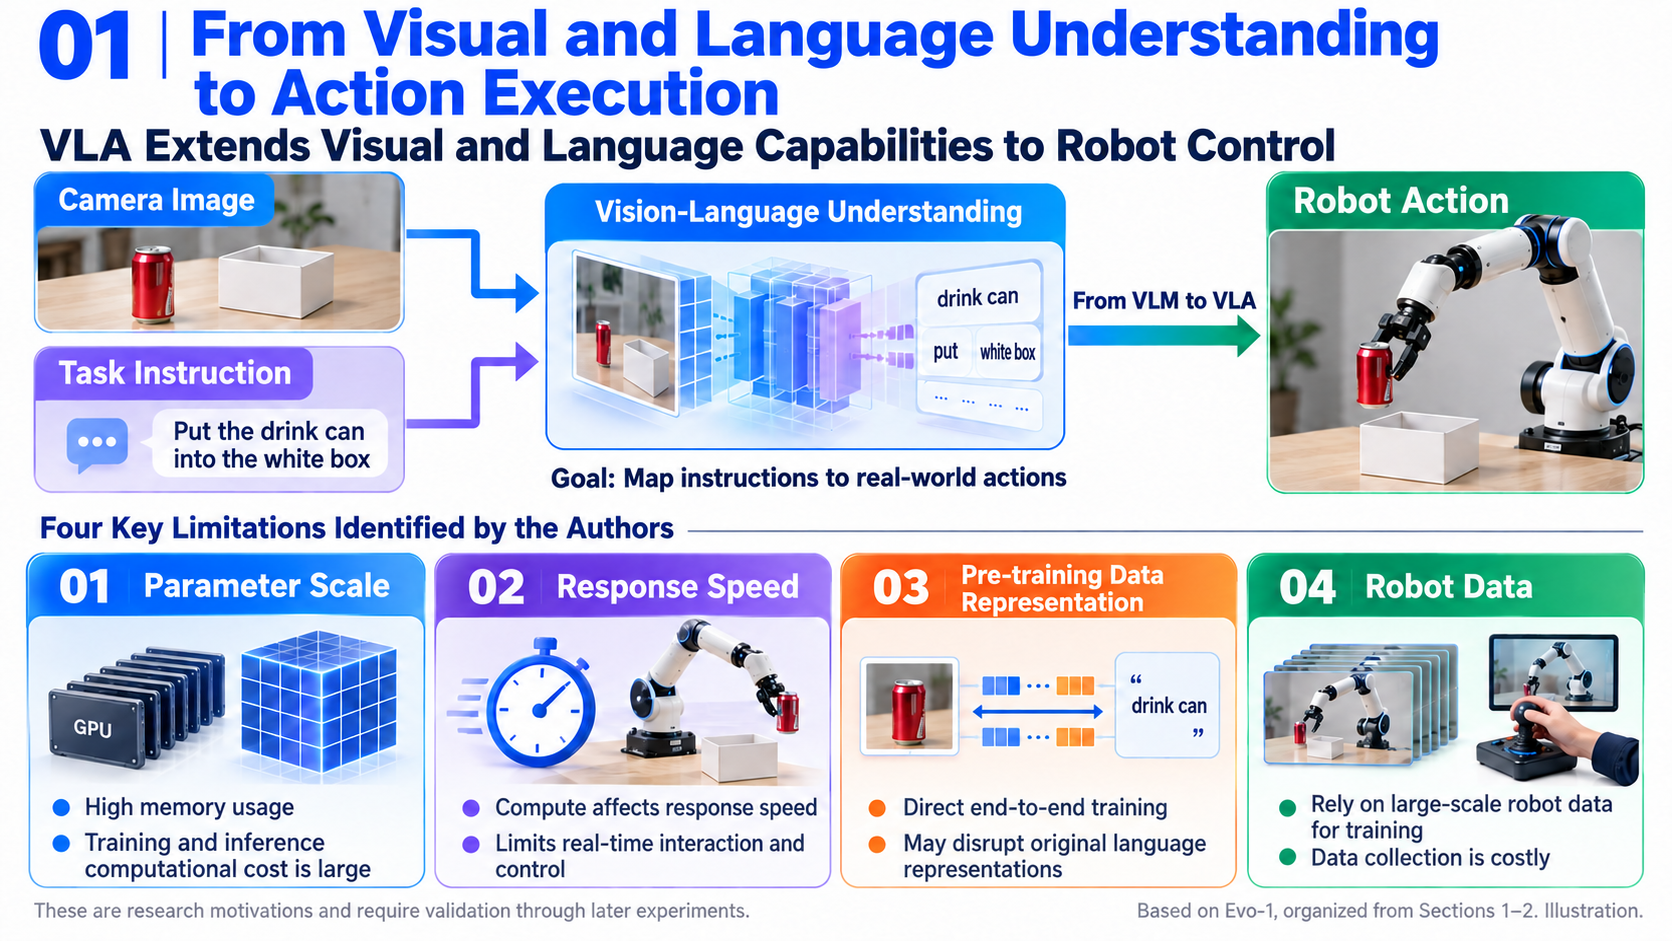
Explicação: Aprendizado por imitação ensina o robô a se mover em uma situação demonstrada. Um modelo de visão-linguagem-ação adiciona texto de tarefa, aprendendo ações de controle condicionadas tanto em imagens quanto em instruções.
Para a tarefa do artigo “colocar a lata de bebida na caixa branca”, a teleoperação fornece imagens de câmera, configurações do robô e ações correspondentes. O modelo aprende a relação delas com o texto da tarefa. Na implantação, imagens atuais, uma instrução e o estado produzem ações futuras, em vez de apenas uma instrução verbal para pegar a lata.
| Conceito | Significado | Exemplo em Evo-1 |
|---|---|---|
| Observação | Informação usada para avaliar o ambiente | Imagens RGB de múltiplas vistas; o xArm6 real usa câmeras fixa e de pulso. |
| Estado proprioceptivo | Descrição numérica do próprio robô | Ângulos absolutos das juntas no conjunto de dados do robô real. |
| Ação | Comandos numéricos para a interface de controle | Registrados como ângulos absolutos das juntas no sistema real; outras plataformas usam suas próprias interfaces de ação. |
| Modelo de visão-linguagem (VLM) | Converte imagens e texto em recursos processados em conjunto | O backbone InternVL3-1B. |
| Alinhamento semântico | Preservar a correspondência entre o conteúdo da imagem e o significado da linguagem | “Lata de bebida” deve se relacionar à lata visível em vez de ao fundo irrelevante. |
Atenção: Preservar o alinhamento é um objetivo de projeto apoiado por visualizações de atenção e resultados de tarefas. Não é uma avaliação abrangente de todo o conhecimento de linguagem.
Ações de passo único e blocos
Predição de passo único gera apenas a ação atual. Agrupamento de ações em blocos prevê várias ações futuras em conjunto. O horizonte padrão do Evo-1 é de 50 passos.
Single-step: current images, instruction, state → aₜ
Action chunking: current images, instruction, state → [aₜ, aₜ₊₁, …, aₜ₊₄₉]
Exemplo ilustrativo: Para uma junta, três ângulos alvo podem ser [0.10, 0.12, 0.15] radianos. A predição de passo único os produz separadamente; o agrupamento prevê a sequência em conjunto. As saídas reais do Evo-1 são blocos multidimensionais de 50 passos.
Blocos modelam trajetórias contínuas, mas o ambiente pode mudar durante a execução. O artigo não especifica totalmente quantos passos são executados antes de uma nova observação, mistura de sobreposição ou replanejamento em cada plataforma. Prever 50 passos, portanto, não implica executar todos os 50 em malha aberta, e o comprimento do bloco não determina a frequência final de controle.
Distinguir três estágios
| Estágio | Entradas e operações | Resultado ou critério |
|---|---|---|
| Treinamento | Imagens de demonstração, instruções, estados e ações; ruído é adicionado às ações para aprender uma direção de geração. | Parâmetros do modelo; a perda mede o erro de predição de direção. |
| Inferência | Imagens atuais, instrução, estado e um novo bloco de ação ruidoso amostrado. | Gera ações futuras contínuas para execução. |
| Avaliação | Executar sob tarefas e condições iniciais especificadas. | Sucesso na tarefa, além de medições de VRAM e taxa de inferência em uma GPU especificada. |
Baixa perda de treinamento não implica diretamente alto sucesso em tarefas reais. O mecanismo de treinamento e as evidências de avaliação são discutidos separadamente abaixo.
Resumo: Tradução e Comentários
Tradução
VLAs unificam percepção, linguagem e controle, possibilitando tarefas diversas por meio de compreensão multimodal. No entanto, muitos têm grande contagem de parâmetros e dependem fortemente de pré-treinamento com grandes quantidades de dados de robôs, aumentando os custos de treinamento e limitando a implantação em tempo real. Algumas abordagens de treinamento também podem enfraquecer as representações perceptivas do backbone, levando a overfitting e fraca generalização em tarefas posteriores.
Evo-1 é um VLA leve que melhora a eficiência de implantação sem pré-treinamento com dados de robôs. Ele se baseia em um VLM nativamente multimodal com um Transformer de difusão com cross-modulation e um módulo de integração otimizado. Um processo de treinamento em duas etapas alinha progressivamente ações com percepção enquanto retém representações úteis do VLM.
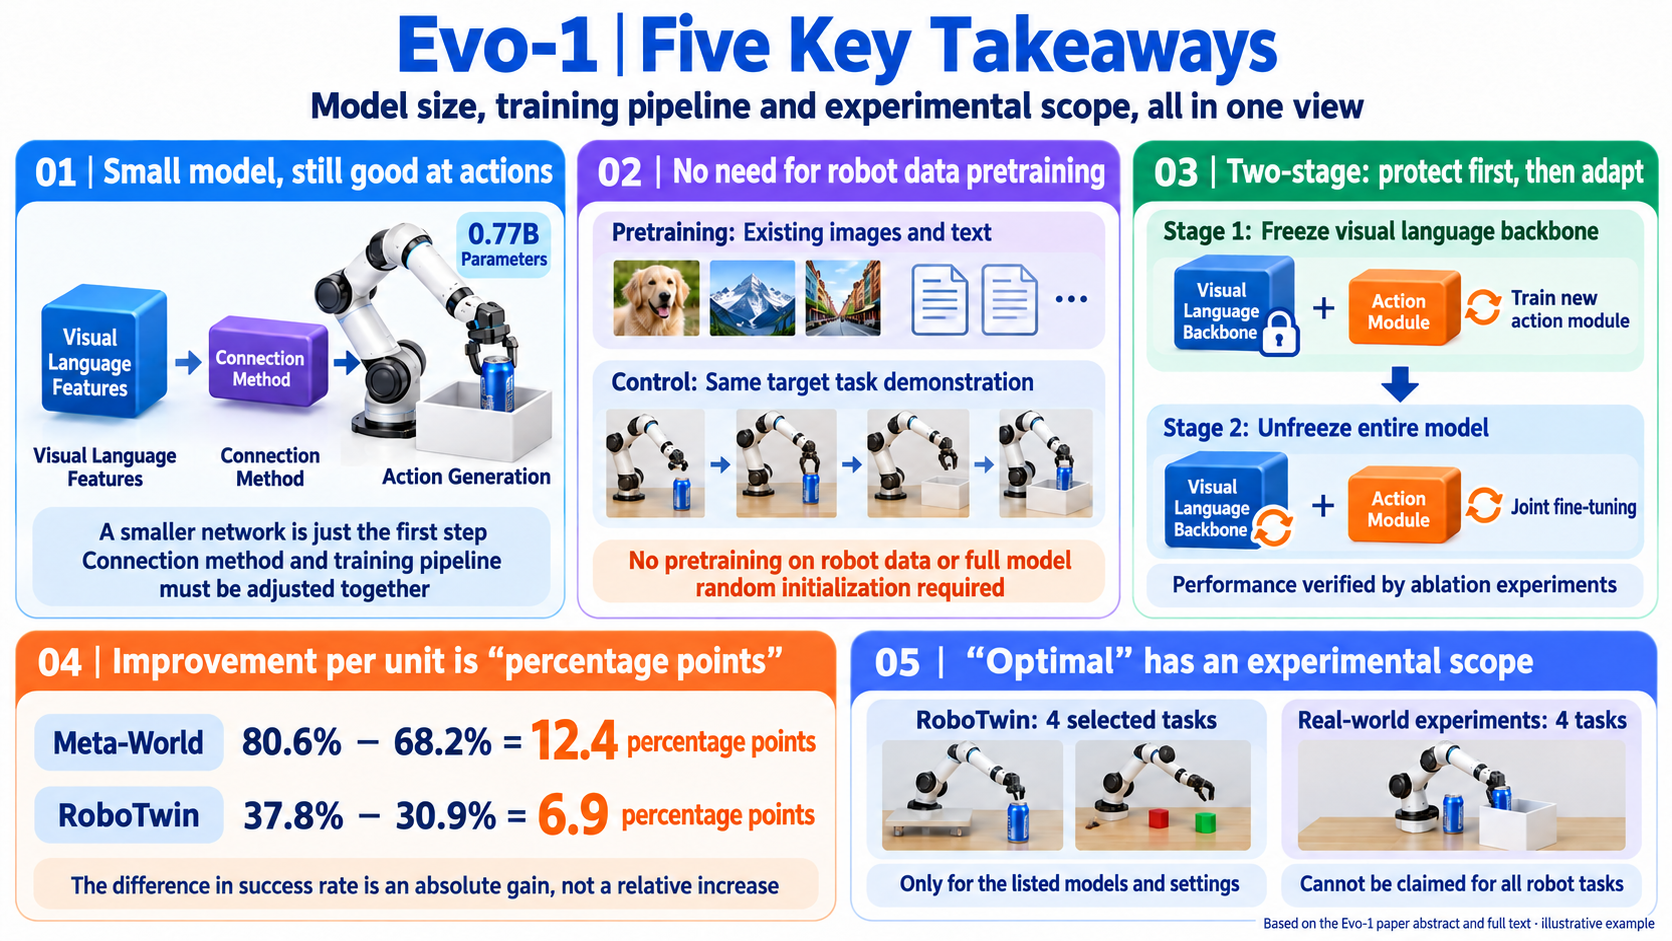
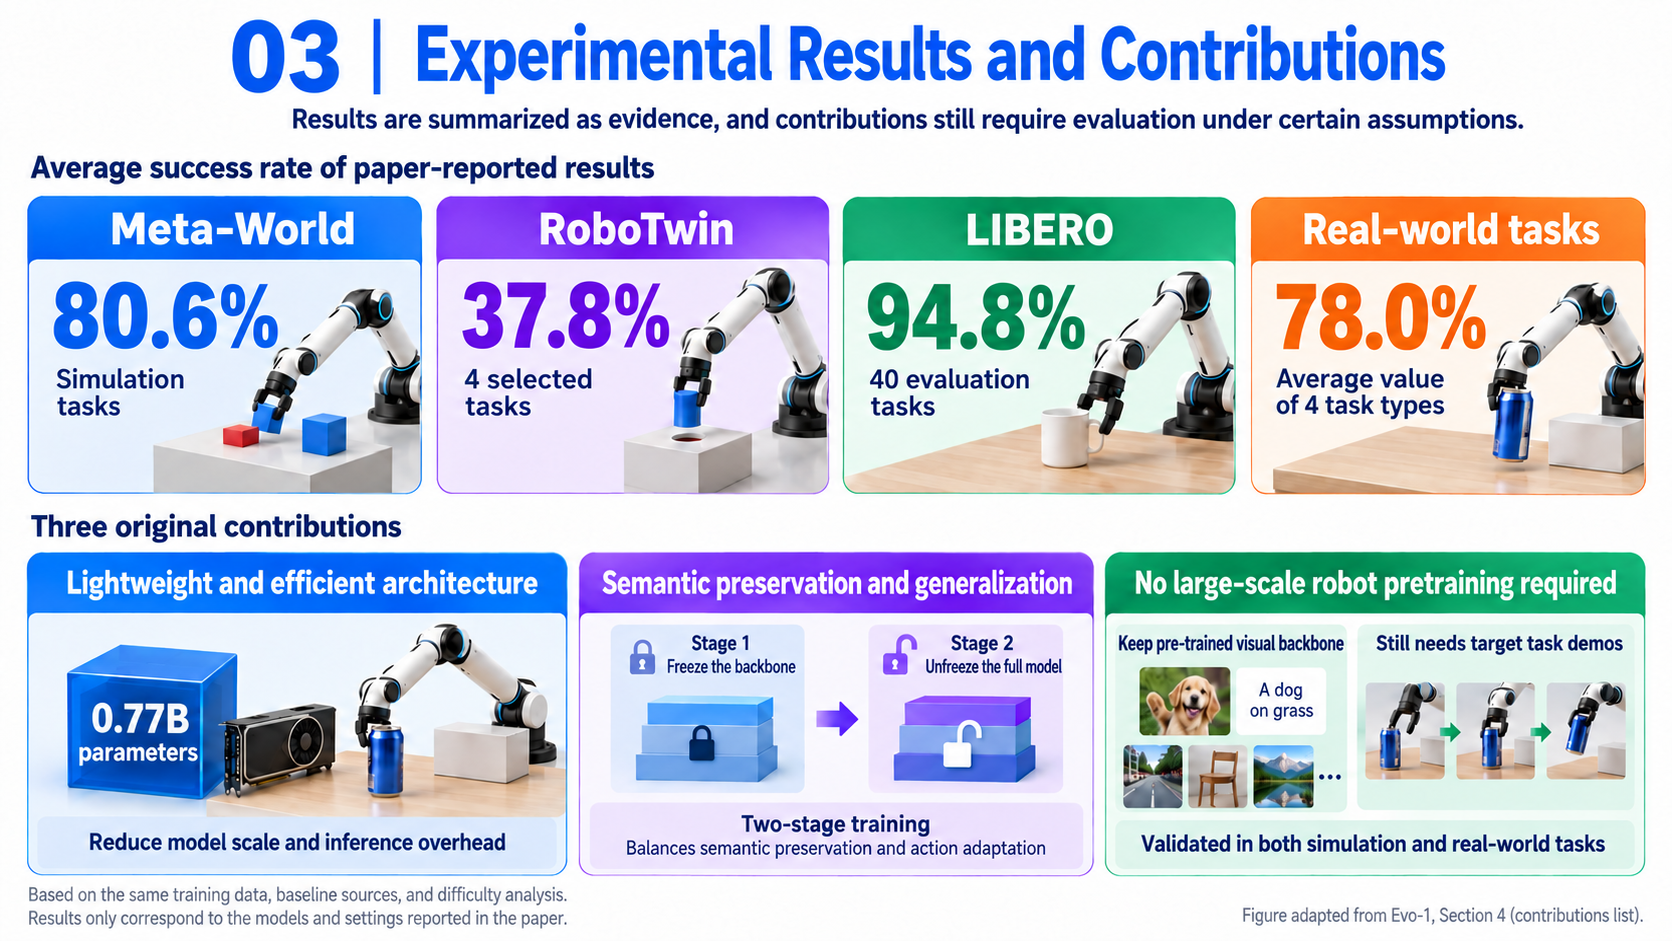
Com 770 milhões de parâmetros, o Evo-1 relata resultados de ponta na época da publicação em Meta-World e RoboTwin, superando os melhores resultados comparados em 12,4 e 6,9 pontos percentuais, e um competitivo 94,8% em LIBERO. A avaliação no mundo real relata 78% de sucesso médio com inferência rápida e baixo uso de memória, superando as linhas de base comparadas. Código, dados e pesos são disponibilizados.
Comentários
Introdução e Trabalhos Relacionados: Por que mudar a arquitetura e o treinamento?
Os quatro parágrafos principais da introdução
Relação com trabalhos anteriores
-
VLAs em larga escala: OpenVLA modela ações discretas, π0 usa um especialista de ação contínua, e Hi-Robot explora raciocínio hierárquico. Essas abordagens frequentemente usam backbones com bilhões de parâmetros. O Evo-1, em vez disso, comprime o backbone de visão-linguagem e usa um design distinto de integração e treinamento para ações downstream.
-
VLAs leves e eficientes: TinyVLA combina um VLM pequeno com um decodificador de ação por difusão. SmolVLA usa um especialista compacto de flow-matching, redução de camadas, redução de tokens e inferência assíncrona. O Evo-1 persegue objetivos de eficiência semelhantes com InternVL3, cross-attention empilhada e uma sequência de treinamento congelar-depois-descongelar.
Atenção: Estes são os dois grupos de trabalhos relacionados do artigo original. Eles não estabelecem que todo modelo grande exija pré-treinamento com robôs ou que projetos compactos vençam em toda tarefa.
Método central: Contexto estável para ações contínuas
Arquitetura, entradas e saídas
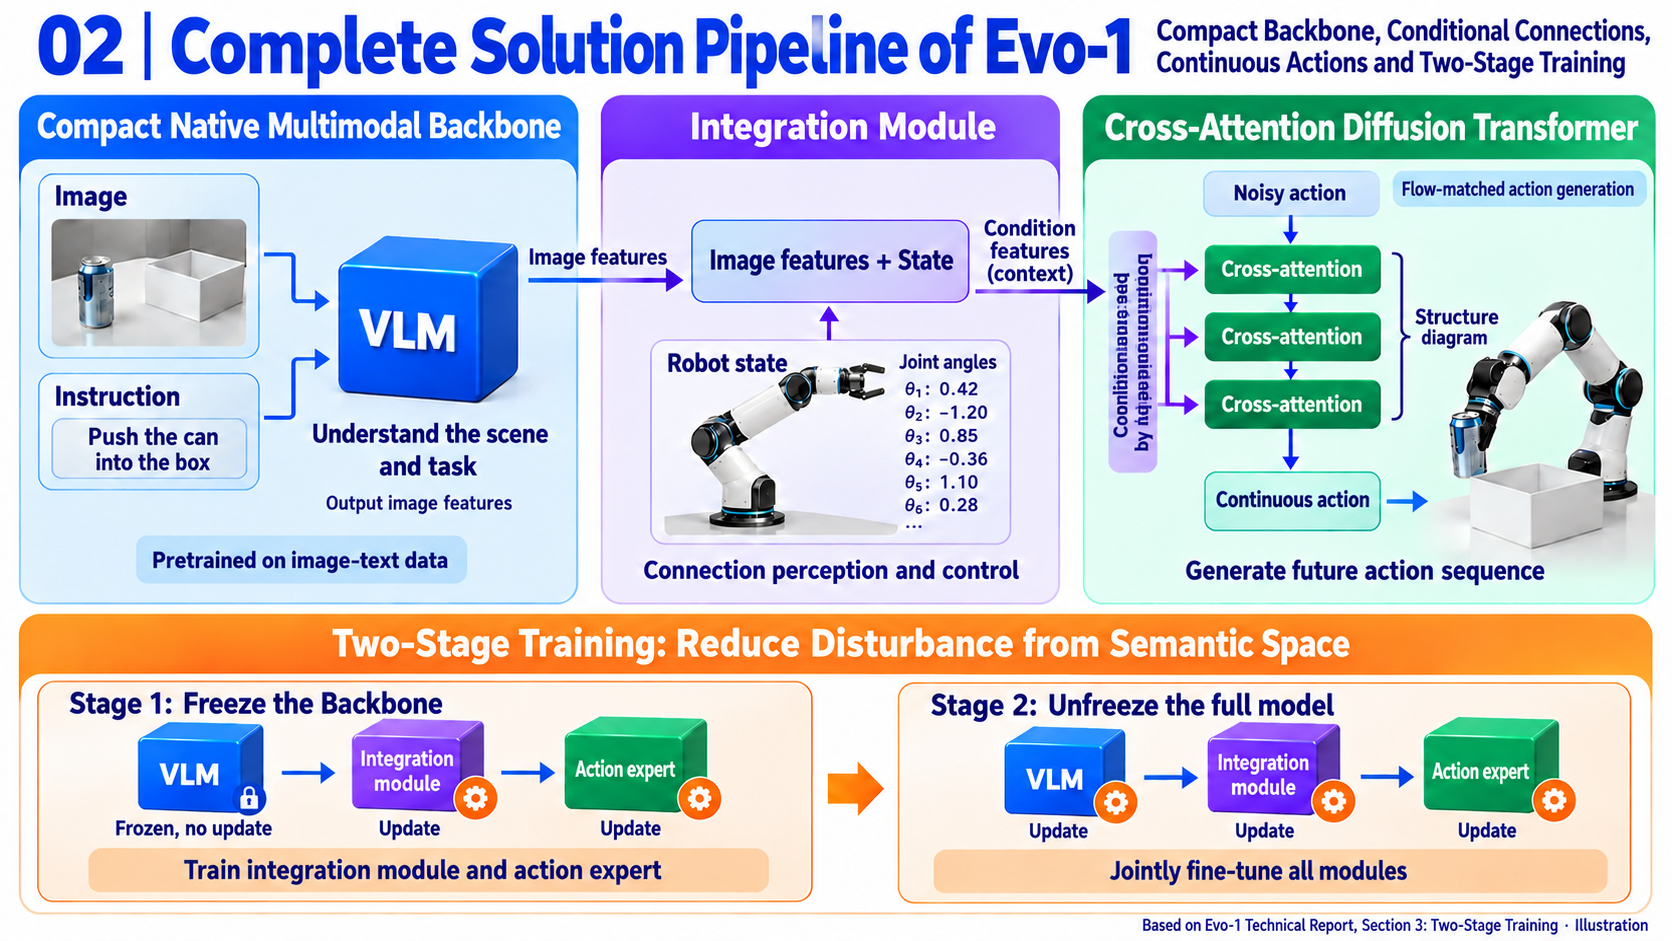
O modelo codifica o que vê e o que deve fazer, combina isso com o estado atual do robô e gera ações futuras a partir de ruído.
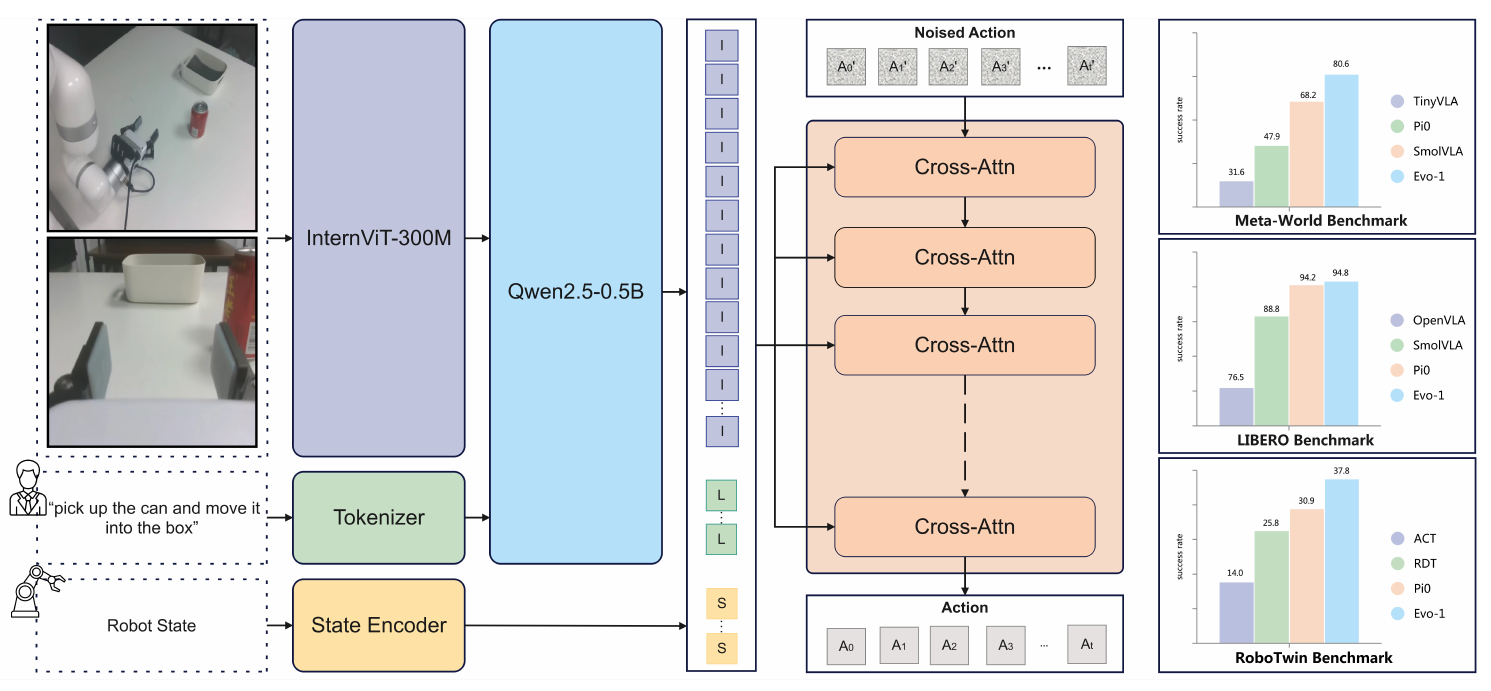
Artigo: Os três componentes são o backbone VLM, o módulo de integração e o Transformer de difusão com cross-modulation. O modelo completo tem 0,77B de parâmetros; não some o “1B” do nome InternVL3-1B ao total após o truncamento.
| Caminho | Entrada bruta | Codificação e processamento | Saída ou função |
|---|---|---|---|
| Visão | N vistas RGB atuais | Redimensionar cada uma para 448 × 448 × 3; extrair recursos InternViT-300M; pixel-unshuffle reduz a contagem de tokens visuais para um quarto. | Embeddings visuais entram na sequência imagem-texto. |
| Linguagem | Instrução em linguagem natural | Tokenizar e processar com as primeiras 14 camadas do ramo Qwen2.5-0.5B. | Recursos imagem-texto fundidos na camada 14. |
| Estado | Propriocepção do robô | Preencher para 24 dimensões por padrão; a Figura 1 inclui um codificador de estado. | Contexto de condicionamento para o especialista de ação. |
| Ação | Bloco de ação futura ruidosa | Forma padrão 50 × 24; processado por um Transformer especialista de oito camadas. | Atualizações de geração com a mesma forma e, por fim, um bloco de ação contínua. |
N é a contagem de câmeras e varia por plataforma; o xArm6 real usa duas. Tokens são elementos de sequência; tokens visuais são recursos contínuos, não palavras. Reduzir a contagem de tokens por meio de pixel-unshuffle não significa encolher a largura e a altura da imagem cada uma para um quarto.
Artigo: InternVL3 aprende conjuntamente representações de imagem-texto e de texto durante o pré-treinamento multimodal nativo. InternViT-300M é destilado de InternViT-6B. As incorporações visuais substituem os placeholders <img> designados antes do processamento conjunto com texto em um decodificador compartilhado. Evo-1 lê recursos da camada 14 e remove as camadas de linguagem subsequentes.
Formas ilustrativas: Um bloco de ação contém 50 × 24 = 1,200 números; um lote de 16 tem forma 16 × 50 × 24. A interface de 24 dimensões inclui preenchimento e não significa que o xArm6 tenha 24 juntas. Interprete dimensões efetivas e unidades de acordo com a interface de dados de cada plataforma.
Cuidado: O artigo não especifica totalmente a contagem de tokens visuais, a largura oculta de imagem-texto, a largura oculta do especialista em ações ou os detalhes de codificação de estado. Esses limites de implementação são mantidos sem inferir valores a partir dos nomes dos componentes. O codificador de estado da Figura 1 não deve ser omitido alegando que um vetor bruto 24D é adicionado diretamente a todos os recursos de imagem-texto.
Integração: Ler o Mesmo Contexto em Cada Camada
Problema: Os recursos de imagem-texto descrevem a cena e a tarefa, enquanto o estado descreve a configuração atual. A geração de ações deve manter acesso a essas condições para permanecer direcionada à tarefa.
Intuição: Tratar recursos multimodais e estado como uma fonte de informação compartilhada que cada camada de ação lê usando sua representação de ação atual. O projeto final é atenção cruzada em camadas intermediárias, Módulo A no artigo.
Na atenção cruzada, a consulta Q representa o que uma ação precisa saber; as chaves K correspondem a essa consulta, e os valores V fornecem o conteúdo recuperado. Artigo: concatenar recursos de imagem-texto da camada 14 e estado como K e V, com representações de ação ruidosas como Q. Todas as camadas de ação leem a mesma fonte de condicionamento.
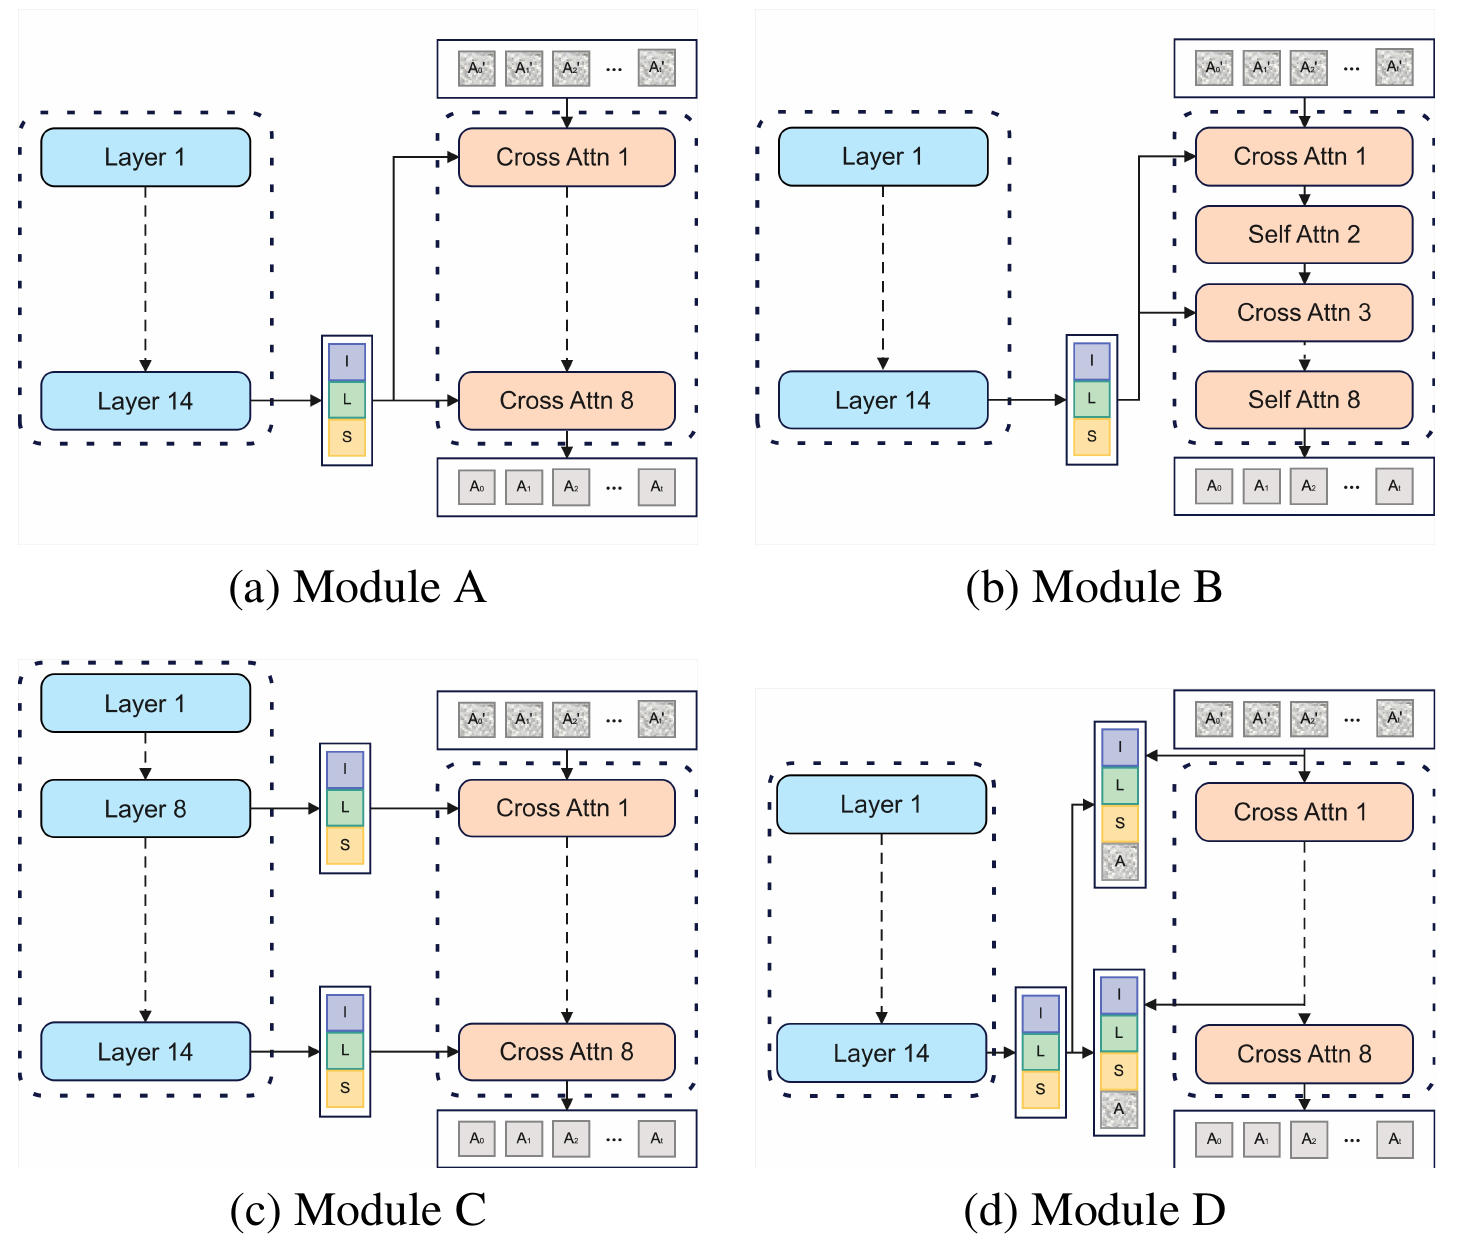
| Projeto | Conexão | Diferença em relação ao projeto final |
|---|---|---|
| A: Atenção cruzada em camadas intermediárias | Recursos de imagem-texto da camada 14 e estado fornecem K e V para cada camada de ação. | Projeto escolhido; condições consistentes entre as camadas. |
| B: Atenção cruzada/autorreferente intercalada em camadas intermediárias | Adicionar autoatenção após ler as condições. | Mais interações dentro da sequência de ações. |
| C: Atenção cruzada por camada | Diferentes camadas de ação leem recursos do VLM de diferentes profundidades mais o estado. | As condições variam com a profundidade da camada de ação. |
| D: Atenção cruzada com KV conjunto | Imagem-texto, estado e ações ruidosas entram todos em K e V. | As ações também se tornam contexto recuperado. |
Equação padrão de atenção para explicação, não uma perda adicional proposta pelo artigo:
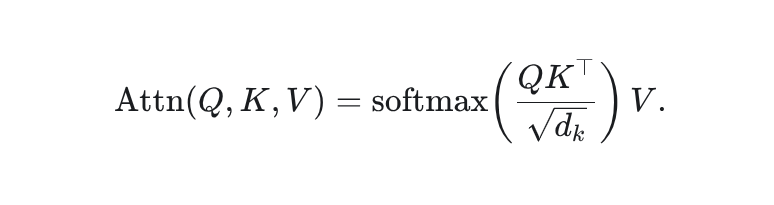
Com 50 posições de ação e M tokens de condicionamento, uma cabeça tem Q: 50 × d_k, K: M × d_k e V: M × d_v; sua saída é 50 × d_v. d_k e d_v são larguras de cabeça. Softmax normaliza as M correspondências para cada consulta. Estes são símbolos explicativos; o artigo não relata totalmente seus valores concretos.
Exemplo mínimo: Suponha que uma posição de ação atribua pesos [0.75, 0.25] a dois tokens, cujo valor selecionado em uma dimensão é [6, 2]. A recuperação dá 0.75 × 6 + 0.25 × 2 = 5. Este é um recurso interno, não um ângulo comandado. A próxima camada pode ler o contexto novamente com sua representação de ação atualizada.
Cuidado: O texto enfatiza concatenação em vez de projeção em um espaço de incorporação compartilhado, enquanto a Figura 1 inclui um codificador de estado. Interprete isso como preservação de condicionamentos separados antes da concatenação, não como evidência de que toda a rede não tem projeções ou codificadores. O eixo exato de concatenação e as larguras de codificação exigem detalhes de implementação.
Especialista em Ações: Gerar um Bloco com Flow Matching
Problema: Recursos de imagem-texto não podem ser usados diretamente como ângulos de juntas. Trajetórias futuras contêm muitos valores contínuos que devem ser gerados sob as condições da tarefa.
Intuição: Começar com um bloco de ruído aleatório e aprender em que direção mover seus valores em direção às ações demonstradas. “Diffusion Transformer” (DiT) descreve a arquitetura da rede; flow matching descreve o objetivo de treinamento. Os nomes são compatíveis.
Equação (3) do artigo:
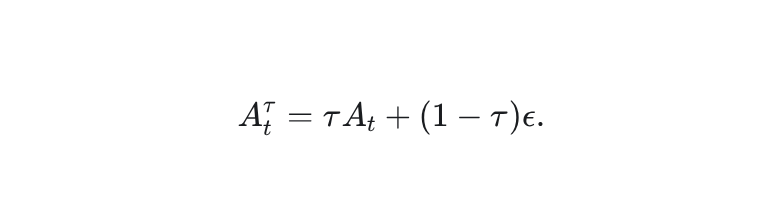
t é o tempo de observação; A_t é o bloco demonstrado começando então; ε é ruído com o mesmo formato; τ é o progresso interno de geração, distinto do tempo do robô. Ambos os arrays têm padrão 50 × 24. O τ adimensional é amostrado de uma distribuição Beta e restrito a [0.02, 0.98]; os parâmetros da Beta não são especificados.
Exemplo mínimo: Para um elemento, tome ação 0.6, ruído −0.2 e τ=0.5; o valor interpolado é 0.2. Nesse caminho linear, τ=0 é ruído e τ=1 é dado, embora o treinamento amostre apenas o intervalo truncado.
Equação (4), com fontes de amostragem abreviadas:
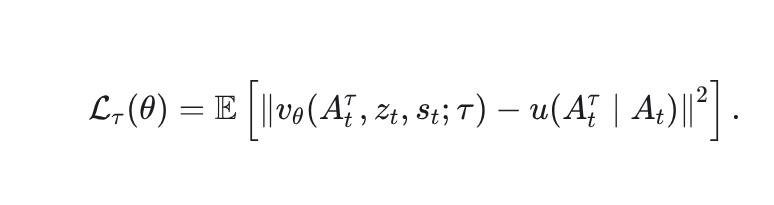
θ denota parâmetros treináveis; z_t recursos de imagem-texto; e s_t estado proprioceptivo. v_θ é o campo de velocidade condicionado ao tempo previsto, e u a direção-alvo de geração, ambos com o formato do bloco de ação. A norma ao quadrado compara erros direcionais em cada elemento, com expectativa sobre ações de demonstração e amostras com ruído. A equação original omite a condição de tempo dos argumentos da rede; τ é mostrado aqui para corresponder à descrição no texto de um campo de velocidade condicionado ao tempo.
Explicação: Diferenciar o caminho linear na Equação (3) dá A_t−ε; esta é uma interpretação da equação, não uma expansão explícita de u no artigo. No exemplo, a direção-alvo é 0.8; prever 0.7 dá erro quadrático 0.01. O modelo aprende como mover a estimativa, em vez de regredir diretamente valores ruidosos para respostas finais.
A inferência prevê repetidamente direções e atualiza ruído novo sob condicionamento de imagem-texto e estado, produzindo [âₜ, âₜ₊₁, …, âₜ₊₄₉]. O especialista usa oito camadas de Transformer com atenção cruzada empilhada, em vez de autoatenção alternada.
Atualização discreta ilustrativa:
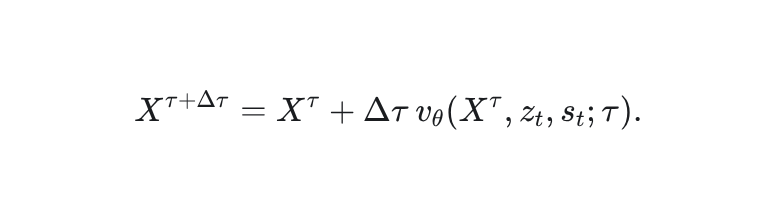
X^τ é a estimativa atual e Δτ um tamanho de passo interno adimensional. Esta atualização de Euler explica o campo de velocidade; não é um algoritmo de inferência totalmente especificado pelo artigo. Exemplo: um valor de 0.2, direção prevista 0.8 e passo 0.1 atualizam para 0.28.
Cuidado: O número de atualizações internas, o solucionador numérico e o cronograma de execução não são totalmente relatados. Oito camadas de Transformer não significam oito etapas de remoção de ruído, e τ não é o tempo de movimento do robô. Gerar conjuntamente um bloco também não implica ações independentes.
Treinamento em Duas Etapas: Adaptar Novos Módulos a Recursos Existentes Primeiro
Problema: O backbone já tem capacidades de imagem-texto, mas o especialista em ações é recém-inicializado. Treinar tudo imediatamente pode permitir que os gradientes dos novos módulos distorçam representações úteis em direção a um conjunto limitado de demonstrações.
Intuição: Primeiro ensinar os módulos de ação a usar recursos existentes, depois permitir adaptação conjunta. O mecanismo concreto é controlar quais parâmetros recebem atualizações.
| Etapa | Backbone VLM | Módulo de integração e especialista em ações | Propósito |
|---|---|---|---|
| 1: Alinhamento do especialista em ações | Totalmente congelado | Treinável | Conectar recursos perceptuais fixos às ações. |
| 2: Fine-tuning de modelo completo | Descongelado e treinável | Continuar treinamento | Adaptar conjuntamente o controle downstream a partir do checkpoint da etapa 1. |
Artigo: Todos os experimentos usam treinamento distribuído em oito GPUs NVIDIA A100. Meta-World usa 10.000 etapas na etapa 1 e 65.000 na etapa 2; ambas usam taxa de aprendizado 1×10⁻⁵, tamanho de lote 16, 1.000 etapas de aquecimento, clipping de gradiente 1,0 e weight decay 0,001. O dropout do especialista tem padrão 0,2 e a augmentação permanece habilitada. Outros benchmarks usam a mesma abordagem em duas etapas com passos ajustados para o tamanho do conjunto de dados (página 11, Tabelas 4 e 5).
Exemplo: Um erro de previsão atualiza apenas novos módulos na etapa 1, mas também pode alterar o backbone na etapa 2. As etapas não são dois tipos de robô, nem pré-treinamento com dados de robô seguido de treinamento de tarefa.
Nenhuma perda explícita de preservação semântica é adicionada; o objetivo de ação relatado é flow matching. A retenção semântica depende principalmente da inicialização e da ordem de treinamento, enquanto a etapa 2 ainda altera o backbone. O artigo não fornece tempo de relógio de parede nem custo total de treinamento, portanto baixo custo não deve ser interpretado como concluir todo o treinamento em uma única GPU de consumidor.
Treinamento e Inferência de Ponta a Ponta
Training: demonstration images + instruction → VLM layer-14 image-text features
          demonstrated state → state encoding / integration context
          action chunk + random noise + generation progress → noisy chunk
          context + noisy chunk → action expert → direction prediction → flow-matching loss
          update new modules in stage 1; update the full model in stage 2

Inference: current images + instruction → image-text features
           current state → conditioning context
           fresh noisy chunk → repeated time-conditioned expert updates
           → 50-step continuous prediction → platform control interface → later observations
Visão em uma frase: Um backbone compacto interpreta a cena e o objetivo; a integração fornece contexto persistente; o flow matching transforma ruído em trajetórias; o treinamento em duas etapas controla como percepção e ação se adaptam.
Experimentos: Onde os ganhos se aplicam
Simulação: Médias fortes com resultados individuais desiguais
| Benchmark e escopo | Treinamento e avaliação | Sucesso médio do Evo-1 | Principal comparação |
|---|---|---|---|
| Meta-World, 50 tarefas | 50 demonstrações por tarefa, 2.500 no total; 10 avaliações por tarefa, em média em cinco execuções independentes. | 80,6% | SmolVLA 68,2%; +12,4 pontos percentuais. |
| LIBERO, 40 tarefas em quatro suítes | Spatial / Object / Goal / Long; 10 avaliações por tarefa, em média em cinco execuções. | 94,8% | π0 94,2%; +0,6 pontos percentuais. |
| Quatro tarefas selecionadas do RoboTwin 2.0 | 50 demonstrações por tarefa; configurações fácil e difícil; o texto relata 100 tentativas de avaliação. | 37,8% | π0 30,9%; +6,9 pontos percentuais. |
Fonte: página 5 do PDF, Tabela 1; configurações experimentais nas páginas 5–6; suplementos nas páginas 12–13. A distribuição dos “100 testes” do RoboTwin entre os níveis de dificuldade não é clara, portanto nenhum total adicional é inferido. Esta versão não declara claramente o número de demonstrações LIBERO por tarefa.
Artigo: Os grupos de dificuldade do Meta-World obtêm 89,2%, 76,8%, 77,2% e 79,2%, todos acima das linhas de base listadas. Os grupos do LIBERO obtêm 92,7%, 97,7%, 96,3% e 92,3%. Object, Goal e Long lideram, mas Spatial fica abaixo dos 96,8% de π0. Uma vantagem média não significa vencer em todas as categorias.
Os ganhos no RoboTwin se concentram em Click Alarmclock: 77% / 58% para fácil / difícil, em comparação com 63% / 11% de π0. Falhas difíceis permanecem: Place Can Basket difícil atinge apenas 1%, abaixo dos 5% de π0. Esses resultados apoiam a eficácia em tarefas bimanuais selecionadas, não uma solução abrangente para cenas difíceis.
Cuidado: As linhas de base do Meta-World e do LIBERO vêm de artigos ou reproduções existentes, e as linhas de base do RoboTwin vêm de seu artigo oficial; nem todos os métodos foram retreinados de forma uniforme aqui. A Tabela 1 rotula SmolVLA como 2,25B, enquanto a Tabela 2 de eficiência usa 0,45B. A discrepância não é totalmente explicada, portanto não os trate como uma configuração idêntica.
Sistema real: duas visões RGB e ângulos articulares absolutos
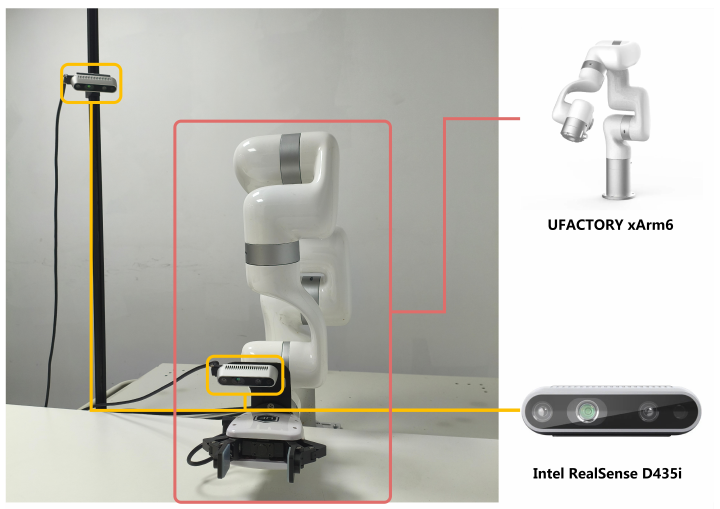
| Item | Configuração no artigo |
|---|---|
| Robô | xArm6 de seis DoF com um gripper paralelo, controlado pela xArmAPI oficial. |
| Visão | Câmeras RGB fixas de ambiente e de pulso; a capacidade de profundidade do dispositivo não é tratada como entrada. |
| Gravação | Formato LeRobot v2.1; observações sincronizadas gravadas a 30 Hz. |
| Estado e ação | Ângulos articulares absolutos, consistentes com supervisão e replay; a interface acolchoada do modelo tem 24 dimensões. |
| Demonstrações e avaliação | 100 demonstrações teleoperadas para cada uma das quatro tarefas, 400 no total; 20 testes por tarefa, 80 no total. |
Fonte: página 6 e páginas 14–15. Resolução bruta da câmera, durações das demonstrações e o mapeamento completo do campo do gripper não são explicitamente relatados. 448 × 448 é o tamanho de entrada do modelo.
Desempenho no mundo real e eficiência de inferência
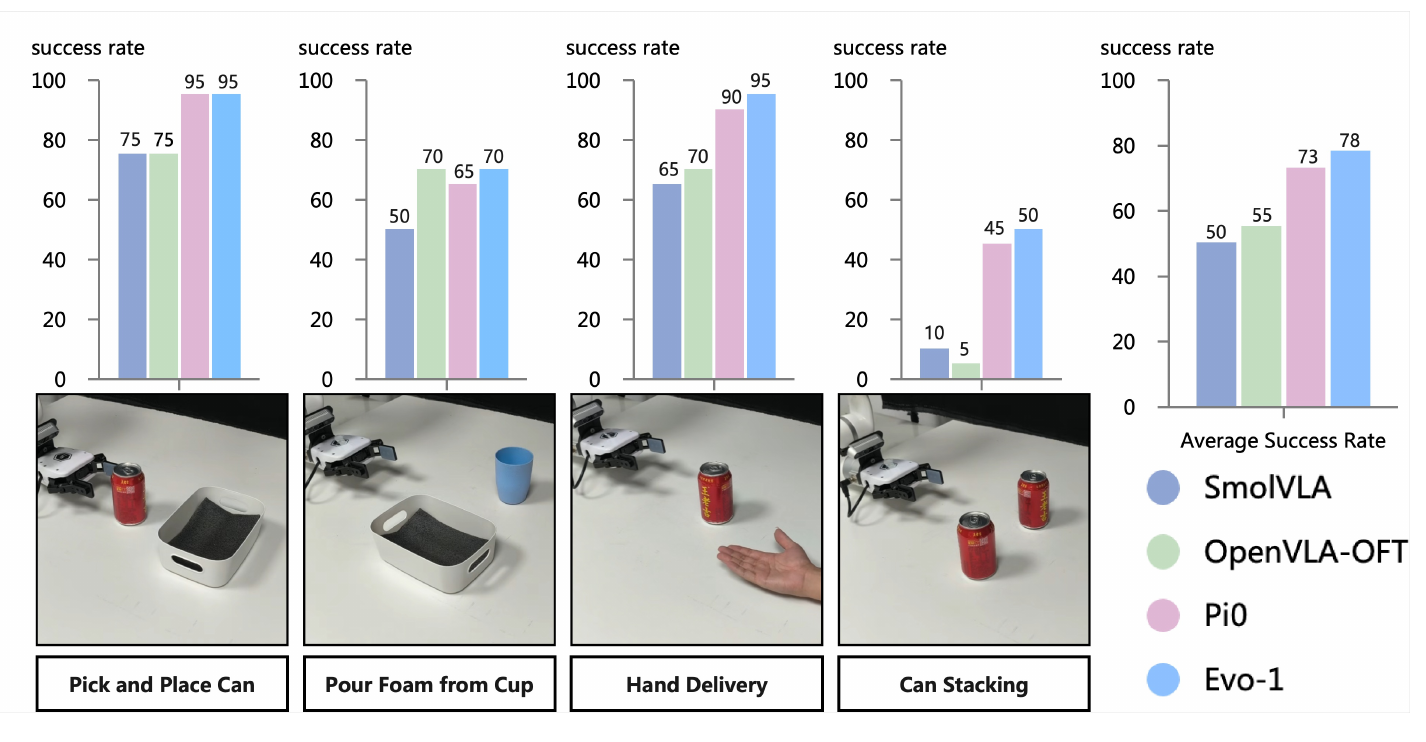
| Tarefa | Critério de sucesso no artigo | Sucesso do Evo-1 |
|---|---|---|
| Pegar e colocar uma lata | Inteiramente dentro da caixa branca, estável e sem rolar para fora. | 95% |
| Despejar espuma de um copo | A maior parte da espuma entra na caixa branca, com acúmulo visível e pouco derramamento. | 70% |
| Entregar uma lata para uma pessoa | Colocada com segurança na mão sem que a pessoa precise perseguir ou se ajustar para pegá-la. | 95% |
| Empilhar latas | A lata superior permanece estável por pelo menos dois segundos sem escorregar ou cair. | 50% |
Fonte: Figura 4 e critérios de sucesso na página 15. A média das quatro tarefas é 77,5%, relatada como 78%; isso não é uma pontuação de 78% em cada tarefa. Empilhar continua sendo uma fraqueza.
Tabela 2: medições na GPU RTX 4090d especificada.
| Modelo | Parâmetros | VRAM média de inferência | Taxa média de inferência | Sucesso médio em tarefas reais |
|---|---|---|---|---|
| SmolVLA | 0.45B | 2.0 GB | 12.7 Hz | 50.0% |
| OpenVLA | 7.0B | 15.1 GB | 7.9 Hz | 55.0% |
| π0 | 3.5B | 17.9 GB | 11.5 Hz | 73.0% |
| Evo-1 | 0.77B | 2.3 GB | 16.4 Hz | 78.0% |
Fonte: página 7, Tabela 2. A Figura 4 e o texto de resultados chamam uma linha de base de OpenVLA-OFT, enquanto a Tabela 2 a chama de OpenVLA. Os nomes são mantidos sem assumir configurações de implementação idênticas.
Evo-1 tem a inferência mais rápida e o maior sucesso médio nesta comparação, mas uso de VRAM ligeiramente maior que o SmolVLA. O valor de 2,3 GB é memória média de inferência, não memória de treinamento nem garantia dessa taxa em qualquer dispositivo de 2,3 GB.
Cuidado: 30 Hz é a frequência de gravação das demonstrações; 16,4 Hz é a frequência de inferência na GPU; 50 é o horizonte de predição. Esses valores descrevem estágios diferentes. A latência completa percepção–comunicação–execução não é relatada, portanto 16,4 Hz não deve ser descrito como a taxa final de controle do robô.
Generalização: distratores e mudanças de posição em uma tarefa
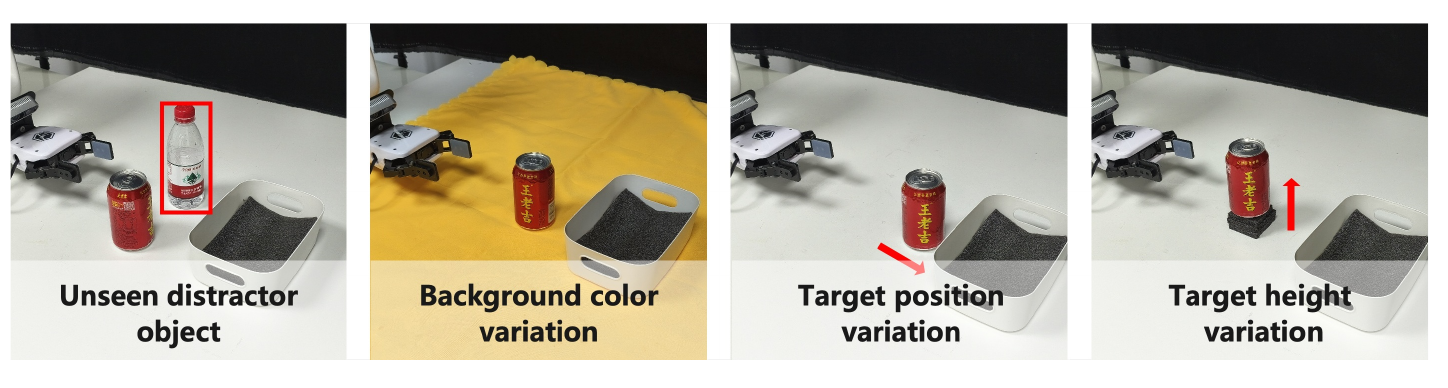
O teste de generalização usa colocação de lata na caixa com 20 testes por perturbação. Os autores definem essas mudanças como fora da distribuição de treinamento.
| Condição | SmolVLA | Evo-1 |
|---|---|---|
| Cena base | 75% | 95% |
| Garrafa não vista adicionada | 65% | 80% |
| Toalha de mesa amarela adicionada | 60% | 75% |
| Alvo movido para trás 10 / 20 / 30 mm | 75% / 60% / 60% | 95% / 85% / 80% |
| Alvo elevado em 10 / 20 / 30 mm | 75% / 65% / 60% | 100% / 90% / 70% |
Fonte: página 7, Tabela 3. Deslocamento e altura são medidos em milímetros.
Interpretação: Os resultados apoiam a adaptação a essas mudanças locais, com Evo-1 acima do SmolVLA comparado em cada condição. Elevar o alvo em 30 mm reduz o sucesso para 70%. Com 20 testes, um único sucesso altera a pontuação em cinco pontos percentuais; pequenas diferenças não devem ser tratadas como leis universais. Isso não testa generalização zero-shot para objetos, tarefas ou robôs arbitrários.
O suplemento também mostra um SO-100 pegando um pequeno bloco e colocando-o em um recipiente fixo (páginas 15 e 19). Sem medições comparáveis de sucesso, número de demonstrações ou eficiência, isso é uma demonstração de implantação em vez de prova quantificada de transferência entre robôs sem adaptação.
Ablations e limites das evidências
O condicionamento persistente ajuda?
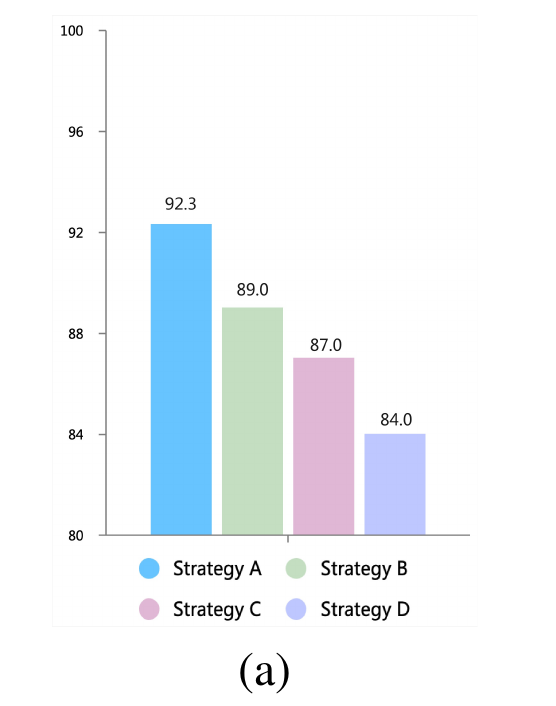
Artigo: Os módulos A, B, C e D alcançam 92,3%, 89,0%, 87,0% e 84,0%. A supera B em 3,3 pontos percentuais e é escolhido para o modelo final.
Interpretação: Isso apoia ler repetidamente os mesmos recursos intermediários de imagem-texto e estado. Os autores atribuem o ganho a um condicionamento mais contínuo, mas o experimento compara quatro projetos completos em vez de isolar cada fator. Ele não mostra que self-attention é geralmente prejudicial ou que fusão de recursos em múltiplas camadas é sempre inferior.
O treinamento em duas etapas ajuda?
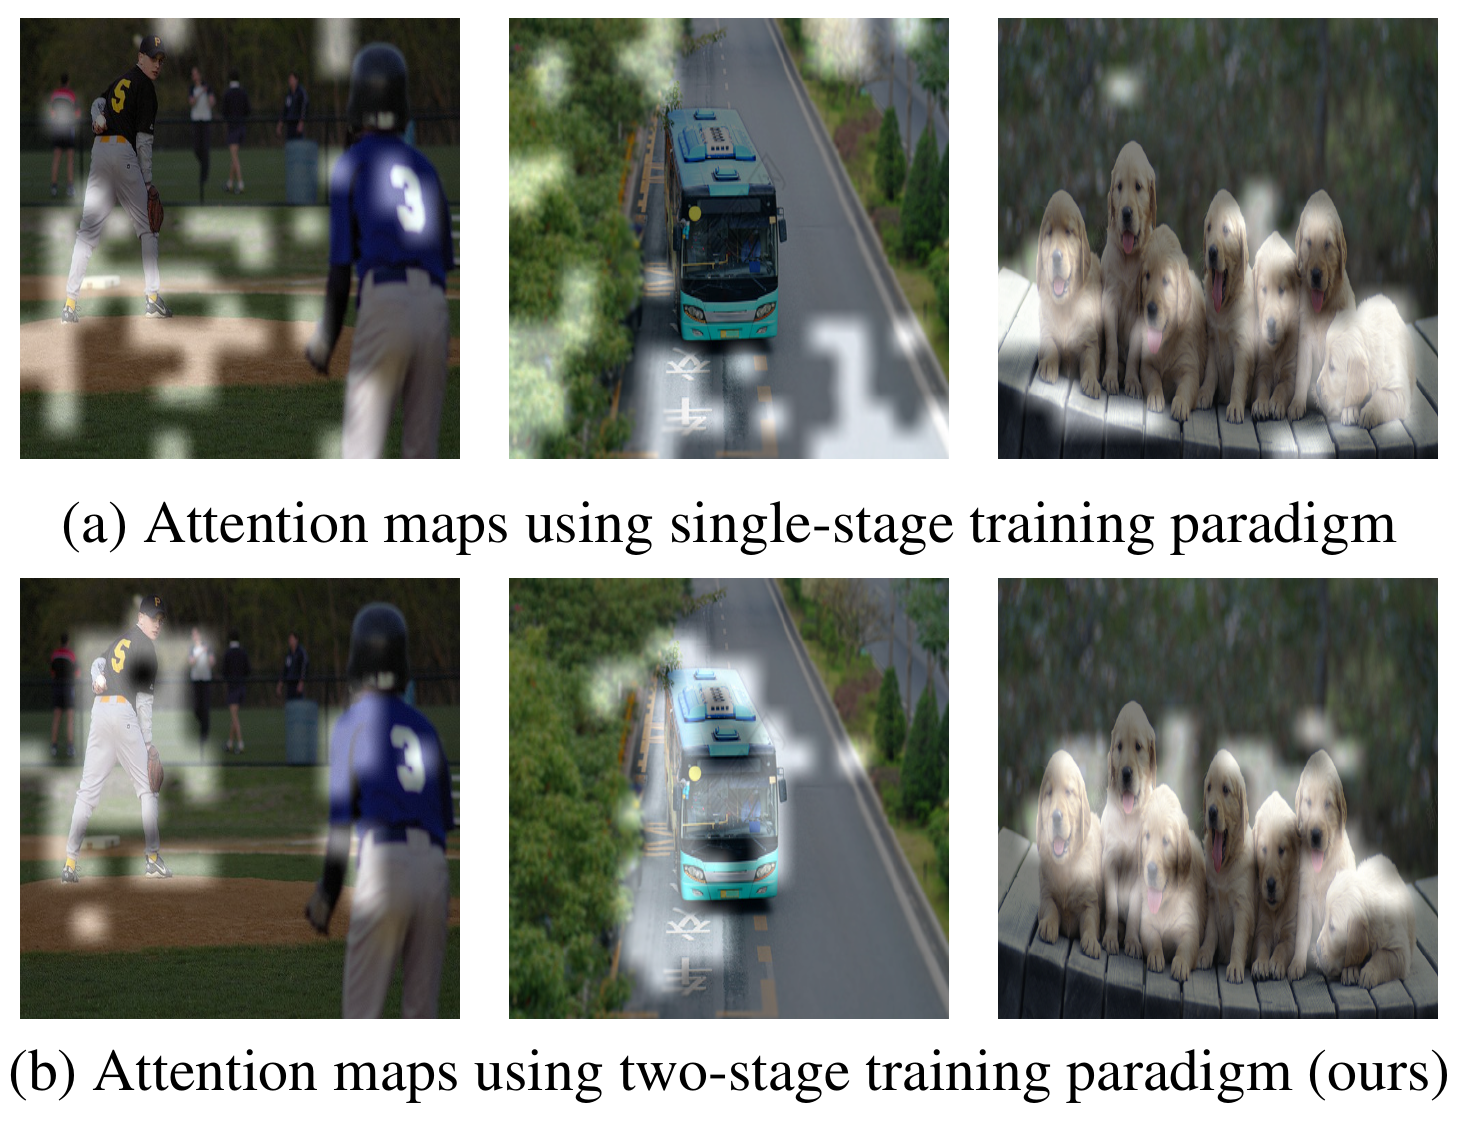
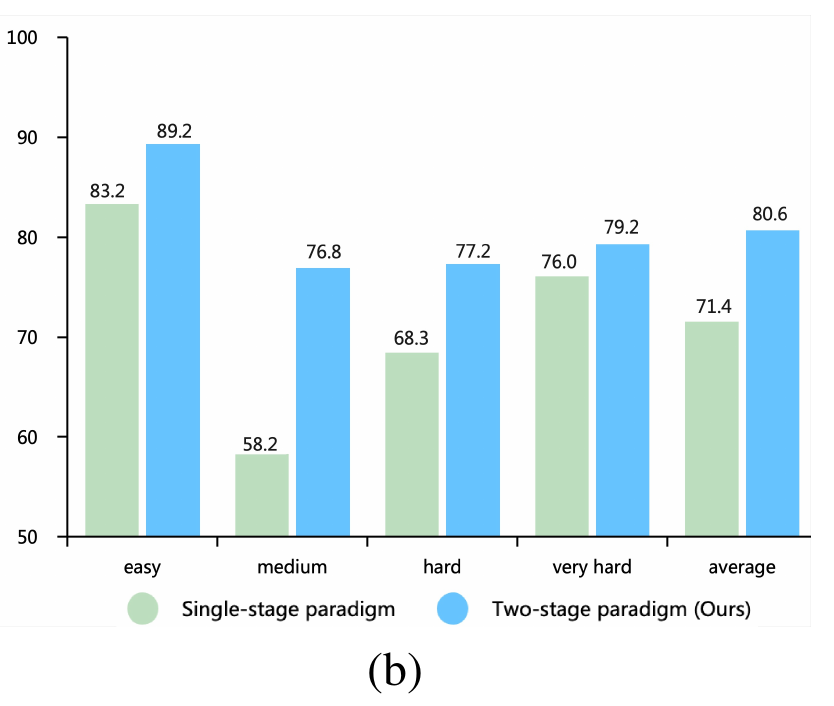
Artigo: O treinamento em duas etapas vence em todos os quatro grupos de dificuldade, com média de 80,6% contra 71,4%, um ganho de 9,2 pontos. O treinamento em uma etapa atualiza todos os módulos imediatamente; o treinamento em duas etapas congela primeiro o backbone e depois faz fine-tuning conjunto.
Interpretação: A comparação controlada de taxa de sucesso apoia a ordem de treinamento. Mapas de atenção sugerem foco imagem-texto mais claro. A Figura 2 também compara Evo-1 e OpenVLA, mas backbones e tamanhos diferentes impedem usar apenas essa comparação para estabelecer o efeito causal do treinamento em duas etapas; a ablação com a mesma arquitetura é mais direta.
Cuidado: Não há uma avaliação quantitativa abrangente de question answering visual geral, compreensão de linguagem ou esquecimento semântico. A retenção semântica tem visualização local e evidência em tarefas, não prova de que todo o conhecimento pré-treinado é preservado.
O que levar consigo
Evo-1 combina um backbone multimodal nativo compacto truncado, condicionamento estável por cross-attention e alinhamento antes do fine-tuning conjunto. Essa combinação de 0,77B tem bom desempenho nas tarefas simuladas e reais relatadas. O especialista de ação baseado em flow matching ainda requer demonstrações da tarefa-alvo.
Mantenha a conclusão dentro das evidências: RoboTwin cobre quatro tarefas selecionadas, o empilhamento real de latas tem sucesso 50% do tempo, e a generalização cobre algumas mudanças em uma tarefa. A eficiência depende de medições na RTX 4090d, enquanto o treinamento usa oito A100. O artigo mostra o valor do design de arquitetura e treinamento para VLAs pequenos, não a substituição universal de modelos maiores ou implantação direta em robôs arbitrários.