G0.5: Raciocínio e Ação em uma Única Sequência
Galaxea G0.5: Um Único Fluxo Autoregressivo para Raciocínio e Ação em Robôs
arXivLeia o artigoEquipe Galaxea · arXiv:2608.11739v1 · 12 de agosto de 2026 · página do projeto Galaxea
Um robô é solicitado a abrir uma gaveta, despejar algumas nozes e fechá-la. Na primeira vez que o robô vê a maçaneta, ele precisa estender o braço e puxar. Depois de despejar as nozes, ele vê a mesma maçaneta e precisa empurrar a gaveta para fechá-la. Um modelo de visão e linguagem pode gerar tanto o que fazer agora quanto como o braço deve se mover em seguida? Essa é a questão que o G0.5 aborda.
Pré-requisitos: Predizendo um Bloco de Ação
Um modelo de visão-linguagem-ação (VLA) aprende a partir de demonstrações a transformar imagens de câmera, instruções de tarefa e o próprio estado do robô em comandos de controle. O estado inclui medições como posições das juntas. Quando o robô abre a gaveta, a imagem mostra onde está a maçaneta, o estado descreve a pose atual do braço, e as ações aproximam a garra, fecham-na e puxam.
Um bloco de ação é uma sequência de ações ordenadas pelo passo de controle. Uma política de passo único prediz no tempo . Uma política de blocos prediz a partir da mesma observação, em que é o vetor de controle para o passo . O robô pode executar os primeiros passos e então replanejar usando uma nova observação. O tempo necessário para gerar um bloco, o número de passos executados a partir dele e a frequência de controle de baixo nível são quantidades separadas.
Autoregressivo (AR) descreve como o G0.5 gera um bloco. Seu modelo de visão e linguagem (VLM) prediz um token por vez e usa os tokens que já gerou para predizer o próximo. Ele pode escrever “agarre a maçaneta” e então continuar com códigos de ação comprimidos. O codec de ação transforma esses códigos em comandos de controle contínuos antes da execução.
Resumo e Guia de Leitura
Resumo em poucas palavras. Muitos VLAs usam um VLM pré-treinado para codificar a cena e a instrução, depois delegam o controle a um especialista em ação de flow-matching (FM) treinado separadamente. O G0.5 da Galaxea usa um único decodificador Transformer e um único objetivo de treinamento para tokens de raciocínio e de ação. Os autores treinam um tokenizador de ação entre diferentes corpos, inserem raciocínio incorporado, como subtarefas e localizações de alvo, na sequência de geração e usam o codificador de visão para processar vários segundos de histórico visual. Eles relatam que prompts podem mudar como o modelo decompõe ou executa uma tarefa, com algumas mudanças de comportamento observadas sem treinamento adicional.
Os autores pré-treinam em uma mistura de dados de robôs e exemplos de visual question answering (VQA) e relatam sete avaliações. Após ajuste fino em R1-Lite e R1-Pro, o sucesso médio em robôs reais é de 76,7% para o G0.5, 53,3% para o π₀.₅ e 24,4% para o GR00T-N1.7. Nas 50 tarefas domésticas de longo horizonte do BEHAVIOR Challenge 2025, a pontuação de progresso de uma única política é de 31,4% para o G0.5, 26,3% para o π₀.₅ e 26,1% para a submissão vencedora. As avaliações restantes cobrem transferência para ambientes e objetos reservados após pós-treinamento no DROID (82,5%), seguimento de instruções em pick-and-place, LIBERO (98,9%), RoboTwin 2.0 (93,3%) e SimplerEnv-Bridge (87,3%).
Notas de leitura
- A compressão de ações torna prática a geração token a token. Um movimento de braço abrange vários passos e canais de controle. Comprimir a sequência no tempo e omitir tokens para partes ociosas aborda duas fontes de comprimento.
- O decodificador pode usar o raciocínio que acabou de gerar. Quando uma caixa delimitadora ou uma subtarefa vem antes da ação, o decodificador pode condicionar suas próximas predições nessa saída. O artigo alterna o raciocínio para testar se ele ajuda.
- As avaliações medem diferentes tipos de generalização. DROID testa a transferência para novos ambientes e objetos após pós-treinamento específico do conjunto de dados. BEHAVIOR mede quantas condições de objetivo uma única política pós-treinada satisfaz em 50 tarefas.
Motivação e Trabalhos Relacionados
O artigo começa com a discretização de ações em RT-2 e OpenVLA. Frequências de controle mais altas, mais dimensões de ação ou horizontes de predição mais longos tornam mais caro tokenizar cada valor individualmente. Um especialista em ações contínuas pode emitir um bloco inteiro enquanto o VLM fornece seu condicionamento. Os autores perguntam como dar às habilidades de linguagem e raciocínio do VLM pré-treinado um papel mais direto no controle.
O G0.5 aprende um codec de ação entre diferentes corpos, coloca uma cadeia de pensamento na sequência de ação e investiga se mudar a formulação de uma instrução afeta o comportamento. A memória visual fornece observações recentes. Os autores examinam essas ideias por meio de benchmarks de controle, testes de seguimento de instruções e tarefas de longo horizonte divididas em etapas. Os resultados sobre formulação de prompts são observações qualitativas de uma amostra pequena.
- Comprimindo tokens de ação. FAST usa uma transformada cosseno discreta para explorar a redundância temporal. O G0.5 aprende um vocabulário compartilhado organizado por parte do corpo e pode omitir grupos ociosos.
- Passando o raciocínio para o controle. ECoT já permite que a predição autoregressiva de ações leia tokens de raciocínio anteriores. O G0.5 usa uma interface de ação entre diferentes corpos e prompts que selecionam entre subtarefas, caixas delimitadoras, trajetórias e dicas de ação.
Como G0.5 e π₀.₅ Usam Subtarefas
Ambas as abordagens podem gerar primeiro a subtarefa atual. Depois de despejar as nozes, o π₀.₅ pode gerar “empurre a gaveta para fechar”, depois deixar que um especialista em ações contínuas produza o movimento a partir de suas entradas de condicionamento. No caminho principal do G0.5, o decodificador continua a partir da subtarefa em códigos de ação discretos, que o ActionCodec converte em movimento contínuo.
| Aspecto | π₀.₅ | G0.5 |
|---|---|---|
| Saída em alto nível | Texto de subtarefa gerado autoregressivamente | Subtarefas opcionais, caixas delimitadoras, trajetórias 2D e dicas de ação |
| Saída de ação | Um especialista de flow-matching gera controles contínuos | O mesmo decodificador continua com códigos discretos, que o ActionCodec decodifica em controles contínuos |
| Papel dos tokens de ação discretos | Tokens FAST são usados no pré-treinamento. Um especialista contínuo lida com a execução. | Tokens ActionCodec são usados no pré-treinamento e na execução AR. |
Ilustração. Ambos os caminhos também recebem entradas como imagens e estado do robô.
G0.5 também tem uma cabeça opcional de flow-matching. A tabela descreve seu principal caminho AR. Os experimentos abaixo alternam entre as duas cabeças. π₀.₅ paper deep-dive
De Onde Vêm as Ações e os Rótulos de Raciocínio
G0.5 é pré-treinado em demonstrações de robôs de 14 corpos diferentes, juntamente com VQA geral e incorporado. As demonstrações mostram como diferentes robôs se movem. Respostas a perguntas e anotações adicionais ensinam ao modelo sobre instruções, alvos e estágios de tarefas. DROID entra no pipeline mais tarde, durante o pós-treinamento específico de conjunto de dados.
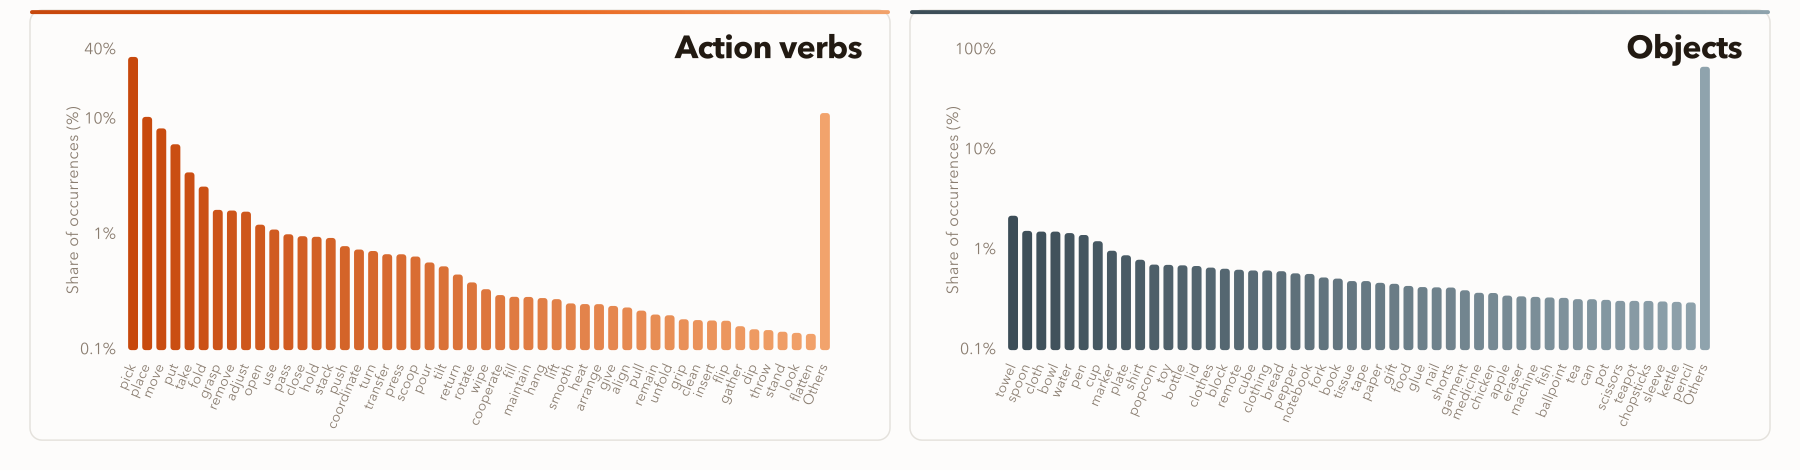
Os eixos verticais mostram a frequência em escala logarítmica. Verbos de ação aparecem à esquerda e substantivos de objeto à direita. Ações comuns como pegar, colocar e mover ocorrem com mais frequência, enquanto habilidades e objetos menos comuns ocupam a cauda longa. Um conjunto de dados pode cobrir muitos corpos e habilidades e ainda assim conter poucos exemplos de habilidades específicas.
| Alvo de treinamento | Como é obtido |
|---|---|
| Tarefas e subtarefas | Dividir demonstrações em segmentos temporais e então usar um modelo multimodal para anotar descrições de tarefas e dicas de ação locais |
| Caixas delimitadoras | Localizar o alvo com um modelo de visão e depois rastreá-lo nos quadros subsequentes |
| Trajetórias 2D do efetuador final | Aplicar cinemática direta às posições das juntas e projetar as posições 3D do efetuador final na imagem da câmera da cabeça |
| Códigos de ação | Passar blocos de demonstração alinhados pelo ActionCodec pré-treinado |
| Resposta visual a perguntas | Usar respostas em texto de pares gerais e incorporados de imagem-pergunta |
Cada exemplo de robô usa um de oito formatos de raciocínio, escolhidos com pesos de amostragem. Um formato gera ações diretamente. Isso permite que o modelo aprenda a fazer julgamentos intermediários e também opere sem texto de raciocínio.
Um Espaço de Ação Compartilhado de 27 Dimensões
Canais de controle de diferentes corpos são alinhados por parte do corpo. O layout base tem 27 dimensões, com a mesma ordem de slots em cada passo de tempo. Um bloco de ação com passos de controle previstos é um arranjo .
| Parte do corpo | Dimensões | Uso |
|---|---|---|
| Controles do lado esquerdo e garra | 9+1 | Controles do braço esquerdo e ação da garra esquerda |
| Controles do lado direito e garra | 9+1 | Controles do braço direito e ação da garra direita |
| Parte inferior do corpo | 7 | Slots para movimentos suportados como controle de torso e base |
Ilustração. Suponha que um robô de braço direito tenha cinco canais de controle de juntas e um canal de garra. Coloque cada ação demonstrada nos slots apropriados do lado direito para que compartilhe um layout com demonstrações de dois braços. Preencha slots não usados com placeholders. O modelo pode emitir apenas os códigos da parte ativa, e o controlador pode recuperar os seis canais de que precisa a partir da saída decodificada.
Este é um mapeamento simplificado. Cada robô usa suas próprias definições de junta ou efetuador final, mapeamento de slots e estatísticas de normalização. O checkpoint convertido LeRobot SO-101 usa um layout interno de 20 dimensões.
Do Raciocínio de Cena aos Códigos de Ação
O Que Acontece em Uma Chamada de Política?
G0.5 é inicializado a partir de Qwen3.5-2B. O codificador de visão converte as imagens em representações visuais. O decodificador recebe essas representações juntamente com a instrução de tarefa, o estado atual do robô e o identificador de corpo. Quando o chain of thought (CoT) está habilitado, o decodificador gera os campos de raciocínio solicitados, como a subtarefa e uma caixa delimitadora em torno da maçaneta. Em seguida, ele prevê tokens de ação condicionados às mesmas entradas e ao raciocínio que acabou de gerar. ActionCodec converte esses tokens em um bloco contínuo para o robô executar.
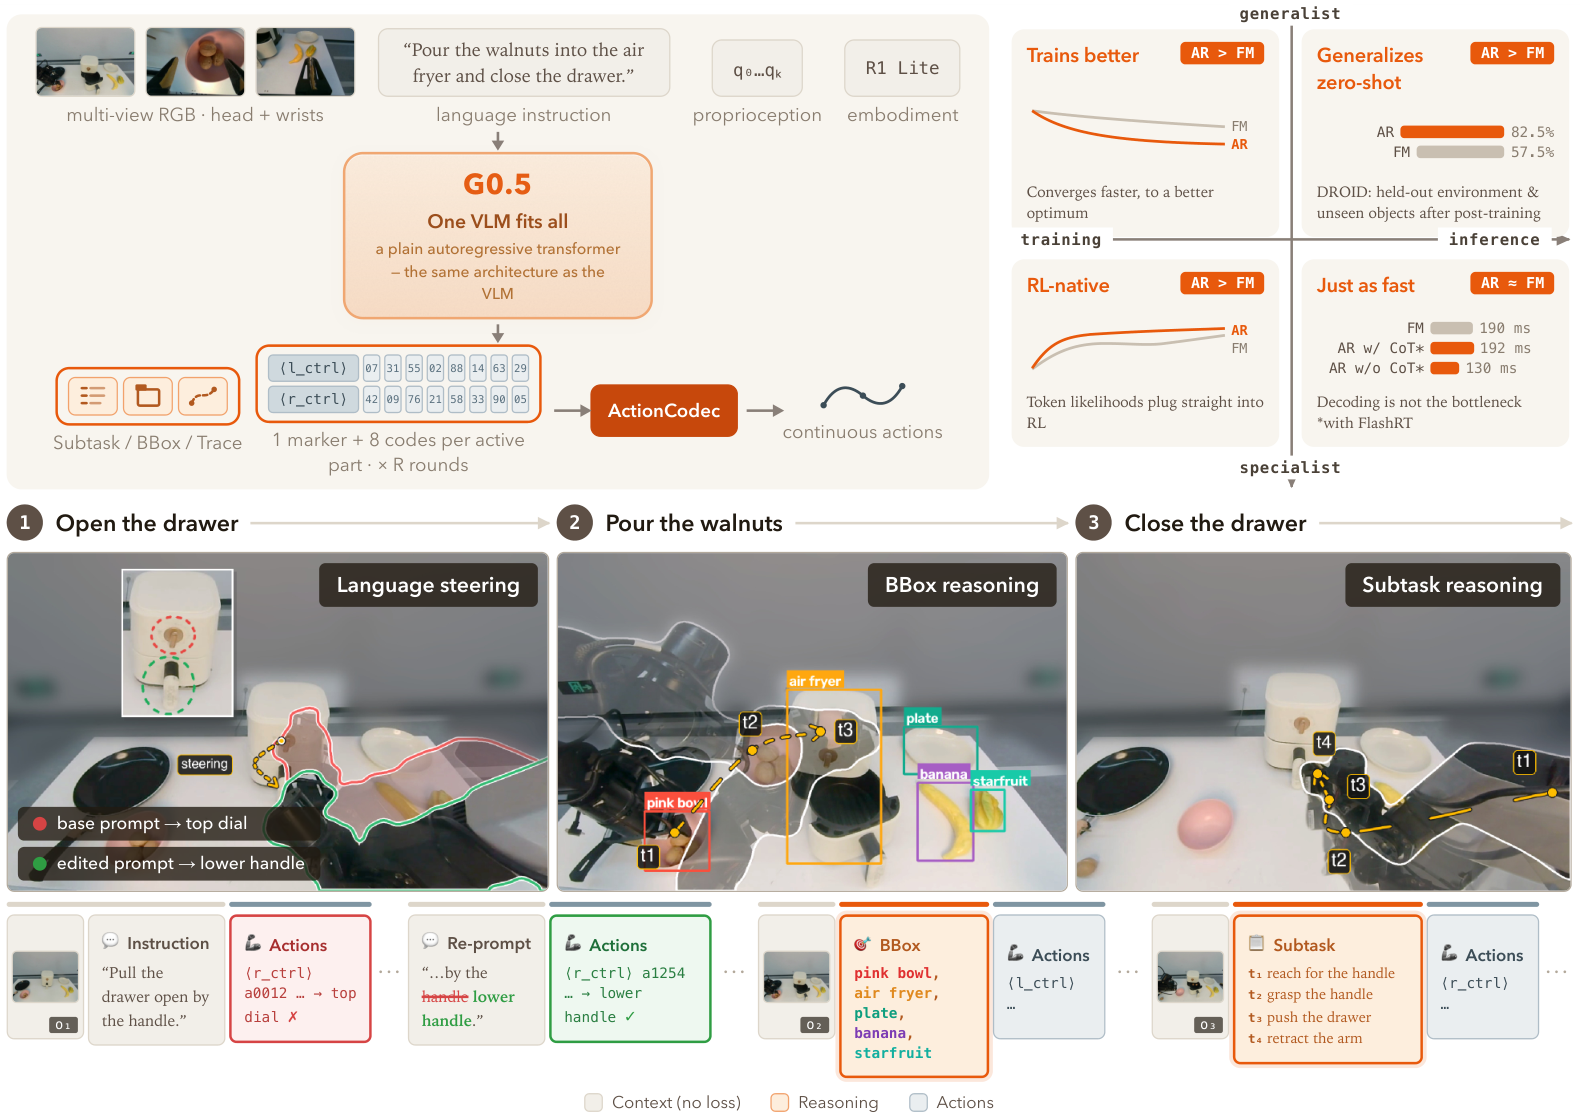
A parte superior esquerda mostra como as quatro entradas levam ao raciocínio, códigos de ação e controle contínuo. Os três painéis ao longo da parte inferior mostram abrir a gaveta, despejar e fechar, com novas observações em cada estágio. No exemplo de abertura, reformular o prompt desloca o alvo de um botão superior para a maçaneta inferior. A parte superior direita resume resultados de vários protocolos. O experimento abaixo compara diretamente as configurações de raciocínio.
Como o ActionCodec Usa Menos Tokens
Quando o braço direito abre a gaveta, o bloco de ação abrange vários passos desde alcançar até puxar. O braço esquerdo pode permanecer parado o tempo todo. ActionCodec comprime o movimento do braço direito em um pequeno conjunto de códigos. O modelo também pode omitir códigos para partes estacionárias, reduzindo quantos tokens ele precisa prever.
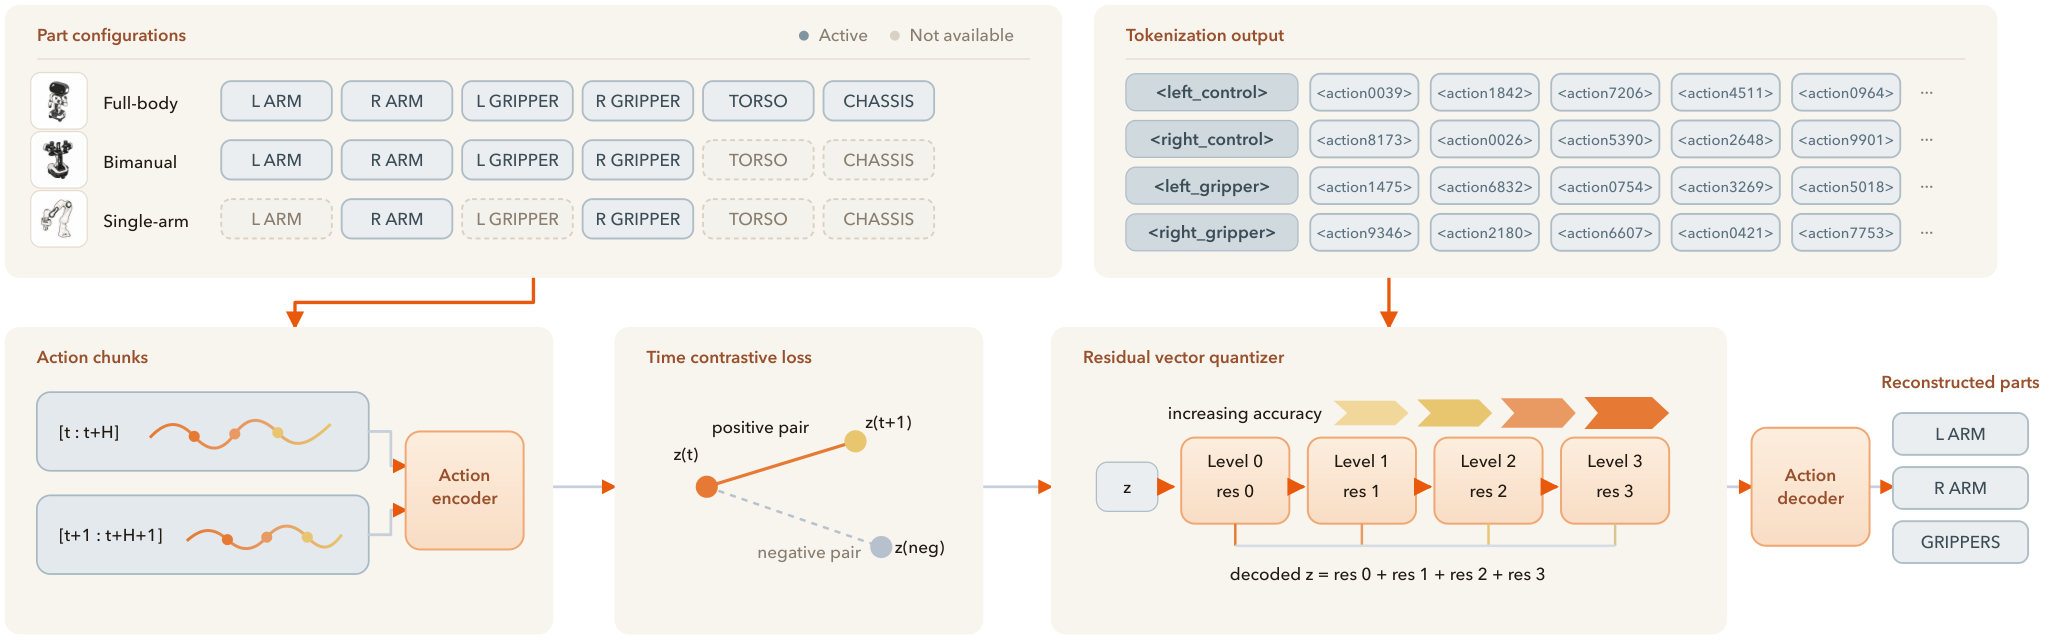
Leia o diagrama da esquerda para a direita. Ações de diferentes corpos são atribuídas às suas partes do corpo correspondentes e codificadas por grupo. O quantizador produz índices discretos, e a sequência preserva a qual parte cada grupo de índices pertence. O objetivo contrastivo temporal no meio incentiva movimentos semelhantes em passos de tempo próximos a terem códigos consistentes.
Quantização vetorial residual (RVQ) aproxima o vetor latente de um segmento de ação por meio de consultas sucessivas ao codebook. A primeira rodada encontra um vetor próximo. A segunda rodada procura um vetor para o residual. Para decodificar, o codec recupera os vetores selecionados, os soma e reconstrói a ação.
Exemplo detalhado. Considere um valor latente sem unidade de . A primeira consulta retorna , deixando um residual de . A segunda retorna . A soma é , e o erro absoluto cai de para . O codec real armazena índices para vetores no codebook.
Cada rodada usa um marcador de grupo mais oito códigos de ação para cada grupo ativo. Com duas rodadas e apenas o lado direito ativo, a sequência de ação precisa de tokens. Com ambos os lados ativos, precisa de . Essa contagem exclui limites de sequência e texto de raciocínio. O layout compartilhado pode conter slots para partes inativas enquanto a sequência gerada omite essas partes. O VLM aprende a prever os índices, e o ActionCodec aprende a codificar e reconstruir ações.
O modelo de sequência mostra ambos os marcadores de braço como sempre emitidos. A descrição da tokenização de ação no artigo permite que grupos inativos sejam omitidos. A contagem de tokens acima usa essa configuração.
Como o Raciocínio Afeta as Ações
Uma caixa delimitadora identifica onde agir. Uma subtarefa descreve o que fazer em seguida. A sequência pode carregar quatro tipos de saída de raciocínio.
| Campo gerado | O que ele fornece no exemplo da gaveta |
|---|---|
Subtask | A operação atual, como “agarrar a maçaneta inferior” |
BBox | Uma caixa delimitadora em torno do alvo na imagem |
Trace | A trajetória do efetuador final no plano da imagem |
ActionHint | Uma dica de movimento local, como fechar a garra após se aproximar |
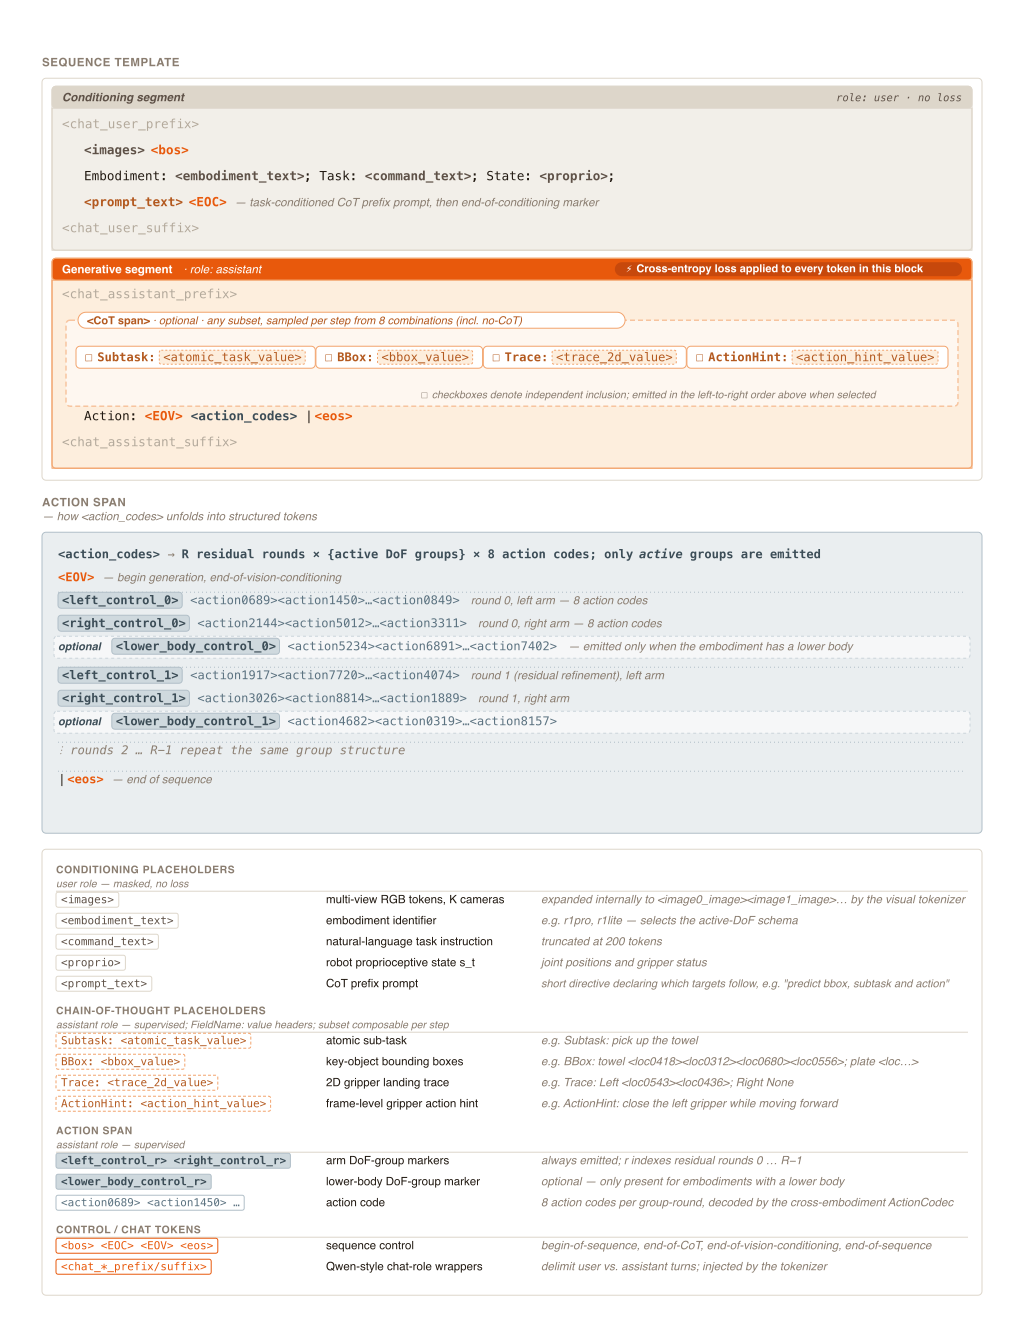
O segmento de condicionamento contém imagens, o corpo, o estado do robô e o prompt. O segmento gerado começa com os campos de raciocínio selecionados e continua com códigos de ação agrupados por parte do corpo. A cabeça FM opcional produz ações contínuas a partir dos estados ocultos do backbone e também pode usar o contexto após o raciocínio.
Ilustração. Antes de abrir a gaveta, o modelo usa a imagem e a pose atual para gerar “agarrar a maçaneta inferior” e uma caixa delimitadora ao redor dela. O decodificador lê a subtarefa e as coordenadas geradas enquanto prevê códigos para o braço direito se aproximar. Após executar um segmento curto, o robô atualiza as entradas com uma nova imagem e estado.
Ambos os tipos de saída compartilham um objetivo de entropia cruzada de próximo token. O artigo o apresenta como
Aqui denota os parâmetros do decodificador, é o conjunto de posições no segmento gerado, é o token alvo na posição , e inclui as entradas de condicionamento e tokens anteriores. O segmento de condicionamento fornece contexto, e a perda é somada sobre o segmento gerado. Se o modelo atribuir probabilidades e a um token de subtarefa alvo e a um código de ação alvo, sua perda combinada é . O treinamento pode usar prefixos anotados. Na inferência, um erro no próprio raciocínio do modelo pode se propagar para a ação.
Como o Modelo Usa o Histórico Visual Recente
O pulso pode bloquear a maçaneta enquanto o braço a alcança. Quadros anteriores ainda mostram a maçaneta, enquanto o quadro atual mostra o pulso. G0.5 insere atenção espacial e temporal fatorizada a cada quatro camadas no Transformer de visão para combinar informações entre patches de imagem e passos de tempo. Na camada final, apenas a representação do quadro atual, que absorveu informações de quadros anteriores, é passada ao decodificador. O caminho com histórico habilitado usa embeddings contínuos de estado para alinhar o estado do robô com as imagens correspondentes.
Durante o treinamento, o modelo às vezes descarta aleatoriamente todo o conjunto de quadros de histórico para que o codificador também possa funcionar apenas a partir do quadro atual. O artigo usa entradas de quadro único para o BEHAVIOR após o pós-treinamento. Os autores atribuem parte dos ganhos de longo horizonte ao pré-treinamento com histórico. Os experimentos deixam sua contribuição individual sem ser medida.
Do Treinamento à Execução
| Estágio | Entradas | Comportamento ou saída aprendida |
|---|---|---|
| Treinamento do codec | Ações contínuas alinhadas agrupadas por parte do corpo | Comprime blocos em índices discretos e reconstrói as ações a partir desses índices |
| Pré-treinamento VLA | Imagens, instruções, estado do robô, códigos de ação do codec congelado e rótulos de raciocínio | Aprende a prever raciocínio e códigos de ação com entropia cruzada de próximo token e a responder perguntas visuais |
| Pós-treinamento downstream | Demonstrações da tarefa-alvo e interfaces de observação e controle do embodiment | Produz um checkpoint para um robô ou benchmark específico |
| Execução | Observações mais recentes, instrução de tarefa, identificador de embodiment e estado do robô | Raciocínio opcional → códigos de ação → bloco de ação contínua |
No caminho principal do artigo, o robô executa parte do bloco, coleta novas imagens e estado e faz uma nova previsão. Se a maçaneta se deslocar enquanto o robô empurra a gaveta, o próximo bloco pode responder à sua posição observada. Isso fecha o ciclo de feedback por meio de observação e replanejamento. Os comprimentos de previsão e execução dependem da plataforma ou da configuração do checkpoint.
O Que os Experimentos Mostram
Alternando o Raciocínio Ligado e Desligado para Cada Cabeça de Ação
Os autores usam um checkpoint G0.5 e testam quatro configurações alternando entre AR e FM e ativando ou desativando CoT. Com CoT ativado, ambas as cabeças podem usar o contexto resultante. A avaliação de pick-and-place de estágio único usa 64 tentativas. As avaliações de longo horizonte usam duas tarefas de cinco estágios, Air Fryer e Cook Bacon, com cinco tentativas por configuração e o subobjetivo atual fornecido em tempo de execução.
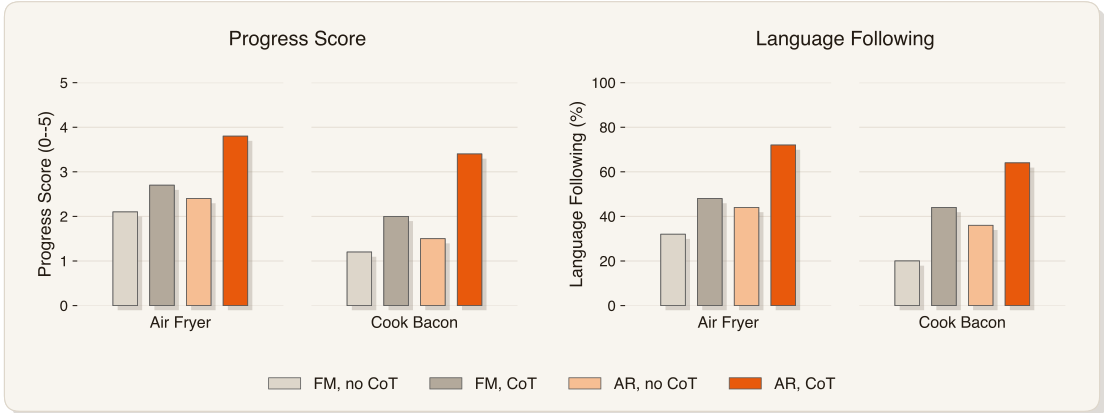
O painel esquerdo mostra os estágios concluídos (0–5) e o direito mostra o acompanhamento de linguagem. Com CoT ativado, os estágios médios concluídos em Air Fryer sobem de 2,4 para 3,8 para AR e de 2,1 para 2,7 para FM. A avaliação de pick-and-place de estágio único muda muito menos, com o acompanhamento de linguagem de AR subindo de 65,6% para 67,2%. Esses resultados apoiam o uso de CoT para grounding e execução quando objetivos de estágio são fornecidos. Os efeitos de reformular verbos ou pistas espaciais permanecem observações qualitativas de uma amostra pequena.
Pick-and-Place: Seleção de Alvo e Conclusão da Tarefa
Um R1-Lite deve colocar um objeto especificado em um recipiente especificado sobre uma mesa desorganizada. Ambos os modelos executam 64 tentativas em robô real sob as mesmas instruções, disposições de objetos e poses iniciais. O teste inclui categorias de objetos vistas durante o pós-treinamento e categorias excluídas dele.
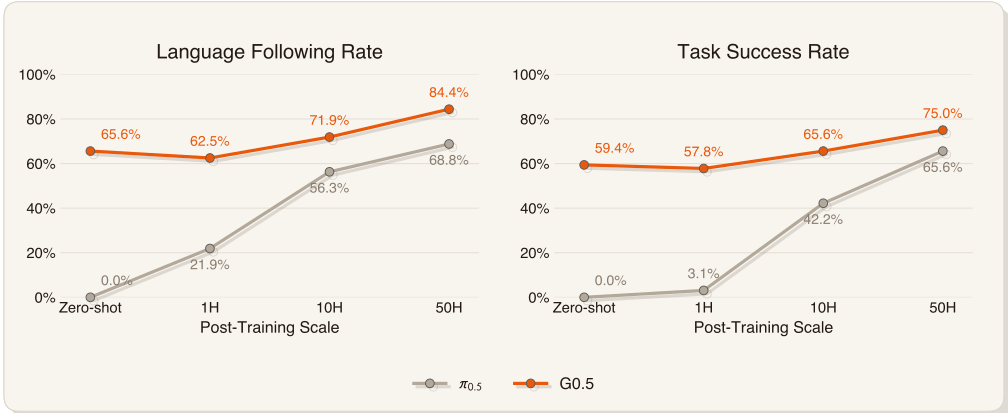
O acompanhamento de linguagem à esquerda mede se o robô se aproxima e tenta agarrar o objeto correto. O sucesso da tarefa à direita também exige agarrá-lo com sucesso e colocá-lo no recipiente especificado. Por exemplo, um robô que tenta o agarre correto, mas deixa o objeto cair pode passar na verificação de acompanhamento de linguagem e falhar na tarefa. Após o pós-treinamento em 50 horas de dados de tarefa, o G0.5 marca 84,4% e 75,0% nas duas métricas. π₀.₅ marca 68,8% e 65,6%.
DROID: Transferência para Novos Ambientes e Falhas de Baixo Contraste
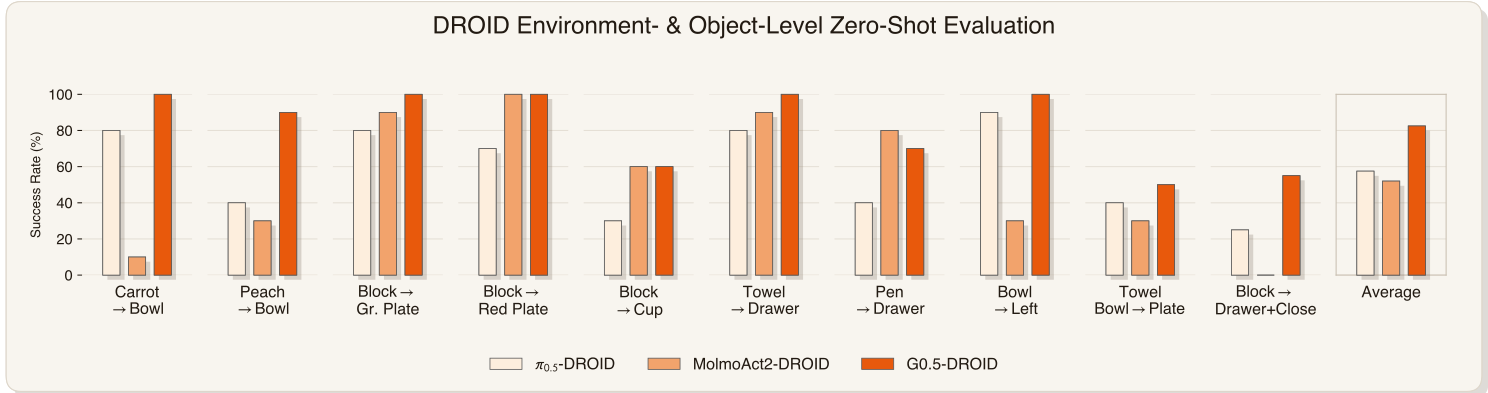
O eixo horizontal lista dez tarefas de manipulação e sua média. O eixo vertical mostra o sucesso sob o protocolo de avaliação do artigo. Cada modelo é treinado no DROID e depois executa dez tentativas por tarefa em ambientes reais excluídos com objetos excluídos. A tarefa final permite 0,5 ponto para conclusão parcial. O G0.5 tem média de 82,5%, π₀.₅-DROID 57,5% e MolmoAct2-DROID 52,0%.
O G0.5 tem sucesso em 60% das tentativas ao colocar uma toalha em uma gaveta de baixo contraste. Depois que os autores adicionam marcadores de alto contraste, o sucesso sobe para 100%. O ganho médio deixa algumas tarefas sensíveis à visibilidade do alvo.
Fine-Tuning em Robô Real e Tarefas de Longo Horizonte
| Avaliação | Configuração | Resultado reportado |
|---|---|---|
| Hardware R1-Lite e R1-Pro | Duas plataformas móveis de dois braços. Quatro tarefas geram seis configurações tarefa–embodiment com 15 episódios cada. Os modelos usam dados e orçamentos de treinamento correspondentes. | O sucesso médio é 76,7% para G0.5, 53,3% para π₀.₅ e 24,4% para GR00T-N1.7 |
| BEHAVIOR Challenge 2025 | 50 tarefas domésticas com dez instâncias cada. A pontuação mede a proporção de condições de objetivo alcançadas e permite crédito parcial. | O G0.5 de checkpoint único marca 0,2904 após uma época e 0,3136 após quatro épocas de pós-treinamento. π₀.₅ marca 0,2626 após quatro épocas. |
R1-Lite e R1-Pro têm seis e sete graus de liberdade por braço, respectivamente. Ambos usam uma câmera externa e duas câmeras de pulso na avaliação em robô real. Em transporte e empilhamento de caixas, π₀.₅ marca 93,3% e G0.5 marca 80,0%. O BEHAVIOR faz a média de duas execuções de avaliação para cada política de checkpoint único. A entrada vencedora da competição usa quatro checkpoints e marca 0,2605. Essas comparações avaliam políticas completas. Isolar um componente exigiria uma comparação controlada separada.
Os três benchmarks padrão de simulação também usam seus próprios protocolos de adaptação. Uma política ajustada tem média de 98,9% em quatro suítes de tarefas LIBERO. O RoboTwin 2.0 tem média de 93,3% em configurações limpas e randomizadas. Para o Bridge, os autores fazem pós-treinamento em demonstrações de robô real e transferem a política para o SimplerEnv sem entrada de estado do robô, alcançando 87,3%. Esses resultados avaliam o desempenho geral de controle. O experimento de alternância de raciocínio aborda o efeito de CoT.
Ações tokenizadas também têm um uso no treinamento. Uma política AR fornece diretamente a probabilidade logarítmica de seus tokens amostrados, o que suporta aprendizado por reforço com razões de probabilidade. Os autores comparam o fine-tuning GRPO em quatro tarefas LIBERO com taxas de sucesso iniciais semelhantes. AR atinge uma taxa média de sucesso final mais alta. A comparação usa a variante FM do artigo com uma aproximação de denoising estocástico e se aplica a esse cenário com poucas demonstrações.
Integração com LeRobot e Diferenças de Avaliação
Nota de implementação. policy.action_head seleciona decodificação ActionCodec ou geração de ação contínua com FM. policy.runtime_system controla se o modelo gera raciocínio primeiro. O Sistema 1 produz ações diretamente. O Sistema 2 gera um subtarefa ou uma caixa delimitadora e subtarefa na mesma chamada de política e depois usa esse contexto para gerar ações. Ele requer um checkpoint com predict_cot=true. A cabeça de ação e a configuração de CoT são independentes.
| Checkpoint | Caminho de ação disponibilizado | Prever / Executar | Interface |
|---|---|---|---|
lerobot/g05_base | Selecionar explicitamente ActionCodec ou FM. CoT é suportado. | 32 / 16 | Layout de corpo inteiro de 27 dimensões. O processador R1 Lite incluído usa uma câmera de cabeça, ambas as câmeras de pulso e seis quadros incluindo o quadro atual. |
lerobot/g05_libero | FM, Sistema 1 | 32 / 10 | Efetor final de braço único e garra mapeiam para 20 dimensões. Câmeras externa e de pulso direito. |
lerobot/g05_robotwin20 | FM, Sistema 1 | 32 / 8 | Dois braços e garras mapeiam para 20 dimensões. Câmeras aérea e de ambos os pulsos. |
lerobot/g05_so101 | ActionCodec ou FM. CoT é suportado. | 32 / 16 | Seis controles de braço único mapeiam para 20 dimensões. Câmeras externa e de pulso direito, com um slot opcional para pulso esquerdo. |
Para execução síncrona em SO-101, o modelo prevê 32 passos e coloca os primeiros 16 em fila. A política é executada novamente quando a fila está vazia. O processador de saída desnormaliza a representação interna de 20 dimensões usando as estatísticas do checkpoint e a mapeia de volta para seis controles. Demonstrações comuns podem fornecer alvos de ação. Treinar subtarefas e caixas delimitadoras requer rótulos correspondentes. As pontuações de simulação no artigo vêm da configuração de avaliação da Galaxea. Os checkpoints convertidos do LeRobot LIBERO e RoboTwin usam a cabeça contínua e devem ser avaliados sob suas próprias configurações. A portabilidade e os checkpoints usam a G0.5 Community License, que inclui restrições de uso não comercial.
Conclusão
O G0.5 usa quantização agrupada para comprimir controle de múltiplos passos em tokens. O decodificador pode então prever esses tokens usando subtarefas e localizações-alvo que ele gerou na mesma chamada. A evidência mais direta vem de alternar CoT no mesmo checkpoint. Isso melhora o progresso nas tarefas de cinco estágios quando subobjetivos são fornecidos, com pouca mudança em pick-and-place de estágio único. A memória visual cobre alguns segundos, e os resultados com a gaveta de baixo contraste mostram o quanto o sucesso da ação ainda pode depender do que o robô consegue ver.
As figuras são reproduzidas do artigo arXiv v1 da Equipe Galaxea com suas legendas e conteúdo originais. CC BY-NC-SA 4.0