GR00T 2: Como a Modelagem Mundo-Ação Suporta Generalização e Adaptação
GR00T 2: Escalando Modelos Fundamentais de Robótica para Generalização, Destreza e Adaptação
NVIDIA · Novembro de 2026
- Modelo mundo-ação
- Transferência entre corpos
- Adaptação rápida
- Controle de corpo inteiro
Um robô pode aprender a colocar papel de filtro em um funil observando uma pessoa fazer isso? Se um robô já conhece a ordem das etapas em uma tarefa de montagem, algumas demonstrações podem ensiná-lo a fazer um contato mais preciso? Como um humanoide pode usar a mesma habilidade enquanto mantém o equilíbrio? Essas perguntas compartilham um objetivo: aprender habilidades a partir de uma ampla gama de experiências e adaptá-las a um robô, tarefa e condição de operação específicos.
A questão central em GR00T 2 é se aprender conjuntamente como o mundo muda e como um robô age pode tornar as habilidades mais fáceis de transferir, adaptar e executar.
Visão geral do projeto, em paráfrase: GR00T 2 é um modelo mundo-ação que prevê conjuntamente vídeo futuro e ações do robô. Ele aprende com vídeos humanos, demonstrações capturadas com dispositivos manuais e dados de robôs. A NVIDIA demonstra transferência de habilidades entre corpos, adaptação com poucos exemplos e controle agente. GR00T 2 Turbo estende a abordagem para loco-manipulação de corpo inteiro em humanoides.
Nota de leitura: A predição conjunta é a abordagem de modelagem comum. Alinhamento entre corpos, pós-treinamento de tarefa, um agente de raciocínio e um controlador de corpo inteiro abordam cada um uma parte diferente do problema. Este artigo segue o caminho do treinamento do modelo até a transferência e execução de habilidades, mantendo a contribuição do modelo fundamental distinta dos resultados do sistema completo.
Predição Conjunta: Conectando Vídeo Futuro e Ações do Robô
Por Que Prever o Futuro Assim Como a Ação?
Um modelo convencional de visão-linguagem-ação (VLA) gera ações de controle a partir de observações de câmera, instruções em linguagem natural e estado do robô. Demonstrações de robô fornecem alvos de ação para o treinamento. A maioria dos vídeos humanos, porém, não vem com comandos de robô que possam servir como o mesmo tipo de supervisão.
Movimentos humanos e de robôs diferem, mas o vídeo pode descrever as mudanças que eles produzem: papel de filtro se move para dentro de um funil, ou um plugue se aproxima de uma tomada e faz contato. A geração de vídeo fornece uma forma de aprender essas mudanças. Coleta de dados entre corpos e retargeting de movimento ajudam a mapear movimentos de corpos diferentes em representações adequadas para o treinamento.
GR00T 2 conecta essas ideias em um modelo mundo-ação (WAM). Uma rede compartilhada gera conjuntamente observações visuais futuras e ações. A predição de vídeo descreve como uma interação se desenrola, enquanto a predição de ação descreve o que o robô atual deve fazer.
Isso se baseia em ideias discutidas em outras partes da série. VLA-JEPA usa predição de estado futuro para melhorar suas representações; LingBot-VA usa predições futuras para controle. GR00T 2 estende a modelagem conjunta de vídeo e ação para treinamento em larga escala com múltiplas fontes de dados e corpos de robôs. Estas são comparações de escolhas de projeto, não rankings de desempenho entre artigos.
Das Representações de Entrada à Geração Conjunta
O modelo recebe vídeo recente de múltiplas câmeras, uma instrução em linguagem natural e o estado do robô. O histórico na demonstração da NVIDIA cobre 0,8 segundos. A partir dessas entradas, o modelo prevê vídeo futuro e uma sequência de ações chamada de bloco de ação.
Um autoencoder variacional de vídeo (VAE) comprime o vídeo bruto em latentes, que são então tokenizados para a rede compartilhada. A linguagem é codificada como recursos de instrução. Pequenos módulos específicos de cada corpo conectam o estado e as ações do robô à rede compartilhada. Aqui, corpo inclui a estrutura física do robô, a configuração das câmeras e a interface de ação. A mesma instrução para agarrar papel de filtro exige alvos de juntas diferentes em mãos de robôs diferentes.
A conexão-chave está dentro do Transformer compartilhado. Representações de vídeo trocam informações ao longo do tempo e entre visões de câmera. Tokens de ação podem prestar atenção a tokens de vídeo, incluindo o vídeo futuro que está sendo gerado. Isso dá à predição de ação acesso à estimativa do modelo de como a cena vai mudar.
O exemplo de montagem Dexter da NVIDIA mostra a câmera da cabeça e ambas as câmeras de pulso. A imagem superior é o histórico real de observações; a imagem inferior é o futuro gerado a partir dele. As mudanças nas mãos e no caminhão na imagem inferior são predições.
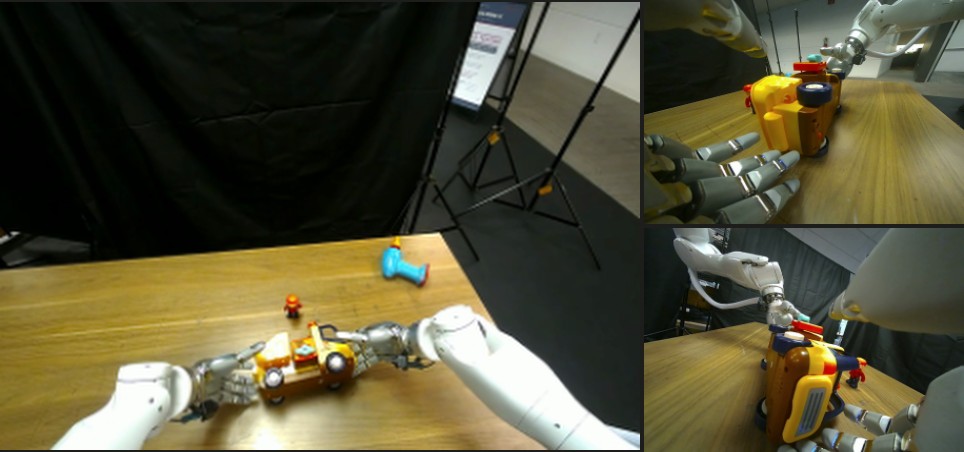
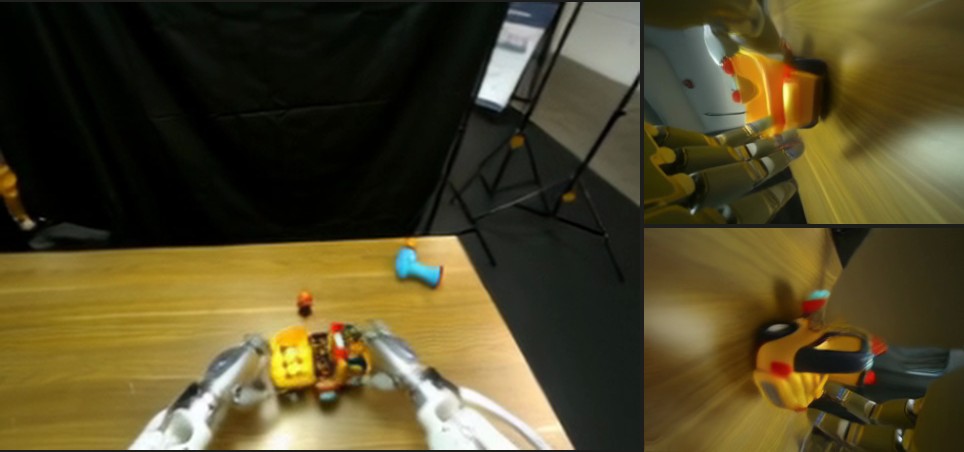
Considere a tarefa do papel de filtro. O papel ainda está na mão do robô no quadro observado. O ramo de vídeo prevê como ele entrará em contato com o funil, enquanto o ramo de ação gera os movimentos correspondentes de pulso e dedos. Ambas as saídas são refinadas na mesma rede. A política não precisa renderizar um vídeo RGB completo e entregá-lo a um controlador separado.
Por fim, módulos específicos de cada corpo decodificam a representação compartilhada em controles para o robô atual. O modelo pode compartilhar o que aprende sobre interações enquanto preserva o significado das ações para cada corpo.
Treinando com Supervisão de Vídeo e Ação
GR00T 2 usa flow matching para aprender como recuperar vídeo futuro e ações a partir de ruído. Para ilustrar a ideia, use o caminho padrão em linha reta abaixo, com denotando um tensor alvo de latentes de vídeo ou ações:
Aqui, é um ruído Gaussiano com o mesmo formato, e é o tempo interno de geração do modelo. Em , a entrada é ruído; em , é o alvo limpo. Condicionado às observações, a rede recebe a entrada ruidosa e aprende a direção alvo . Alvos de vídeo e de ação fornecem supervisão separada e atualizam a rede compartilhada.
Considere um único elemento de ação. Se seu alvo normalizado é 0,6 e seu valor de ruído é −0,2, o ponto médio é 0.5×0.6 + 0.5×(−0.2) = 0.2, e a direção alvo é −0.2−0.6 = −0.8. Na inferência, a integração vai do ruído em direção aos dados, na direção de tempo de geração decrescente, então o valor se move em direção a 0,6. O modelo real aprende sobre todos os tensores de vídeo e ação; o exemplo isola um único elemento.
Amostras somente de vídeo ainda podem supervisionar a previsão visual futura. A supervisão de ação se aplica onde rótulos de ação válidos estão disponíveis. Vídeos humanos podem, portanto, ajudar a treinar a rede compartilhada que gera ações de robô sem exigir um conjunto completo de rótulos de controle de robô para cada clipe.
Durante o treinamento, o futuro observado fornece o alvo. Durante a inferência, o modelo começa com ruído novo e gera latentes de vídeo futuros e um bloco de ações. O robô executa parte do bloco, lê novas observações de câmera e estado e inicia a próxima rodada. Etapas internas de remoção de ruído e etapas de execução física ocorrem em escalas de tempo diferentes. O robô ainda precisa de observações reais para verificar uma previsão de que o papel de filtro está no lugar.
Treinamento Multiorigem: Construindo uma Base para Habilidades Adaptáveis
O que Cada Fonte de Dados Contribui
| Fonte de dados | Quantidade usada para treinamento | O que ela contribui |
|---|---|---|
| Vídeo humano egocêntrico | 402.730 horas | Uma ampla variedade de tarefas, objetos e interações mão–objeto |
| Demonstrações com garra UMI de mão | 10.184 horas em 2.897 tarefas | Demonstrações de movimento e preensão em uma forma mais próxima da manipulação robótica |
| Teleoperação de robô | Cerca de 23.500 horas | Aparência, estado e controle executável específicos da corporificação |
O vídeo humano vem do Human-1M. A tabela mostra a quantidade filtrada usada pelo GR00T 2. A UMI captura demonstrações com uma garra de mão. Os dados de robô abrangem garras paralelas, mãos hábeis e humanóides.
As fontes se complementam. A experiência humana amplia a cobertura de tarefas, dispositivos de mão tornam as demonstrações menos dependentes de acesso a robôs, e dados de robô conectam essa experiência ao controle físico. Amostras humanas com movimento de mão rastreado também podem fornecer supervisão de movimento. Amostras sem ações válidas ainda podem treinar a previsão de vídeo futuro.
O treinamento conjunto também depende de alinhamento: observações, quadros futuros, linguagem e ações precisam se referir à mesma interação. “Coloque o papel de filtro no funil com a mão direita” fornece uma supervisão mais específica para uma etapa do que “termine o experimento” ao longo de toda a gravação. Filtragem, segmentação e anotação de dados ajudam a estabelecer essa correspondência.
De um Prior de Vídeo a Ações de Robô
O treinamento ocorre em três estágios:
- Pré-treinamento de vídeo de visão única. Inicializar a partir de um modelo de difusão de vídeo pré-treinado e aprender o futuro de interações corporificadas a partir de observações humanas e de robôs.
- Treinamento de vídeo-ação multivisão. Adicionar módulos de estado e ação específicos da corporificação e treinar com observações de múltiplas câmeras e rótulos de ação válidos.
- Treinamento de vídeo-ação com peso maior para robôs. Aumentar a contribuição de demonstrações de robôs mantendo as outras fontes, aproximando o modelo compartilhado das condições que enfrentará em um robô.
Esses estágios produzem um modelo de base que pode ser executado diretamente ou adaptado ainda mais. Eles conectam o pré-treinamento de vídeo ao controle de robôs e explicam por que a adaptação de baixo custo descrita mais adiante depende de pré-treinamento em larga escala.
Escalar Vídeo Humano Ajuda em Robôs Reais?
Os autores treinam modelos com 0%, 1%, 10% e 100% dos dados de vídeo humano e então avaliam tanto rollouts gerados quanto execução em robô real em 72 tarefas Dexter. À medida que a quantidade de vídeo humano aumenta, o progresso médio da tarefa sobe de 64% para 77% em rollouts gerados e de 50% para 70% no robô.
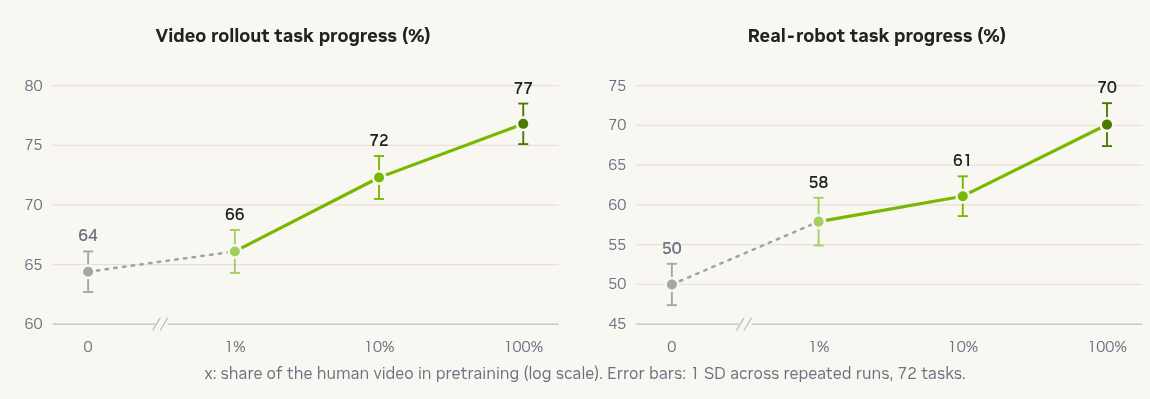
O painel esquerdo na figura da NVIDIA mostra o progresso de rollout de vídeo; o direito mostra o progresso em robô real. As barras de erro representam um desvio padrão.
A métrica é o progresso da tarefa: quanto de uma tarefa foi concluído. Ela é distinta da taxa de sucesso de tarefa completa. Rollouts gerados e execuções em robô são pontuados separadamente. O aumento em ambas as medidas apoia o uso de vídeo humano para aprendizado de robôs, bem como para previsão de vídeo.
A quantidade de treinamento também muda nesses cenários. Os resultados apoiam a abordagem geral de escala, sem isolar os efeitos de mais dados e mais treinamento. A próxima questão é se a experiência resultante se transfere para tarefas que o robô alvo nunca demonstrou.
X-Adaptabilidade: Transferência de Habilidades entre Corporificações
Demonstrações Humanas Ensinam a Tarefa; Dados de Robô a Ancoram no Corpo Alvo
A NVIDIA chama essa capacidade de adaptação cruzada (X-Adapt). Uma pessoa ou outro dispositivo de coleta de dados demonstra a tarefa alvo. O robô alvo pode contribuir com dados de outras tarefas ou atividades gerais, mas não fornece nenhuma demonstração da tarefa alvo.
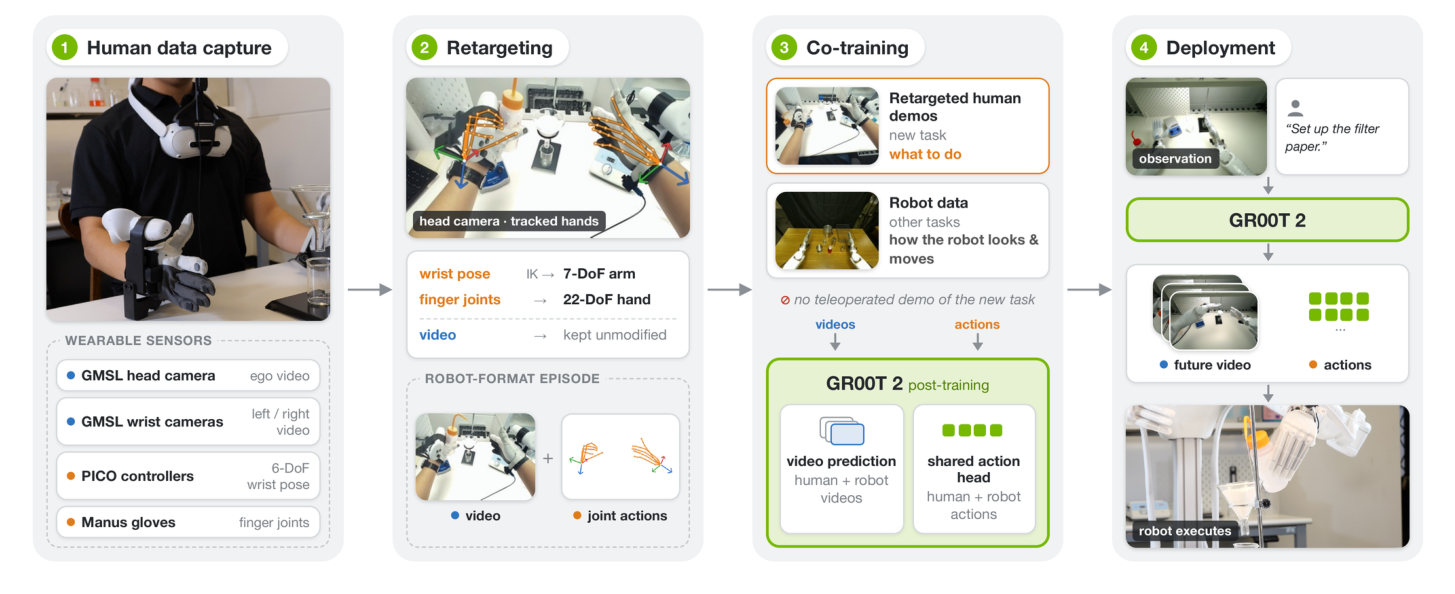
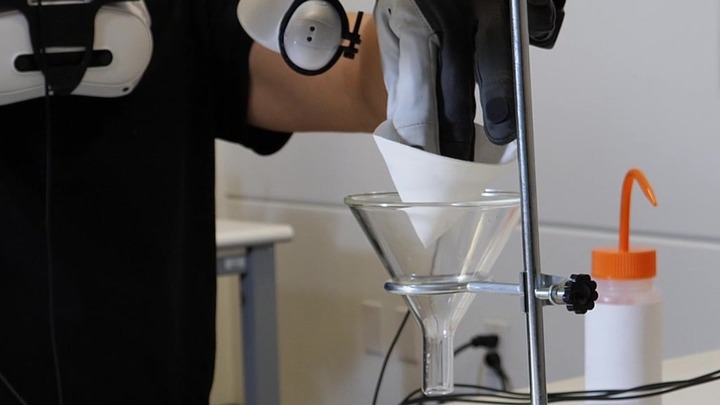
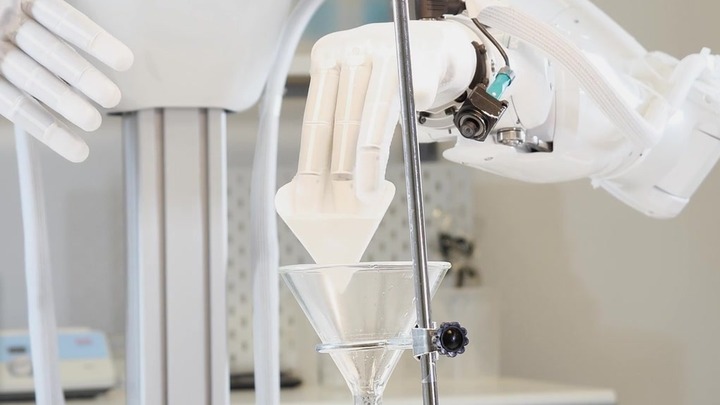
A Figura 12 acompanha a tarefa do papel de filtro ao longo do processo de transferência:
- Uma pessoa executa a tarefa usando câmeras na cabeça e no pulso e equipamento de rastreamento de movimento, com vistas de câmera posicionadas para aproximar as do robô.
- Transformar as trajetórias do pulso humano para o referencial de coordenadas do robô e redirecionar poses de mão para alvos de robô viáveis, preservando relações de contato importantes e respeitando limites de junta.
- Co-treinar nas demonstrações da tarefa alvo e em dados de brincadeira de robô independentes de tarefa que excluem essa tarefa. As demonstrações mostram o que fazer; dados de brincadeira ensinam ao modelo como o robô alvo se parece e como ele se move.
- Na implantação, usar as próprias observações do robô para prever vídeo futuro e ações para aquele corpo e então continuar a execução com feedback real.
Zero demonstrações teleoperadas da tarefa alvo ainda deixam espaço para experiência de robô em outras tarefas. A previsão conjunta fornece um objetivo de aprendizado compartilhado, enquanto o alinhamento de vistas e o redirecionamento de ações ajudam a transpor diferenças entre corpos.
Com 20 tentativas em robô real por tarefa, a configuração do papel de filtro tem sucesso em 65% das tentativas. Os resultados nas quatro tarefas de laboratório variam de 10% a 65%. A transferência de habilidade é possível, mas a variação mostra que algumas tarefas de manipulação fina continuam difíceis de concluir de forma confiável.
Na comparação de papel de filtro da NVIDIA, a imagem superior é uma demonstração de treinamento humano e a imagem inferior mostra o Dexter rodando de forma autônoma. Ambos colocam papel de filtro em um funil, usando dedos e interfaces de ação diferentes.
Transferindo de Garras de Mão e Mãos Vestíveis
As demonstrações UMI estão mais próximas de um formato compatível com robôs do que vídeo humano comum. A garra, a câmera e o referencial de ação ainda podem ser diferentes. Transferir para o YAM exige alinhar a vista da câmera de pulso e expressar o movimento do efetuador final e a largura da garra no espaço de ação do YAM.
Somente com dados UMI, o modelo ainda pode prever um braço humano e uma garra de mão após uma observação do YAM. Adicionar dados independentes de tarefa do robô alvo ajuda as previsões a refletirem a aparência do YAM. Tentativas em robô real determinam se a tarefa é realmente concluída.
Na montagem de caminhão basculante de brinquedo, uma tarefa demonstrada apenas com a garra de mão, o YAM conclui 6/10 tentativas de ponta a ponta. O robô alvo não tem demonstração dessa tarefa, mas ainda se beneficia de pré-treinamento e de dados independentes de tarefa. O resultado mostra transferência entre dispositivos juntamente com falhas substanciais em uma tarefa de longo horizonte.
DexUMI estende essa abordagem de coleta para um exoesqueleto vestível de cinco dedos. Quando suas juntas e geometria de contato correspondem à mão alvo, demonstrações humanas se mapeiam mais facilmente para ações de robô em tarefas bimanuais como preparar café da manhã ou riscar um fósforo. Uma mão de robô diferente ainda pode exigir redirecionamento de movimento e alinhamento de vistas.
Um modelo compartilhado pode transferir experiência de tarefa; a configuração de transferência ainda precisa alinhar observações e semântica de ação. Os experimentos avaliam modelagem conjunta, dados de treinamento e alinhamento em conjunto. Eles não isolam quanto do ganho vem apenas da previsão de futuro.
Adaptação Rápida e Execução Confiável
Melhorando a Precisão de Execução com Poucas Demonstrações
Após a transferência entre corporificações, um robô pode seguir a sequência correta, mas errar a posição de preensão, a abertura da garra ou o alinhamento de contato. Demonstrações do robô alvo fornecem esses detalhes, que a adaptação incorpora à habilidade existente.
GR00T 2 usa adaptação de baixa classificação (LoRA). Ele mantém os pesos base e treina um conjunto menor de atualizações de parâmetros enquanto continua aprendendo vídeo futuro e ações. Isso adapta o modelo a uma tarefa com menos dados e computação do que retreinar o modelo de base.
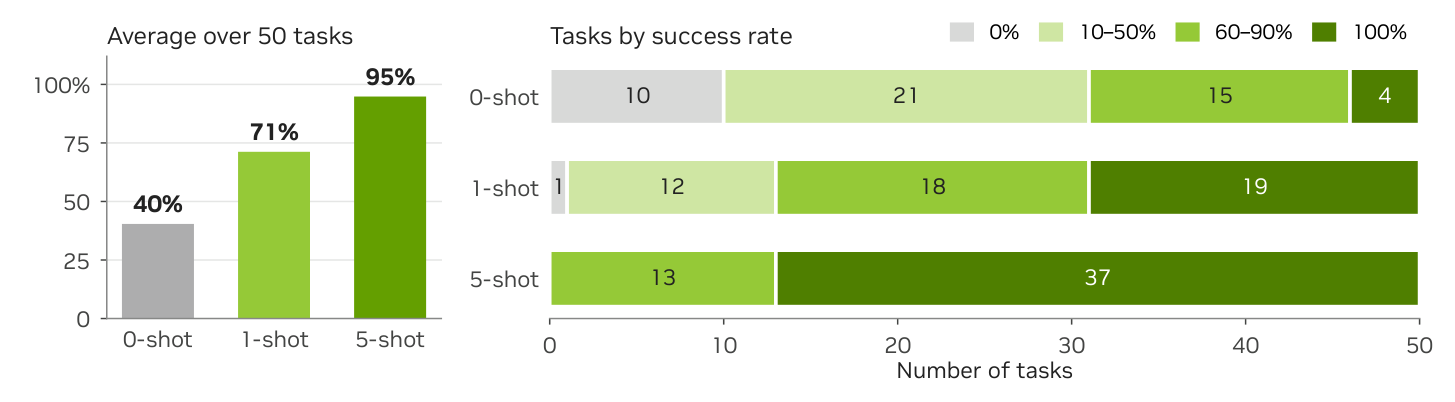
As tarefas Dexter-50 aparecem em vídeos humanos ou em dados de outros robôs, mas estão ausentes dos próprios dados de treinamento do Dexter. A avaliação compara o uso direto do modelo pré-treinado com a adaptação em uma ou cinco demonstrações por tarefa:
| Demonstrações por tarefa | 0 | 1 | 5 |
|---|---|---|---|
| Taxa média de sucesso por tentativa | 40% | 71% | 95% |
Cinco demonstrações somam menos de três minutos de dados de robô por tarefa. O ajuste fino correspondente com LoRA leva cerca de 30 minutos em uma única RTX 5090. Esse é o custo de adaptar um modelo de base existente.
As 50 tarefas foram selecionadas a partir de um conjunto que atingiu pelo menos 80% de sucesso após cinco demonstrações. A média de 95% se aplica a esse conjunto selecionado e não garante sucesso com cinco demonstrações em tarefas novas arbitrárias. Além disso, “obteve sucesso pelo menos uma vez em 40/50 tarefas” é diferente da taxa de sucesso de 40% por tentativa sem demonstrações na tabela.
Manipulação hábil mostra o que a adaptação de tarefas pode alcançar. Com duas mãos Sharpa de 22 DoF, o Dexter consegue realizar tarefas de montagem e de laboratório. A NVIDIA relata 85% de sucesso na instalação de módulos de memória. Em outro exemplo, os autores reconstroem em simulação uma tarefa de uso de ferramenta a partir de uma demonstração humana, coletam demonstrações usando aprendizado por reforço, adaptam o GR00T 2 nos dados de simulação e o transferem para mãos robóticas reais. Esses exemplos usam pós-treinamento de tarefas.
Aprendizado por Reforço para Habilidades Ricas em Contato
Ao inserir um cabo Ethernet ou rosquear um conector de tubo, uma ação pode se parecer com a demonstração e ainda assim falhar. O aprendizado por reforço (RL) no mundo real permite que o robô experimente ações e use o sucesso na tarefa como feedback para encontrar maneiras melhores de fazer contato.
Os autores coletam rollouts bem-sucedidos encontrados por RL e fazem ajuste fino a partir da mesma inicialização de ajuste fino supervisionado (SFT) que o GRPO. Eles chamam isso de auto-imitação induzida por GRPO. A interação encontra comportamentos eficazes, e o treinamento supervisionado os consolida.
A NVIDIA destaca três tarefas ricas em contato. Em conexões de tubo fixo, inserção de cabo e inserção de carregador, o ajuste fino supervisionado atinge 66%, 76% e 40% de sucesso, respectivamente. A auto-imitação induzida por GRPO eleva esses valores para 88%, 94% e 96%, com 50 tentativas por tarefa e política. A comparação mostra que a experiência de interação pode melhorar a precisão de contato nessas condições de tarefa e avaliação.
Agentic GR00T 2: Controle e Direcionamento
Mesmo quando um robô consegue montar uma peça, deixá-la cair deixa uma decisão a ser tomada: continuar, tentar de novo ou recuperar a peça primeiro. Agentic GR00T 2 é um sistema de controle em camadas que usa o GR00T 2 como sua política de manipulação. Um agente de raciocínio de nível superior decompõe a tarefa, escolhe o próximo passo e verifica os resultados. O GR00T 2 gera ações a partir de instruções e observações, e o robô as executa.
Por meio de um servidor de ferramentas compartilhado, o agente lê imagens de câmera e o estado do robô, chama o GR00T 2 através da WAM API e usa ferramentas de code-as-policy (CaP) quando necessário. O agente observa o resultado antes de escolher o que fazer em seguida. O controle agentic organiza o ciclo de feedback; o direcionamento visual fornece alvos espaciais para a etapa atual.
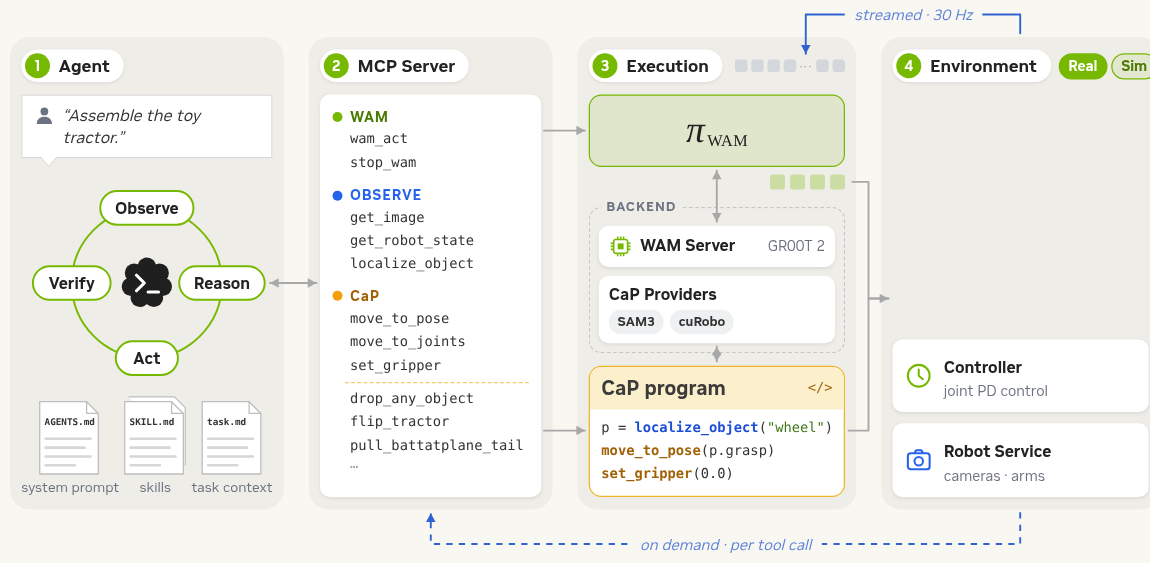
Leia o diagrama de runtime da NVIDIA da esquerda para a direita para ver como uma tarefa se torna um comando de execução. As setas azuis mostram como as observações retornam para a política ou para o servidor de ferramentas.
Controle Agentic: Sequenciamento de Tarefas e Recuperação de Falhas
Na montagem em robôs reais, o GR00T 2 realiza a maior parte da manipulação enquanto o agente monitora o progresso. Se uma peça cai ou o progresso trava, o agente pode usar uma ferramenta de recuperação para re-agarrar a peça ou reorganizar a cena e então devolver o controle ao GR00T 2. Isso coloca habilidades individuais dentro de um ciclo observar–raciocinar–agir–verificar para tarefas de longo horizonte.
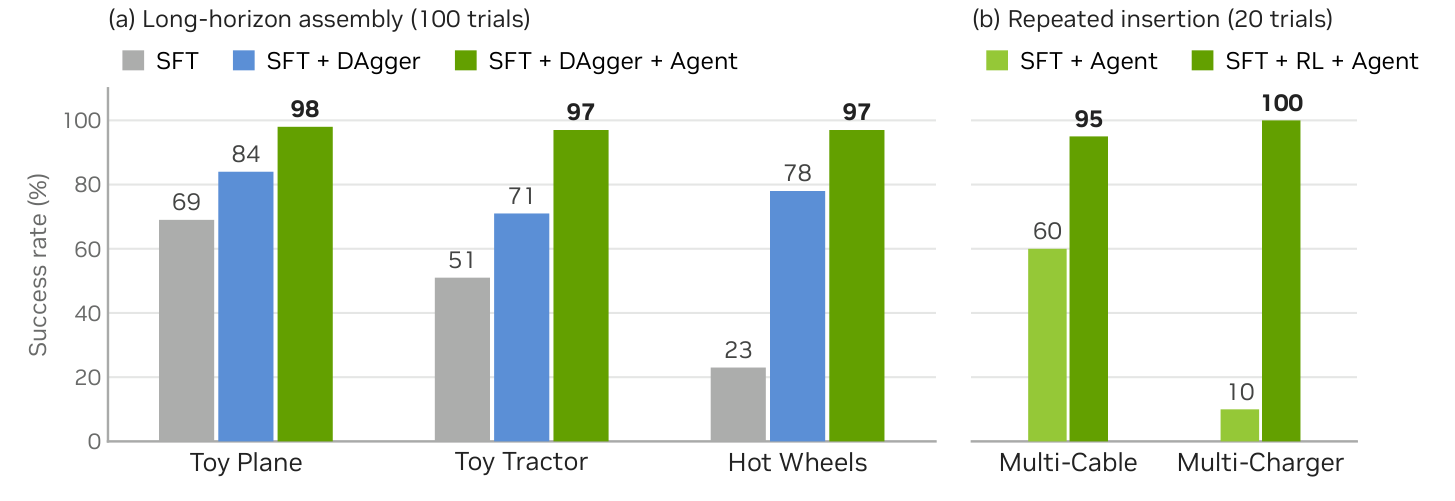
O painel esquerdo da Figura 7 relata 100 tentativas por tarefa e método. No início de cada tentativa, as peças são despejadas sobre uma mesa, então o robô deve completar a montagem a partir de uma disposição desorganizada:
| Método | Avião de brinquedo | Trator de brinquedo | Carrinho Hot Wheels |
|---|---|---|---|
| Ajuste fino supervisionado (SFT) | 69/100 | 51/100 | 23/100 |
| Adicionar demonstrações corretivas em estados encontrados pela política (DAgger) | 84/100 | 71/100 | 78/100 |
| Adicionar recuperação agentic | 98/100 | 97/100 | 97/100 |
Taxas de sucesso de 97% ou mais são resultados do sistema combinado, que inclui demonstrações corretivas e recuperação. Algumas falhas ainda foram marcadas como completas, embora os parafusos não estivessem totalmente apertados. Verificar o estado físico continua sendo um desafio.
Direcionamento Visual: Tornando o Alvo Inequívoco
Somente a linguagem pode deixar incerto o que pegar, onde colocar ou qual braço deve agir. No mesmo sistema, o agente de raciocínio marca pontos de agarrar e soltar na visão atual da câmera, usa cores para indicar o braço e passa essas marcações para o GR00T 2 com uma instrução de etapa. O GR00T 2 gera os movimentos de aproximação, agarrar, transporte e soltura. O agente então verifica se deve continuar ou tentar novamente.
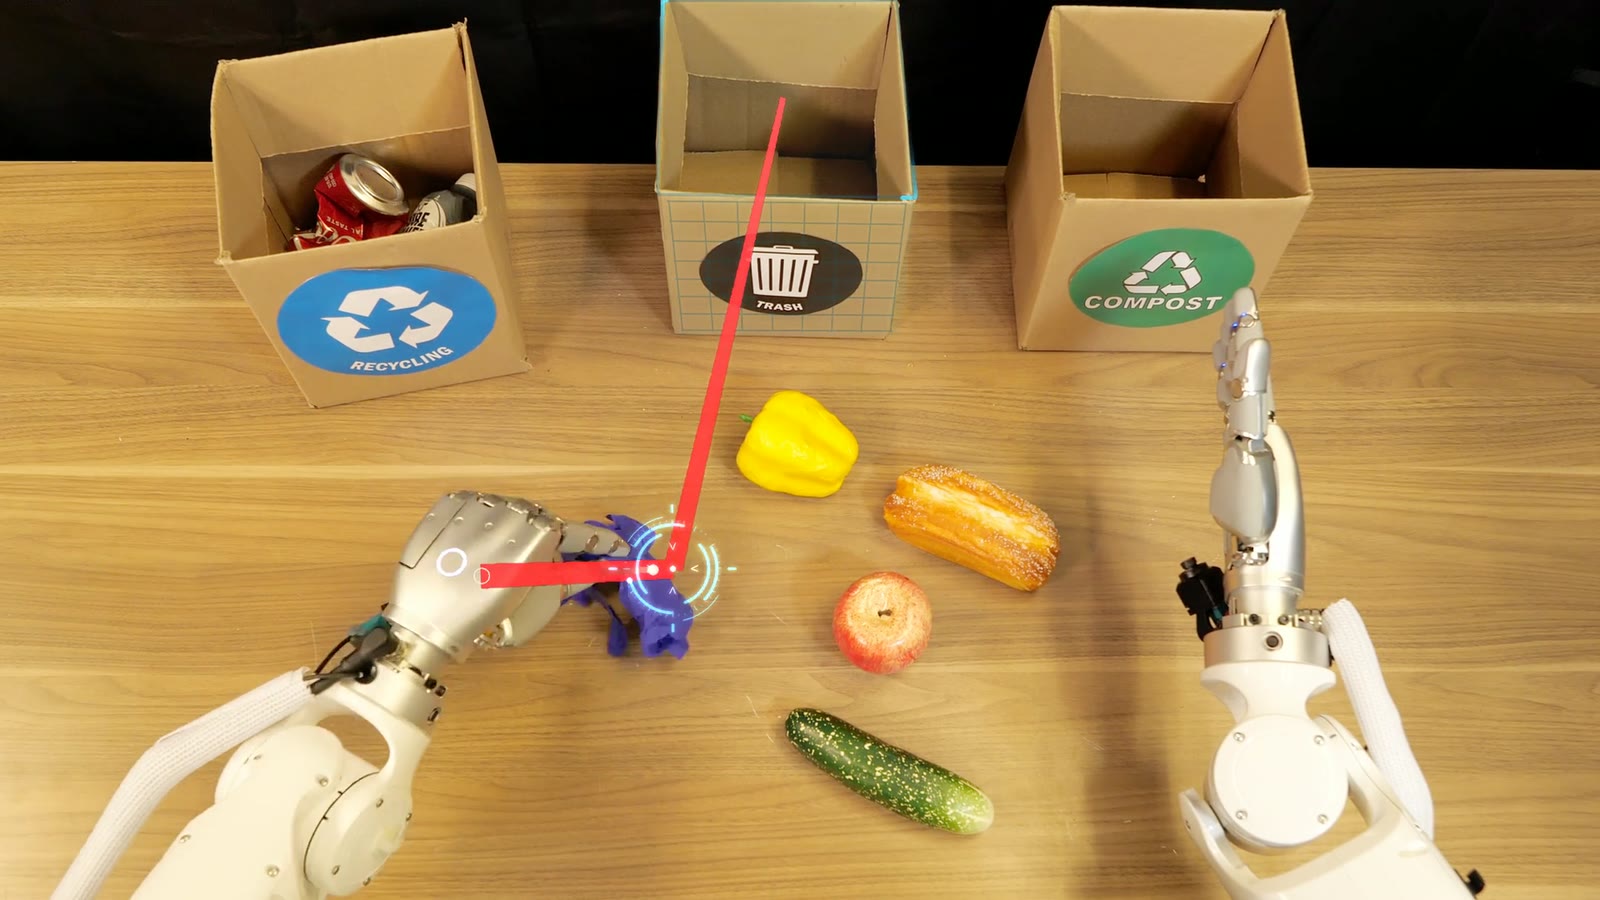
O exemplo de classificação do Dexter da NVIDIA mostra o objeto e a lixeira selecionados. As marcações especificam qual objeto mover e para onde ele deve ir naquela etapa.
As marcações de treinamento podem ser extraídas do estado das mãos e garras em demonstrações existentes. O modelo aprende a interpretar essas marcações durante o treinamento sem exigir uma nova coleta de demonstrações anotadas.
Nos testes de curto horizonte what-and-where do YAM, cada configuração tem 90 tentativas. Apenas a instrução da tarefa produz 40% de sucesso. Instruções de etapa do planejador chegam a 66%, e adicionar marcações visuais a essas instruções de etapa chega a 92%. Todos os três resultados são para o mesmo subconjunto de tarefas e devem ser mantidos separados de agregados que incluam outros tipos de instruções.
Com direcionamento visual, o YAM completa 17/20 tentativas de classificação de resíduos de longo horizonte e 3/10 tentativas de desmontagem de placas. Completar toda a tarefa de classificação ainda é difícil para o Dexter. Pontos de agarrar e soltar também deixam a orientação final e movimentos intermediários, como despejar ou limpar, não especificados. A linguagem e as habilidades de manipulação aprendidas ainda fornecem essas informações.
Adaptação rápida e aprendizado por reforço melhoram habilidades individuais. Agentic GR00T 2 combina execução, verificação e recuperação em tarefas mais longas. Implantar predição conjunta em um humanóide em movimento também exige lidar com o custo de inferência e o controle de corpo inteiro.
GR00T 2 Turbo: Loco-Manipulação de Corpo Inteiro Embarcada
O Que a Compactação Economiza e o Que Ela Custa
Um humanóide precisa manipular objetos enquanto se move e mantém o equilíbrio. O custo da predição conjunta de vídeo e ação afeta se uma política pode fazer isso no hardware embarcado do robô.
GR00T 2 Turbo usa um Transformer conjunto de vídeo e ação menor, com 2B de parâmetros, e um codificador de vídeo com maior compactação. Uma representação de vídeo mais compacta reduz a computação enquanto mantém a predição conjunta e o mesmo horizonte de ação.
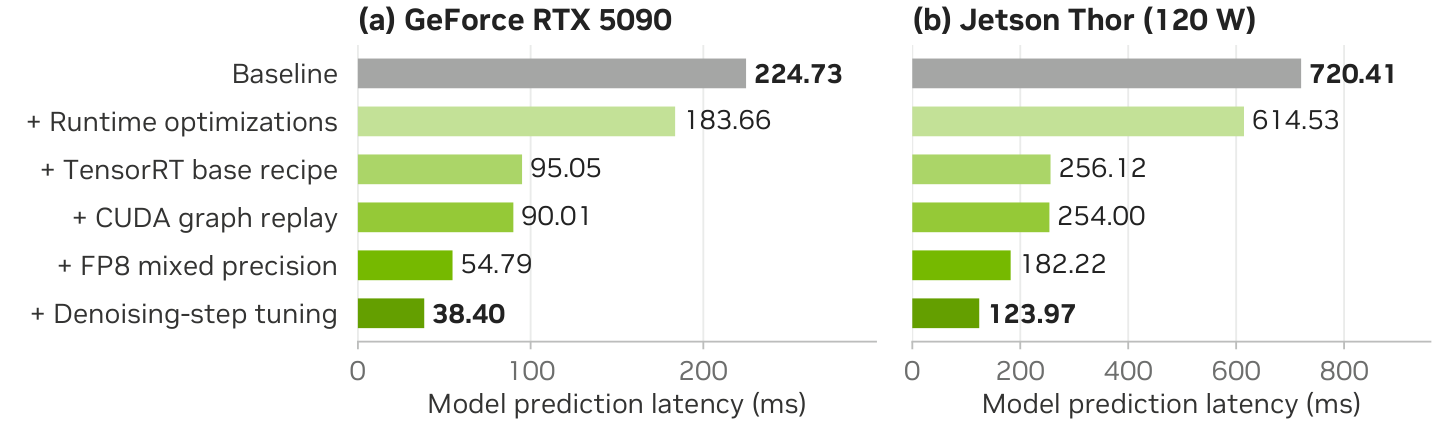
A Figura 19 compara o tempo de predição para o mesmo checkpoint antes e depois da otimização de inferência. Na configuração G1 otimizada, uma predição leva cerca de 38 ms em uma RTX 5090 e 124 ms no Jetson Thor embarcado. Isso mede a predição do modelo, não a resposta completa, que também inclui preparação da observação, transmissão e controle. A melhoria reflete toda a configuração de inferência, e não apenas a compactação do modelo.
Há um compromisso entre velocidade e capacidade. Na comparação tarefa a tarefa da NVIDIA, o Turbo supera o GR00T 2 nas conexões de tubo fixo do YAM e na inserção de fio em disjuntor, mas fica atrás nas outras quatro tarefas do YAM. No Dexter, o Turbo fica atrás em cinco de seis tarefas e empata na sexta. Seus requisitos de computação são mais adequados para uso embarcado, enquanto o desempenho em manipulação fina ainda precisa ser verificado tarefa a tarefa.
Conectando Predições de Tarefa ao Controle de Corpo Inteiro em Alta Frequência
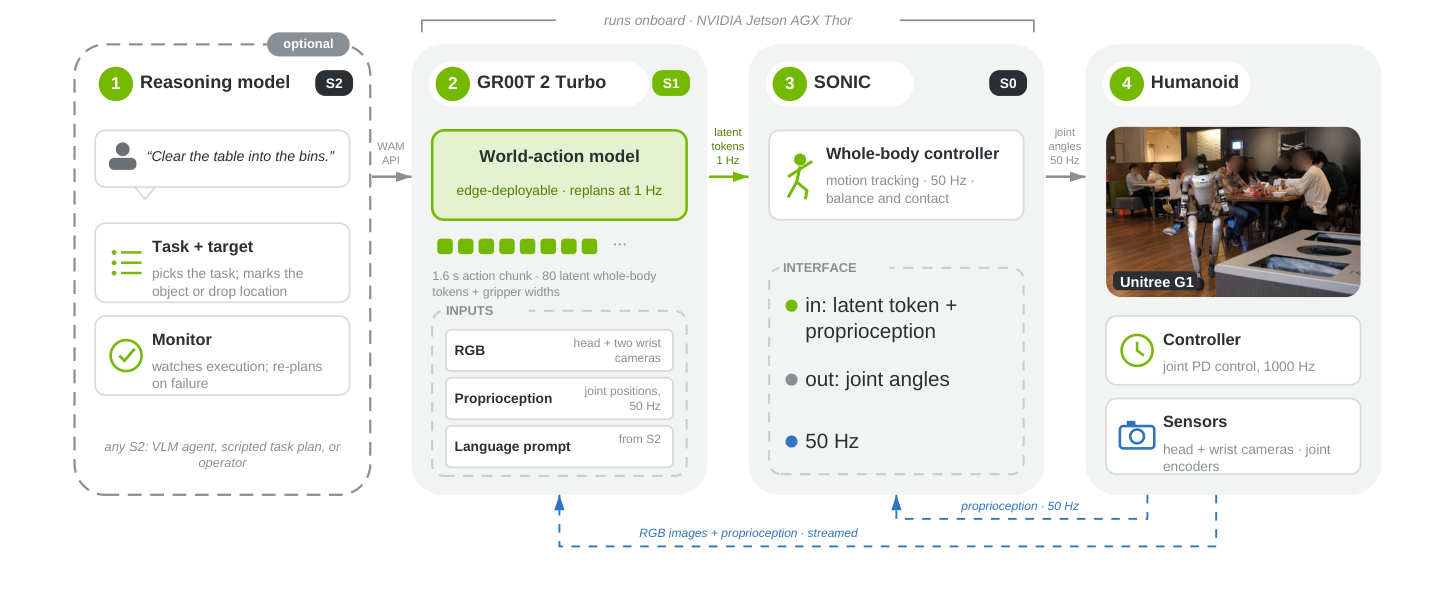
A Figura 9 separa a predição em nível de tarefa do controle do corpo. Um modelo de raciocínio seleciona a tarefa. O Turbo prediz conjuntamente tokens de vídeo futuro e de movimento de corpo inteiro. O controlador de corpo inteiro SONIC converte esses tokens em alvos de juntas usando o estado atual do robô para seguir o movimento e manter o equilíbrio.
O Turbo planeja aproximadamente uma vez por segundo e gera 1,6 segundos de movimento por bloco. O SONIC executa a 50 Hz. O controlador de nível inferior mantém o robô em movimento sem exigir que o modelo gere uma nova predição de vídeo a cada 20 milissegundos. Os componentes de execução rodam embarcados; o modelo de raciocínio de nível superior roda separadamente.
O sistema G1 completa 48/48 tentativas de servir pipoca e 28/30 tentativas de limpar a mesa, mas apenas 14/30 tentativas em uma tarefa de limpeza de corpo inteiro mais difícil. A predição conjunta pode suportar loco-manipulação no mundo real, com espaço claro para melhorar a confiabilidade em tarefas mais difíceis.
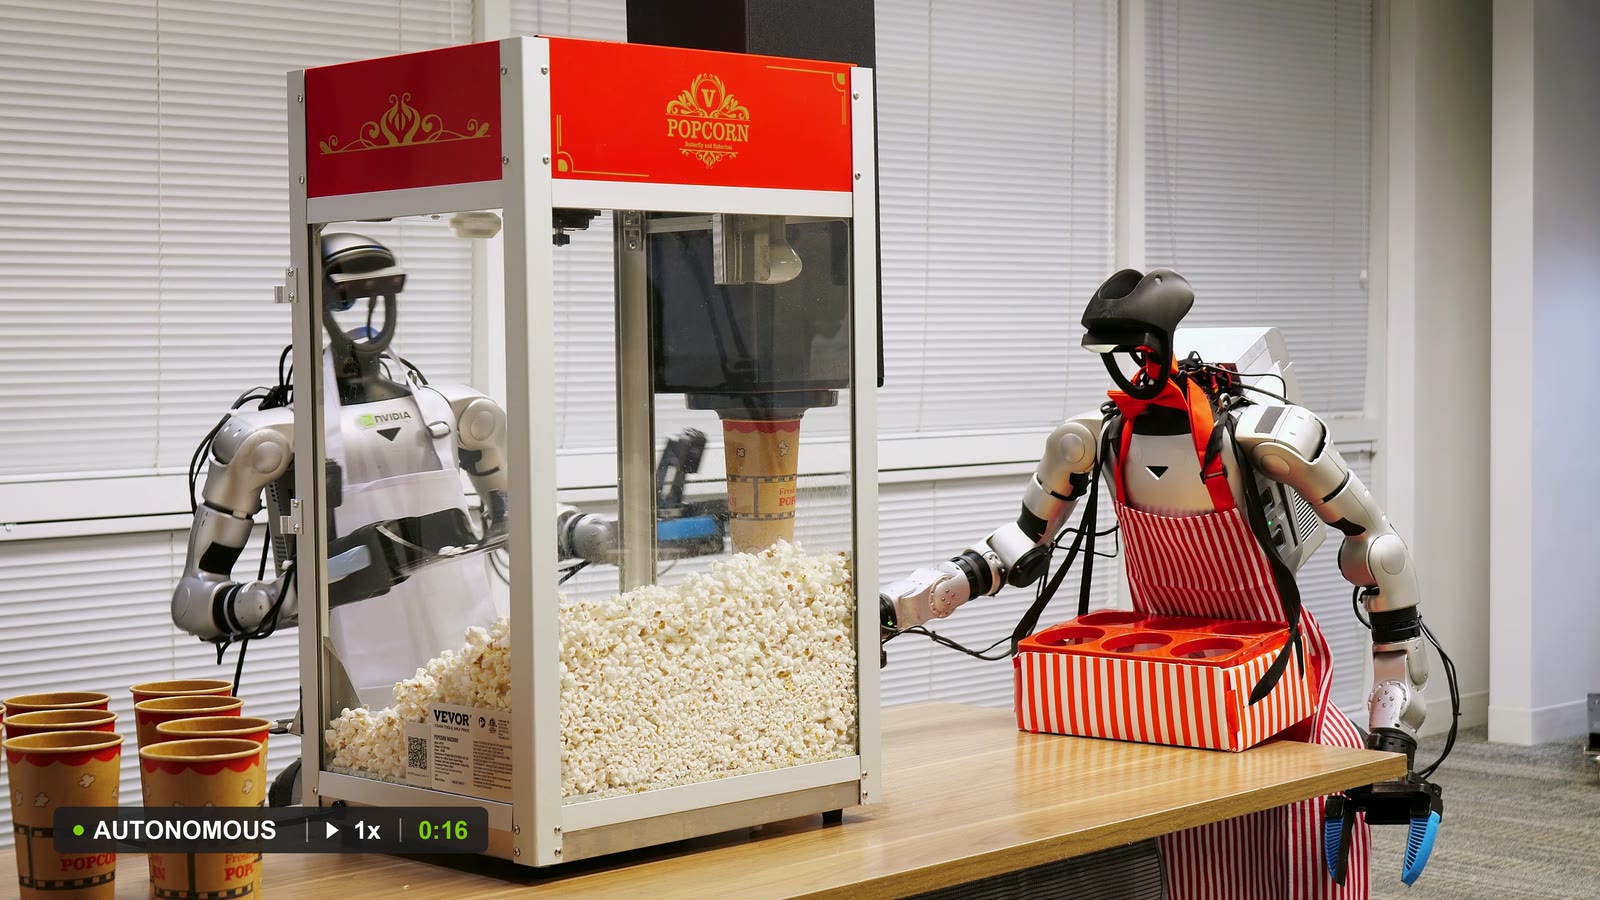
Na demonstração oficial de pipoca, segurar a bandeja e entregar a pipoca exige que os movimentos das mãos e o movimento de corpo inteiro funcionem em conjunto.
Simulação para Treinamento e Avaliação
Adicionando Experiência para o Corpo-Alvo
Coletar demonstrações de corpo inteiro e aprender por tentativa e erro em um robô real é caro. A simulação pode complementar os dados do robô real com mais variação nas tarefas e nos movimentos do robô. Testes no mundo real então verificam se as habilidades são transferidas.
Com os dados reais de treinamento mantidos fixos, adicionar demonstrações simuladas eleva a taxa de sucesso do Turbo em robôs reais nas tarefas G1 fora da distribuição de 6,7% para 63,3%. O GR00T 1.7 atinge 40,0% com dados de simulação. A comparação apoia o uso de dados de simulação como uma forma de melhorar a generalização no mundo real nesse contexto; isso não implica que toda habilidade simulada será transferida diretamente.
No exemplo de pegar a coroa com o G1 da NVIDIA, a imagem superior é a simulação e a imagem inferior é o robô real. Compare as posições dos objetos na mesa e a postura inicial do robô.
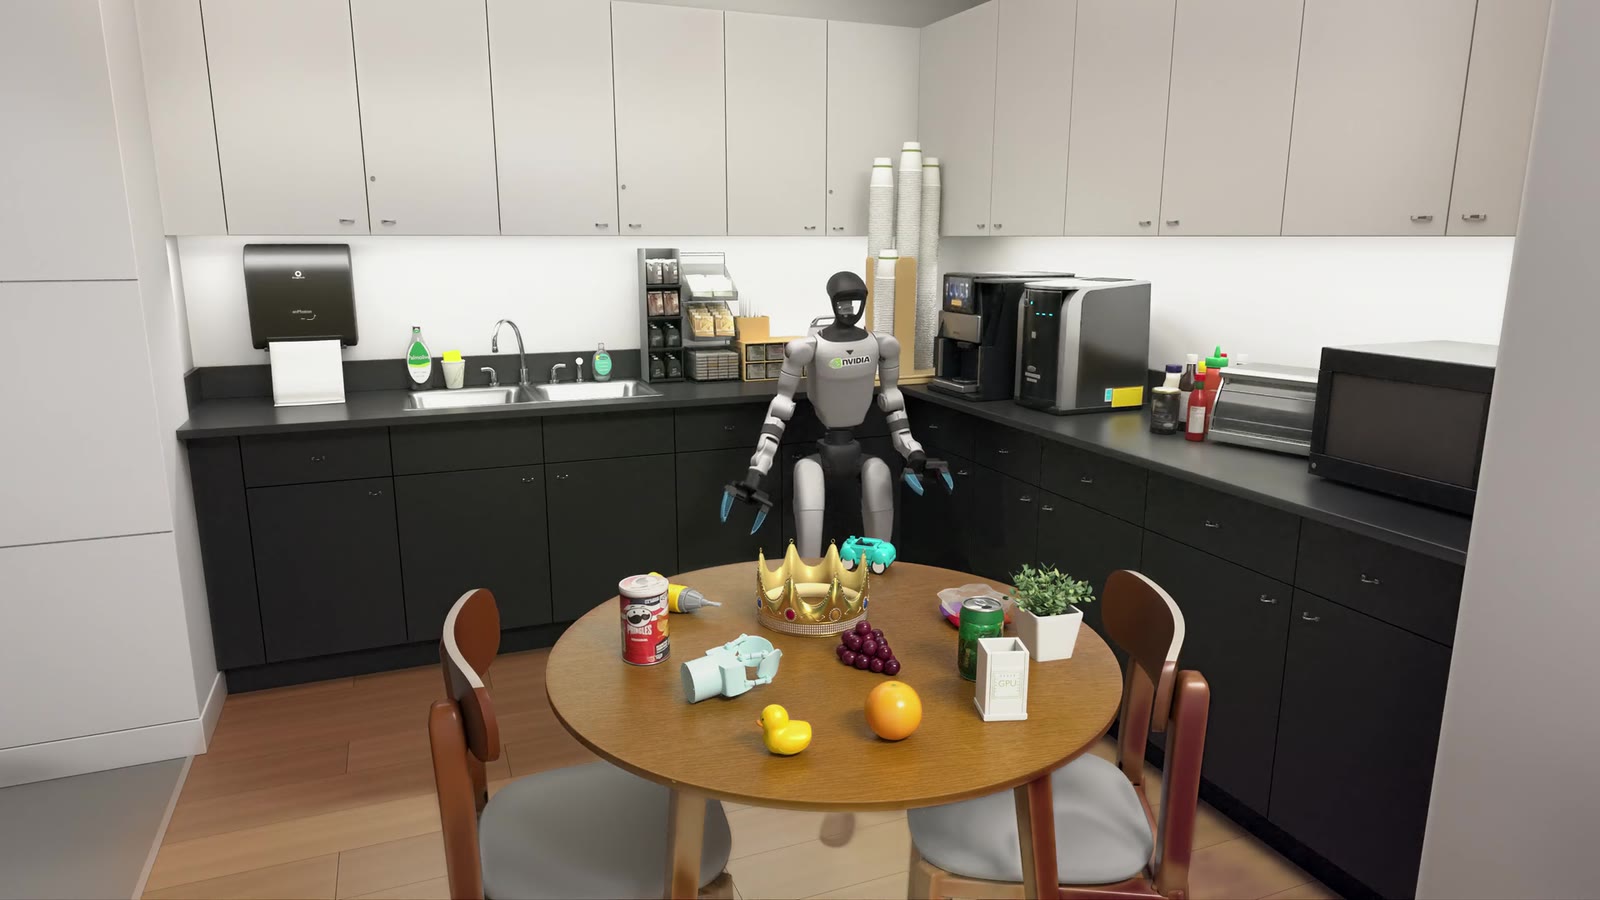
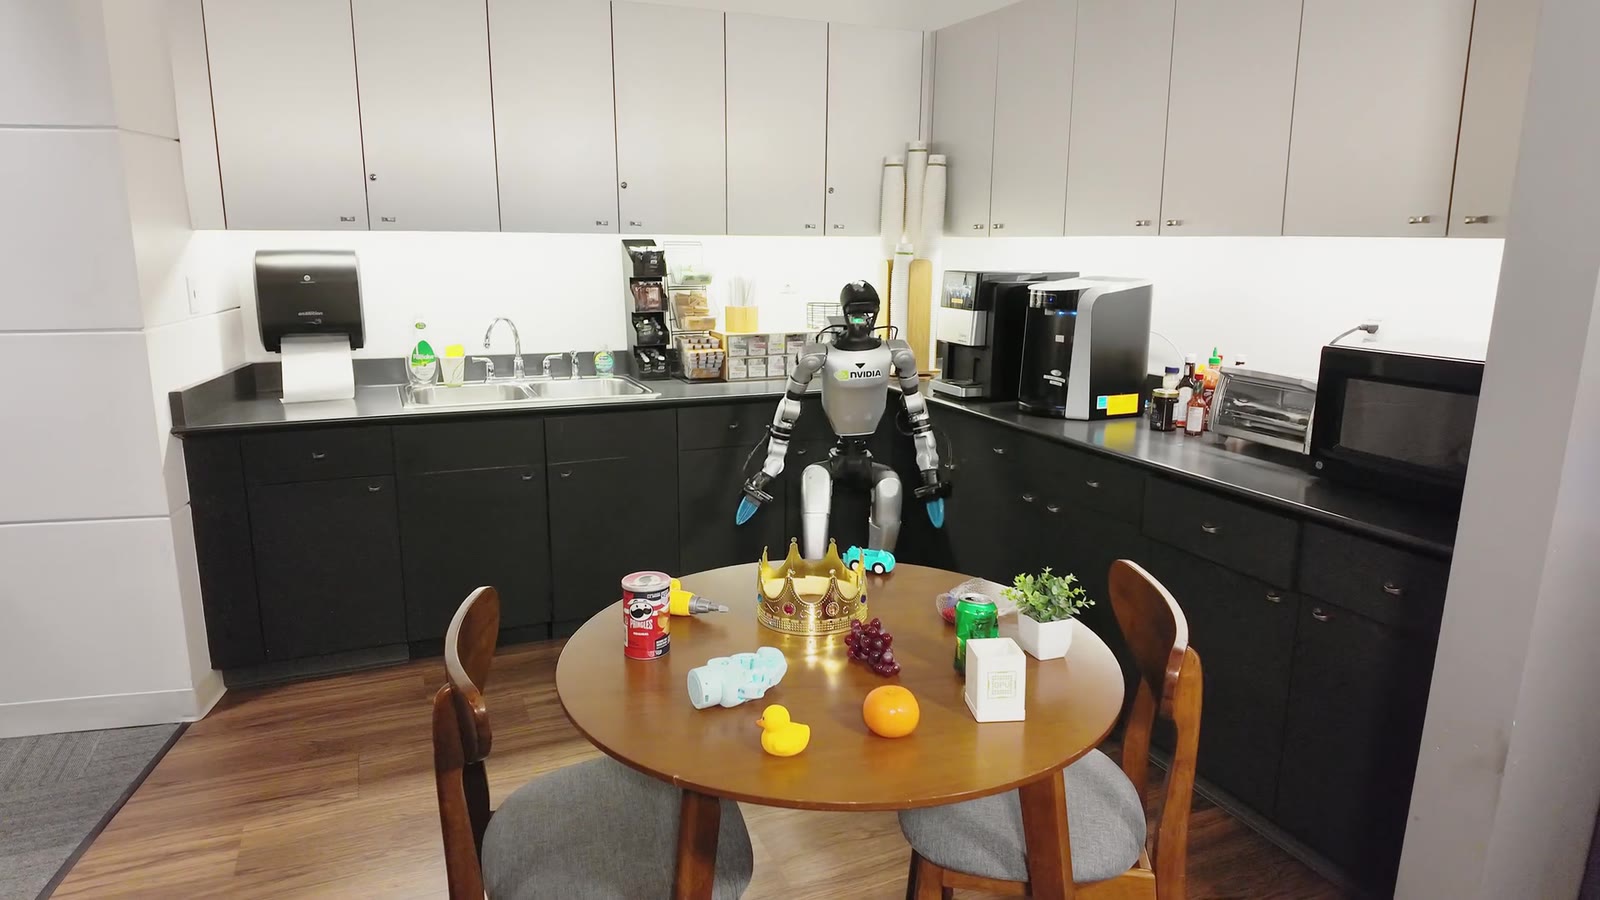
Esses componentes abordam diferentes partes da loco-manipulação de corpo inteiro: o Turbo reduz o custo de predição, o SONIC conecta as predições ao controle físico e a simulação adiciona experiência para aprender novas habilidades.
Usando Gêmeos Digitais para Selecionar Modelos
A simulação também ajuda desenvolvedores a selecionar modelos antes dos testes com robôs reais. Os autores usam vídeos de robôs, varreduras e fotografias para reconstruir o ambiente da tarefa, incluindo geometria, aparência e modelos de colisão. Testes automatizados e feedback humano ajudam a refinar os gêmeos digitais resultantes.
Em 25 tarefas YAM e 14 políticas, as taxas de sucesso simuladas e em robôs reais têm uma correlação de Pearson de 0,92. Essa correspondência permite que os desenvolvedores filtrem configurações de processamento de dados ou de inferência em simulação antes de testá-las no hardware.
O resultado apoia a simulação como uma ferramenta de desenvolvimento para essas tarefas. Novas condições de contato, corpos ou métodos de treinamento ainda exigem novas verificações de quão de perto a simulação acompanha a realidade. Uma correlação alta por si só não valida a execução no mundo real.
Conclusão: Transformando um Modelo Compartilhado em Habilidades Utilizáveis
O GR00T 2 aprende mudanças visuais futuras e ações do robô em conjunto, permitindo que vídeos humanos, demonstrações com dispositivos portáteis e dados de robôs contribuam para uma base comum de habilidades. Experimentos entre diferentes corpos mostram como a experiência em tarefas pode ser transferida. Adaptação com poucos exemplos e aprendizado por reforço melhoram operações específicas. Um agente de raciocínio sequencia tarefas, identifica alvos e lida com recuperação. O Turbo e um controlador de corpo inteiro trazem a predição conjunta para a loco-manipulação embarcada.
A modelagem conjunta fornece a base compartilhada; alinhamento e pós-treinamento transformam essa base em habilidades de tarefa; controle e feedback colocam essas habilidades em uso. Os três grupos de capacidades compartilham uma abordagem de modelagem e dependem de seus próprios dados, treinamento e componentes de sistema.
Os resultados apoiam o potencial de escalar essa abordagem, com limites claros. Demonstrações zero da tarefa-alvo ainda dependem de experiência prévia com o corpo-alvo. O alto sucesso com cinco exemplos depende da seleção da tarefa. Verificar estados físicos durante tarefas longas e realizar operações difíceis de corpo inteiro continuam sendo desafios. Um futuro previsto plausível não é confirmação de que o mundo físico mudou como previsto. A confiabilidade em última instância depende de feedback real e avaliação na tarefa pretendida.