GR00T N1: Como uma Arquitetura de Sistema Duplo Suporta o Controle Humanoide Generalista
GR00T N1: Um Modelo Fundamental Aberto para Robôs Humanoides Generalistas
- Robôs humanoides
- Arquitetura de sistema duplo
- Pirâmide de dados
- Flow matching
GR00T N1.7: Adaptação e Fine-Tuning
Esta leitura cobre o artigo original do GR00T N1. Para trabalho prático com o GR00T N1.7 (nvidia/GR00T-N1.7-3B), siga o curso reBot existente:
- Embodiment de Robô e Arquitetura GR00T
- Preparar um Dataset VLA para o reBot
- Fazer Fine-Tuning do GR00T N1.7 para o Braço reBot
- Implantar o Modelo com Fine-Tuning no Robô
As configurações experimentais do N1 discutidas abaixo pertencem ao artigo original. Use os tutoriais do N1.7 para configuração de treinamento e implantação específicas da versão.
Pré-requisitos
De ACT a GR00T N1: O Loop de Aprendizado é o Mesmo
Se você já usou LeRobot + ACT, este fluxo de trabalho é familiar:
Human teleoperation
    ↓
Collect camera / state / action data
    ↓
Organize an episode dataset
    ↓
Train a policy
    ↓
Observation → Action chunk → On-robot execution
GR00T N1 ainda responde à mesma pergunta:
Dado o que o robô vê, seu estado atual e a solicitação do usuário, como ele deve se mover em seguida?
Normalmente, o ACT aprende um robô e uma família de tarefas a partir de demonstrações. GR00T N1 busca priors gerais a partir de múltiplos robôs, vídeos humanos e dados sintéticos antes de se adaptar a um robô real específico.
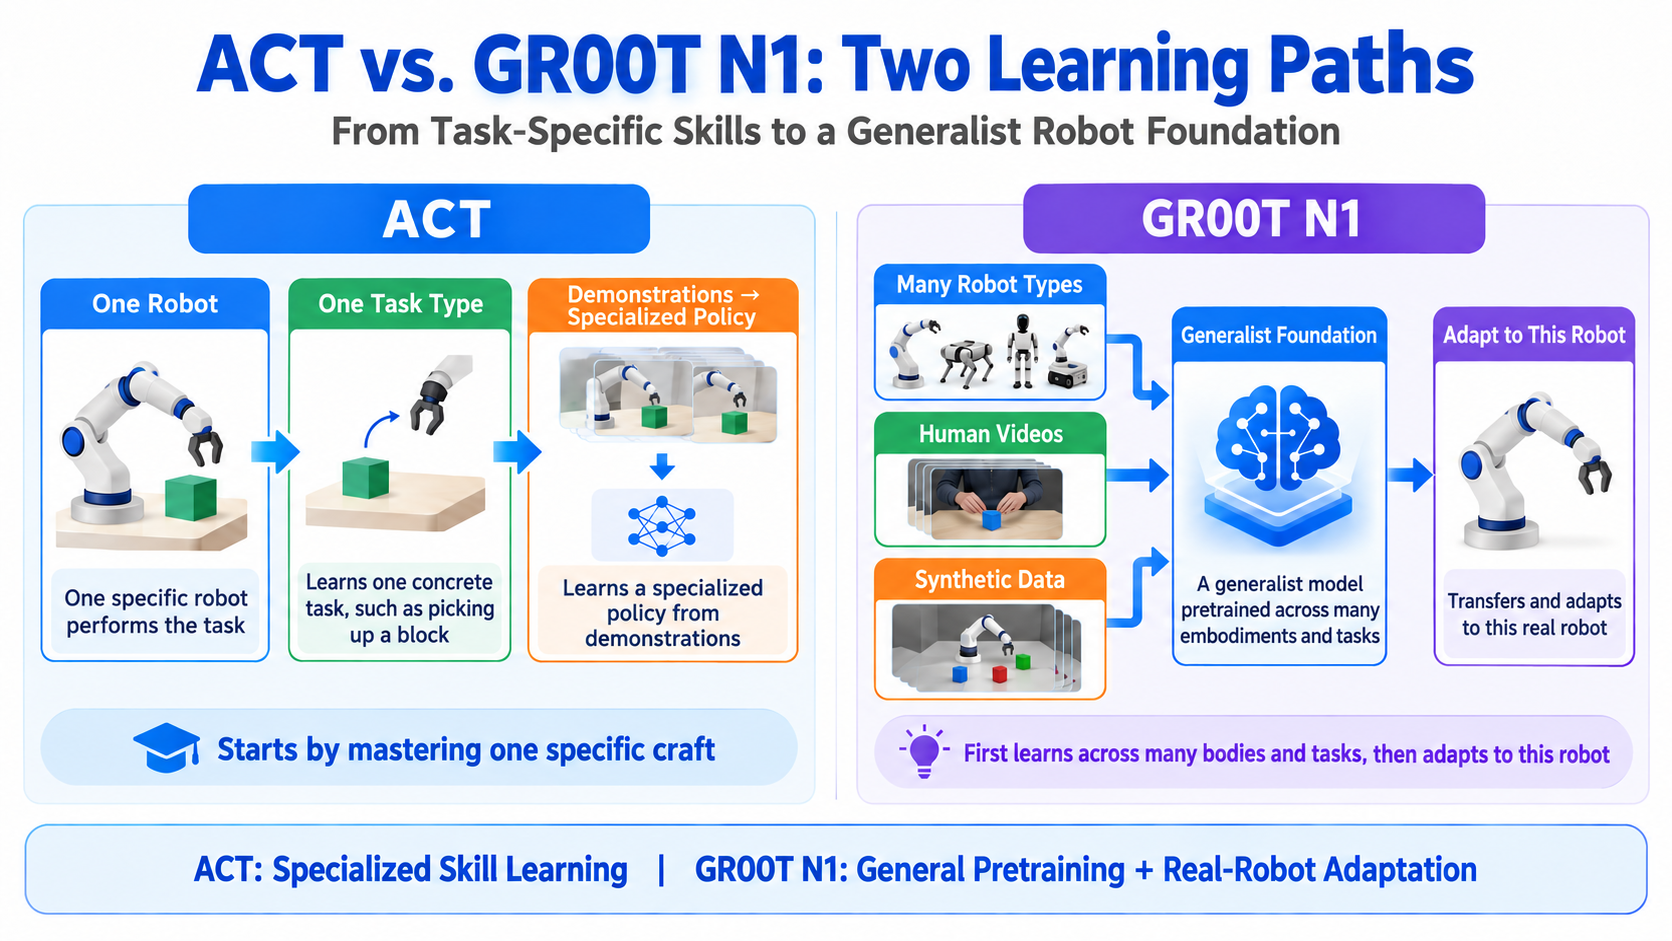
ACT começa com uma habilidade concreta; GR00T N1 primeiro aprende uma base comum entre corpos e tarefas, depois aprende a usar o robô atual.
Observação, Estado, Ação e Embodiment
Os três termos introduzidos com ACT mantêm seu significado:
-
Observação: informação de sensores externos, como imagens RGB da cabeça, do punho e de múltiplas vistas.
-
Estado: a configuração do robô, incluindo ângulos de juntas, abertura do gripper, pose do efetuador final, estado da cintura ou do pescoço.
-
Ação: controles solicitados, potencialmente alvos de juntas, incrementos, poses do efetuador final ou comandos do gripper.
Embodiment inclui mais do que aparência. Ele combina definições de corpo e de controle:
Robot structure
+ Sensors
+ State definition
+ Action definition
+ Control frequency and mode
= One embodiment
Um único Franka, um sistema bimanual e um humanoide GR-1 têm dimensões de estado/ação diferentes. Compartilhar um modelo entre esses corpos é um desafio central.
VLA, Action Chunking e Flow Matching
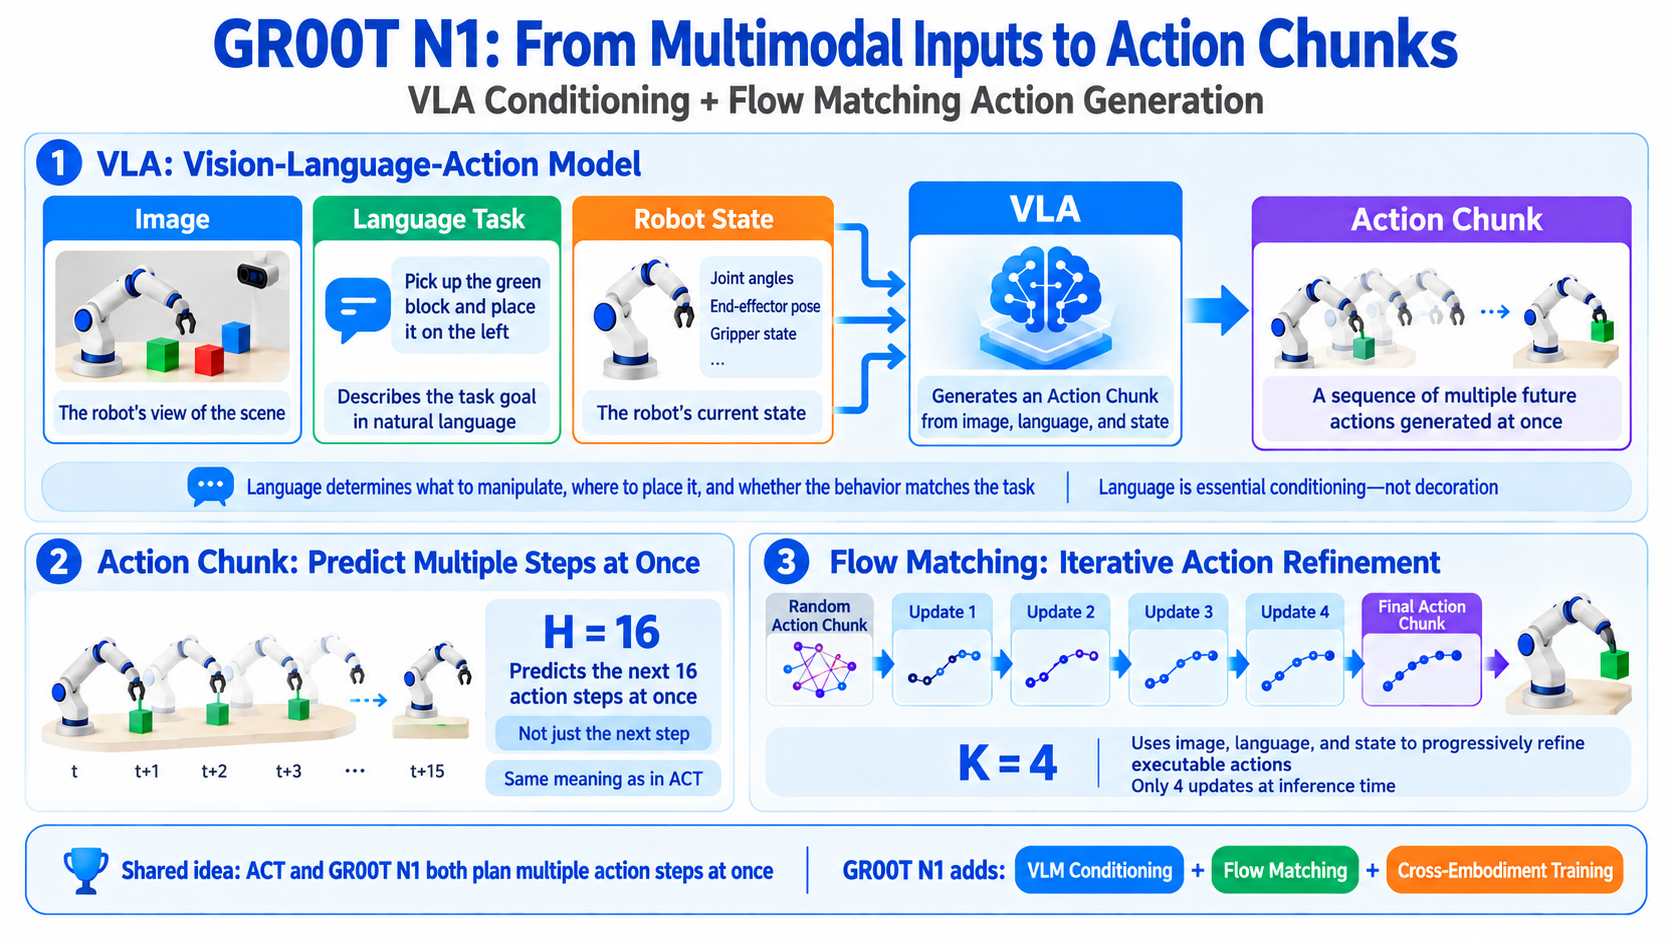
Uma VLA adiciona linguagem de tarefa às entradas visuais da política. A linguagem identifica qual objeto manipular, para onde ele deve ir e se o comportamento corresponde ao pedido; não é um contexto decorativo.
Um action chunk, como em ACT, prevê uma curta sequência futura em vez de uma única ação. GR00T N1 define H = 16.
Flow matching pode ser entendido como refinar ações aleatórias em um chunk executável sob condicionamento de imagem, linguagem e estado. O artigo usa apenas K = 4 atualizações de inferência.
Resumo
Robôs de uso geral precisam de corpos capazes e modelos inteligentes. Humanoides são promissores para ambientes humanos, mas compreender novas situações, lidar com variações do mundo real e aprender rapidamente novas tarefas exige modelos fundamentais treinados em dados grandes e diversos.
GR00T N1 é um modelo fundamental aberto para humanoides com uma arquitetura VLA de sistema duplo. Um módulo de visão e linguagem, Sistema 2, interpreta imagens e instruções; um Transformer de difusão, Sistema 1, gera ações suaves em tempo real. Os módulos são fortemente conectados e treinados em conjunto de ponta a ponta.
O treinamento mistura trajetórias reais, vídeos humanos e dados sintéticos. GR00T N1 supera as bases de comparação de aprendizado por imitação em benchmarks de simulação entre diferentes embodiments e aprende tarefas bimanual condicionadas por linguagem de forma eficiente no humanoide Fourier GR-1.
Três ideias organizam o artigo:
-
VLA de sistema duplo: um componente interpreta, outro age.
-
Dados heterogêneos: usar vídeos humanos, simulação e vídeos gerados junto com demonstrações de robôs.
-
Compartilhamento entre embodiments: corpos diferentes compartilham capacidades centrais em vez de receber modelos totalmente independentes.
Introdução e Trabalhos Relacionados
Hardware, Modelos, Dados e Ilhas de Dados
A introdução identifica três elementos necessários:
-
Hardware determina a capacidade física. Humanoides são atraentes porque ambientes humanos são projetados para corpos humanos.
-
Modelos devem lidar com tarefas abertas, não um comportamento fixo.
-
Dados determinam a exposição a ambientes, objetos, tarefas e corpos.
Modelos de linguagem e visão podem aprender a partir da internet, mas a robótica não tem um equivalente de internet de ações. Dados reais são caros e lentos de coletar, e robôs diferem em juntas, sensores e controles.
Juntar datasets ainda pode deixar ilhas de dados: arquivos compartilham um banco de dados, mas não espaços de semântica ou de ação.
O artigo, portanto, pergunta não apenas como projetar uma política, mas também como unificar seu corpus de treinamento.
A Pirâmide de Dados
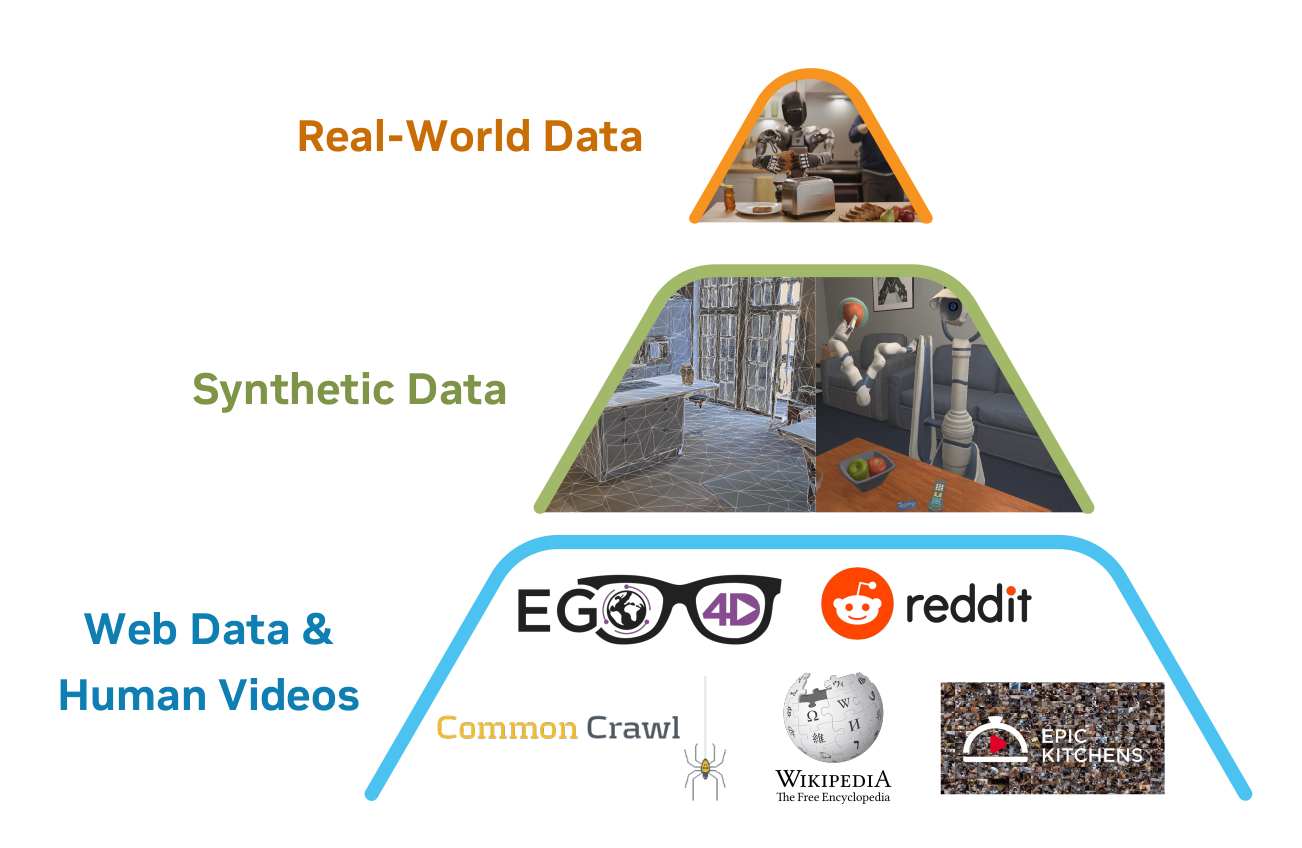
| Nível | Dados | Quantidade relativa | Relação com o robô |
|---|---|---|---|
| Base | Dados da web + vídeos humanos | Maior | Conceitos ricos de ação sem comandos diretos de robô. |
| Meio | Simulação + trajetórias neurais | Grande | Escalável e controlável, mas com viés de simulação ou geração. |
| Topo | Dados de robôs no mundo real | Menor | Mais próximo da execução, mais caro de coletar. |
Subir na pirâmide reduz a quantidade, mas aumenta a especificidade para o embodiment alvo.
Vídeos humanos: quais ações e tarefas existem Simulação / geração: como essas tarefas podem variar Dados de robôs reais: como este corpo deve executá-las
Arquitetura do GR00T N1
Sistema 2 Entende; Sistema 1 Age
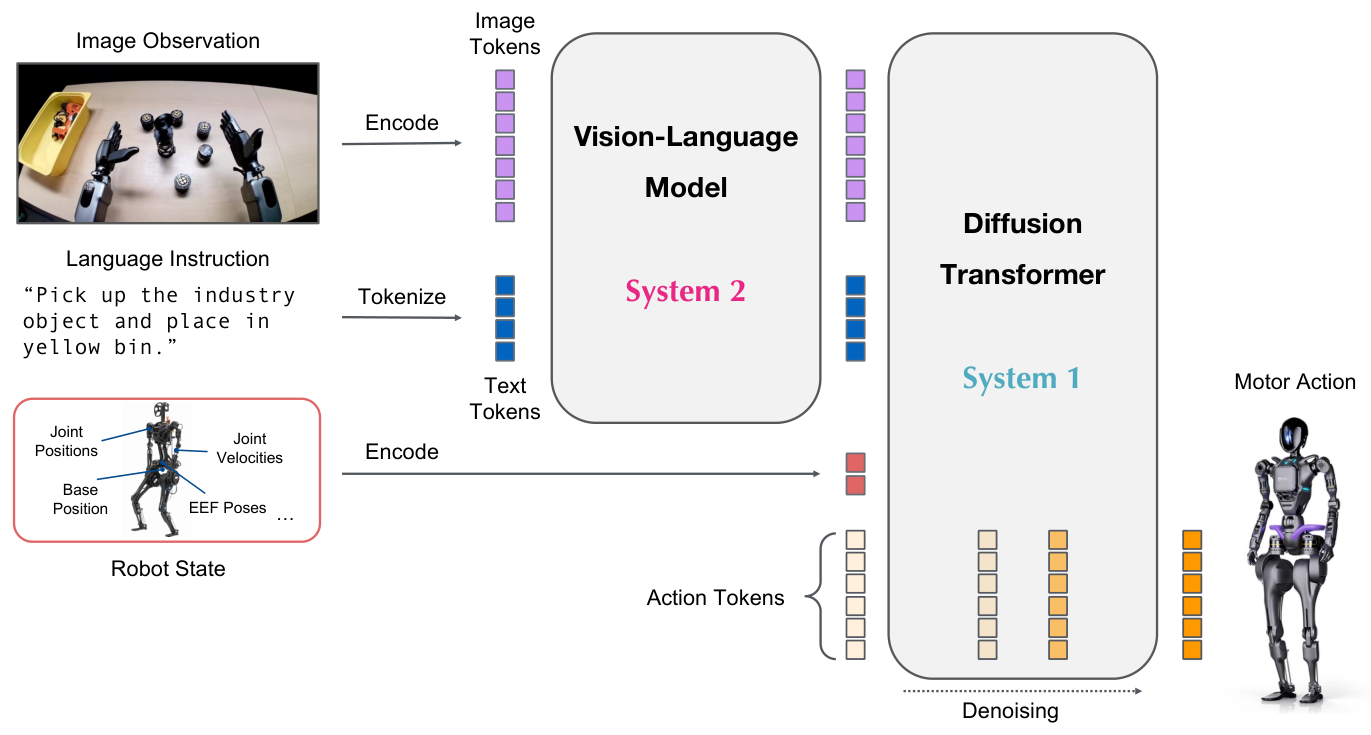
A arquitetura toma emprestada uma analogia de sistema duplo da cognição:
-
Sistema 2: Eagle-2 VLM, interpretando imagens, linguagem e tarefas.
-
Sistema 1: Transformer de difusão (DiT), gerando ações contínuas rapidamente.
Estes não são programas independentes: cross-attention os conecta de forma estreita e o treinamento os otimiza conjuntamente.
Eagle-2 contém um modelo de linguagem e um codificador de imagens. As imagens entram em 224 × 224, produzindo 64 tokens por quadro. Os autores usam recursos VLM intermediários da camada 12 em vez de recursos finais, melhorando a velocidade e o sucesso em tarefas posteriores em seus experimentos.
O Sistema 2 opera a cerca de 10 Hz em uma NVIDIA L40, enquanto o sistema de ação pode gerar controles em malha fechada em uma taxa mais alta. A interpretação de alto nível não precisa ser recomputada a cada milissegundo, enquanto o movimento deve permanecer contínuo.
Conectando Diferentes Robôs a um Único DiT
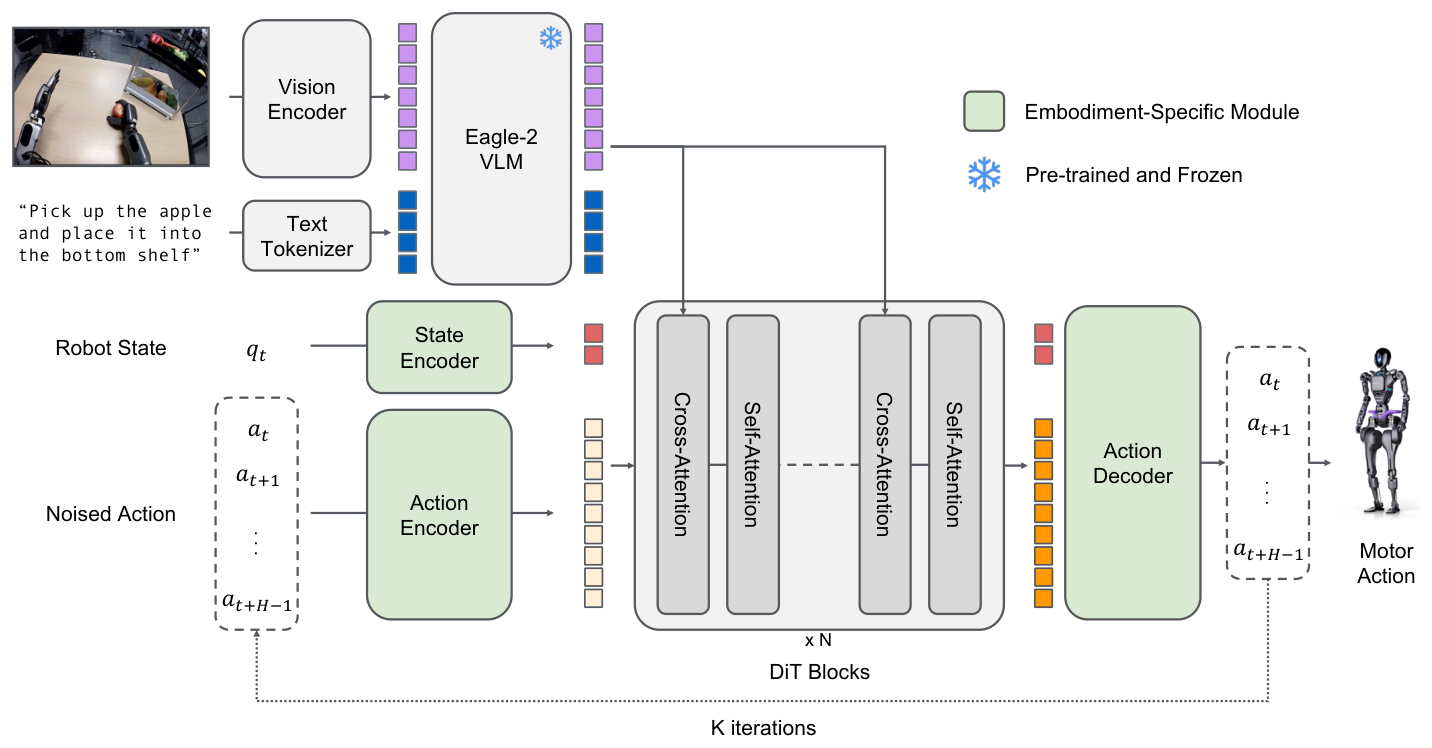
Existem dois tipos de módulos:
-
Núcleo compartilhado: VLM e DiT compartilham conhecimento visual, de linguagem e comportamental entre robôs.
-
Interfaces específicas de embodiment: codificador de estado, codificador de ação e decodificador de ação traduzem dimensões de plataforma e semântica de controle de e para recursos compartilhados.
| Módulo | Função | Por que específico de embodiment? |
|---|---|---|
| Codificador de estado | Codificar o estado atual como tokens. | Campos e dimensões de estado diferem. |
| Codificador de ação | Codificar ações ruidosas e o tempo de geração. | Dimensões de ação diferem. |
| Decodificador de ação | Converter recursos do DiT em controles. | Modos de controle de juntas, efetuador final e gripper diferem. |
Comentário: Aprendizado entre robôs diferentes não é apenas preencher vetores com zeros até terem o mesmo comprimento. Dimensões iguais são sem sentido sem saber que junta, pose ou comando cada valor representa.
Chunks de Ação com Flow-Matching
No tempo t, predizer uma sequência em vez de uma única ação:
A_t = [a_t, a_(t+1), ..., a_(t+H-1)]
H = 16
O treinamento começa com o chunk real A_t, ruído Gaussiano ε e tempo de fluxo τ, construindo:
A_t^τ = τ A_t + (1 - τ) ε
-
Perto de
τ=0, o chunk se assemelha a ruído. -
Perto de
τ=1, ele se assemelha a ações reais.
O DiT lê recursos de visão-linguagem, recursos de estado e ações ruidosas para aprender uma direção de atualização. O artigo escreve a loss como:
L_fm(θ)
= E_τ [ || V_θ(φ_t, A_t^τ, q_t) - (ε - A_t) ||² ]
Aqui φ_t denota recursos de VLM e q_t recursos de estado do robô.
Na inferência não há ação futura real, então ela começa a partir de ruído e realiza quatro atualizações de Euler direto:
A_t^0 ~ N(0, I)

A_t^(τ+1/K)
= A_t^τ + (1/K) V_θ(φ_t, A_t^τ, q_t)

K = 4
GR00T-N1-2B tem 2,2B de parâmetros totais, incluindo cerca de 1,34B no VLM. Em uma L40, gerar um chunk de 16 passos leva cerca de 63,9 ms.
Dados e Treinamento
Usando Vídeos sem Ações de Robô
Trajetórias de robô supervisionam diretamente imagens, estados e ações. Vídeos humanos e gerados contêm imagens, mas nenhum comando de junta de robô.
GR00T N1 adiciona supervisão semelhante a ações de duas maneiras.
Ações latentes aprendem códigos comportamentais discretos a partir de mudanças visuais, em vez de ângulos de junta exatos: conceitos como mover para a esquerda, agarrar ou empurrar.
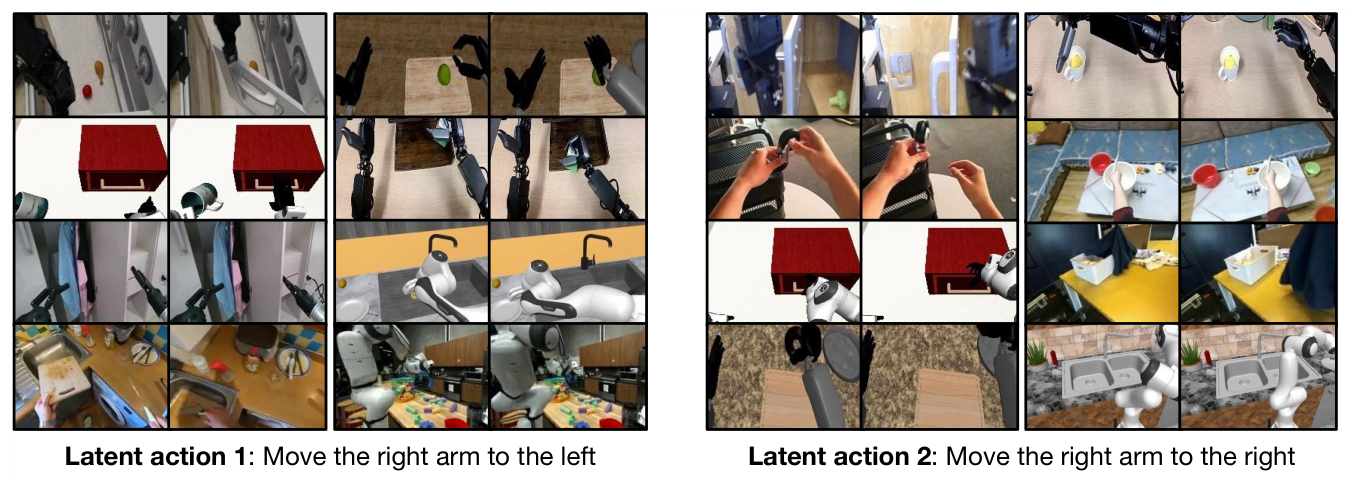
Estas podem abranger diferentes corpos: mãos humanas e garras de robô têm juntas diferentes, mas ambas podem mover um objeto para a esquerda na imagem.
Um modelo de dinâmica inversa (IDM) infere ações entre observações:
Observation_t + Observation_(t+1)
                  ↓
                 IDM
                  ↓
          Pseudo Action Label
Ações latentes se assemelham a um vocabulário comportamental sem unidade; saídas de IDM se assemelham a rótulos de pseudo-ações. Nenhuma das duas torna os vídeos demonstrações físicas perfeitas. Elas tornam dados apenas de imagem utilizáveis para pré-treinamento.
Trajetórias Neurais e Simulação: Mais Variação a partir de Menos Demonstrações
A geração de vídeo começa a partir de imagens reais de robô e varia prompts de linguagem para sintetizar tarefas, posições de objetos e trajetórias. Estas são trajetórias neurais.
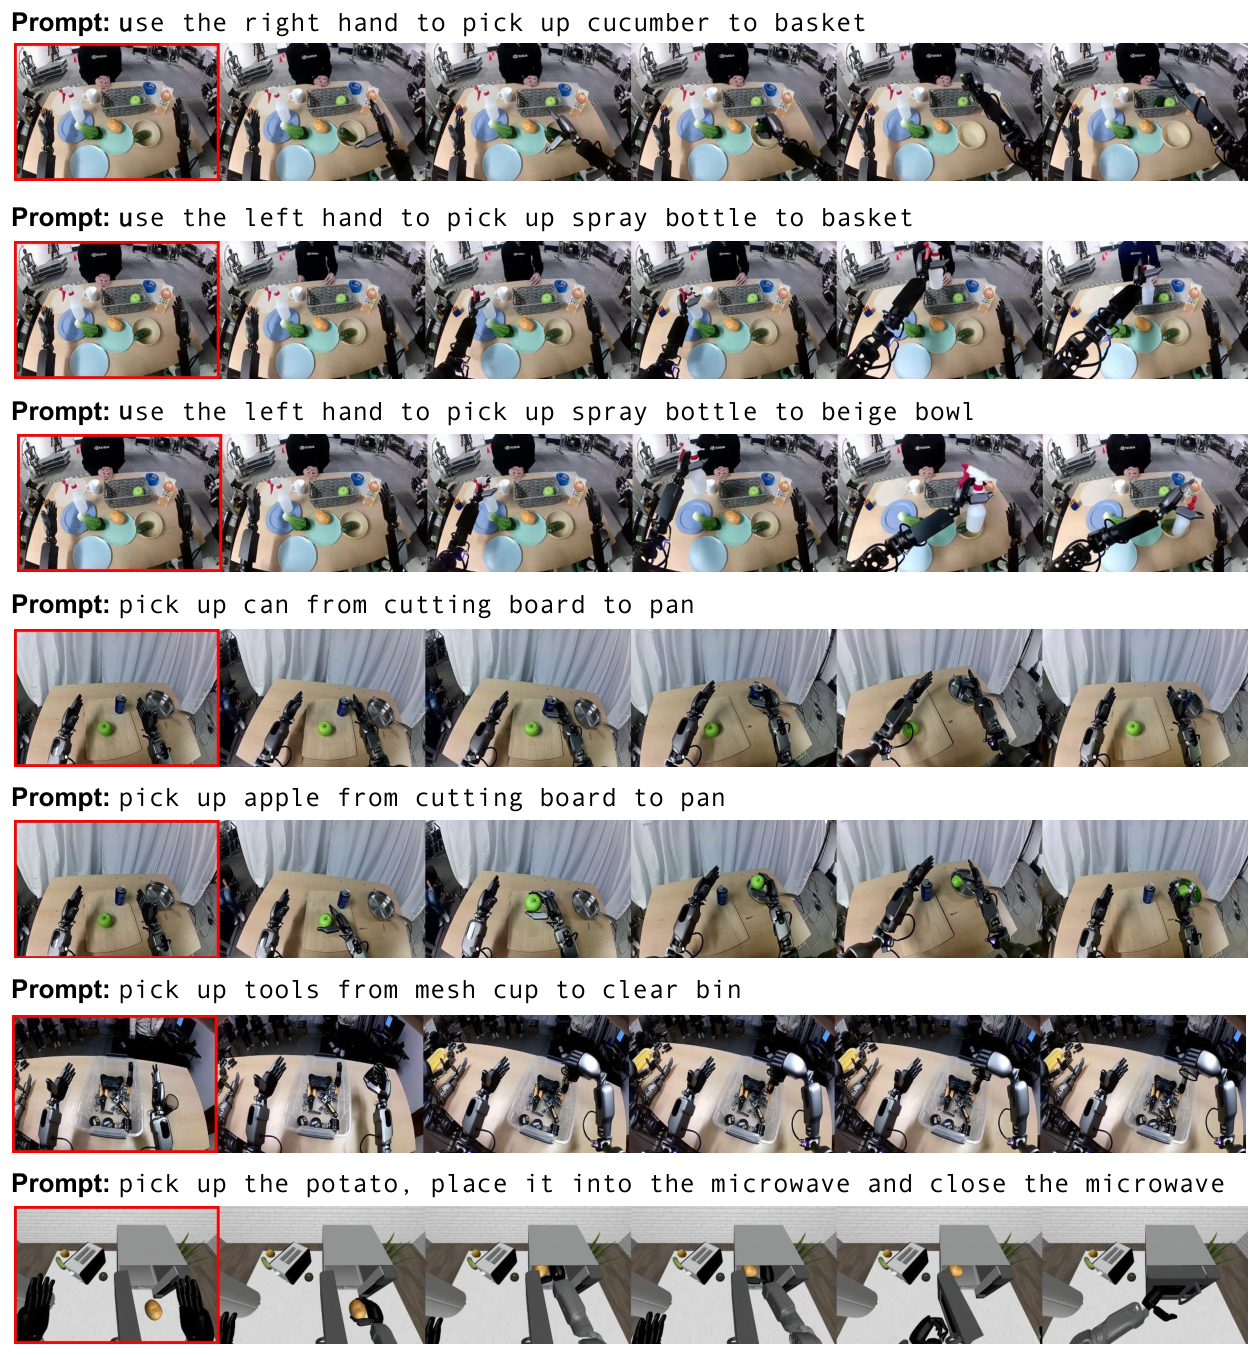
Os autores expandem 88,4 horas de teleoperação interna para 827,3 horas de vídeo gerado, quase dez vezes mais. A geração pode mover objetos de forma impossível, distorcer contatos ou deformar o robô, então filtros baseados em modelo de linguagem e regras removem amostras de baixa qualidade antes que ações latentes ou IDM forneçam supervisão.
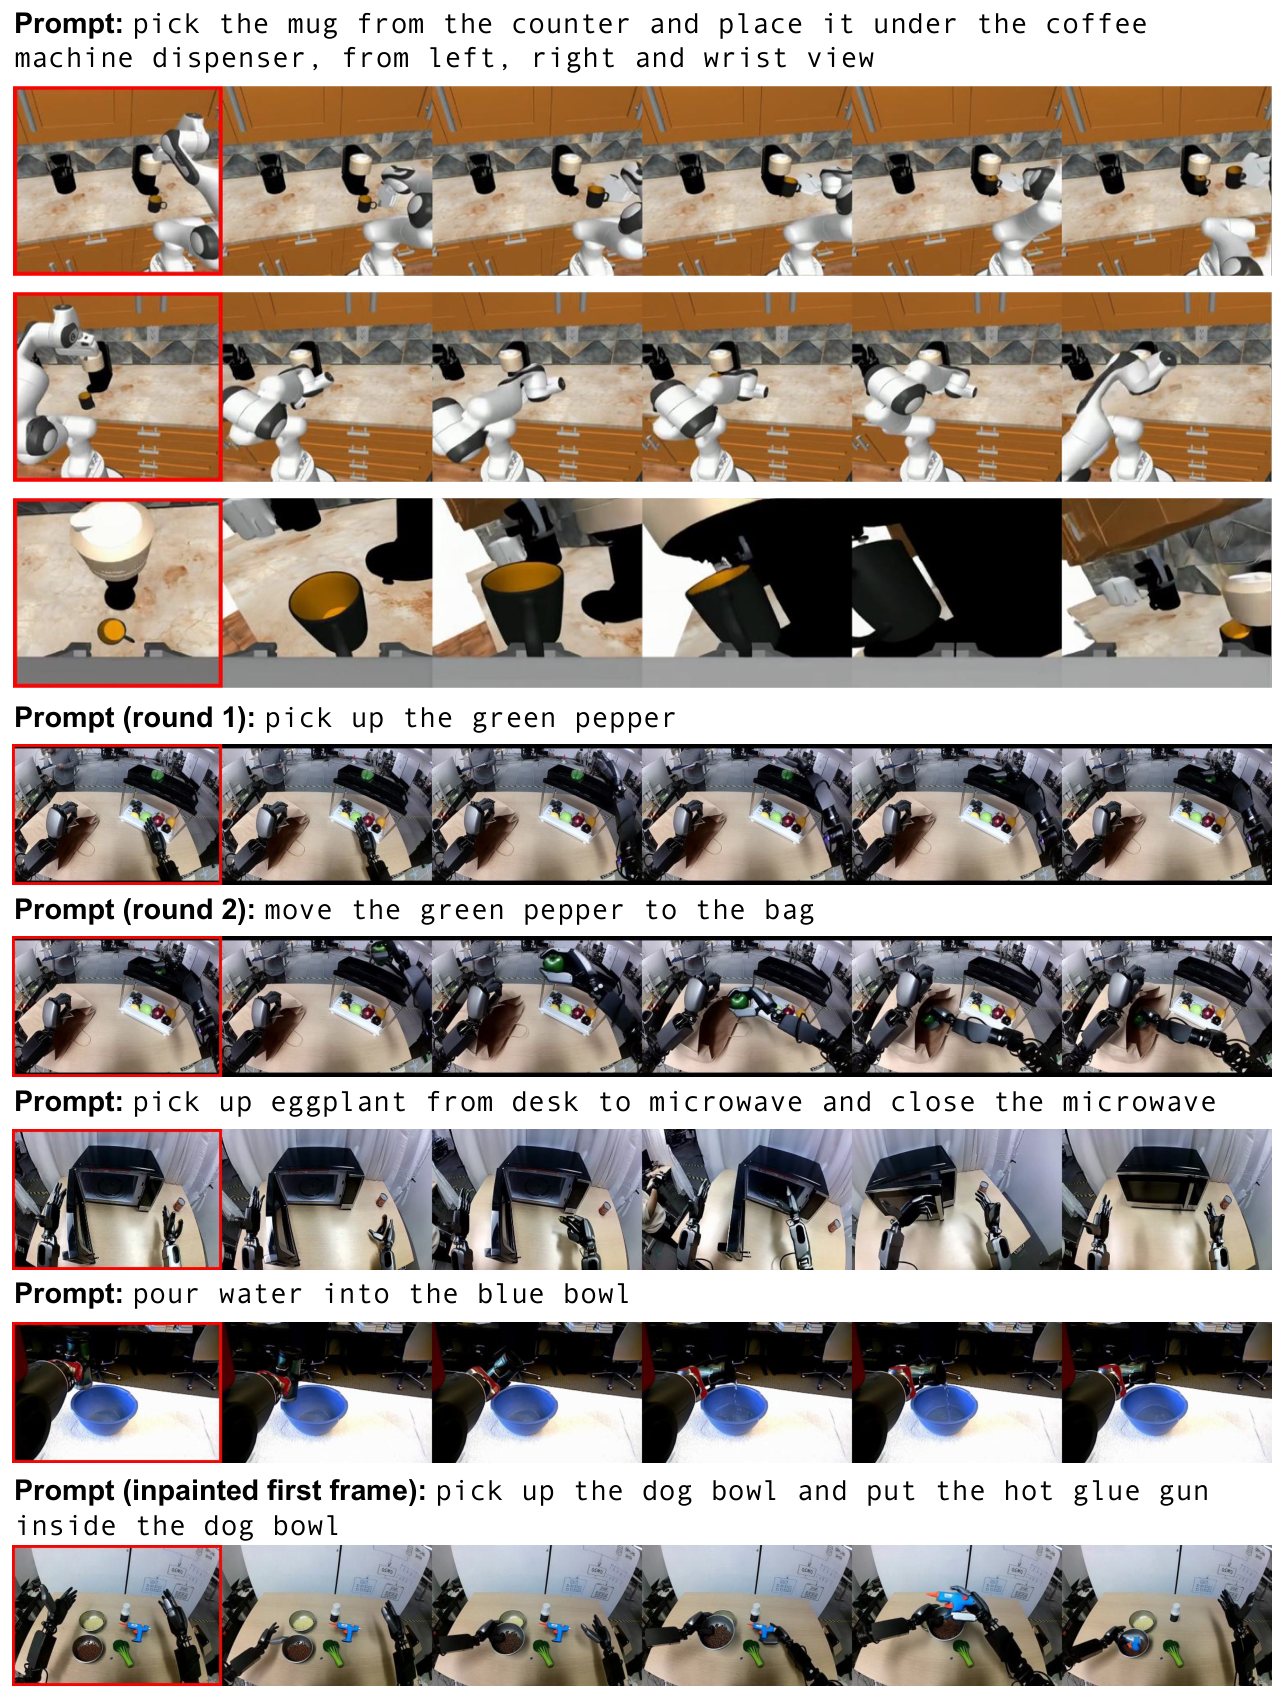
A simulação, por sua vez, é executada em um motor de física. Métodos como DexMimicGen redirecionam demonstrações centradas em objetos para novas cenas, produzindo cerca de 780.000 trajetórias simuladas, aproximadamente 6.500 horas.
Diferença:
-
Trajetórias neurais fornecem variação visual e semântica, mas confiabilidade física limitada.
-
A simulação fornece ações exatas e interações físicas, mas mantém um gap sim-to-real.
Pré-Treinamento e Pós-Treinamento
Dados de teleoperação vêm de Manus, VIVE, Apple Vision Pro, Leap Motion e outros dispositivos, redirecionados para os robôs.
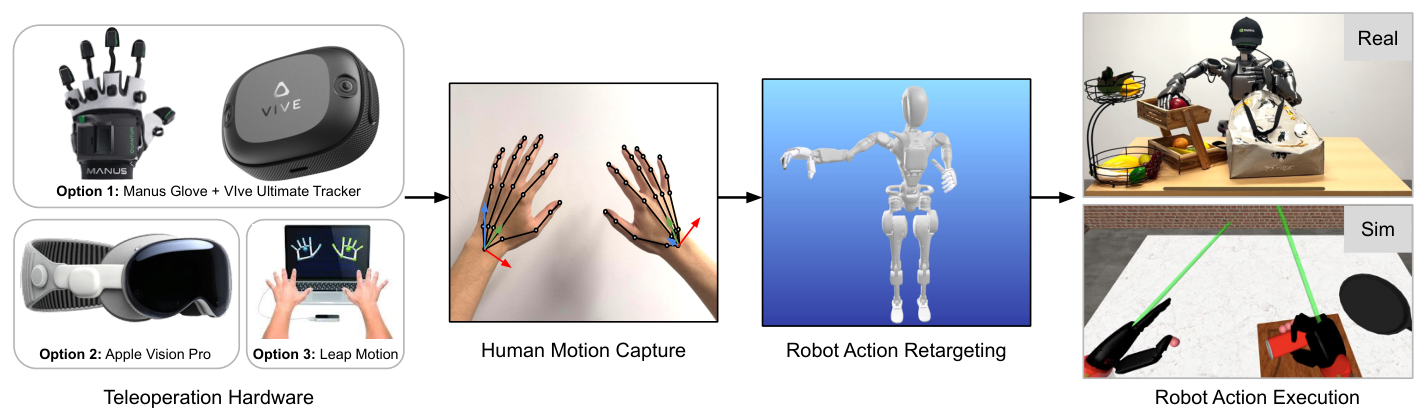
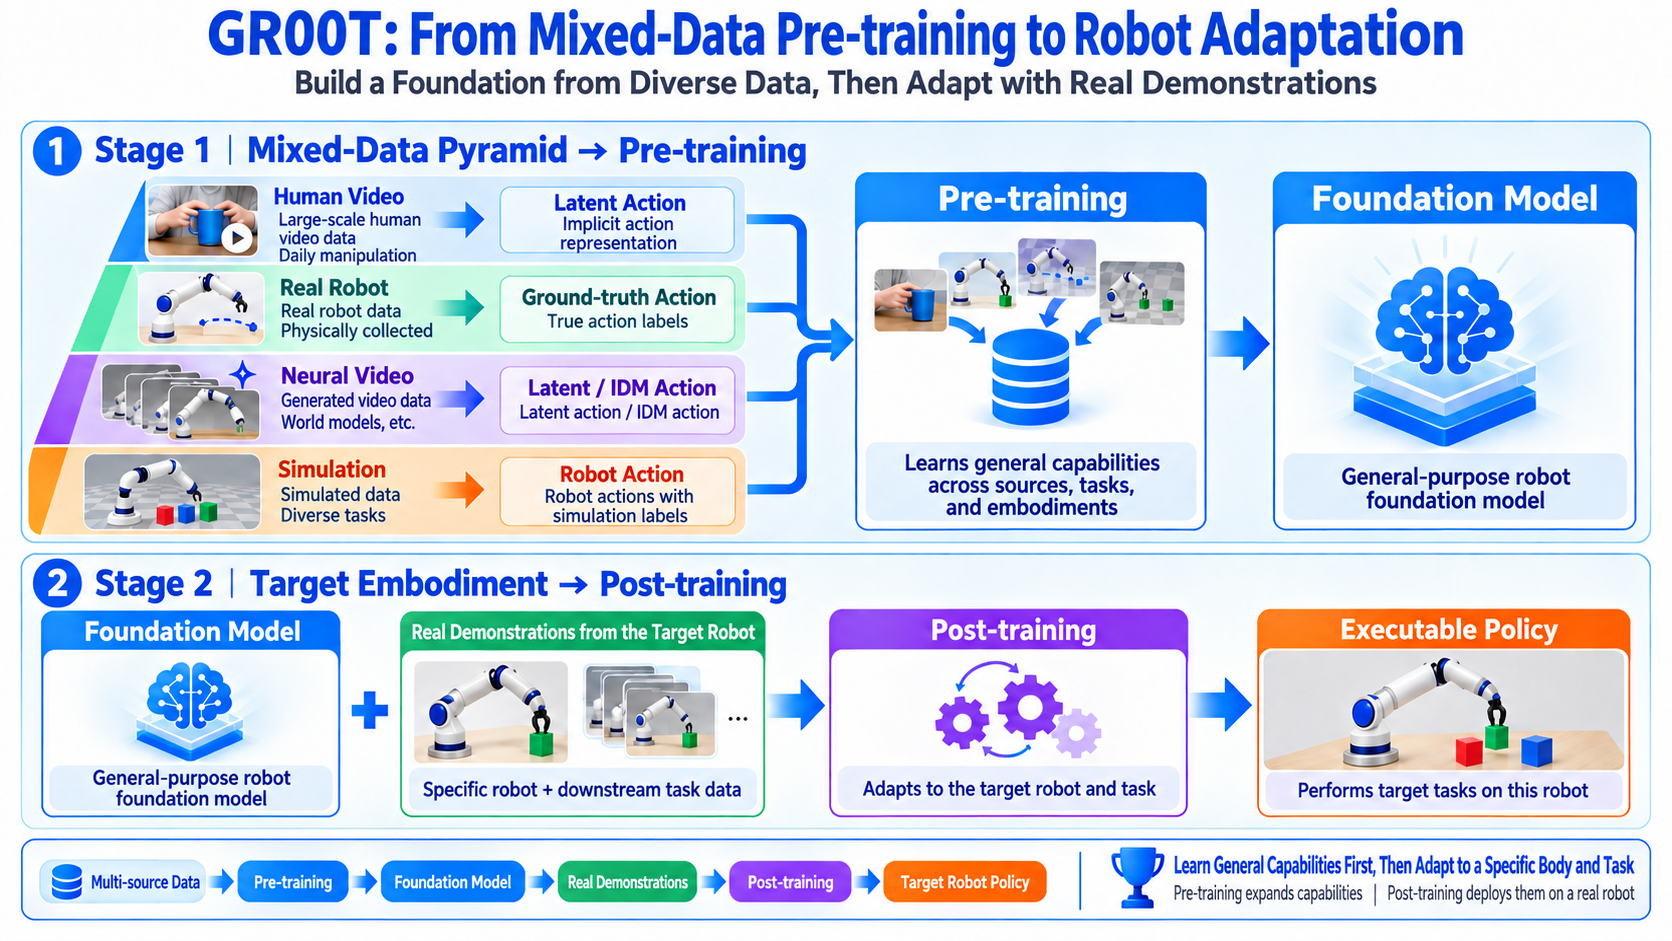
Pós-treinamento não é nem treinar do zero nem controle zero-shot imediato de robôs arbitrários. Ele adapta a fundação para uma configuração de câmera, estado, interface de ação e tarefa alvo.
| Configuração | Pré-treinamento | Pós-treinamento |
|---|---|---|
| Tamanho de batch | 16.384 | 128 ou 1.024 |
| Passos de Gradiente | 200.000 | 20.000-60.000 |
| Dados principais | Múltiplos corpos | Um corpo / tarefa |
| Propósito | Priors gerais | Adaptação a um corpo e tarefa específicos |
O pré-treinamento do GR00T-N1-2B usa cerca de 50.000 horas de GPU H100. O conjunto de dados totaliza 8.375,7 horas e 592,9M quadros.
Visão em uma frase: O pré-treinamento fornece ampla experiência de mundos e corpos; o pós-treinamento ensina o modelo a usar este robô em particular.
Experimentos e Resultados
Como a Efetividade é Testada?
Testes em simulação e físicos examinam priors de pré-treinamento e adaptação com dados limitados, em vez de apenas ajustar tarefas de treinamento.
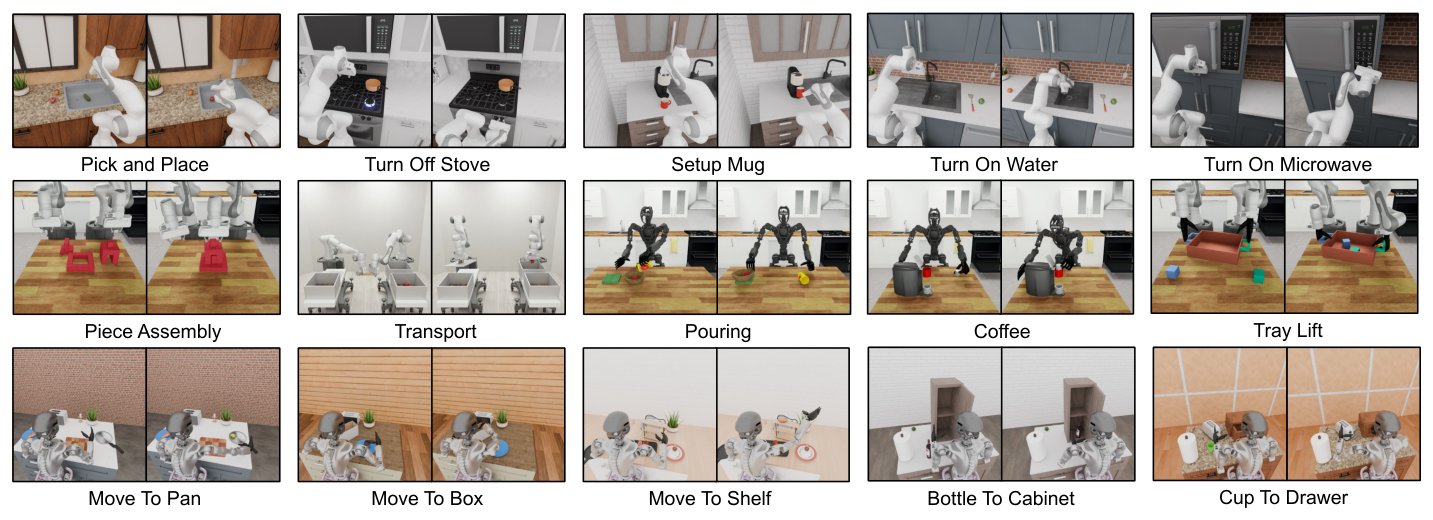
Benchmarks em simulação incluem:
-
RoboCasa Kitchen: 24 tarefas de cozinha.
-
DexMimicGen Cross-Embodiment Suite: nove tarefas de manipulação entre robôs diferentes.
-
GR-1 Tabletop: 24 tarefas humanoides de mesa.
Testes reais com o GR-1 incluem pick-and-place, objetos articulados, manipulação industrial e cooperação multi-robô.
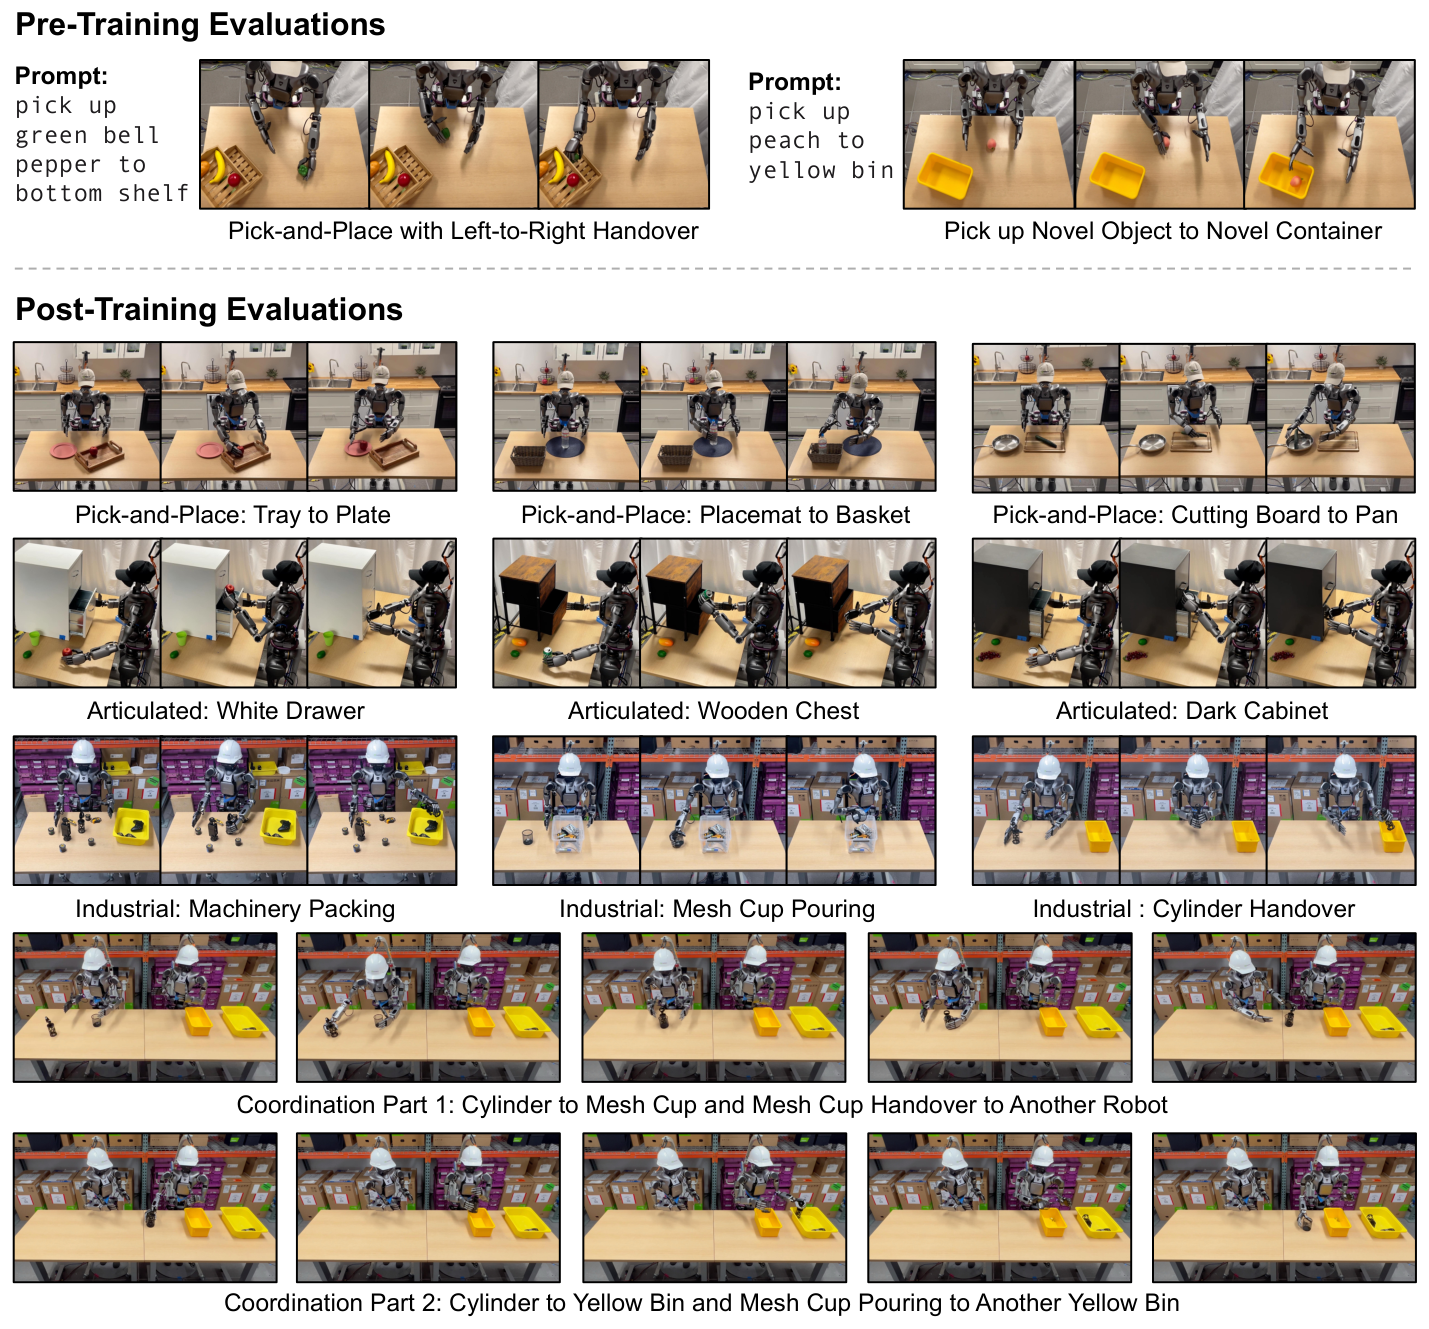
As principais comparações são BC-Transformer e Diffusion Policy. GR00T N1 difere não apenas em tamanho e arquitetura, mas em pré-treinamento heterogêneo entre corpos diferentes, então os resultados refletem também dados e treinamento.
Priors Ajudam com Poucos Dados?
O pós-treinamento em simulação usa 30, 100 ou 300 demonstrações por tarefa. As principais tendências são:
-
Priors ajudam mais quando os dados da tarefa são escassos.
-
Com mais dados, uma Diffusion Policy dedicada reduz a diferença, mas GR00T N1 mantém forte eficiência de dados.
-
Em alguns cenários, cerca de 10% dos dados da tarefa se aproxima de uma Diffusion Policy treinada com todos os dados.
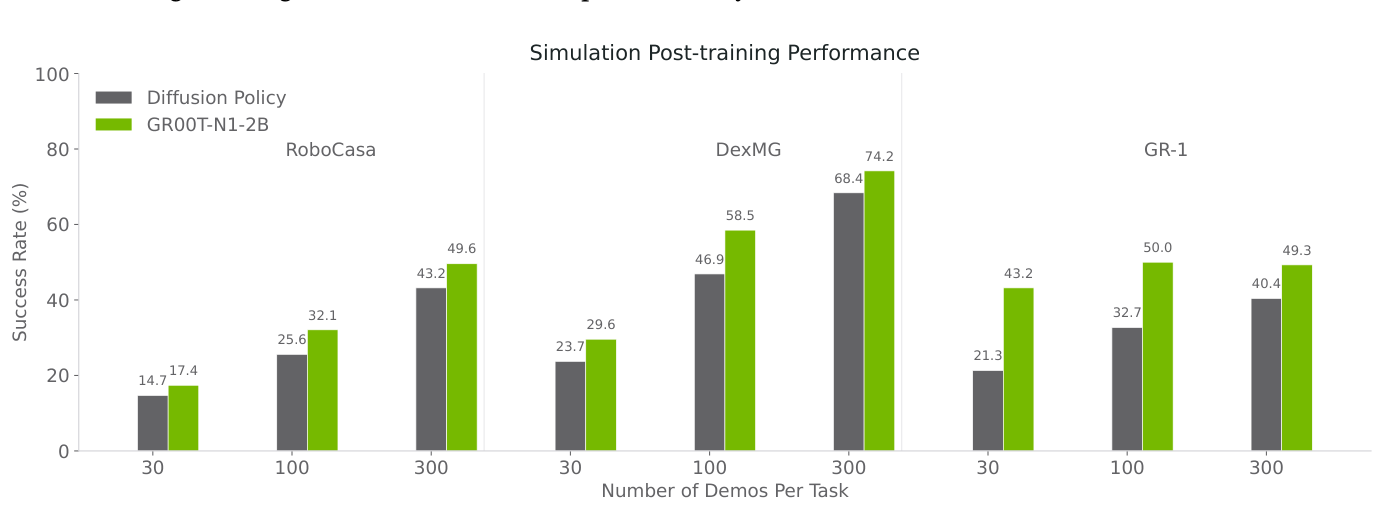
A implicação prática é:
O valor de um modelo de fundação não é não precisar de dados; é aprender de forma eficaz a partir de um ponto de partida pré-treinado quando seus dados são limitados.
Trajetórias Neurais Melhoram o Comportamento Real?
Ablations comparam apenas dados reais, vídeos gerados rotulados com ações latentes e vídeos gerados com pseudo-ações de IDM.
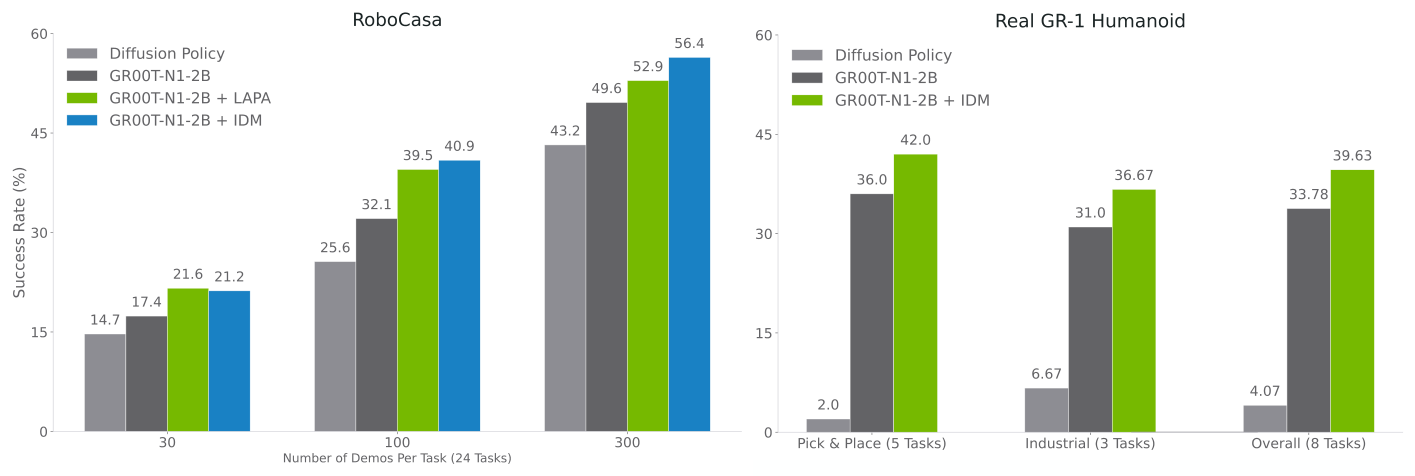
Trajetórias sintéticas melhoram algumas tarefas, com IDM frequentemente se conectando de forma mais direta a espaços de ação reais do que códigos latentes. Mais geração não é automaticamente melhor: erros físicos e viés de pseudo-rótulos entram no treinamento também.
Os autores também observam passagens espontâneas de mão esquerda para direita em um modelo pré-treinado que podem desaparecer após um pós-treinamento focado em tarefas estreitas.
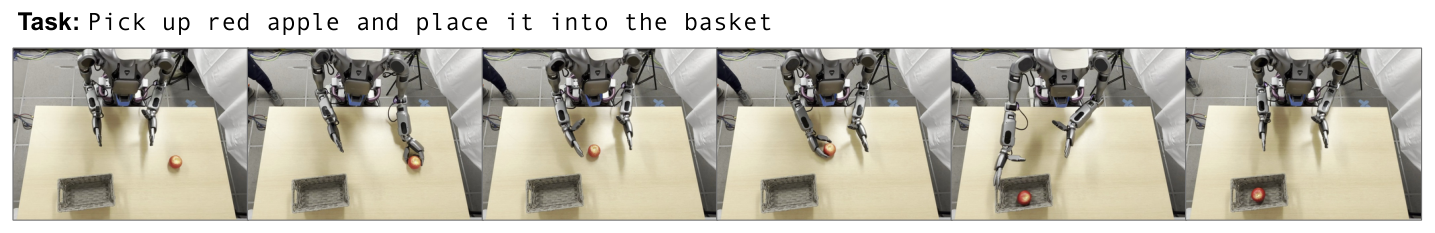
Isso ilustra o esquecimento catastrófico: um fine-tuning focado pode elevar uma métrica alvo enquanto sobrescreve capacidades mais amplas pré-treinadas.
Limitações, Implicações Práticas e Resumo
O que Permanece sem Solução?
-
Principalmente tarefas curtas de mesa. Navegação de longa duração, movimento de corpo inteiro e planejamento conjunto permanecem como trabalhos futuros.
-
Raciocínio espacial limitado. Reconhecer um objeto não implica compreensão precisa de 3D, contato ou força.
-
Inconsistências físicas sintéticas. Vídeo com aparência plausível não garante movimento executável.
-
Esquecimento durante o pós-treinamento. A adaptação deve ser avaliada quanto à retenção de generalização, bem como quanto ao sucesso no alvo.
Conectando à Prática com LeRobot
O apêndice de engenharia estende o formato de conjunto de dados do LeRobot. Armazenar números é insuficiente; seus significados devem ser definidos.
| Conteúdo | Informação a especificar |
|---|---|
| Vídeo | Nomes de câmeras, visões, resolução, taxa de quadros e alinhamento temporal. |
| Estado | A junta ou pose representada por cada dimensão. |
| Ação | Alvos absolutos ou incrementais; controles de junta ou de efetuador final. |
| Linguagem | Instruções associadas a cada episódio. |
| Rotação | Matriz de rotação, ângulos de Euler, quaternion ou representação 6D. |
modality.json adiciona essas semânticas, abordando se o modelo entende o sétimo número, não apenas se ele consegue abrir o arquivo.
Para leitores com conjuntos de dados ACT, as considerações adicionais são:
| Estágio | Prática ACT | Considerações adicionais para foundation-VLA |
|---|---|---|
| Coleta | Alinhar câmeras, estado e ações. | Anotações de linguagem estáveis. |
| Dados | Consistência dentro de um robô. | Consistência semântica entre diferentes corpos. |
| Treinamento | Aprender uma política a partir de demonstrações. | Pós-treinar um checkpoint de fundação. |
| Inferência | Imagem + estado → chunk de ação | Imagem + linguagem + estado → chunk de ação |
| Avaliação | Sucesso no robô | Sucesso, generalização e retenção de capacidades pré-treinadas |