LaWAM: Prevendo Mudanças na Cena Antes de Gerar Ações de Robôs
LaWAM: Latent World Action Models for Efficient Dynamics-Aware Robot Policies
arXivLer o artigoJialei Chen et al. · arXiv:2606.15768v2 · 25 de outubro de 2026 · CoRL 2026 · Página do projeto · Código dos autores
Um robô é solicitado a abrir uma gaveta. Primeiro ele move o gripper em direção à maçaneta, depois fecha o gripper e puxa. Se o primeiro bloco de ações apenas aproximar o gripper da maçaneta, essa aproximação pode ser a única mudança visível que a política precisa prever para esse bloco. Quando a próxima observação mostra o gripper fechado em torno da maçaneta, a previsão seguinte pode incluir a gaveta deslizando para abrir. Se uma política prevê a cena no final do próximo bloco de ações e usa essa previsão para gerar controles, quanto do futuro ela precisa prever?
Pré-requisitos: Três Quantidades na Tarefa da Gaveta
- Uma ação latente é um vetor contínuo aprendido a partir de um par de observações. Ele resume a transição entre elas, como o gripper se movendo em direção à maçaneta ou puxando para fora. O treinamento determina o que suas coordenadas codificam.
- Um subobjetivo visual latente é uma previsão da cena no final do bloco de ações atual, representada por recursos visuais que preservam o arranjo espacial. Os recursos próximos ao gripper podem mudar à medida que ele se move, enquanto aqueles da superfície da mesa podem permanecer aproximadamente os mesmos.
- Um bloco de ações é uma sequência temporalmente ordenada de vetores de controle, como poses do efetuador final e comandos do gripper. O especialista em ações gera comandos para alcançar, fechar e puxar. Após a execução, a política usa uma nova observação para gerar ações subsequentes.
Resumo e Guia de Leitura
Resumo em poucas palavras. LaWAM desloca a previsão do futuro para o espaço de recursos de um codificador visual pré-treinado. Durante o pré-treinamento em vídeo, ele infere uma ação latente a partir de duas observações e aprende a usá-la para prever recursos futuros a partir dos recursos atuais. Na política do robô, o backbone de visão e linguagem prediz uma ação latente a partir da observação atual e da instrução. O modelo de mundo a mapeia para um subobjetivo espacial, que condiciona o especialista em ações. Os autores relatam taxas médias de sucesso de 98,6% no LIBERO e 91,22% no RoboTwin, com a inferência do modelo levando 187 ms por bloco de ações.
Nota de leitura. Acompanhe duas passagens de informação. Primeiro, o futuro observado fornece um sinal de professor para a ação latente durante o treinamento. Na implantação, a própria política fornece sua estimativa dessa ação latente. Segundo, o especialista em ações recebe o subobjetivo visual previsto. Uma ablação testa essa conexão removendo o subobjetivo das entradas do especialista.
Estágio 1: Aprendendo a Prever Mudanças a partir de Duas Observações
Para cada exemplo de vídeo, os autores amostram um quadro atual e um quadro futuro separados por um intervalo físico . Um codificador DINOv3 congelado os mapeia para recursos espaciais e , com denotando o ponto final do intervalo. O codificador de dinâmica inversa processa em conjunto os patches visuais de ambos os quadros e infere uma ação latente contínua . O decodificador direto recebe os recursos atuais e . Ele injeta por meio de normalização de camada adaptativa para prever os recursos do ponto final:
No exemplo da gaveta, o codificador de dinâmica inversa vê a gaveta antes e depois de abrir e deve codificar informação suficiente sobre essa mudança em . O decodificador direto parte dos recursos da gaveta fechada. Os recursos atuais preservam as posições iniciais da gaveta e do gripper, e a ação latente informa ao decodificador o que mudou para que ele possa prever a gaveta aberta no contexto dessa cena.
O treinamento minimiza o erro quadrático entre e e usa divergência KL para regularizar o posterior da ação latente em direção a uma distribuição normal padrão. Quando o estado do efetuador final está disponível, uma cabeça auxiliar prediz o estado do efetuador final no ponto final a partir do estado atual e de . Isso incentiva a codificar o movimento do robô. Após o pré-treinamento, o decodificador direto se torna o Latent World Model (LaWM), o codificador de dinâmica inversa congelado atua como professor para o próximo estágio, e a cabeça auxiliar é descartada.
Este estágio usa aproximadamente 3.000 horas de vídeo de robôs e 1.500 horas de vídeo egocêntrico de humanos. O horizonte de previsão é de 1,2 segundo para vídeo de teleoperação de robôs e 0,4 segundo para vídeo de humanos. Os recursos visuais fornecem um alvo de treinamento comum, e dados de robôs com rótulos de controle ou estado podem fornecer supervisão adicional.
Estágio 2: Predizendo a Ação Latente Antes que o Futuro Seja Observado
Durante o treinamento da política, o professor congelado ainda pode usar ambos os quadros. O backbone Qwen3-VL estima uma ação latente a partir da observação atual e da instrução de tarefa. As consultas de ação latente atentam para a visão principal e a instrução, enquanto as consultas de ação também podem atentar para visões auxiliares opcionais. Uma única passagem direta pelo LaWM mapeia e os recursos atuais para o subobjetivo espacial .
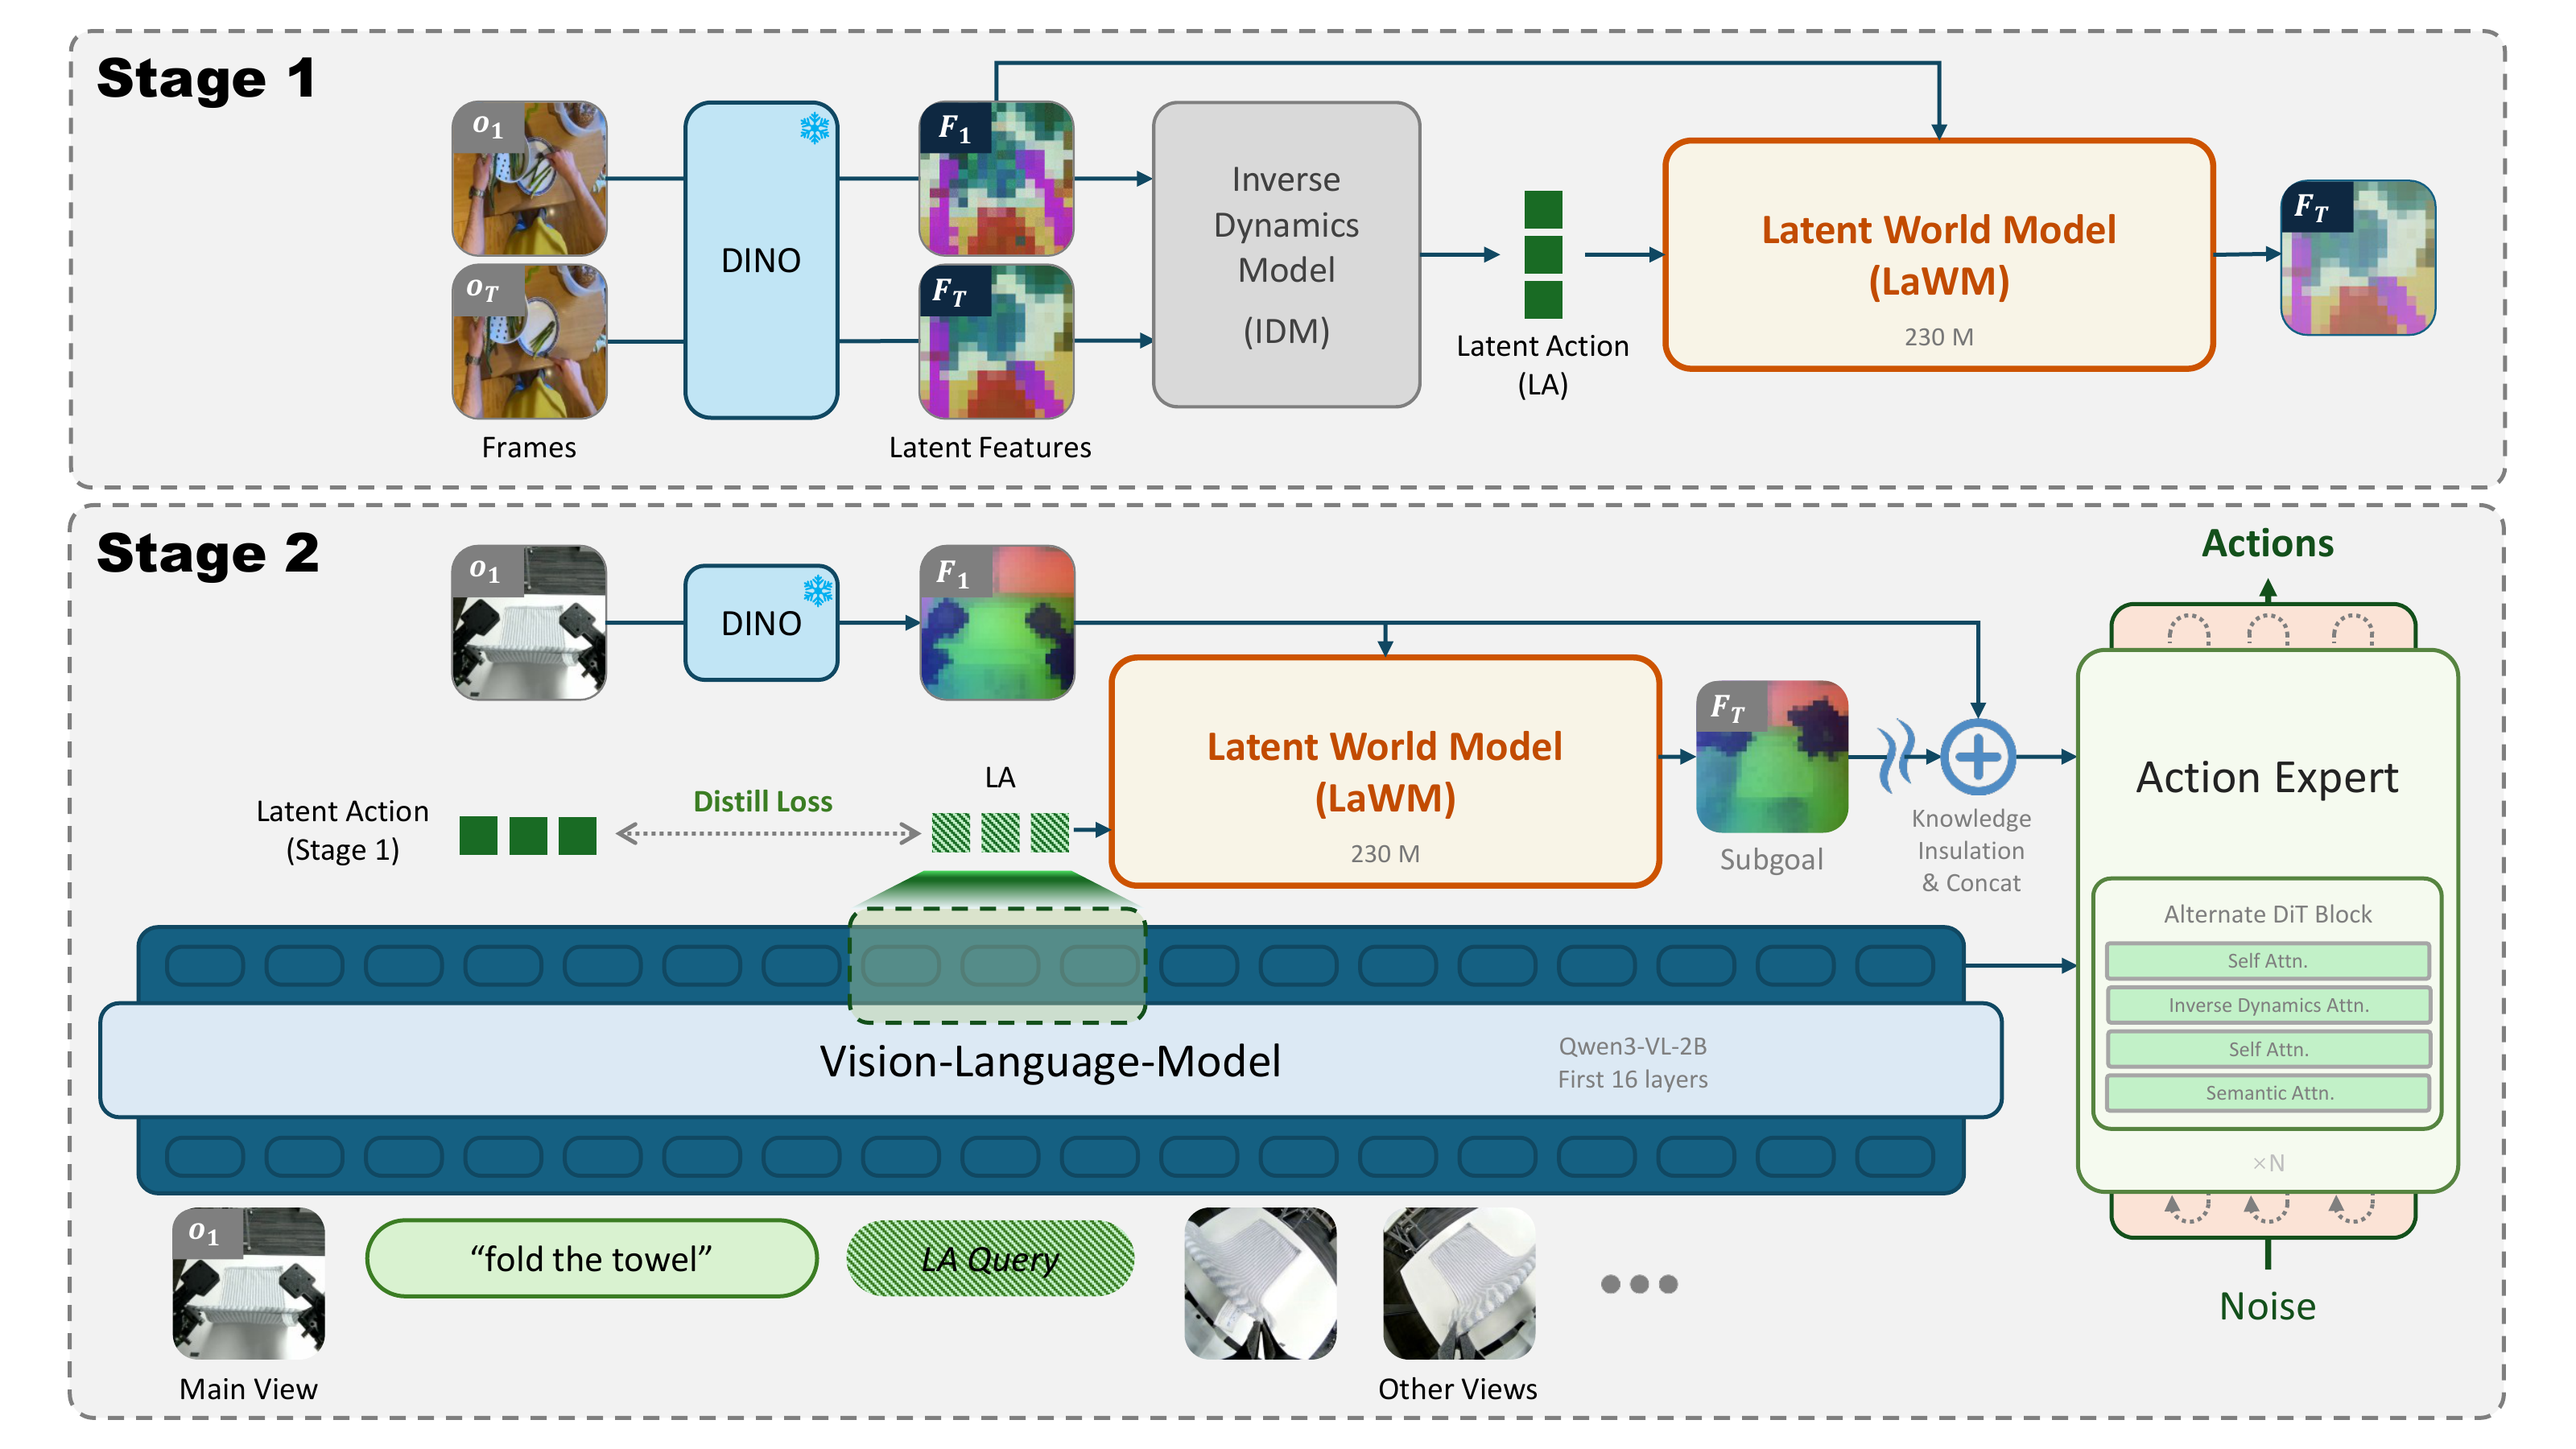
O primeiro estágio aprende mudanças a partir de observações de vídeo emparelhadas. O segundo estágio prediz uma ação latente a partir da observação atual e da instrução. O especialista em ações usa tanto o contexto de visão e linguagem quanto os recursos espaciais para as cenas atual e prevista. Imagem da página do projeto dos autores.
O especialista em ações Alternate-DiT alterna a atenção entre duas entradas. Uma fornece o contexto semântico do VLM. A outra fornece os recursos espaciais atuais e o subobjetivo previsto . Para a tarefa da gaveta, a primeira entrada carrega informação sobre a instrução e o objeto alvo, e a segunda descreve a mudança esperada durante este bloco. A cabeça de ação aprende flow matching condicional para transformar uma sequência de ações ruidosa em um bloco de ações contínuo. Na configuração padrão de inferência do artigo, o especialista em ações usa 10 etapas de remoção de ruído, e o LaWM calcula um subobjetivo visual por bloco.
| Sinal de treinamento | O que ele restringe |
|---|---|
| Destilação de ação latente | Aproxima a predição de política da ação latente do professor , inferida a partir do par de observações. |
| Regressão de características futuras | Aciona o LaWM com o próprio da política e treina sua saída para corresponder às características futuras observadas . |
| Correspondência de fluxo de ação | Usa o subobjetivo previsto e o contexto semântico para aprender blocos de ação a partir de demonstrações de robôs. |
O especialista em ação usa o subobjetivo previsto tanto no treinamento quanto na implantação. Knowledge Insulation (KI) bloqueia gradientes da perda de ação através do ramo de subobjetivo. A regressão de características futuras ainda atualiza o LaWM, e a perda de ação ainda treina o especialista em ação e seu caminho de condicionamento semântico. Na implantação, a política vai da imagem e instrução atuais para uma estimativa de ação latente, um subobjetivo previsto e, em seguida, um bloco de ação. A política usa observações RGB, e os rótulos de ação do robô usam uma representação do efetuador final. O vídeo humano contribui para o Estágio 1. O Estágio 2 usa trajetórias de robô com instruções em linguagem natural.
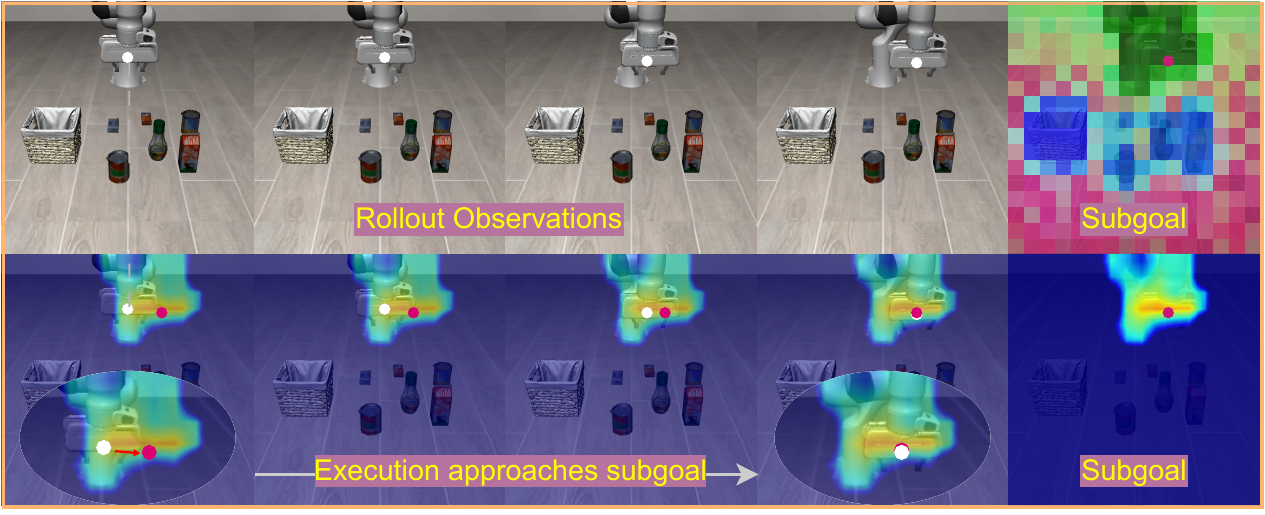
A coluna da direita mostra o subobjetivo previsto para este bloco de ação. Nas observações à esquerda, o gripper se move em direção à posição indicada pelo subobjetivo à medida que o bloco é executado.
Por que o Mesmo Horizonte de Subobjetivo Pode Conter Diferentes Números de Passos
Cada conjunto de dados mantém sua frequência de controle nativa. A Hz, um bloco de ação que abrange segundos contém passos. O passo é codificado em seu tempo decorrido . Para um horizonte de 1,2 segundo, dados a 5 Hz fornecem seis passos e dados a 20 Hz fornecem 24 passos. O passo 3 a 5 Hz e o passo 12 a 20 Hz ocorrem ambos em 0,6 segundo, portanto recebem a mesma codificação de posição temporal.
Para um experimento controlado em LIBERO, os autores fazem downsample das mesmas demonstrações de 20 Hz para criar versões de 5 Hz e 10 Hz. As tarefas, o corpo do robô e as demonstrações de origem são compartilhados entre as taxas. Misturar frequências sem codificação de tempo físico reduz o sucesso em relação à referência de 20 Hz. Adicionar a codificação recupera grande parte do desempenho perdido. A comparação isola como alinhar ações pelo tempo decorrido afeta o treinamento com frequências mistas.
Experimentos: Latência de Bloco de Ação e Sucesso na Tarefa
LIBERO: Taxa de Sucesso e Latência por Bloco de Ação
O artigo avalia as suítes Spatial, Object, Goal e Long, com 40 tarefas no total e 50 tentativas por tarefa. Uma tentativa conta como bem-sucedida quando atende à condição de sucesso da tarefa. A tabela mostra taxas médias de sucesso e latências de bloco de ação para métodos selecionados.
| Método | Taxa média de sucesso nas quatro suítes | Latência por bloco de ação |
|---|---|---|
| π₀.₅ | 96,9% | 220 ms |
| Fast-WAM | 97,6% | 486 ms |
| Cosmos-Policy | 98,5% | 1.413 ms |
| LingBot-VA | 98,5% | 4.482 ms |
| LaWAM | 98,6% | 187 ms |
LaWAM obtém 99,4% em Spatial, 99,6% em Object, 98,4% em Goal e 97,0% em Long. A diferença de latência de aproximadamente 24 vezes é relativa ao LingBot-VA. Os autores medem o tempo dos modelos na mesma GPU A100 com precisão BF16 e 10 etapas de denoising, enquanto cada método mantém sua resolução de entrada e horizonte de predição nativos. Os 187 ms cobrem apenas a inferência do modelo. O LaWM tem cerca de 230 milhões de parâmetros, e a política completa tem cerca de 2,3 bilhões.
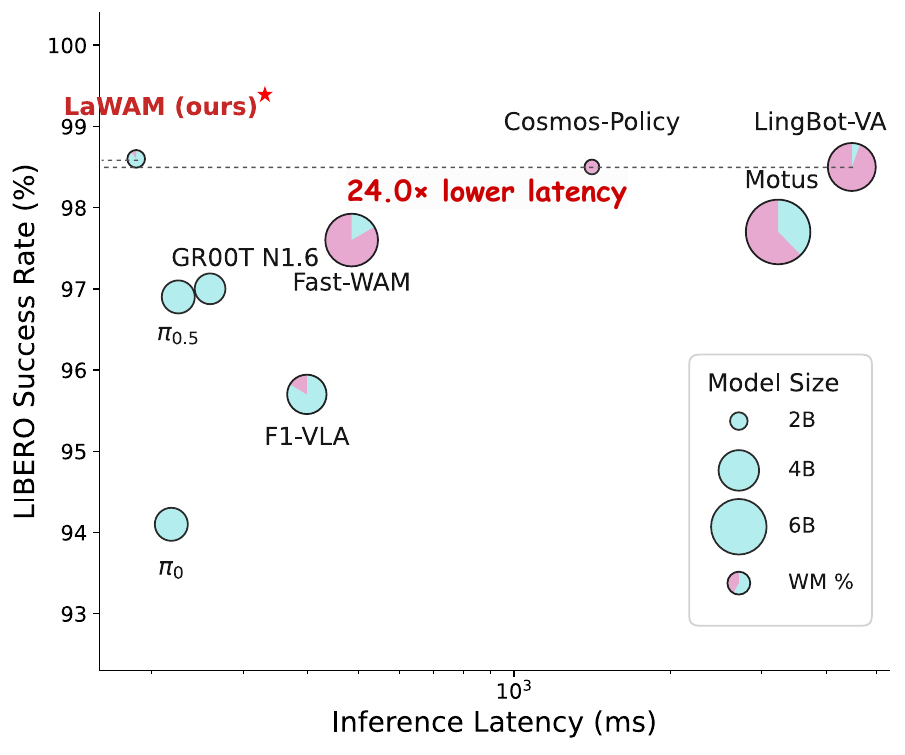
O eixo horizontal é a latência de inferência por bloco, e o eixo vertical é a taxa média de sucesso em LIBERO. O tamanho do círculo representa a contagem de parâmetros. O setor rosa representa a fração de parâmetros no modelo de mundo.
RoboTwin e Robôs Físicos: O Que as Médias Deixam de Fora
O RoboTwin 2.0 avalia 50 tarefas bimanual, com 100 tentativas por tarefa em cada uma de duas condições: cenas limpas e randomizadas. O LaWAM atinge 92,64% e 89,80%, respectivamente, para uma média combinada de 91,22%. O Fast-WAM atinge 91,98% e 90,52% nas mesmas condições. O LaWAM lidera em cenas limpas e fica um pouco atrás do Fast-WAM sob randomização. Na tarefa de abrir o micro-ondas, o LaWAM obtém 41% e 43%, em comparação com 95% e 91% para o Motus.
Os autores usam um braço Franka para pegar-e-colocar e abrir gavetas, e um Quanta X1 para dobrar toalhas e limpar a mesa. O LaWAM tem sucesso em 28, 26 e 27 de 30 tentativas, respectivamente, nas três primeiras tarefas. Uma tentativa de limpeza de mesa só é bem-sucedida se o robô completar todas as oito subtarefas. Com o mesmo checkpoint, o LaWAM limpa a mesa em 21 de 50 tentativas sob iluminação normal e 12 de 50 com iluminação colorida adicional. A menor taxa de sucesso sob iluminação colorida mostra o quanto o resultado pode variar com as condições de observação nessa tarefa de longo horizonte.
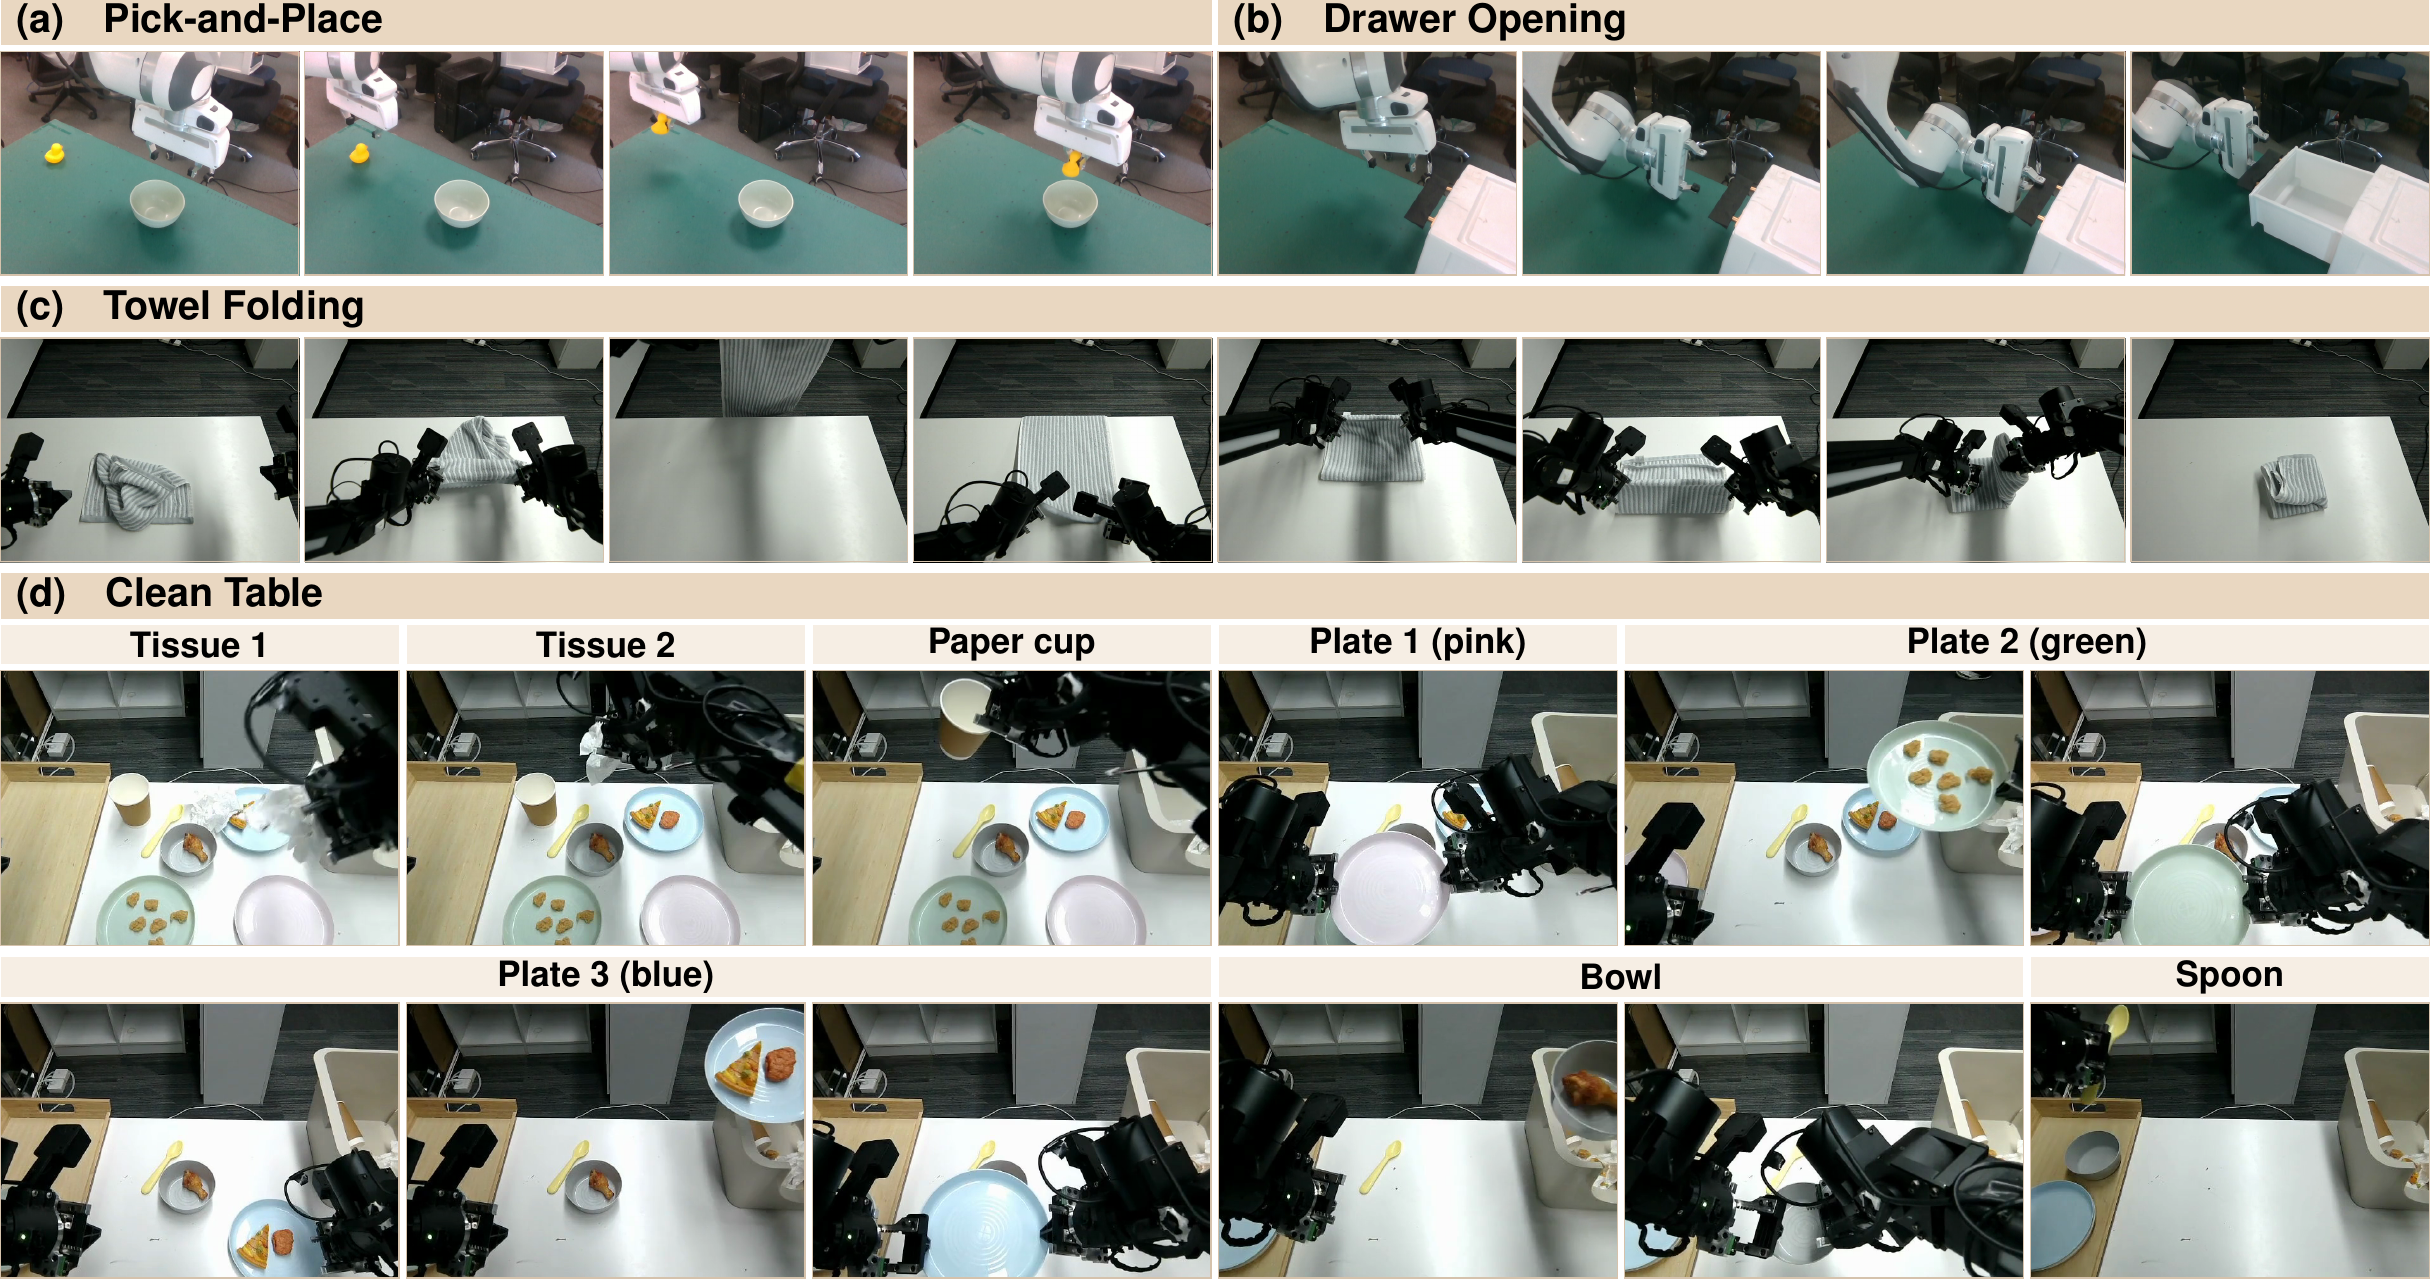
Leia cada sequência da esquerda para a direita. O exemplo de limpeza de mesa continua por duas linhas e inclui limpar lenços de papel, um copo de papel, pratos, uma tigela e uma colher.
As Mesmas Ações Latentes Podem Ser Reutilizadas em Diferentes Cenas?
Os autores extraem uma sequência de ações latentes de um vídeo de origem e a aplicam a observações iniciais de diferentes cenas e corpos de robô. Isso ilustra como o LaWM mapeia o mesmo código de transição para mudanças específicas de contexto em características espaciais. Estas são predições qualitativas de características em malha aberta. Os testes anteriores em malha fechada medem o sucesso no controle real.
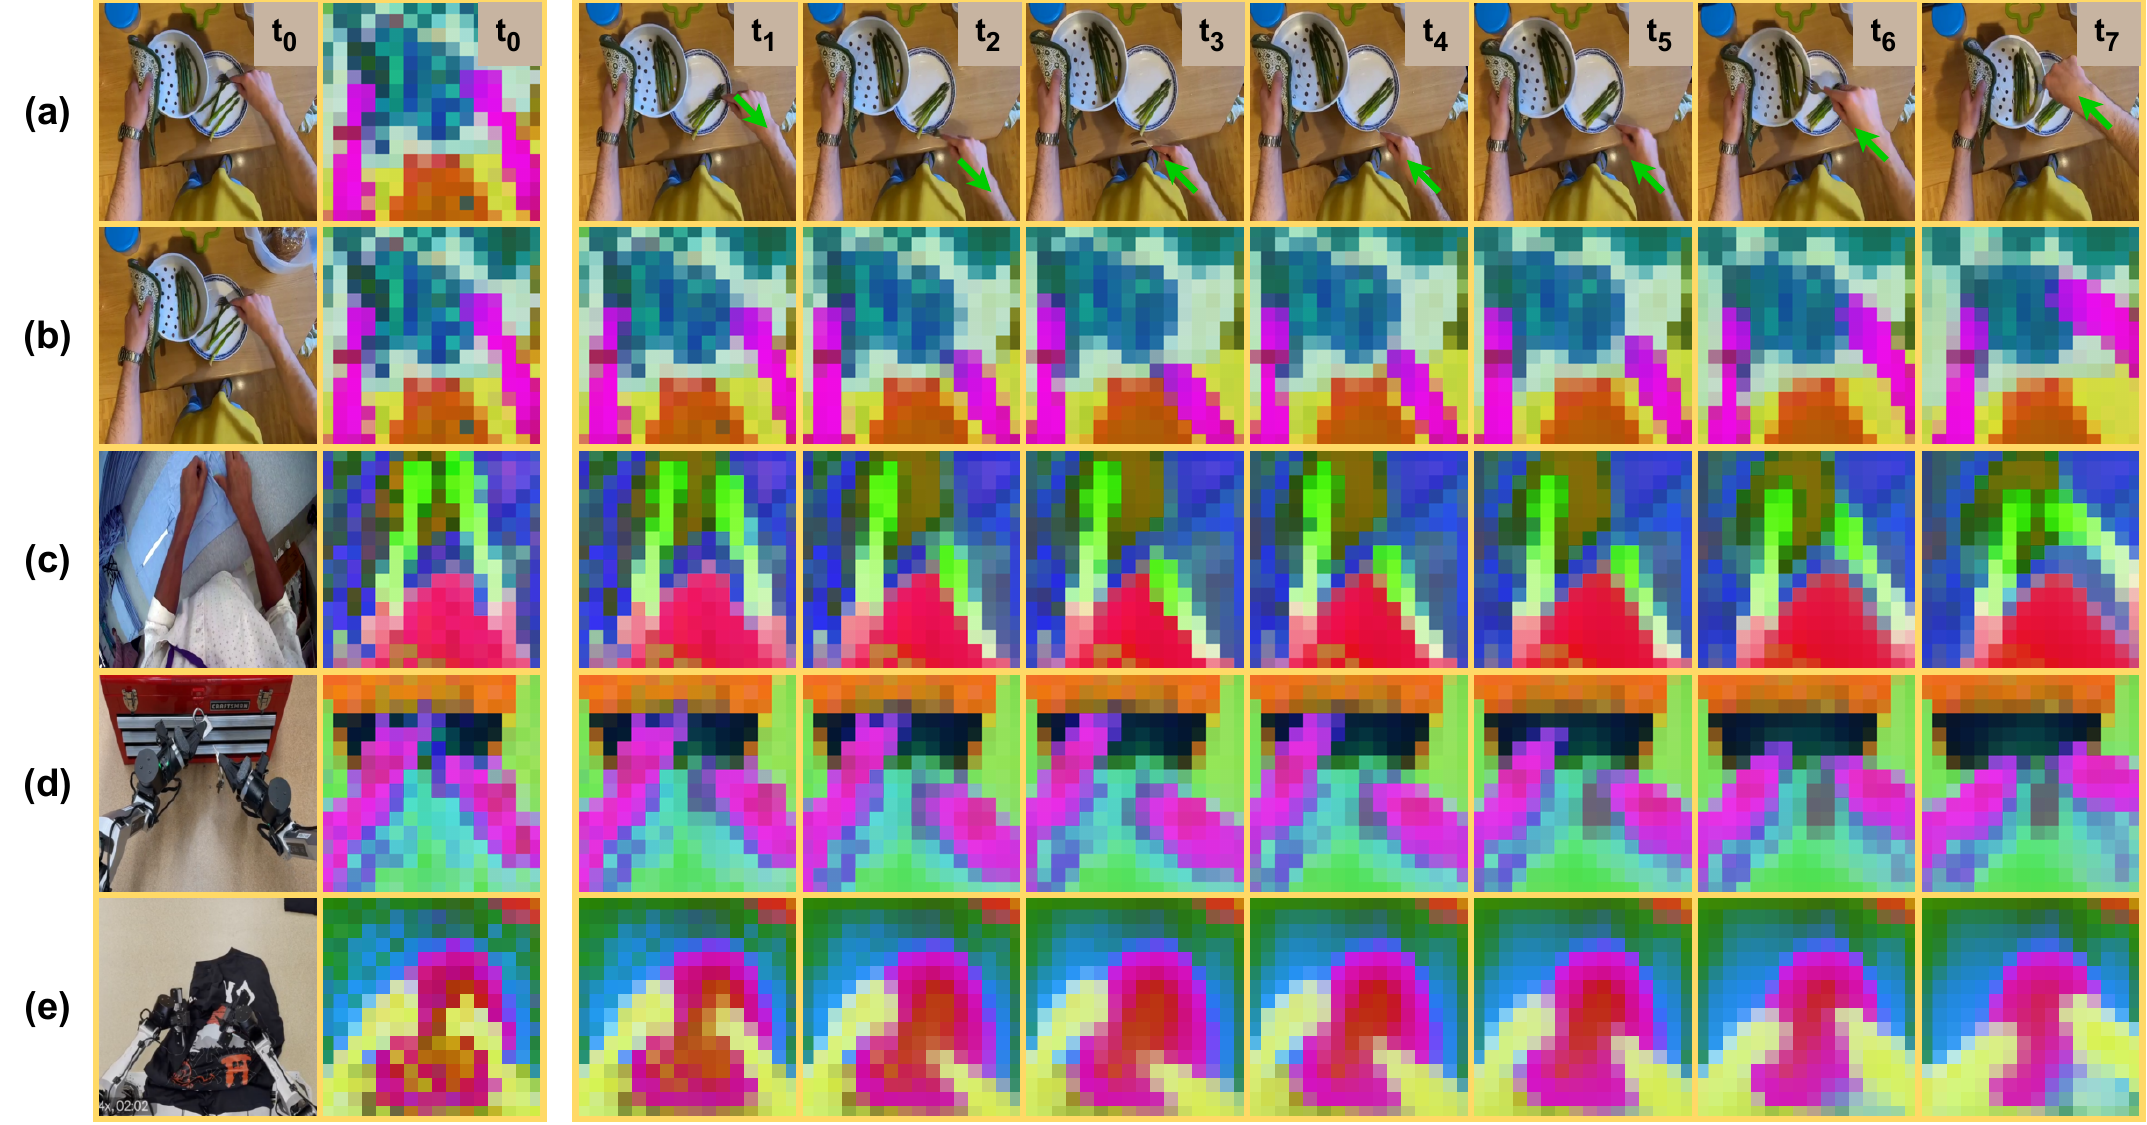
A linha superior é o vídeo de origem usado para inferir as ações latentes. Cada linha restante começa com uma imagem inicial e suas características visuais. As grades coloridas subsequentes mostram as predições do LaWM em tempos sucessivos.
Ablation: O Que o Subobjetivo Previsto Contribui para a Geração de Ação?
As ablações em LIBERO-10 usam como referência uma variante que pula o pré-treinamento de política do Estágio 2. Ela obtém 96,4%, enquanto o modelo completo com esse pré-treinamento obtém 97,0%. As variantes abaixo usam a referência de 96,4% e mantêm a perda de ação.
| Configuração | Taxa de sucesso |
|---|---|
| Referência sem pré-treinamento de política do Estágio 2 | 96,4% |
| Remover o condicionamento de subobjetivo do especialista em ação mantendo a destilação e a supervisão de características futuras | 94,6% |
| Remover Knowledge Insulation | 94,2% |
| Remover destilação de ação latente | 93,4% |
| Prever características futuras diretamente, ignorando a interface de ação latente | 94,4% |
| Usar um adaptador com número de parâmetros equivalente | 91,4% |
| VLA base | 91,0% |
Remover a entrada de subobjetivo do especialista em ação reduz o sucesso em 1,8 pontos percentuais. Essa comparação testa diretamente o valor de permitir que o especialista leia as características previstas na inferência. Os controles de predição direta e de parâmetros equivalentes testam o papel da interface de ação latente e se apenas a capacidade extra explica a melhoria.
Integração com LeRobot e Diferenças de Avaliação
O checkpoint LIBERO do LeRobot lançado inclui normalização e processamento do gripper. Com action_horizon=8, ele prevê oito passos de controle por bloco. Com n_action_steps=8, ele executa todos os oito antes de prever um novo bloco a partir da observação mais recente. A cabeça de ação preenche sua sequência interna até chunk_size=50. policy.path carrega o checkpoint model.safetensors no formato LeRobot. Os pesos originais .pt dos autores exigem conversão antes de serem carregados por essa interface.
Para um conjunto de dados multicâmera diferente, primary_image_features e wrist_image_features especificam os papéis das visões principal e de pulso. lam_image_feature seleciona qual visão principal fornece os quadros temporais para o modelo de ação latente.
O LeRobot relata 1.970 sucessos em 2.000 tentativas (98,5%) para o checkpoint lançado nas quatro suítes LIBERO com MuJoCo 3.3.2. O artigo relata uma taxa média de sucesso de 98,6% em sua tabela de experimentos.
Conclusão
No exemplo da gaveta, o LaWAM prevê características da cena no final do bloco de ação atual. O especialista em ação as usa para gerar os controles para alcançar, fechar o gripper ou puxar. A comparação de latência em LIBERO mostra que a política pode usar um futuro previsto mantendo a geração de blocos de ação rápida. Remover o subobjetivo do especialista em ação reduz o sucesso em LIBERO-10, mostrando que as características espaciais previstas ajudam a geração de ação nessa avaliação.
Grandes movimentos de câmera podem interferir no aprendizado de ações latentes, e deformações sutis de tecido são raras nos dados de treinamento. A queda na taxa de sucesso de limpeza de mesa sob iluminação colorida adicional mostra que as condições de observação ainda importam para tarefas de longo horizonte.