LingBot-VA: Um Modelo de Mundo Causal de Imagens Futuras para Ações de Robôs
Modelagem de Mundo Causal para Controle de Robôs
- Geração de vídeo e ações
- Histórico causal
- Feedback real
- Correção assíncrona
Um robô precisa abrir uma caixa de entrega. Sua câmera vê a caixa e um estilete, mas uma única imagem não pode dizer se o lacre foi cortado, se a lâmina está estendida ou qual etapa deve ser repetida após uma falha. Se um modelo apenas produz o próximo segmento de movimento do braço, a relação entre mudanças visuais e consequências das ações precisa permanecer implícita dentro de sua política.
LingBot-VA torna essa relação explícita na geração: prevê possíveis estados futuros em um espaço de vídeo comprimido, gera ações a partir deles e depois atualiza o contexto com imagens reais após a execução. Isso introduz desafios: imagens imaginadas podem ser imprecisas, a geração de vídeo leva tempo e o robô não pode ficar parando para esperar. Este guia acompanha como o futuro afeta as ações, como o feedback real corrige previsões e como o cálculo se encaixa em torno da execução.
Pré-requisitos: Prever Imagens e Escolher Ações
Um modelo de mundo aprende como o ambiente muda. Quando uma garra sobe, por exemplo, a tampa de uma caixa pode subir com ela ou permanecer parada se a preensão falhar. Aqui, o mundo é a cena de manipulação visível pelas câmeras; o termo não implica um simulador de física completo e preciso.
Dinâmica inversa infere ações a partir de uma mudança de estado: se a garra está atualmente fora da tampa e deve agarrá-la em seguida, como ela deve se mover e fechar? Dinâmica direta prevê consequências a partir do estado atual e de uma ação dada. Elas respondem, respectivamente, como alcançar uma mudança e o que uma ação específica irá causar.
Um latente de vídeo é a representação produzida quando um VAE de vídeo comprime imagens. A maior parte da predição acontece nessa representação, sem exigir um vídeo RGB reproduzível antes de cada passo de controle. Autoregressivo (AR) significa que a geração posterior depende do histórico existente. Este modelo gera variáveis contínuas em blocos, com múltiplas atualizações de flow matching dentro de cada bloco, em vez de escolher uma palavra discreta por vez como faz um modelo de linguagem.
Mantenha três escalas de tempo separadas: o tempo real de execução do robô, os índices de blocos de vídeo/ação e o tempo de geração que gradualmente transforma ruído em dados. Uma atualização extra de desruído não executa automaticamente outra ação do robô.
Resumo: Paráfrase e Notas de Leitura
Paráfrase: Os autores argumentam que a modelagem de mundo em vídeo pode fornecer uma base para o aprendizado de robôs ao lado do pré-treinamento visão-linguagem. LingBot-VA é um framework de difusão autoregressivo que aprende conjuntamente predição de quadros futuros e execução de política. Seus três principais componentes integram tokens visuais e de ação em um espaço latente compartilhado por meio de um Mixture-of-Transformers, atualizam continuamente rollouts em malha fechada com observações reais e coordenam a predição de ações de forma assíncrona com a execução do robô. Experimentos em simulação e hardware examinam manipulação de longo horizonte, eficiência de dados após o treinamento e generalização para novas configurações. Código e modelos são disponibilizados.
Nota de leitura: O primeiro componente diz respeito à troca de informação, o segundo diz respeito ao contato com o ambiente real e o terceiro diz respeito à latência de geração no laço de controle. Todos os três precisam funcionar juntos: melhor predição de imagens não implica necessariamente melhores ações, histórico armazenado não garante tratamento de perturbações e operação assíncrona não justifica usar previsões obsoletas indefinidamente. As seções a seguir avaliam essas afirmações por meio de mecanismos e experimentos.
Introdução e Trabalhos Relacionados: Trazendo Geração de Vídeo para o Controle
O primeiro parágrafo da introdução identifica uma carga de aprendizado: quando ações são previstas diretamente a partir de observações, semântica da cena, mudanças físicas e controle motor são ligados principalmente pelo mesmo sinal de supervisão de demonstração. Os autores chamam isso de emaranhamento de representação e sugerem que aprender explicitamente a evolução do ambiente pode melhorar a eficiência de amostragem e a generalização. A questão é se a supervisão de dinâmica entra explicitamente no objetivo; VLAs com histórico de observação também podem usar informação temporal.
O argumento então se volta para modelos de mundo existentes. Simuladores neurais interativos preveem consequências de ações, difusão conjunta vídeo-ação usa ambos os tipos de supervisão, e abordagens que primeiro geram imagens-alvo fornecem objetivos visuais para uma política. No entanto, previsões longas sem feedback real subsequente se afastam da execução, enquanto blocos sem contexto persistente podem perder o estado de manipulação anterior. Os autores, portanto, predizem bloco a bloco a partir do histórico e incorporam observações reais por meio de um cache.
A Seção 5 divide trabalhos relacionados em políticas visão-linguagem e modelos de mundo para robôs. Estes últimos podem prever estados latentes de baixa dimensão, nuvens de pontos 3D ou imagens 2D. LingBot-VA segue a geração de vídeo, com computação no espaço latente do VAE. Sua contribuição vai além de uma perda auxiliar de vídeo: representações futuras previstas participam da geração de ações no momento da inferência.
Aqui, causal descreve principalmente dependências temporais e visibilidade de atenção. Ela organiza a geração em torno das informações disponíveis; não estabelece causalidade no mundo real por meio de intervenções nem garante correção física. A Seção 3.2 permite explicitamente atenção bidirecional dentro de um bloco de geração. A fronteira causal separa principalmente blocos históricos e futuros.
Processo Geral: Prever o Futuro e Depois Inferir Ações a partir da Mudança
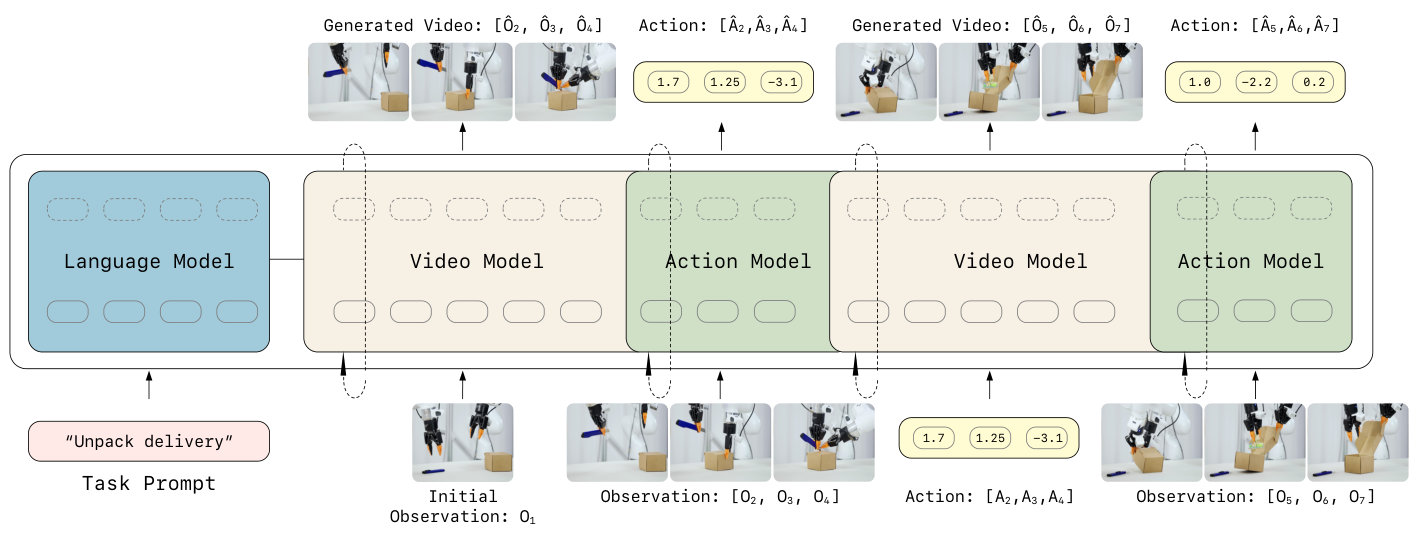
Na Figura 2, distinga primeiro as duas linhas. A linha superior contém imagens e ações previstas; a inferior fornece observações reais e ações executadas entre blocos. A geração à direita lê o contexto atualizado, então uma tampa imaginada como aberta não se torna automaticamente um fato no ambiente.
Seja uma observação, o estado latente do codificador de vídeo causal, uma ação e a instrução em linguagem natural. As relações de condicionamento na Seção 3.2, Equações (8)–(9), podem ser organizadas como:
A primeira expressão prevê latentes futuros; a segunda gera ações condicionadas a eles. Os acentos circunflexos indicam previsões. Seguindo a indexação simplificada do artigo, cada estado futuro corresponde a um segmento de controle; o sistema real combina vídeo mais esparso com ações mais densas. O condicionamento por linguagem, omitido em algumas expressões abreviadas no artigo, é escrito explicitamente aqui para deixar claro que instruções são entradas.
Para abrir a tampa de uma caixa, as representações atual e futura previstas em conjunto informam ao ramo de ação para onde o gripper deve ir e como a tampa deve mudar. Ações e observações passadas também ajudam a determinar se ela já foi agarrada. Uma interface de controle de baixo nível executa as ações, e o resultado real é codificado de volta no histórico. Esse caminho gera ações diretamente a partir de estados previstos; ele não enumera trajetórias candidatas nem seleciona uma usando uma função de custo explícita.
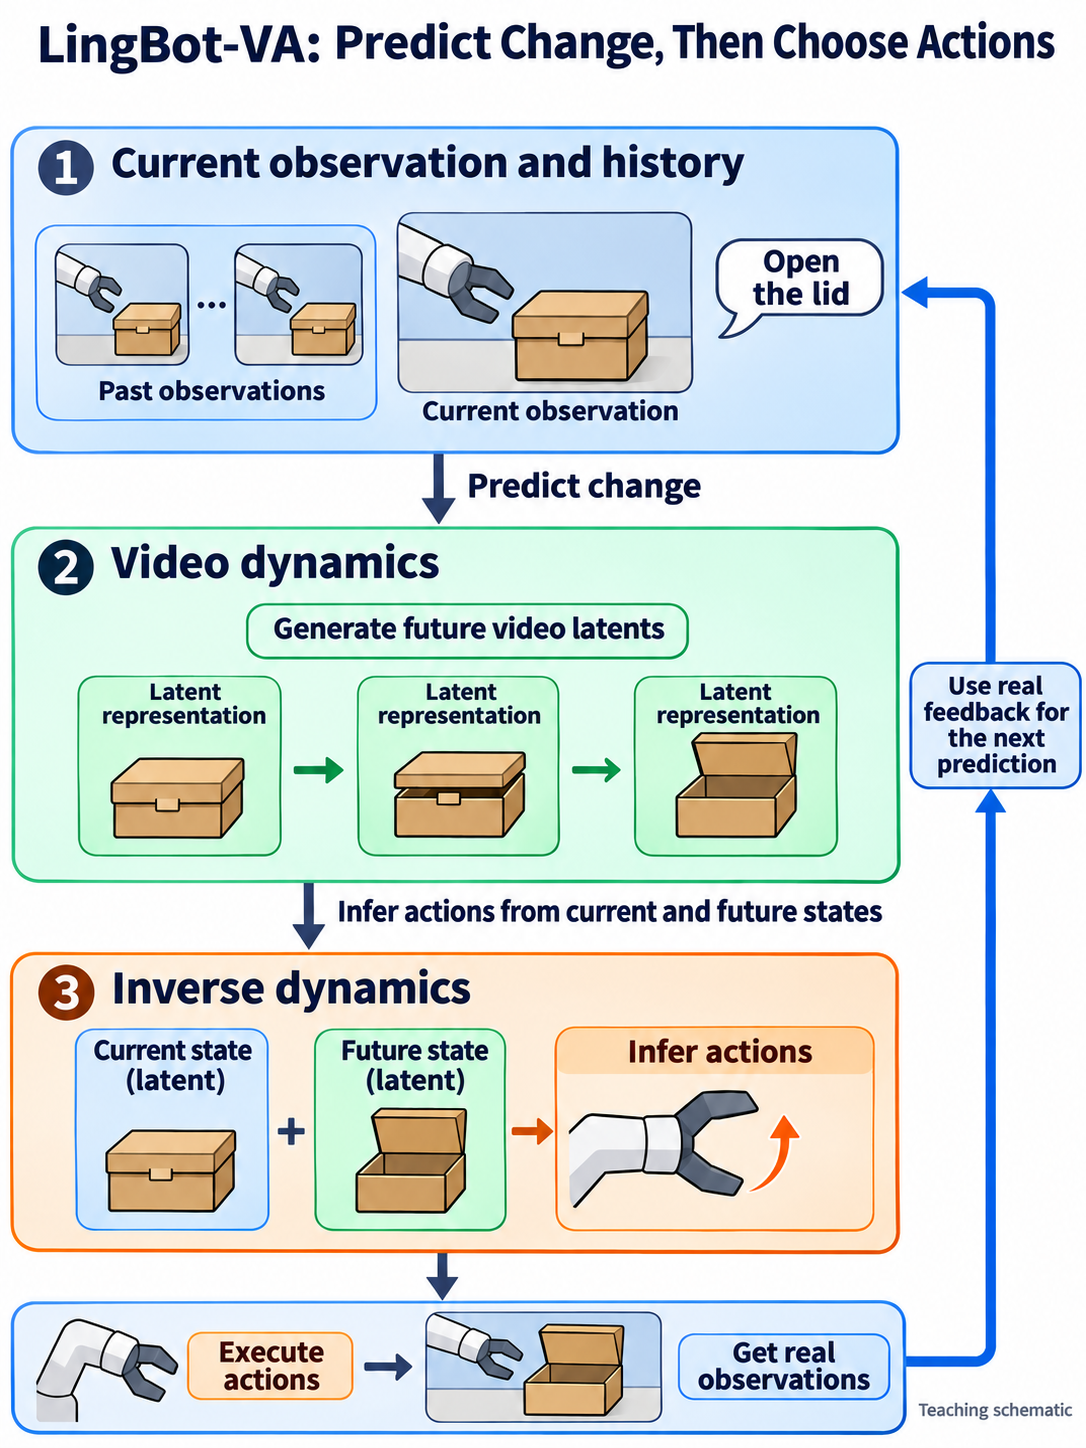
Ilustração didática: as caixas verdes são representações latentes previstas; a caixa azul na parte inferior vem da câmera real. Siga a seta de feedback à direita para ver como a execução real atualiza a base para a próxima previsão.
Como Vídeo e Ações Entram em um Único Modelo
Comprimir Imagens preservando Diferentes Taxas de Amostragem
O artigo usa o VAE causal Wan2.2 para comprimir vídeo em aproximadamente 4 × 16 × 16 no tempo, altura e largura, depois aplica patchificação espacial 2 × 2 para reduzir tokens. Codificações de múltiplas câmeras são concatenadas ao longo da largura. A Seção 4.2 relata 192 tokens espaciais por quadro para sua configuração. Isso depende da resolução e do arranjo das câmeras e não é fixo em todas as configurações do LeRobot.
Mudanças visuais geralmente são mais lentas do que mudanças em comandos de controle. A Seção 3.3 usa : cada ponto de tempo de vídeo retido é associado a 4 ações. Gerar desses pontos de tempo visuais corresponde, portanto, a posições de ação. Amostragem esparsa de vídeo e compressão temporal do VAE são operações separadas; elas não significam em conjunto que o robô só precisa olhar a cada 16 passos.
Exemplo de forma: Com os padrões do LeRobot frame_chunk_size=4, action_per_frame=4 e action_dim=30, o ruído interno do fluxo de ações pode ter forma [1,30,4,4,1]: 16 posições temporais com 30 canais cada. Canais de ação válidos são selecionados da saída e convertidos para [batch,action_steps,robot_action_dimensions]. Este é um exemplo de interface da implementação fixada, em vez de uma forma de tensor universal para todas as plataformas no artigo.
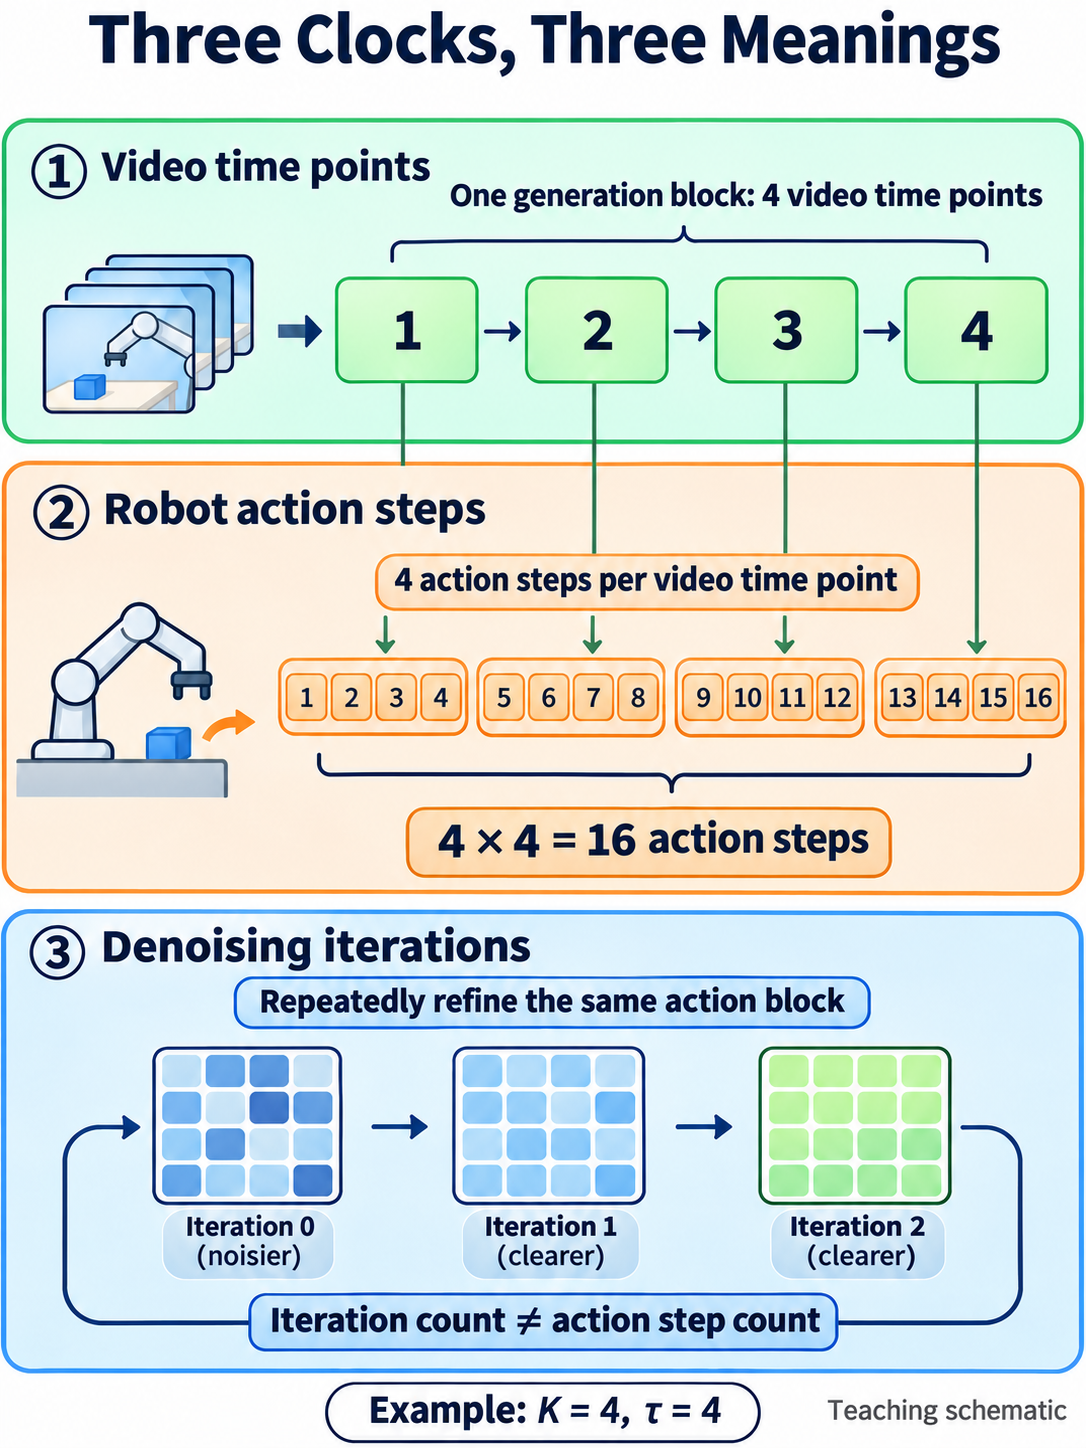
Ilustração didática: as duas linhas superiores seguem o tempo do robô; a linha inferior segue o progresso da geração. Cada atualização de remoção de ruído modifica o mesmo bloco de ações sem adicionar um ponto de tempo de execução.
MoT: Processamento Separado com Troca Baseada em Atenção
O Mixture-of-Transformers (MoT) do artigo tem dois ramos parametrizados. O ramo de vídeo parte do Wan2.2-5B, com largura oculta 3072 e 30 camadas. O ramo de ação tem a mesma profundidade, mas largura 768, adicionando aproximadamente 350M parâmetros para um total de cerca de 5,3B. Mudanças visuais de alta dimensão recebem mais capacidade, enquanto o controle de baixa dimensão usa um ramo de ação menor (Seção 4.2).
Em cada camada, vídeo e ações formam queries, keys e values por meio de suas próprias projeções. As características de ação são então projetadas em um espaço para atenção conjunta, trocam informações com características visuais e retornam ao ramo de ação. Uma cabeça linear final as mapeia de volta para vetores de controle. Um codificador T5 congelado fornece condicionamento de texto por meio de cross-attention.
O MoT aborda como modalidades mantêm seu próprio processamento enquanto compartilham informações. O MoE do LingBot-VLA 2.0, por sua vez, permite que tokens selecionem alguns especialistas feed-forward para distribuir capacidade e computação ativa. Os nomes são semelhantes, mas os mecanismos diferem.
Os autores também interpolam pesos de vídeo para a largura de ação e escalam a inicialização por . Substituindo 3072/768=4 obtemos $\alpha=2`. Isso estabiliza distribuições de saída iniciais entre ramos de larguras diferentes. A Figura 7 compara perda de treinamento, normas de gradiente e perda de validação, apoiando maior estabilidade do que a inicialização aleatória; essas curvas não são taxas de sucesso do robô.
A Arquitetura Liberada e a Arquitetura do Artigo
O checkpoint liberado usa um backbone compartilhado, também integrado ao LeRobot. Ele trata vídeo e ações como dois fluxos de geração, com mapeamentos de entrada/saída separados, mas blocos Transformer principais compartilhados. Os ramos assimétricos 3072/768 do artigo e o total de aproximadamente 5,3B descrevem uma organização de parâmetros diferente e não podem estimar diretamente o tamanho ou a computação do checkpoint com backbone compartilhado.
Treinamento: Dois Objetivos de Flow Matching e Supervisão de Histórico
Do Ruído ao Vídeo e do Ruído às Ações
Seguindo a direção do tempo na Seção 2, seja latentes de vídeo limpos e dados de ação, com ruídos gaussianos independentes das formas correspondentes:
As redes aprendem alvos de velocidade e , respectivamente. A Seção 3.3, Equações (11)–(12), define por meio do erro de geração de latentes de vídeo e por meio do erro de geração de ações condicionado às representações visuais atuais e futuras. O objetivo total é:
O pré-treinamento usa $\lambda=1`. Ambos os termos são erros quadráticos de campo de velocidade, em vez de uma soma direta de erros de pixels e juntas. O LeRobot adicionalmente pondera pelo tempo de ruído e reduz o erro de ação usando uma máscara de canais válidos, então valores numéricos de perda não podem ser inferidos apenas a partir desse coeficiente.
Cálculo didático: Simplifique um latente para um número, com valor de dado 0,2 e ruído 1,0. Em , a entrada é 0,6 e a velocidade alvo é 0.2−1.0=−0.8. Com um modelo preciso, uma atualização de Euler de s$ é o progresso da geração, não o tempo de execução do robô decorrido.
Teacher Forcing: Que Histórico é Visível durante o Treinamento?
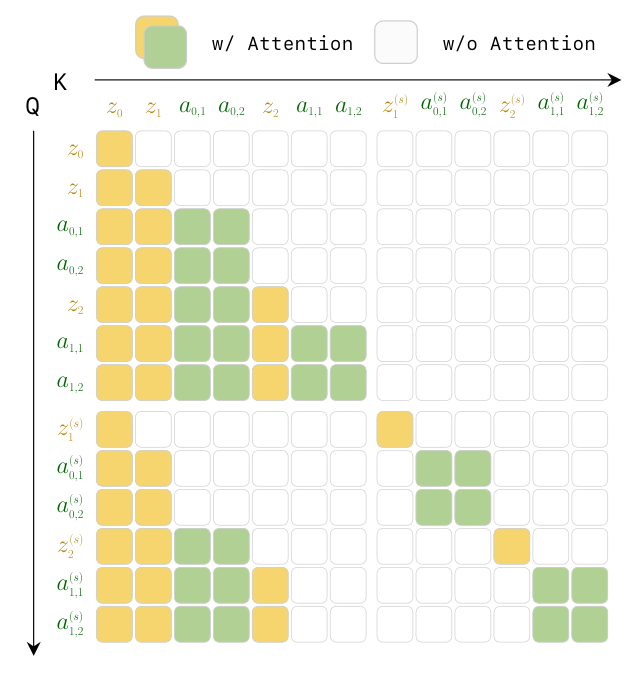
Teacher forcing condiciona o treinamento ao histórico real dos dados, em vez de primeiro executar uma trajetória completa prevista pelo modelo. Na Figura 3, as linhas são tokens que consultam e as colunas são chaves legíveis. Amarelo denota visão, verde ações e entradas em branco bloqueiam o acesso. A metade superior organiza o cache de histórico; a metade inferior organiza alvos ruidosos. Esta não é uma máscara triangular inferior simples que restringe cada token individualmente: a geração de ações deve ler as condições visuais futuras correspondentes, e a geração conjunta dentro de um bloco é permitida.
Ações futuras reais não devem condicionar diretamente a previsão atual. Fronteiras entre blocos de histórico e de previsão permitem que o treinamento processe múltiplos pontos de tempo em paralelo em um único forward pass. Durante a execução, o feedback da câmera real reentra no histórico, fazendo com que algumas condições de treinamento se assemelhem à implantação. Latentes futuros previstos, erros de controle e latência de feedback ainda podem causar deslocamento de distribuição.
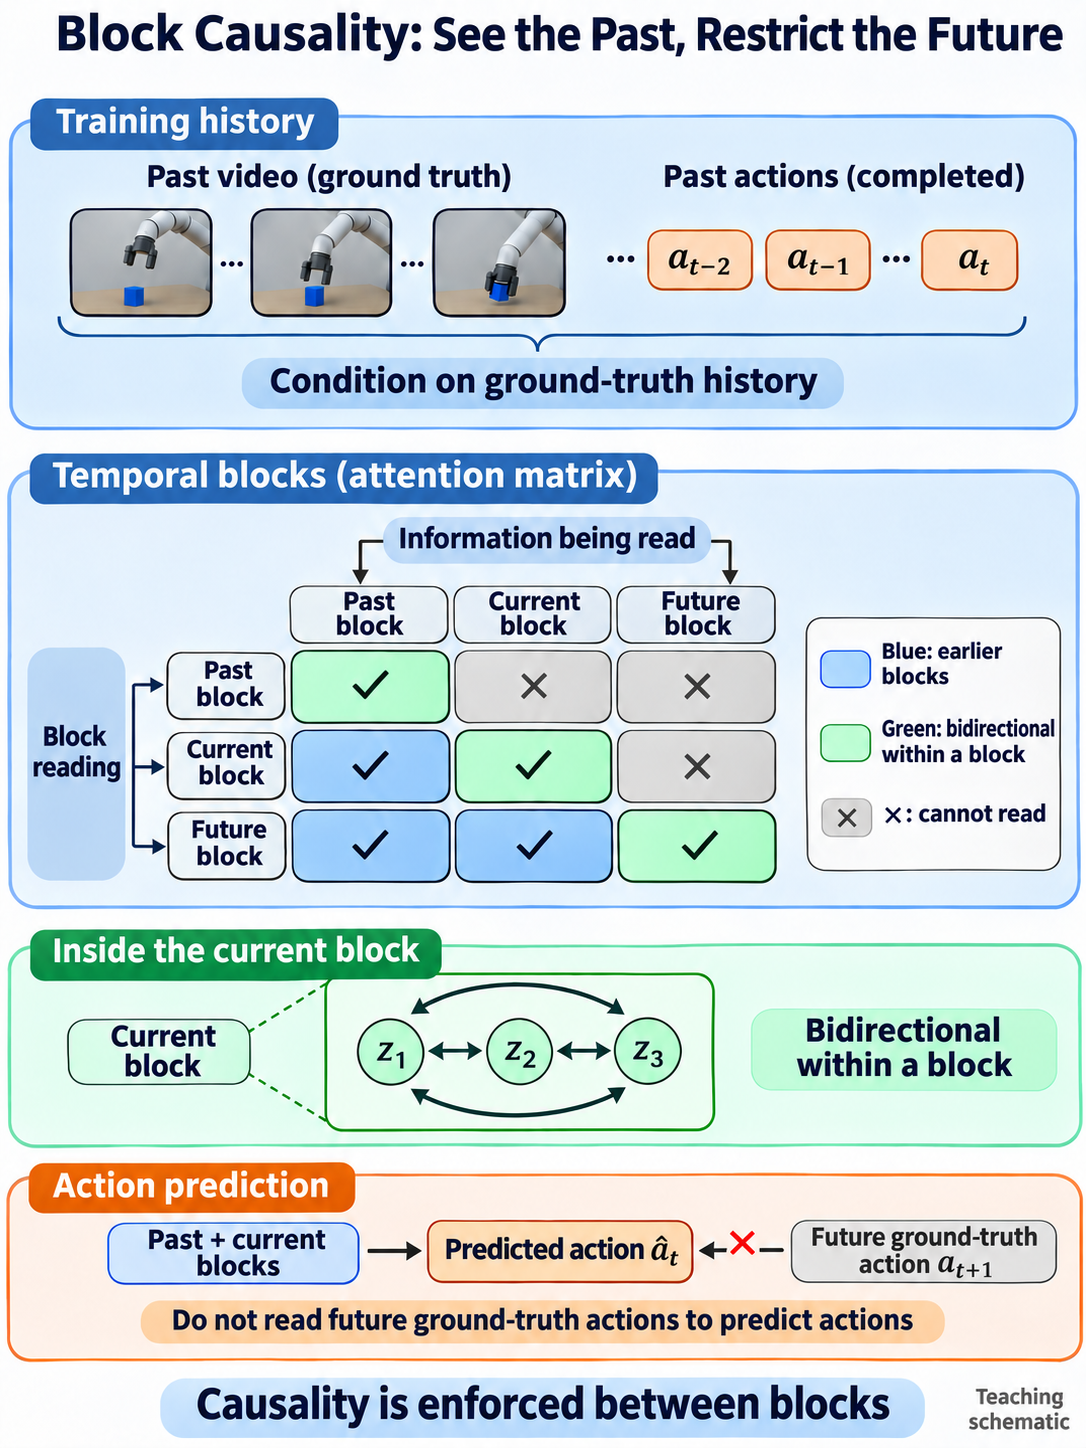
Ilustração didática: leia as linhas para identificar quem está lendo e depois as colunas para identificar o que é lido. Esta matriz apenas resume relações entre blocos temporais. A Figura 3 do artigo define a visibilidade detalhada entre fluxos de vídeo e ação, particularmente as conexões de dinâmica inversa com as condições visuais futuras correspondentes.
Histórico ruidoso: gerar ações antes que o vídeo esteja totalmente sem ruído
A Equação (10) adiciona ruído ao histórico de vídeo com probabilidade 0,5: , com amostrado de [0.5,1]; caso contrário, o histórico permanece limpo. Assim, o fluxo de ações aprende a inferir ações a partir de representações visuais que continuam ruidosas, mas contêm a estrutura da tarefa.
Isso dá suporte à remoção parcial de ruído do vídeo na inferência, reservando computação para as ações. O Algoritmo 1 ilustra a integração até 0,5; a Seção 4.2 na verdade relata 3 etapas de vídeo até 0,6 e 10 etapas de ação até 1,0. Estes são, respectivamente, um algoritmo conceitual e uma configuração experimental. Os padrões atuais do LeRobot, em vez disso, usam 20 etapas de vídeo e 50 etapas de ação, com video_exec_step=-1 desativando o truncamento antecipado. Esses três ajustes não são intercambiáveis, e a configuração de 3 etapas do artigo não pode estimar a velocidade do código padrão atual.
Execução em malha fechada: o que armazenar em cache e o que corrigir
Atualizar o cache KV com feedback real
O cache KV de um Transformer armazena as chaves e valores formados por tokens históricos em cada camada, evitando o recálculo de todo o histórico. O Algoritmo 1 começa com uma observação inicial, prediz latentes e ações futuras, executa as ações atuais, coleta observações reais e adiciona latentes reais e ações executadas ao cache.
O cache armazena características internas do modelo. Ele torna o histórico disponível, enquanto o uso efetivo desse histórico ainda depende do aprendizado. O contexto também é finito. O LeRobot atual usa attn_window=30 e chama reset para um novo episódio, limpando a fila de ações, o cache do Transformer e o cache de streaming da VAE. Isso não é memória ilimitada nem retenção automática de memória entre tarefas.
Assincronia exige mais do que iniciar duas threads
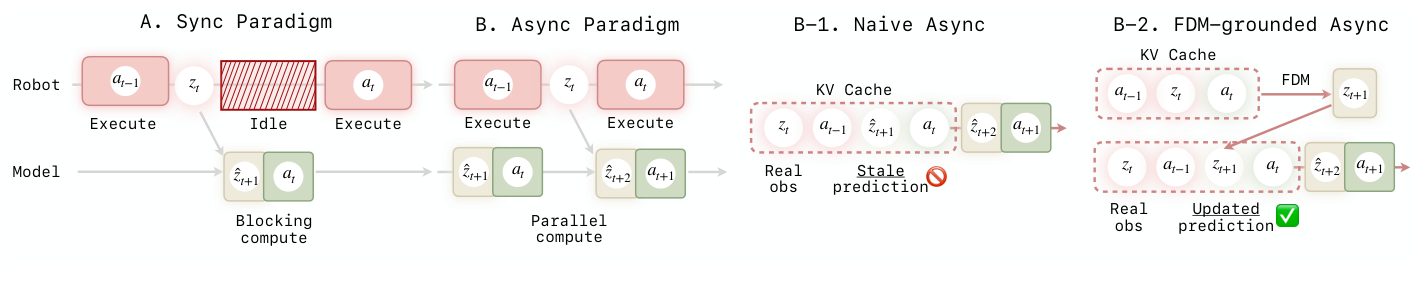
A sequência síncrona da Figura 4A é executar, observar, esperar pela geração e então continuar a execução. As hachuras vermelhas marcam a espera pela computação. A Figura 4B prediz o próximo bloco enquanto o robô executa o bloco atual, sobrepondo execução e geração.
O custo é informação obsoleta: o bloco atual não terminou quando o próximo é previsto. Se o modelo apenas reutiliza imagens imaginadas, ele ainda pode acreditar que a tampa está agarrada, apesar de observações reais recentes mostrarem um deslizamento. A Figura 4B-1 ilustra essas previsões antigas continuando a ocupar o contexto.
O artigo chama isso de ancoragem por Forward Dynamics Model (FDM): um cálculo de dinâmica direta que corrige previsões obsoletas. Partindo da observação real mais recente e das ações que estão sendo executadas, ele prediz novamente o resultado delas e então usa esse estado futuro realinhado para predizer o vídeo e as ações subsequentes. Ele usa a capacidade de previsão direta do próprio modelo; o artigo não exige um simulador totalmente separado. O pós-treinamento adiciona a perda de previsão direta na Equação (13), enquanto o Algoritmo 2 descreve a coordenação entre os ramos de execução e inferência.
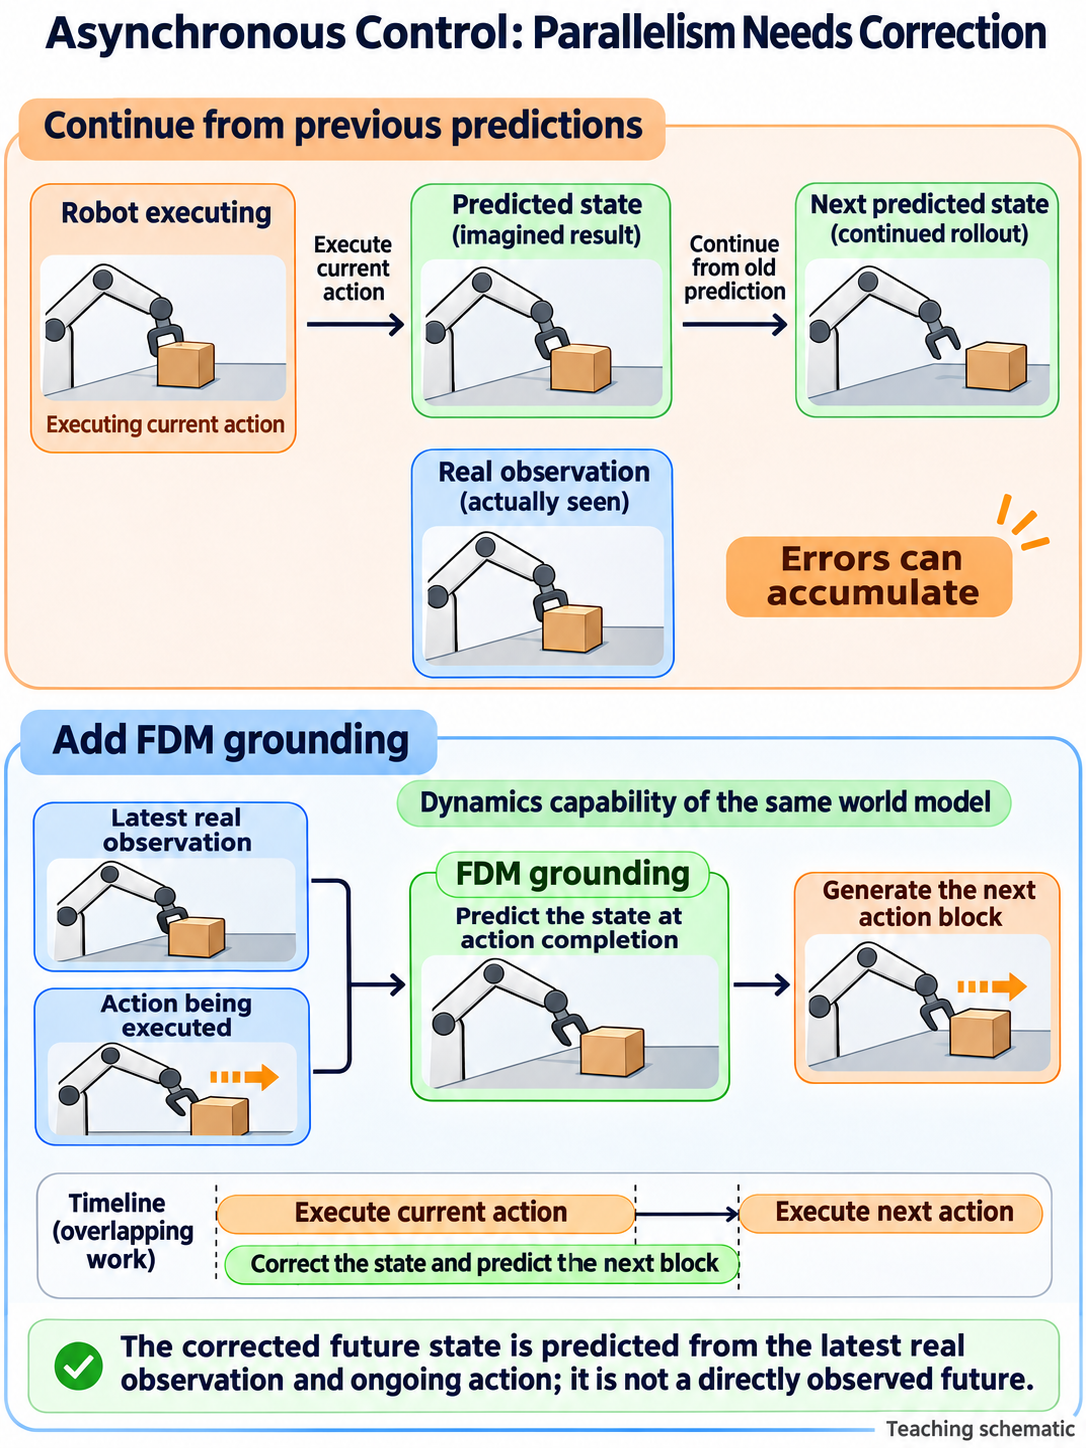
Ilustração didática: os dois caminhos diferem em usar ou não o feedback mais recente para predizer novamente as consequências das ações atuais. A linha do tempo abaixo mostra computação e execução sobrepostas, não observação direta do futuro nem proporções de tempo fixas.
Exemplo de temporização: suponha que executar o bloco atual leve 320 ms e gerar o próximo leve 180 ms. Um ciclo síncrono leva cerca de 320+180=500 ms. Se a execução cobrir totalmente a geração, o ciclo ideal em pipeline é de cerca de 320 ms, uma razão de velocidade de 500/320=1.56. Este exemplo didático ignora comunicação, inicializações frias e espera por feedback; não é uma medição do artigo. A assincronia reduz a espera, mas não torna atuais observações obsoletas.
O select_action atual do LeRobot espera até que a fila de ações esteja vazia, atualiza o cache com keyframes reais em buffer e o bloco de ação precedente e então gera vídeo e ações em série. Ele implementa feedback real entre blocos. O Algoritmo 2 exige adicionalmente execução e predição em paralelo, além da ancoragem FDM de previsões obsoletas.
Dados, representação de ações e estágios de treinamento
A Seção 4.1 lista seis fontes — AgiBot, RoboMind, InternData-A1, o subconjunto OpenVLA de OXE, a família UMI excluindo DexUMI e RoboCOIN — mais trajetórias coletadas internamente, totalizando aproximadamente 16.000 horas de dados de manipulação robótica. Cada conjunto de dados é dividido em 90%/10% para treinamento e validação. O conhecimento de vídeos da internet entra principalmente por meio da inicialização Wan; essas 16.000 horas não devem ser descritas como inteiramente vídeo humano sem rótulo de ação.
O espaço de ação canônico aloca para cada braço 7 dimensões de pose do efetuador final, até 7 dimensões de junta e 1 dimensão de garra: 2×(7+7+1)=30 para dois braços. Juntas ausentes são preenchidas. Poses de efetuador final e posições de juntas são representações de controle diferentes; os espaços não representam 30 graus de liberdade físicos independentes.
Nas interfaces disponibilizadas, o LIBERO usa 7 canais para deltas do efetuador final e a garra. O RoboTwin usa 16 canais para XYZ+quaternion+garra de dois braços e então os converte em trajetórias de juntas com cinemática inversa CuRobo. Embora a estrutura de 30 dimensões reserve espaços para juntas, esses dois checkpoints disponibilizados não predizem diretamente posições de juntas. Apenas preencher não completa a adaptação a um conjunto de dados personalizado em espaço de juntas.
| Estágio | Informação aprendida ou usada | Configurações para distinguir |
|---|---|---|
| Inicialização | Prior de geração de vídeo Wan2.2; VAE de vídeo e codificador de texto congelados | Os ramos assimétricos do artigo diferem da versão atual com backbone compartilhado |
| Pré-treinamento vídeo-ação | Vídeo de robô, ações e linguagem; objetivos de dinâmica e dinâmica inversa | O artigo relata 1,4T tokens, taxa de aprendizado máxima 1e-4, BF16 e |
| Pós-treinamento downstream | Demonstrações da plataforma e tarefas-alvo | Exemplo de adaptação geral: 1e-5, 3K etapas; seis tarefas de hardware: 50 demonstrações por tarefa, 1e-4, 500 etapas |
| Implantação | Instrução, imagens iniciais, feedback real subsequente e histórico de ações | Ações de saída; a decodificação de vídeo pode inspecionar previsões e não precisa rodar a cada passo de controle |
A seção de método usa [1,8] para ilustrar comprimentos de bloco variáveis; a Seção 4.2 relata treinamento real com [1,4]. Taxas de aprendizado e contagens de etapas de pós-treinamento também variam conforme a plataforma-alvo e o experimento.
Experimentos: evidências e condições
Simulação: comparar dentro da mesma avaliação
O treinamento do RoboTwin 2.0 usa 2.500 demonstrações limpas e 25.000 randomizadas em 50 tarefas, ou 50 e 500 por tarefa. O vídeo é subamostrado de 50 Hz para 12,5 Hz enquanto as ações permanecem em 50 Hz. Easy fixa configurações iniciais; Hard randomiza poses de objetos e layouts de cena (Seção 4.3.2).
| Método | RoboTwin Easy | RoboTwin Hard |
|---|---|---|
| π0.5 | 82,7% | 76,8% |
| Motus | 88,7% | 87,0% |
| LingBot-VA | 92,93% | 91,55% |
A Tabela 1 relata o sucesso médio em 50 tarefas. As margens sobre o Motus são cerca de 4,2/4,6 pontos percentuais, ou 8,2/9,1 pontos no grupo Horizon=3. Aqui, horizon agrupa passos de tarefa; não é o comprimento do bloco de geração . A Tabela S1 do apêndice também mantém fraquezas: Hanging Mug atinge apenas 40%/28% e Turn Switch 44%/45%, o que as médias gerais não devem obscurecer.
Cada uma das quatro suítes LIBERO contém 10 tarefas com 50 demonstrações por tarefa. O artigo relata 3 seeds aleatórias por suíte e 500 avaliações por seed, totalizando 1.500 por suíte. A Tabela 2 apresenta:
| Método | Spatial | Object | Goal | Long | Média |
|---|---|---|---|---|---|
| X-VLA | 98,2 | 98,6 | 97,8 | 97,6 | 98,1 |
| LingBot-VA | 98,5 ± 0,3 | 99,6 ± 0,3 | 97,2 ± 0,2 | 98,5 ± 0,5 | 98,5 |
Os valores são taxas de sucesso em %. LingBot-VA não supera X-VLA em Goal. Os valores de baseline vêm do artigo do X-VLA, sem condições de treinamento e implementação totalmente correspondentes. Os valores originais de ± são mantidos; o artigo não especifica se são desvios padrão, erros padrão ou intervalos de confiança. As altas taxas de sucesso se aplicam a essas tarefas e protocolos de simulação.
Hardware: sucesso e progresso podem contar histórias diferentes
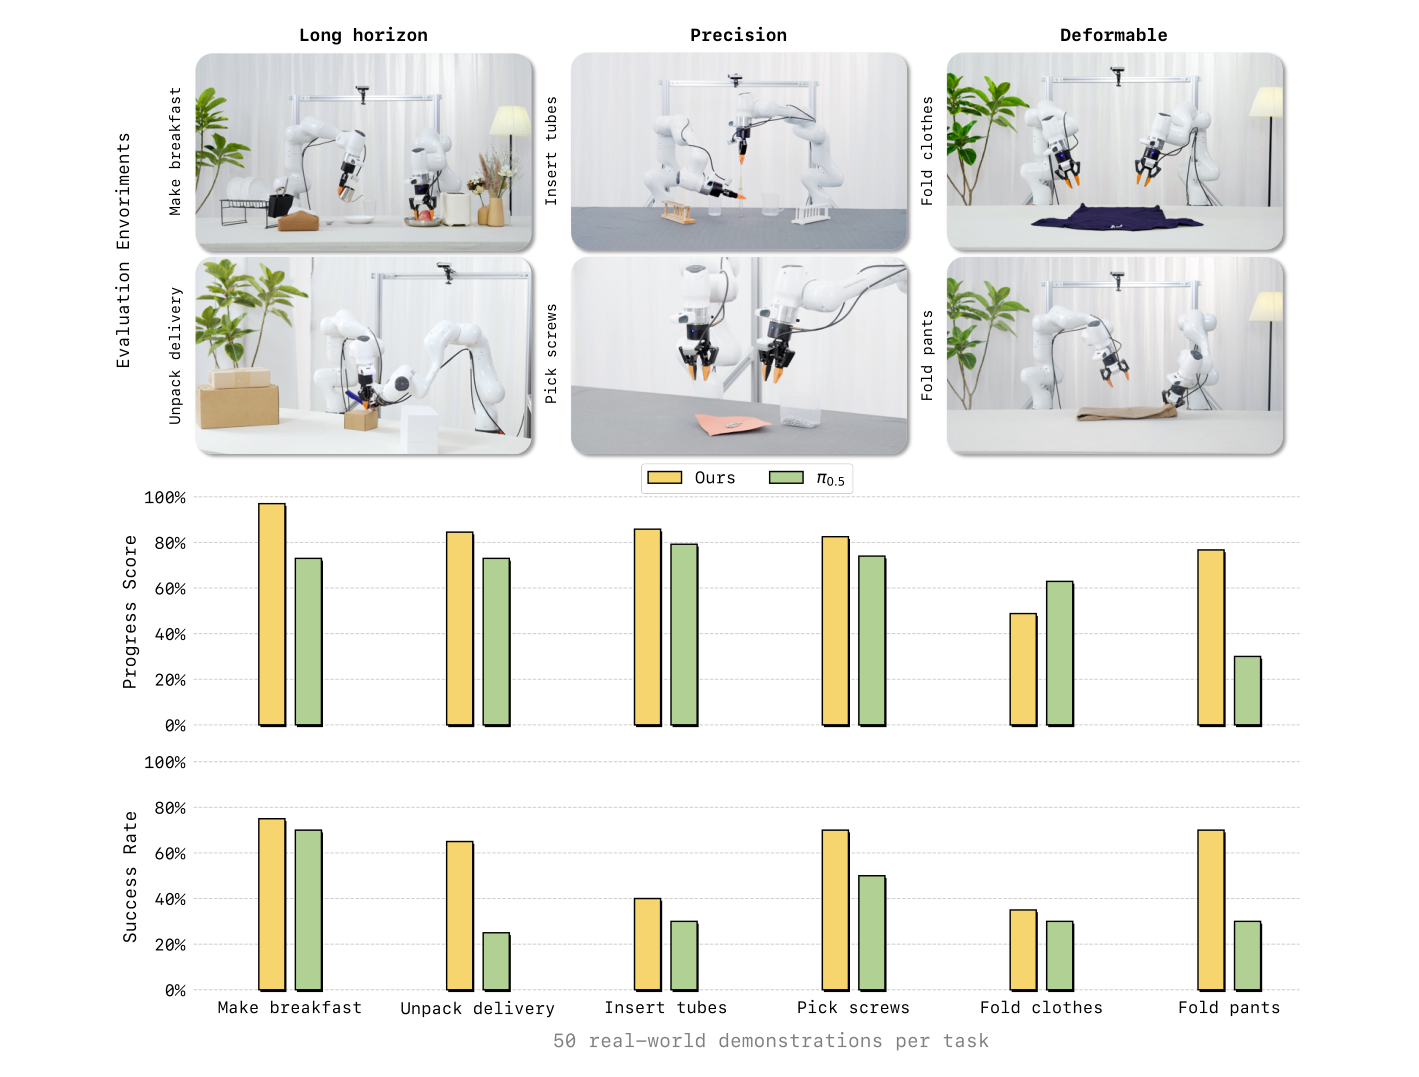
O topo da Figura 5 mostra seis tarefas: Make Breakfast, Unpack Delivery, Insert Tubes, Pick Screws, Fold Clothes e Fold Pants. Cada tarefa usa 50 demonstrações em robô real para pós-treinamento. As Tabelas S2–S7 do apêndice listam cada uma 20 avaliações. O escore de progresso é o escore de subetapa dividido pelo escore máximo; a taxa de sucesso é calculada a partir dos rótulos de Success dos testes e não pode ser simplesmente inferida a partir de se o progresso atinge seu máximo.
| Tarefa | Escore de progresso / taxa de sucesso do LingBot-VA | Escore de progresso / taxa de sucesso do π0.5 |
|---|---|---|
| Make Breakfast | 97,0 / 75,0 | 73,0 / 70,0 |
| Unpack Delivery | 84,5 / 65,0 | 73,0 / 25,0 |
| Insert Tubes | 85,8 / 40,0 | 79,2 / 30,0 |
| Pick Screws | 82,5 / 70,0 | 74,0 / 50,0 |
| Fold Clothes | 48,8 / 35,0 | 62,9 / 30,0 |
| Fold Pants | 76,7 / 70,0 | 30,0 / 30,0 |
Todos os valores são porcentagens, retiradas das tabelas do apêndice. O sucesso em Breakfast é 15/20=75%: mesmo com 97% de progresso médio, um quarto dos testes não tem rótulo de sucesso. A dobra de roupas tem uma tentativa bem-sucedida a mais, mas um escore médio de progresso 14,1 pontos menor. Isso difere da afirmação ampla do texto principal de liderança em ambas as métricas para todas as seis tarefas; a própria Figura 5 mostra o contraexemplo.
A tabela produz taxas médias de sucesso de aproximadamente 59.2% e 39.2%, mas um teste em hardware corresponde a 5 pontos percentuais. Os resultados apoiam uma melhoria geral neste conjunto de tarefas, sem isolar a contribuição causal de cada componente. E 50 demonstrações de tarefas-alvo não significam que o modelo foi treinado do zero com apenas 50 amostras.
Ablations de assincronia e pré-treinamento: benefícios com custos
A Tabela 3 relata o seguinte em RoboTwin Easy:
| Configuração | Sucesso médio em todas as tarefas | Horizonte=3 |
|---|---|---|
| Linha de referência LingBot-VA | 92.9% | 93.2% |
| Assíncrono com grounding FDM | 90.4% | 85.6% |
| Assíncrono ingênuo | 74.3% | 32.9% |
| Pós-treinamento a partir de inicialização WAN | 80.6% | 67.6% |
O grounding FDM melhora em relação à assincronia ingênua em 16,1 pontos percentuais no geral e 52,7 no grupo de tarefas longas, apoiando o realinhamento de previsões obsoletas com feedback. Ainda fica atrás da linha de referência em 2,5 pontos no geral e 7,6 em tarefas longas. Os autores relatam aproximadamente 2× de velocidade para execução assíncrona, mas a tabela não lista nem tempos nem hardware de teste. As taxas de sucesso mostram um custo de desempenho ao reduzir a espera. O resultado de velocidade também não se aplica diretamente ao caminho de geração serial do LeRobot atual.
A diferença entre inicialização WAN e pré-treinamento completo apoia o valor do pré-treinamento de vídeo-ação de robô. Essa comparação altera a experiência de pré-treinamento, então a lacuna completa não pode ser atribuída a um único módulo de atenção. A Tabela 3 não compara diretamente modelagem de mundo AR e bidirecional e, portanto, não quantifica separadamente o benefício da estrutura autoregressiva.
O que os testes de few-shot, memória e generalização mostram
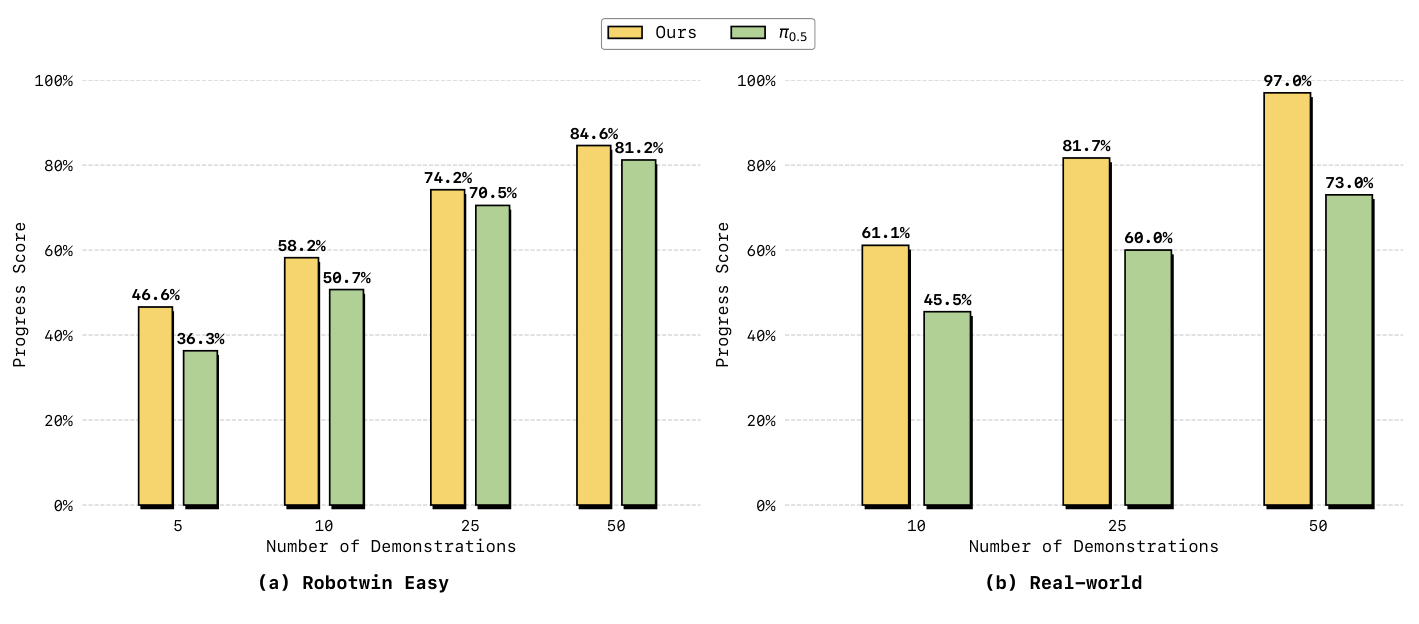
A Figura 8 traça a contagem de demonstrações de tarefas-alvo contra a pontuação de progresso. Para o café da manhã à direita, 10 demonstrações produzem 61.1% versus 45.5%, uma diferença de 15,6 pontos; 50 produzem 97.0% versus 73.0%. Para RoboTwin Easy à esquerda, 10 demonstrações produzem 58.2% versus 50.7%, uma diferença de 7,5 pontos. O texto afirma 10,3, mas a figura associa 46.6−36.3=10.3 a 5 demonstrações. Este guia segue a correspondência da figura. Esses resultados indicam menos demonstrações necessárias nas condições de pós-treinamento testadas, não menores custos de dados ou computação de pré-treinamento.
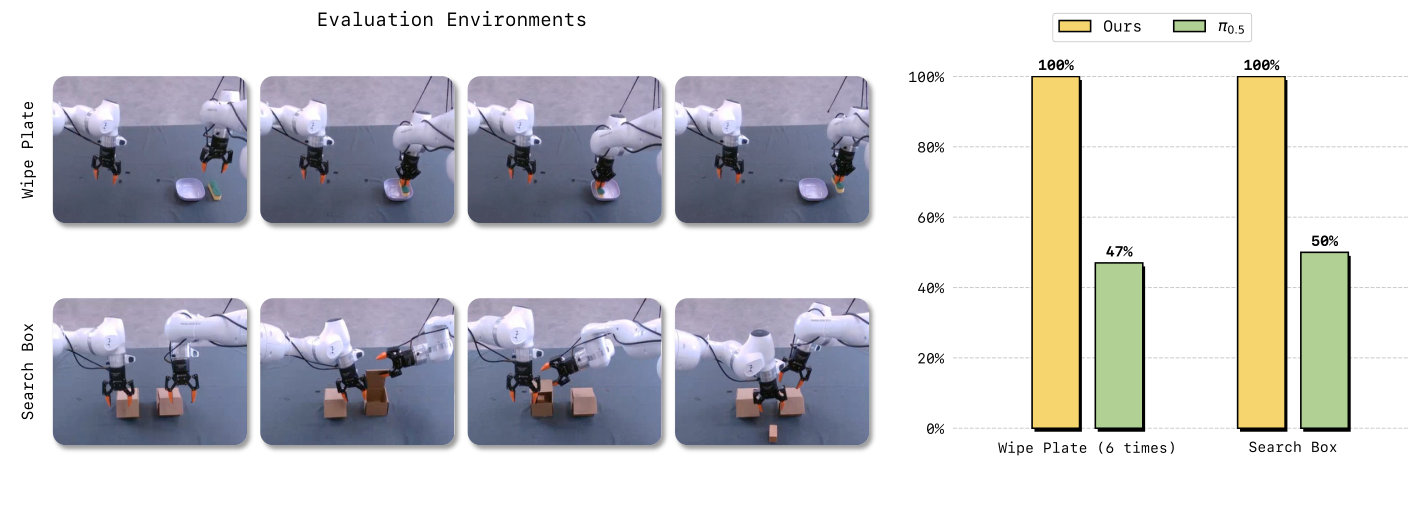
Limpar o prato exige exatamente seis repetições; a busca em caixas exige lembrar que a caixa da direita estava vazia e então buscar na esquerda. As barras à direita da Figura 9 relatam 100% para LingBot-VA em ambas, versus 47% e 50% para π0.5. Esses testes sondam o uso de estado temporal de forma mais direta do que a preensão em quadro único. No entanto, o artigo não fornece contagens de tentativas para essas barras e não remove independentemente o cache KV aqui, então eles não estabelecem confiabilidade em tarefas arbitrárias de histórico longo.
A Figura 10 visualiza substituições de objetos e faixas mais amplas de posição de objetos, sugerindo generalização. Sem uma tabela completa de sucesso fora da distribuição ou contagens de amostras, algumas demonstrações bem-sucedidas não podem estabelecer robustez geral. Continuidade visual, conclusão da tarefa e correção física permanecem em níveis diferentes de avaliação.
Integração com LeRobot: conectando mecanismos à interface atual
LeRobot fornece um modelo base e checkpoints pós-treinados de LIBERO-Long e RoboTwin. Os checkpoints armazenam os pesos principais treináveis do Transformer; o VAE congelado, o codificador de texto e o tokenizador são obtidos separadamente durante o carregamento, então o carregamento prático também requer esses componentes.
A ordem das câmeras faz parte da definição de entrada. LIBERO coloca a visão externa antes da visão do punho, concatenando latentes ao longo da largura. RoboTwin usa visões de cabeça, punho esquerdo e punho direito no layout robotwin_tshape. Trocar nomes de câmeras sem ajustar o layout altera o significado espacial. Canais de ação válidos, convenções de pose do efetuador final e estatísticas de normalização também devem corresponder ao checkpoint.
O padrão 4×4=16 descreve um bloco de ação comum. No código fixado, o primeiro bloco inclui o quadro de condicionamento inicial e descarta suas ações correspondentes, então retorna (4−1)×4=12 passos; blocos posteriores retornam 16. A interface atual prevê novamente após a fila esvaziar. Suas atualizações de geração 20/50 não devem ser chamadas de frequências de controle.
O forward de treinamento codifica janelas temporais de câmera e calcula as perdas de flow matching de vídeo e de ação. attn_mode=flex é necessário para o caminho de treinamento causal em blocos. save_predicted_video adiciona decodificação VAE para inspecionar mudanças ambientais previstas; a avaliação deve comparar esse vídeo imaginado com gravações reais de execução.
Conclusão
A percepção central do LingBot-VA é que representações futuras podem condicionar a geração de ações, mas devem ser continuamente corrigidas pelo ambiente real. O ramo de vídeo aprende mudanças, o ramo de ação infere controle a partir delas, e o cache de histórico preserva o contexto de interação. Desnoising parcial e execução assíncrona abordam o custo de tempo de trazer a geração para dentro do controle.
Experimentos apoiam essa abordagem nas configurações de simulação, hardware e few-shot testadas, ao mesmo tempo em que mantêm limites claros: menor progresso em dobrar roupas, degradação substancial com assincronia ingênua e um custo em taxa de sucesso mesmo com grounding FDM. O backbone compartilhado liberado e a interface LeRobot também diferem do sistema completo do artigo. Essas condições ajudam a determinar experimentos de acompanhamento adequados mais do que uma taxa média de sucesso sozinha.