LingBot-VLA 2.0: Ações entre Diferentes Corpos e Percepção do Futuro
Da Base à Aplicação: Melhorando Modelos VLA na Prática
- Dados entre diferentes corpos
- Espaço de ação de 55 dimensões
- MoE esparso
- Predição do futuro
Para colocar frutas em uma geladeira, um robô precisa identificar objetos, alcançar e agarrar, mover sua base, abrir a geladeira e colocar a fruta. Mudar de robô muda contagens de juntas, posições de câmeras e ações disponíveis. LingBot-VLA 2.0 pergunta como um único modelo de base pode aprender experiência de manipulação compartilhada enquanto acomoda requisitos de controle de corpos diferentes e antecipa mudanças subsequentes na cena.
Pré-requisitos: Experiência Compartilhada e Interfaces de Controle Compartilhadas
Um modelo Visão-Linguagem-Ação (VLA) recebe imagens, texto de tarefa e o estado atual do robô, depois produz valores numéricos de controle. Ele precisa aprender como se mover em uma cena, em vez de apenas descrevê-la.
Corpo (embodiment) significa o corpo físico de um robô e suas condições de controle. Garras bimanuais, mãos humanoides hábeis e braços em bases móveis não podem reutilizar valores de juntas idênticos mesmo para a mesma instrução. Um formato de dados unificado fornece uma interface comum, enquanto o modelo ainda precisa aprender os padrões de movimento de cada corpo.
Um bloco de ação (action chunk) é uma sequência de ações de múltiplos passos prevista de uma vez. A implementação disponibilizada usa por padrão 50 passos, cada um usando um vetor canônico de 55 dimensões, com forma 50 × 55. Isso inclui preenchimento e não significa que o robô tenha 55 juntas. Gerar um bloco também não significa que o controlador só possa rodar uma vez por segundo.
Resumo e Guia de Leitura
Paráfrase: Apesar do progresso em modelos de base VLA, ainda existe um gap entre resultados de laboratório e aplicações práticas. LingBot-VLA 2.0 melhora seu predecessor em três direções funcionais: um pipeline de dados redesenhado e pré-treinamento em cerca de 60.000 horas, compreendendo 50.000 horas de trajetórias em 20 configurações de robôs e 10.000 horas de vídeo egocêntrico humano; um espaço de controle expandido para cabeças, cinturas, bases móveis e mãos hábeis; e predição do futuro como tarefa proxy para modelagem de dinâmica preditiva, usando um modelo de representação de vídeo para priors semânticos e um modelo de profundidade para pistas geométricas. Os autores avaliam essas melhorias em configurações de política generalista GM-100 e em manipulação móvel de longo horizonte em duas plataformas.
Nota de leitura: Essas três direções em conjunto constituem a contribuição do sistema. MoE expande a capacidade de modelagem de ações por meio da arquitetura; a destilação de dupla consulta treina representações espaciais e temporais. As principais tabelas de resultados avaliam o sistema completo e não podem atribuir toda a melhora média a um único módulo.
Introdução e Trabalhos Relacionados: Por que Mudar Três Coisas ao Mesmo Tempo?
O primeiro parágrafo da introdução reconhece dois fundamentos: modelos visão-linguagem fornecem semântica imagem-texto, e conjuntos de dados de robôs maiores fornecem experiência de manipulação. O segundo identifica demandas práticas mais fortes: os dados vêm de corpos diferentes, as ações envolvem mais partes do corpo e ambientes em mudança exigem entender resultados subsequentes.
O terceiro parágrafo revisa escalonamento de dados, arquiteturas para diferenças de corpo e ações latentes ou modelagem preditiva. O quarto organiza isso em três melhorias: dados mais amplos e limpos, mais partes do corpo controláveis e aprendizado de percepção direcionado ao futuro. Experimentos de manipulação bimanual e manipulação móvel então testam essa abordagem (páginas 1–2 do PDF).
Os trabalhos relacionados têm dois grupos (Seção 2):
- Políticas generalistas de manipulação: Escalonamento de dados, experiência humana egocêntrica, representações de ação unificadas, supervisão geométrica e objetivos preditivos fornecem capacidades diferentes. Este trabalho as reúne em um único framework de pré-treinamento e controle.
- VLAs com Mixture-of-Experts: Algumas abordagens organizam especialistas por sensoriamento de força, parte do corpo ou habilidade atômica. Aqui, cada token de ação seleciona especialistas a partir de suas próprias features, sem pré-atribuir especialistas a robôs ou habilidades específicas.
Comparação com LingBot-VA: Como a Informação Futura Entra na Geração de Ações
LingBot-VA e LingBot-VLA 2.0 buscam ambos usar mudanças ambientais para ação. A diferença é que LingBot-VA gera latentes de vídeo futuros na inferência e infere ações a partir de mudanças visuais; LingBot-VLA 2.0 treina consultas com supervisão de features futuras e então permite que especialistas de ação leiam essas consultas na inferência.
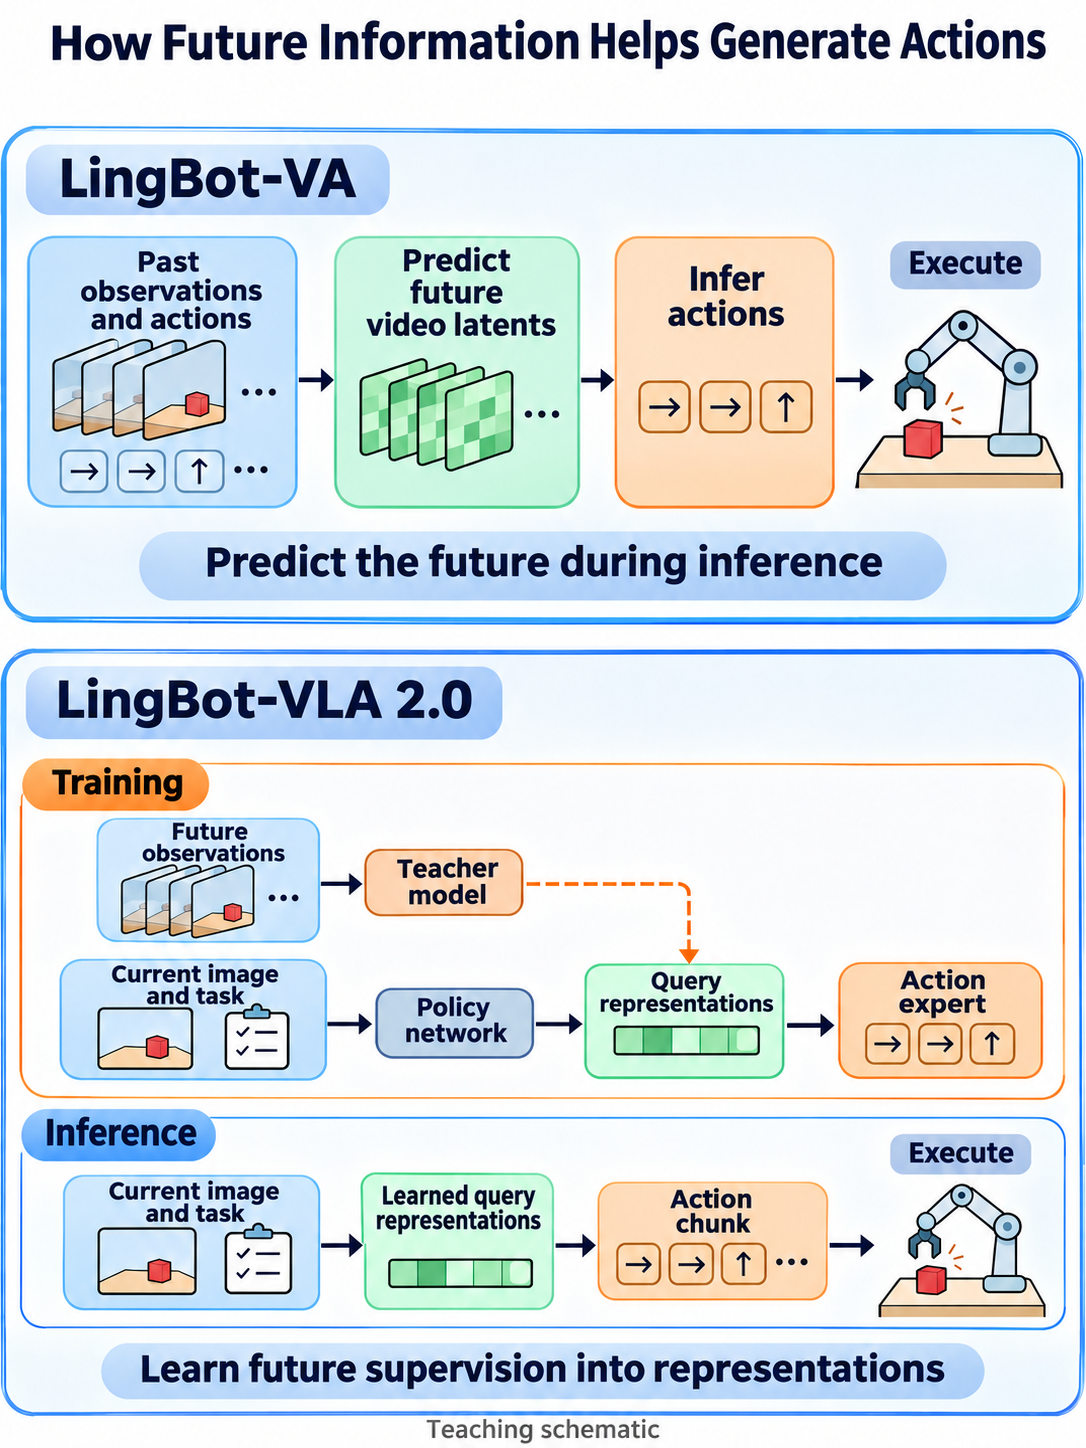
Ilustração didática: setas sólidas traçam a geração de ações; setas tracejadas laranja traçam a supervisão de treinamento. Os alvos do professor em VLA 2.0 se alinham às representações de consulta realmente lidas pelos especialistas de ação, e a linha de inferência mantém o caminho de consulta aprendido. Condições compartilhadas como o estado do robô são omitidas.
| Aspecto | LingBot-VA | LingBot-VLA 2.0 |
|---|---|---|
| Base principal | Prior de geração de vídeo Wan2.2 e condicionamento de texto | Backbone de compreensão visão-linguagem Qwen3-VL |
| Representação de futuro | Latentes de VAE de vídeo previstos condicionam ações; imagens podem ser decodificadas quando necessário | Consultas predizem profundidade e recursos DINO-Video; não é um gerador de vídeo RGB |
| Aprendizado de ação | Fluxo de correspondência de duas vias para dinâmica de vídeo e dinâmica inversa | Correspondência de fluxo de ação mais alinhamento de recursos de professor atual/futuro |
| Organização de capacidade | MoT assimétrico de dois ramos no artigo; backbone compartilhado na versão atual | Especialistas de ação MoE esparsos; a configuração lançada tem 32 especialistas roteados, top-4 |
| Cobertura de dados e corpos | Cerca de 16.000 horas de trajetórias de robôs; espaço canônico de braço duplo de 30 dimensões | Cerca de 50.000 horas de robôs e 10.000 horas de trajetórias humanas egocêntricas; 55 dimensões cobrem cabeça, cintura, base e mãos hábeis |
| Histórico e feedback | Geração em blocos com observações reais e histórico de ações em um cache KV | Observações atuais, linguagem, estado e consultas condicionam ações; o padrão atual do LeRobot é um passo de observação |
| Cálculo adicional de inferência | Geração de latentes de vídeo permanece no caminho de controle; redução parcial de ruído e assincronia reduzem o custo no artigo | Professores futuros são apenas para treinamento; a inferência mantém consultas sem executar professores de profundidade/vídeo |
Considere uma preensão malsucedida em uma tampa de caixa. LingBot-VA precisa de feedback real para substituir ou corrigir sua previsão visual anterior de uma preensão bem-sucedida; caso contrário, o próximo bloco pode continuar a partir de um estado imaginado falso. O esquema assíncrono do artigo usa ancoragem FDM para realinhar sua previsão do resultado visual das ações em andamento com o feedback real. O LeRobot atual só atualiza o feedback depois que a fila esvazia e não implementa totalmente esse algoritmo assíncrono. VLA 2.0 gera outro bloco a partir de observações e estado reais na próxima rodada; suas consultas futuras fornecem recursos preditivos aprendidos em vez de uma simulação explícita de vídeo imaginado.
Contagens padrão de geração também não comparam diretamente a velocidade. No código fixado do LeRobot, um bloco VA comum tem 4×4=16 posições de ação, com 20/50 atualizações de vídeo/ação; VLA 2.0 usa blocos de 50 passos e 10 atualizações de geração de ação. Arquitetura, precisão, resolução e agendamento diferem, então contagens de atualização sozinhas não determinam a velocidade. O primeiro bloco do VA retorna apenas 12 passos por causa de seu quadro de condicionamento inicial; veja sua seção de integração.
Conclusões experimentais exigem o mesmo cuidado. A tabela principal RoboTwin do VA relata médias Easy/Hard de 92.93%/91.55%; os 93.52%/92.80% na documentação de integração deste guia vêm de uma versão posterior de checkpoint do VLA 2.0. Nenhum dos artigos fornece uma comparação direta com modelos, treinamento e condições de execução totalmente correspondentes. Esses quatro números não podem estabelecer que o VLA 2.0 é melhor em todos os aspectos. As abordagens enfatizam, respectivamente, previsão ambiental explícita durante a inferência e supervisão de percepção futura para modelagem de ação entre diferentes corpos.
Dados: Tornando Trajetórias Dignas de Aprendizado e Compatíveis entre Fontes
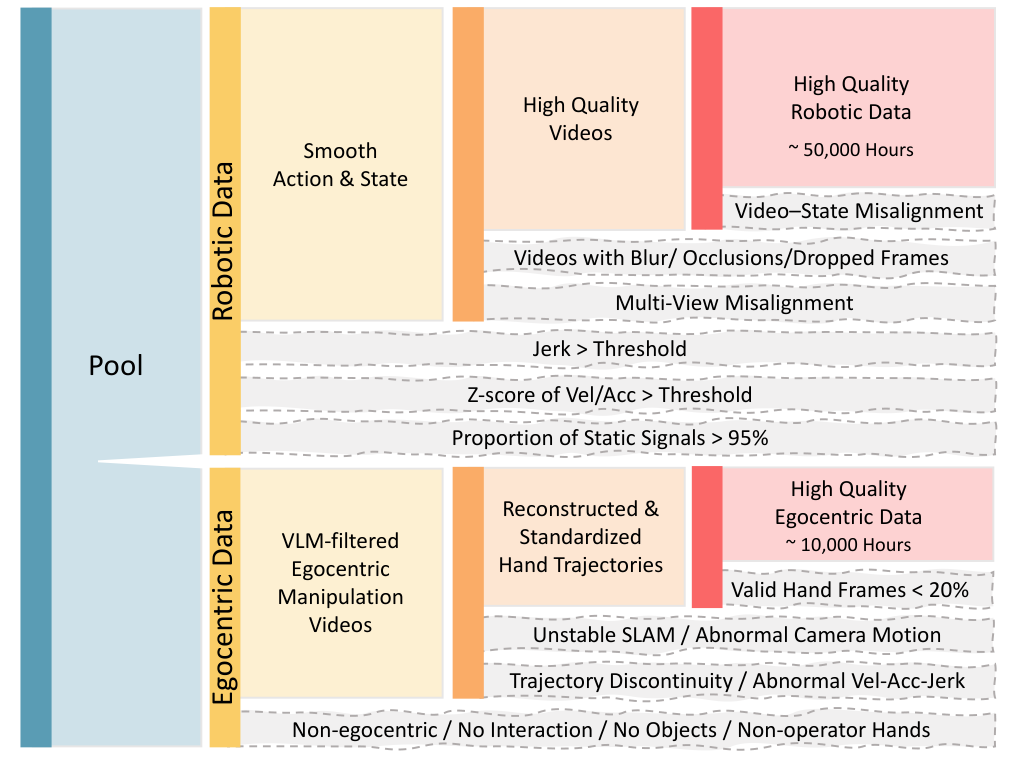
Os dois caminhos da Figura 3 retêm cerca de 50.000 e 10.000 horas. As 60.000 horas descrevem dados de treinamento filtrados, não a coleta original. O conjunto bruto de robôs contém cerca de 90.000 horas, e o conjunto egocêntrico cerca de 20.000 (Seção 3.1).
As trajetórias de robôs são primeiro verificadas quanto a velocidade, aceleração e tranco—a taxa de variação da aceleração—para remover movimentos bruscos. Trajetórias que ficam quase estacionárias por mais de 95% de sua duração também são descartadas. Limiares são específicos ao corpo. Descrições de robôs URDF e estados gravados são então projetados em imagens para verificações de alinhamento humano, removendo borrões, forte oclusão, quadros perdidos e câmeras desalinhadas.
Um VLM primeiro exclui clipes egocêntricos contendo apenas caminhada, sem interação mão-objeto, observação em terceira pessoa ou mãos dominadas por alguém que não seja o operador. Trajetórias de mão existentes são alinhadas em tempo e coordenadas. Para vídeos sem trajetórias, SLAM estima o movimento da câmera e a estimativa de pose de mão MANO recupera trajetórias de mão em coordenadas do mundo. Clipes são filtrados se quadros de mão válidos ficarem abaixo de 20%, estimativas de câmera forem instáveis ou o movimento da mão violar restrições anatômicas. Esses vídeos devem gerar supervisão de trajetória antes do treinamento; vídeo humano arbitrário não é tratado diretamente como ações de juntas de robô.
Para evitar confundir rotação de cabeça com movimento de mão, trajetórias são armazenadas em coordenadas do mundo. Após amostrar o quadro atual, trajetórias de mão subsequentes são transformadas para o quadro de câmera desse mesmo instante. A Equação (1) é:
Aqui, é o tempo da trajetória, o tempo de observação atual, e o quadro do mundo. inclui rotação e translação e atua em posições em coordenadas homogêneas. Exemplo didático: Se a câmera está em x=1 m do mundo com eixos alinhados ao mundo, e a mão está em x=1,3 m do mundo, sua coordenada na câmera atual é x=0,3 m. Pontos subsequentes usam o mesmo , em vez de seus quadros de câmera individualmente variáveis.
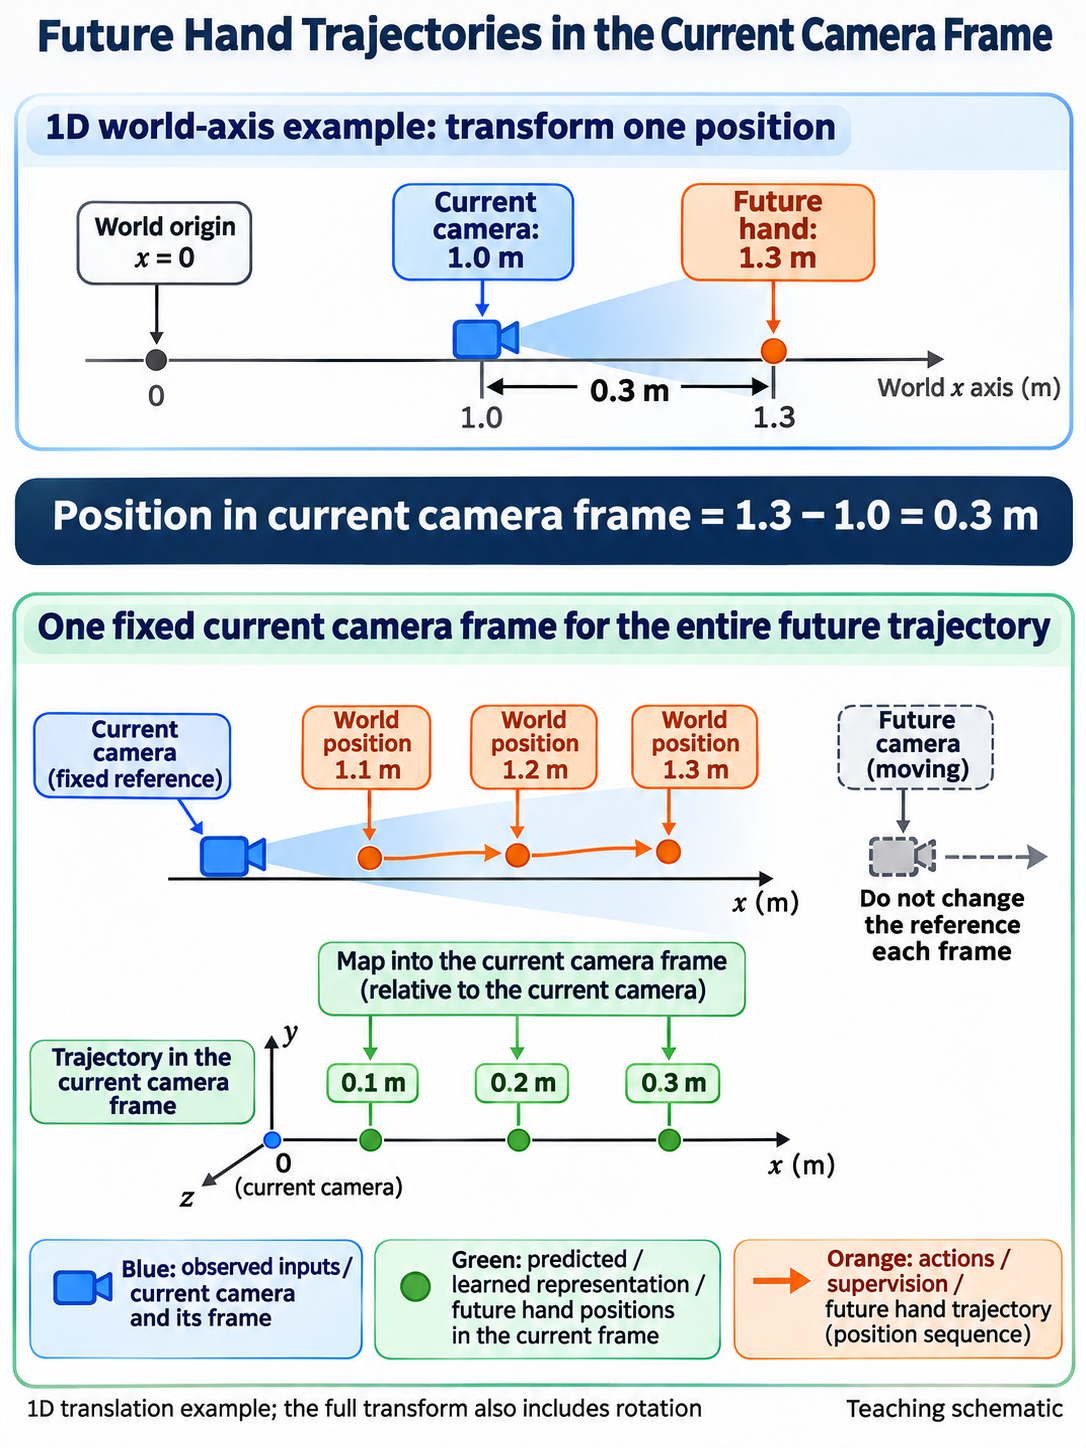
Ilustração didática: subtraia a posição atual da câmera das coordenadas do mundo e então expresse pontos subsequentes no mesmo quadro de referência. Os valores 0,1, 0,2 e 0,3 m ilustram uma translação unidimensional com eixos alinhados; a transformação completa também inclui rotação.
Qwen3.6-27B anota automaticamente a supervisão de linguagem, incluindo instruções de tarefa completas e instruções de subtarefas temporalmente contínuas. Rótulos de ação contêm 15 classes de manipulação mais transit, idle e other; nomes de objetos têm vocabulário aberto. Agarrar, transportar e soltar dentro de uma interação formam uma subtarefa para evitar fragmentação excessiva. A Figura 5 mostra que move e transit juntos respondem por cerca de 88,7% das subtarefas, enquanto idle é excluída do treinamento. Um grande conjunto de dados não implica habilidades equilibradas.
Um Espaço de Ação Unificado de 55 Dimensões
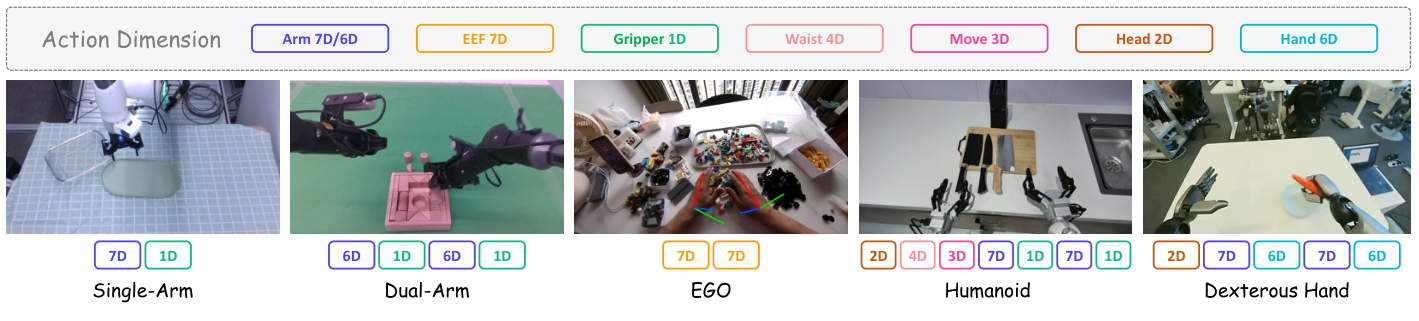
A Figura 4 usa cores para colocar valores de controle de diferentes robôs em slots comuns de partes do corpo. A Seção 3.1.3 define o seguinte vetor canônico tanto para estados quanto para ações:
| Parte | Dimensões | Significado |
|---|---|---|
| Juntas de braço duplo | 14 | Até 7 posições de junta por braço |
| Poses de efetuador final de braço duplo | 14 | Posição XYZ e quaternions, 7 dimensões por braço |
| Garras | 2 | Posições das garras em ambos os lados |
| Mãos hábeis | 12 | Posições de juntas para ambas as mãos |
| Cintura / cabeça | 4 + 2 | Juntas corporais correspondentes |
| Sinais de mobilidade | 3 | Movimento da base; o slot do LeRobot é chamado base.velocity |
| Reservado | 4 | Espaço para extensão |
O total é 14 + 14 + 2 + 12 + 4 + 2 + 3 + 4 = 55. Partes do corpo ou dimensões ausentes são preenchidas. Posições de juntas e poses de efetuador final são representações diferentes; reservar ambas não cria 28 graus de liberdade físicos independentes.
Exemplo didático: Um conjunto de dados de braço único com 5 juntas e 1 garra pode usar [q₁,…,q₅,g]. O LeRobot coloca os primeiros 5 valores no início de arm.position, coloca g em effector.position, preenche o restante com zeros e exclui dimensões inválidas da perda de ação com uma máscara. As saídas são mapeadas de volta para as 6 dimensões originais. Mapeamentos correspondentes se aplicam separadamente a estados e ações e devem concordar com mapeamentos de câmera e estatísticas de normalização.
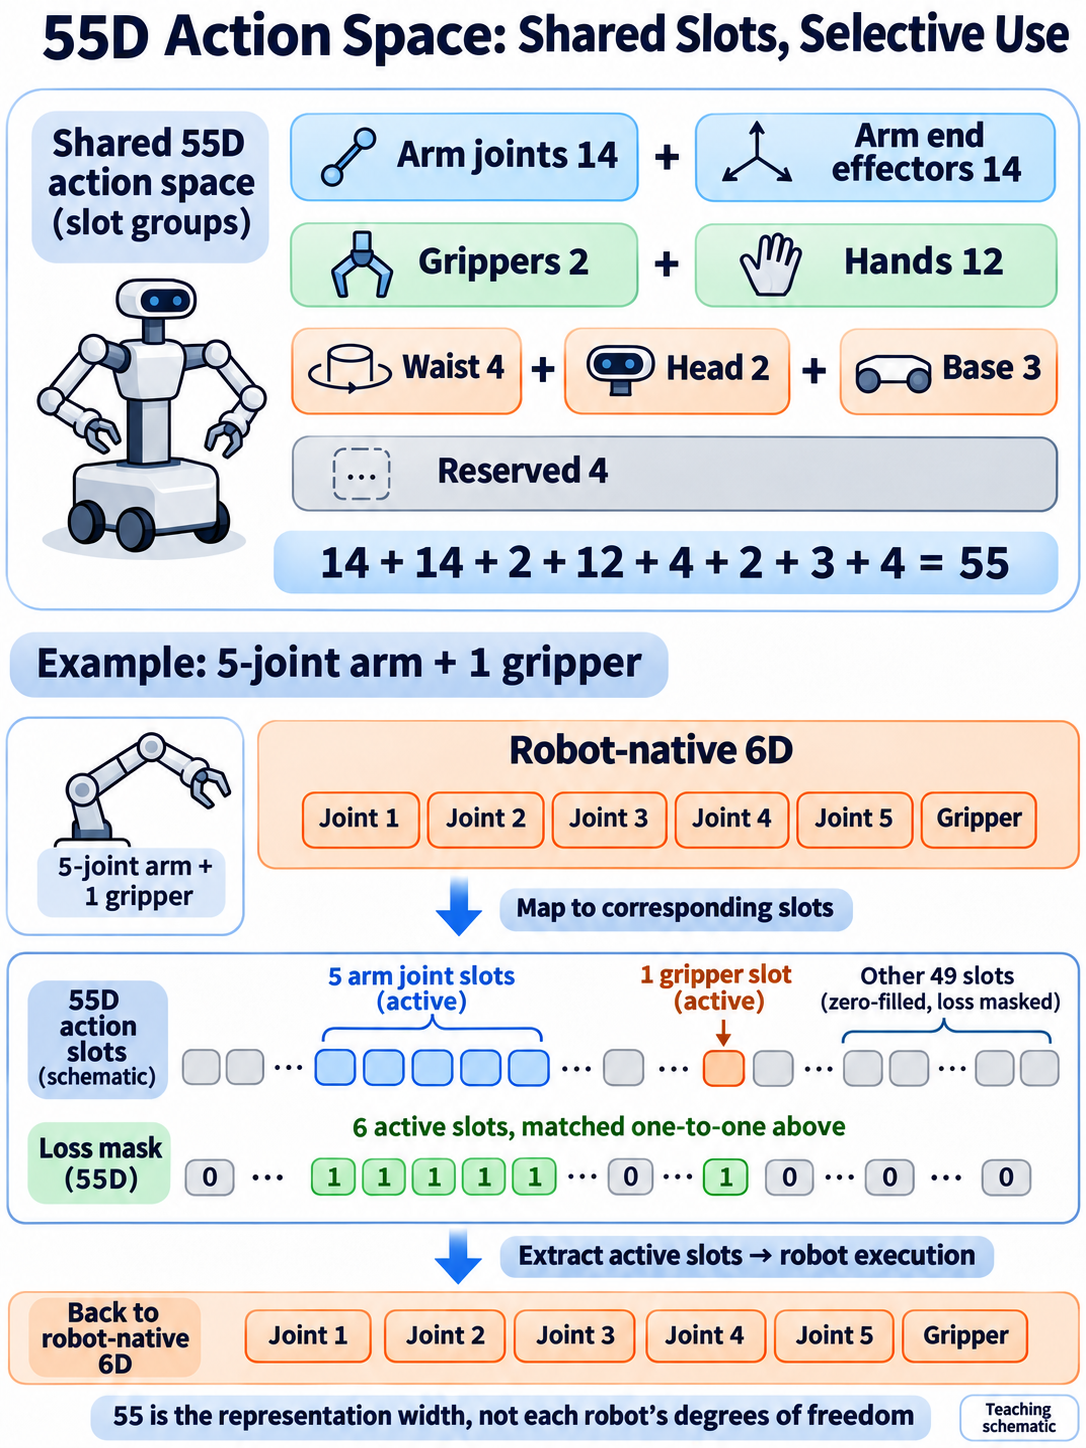
Ilustração didática: cinco juntas e uma garra ocupam seus respectivos slots, que podem ser separados por dimensões não utilizadas. Slots em cinza são mascarados da perda de ação. As saídas ainda devem ser reduzidas a dimensões válidas e restauradas para a interface de controle do robô.
Slots unificados permitem que dados sejam processados em lote juntos, mas coordenadas, unidades e significados de juntas ainda exigem configuração correta. Eles fornecem uma interface para aprendizado entre diferentes corpos; o comprimento do vetor por si só não pode garantir uso sem adaptação de um novo robô.
Rede Central: Compreender Cenas, Roteamento de Especialistas, Gerar Ações
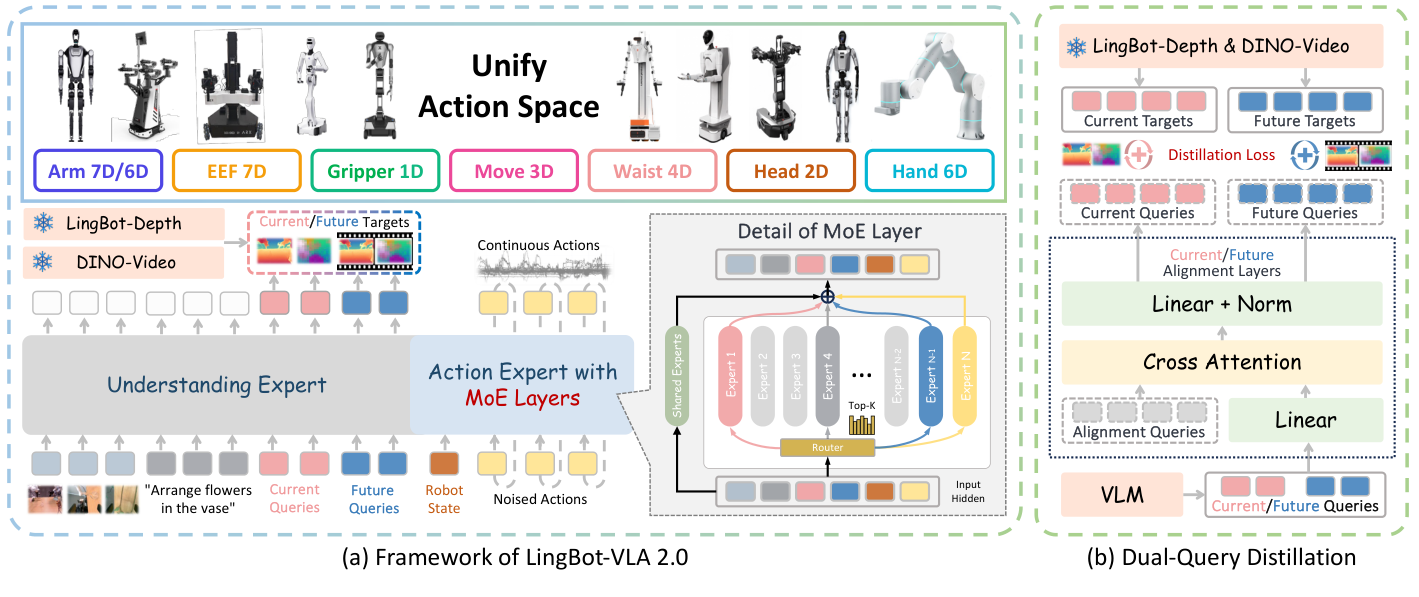
Comece pela esquerda da Figura 1. Imagens e instruções entram no ramo de compreensão, com consultas atuais e futuras colocadas após tokens de imagem-texto. O ramo de ação recebe o estado atual do robô e ações ruidosas, lê o contexto multimodal incluindo as consultas e produz ações contínuas. O lado direito explica a supervisão de professores para as consultas.
Suplemento de implementação: A versão lançada usa um backbone visão-linguagem Qwen3-VL-4B e um especialista de ação com arquitetura Qwen2. Estados e ações têm projeções separadas, e a geração de ações também recebe codificação de tempo de ruído. A atenção troca informações de condicionamento entre os ramos. A formulação de correspondência de fluxo e o padrão de 50 passos abaixo vêm do código fixado, em vez de uma receita completa de treinamento na Seção 4.
MoE: Cada Token Seleciona Alguns Especialistas
Uma camada de Mixture-of-Experts (MoE) substitui uma rede feed-forward (FFN) dentro do Transformer especialista de ação por um especialista compartilhado e um conjunto de especialistas roteados. O especialista compartilhado lida com padrões reutilizáveis; um roteador seleciona alguns especialistas a partir dos recursos atuais de cada token, aumentando a capacidade sem calcular todos os especialistas a cada vez. A configuração lançada tem 32 especialistas roteados, ativa 4 por token e mantém um especialista compartilhado.
Omitindo os subscritos de camada e token, as Equações (2), (6) e (7) podem ser combinadas como:
é a característica interna de um token de ação, um vetor de roteamento, uma pontuação de afinidade token‑para‑especialista, e um viés de correção de roteamento para balanceamento de carga; escala o ramo roteado. O especialista compartilhado e os especialistas selecionados são MLPs. A seleção usa pontuações ajustadas por viés, enquanto os pesos de mistura usam as pontuações originais.
Exemplo didático: Simplifique para selecionar 2 de 3 especialistas. Pontuações originais [0.8, 0.6, 0.2] e vieses [−0.4, 0, 0.3] geram pontuações de seleção [0.4, 0.6, 0.5], escolhendo os especialistas 2 e 3. Seus pesos de mistura são 0.6/0.8=0.75 e 0.2/0.8=0.25. Isso aumenta as chances de seleção de especialistas menos usados, preservando ao mesmo tempo suas forças de correspondência originais.
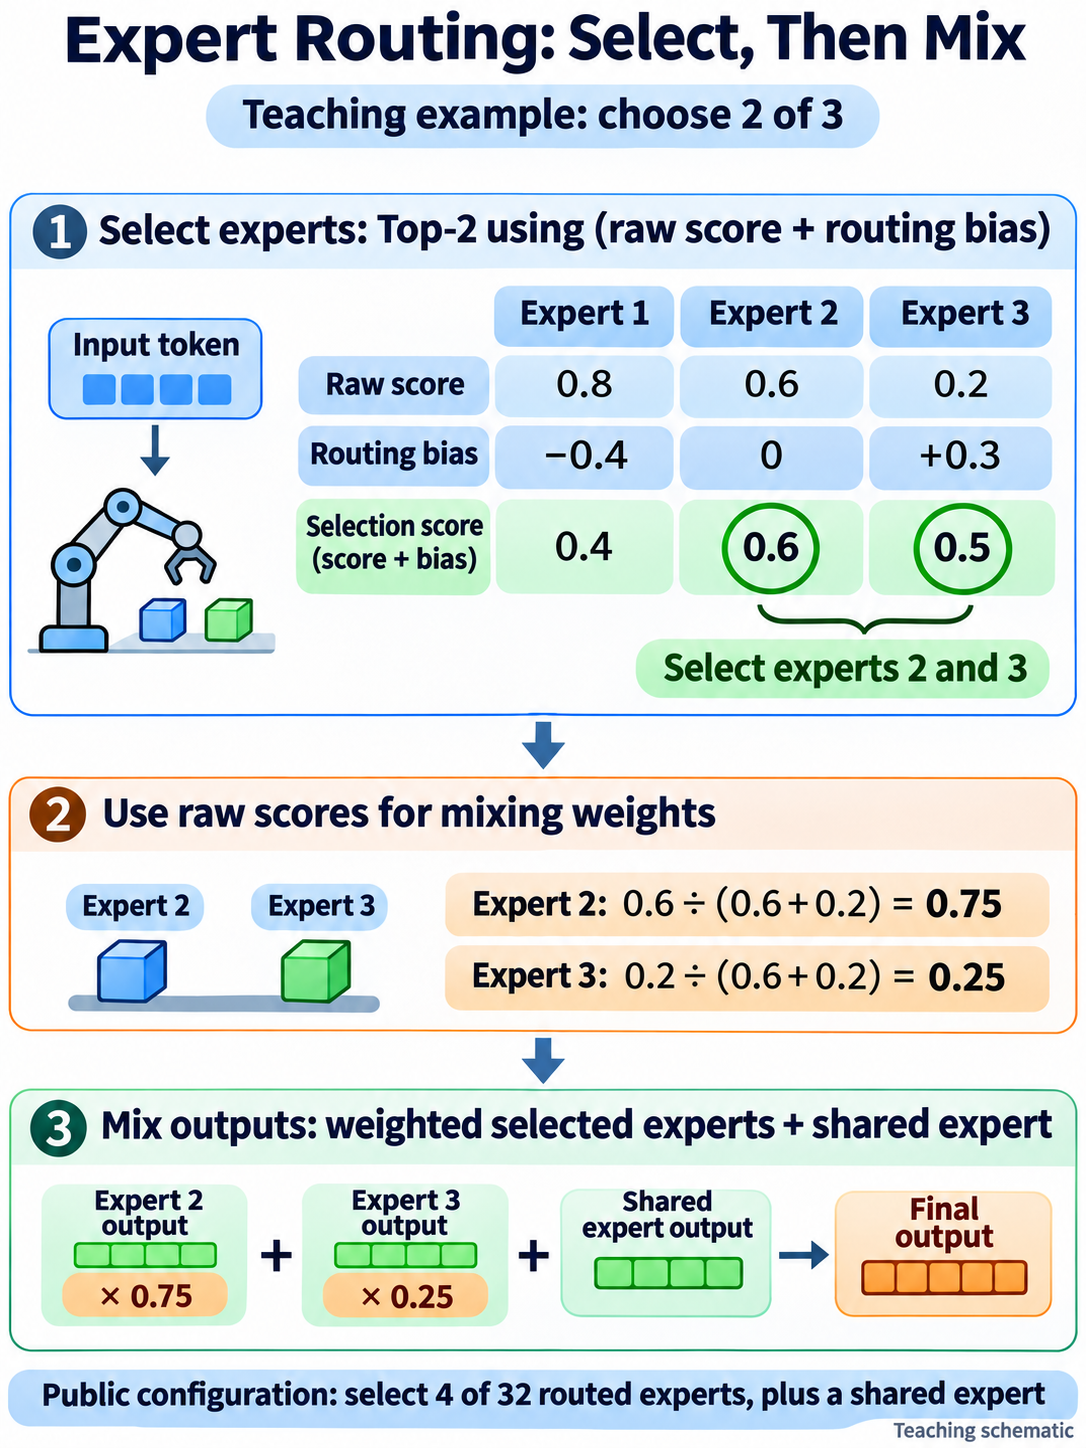
Ilustração didática: siga seleção, ponderação e mesclagem de cima para baixo. Selecionar 2 de 3 especialistas e definir a escala do ramo roteado como 1 são simplificações didáticas. O especialista compartilhado tem um caminho separado; a configuração disponibilizada ainda seleciona 4 de 32.
O pré-treinamento do artigo usa balanceamento de carga sem perda auxiliar: diminui o viés de um especialista quando sua carga excede a média e o aumenta quando está abaixo (Equação 8). “Sem perda” refere-se apenas ao balanceamento de carga, não à ausência de uma perda de ação. A configuração de pós-treinamento disponibilizada adicionalmente ativa a perda de balanceamento de sequência e a router z-loss, e deve ser diferenciada do mecanismo de pré-treinamento do artigo.
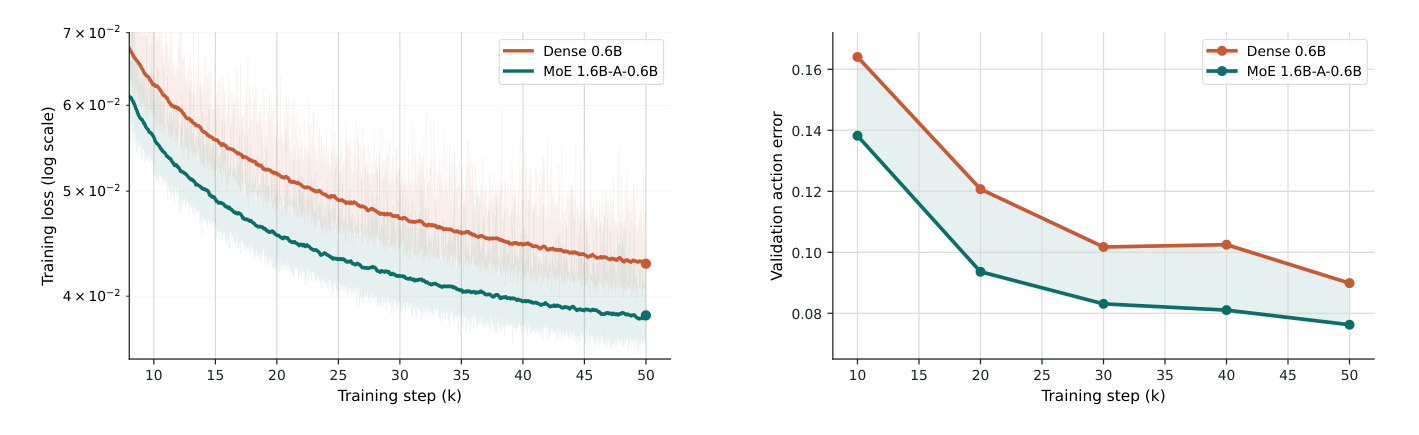
A Figura 7 compara um modelo denso 0.6B com um MoE tendo 1.6B no total e 0.6B parâmetros ativos. À medida que o treinamento avança, o MoE apresenta menor perda de treinamento e menor erro de ação GM-100 de validação. Isso apoia a alocação esparsa de capacidade. O eixo horizontal são passos de treinamento, não latência de inferência medida, e 0.6B não descreve o modelo completo.
Destilação de Consulta Dupla: Representações Futuras como Condições de Ação
Um token de consulta é um token interno aprendível. Após o processamento pelo modelo visão‑linguagem, seu estado de consulta contextualizado carrega informações que o modelo extrai ou prediz. As consultas formam grupos atual e futuro, e ; isso não significa que haja apenas dois tokens na implementação. Os grupos aprendem, respectivamente, o estado atual e o possível estado após o horizonte de ação.
Os professores se complementam: LingBot-Depth, o professor de profundidade, fornece supervisão geométrica, enquanto DINO-Video, o professor de vídeo causal, fornece representações visuais sensíveis ao movimento. O aluno vê observações e instruções atuais; durante o treinamento, os professores também podem ver imagens futuras para fornecer alvos. Imagens futuras não são entradas do aluno na inferência.
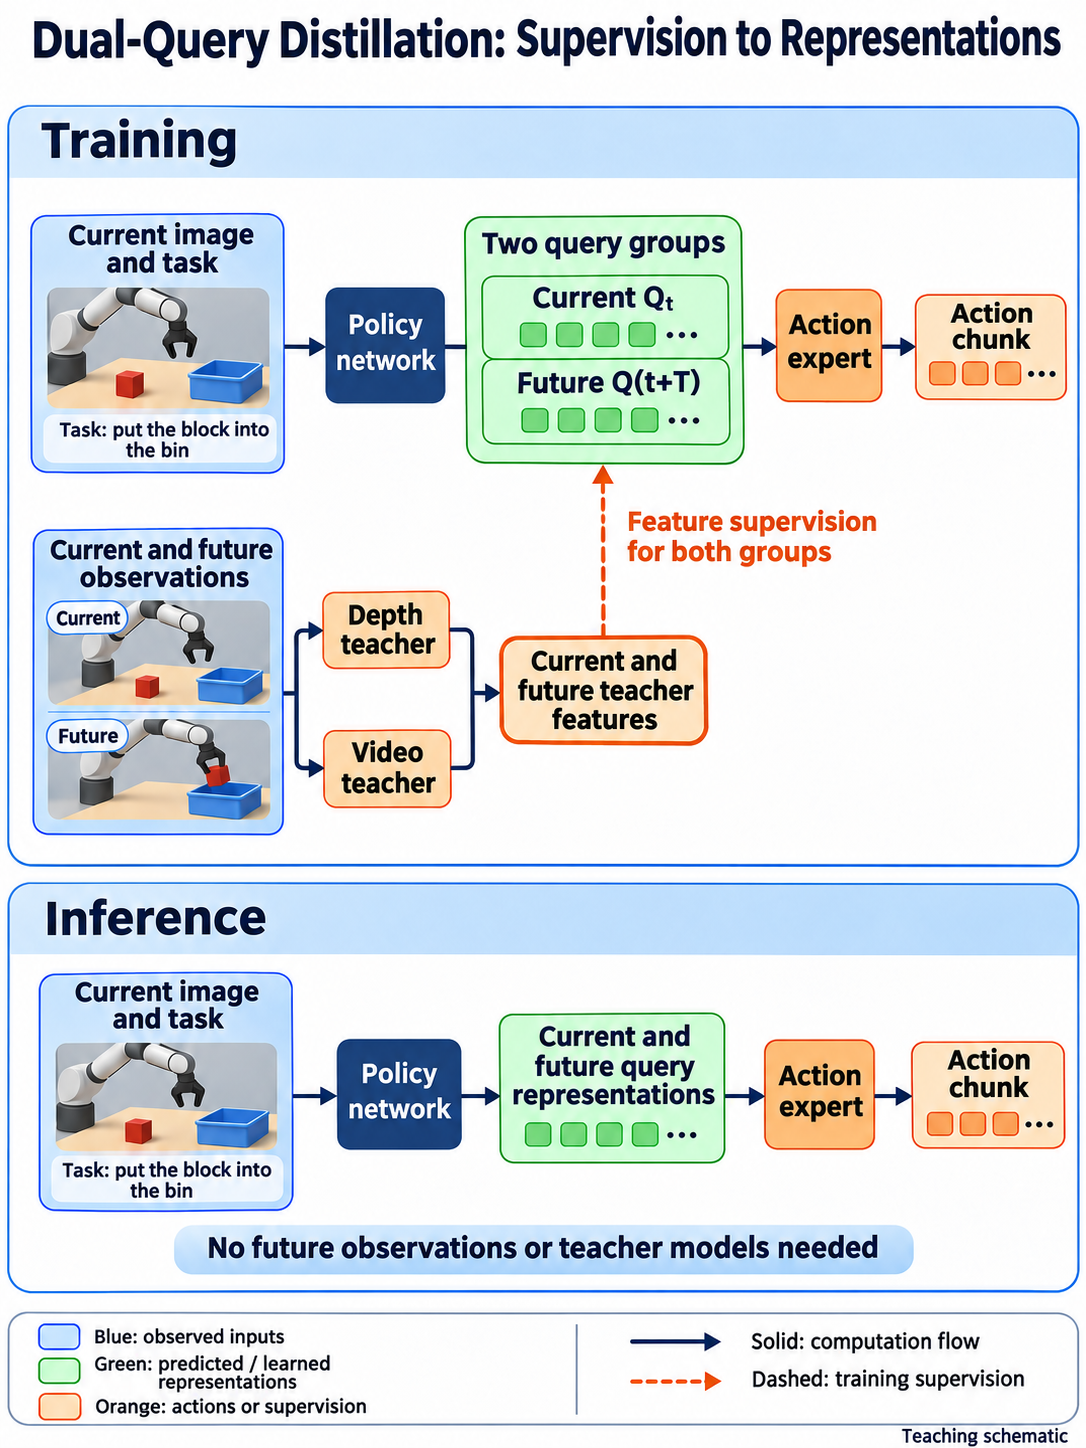
Ilustração didática: a grande caixa verde contém os grupos de consulta atual e futuro. Durante o treinamento, os professores de profundidade e vídeo fornecem conjuntamente alvos para ambos os tempos. As linhas tracejadas laranja denotam alinhamento de características; projeções e perdas são detalhadas abaixo. A inferência segue apenas o caminho sólido na linha inferior.
As Equações (9) e (10) alinham tanto as representações atuais quanto as futuras. Com , elas podem ser escritas de forma equivalente como:
e são características de profundidade e vídeo dos professores. Módulos de projeção remodelam as consultas do aluno para corresponder às características dos professores; a projeção de profundidade inclui cross‑attention. O primeiro termo soma erros absolutos, o segundo erros quadráticos. Cálculo didático: Para predição simplificada [0.2,0.7] e alvo [0.3,0.5], L1 é 0.1+0.2=0.3 e o erro quadrático somado é 0.01+0.04=0.05, antes da agregação entre alvos atuais/futuros e amostras. As características reais têm dimensionalidade muito maior; reduções, pesos e termos adicionais de alinhamento seguem a configuração do código.
DINO-Video parte de DINOv3, adiciona atenção temporalmente causal e embeddings posicionais rotatórios 3D, e é treinado em 5 milhões de clipes de vídeo com 16 quadros amostrados por exemplo (Seção 4.2). As características do quadro atual dependem apenas de quadros atuais e passados; características futuras usam quadros até aquele tempo futuro. Os 16 quadros são uma configuração de amostragem do pré-treinamento do professor, não uma exigência de 16 quadros de entrada na inferência do robô.
Após a supervisão, as consultas permanecem como contexto para os especialistas de ação. Aprender geometria e mudanças futuras pode, portanto, afetar a geração de ações. Isso não exige produzir uma imagem futura completa antes do planejamento, e o artigo não define um planejador que busque explicitamente múltiplos futuros.
Flow Matching: Transformar um Bloco de Ação Ruidoso em uma Trajetória Executável
Flow matching treina uma rede para prever direções de atualização para geração contínua de ações. Seguindo a direção temporal no código fixado pelos autores, seja um bloco de ação demonstrado, ruído Gaussiano de mesma forma e o tempo de ruído:
Condicionado em imagens atuais, linguagem, estado, consultas e , o modelo prediz e o alinha com usando L1 ou L2. Velocidade aqui significa uma direção de geração no espaço de ações, não velocidade física da base; também difere do tempo de execução do robô . A inferência começa a partir de ruído em e diminui usando atualizações de Euler:
Exemplo didático: Para um alvo de ação normalizado 0.2 e ruído 1.0, a direção ideal é 1.0−0.2=0.8. Com N=10, o primeiro passo dá 1.0−0.1×0.8=0.92; dez passos chegam a 0.2 nesse caminho ideal unidimensional em linha reta. O modelo real reestima a direção a cada passo e gera todo o bloco 50 × 55 de uma vez. 10 atualizações de geração e 50 pontos de tempo de ação são quantidades diferentes.
Conectando o Treinamento ao Uso Prático
| Estágio | Informações disponíveis e aprendizado | Saída ou uso |
|---|---|---|
| Preparação dos professores | Modelo de profundidade fornece geometria; DINO-Video aprende características temporais por auto‑destilação em vídeo | Professores congelados durante o treinamento VLA |
| Pré-treinamento VLA | Trajetórias filtradas de robô/humano, linguagem, imagens atuais e alvos futuros dos professores | Condicionamento compartilhado imagem‑texto, modelagem de ação e representações atual/futura |
| Pós-treinamento downstream | Estados/ações da plataforma‑alvo, mapeamentos de câmera e demonstrações de tarefa | Política da tarefa‑alvo e estatísticas de normalização |
| Inferência e execução | Imagens atuais, instrução, estado atual e novo ruído amostrado | Gerar blocos, desnormalizar, remapear e enviar para a interface de controle do robô |
Imagens futuras e professores fornecem supervisão adicional apenas durante o treinamento. A inferência mantém consultas aprendidas sem executar os professores. LeRobot obtém supervisão futura do último quadro do bloco de ação, usando o deslocamento de índice chunk_size−1; o artigo expressa o horizonte como . Estes são, respectivamente, um horizonte conceitual e um índice de código, e não devem introduzir mecanicamente um quadro extra.
O artigo não fornece hiperparâmetros completos de pré-treinamento ou cronogramas de execução para todas as plataformas. Exemplos de treinamento no código disponibilizado são receitas de pós-treinamento. Contagem de GPUs de pré-treinamento, duração e o escopo completo de congelamento permanecem não revelados. Comprimento do bloco, passos executados e cadência de observação dependem do checkpoint e da estratégia de controle.
Experimentos: Onde a Melhora Aparece e o que Continua Difícil
Manipulação Bimanual: Médias Melhores, Resultados de Tarefa Desiguais
O artigo seleciona 9 tarefas do GM-100 e treina conjuntamente uma política por embodiment. Ele não avalia todo o GM-100 nem usa a mesma política pós-treinada em ambos os robôs. A Tabela 5 relata tanto a pontuação de progresso quanto a taxa de sucesso. Progresso dá crédito parcial por etapas concluídas; sucesso exige completar toda a tarefa.
| Plataforma | GR00T N1.7 | π0.5 | LingBot-VLA 1.0 | LingBot-VLA 2.0 |
|---|---|---|---|---|
| AgileX Cobot Magic | 36.3 / 17.8 | 59.1 / 32.2 | 58.2 / 30.0 | 66.2 / 34.4 |
| Galaxea R1 Pro | 16.4 / 5.6 | 27.4 / 8.9 | 32.7 / 15.6 | 34.6 / 15.6 |
Os valores são pontuação de progresso / taxa de sucesso (%) em média sobre nove tarefas. No Cobot Magic, a versão 2.0 ganha 8.0 / 4.4 pontos percentuais sobre a 1.0. No Galaxea, o progresso melhora enquanto o sucesso permanece em 15.6%. Esta seção não fornece explicitamente contagens de tentativas por tarefa nem intervalos de confiança, portanto margens pequenas não podem ser chamadas diretamente de estatisticamente significativas.
Resultados em nível de tarefa mostram os limites com mais clareza. Cobot Magic atinge 100 / 100 para pegar um chaveiro, mas apenas 56.8 / 0 para ordenar blocos, em comparação com 90.4 / 60 da π0.5. A recuperação de tigela de micro-ondas do Galaxea cai de 97.5 / 100 da versão 1.0 para 65 / 30. Ancoragem visual, preensão e conclusão precisa mantêm gargalos diferentes; uma média melhor não significa que toda tarefa melhora.
Manipulação Móvel de Longo Horizonte: Ganhos Relativos com Degradação OOD Substancial
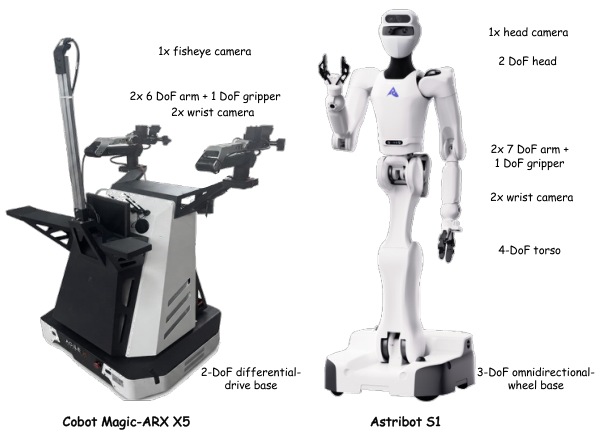
A Figura 9 mostra diferentes combinações de bases, torsos, braços e câmeras. As tarefas móveis, portanto, testam a coordenação do corpo e a conclusão em múltiplas etapas: a organização da geladeira tem 11 subtarefas e a limpeza do fogão 7. Cada modelo recebe 15 tentativas independentes por par tarefa-configuração (Seção 5.3, Tabelas 6–7).
| Plataforma e tarefa | Configuração | LingBot-VLA 2.0 | π0.5 |
|---|---|---|---|
| Astribot S1: Organizar objetos na geladeira | In-domain (ID) | 77.1 / 60.0 | 65.3 / 46.7 |
| Astribot S1: Organizar objetos na geladeira | Out-of-distribution (OOD) | 37.0 / 13.3 | 30.3 / 6.7 |
| Cobot Magic-ARX X5: limpeza do fogão | ID | 84.3 / 66.7 | 79.9 / 60.0 |
| Cobot Magic-ARX X5: limpeza do fogão | OOD | 67.5 / 40.0 | 62.5 / 33.3 |
Os valores continuam sendo pontuação de progresso / taxa de sucesso (%). OOD perturba a posição inicial do robô em aproximadamente ±10 cm para frente, para trás, para a esquerda e para a direita em relação às posições nominais. As tarefas de geladeira também substituem categorias de frutas e garrafas de água não vistas; as tarefas de fogão não usam a mesma substituição de objetos. Portanto, as duas dificuldades OOD não são diretamente equivalentes.
Embora 2.0 supere π0.5 em todas as quatro condições, o sucesso na geladeira cai de 60,0% em ID para 13,3% em OOD, aproximadamente 9/15 → 2/15. Uma tentativa corresponde a cerca de 6,7 pontos percentuais. Isso sustenta a melhoria relativa nas condições testadas, ao mesmo tempo em que mostra que a conclusão de longo horizonte e a generalização continuam limitadas.
Ablations: Alvos, Espaços de Ação e Normalização Importam
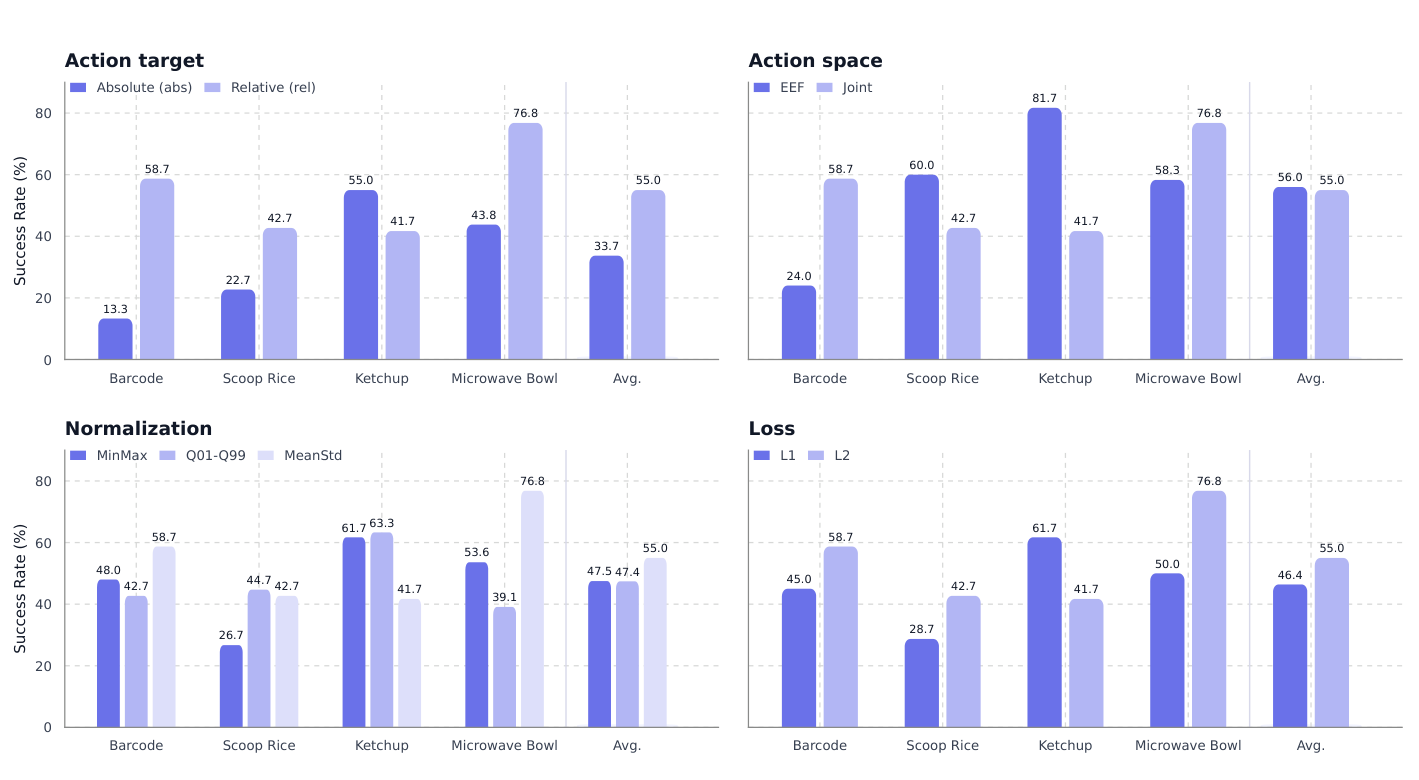
A Figura 10 abrange leitura de código de barras, servir arroz com colher, espremer ketchup e recuperar uma tigela do micro-ondas. O Avg. mais à direita de cada grupo é o sucesso médio nessas quatro tarefas, distinto da média de nove tarefas da Tabela 5 (Seção 6.1).
- Alvos relativos / absolutos de juntas: Alvos relativos têm média de 55,0%, contra 33,7% para alvos absolutos. Os autores sugerem que mudanças de movimento local são mais concentradas e têm menor variância, tornando-as mais fáceis de aprender. Na implementação atual, ações relativas referenciam o estado atual, em vez de usar diferenças passo a passo entre ações futuras adjacentes.
- Espaço do efetuador final (EEF) / espaço de juntas: As médias são 56,0% e 55,0%, mas as preferências por tarefa diferem substancialmente. Espremer ketchup atinge 81,7% no espaço do efetuador final contra 41,7% no espaço de juntas; a leitura de código de barras dá 24,0% contra 58,7%. Nenhum espaço de ação vence em todas as tarefas.
- Normalização: MeanStd atinge 55,0%, MinMax 47,5% e Q01–Q99 47,4%. Os autores relacionam as diferenças ao intervalo dinâmico efetivo das distribuições de alvos. Essa configuração Q01–Q99 não recorta valores, portanto as falhas não podem ser explicadas como recorte removendo ações grandes.
- Loss: L2 atinge 55,0% e L1 46,4%, embora L1 seja melhor para espremer ketchup. Os padrões atuais do LeRobot e o exemplo oficial de pós-treinamento do RoboTwin usam
L1_fm, sob configurações diferentes desta ablação de hardware de quatro tarefas.
Essas ablações mostram que a representação de ações, a normalização e a loss afetam as tarefas de maneiras diferentes. Além da arquitetura do modelo, a definição dos valores de controle é uma condição importante para o desempenho.
O Que as Evidências de Predição do Futuro Sustentam
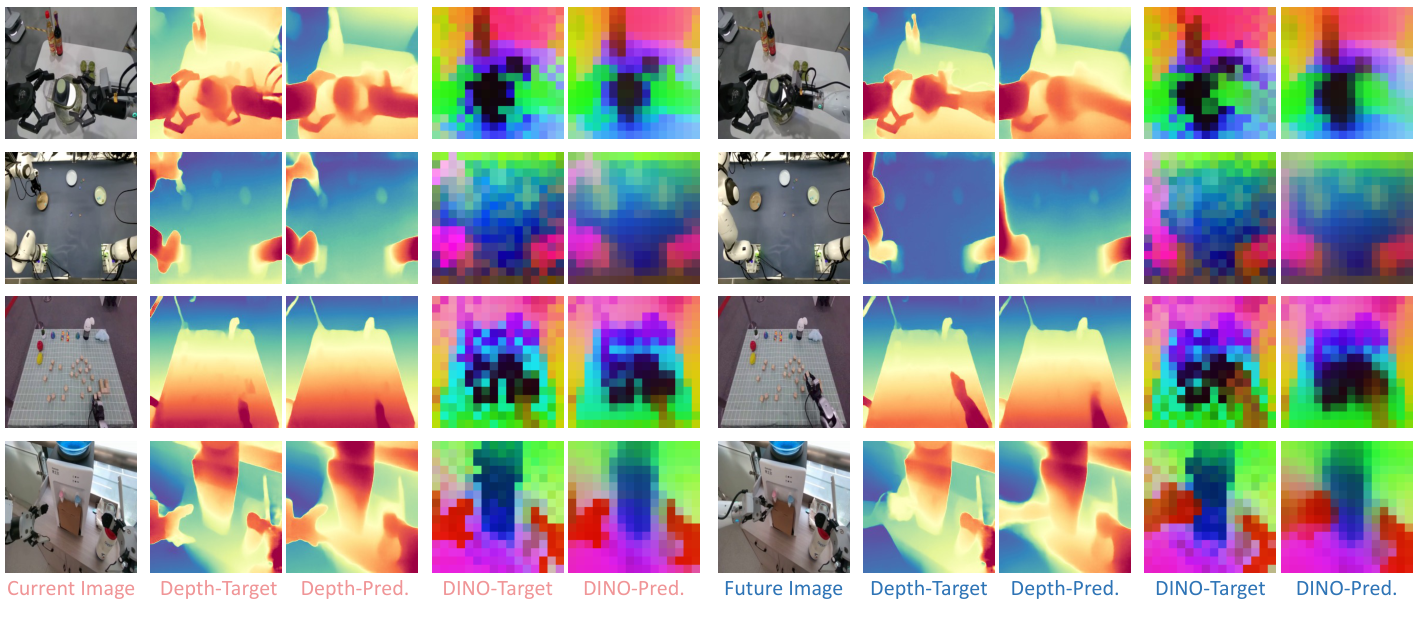
A metade esquerda da Figura 13 compara features do professor e predições para imagens atuais; a metade direita mostra resultados de imagens futuras. Saídas DINO coloridas visualizam o PCA das features. Formas e distribuições espaciais semelhantes sugerem pistas geométricas e temporais aprendidas. As cores não são valores físicos de profundidade nem vídeo RGB gerado.
A Tabela 3 avalia separadamente o professor. DINO-Video lidera em três das quatro métricas do LARYBench, mas obtém 80,21 no benchmark de classificação Composite Human, ligeiramente abaixo dos 80,35 do V-JEPA 2. A capacidade do professor e os resultados qualitativos da Figura 13 sustentam o aprendizado de representações. O artigo não remove de forma independente consultas atuais/futuras ou supervisão de profundidade/vídeo para quantificar seus benefícios de controle, portanto essas figuras sozinhas não podem estabelecer quanto de melhoria na taxa de sucesso a destilação causa.
Integração com LeRobot e os Limites dos Resultados do Artigo
O lerobot/lingbot_vla_v2_base do LeRobot oferece suporte a fine-tuning a partir do espaço canônico; lerobot/lingbot_vla_v2_robotwin é um checkpoint RoboTwin com uma interface de braço duplo de 14 dimensões. Adaptar um novo robô exige definir slots de estado/ação, nomes de câmeras, dimensões válidas e estatísticas de dados antes de fazer o mapeamento reverso das saídas.
Os 93,52% de Clean e 92,80% de Randomized na documentação do RoboTwin vêm da avaliação upstream de um checkpoint posterior lançado pelos autores: 50 tarefas, 100 episódios por tarefa, pós-treinamento conjunto em dados limpos e randomizados, e inferência em FP32. Essas tarefas e protocolos diferem dos experimentos GM-100 e de manipulação móvel acima.
O uso prático exige distinguir duas configurações. O artigo descreve roteamento sem loss auxiliar durante o pré-treinamento, enquanto os exemplos de pós-treinamento lançados adicionam termos de balanceamento. O estudo de quatro tarefas do artigo favorece alvos relativos e L2, enquanto os padrões do LeRobot desativam ações relativas e usam L1_fm. Interprete essas diferenças para o checkpoint e a tarefa-alvo; nenhum padrão é uma receita universalmente ótima derivada do artigo.
Conclusão
A conexão mais útil do LingBot-VLA 2.0 é que filtragem e reconstrução produzem trajetórias confiáveis, slots canônicos conectam corpos heterogêneos, especialistas esparsos acomodam padrões compartilhados e diferenças, e consultas atuais/futuras trazem supervisão de percepção para a geração de ações. Isso move as capacidades de modelos de fundação em direção a uma interface de controle de robôs mais completa.
Resultados de hardware sustentam melhoria média do sistema geral nas condições testadas, ao mesmo tempo em que mantêm baixo sucesso em tarefas completas, regressões em algumas tarefas e degradação substancial em OOD. Representações unificadas não tornam encarnações arbitrárias plug-and-play, e features futuras semelhantes não estabelecem planejamento geral confiável. A eficácia ainda depende do alinhamento de dados, das definições de ação e da avaliação da tarefa-alvo.