LBM e MultiTask DiT: Como o pré-treinamento multitarefa ajuda robôs a aprender
Um exame cuidadoso de Large Behavior Models para manipulação hábil multitarefa
- Diffusion Transformer
- Pré-treinamento multitarefa
- Eficiência de dados
- Avaliação rigorosa
Demonstrações de múltiplas tarefas podem ajudar robôs a aprender novas tarefas com menos dados e lidar com mudanças no ambiente? Este artigo mantém a arquitetura da política fixa e usa experimentos controlados para medir os benefícios do pré-treinamento.
O artigo LBM da TRI estuda o pré-treinamento multitarefa com um objetivo de diffusion. O LeRobot MultiTask DiT é uma implementação open-source inspirada por essa abordagem e também oferece suporte a flow matching. O blog do Atlas da Boston Dynamics descreve uma aplicação para controle de corpo inteiro. Suas plataformas, conjuntos de dados e receitas de treinamento diferem; tamanhos de modelo, espaços de ação e resultados devem ser interpretados dentro de cada fonte.
Pré-requisitos: de demonstrações a blocos de ação
Treinamento e inferência
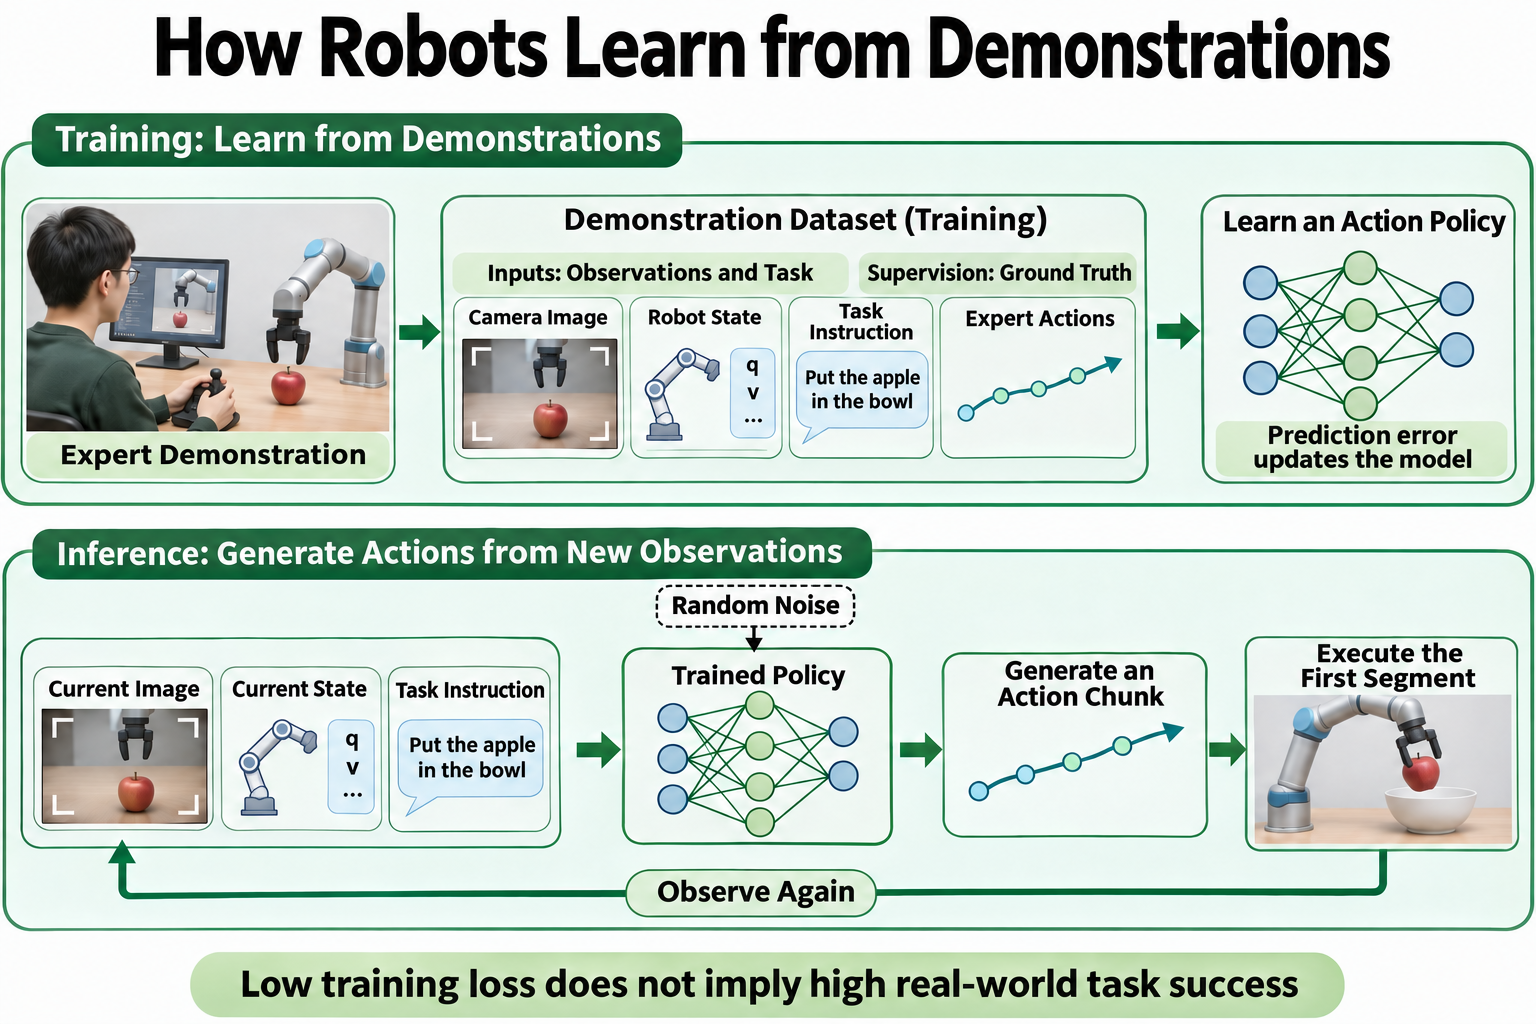
Ilustração de ensino baseada no artigo e na implementação do LeRobot. O exemplo explica o fluxo de trabalho de aprendizado.
Behavior cloning usa ações de especialistas como supervisão para aprender ações condicionadas a imagens, estado proprioceptivo e instruções de tarefa. O treinamento fornece ações futuras de especialistas; a inferência gera um bloco de ação a partir de observações e de uma instrução.
Um Large Behavior Model (LBM) aqui é uma política visuomotora treinada em demonstrações multitarefa. Codificadores de imagem e texto de Contrastive Language–Image Pre-training (CLIP) convertem imagens e instruções em recursos de condicionamento, permitindo que a linguagem de tarefa guie a geração de ações.
Blocos de ação e modelos generativos
Agrupamento de ações (action chunking) prevê vários passos de controle em conjunto. Após executar um segmento, a política observa novamente e prevê outro bloco. Por padrão, o LeRobot gera um novo bloco quando sua fila de ações está vazia, executando o segmento enfileirado em malha aberta. Isso difere das previsões sobrepostas e do ensemble temporal do ACT. Veja Janela de ação e segmento de execução.
Uma cena pode admitir várias trajetórias válidas, cuja média pode ser inadequada. O modelo generativo de diffusion aprende uma distribuição condicional sobre trajetórias, gerando ações a partir de ruído aleatório sob condicionamento de observação.
O tempo de diffusion descreve o progresso da remoção de ruído, não o movimento físico do robô. Abaixo, denota o tempo físico e um passo discreto de remoção de ruído.
Resumo: o valor do pré-treinamento
Resumo do abstract
Aprendizado por imitação pode resolver tarefas complexas de manipulação, mas os benefícios práticos de grandes modelos de robôs ainda são difíceis de avaliar de forma confiável. Os autores estendem Diffusion Policy para dados multitarefa e o comparam com políticas de tarefa única usando seeds aleatórios combinados e pontuação automatizada em simulação, e testes cegos com ordem de políticas randomizada no mundo real.
O pré-treinamento multitarefa seguido de fine-tuning melhora o sucesso e a robustez enquanto reduz as demonstrações necessárias para novas tarefas. Dentro dos cenários avaliados, conjuntos de pré-treinamento maiores e mais diversos geralmente trazem benefícios maiores.
Comentários
- Uma arquitetura central fixa ajuda a separar os benefícios do pré-treinamento dos efeitos do tamanho do modelo.
- As conclusões sobre eficiência de dados dizem respeito ao fine-tuning específico de tarefa, em vez de aprendizado zero-shot.
- Condições iniciais, ordem dos testes e pontuação são controladas, com análise estatística dos resultados.
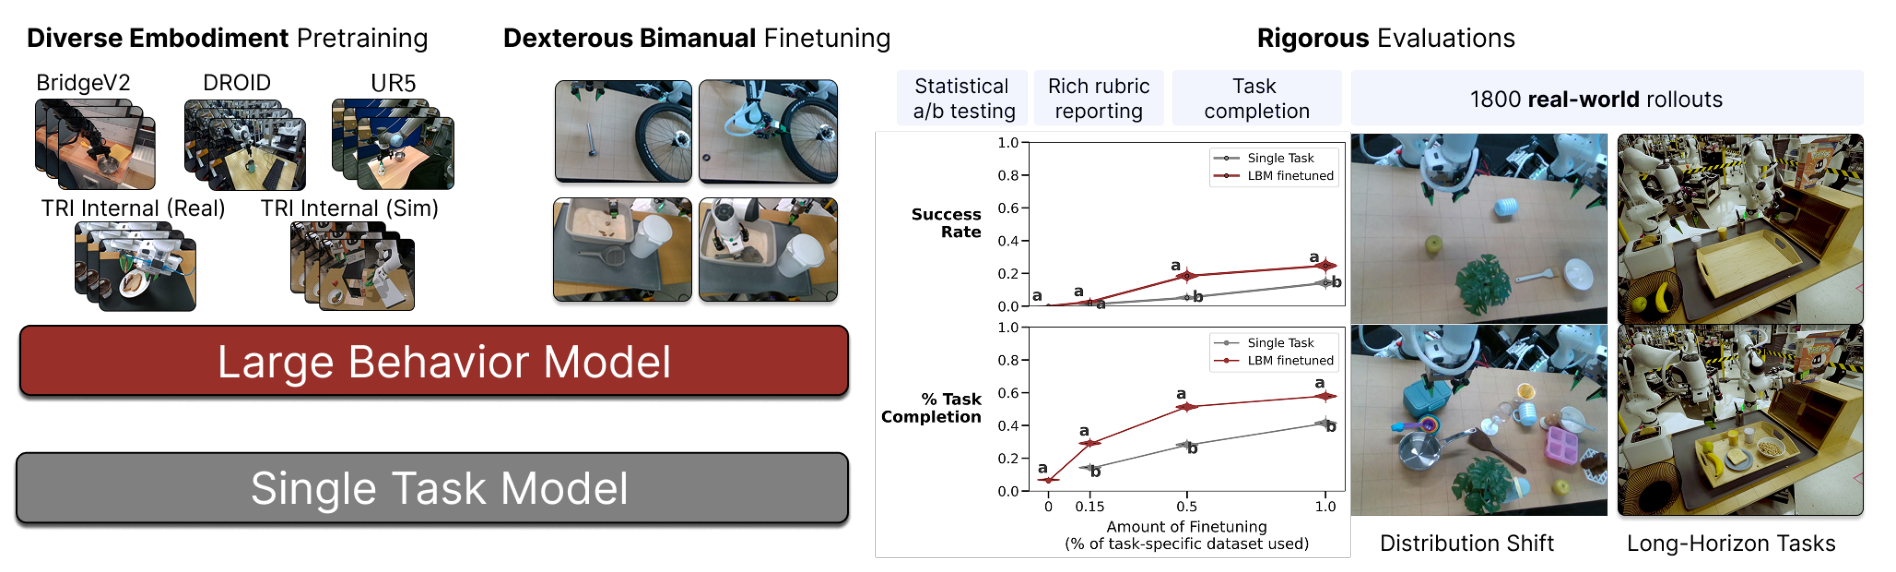
Figura 1 original (PDF p. 2). Esquerda: pré-treinamento seguido de fine-tuning versus treinamento de tarefa única. Direita: testes no mundo real e comparações estatísticas.
Introdução e trabalhos relacionados
Os três parágrafos da introdução
Parágrafo 1: A lacuna entre capacidades de hardware e autonomia motiva o aprendizado a partir de demonstrações. O hardware de robôs suporta comportamentos diversos, mas a autonomia confiável muitas vezes permanece limitada a tarefas simples ou ambientes estruturados. Behavior cloning substitui programação específica de tarefa por demonstrações. Seu progresso em manipulação rica em contato, objetos deformáveis e coordenação bimanual motiva o estudo de manipulação de uso geral.
Parágrafo 2: Políticas frágeis de tarefa única levantam uma questão sobre pré-treinamento. Behavior cloning de tarefa única tem dificuldades fora de sua distribuição de treinamento. LBMs usam demonstrações multitarefa para ampliar a experiência, mas quanta parte de seu sucesso observado vem do pré-treinamento multitarefa ainda não está clara. Essa questão motiva uma avaliação controlada.
Parágrafo 3: Os autores estabelecem a escala experimental e apresentam três conclusões. Os modelos são treinados em aproximadamente 1.700 horas de demonstrações e avaliados em simulação e em cerca de 1.800 testes controlados no mundo real. As três conclusões são: o fine-tuning requer menos demonstrações da tarefa-alvo para atingir desempenho comparável; com a mesma quantidade de dados da tarefa-alvo, modelos ajustados por fine-tuning têm desempenho melhor quando agregados entre tarefas; e esses benefícios aumentam quando as condições de implantação diferem do treinamento. As seções seguintes examinam as evidências e seu escopo.
Trabalhos relacionados
| Área | Trabalhos anteriores | Foco deste artigo |
|---|---|---|
| Políticas generalistas de robôs e VLAs | Estender capacidades por meio de dados multitarefa, representações pré-treinadas e geração de ações | Quantificar benefícios do pré-treinamento com uma arquitetura fixa |
| Conjuntos de dados em larga escala para robôs | Expandir dados por teleoperação, conjuntos públicos, simulação e dispositivos portáteis | Padronizar observações e ações; estudar escala e diversidade de dados |
| Avaliação de robôs | Benchmarks em simulação, conjuntos físicos de objetos, robôs remotos e métricas de sucesso | Comparar políticas usando testes cegos, ordem randomizada, reinicialização de cenas e pontuação por marcos |
O artigo não fornece uma comparação sistemática entre arquiteturas VLA nem estabelece que DiT sempre supera VLAs.
Método central: Diffusion Transformer condicional
Arquitetura
Intuição: Imagens localizam objetos, instruções especificam a tarefa e propriocepção descreve a configuração atual do robô. A rede codifica esse contexto e refina iterativamente um bloco de ação ruidoso em uma trajetória adequada à cena.
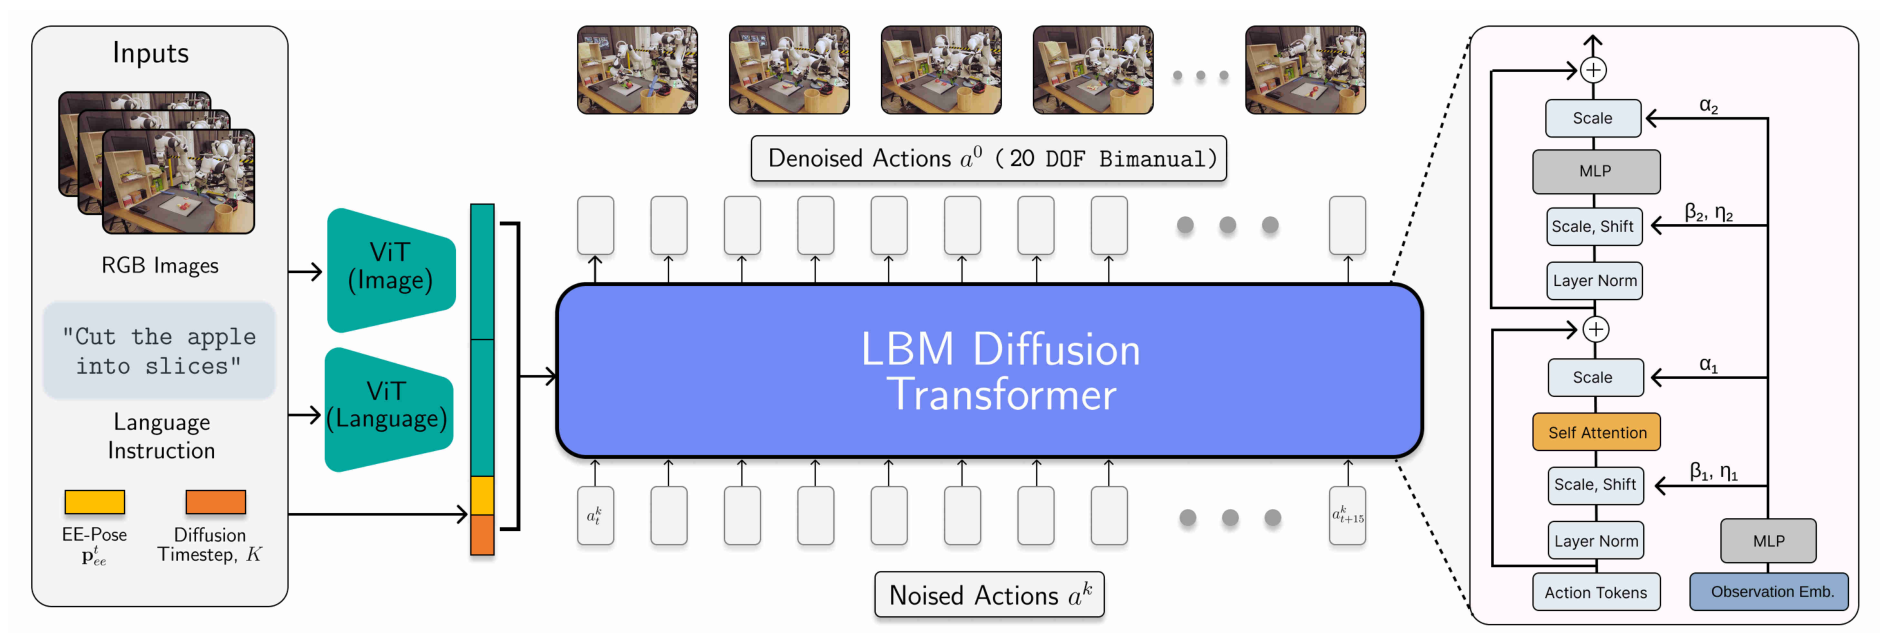
Figura 9 original (PDF p. 12). Codificação de observação à esquerda, remoção de ruído da ação no centro e módulos de condicionamento Transformer à direita.
O codificador de visão resume cada imagem com seu token de classificação (CLS). Seus pesos são atualizados durante o treinamento e compartilhados entre câmeras. O codificador de texto produz uma representação de instrução de comprimento fixo; seu backbone é congelado, enquanto a projeção subsequente é treinável. O Diffusion Transformer (DiT) aplica self-attention ao longo da sequência de ações e prevê o ruído para todo o bloco. Tokens aqui são unidades de recurso e podem ser vetores contínuos.
Dimensões de observação e ação
O artigo usa dois quadros de observação com até seis visões RGB, preenchendo com zeros as câmeras ausentes. Propriocepção inclui poses do efetuador final em relação à base e ao outro efetuador final, além das larguras das garras, em vez de um vetor de ângulos de junta.
As trajetórias de ação são representadas em relação à observação atual (Seções IV-D1 e IV-D2 do artigo). A ação de cada mão contém três componentes de translação, uma representação de rotação de seis dimensões e um valor de abertura do gripper. A dimensão de ação bimanual é, portanto:
é a dimensão de ação por passo de controle. A rede produz 16 passos, gerando uma amostra com 320 valores. A representação de rotação 6D usa as duas primeiras linhas de uma matriz de rotação; ela não denota seis juntas rotacionais. Essas saídas de 20 dimensões não podem acionar diretamente um controlador de juntas de um único braço.
O artigo concatena 6.732 características de observação ao longo dos dois quadros e usa oito blocos DiT com dimensão oculta 768. O LeRobot calcula a dimensão de condicionamento a partir de sua contagem de câmeras, dimensão de estado e configuração.
Treinamento por Difusão: Predizendo Ruído
Seja um bloco de ações limpo e o contexto visual, de linguagem e de estado. O treinamento amostra um nível de ruído e ruído Gaussiano . A formulação padrão de denoising diffusion probabilistic model (DDPM) abaixo explica o objetivo: misturar ações com ruído de acordo com o nível de ruído e então predizer o ruído adicionado.
Aqui, é o comprimento do bloco, a dimensão de ação, o fator cumulativo de retenção de sinal no agendamento de ruído, e a predição de ruído do DiT. A esperança cobre amostras, ruído e níveis de denoising. A Equação (2) do artigo fornece a perda de predição de ruído e escreve a adição de ruído como . Aqui, a formulação DDPM padrão explica o caminho add_noise do LeRobot; ela não é uma expansão termo a termo da expressão do artigo.
Exemplo ilustrativo: Para um valor de ação normalizado de , e ruído , a entrada ruidosa é . A rede recebe e o contexto de observação; seu alvo é o ruído . Este exemplo escalar ilustra um elemento; o modelo prediz o ruído para todo o bloco conjuntamente.
Como o DiT Usa o Condicionamento por Observação
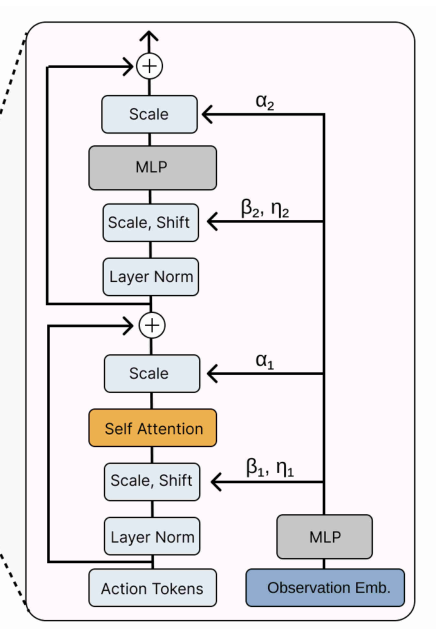
Vetores de ação projetados formam uma sequência de tokens. A autoatenção conecta passos de controle, enquanto a normalização de camada adaptativa (adaLN) condiciona características de ação gerando escalas e deslocamentos por característica a partir da cena e da tarefa. Essa modulação pode ser escrita como:
denota características de ação ocultas; combina condicionamento de visão, texto, estado e passo de denoising. é normalização de camada, e são o ajuste de escala previsto e o deslocamento, e denota multiplicação elemento a elemento. Esses parâmetros são difundidos ao longo da sequência de ações, enquanto a atenção modela relações entre ações. O LeRobot também prediz portas para os ramos residuais de atenção e multilayer perceptron (MLP).
Exemplo ilustrativo: Uma característica normalizada de , ajuste de escala de e deslocamento de produzem . Condições diferentes podem gerar escalas e deslocamentos diferentes. Estes são parâmetros internos de características, em vez de comandos enviados diretamente ao robô.
Arquitetura: As observações codificadas são concatenadas em um vetor de condicionamento de comprimento fixo que modula características de ação por meio de adaLN. Interpretação dos autores: O desempenho inconsistente sem fine-tuning pode refletir em parte uma orientação fraca de linguagem vinda do pequeno codificador de linguagem. O artigo não isola a compactação do condicionamento em um ablation, portanto não estabelece que a própria compactação limita as capacidades de linguagem. Detalhe da parte direita da Figura 9 original (PDF p. 12). Embeddings de condicionamento geram escalas, deslocamentos e portas para os ramos de atenção e MLP.Figura 9: módulo de condicionamento ampliado
Inferência: Denoising e Execução
Na inferência, a política codifica as observações atuais e aplica repetidamente o mesmo DiT para fazer denoising de um bloco de ações aleatório. O artigo usa amostragem de denoising diffusion implicit model (DDIM): o preditor de ruído treinado atualiza o bloco iterativamente. Após executar um prefixo selecionado, a política gera outro bloco a partir de novas observações.
Frequência de controle, comprimento do bloco e passos de amostragem são distintos. O artigo gera 16 passos de ação e replana após executar oito. Gerar um bloco requer múltiplas avaliações do DiT. O loop de política reportado de 10 Hz não implica dez novos blocos por segundo nem garante latência em outros hardwares.
Treinamento: Pré-treinamento e Fine-Tuning
Robôs e Dados de Demonstração
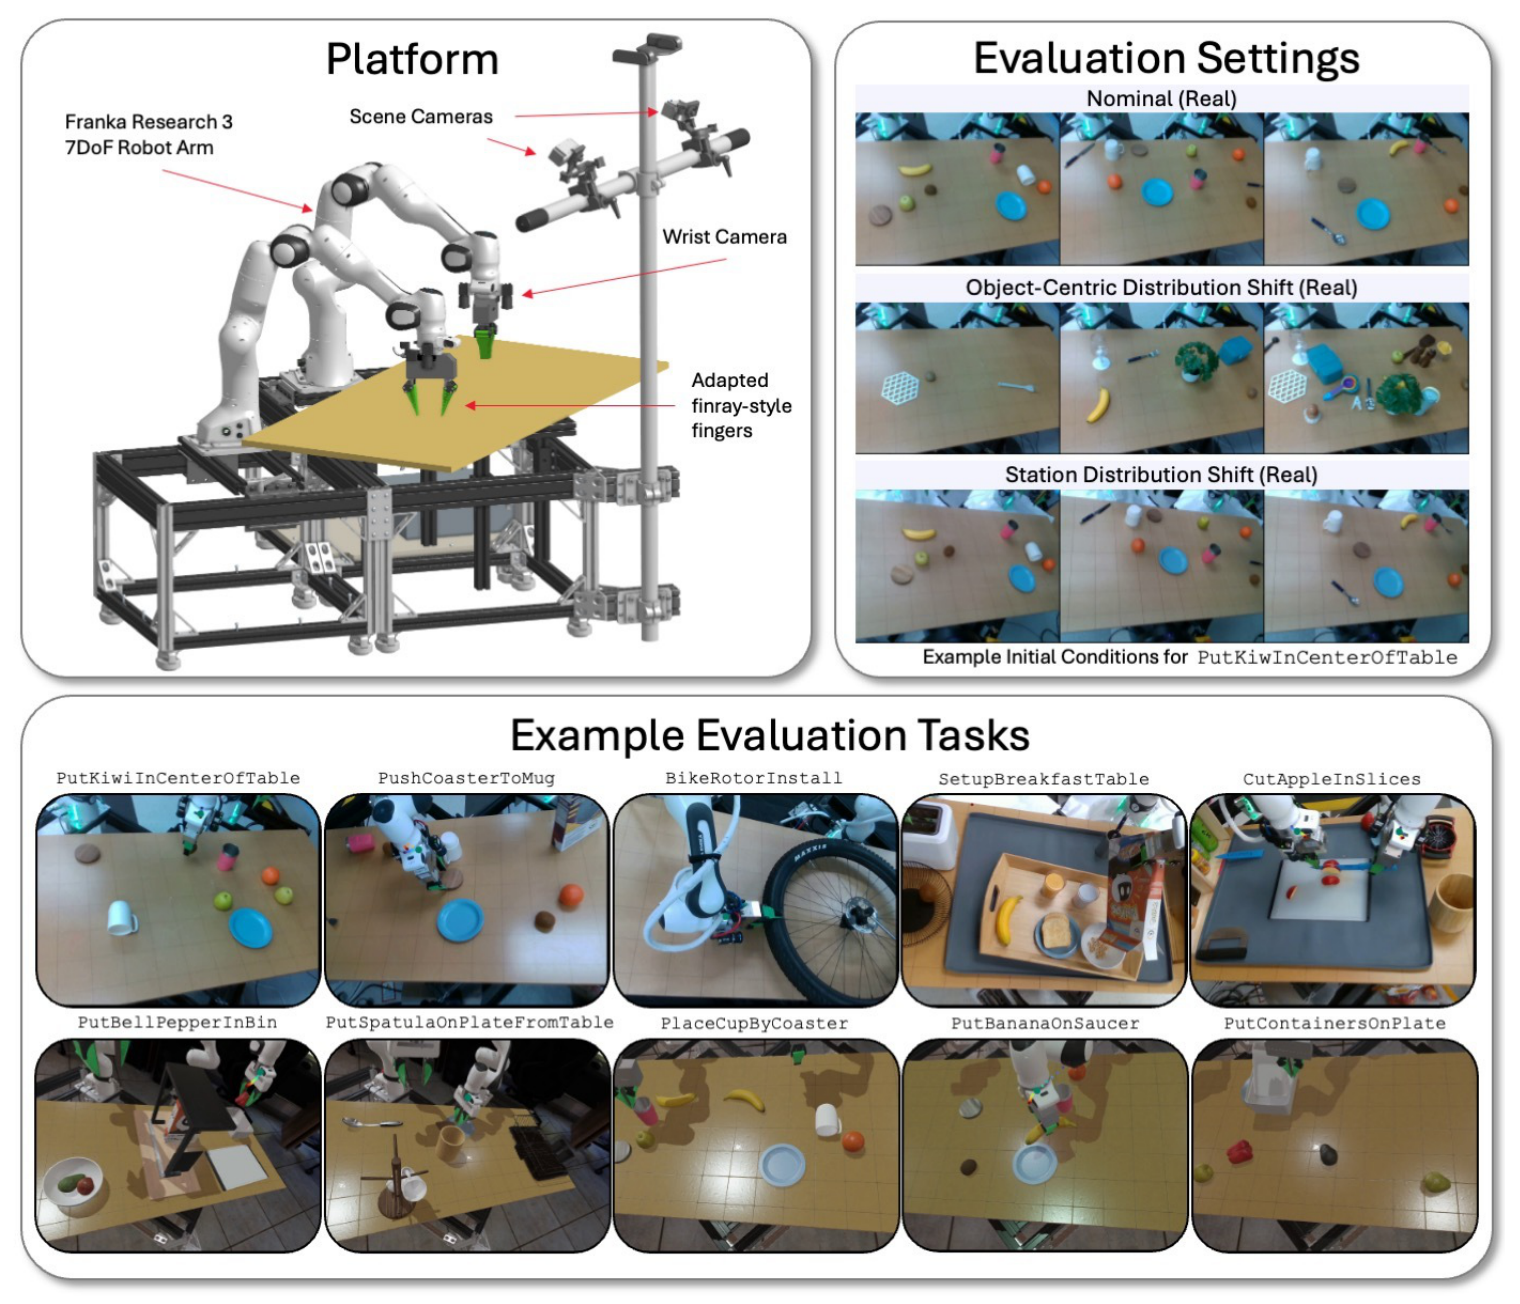
Figura 10 original (PDF p. 14). Canto superior esquerdo: braços e câmeras. Canto superior direito: mudanças ambientais. Parte inferior: tarefas de posicionamento e manipulação hábil em múltiplos passos.
O artigo usa dois braços Franka FR3 com grippers paralelos e dedos personalizados em estilo finray. A plataforma mais recente tem duas câmeras de cena e duas câmeras por punho, fornecendo seis visões RGB. Os dados abrangem gerações de hardware; a avaliação no mundo real usa a plataforma mais recente. Cinemática inversa diferencial e controle de impedância de juntas rastreiam alvos de efetuador final, com desvio de colisão tratado pelo controlador de baixo nível. O aprendizado de ponta a ponta ainda depende dessas interfaces de execução.
| Fonte de dados | Escala reportada | Papel |
|---|---|---|
| TRI-Ramen-Real | 468 horas; 362 tarefas; 46.063 demonstrações | Dados internos de robô bimanual no mundo real |
| TRI-Ramen-Sim | 45 horas; 41 tarefas; 7.348 demonstrações | Dados de simulação correspondentes à plataforma real |
| TRI-Ramen-UMI | 32 horas; 129 tarefas; 10.851 demonstrações | Manipulação coletada fora do laboratório com dispositivos portáteis |
| OXE-Ramen | Aproximadamente 1.150 horas | Subconjunto curado e padronizado de dados públicos Open X-Embodiment |
As três primeiras fontes totalizam aproximadamente 545 horas, 532 tarefas e 64.262 demonstrações. Incluindo OXE-Ramen, obtêm-se aproximadamente 1.695 horas. A contagem de 532 tarefas cobre apenas dados coletados internamente.
Alinhamento e Normalização de Dados
As fontes de dados exigem quadros de coordenadas, unidades de pose, larguras de gripper e processamento de imagem consistentes. O artigo converte dados de um único braço para um formato bimanual preenchendo com zeros o braço ausente e trocando os lados aleatoriamente. Amostragem ponderada impede que fontes maiores dominem os batches.
Ações futuras mais distantes tipicamente abrangem faixas mais amplas. O artigo calcula quantis separadamente por dimensão de característica, passo temporal relativo e fonte de dados. Ele mapeia o intervalo do 2º ao 98º percentil para e faz clipping em ; a representação de rotação 6D é excluída desse escalonamento.
Diferença do LeRobot: A versão fixada usa por padrão MIN_MAX para estados e ações e MEAN_STD para imagens. Ela não reproduz automaticamente a normalização por quantis específica de fonte e passo temporal do artigo. Tais diferenças de pré-processamento também afetam os resultados.
Configuração de Treinamento
| Estágio | Inicialização e dados | Taxa de aprendizado | Tamanho de batch global | Passos de treinamento |
|---|---|---|---|---|
| Pré-treinamento multitarefa | Mistura completa de dados; codificadores de visão e texto pré-treinados com CLIP | 3e-4 | 2.560 | 48.000 |
| Fine-tuning de tarefa no mundo real | Pesos LBM mais demonstrações da tarefa-alvo | 2e-5 | 320 | 30.000 |
| Fine-tuning de tarefa em simulação | Pesos LBM mais demonstrações da tarefa-alvo | 2e-5 | 320 | 10.000 |
| Baseline de tarefa única no mundo real | Sem pré-treinamento multitarefa de robô; mesma inicialização CLIP | 2e-5 | 320 | 100.000 |
| Baseline de tarefa única em simulação | Mesma inicialização; apenas demonstrações da tarefa-alvo | 2e-5 | 320 | 25.000 |
O codificador de visão usa um décimo da taxa de aprendizado dos outros componentes treináveis. As imagens de treinamento são redimensionadas para 256×342 (altura × largura), recortadas aleatoriamente para 224×224 e têm cores aumentadas. A inferência usa um recorte central.
Treinar “do zero” significa sem pré-treinamento multitarefa de robô; a inicialização CLIP é mantida. Os baselines de tarefa única recebem mais passos de treinamento na tarefa-alvo.
Metodologia de Avaliação
Divisão de Tarefas e Pontuação
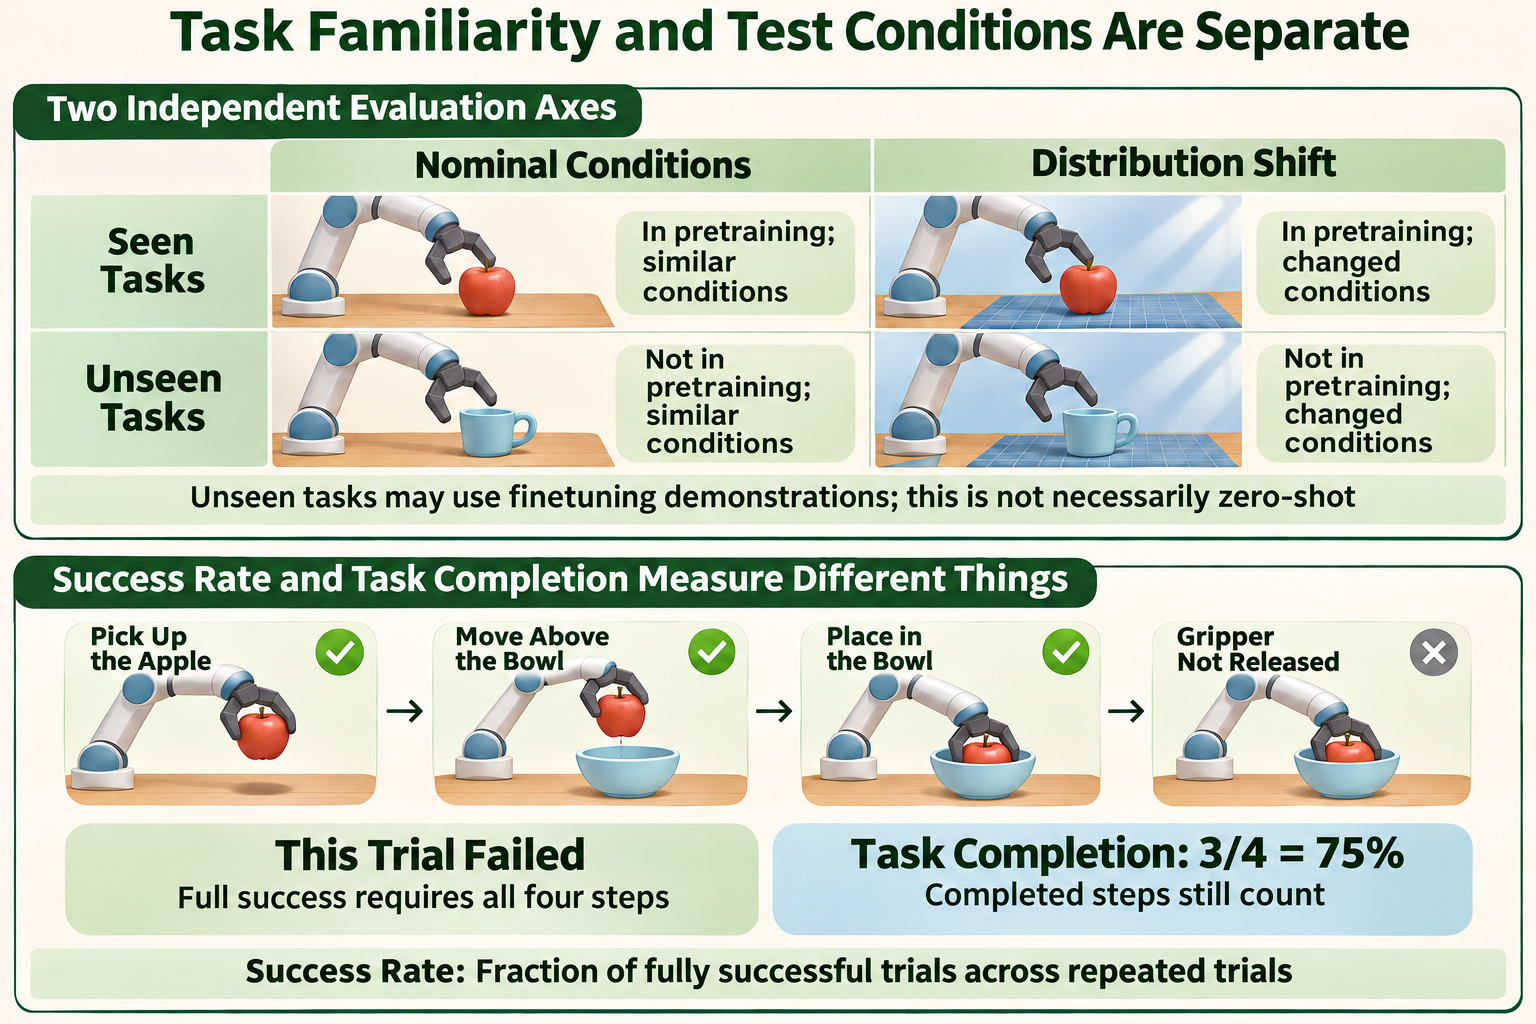
Ilustração didática baseada no artigo. A rubrica de quatro passos para posicionar a maçã explica as métricas e não é um registro de uma tarefa avaliada.
O painel superior separa tarefas vistas/não vistas de mudança de distribuição. Tarefas não vistas ainda podem fornecer demonstrações de fine-tuning. Mudança de distribuição refere-se a alterações nas condições de teste, como distratores, combinações de objetos ou estações de robô.
O painel inferior usa quatro marcos para distinguir taxa de sucesso (SR) de conclusão de tarefa (TC). Se a maçã chega à tigela, mas o gripper ainda não a soltou, três dos quatro marcos estão completos: TC é 75%, mas a tentativa é malsucedida. Este é um exemplo ilustrativo de pontuação.
conta as tentativas e conta as tentativas totalmente bem-sucedidas. é o número de marcos; indica se a tentativa completa o marco .
Mascaramento, Randomização e Redefinições
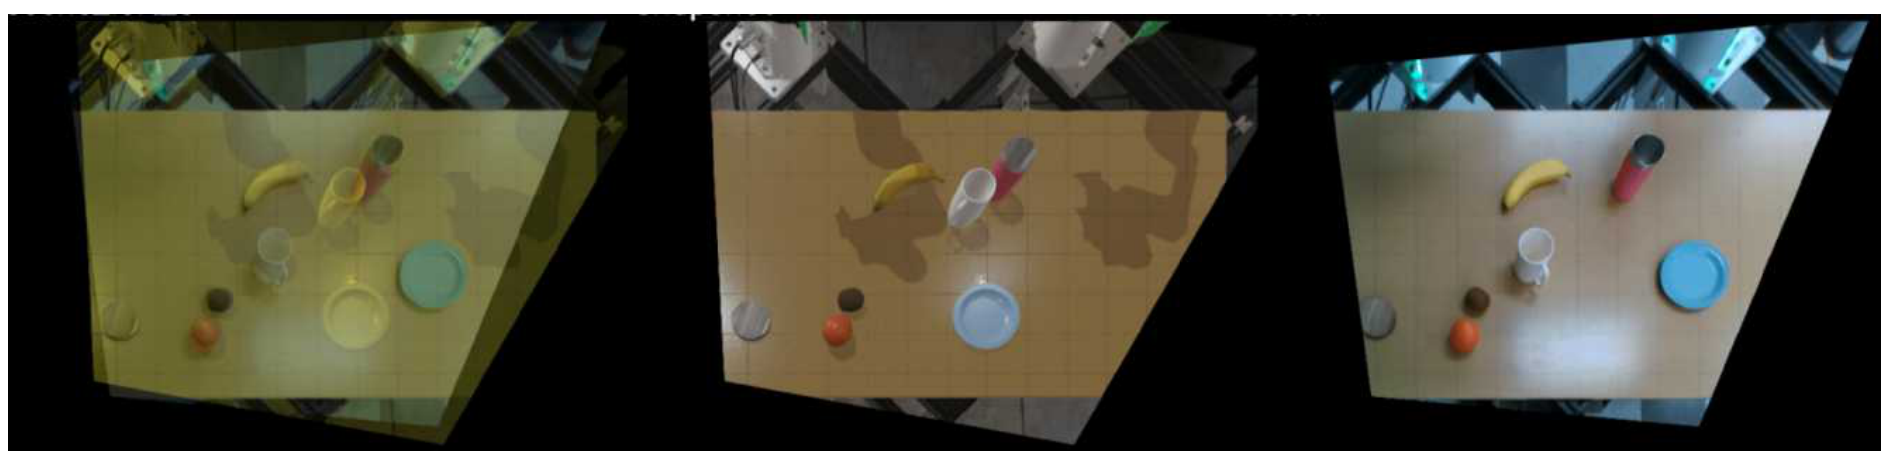
Figura 8 original (PDF p. 11). Esquerda: uma sobreposição da cena alvo e da cena atual auxilia as redefinições. Centro: cena alvo. Direita: cena atual.
Os avaliadores não sabem qual política está sendo usada (estão cegos quanto à identidade da política). As políticas são executadas em ordem aleatória a partir de condições iniciais correspondentes, com redefinições após cada rollout para reduzir vieses de ordem, iluminação e posicionamento. A simulação usa sementes aleatórias correspondentes; as redefinições no mundo real usam sobreposições de imagem. Os estados iniciais de teste não simplesmente reproduzem demonstrações individuais de treinamento.
A avaliação no mundo real inclui três tarefas vistas e cinco não vistas; a simulação inclui 16 tarefas vistas e oito não vistas. Cada combinação tarefa–política–condição é programada para 50 rollouts no mundo real ou 200 rollouts em simulação. Algumas combinações em simulação têm menos de 200 devido a dados ausentes. A análise abrange aproximadamente 1.800 rollouts no mundo real e mais de 47.000 rollouts em simulação.
Gráficos de Violino e Comparações Estatísticas
Os violinos de SR mostram pós-distribuições bayesianas sobre a verdadeira probabilidade de sucesso, estimadas a partir de resultados de sucesso/fracasso. Os gráficos de TC por tarefa individual mostram principalmente distribuições empíricas de conclusão; alguns gráficos agregados e de eficiência de dados, em vez disso, mostram pós-distribuições sobre a conclusão média. Estes representam quantidades diferentes.
O artigo usa Compact Letter Display (CLD) para resumir comparações estatísticas. Grupos sem nenhuma letra em comum diferem significativamente. Uma letra compartilhada significa que nenhuma diferença significativa foi detectada, em vez de desempenho equivalente. Interprete as letras em conjunto com a legenda, o teste estatístico e o escopo da comparação.
Resultados e Limitações
Conclusão em Tarefas Não Vistas
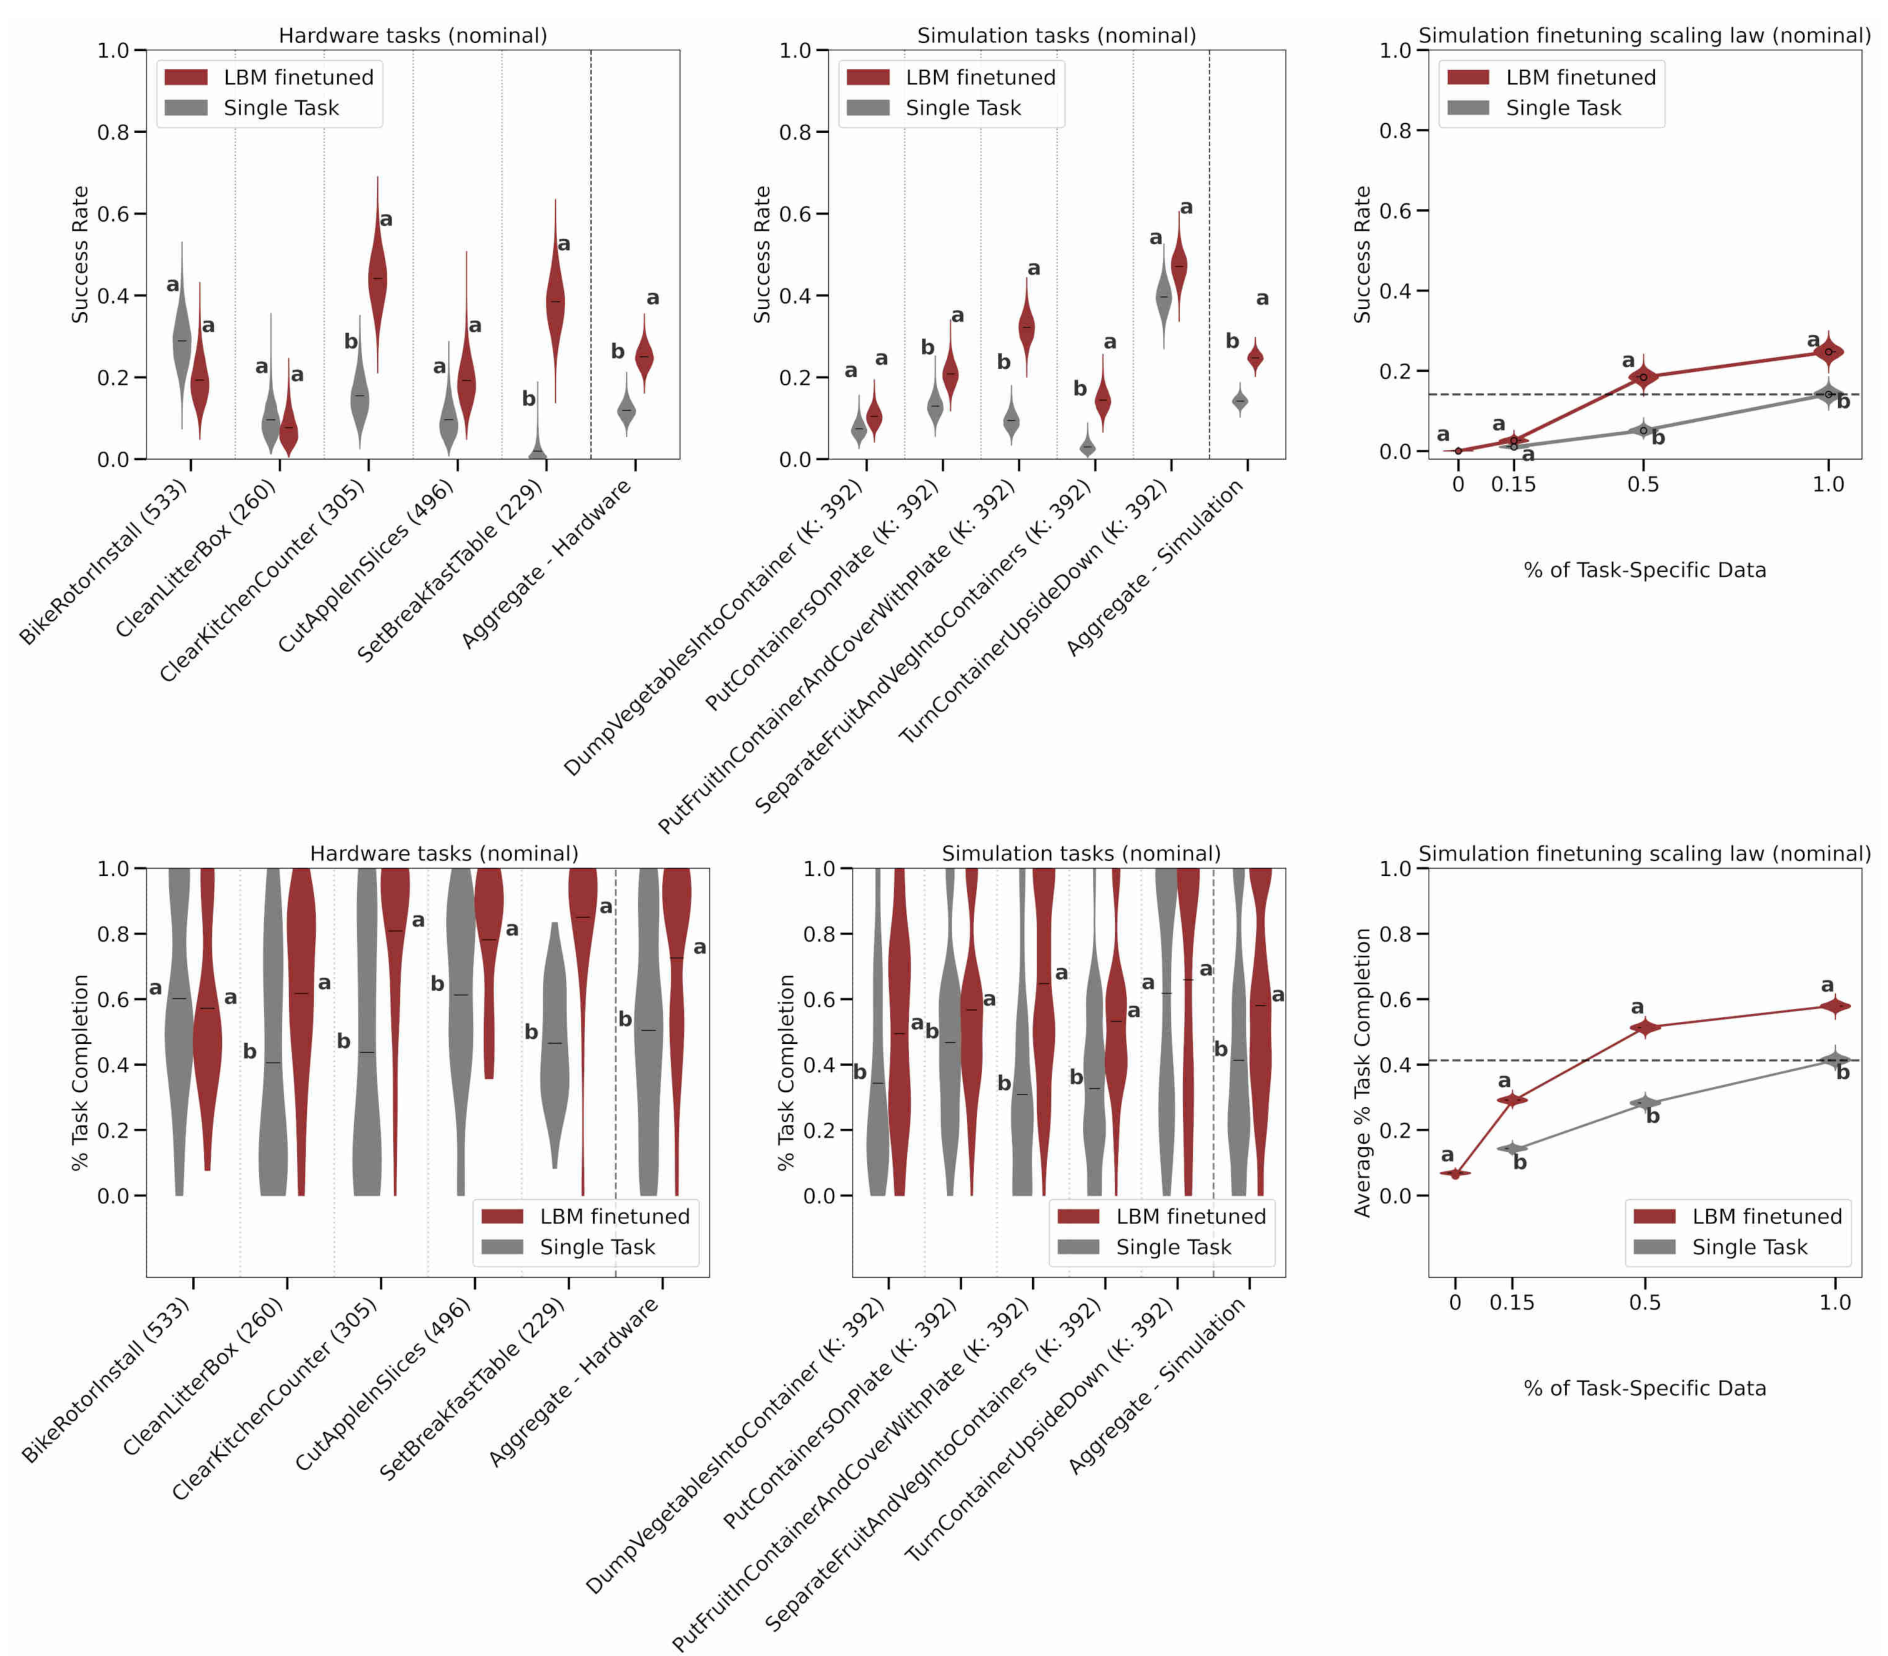
Figura 4 original (PDF p. 7). Tarefas não vistas sob condições nominais. Topo: SR. Parte inferior: TC. Colunas: tarefas no mundo real, tarefas em simulação e eficiência de dados em simulação. Vermelho: LBM pré-treinado e ajustado (fine-tuned). Cinza: baseline de tarefa única.
O sucesso completo continua difícil em tarefas complexas, mas LBMs ajustados por fine-tuning geralmente completam mais marcos. Entre cinco tarefas complexas não vistas no mundo real, TC é significativamente maior que o baseline de tarefa única em quatro, enquanto SR é significativamente maior em apenas duas.
Os ganhos agregados são mais consistentes, mas algumas diferenças individuais são insignificantes ou favorecem o baseline. As políticas podem permanecer inativas no início ou tentar a tarefa errada, portanto resultados individuais e casos de falha são importantes.
Robustez: Os Ganhos Persistem Quando as Condições de Teste Mudam?
Os deslocamentos de distribuição em simulação alteram principalmente a aparência: mapas de iluminação de ambiente não vistos, diferentes parâmetros de luzes e câmera, e texturas ou cores alteradas de objetos e da mesa. Algumas cenas também incluem elementos de distração. Os autores comparam LBMs ajustados por fine-tuning com baselines de tarefa única sob essas mudanças para testar se os ganhos do pré-treinamento persistem.
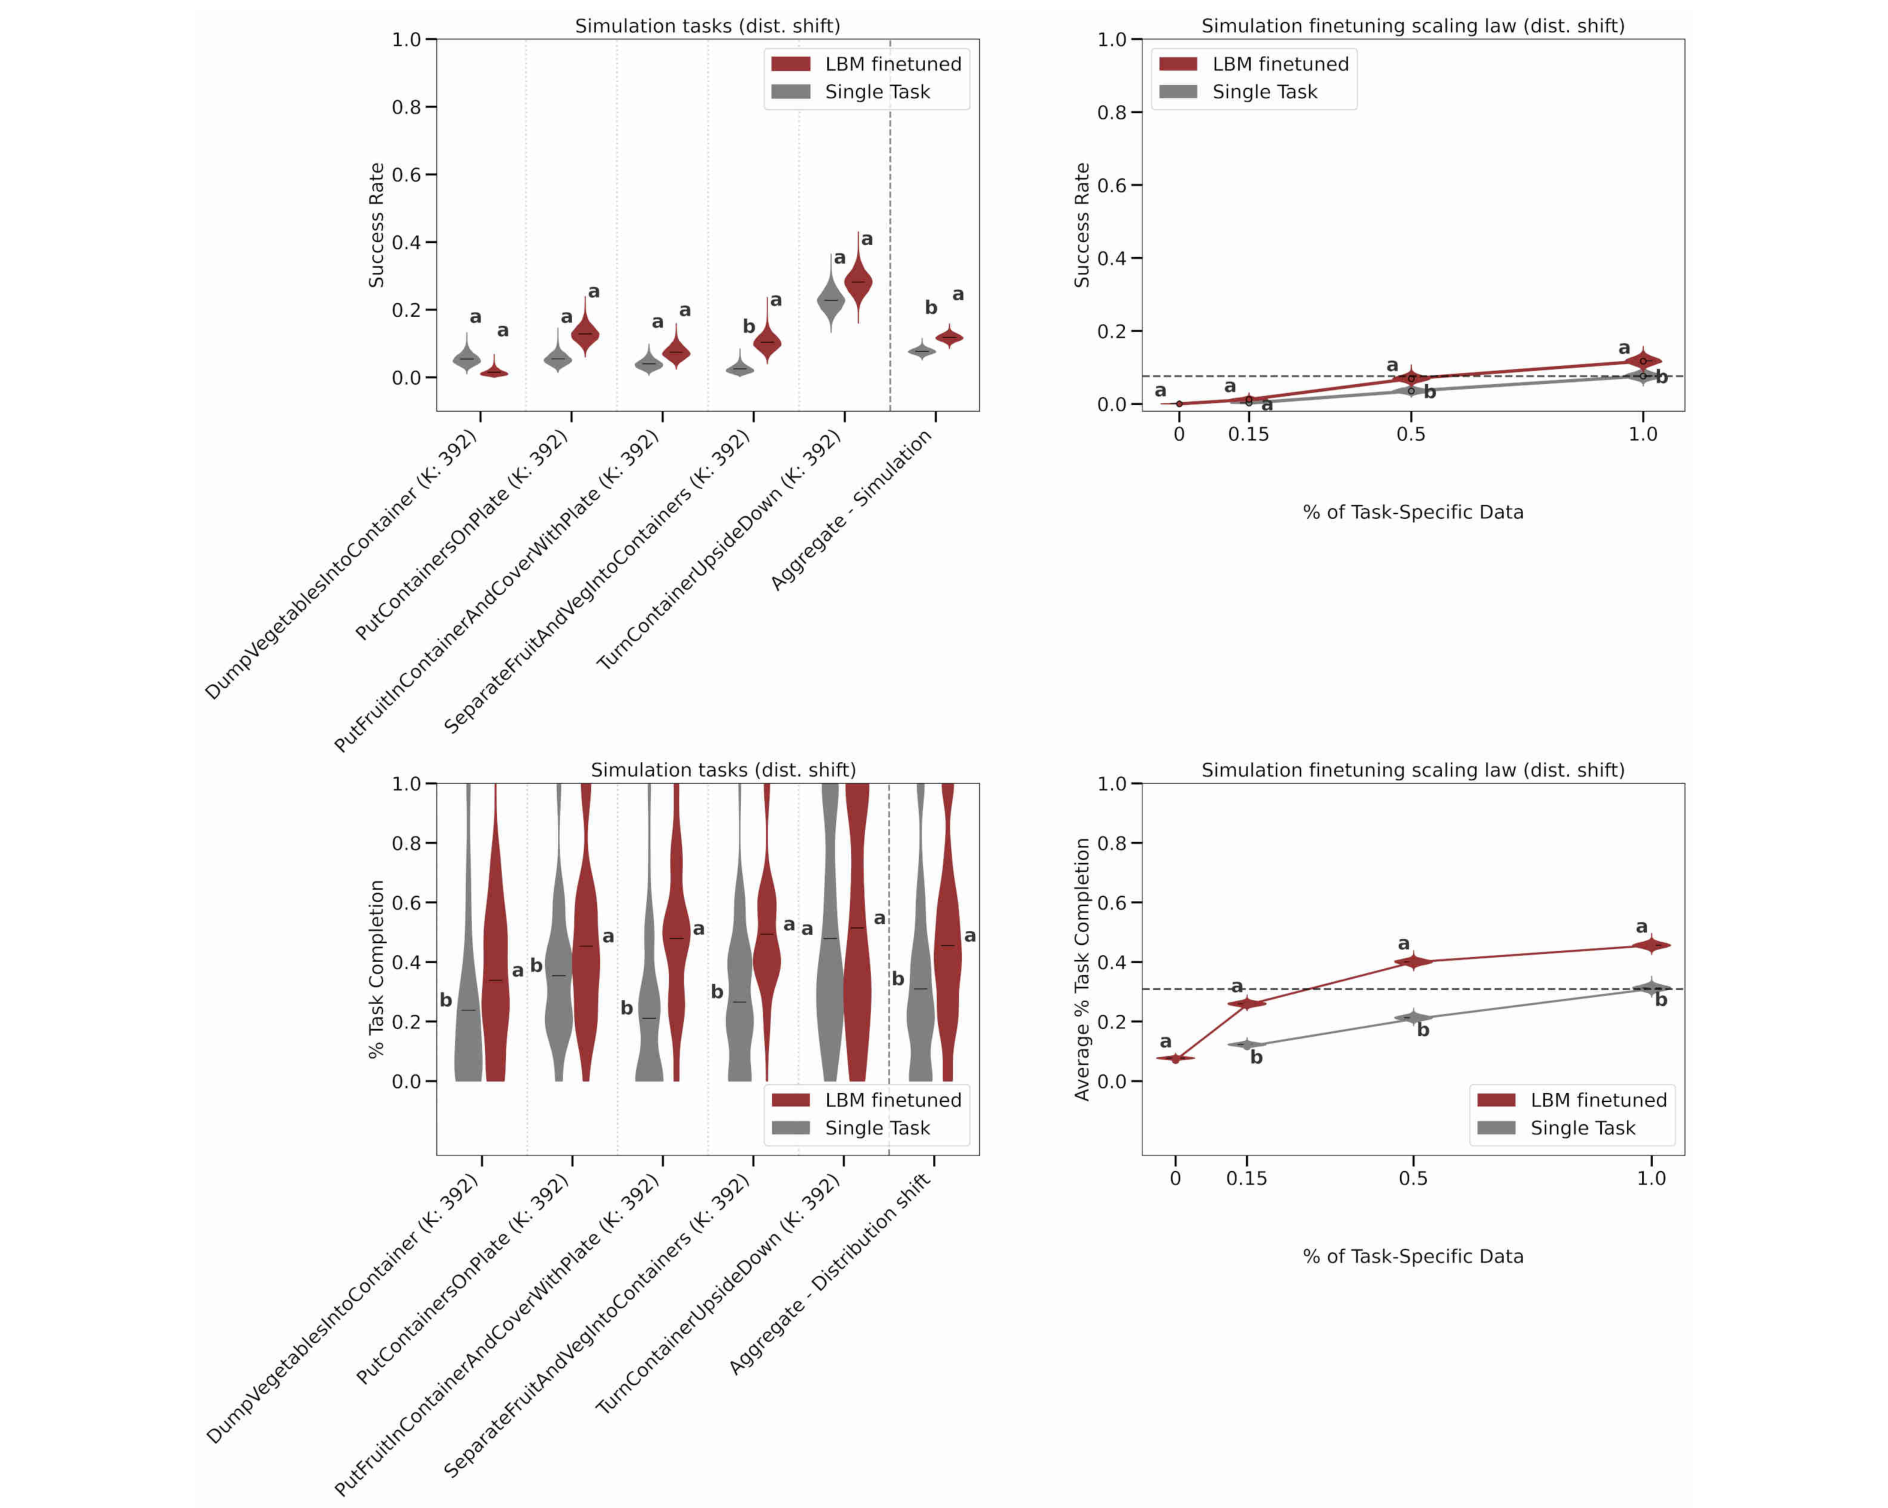
Figura 6 original (PDF p. 9). Topo: SR. Parte inferior: TC. Esquerda: tarefas individuais e resultados agregados. Direita: frações variáveis de dados da tarefa alvo. Vermelho: LBM pré-treinado e ajustado (fine-tuned). Cinza: baseline de tarefa única. Compare com os painéis de simulação na Figura 4; a Figura 6 não contém resultados do mundo real.
Para cinco tarefas complexas de simulação não vistas sob deslocamento de distribuição, TC é significativamente maior que o baseline em quatro tarefas, mas SR é significativamente maior em apenas uma. Em tarefas de simulação vistas, o número com SR significativamente maior aumenta de 3/16 sob condições nominais para 10/16 sob deslocamento de distribuição; a diferença agregada na taxa de sucesso também se amplia (Seção III-A e Figura 2).
Esses achados apoiam uma maior robustez de LBMs ajustados por fine-tuning sob os deslocamentos testados, embora o desempenho absoluto diminua na maioria das tarefas após as mudanças. Completar mais marcos ainda pode deixar o sucesso completo raro. As mudanças de aparência simuladas também diferem das mudanças reais na estação e nos objetos.
Eficiência de Dados em Novas Tarefas
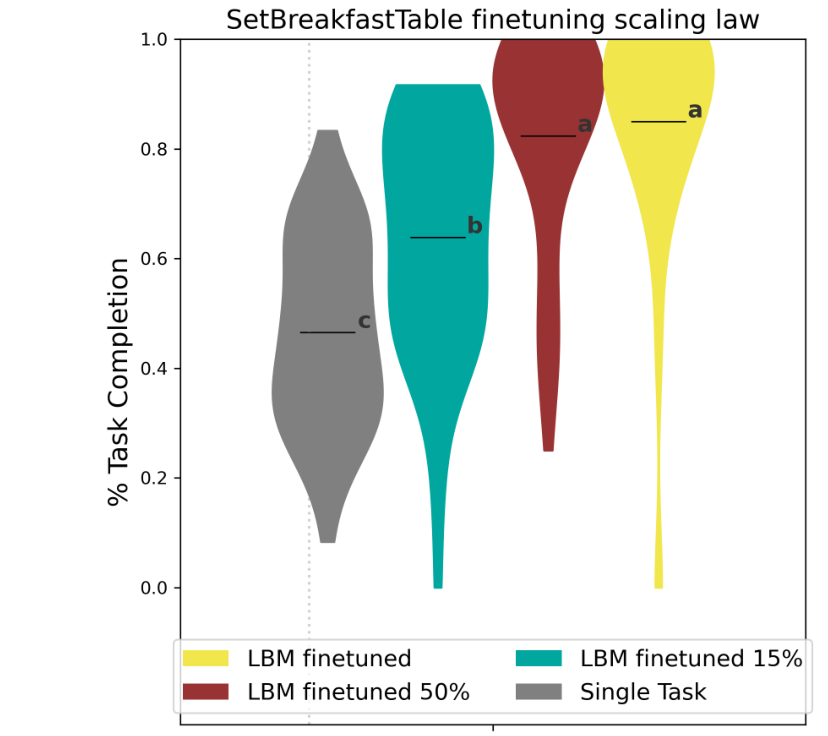
Figura 5 original (PDF p. 8). Eficiência de dados no mundo real: o eixo vertical é TC. Cada grupo compara LBMs ajustados por fine-tuning em diferentes frações de dados com um baseline de tarefa única treinado em todos os dados da tarefa alvo.
Na tarefa do mundo real SetBreakfastTable, um LBM ajustado por fine-tuning em 15% dos dados da tarefa alvo atinge TC significativamente maior que o baseline de tarefa única treinado em 100% desses dados. Esse resultado diz respeito à conclusão, e não à taxa de sucesso.
A interpolação de curvas agregadas para tarefas complexas em simulação sugere que um desempenho comparável pode exigir menos de 30% dos dados necessários para treinar do zero. Este resultado e o de 15% no mundo real vêm de experimentos diferentes; nenhum deles estabelece uma taxa fixa de economia de dados para toda tarefa.
Escala e Diversidade dos Dados de Pré-treinamento
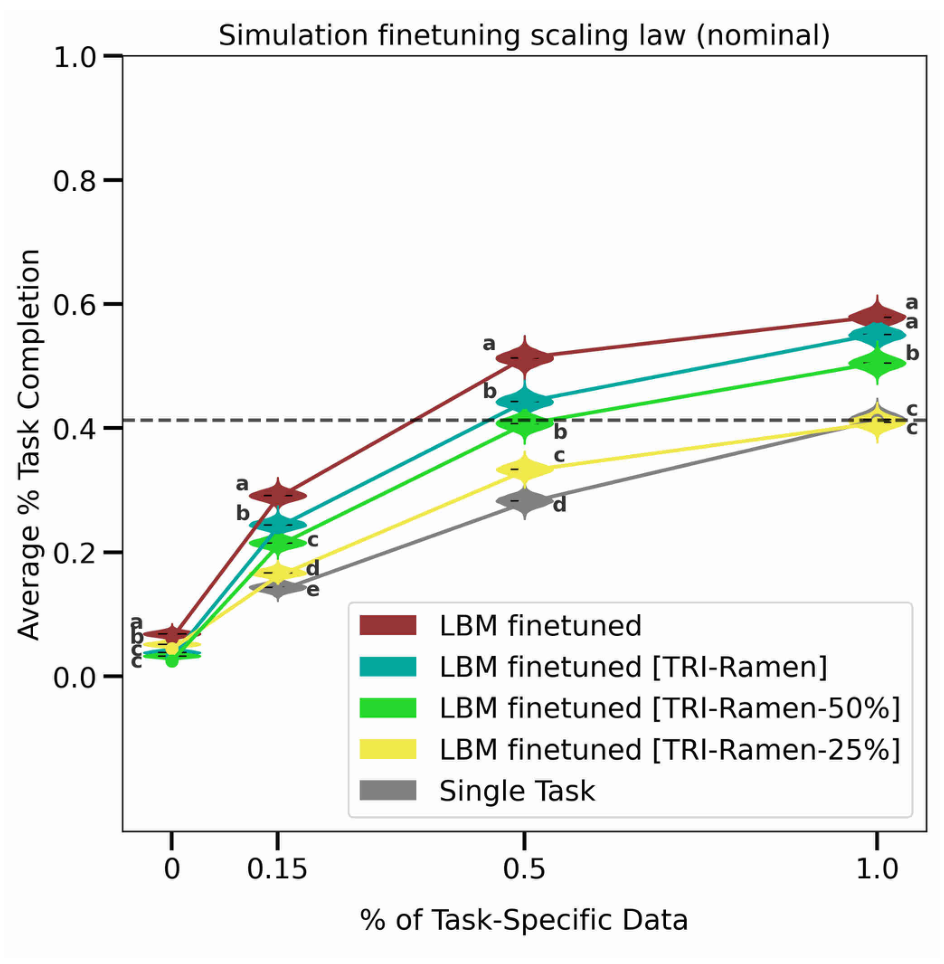
Figura 7 original (PDF p. 10). Eixo horizontal: fração de dados de fine-tuning. Eixo vertical: TC médio em cinco tarefas de simulação não vistas. As curvas correspondem a diferentes misturas de pré-treinamento.
Na mesma fração de dados de fine-tuning, dados de pré-treinamento mais diversos geralmente produzem melhor desempenho, particularmente quando os dados da tarefa alvo são escassos. O eixo horizontal varia os dados de fine-tuning. Esses experimentos limitados com subconjuntos não estabelecem nem uma lei de escala universal nem benefícios de aumentar a contagem de parâmetros do modelo.
Limitações
- Os ganhos sem fine-tuning são inconsistentes. LBMs pré-treinados não superam consistentemente políticas de tarefa única; os autores sugerem que isso pode refletir em parte limitações na orientação em linguagem do pequeno codificador de linguagem.
- O escopo experimental é limitado. Resultados em uma plataforma bimanual específica não se generalizam diretamente para robôs de um único braço ou para casas arbitrárias.
- A aleatoriedade do treinamento não é totalmente avaliada. Os gráficos de violino capturam principalmente a incerteza de avaliação para checkpoints fixos, em vez da variação entre execuções de treinamento independentes.
- Havia um bug de normalização no pré-treinamento. Alguns dados usaram parâmetros de outra fonte, e os principais experimentos não foram todos reexecutados. Após a correção, experimentos suplementares melhoraram o desempenho sob os deslocamentos de distribuição em simulação testados.
- Filtrar quadros estacionários tem efeitos mistos. Remover segmentos iniciais de baixa movimentação melhorou algumas políticas de simulação de tarefa única, mas fez com que alguns modelos pré-treinados escolhessem a tarefa errada com mais frequência. Portanto, isso não foi aplicado de forma uniforme.
Implementação e Aplicação no LeRobot
A comparação a seguir usa o commit f5c9bc0. O LeRobot MultiTask DiT segue a abordagem DiT condicional de LBM, mas sua configuração, pré-processamento e resultados de treinamento devem ser interpretados separadamente.
Comparação de Configuração
| Componente | Artigo TRI | Padrões fixados do LeRobot |
|---|---|---|
| Objetivo | Predição de ruído de difusão; amostragem DDIM | diffusion; também oferece suporte a flow_matching |
| Backbones de imagem e texto | CLIP; visão treinável, texto congelado | Mesma abordagem; padrão para openai/clip-vit-base-patch16 |
| Tamanho do DiT | 8 camadas; dimensão oculta 768 | 6 camadas; dimensão oculta 512; 8 cabeças de atenção |
| Histórico de observação | 2 quadros | n_obs_steps=2 |
| Saída de ação | 16 passos, cada um 20-dimensional | horizon=32; dimensão da ação a partir do dataset |
| Segmento de execução | Executar 8 passos antes de replanejar | n_action_steps=24; fatiar usando o deslocamento de observação e então enfileirar |
| Câmeras | Padronizado para 6 visões; visões ausentes preenchidas com zeros | Contagem inferida a partir dos recursos de entrada; codificador de visão compartilhado por padrão |
| Normalização | Quantis por fonte, timestep relativo e dimensão de recurso | Estados e ações: MIN_MAX; imagens: MEAN_STD |
Por padrão, num_inference_steps=None recai para num_train_timesteps=100, resultando em 100 passos de remoção de ruído. Embeddings de posição rotatória (RoPE) são ativados por padrão. Embeddings de posição absoluta aprendíveis também são suportados; esta versão permite ambos simultaneamente.
A contagem de parâmetros depende da contagem de câmeras, da contagem de camadas e da dimensão oculta. Os 450M de parâmetros, horizonte de predição de 48 passos e segmento de execução de 24 passos do blog da Boston Dynamics descrevem a configuração do Atlas e não se aplicam a toda configuração do LeRobot.
Janela de Ação e Segmento de Execução
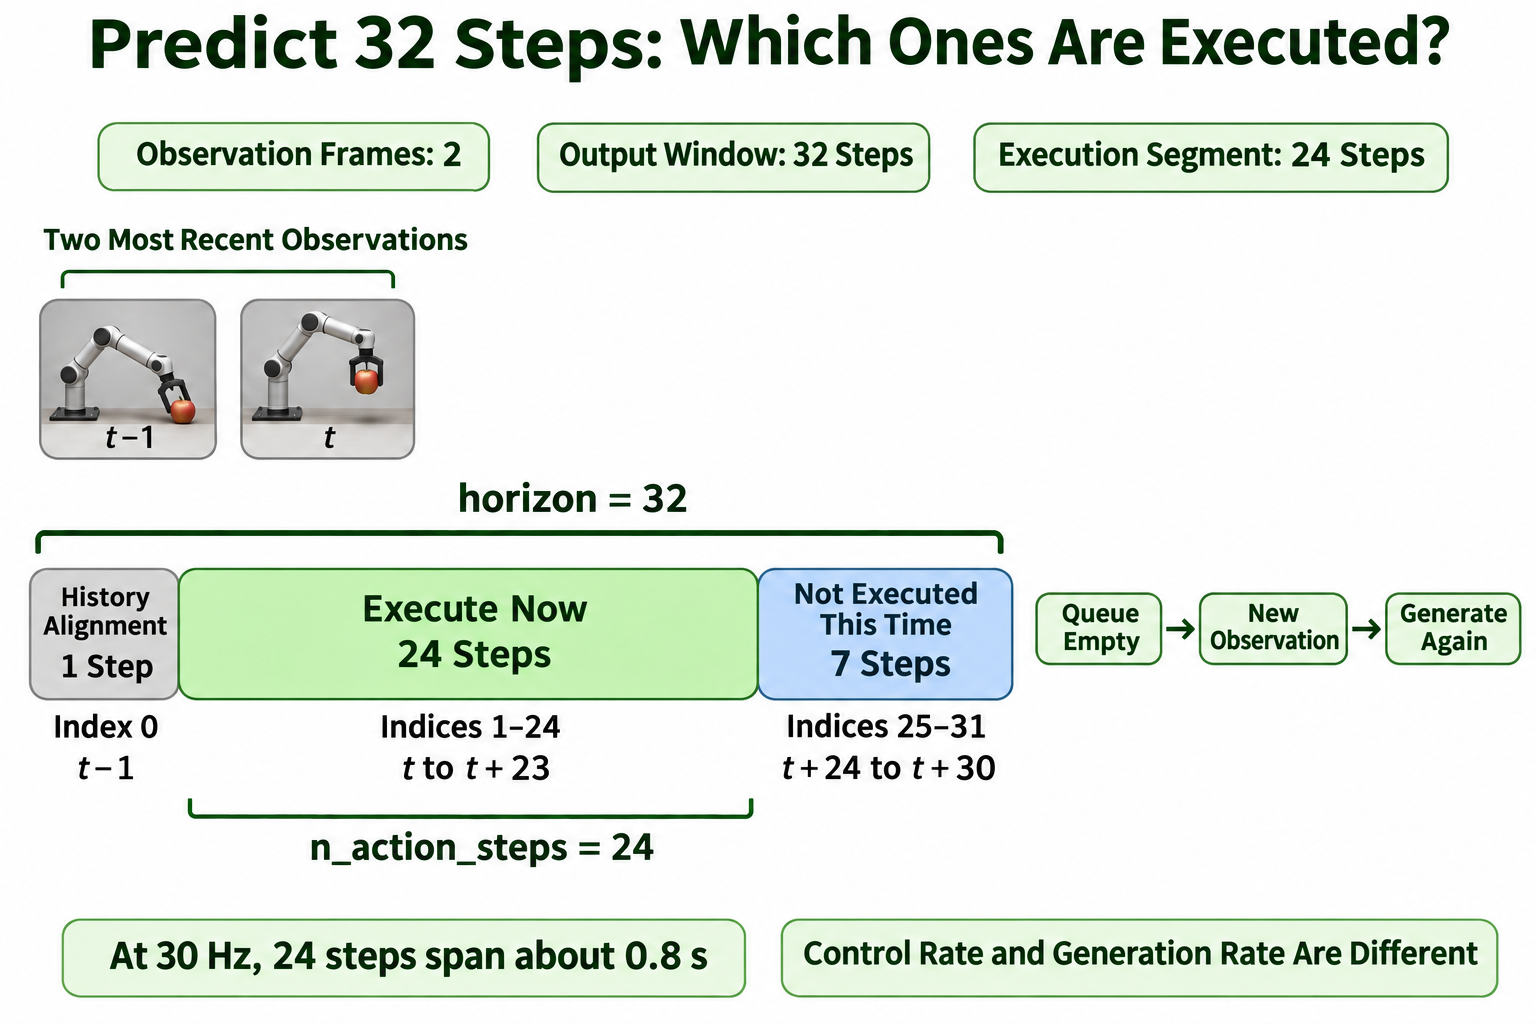
Ilustração didática baseada no fatiamento de ações na implementação fixada do LeRobot. A janela de 32 passos e o segmento de execução de 24 passos são os padrões desta versão.
Com dois quadros de observação, a janela de ação começa em . _generate_actions usa os índices 1:25, colocando 24 ações de até na fila de execução. O comprimento da janela , a contagem de observações e o comprimento de execução devem satisfazer:
Para , e , isso resulta em .
Quando a amostragem de demonstrações e a execução de ações rodam ambas a 30 Hz, 24 passos correspondem aos 0,8 segundos ilustrados; a 10 Hz, eles abrangem aproximadamente 2,4 segundos. Segmentos de execução mais curtos incorporam novas observações mais cedo, mas exigem geração mais frequente. A temporização real também depende da latência de inferência e comunicação; os parâmetros da janela não definem a frequência de controle.
Inicialização do Treinamento e Conclusões do Artigo
LeRobot pode inicializar seus codificadores de imagem e texto a partir de pesos CLIP pré-treinados e treinar uma política de ação com as suas próprias demonstrações de robô. Isso não fornece a experiência de pré-treinamento multitarefa de robôs da TRI. Testar os benefícios de transferência do artigo exige comparar o treinamento de tarefa única com o pré-treinamento multitarefa seguido de fine-tuning, controlando os dados da tarefa-alvo, as interfaces de ação e as condições de teste.
Para adaptação ao reBot ou SO-ARM101, primeiro verifique os estados do conjunto de dados, ações, câmeras, carimbos de tempo e instruções de tarefa e, em seguida, valide o pipeline de controle de tarefa única.
Interpretando as Conclusões
O artigo usa uma arquitetura de política fixa e uma avaliação controlada para testar os benefícios do pré-treinamento multitarefa. Nas tarefas avaliadas, o pré-treinamento seguido de fine-tuning melhora o desempenho agregado e reduz as demonstrações da tarefa-alvo necessárias para um desempenho comparável. Algumas vantagens tornam-se mais pronunciadas quando as condições de teste mudam.
Os resultados apoiam o pré-treinamento em demonstrações diversas dentro de limites claros: os ganhos dependem da tarefa e das condições de fine-tuning; melhor conclusão não implica necessariamente sucesso completo; e modelos sem fine-tuning não superam de forma consistente as políticas de tarefa única. Compreender a contribuição exige conectar a geração de ações, as comparações experimentais e o escopo das evidências.