π₀ — Controle Robótico de Uso Geral
π0: Um Modelo de Fluxo Visão-Linguagem-Ação para Controle Robótico Geral
- Modelos fundamentais para robôs
- Especialista em ações
- Flow matching
- Treinamento entre diferentes corpos robóticos
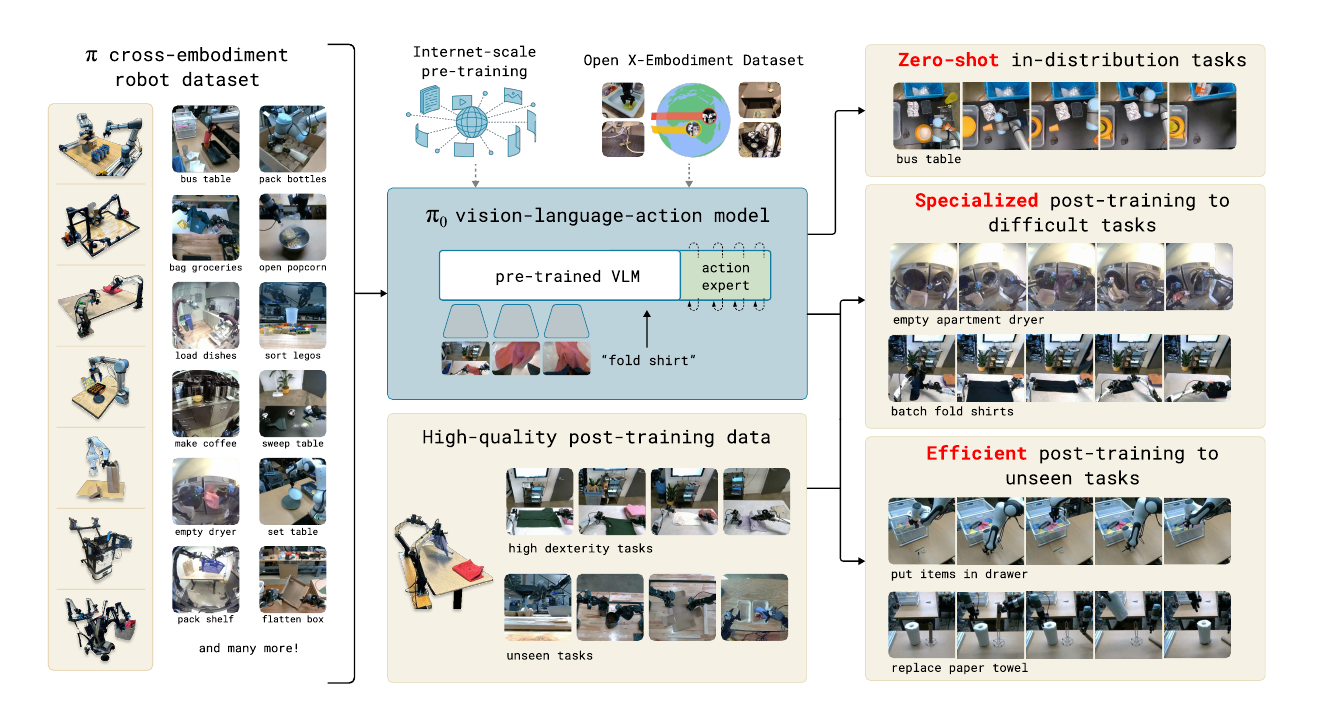
π0 usa o modelo visão-linguagem PaliGemma pré-treinado como backbone semântico e adiciona um especialista em ações com aproximadamente 300 milhões de parâmetros. Conditional flow matching gera blocos contínuos de ações, enquanto o pré-treinamento em larga escala entre diferentes robôs e o pós-treinamento de tarefas de alta qualidade adaptam o mesmo modelo a sistemas de braço único, bimanual e móveis.
Pré-requisitos
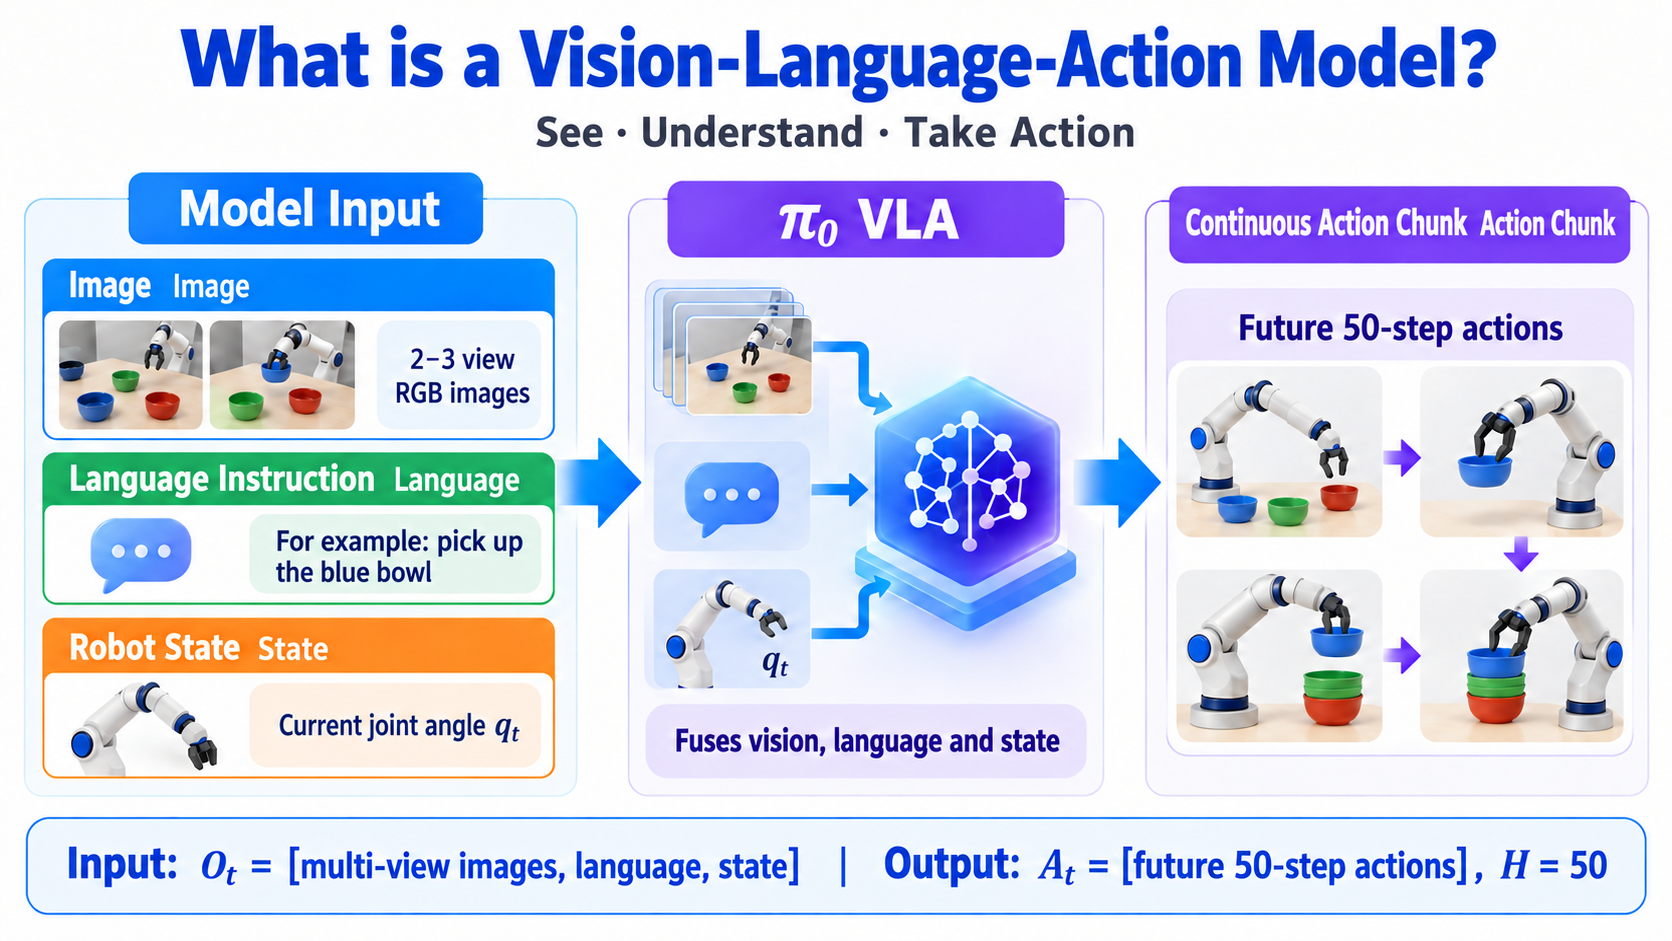
O que é um Modelo Visão-Linguagem-Ação?
Ações Discretas Autoregressivas e Blocos Contínuos
Treinamento, Inferência e Avaliação
Resumo
Tradução
Aprendizado de robôs promete sistemas flexíveis, de uso geral, hábeis e também insights sobre questões fundamentais de IA. Alcançar a generalidade necessária para sistemas reais ainda enfrenta obstáculos substanciais em dados, generalização e robustez.
O artigo pergunta como políticas generalistas para robôs, ou modelos fundamentais para robôs, podem enfrentar esses desafios em tarefas complexas e hábeis. Ele introduz uma arquitetura de flow matching construída sobre um VLM pré-treinado, herdando conhecimento semântico de dados em escala de internet, e então a treina em diversas plataformas de braço único, bimanual e de manipulação móvel.
A avaliação cobre três configurações: prompting direto, seguir instruções em linguagem natural de um humano ou de uma política VLM de alto nível, e fine-tuning para novas habilidades. As tarefas incluem dobrar roupas, limpar mesas e montar caixas de papelão.
Comentários
-
A arquitetura é apenas uma parte do problema. O artigo identifica três gargalos: escala de dados suficiente, uma arquitetura para ações contínuas de alta frequência e receitas adequadas de pré-/pós-treinamento.
-
O VLM fornece entendimento; o especialista em ações fornece controle. PaliGemma lida com a semântica imagem-linguagem, enquanto o especialista processa o estado do robô, ações ruidosas e saídas contínuas.
-
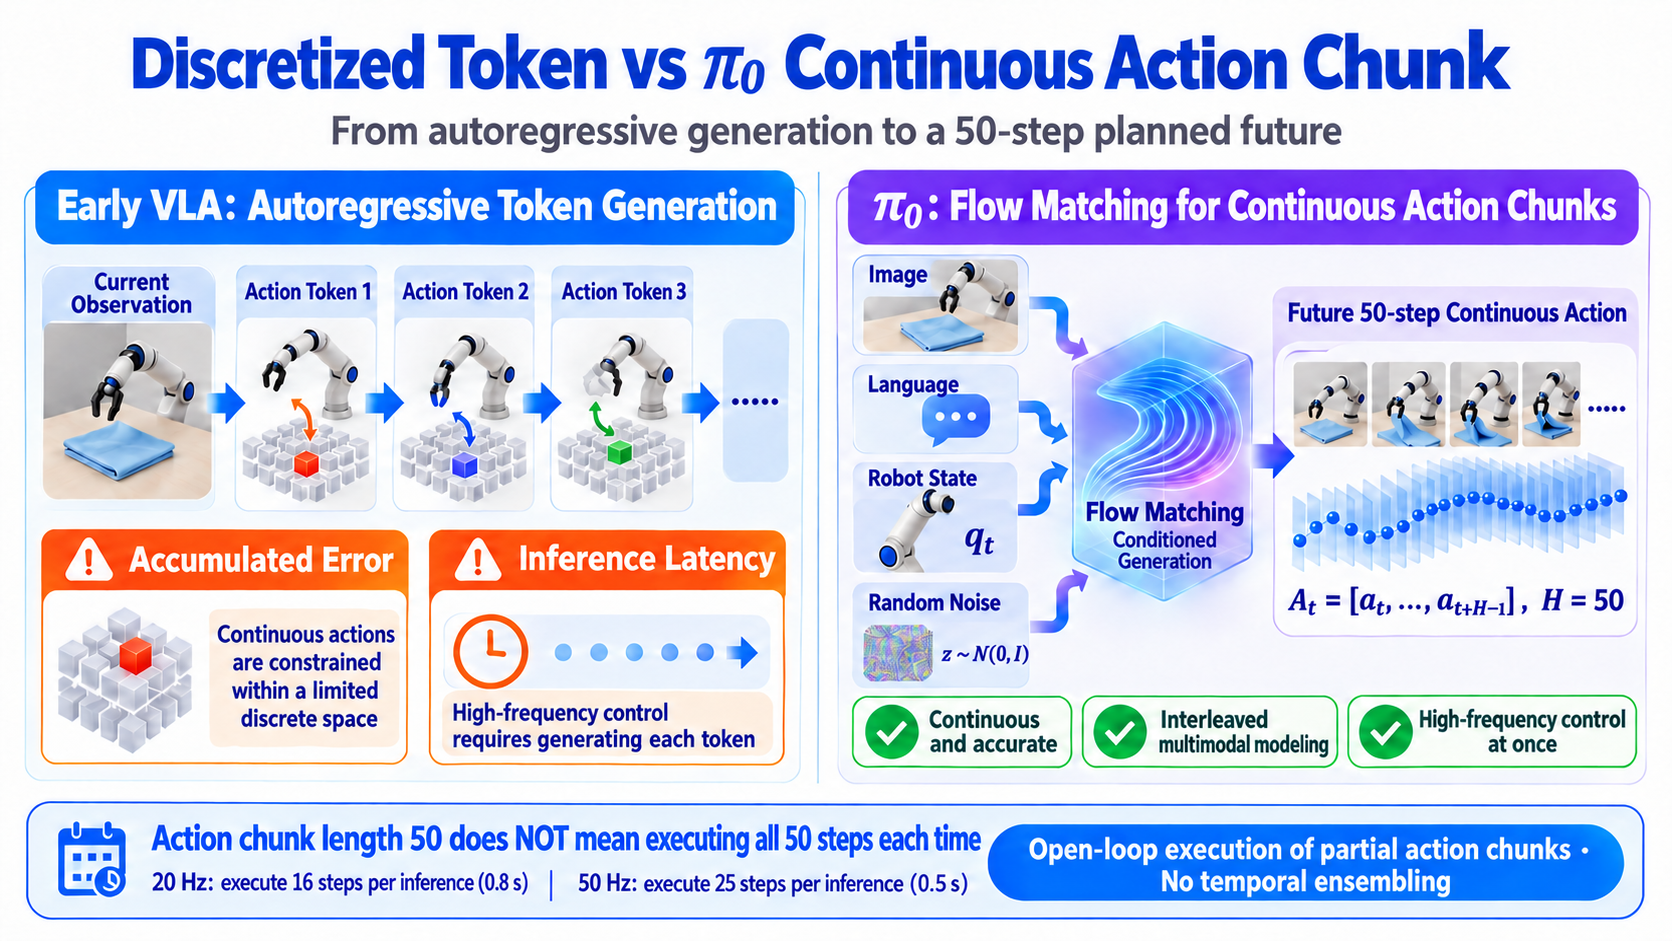
Flow matching substitui a geração autoregressiva de tokens de ação. O modelo gera em paralelo todo o bloco contínuo a partir de ruído.
-
Dados entre diferentes corpos robóticos são centrais. Braços e bases móveis têm espaços de estado e ação diferentes. Preenchimento (padding) e slots de imagem mascarados fornecem uma interface de treinamento compartilhada.
-
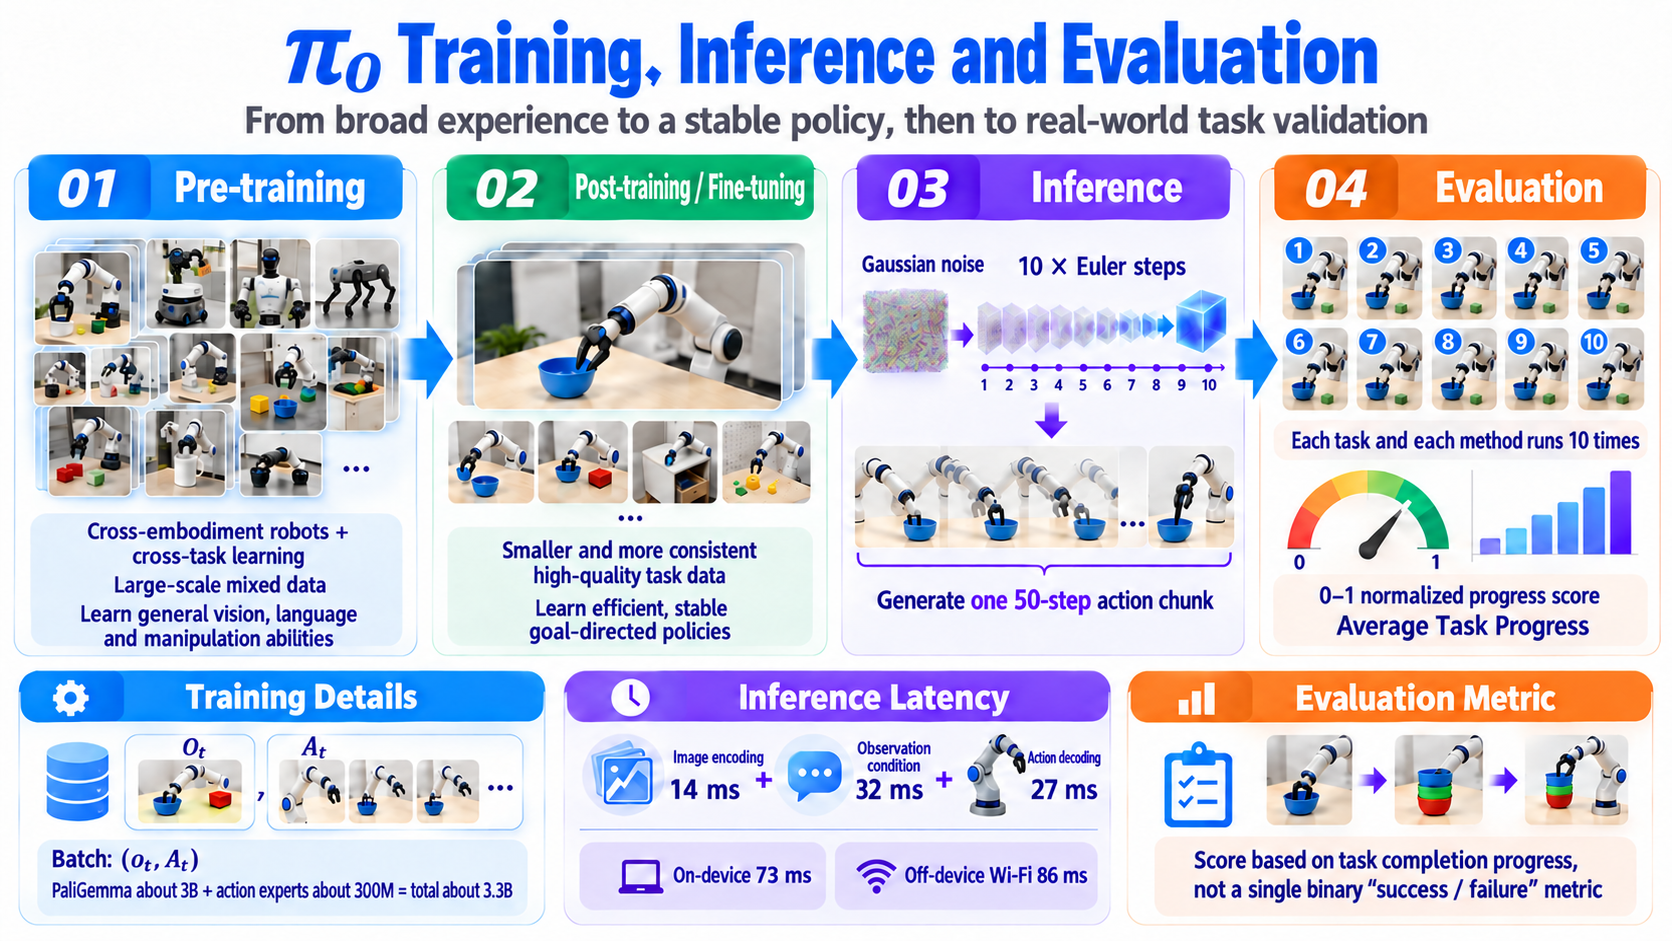
Pré-treinamento e pós-treinamento têm papéis diferentes. O pré-treinamento amplo inclui estados incomuns e comportamento de recuperação; o pós-treinamento enfatiza sucesso consistente e fluente. Juntos, eles sustentam adaptabilidade e qualidade de execução.
Introdução
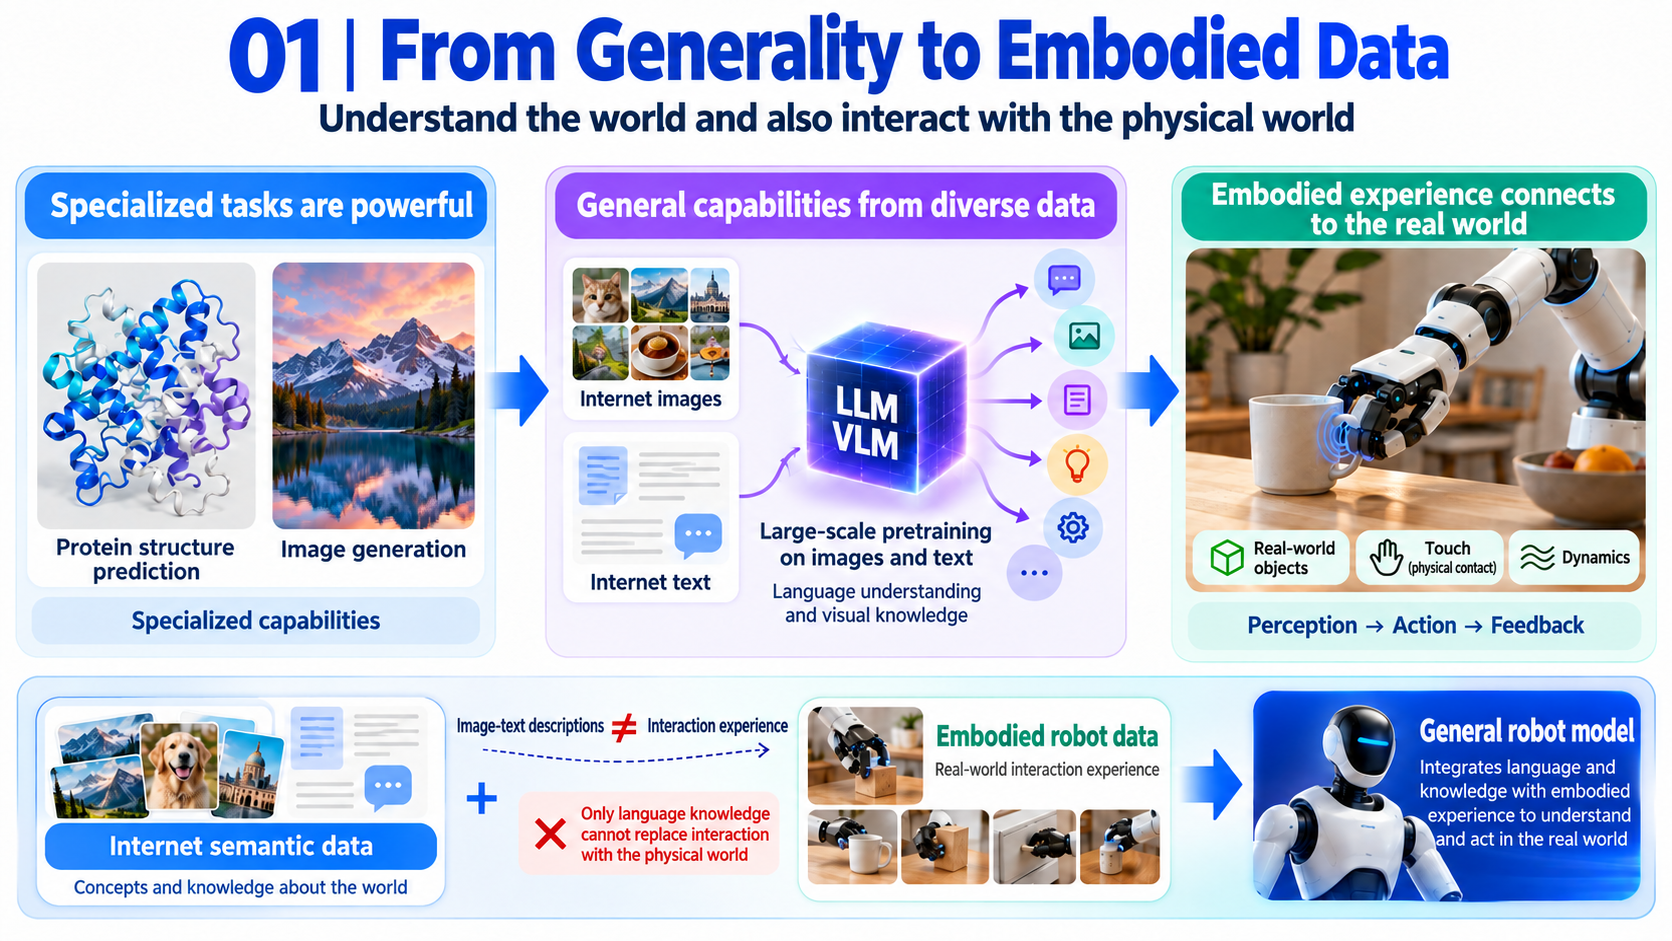
Parágrafo 1: Generalidade Requer Experiência Física
-
Ponto principal: A IA se destaca em tarefas especializadas como predição de estrutura de proteínas e geração de imagens, mas as pessoas continuam muito mais gerais em diferentes ambientes, restrições, linguagem e eventos inesperados. LLMs e VLMs se beneficiam de pré-treinamento diverso, mas não adquirem por si só experiência de interação física.
-
Problema levado adiante: Descrições imagem-texto não podem substituir contato com objetos e experiência de dinâmica.
-
Preparação para o método: Modelos generalistas de robôs precisam tanto de semântica da internet quanto de dados físicos de robôs.
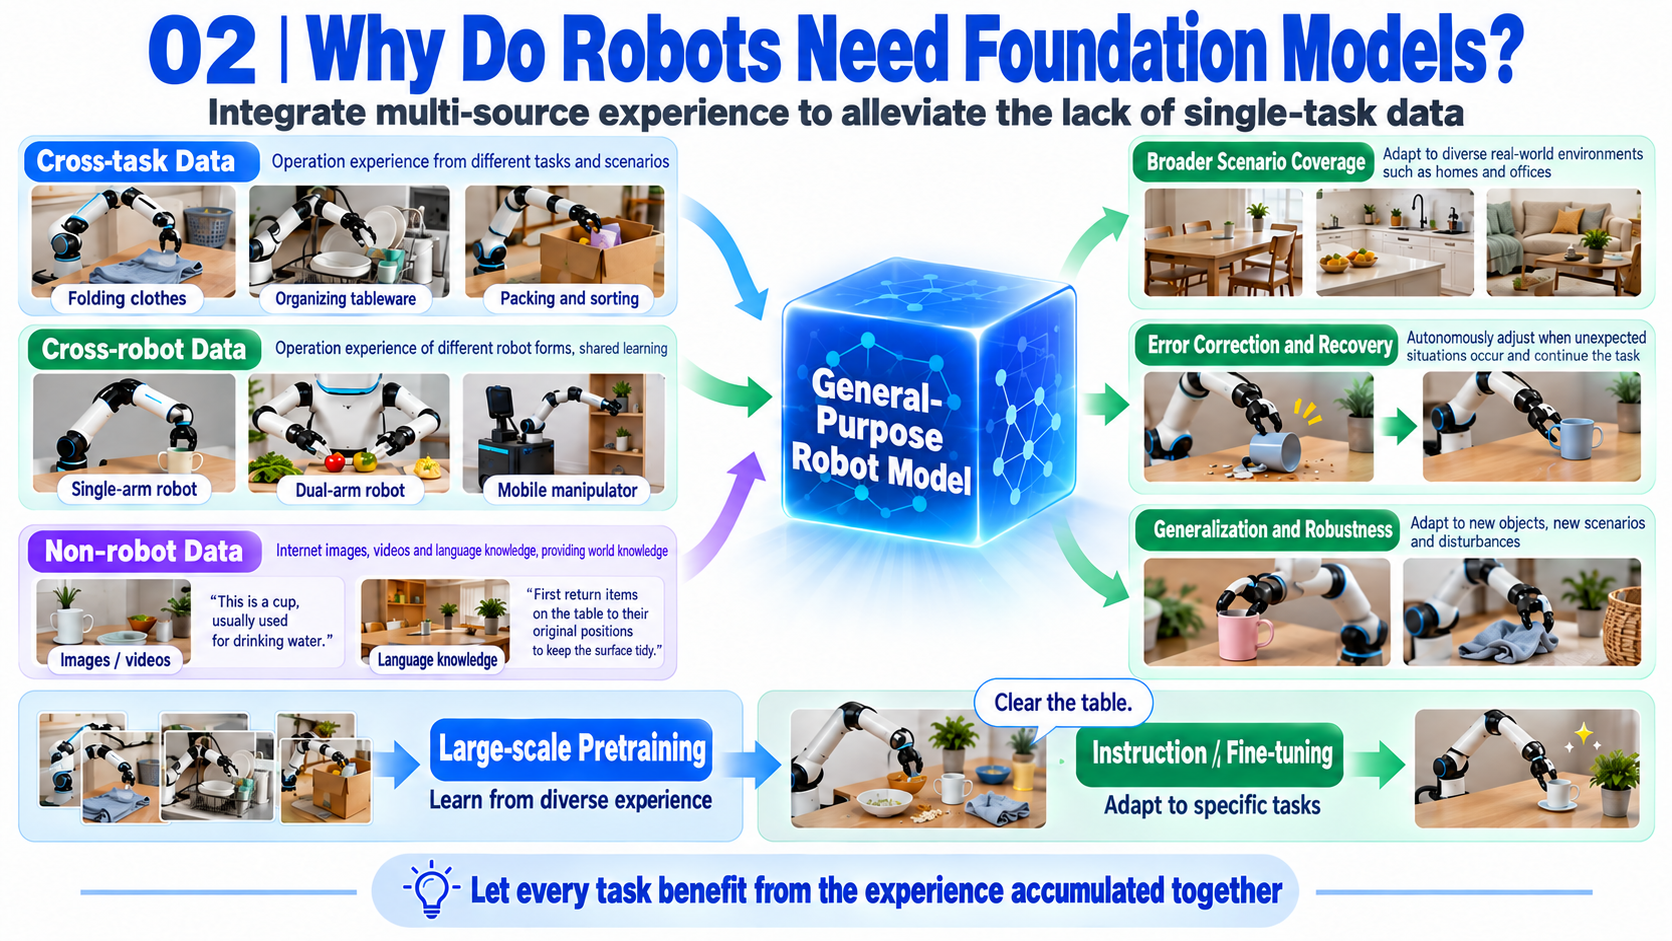
Parágrafo 2: Por que Modelos Fundamentais se Encaixam em Robótica
-
Ponto principal: Modelos generalistas reúnem dados de outras tarefas, robôs e até fontes não robóticas, reduzindo a escassez de dados de uma única tarefa. A diversidade também pode cobrir mais cenários, erros e recuperações, melhorando a robustez.
-
Problema levado adiante: Um robô e uma tarefa raramente fornecem dados suficientes para cobrir estados de falha.
-
Preparação para o método: Pré-treinar amplamente e depois usar prompting ou fine-tuning, em vez de treinar cada tarefa do zero.
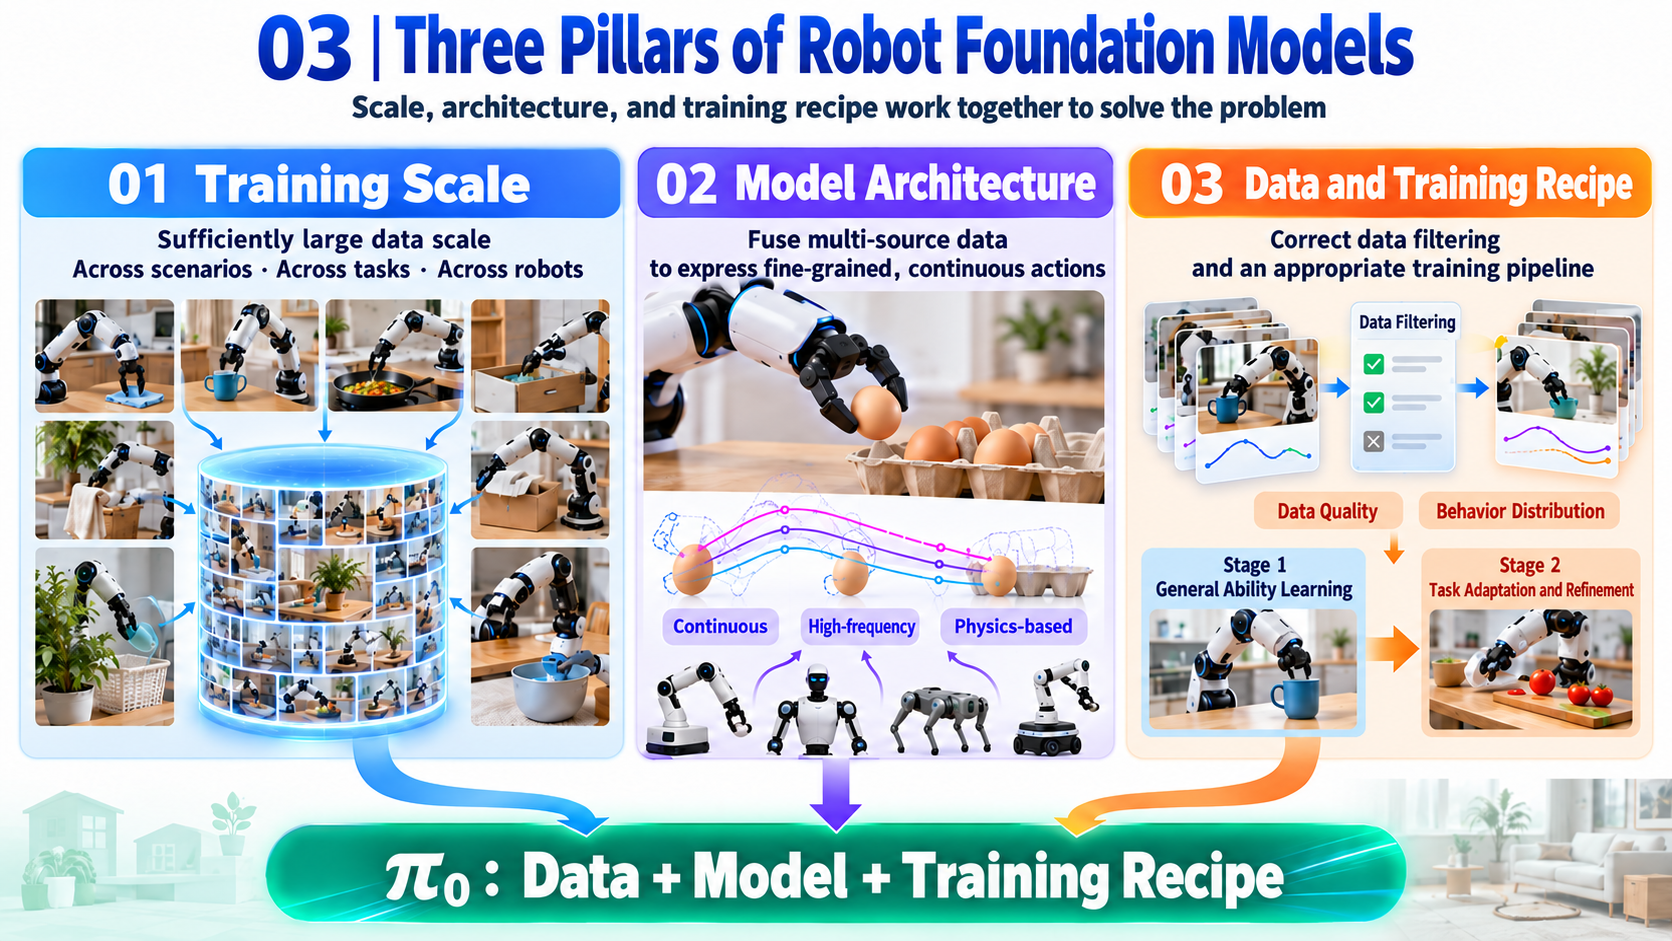
Parágrafo 3: Três Gargalos
-
Ponto principal: Políticas generalistas precisam de escala suficiente, de uma arquitetura que una dados heterogêneos e expresse ações precisas, e de seleção de dados e receitas de treinamento apropriadas.
-
Problema levado adiante: Métodos de modelos de linguagem não podem simplesmente ser copiados para controle contínuo, de alta frequência e dependente da plataforma.
-
Preparação para o método: π0 aborda dados, arquitetura e treinamento separadamente.
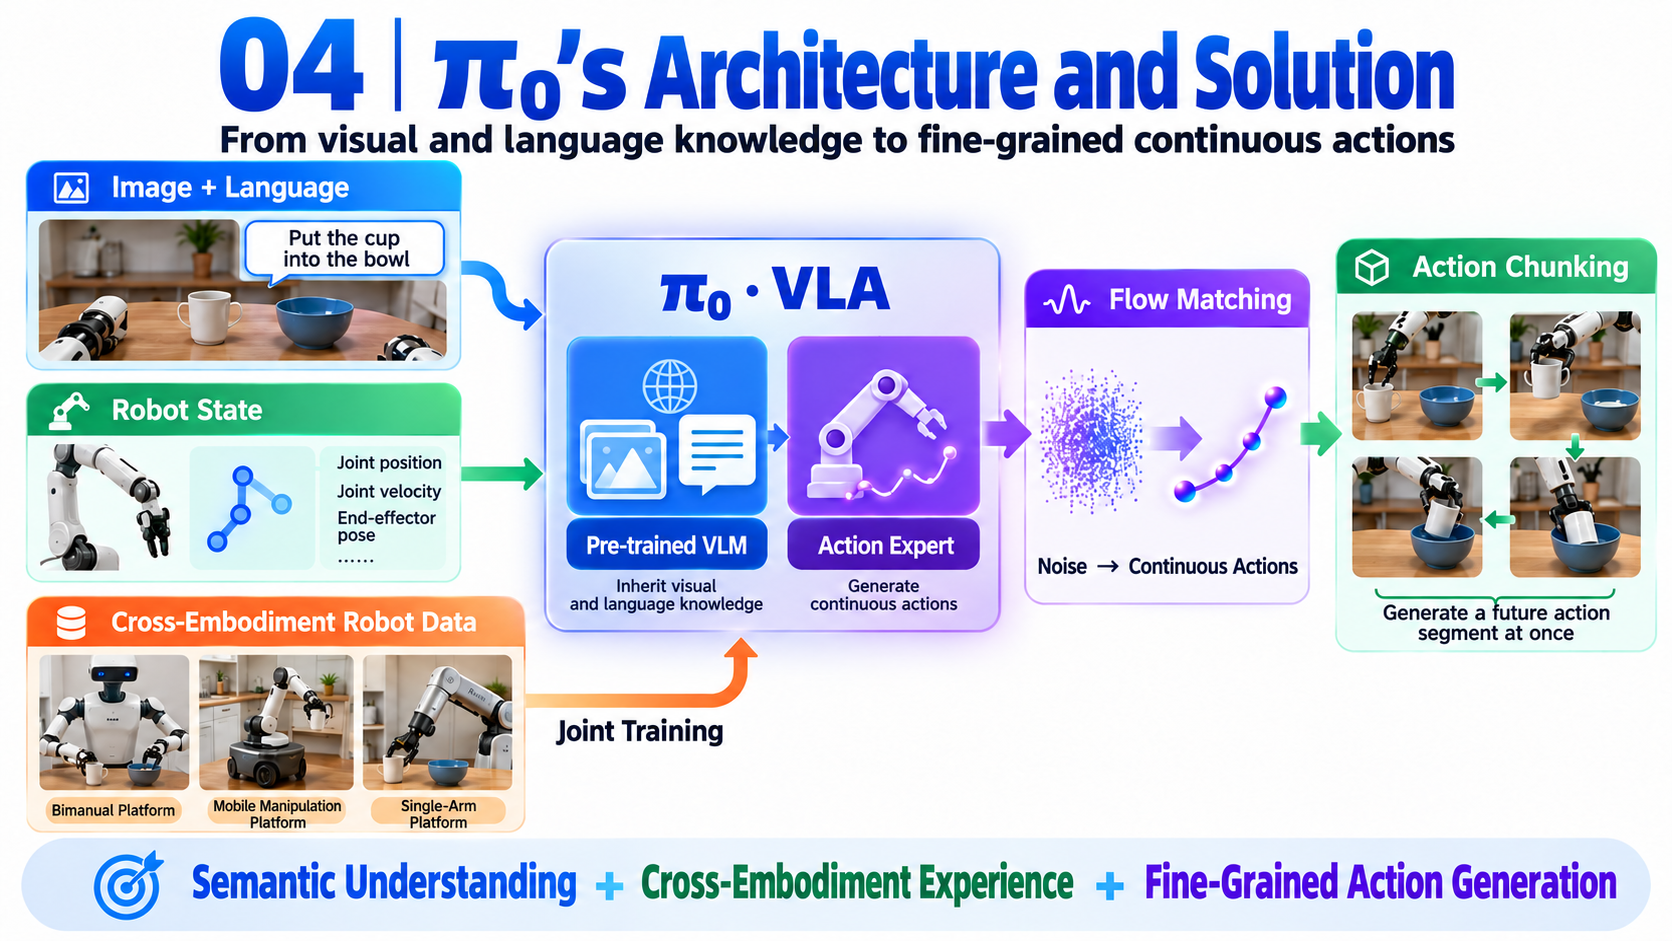
Parágrafo 4: A Resposta Arquitetural
-
Ponto principal: Inicializar a partir de um VLM, treinar conjuntamente entre diferentes corpos robóticos, usar blocos de ações e flow matching para controle contínuo e adicionar um especialista em ações para estender o backbone em um gerador de ações.
-
Problema levado adiante: Robôs diferentes têm espaços de ação diferentes, enquanto a autoregressão discreta tem dificuldade em combinar velocidade e precisão.
-
Preparação para o método: As Seções 5 e 6 desenvolvem o conjunto de dados entre diferentes corpos robóticos e o especialista em ações.
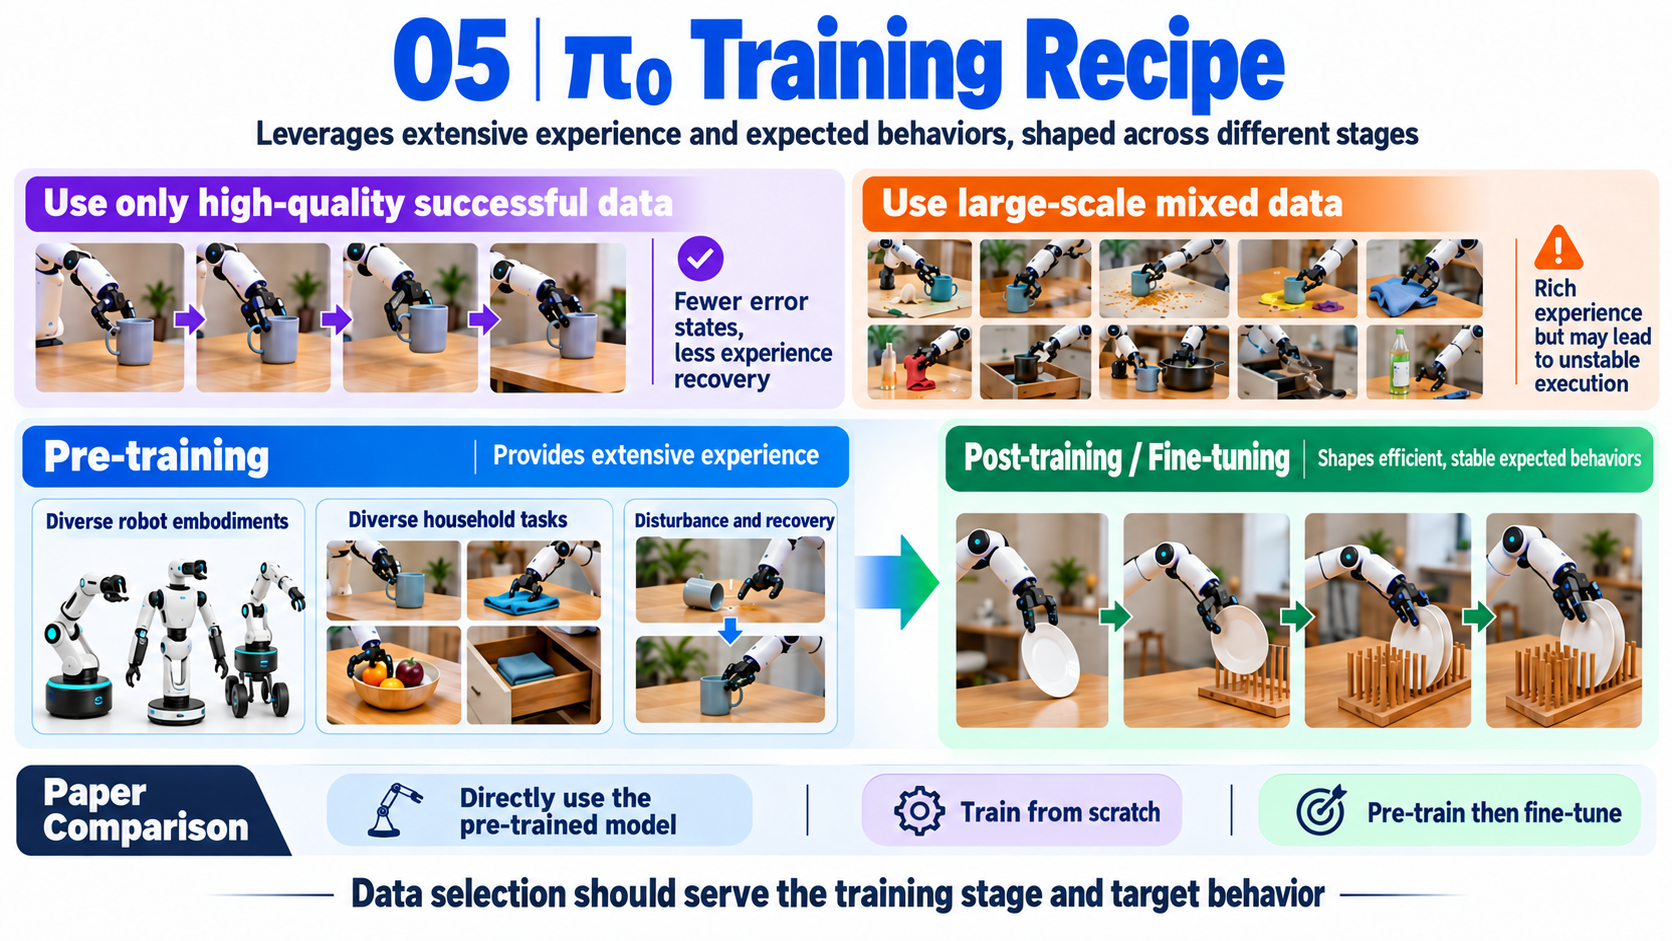
Parágrafo 5: A Receita de Treinamento
-
Ponto principal: Pré-/pós-treinamento dividem o trabalho. Treinar apenas em sucessos bem polidos fornece pouca experiência de erros ou recuperação; usar apenas dados amplos, porém de menor qualidade, pode não produzir execução eficiente. O pré-treinamento amplia a experiência e o pós-treinamento molda o comportamento preferido.
-
Problema levado adiante: “Dados mais limpos são sempre melhores” não é uma regra universal em todas as etapas de aprendizado de robôs.
-
Preparação para os experimentos: Comparar o uso direto do modelo pré-treinado, o treinamento do zero e o fine-tuning após o pré-treinamento.
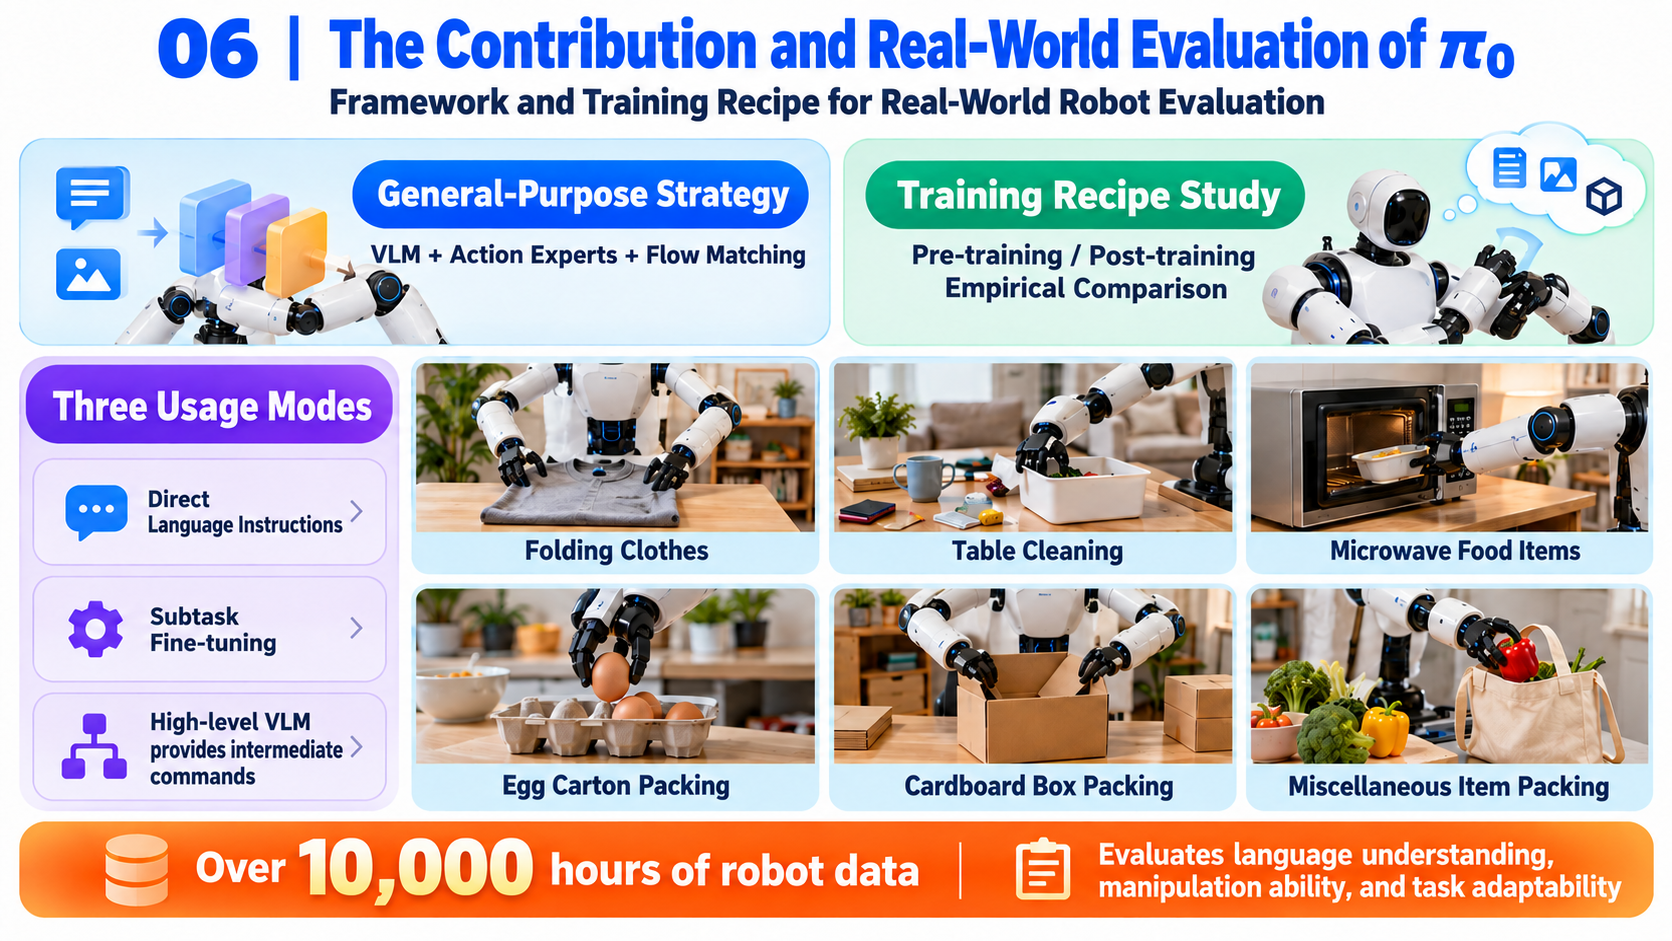
Parágrafo 6: Contribuições e Escopo da Avaliação
-
Ponto principal: As contribuições incluem uma arquitetura generalista baseada em VLM com flow matching e um estudo empírico de receitas de pré-/pós-treinamento. A política oferece suporte a prompting em linguagem natural, fine-tuning para tarefas downstream e instruções intermediárias de um VLM de alto nível.
-
Problema levado adiante: Tanto a arquitetura quanto o treinamento precisam de evidências em robôs reais.
-
Preparação para os experimentos: Mais de 10.000 horas de dados de robôs sustentam avaliações incluindo dobrar roupas, limpar mesas, carregar micro-ondas, embalar cartelas de ovos, montar caixas e ensacar compras.
Trabalhos Relacionados
-
VLAs: RT-2, OpenVLA e Octo transferem representações visão-linguagem para controle de robôs. Muitos usam tokens de ação discretos autoregressivos. π0 mantém um VLM pré-treinado enquanto gera blocos contínuos de alta frequência por meio de conditional flow matching.
-
Modelos de difusão/flow e Transformers multimodais: Diffusion Policy modela ações contínuas multimodais, enquanto Transfusion combina tokens discretos e objetivos generativos contínuos. π0 aplica ideias relacionadas a VLAs, com pesos de imagem-linguagem e estado-ação interagindo por meio de atenção.
-
Aprendizado de robôs em larga escala: Conjuntos de dados anteriores frequentemente focavam em tarefas mais simples de agarrar e empurrar. OXE, Bridge e DROID ampliam a cobertura de tarefas e robôs. π0 adiciona mais de 10.000 horas de dados internos, em grande parte comportamento bimanual hábil, e uma receita de pré-/pós-treinamento em duas etapas.
-
Manipulação hábil: ACT e Diffusion Policy aprendem tarefas precisas a partir de conjuntos de dados menores, mas geralmente são específicos de tarefa e robô. π0, em vez disso, é pré-treinado entre diferentes corpos robóticos e depois usa prompting ou pós-treinamento de alta qualidade em diferentes escalas de dados.
Sistemas e Dados Entre Diferentes Corpos Robóticos
Objetivos de Projeto e Componentes
π0 é um sistema de modelo e dados entre diferentes corpos robóticos, em vez de um controlador preso a um único braço. Seus objetivos são:
-
Compartilhar dados entre robôs de braço único, bimanual e de manipulação móvel.
-
Processar linguagem, observações visuais, estado do robô e ações contínuas em conjunto.
-
Executar diretamente tarefas cobertas ou aprender tarefas difíceis/novas por meio de pós-treinamento.
-
Suportar controle hábil em até 50 Hz.
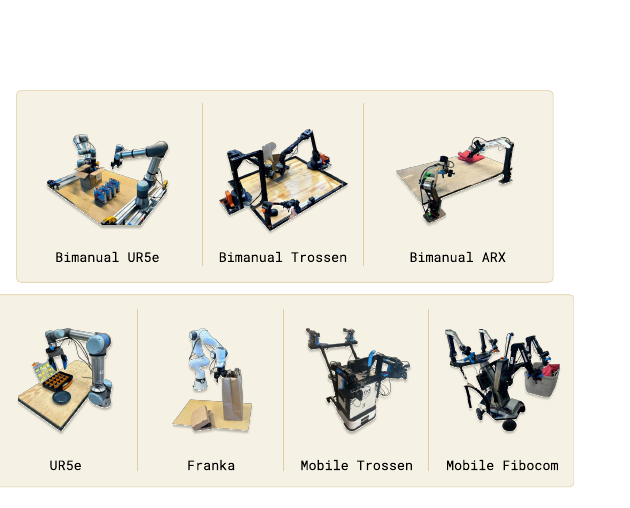
| Categoria de plataforma | Entradas de imagem | Espaço de estado / ação |
|---|---|---|
| UR5e único | Pulso + ombro, duas visões | Estado 7D, ação 7D |
| UR5e bimanual | Três visões | Estado 14D, ação 14D |
| Franka único | Duas visões | Estado 8D, ação 8D |
| Trossen bimanual | Dois pulsos + base, três visões | Estado 14D, ação 14D |
| ARX / AgileX bimanual | Dois pulsos + base, três visões | Estado 14D, ação 14D |
| Trossen móvel / ARX móvel | Dois pulsos + base, três visões | Estado 14D, ação 16D; dois controles extras de base não holonômica |
| Fibocom móvel | Dois braços + base omnidirecional | Estado 14D, ação 17D; dois controles de translação e um de rotação para a base |
Cuidado: Plataformas cinematicamente semelhantes são agrupadas em categorias de configuração. Sete configurações não significam sete robôs físicos, nem apenas sete tipos de robôs no OXE. Os dados internos de destreza cobrem sete configurações; os dados adicionais do OXE cobrem 22 tipos de robôs.
Treinamento e Controle entre Diferentes Corpos (Cross-Embodiment)
O fluxo de trabalho geral é:
Multi-platform teleoperation + open robot data + internet image-text pre-training
                         ↓
          Weighted cross-embodiment data mixture
                         ↓
      Joint training of PaliGemma + π0 action expert
                         ↓
             Generalist π0 base policy
                  ↙                 ↘
        Direct language prompting        High-quality task post-training
                  ↘                 ↙
           Continuous action chunks across platforms
Dois alinhamentos ajustam diferentes robôs em um único modelo:
-
Alinhamento de estado/ação: preenchimento até um máximo de 18 dimensões. Robôs menores usam zeros à direita; 18 dimensões acomodam dois braços de seis DoF, dois garras, uma base móvel e um torso elevável.
-
Alinhamento de imagem: reserva três espaços de imagem e mascara visões ausentes para robôs com apenas uma ou duas câmeras.
Rótulos em linguagem incluem tarefas completas e segmentos curtos, tipicamente de cerca de dois segundos. Instruções segmentadas como “pegue o guardanapo” e “jogue-o no lixo” permitem que um VLM de alto nível decomponha tarefas longas como limpar a mesa enquanto π0 lida com a execução física.
Artigo: Um grupo tarefa–robô com amostras recebe peso . O expoente sublinear reduz a dominância de grupos muito grandes, como tarefas de lavanderia amplamente amostradas.
Sensores, Coleta e Capacidades
Composição dos Dados
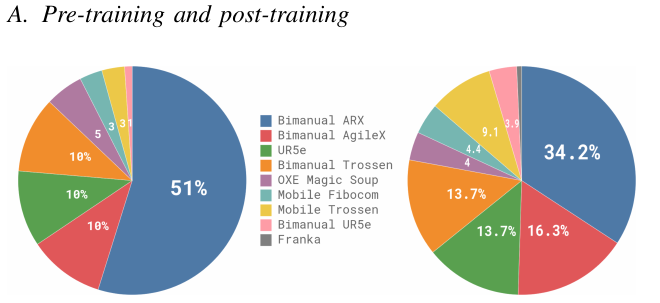
-
Os dados internos contêm 903M timesteps: 106M de robôs de braço único e 797M de robôs bimanuais.
-
Eles cobrem 68 tarefas amplas e sete configurações de robôs.
-
Os dados abertos representam 9,1% da mistura, incluindo OXE, Bridge v2 e DROID.
-
Conjuntos de dados abertos tipicamente têm uma ou duas câmeras e controle de 2–10 Hz, mas grande diversidade de objetos e ambientes.
-
O artigo resume o total de demonstrações de robôs como mais de 10.000 horas.
-
O pós-treinamento de tarefas varia de cerca de cinco horas para tarefas simples até 100 horas ou mais para as tarefas mais difíceis.
Prompting Direto
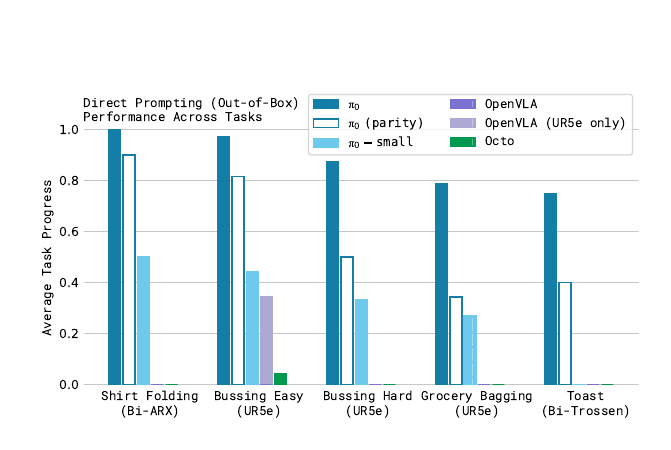
O artigo compara π0, OpenVLA, Octo e π0-small sem inicialização por VLM em dobrar camisa, limpeza de mesa fácil e difícil, ensacamento de compras e tirar torradas de uma torradeira:
-
O π0 completo treinado por 700k passos atinge o maior progresso médio em todas as cinco tarefas.
-
Um modelo de paridade π0 de 160k passos, com atualizações comparáveis às linhas de base, ainda os supera.
-
π0-small geralmente supera OpenVLA e Octo, apoiando o valor da própria arquitetura de blocos contínuos.
-
O π0 completo supera substancialmente o π0-small, apoiando os benefícios do pré-treinamento de VLM para semântica e controle entre tarefas.
Cuidado: OpenVLA e Octo não são treinados pelo mesmo número de épocas que o π0 completo. A comparação de paridade aborda parcialmente a equidade de computação, mas a comparação de modelo completo não é estritamente compatível em termos de computação.
Pós-Treinamento em Novas Tarefas
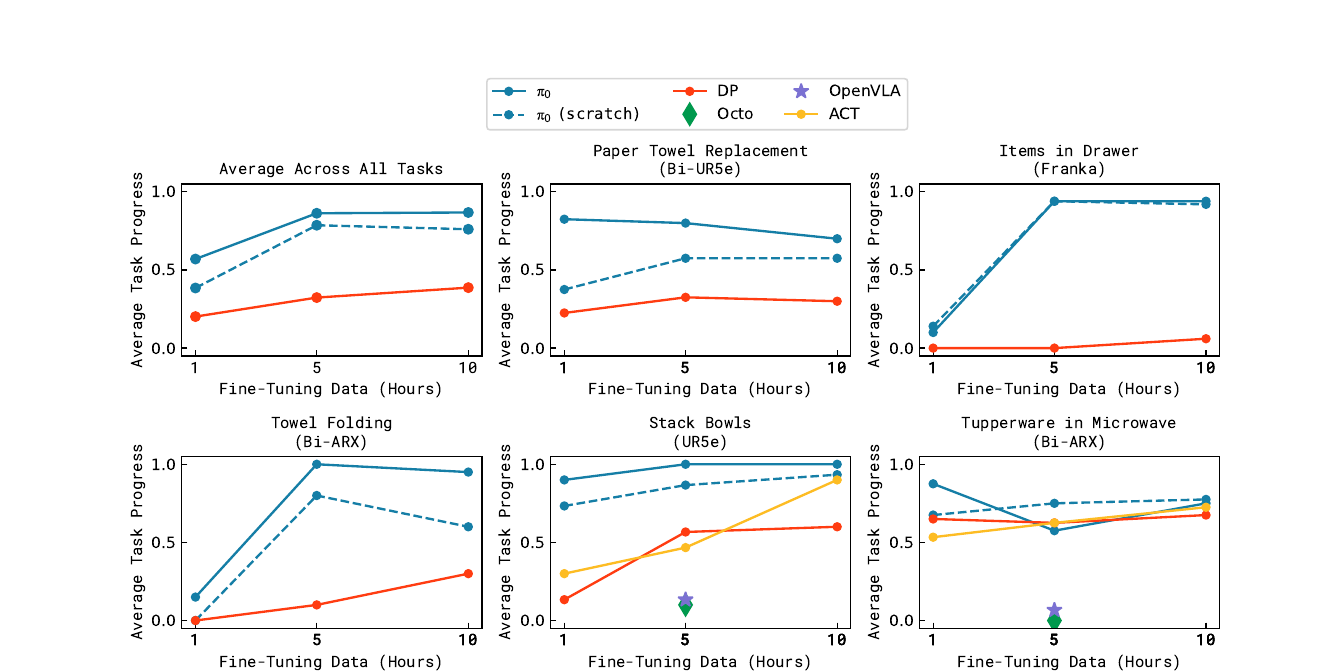
Novas tarefas incluem empilhar tigelas, dobrar toalhas, colocar um recipiente de comida em um micro-ondas, trocar um rolo de papel-toalha e carregamento de gaveta Franka. Cada método é calculado pela média de dez tentativas por tarefa:
-
π0 supera o treinamento do zero e outros métodos no geral e na maioria das tarefas individuais.
-
Dobrar toalhas e empilhar tigelas, que se assemelham a tarefas de pré-treinamento, alcançam progresso substancial com menos dados.
-
Em algumas tarefas, o pré-treinamento quase dobra o desempenho em relação ao treinamento do zero.
-
Os ganhos não são monotônicos em todas as escalas de dados. Para carregamento de micro-ondas, a configuração de cinco horas é próxima da linha de base, enquanto a configuração de uma hora mostra uma vantagem maior.
Tarefas Complexas de Longo Horizonte
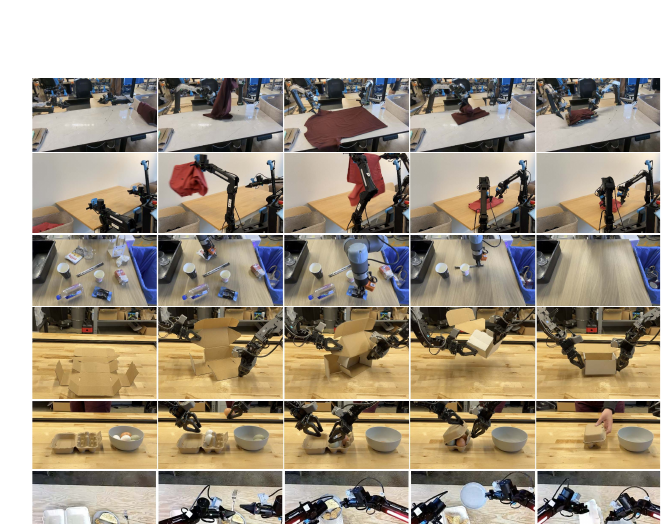
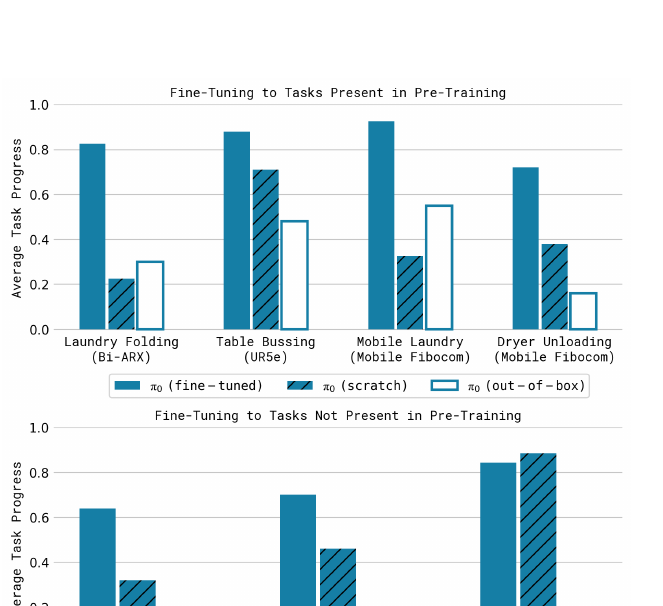
Essas tarefas duram cerca de 5–20 minutos e combinam dezenas de comportamentos de agarrar, empilhar, espalhar e dobrar. Pré-treinamento mais pós-treinamento excede metade da pontuação máxima em todas as tarefas ilustradas e geralmente supera o treinamento do zero ou o uso direto da política pré-treinada. Os benefícios são especialmente aparentes em tarefas difíceis.
Limite das evidências: Nem toda tarefa é resolvida de forma confiável. Os autores ainda não sabem a mistura ideal de pré-treinamento nem quanto e que tipo de dado uma nova tarefa precisa. A transferência para domínios mais distantes, como direção, navegação ou locomoção com pernas, não foi verificada. “Generalista” refere-se às tarefas estudadas e às plataformas de manipulação, não a robôs e ambientes arbitrários.
π0: Um VLA com um Especialista em Ações e Conditional Flow Matching
Ação em Blocos (Action Chunking): Gerar 50 Passos Futuros
π0 modela um bloco de ações em vez de apenas :
O particionamento em blocos atende a duas necessidades:
-
Eficiência de saída em alta frequência: uma inferência produz 50 pontos de controle sem decodificar autoregressivamente um token para cada dimensão de ação.
-
Coerência de trajetória: o modelamento conjunto de blocos representa dependências entre ações contínuas.
Em , isso se reduz à predição de um único passo. Um grande executado totalmente em malha aberta reage lentamente a novas observações. π0 prediz , mas executa 16 ou 25 passos antes de observar novamente, equilibrando o custo de inferência e a frequência de realimentação.
O preenchimento até 18 dimensões é uma interface de treinamento. Apenas as dimensões válidas de um robô específico são enviadas ao seu controlador.
Conditional Flow Matching: Do Ruído às Ações Contínuas
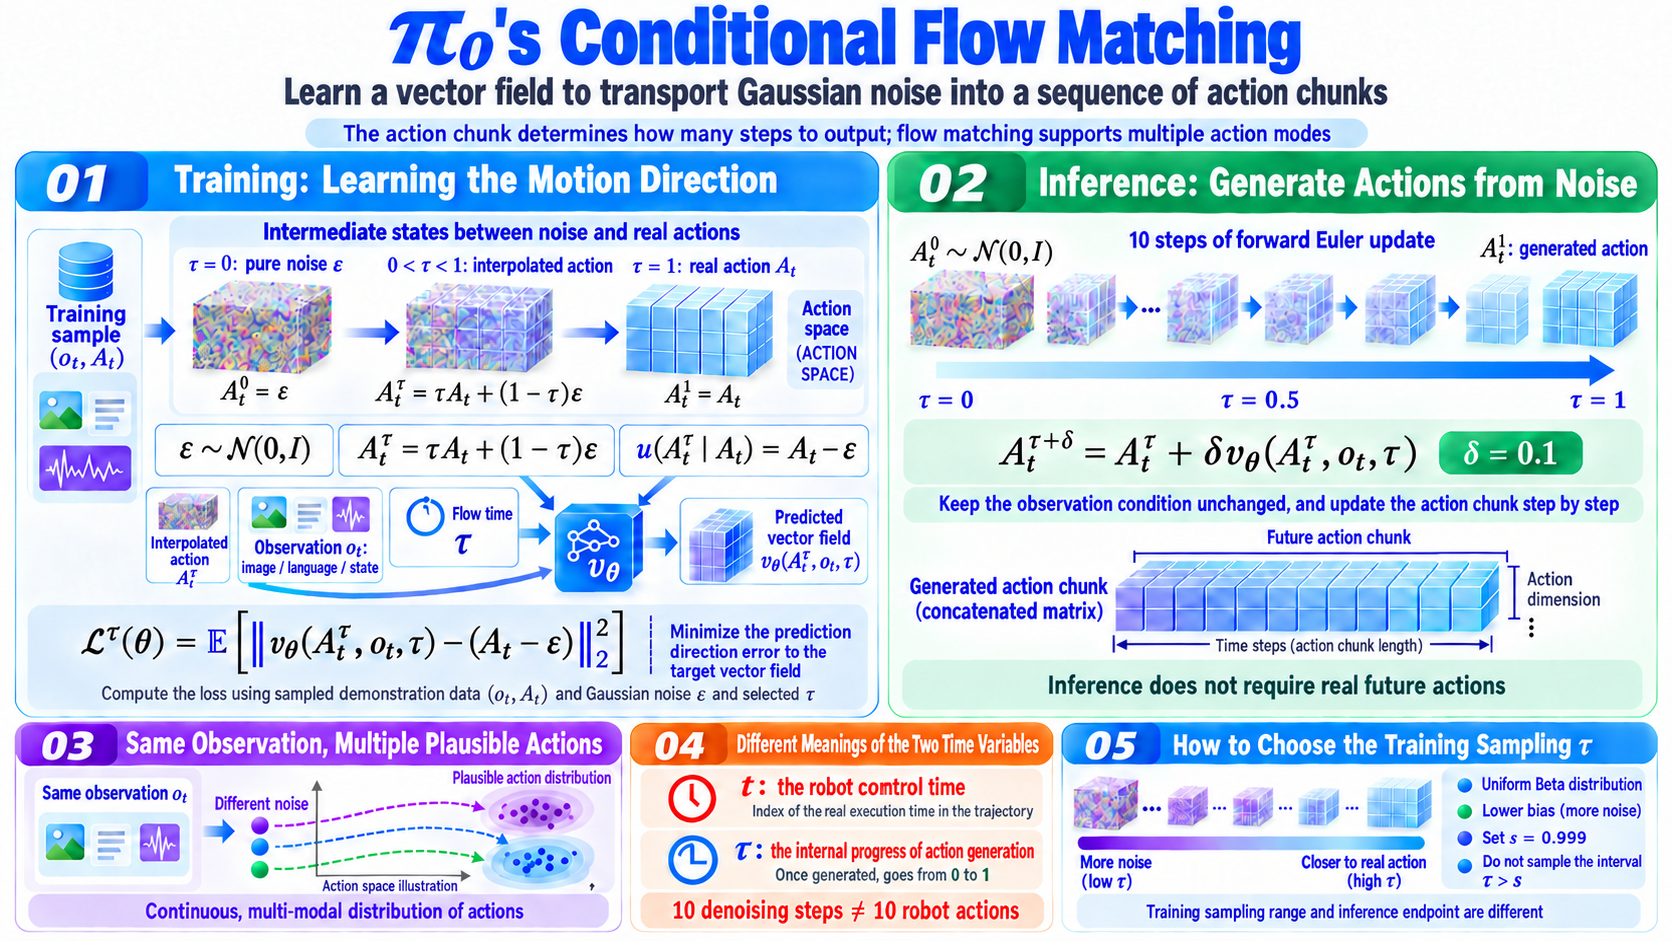
Uma Interface Compartilhada sem Apagar Diferenças de Plataforma
Os robôs diferem em contagem de câmeras, dimensões de estado e dimensões e significados de ação. π0 usa espaços de tamanho fixo:
-
Até três imagens, com visões ausentes mascaradas.
-
Estado e ação preenchidos até 18 dimensões.
-
Um Transformer condicionado em imagens, linguagem, estado e ações demonstradas aprende relações entre combinações de robô–tarefa.
Isso não força a dimensão de ação a significar a mesma quantidade física em todo robô. Ele fornece uma interface fixa enquanto o modelo aprende o comportamento específico da plataforma a partir de observações, distribuições de estado e dados.
Dois especialistas processam diferentes modalidades:
-
Backbone VLM: tokens de imagem e linguagem, herdando o pré-treinamento em escala de internet do PaliGemma.
-
Especialista em ações: estado do robô e blocos ruidosos , especializado em controle contínuo.
Os pesos são separados, mas trocam informações por meio da autoatenção do Transformer. As ações podem, portanto, depender da linguagem e das imagens sem converter todo o VLM em uma rede apenas de ações.
Combinando Pré-Treinamento e Pós-Treinamento
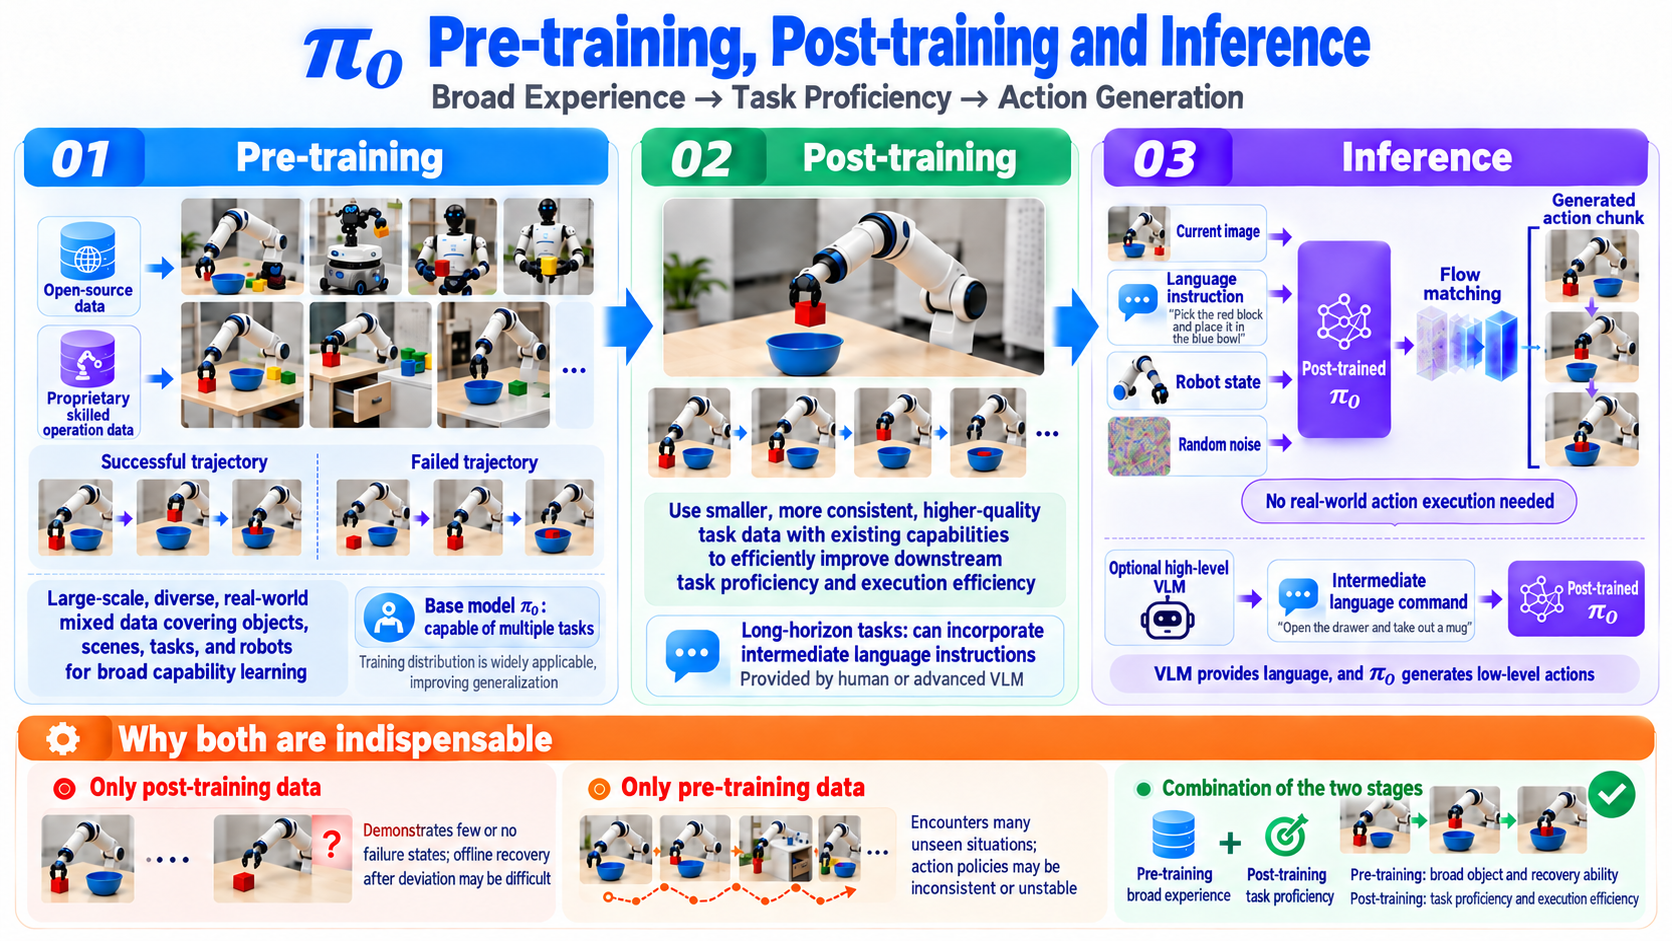
A Rede Completa π0
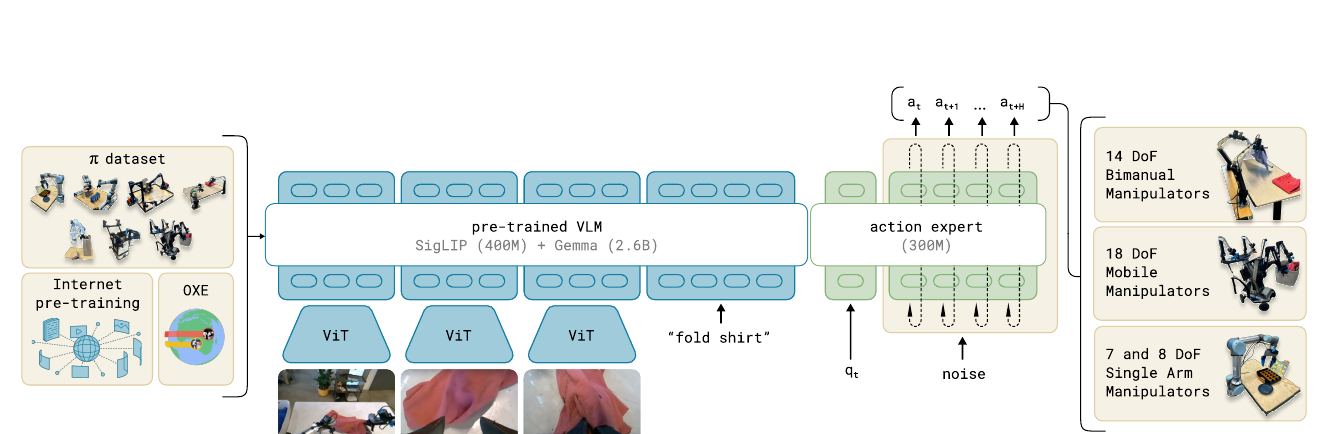
Entradas de Imagem e Linguagem
O codificador SigLIP do PaliGemma converte cada imagem RGB em tokens visuais, e instruções tokenizadas entram com elas no especialista VLM maior. A figura da arquitetura resume aproximadamente 400M de parâmetros do SigLIP e 2,6B de parâmetros do Gemma.
Cuidado: O PDF não informa uma resolução de imagem de entrada unificada nem a contagem exata de tokens visuais por imagem. Essas dimensões não são inferidas aqui a partir de configurações comuns do PaliGemma.
Estado do Robô
O estado é projetado linearmente para a largura de embedding do Transformer e fornecido ao especialista em ações como um bloco de estado separado.
Ações Ruidosas e Tempo de Fluxo
O bloco tem tokens de ação. Cada ação ruidosa é combinada com a codificação senoidal de tempo de fluxo por meio de um MLP:
Esses embeddings entram no especialista em ações. A rede lê as 50 saídas de posição de ação e as projeta linearmente para o campo vetorial .
O tensor máximo de ações é . Apenas as dimensões válidas de cada robô são usadas; o preenchimento não é enviado aos atuadores.
Transformer de Dois Especialistas
-
Backbone PaliGemma: cerca de 3B de parâmetros.
-
Especialista adicional em ações: cerca de 300M.
-
Total: cerca de 3,3B.
-
Especialista VLM: largura 2048, 18 camadas, largura de MLP 16.384.
-
Especialista em ações: largura 1024 e largura de MLP 4096, reduzindo o custo de dez passagens forward de flow matching.
Os especialistas usam pesos separados, enquanto seus tokens interagem na autoatenção de cada camada. Isso se assemelha a uma mistura de especialistas de dois ramos: tokens de imagem/linguagem são roteados para os pesos do VLM e tokens de estado/ação para os pesos do especialista em ações.
Máscara de Atenção em Blocos
A sequência de entrada tem três blocos:
[Images, language] → [Robot state] → [Noisy action chunk]
A atenção é bidirecional dentro de cada bloco. Blocos anteriores não podem ler blocos posteriores; blocos posteriores podem ler o contexto anterior. Isso limita mudanças em relação à distribuição de pré-treinamento do PaliGemma e permite que chaves/valores fixos de imagem, linguagem e estado sejam armazenados em cache ao longo de dez passos de integração, recomputando apenas o sufixo de ações.
Perda de Treinamento
O conditional flow matching minimiza o erro quadrático médio entre os campos vetoriais previstos e de destino, construídos a partir de ações demonstradas e ruído. Ele aprende um transporte condicional do ruído para uma distribuição de ações contínuas plausíveis, em vez de ajustar uma única ação exclusiva.
Fluxo Completo de Dados
Training:
Multi-view images + language + robot state + demonstrated 50-step actions
→ Sample ε and τ; construct a noisy chunk
→ Images/language enter the VLM; state/actions enter the action expert
→ Predict the action vector field
→ Compute flow-matching loss against the target field

Inference:
Multi-view images + language + robot state + random action noise
→ Cache the observation prefix
→ Run ten Euler integration steps with the action expert
→ Obtain a 50-step continuous chunk
→ Execute 16 or 25 steps, depending on platform
→ Observe again and generate the next chunk

In one sentence:
PaliGemma interprets what is visible and what the user wants; the expert turns that understanding into continuous high-frequency control.
Chunking provides efficient, coherent trajectories; flow matching models continuous multimodal actions.
Cross-embodiment pre-training supplies broad experience, and high-quality post-training shapes skilled, stable task execution.