π0.5: Como o Treinamento Conjunto Suporta a Generalização em Mundo Aberto
π0.5: um modelo Visão‑Linguagem‑Ação com generalização em mundo aberto
- Generalização em mundo aberto
- Dados heterogêneos
- Controle hierárquico
- Treinamento conjunto
Pré-requisitos
Como os robôs aprendem a partir de demonstrações
Explicação: Aprendizado por imitação usa a operação humana gravada para aprender como se mover em uma cena específica sob uma instrução.
Um VLA recebe imagens, texto de tarefa e estado do robô e produz ações de controle. Para “coloque o prato na pia”, as imagens localizam o prato, o estado descreve o braço, a instrução define o objetivo e as ações controlam a preensão e a colocação.
π0.5 também prediz uma subtarefa curta, como “pegar o prato”, que então condiciona a geração de ações.
De ações diretas à seleção de subtarefas
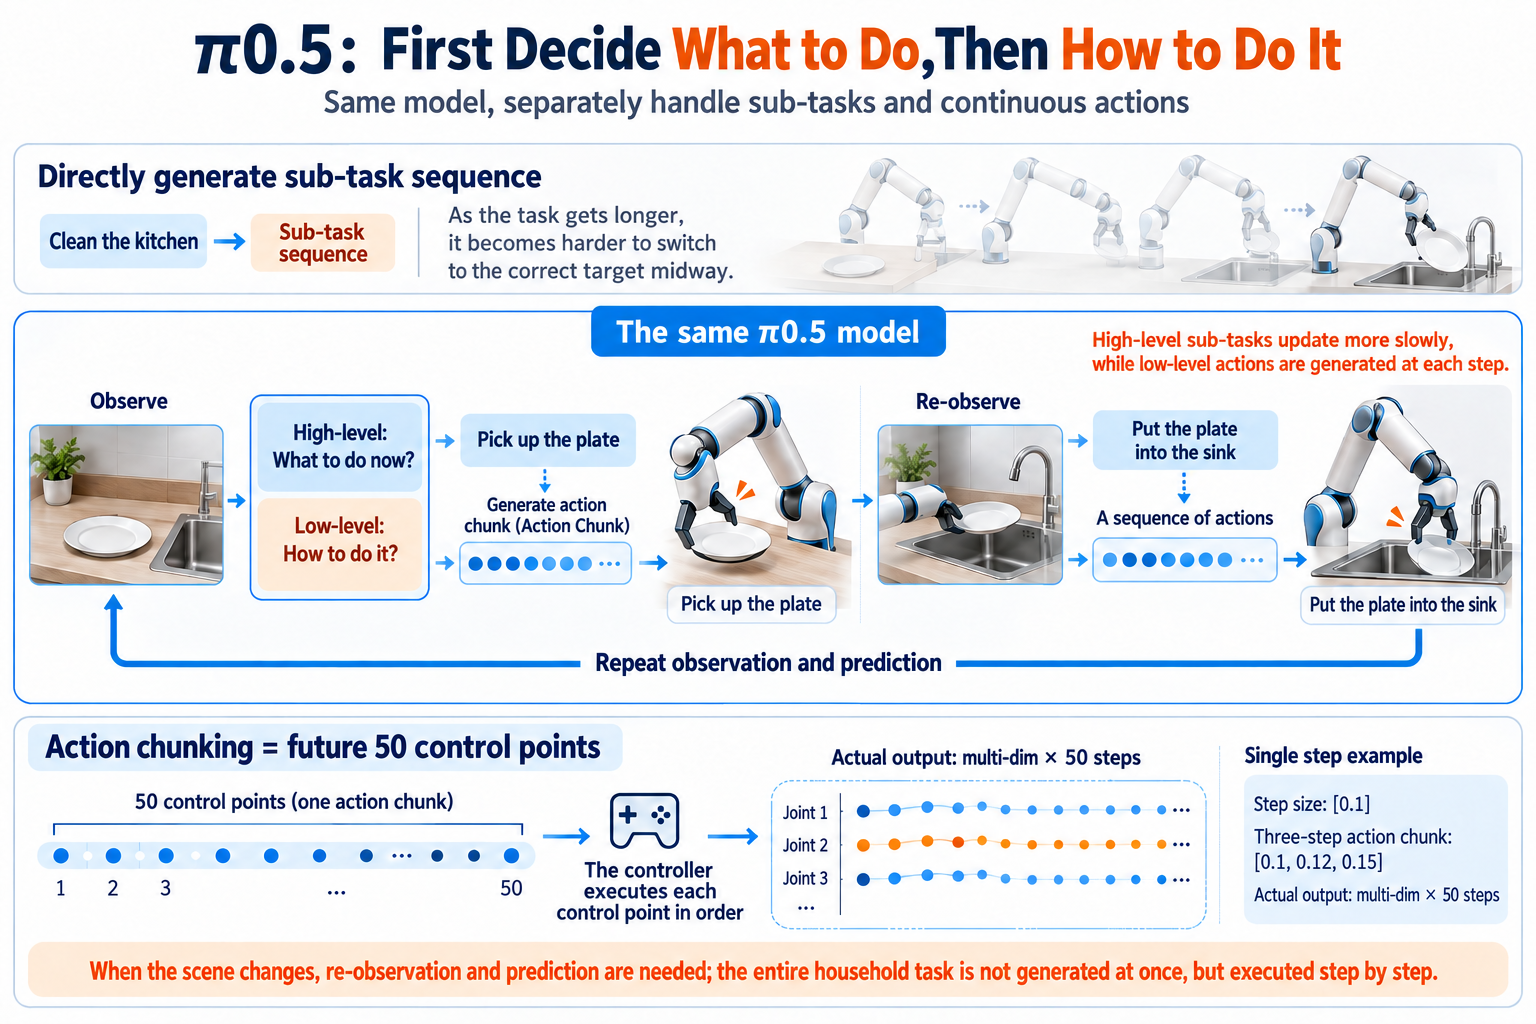
Mapear “limpar a cozinha” diretamente para movimentos de juntas combina decidir o que fazer com decidir como se mover. Tarefas mais longas tornam as transições mais difíceis.
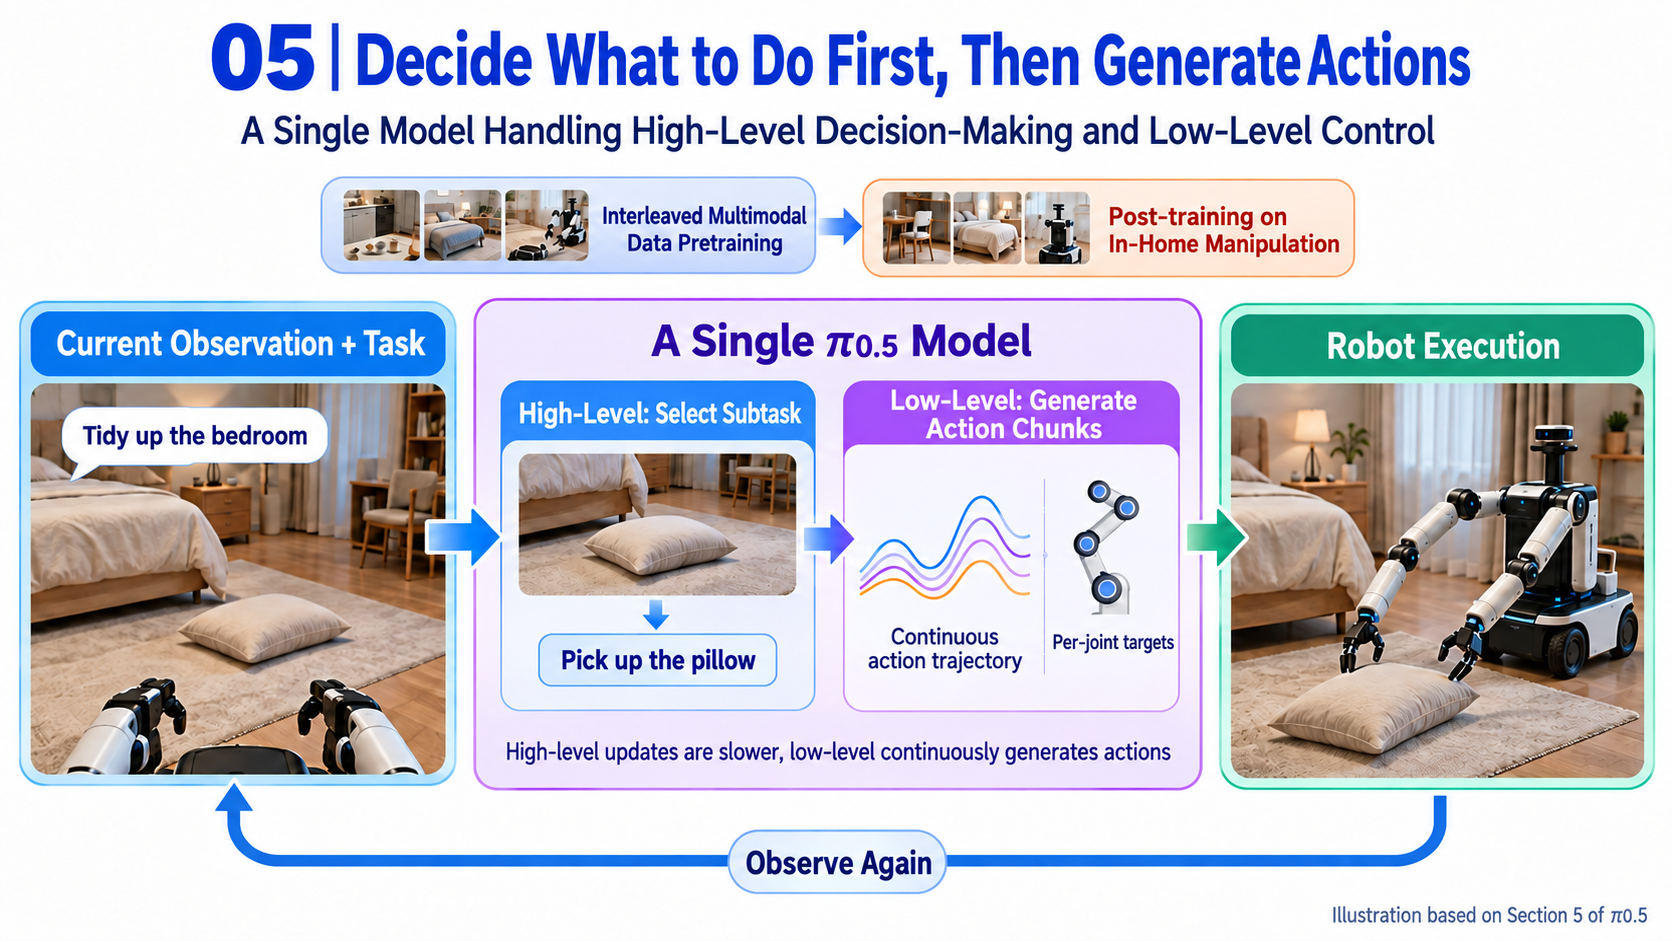
π0.5 separa essas decisões dentro do mesmo modelo: selecionar a subtarefa atual e depois gerar ações contínuas. Por exemplo:
Clean the kitchen → Pick up the plate → Grasping action chunk
Observe again → Put the plate in the sink → Transport action chunk
Artigo: Cada predição cobre 50 pontos de controle futuros, um bloco de ação. Subtarefas de alto nível são atualizadas mais lentamente; o nível baixo gera blocos condicionados a elas, e o controlador executa os pontos sequencialmente.
Exemplo: Uma junta pode ter um alvo de passo único [0.1] ou um bloco de três passos [0.1, 0.12, 0.15]. As saídas reais são multidimensionais e com 50 passos. O robô ainda precisa de novas observações e predições; uma tarefa doméstica inteira não é gerada de uma vez e executada às cegas.
Treinamento, inferência e avaliação
| Etapa | O que acontece |
|---|---|
| Treinamento | Aprende saídas de texto e ação a partir de demonstrações, anotações de subtarefas e dados de imagem‑texto, depois adapta para manipulação móvel doméstica. |
| Inferência | Seleciona uma subtarefa a partir das imagens atuais e da instrução geral, depois gera ações contínuas a partir da subtarefa e do estado. |
| Avaliação | Executa em cômodos reservados e pontua os passos concluídos; testa separadamente se o objeto solicitado e o destino são selecionados. |
Erro de treinamento baixo não garante trabalho doméstico bem‑sucedido; isso exige testes com robôs reais.
Resumo
Tradução
Robôs úteis precisam executar tarefas reais além do laboratório. VLAs mostram fortes capacidades de controle direto, mas a adaptação a ambientes reais desconhecidos permanece uma questão em aberto.
Com base em π0, π0.5 melhora a adaptabilidade por meio de treinamento conjunto em tarefas e fontes heterogêneas: múltiplos robôs, predição semântica de alto nível e dados da web. Amostras combinam imagens, instruções, detecção de objetos, predição de subtarefas e ações de baixo nível.
Os experimentos sugerem que a transferência entre essas fontes de conhecimento é importante para a generalização. Os autores descrevem um sistema aprendido de ponta a ponta executando tarefas longas e hábeis de limpeza de cozinha e quarto em casas totalmente inéditas, e o reivindicam como o primeiro sistema com essa combinação de capacidades.
Comentário
-
A questão central é se o robô funciona em outra casa. Pegar um prato em uma sala de treinamento é diferente de encontrar um, escolher o próximo passo e colocá‑lo na pia de uma cozinha desconhecida.
-
As fontes servem a propósitos diferentes. Outros robôs fornecem experiência de manipulação, dados de imagem‑texto fornecem conhecimento de objetos e cenas, e anotações de subtarefas ensinam organização de tarefas.
-
“Primeiro” é a reivindicação dos autores. Avalie o escopo da avaliação e as comparações em vez de tratar a formulação como solução para toda tarefa doméstica.
Introdução
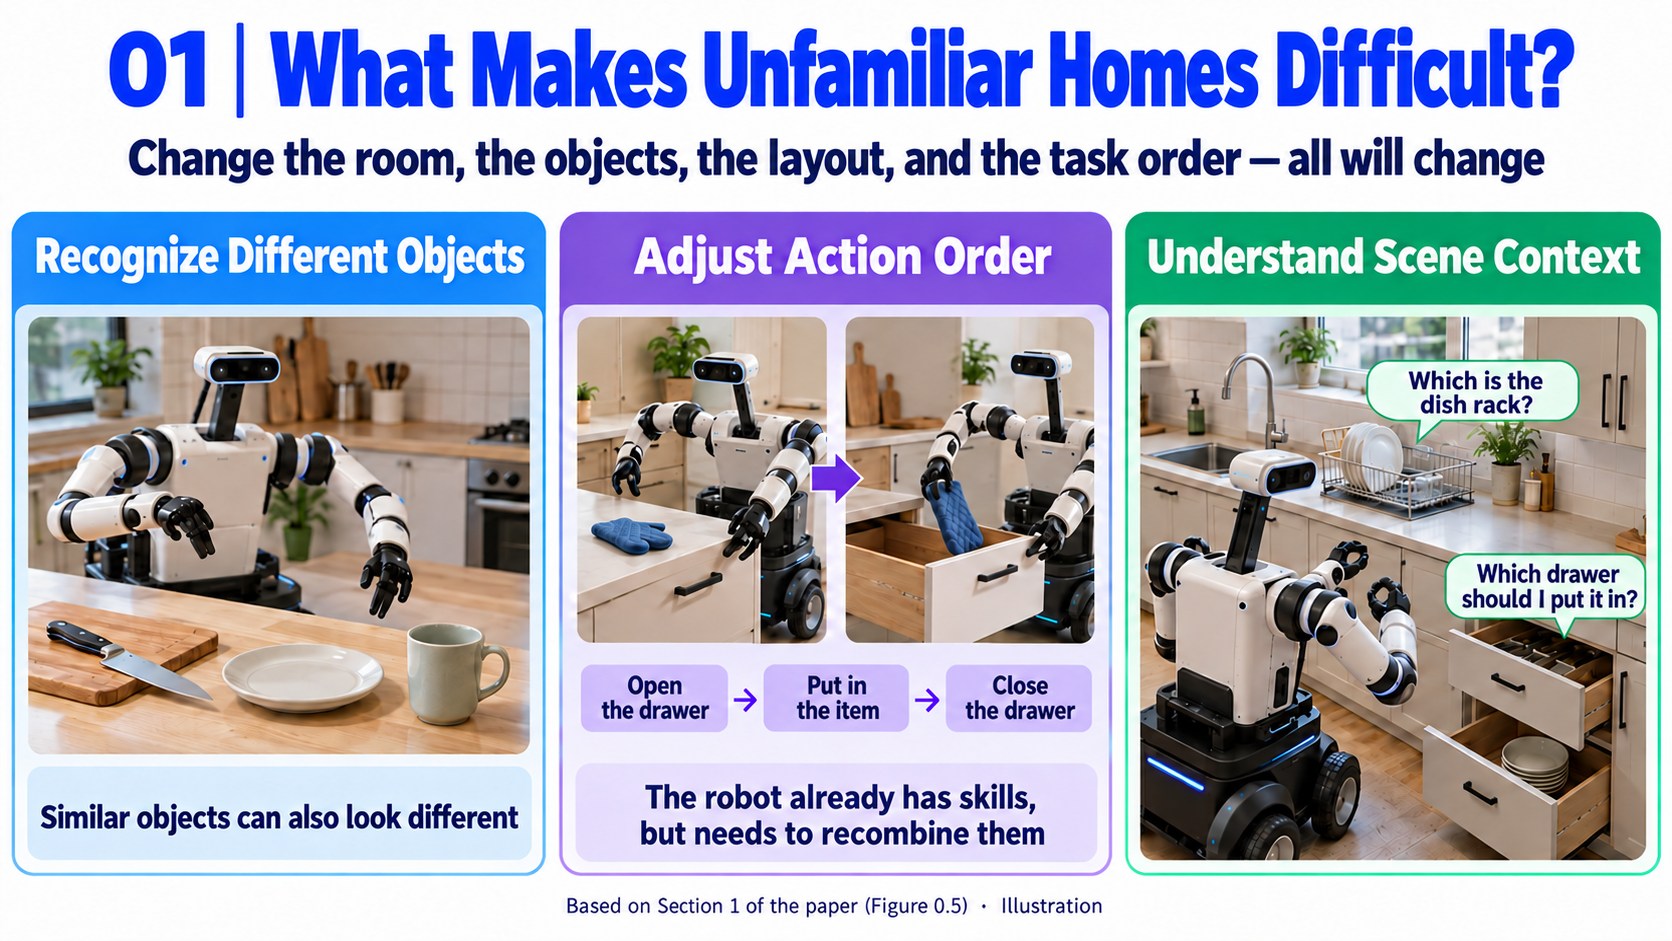
Parágrafo 1: Ambientes desconhecidos são difíceis
-
Conteúdo: Fora do laboratório, robôs enfrentam objetos diferentes, ordenações de habilidades diferentes e propósitos de cena diferentes.
-
Problema: Sucesso em uma cena fixa é insuficiente para o mundo real.
-
Configuração: A receita de treinamento deve cobrir vários níveis de capacidade.
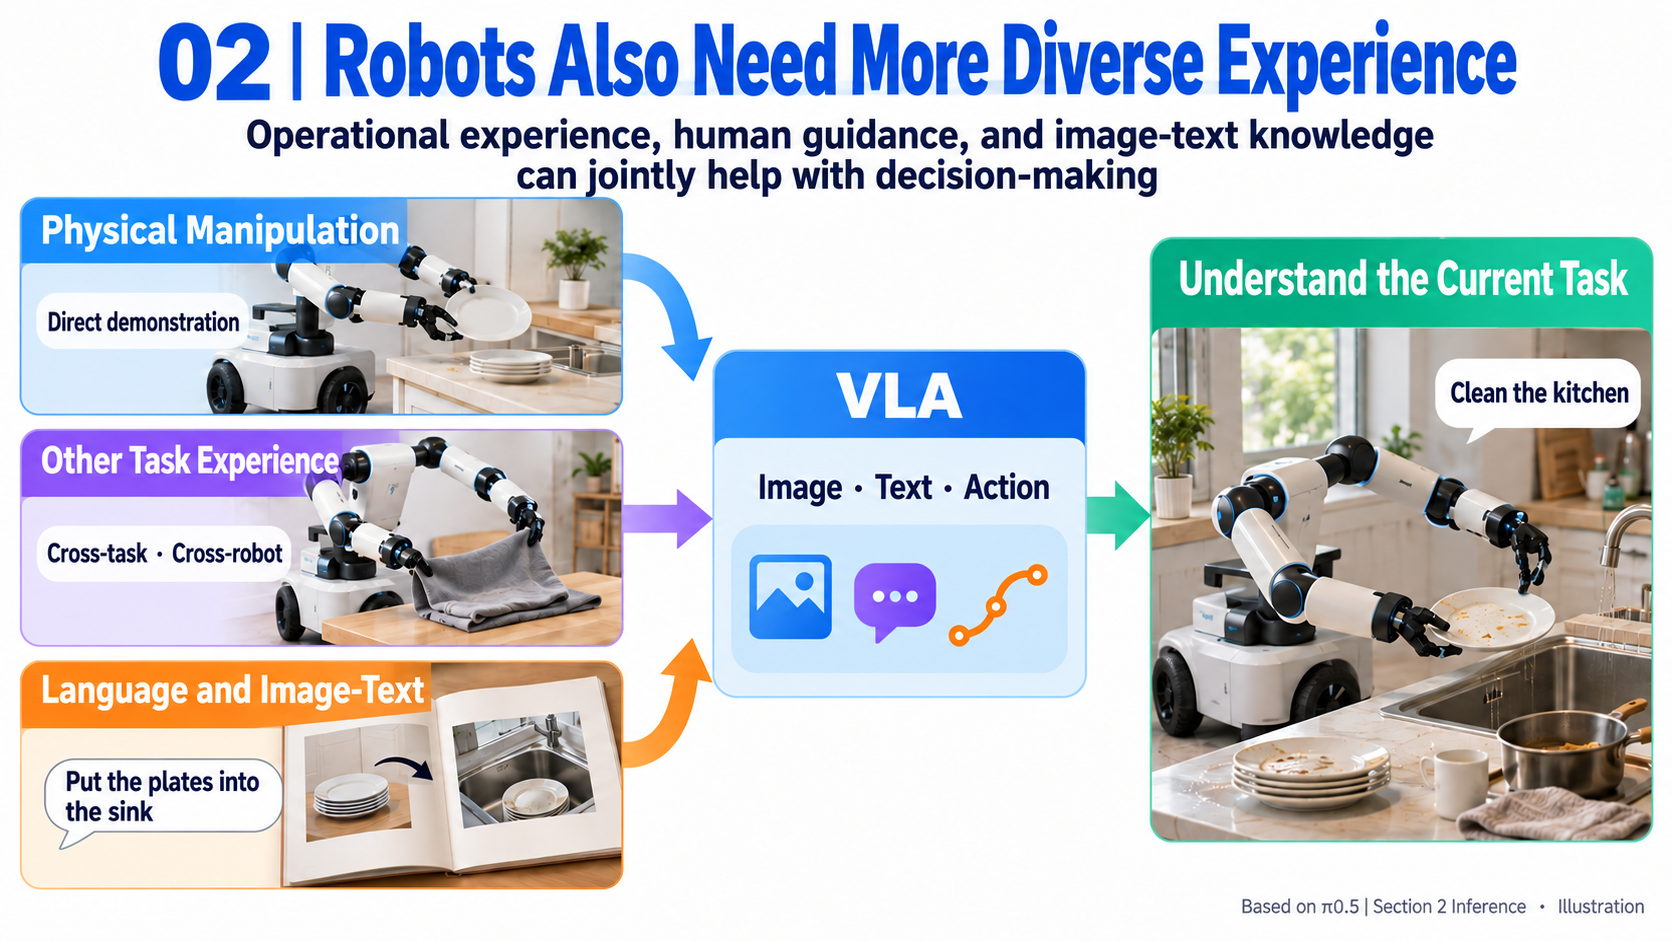
Parágrafo 2: Por que usar experiências diferentes?
-
Conteúdo: As pessoas combinam experiência direta, conhecimento de outros e lições de outras tarefas. Robôs também devem usar múltiplas fontes.
-
Problema: Demonstrações do robô‑alvo não podem cobrir todas as situações do mundo real.
-
Configuração: VLAs fornecem uma interface compartilhada para imagens, texto e ações.
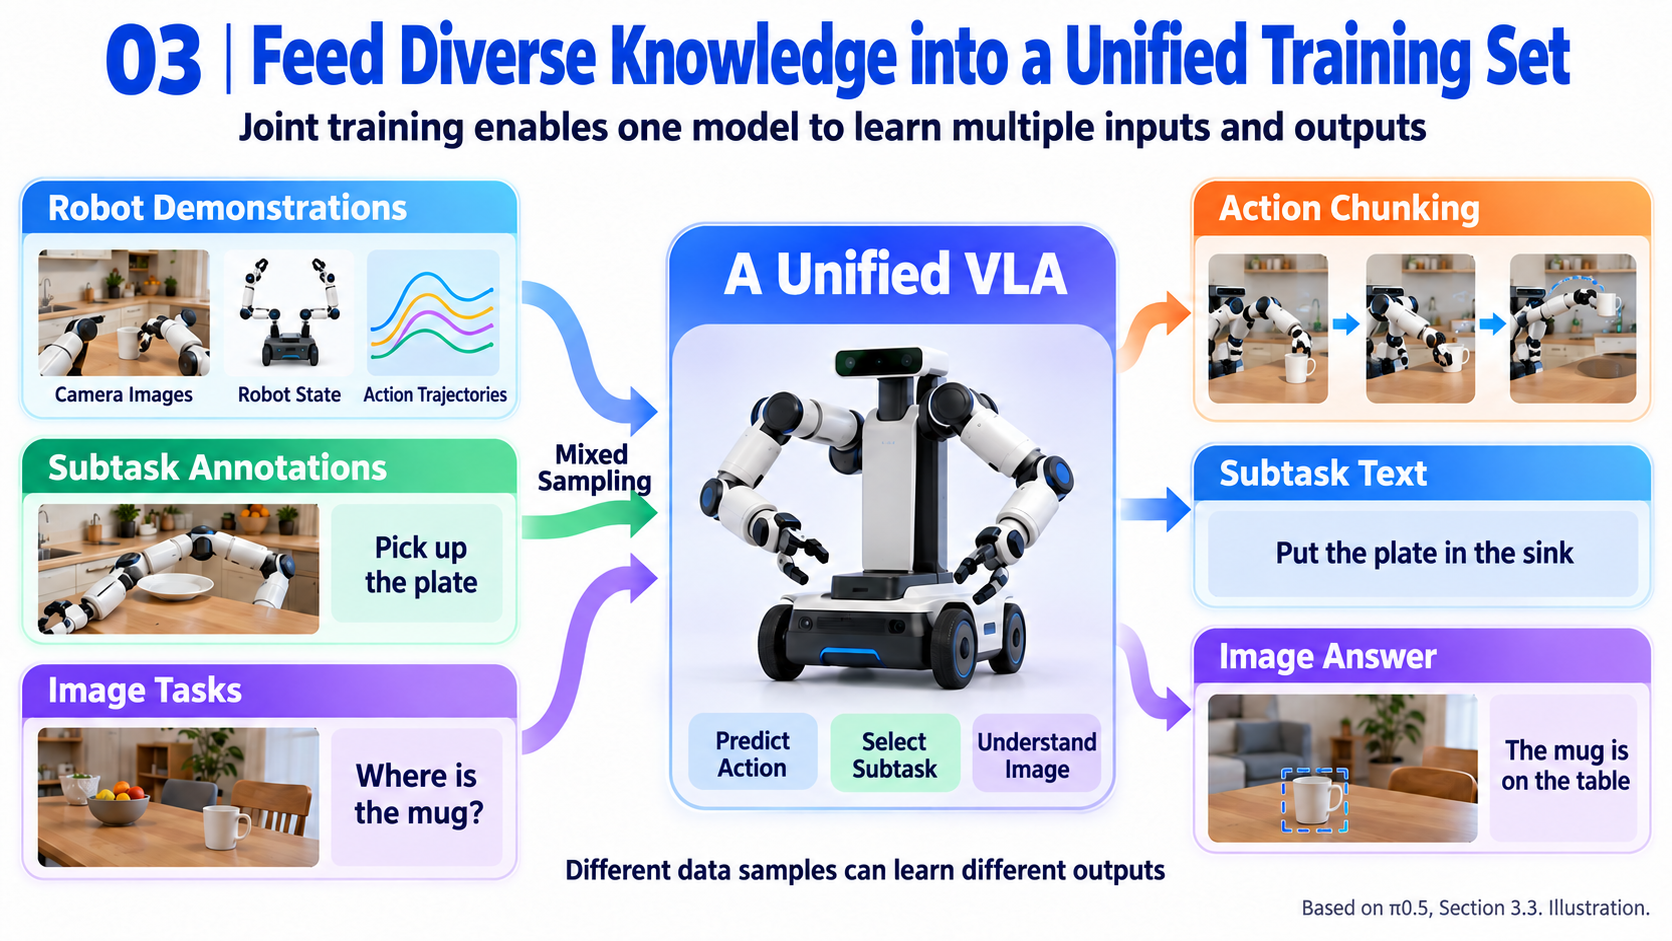
Parágrafo 3: Um framework de treinamento conjunto
-
Conteúdo: Os autores propõem treinar conjuntamente um VLA em diferentes tipos e fontes de conhecimento.
-
Problema: Transformar a motivação anterior em uma abordagem concreta de pesquisa.
-
Configuração: Introduzir π0.5 e sua composição de dados.
Parágrafo 4: A receita de dados
-
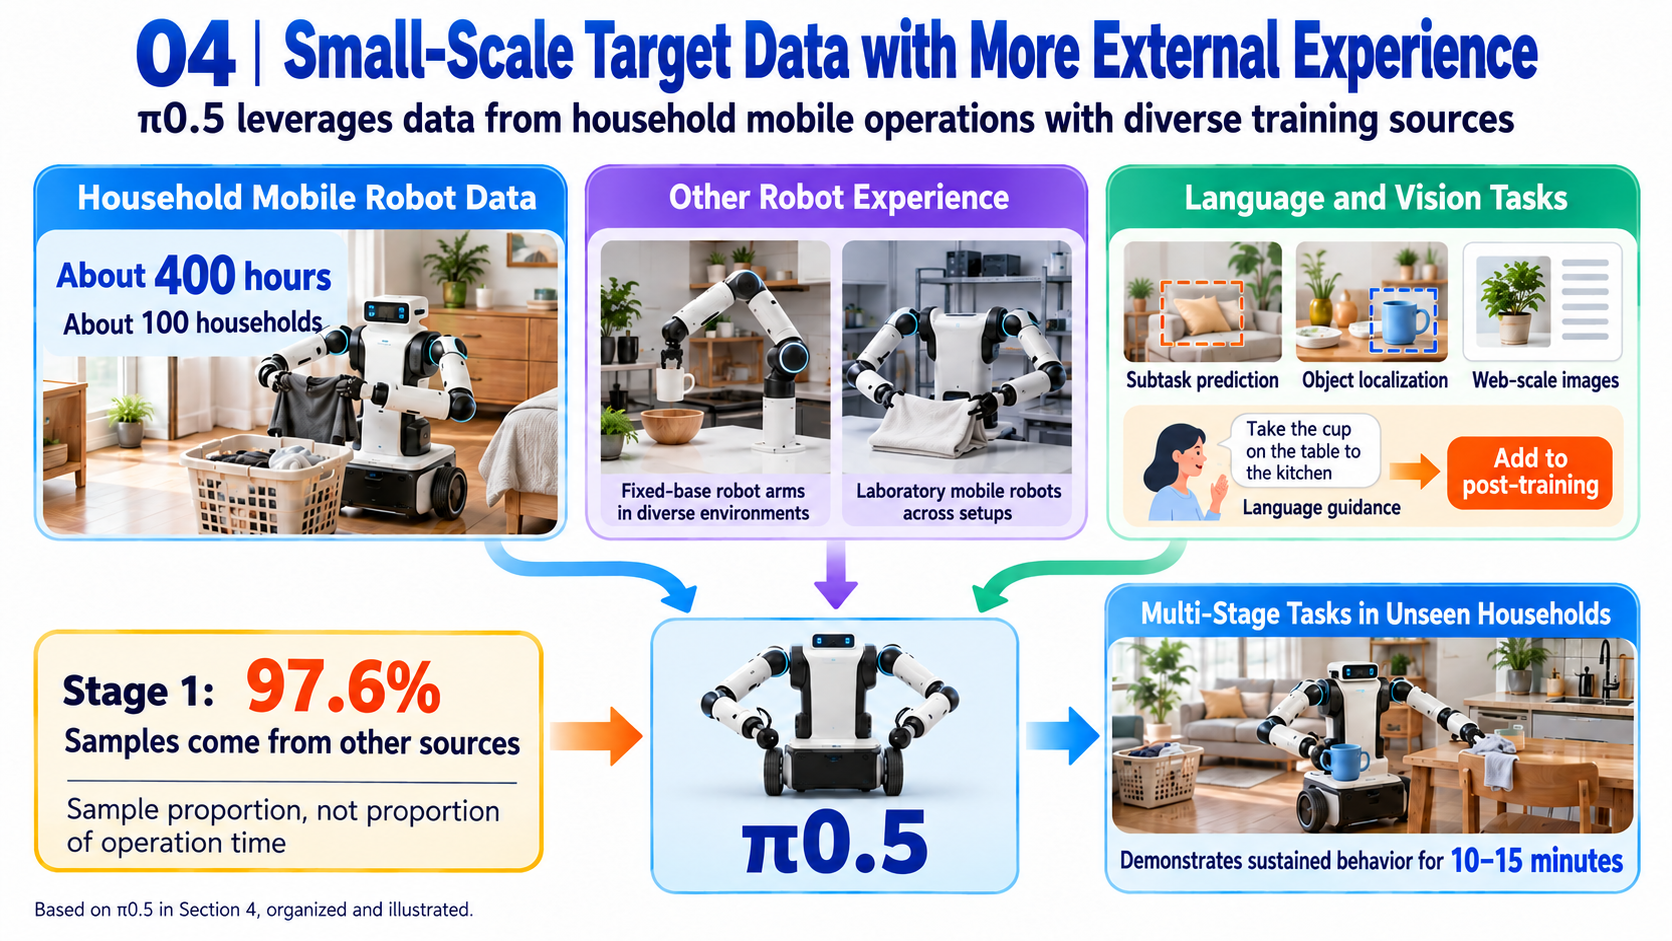
Conteúdo: Estender π0 com cerca de 400 horas de dados de robô móvel doméstico mais outros robôs e tarefas de imagem‑texto. No estágio 1, 97,6% das amostras de treinamento vêm de fora dos dados‑alvo de manipulação móvel doméstica.
-
Problema: Como essas fontes podem ajudar conjuntamente o robô‑alvo?
-
Configuração: Demonstrar comportamento de 10–15 minutos em casas desconhecidas e depois ablar as fontes. O valor de 97,6% é uma proporção de amostras, não de duração.
Parágrafo 5: Execução hierárquica
-
Conteúdo: Após o pré‑treinamento heterogêneo, faz‑se pós‑treinamento para manipulação móvel. O mesmo modelo seleciona subtarefas e produz ações, com atualizações de alto nível menos frequentes.
-
Problema: Tarefas longas exigem tanto escolhas corretas do próximo passo quanto execução precisa.
-
Configuração: Explicar como diferentes fontes apoiam o julgamento de cena e o controle.
Parágrafo 6: Contribuições e validação
-
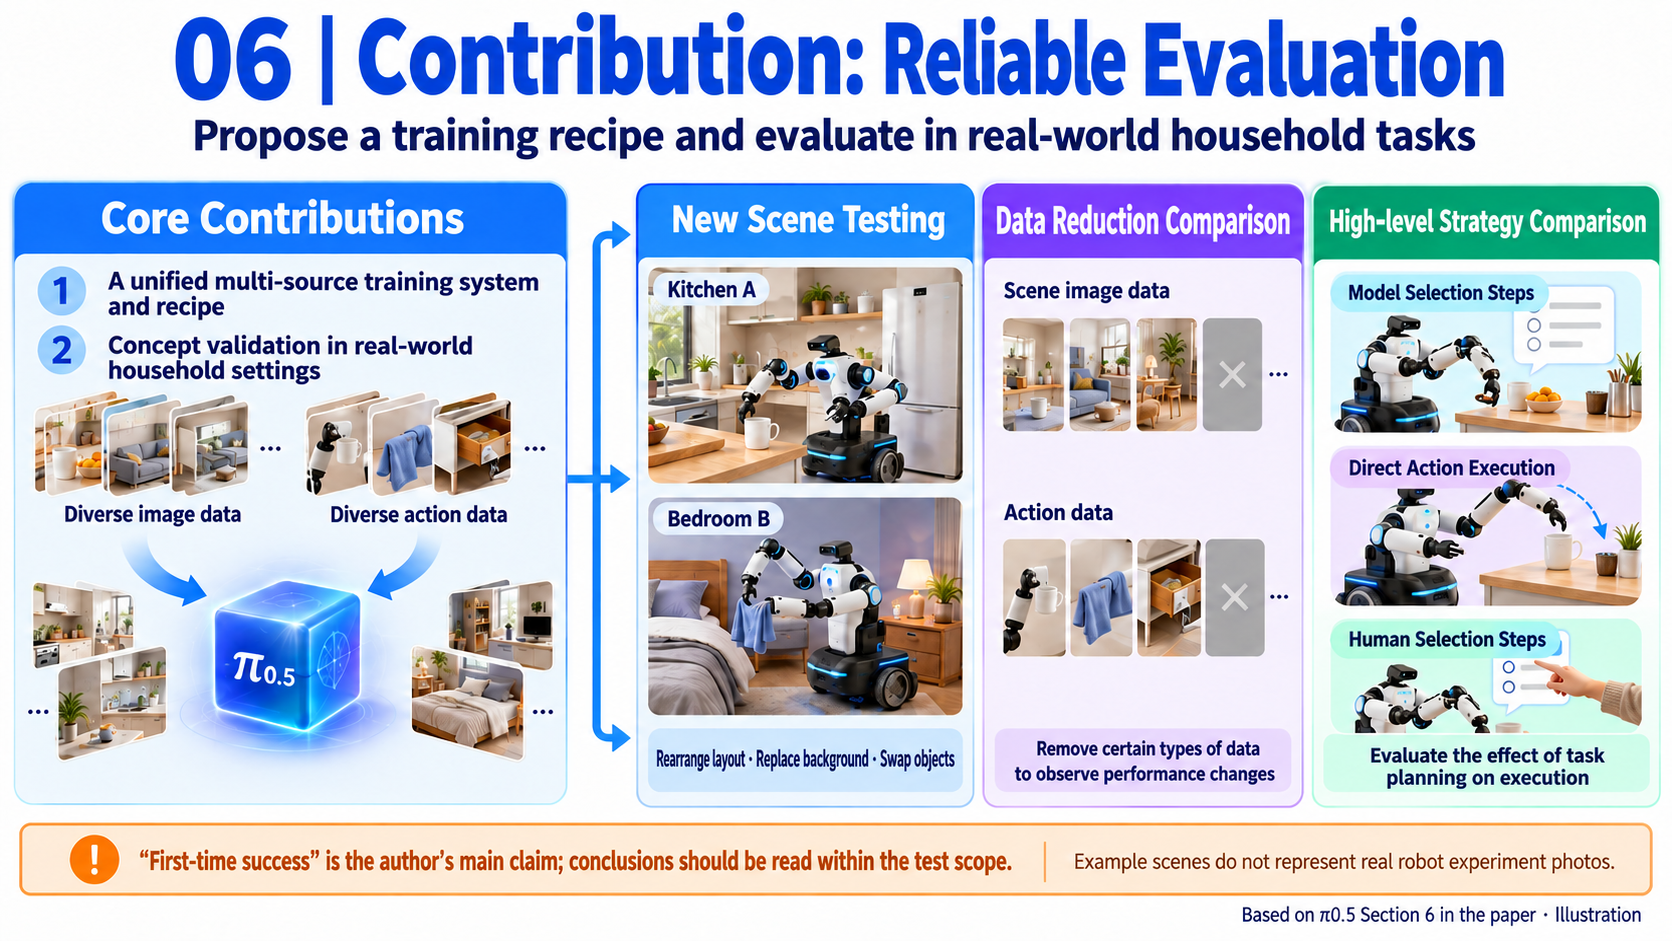
Conteúdo: A contribuição é o sistema π0.5 e a receita de treinamento, com uma prova de conceito em casas inéditas.
-
Problema: Os experimentos precisam estabelecer se o treinamento conjunto realmente melhora a adaptabilidade.
-
Configuração: Testar novas cenas, remover fontes de dados e comparar políticas de alto nível. A formulação de “primeiro” continua sendo uma reivindicação dos autores.
Trabalhos relacionados
-
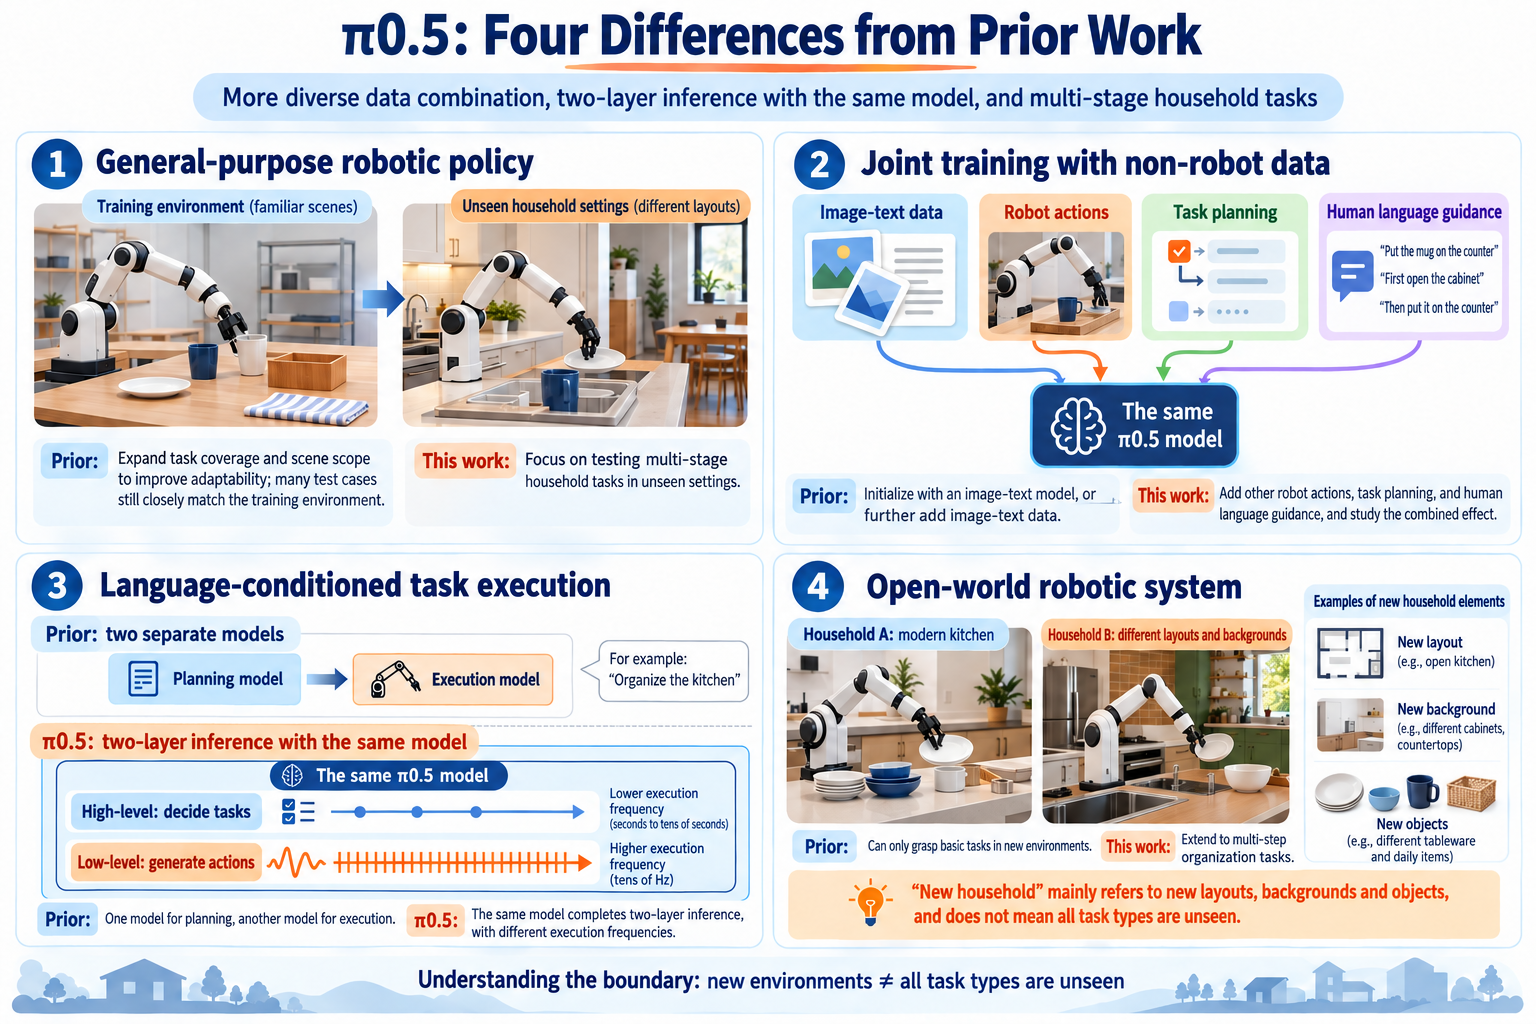
Políticas generalistas de robôs: Trabalhos anteriores ampliam a cobertura de tarefas e cenas, mas muitos testes permanecem próximos às condições de treinamento. Este artigo enfatiza tarefas domésticas em múltiplas etapas em casas desconhecidas.
-
Treinamento conjunto com dados não robóticos: Trabalhos anteriores inicializam ou continuam o treinamento com dados de imagem‑texto. Aqui, ações de outros robôs, predição de subtarefas e orientação em linguagem humana são combinadas e avaliadas.
-
Organização de tarefas baseada em linguagem: Um design comum separa modelos de planejamento e de execução. π0.5 usa um único modelo para ambos os níveis, embora eles rodem em frequências diferentes.
-
Sistemas de mundo aberto: Robôs anteriores executam tarefas básicas como preensão em novos cenários. Este trabalho estende para arrumação em múltiplos passos; novas casas significam principalmente novos layouts, fundos e objetos, não categorias de tarefas totalmente inéditas.
Plataformas de Robô e Dados
Objetivos e Componentes
Artigo: Duas plataformas móveis bimanuais são usadas, visando um único modelo que possa organizar e limpar diferentes casas.
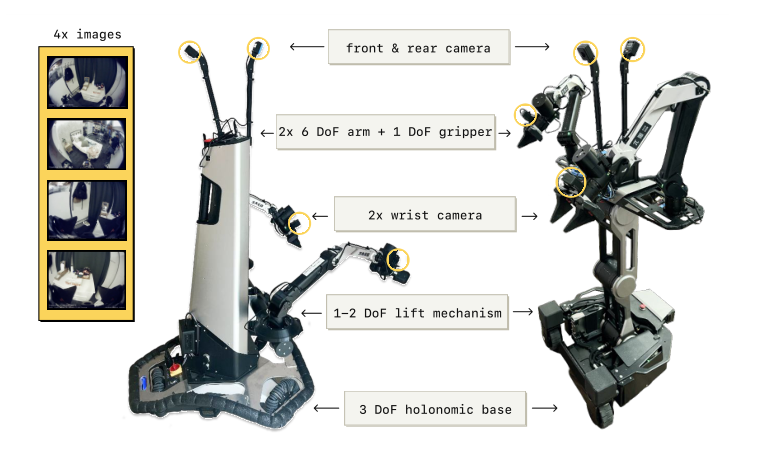
| Componente | Configuração e função |
|---|---|
| Braços e garras | Seis graus de liberdade de movimento mais um controle de garra por braço, 14 dimensões no total. |
| Base móvel | Duas velocidades translacionais e uma rotacional, três dimensões no total. |
| Mecanismo de elevação | Uma ou duas dimensões para ajuste de altura ou frente-trás. |
| Estado e ação | 18 ou 19 dimensões, dependendo da plataforma. |
| Câmeras | Quatro visões RGB: frontal, traseira e dois pulsos. |
As saídas são posições-alvo para braços, garras e elevação, além de velocidades da base. Um controlador PD simples as acompanha; o sistema descrito não possui módulo adicional de planejamento de trajetória ou detecção de colisão.
Explicação: Os braços manipulam, enquanto mobilidade e elevação estendem o alcance. O hardware por si só não estabelece a capacidade de tarefa; os experimentos é que o fazem.
Conectando Operação e Registro
As demonstrações registram imagens, estados e ações. Tarefas de múltiplas etapas também recebem anotações humanas de subtarefas e localização de objetos. O pós-treinamento adiciona demonstrações em linguagem: um especialista seleciona a próxima instrução e uma política de baixo nível já treinada a executa.
Expert selects “pick up the pillow” → Low-level policy executes → Record the images and chosen instruction
Explicação: Esses registros supervisionam diretamente o que fazer em seguida, em vez de apenas como as juntas se movem. Eles assumem que a política de baixo nível já consegue executar a subtarefa. Na implantação, o modelo seleciona os passos por conta própria.
Sensores, Coleta e Capacidades
Decisões de alto nível usam as quatro visões; ações de baixo nível usam a visão frontal e as duas dos pulsos. Os alvos de controle são executados a 50 Hz, o que não significa rodar o modelo completo 50 vezes por segundo.
Cerca de 400 horas de demonstrações móveis vêm de aproximadamente 100 casas. Outras fontes incluem braços domésticos estacionários, robôs de laboratório e OXE. Resoluções de imagem, taxas de amostragem por fonte e durações das demonstrações não são especificadas de forma uniforme; a taxa de controle de 50 Hz não preenche essas lacunas.
Os comportamentos demonstrados incluem coleta de roupas, colocação de pratos, organização de gavetas, arrumar a cama e pendurar toalhas. Testes quantitativos em casas reais cobrem três casas inéditas, focando em tarefas de carregar gavetas, roupas-para-o-cesto e louça-para-a-pia; comparações controladas também incluem arrumar a cama.
Co-Treinamento Heterogêneo e Ações Hierárquicas
Selecionar Primeiro a Subtarefa Atual
“Limpar o quarto” não especifica o que agarrar agora. O modelo deve inspecionar a cena, escolher o próximo passo e condicionar a geração de ações a ele.
Duas relações condicionais resumem isso:
Current images + state + overall task → Subtask s
Current images + state + subtask s → Action chunk A
Aqui, s é um texto como “pegar o travesseiro”, e A é uma sequência de controle. Na fatorização do artigo, ações de baixo nível dependem da subtarefa em vez de depender diretamente da instrução geral.
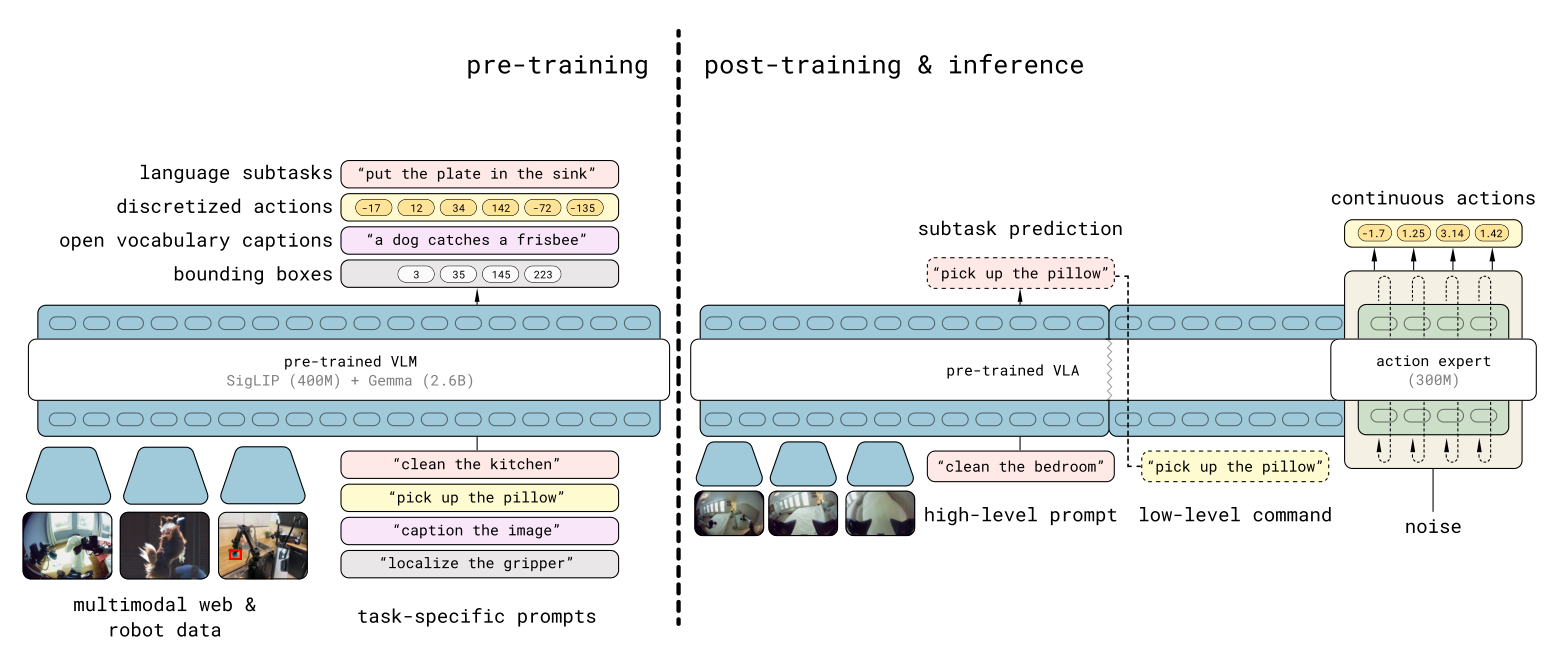
Um travesseiro no chão pode levar a “pegá-lo”, seguido de “colocá-lo na cabeceira da cama”. Se a escolha de alto nível estiver errada, movimentos precisos ainda podem executar a tarefa errada. Abrir e fechar gavetas repetidamente é uma falha observada.
Ações Codificadas para Treinamento, Ações Contínuas para Execução
O modelo precisa de aprendizado eficiente e controle oportuno e preciso, então as etapas usam representações diferentes.
-
Pré-treinamento: FAST comprime ações contínuas em símbolos discretos, aprendidos junto com texto por meio de predição do próximo token.
-
Pós-treinamento: Adicionar um especialista em ações treinado com flow matching, mantendo a predição de texto e de ações discretas.
-
Execução: Gerar o texto da subtarefa de forma autoregressiva e então usar dez atualizações a partir de uma inicialização aleatória para obter um bloco contínuo.
Para 50 passos futuros e 18 controles por passo, o controlador no fim precisa de um arranjo numérico 50 × 18, não de texto. Treinamento codificado seguido de controle contínuo é uma distinção importante entre as etapas.
Explicação: O comprimento do bloco controla o horizonte de predição; a contagem de atualizações controla o refinamento interno. Predição de passo único não tem planejamento dentro do bloco, enquanto horizontes longos encontram mais mudanças de cena. O artigo usa 50 pontos de controle e dez atualizações sem estabelecer sistematicamente que sejam ótimos para todo robô.
A geração conjunta de blocos não elimina a necessidade de realimentação. O artigo não fornece uma fração de execução universal para todas as plataformas, e o agrupamento temporal ao estilo ACT não é seu mecanismo central.
O que Cada Fonte de Dados Adiciona
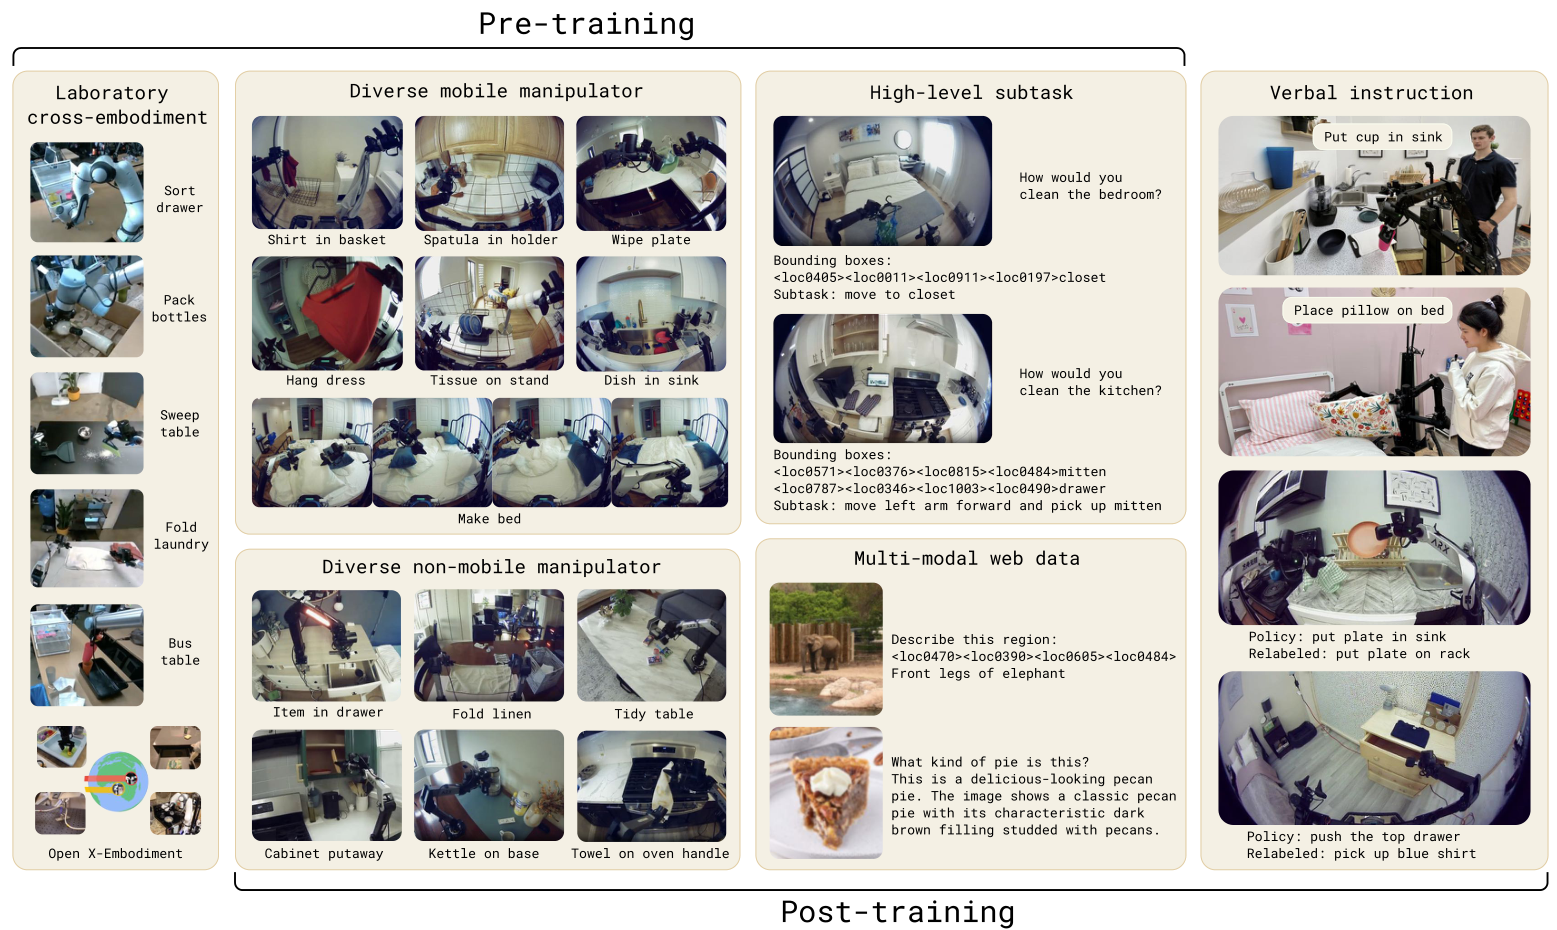
| Dados | Oportunidade de aprendizado |
|---|---|
| Dados de robôs móveis domésticos | Combinar movimento, elevação e manipulação bimanual em casas reais. |
| Braços estacionários em diferentes ambientes | Mais casas, objetos e cenas de manipulação. |
| Dados de laboratório entre robôs | Mais habilidades e tarefas. |
| Anotações de subtarefas | Escolher o próximo passo e localizar objetos relevantes. |
| Dados web de imagem-texto | Manter capacidades de reconhecimento, compreensão de cena e linguagem. |
| Demonstrações em linguagem por especialistas | Conduzir uma política de baixo nível existente por tarefas de múltiplas etapas. |
Essas fontes treinam um único modelo; a execução não percorre ciclicamente os conjuntos de dados. Amostras diferentes pedem saídas diferentes: um par imagem-pergunta-resposta não precisa de ações de robô fabricadas.
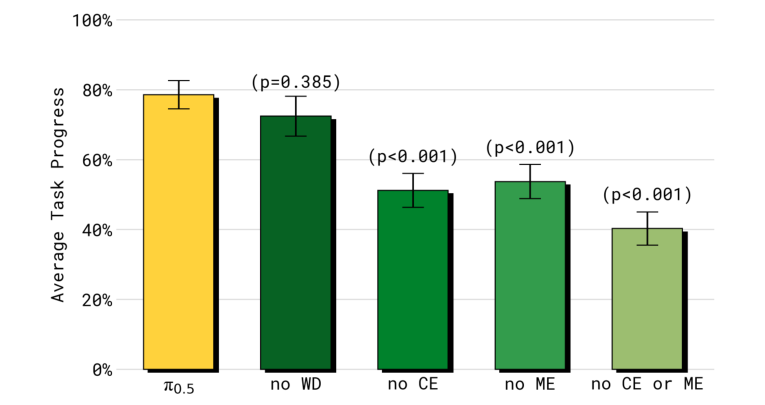
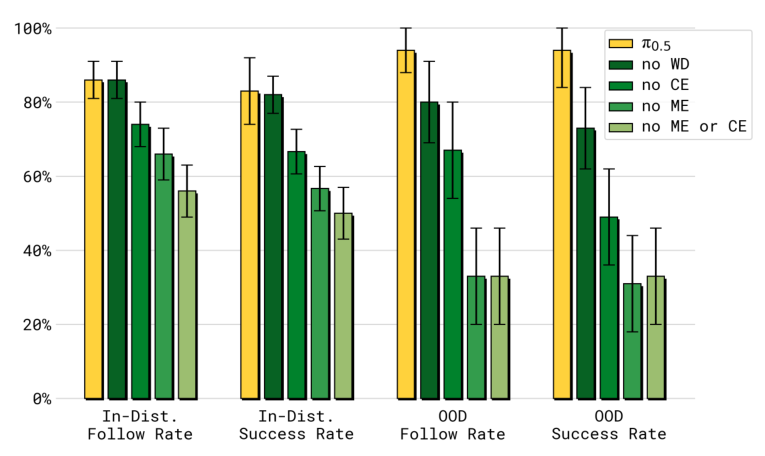
Limite de evidência: Remover dados de outros robôs reduz o desempenho em tarefas domésticas controladas. Remover dados da web não causa queda estatisticamente significativa nesse grupo de teste, mas piora o acompanhamento de instruções com objetos desconhecidos e o julgamento de alto nível. Fontes diferentes não são igualmente importantes em todo teste.
Conectando as Duas Etapas de Treinamento
Pré-treinamento: Começar a partir de PaliGemma e misturar ações de robô, subtarefas, localizações de objetos e tarefas de imagem-texto por 280.000 passos. Nenhuma perda de treinamento do especialista contínuo é usada nessa etapa.
Normalizar ações para [−1, 1] usando os percentis 1 e 99 de cada dimensão de conjunto de dados, e preencher com zeros os robôs de menor dimensionalidade. Marcas de modo de controle nas instruções distinguem alvos de juntas de alvos de efetuador final.
Pós-treinamento: Adicionar um especialista em ações com inicialização aleatória, com aproximadamente 300M de parâmetros, e treinar por 80.000 passos. Manter demonstrações bem-sucedidas, sem timeout, de robôs móveis domésticos e braços estacionários e remover dados de ações de laboratório entre robôs. Manter subtarefas e dados web relevantes e adicionar demonstrações em linguagem por especialistas.
O objetivo pode ser resumido como:
Perda total = perda de predição de tokens + 10 × perda de ações contínuas.
O primeiro termo é entropia cruzada para texto e tokens FAST; o segundo é erro quadrático nas direções de atualização de ação. Seu peso é dez durante o pós-treinamento e zero durante o pré-treinamento. A atenção separa as representações de ação para que o especialista contínuo não possa ler as respostas de ações FAST.
O treinamento com flow matching mistura ações reais A com ruído Gaussiano padrão ε: noisy action = τA + (1−τ)ε, com τ entre zero e um. A Equação (1) escreve o alvo como ε−A. Para A=0.6, ε=−0.2 e τ=0.5, a entrada é 0.2 e o alvo −0.8. Esta é uma convenção de sinal de campo vetorial, não um comando para mover o robô para trás.
τ é o progresso interno de geração; ε e A são arranjos normalizados 50 × d, onde d é a dimensionalidade da ação. Eles não são segundos. O exemplo escalar explica a equação; o treinamento usa arranjos completos. A inferência começa a partir de ruído e não requer A verdadeiro.
Rede Completa, Experimentos e Limites
Artigo: Imagens se tornam recursos visuais, e instruções e estado entram no VLM. Diferente de π0, π0.5 discretiza o estado como tokens de texto. O backbone prediz subtarefas e fornece recursos de observação ao especialista menor, que gera ações contínuas a partir de entradas ruidosas.
| Entrada ou módulo | Forma ou processamento |
|---|---|
| Imagens | Quatro visões de alto nível, três visões de baixo nível; codificadas como sequências de recursos visuais. |
| Instrução geral, subtarefa e estado | Sequências de tokens formando o prefixo de observação com recursos visuais. |
| Backbone VLM | Largura 2048, 18 camadas; prediz texto e, durante o pré-treinamento, tokens FAST. |
| Especialista em ações | Largura 1024, 18 camadas, cerca de 300M de parâmetros; incorpora linearmente ações ruidosas 50 × d. |
| Progresso de geração τ | Codificado separadamente e injetado nas camadas do especialista; a atenção lê o prefixo de observação. |
| Saída contínua | Projetar de volta para atualizações 50 × d; dez atualizações geram um bloco. |
O especialista lê observações e suas próprias características de ação, mas não tokens FAST. O backbone não lê características do especialista. A atenção compartilha informações de observação sem somar diretamente larguras 2048 e 1024. O artigo não especifica de forma uniforme o comprimento da sequência visual ou uma dimensão máxima de ação em todos os conjuntos de dados.
Cuidado: A Figura 3 rotula o Gemma como 2,6B, enquanto o Apêndice E o chama de “VLM de 2B”. As contagens de camadas e larguras verificáveis são mantidas sem inventar uma contagem exata de parâmetros totais.
O apêndice fornece 50 pontos de controle. Pela convenção de incluir o ponto final, escreve-se H=49; “50 etapas” evita confusão. As duas plataformas produzem matrizes de 50 × 18 ou 50 × 19, com preenchimento para treinamento entre robôs.
Training: heterogeneous data → backbone predicts text / action tokens
          post-training adds noisy actions → expert learns continuous updates

Inference: observations + overall task → subtask text
           observations + subtask + random actions → ten updates → continuous chunk → execute and observe again
Três pontos a observar nos experimentos:
-
Mais locais de treinamento geralmente ajudam. As comparações usam 3, 12, 22, 53, 82 e 104 locais. O modelo com 104 locais se aproxima de um modelo que viu o cenário de avaliação nessas tarefas; isso não é uma garantia para cada nova casa.
-
A receita completa supera mudar apenas o treinamento de ações. Com o mesmo conjunto de dados de robô e etapas semelhantes, π0.5 supera π0 e π0-FAST+Flow. FAST sozinho não explica o ganho; o co-treinamento de subtarefas e imagem-texto também é diferente.
-
O raciocínio de alto nível ajuda, e os dados de treinamento de alto nível também importam. Uma variante que mantém todos os dados de treinamento, mas omite a seleção explícita de subtarefas na inferência é a segunda melhor. Remover demonstrações em linguagem ou dados da web reduz o desempenho. Dizer uma subtarefa antes de agir não é toda a explicação.
A maioria das figuras principais relata pontuações de conclusão de tarefa, não taxas de sucesso da tarefa completa. Normalmente há cerca de dez tentativas por política por tarefa, ou aproximadamente 40 nas quatro tarefas controladas; algumas tentativas canceladas são excluídas. Dishes-to-sink tem oito pontos possíveis, concedidos separadamente para pegar e colocar. Metade da pontuação não significa que metade das tentativas teve sucesso completo.
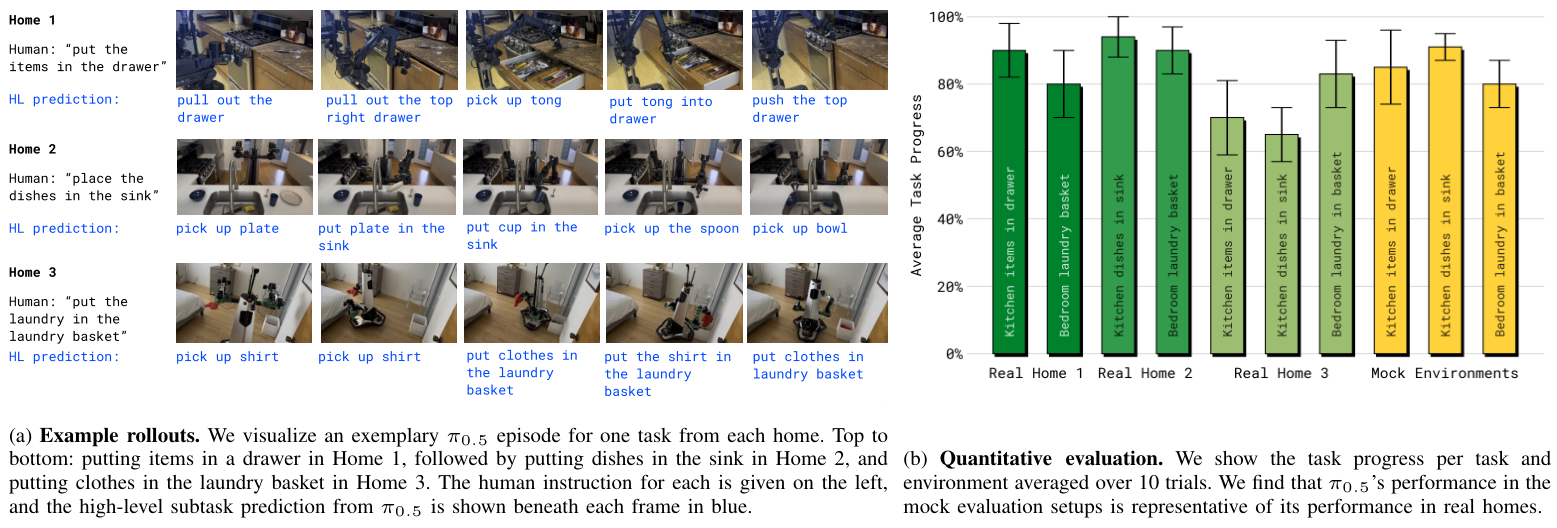
O artigo demonstra comportamentos de 10–15 minutos, enquanto muitas tarefas avaliadas quantitativamente em casas reais duram cerca de 2–5 minutos. Não as confunda. Maçanetas desconhecidas, portas difíceis, oclusão, decisões de alto nível repetidas, preferências complexas e memória entre cômodos continuam sendo desafios. O trabalho valida comportamentos úteis em novas casas, em vez da conclusão confiável de todas as tarefas domésticas.
Locais de referência: resumo e introdução; Seções II, IV-A–IV-E, V-A–V-E e VI; Figuras 3, 5 e 7–13; Apêndices B e E. Este guia não adiciona suposições específicas de hardware para transferência de projeto.
Comparando π0 e π0.5
Principais mudanças
Explicação: π0 estuda controle generalista e hábil entre robôs e tarefas. π0.5 estende isso em direção ao entendimento de casas desconhecidas e à organização de trabalho doméstico em múltiplas etapas.
| Aspecto | π0 | π0.5 |
|---|---|---|
| Foco | Manipulação geral entre robôs e tarefas. | Manipulação em múltiplas etapas em novas casas, com novos objetos e layouts. |
| Dados | Inicialização com VLM, principalmente demonstrações entre robôs e rótulos em linguagem para treinamento da política. | Co-treinamento contínuo em ações, subtarefas, localização e dados da web; demonstrações em linguagem de especialistas no pós-treinamento. |
| Treinamento de ações | Especialista contínuo tanto no pré- quanto no pós-treinamento. | Tokens FAST durante o pré-treinamento; adiciona o especialista durante o pós-treinamento mantendo ambas as representações. |
| Ações executadas | Blocos contínuos de flow matching. | Também blocos contínuos de flow matching; FAST melhora principalmente o treinamento. |
| Organização de tarefas longas | Seguir instruções de uma pessoa ou de um VLM externo de alto nível quando é necessário planejamento semântico explícito. | O mesmo modelo seleciona subtarefas a partir da tarefa geral e gera ações para elas. |
| Entrada de estado | Estado contínuo projetado no especialista de ação. | Estado discretizado como tokens no VLM. |
| Objetivo do pós-treinamento | Melhorar a proficiência em tarefas com demonstrações mais limpas e consistentes. | Adaptar tanto a execução de ações quanto a seleção de subtarefas para manipulação móvel doméstica. |
Ambos usam PaliGemma e um especialista de ação com aproximadamente 300M de parâmetros, com 50 pontos de controle e dez atualizações de fluxo. π0.5 muda principalmente a receita de treinamento e a organização das tarefas; seus ganhos não vêm simplesmente de um modelo maior ou de blocos mais longos.
Exemplo: Colocar um prato na pia
π0:
Images + state + “put the plate in the sink” → continuous chunk → execute
A person or external high-level model can supply intermediate instructions for an explicitly decomposed kitchen-cleaning task.

π0.5:
Images + state + “clean the kitchen” → model selects “pick up the plate”
Images + state + “pick up the plate” → continuous chunk → execute and observe again
Then select another subtask, such as “put the plate in the sink,” from the updated scene.
Atenção: Isto compara caminhos de execução. O π0 original também demonstra tarefas longas; ele não é limitado a operações de etapa única. π0.5 adiciona seleção explícita de subtarefas dentro do mesmo modelo.
O que os experimentos sustentam?
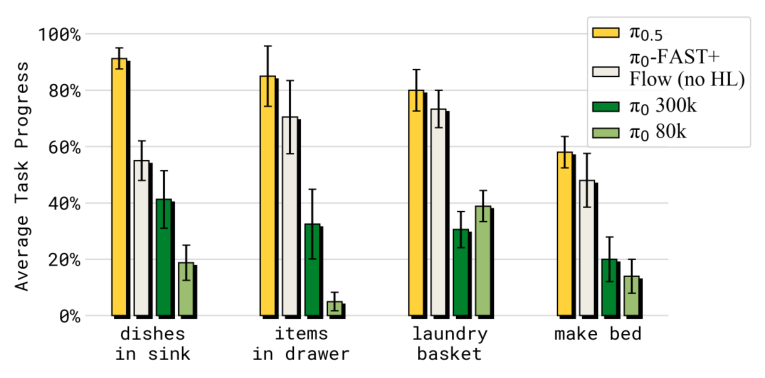
Artigo: Com o mesmo conjunto de dados de robô e etapas semelhantes, a receita completa de π0.5 supera π0 e π0-FAST+Flow nas casas controladas desconhecidas testadas. Este último já combina FAST e flow matching, mas usa apenas dados de ações de robô e carece de raciocínio de alto nível. Mudar apenas o treinamento de ações é insuficiente para igualar o π0.5 completo.
Atenção: Estas são bases re-treinadas dentro do artigo de π0.5, não pontuações emendadas de publicações separadas. Elas sustentam melhorias nessas tarefas e condições, não um ganho fixo em todos os lugares.
Compare cuidadosamente os escopos de dados: os “mais de 10.000 horas” de π0 se referem ao total de demonstrações de robô, enquanto as “cerca de 400 horas” de π0.5 se referem apenas à manipulação móvel doméstica e excluem dados substanciais de outros robôs e de imagem-texto. Os números não mostram que π0.5 vence universalmente com menos dados totais.
Fontes de comparação: π0, 2410.24164v4, Seções III–V e experimentos de instruções de alto nível; π0.5, 2504.16054v1, Seções IV, V-D, V-E, Figura 12 e Apêndice E.