FAST e π0-FAST: Como uma Tokenização de Ações Eficiente Acelera o Aprendizado de Robôs
FAST: Tokenização de Ações Eficiente para Modelos Visão-Linguagem-Ação
- Tokenização de ações
- DCT
- Compressão BPE
- Políticas autoregressivas
Relação com π0: O artigo se chama FAST; π0-FAST é a política treinada usando-o. FAST é um método de tokenização, FAST+ um tokenizer universal pré-treinado de ações, e π0-FAST um VLA autoregressivo usando essa representação. Ele compartilha a abordagem de backbone PaliGemma com o π0, mas muda a geração de ações; não é apenas um pré-processador de compressão adicionado ao expert de flow matching do π0.
Fonte de leitura: O PDF original, Seções I–VII e Apêndices A–E, seguindo a estrutura da análise detalhada de π0 anterior. Os números de página se referem às páginas físicas do PDF de 19 páginas, do qual as figuras são extraídas. Derivações adicionais e exemplos numéricos são marcados como explicações em vez de atribuídos ao artigo.
Pré-requisitos
VLAs e Tokenização de Ações
Explicação: Um VLA converte uma cena visível e uma tarefa em linguagem em controles de robô. Para dobrar uma camiseta, imagens localizam a camiseta e os ganchos, a linguagem define o objetivo, o estado descreve os braços, e o modelo prediz ações futuras dos braços e garras.
Este artigo usa divisão em blocos de ações: predizer passos futuros em vez de apenas um. Defina:
Aqui é o tempo de controle do robô, uma ação -dimensional, e o horizonte. é a visão de câmera , o número de câmeras, a instrução e a propriocepção. A política aprende , onde denota os parâmetros da rede.
Artigo: Os blocos têm principalmente um segundo de duração. Assim, depende da taxa de controle: 15 a 15 Hz, 20 a 20 Hz e 50 a 50 Hz. Não assuma que o de π0 vale para todo dataset aqui.
A tokenização de ações mapeia um bloco contínuo para símbolos discretos:
é o tokenizer, um ID de token de ação, o tamanho do vocabulário e o comprimento da sequência comprimida. Blocos com a mesma forma podem produzir diferentes, assim como frases com o mesmo comprimento podem ter contagens diferentes de subpalavras.
Cuidado: Um ID de token não é um ângulo de junta. Um token FAST não precisa corresponder a um passo de tempo, junta ou ação completa. Gere a sequência primeiro, depois decodifique-a para um bloco contínuo.
Agrupamento Pontual, Flow Matching de π0 e FAST
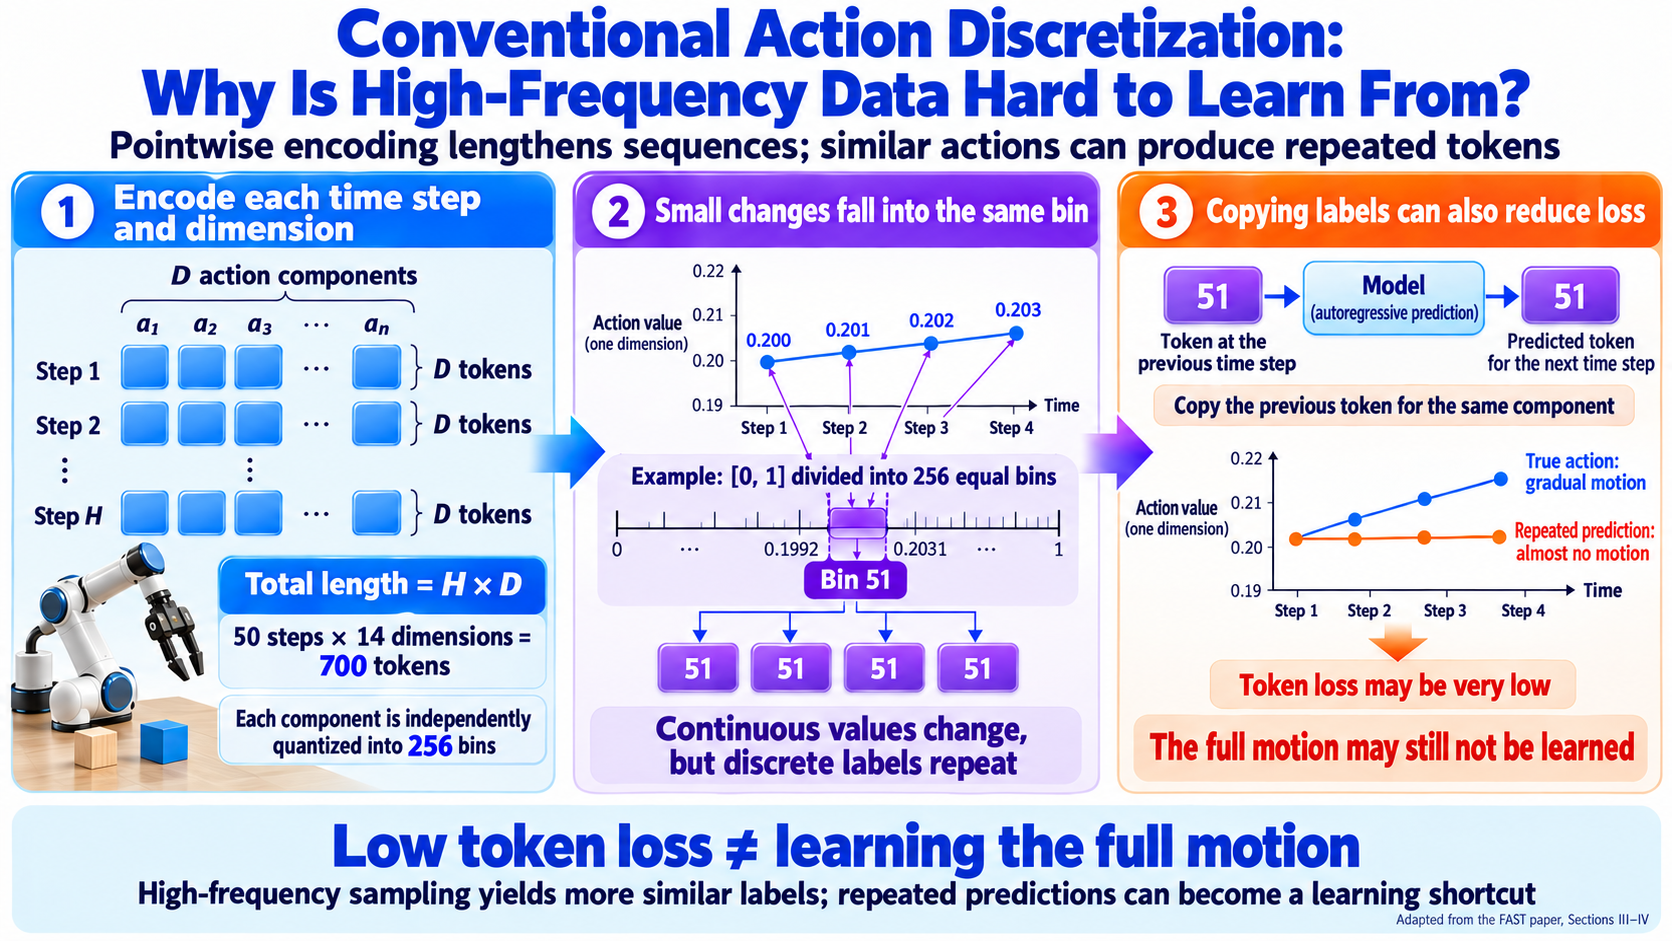
O agrupamento convencional quantiza de forma independente cada passo de tempo e dimensão de ação. Uma configuração comum discutida no artigo usa 256 intervalos uniformes:
D action components at step 1 → D tokens
D action components at step 2 → D tokens
……
D action components at step H → D tokens
Total: H × D tokens
Dados de alta taxa então produzem sequências longas com valores vizinhos altamente semelhantes. Copiar tokens repetidos pode reduzir a perda sem aprender o movimento global.
Exemplo mínimo: Valores podem todos cair em um mesmo intervalo grosseiro. Repetir o token anterior prediz muitos rótulos corretamente, mas falha em expressar a trajetória que muda de forma constante.
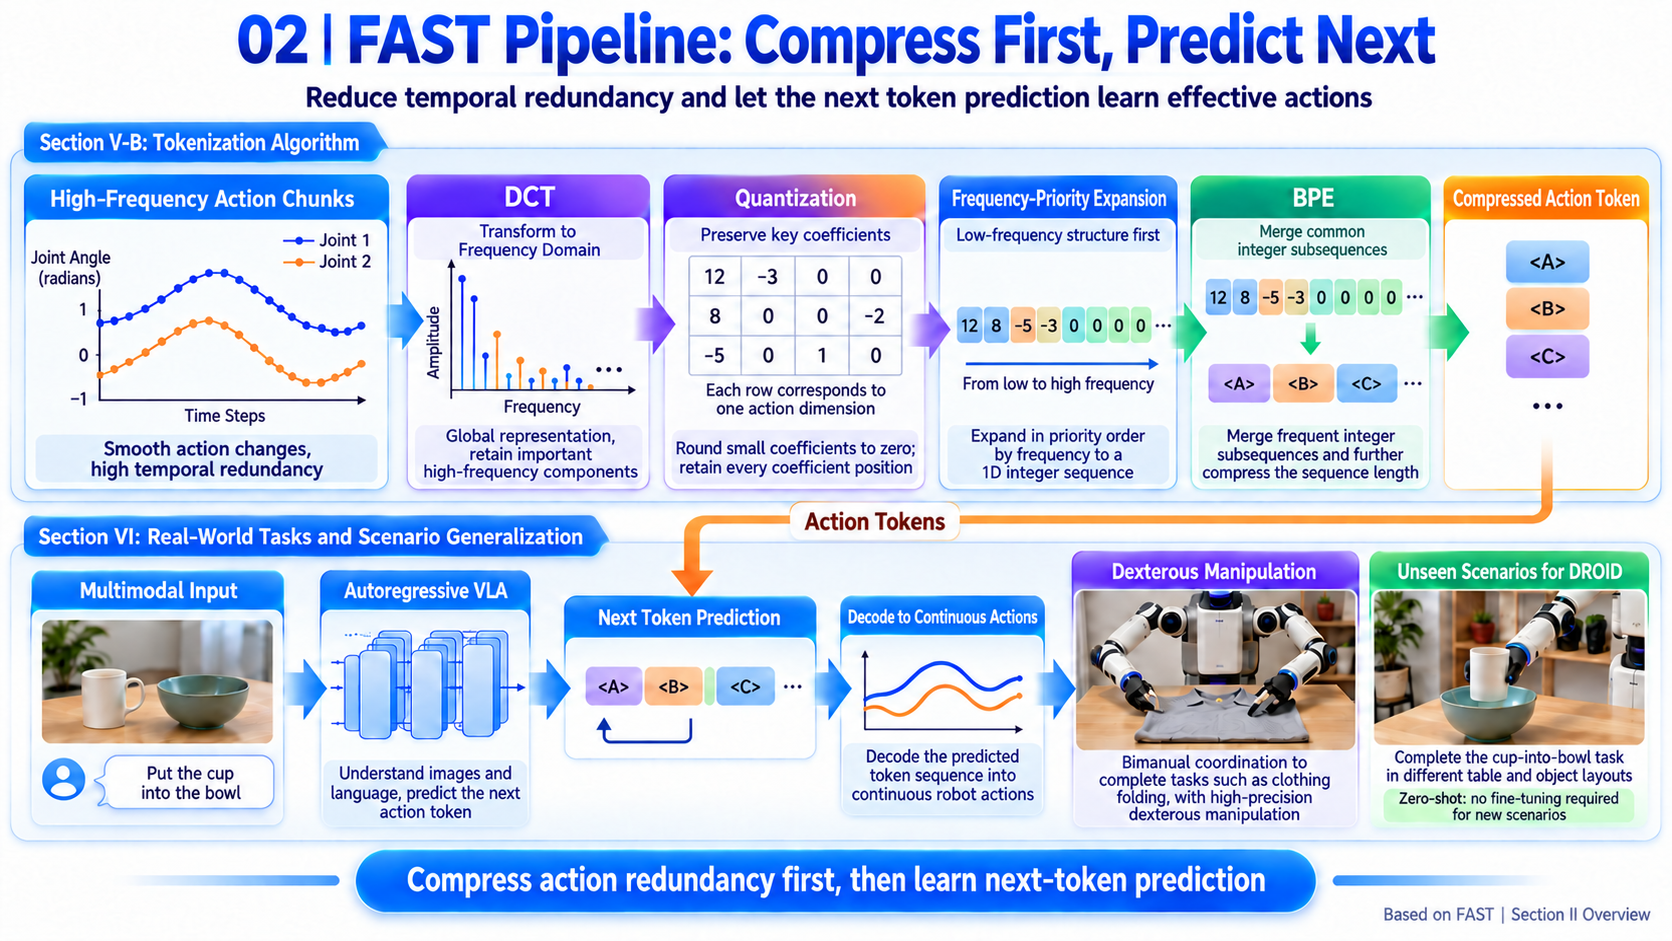
FAST usa:
Continuous chunk → frequency coefficients → quantization → frequency-first flattening → BPE
          → fewer action tokens → autoregressive VLA prediction → continuous-chunk decoding
A transformada discreta do cosseno (DCT) expressa uma trajetória como componentes de cosseno em diferentes frequências; a codificação por pares de bytes (BPE) mescla subsequências inteiras comuns. Predizer essa representação comprimida da trajetória remove supervisão redundante.
| Aspecto | VLA autoregressivo pontual | π0 original | π0-FAST |
|---|---|---|---|
| Representação | Valor discreto por passo de tempo e dimensão | Bloco contínuo | Tokens discretos comprimidos para um bloco |
| Objetivo | Predição do próximo token | Flow matching condicional | Predição do próximo token |
| Geração | Gera sequencialmente tokens | Atualiza iterativamente o bloco completo com um expert | Gera tokens comprimidos, depois decodifica |
| Dados de alta taxa | Mais tokens e repetição | A geração contínua evita decodificação dimensão a dimensão | Comprime redundância temporal e encurta a saída |
| Principal limitação | Destreza em alta taxa pode ser difícil de aprender | Requer um expert contínuo dedicado | Quantização com perda; a inferência autoregressiva ainda pode ser lenta |
Artigo: A Tabela I reduz um bloco de camiseta de um segundo, 50 Hz, 14D de 700 tokens pontuais para uma média de 53 tokens FAST. A decodificação ainda produz 50 × 14 ações; o controle do robô não se torna “53 tokens por segundo”.
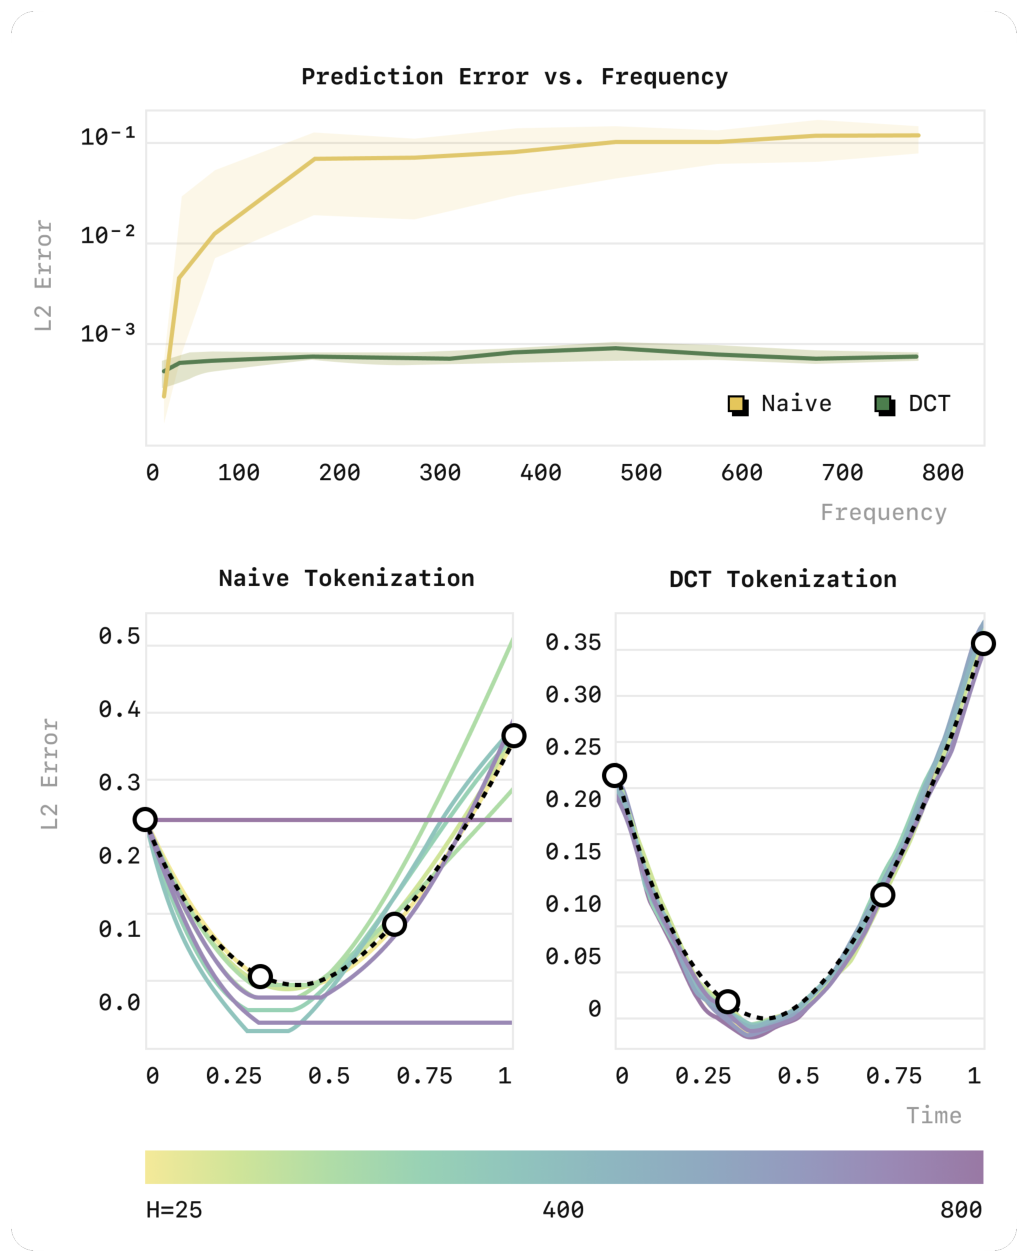
Figura 2: predições da mesma spline cúbica em diferentes densidades de amostragem. Amarelo é agrupamento pontual; verde é DCT. A escala de cores inferior vai de amarelo claro a roxo conforme a contagem de amostras aumenta de 25 para 800. Da Figura 3 original, página 3 do PDF.
Lendo a figura: Quatro pontos de entrada definem o mesmo tipo de alvo de interpolação enquanto a densidade aumenta. O erro da tokenização pontual cresce, eventualmente se aproximando de uma predição constante; o erro da DCT permanece baixo. O aprendizado pode falhar por causa da representação, e não por uma tarefa mais difícil. Os valores 25–800 são amostras sintéticas por sequência, não frequências reais de controle de robô.
Treinamento, Inferência e Avaliação
| Estágio | Entradas e operações | Saída e critério |
|---|---|---|
| Treinamento do tokenizer | Normalizar ações, aplicar DCT e quantização, e aprender BPE a partir de sequências inteiras. | Regras de codificação/decodificação; erro de compressão e reconstrução. |
| Treinamento da política | Condicionar em imagens, linguagem e estado; codificar ações futuras demonstradas como rótulos FAST. | Otimização de entropia cruzada e pesos do VLA. |
| Inferência da política | Gerar tokens, reverter BPE, desquantizar e aplicar DCT inversa. | Blocos contínuos para o controlador. |
| Avaliação no robô | Executar tarefas e condições iniciais especificadas. | Sucesso na tarefa ou progresso normalizado. |
Artigo: A avaliação inclui seis tarefas/configurações de robô real e um benchmark em simulação, além de testes offline separados de compressão FAST+ em diferentes corpos robóticos. Comprimir dados de humanóides não é o mesmo que treinar e validar fisicamente uma política para humanóides.
Cuidado: Perda de token, erro de reconstrução e pontuação de tarefa são distintos. Um achado importante é que rótulos repetitivos podem produzir baixa perda de treinamento enquanto trajetórias e comportamento do robô permanecem ruins.
Resumo
Tradução
Modelos de sequência autoregressivos, incluindo VLAs baseados em Transformer, podem representar comportamentos robóticos complexos e generalizáveis, mas exigem um tokenizer para mapear predições discretas para ações contínuas. Os autores constatam que um agrupamento simples por dimensão e por passo de tempo tem desempenho ruim em dados hábeis de alta frequência.
Eles propõem a Tokenização de Sequência de Ações no Espaço de Frequência (FAST), usando compressão baseada em DCT para permitir que VLAs autoregressivos aprendam tarefas hábeis de alta frequência onde a discretização padrão falha.
FAST+ é um tokenizer universal treinado em um milhão de sequências de ações de robôs reais, utilizável como um tokenizer de caixa-preta em diferentes espaços de ação e frequências de controle.
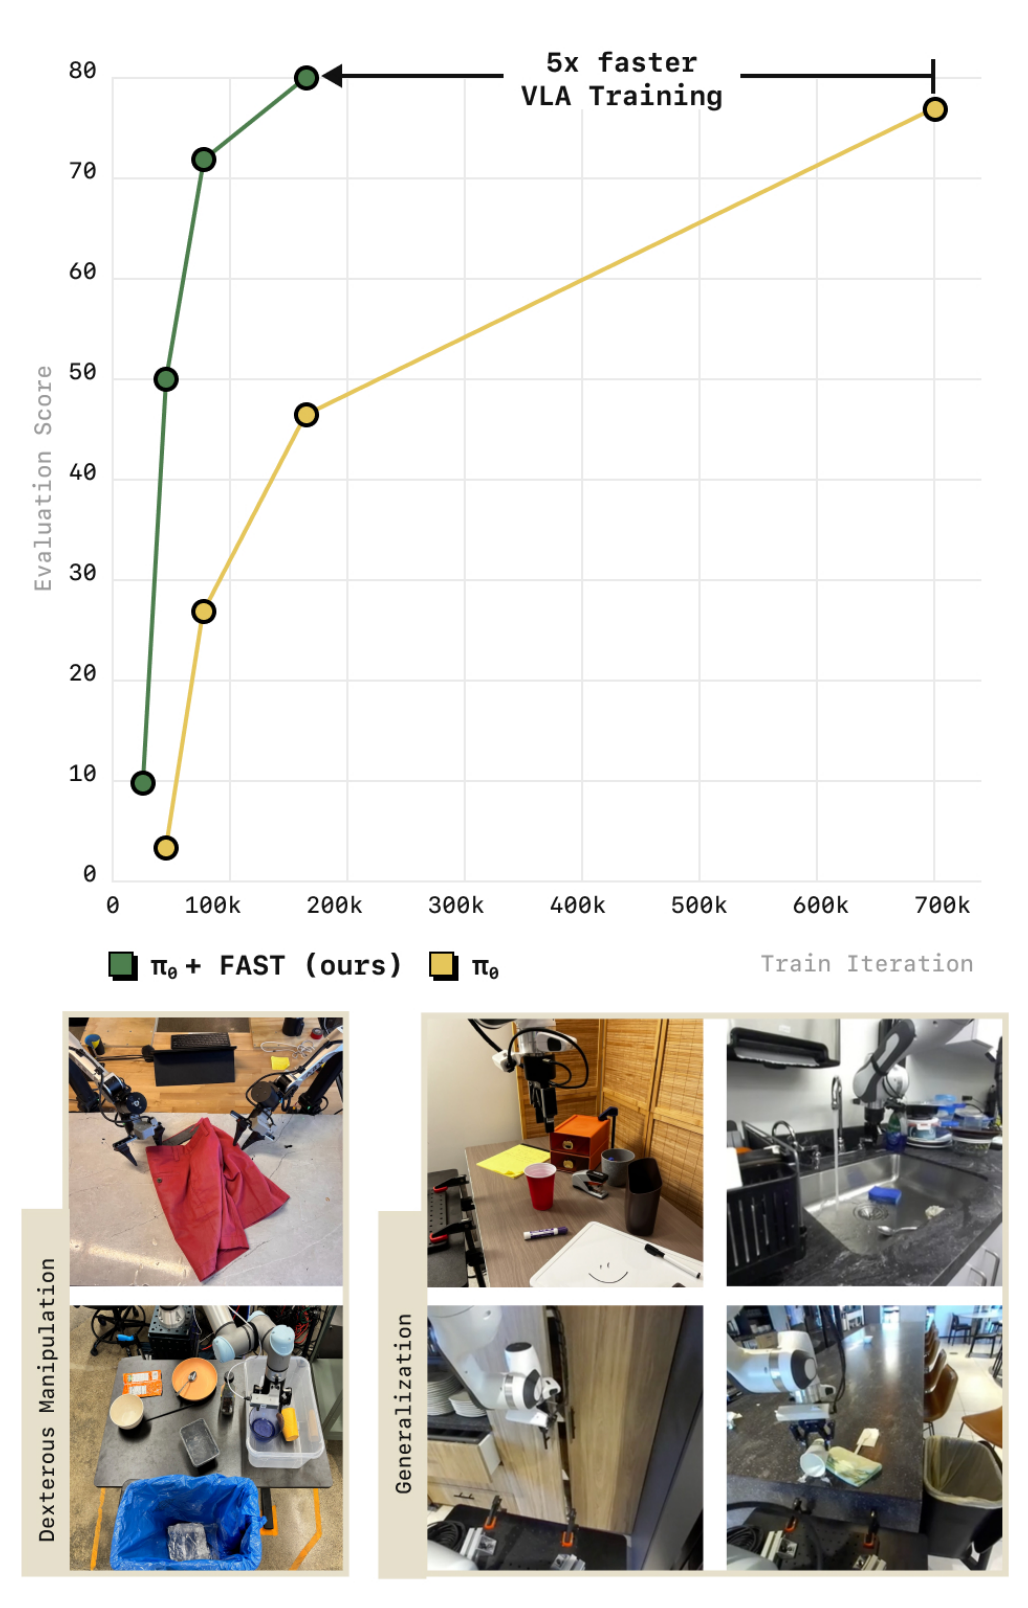
Combinado com a abordagem de VLA π0, FAST escala para 10.000 horas de dados de robôs, iguala o desempenho de VLAs no estilo difusão e reduz o tempo de treinamento em até cinco vezes.
Comentário
-
Motivação: Ações em alta taxa contêm informação repetida. Tokens pontuais gastam esforço de predição em rótulos com pouca supervisão de novo movimento.
-
Mudança central: Alterar a representação do alvo de aprendizado antes de treinar a política. FAST comprime informações de trajetória sem reduzir a frequência de execução nem descartar pontos de controle.
-
Por que isso pode funcionar: A DCT concentra o formato da trajetória, a quantização cria coeficientes comprimíveis e o BPE encurta combinações comuns. Os três contribuem para os tokens finais.
-
Significado de “universal”: FAST+ evita retreinar um vocabulário BPE específico de cada dataset, mas ainda requer normalização, dimensões e horizontes compatíveis. Seus um milhão de amostras de treinamento são principalmente trechos de um segundo, não um milhão de episódios completos de tarefa.
-
Escopo de “cinco vezes”: Experimentos de política em larga escala reduzem as horas de GPU necessárias em até cerca de cinco vezes. Isso não é inferência mais rápida: a v1 relata cerca de 750 ms por trecho π0-FAST versus geralmente menos de 100 ms para π0.
Introdução
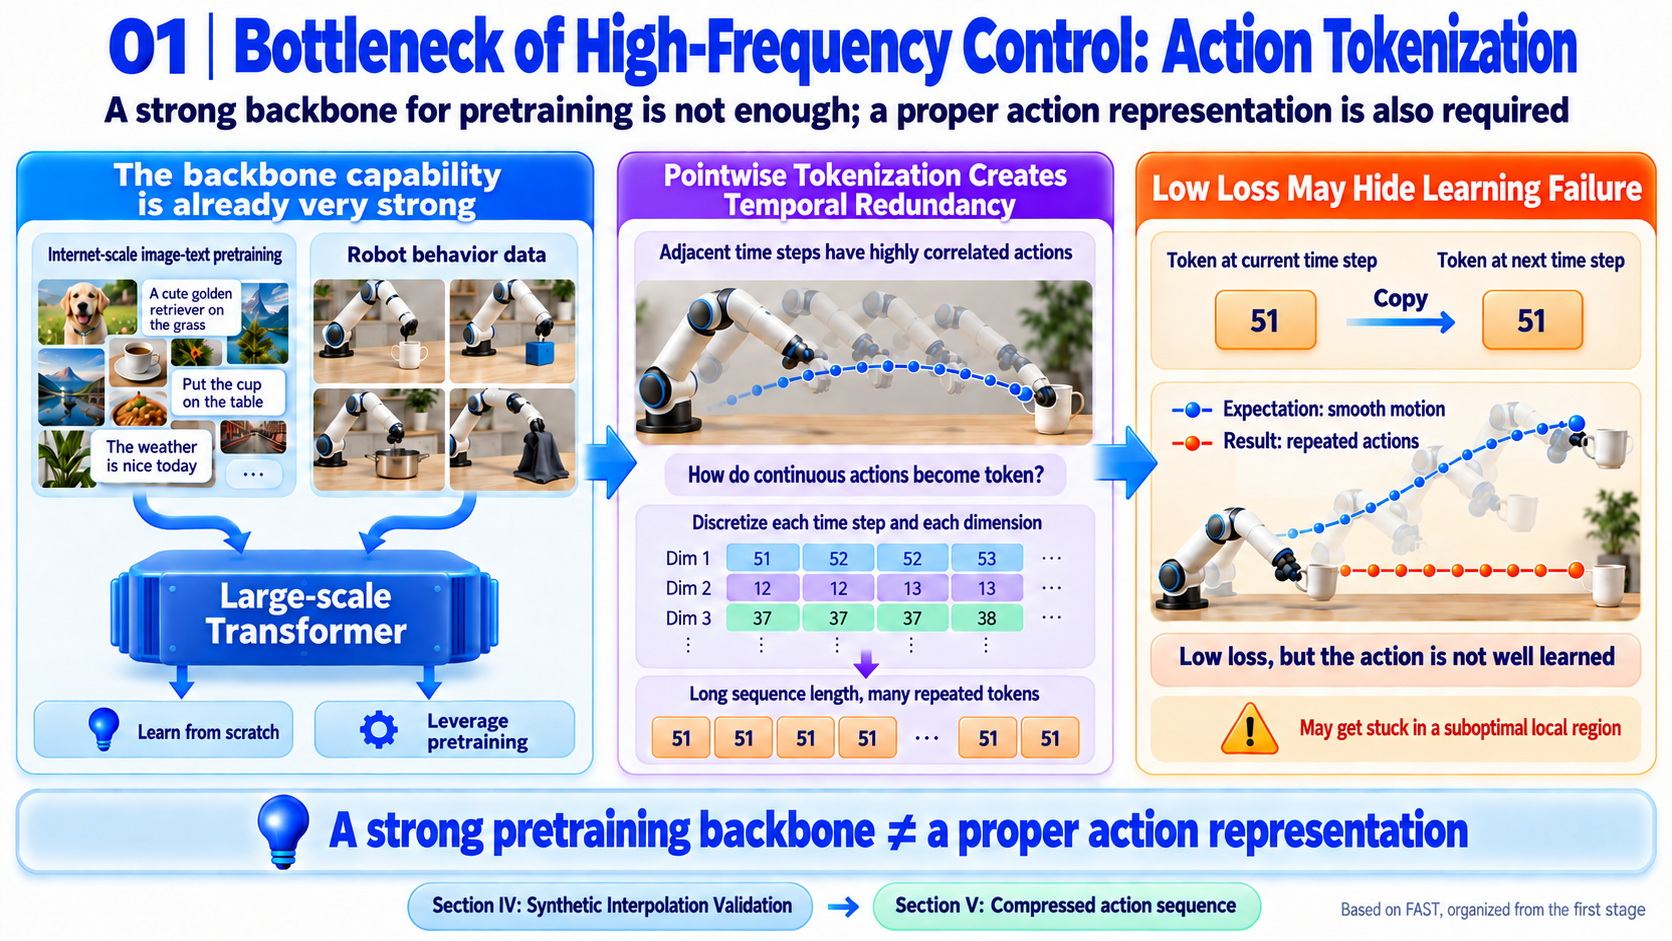
Parágrafo 1: Localizar o Gargalo na Tokenização
-
Ponto principal: Grandes Transformers podem aprender o comportamento do robô do zero ou usar pré-treinamento imagem-texto, mas as ações precisam ser tokenizadas. A discretização ponto a ponto enfrenta dificuldades em tarefas hábeis de alta taxa porque copiar valores recentes correlacionados obtém baixa perda e pode prender o aprendizado em um ótimo local ruim.
-
Problema: Um backbone poderoso não garante aprendizado útil de ações; a representação do alvo pode limitar a supervisão.
-
Configuração: A Seção IV estuda a densidade de amostragem com interpolação sintética; a Seção V propõe compressão.
Parágrafo 2: Comprimir Primeiro, Prever Depois
-
Ponto principal: Inspirado pela tokenização de linguagem, FAST usa DCT para sinais contínuos de robôs. A predição padrão do próximo token então aprende tarefas que antes falhavam e suporta uma política DROID usada via linguagem em cenários inéditos.
-
Problema: Se a redundância temporal é o obstáculo, reduza a redundância dos rótulos em vez de apenas aumentar a capacidade da rede.
-
Configuração: A Seção V-B apresenta o algoritmo, e a Seção VI avalia tarefas reais e a generalização do DROID.
Parágrafo 3: Tokenização Universal e Políticas em Larga Escala
-
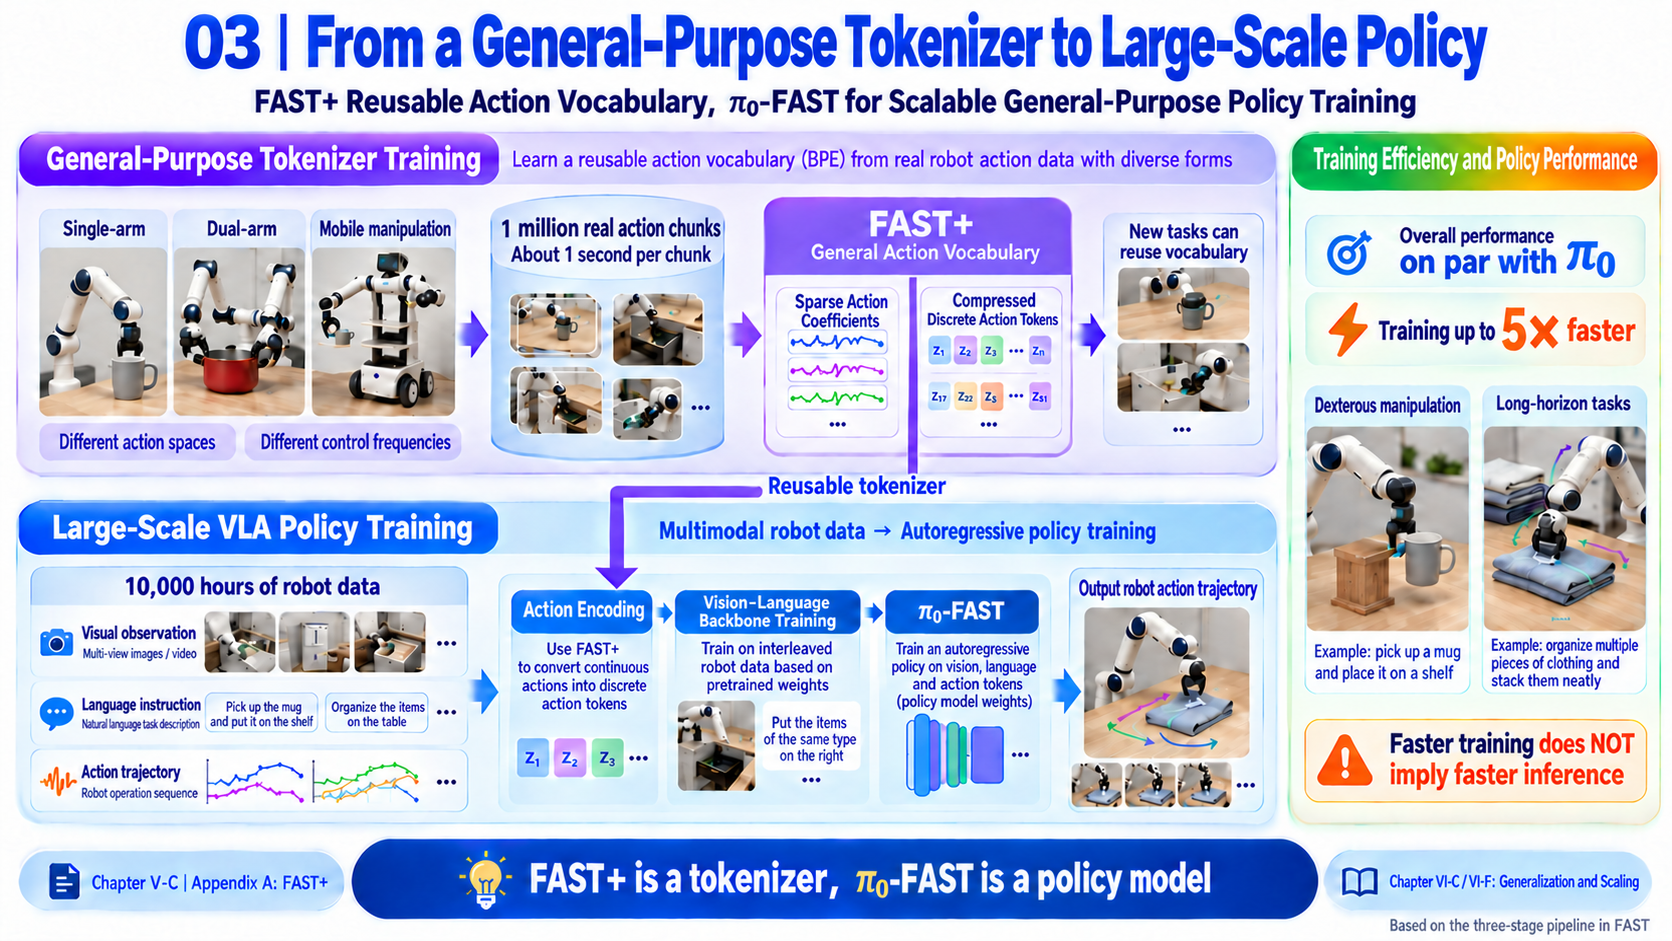
Ponto principal: FAST+ aprende um vocabulário a partir de um milhão de sequências cobrindo braço único, bimanual, móvel e interfaces e frequências de controle variadas. π0-FAST escala a autorregressão para 10.000 horas com menos tempo de treinamento do que a comparação em estilo de difusão.
-
Problema: Retreinar um tokenizador para cada robô adiciona sobrecarga, e o método precisa escalar além de datasets individuais.
-
Configuração: A Seção V-C e o Apêndice A descrevem o FAST+; VI-C testa universalidade e VI-F políticas em larga escala.
Atenção: A introdução contém três parágrafos principais, com o primeiro abrangendo as páginas 1–2. Quebras de página e legendas de figuras não são parágrafos extras. Afirmações sobre o “primeiro” resultado DROID refletem a avaliação dos autores na época da publicação, não uma revisão de trabalhos posteriores.
Trabalhos Relacionados
-
Tokenização de texto, imagem e áudio: O BPE de texto mescla subsequências frequentes; outros modos usam quantização aprendida ou representações em frequência. FAST aplica o princípio de representação e compressão a trechos de ações contínuas. A DCT é analítica; apenas o vocabulário BPE é aprendido.
-
VLAs: RT-2 e OpenVLA transferem conhecimento imagem-texto para controle, mas comumente usam discretização ponto a ponto de ações. FAST altera as saídas para que um backbone autorregressivo possa aprender destreza em alta taxa; o π0 de fluxo contínuo é uma comparação chave.
-
Representações de ação: Subtarefas semânticas e keypoints podem depender de controladores projetados manualmente; a discretização representa diretamente os controles, mas tem redundância temporal; cabeças de regressão e difusão mudam os mecanismos de saída. FAST mantém a predição de sequência discreta. A comparação com compressão aprendida usa quantização escalar finita (FSQ). FAST não precisa de codificador neural e tem melhor desempenho nas reconstruções de alta fidelidade e tarefas hábeis testadas, não necessariamente em todo tokenizador aprendido.
Sistema de Política π0-FAST e Plataformas Experimentais
Objetivos e Componentes
FAST é um método de processamento de ações, não um novo hardware de teleoperação. Esta seção do sistema explica como tokenização, a VLA, controle e avaliação se encaixam.
Os objetivos são comprimir ações de alta taxa mantendo trajetórias detalhadas, reutilizar treinamento autorregressivo de VLM, suportar espaços de ação variados, permitir treinamento/reuso fácil de tokenizadores e escalar entre diferentes corpos robóticos.
| Componente | Configuração no artigo | Função |
|---|---|---|
| FAST / FAST+ | DCT, quantização, achatamento frequência-primeiro, BPE | Codificar trechos como símbolos previsíveis e decodificá-los. |
| Backbone π0-FAST | PaliGemma-3B | Codificar imagens/linguagem e gerar tokens de ação de forma autorregressiva. |
| Comparação de transferência de backbone | OpenVLA baseado em Prismatic 7B | Testar se os benefícios se estendem além do PaliGemma. |
| Imagens | Duas ou três visões | Uma visão externa mais uma visão de punho por braço. |
| Propriocepção | Discretização em 256 faixas, depois tokenização de inteiros em texto | Fornecer o estado atual do robô. |
| Execução | Controladores de baixo nível específicos da plataforma | Enviar valores contínuos decodificados para juntas, garras e outros controles. |
Artigo: Todos os pesos de política são ajustados por fine-tuning. Cada imagem é codificada separadamente, depois os tokens visuais são concatenados. O tamanho da imagem e a codificação textual de estado são especificados no Apêndice C em vez de inferidos de π0.
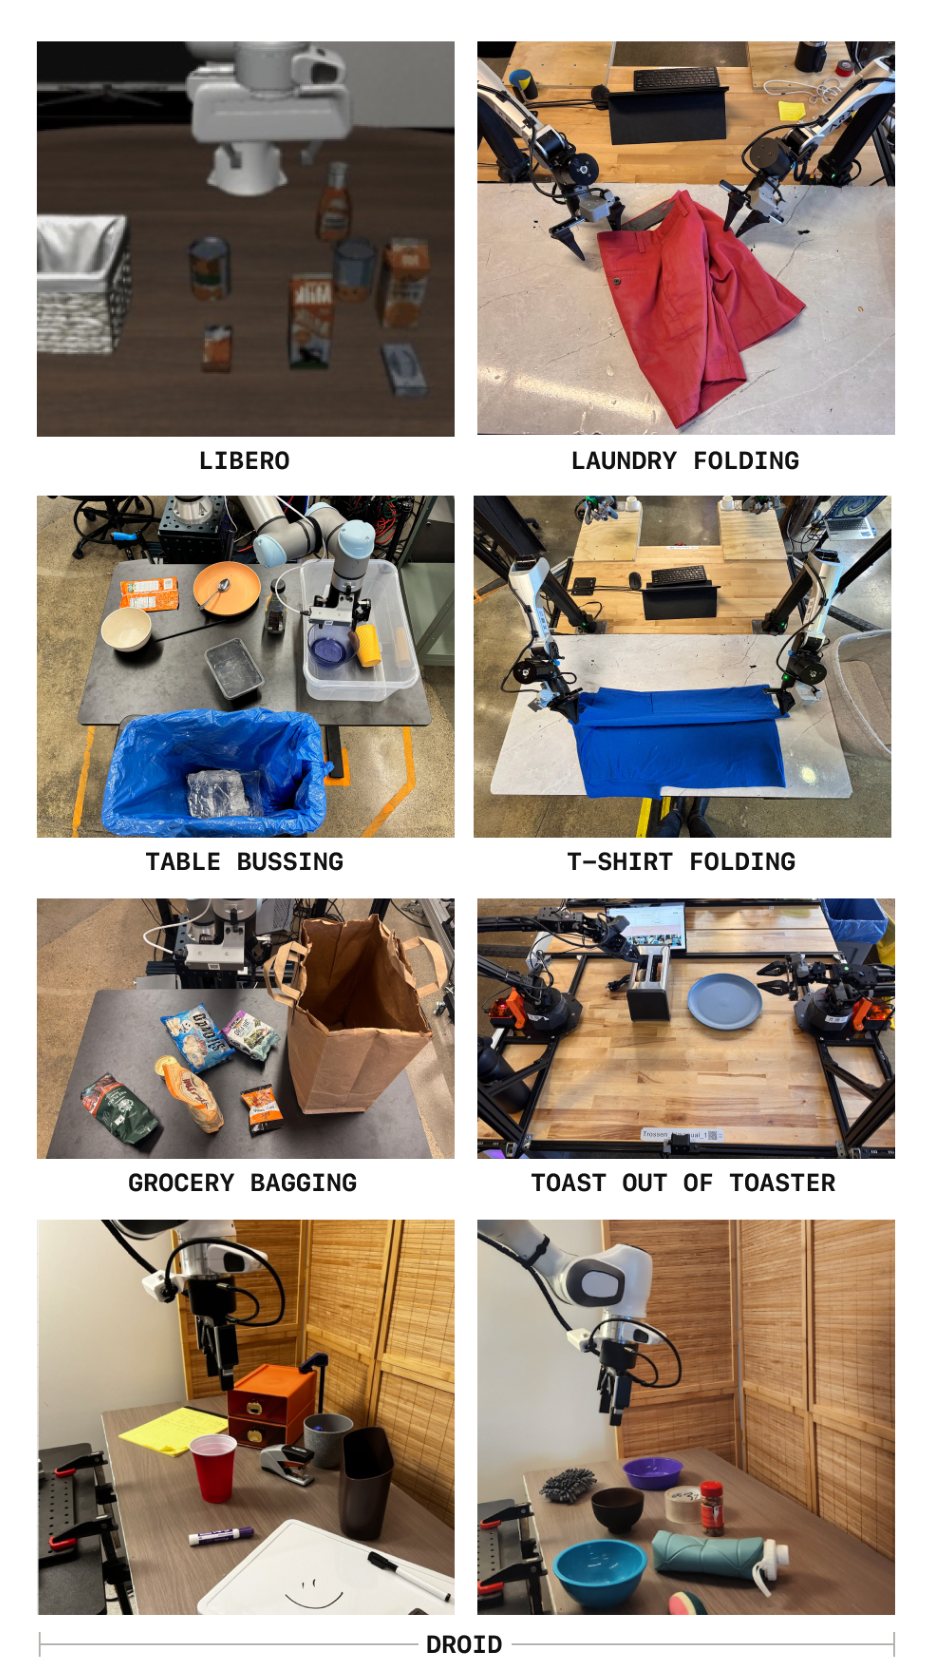
| Tarefa / cenário | Plataforma e taxa de controle | Capacidade testada |
|---|---|---|
| LIBERO | Simulação | Generalização espacial, de objetos, de objetivos e de longo horizonte. |
| Limpeza de mesa | UR5/UR5e único, 20 Hz | Agarrar, classificar e guardar 12 objetos. |
| Dobrar camiseta | ARX bimanual, 50 Hz | Agarrar e dobrar com precisão uma camiseta plana. |
| Ensacamento de compras | UR5/UR5e único, 20 Hz | Ensacar sete objetos sem colapsar ou rasgar a sacola. |
| Torrada fora da torradeira | Trossen Viper-X bimanual, 50 Hz | Remover duas fatias de torrada e colocá-las em um prato. |
| Dobrar roupa | ARX bimanual, 50 Hz | Retirar, estender, dobrar e empilhar roupas de um cesto. |
| Tarefas de mesa DROID zero-shot | Dados e implantação em Franka, 15 Hz | Seguir linguagem para posicionamento, limpeza, operações com gavetas e tarefas relacionadas em novos cenários. |
Atenção: Alta frequência de controle significa muitos pontos de controle por segundo; alta frequência em DCT significa variação rápida ao longo de uma trajetória. Movimento suave a 50 Hz ainda pode ser dominado por coeficientes de baixa frequência. Nenhuma delas é a taxa de inferência do modelo completo.
Conectando Codificação, Predição e Execução
O fluxo de trabalho completo é:
Demonstrations → one-second future chunks → normalization and FAST → action-token labels
Current images + language + state → VLM prefix → learn action-token prediction
                                      ↓ after training
New observations → autoregressive tokens → FAST decoding → continuous chunk → execute
                                                                  ↓
                                                          observe and predict again
FAST codifica apenas alvos de ação; ele não interpreta imagens nem aplica DCT à propriocepção atual. Durante o treinamento, o modelo vê tokens de ações anteriores de verdade-terreno; na inferência, ele vê seus próprios tokens gerados.
Artigo: Símbolos de ação substituem slots raramente usados no vocabulário da VLM, reutilizando saídas discretas sem um especialista de fluxo ao estilo π0. Experimentos com OpenVLA ainda modificam entradas de múltiplas imagens e saídas em trechos. Compatibilidade com backbones autorregressivos não significa que todo código-base robótico existente não precise de adaptação.
Temporização de execução: DROID prediz 15 passos e executa oito ou 15 em malha aberta antes de atualizar observações. A 15 Hz, isso cobre cerca de 0,53 ou um segundo de pontos de controle, não o total de ciclos de relógio de parede incluindo inferência e comunicação. A v1 não especifica um único comprimento de execução para todas as plataformas.
Justificativa: Trechos preservam a coerência da trajetória; a compressão torna rótulos de alta taxa aprendíveis; saídas autorregressivas permitem que pesos pré-treinados de imagem-texto participem diretamente. Controladores recebem valores contínuos, não IDs de BPE.
Dados, Capacidades e Resultados
Escala e Configuração do Dataset
| Uso | Escopo | Distinção |
|---|---|---|
| Treinamento do tokenizador FAST+ | Cerca de um milhão de trechos de ações reais de um segundo | Aprende BPE, não compreensão visual da VLA. |
| Cobertura do FAST+ | Braço único, bimanual, móvel; controles de junta, efetuador final em referencial do mundo e efetuador final em referencial da câmera; frequências variadas | Um robô pode contribuir com múltiplas parametrizações de ação. |
| Política em larga escala | Mistura π0: 903M timesteps internos, com dados abertos recebendo peso de amostragem de mistura de 9,1% | Fontes abertas incluem Bridge v2, DROID e OXE; 9,1% não é uma fração do volume bruto de dados. |
| Política específica de DROID | 75k episódios bem-sucedidos, cerca de 21M amostras | Filtragem leve e remoção de ações ociosas totalmente zero; o treinamento da política ainda é necessário. |
| Treinamento DROID | Lote 256, 240k iterações, cerca de três épocas | O Apêndice D relata cerca de quatro dias em oito H100s para essa configuração. |
Artigo: O treinamento do FAST+ preenche ações até 32 dimensões. Isso alinha os dados do tokenizador, não o tamanho de saída de toda política, e difere da interface 18D de π0. Novas plataformas ainda precisam que suas dimensões efetivas de ação sejam definidas.
DROID usa uma imagem externa e uma de pulso. O treinamento escolhe aleatoriamente entre duas câmeras externas disponíveis e três anotações de linguagem por episódio, sem informações de calibração de câmera. Os controles são velocidades das juntas e posição absoluta do gripper. A implantação em novos pontos de vista não elimina a necessidade de configurar coordenadas e interfaces de controle.
Compressão: Menos tokens, o mesmo horizonte de ação
Esses resultados de um segundo reproduzem a Tabela I. A compressão é a contagem pontual de tokens dividida pela contagem média de FAST em erro de reconstrução semelhante.
| Conjunto de dados / tarefa | Dimensão | Taxa e horizonte | Tokens pontuais | Tokens FAST médios | Compressão |
|---|---|---|---|---|---|
| BridgeV2 | 7 | 5 Hz, 5 passos | 35 | 20 | 1.75 |
| DROID | 7 | 15 Hz, 15 passos | 105 | 29 | 3.6 |
| Arrumação de mesa | 7 | 20 Hz, 20 passos | 140 | 28 | 5.0 |
| Dobragem de camiseta | 14 | 50 Hz, 50 passos | 700 | 53 | 13.2 |
Interpretação: Aumentar os pontos de controle não adiciona necessariamente, de forma proporcional, novas informações de movimento. Cerca de 30 tokens por braço por segundo é uma observação empírica aqui, não um comprimento fixo.
Verificação de versão: A Tabela III do apêndice usa alguns conjuntos de dados offline de dimensões diferentes, incluindo DROID Joint 8D e arrumação de mesa, enquanto a Tabela I lista 7D. A convenção da Tabela I é mantida em vez de fundir diferentes parametrizações em uma única especificação.
Avaliação: Sucesso e progresso são diferentes
| Tarefa | Avaliação |
|---|---|
| LIBERO | Sucesso binário por episódio; quatro suítes treinadas em conjunto em cerca de 270k amostras por 40k iterações. |
| Arrumação de mesa | Fração de 12 objetos colocados corretamente no lixo ou no recipiente de armazenamento. |
| Dobragem de camiseta | Sucesso de dobragem julgado por humanos em cinco camisetas já vistas. |
| Ensacamento de compras | Fração de sete objetos colocados na sacola. |
| Remoção de torradas | Um ponto por fatia removida e um por fatia servida no prato; quatro pontos no total, depois normalizados. |
| Dobragem de roupa | Dobragem e empilhamento de roupas julgados por humanos, com cinco peças aleatórias no cesto. |
| Testes quantitativos de DROID | 44 tentativas por política, com pontos de progresso específicos da tarefa, como pega correta e destino correto. |
Verificação de versão: O texto principal chama a quarta suíte do LIBERO de Libero-10; o apêndice a chama de Libero-Long. Ela é descrita aqui como a suíte de longo horizonte. O Apêndice E menciona 16 tarefas DROID, enquanto a Tabela II lista 17 nomes; as contagens de tentativas ainda somam 44. A discrepância é preservada em vez de ser resolvida silenciosamente.
Limite da evidência: Implantações em Berkeley, Stanford e na Universidade de Washington são demonstrações qualitativas adicionais sem taxas de sucesso reportadas. Zero-shot significa nenhum treinamento adicional para a nova cena de implantação, não ausência de treinamento DROID. O treinamento de vocabulário FAST+ também inclui dados de tarefas reais de avaliação, então a Figura 6 não mostra tanto o tokenizador quanto a política completamente desconhecendo todas as tarefas.
Comparando tokenizadores
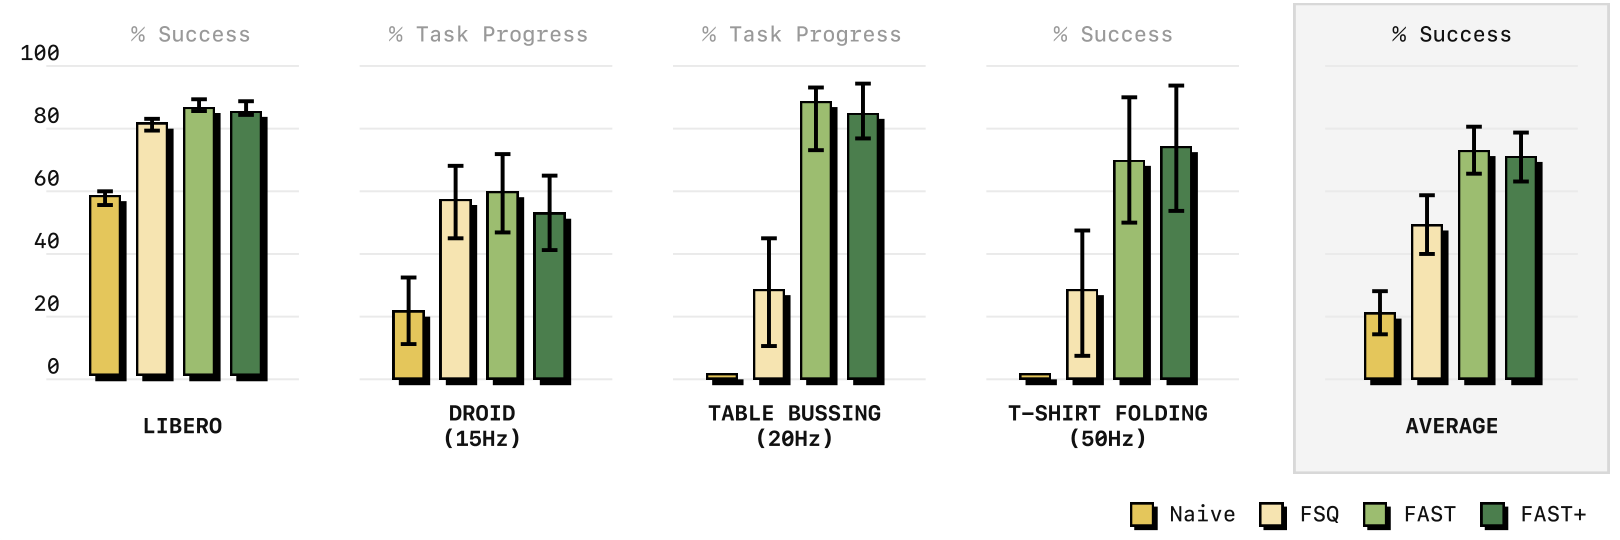
Em arrumação de mesa a 20 Hz e dobragem de camiseta a 50 Hz, o agrupamento pontual faz pouco progresso, enquanto FAST e FAST+ aprendem políticas úteis. FSQ apoia o valor da compressão, mas geralmente fica atrás de FAST nessas tarefas de destreza. FAST+ universal fica próximo do FAST específico do conjunto de dados, apoiando seu uso como padrão.
Cuidado: A figura faz a média de diferentes pontuações de tarefas, portanto não é uma taxa de sucesso média uniforme. As barras de erro também limitam conclusões sobre pequenas diferenças entre barras semelhantes.
Comparação de conjunto de dados único com π0
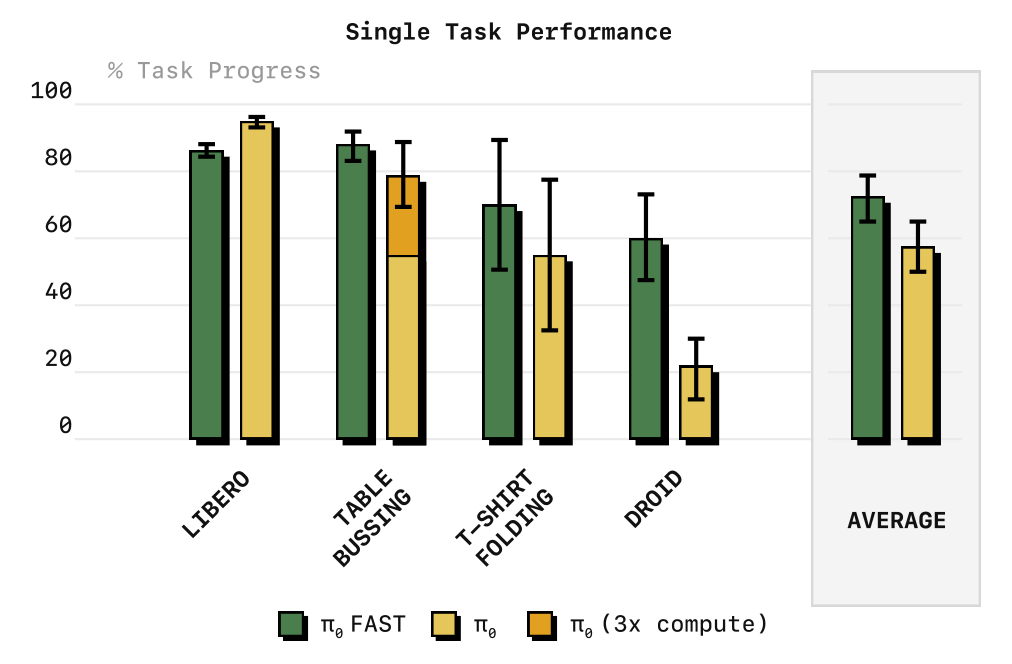
-
Em conjuntos de dados menores como LIBERO e dobragem de camiseta, os autores julgam o desempenho comparável.
-
Em grandes dados de arrumação de mesa, FAST atinge desempenho forte mais cedo; π0 leva cerca de três vezes mais passos para se aproximar disso.
-
Em DROID, π0-FAST segue a linguagem de forma mais confiável enquanto o π0 com flow-matching frequentemente a ignora; o artigo não estabelece a causa subjacente.
Explicação: Teacher forcing calcula perdas para posições de saída em paralelo durante o treinamento; a inferência autoregressiva permanece sequencial. Treinamento mais rápido e inferência mais lenta podem coexistir. Esses resultados não estabelecem superioridade autoregressiva universal.
Generalistas em larga escala e comparação com computação equivalente
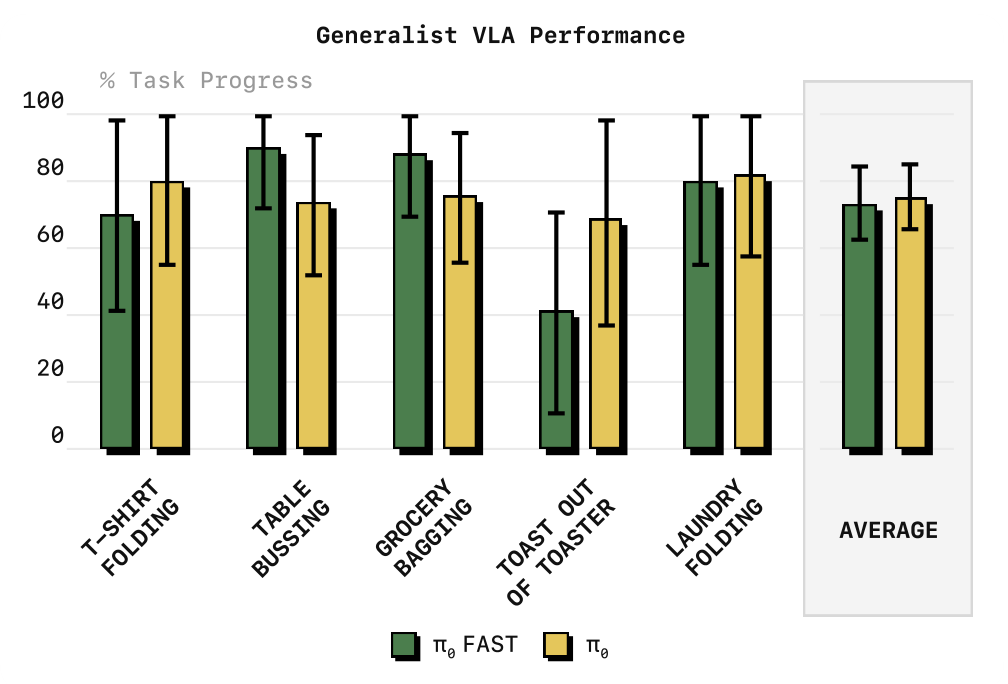
π0-FAST tem desempenho geral semelhante ao π0 em dobragem, arrumação, ensacamento, torradas e lavanderia. As tarefas individuais variam; torradas não sustentam uma afirmação de superioridade universal do FAST. O π0-FAST avaliado usa cerca de um quinto das horas de GPU.
Cuidado: VI-F descreve de forma ampla a comparação zero-shot, mas o Apêndice E especifica ajuste fino de tarefa de alta qualidade para lavanderia após pré-treinamento em larga escala. Ensacamento e torradas usam modelos pré-treinados diretamente. Nem toda tarefa da Figura 6 está livre de ajuste fino específico da tarefa.
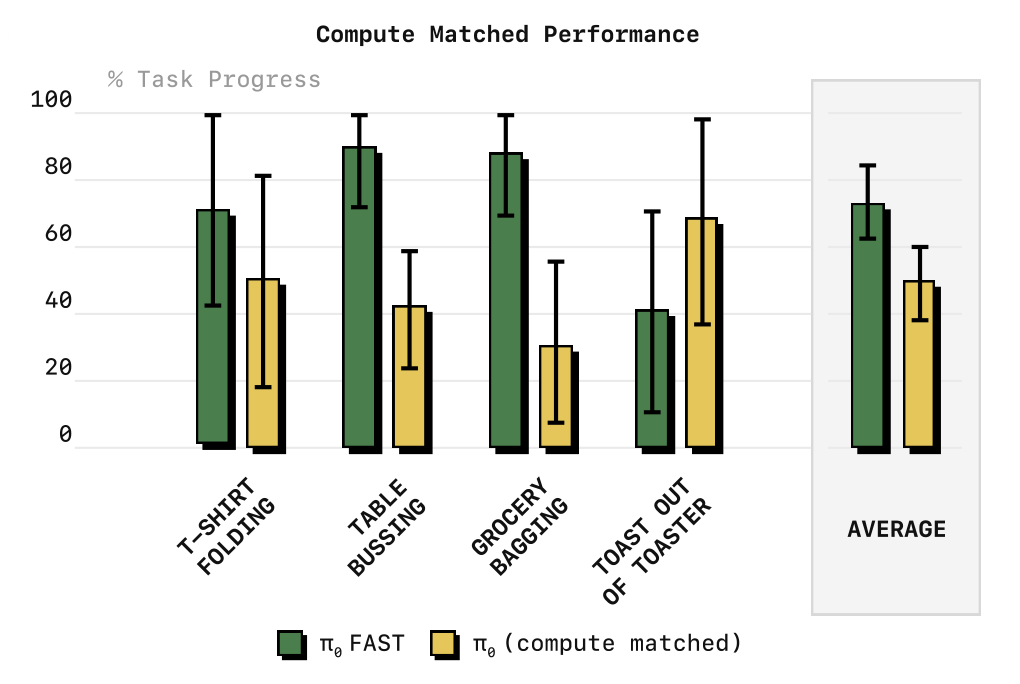
A equiparação de computação apoia mais diretamente a convergência mais rápida: FAST tem uma média geral mais alta e ganhos claros em arrumação/ensacamento, embora ainda fique atrás em torradas. Isso é evidência de eficiência de treinamento, não de capacidade final mais forte em todas as tarefas.
Limite de implantação: Em uma RTX 4090, VI-E relata geralmente menos de 100 ms para π0 e cerca de 750 ms para π0-FAST por bloco de um segundo. FAST decodifica cerca de 30–60 tokens através de todo o backbone de linguagem; π0 repete principalmente seu especialista menor de 300M por dez atualizações de fluxo. Tarefas estáticas toleram essa latência, mas tarefas dinâmicas e otimização de inferência permanecem trabalho futuro.
Tokenização em espaço de frequência e modelagem de política autoregressiva
Mecanismo 1: Expressar uma trajetória com DCT
Problema e intuição
Pontos de controle vizinhos em trajetórias suaves são semelhantes. Alvos independentes crescem com a taxa de amostragem sem adicionar muita informação. DCT, em vez disso, descreve quais formas de cosseno se combinam, e com quais amplitudes, para formar a trajetória.
Alguns poucos coeficientes de baixa frequência frequentemente descrevem a forma global suave; frequências mais altas representam mudanças rápidas e detalhes. A própria DCT nem descarta altas frequências nem impõe um filtro passa-baixa fixo. DCT completa e DCT inversa são reversíveis; a quantização introduz a perda.
Expressão formal
Explicação: O artigo aplica DCT de forma independente ao longo de cada dimensão de ação. Uma convenção DCT-II ortonormal é usada abaixo para clareza, sem afirmar que o pseudocódigo especifica essa normalização.
Para um bloco normalizado :
indexa o tempo dentro do bloco, dimensões de ação, e frequência. é a matriz de coeficientes. é constante; mais altos variam mais rápido. DCT atua ao longo do tempo, não entre juntas.
A inversa correspondente é:
Cada ponto no tempo depende de múltiplas frequências; um coeficiente de frequência geralmente afeta todo o bloco.
Exemplo numérico mínimo
Explicação: Considere , com ações normalizadas ilustrativas:
A primeira dimensão constante precisa de apenas um coeficiente constante diferente de zero. A segunda dimensão crescente é representada principalmente pelo componente constante e pelo primeiro componente variante, com um pequeno coeficiente de frequência mais alta. Ainda há quatro instantes de tempo e duas dimensões; apenas a representação de coordenadas muda.
Por que isso ajuda: Amostras densas de movimento suave adicionam pontos semelhantes sem necessariamente adicionar frequências importantes. Concentrar informações compartilhadas torna possível a compressão em menos tokens informativos.
Escala e limites: Os blocos geralmente têm cerca de um segundo. não oferece redundância temporal; blocos curtos limitam a compressão, enquanto blocos longos aumentam o horizonte e, se executados em malha aberta, atrasam o feedback. Contato abrupto ou transições do gripper podem exigir frequências mais altas; algumas poucas baixas frequências não podem representar com precisão toda ação.
Mecanismo 2: Quantização, ordenação por frequência primeiro e BPE
Por que DCT sozinha é insuficiente
DCT ainda produz coeficientes reais. Tokenizar cada um separadamente não encurta a sequência, e coeficientes próximos de zero criam rótulos repetidos. FAST, portanto, adiciona quantização e BPE.
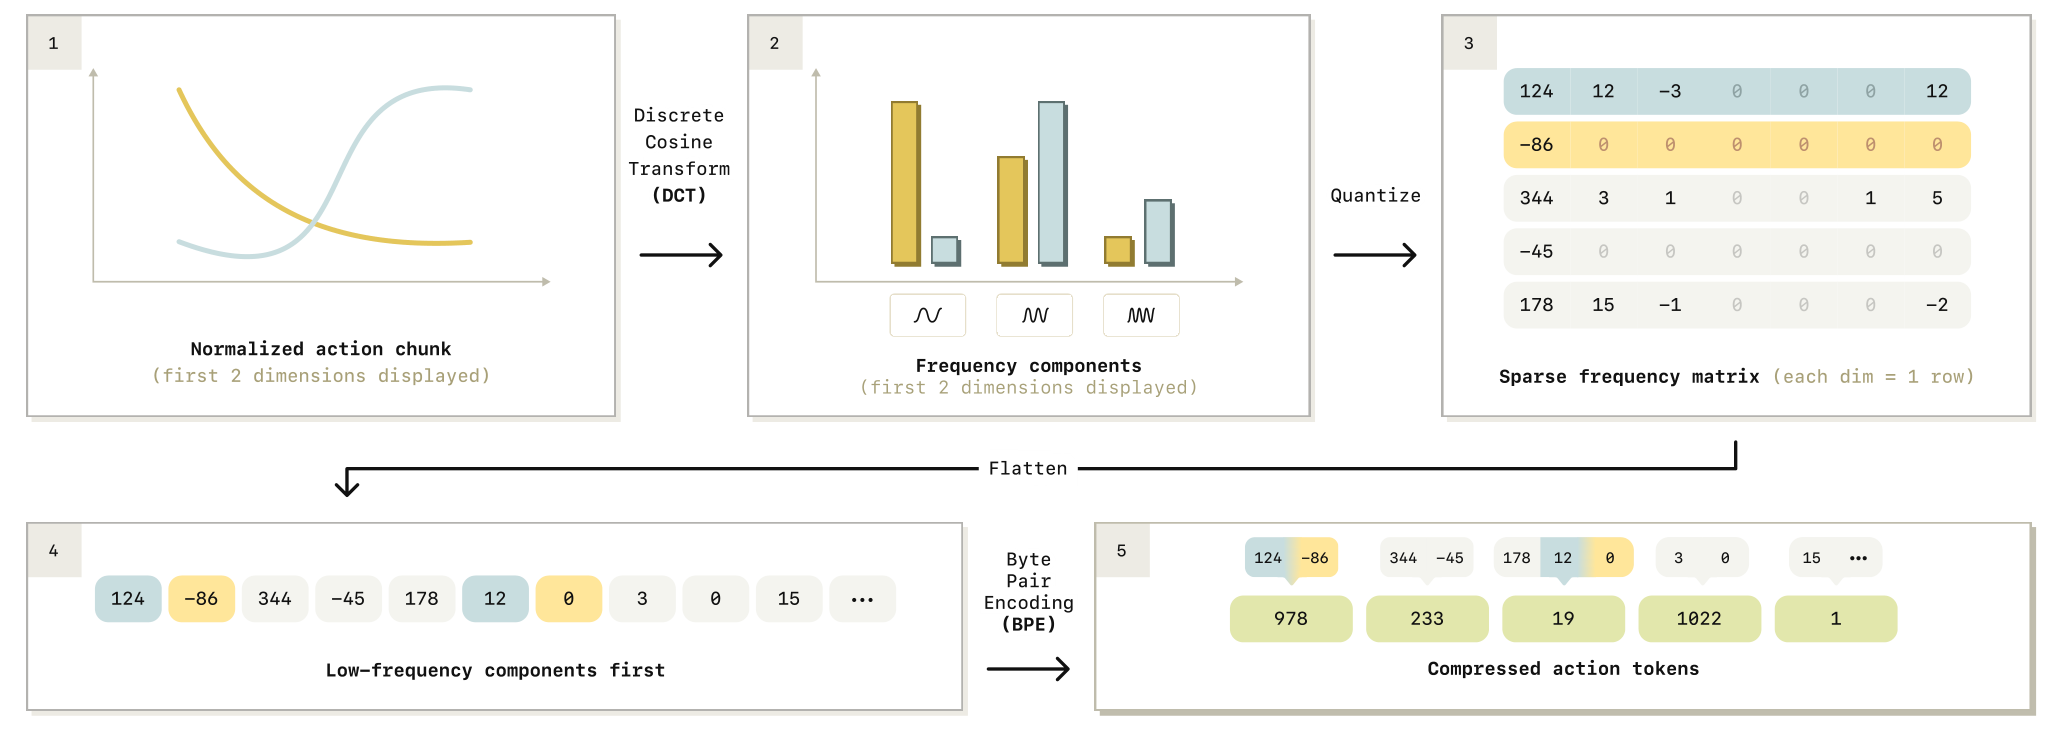
Normalização por percentil por dimensão
Artigo: Mapear os percentis 1 e 99 de cada dimensão dos dados de treinamento para e , reduzindo diferenças de escala e a influência de outliers.
Explicação: Para uma dimensão não degenerada:
e são os percentis 1 e 99, respectivamente; é o componente de ação física, e seu valor normalizado sem unidade. Se para uma junta, ações físicas mapeiam para .
Cuidado: Mapear percentis não força todo valor para dentro de . Siga a implementação para recorte (clipping) e para o caso degenerado ; a v1 não detalha isso. Salve as estatísticas de treinamento para implantação em vez de recomputar percentis em cada bloco previsto.
Escalonar e Arredondar para Criar Inteiros Compressíveis
é a matriz de inteiros, a escala, e os coeficientes reconstruídos. Um maior torna a malha mais fina, geralmente melhorando a reconstrução, mas potencialmente aumentando os tokens; valores menores zeram mais coeficientes pequenos e comprimem mais, com erro maior.
Artigo: Os experimentos específicos de conjunto de dados usam e vocabulário , com sensibilidade limitada na faixa testada. Esses não são ajustes universais para espaços de ação arbitrários.
Continuando o exemplo com :
A alta frequência torna-se zero, enquanto torna-se . Nenhuma regra mantém apenas as duas primeiras frequências; qualquer coeficiente suficientemente grande pode permanecer diferente de zero.
Explicação: O arredondamento comum garante . Isso limita o erro de um coeficiente, não o erro físico da junta diretamente, que também depende da transformação inversa, da escala de ação e do clipping.
Ordenação por Frequência Prioriza a Forma Global
Antes do BPE, FAST ordena os coeficientes por frequência crescente e, em seguida, por dimensão de ação dentro de cada frequência:
contém inteiros. No exemplo:
Frequency 0, two dimensions: 4, 3
Frequency 1, two dimensions: 0, -2
Frequency 2, two dimensions: 0, 0
Frequency 3, two dimensions: 0, 0
Flattened: 4, 3, 0, -2, 0, 0, 0, 0
Artigo: A ordenação por frequência produz rollouts mais estáveis do que a ordenação por dimensão, ao prever primeiro a forma global de baixa frequência. A matriz original chama isso de ordem por colunas; a convenção deste guia a torna ordem por linhas. O que importa é a ordenação semântica, não o rótulo de linha/coluna.
BPE Agrupa Subsequências de Inteiros Comuns
BPE aprende combinações frequentes de símbolos adjacentes e as adiciona a um vocabulário finito. Um vocabulário ilustrativo pode agrupar ou em tokens individuais, encurtando o exemplo de oito inteiros.
Explicação: As regras de mesclagem reais e os IDs dependem dos dados de treinamento; estes não são o vocabulário literal do artigo. Um token pode abranger dimensões ou frequências vizinhas, e a decodificação o expande de volta em inteiros.
Distinção chave: Arredondar coeficientes é com perda; BPE é sem perda na sequência de inteiros quantizados. Posições de zero são preservadas e comprimidas, não removidas. Caso contrário, a transformação inversa perderia suas localizações de frequência e dimensão.
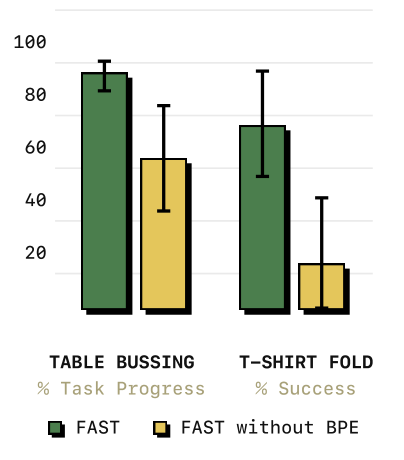
Lendo a ablação: Sem BPE, DCT ainda concentra informação e supera o binning ponto a ponto, mas tokens de zero repetidos diluem a supervisão e adicionam etapas de decodificação. O desempenho cai em ambas as tarefas reais, apoiando contribuições separadas de DCT e BPE.
Modelando Demonstrações e Reutilizando FAST+ entre Corpos
Uma Observação Pode Ter Várias Ações Válidas
Uma pessoa pode segurar qualquer um dos cantos da camisa ou desdobrá-la de forma diferente. A regressão direta de erro quadrático médio pode fazer a média de alternativas válidas em um caminho intermediário inválido. π0 modela uma distribuição contínua; π0-FAST modela probabilidades sobre tokens comprimidos.
Fatorização autoregressiva:
é a sequência FAST e seu prefixo antes do token . Cada etapa prevê probabilidades no vocabulário em vez de fazer a média de valores físicos de ação; a sequência completa decodifica para uma trajetória.
Cuidado: FAST não tem codificador CVAE, bloco de ação Gaussiano ruidoso ou entrada de tempo de fluxo como π0. Esta seção explica o modelamento de demonstrações sem importar módulos ACT ou π0. A cobertura ainda depende dos dados, da fidelidade da quantização e do aprendizado.
Por que Rótulos Repetidos em Alta Taxa Enfraquecem o Aprendizado
Explicação: Quando valores adjacentes mal mudam, a entropia condicional do próximo token pode ser baixa:
é um token de ação aleatório e entropia condicional, distinta do horizonte . Um prefixo previsível explica grande parte do próximo rótulo, então a repetição pode obter boa pontuação sem dependência suficiente da imagem ou da tarefa.
Essa perspectiva de informação explica os resultados sintéticos e de alta taxa; não é prova de que toda política binada falha ou de que menos tokens sempre ajudam. Perda severa de compressão ainda pode produzir comportamento incorreto.
Um Vocabulário Universal com FAST+
As etapas analíticas de FAST se transferem entre conjuntos de dados, mas um vocabulário BPE específico de conjunto de dados não necessariamente o faz. FAST+ aprende uma cobertura mais ampla a partir de cerca de um milhão de blocos entre corpos diferentes:
Multiple robots, action spaces, and control rates
→ Normalize for each data configuration
→ Pad training actions to 32 dimensions
→ DCT, quantization, frequency-first flattening
→ Train BPE on the pooled integer sequences
→ Reusable FAST+ tokenizer
O vocabulário aprende padrões comuns de coeficientes e zeros, não semântica de câmera ou o controlador cinemático completo de um robô. Uma nova política ainda precisa de dados de imagem, linguagem, estado e ação para aprender o que fazer. Tokenização universal e controle generalista são níveis diferentes.
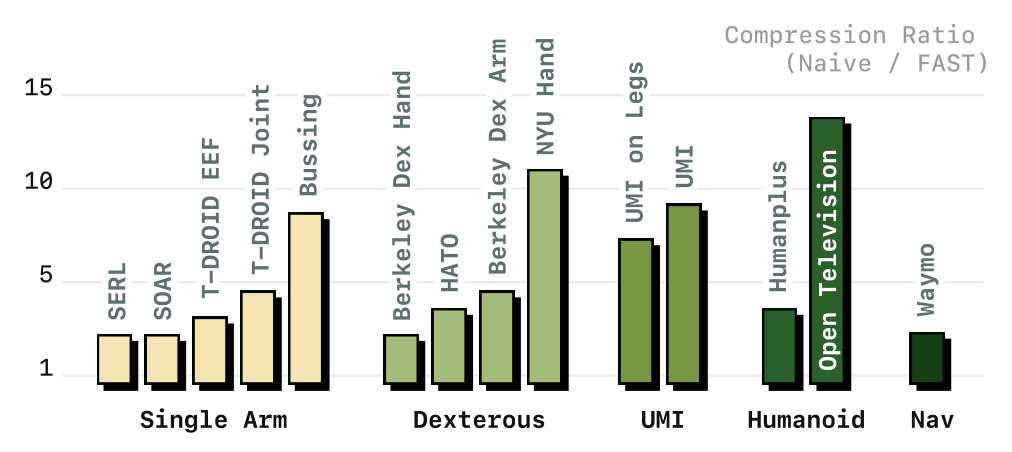
Lendo a figura: FAST+ comprime formas, dimensões e frequências variadas. A Seção VI-C chama os testes de dados não vistos, enquanto a Tabela III inclui versões de plataformas/tarefas também nomeadas no treinamento. “Não visto” é, portanto, mantido no nível de divisão de dados do artigo, não estendido a todas as categorias de robô.
Limite: A Figura 10 é compressão offline, não sucesso de locomoção humanoide, mão hábil ou política de direção. A Seção VII observa que políticas físicas são validadas principalmente em manipuladores estacionários. A Tabela III inclui dados humanoides 40D, então o padding de treinamento 32D não é um máximo matemático para o método.
Treinando, Codificando e Decodificando o Tokenizador
Treinamento do Tokenizador
Para blocos de demonstração , com índice de amostra :
-
Calcule e salve estatísticas de percentil por dimensão para cada configuração de dados.
-
Normalize para e aplique DCT ao longo do tempo de forma independente por dimensão.
-
Quantize para inteiro usando fixo.
-
Achate em ordem de frequência primeiro para .
-
Treine BPE de tamanho fixo em todas as sequências de inteiros para obter o vocabulário e as regras de mesclagem .
Artigo: BPE é o único componente de tokenizador aprendido. Um vocabulário específico geralmente é treinado em minutos, não nos dias ou mais necessários para um VLA. DCT e quantização não têm pesos neurais e não precisam de codificador/decodificador VQ separado.
Codificação: Transformar Demonstrações Futuras em Rótulos
A codificação completa é:
é a normalização, o achatamento com frequência primeiro, e regras BPE fixas. DCT atua ao longo do tempo por dimensão. A codificação precisa de ações futuras reais, então cria rótulos de treinamento em vez de assumir conhecimento futuro durante a implantação.
Cuidado: O Algoritmo 1 começa em DCT, omitindo a normalização explícita, enquanto a Seção V-B a especifica em prosa. Este guia segue o pipeline completo. O arredondamento não pode ser invertido exatamente, então a decodificação reconstrói uma aproximação das ações pré-quantizadas.
Decodificação: Transformar Previsões em Ações Executáveis
Após gerar :
é a contagem de tokens gerados; reconstrói a matriz de coeficientes e é a inversa correspondente. O final é contínuo. A implantação ainda precisa de alvo; o comprimento variável de tokens não substitui a definição da interface de controle.
Para a normalização linear anterior, a desnormalização é:
Explicação: A transformação inversa do exemplo com fornece aproximadamente:
A segunda dimensão original é ; a reconstrução preserva sua forma crescente com pequenos erros. A decodificação BPE não adiciona nenhuma mudança a : a quantização causa o erro. Esses são valores normalizados, não diretamente radianos ou milímetros.
Verificar Compressão e Reconstrução em Conjunto
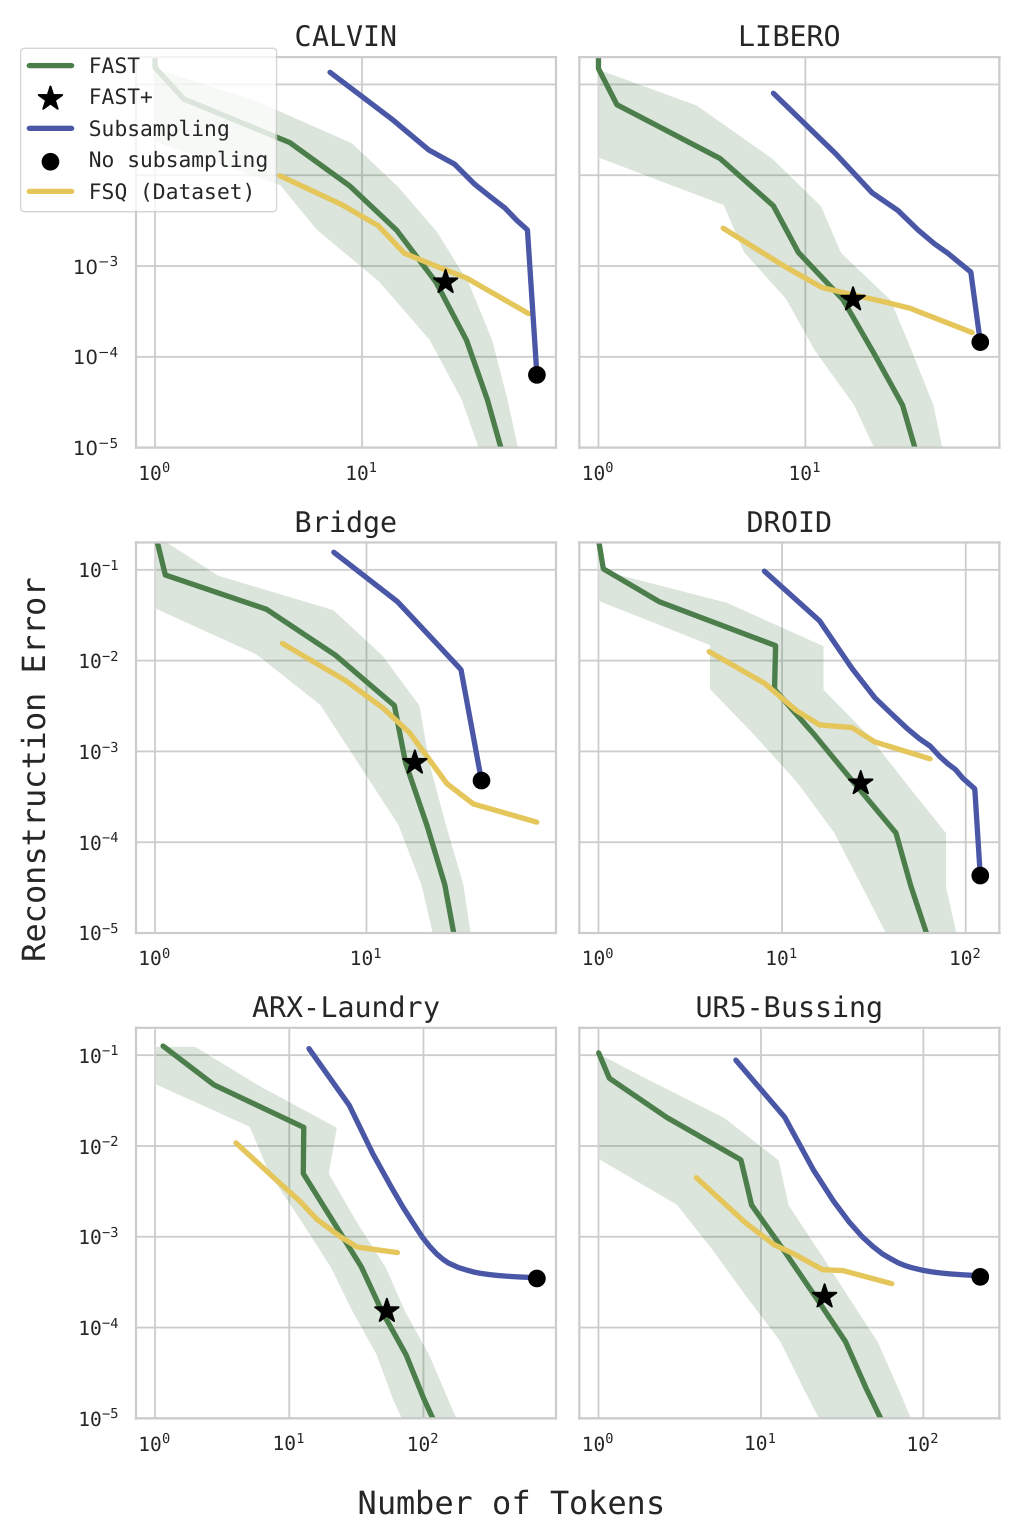
Lendo a figura: FSQ aprendido pode ser eficaz em baixa precisão e com pouquíssimos tokens. Em maior precisão, o erro de FAST diminui mais com a contagem de tokens e se adapta melhor às tarefas de controle fino testadas. A sequência mais curta não é automaticamente a melhor representação de trajetória.
Limites: Escalas de quantização muito pequenas podem apagar coeficientes e produzir movimento quase constante; escalas grandes melhoram a fidelidade, mas criam menos zeros compressíveis e inteiros mais complexos. Vocabulários maiores representam mais combinações, mas consomem mais posições de saída. A faixa testada não estabelece ganhos de desempenho monotônicos.
Nota de engenharia: Tokens previstos ou comprimentos expandidos podem ser inválidos. Verifique o formato do bloco, as dimensões efetivas e os limites de controle antes da execução. A v1 não especifica totalmente reparos, então padding ou truncamento não devem ser apresentados como uma implementação documentada do artigo.
A Rede π0-FAST Completa
Entradas e Formatos
Cada predição é condicionada em:
-
Duas ou três imagens RGB de .
-
Instrução em linguagem natural .
-
Propriocepção , com dimensões dependentes da plataforma.
-
Apenas durante o treinamento, ações futuras reais para supervisão FAST.
O cenário de camisa da Tabela I usa , resultando em rótulos ; seu cenário DROID usa , resultando em . Use o espaço de ação efetivo para a versão real do conjunto de dados.
Diferença em relação a π0: π0 projeta continuamente estado e ações ruidosas em um especialista. FAST v1 discretiza o estado atual em 256 níveis e tokeniza os inteiros como texto, enquanto ações futuras usam FAST. O estado é uma condição atual em vez de uma longa saída em alta taxa, então os autores consideram a discretização simples suficiente nesse caso.
Recursos de Imagem e Texto em um Único Backbone
Um codificador pré-treinado produz tokens visuais por câmera; strings de tarefa e estado produzem tokens de texto. Juntos, eles formam o prefixo de observação. PaliGemma-3B é o backbone principal, com OpenVLA/Prismatic 7B como comparação de transferência.
Explicação: Com tokens por imagem e tokens de linguagem/estado, o comprimento do prefixo é:
é a contagem de câmeras e o comprimento do prefixo, ignorando alguns separadores/tokens especiais. Para largura de embedding , a representação é . Isso explica as dimensões, não uma especificação completa da v1; contagens visuais, largura, separadores e codificações de posição não são todos fornecidos.
Sufixo de Ação e Atenção
FAST codifica ações demonstradas como tokens, mapeados para slots de VLM raramente usados e fornecidos como um sufixo de predição após o prefixo de observação.
Explicação: A predição do token usa observações e os tokens de ação anteriores, nunca rótulos futuros. Isso é autoregressão causal, sem codificador CVAE ou decodificador de fluxo contínuo.
Os estados ocultos do backbone se tornam logits de vocabulário e probabilidades de classificação. é o vocabulário de ações em experimentos específicos de conjunto de dados, não o vocabulário completo de linguagem.
Loss de Treinamento da Política
Explicação: A log-verossimilhança negativa padrão expressa o objetivo declarado de próximo token:
é o loss autoregressivo, os pesos da política, e a expectativa faz a média sobre demonstrações; varia por amostra. A v1 não especifica completamente a média sobre tokens ou o tratamento de símbolos de fim.
Teacher forcing usa de verdade-terreno durante o treinamento. Uma máscara causal permite losses em todas as posições em um único forward pass, enquanto a inferência depende de prefixos gerados e prossegue sequencialmente. Alvos mais curtos reduzem overhead sem remover a dependência serial da inferência.
Configuração do artigo: 1.000 passos lineares de aquecimento, depois taxa de aprendizado ; AdamW com , sem weight decay, clipping de gradiente em 1 e coeficiente de média móvel exponencial 0,999. Todos os pesos da política são fine-tunados.
Amostragem e Saídas Contínuas
A maioria das tarefas usa decodificação gananciosa (greedy). Dobragem de camisa bimanual, remoção de torrada e lavanderia usam temperatura 0,7, o que os autores consideram ajudar a escapar de comportamento quase estacionário em torno de poses iniciais.
Explicação: Para logits e temperatura :
indexam candidatos e é a probabilidade de amostragem. Este guia usa para distinguir temperatura de do otimizador; o artigo escreve temperatura . Ela difere da escala de quantização .
FAST decodifica tokens para nas unidades físicas do conjunto de dados. DROID usa velocidade de junta e posição absoluta do gripper; outras tarefas usam suas configurações de plataforma. Controladores executam ações válidas, então novas observações geram o próximo bloco.
Ablation: Depois de adicionar entrada multi-imagem e blocos de um segundo ao OpenVLA, substituir a discretização por FAST+ melhora substancialmente a dobragem de camisa. Os benefícios se estendem além do backbone π0, mas o teste não estabelece ganhos iguais para todo VLM.
Fluxo Completo em Comparação com π0
Training:
Demonstration images + task language + current state + real next-second actions
→ Encode images as visual tokens
→ Tokenize language and discretized state text as the observation prefix
→ Normalize actions; DCT; quantize; frequency-first flatten; BPE
→ Map action tokens to VLM output slots
→ Compute teacher-forced next-token cross-entropy
→ Fine-tune all policy weights to obtain π0-FAST

Inference:
Current images + task language + state
→ Construct observation prefix
→ Greedily decode or sample action tokens at the specified temperature
→ Reverse BPE and restore integer coefficient ordering
→ Dequantize, inverse DCT, denormalize
→ Obtain an H × D continuous chunk
→ Execute the configured steps with the low-level controller
→ Observe and predict again

In one sentence:
The VLM selects actions from the scene and task;
DCT concentrates shared information from densely sampled trajectories;
quantization and BPE turn coefficients into shorter token sequences;
autoregressive training models their conditional distribution, and FAST decoding restores continuous control.
The main benefits are action representation and training efficiency; v1 inference latency remains a major limitation.