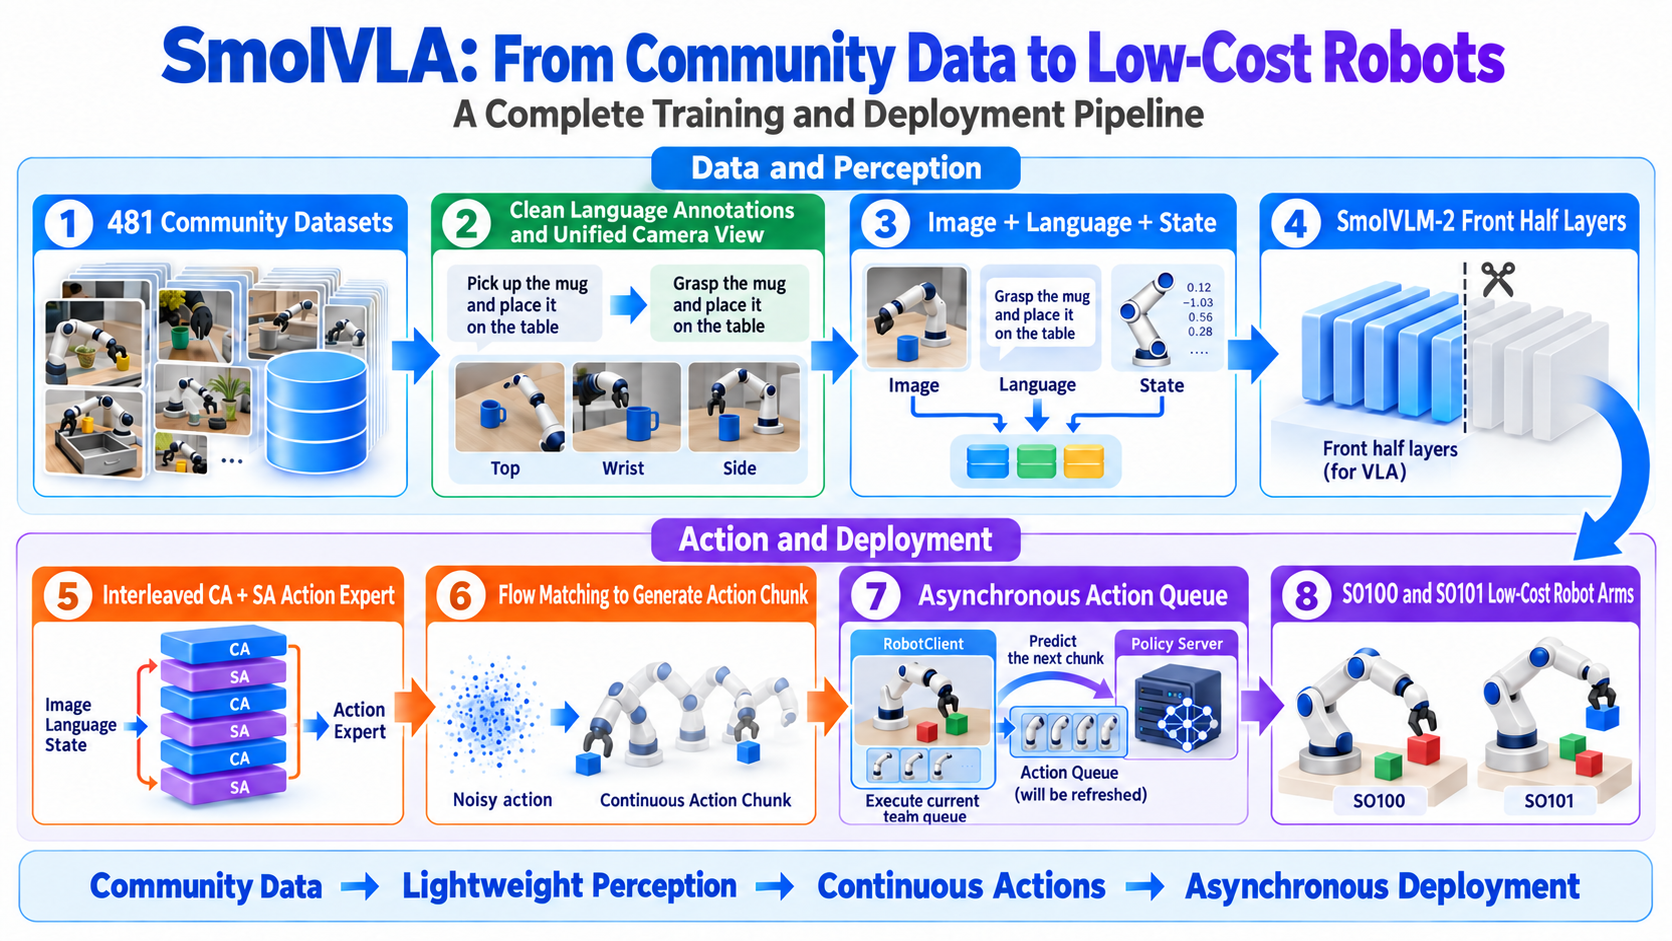
SmolVLA — Modelos de Visão-Linguagem-Ação Acessíveis
SmolVLA: um modelo de visão-linguagem-ação para robótica acessível e eficiente
- VLA leve
- Dados da comunidade
- Flow matching
- Inferência assíncrona
Pré-requisitos
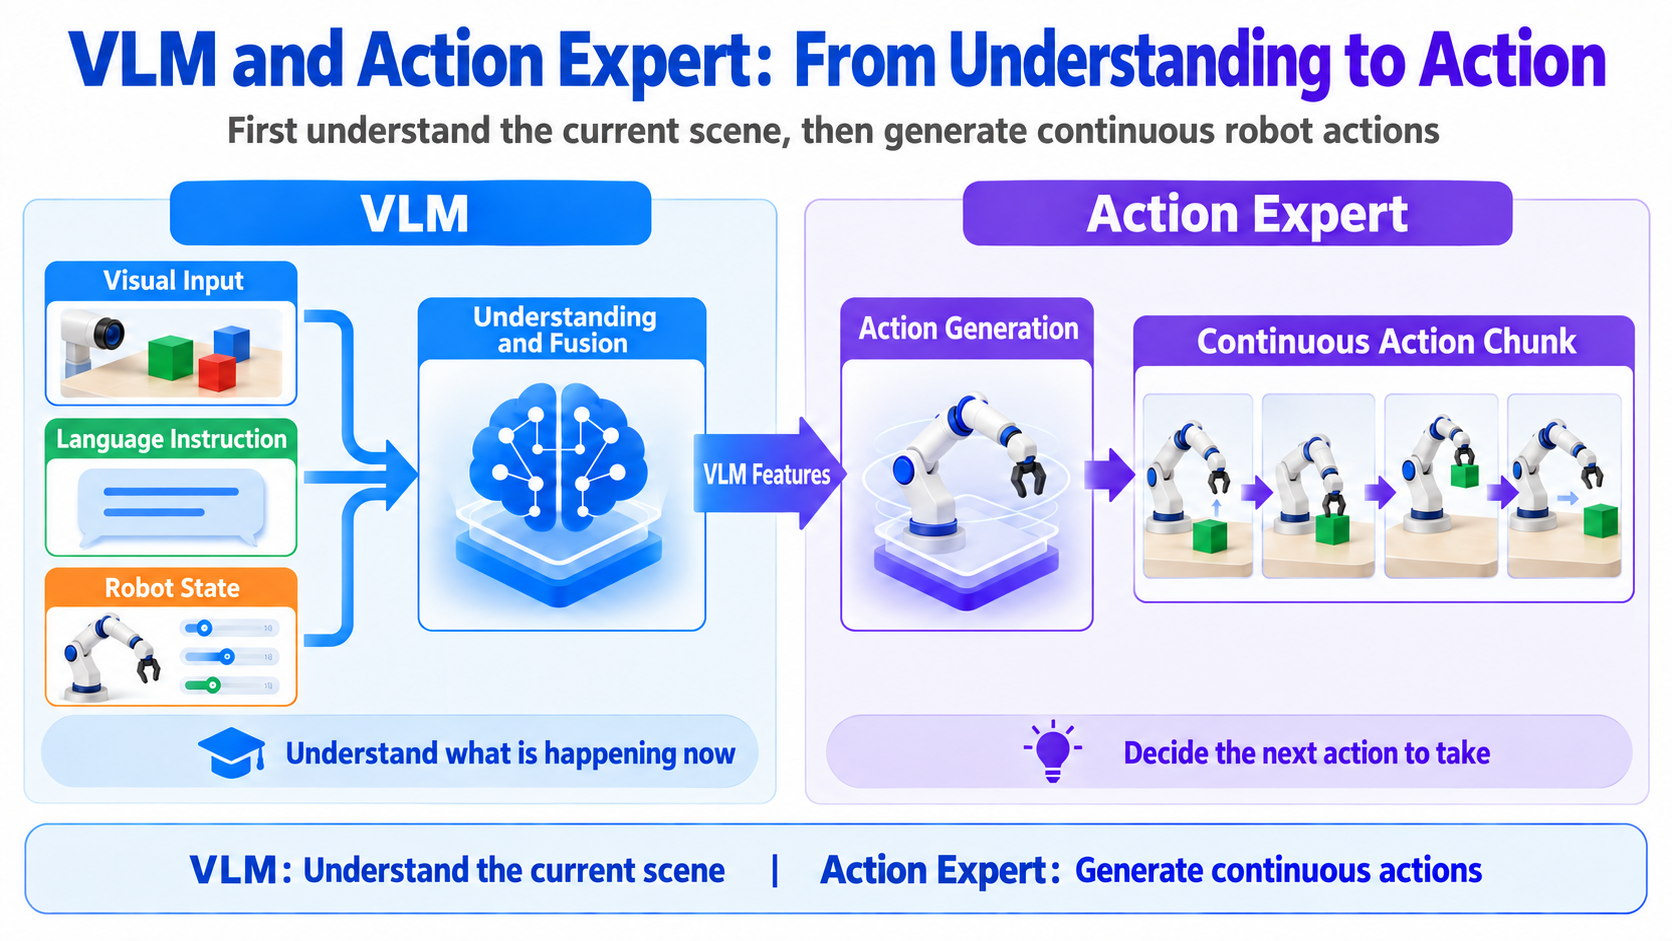
VLMs e VLAs
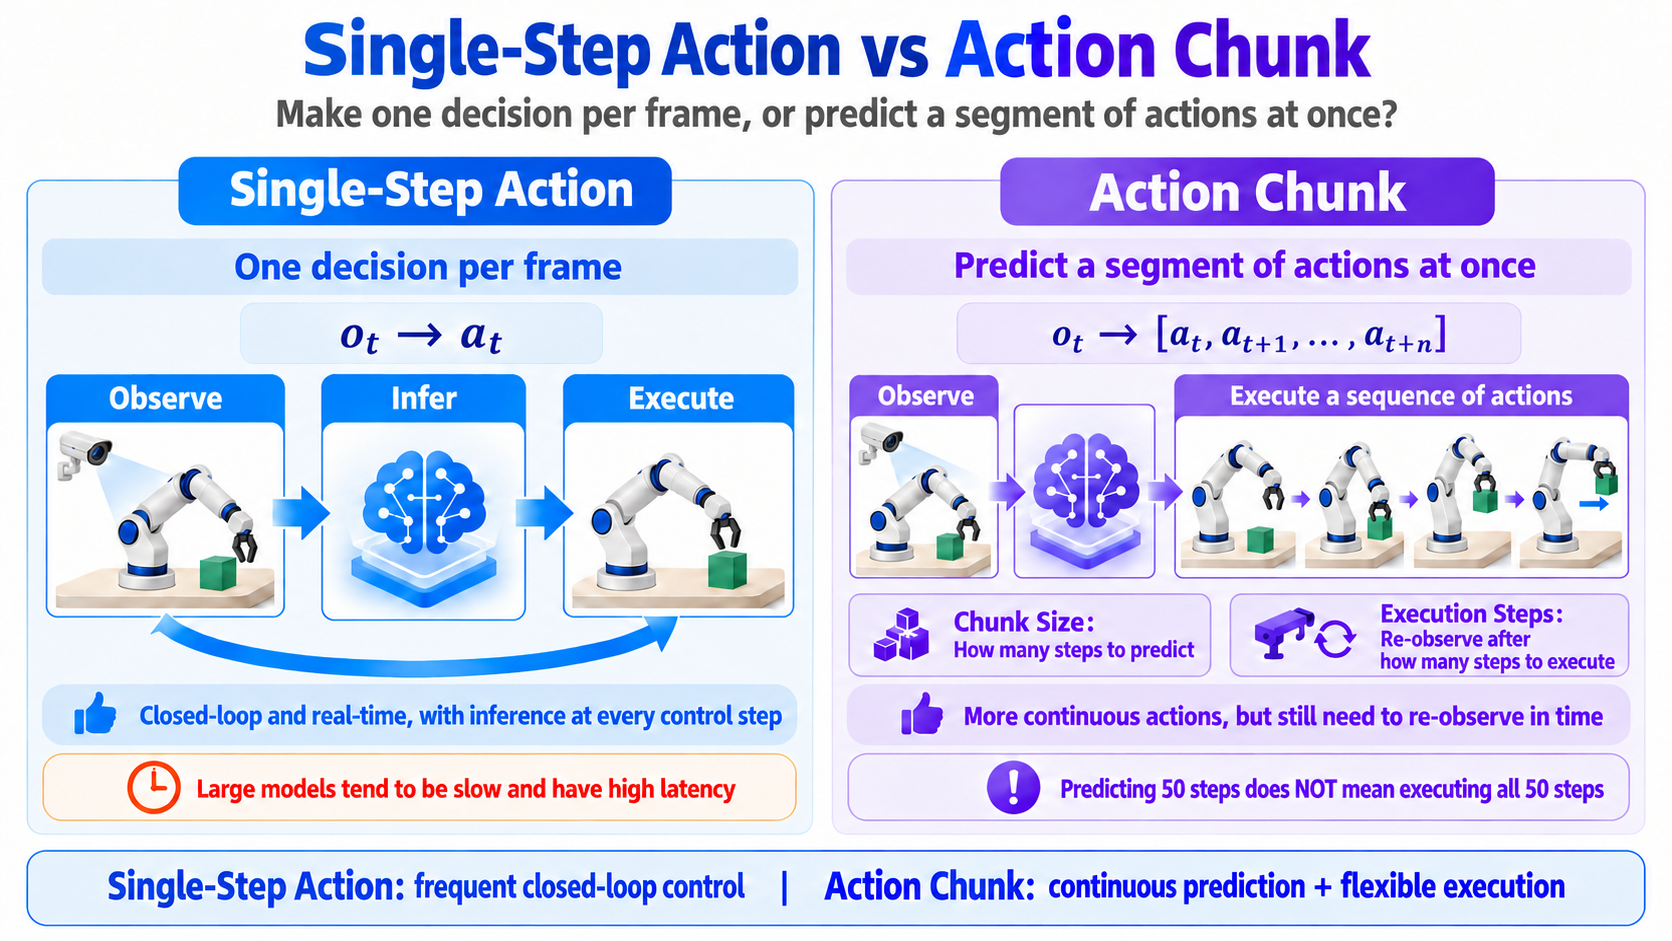
Ações de Único Passo e Blocos de Ação
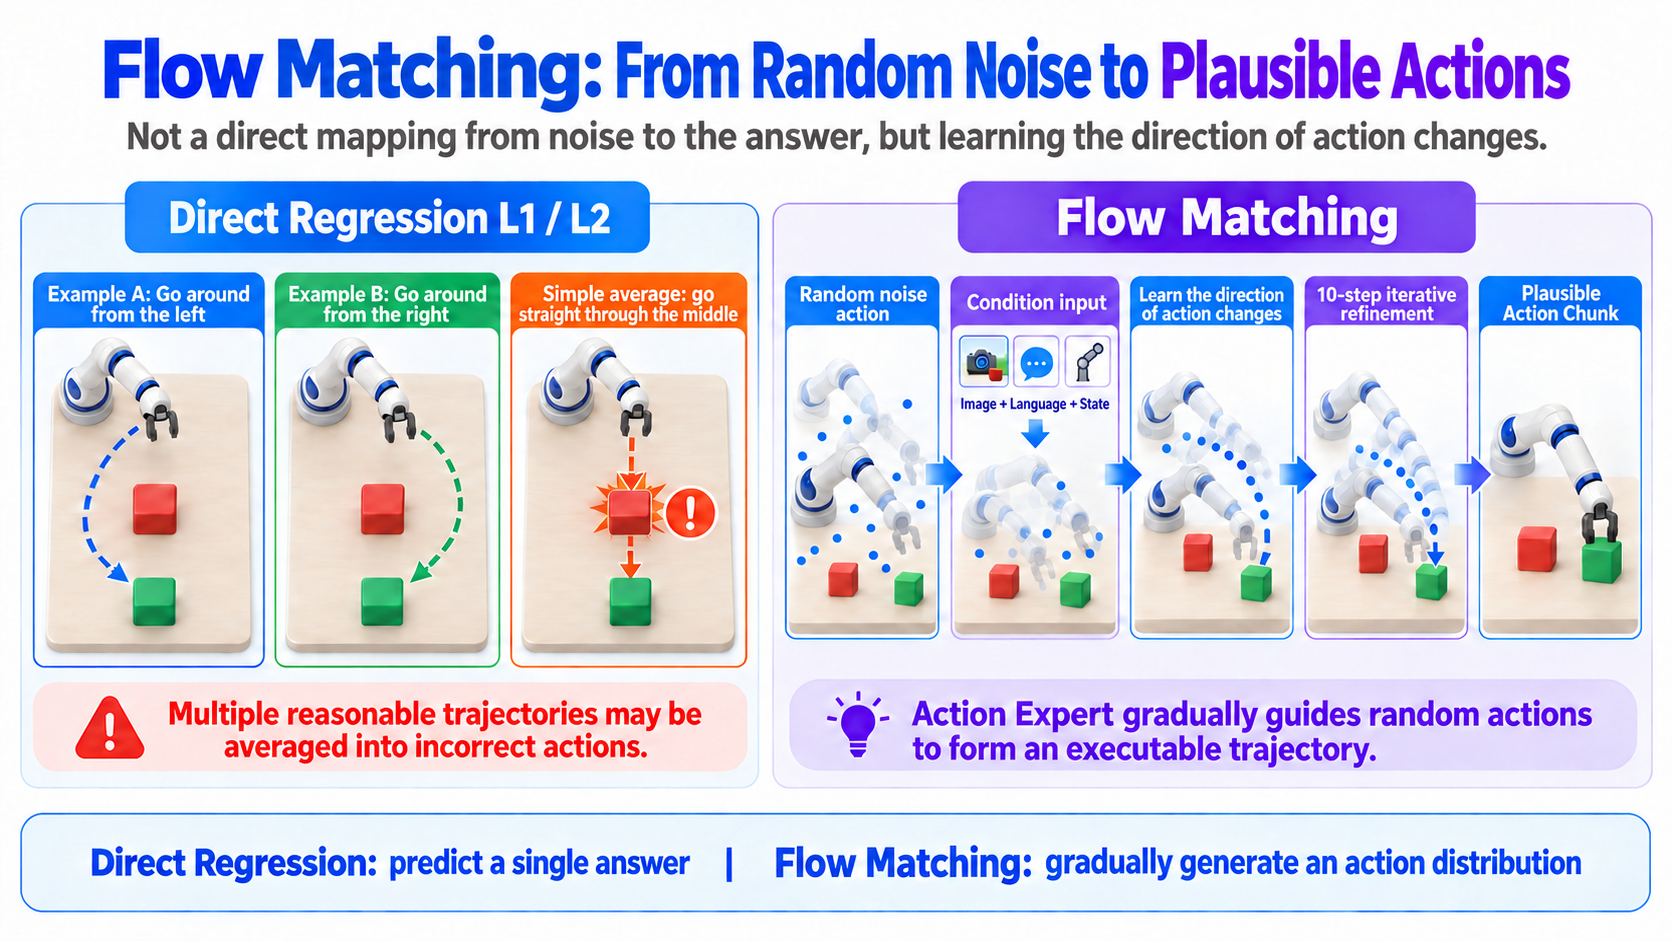
O que é Flow Matching?
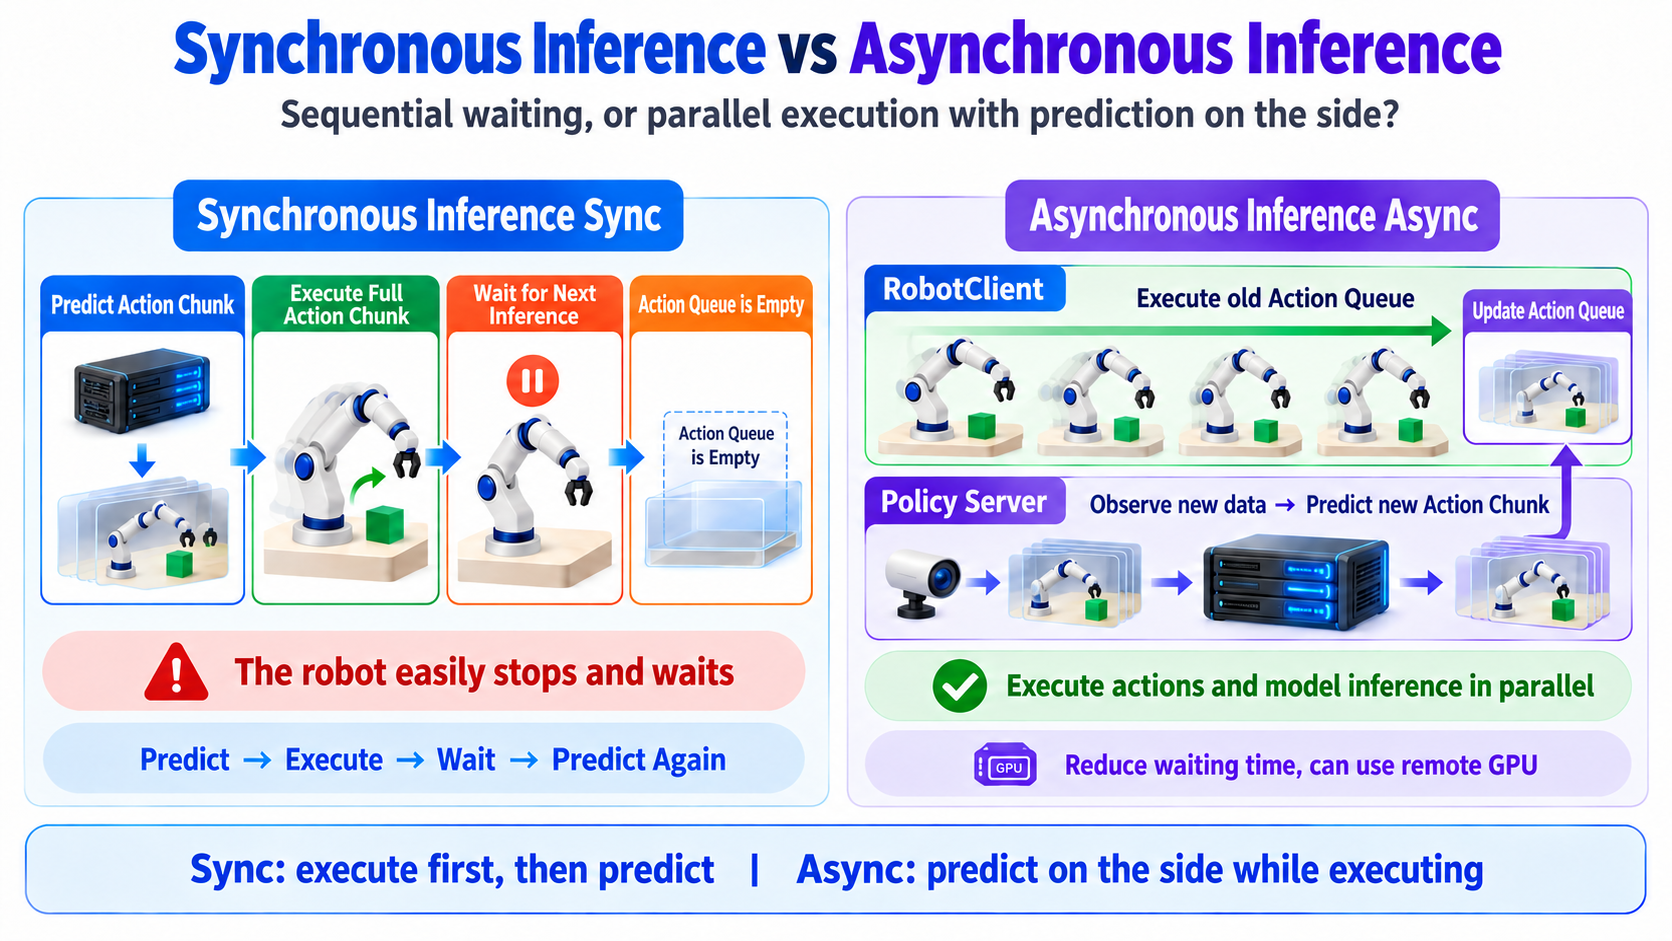
Inferência Síncrona e Assíncrona
Resumo
Modelos de visão-linguagem pré-treinados adquirem conhecimento visual e linguístico substancial a partir de grandes conjuntos de dados multimodais, tornando-se bases úteis para políticas de robôs. Trabalhos recentes adaptam VLMs em VLAs que percebem e controlam robôs a partir de instruções em linguagem natural, em vez de treinar políticas do zero.
No entanto, muitos VLAs contêm bilhões de parâmetros, são caros de treinar e difíceis de implantar em robôs reais. Eles também dependem principalmente de conjuntos de dados acadêmicos e industriais, deixando subutilizados os crescentes dados públicos de comunidades de robôs de baixo custo.
SmolVLA é um VLA pequeno, eficiente e orientado por dados da comunidade. Ele reduz os custos de treinamento e inferência, mantendo desempenho competitivo. Pode ser treinado em uma única GPU e implantado em GPUs de consumo ou até mesmo em uma CPU.
O artigo também apresenta uma pilha de inferência assíncrona que separa percepção e predição de ação da execução. O robô prevê seu próximo bloco enquanto executa o atual. Apesar do seu tamanho, o SmolVLA compete com VLAs aproximadamente dez vezes maiores. Os autores avaliam tarefas em simulação e em robôs reais e disponibilizam código, modelos pré-treinados e dados de treinamento.
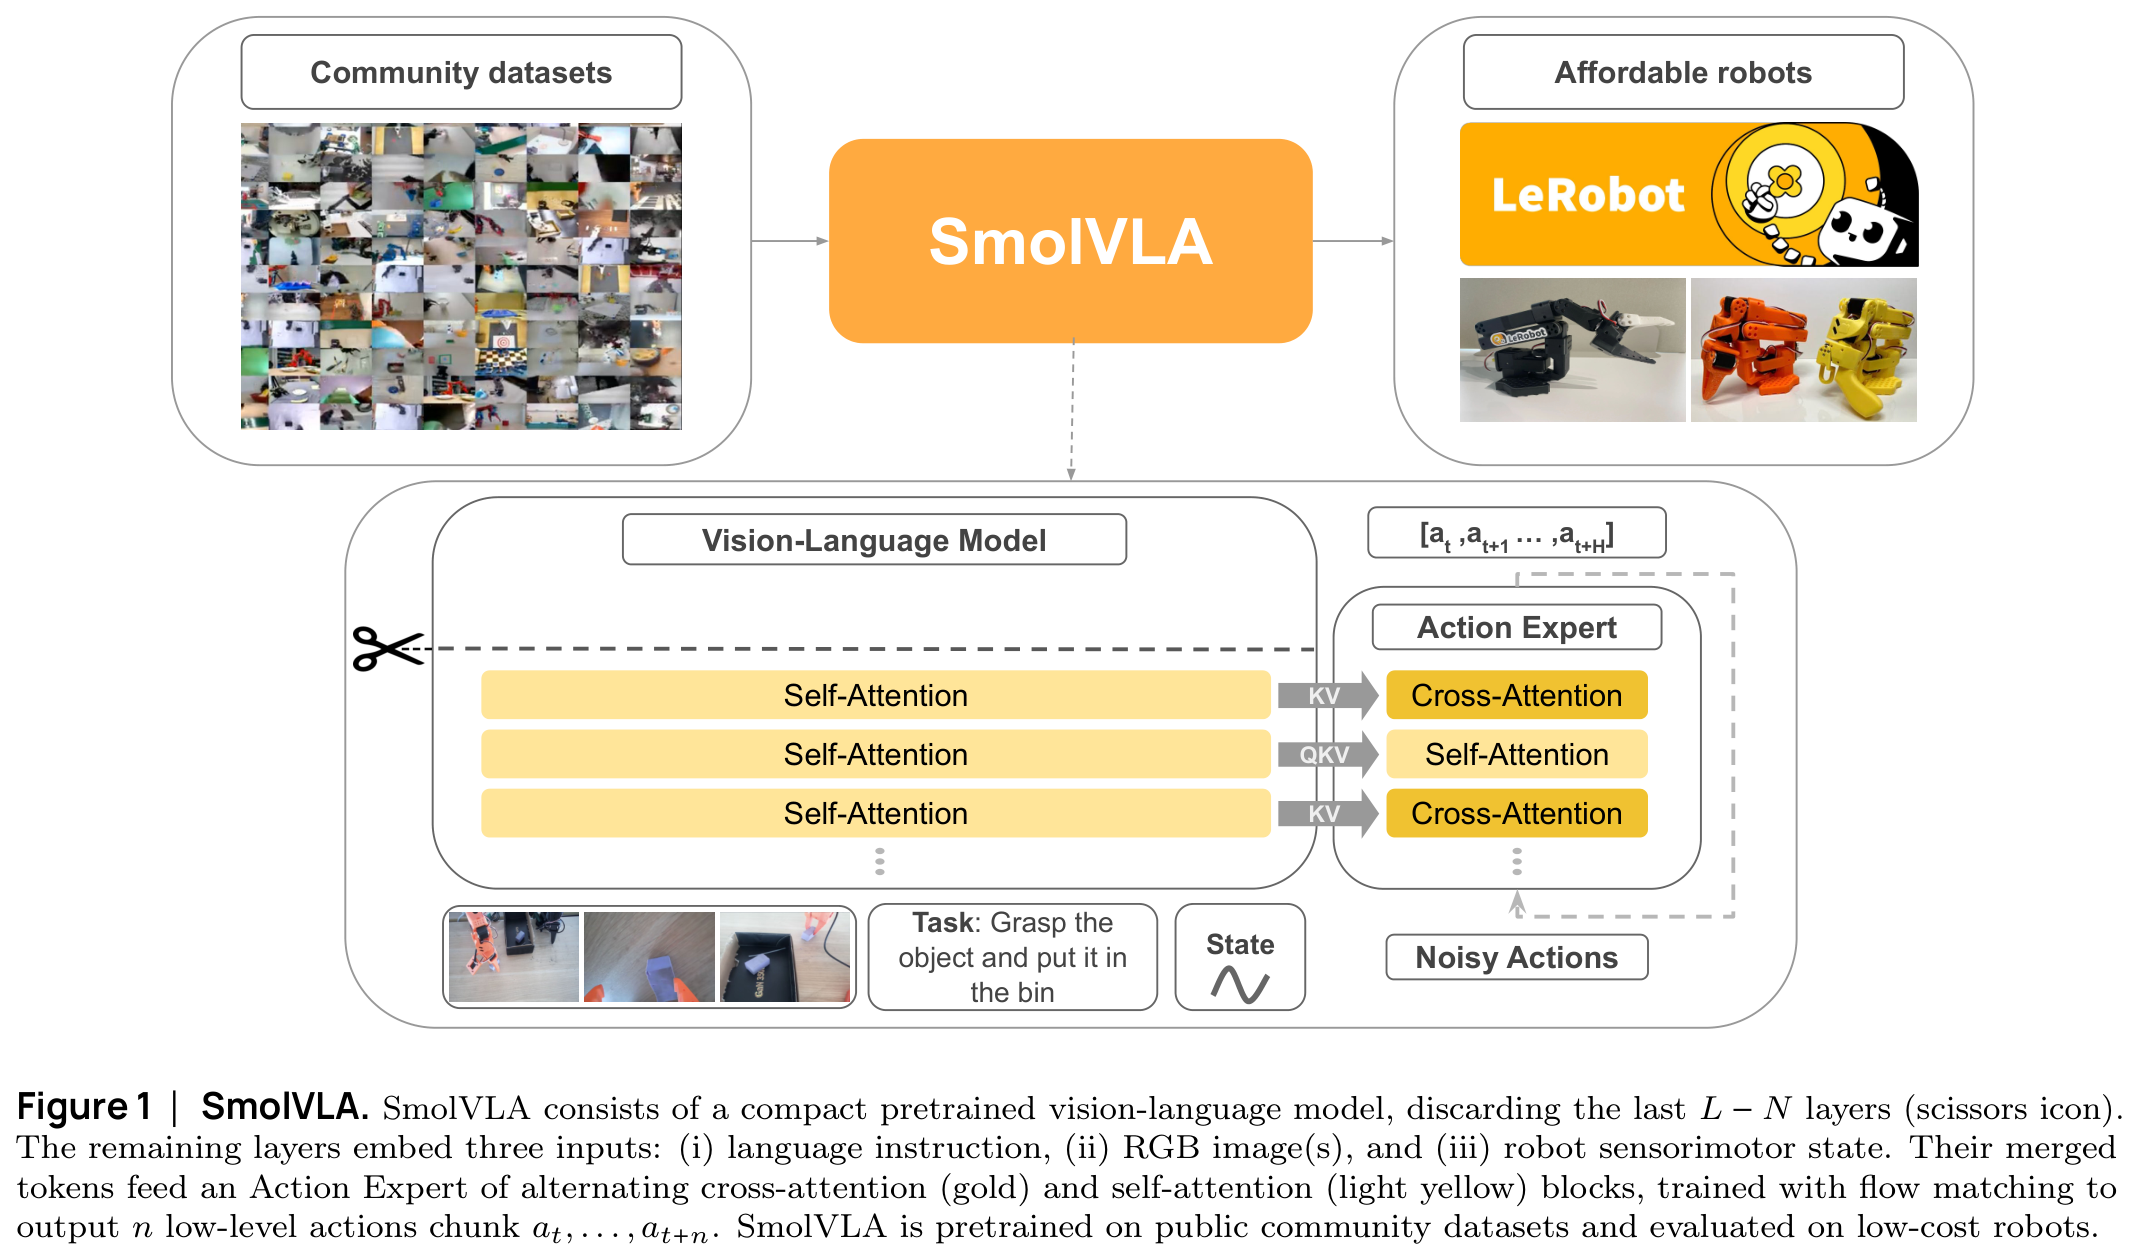
Arquitetura Leve e Rede Completa do SmolVLA
Fluxo geral de dados
- SmolVLA consiste em um VLM e um especialista em ações.
Multi-view RGB images
Language instruction
Robot state
      ↓
    VLM
      ↓
Scene-conditioning features
      ↓
Action Expert + Noisy Actions
      ↓
Flow Matching
      ↓
Action Chunk
- O VLM interpreta o ambiente; o especialista em ações converte essa representação em ações contínuas. O modelo de linguagem fornece recursos de condicionamento em vez de especificar diretamente ângulos de juntas.
Como imagens, linguagem e estado entram no VLM
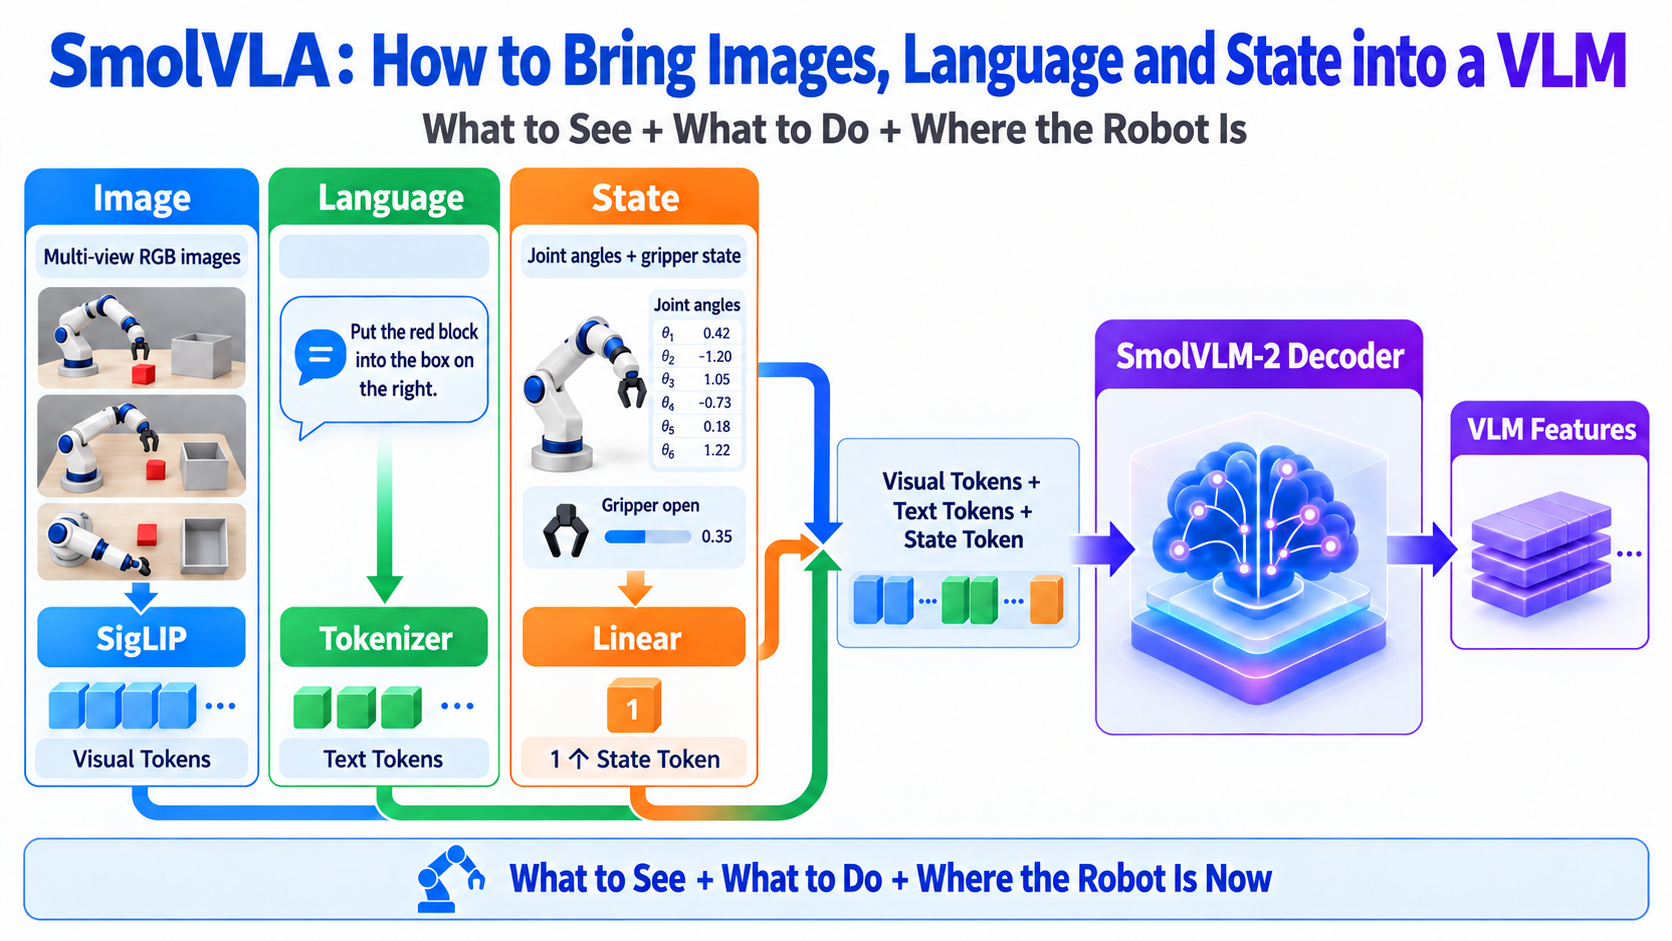
Por que manter apenas 64 tokens visuais por quadro?
-
Imagens de alta resolução produzem muitos tokens visuais. Mais tokens aumentam o cálculo de atenção e tornam a inferência mais lenta.
-
SmolVLM-2 oferece suporte a divisão de imagem em blocos, que codifica várias regiões locais da imagem. SmolVLA desativa essa divisão para ganhar velocidade, mantém a imagem global e usa pixel shuffle para limitar cada quadro a 64 tokens visuais.
-
Isso pode sacrificar detalhes de pequenos objetos e textura fina, mas reduz substancialmente o custo computacional.
Por que usar apenas a primeira metade do VLM?
-
Para um VLM com L camadas, SmolVLA extrai recursos na camada N e descarta as L−N camadas restantes.
-
Os autores constatam que
N = L/2equilibra velocidade e desempenho. O modelo principal usa as primeiras 16 camadas do modelo de linguagem.
Full VLM: Layer 1 → 2 → ... → L

SmolVLA:Layer 1 → 2 → ... → N → Action Expert
                               × Remaining layers are not computed
- Isso mantém a primeira metade em vez de pular camadas alternadas. As ablações sugerem que isso geralmente é melhor do que substituir o backbone por um VLM menor, porque as camadas mantidas preservam a largura e a capacidade de representação do modelo maior.
Como o especialista em ações gera ações
-
O especialista em ações recebe:
-
Recursos de condicionamento do VLM.
-
Um bloco de ação ruidoso.
-
-
Ele alterna entre cross-attention e self-attention causal.
Cross-attention lê a tarefa atual
- Tokens de ação atuam como consultas, lendo chaves e valores dos recursos do VLM para responder:
What is visible now?
What does the instruction request?
What is the robot's current configuration?
Self-attention relaciona as ações
- Self-attention entre tokens de ação torna a sequência futura coerente, por exemplo “aproximar → fechar o gripper → erguer → transportar → posicionar.”
Por que usar uma máscara causal?
-
A máscara permite que a ação i atenda a tokens de ação anteriores, mas não a posteriores.
-
Atenção bidirecional tem desempenho pior nas ablações do artigo. Os autores sugerem que impedir vazamento de ações futuras ajuda a aprender uma estrutura temporal mais adequada.
-
A estrutura final é:
VLM Features ───────┐
                    ↓
Noisy Actions → Cross-Attention
                    ↓
              Self-Attention
                    ↓
              Cross-Attention
                    ↓
              Self-Attention
                    ↓
               Action Chunk
Flow matching no SmolVLA
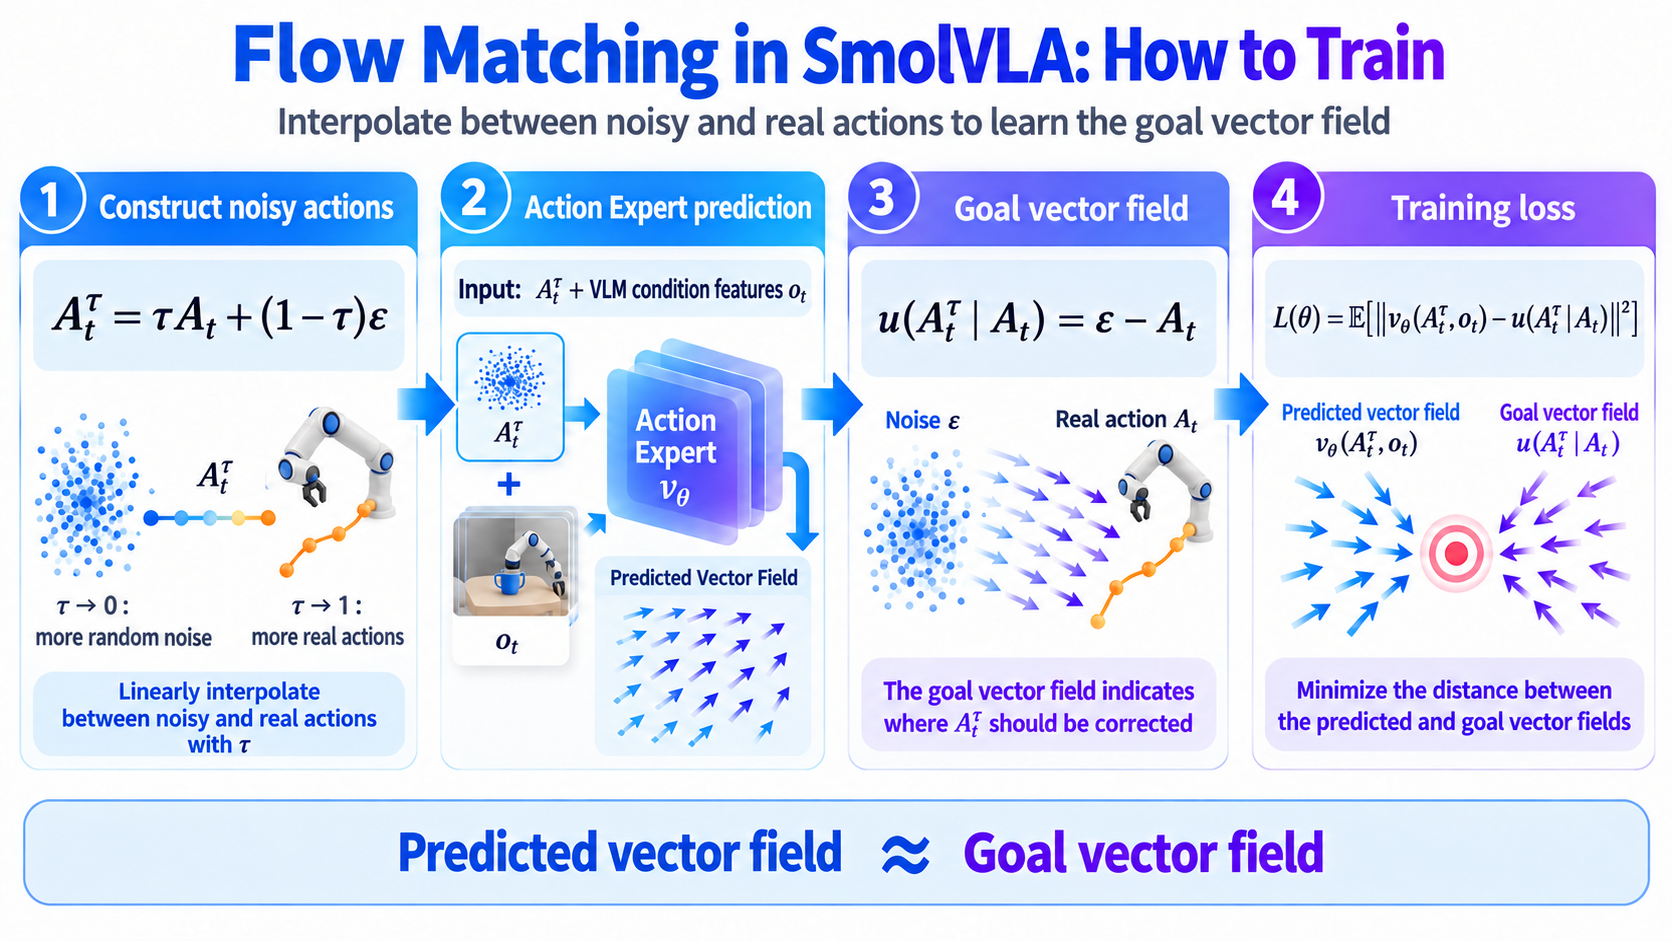
Fluxo completo de treinamento e inferência
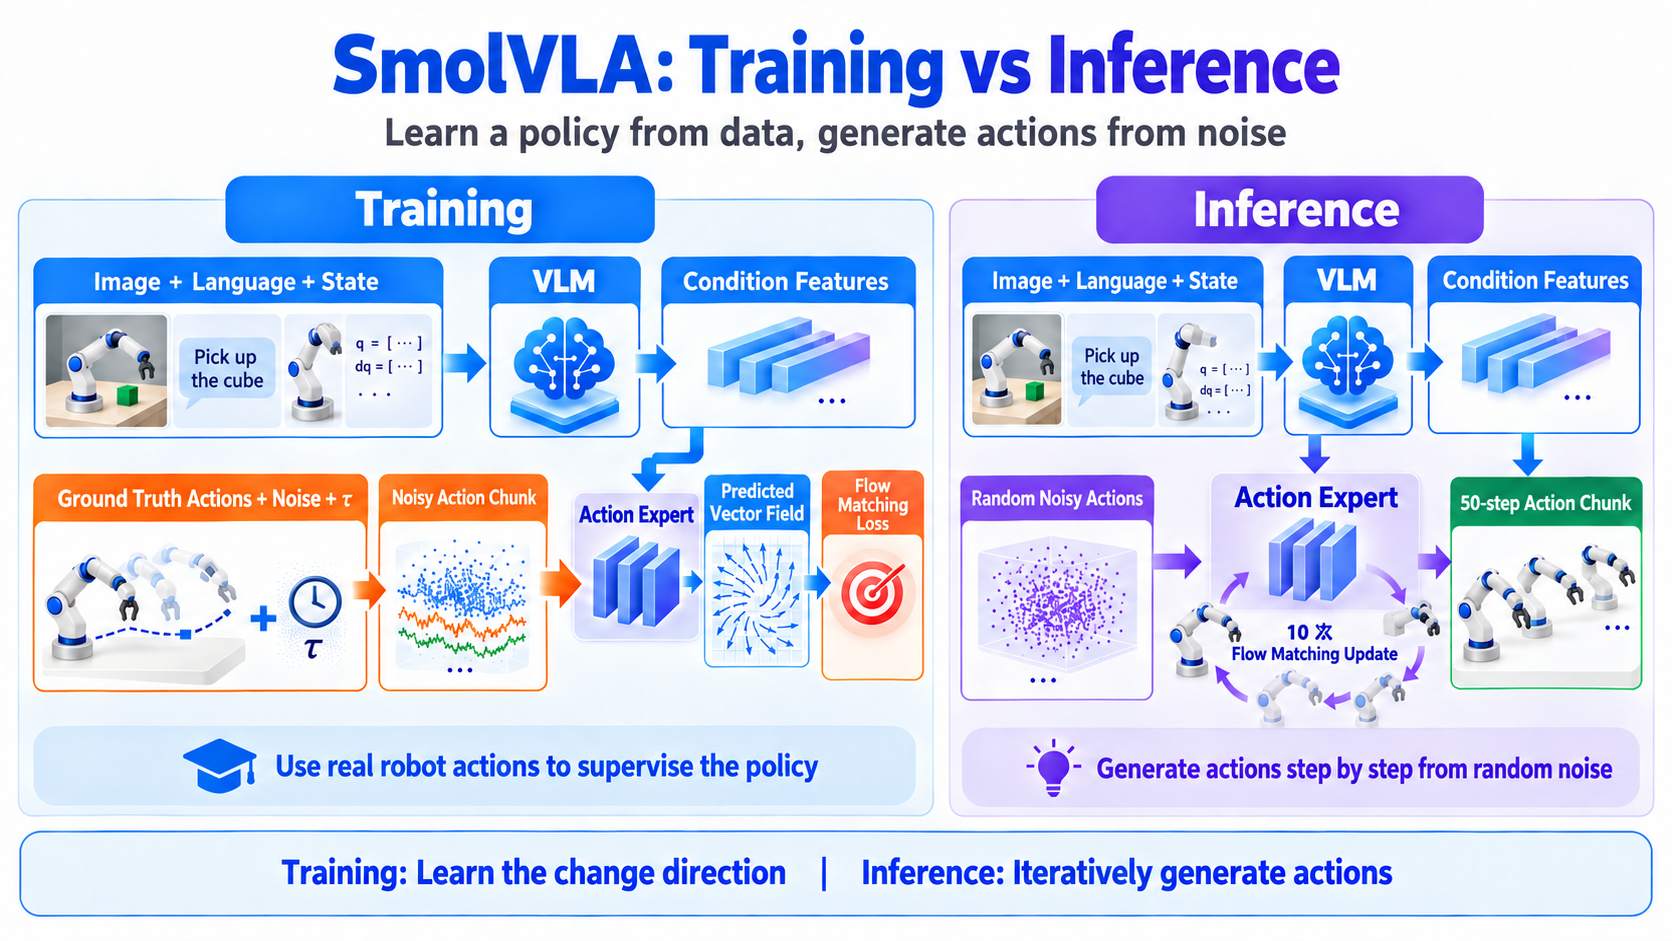
- O modelo principal tem cerca de 450 milhões de parâmetros, incluindo aproximadamente 100 milhões no especialista em ações. Durante o treinamento, o VLM é congelado e apenas o especialista em ações é treinado.
Pré-treinamento com Dados da Comunidade
Por que Dados de Robôs Formam Ilhas
-
Diferentemente de texto e imagens da internet, demonstrações de robôs exigem hardware físico e teleoperação. Conjuntos de dados podem diferir em:
-
Estrutura do robô.
-
Frequência de controle.
-
Definições de juntas.
-
Quantidade e posicionamento de câmeras.
-
Descrições de tarefas.
-
Formato de arquivo.
-
-
Essas coleções desconectadas são “ilhas de dados”. Apenas concatenar arquivos não as torna utilizáveis para pré-treinamento.
Quanto Dado da Comunidade é Usado?
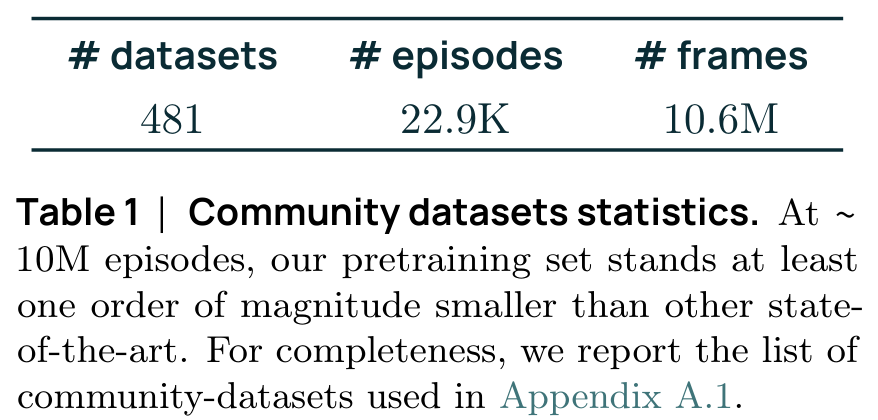
-
A seleção considera tipo de robô, número de episódios, qualidade geral e cobertura de quadros.
-
Isso é cerca de uma ordem de grandeza menos dados do que muitos VLAs grandes utilizam. O objetivo é mostrar que dados da comunidade cuidadosamente limpos podem fornecer benefícios significativos de pré-treinamento em menor escala.
Limpar a Linguagem das Tarefas com um VLM
Rótulos de tarefas da comunidade costumam ser vagos, por exemplo:
task desc
Hold
Up
Uma pessoa pode inferir a tarefa a partir do vídeo, mas tais rótulos não fornecem a um VLA uma descrição estável do objetivo.
Os autores usam Qwen2.5-VL-3B-Instruct para gerar descrições aprimoradas:
-
Amostrar imagens representativas do conjunto de dados.
-
Fornecer o rótulo de tarefa original.
-
Pedir uma frase curta e completa começando com um verbo de ação.
Vague original label + representative images
             ↓
     Qwen2.5-VL-3B
             ↓
Clear action-oriented instruction
Padronizar Pontos de Vista de Câmera
-
Nomes de câmeras variam entre conjuntos de dados da comunidade.
images.laptoppode descrever uma câmera aérea em um conjunto de dados e uma câmera de punho em outro. -
Tratar nomes como semântica fixa faria com que diferentes vistas fossem repetidamente atribuídas ao mesmo slot de entrada, confundindo o treinamento.
-
Os autores mapeiam manualmente as câmeras para uma ordenação padrão, priorizando:
Top → Wrist → Side
- Em seguida, eles as renomeiam de forma consistente:
OBS_IMAGE_1
OBS_IMAGE_2
OBS_IMAGE_3
- Vistas extras além das necessárias são descartadas.
Inferência Assíncrona
O Problema com Blocos Síncronos
- Considere que o modelo prevê um bloco de ação a partir da observação
o_t:
A_t = [a_t, a_t+1, ... , a_t+n]
-
Um sistema síncrono eficiente em computação executa todo
A_tantes de observar e prever novamente. Isso causa dois problemas:-
A execução não usa imagens novas durante o bloco, criando um intervalo em malha aberta.
-
Quando o bloco se esgota, o robô espera pela inferência.
-
RobotClient e PolicyServer
- SmolVLA separa dois papéis:
| Componente | Responsabilidade |
|---|---|
| RobotClient | Capturar imagens, ler estado, manter a fila de ações e executar ações. |
| PolicyServer | Receber observações, executar o SmolVLA e retornar um novo bloco de ação. |
- RobotClient solicita novas ações antes que a fila atual se esgote, acionando a inferência de forma assíncrona.
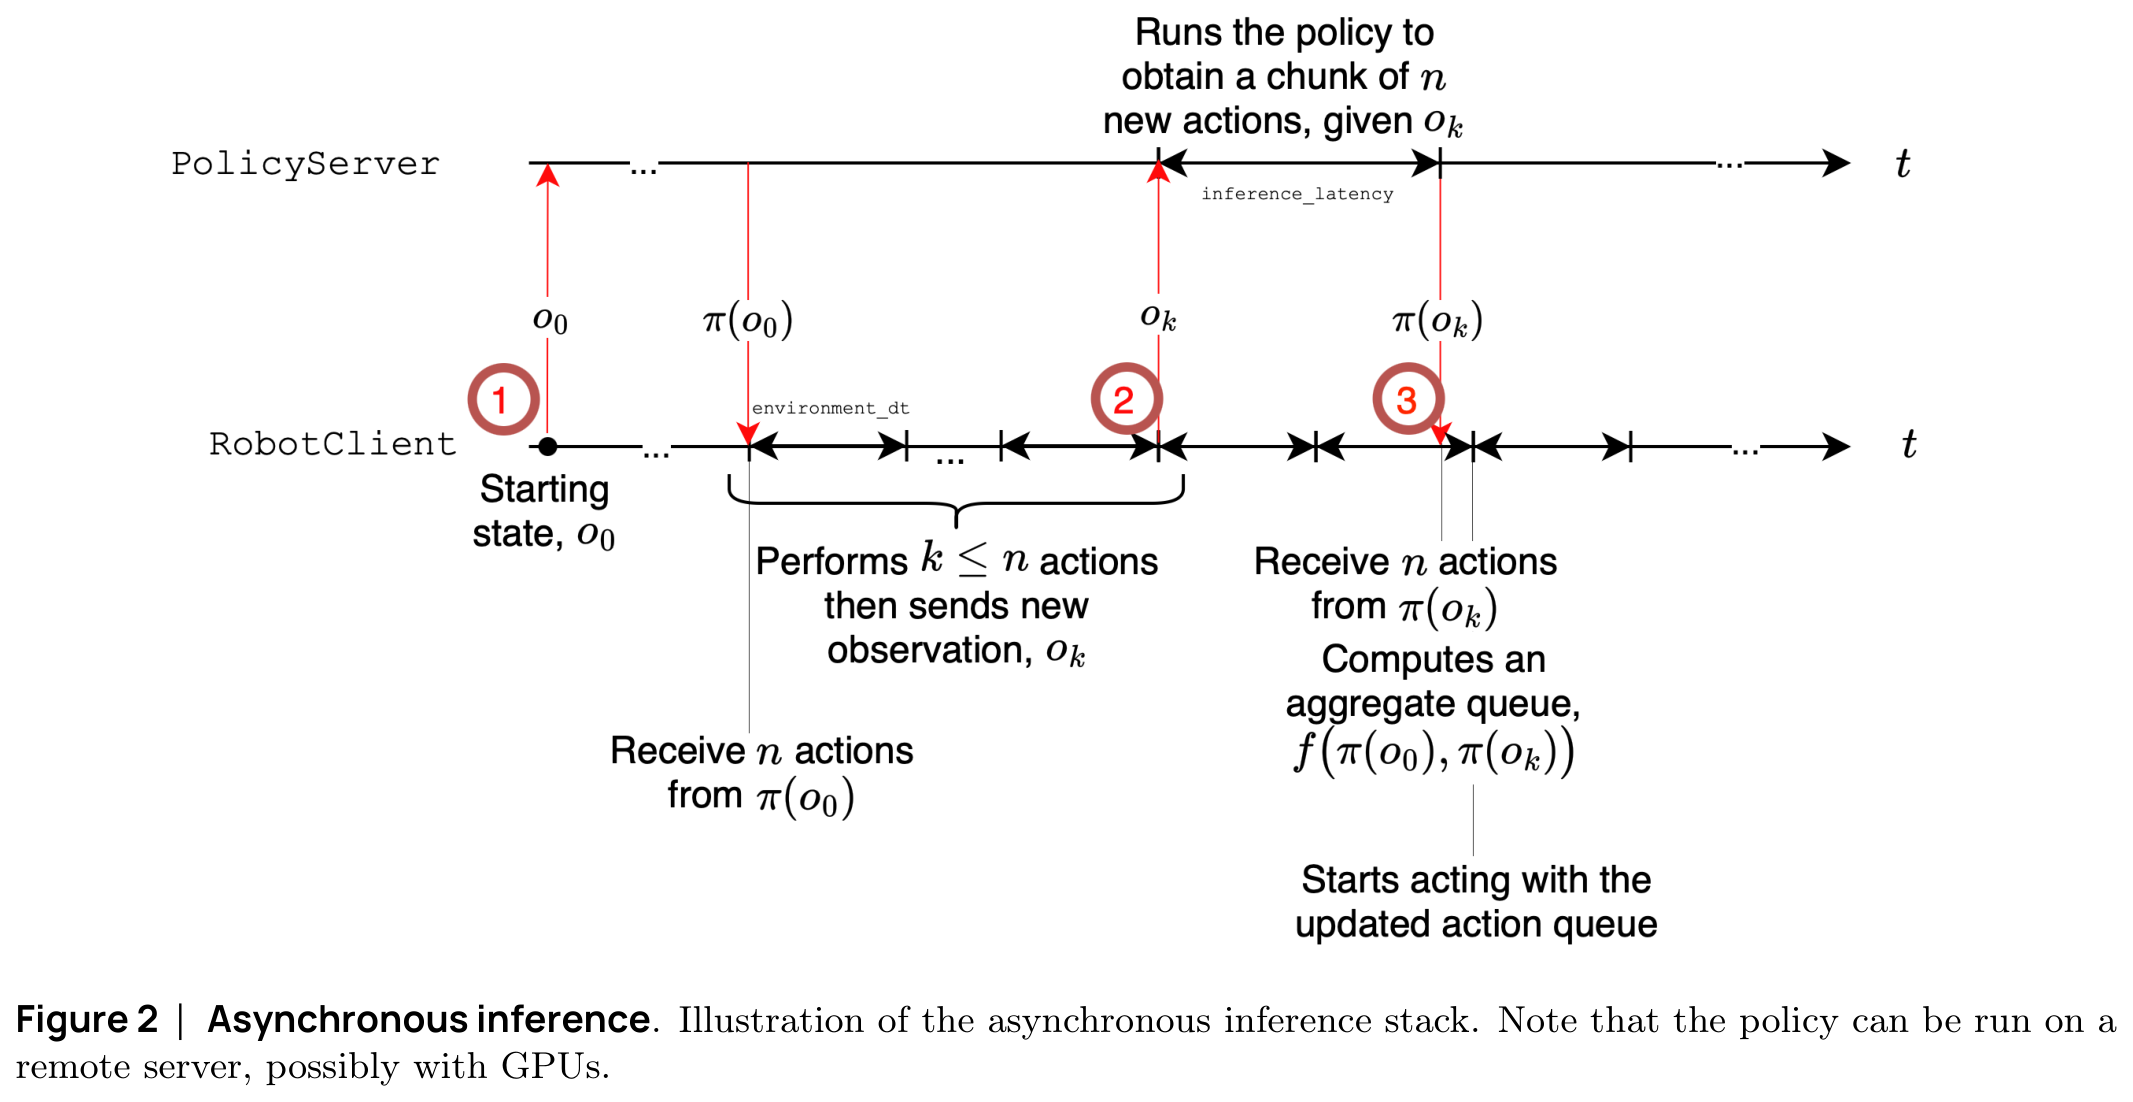
- A sequência é:
Robot executes the old chunk
        ↓
Queue falls below the threshold
        ↓
Capture a new observation and request PolicyServer asynchronously
        ↓
Robot continues executing the old queue
        ↓
New chunk arrives
        ↓
Merge or update the action queue
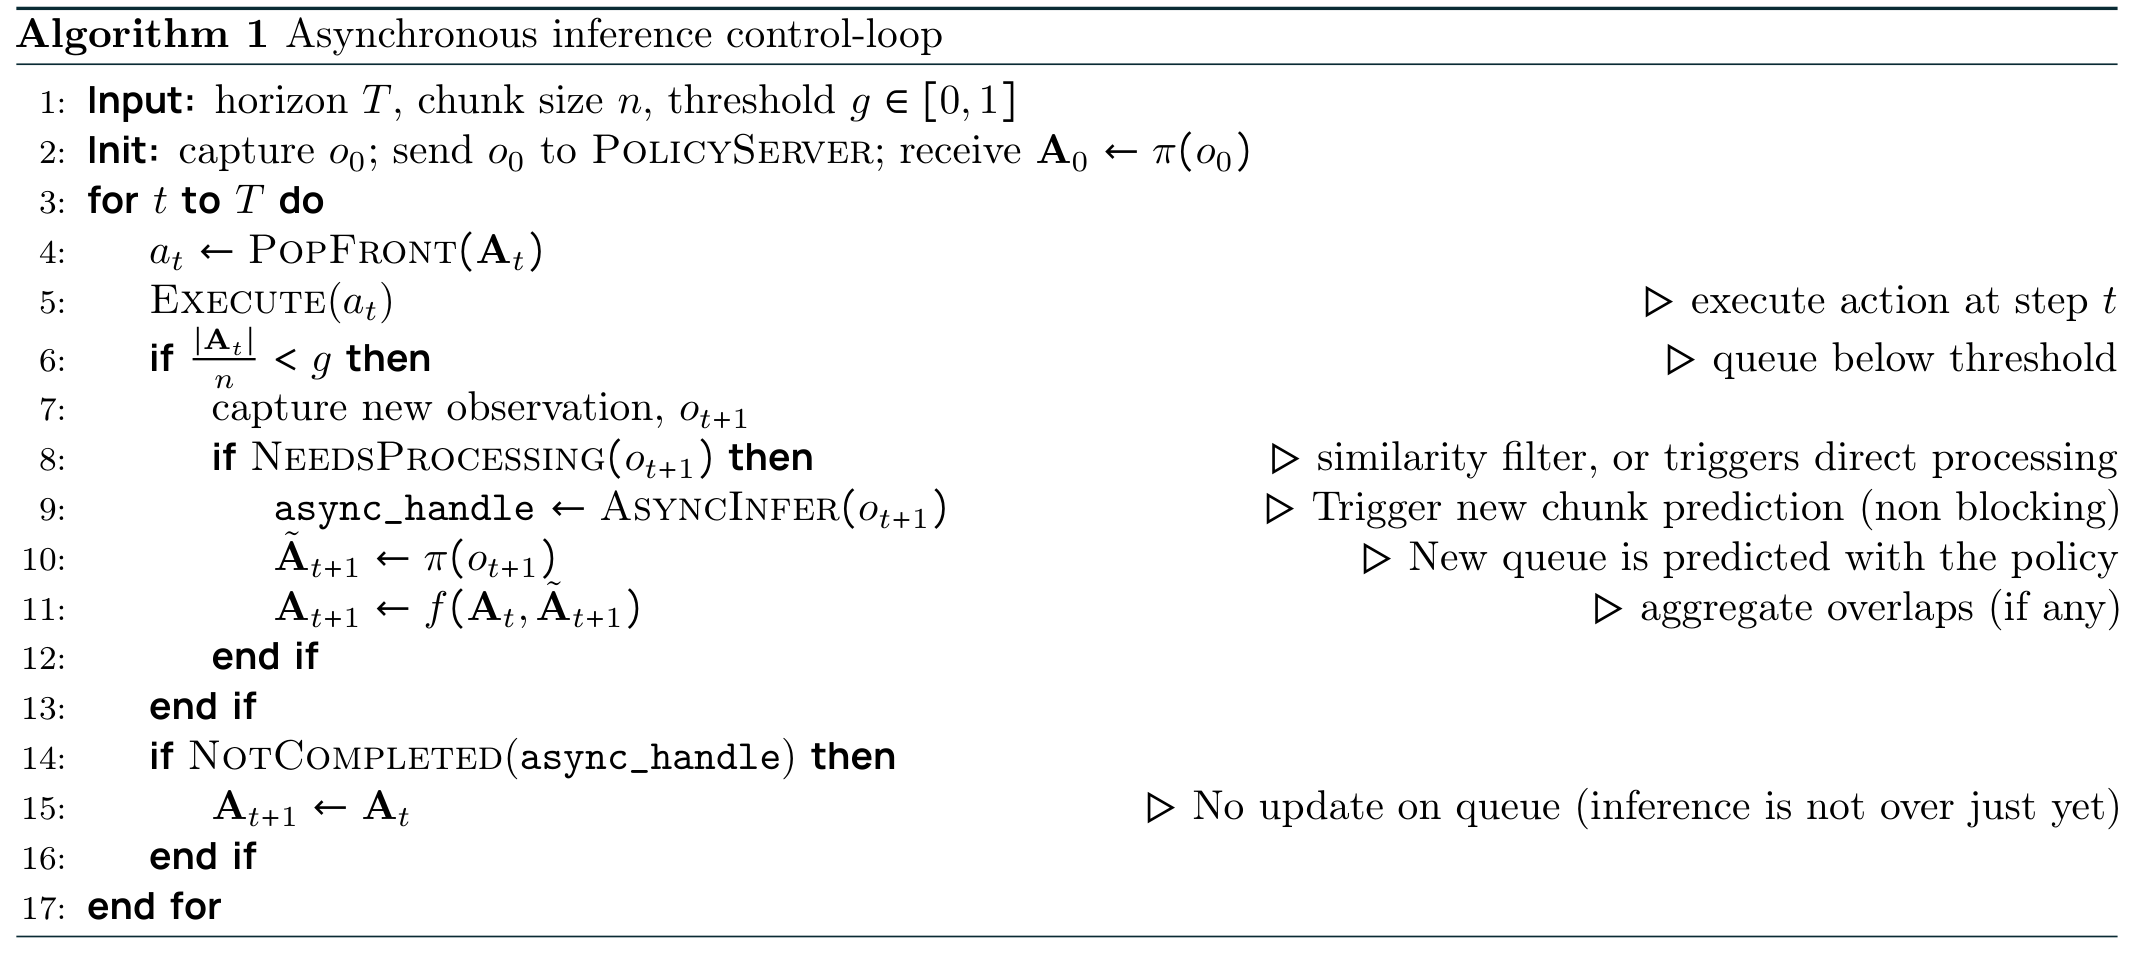
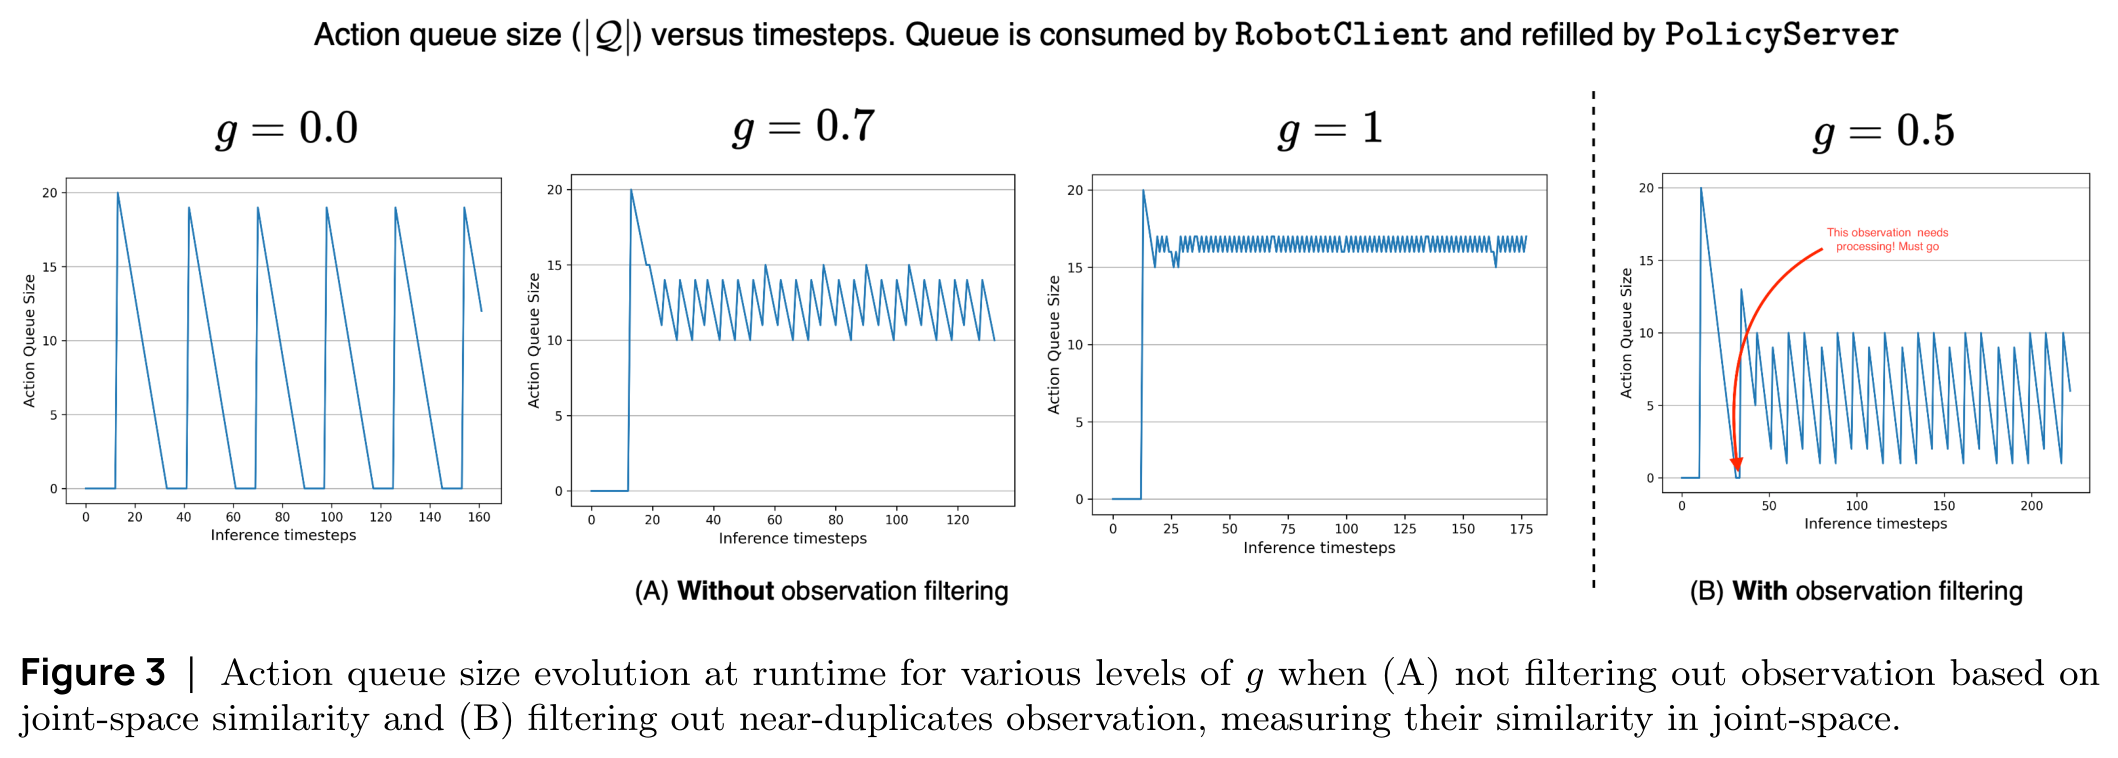
O limiar g controla quando prever
- O artigo usa
g ∈ [0,1]. O RobotClient solicita outro bloco quando a proporção de ação restante cai abaixo deg:
|A_t| / n < g
g = 0
- Esperar até que a fila esteja vazia, aproximando-se de inferência síncrona e criando um risco maior de pausas.
g = 1
- Solicitar novas ações quase a cada ciclo de controle, maximizando a capacidade de resposta, mas também o custo computacional.
0 < g < 1
- O artigo ilustra o trade-off com
g = 0.7: consumir parte da fila antiga e, em seguida, solicitar o próximo bloco antecipadamente. Isso reduz lacunas sem executar o modelo a cada passo.
- Na prática,
greserva tempo de inferência. Modelos mais lentos ou maiores atrasos de rede exigem solicitações mais antecipadas.
Por que filtrar observações repetidas?
-
Se o braço mal se move, observações consecutivas podem ser quase idênticas. Enviar todas desperdiça computação e pode mesclar repetidamente blocos quase idênticos.
-
Os autores comparam observações usando distância no espaço de juntas e pulam quase duplicatas quando a distância fica abaixo de
ε. -
Se a fila estiver vazia, porém, a observação mais recente deve ser processada mesmo que seja semelhante; caso contrário, o robô poderia permanecer parado indefinidamente.
Configuração experimental
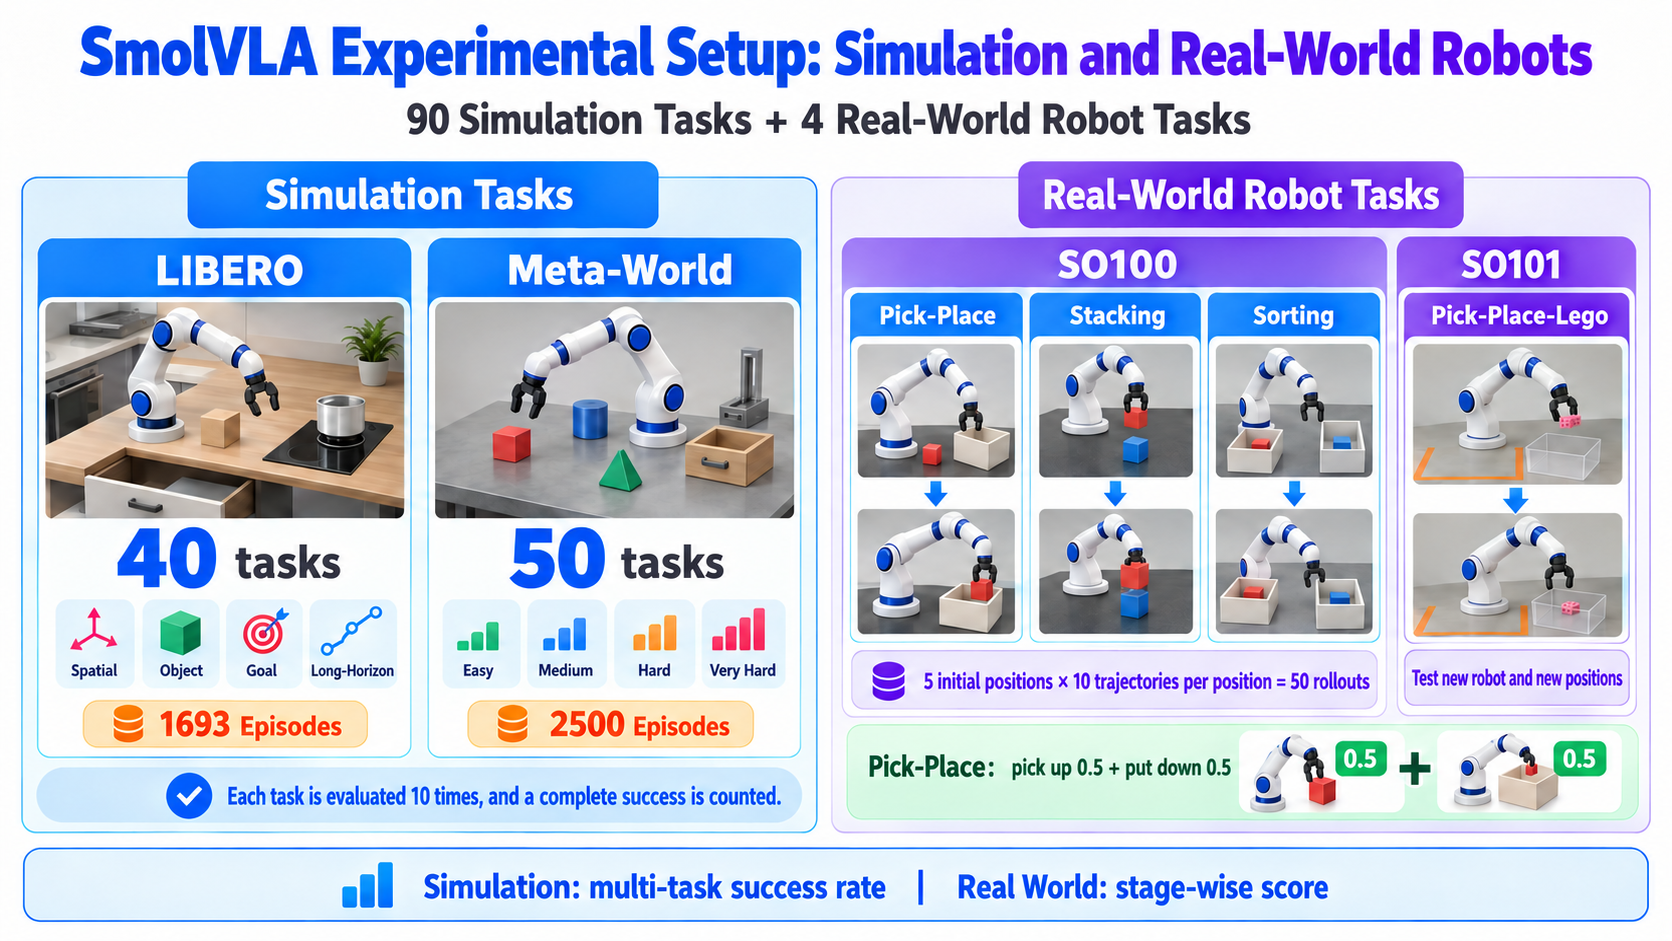
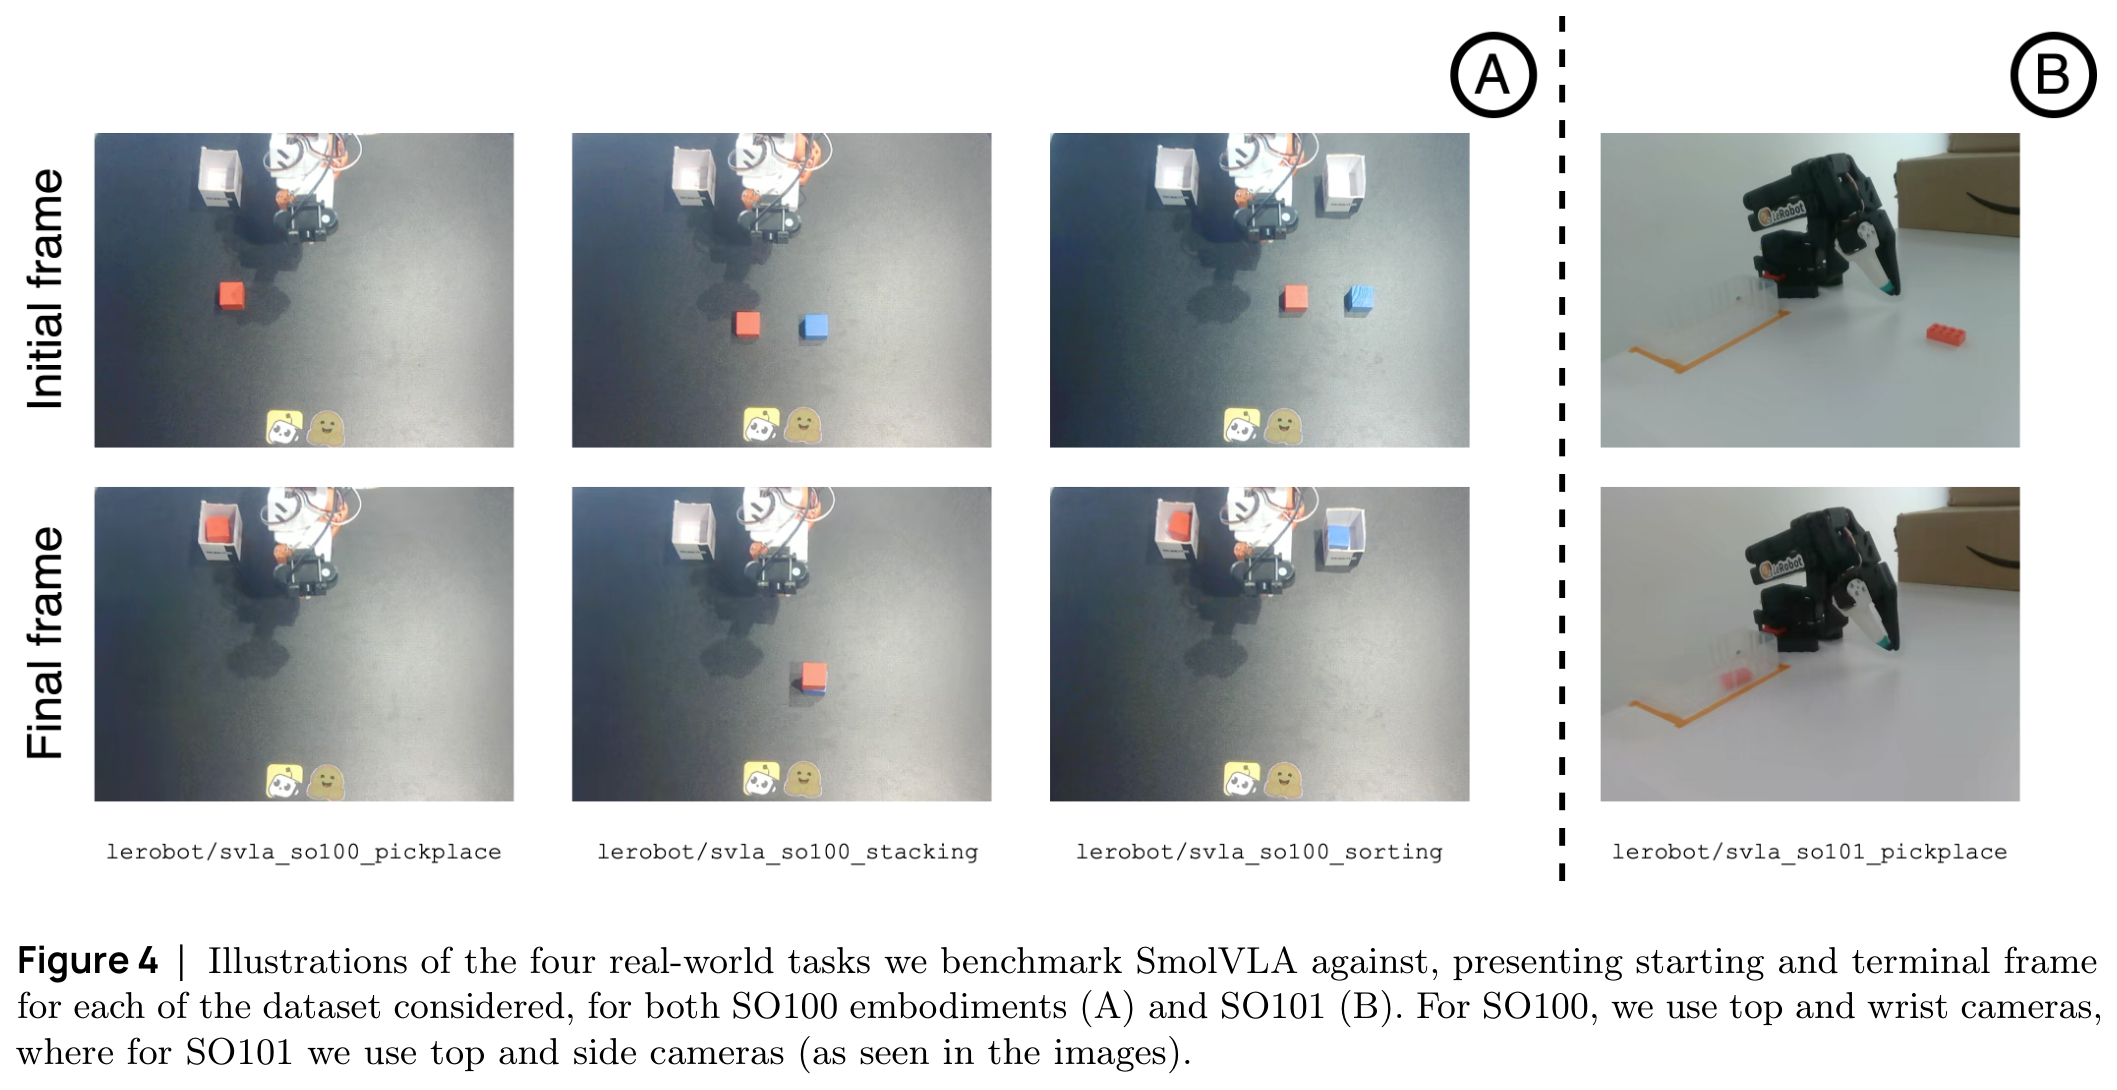
Configuração de treinamento
| Item | Configuração |
|---|---|
| Resolução da imagem | 512 × 512 |
| Etapas de pré-treinamento | 200K |
| Tamanho global do batch | 256 |
| Otimizador | AdamW |
| Taxa de aprendizado | Decai de 1e-4 para 2.5e-6 |
| Tamanho do bloco de ações | 50 |
| Etapas de Flow Matching | 10 |
| Parâmetros do modelo principal | 450M |
| Parâmetros do especialista em ações | Cerca de 100M |
| Custo computacional total do projeto | Cerca de 30K horas de GPU |
- O pré-treinamento usa quatro GPUs para obter um batch maior, enquanto os autores observam que o modelo em si pode ser treinado em uma única GPU.
Resultados
Simulação
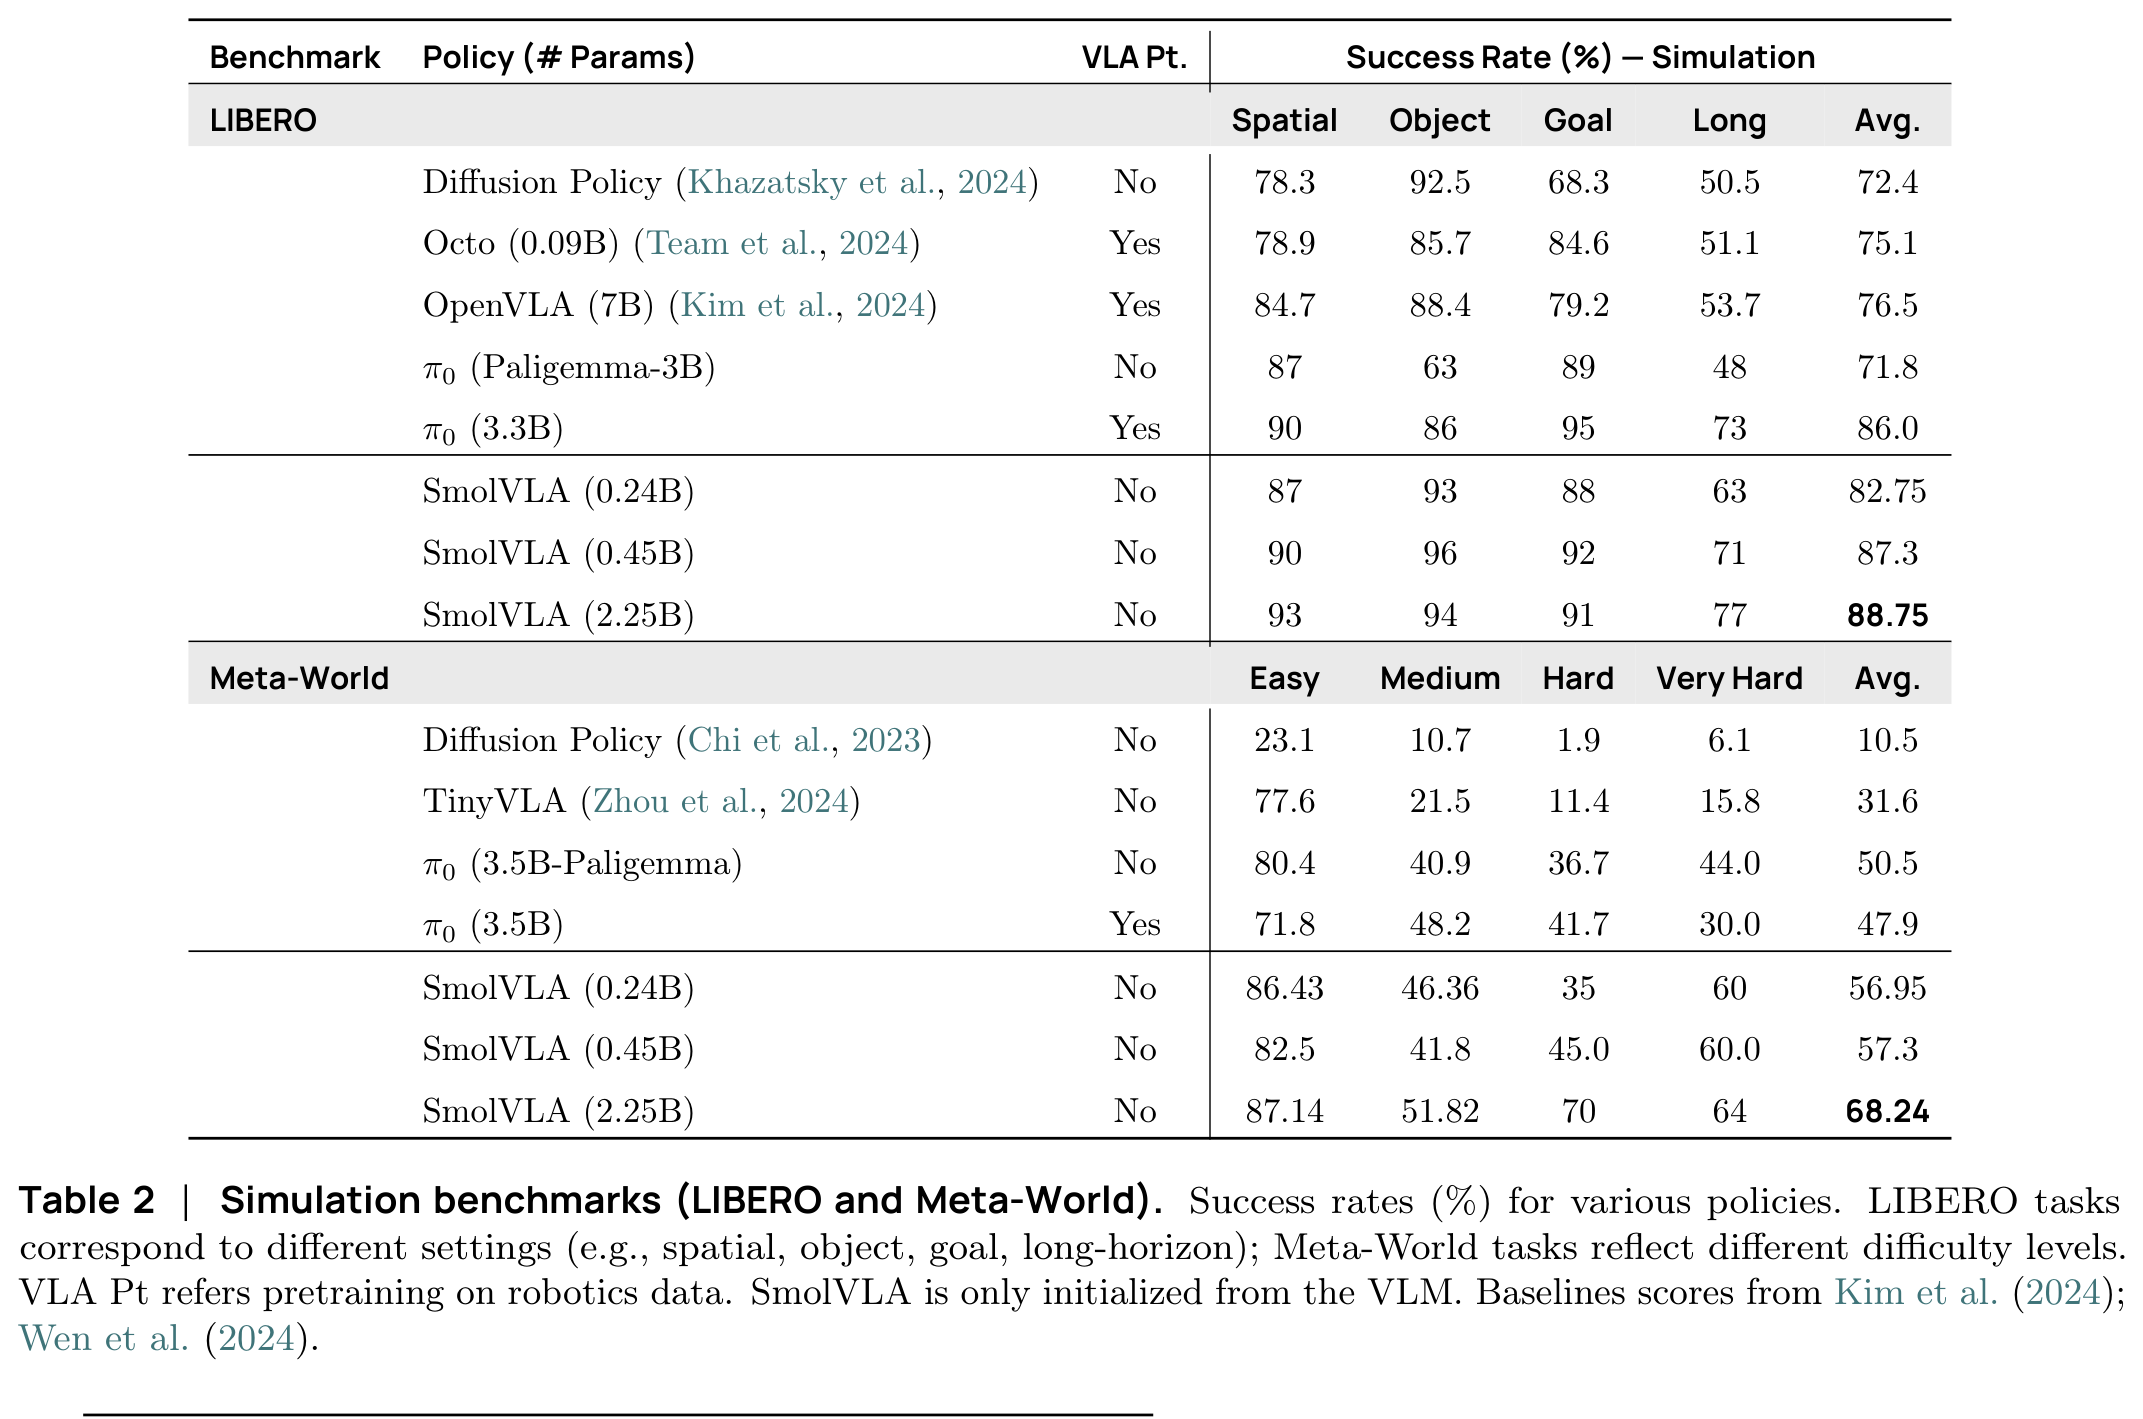
No LIBERO:
-
O SmolVLA de 0,45B tem uma taxa média de sucesso maior do que o π0 de 3,3B e o OpenVLA de 7B. Escalar para 2,25B melhora ainda mais o desempenho, mas o ganho em relação a 0,45B é menor.
-
No Meta-World, o sucesso médio é 57,3 para o modelo de 0,45B e 68,24 para 2,25B. O tamanho do modelo por si só não determina o desempenho: arquitetura, dados e objetivos de treinamento também importam.
Resultados em robô real SO100
-
O π0 atinge 100 na tarefa de pick-and-place mais fácil, mas o SmolVLA tem desempenho substancialmente melhor em empilhamento e ordenação e alcança a melhor média geral.
-
O SmolVLA tem aproximadamente um sétimo do número de parâmetros do π0.
Resultados de transferência SO101
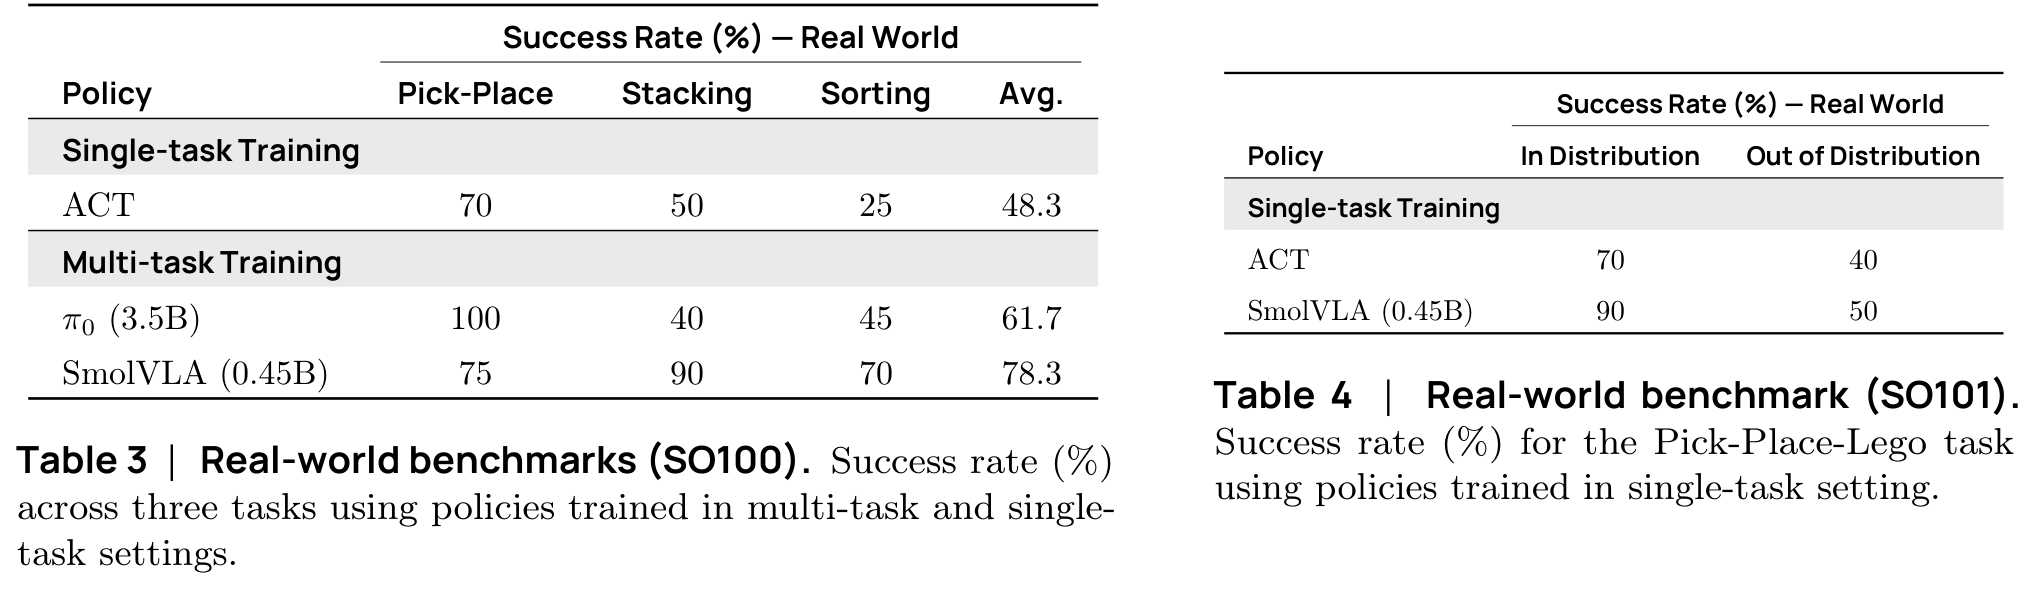
- O pré-treinamento comunitário usa principalmente dados SO100, sem dados SO101. Após o fine-tuning em tarefas SO101, o SmolVLA ainda supera o ACT, demonstrando adaptação a outra plataforma.
O que o pré-treinamento comunitário contribui
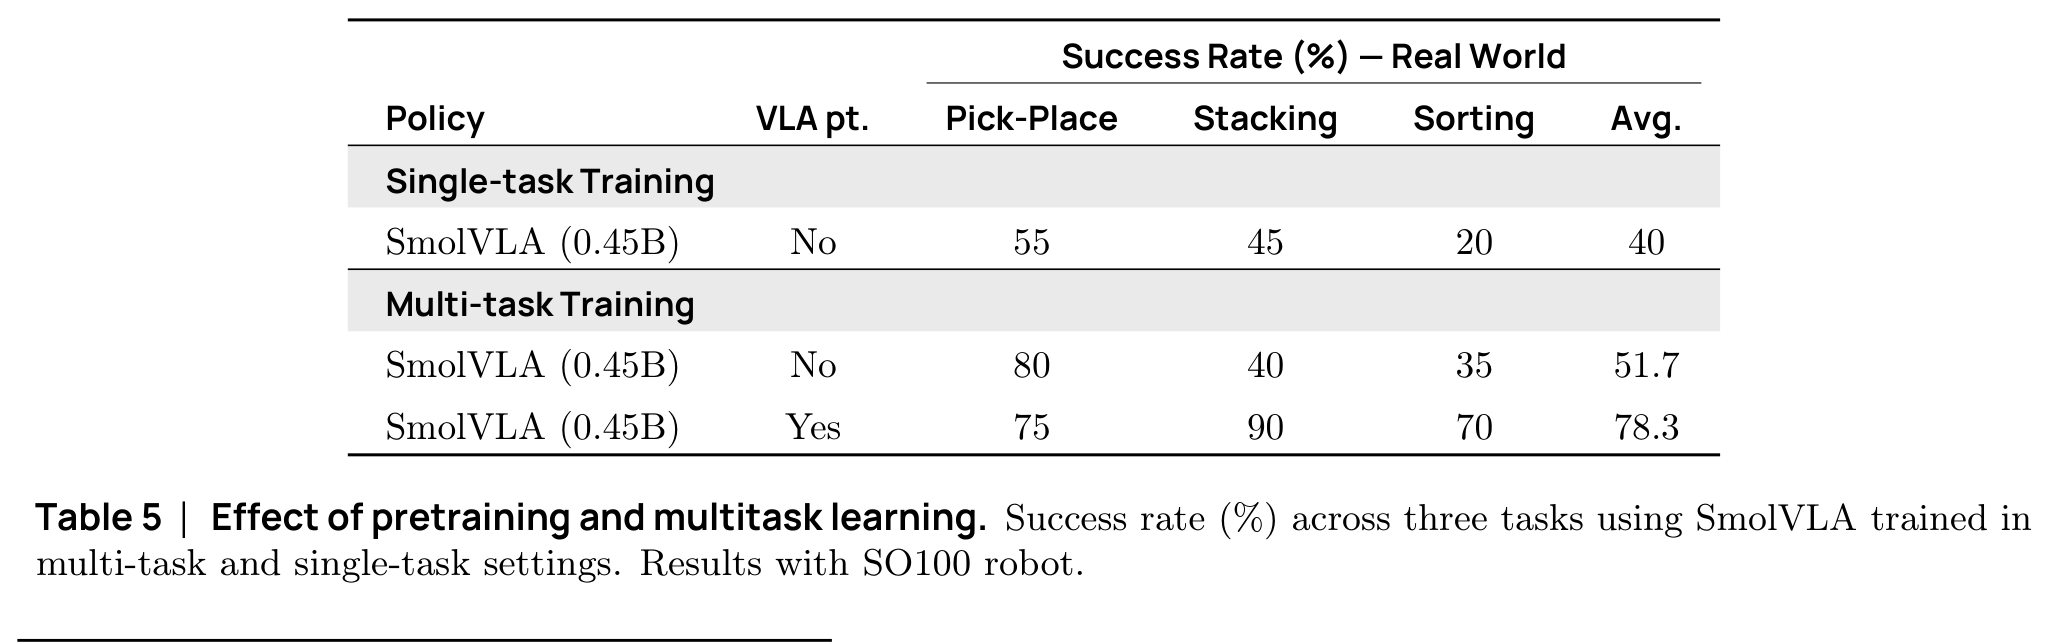
-
Passar de treinamento de tarefa única para multi-tarefa eleva o sucesso médio de 40,0 para 51,7.
-
Adicionar pré-treinamento comunitário o eleva para 78,3.
-
Uma conclusão importante é que os dados de pré-treinamento podem importar mais do que simplesmente aumentar a contagem de parâmetros.
Inferência síncrona e assíncrona
| Inferência | Pick-Place | Empilhamento | Ordenação | Média |
|---|---|---|---|---|
| Síncrona | 75 | 90 | 70 | 78.3 |
| Assíncrona | 80 | 90 | 50 | 73.3 |
-
A assincronia não melhora todas as tarefas: a ordenação cai de 70 para 50. Ela não deve ser descrita como universalmente mais precisa.
-
Seu principal benefício é velocidade e throughput:
Average completion time: 13.75 seconds → 9.70 seconds
Tasks completed in a fixed time: 9 → 19
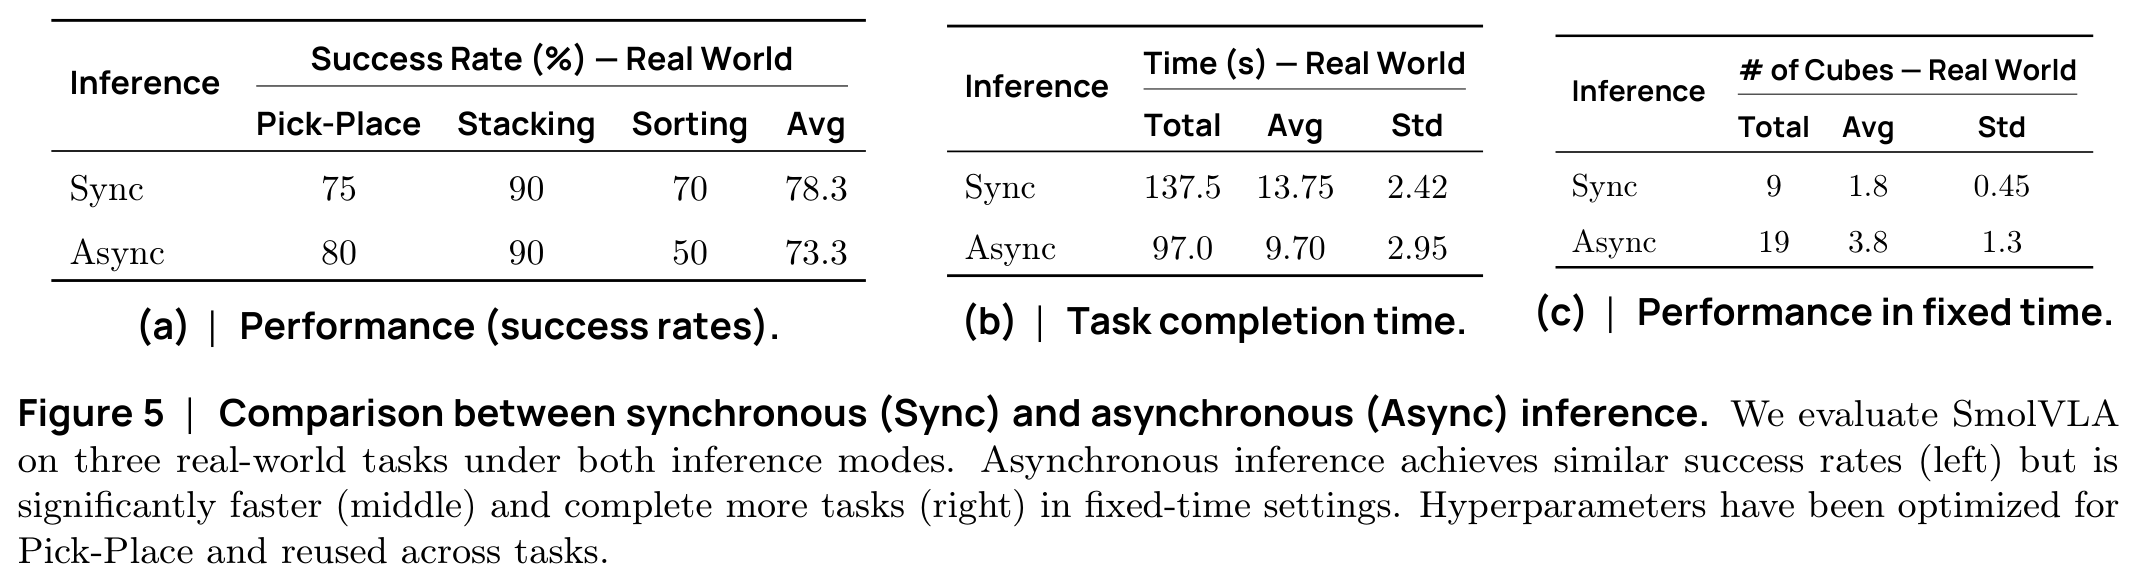
- Com taxas médias de sucesso semelhantes, a inferência assíncrona conclui pick-and-place cerca de 30% mais rápido e mais do que dobra as tarefas concluídas dentro de um intervalo fixo.
Ablations
Cross-Attention e Self-Attention
| Atenção | Sucesso médio no LIBERO |
|---|---|
| Cross-Attention | 79.0 |
| Self-Attention | 74.5 |
| Alternando CA + SA | 85.5 |
- Ler apenas recursos do VLM ou modelar apenas relações entre ações é insuficiente. Alterná-los funciona melhor, apoiando os papéis complementares de condicionamento de tarefa e coerência temporal.
Atenção causal e bidirecional
| Máscara | Sucesso médio no LIBERO |
|---|---|
| Bidirecional | 67.5 |
| Causal | 74.5 |
- Impedir que tokens de ação vejam ações futuras melhora o desempenho neste experimento, sugerindo que direção temporal explícita é útil.
Flow Matching e regressão direta
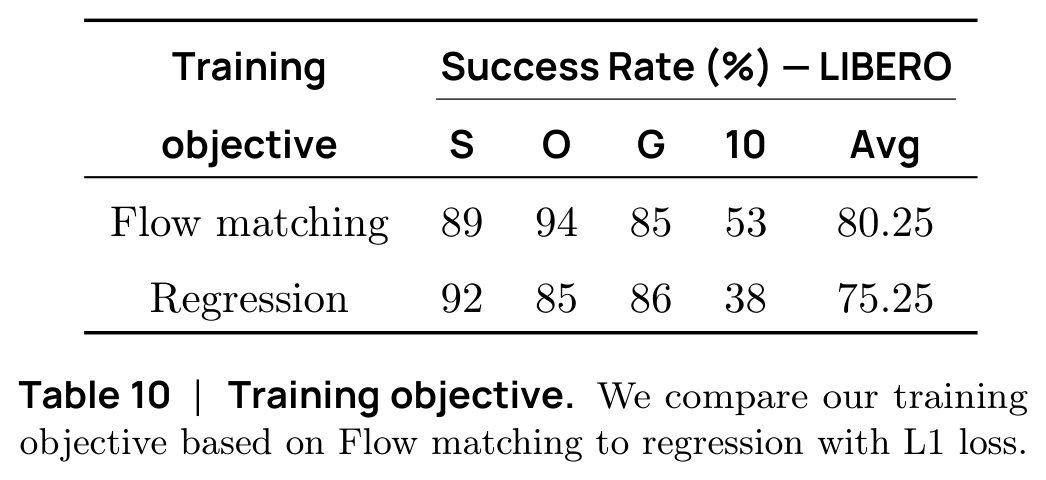
-
A principal vantagem do flow matching aparece em tarefas de longo horizonte, onde o sucesso aumenta de 38 para 53.
-
Isso apoia a visão dos autores de que objetivos generativos modelam melhor distribuições de ações complexas e multimodais.
Onde o estado deve entrar?
Os autores comparam:
-
Sufixo: alimentar o estado diretamente ao especialista em ações.
-
Prefixo: alimentar o estado primeiro ao VLM.
Com cross-attention, o prefixo atinge sucesso médio de 80,3 versus 73,3 para o sufixo. O modelo final, portanto, fornece o estado ao VLM juntamente com imagens e linguagem.
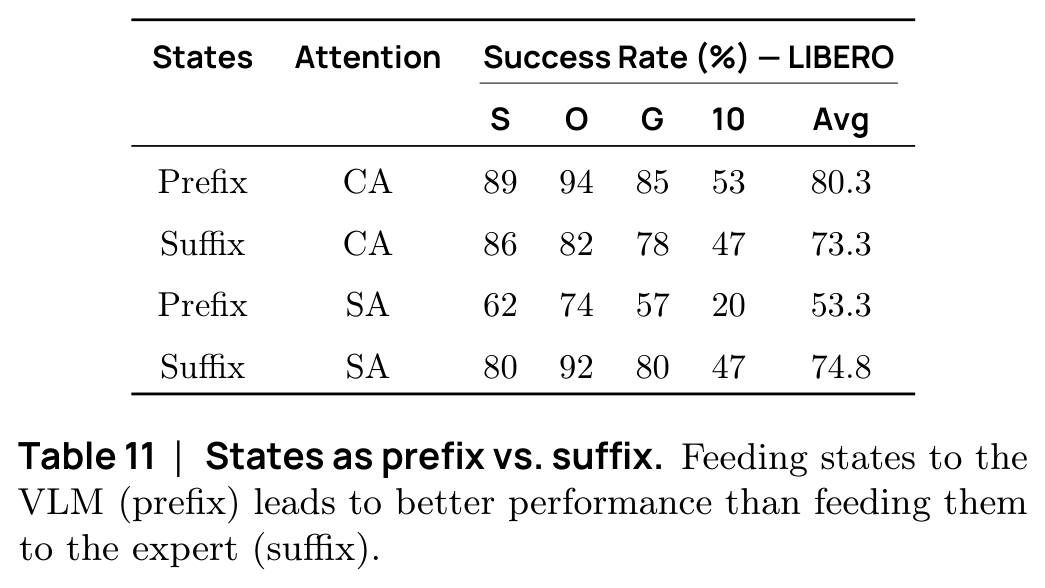
A variante de self-attention pura não mostra a mesma tendência. A conclusão apoiada é que o estado em prefixo funciona melhor no design condicionado por VLM escolhido, em vez de ser universalmente superior para toda arquitetura de atenção.
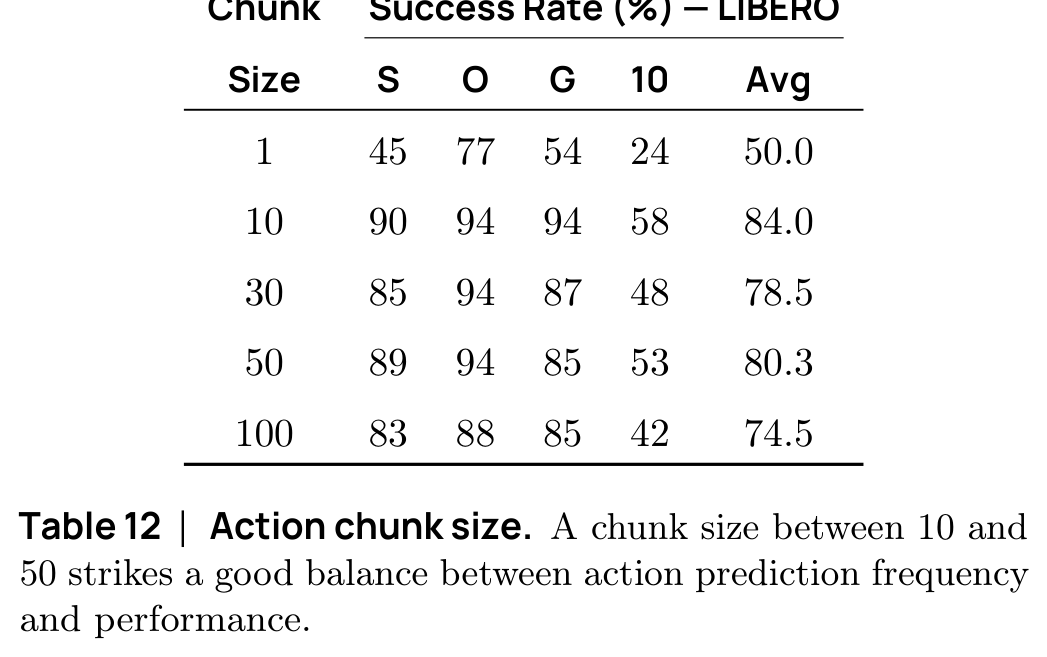
Qual deve ser o comprimento de um bloco de ações?
-
Blocos muito curtos subutilizam a estrutura de sequência. Blocos muito longos são mais difíceis de prever e podem incentivar execução em malha aberta excessivamente longa.
-
O artigo identifica 10–50 como um equilíbrio útil, em vez de tratar blocos mais longos como sempre melhores.
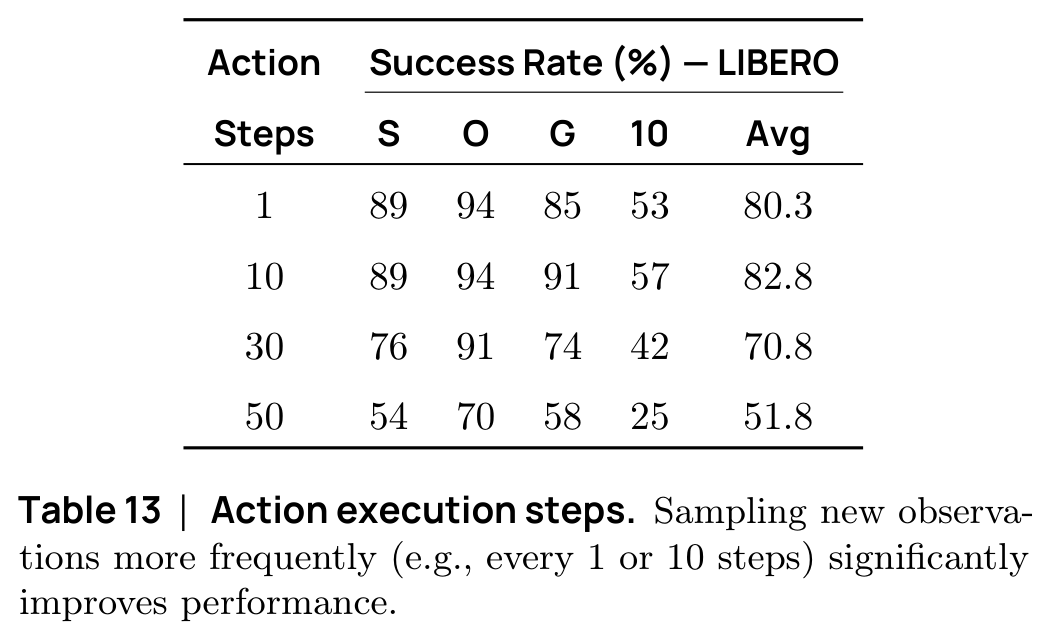
Prever 50 passos não significa executar 50
-
O modelo pode prever 50 passos, mas executar apenas 10 antes de observar novamente, combinando coerência de sequência com feedback do ambiente.
-
Executar todos os 50 antes de observar produz apenas sucesso médio de 51,8.
-
Isso motiva a inferência assíncrona: observar com frequência sem fazer o robô esperar pelo modelo.
Limitações
-
Diversidade limitada de embodiment. O pré-treinamento comunitário é principalmente SO100. A transferência para SO101 é demonstrada por meio de fine-tuning, mas isso não é um pré-treinamento amplo entre diferentes embodiments.
-
Escala de dados limitada. O SmolVLA usa cerca de 23.000 trajetórias, enquanto modelos como o OpenVLA podem usar quase um milhão. A eficiência em escalas maiores de dados comunitários ainda precisa ser testada.
-
Adequação do backbone permanece em aberto. Grande parte do pré-treinamento do SmolVLM-2 diz respeito a documentos e OCR. Se ele é ideal para relações espaciais, affordances e interação física ainda não está resolvido.
-
Tarefas reais continuam relativamente curtas. Pegar, colocar, empilhar e ordenar não cobrem comportamentos realmente de longo horizonte, que podem exigir políticas hierárquicas ou planejamento em múltiplos níveis.
-
Principalmente aprendizado por imitação. O desempenho continua limitado pela cobertura das demonstrações. Os autores sugerem combinar aprendizado por reforço para melhorar tarefas de longo horizonte e manipulação hábil.
Resumo