VLA-JEPA: Aprendendo Ações Latentes a partir de Vídeo
VLA-JEPA: Aprimorando o Modelo Visão-Linguagem-Ação com um Modelo de Mundo Latente
- Pré-treinamento com vídeos de humanos
- Modelo de mundo latente
- Head de ação com flow matching
- Robustez a perturbações
Vídeos de humanos mostram como colocar uma maçã em uma tigela, mas não contêm comandos de controle para um robô específico. VLA-JEPA primeiro aprende como os objetos mudam a partir de vídeo, depois aprende como agir a partir de demonstrações de robôs. Um modelo de mundo conecta esses dois sinais de aprendizado.
Pré-requisitos
Três quantidades importam. Considere colocar uma maçã em uma tigela:
- Características do estado do mundo descrevem a cena e o estado dos objetos, conforme extraídos por um codificador de vídeo.
- Ações latentes são características ocultas que ajudam a prever mudanças de estado, como a maçã se movendo da mesa para acima da tigela. Elas não têm unidades físicas predefinidas.
- Ações do robô contêm valores enviados ao controlador, como translação e rotação do efetuador final e comandos da garra.
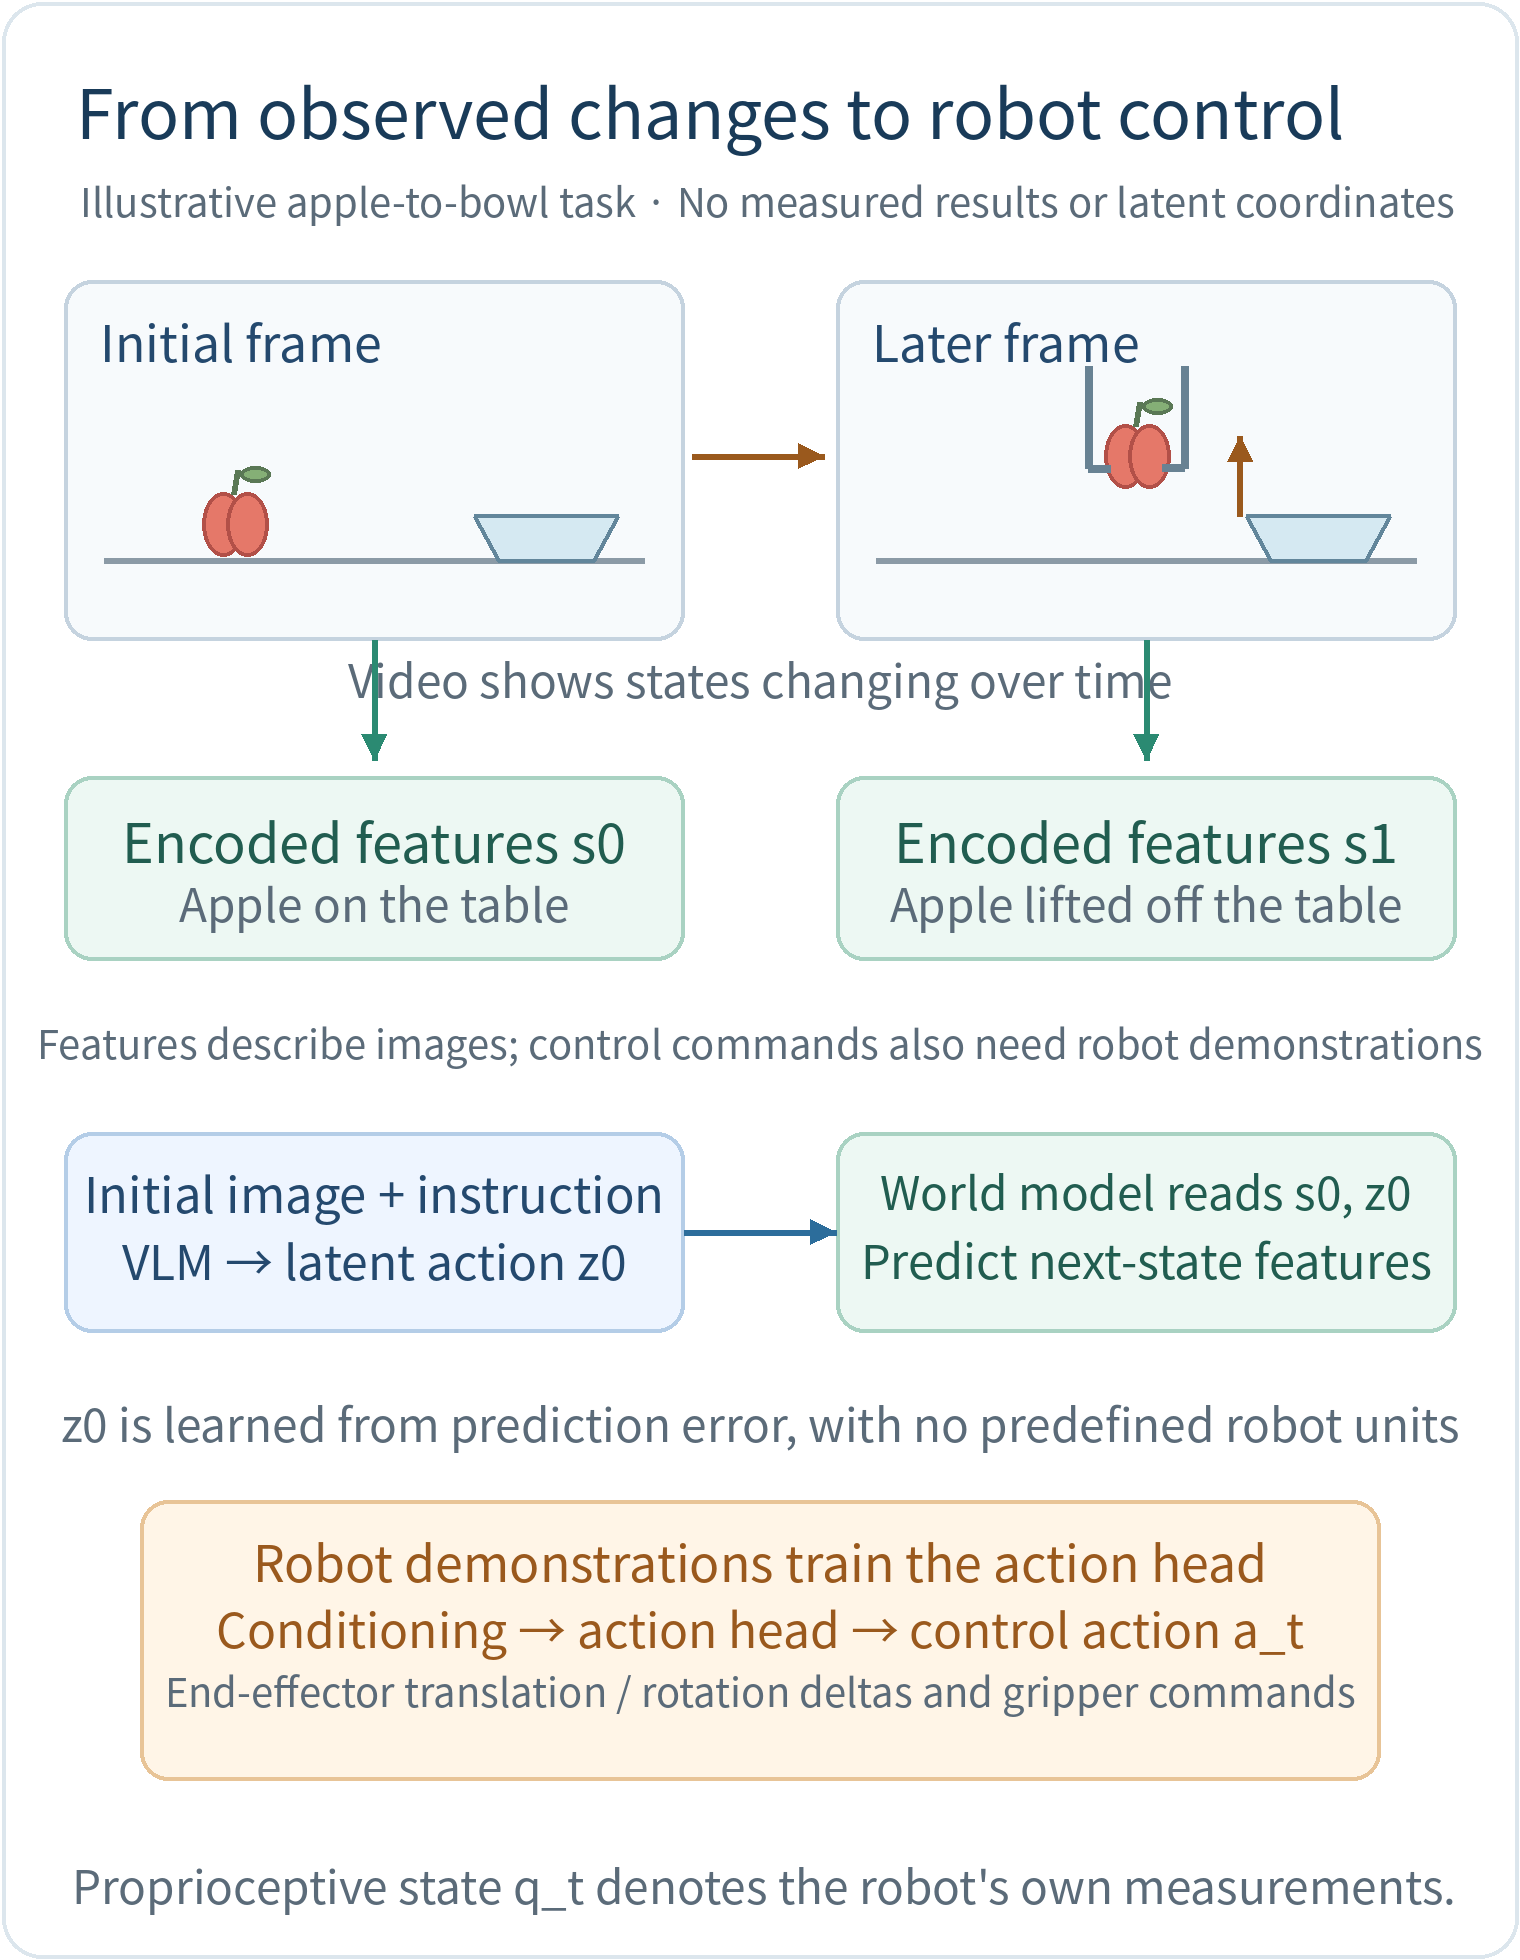
JEPA (Joint-Embedding Predictive Architecture) prediz características futuras. Ele compara características previstas com características codificadas a partir de imagens futuras reais, sem reconstruir cada pixel. VLA-JEPA usa esse objetivo para ensinar a um modelo visão-linguagem (VLM) mudanças relacionadas à manipulação.
Resumo
Paráfrase: Vídeo da Internet pode ajudar a lidar com a escassez de dados de robôs para modelos visão-linguagem-ação (VLAs). Métodos existentes de ação latente, porém, podem aprender mudanças de aparência, movimento irrelevante ou atalhos a partir de imagens futuras. VLA-JEPA gera ações latentes a partir de observações atuais e linguagem, depois prediz características de estado futuras. Imagens futuras fornecem supervisão sem entrar diretamente no VLM que gera ações latentes. Pré-treinamento conjunto em vídeo e dados de robôs, seguido de adaptação em tarefas downstream, produz resultados competitivos em simulação e hardware.
Nota de leitura: A ausência de rótulos de ação se aplica a vídeos de humanos. Vídeos ensinam mudanças; demonstrações de robôs ainda ensinam valores de controle. As ablações mostram benefícios mais claros para robustez a perturbações do que melhoria consistente em todas as tarefas.
Introdução e Trabalhos Relacionados
Comece pelo problema de dados. Demonstrações de robôs são caras, enquanto vídeos de humanos são abundantes. Os autores, portanto, buscam transferir experiência de vídeo para aprendizado de robôs (Seção 1 do artigo). Mais vídeo por si só é insuficiente: predição de pixels pode focar em textura, iluminação e movimento de câmera em vez de mudanças úteis para controle.
Depois examine a supervisão. Se um extrator de ações latentes vê imagens atuais e futuras, ele pode codificar a resposta futura. Extrair ações latentes antes de alinhar separadamente uma política também adiciona estágios de treinamento. Os autores mudam tanto o alvo de predição quanto a fonte de informação: predizer características futuras e gerar ações latentes apenas a partir de observações iniciais.
A Seção 2 discute dois grupos principais: VLAs como a série RT, que dependem de demonstrações rotuladas com ações, e métodos como LAPA, UniVLA e MotoGPT, que extraem ações latentes de vídeo antes de conectá-las ao controle de robôs. VLA-JEPA, em vez disso, deixa o erro de predição de estado treinar diretamente o VLM que gera ações latentes, enquanto a supervisão de ações de robôs treina o mesmo backbone. Isso forma um processo unificado de pré-treinamento, ainda seguido por fine-tuning em tarefas downstream.
Como o VLA-JEPA Aprende Ações a partir de Vídeo
A Rede como um Todo
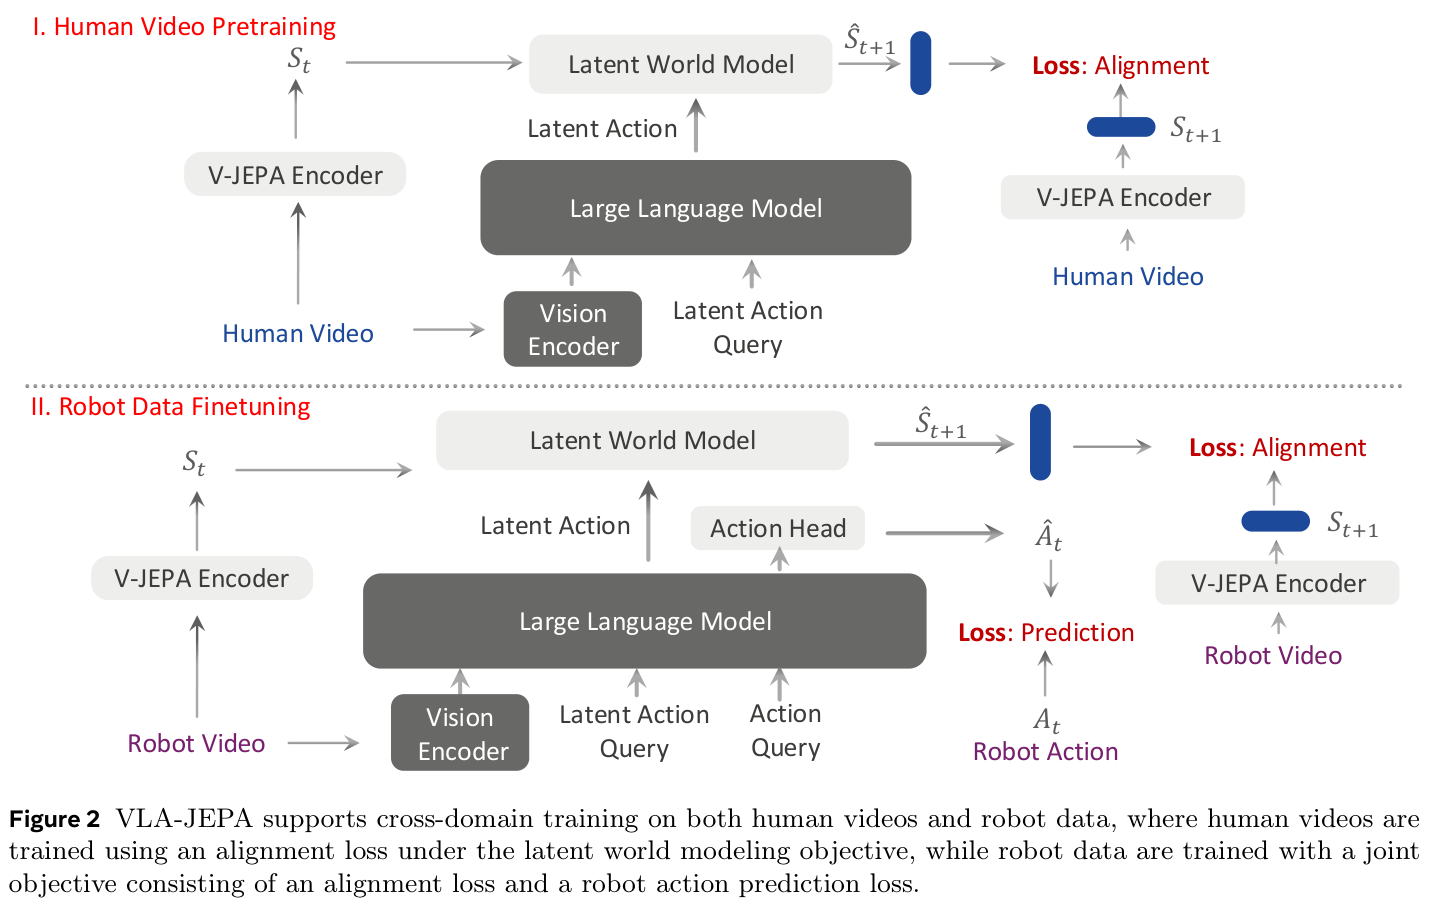
Cada um dos quatro módulos tem um papel: Qwen3-VL-2B lê imagens atuais e instruções para produzir ações latentes e condicionamento de ação; o V-JEPA2 congelado codifica vídeo em características de estado; o modelo de mundo prediz estados subsequentes; e o head de ação gera sequências de controle do robô.
O caminho superior treina predição de estado em vídeo de humanos. O caminho inferior treina predição de estado e geração de ação em dados de robôs. Ambos compartilham o VLM, permitindo que a experiência em vídeo influencie o controle posterior.
Treinando Ações Latentes por meio de Predição de Estado
Um codificador fixo extrai características de cada visão e as concatena ao longo da dimensão de características (Equação (1) do artigo):
é a imagem da visão na posição temporal . Na interface da Tabela 5, dois arrays de características tornam-se : a contagem de tokens visuais permanece inalterada, e cada token combina duas visões.
Consultas de ação latente aprendíveis seguem as imagens iniciais e a linguagem. Suas características no VLM tornam-se . O modelo de mundo prediz o próximo estado a partir de estados históricos e ações latentes. As Equações (2)–(3) podem ser encurtadas para:
é a instrução, e é um token de consulta aprendível. Todas as ações latentes usam as mesmas observações iniciais em vez de suas imagens futuras correspondentes. O treinamento usa teacher forcing: prever pode usar o histórico verdadeiro , mas prever não pode usar como entrada.
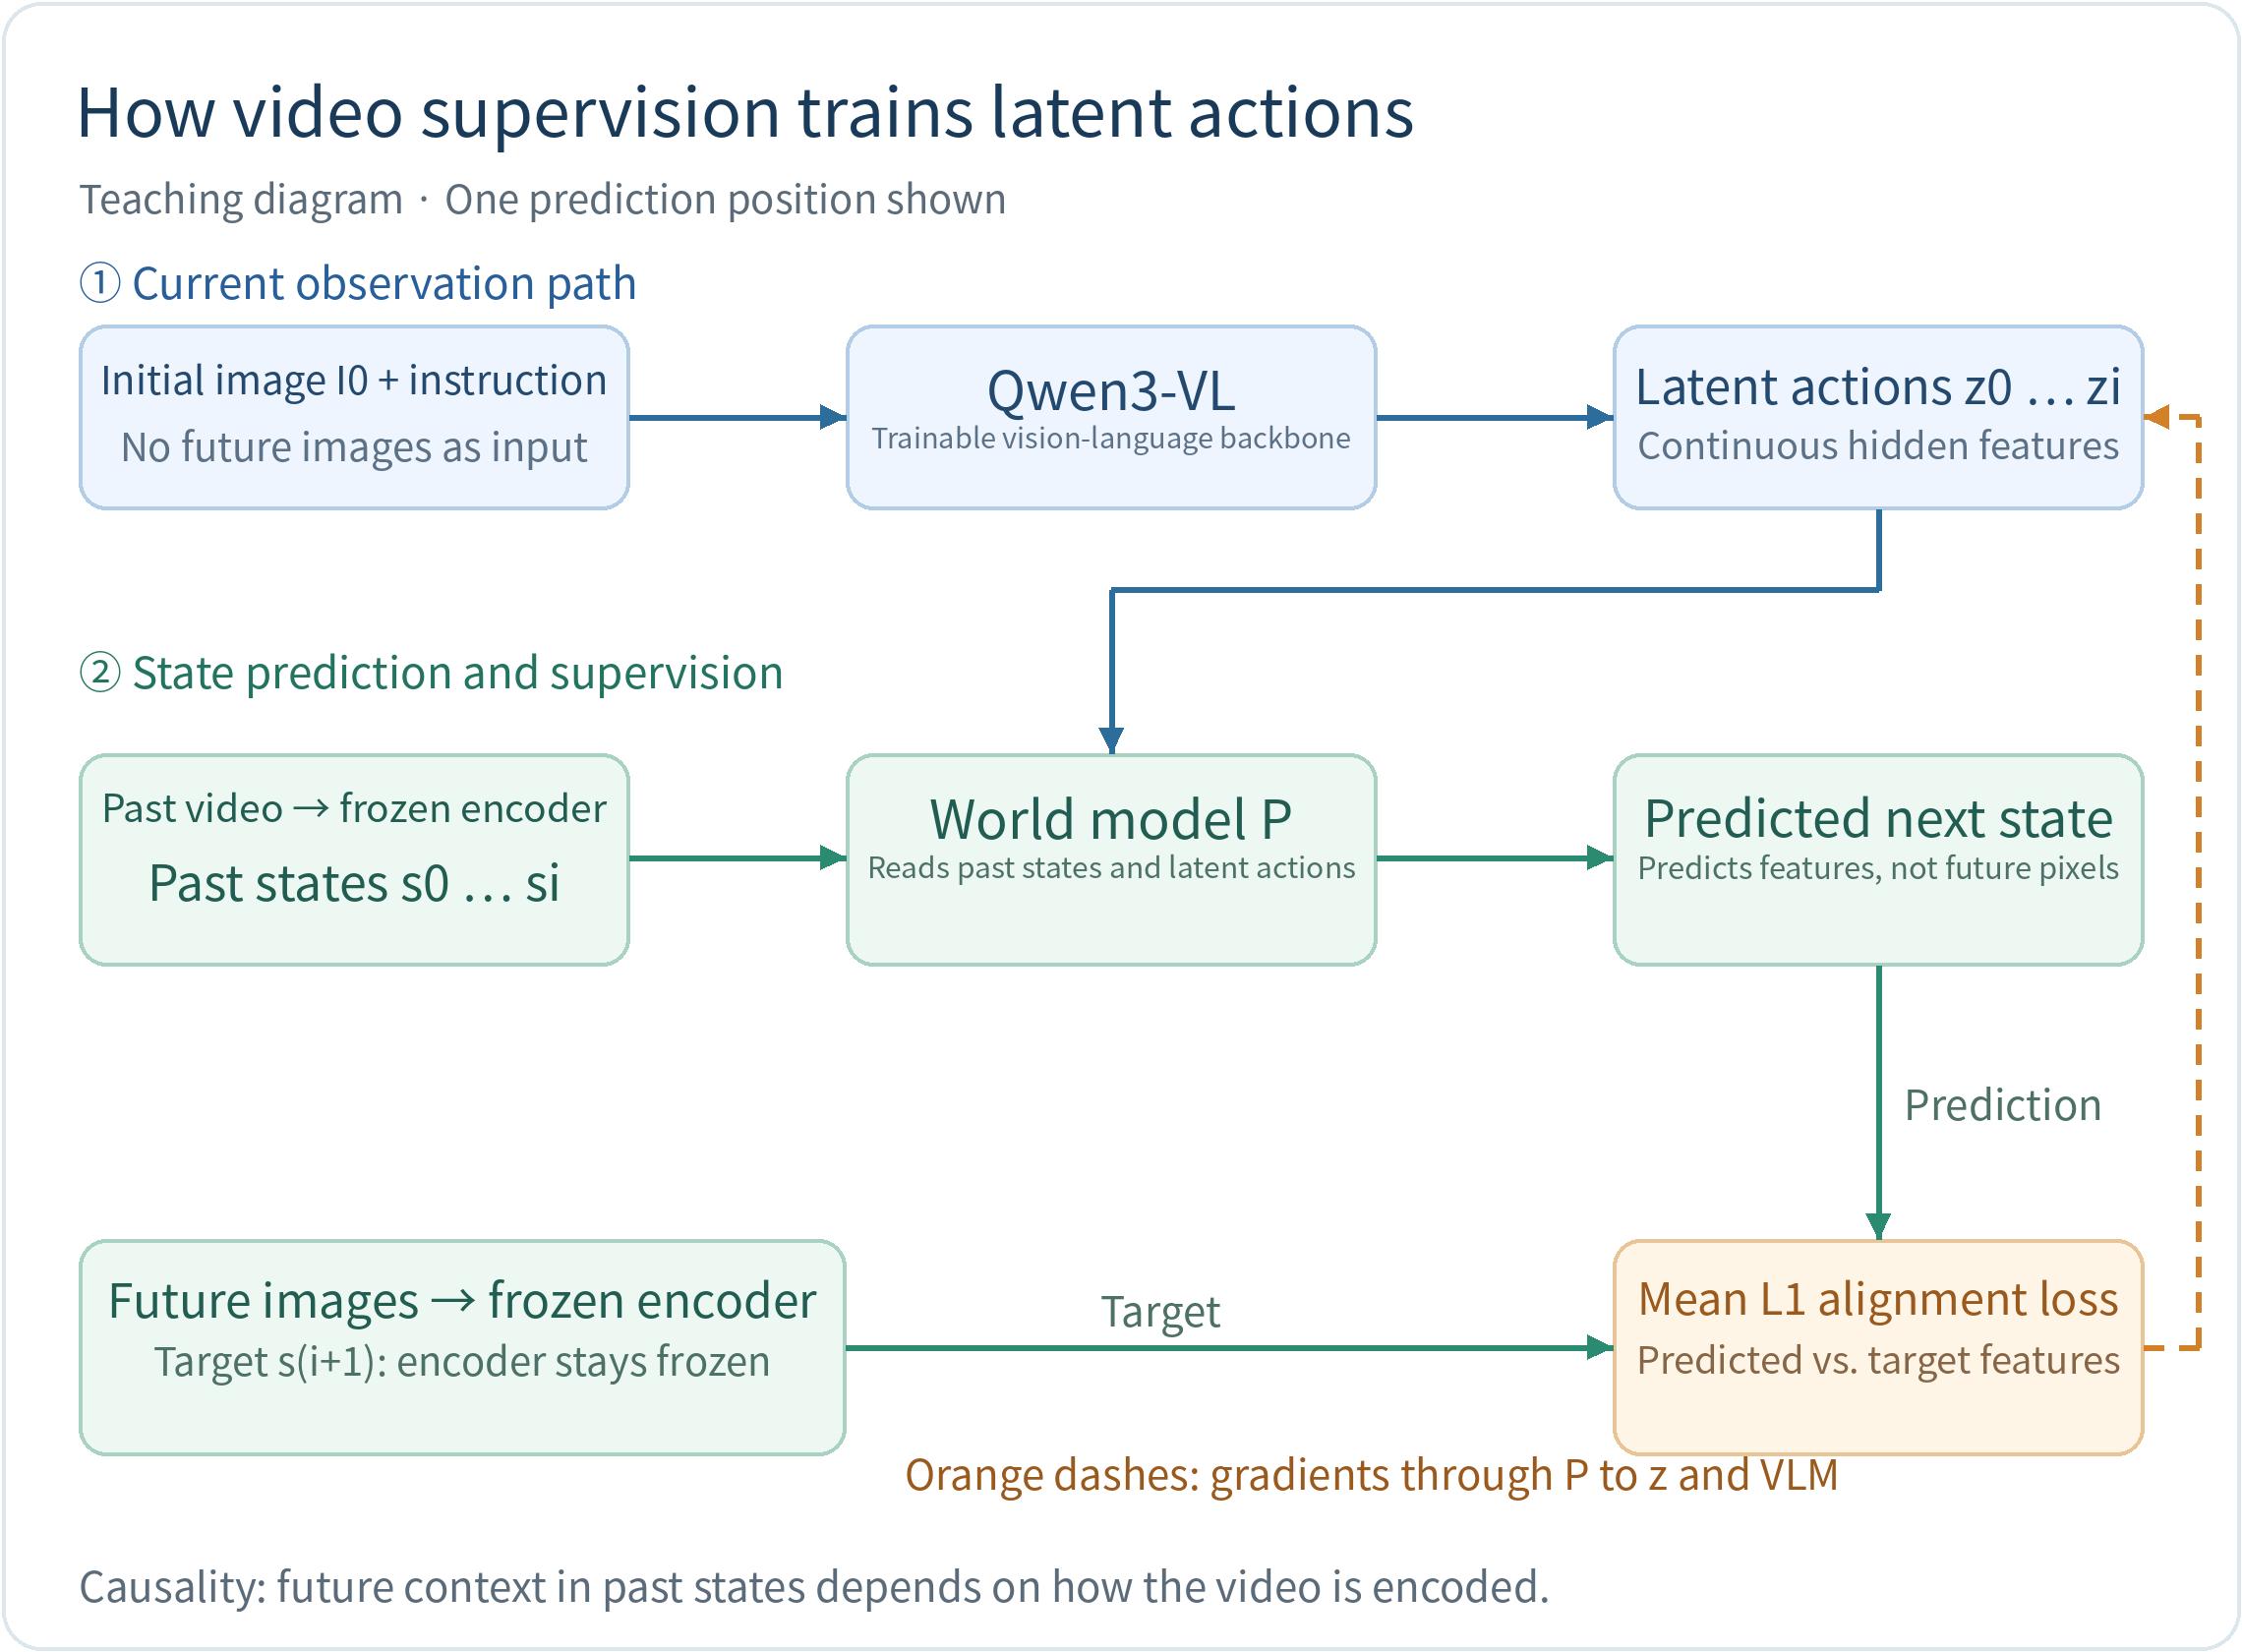
A conexão crucial é o caminho do gradiente. Imagens futuras passam pelo codificador fixo para formar alvos. O erro de predição se propaga pelo modelo de mundo até o VLM, incentivando as ações latentes a carregarem informação útil para prever mudanças. Para prever uma maçã saindo da mesa, por exemplo, a ação latente deve ajudar a explicar essa transição sem um rótulo semântico manual para cada característica oculta.
A implementação dos autores usa erro L1 médio. O seguinte expande essa loss implementada; a Equação (5) em si não especifica a norma de erro:
reúne características alvo, conta elementos, e denota stop-gradient; o codificador permanece fixo. Em um exemplo didático, alvo e predição dão erro médio .
Isso restringe a entrada de imagens futuras ao VLM. A máscara temporal do preditor por si só não garante causalidade estrita das características históricas do codificador de vídeo.
De Ações Latentes para Ações de Robô
As características de estado ainda precisam de uma conexão com o controle. Um segundo conjunto de consultas de ação segue as consultas de ação latente, lendo imagens anteriores, linguagem e ações latentes para formar o condicionamento (Equação (6)). Um head de ação DiT (Diffusion Transformer) então gera uma sequência contínua de ações.
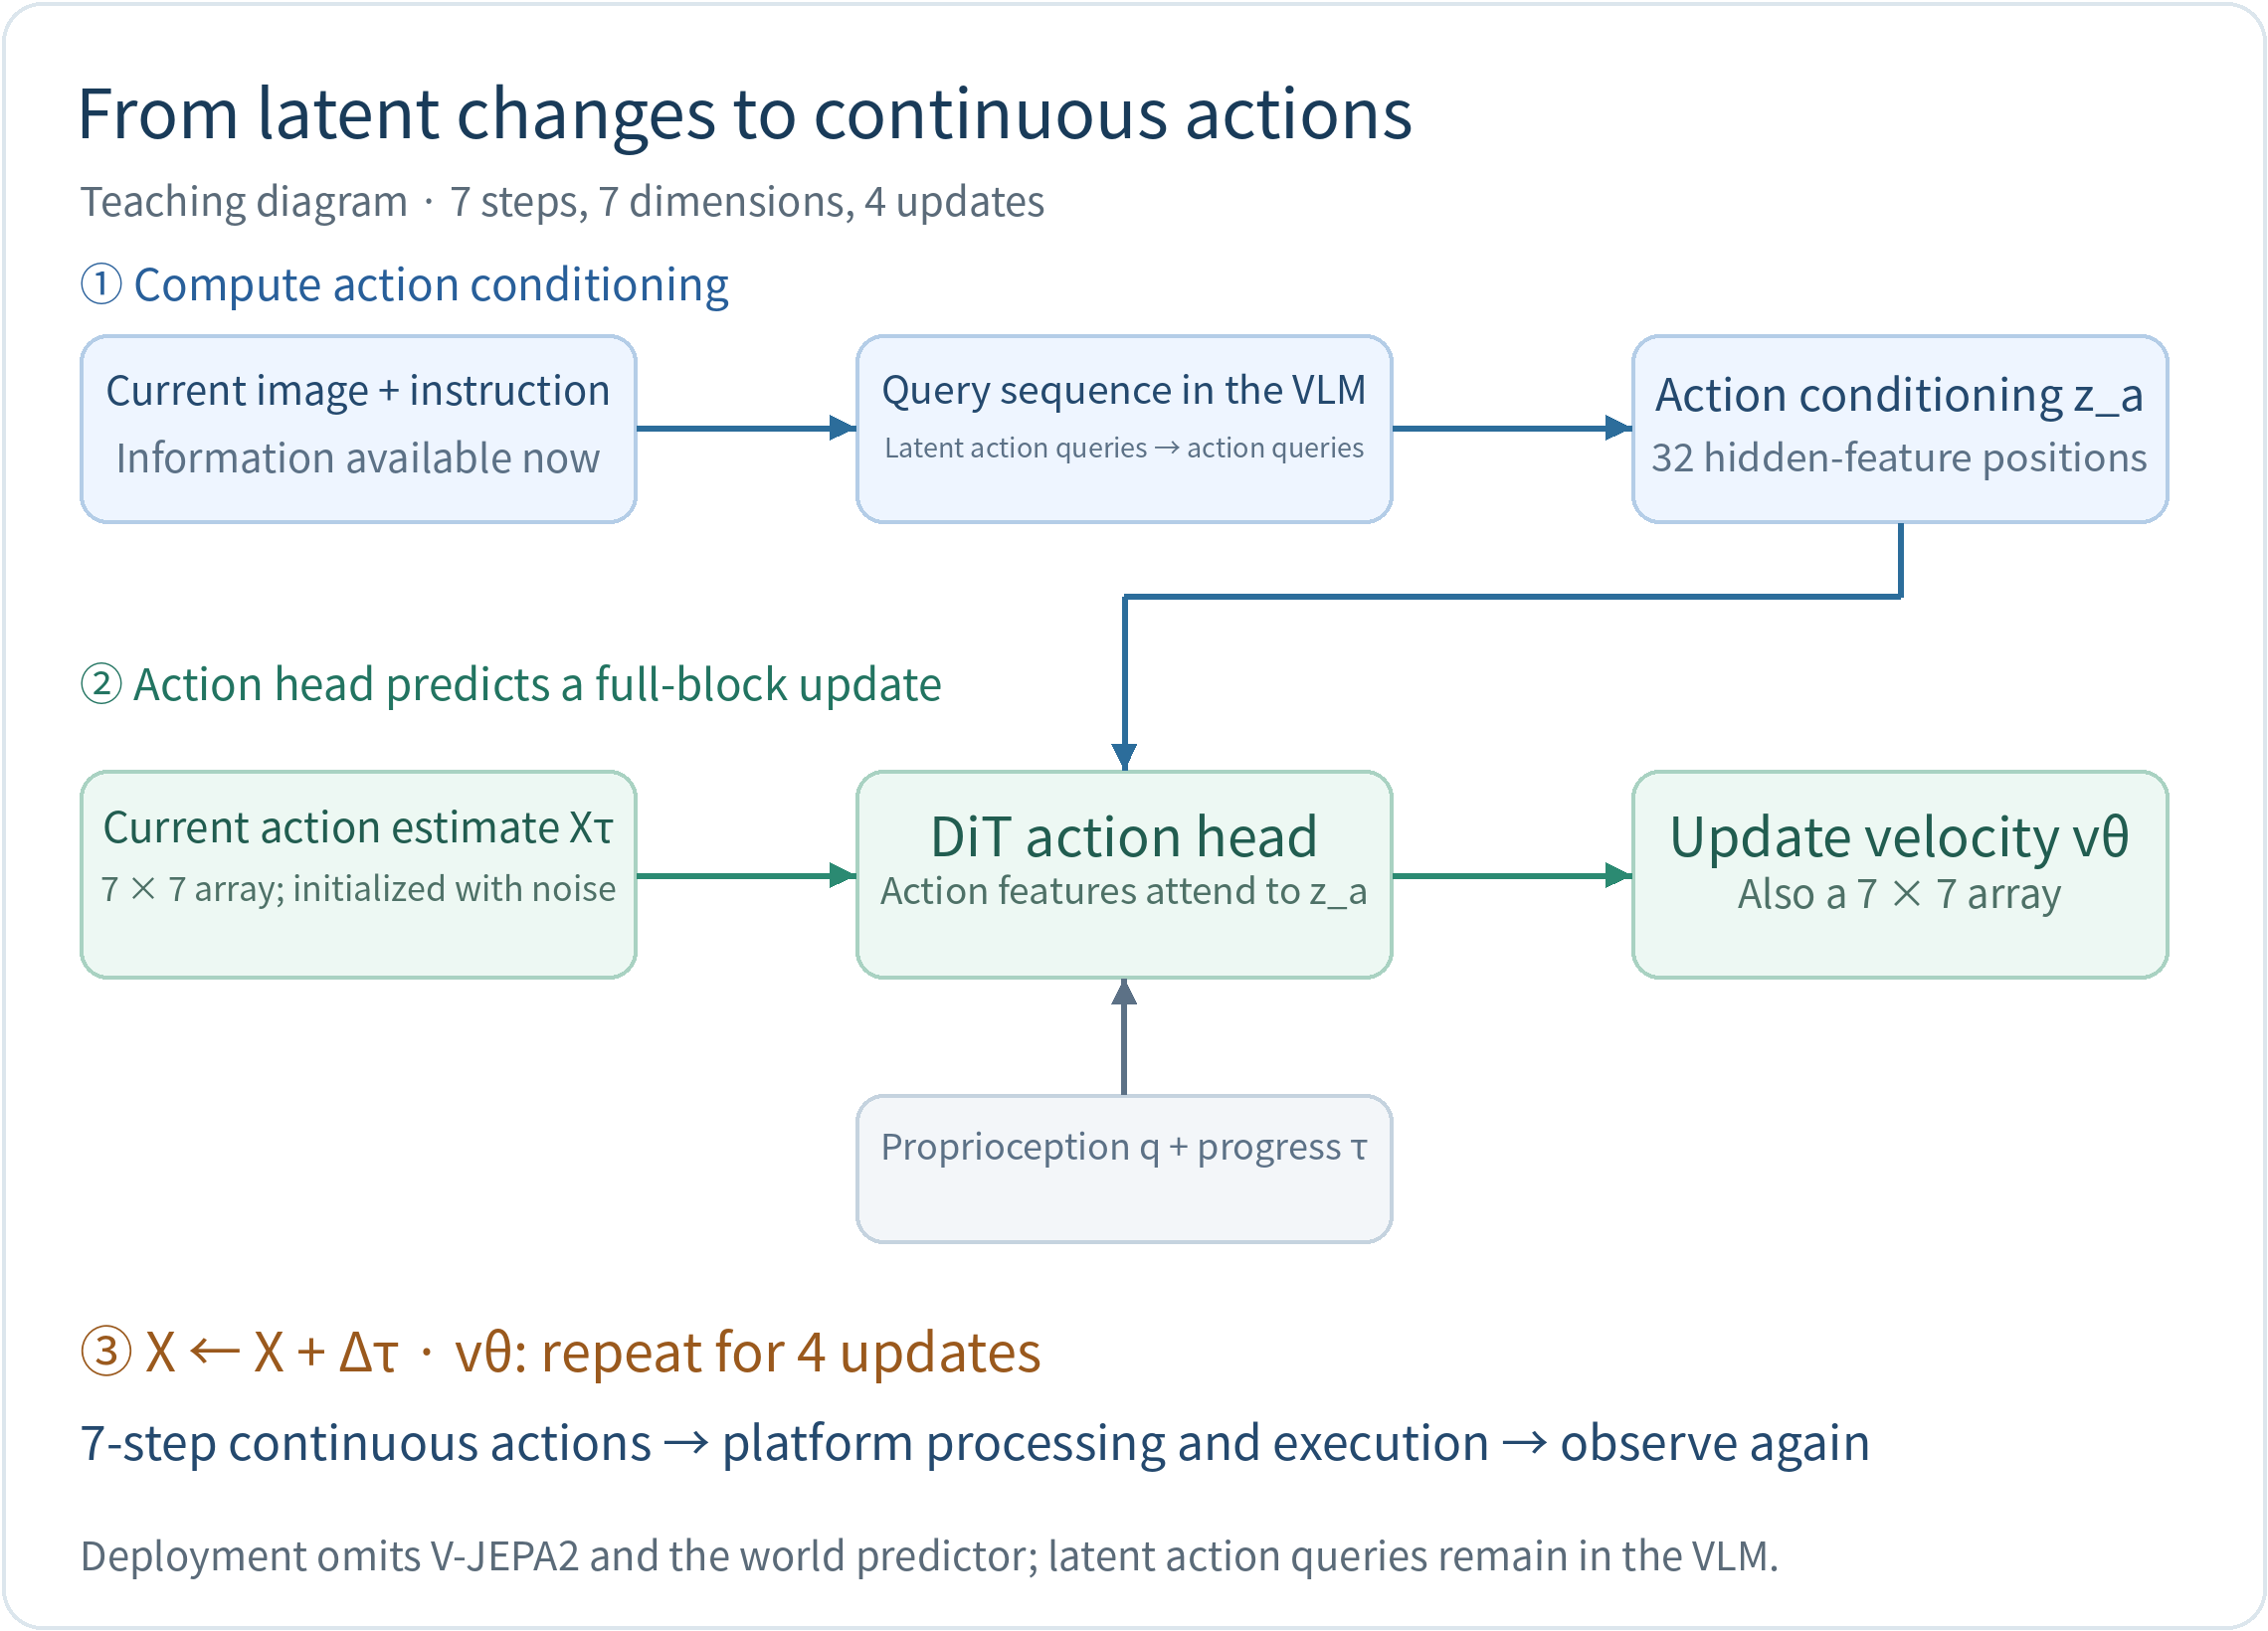
O head usa conditional flow matching. Ele mistura um bloco de ações demonstradas com ruído Gaussiano de mesmo formato e então aprende a direção do ruído em direção às ações. As Equações (7)–(8) podem ser escritas como:
é o progresso da geração, distinto do tempo do robô. retorna atualizações com o formato do bloco de ações. Para um elemento, , e dão um valor intermediário de 0.2 e direção alvo de 0.8. Prever 0.5 dá erro quadrático de 0.09.
A inferência começa a partir de ruído novo e segue as direções previstas. A implementação fixada usa atualizações de Euler:
Quatro atualizações geram um bloco de ações de : sete passos de controle com sete valores cada. As quatro atualizações ocorrem dentro da cabeça de ação, em vez de representar quatro passos do robô. A implementação também fornece estado proprioceptivo e progresso da geração para a cabeça, que lê por meio de cross-attention. O artigo usa amostragem temporal uniforme, enquanto a implementação fixada usa amostragem Beta, uma diferença de configuração de treinamento.
Treinamento e Inferência
O pré-treinamento conjunto usa aproximadamente 220.000 vídeos humanos Something-Something-v2 e 76.000 trajetórias de robô DROID. Os vídeos humanos fornecem imagens e linguagem para predição de estado. Os dados de robô fornecem adicionalmente rótulos de ação para otimização conjunta (Equação (9)):
pondera as duas perdas. A implementação do autor e a versão fixada do LeRobot usam ambas 0,1. Após 50.000 passos de pré-treinamento, ramificações separadas continuam a partir desse checkpoint para treinamento em simulação (30.000 passos) e fine-tuning em hardware (20.000 passos).
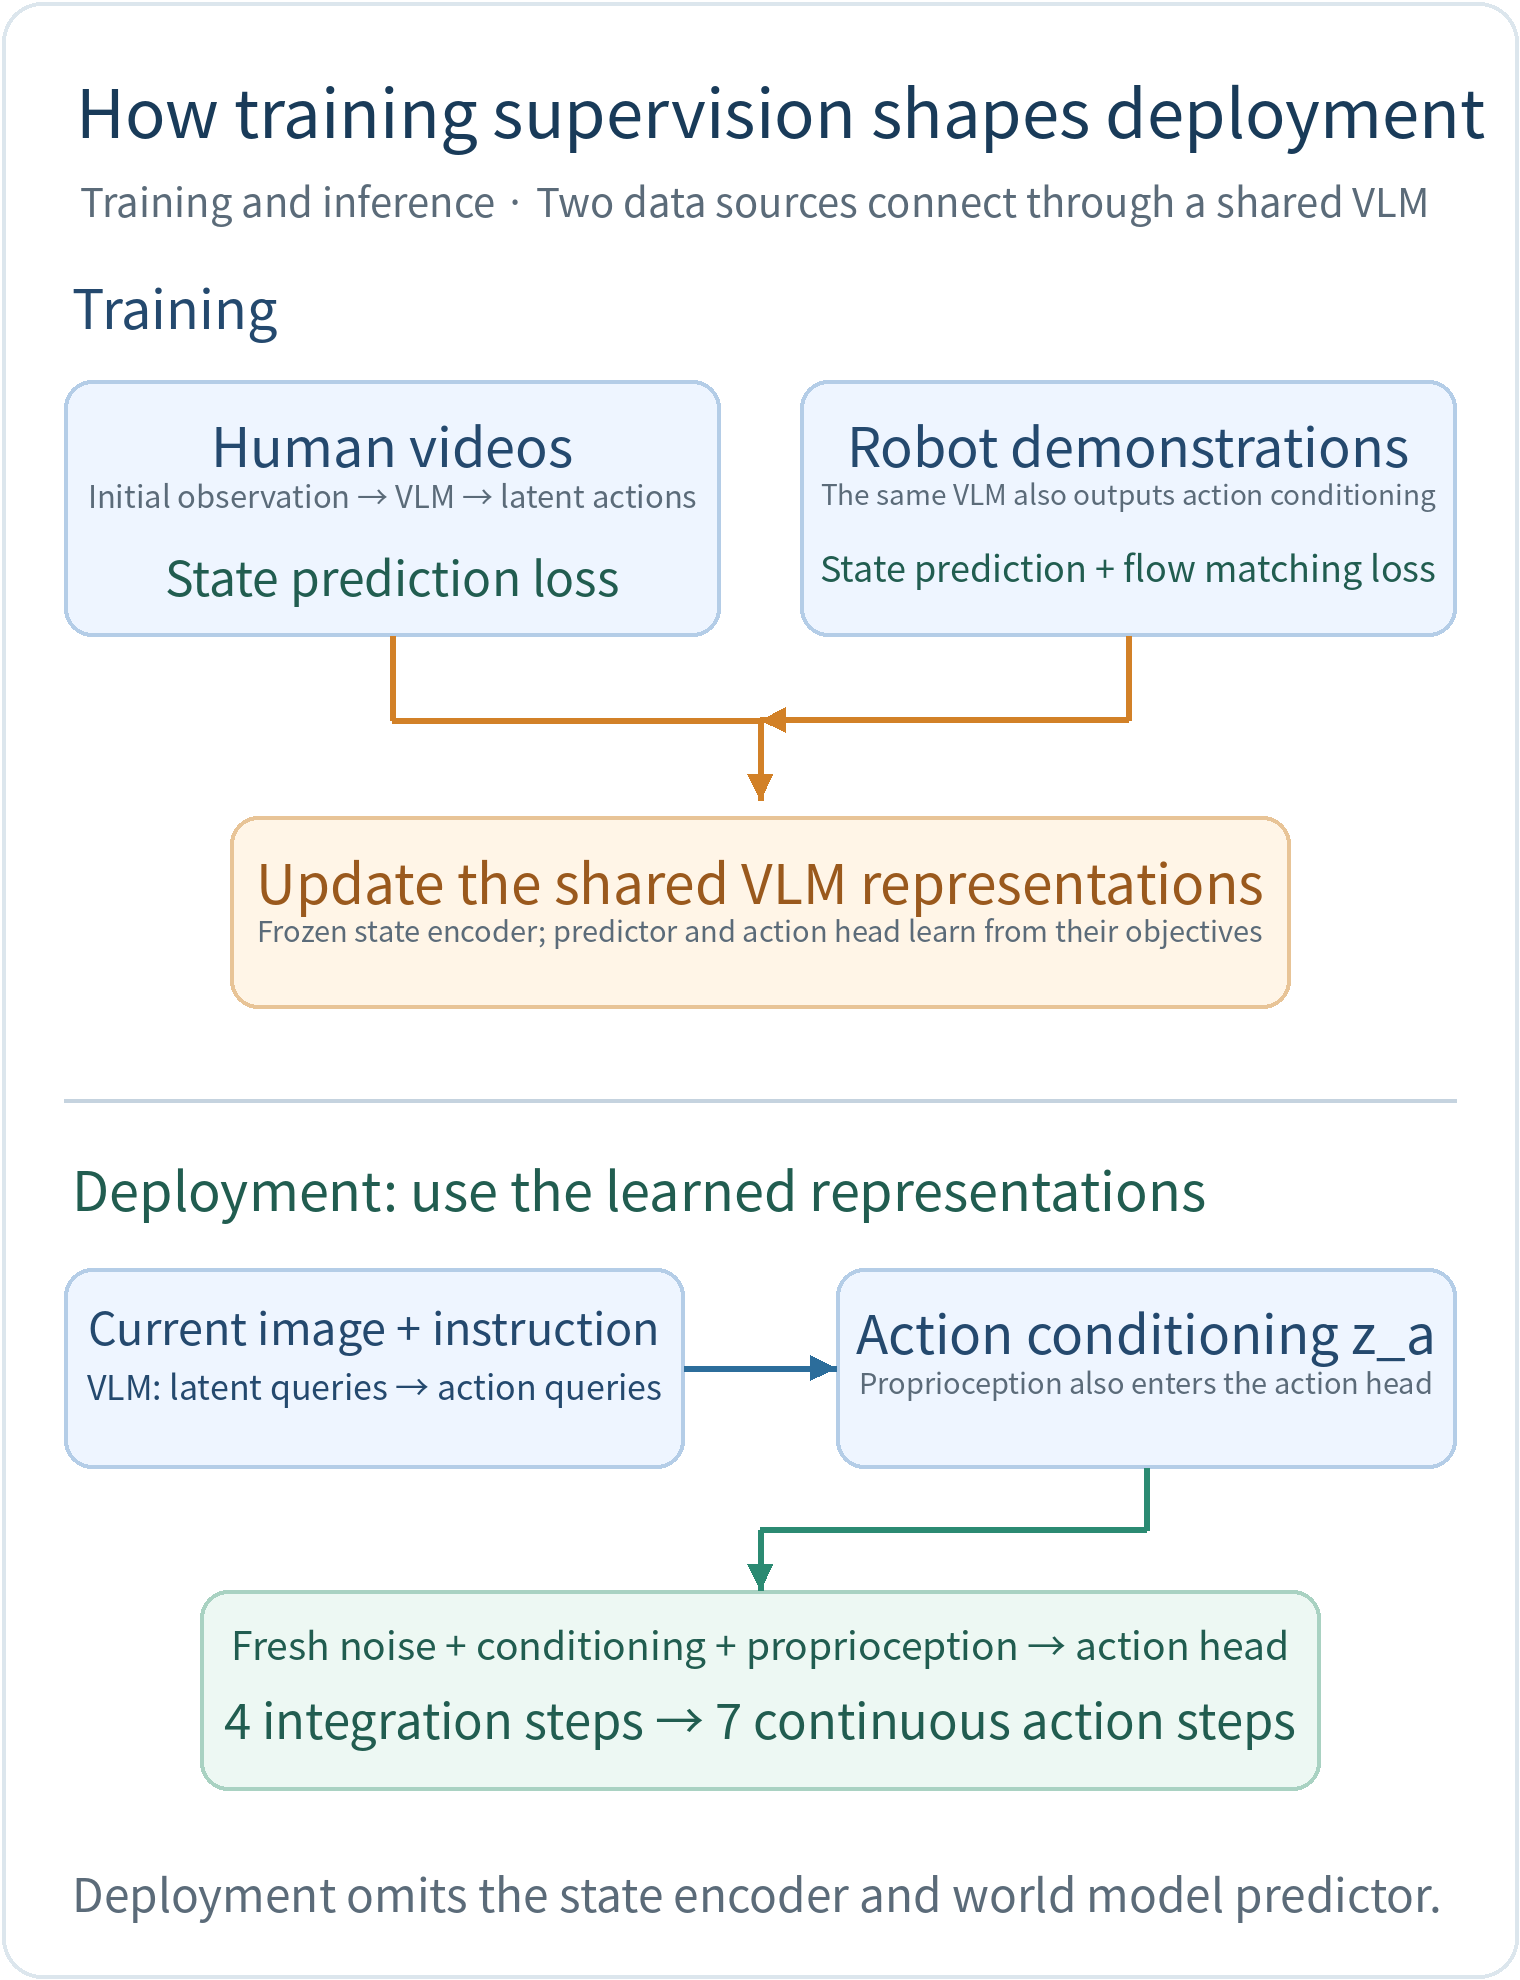
Durante o treinamento, o codificador de vídeo fornece histórico e alvos; o erro do modelo de mundo treina o VLM, e as demonstrações de robô adicionam supervisão de controle. Durante a implantação, imagens atuais, instruções e as entradas de estado exigidas pela cabeça de ação são suficientes. O cálculo de ações latentes e a cabeça de ação permanecem; o codificador de vídeo e o preditor do modelo de mundo são omitidos. O controlador executa ações e, em seguida, novas observações sustentam outra predição.
O modelo de mundo, portanto, atua principalmente como um professor em tempo de treinamento. Ele incentiva representações que expliquem mudanças, sem buscar vídeos futuros para escolher ações durante a implantação.
Resultados Experimentais
Tarefas Padrão e Perturbações
O fine-tuning no LIBERO usa demonstrações de especialistas. Quatro suítes contêm cada uma dez tarefas, avaliadas 50 vezes por tarefa: 2.000 tentativas no total. A Tabela 1 compara métodos completos e inclui a ablação de vídeos humanos em suas duas últimas linhas:
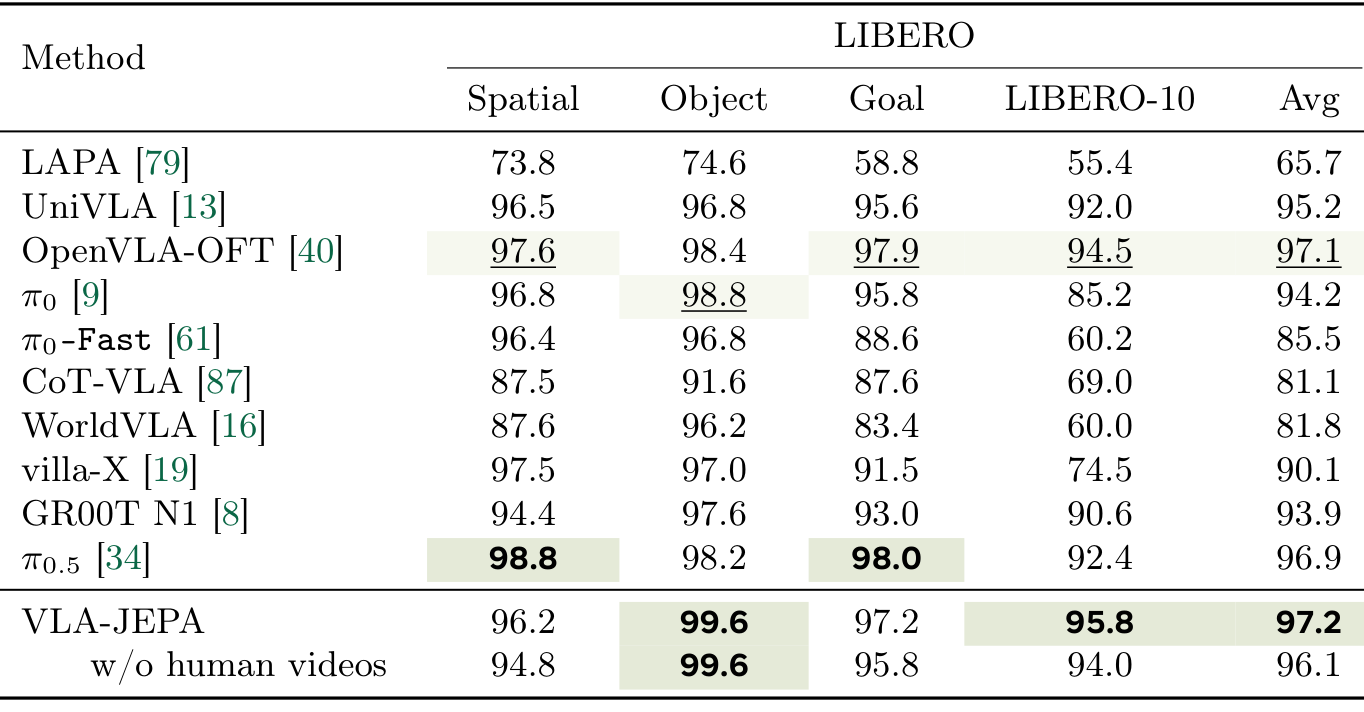
O sucesso médio é 97,2%, contra 96,1% sem vídeo humano. O modelo completo lidera os métodos listados, mas está próximo dos 97,1% do OpenVLA-OFT. A tabela principal não apresenta barras de erro em execuções de treinamento independentes, portanto pequenas diferenças não devem ser superestimadas.
LIBERO-Plus adiciona sete tipos de perturbação enquanto mantém os dados de treinamento LIBERO originais:
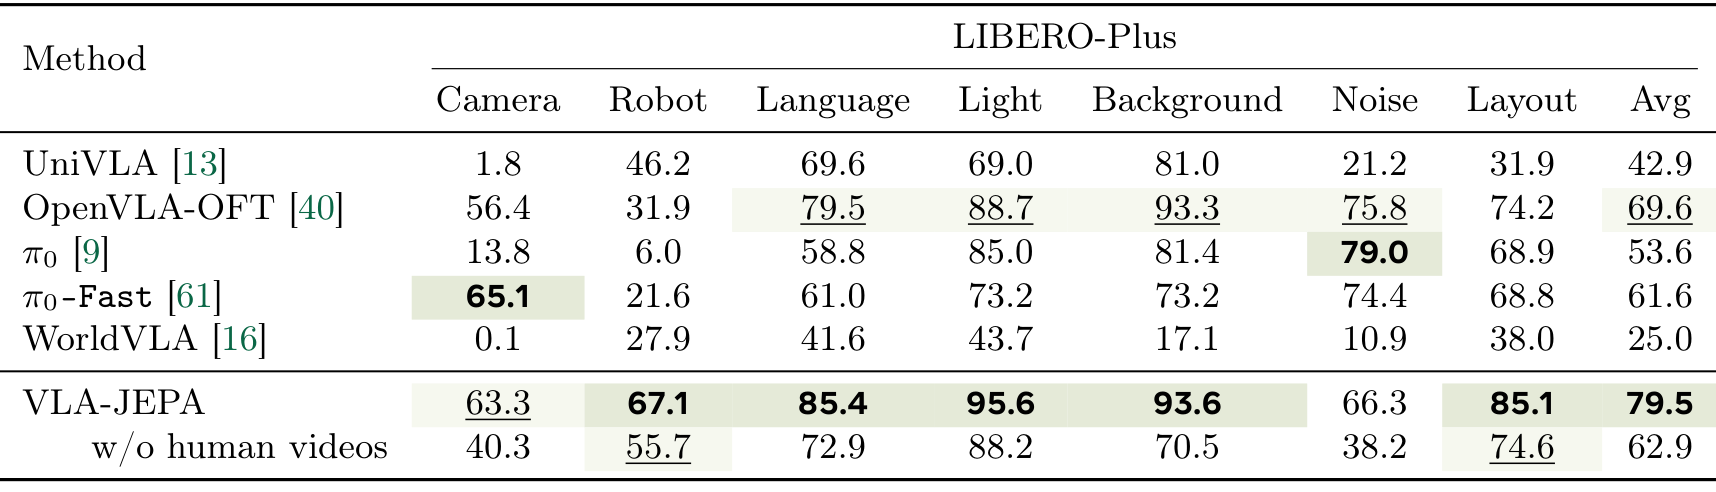
O vídeo humano eleva o sucesso médio de 62,9% para 79,5%, melhorando todas as sete categorias. Esse ganho de 16,6 pontos percentuais é maior que o ganho de 1,1 ponto em tarefas padrão, fornecendo evidência mais clara de benefícios sob perturbações.
Transferência e Desempenho em Hardware
SimplerEnv avalia a transferência de dados de treinamento de robô real para simulação:
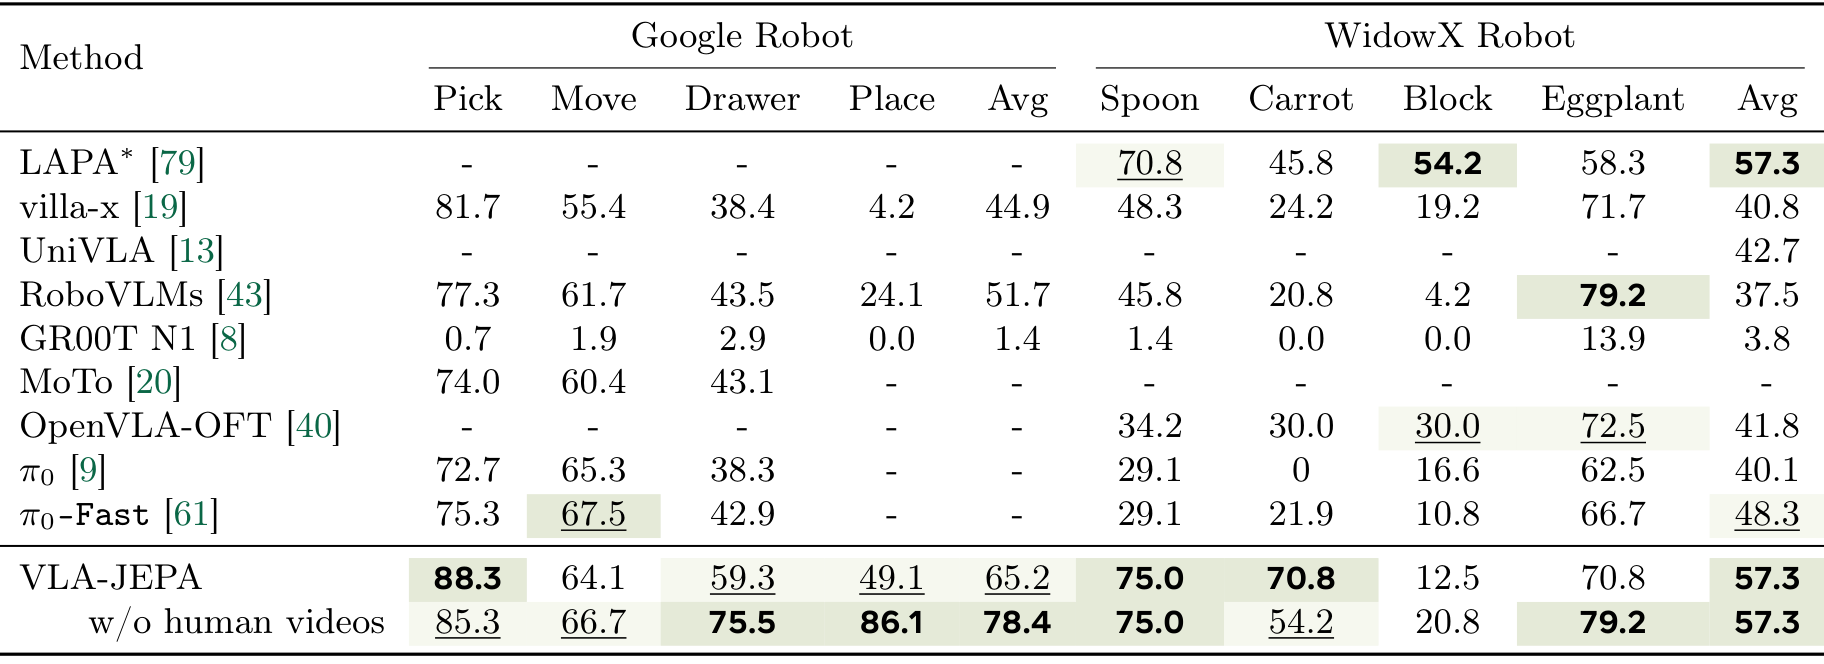
Os benefícios não são universais. Adicionar vídeo humano reduz o sucesso médio no Google Robot de 78,4% para 65,2%; WidowX permanece em 57,3%. A experiência em vídeo não substitui demonstrações de robô para tarefas de controle específicas. Algumas médias de baseline e classificações textuais são inconsistentes, portanto a conclusão aqui usa a ablação do modelo.
Os testes em hardware usam um Franka Research 3, garra Robotiq e três câmeras D435, com dez tentativas por tarefa. A Figura 4 apresenta os resultados:
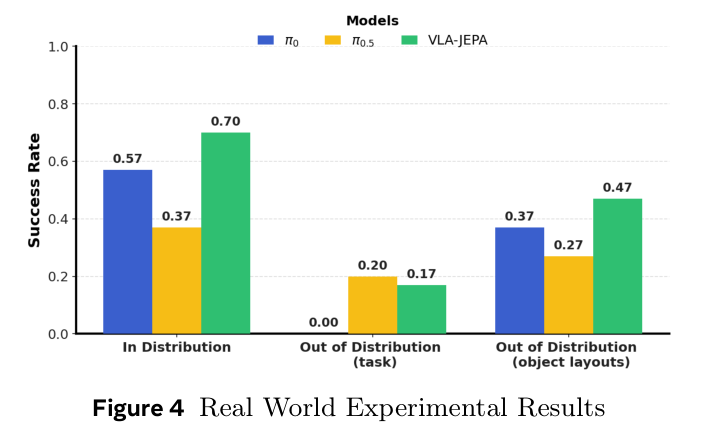
VLA-JEPA atinge 0,70 em condições dentro da distribuição e 0,47 após mudanças de layout, liderando as duas linhas de base. Sua pontuação em tarefas não vistas é 0,17, abaixo dos 0,20 do π0.5. Nenhum dos três modelos conclui colocar uvas no nível superior de uma prateleira não vista, e o VLA-JEPA ainda pode selecionar o objeto errado.
Esses experimentos apoiam a competitividade geral do método e a contribuição de vídeos humanos para a robustez a perturbações. Eles não isolam separadamente os efeitos do objetivo JEPA, do acesso à informação e das etapas de treinamento.
Conclusão
VLA-JEPA transforma mudanças de estado em vídeo em supervisão para representações de robô. Ações latentes explicam mudanças, a cabeça de ação produz valores de controle, e demonstrações de robô conectam as duas coisas. Esse desenho de supervisão melhora o desempenho sob as perturbações testadas, enquanto a execução confiável e a generalização para tarefas não vistas permanecem em aberto.