WALL-OSS: Como o Entendimento Visão-Linguagem se Conecta a Ações Incorporadas
Impulsionando VLMs em direção ao Espaço Incorporado
- Semântica de ações
- Controle contínuo
- Uni-CoT
- VQA incorporado
Pré-requisitos: Conectando Objetivos à Execução
De VLM para VLA
Explicação: Um VLM interpreta imagens e texto; um VLA adicionalmente gera controles numéricos. Este artigo aprende o mapeamento a partir de demonstrações, VQA visual e anotações de processo em vez de enviar uma resposta verbal diretamente para os motores.
A tarefa de blocos de letras exige reconhecer o objetivo, escolher a ordem das letras e localizar e posicionar os blocos. Responder “spell FIVE” completa apenas a parte de entendimento.
| Conceito | Intuição | Exemplo neste artigo |
|---|---|---|
| Observação | Informação externa sobre a cena | Imagens em visão ego e de câmera montada no braço. |
| Estado do robô | Configuração numérica do robô | Estado entrando no ramo contínuo na Figura 3; campos e dimensões não são informados. |
| Ação | Alvos numéricos para a interface de controle | Uma trajetória de T passos e d dimensões; posições padronizadas para metros e ângulos para radianos entre fontes. |
| Visual question answering (VQA) | Responder perguntas em texto a partir de imagens | Localizar um bloco, descrever a cena ou prever uma subtarefa. |
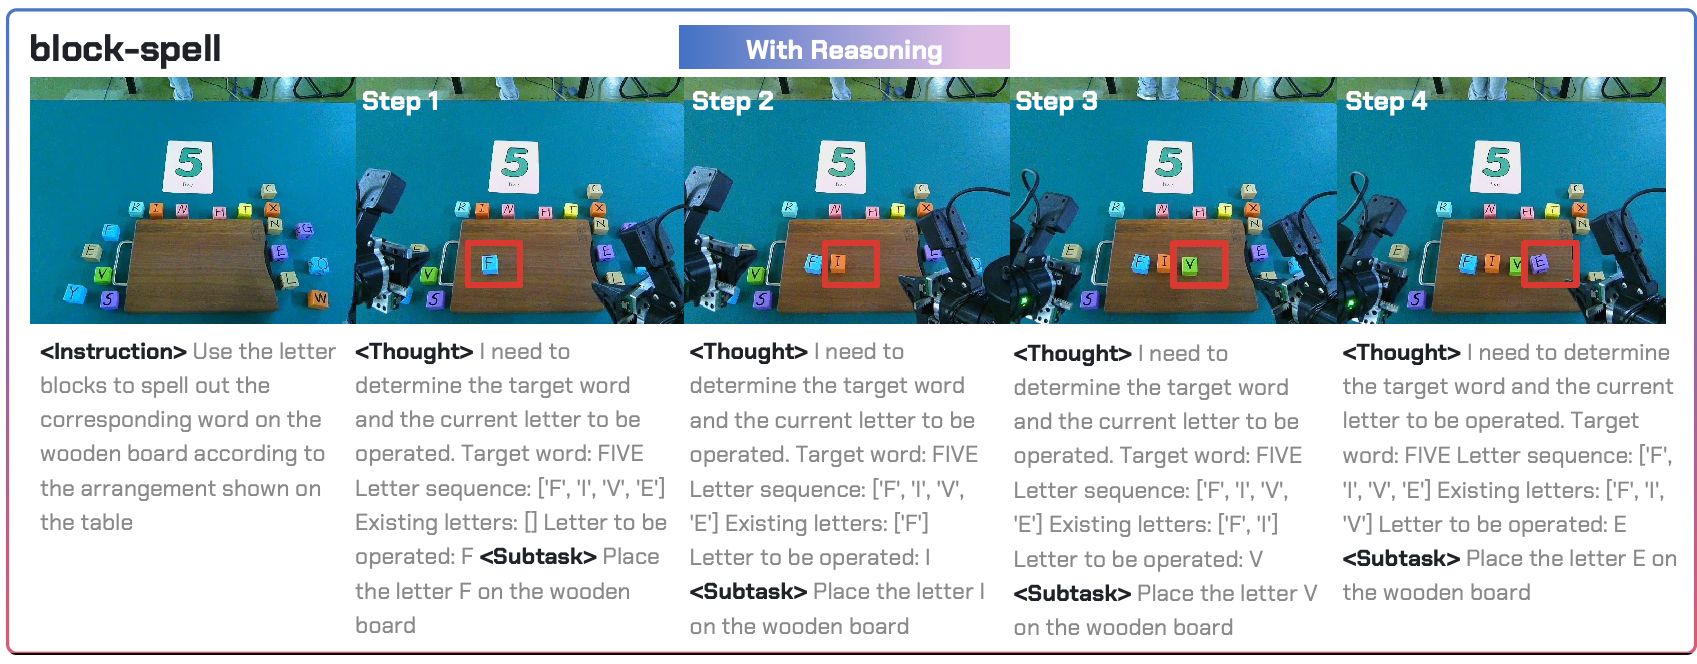
| Chain of thought (CoT) | Raciocínio intermediário explícito | O objetivo é FIVE; F e I estão posicionados; V é o próximo. |
Cuidado: A entrada de estado da Figura 3 não deve ser omitida porque o texto resume o condicionamento como visão e instrução. As plataformas incluem robôs de um braço, bimanipulares, móveis e humanóides com rodas, então elas não podem compartilhar uma contagem de DoF, número de câmeras ou especificação de ação presumidos em comum.
Ações Diretas e Decisões Entre Níveis
Uma política direta mapeia imagens e instruções para ações; um pipeline hierárquico usa um planejador separado antes de um controlador. WALL-OSS aprende “instrução → raciocínio → subtarefa → ações contínuas” em um único modelo, permitindo que níveis intermediários desnecessários sejam ignorados.
Direct: image + “spell FIVE” → action sequence
Full: image + instruction → goal/progress reasoning → “place V third” → actions

Illustrative timeline:
First decision: empty board → place F
Later decision: F is present → place I
Next decision: F and I are present → place V
Explicação: Subtarefas esclarecem o objetivo atual e podem reduzir ações repetidas ou confusão entre estágios. Um raciocínio correto ainda exige execução de baixo nível precisa. Esta linha do tempo explica o progresso, não um cronograma fixo de replanejamento relatado.
Modelagem de ações discretas (DAM) codifica trajetórias numéricas como tokens; modelagem de ações contínuas (CAM) gera trajetórias numéricas diretamente. Esta é uma distinção de representação/objetivo, não outro nome para controle de passo único versus múltiplos passos.
Treinamento, Inferência e Avaliação
| Estágio | Operação | Resultado |
|---|---|---|
| Treinamento | Usar VQA visual, ações demonstradas e anotações limitadas de raciocínio/subtarefas para otimizar objetivos de texto e ação. | Parâmetros; perdas medem o ajuste à supervisão. |
| Inferência | Ler imagens, instruções e estado para o caminho contínuo; gerar raciocínio opcional, subtarefas e ações. | Trajetórias enviadas ao controle. |
| Avaliação | Executar tarefas especificadas e avaliar manualmente o VQA incorporado. | Qualidade de QA, progresso, sucesso ou precisão de instruções, interpretados separadamente. |
Taxas completas de controle, latência de inferência e agendamento de execução não são relatados. “Ações de alta frequência” ou “controle assíncrono” não estabelecem desempenho em tempo real, e perda não é sucesso em tarefa.
Resumo: Tradução e Comentários
Tradução
Apesar do progresso em linguagem e visão, o entendimento espacial e incorporado de VLMs permanece limitado. Avançar em direção à interação física expõe desencontros em modalidades, distribuições de pré-treinamento e objetivos, tornando o entendimento e a geração de ações um grande desafio rumo à inteligência geral.
Apresentamos o WALL-OSS, um modelo fundamental incorporado de ponta a ponta que usa pré-treinamento multimodal em larga escala para (1) entendimento visão-linguagem sensível a características incorporadas, (2) forte associação linguagem–ação e (3) manipulação robusta. Uma arquitetura fortemente acoplada e um currículo de treinamento com múltiplas estratégias dão suporte ao Unified Cross-Level CoT, unificando raciocínio sobre instruções, decomposição de subobjetivos e síntese de ações de alta granularidade em um único framework diferenciável.
Os autores relatam forte seguimento de instruções, raciocínio e manipulação de longo horizonte em relação às linhas de base, apresentando uma rota escalável de VLMs para modelos fundamentais incorporados.
Comentários
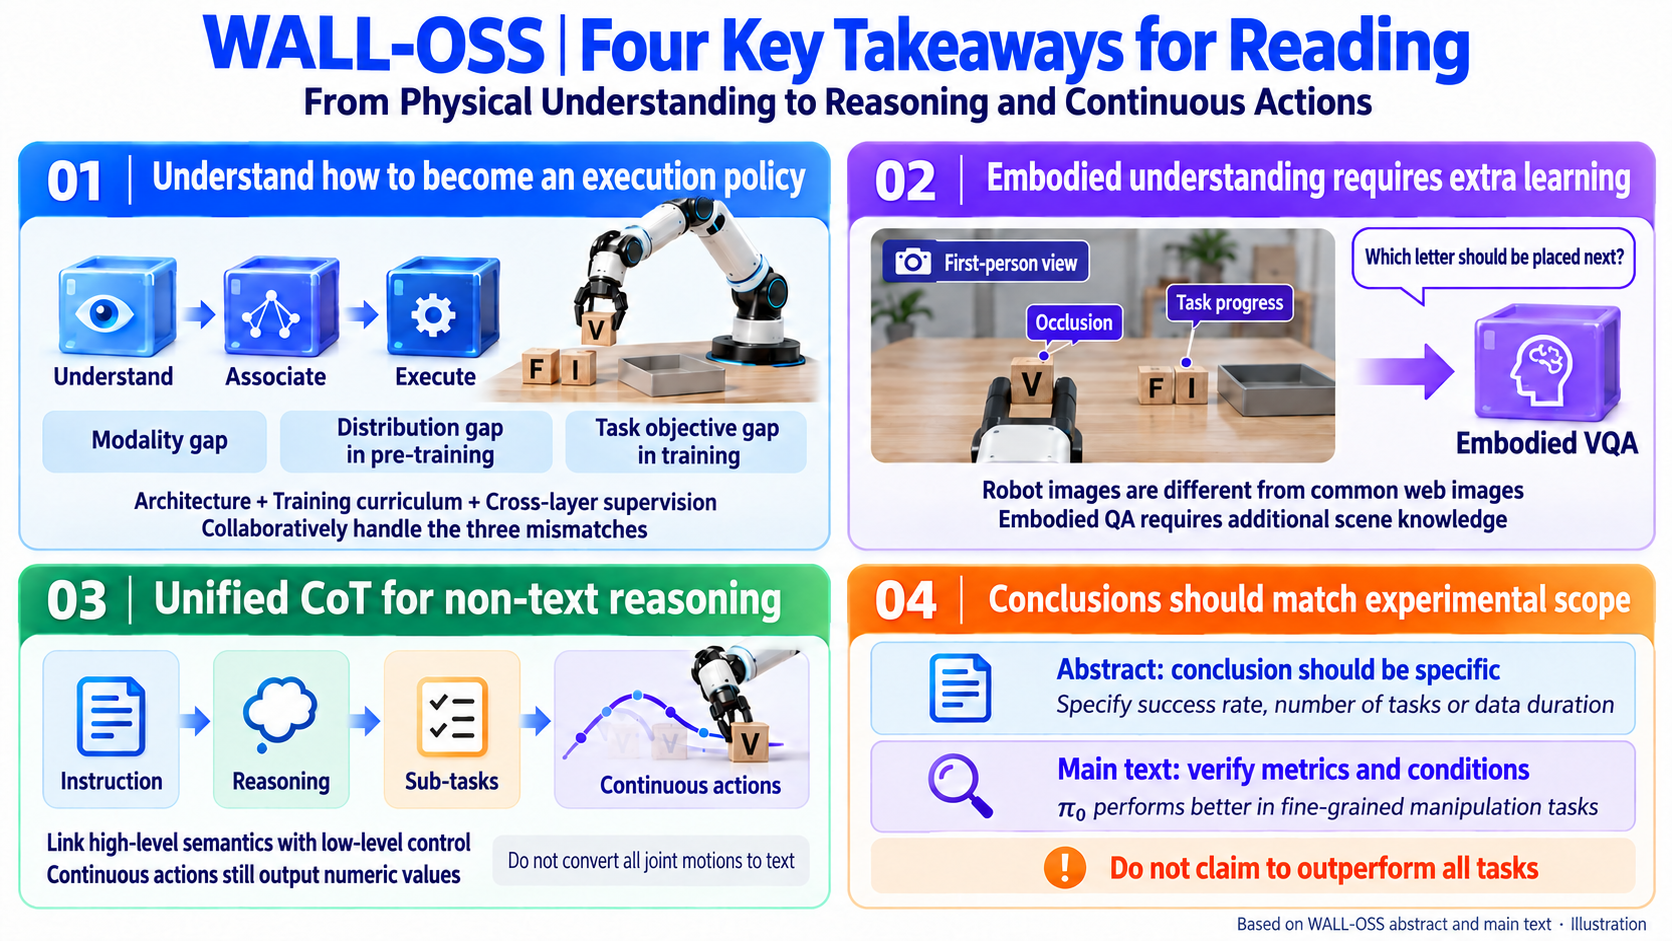
Introdução e Trabalhos Relacionados: Três Desencontros
Os Oito Principais Parágrafos da Introdução
Eles correspondem às páginas 1–3. Três parágrafos têm subtítulos Gap; o parágrafo 7 abrange as páginas 2–3. A legenda da Figura 1 não é contada como texto da introdução.
Parágrafo 1: o destino. Modelos de linguagem/visão entendem entradas multimodais, mas carecem de feedback físico e ações executáveis, o que motiva o entendimento e a geração de ações.
Parágrafo 2: por que transferir de VLMs? Dados imagem-texto são abundantes, dados pareados de robôs são escassos e heterogêneos. Priors pré-treinados motivam transferência em vez de treinamento do zero, mas não provam por si só a eficácia.
Parágrafo 3: o dilema da transferência. Fine-tuning direto de um cabeçalho de ação pode desviar parâmetros pré-treinados; isolamento forte pode enfraquecer o acoplamento semântica–controle. Isso motiva três lacunas.
Parágrafo 4: lacuna de modalidade e escala de dados. Texto e visão comprimida são amplamente alinhados, enquanto ações são sinais espaço-temporais contínuos e instruções de alto nível omitem subtarefas. A discussão de erros de planejador/controlador e abordagens 3D motiva o trabalho em vez de rejeitar experimentalmente todas as alternativas.
Parágrafo 5: lacuna de distribuição. Visões em primeira pessoa, imagens olho de peixe e auto-oclusão diferem de imagens da internet. Ancoragem espacial e avaliação de progresso precisam de supervisão incorporada. A Figura 1 ilustra isso, não um benchmark em larga escala.
Parágrafo 6: lacuna de objetivo. Texto usa predição discreta do próximo token; ações contínuas se adequam a diffusion ou flow matching. Simplesmente juntar objetivos pode não conectar fortemente semântica e controle, motivando treinamento discreto-para-contínuo.
Parágrafo 7: a resposta proposta. Especialistas acoplados e treinamento em estágios abordam objetivos; VQA incorporado e priors discretos abordam distribuições; CoT unificado conecta semântica a ações finas entre níveis.
Parágrafo 8: contribuições e recursos abertos. O artigo não fornece uma lista fixa e numerada de três itens de contribuição. Ele resume o acoplamento de arquitetura e o desenho do currículo; experimentos sobre seguimento de instruções, raciocínio composicional e controle de longo horizonte; e uma rota mais ampla através da lacuna semântica–sensório-motora, enquanto anuncia código de treinamento e checkpoints abertos. Frases como “state of the art” e “theoretical insights” são afirmações dos autores; as evidências são avaliadas por meio de experimentos específicos e descrições formais publicadas.
Três Áreas de Trabalhos Relacionados e Como Este Trabalho Difere
-
Fundamentos de linguagem, visão e manipulação: VLAs existentes usam tokens de ação ou cabeçalhos contínuos. WALL-OSS primeiro aprende priors de ações discretas no espaço de saída de linguagem, depois otimiza flow matching com roteamento estático. Seu agrupamento amplo de ACT com métodos discretos não deve ser lido como tornar ACT um tokenizador FAST/BPE.
-
Co-treinamento multimodal/robótico: Métodos anteriores usam imagens, vídeo e dados de robôs para reter entendimento e melhorar transferência. Aqui, a supervisão incorporada unifica instruções, raciocínio, subtarefas e ações, com cotas e um currículo em estágios para limitar desvio.
-
Raciocínio e decomposição: Planejadores separados simplificam o treinamento, mas podem ter erros de interface e cumulativos. Uni-CoT aprende mapeamentos entre níveis em um único modelo com raciocínio intermediário opcional. Superioridade universal sobre pipelines ainda exige evidências.
Método central: Semântica de ações antes de controle contínuo
Atenção compartilhada, processamento de recursos separado
Problema: Preservar o conhecimento visão–linguagem enquanto se condicionam ações de forma rígida envolve trade-offs entre parâmetros totalmente compartilhados e independentes. Intuição: Trocar informações por meio de atenção compartilhada e depois processar categorias de recursos com redes feedforward separadas.
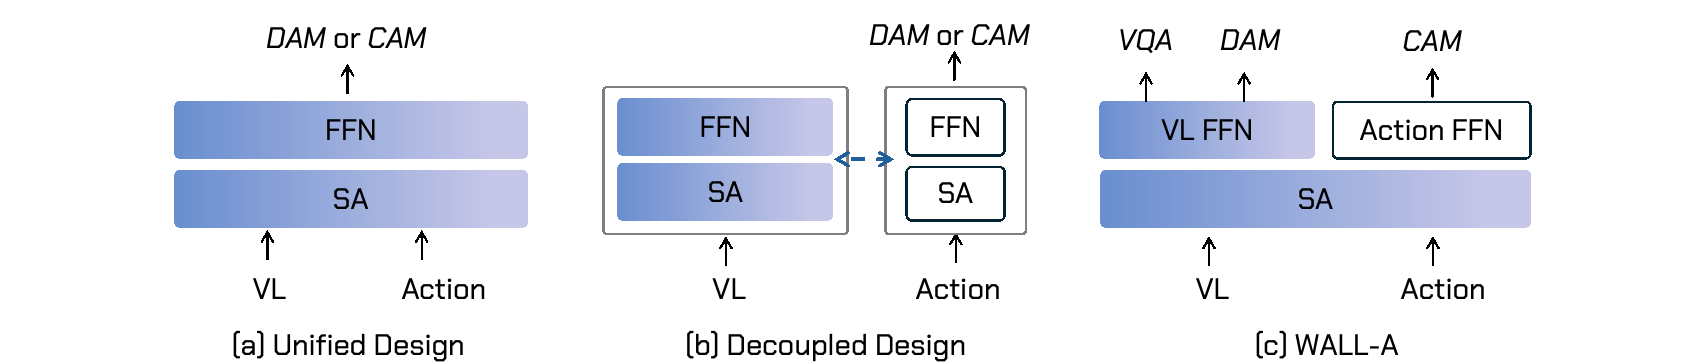
Artigo: Qwen2.5-VL-3B é o backbone. Um design de mixture-of-experts roteia estaticamente recursos visão–linguagem para um FFN de visão–linguagem e recursos de ação para um FFN de ação. A autoatenção troca informações entre modalidades; os FFNs especializam o processamento.
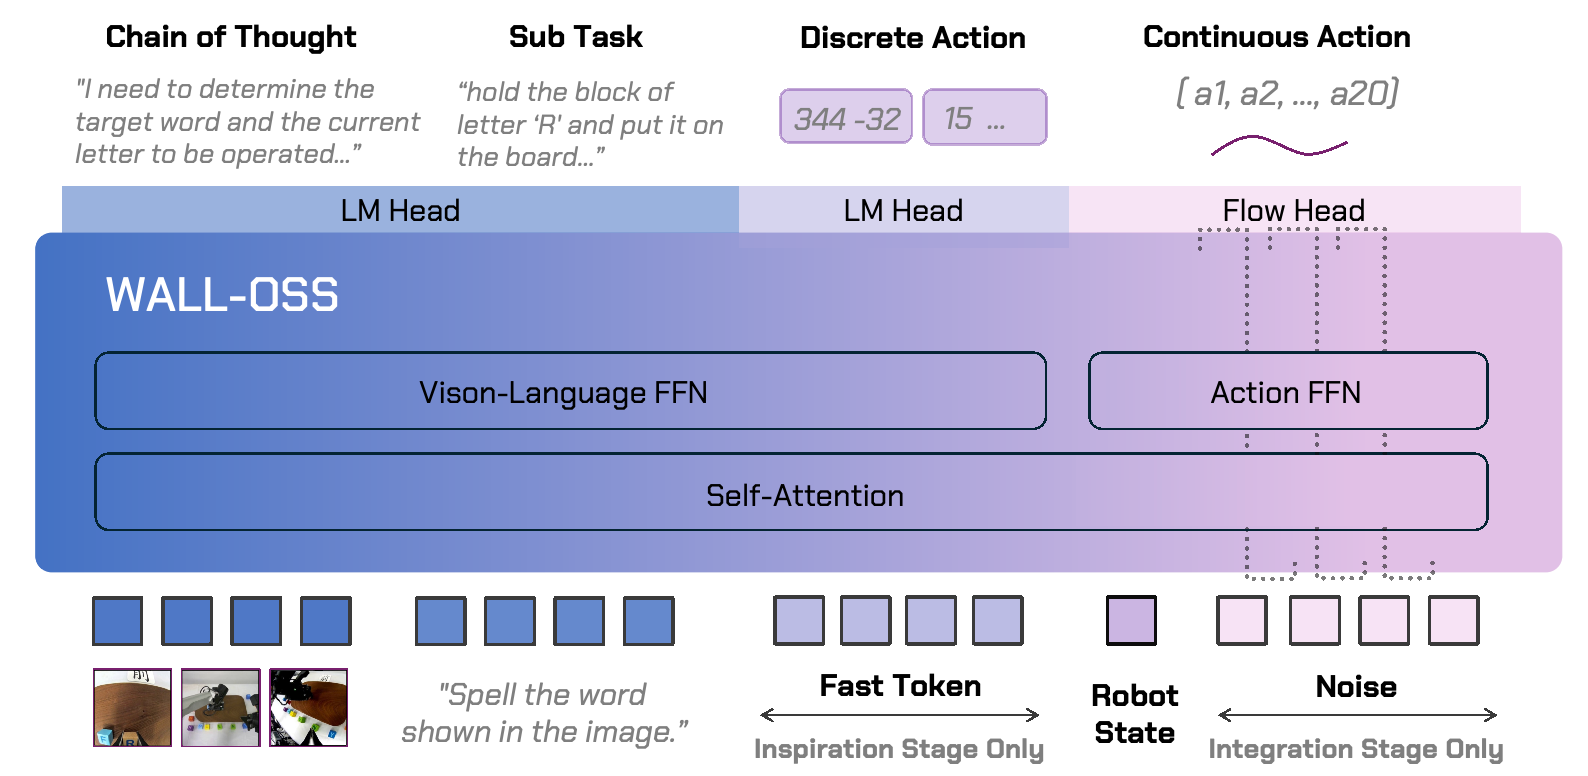
| Caminho | Entrada e processamento | Saída e forma |
|---|---|---|
| Imagens/linguagem | Visões ego/braço e instrução → codificação → atenção compartilhada e VL FFN | Recursos h; contagem de tokens e largura oculta não são especificadas. |
| Texto | Condições visão–linguagem → cabeça de LM | Tokens de raciocínio/subtarefa com probabilidades de vocabulário. |
| Ações discretas | Demonstrações → FAST; prever tokens subsequentes a partir de prefixos | K tokens de ação; K difere dos passos de trajetória T. |
| Ações contínuas | Recursos imagem–texto, estado do robô, ruído com mesma forma, progresso → atenção → FFN de ação e cabeça de fluxo | Campo de velocidade T × d; a integração fornece uma trajetória com a mesma forma. |
Formalização ilustrativa de roteamento estático, não um algoritmo adicional do artigo:
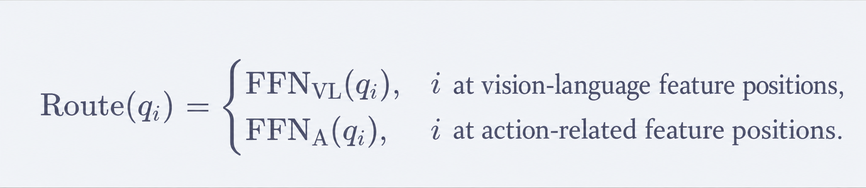
qᵢ é o recurso pós-atenção na posição i, de largura D. Ambos os ramos precisam de representações posteriores compatíveis, mas larguras/projeções não são relatadas. i é um índice de sequência e D uma contagem de recursos sem unidade. Diferente de um gating aprendido com softmax/top-k, o ramo é escolhido pela categoria de recurso, não por uma probabilidade de expert recém-estimada.
Exemplo mínimo: Em [image, image, instruction, action, action], roteie as três primeiras posições para o VL FFN e as duas últimas para o FFN de ação, enquanto a atenção compartilhada ainda as conecta. Isso não preenche a codificação de estado ou roteamento não especificados.
Limite de dimensão: Um bloco ilustrativo com T=3, d=2 contém seis valores, ou forma 4 × 3 × 2 para B=4. Essas contagens não são frequências. O (a₁,…,a₂₀) da Figura 3 é esquemático, não confirmação de um horizonte universal de 20 passos. Interfaces completas de ação, largura de padding e total de parâmetros não são especificados; “3B” nomeia o backbone, não o modelo inteiro.
Inspiração: Ações discretas e QA incorporado
Problema: O VLM carece de conhecimento robô–cenário e de correspondências texto–trajetória. Intuição: Usar predição de sequência familiar tanto para QA incorporado quanto para códigos de demonstração discretos, criando uma interface de aprendizado comum.
Equações da página 5, com símbolos renomeados para evitar colisões:
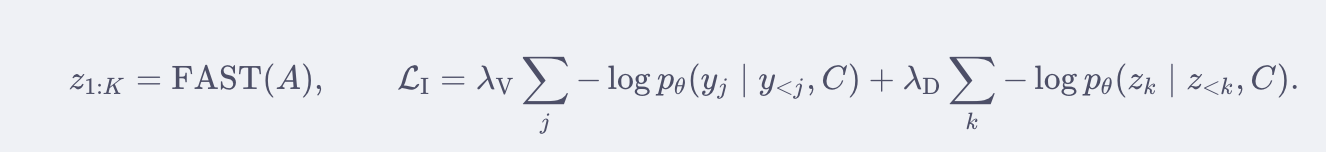
A∈ℝᵀˣᵈ é a trajetória demonstrada; C=(V,L) contém visão e instrução. yⱼ é o token de texto j, zₖ o token de ação k, e <j/<k os prefixos existentes. θ parametriza o caminho VL; pθ é a probabilidade do próximo token. λᵥ e λᴅ são pesos sem unidade. K é o comprimento codificado, não um valor fixo relatado.
FAST é um método eficiente de tokenização de ações. O diagrama mostra transformada cosseno discreta (DCT) → quantização → byte-pair encoding (BPE). Explicação: Transformar trajetórias do domínio do tempo para coeficientes de frequência, depois quantizá-los e compactá-los em tokens; isso não simplesmente atribui uma palavra a cada ângulo de junta. O artigo não relata a configuração do FAST, a precisão de quantização ou o tamanho do vocabulário, portanto padrões de outros artigos não devem ser inseridos.
Exemplo mínimo: Se tokens corretos de texto/ação recebem probabilidades 0.8 e 0.5, com pesos unitários, sua perda é −ln(0.8)−ln(0.5)≈0.916. Isso recompensa sequências corretas em vez de medir diretamente o erro de posicionamento.
Sequências de QA e FAST ground-truth supervisionam o caminho VLM reutilizado, que pode produzir raciocínio, subtarefas e ações discretas neste estágio. A supervisão discreta constrói priors; a implantação final passa para geração contínua e não necessariamente prevê tokens FAST primeiro.
Cuidado: O texto menciona modelagem mascarada, aprendizado contrastivo de imagem/vídeo, seguimento de instruções e modelagem temporal/causal, mas sua equação mostra explicitamente apenas termos de texto e ação discreta. Outras perdas, pesos e cronogramas não são totalmente especificados.
Integração: gerar ações contínuas a partir de ruído
Problema: Priors discretos alinham semântica, mas a execução precisa de valores contínuos. Intuição: Aprender uma direção ao longo de um caminho de ruidificação de ações e então integrar de volta a partir do ruído. Isso é flow matching.
Equações da página 5, renomeando o progresso τ enquanto preserva a direção:
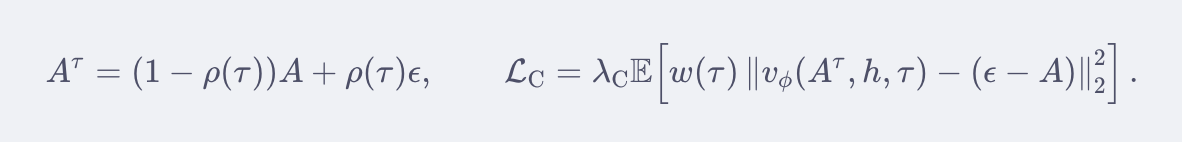
A é a ação limpa, ε ruído Gaussiano com a mesma forma, e A^τ o array ruidoso T × d. h é a codificação VL, φ parâmetros do caminho contínuo, e vφ o campo. τ é o progresso de geração sem unidade, ρ o cronograma, w uma função de ponderação, e λᴄ o peso da perda. As esperanças cobrem dados, ruído e tempo. A “velocidade” do campo é direção no espaço de geração, não automaticamente velocidade de motor.
Exemplo mínimo: Em unidades normalizadas, A=0.6, ε=−0.2, e uma ρ(τ)=τ linear ilustrativa em τ=0.5 dão A^τ=0.2 e alvo ε−A=−0.8. Prever −0.7 dá erro quadrático 0.01 com pesos unitários. Unidades físicas exigem as regras de decodificação do dataset.
A direção importa: Neste exemplo linear, τ=0 é limpo e τ=1 é ruído. Gere integrando de 1 em direção a zero, não executando a direção de ruidificação no robô.
Atualização reversa de Euler ilustrativa, não um resolvedor especificado no artigo:
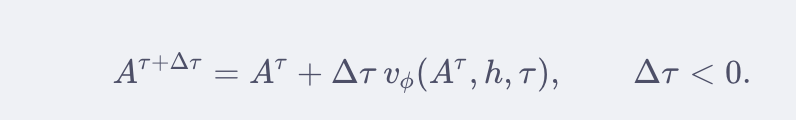
Δτ é sem unidade. Começando em 0.2 com direção −0.8 e Δτ=−0.1 resulta em 0.28, mais próximo de 0.6. O array completo é atualizado junto; uma atualização interna não é um passo de robô.
Cuidado: Uma ρ não linear geral introduziria ρ′(τ) na derivada do caminho, enquanto o artigo escreve diretamente ε−A. O exemplo é restrito a um caminho linear; nenhum cronograma, distribuição de tempo, resolvedor ou contagem de iterações não publicado é inferido. A equação também abrevia o estado do robô da Figura 3, o que não significa que o estado esteja ausente.
Duas etapas principais, com duas fases de integração
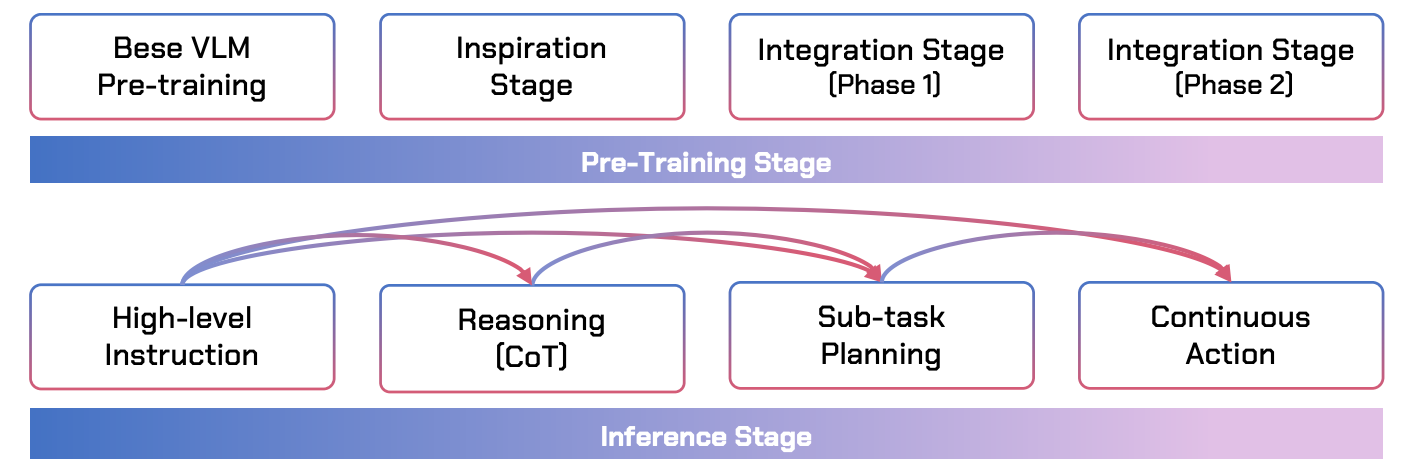
Artigo: Após o pré-treinamento VLM existente, WALL-OSS usa Inspiração e Integração. A Integração tem fases de congelamento e descongelamento; o pré-treinamento original do backbone não é uma terceira etapa recém-projetada.
| Etapa | Supervisão/saída | Atualizações | Objetivo |
|---|---|---|---|
| Inspiração | VQA incorporado, texto/subtarefas/CoT, tokens FAST | Reutilizar/treinar o caminho VLM; detalhes completos de congelamento não especificados. | Compreensão robô–cenário e semântica de ações. |
| Fase 1 de integração | Flow matching contínuo | Congelar VLM e treinar caminho de ação contínua/cabeça de fluxo; limites exatos não especificados. | Permitir que o novo ramo use priors estabelecidos. |
| Fase 2 de integração | Flow matching contínuo e otimização conjunta | Descongelar VLM; atualizar θ e φ. | Alinhar ainda mais visão, linguagem e ações. |
Exemplo: O erro de ação da fase 1 atualiza apenas o ramo contínuo; na fase 2 ele também pode atualizar o backbone. Congelar não é isolamento permanente, e descongelar não descarta o aprendizado prévio.
As etapas mudam representação, objetivo e parâmetros treináveis em vez de emendar modelos de robô independentes. A Seção 4 descreve mistura de fontes e cotas; a Seção 5 relata misturas de ação/VQA downstream. A v1 não fornece receitas, passos ou pesos de objetivo completos, portanto a Figura 4 sozinha não pode reproduzir o treinamento.
Uni-CoT: raciocínio completo ou execução direta
Problema: Imagens semelhantes podem representar progressos diferentes, enquanto planejadores separados podem se desconectar do controle. Intuição: Aprender relações entre níveis em um único modelo e incluir amostras sem raciocínio intermediário, suportando tanto comportamento complexo quanto direto.
Objetivo da página 6, com símbolos renomeados para evitar colisões de ruído:
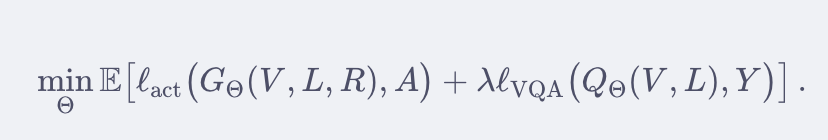
Θ contém parâmetros de modelo unificado; G prediz ações e Q respostas incorporadas. V é visão, L instrução, R raciocínio opcional, A∈ℝᵀˣᵈ ações alvo, Y rótulos de QA, e λ um equilíbrio sem unidade. A perda de ação segue o objetivo da etapa; a perda de VQA avalia respostas. O condicionamento interno de ruído/tempo de G é abstraído aqui.
Os autores chamam isso de path-drop: treinar ambos os caminhos completos com raciocínio e caminhos diretos sem R. Exemplo: uma amostra “spell FIVE” inclui “F e I estão presentes, V em seguida”; outra fornece apenas imagens e a tarefa. Perda de ação 0,2 mais perda de QA 0,4 ponderadas por λ=0,5 resulta em 0,4. Taxa de descarte, algoritmo de amostragem e regras de seleção na inferência não são relatados.
O fine-tuning de longo horizonte gera subtarefas antes das ações; tarefas de cor-palavra e soletração também usam CoT. O artigo descreve interleaving, mas não o tempo completo de chamadas de inferência, agendamento assíncrono ou custos. Raciocínio opcional não estabelece um classificador de dificuldade publicado.
Cuidado: Treinamento compartilhado de ponta a ponta é uma afirmação arquitetural. A perda combinada não mostra como os gradientes de ação passam por texto discreto amostrado, portanto não prova diferenciação através de cada palavra gerada. Ela estabelece aprendizado compartilhado multiobjetivo, não todos os detalhes de gradiente.
Treinamento e Inferência Completos
Training:
  Images + instructions + QA/process labels → VL path → text, reasoning, subtask supervision
  Inspiration: demonstrations → FAST → discrete next-token loss
  Integration: actions + noise + progress → noisy actions
               VL context + state + noisy actions → continuous path → field loss
               freeze VLM first, then unfreeze for joint updates
  Uni-CoT: learn cross-level mappings with and without intermediate reasoning

Inference:
  Current images + task → VL representation
  Generate or skip CoT/subtasks according to the task path; use generated text as context
  VL context + state + fresh noise → continuous field → integration → trajectory
  Decode to the platform interface and execute; later observations condition the next decision
Explicação: A arquitetura conecta informações; a etapa discreta estabelece priors; a etapa contínua gera valores; Uni-CoT conecta objetivos e progresso. Comprimentos de execução e mistura de sobreposição não são especificados. ACT temporal ensembling e CVAEs não devem ser adicionados ao mecanismo do WALL-OSS.
Dados e Plataformas: Compreensão e Execução
Três Fontes
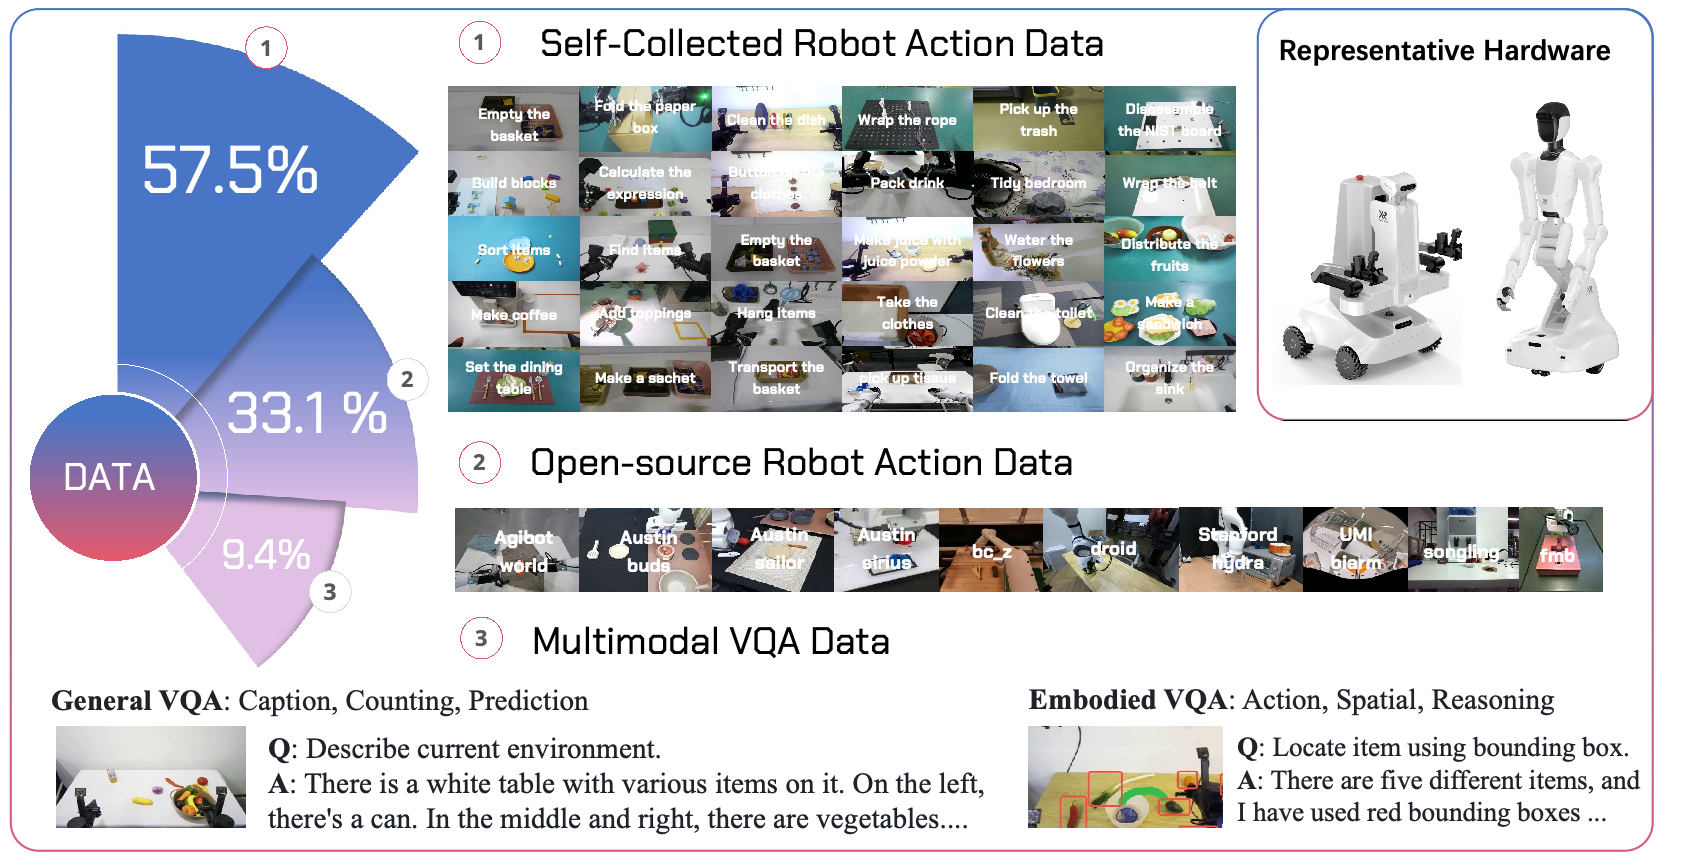
| Fonte | Participação na Figura 5 | Conteúdo e papel |
|---|---|---|
| Ações internas do robô | 57,5% | Manipulação cotidiana, trajetórias complexas e rótulos de processo, incluindo cozinha, roupas/armazenamento, coleta e colocação móvel e montagem. |
| Ações abertas de robô | 33,1% | DROID, BC-Z, BridgeData V2 e outros; plataformas, cenas e estilos variados. Lista completa na Tabela 1. |
| VQA multimodal | 9,4% | QA geral preserva habilidades de imagem-texto; QA incorporado adiciona espaço, tempo, progresso e affordances. |
Cuidado: As participações somam 100%, mas seu denominador—horas, amostras ou pesos de mistura—não é claro, portanto horas não são inferidas. A Seção 4 primeiro diz mais de 10.000 horas, enquanto 4.4 diz mais de dezenas de milhares. A v1 não fornece uma decomposição unificada para resolver isso.
Os dados internos incluem tarefas curtas de instrução explícita enfatizando precisão/generalização e tarefas longas com etapas implícitas que exigem decomposição e acompanhamento de progresso. A anotação combina modelos e verificações humanas. Controles de qualidade incluem timestamps sincronizados, filtragem de outliers/ociosos/baixa qualidade, revisão por regras/manual e aumento de iluminação/fundo.
VQA incorporado cobre planejamento, raciocínio espacial/temporal, atributos, cognição e affordances. Os rótulos incluem caixas, pontos, máscaras opcionais e QA em linguagem natural. <point>[x,y]</point> é uma localização 2D na imagem, não um alvo de preensão 3D; a normalização de coordenadas não é especificada de forma uniforme.
Alinhamento Entre Plataformas e Detalhes Ausentes
Artigo: As fontes incluem braços de mesa, montagens móveis, robôs bímanos com rodas e humanoides com visões ego/externa/braço. Posições usam metros e ângulos em radianos. Um template de DoF máximo com máscaras/placeholders lida com juntas ausentes, enquanto calibração de câmera, timestamps, canais e grades de ação são alinhados.
Explicação: Uma interface comum não torna os DoF idênticos nem torna políticas intercambiáveis sem adaptação. Preenchimento não deve ser executado como controles físicos.
A v1 não relata modelos completos de plataforma, contagens/resoluções de câmeras, taxas de controle/coleta, dimensões unificadas, durações de tarefas, configurações de GPU, tamanho de batch, taxas de aprendizado ou etapas de cada estágio. Fotos de hardware não podem fornecer essas especificações.
Os autores descrevem divisões estratificadas de validação/teste por cena, objeto, tarefa e embodiment, com superamostragem de habilidades longas/raras e misturas por cotas. Contagens completas, temperaturas de amostragem e deduplicação não são publicadas, limitando a reprodução exata.
Experimentos: Compreensão, Raciocínio e Ações
Tarefas, Fine-Tuning e Condições de Avaliação
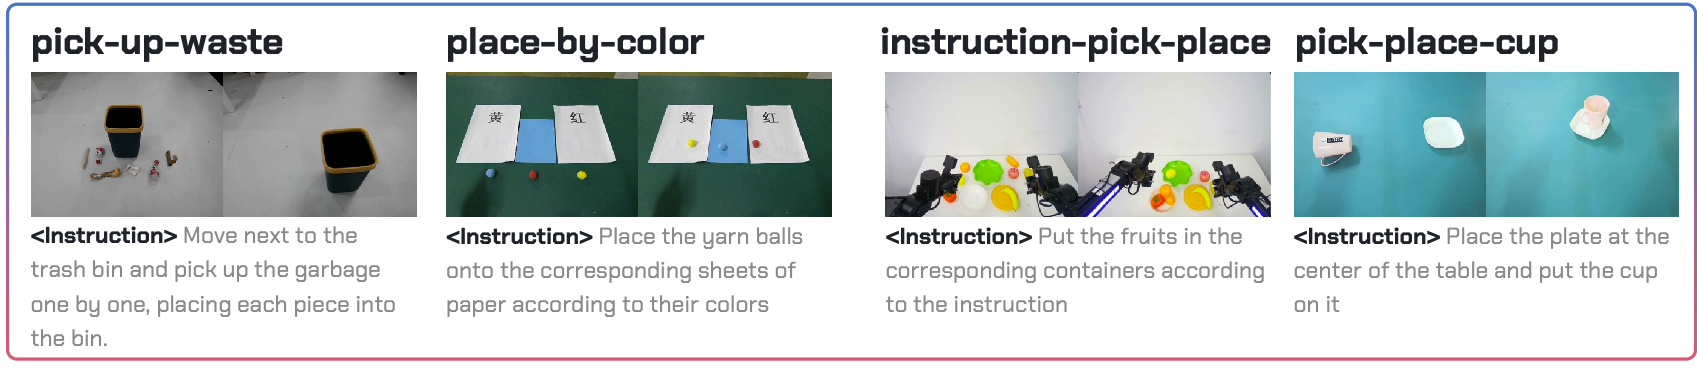
| Tarefa | Teste principal | Demonstrações em 5.1.1 | Fronteira de pré-treinamento / fine-tuning |
|---|---|---|---|
| Instruction-Pick-Place | Selecionar objeto e destino a partir da linguagem. | Sem fine-tuning de tarefa | Avaliação de tarefa zero-shot após pré-treinamento do robô. |
| Place-by-Color | Correspondência direta de cor ou palavra de cor. | 500 episódios | Declarado ausente do pré-treinamento. |
| Block-Spell | Reconhecer/calcular uma palavra e posicionar letras. | 1.600 episódios | Fine-tuning de tarefa, não soletração zero-shot. |
| Set-Table | Arrumar pratos, facas e garfos para duas pessoas. | 1.500 episódios | Declarado ausente do pré-treinamento, depois ajustado por fine-tuning. |
| Tidy-Bedroom | Coletar roupas e arrumar travesseiros. | 1.000 episódios | Declarado ausente do pré-treinamento, depois ajustado por fine-tuning. |
| Collect-Waste | Ir até uma lixeira, pegar e descartar lixo. | 900 episódios | A seção de resultados em vez disso diz 1.000 demonstrações. |
| Pick-Place-Cup | Ajustar configurações de copo/prato e posicioná-los. | 500 episódios | Copos invertidos, direções de alça e variação de posição de prato. |
Cuidado: A Seção 5.1 fala em seis tarefas de manipulação, enquanto 5.1.1 e a Figura 6 listam sete. A Figura 7 resume seis tarefas com fine-tuning; o acompanhamento de instruções zero-shot é separado no texto. Não visto no pré-treinamento não é não visto no fine-tuning, e contagens conflitantes de lixo permanecem sem solução.
Os baselines são π0 e Diffusion Policy (DP). O treinamento plano mapeia instruções de alto nível diretamente para ações; GPT4-Subtask treina com subtarefas anotadas e chama o GPT-4 na inferência. O progresso do Flat Block-Spell é quase zero, então a Figura 7 usa seus baselines GPT-subtask. As barras não compartilham todas configurações de instrução idênticas.
Os autores descrevem supervisão de tarefa igual, mas o WALL-OSS co-treina adicionalmente VQA: amostragem de QA sem subtarefa é escrita 1:15 e de subtarefas 1:100. Unidades e ordem das razões são insuficientemente explicadas para inferir proporções de quadros. Supervisão de tarefa igual não implica dados ou computação gerais idênticos.
Uma terceira parte independente avalia às cegas usando documentos de ambiente, estado inicial e pontuação; VQA é julgada manualmente. Contagens de tentativas, regras completas de pontuação, barras de erro e intervalos de confiança não são totalmente publicados. Testes cegos reduzem viés, mas não substituem estatísticas.
VQA Incorporado: Maiores Ganhos em Grounding
Tabela 2, página 11:
| Categoria | Qwen2.5-VL-3B | WALL-OSS | Ganho em pontos percentuais |
|---|---|---|---|
| Object grounding | 46,1% | 91,6% | +45,5 |
| Scene captioning | 57,7% | 87,6% | +29,9 |
| Action planning | 59,8% | 69,0% | +9,2 |
Interpretação: As maiores melhorias estão em localizar objetos e descrever cenas de robô. O planejamento melhora menos; ambos os modelos podem avaliar mal o progresso. A tabela apoia a compreensão incorporada, não a retenção completa de QA geral ou 91,6% de sucesso de preensão.
Instruções Zero-Shot: Progresso Não É Taxa de Sucesso
Páginas 11–12: Sem fine-tuning de tarefa, Instruction-Pick-Place tem média de 85% de progresso para instruções de objetos/recipientes vistos e 61% para novos objetos. Os autores atribuem muitas falhas a pequenos erros de pose em vez de selecionar o alvo semântico errado.
Cuidado: Zero-shot exclui fine-tuning específico de tarefa, não pré-treinamento de robô/multimodal. Estes são escores médios de progresso, não frações de sucesso completo. A Figura 7 não mostra esses dois grupos separadamente, apesar da citação no texto, portanto os números são atribuídos à prosa.
Precisão e Longos Horizontes: Ganhos Dependentes da Tarefa
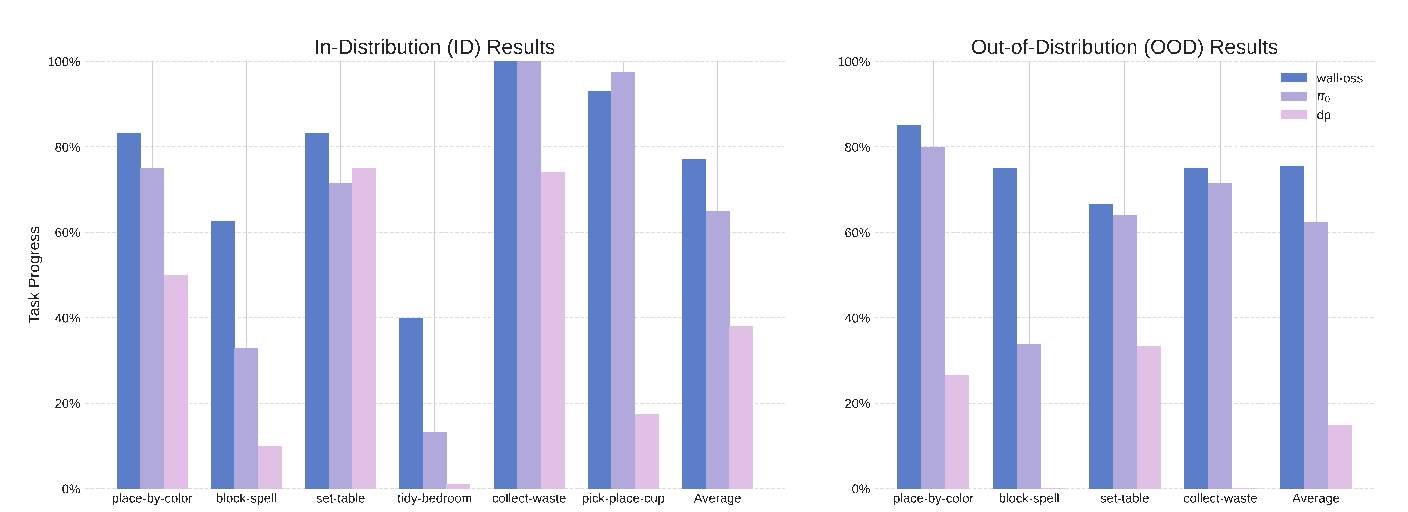
Interpretação da figura: WALL-OSS lidera os baselines mostrados em soletração, arrumação de mesa e organização de quarto. Sua barra de lixo ID e π0 ambas alcançam o topo, enquanto π0 é maior na colocação de copos. Valores exatos das barras não são impressos e não são inferidos visualmente.
Relatos de taxa de sucesso na página 12: A coleta de lixo ID é 100% para WALL-OSS e π0, 80% para DP; a colocação de copos excede 90% para ambos os modelos pré-treinados e fica abaixo de 20% para DP. Em uma nova cena de lixo, relata-se que o DP cai de 80% para zero, enquanto ambos os modelos pré-treinados permanecem acima de 80%.
Cuidado: Taxas de sucesso em prosa e progresso de tarefa na Figura 7 são rotulados de forma diferente e não são diretamente intercambiáveis. O progresso de lixo ID do DP e o progresso de lixo OOD do WALL-OSS parecem aproximadamente três quartos na figura. A v1 não explica a relação, portanto nenhuma média combinada de sucesso é inferida.
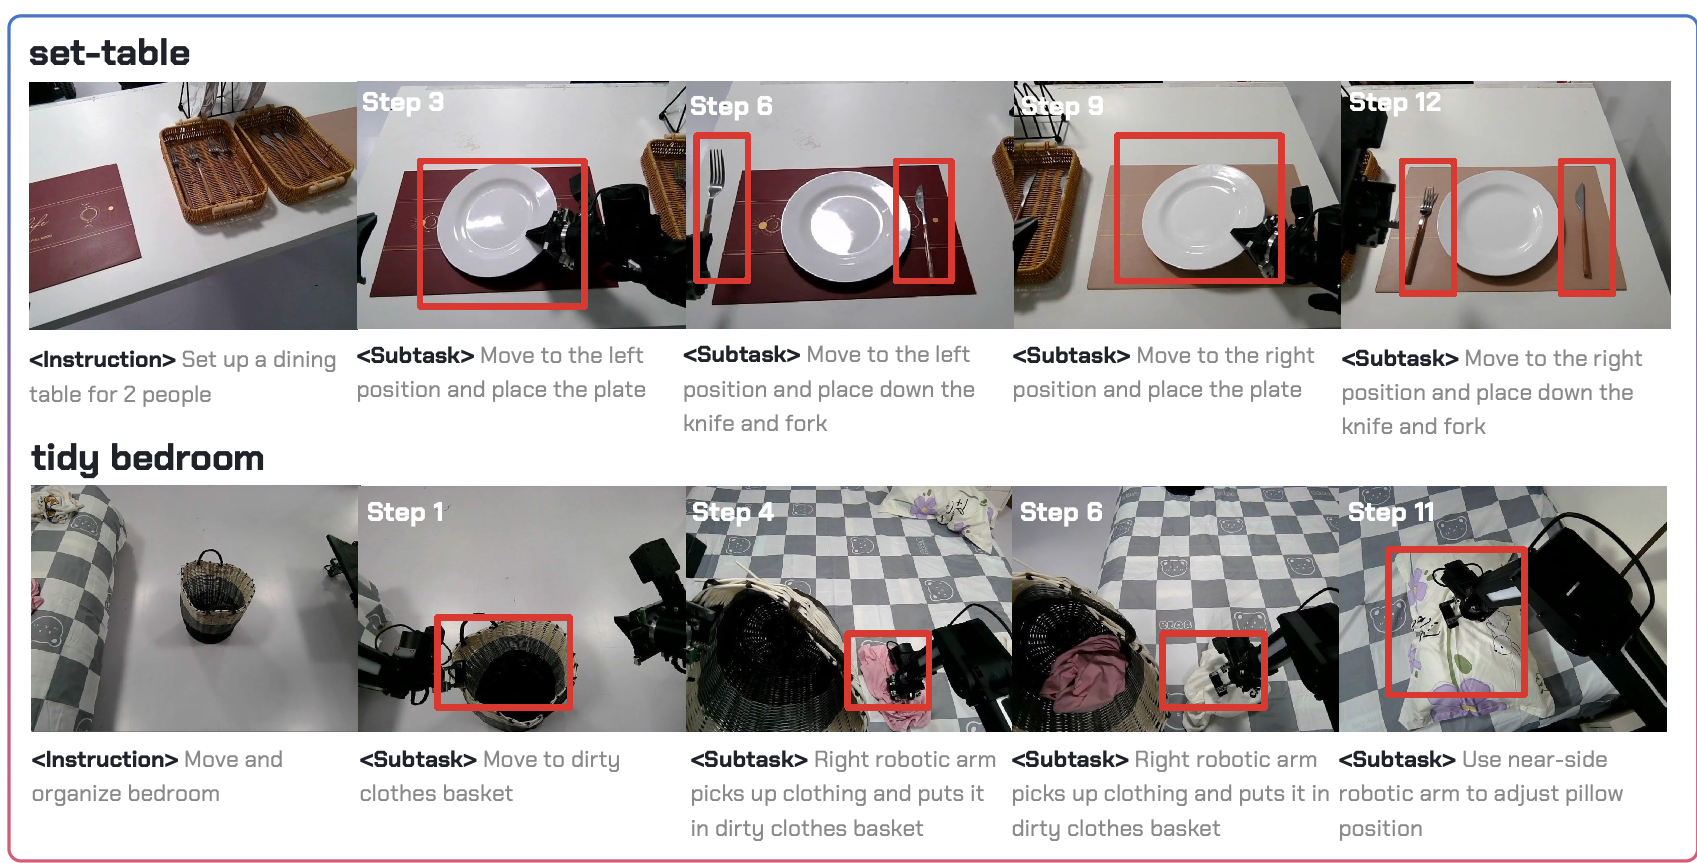
Artigo: Arrumar a mesa e organizar o quarto excedem cinco estágios, com durações médias acima de três e cinco minutos. O fine-tuning combina ações/subtarefas, com apenas 1% dos dados de treinamento de tarefas longas rotulados por subtarefa; na inferência, subtarefas são geradas antes de agir. As linhas de base repetem talheres, deixam de arrumar a outra parte da mesa ou entram em loop quando as roupas saem do campo de visão.
Interpretação: Essas observações apoiam progresso explícito e subtarefas. Três/cinco minutos são durações de tarefa, não latência de inferência. Modelos pré-treinados superando DP apoiam o pré-treinamento neste cenário, mas inicialização, tamanho e arquitetura também diferem.
Raciocínio e Co-Treinamento: Instruções em Nível Fino
CoT adiciona pouco para correspondência direta de cores visuais, mas ajuda ao colocar uma bola sobre um papel contendo uma palavra de cor. Block-Spell primeiro reconhece ou calcula uma resposta, depois posiciona as letras. A página 13 diz que 1% dos quadros de treinamento supervisionam CoT/subinstruções; isso difere em unidade do “1% dos dados de treinamento” de tarefas longas e não é reescrito como 1% dos episódios.
Tabela 3, página 14: acurácia ao selecionar o bloco de letra/número instruído.
| Tipo de bloco | Co-treinamento multimodal WALL-OSS | WALL-OSS apenas ação | π0 apenas ação |
|---|---|---|---|
| Letras | 87% | 26% | 9% |
| Números | 95% | 80% | 35% |
O fine-tuning multimodal combina ações, CoT/subtarefas e grounding 2D. O WALL-OSS apenas ação treina controles a partir de subtarefas. Isso altera o fine-tuning a jusante; não remove todo o pré-treinamento multimodal.
Interpretação: Dentro do WALL-OSS, a acurácia em letras ganha 87−26=61 pontos e a acurácia em números 95−80=15, apoiando a supervisão multimodal contínua para alvos precisos. Múltiplos objetivos mudam juntos, então grounding, CoT e subtarefas não são isolados individualmente. A medida é acurácia de seleção de alvo, não sucesso de soletração de palavra inteira.
Conclusões e Limites
Lição principal: Em vez de anexar uma cabeça de ação como algo secundário, adicione entendimento incorporado, construa priors semânticos por meio de treinamento de discreto para contínuo e conecte objetivos, raciocínio, progresso e execução em um único modelo. Grounding e seleção de alvos finos têm suporte quantitativo claro; raciocínio e tarefas longas também melhoram em relação às linhas de base comparadas.
Mantenha estes limites:
-
Nem sempre o melhor em precisão. A Seção 6.1 reconhece que π0 continua melhor em manipulação fina; afirmações gerais não devem se tornar primeiro lugar em toda métrica.
-
Nem todo componente é isolado. A Tabela 3 apoia o efeito combinado do fine-tuning multimodal, mas a v1 não possui ablações independentes completas para Inspiration, roteamento estático e path-drop.
-
Estatísticas e detalhes de reprodução limitados. Contagens de tarefas, durações, contagens de demonstrações e métricas variam; contagens de tentativas e intervalos de confiança são incompletos. Essas discrepâncias são identificadas em vez de simplesmente ignoradas.
-
Tempo real e transferência ampla precisam de validação. Assincronia e treinamento multiplataforma são descritos sem latência, taxa, interfaces ou testes de transferência completos, portanto temporização específica de hardware e transferência sem adaptação não são garantidas.
-
3D e vídeo permanecem direções futuras. Quadros previstos, percepção 3D e modelagem de mundo são propostos, não demonstrados como componentes atuais do WALL-OSS ou como solução para IA Física geral.
Nenhuma configuração de transferência específica de produto é adicionada. Outro robô precisa de sua própria interface de câmera/estado, unidades, dimensões, ciclo de controle e configuração de execução segura, separada dos resultados do artigo.