27. Visão Robótica e Percepção 3D
Capítulo 27 do Curso para Iniciantes em IA Física da Seeed — como um robô transforma pixels em 3D: o pipeline de visão robótica, sensoriamento RGB-D, mapas de profundidade, câmeras de profundidade estéreo / luz estruturada / TOF, o modelo de câmera pinhole com parâmetros intrínsecos e extrínsecos, conversão de pixel para 3D e nuvens de pontos.
Hardware necessário para este estágio
O que preparar para este estágio. A lista completa para cada estágio está no Capítulo 3.
Unidade de controle principal
| Item | Comprar | Qtde |
|---|---|---|
| reComputer Robotics J4012 | 🛒 | 1 |
| NVIDIA Jetson AGX Thor 128G | 🛒 | 1 |
Também é necessário um desktop ou laptop: Ubuntu 22.04, GTX 4080 ou superior com 12GB+ de VRAM, 16GB+ de RAM.
Para este estágio
| Item | Comprar | Qtde |
|---|---|---|
| reBot Arm B601 DM/RS | 🛒 | 1 |
| Realsense 435i ou Orbbec Gemini2 Depth Camera ou Realsense 405 Stereo Camera | 🛒 | 1 |
| Suporte de Câmera para o Pulso | 🛒 | 1 |
27.1 Visão Geral do Capítulo
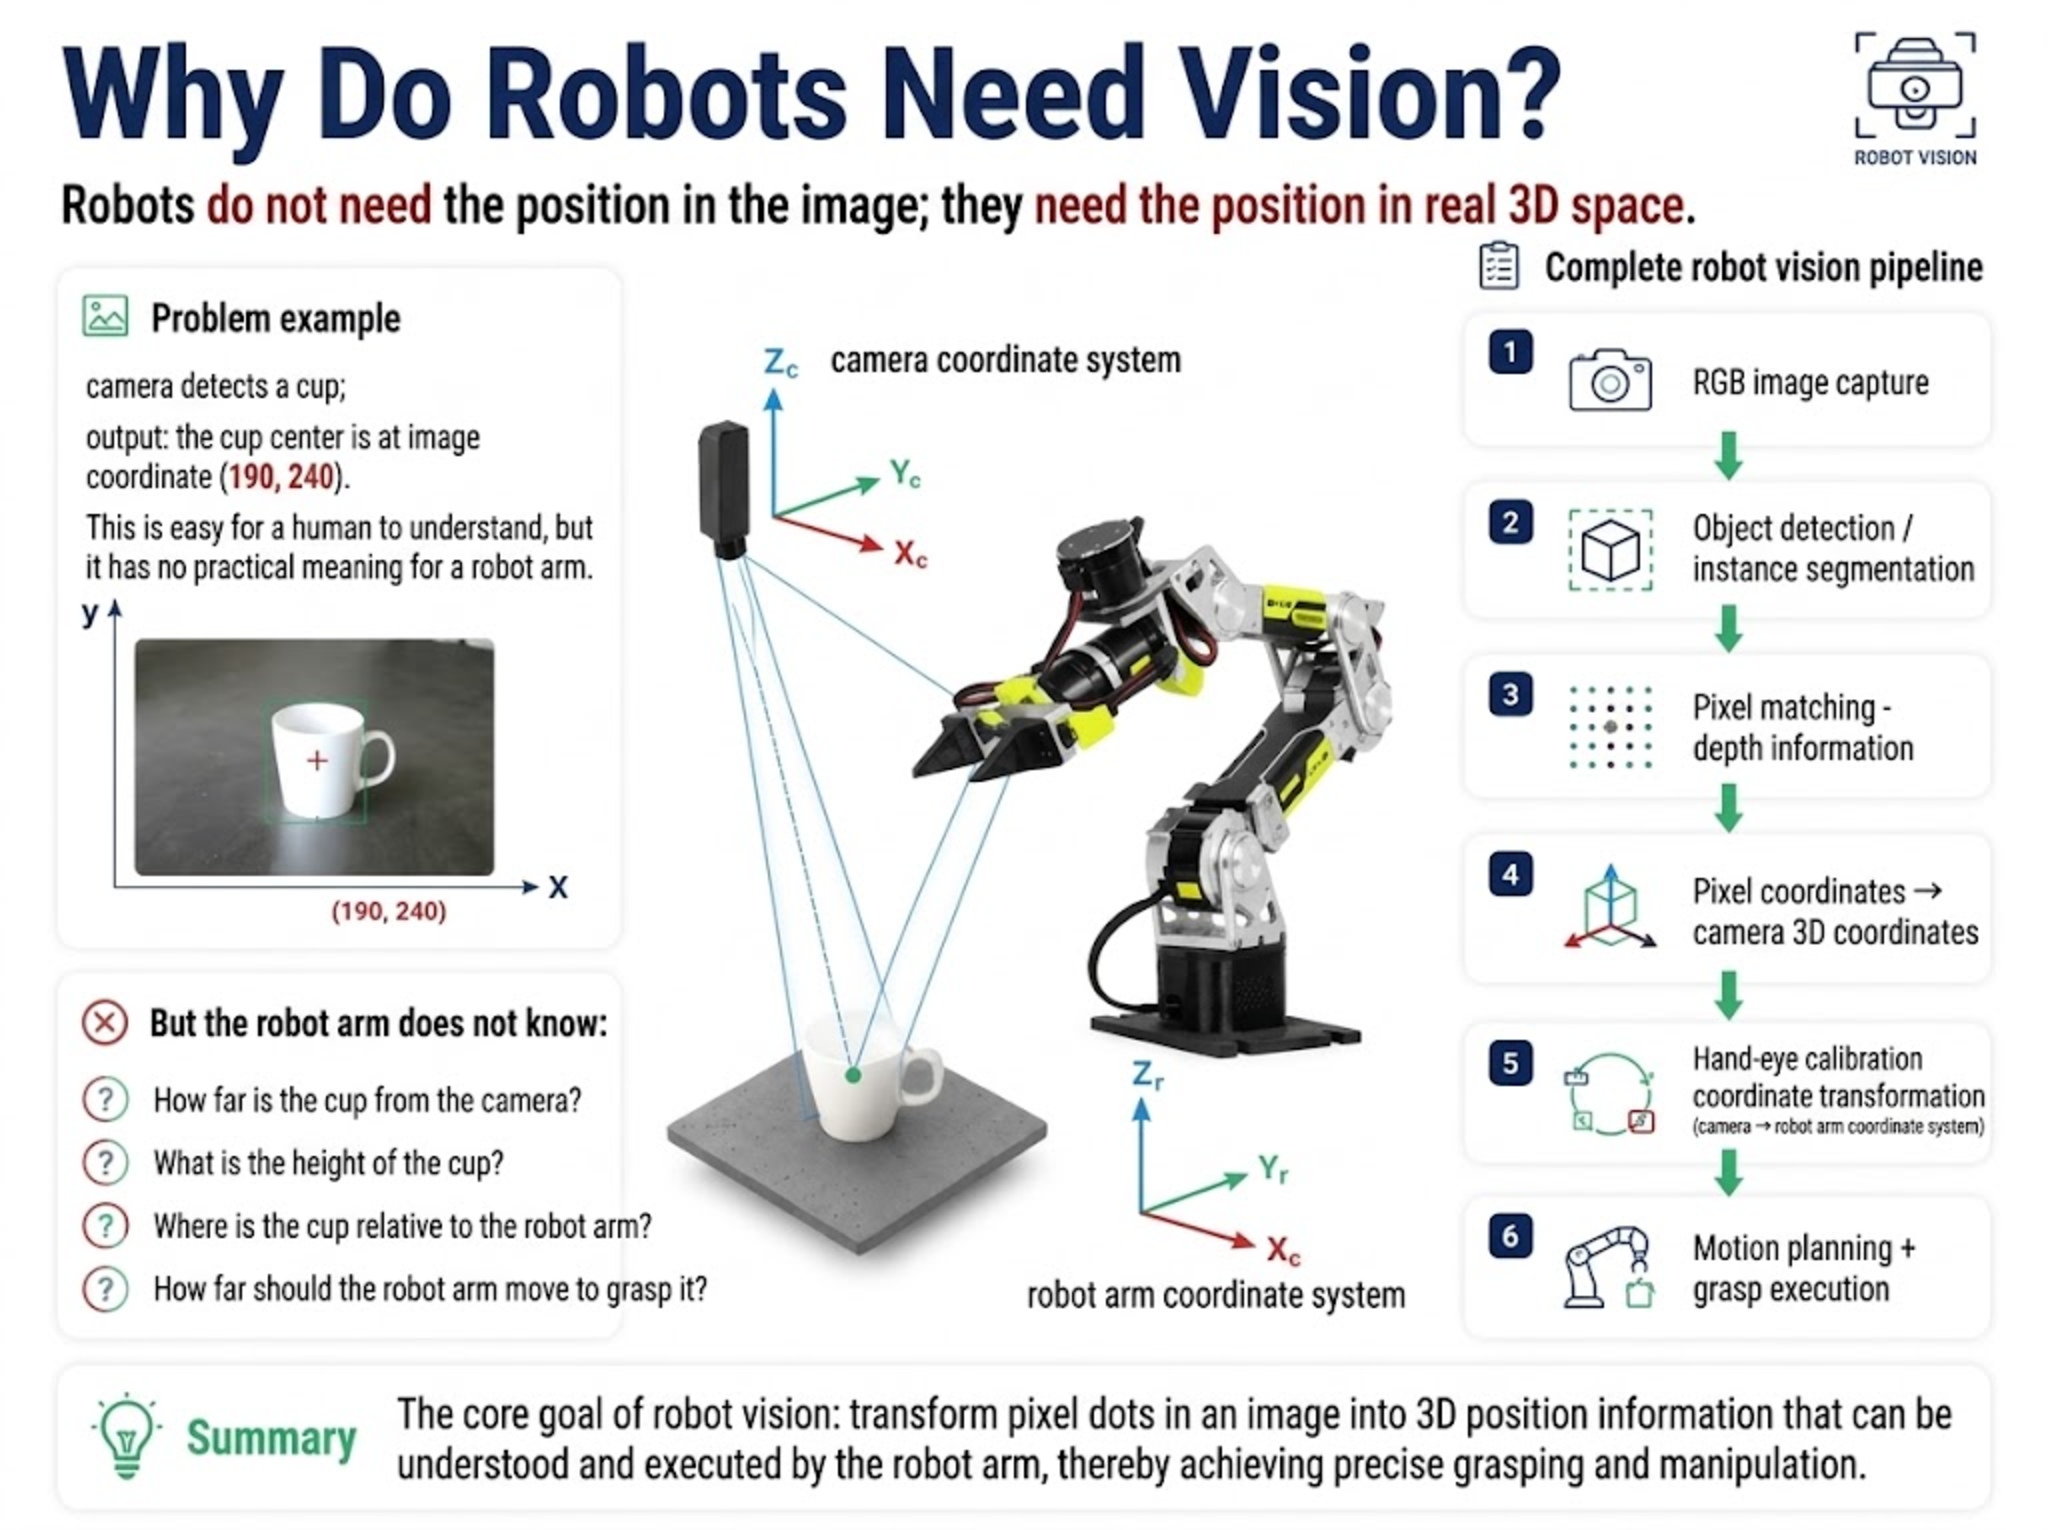
A visão robótica é uma forma fundamental de os robôs perceberem o ambiente externo. Para um braço robótico, apenas saber "onde o objeto está na imagem" não é suficiente; o que o robô realmente precisa é da posição do objeto no espaço tridimensional real.
Por exemplo: a câmera detecta um copo e fornece como saída: o centro do copo está nas coordenadas de imagem (190, 240). Isso é fácil para um humano entender, mas não tem significado real para o braço robótico.
Porque o braço não sabe:
- A que distância o copo está da câmera;
- A que altura o copo está;
- Onde o copo está em relação ao braço;
- Quanto o braço deve se mover para agarrá-lo.
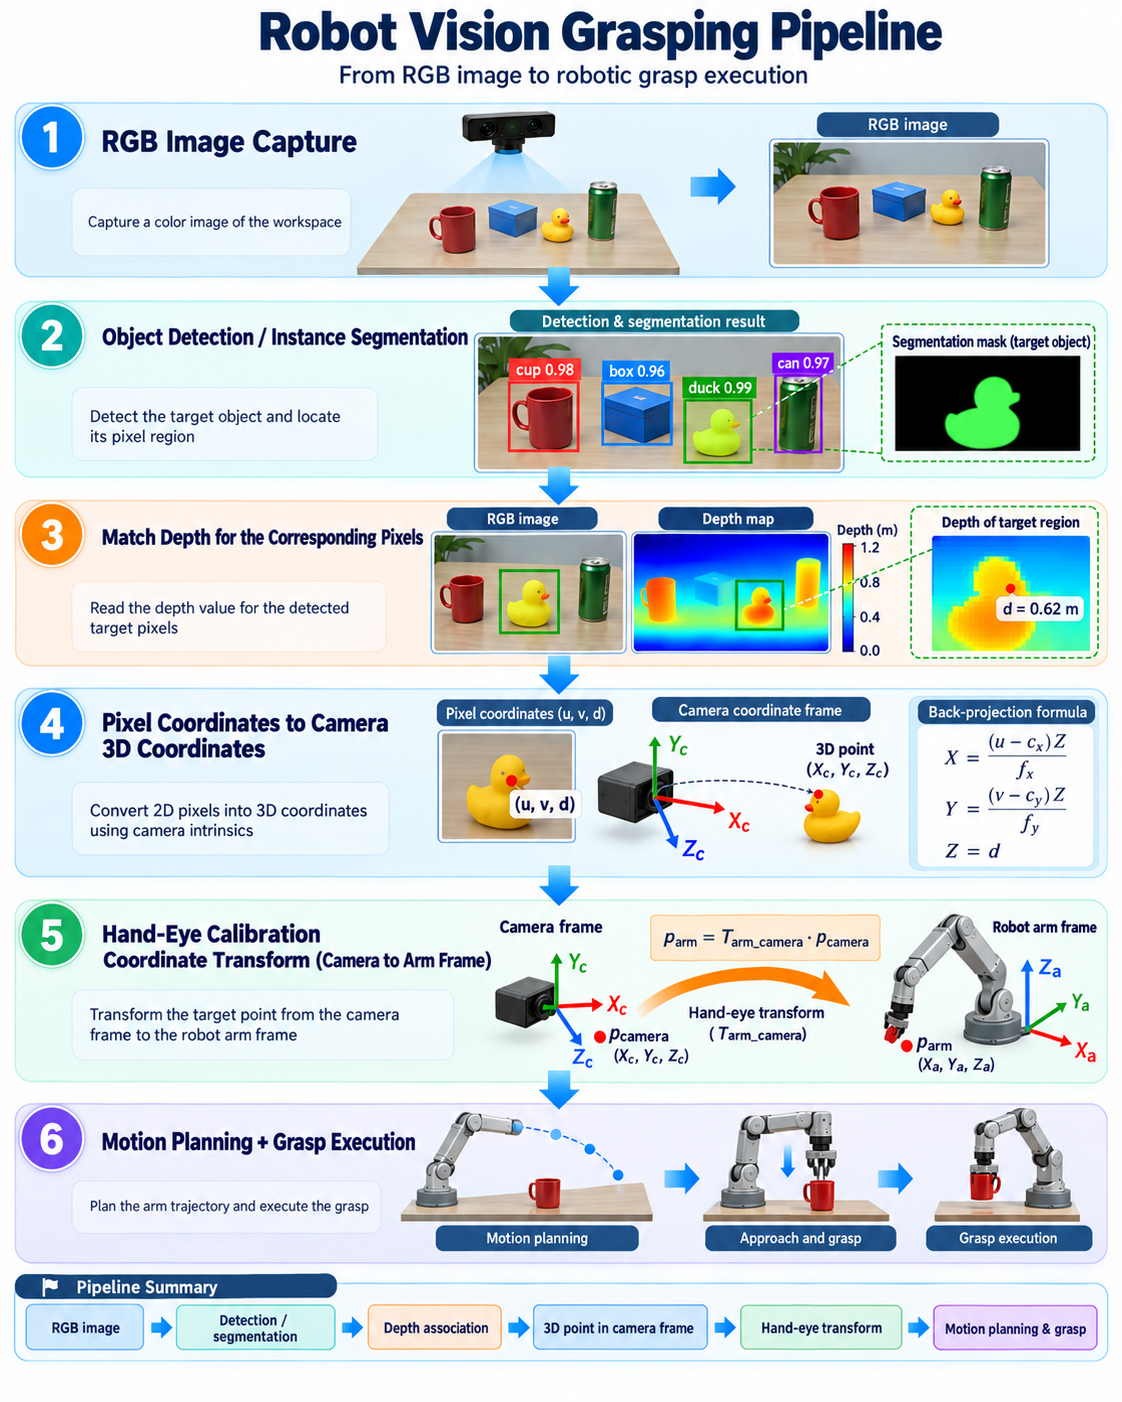
Portanto, a visão robótica deve completar um processo completo:
27.2 Introdução a Sistemas de Visão Robótica
O que é Visão Robótica
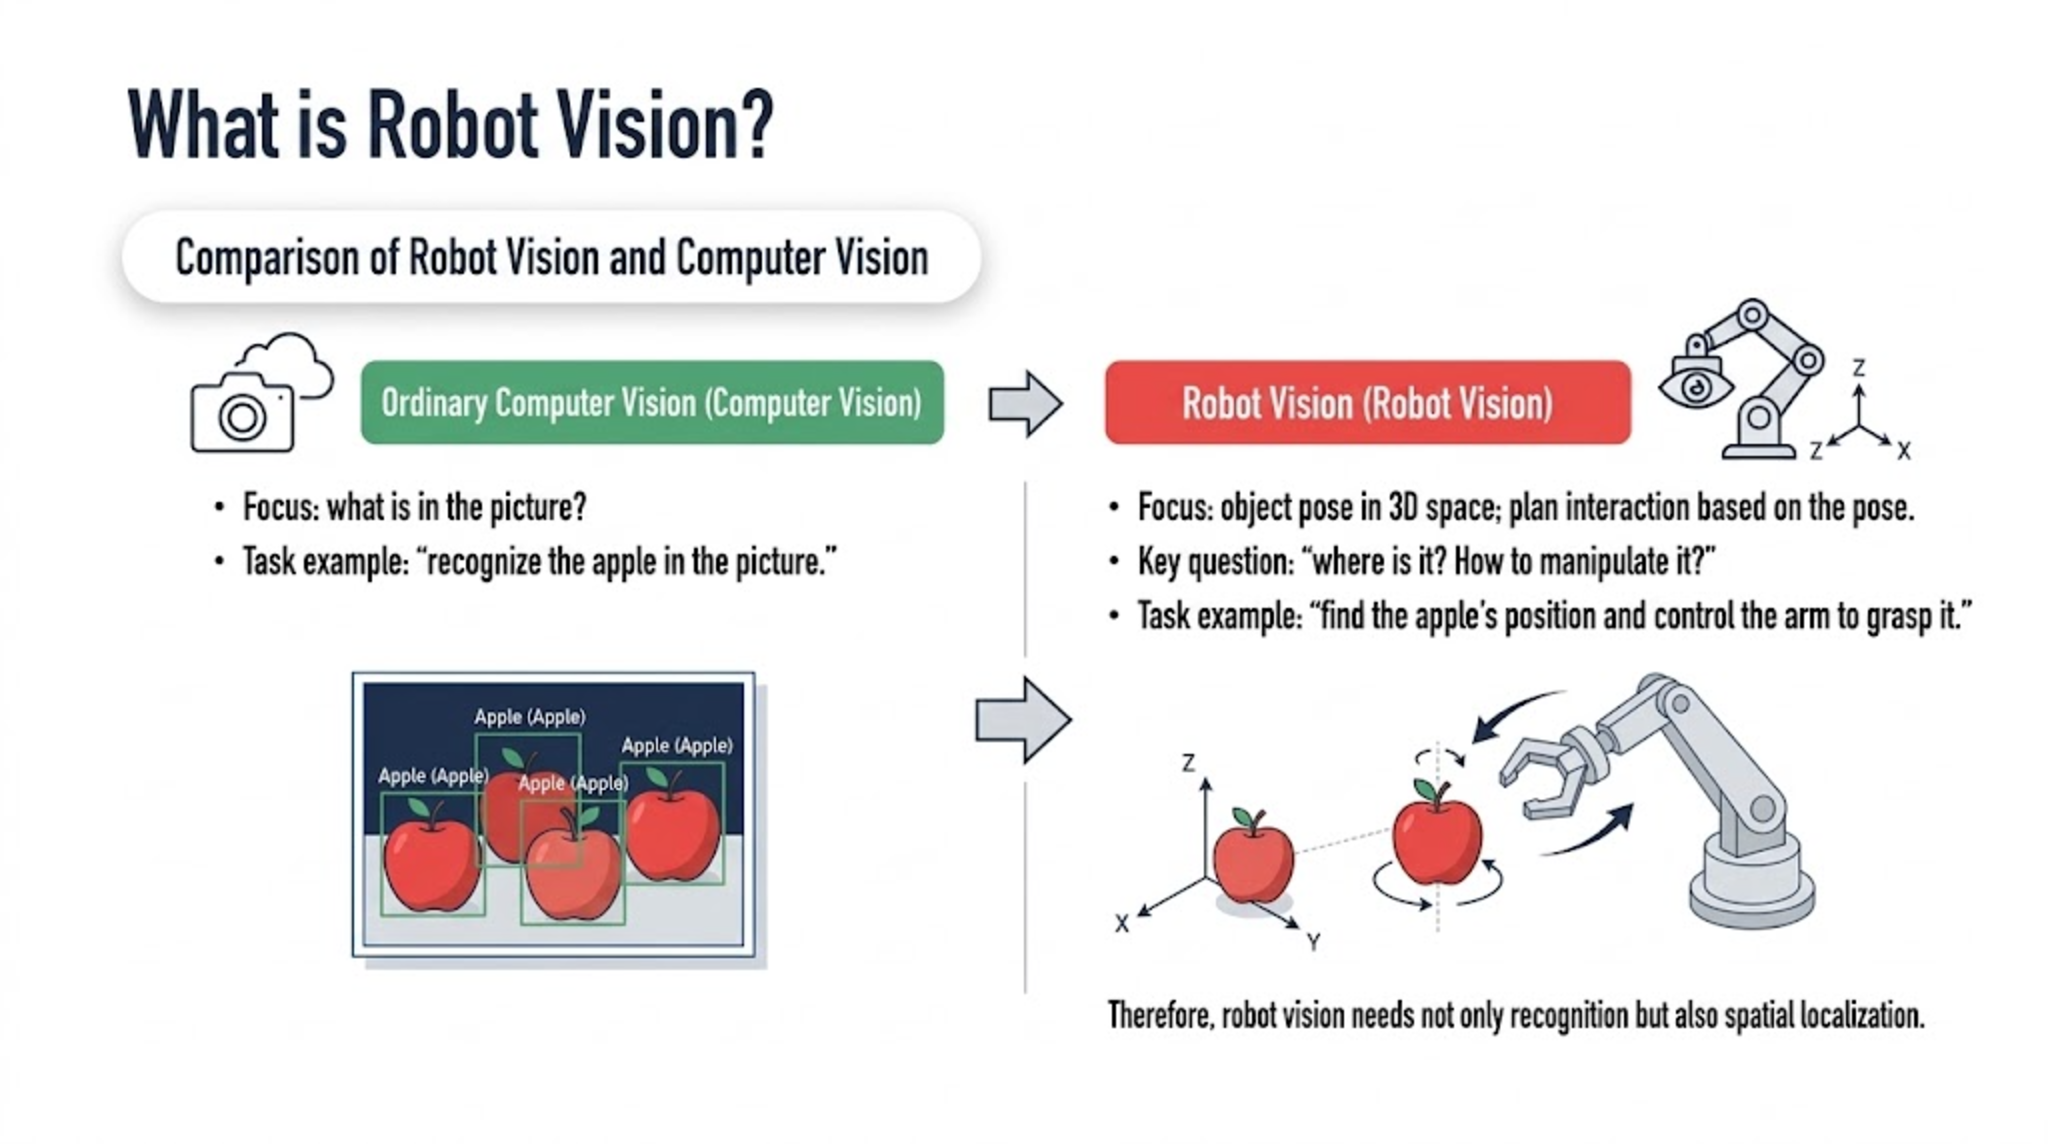
Visão robótica significa que o robô usa câmeras e outros sensores para adquirir informações do ambiente e as compreende por meio de algoritmos, de modo a completar tarefas como localização, reconhecimento e preensão. Diferente da visão computacional comum:
- A visão computacional comum pergunta: o que há na imagem?
- A visão robótica foca em dois problemas: a pose do objeto no espaço 3D e o planejamento da ação do robô a partir dessa pose para completar a interação — isto é, onde está esse objeto? Como o robô deve manipulá-lo?
Por exemplo:
- Tarefa de visão computacional: "reconhecer a maçã na imagem."
- Tarefa de visão robótica: "encontrar a posição da maçã e controlar o braço para agarrá-la."
Portanto, a visão robótica precisa não apenas de reconhecimento, mas também de localização espacial.
Pipeline de Preensão Visual do Braço
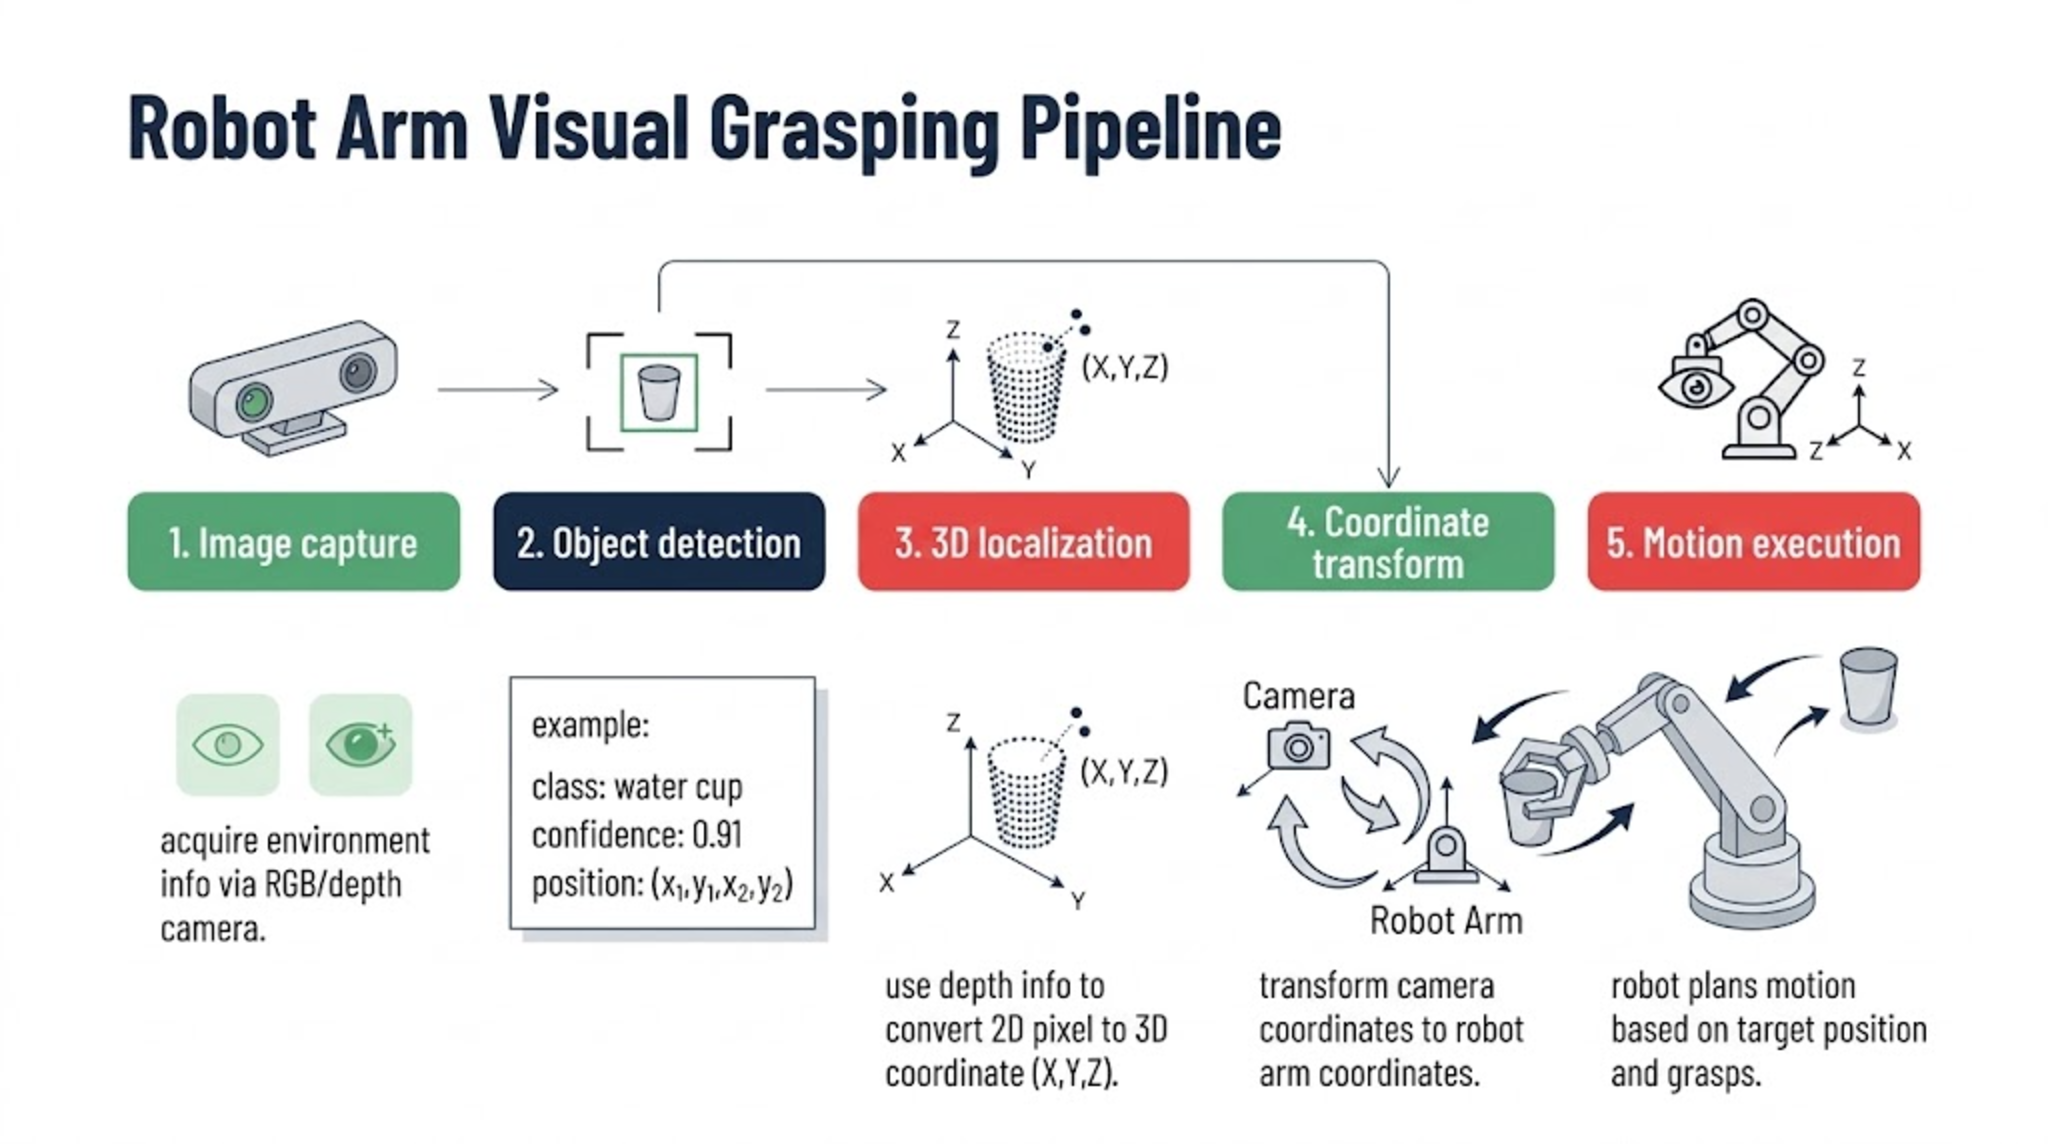
Um sistema completo de preensão visual geralmente inclui:
- Etapa 1: Captura de imagem
- Adquirir informações do ambiente por meio de uma câmera RGB ou de profundidade.
- Etapa 2: Detecção de objetos
- Encontrar o objeto alvo, classificá-lo, obter sua posição
- Por exemplo:
- Classe: copo de água
- Confiança: 0,91
- Posição: (x1,y1,x2,y2)
- Etapa 3: Localização 3D
- Usar informações de profundidade para converter pixels 2D em coordenadas 3D.
- Etapa 4: Transformação de coordenadas
- Converter coordenadas da câmera em coordenadas do braço.
- Etapa 5: Execução do movimento
- O robô planeja o movimento a partir da posição alvo e realiza a preensão.
Imagens RGB e Detecção de Objetos
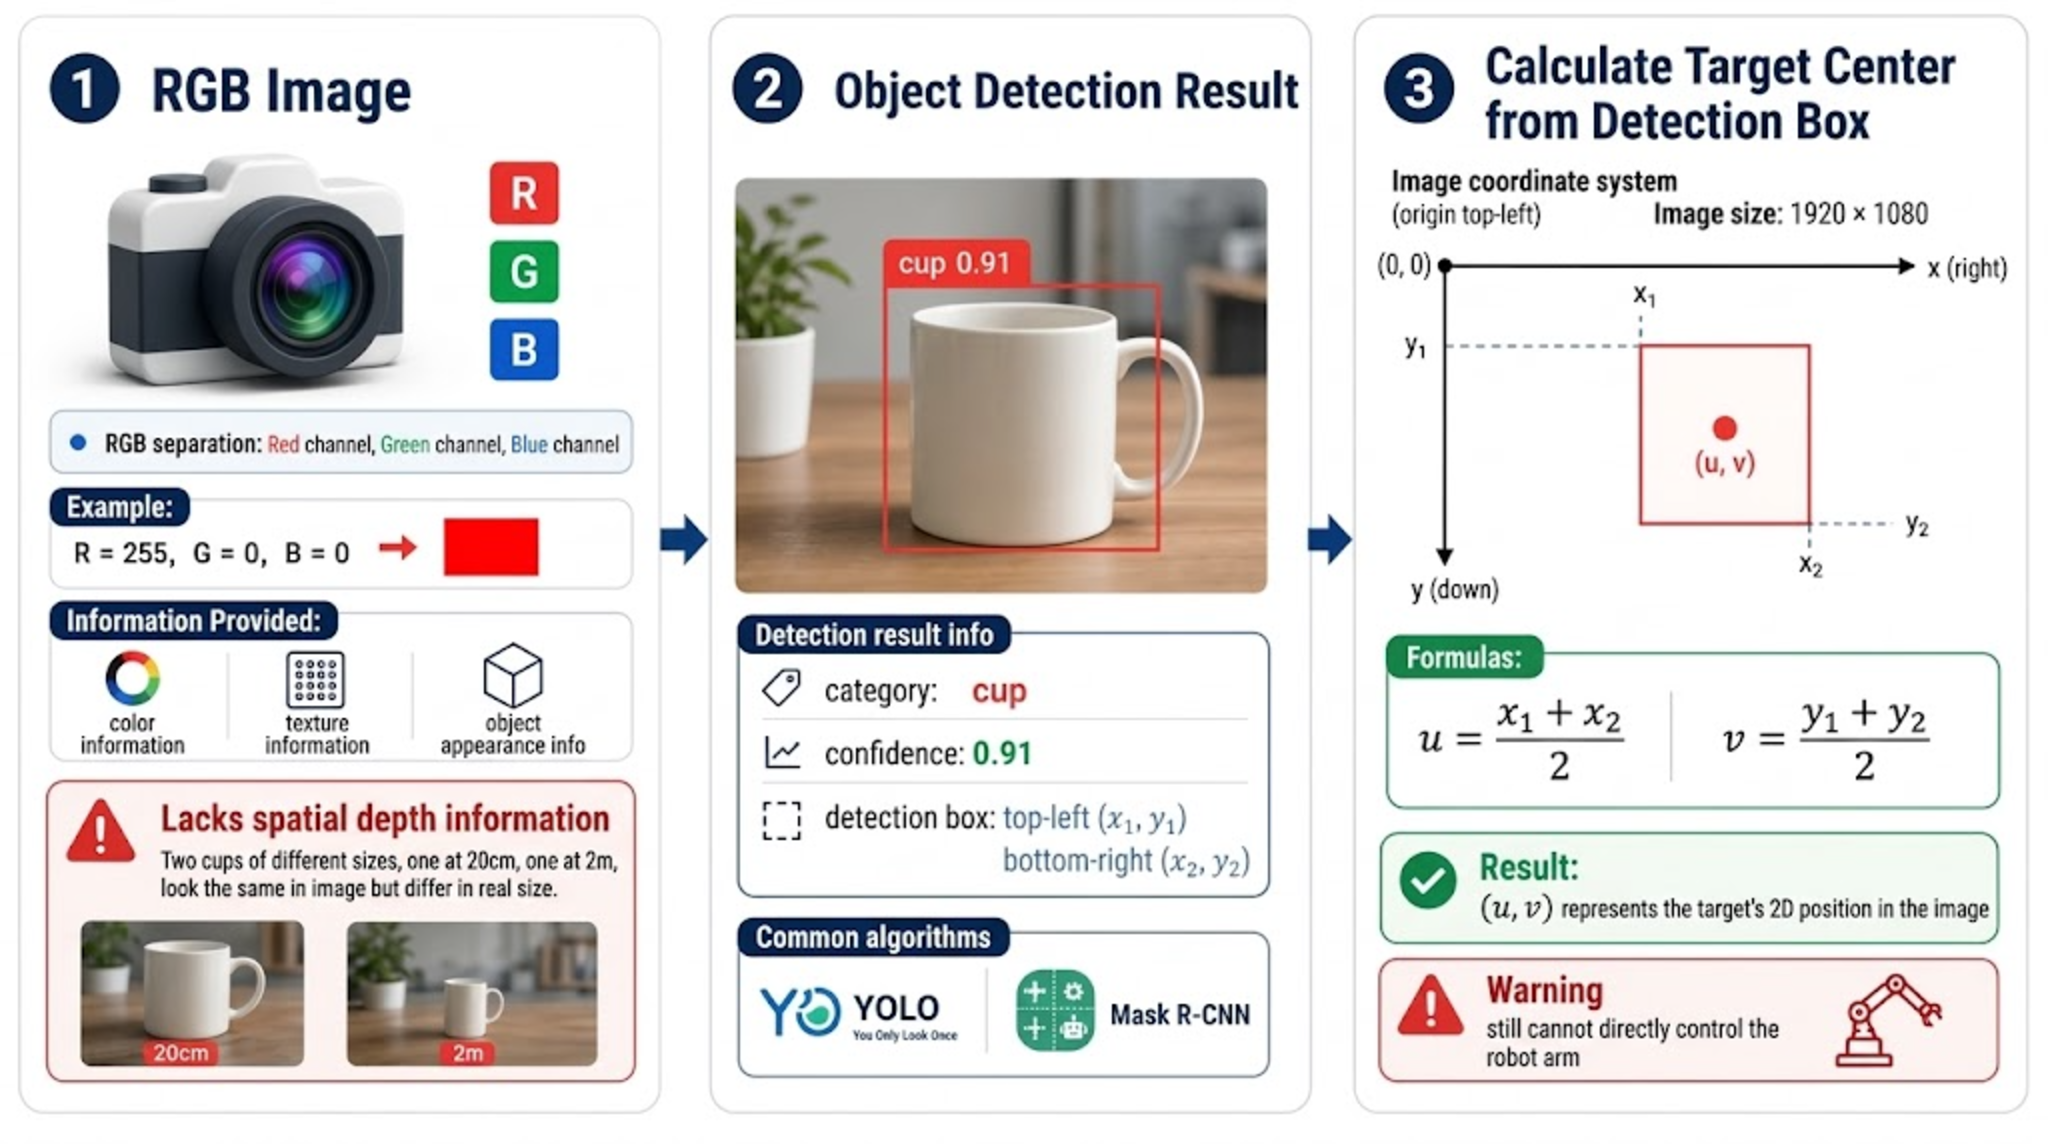
(1) Imagens RGB
Imagens RGB são os dados visuais mais comuns usados por robôs. RGB significa:
- R: Red (vermelho)
- G: Green (verde)
- B: Blue (azul)
Cada pixel é composto por três valores: , , .
Imagens RGB fornecem principalmente: informação de cor, informação de textura, informação de aparência do objeto. Mas imagens RGB têm um problema importante: elas não possuem informação de distância espacial.
- Por exemplo: dois copos, um a 20 cm da câmera, outro a 2 m de distância. Se forem do mesmo tamanho, podem parecer muito semelhantes em uma imagem 2D. RGB só consegue dizer ao robô "onde o copo está na imagem", mas não "a que distância o copo está de mim."
(2) Resultados da Detecção de Objetos
O robô geralmente não usa a imagem inteira diretamente; ele primeiro executa a detecção de objetos.
Algoritmos de detecção (YOLO, Mask R-CNN) fornecem como saída:
| Campo | Significado |
|---|---|
| Class | cup — um copo foi detectado |
| Confidence | 0.91 — o modelo tem 91% de certeza dessa classe |
| Bounding box | Canto superior esquerdo (x1, y1), canto inferior direito (x2, y2) |
(3) Cálculo do Centro do Alvo a partir da Caixa
O robô geralmente precisa do centro do alvo. A imagem que o computador vê é essencialmente uma grade de pixels. Para uma imagem 1920x1080, cada pixel tem sua própria coordenada: canto superior esquerdo (0,0), canto inferior direito (1920,1080); x aumenta para a direita, y aumenta para baixo. Assim, a saída de detecção (u,v) é essencialmente coordenadas de imagem. Calcule:
Resultado: (u,v). Esse ponto é a posição 2D do alvo na imagem. Mas ainda não pode controlar diretamente o braço.
27.3 Por que Robôs Precisam de Informação de Profundidade
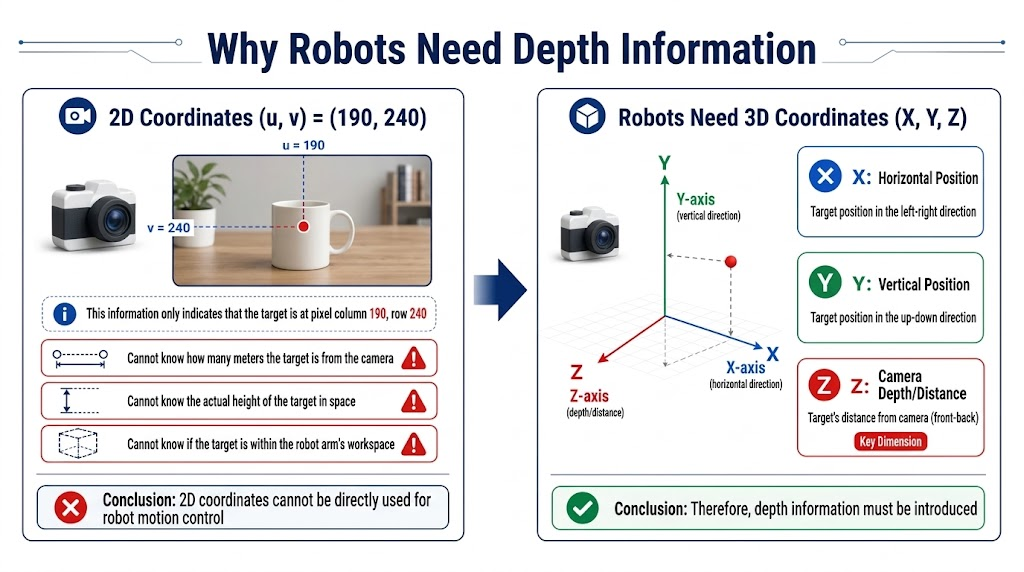
Suponha que o centro do alvo seja:
(u,v)=(190,240)
Isso apenas diz: o alvo está na coluna 190, linha 240 da imagem.
Mas o robô não sabe: a que distância o alvo está da câmera; sua altura no espaço; se ele está dentro da área de trabalho do braço. Portanto: coordenadas 2D não podem acionar diretamente o movimento do robô.
O robô precisa das coordenadas 3D do objeto: x, posição horizontal; Y, posição vertical; Z, profundidade em relação à câmera. Assim, é necessária informação de profundidade.
27.4 Mapas de Profundidade e Dados RGB-D
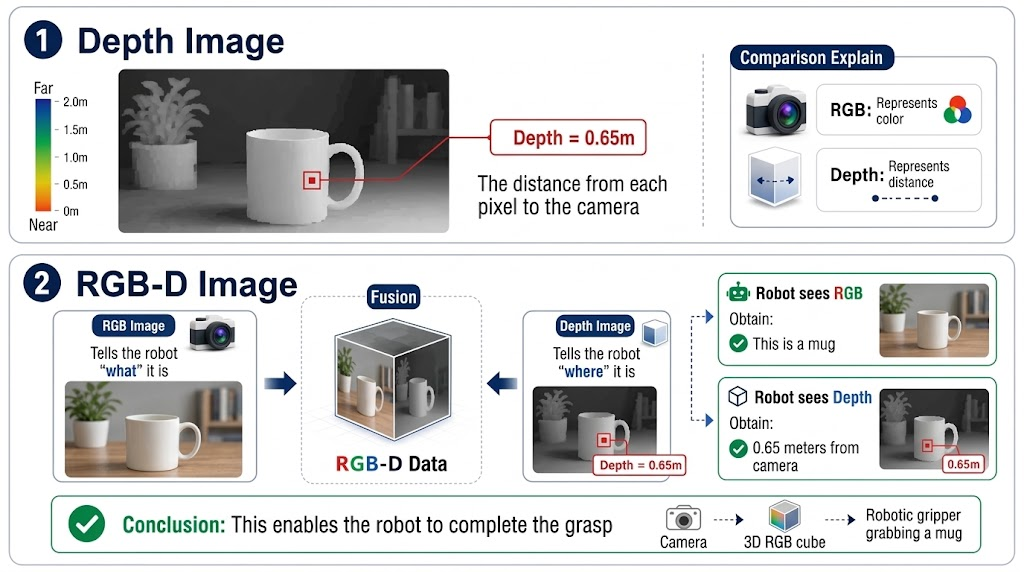
Mapa de Profundidade
Um mapa de profundidade representa: a distância de cada pixel até a câmera.
Por exemplo: algum pixel, Depth=0,65 m.
Significado: aquela posição está a cerca de 65 cm da câmera. Diferente de RGB (que representa cor), Depth representa distância.
Imagem RGB-D
Funda a imagem RGB e a imagem de profundidade para obter dados RGB-D. RGB-D contém:
- Parte RGB: diz ao robô "o que é"
- Parte de profundidade: diz ao robô "onde está"
Por exemplo:
- O robô vê a imagem RGB e aprende que isso é um copo; vê a imagem de profundidade e aprende que o copo está a 0,65 m da câmera. Só então o robô pode agarrar.
27.5 Princípios de Câmeras de Profundidade
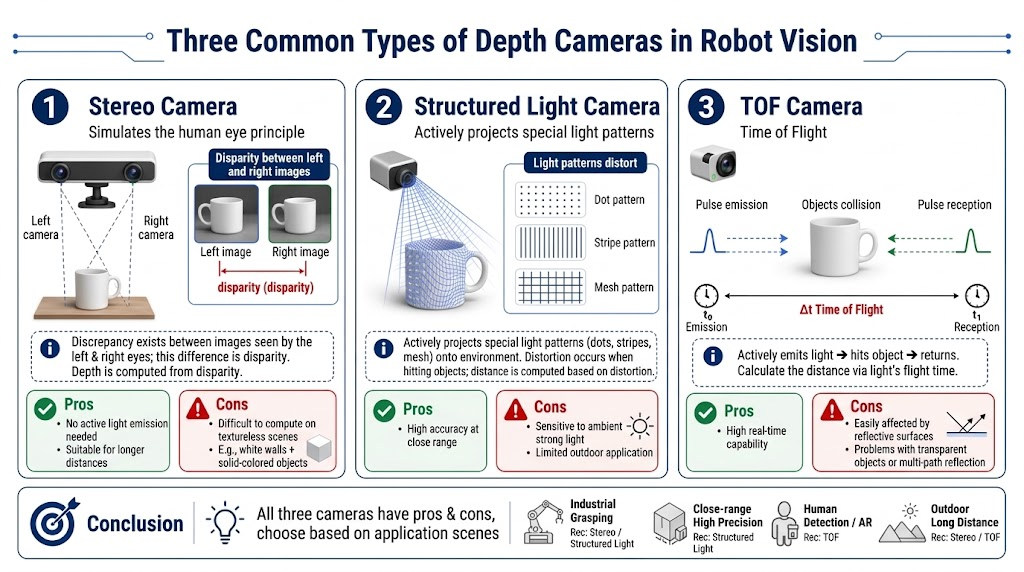
As três câmeras de profundidade mais comuns em visão robótica são câmeras estéreo, câmeras de luz estruturada e câmeras TOF.
| Câmera | Princípio | Prós | Contras |
|---|---|---|---|
| Estéreo | Imita os olhos humanos: duas câmeras comparam onde o mesmo objeto aparece nas visões esquerda e direita, e a profundidade é obtida a partir dessa disparidade | Não precisa de iluminação ativa; funciona a longas distâncias | Falha em objetos sem textura — uma parede branca e um objeto de cor sólida parecem quase idênticos para ambas as câmeras |
| Luz estruturada | Projeta ativamente um padrão conhecido (matriz de pontos, listras, grade) e lê como o padrão se deforma sobre o objeto | Alta precisão a curta distância | Facilmente perturbada por luz forte e condições externas |
| TOF (Time Of Flight) | Emite luz, espera pela reflexão e mede o tempo de ida e volta | Alto desempenho em tempo real | Afetada por superfícies reflexivas, objetos transparentes e reflexão multipercurso |
27.6 Modelo de Coordenadas da Câmera e Parâmetros Intrínsecos
Sistemas de Coordenadas
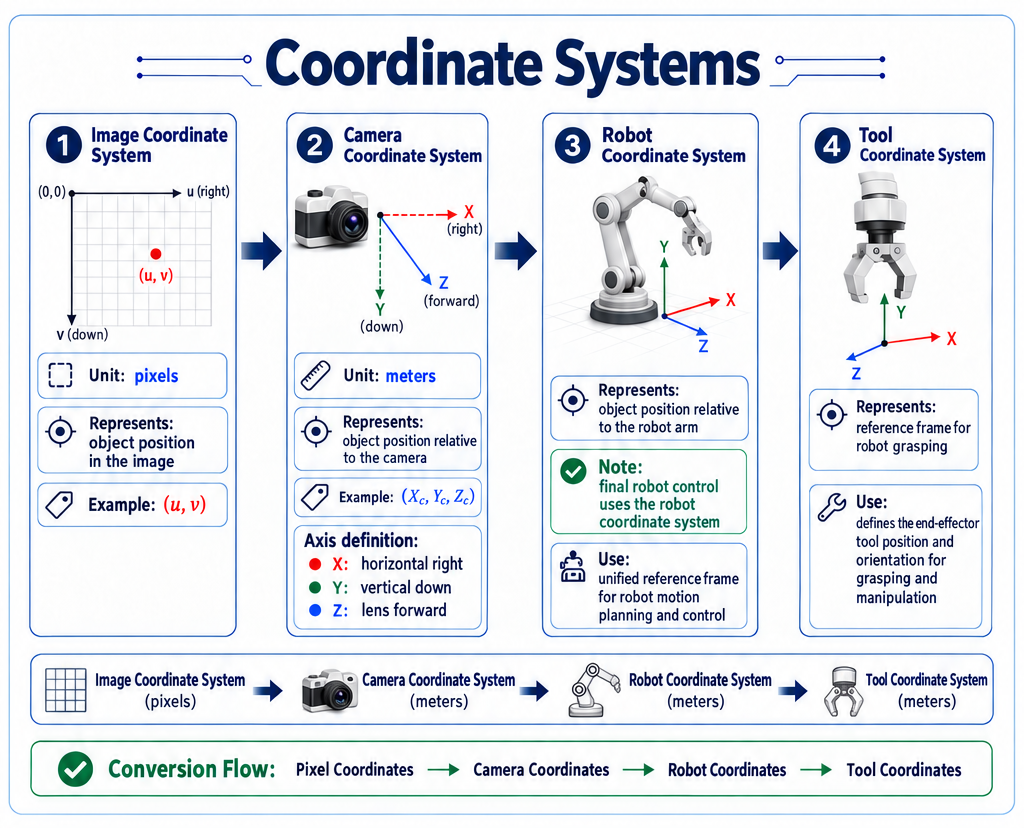
A visão robótica envolve quatro referenciais de coordenadas:
| Referencial | Unidade | Significado | Exemplo |
|---|---|---|---|
| Referencial da imagem | Pixels | Onde o objeto está na imagem | (u, v) |
| Referencial da câmera | Metros | Onde o objeto está em relação à câmera | (Xc, Yc, Zc) — X para a direita, Y para baixo, Z saindo da lente |
| Referencial do robô | Metros | Onde o objeto está em relação ao braço; o braço é controlado, em última instância, em coordenadas do robô | — |
| Referencial da ferramenta (referencial do efetuador final) | Metros | O referencial que o braço usa para executar uma preensão | — |
Parâmetros intrínsecos da câmera
Por que os parâmetros intrínsecos são necessários?
- Porque uma imagem 2D não é o espaço real. A câmera projeta o espaço 3D em uma imagem 2D; isso é chamado de projeção, e os parâmetros intrínsecos descrevem essa projeção. Com os intrínsecos você pode recalcular os pixels 2D de volta para o espaço 3D — isto é, os intrínsecos descrevem como a câmera forma uma imagem.
| Parâmetro | Significado |
|---|---|
fx, fy | Distância focal em x e y (pixels) |
cx, cy | Ponto principal em x e y — o centro da imagem (pixels) |
k1, k2, k3, p1, p2 | Coeficientes de distorção |
- A distorção da lente desloca as posições dos pixels perto das bordas da imagem. Sem correção de distorção, as próprias coordenadas de pixel (u,v) têm erro, e a conversão 3D deriva. Na prática, primeiro corrija a distorção da imagem e depois use as coordenadas de pixel.
27.7 Convertendo pixels em coordenadas 3D
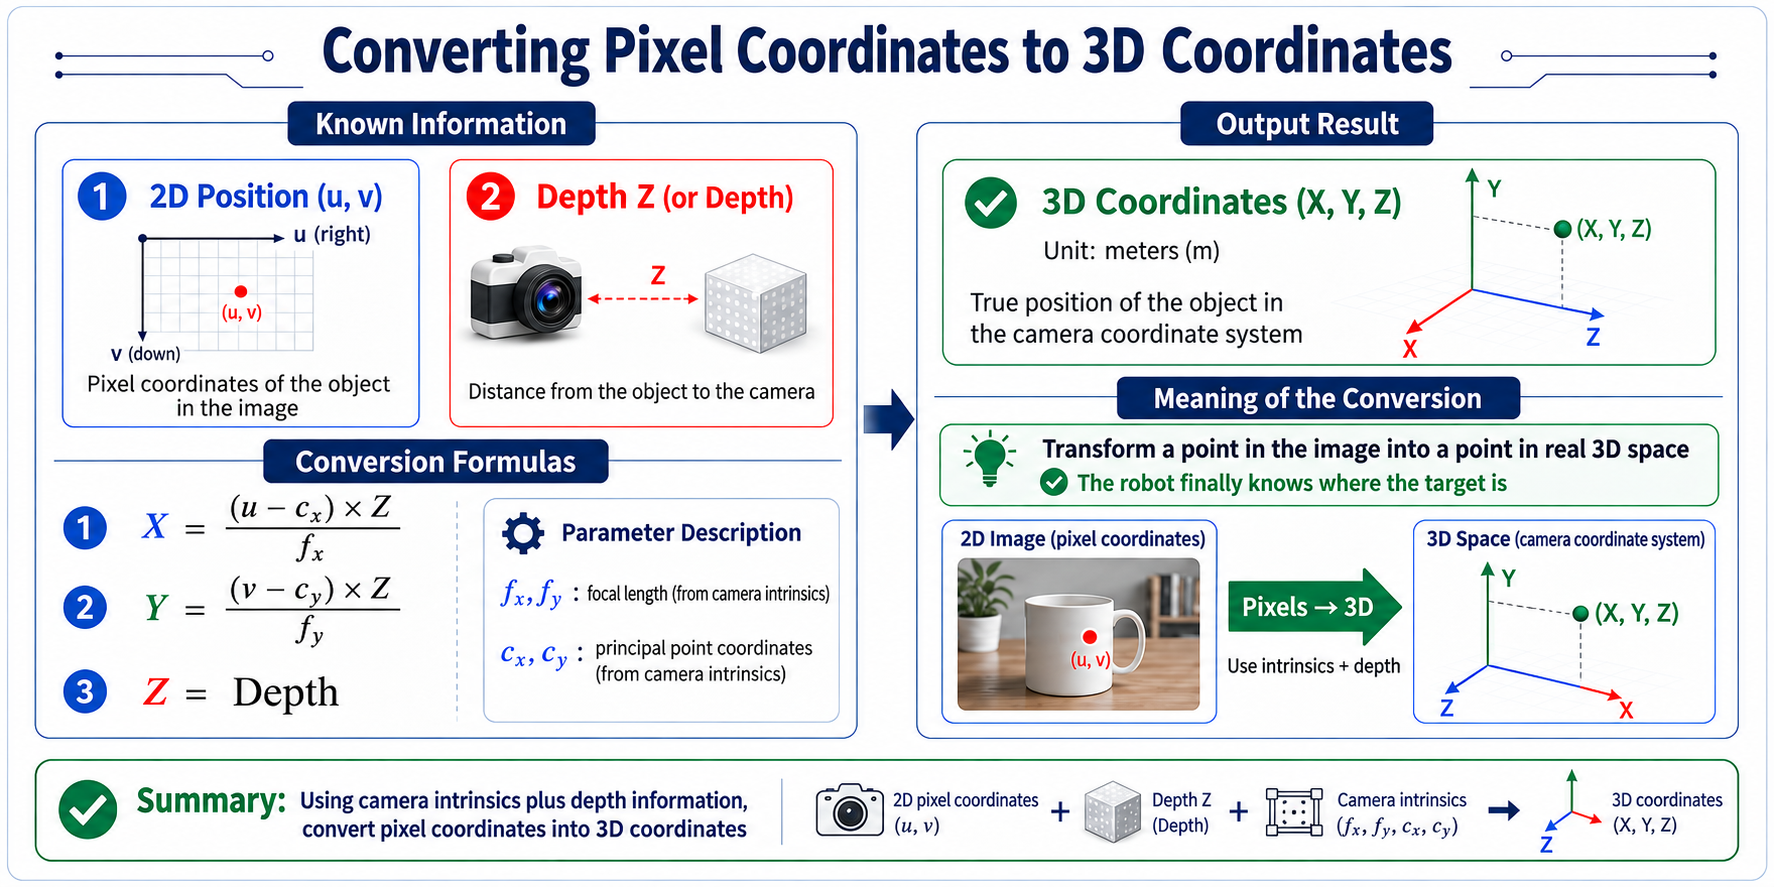
Dadas as seguintes informações sobre o objeto:
- Posição 2D: (u,v)
- Profundidade: Z
Usando os intrínsecos, obtenha do objeto:
- (X,Y,Z)
Fórmulas:
O significado: transformar um ponto na imagem em um ponto no espaço real, para que o robô finalmente saiba onde o alvo está.
27.8 Parâmetros extrínsecos da câmera e transformação de coordenadas
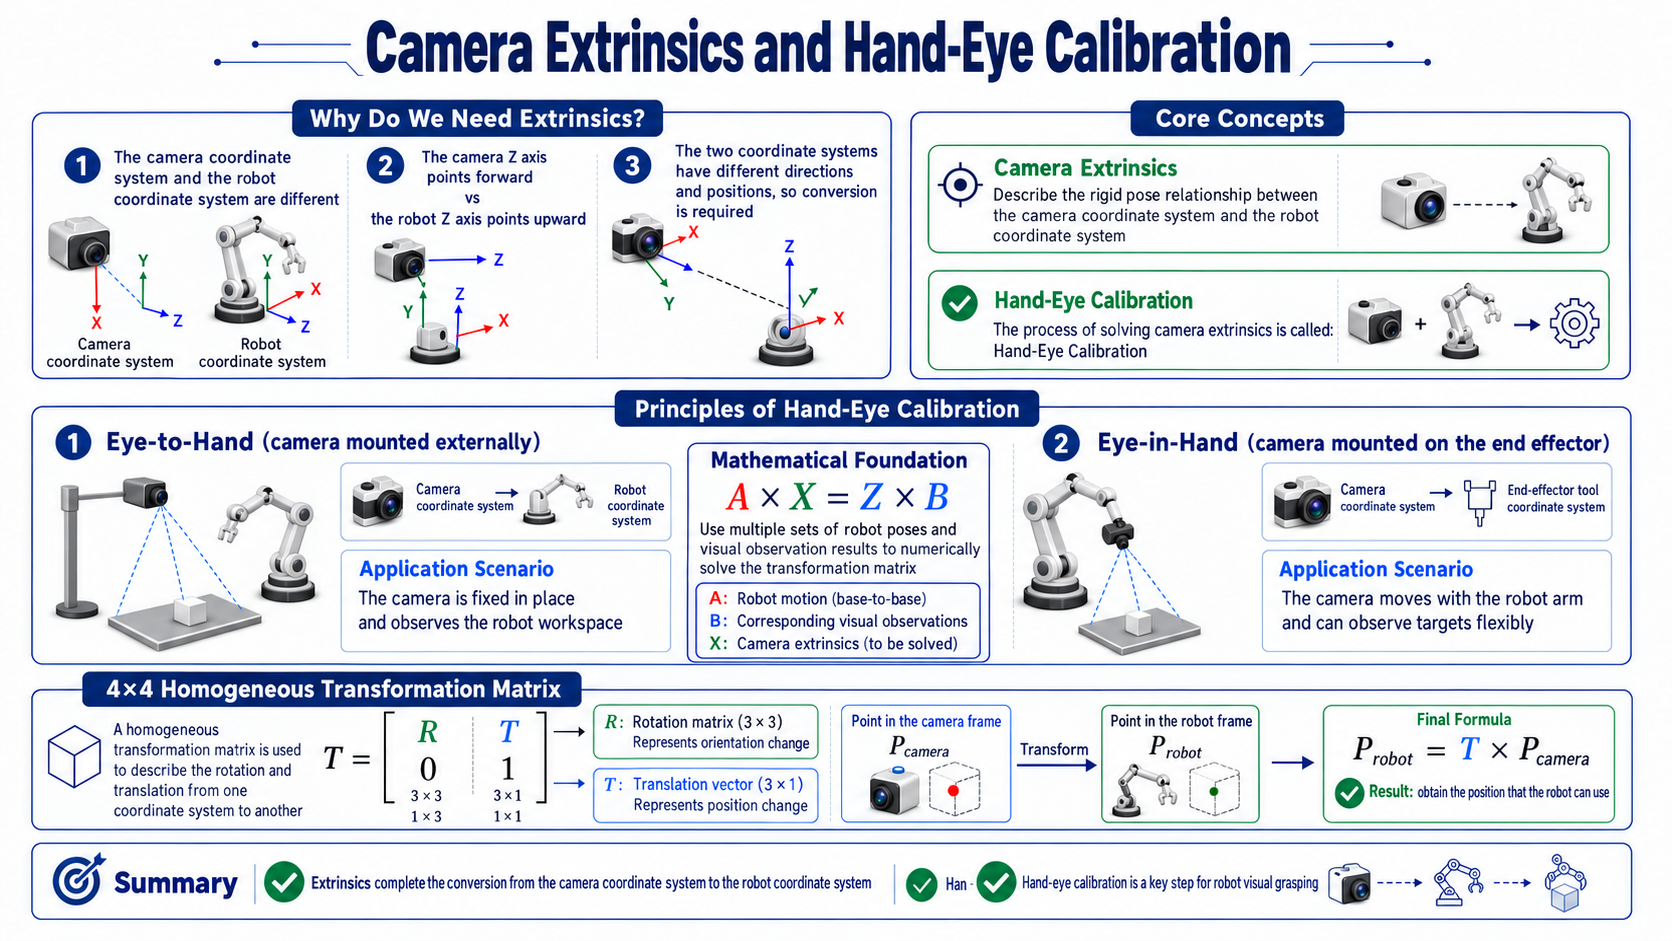
Por que os parâmetros extrínsecos são necessários?
- Porque o referencial da câmera e o referencial do robô são diferentes. Por exemplo, o eixo Z da câmera aponta para a frente, enquanto o eixo Z do robô aponta para cima. Os dois referenciais diferem tanto em orientação quanto em posição, então é necessária uma transformação. Os parâmetros extrínsecos da câmera descrevem a relação de pose de corpo rígido entre o referencial da câmera e o referencial do robô; resolver esses parâmetros é chamado de calibração mão-olho.
Princípios da calibração mão-olho
- Eye-to-Hand: resolver a transformação do referencial da câmera para o referencial da base do braço
- Eye-in-Hand: resolver a transformação do referencial da câmera para o referencial da ferramenta na extremidade do braço
- A base matemática é : coletando múltiplos pares de poses do braço e observações visuais, resolve-se numericamente a transformação X.
Matriz de calibração
Erro de calibração e ponto de preensão, transformação homogênea X
- Os robôs geralmente usam uma matriz 4x4 para representar transformações de coordenadas.
- A matriz contém:
- Matriz de rotação R, representando a mudança de orientação.
- Vetor de translação T, representando a mudança de posição.
- Por fim: , fornecendo a posição que o robô pode usar.
27.9 Nuvens de pontos
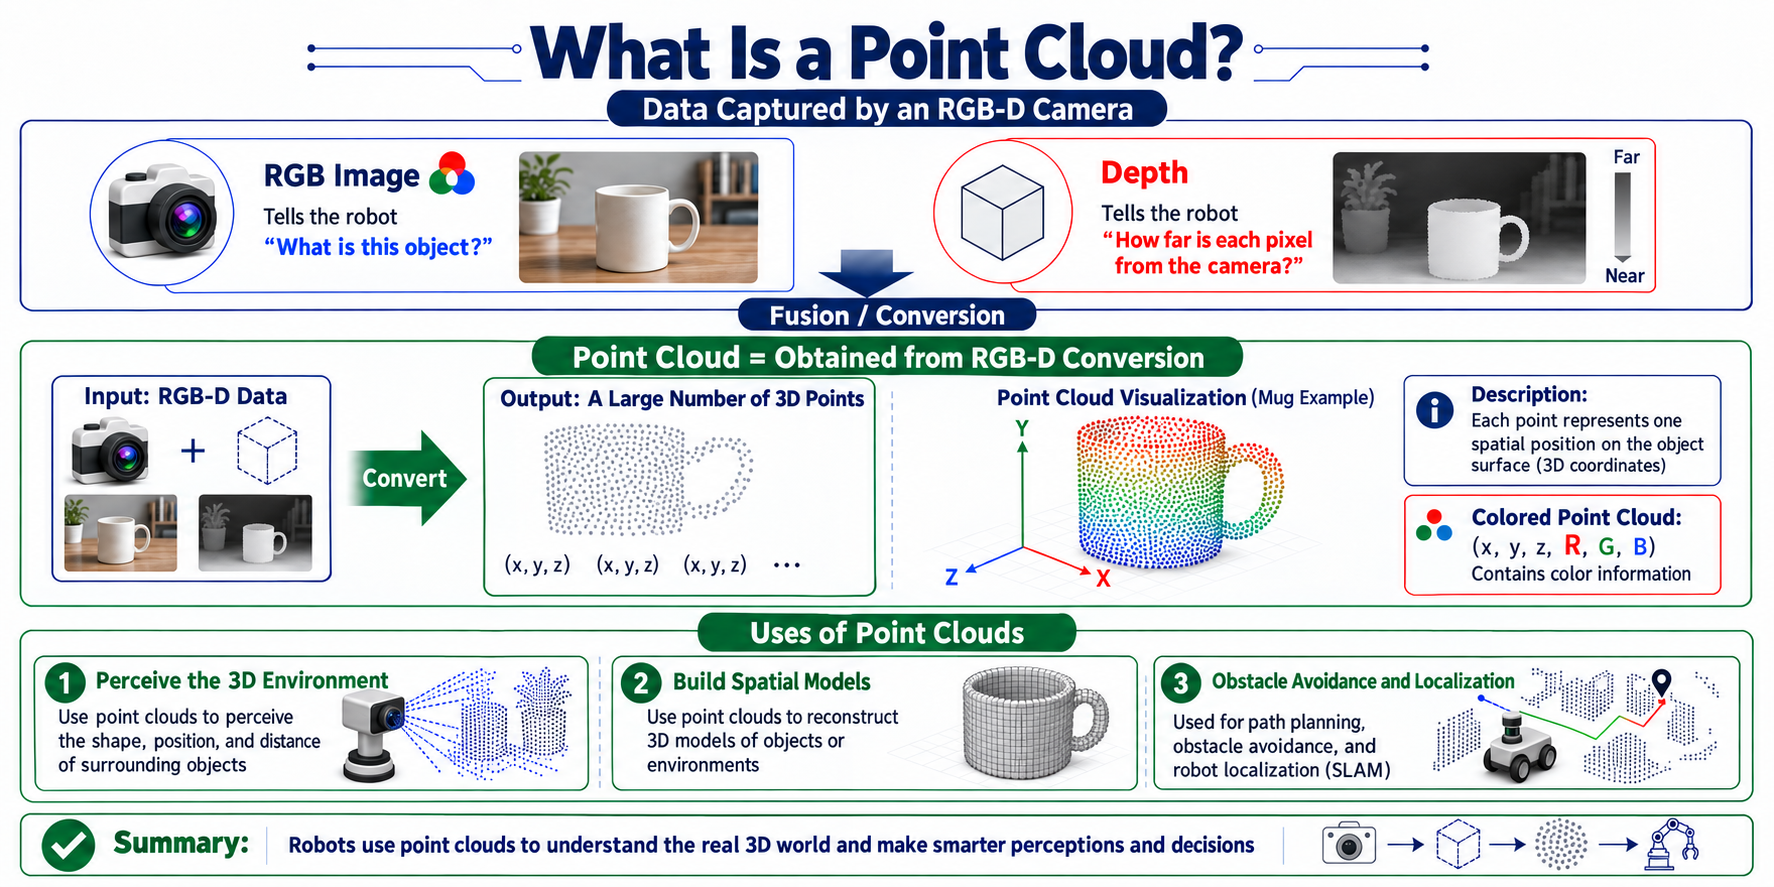
O que é uma nuvem de pontos?
- Os dados de uma câmera RGB-D geralmente incluem
- Imagem RGB: diz ao robô o que é esse objeto?
- Profundidade: diz ao robô a que distância cada pixel está da câmera?
- Uma nuvem de pontos é obtida convertendo RGB-D:
Usos das nuvens de pontos
- Os robôs podem usar nuvens de pontos para perceber o ambiente 3D, construir modelos espaciais, evitar obstáculos e se localizar.