28. Detecção de Objetos e Calibração Mão-Olho
Capítulo 28 do Curso para Iniciantes em IA Física da Seeed — detecção de objetos e calibração mão‑olho: taxonomia de tarefas de visão, YOLO e detecção de vocabulário aberto, caixas delimitadoras orientadas, NMS e mAP, marcadores ArUco com solvePnP, calibração mão‑olho AX = XB e estimação de pose de preensão 6‑DoF com GraspNet.
28.1 Visão Geral do Capítulo
No último capítulo aprendemos o pipeline básico de visão robótica: ambiente -> captura pela câmera -> imagem 2D -> informação de profundidade -> coordenadas no espaço 3D -> coordenadas do robô, mas não nos aprofundamos nos princípios algorítmicos e detalhes de implementação de cada etapa. Este capítulo aprofunda um nível em cada etapa para que o leitor entenda a matemática e os trade-offs de engenharia por trás dos algoritmos.
Em um sistema robótico real, o robô não enfrenta uma posição‑alvo já anotada. Portanto, quatro questões centrais precisam ser resolvidas em profundidade:
- Pergunta 1: Por que o algoritmo de detecção é YOLO? Como o YOLOE permite definir classes personalizadas?
- Ver: princípios de algoritmos de detecção de objetos (28.3)
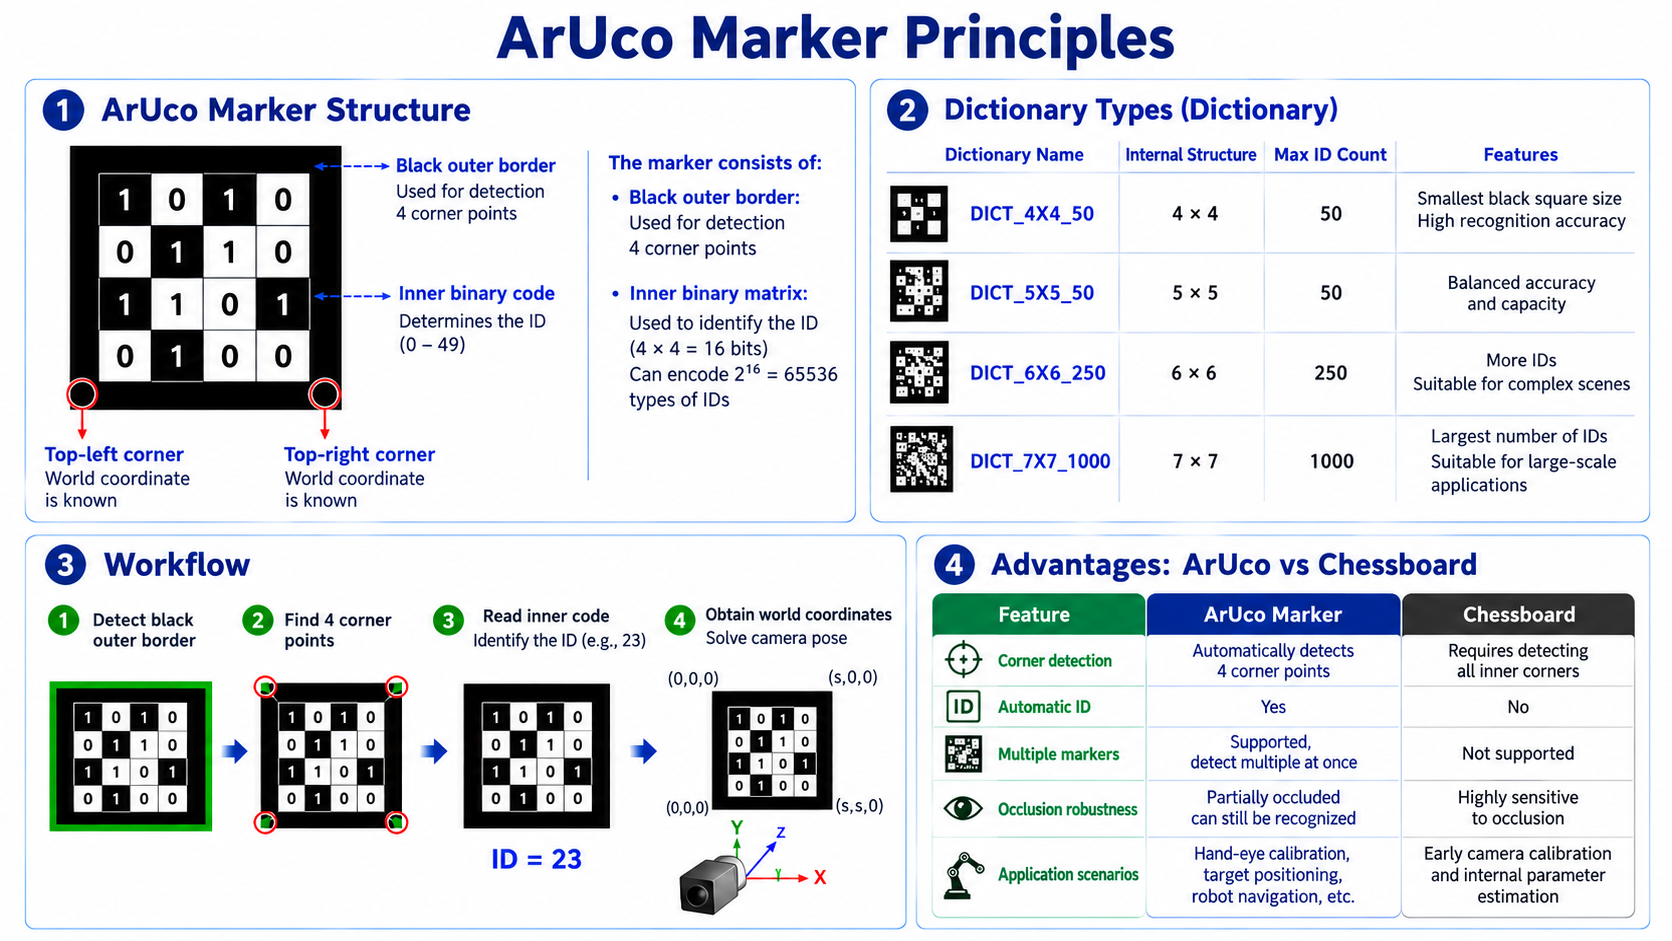
- Pergunta 2: Por que usar ArUco em vez de um tabuleiro de xadrez para calibração de câmera?
- Ver: princípios de marcadores ArUco (28.4)
- Pergunta 3: Por que câmeras de profundidade ativas conseguem produzir diretamente um mapa de profundidade? Como profundidade e RGB são alinhados?
- Ver: princípios de câmeras de profundidade ativas (Capítulo 27, seção 27.5)
- Pergunta 4: Como uma pose de preensão 6‑DoF é estimada a partir de uma imagem?
- Ver: estimação de pose de preensão 6‑DoF (28.6)
- Este capítulo constrói um entendimento mais profundo:
- Algoritmos de detecção (YOLOE / OBB) -> calibração de câmera com ArUco -> princípios de câmeras de profundidade ativas -> estimação de pose de preensão 6‑DoF
28.2 Taxonomia de Tarefas Visuais
A Cadeia de Tarefas na Visão Robótica
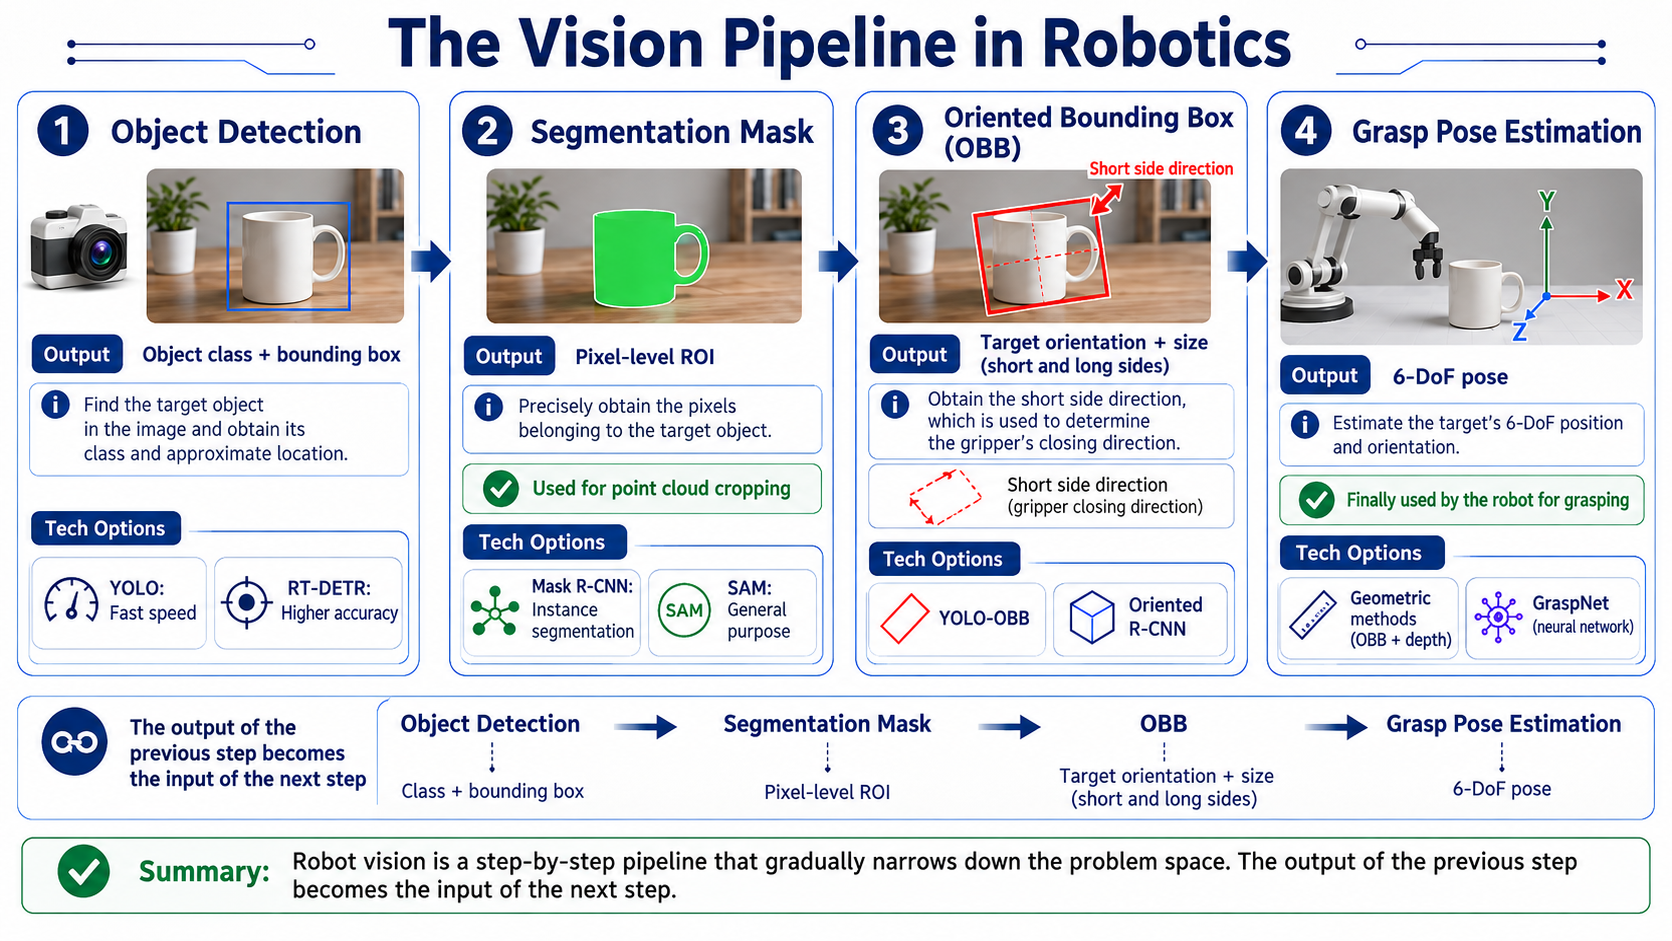
Cada estágio tem suas próprias escolhas técnicas:
| Estágio | Saída | Algoritmos típicos |
|---|---|---|
| Detecção de objetos | Classe + posição grosseira | YOLO (velocidade) ou RT-DETR (precisão) |
| Segmentação | ROI em nível de pixel, usada para recortar a nuvem de pontos | Mask R-CNN (instância) ou SAM (zero-shot) |
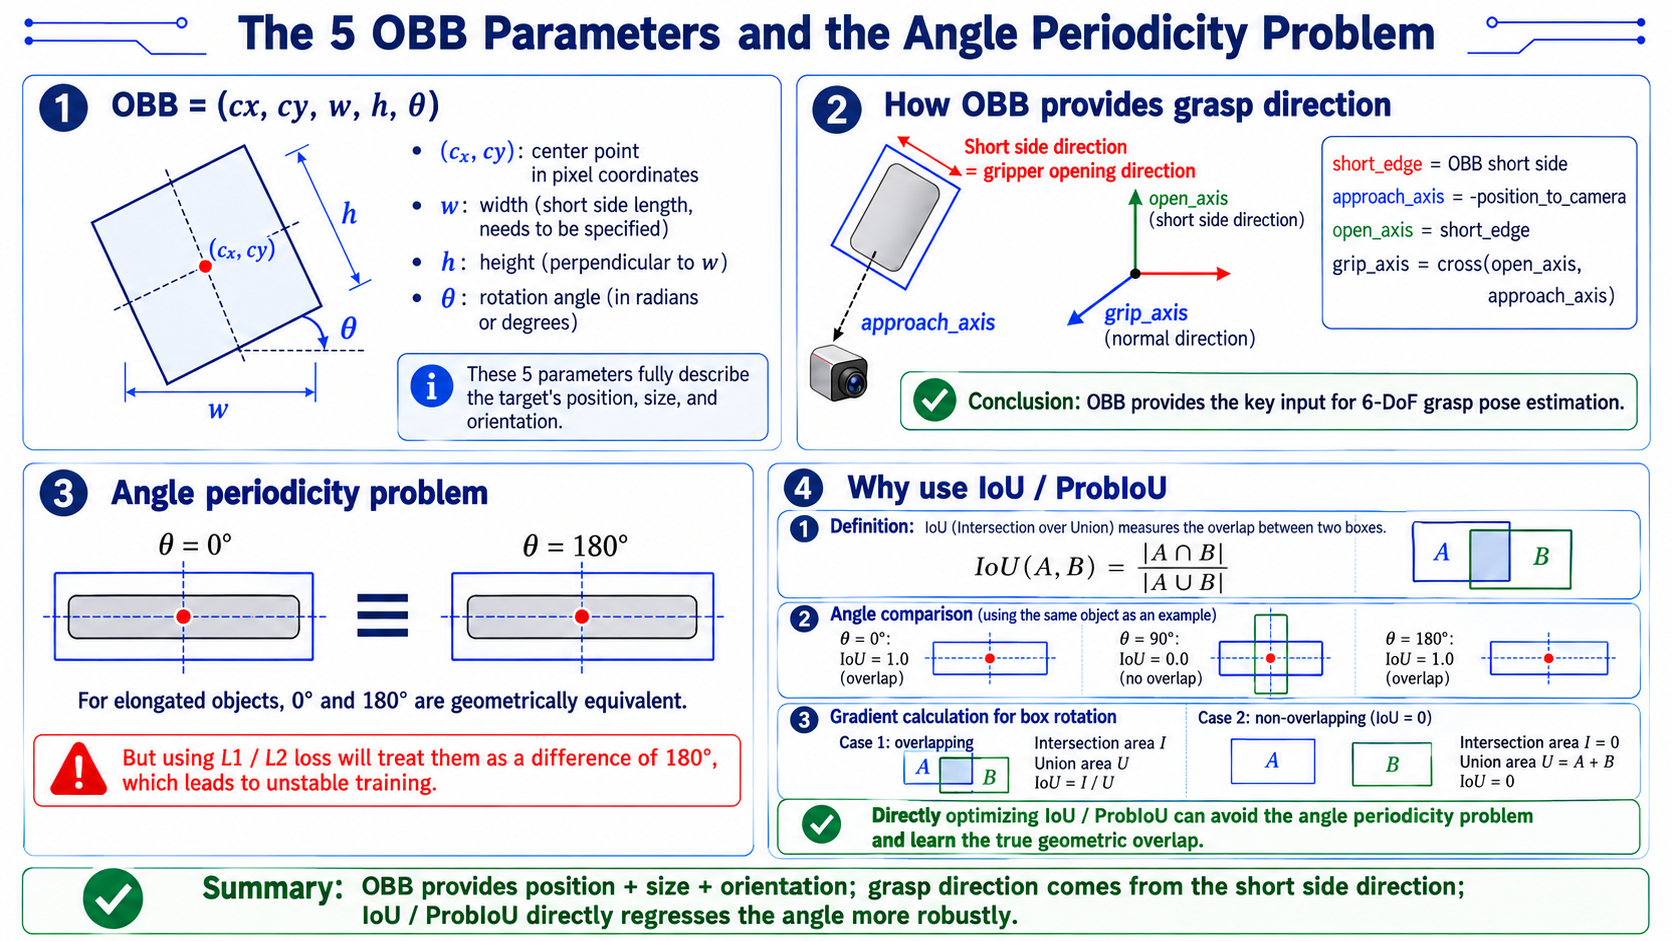
| Caixa delimitadora orientada | Direção da aresta curta = direção de abrir/fechar do gripper | YOLO-OBB ou Oriented R-CNN |
| Estimação de pose de preensão | Pose 6‑DoF | Método geométrico (OBB + profundidade) ou GraspNet (rede neural) |
Comparação de Quatro Tarefas Visuais
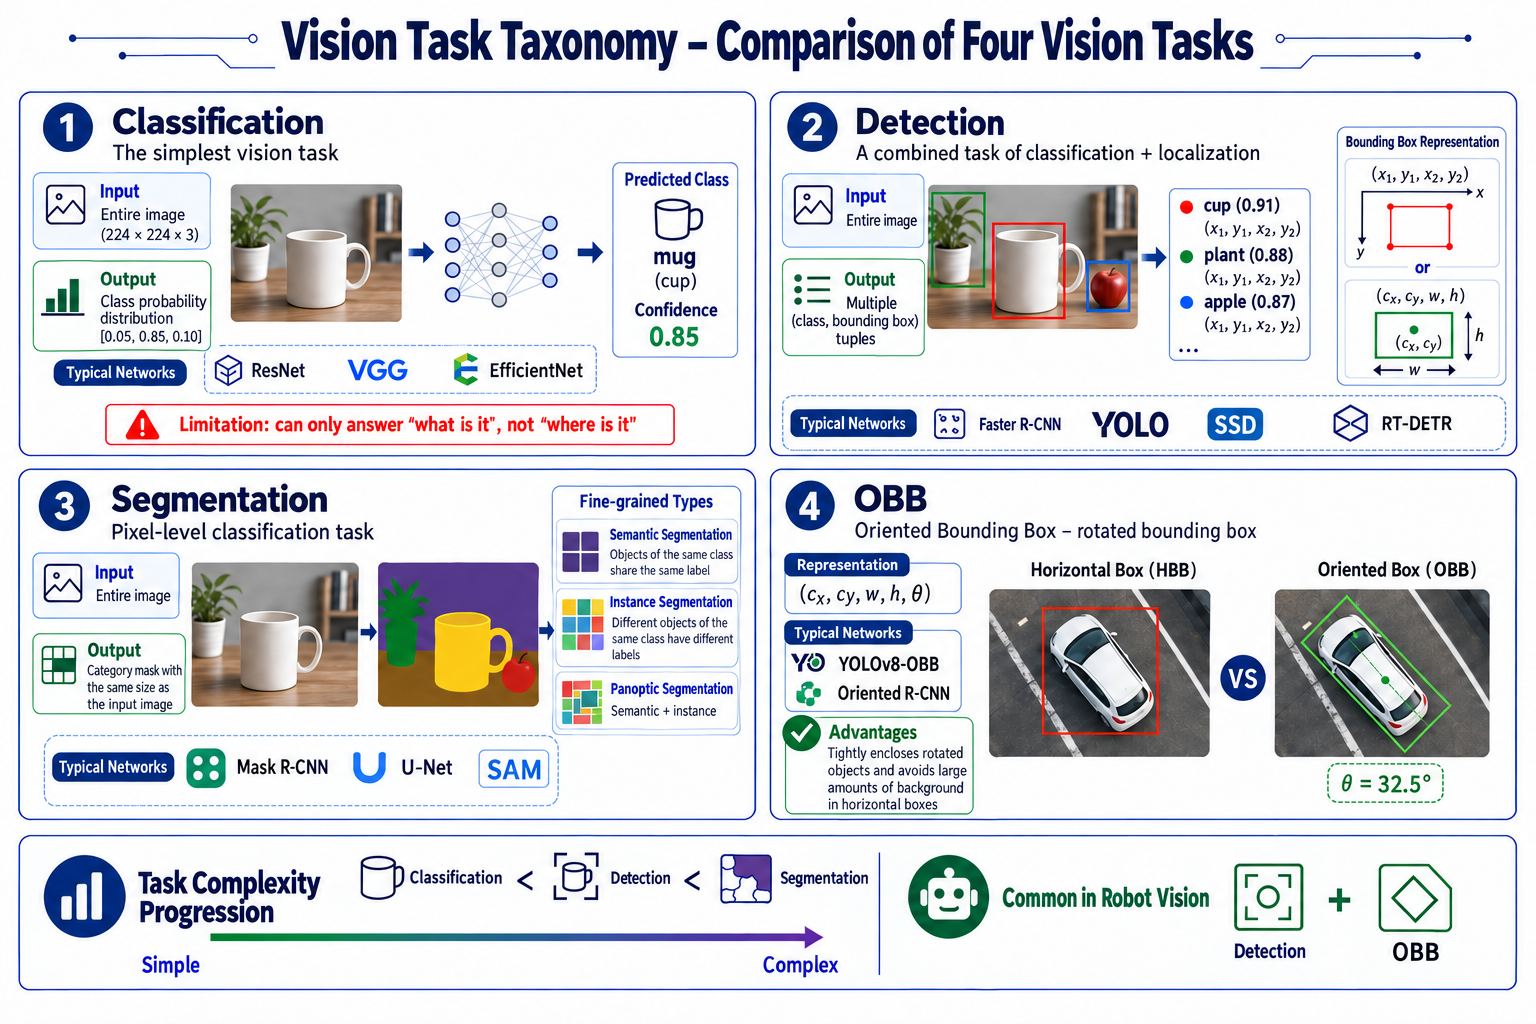
As quatro tarefas se constroem umas sobre as outras; elas diferem no que recebem e no que devolvem:
| Tarefa | O que faz | Entrada | Saída | Redes típicas |
|---|---|---|---|---|
| Classificação | Tarefa mais simples: imagem entra, rótulo de classe sai | Imagem inteira (por exemplo, 224x224x3) | Distribuição de probabilidade de classes (por exemplo, [0.05, 0.85, 0.10]) | ResNet, VGG, EfficientNet |
| Detecção | Classificação + localização | Imagem inteira | Uma tupla (classe, caixa delimitadora) por objeto; caixa como (x1, y1, x2, y2) ou (cx, cy, w, h) | Faster R-CNN, YOLO, SSD, RT-DETR |
| Segmentação | Classificação em nível de pixel: um rótulo de classe por pixel | Imagem inteira | Uma máscara de classe do mesmo tamanho da entrada | Mask R-CNN (instância), U-Net (semântica), SAM |
| Caixa delimitadora orientada (OBB) | Caixa delimitadora com um ângulo de rotação | Imagem inteira | (cx, cy, w, h, theta) | YOLOv8-OBB, Oriented R-CNN |
Três coisas que valem a pena lembrar: classificação só consegue responder "o que há", não "onde"; segmentação vem em três sabores — semântica (mesma classe compartilha um rótulo), por instância (objetos diferentes da mesma classe recebem rótulos diferentes) e panóptica (semântica + instância); e OBB envolve um objeto rotacionado de forma justa em vez de arrastar o fundo que uma caixa horizontal incluiria.
28.3 Mergulho Profundo em Algoritmos de Detecção
Por Que YOLO para Visão Robótica em Tempo Real
O requisito central dos algoritmos de visão robótica é o desempenho em tempo real. Considere um cenário típico:
- Um objeto se move em uma esteira a 0,1 m/s; o campo de visão é 0,5 m; o tempo de travessia é 5 segundos. Suponha controle a 20 Hz (intervalo de quadro de 50 ms). Se a detecção leva 200 ms por quadro (5 Hz), o robô não consegue acompanhar e frequentemente perderá a preensão.
- A ideia de "olhar uma vez" do YOLO: dividir a imagem em uma grade SxS, cada célula de grade prevê diretamente B caixas + classe e produz resultados em uma única passada para frente.
Detecção de Vocabulário Aberto (YOLOE / YOLO-World)
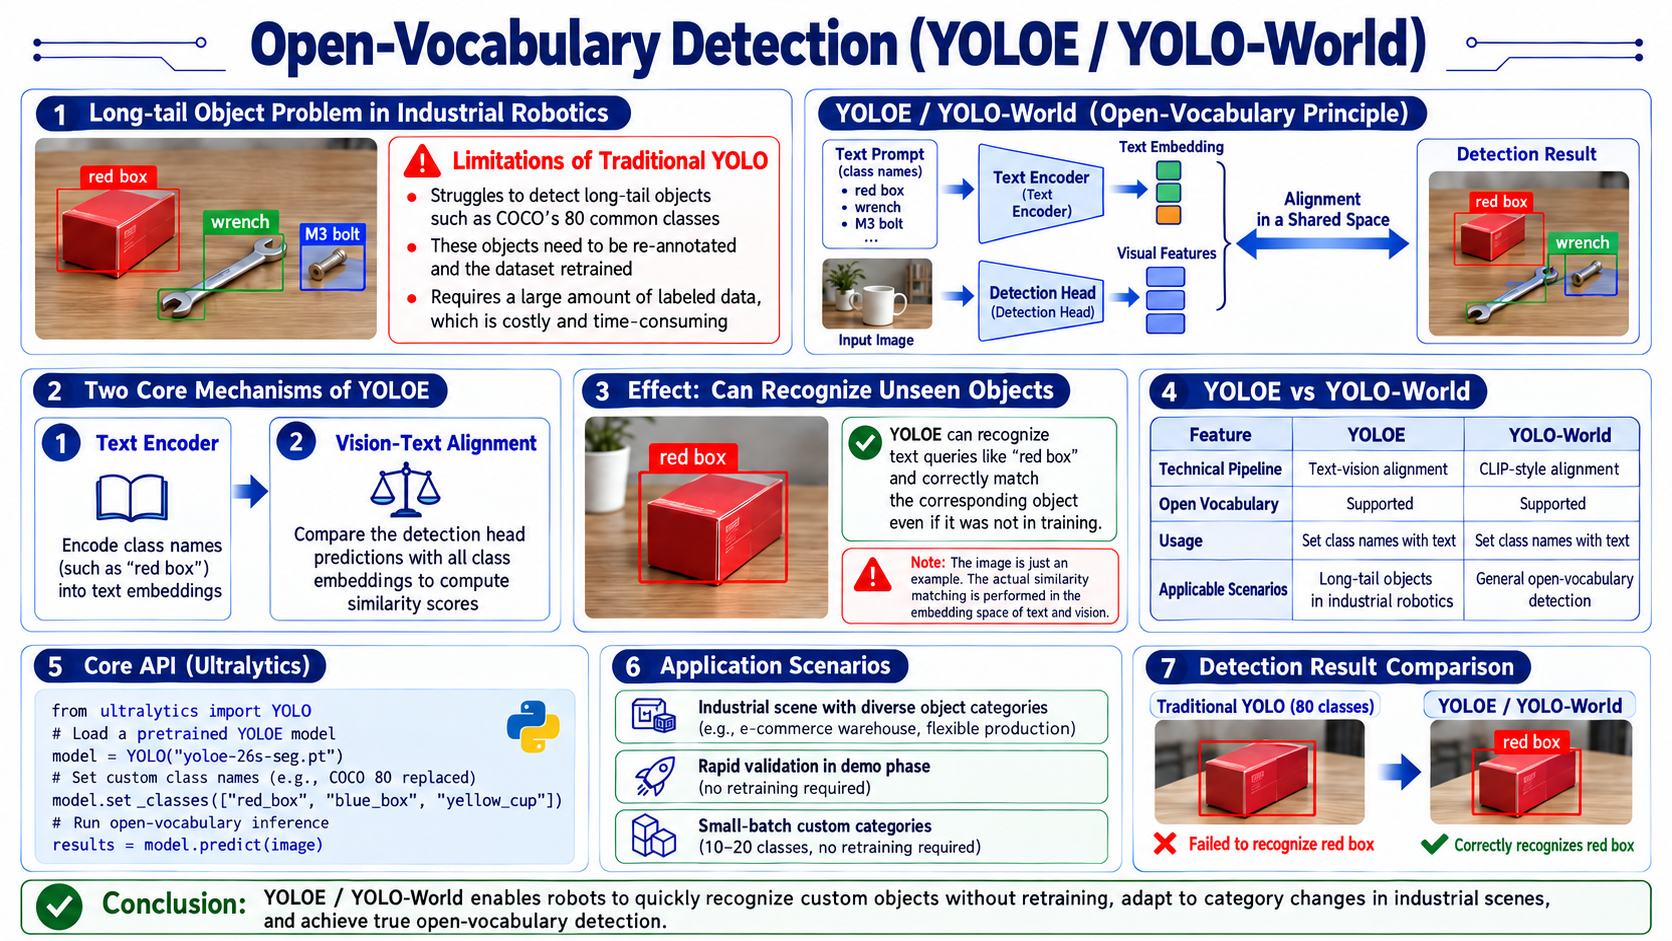
Robôs industriais frequentemente encontram objetos não cobertos pelas 80 classes do COCO: caixas de uma cor específica ("caixa vermelha"), peças personalizadas ("parafuso M3"), ferramentas colocadas temporariamente ("chave inglesa"). O YOLO tradicional precisa ser re‑treinado em um conjunto de dados (centenas de anotações) para reconhecê‑los — algo custoso.
YOLOE (YOLO com vocabulário estendido) alcança vocabulário aberto por meio de dois mecanismos:
- Codificador de texto: codifica nomes de classes (por exemplo, "caixa vermelha") em vetores semânticos;
- Alinhamento visão‑texto: a cabeça de detecção compara as caixas previstas com todas as similaridades de vetores de classe.
- O codificador de texto conhece o conceito visual por trás da frase "caixa vermelha". Mesmo que nunca tenha visto uma caixa vermelha durante o treinamento, ele pode associar o texto "caixa vermelha" à caixa vermelha na imagem. Observe que ele realiza correspondência de similaridade texto‑visual, não compreensão de linguagem verdadeira; e se o codificador de texto nunca viu uma palavra, ele não consegue entendê‑la.
YOLO-World usa uma abordagem semelhante
- YOLO-World usa alinhamento imagem‑texto no estilo CLIP para vocabulário aberto; seu princípio de funcionamento é o mesmo do YOLOE.
API principal
from ultralytics import YOLO

# load pretrained YOLOE model
model = YOLO("yoloe-26s-seg.pt")

# set custom classes (replace default 80)
model.set_classes(["red_box", "blue_box", "yellow_cup"])

# now the model detects only these three classes
results = model.predict(image)
Cenários adequados
- Cenários com braço em que há muitas mudanças de categoria (armazenagem de e-commerce, produção flexível)
- Validação rápida de demonstrações (testar sem treinamento)
- Personalização em pequenos lotes (10–20 classes, sem re‑treinamento)
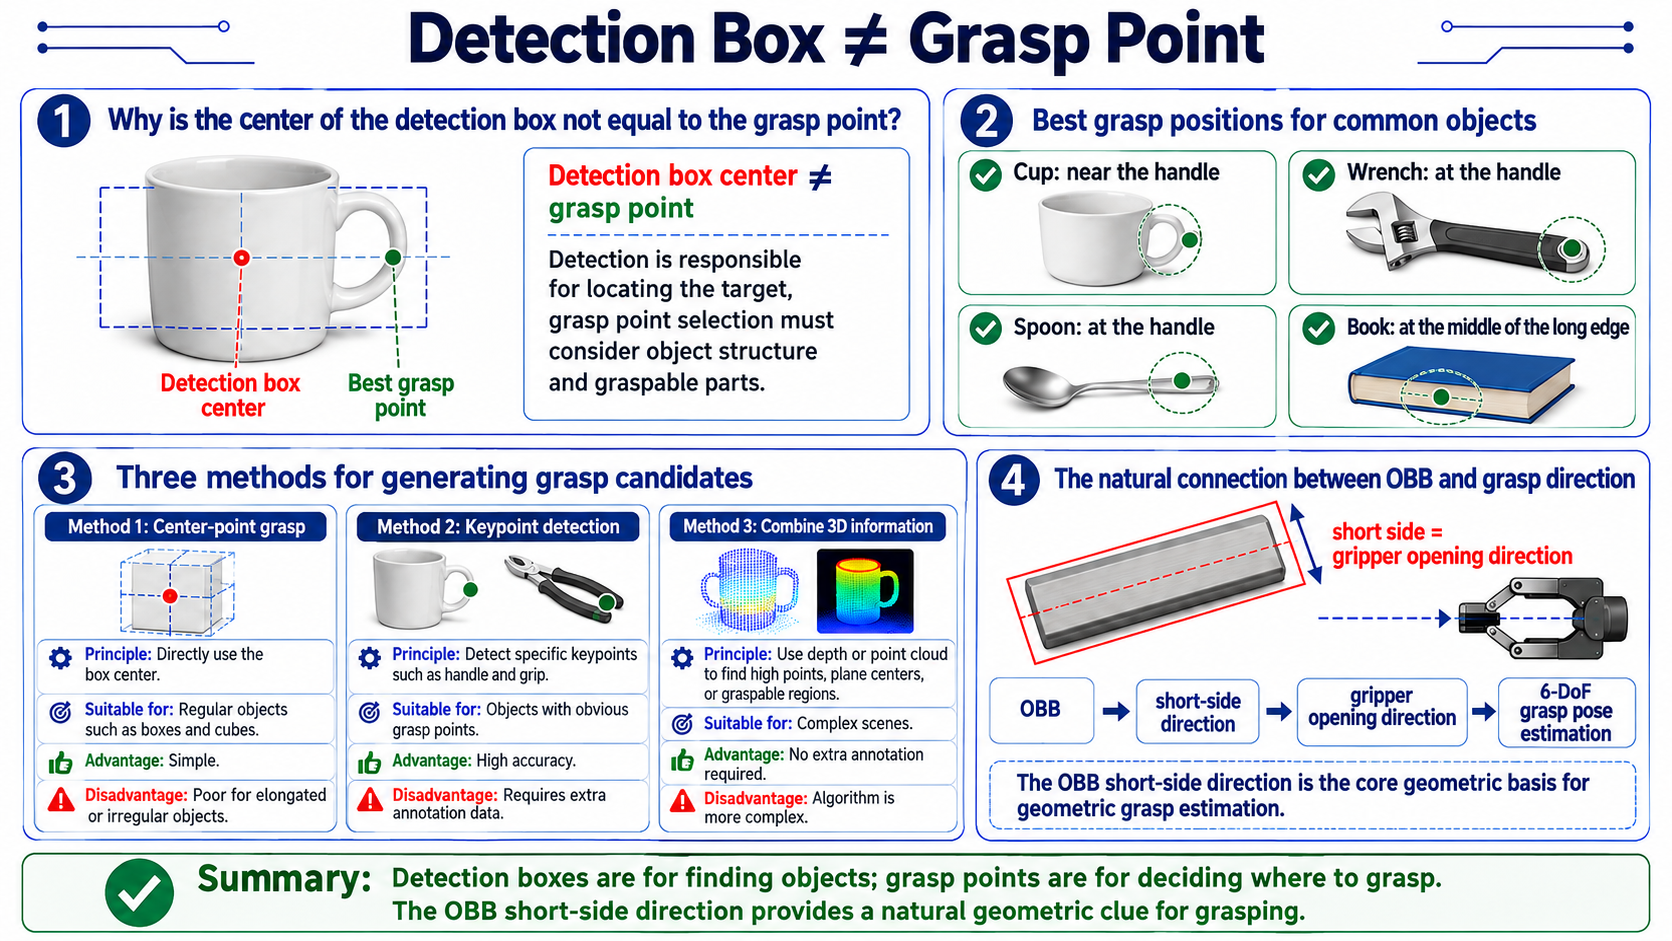
Por Que a Visão Robótica Frequentemente Usa OBB
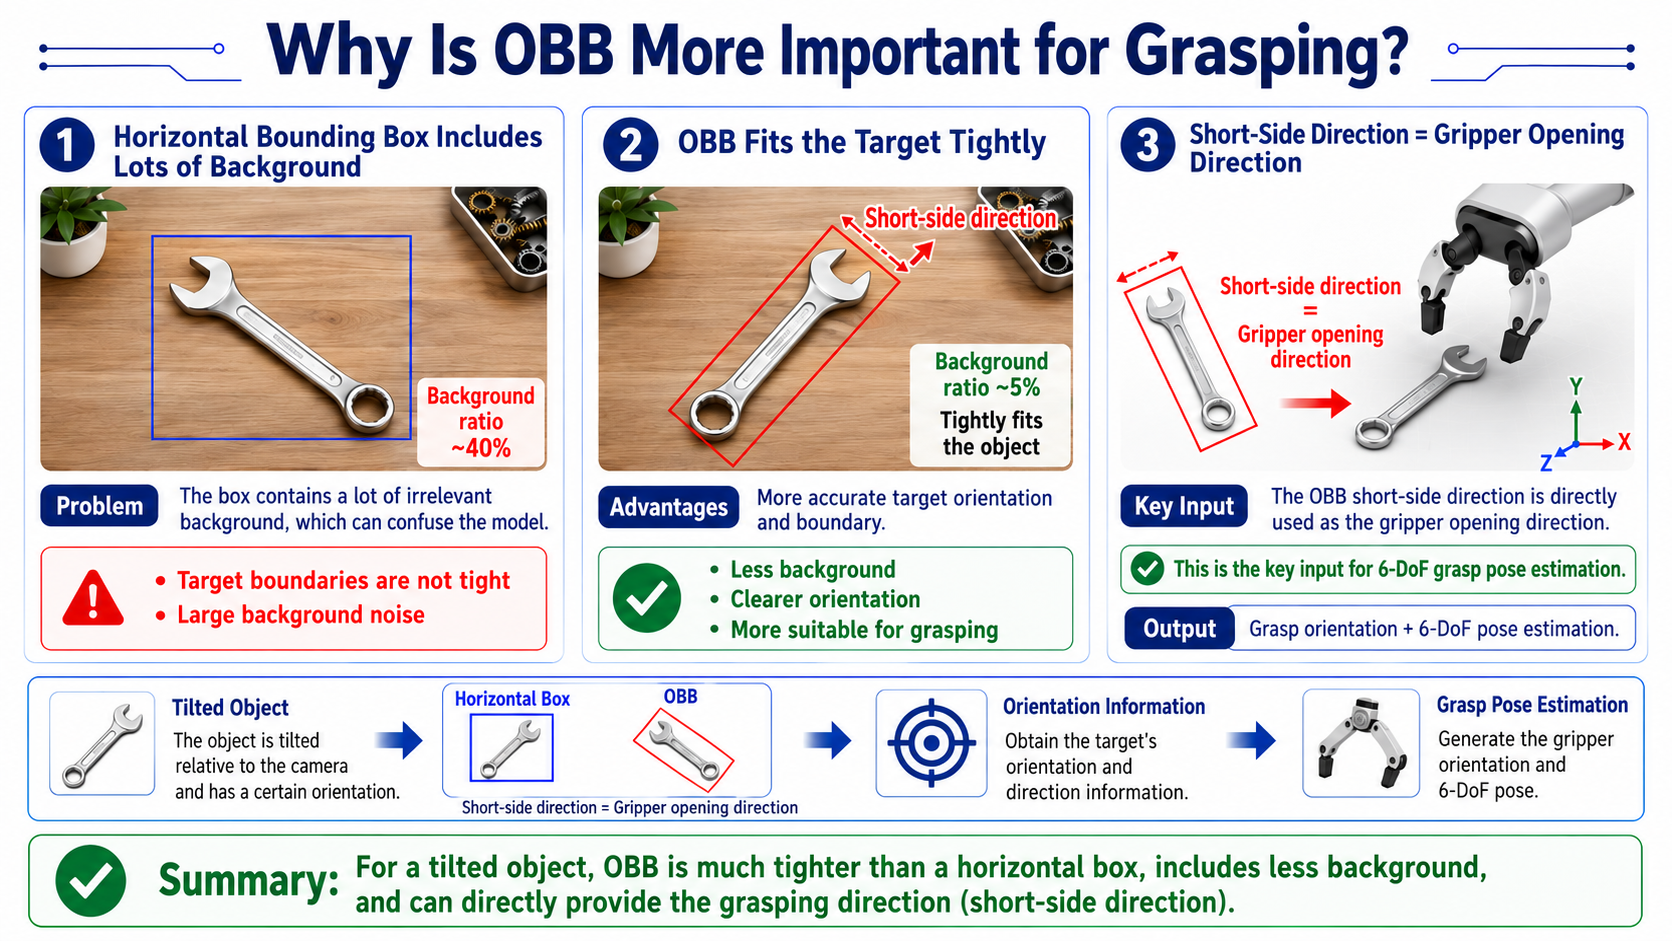
A direção da aresta curta do OBB fornece diretamente a direção de abrir/fechar do gripper — a entrada chave para a estimação de preensão 6‑DoF a jusante.
Princípios da Caixa Delimitadora Orientada (OBB)
Pós-processamento: NMS
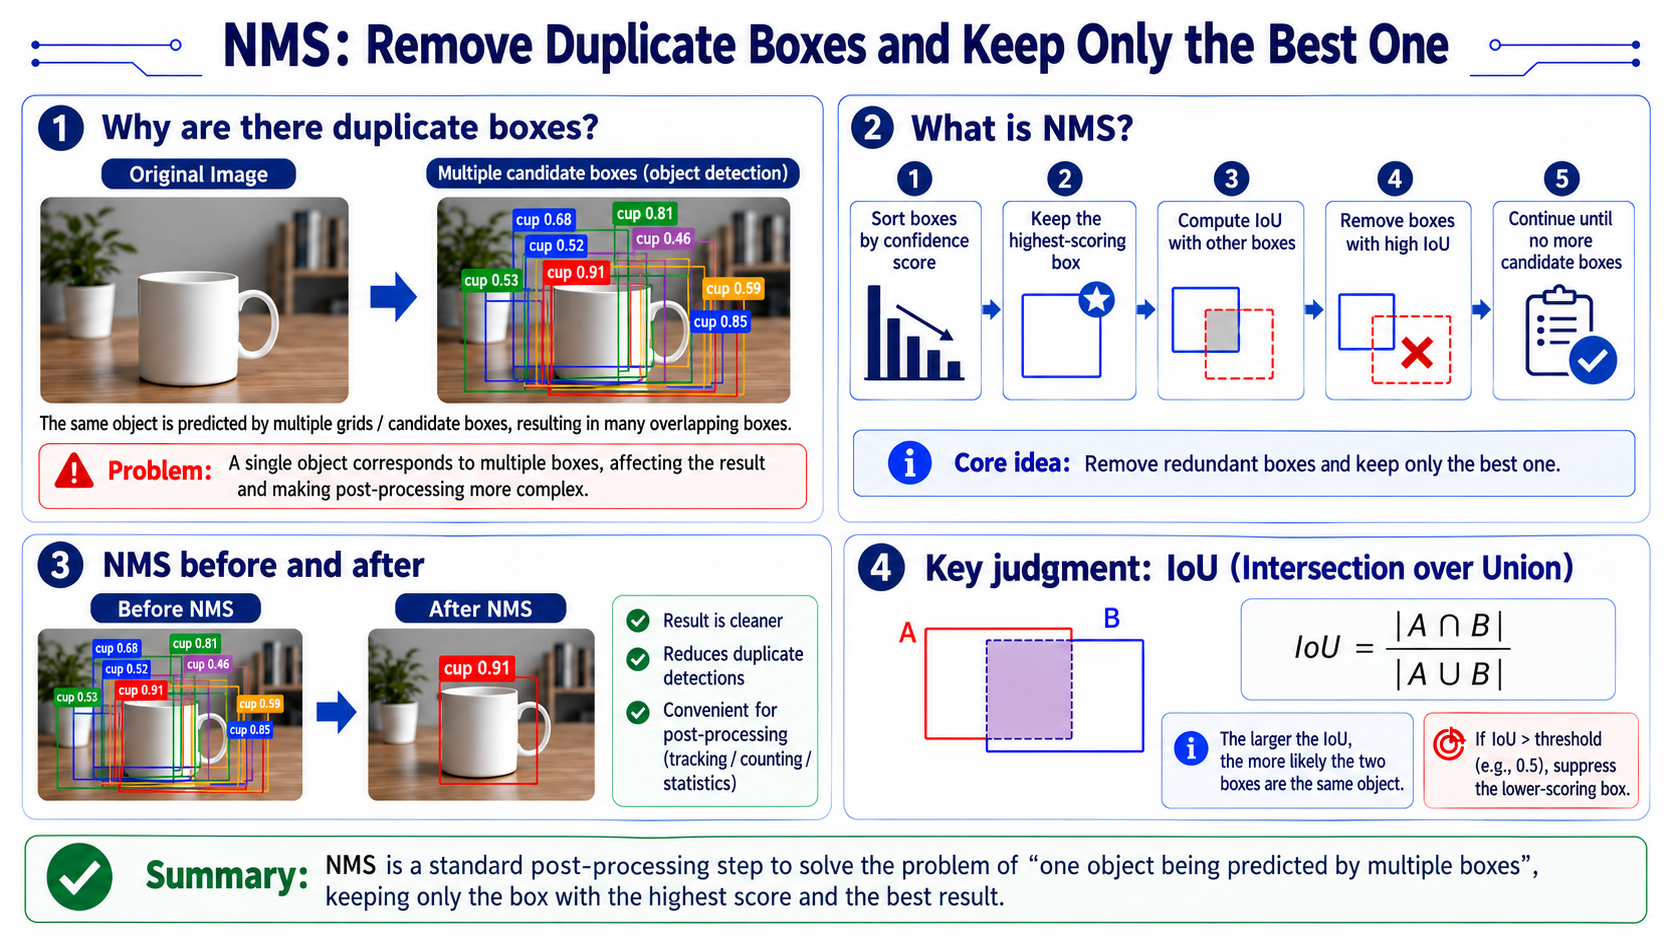
NMS é a etapa padrão pós‑detecção. Depois que o YOLO detecta uma imagem, o mesmo objeto pode ser "repetidamente" previsto por múltiplas células de grade como várias caixas sobrepostas. NMS remove esses duplicados, mantendo apenas a melhor.
-
Código de exemplo
def nms(boxes, scores, iou_threshold):
    """
    boxes: [(x1, y1, x2, y2), ...]
    scores: [confidence, ...]
    returns: list of kept indices
    """
    # 1. sort by confidence descending
    order = sorted(range(len(scores)), key=lambda i: scores[i], reverse=True)

    keep = []
    while order:
        # 2. pick the highest-scoring box
        i = order[0]
        keep.append(i)

        # 3. compute IoU with other boxes
        rest = order[1:]
        ious = [compute_iou(boxes[i], boxes[j]) for j in rest]

        # 4. keep boxes with IoU < threshold (remove redundant)
        order = [rest[j] for j, iou in enumerate(ious) if iou < iou_threshold]

    return keep
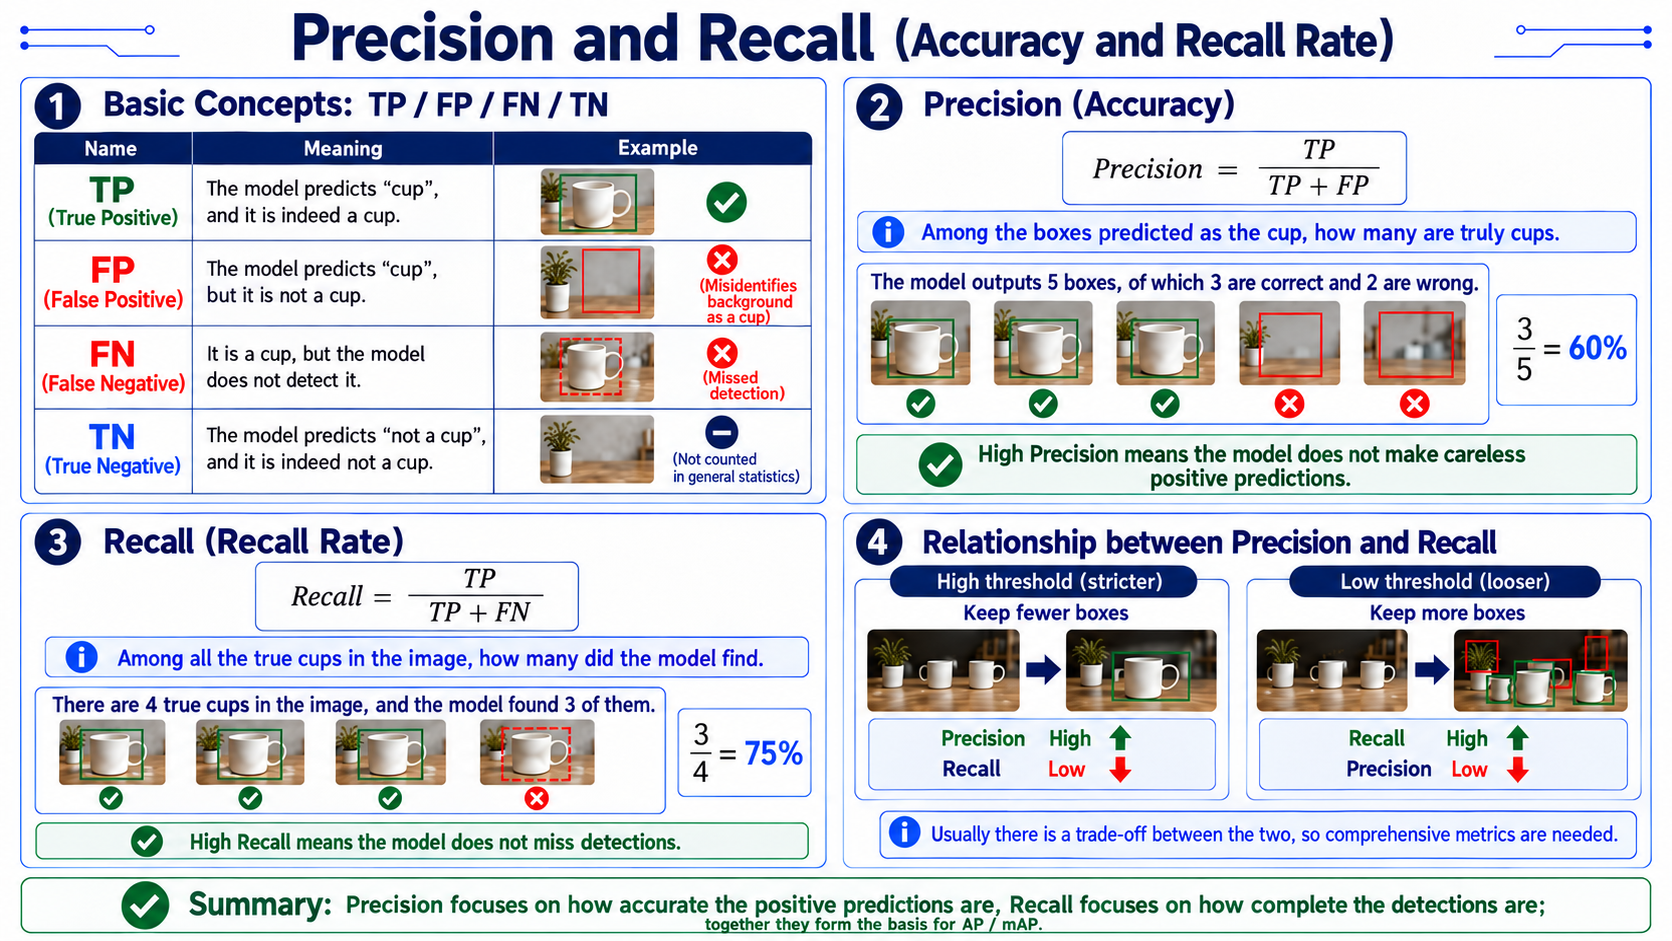
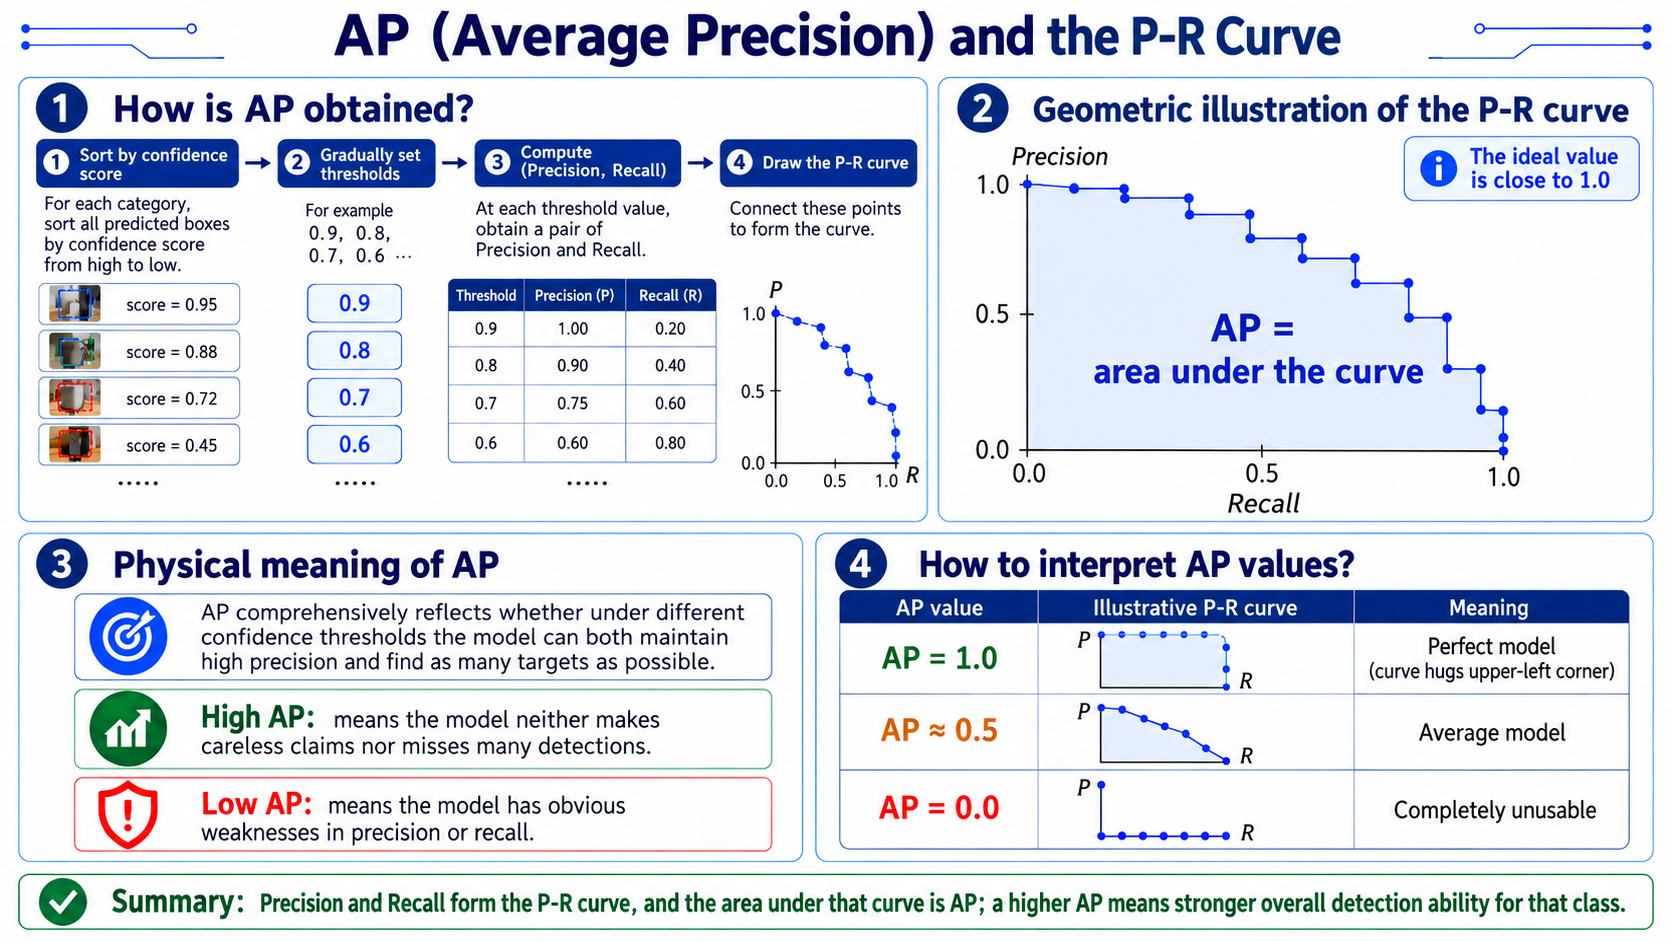
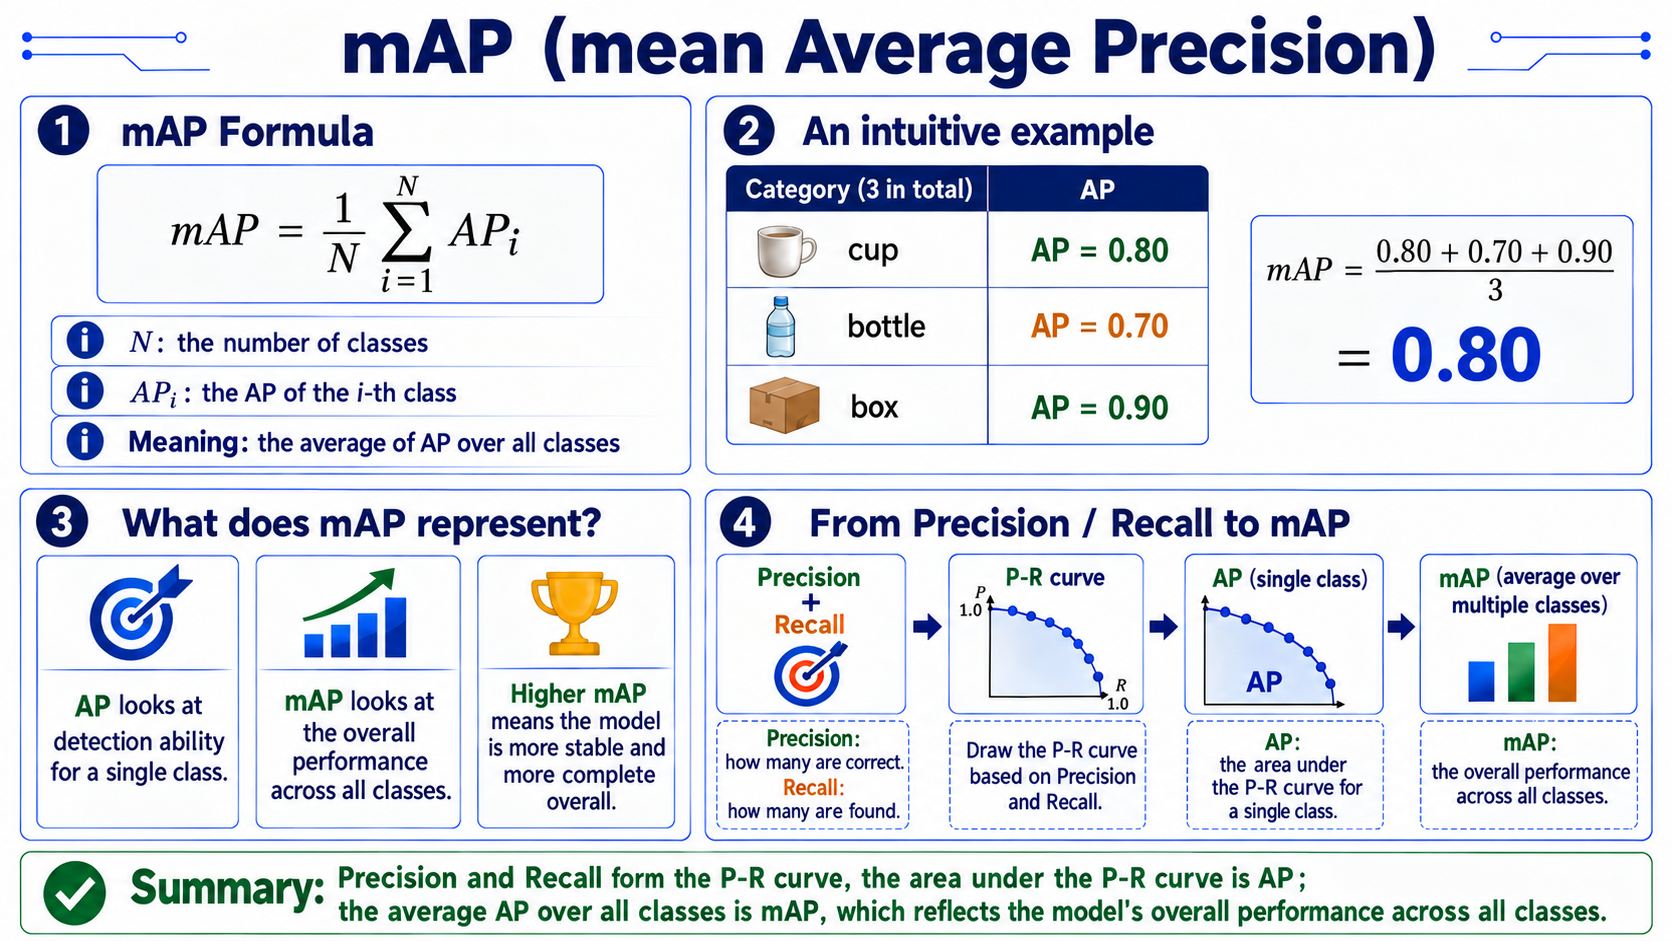
mAP (Métrica de Avaliação)
Do Resultado de Detecção à Direção de Preensão
28.4 ArUco e Calibração de Câmera
Dedução Completa: Pixels para Coordenadas 3D
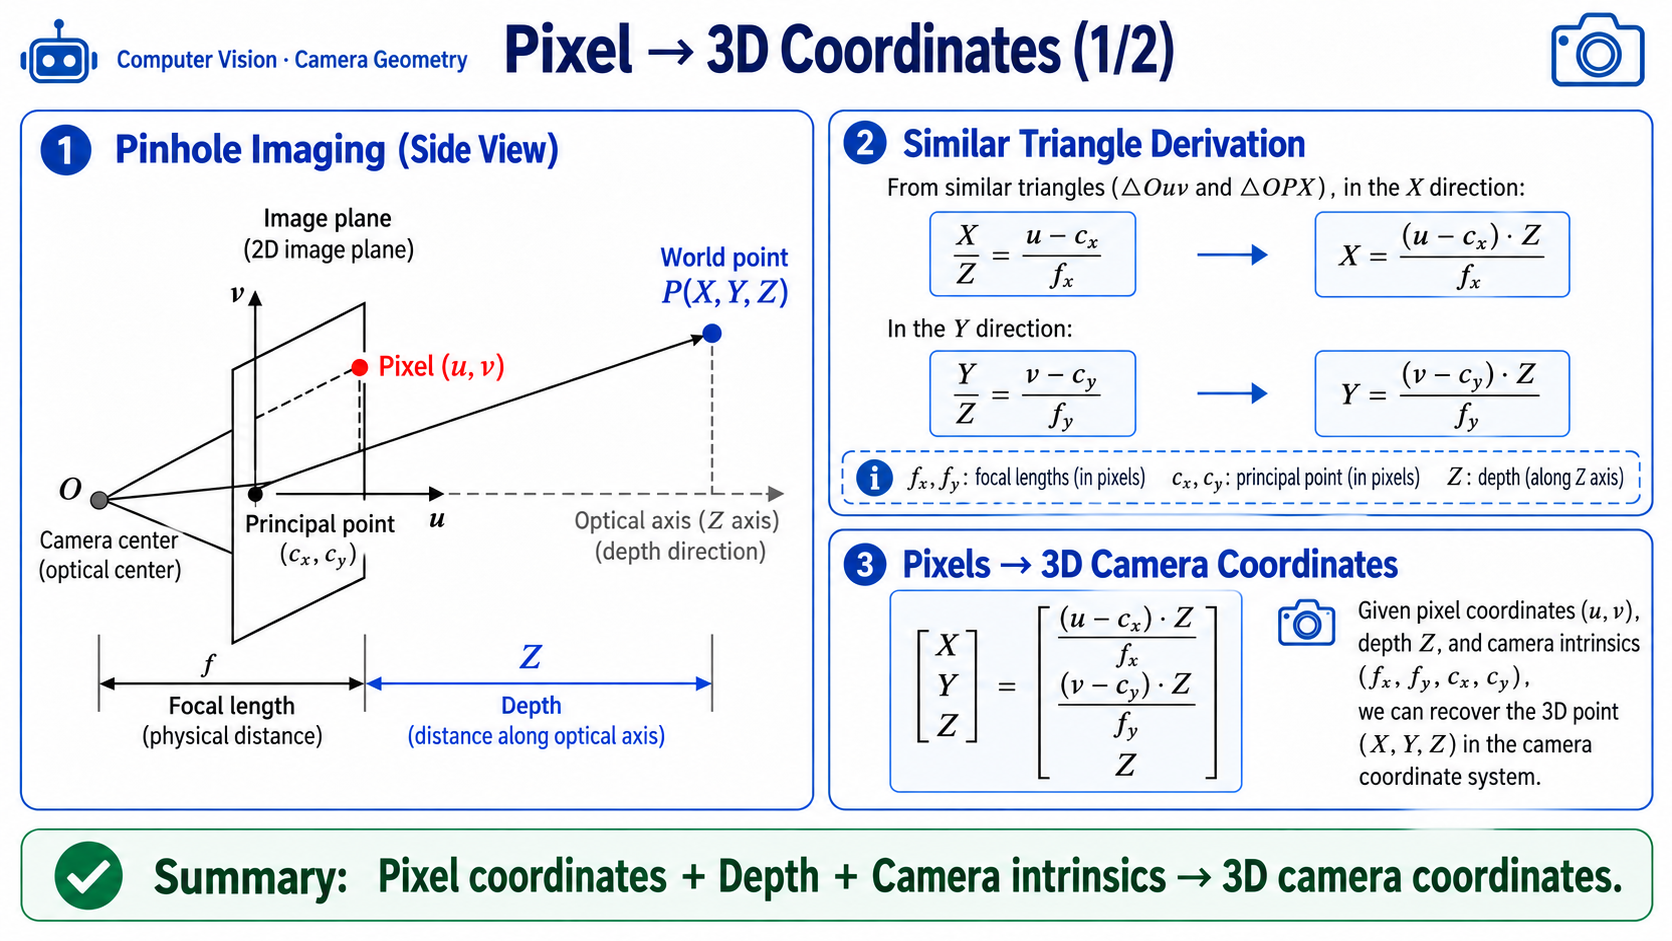
Dedução por triângulos semelhantes
-
A partir de triângulos semelhantes (eixo X do plano da imagem):
-
Reorganizando:
Análise de propagação de erro
-
Seja o erro de profundidade ; a partir da fórmula de X:
- Ou seja: quanto mais distante um pixel estiver do centro óptico (cx, cy), mais o erro de profundidade é amplificado.
- Significado físico: objetos próximos à borda da imagem têm um grande ângulo de disparidade, então um pequeno erro de profundidade afeta significativamente as estimativas de posição X, Y.
-
Exemplo numérico: seja , , , , m e o pixel .
-
A posição do objeto no referencial da câmera: (0.217, 0, 0.65) m
-
Referência de implementação:
# ordinary_grasp.py L398-403 implementation reference
def _backproject(u, v, z_m, K):
    fx, fy = float(K[0, 0]), float(K[1, 1])
    cx, cy = float(K[0, 2]), float(K[1, 2])
    x = (u - cx) * z_m / fx
    y = (v - cy) * z_m / fy
    return np.array([x, y, z_m], dtype=np.float32)
Princípios do marcador ArUco
Estrutura do marcador ArUco
Estimativa de pose ArUco (solvePnP)
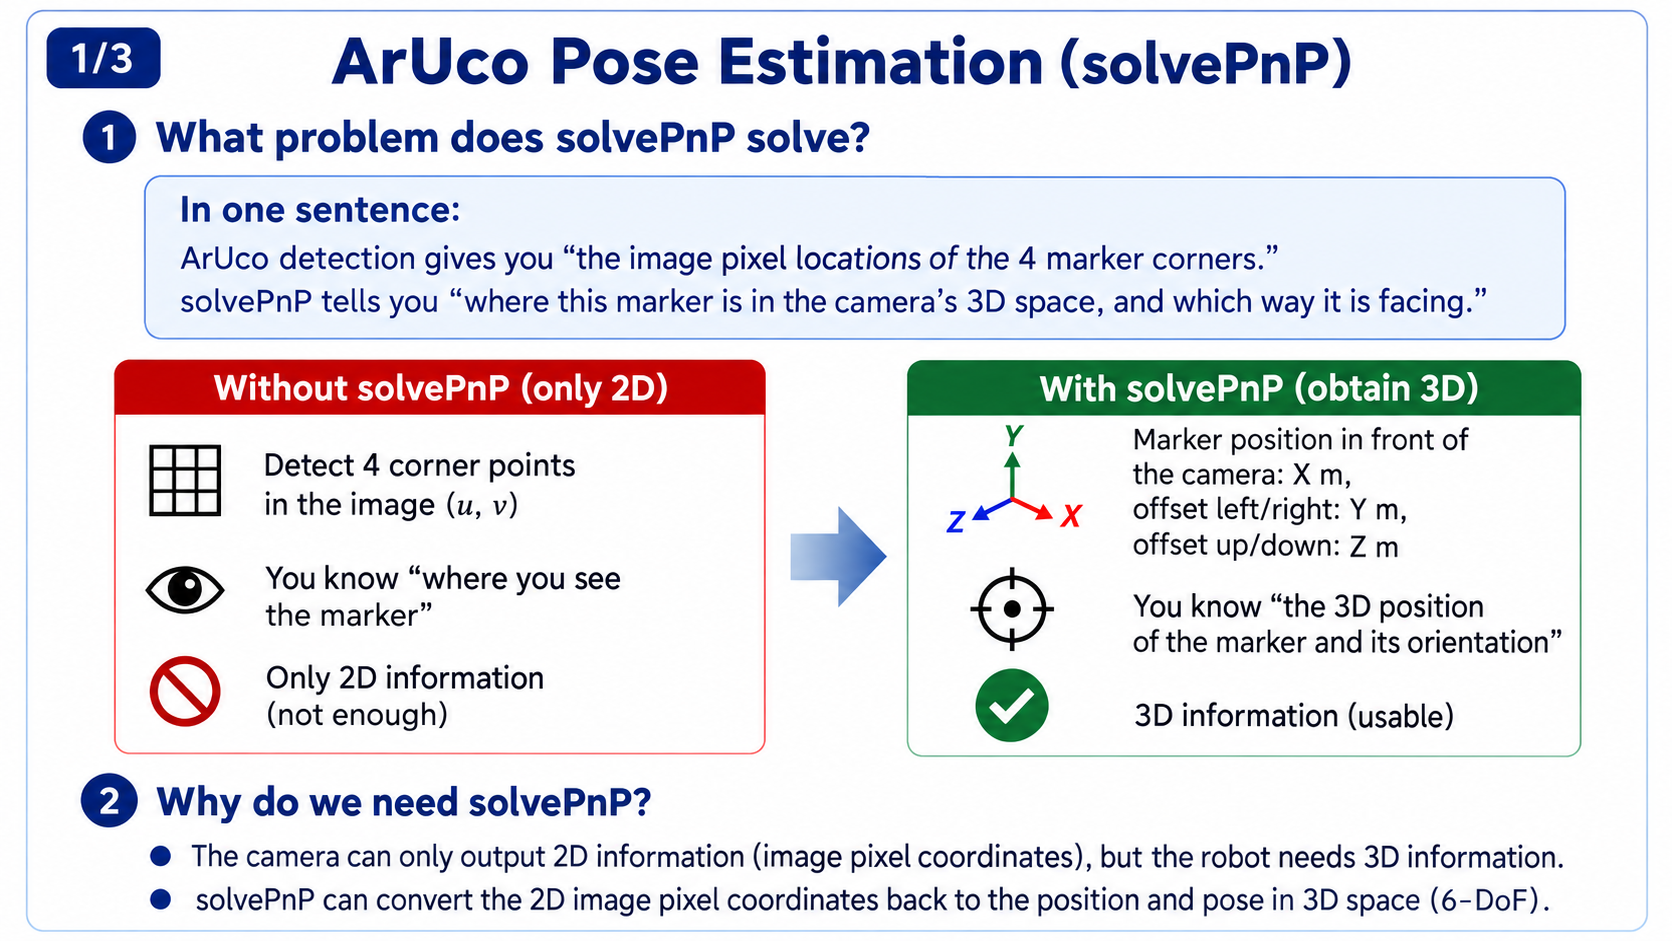
Que problema o solvePnP resolve
- Em uma frase: a detecção ArUco informa "onde estão os 4 cantos do marcador em pixels"; o solvePnP informa "onde esse marcador está no espaço 3D da câmera e como ele está orientado."
Por que o solvePnP é necessário
- A câmera só fornece informação 2D (coordenadas de pixels), mas o robô precisa de informação 3D:
- Lembre-se da calibração mão-olho. Sua equação é AX = XB, onde B é a transformação de marcador para câmera, T_marker2cam — e B é obtido exatamente pela detecção dos cantos ArUco seguida de solvePnP. Sem solvePnP não existe B; sem B você não pode resolver X; a calibração mão-olho não pode prosseguir.
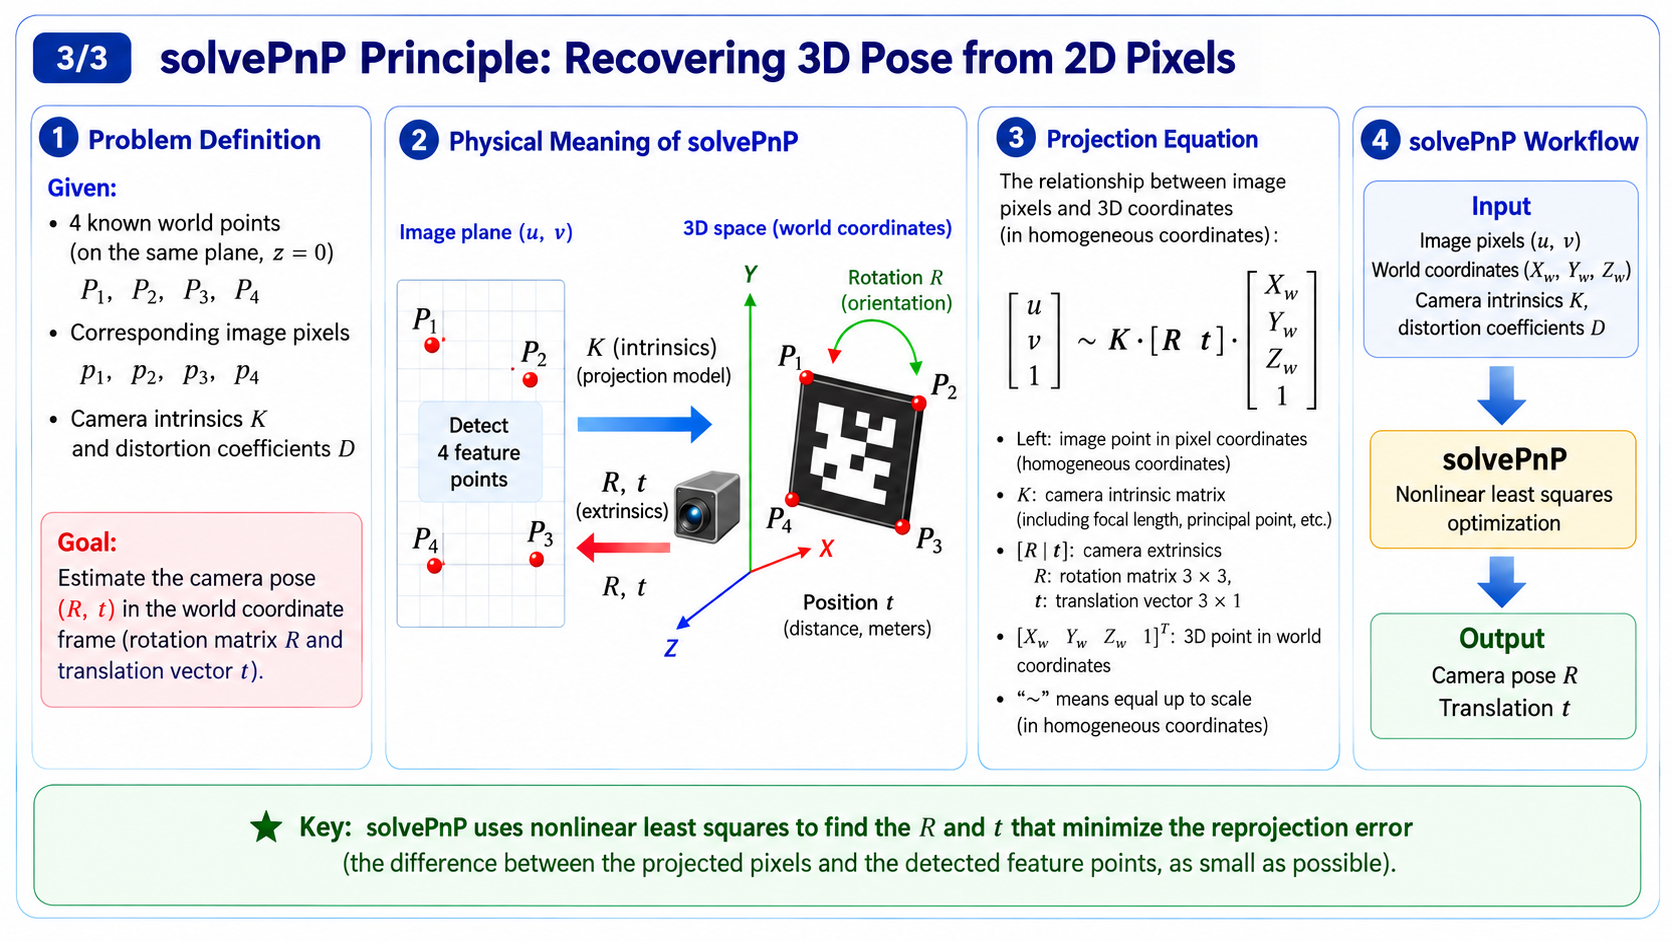
Significado físico do solvePnP
- Dadas coordenadas de mundo 3D (um referencial 3D fixo descrevendo "onde o canto do marcador está no espaço real" com 3 números (X, Y, Z), em unidades reais de comprimento cm/m), as correspondentes coordenadas de pixel 2D (um referencial de imagem 2D descrevendo "onde esse canto caiu na imagem" com 2 números (u, v)), e as intrínsecas da câmera K, o solvePnP deduz de volta a rotação R e a translação t da câmera. Internamente ele usa otimização de mínimos quadrados, minimizando o erro de projeção; a saída é a pose do marcador em relação à câmera.
28.5 Aprofundamento: Calibração Mão-Olho
Significado geométrico de AX = XB
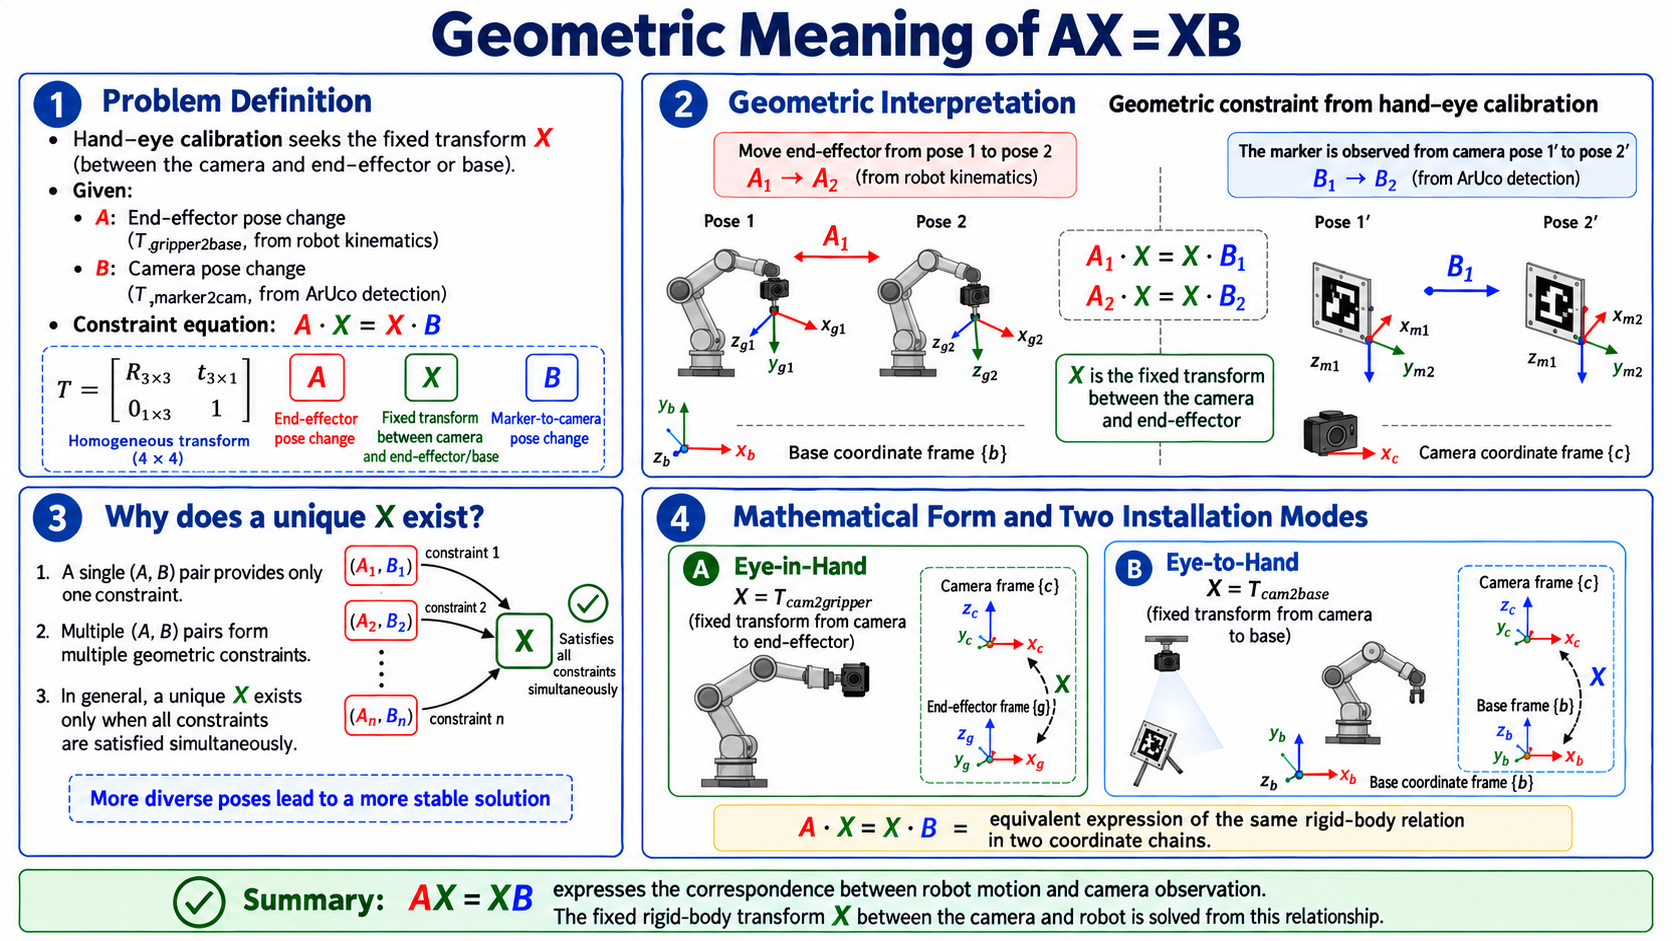
Definição do problema
-
A calibração mão-olho resolve X (a transformação fixa entre câmera e extremidade ou base), dado:
- A: transformação de extremidade para base (T_gripper2base, a partir da cinemática direta do braço)
- B: transformação de marcador para câmera (T_marker2cam, a partir da detecção ArUco)
-
Equação de restrição:
-
X é a matriz mão-olho — uma transformação homogênea 4x4 que descreve a pose fixa (orientação + posição) do referencial da câmera em relação ao referencial da extremidade do braço.
- Ela contém uma matriz de rotação 3x3 R_X (orientação) e uma translação 3x1 t_X (posição);
- Ângulos de Euler são apenas outra "leitura" de R_X — a mesma orientação pode ser uma matriz de rotação ou ângulos de Euler, e é possível converter de um para o outro.
Interpretação geométrica
Geometricamente a restrição é simples. A extremidade se move da pose 1 para a pose 2, (registrado pelo braço), enquanto a câmera vê o marcador se mover de para , (detecção ArUco). é a transformação fixa entre a câmera e a extremidade (câmera na extremidade), então a mesma relação rígida precisa valer em toda pose:
Múltiplos pares (A, B) fornecem múltiplas restrições; geometricamente apenas um X satisfaz todas elas.
Forma matemática
- Eye-in-Hand: resolver X = T_cam2gripper (pose fixa da câmera em relação à extremidade)
- Eye-to-Hand: resolver X = T_cam2base (pose fixa da câmera em relação à base)
- Na implementação, cada par (A, B) amostrado é armazenado; quando há amostras suficientes, um solucionador de calibração resolve todos em conjunto.
Fundamentos matemáticos de transformações de corpo rígido
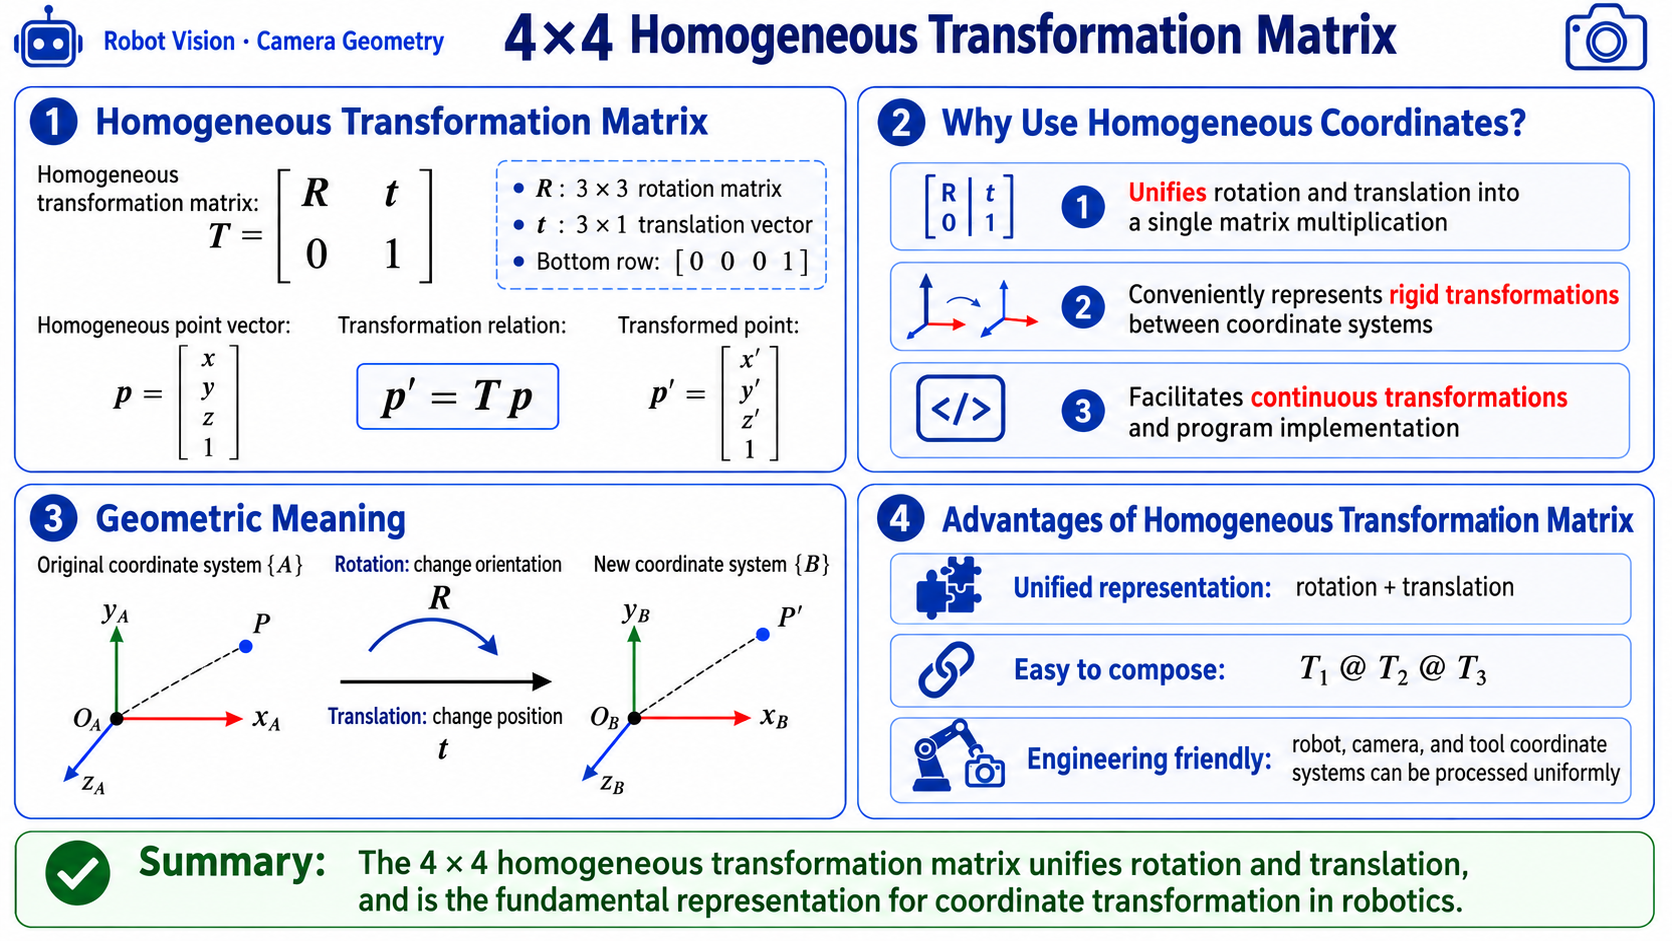
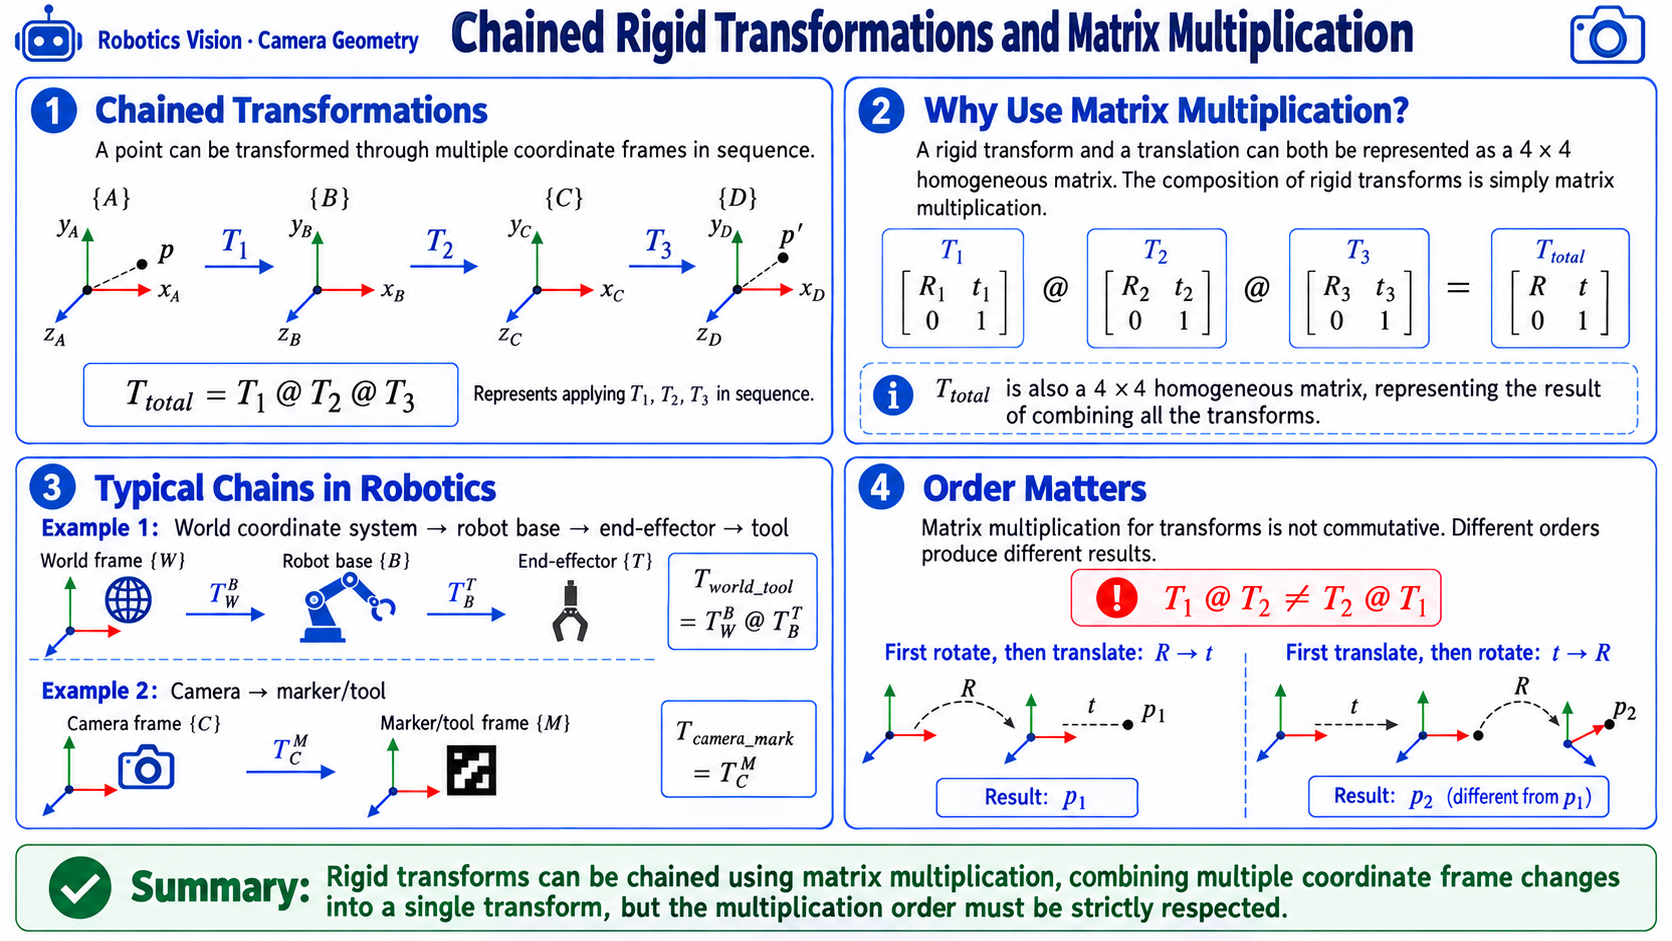
Matriz de transformação homogênea 4x4
T = [ R   t ]    R: 3x3 rotation matrix
    [ 0   1 ]    t: 3x1 translation vector
Vantagens das transformações homogêneas:
- Unificam rotação e translação em uma única multiplicação de matrizes
- Podem ser encadeadas: T1 @ T2 @ T3 significa transformações sucessivas através de T1, T2, T3. Mas observe: a multiplicação de matrizes é não comutativa — ordens diferentes produzem resultados completamente diferentes — "rotacionar 90 graus e depois transladar" não é o mesmo que "transladar e depois rotacionar 90 graus."
Três representações de rotação
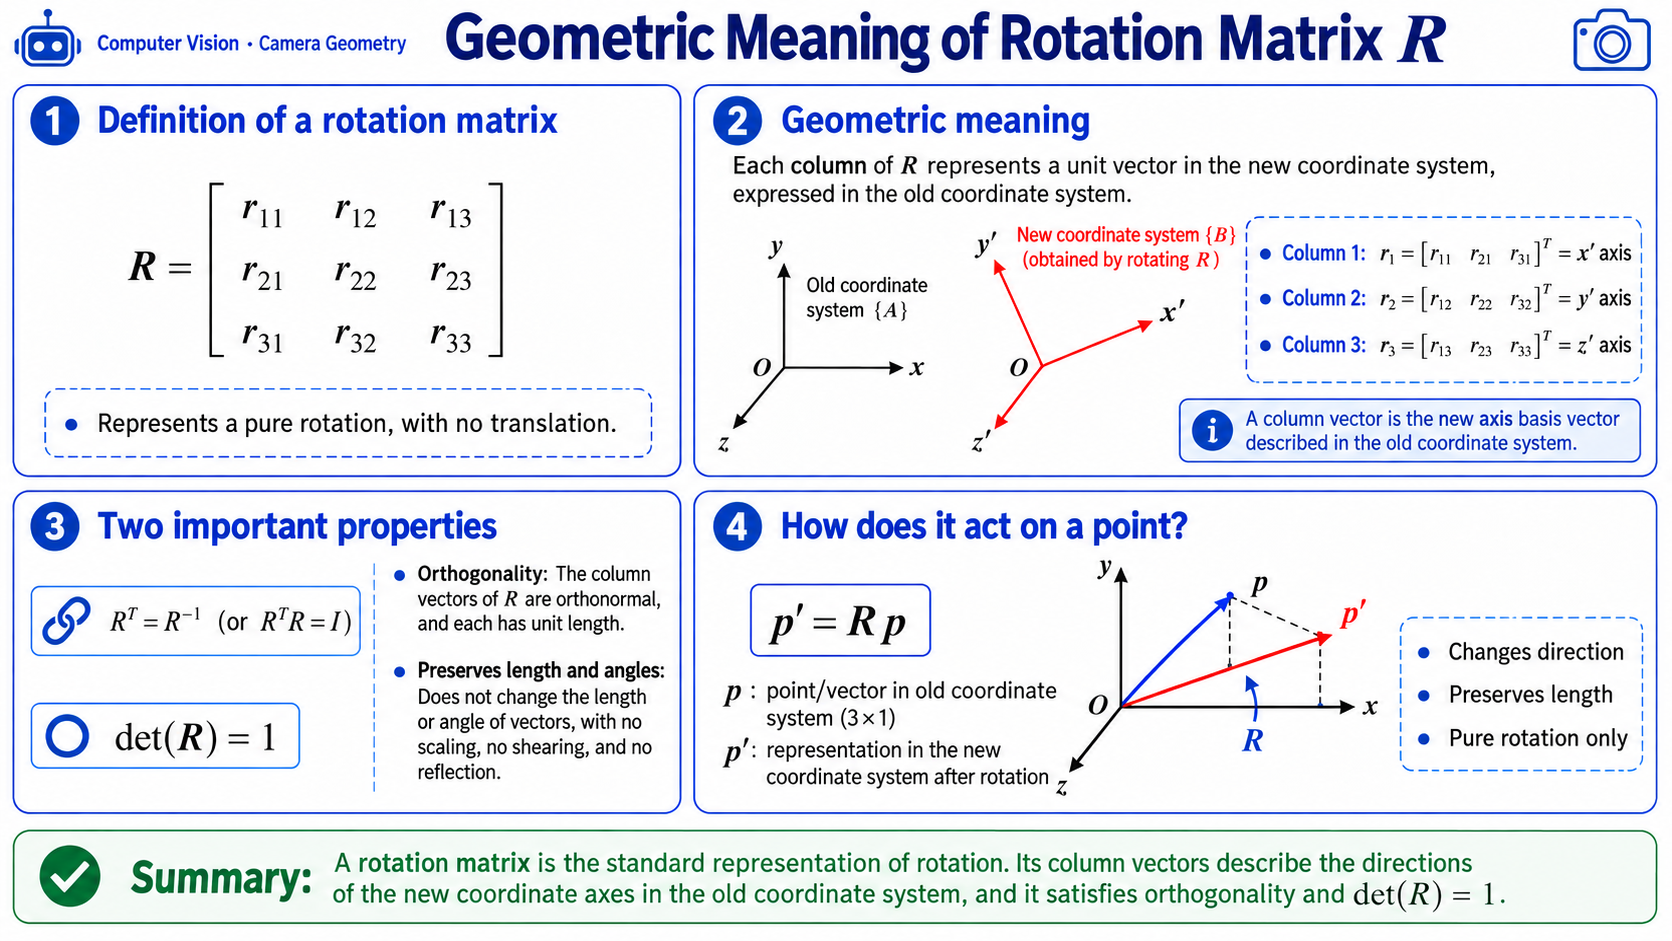
- Matriz de rotação R
-
Propriedades:
- R^T = R^(-1) (ortogonalidade)
- det(R) = 1
[diagram: geometric meaning of R]

R = [ r11 r12 r13 ]    each column is a basis vector
    [ r21 r22 r23 ]    expressed in the new frame
    [ r31 r32 r33 ]
-
-
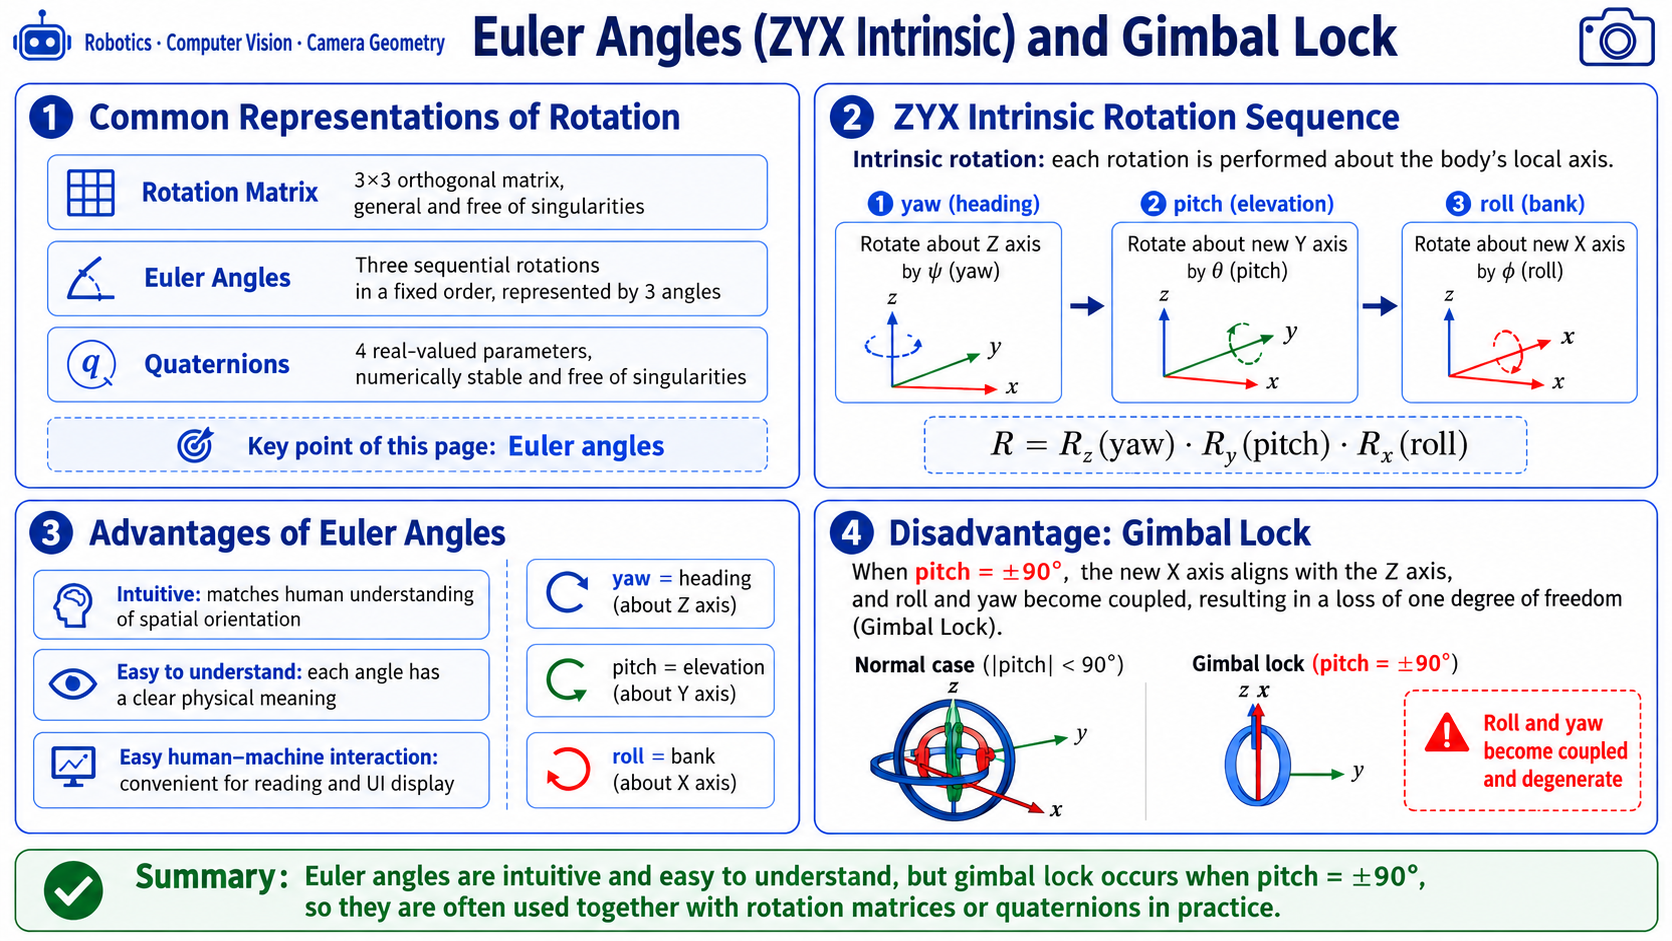
Ângulos de Euler (intrínsecos ZYX)
-
Implementação: rotacionar em torno de Z (yaw) -> em torno do novo Y (pitch) -> em torno do novo X (roll):
# transforms.py L32-72 implementation reference
def pose6d_to_mat4(x, y, z, rx, ry, rz, degrees=False):
    if degrees:
        rx, ry, rz = np.radians(rx), np.radians(ry), np.radians(rz)

# Rotation around X (roll)
    Rx = np.array([
        [1,          0,           0],
        [0,  np.cos(rx), -np.sin(rx)],
        [0,  np.sin(rx),  np.cos(rx)],
    ])
# Rotation around Y (pitch)
    Ry = np.array([
        [ np.cos(ry), 0, np.sin(ry)],
        [          0, 1,          0],
        [-np.sin(ry), 0, np.cos(ry)],
    ])
# Rotation around Z (yaw)
    Rz = np.array([
        [np.cos(rz), -np.sin(rz), 0],
        [np.sin(rz),  np.cos(rz), 0],
        [         0,           0, 1],
    ])

# Intrinsic ZYX rotation: R = Rz @ Ry @ Rx
    R = Rz @ Ry @ Rx

    T = np.eye(4, dtype=np.float64)
    T[:3, :3] = R
    T[:3, 3] = [x, y, z]
    return T
-
-
Singularidade (gimbal lock):
-
Ângulos de Euler têm uma armadilha famosa chamada "gimbal lock": quando o pitch é +/-90 graus, os eixos X e Z coincidem, roll e yaw se degeneram, os graus de liberdade caem de 3 para 2, e a representação da pose deixa de ser única. Portanto, próximo às singularidades o código usa uma fórmula alternativa — é por isso que ângulos de Euler são frequentemente usados em conjunto com matrizes de rotação ou quaternions em engenharia.
# transforms.py L110-122 implementation (handling singularities)
def rotation_matrix_to_euler_zyx(R):
    R = _nearest_rotation_matrix(R)
    sy = np.sqrt(R[0, 0] ** 2 + R[1, 0] ** 2)
    if sy > 1e-6:
        rx = np.arctan2(R[2, 1], R[2, 2])
        ry = np.arctan2(-R[2, 0], sy)
        rz = np.arctan2(R[1, 0], R[0, 0])
    else:
# near singularity, use fallback formula
        rx = np.arctan2(-R[1, 2], R[1, 1])
        ry = np.arctan2(-R[2, 0], sy)
        rz = 0.0
    return np.array([rx, ry, rz], dtype=np.float64)
-
Eye-in-Hand vs Eye-to-Hand
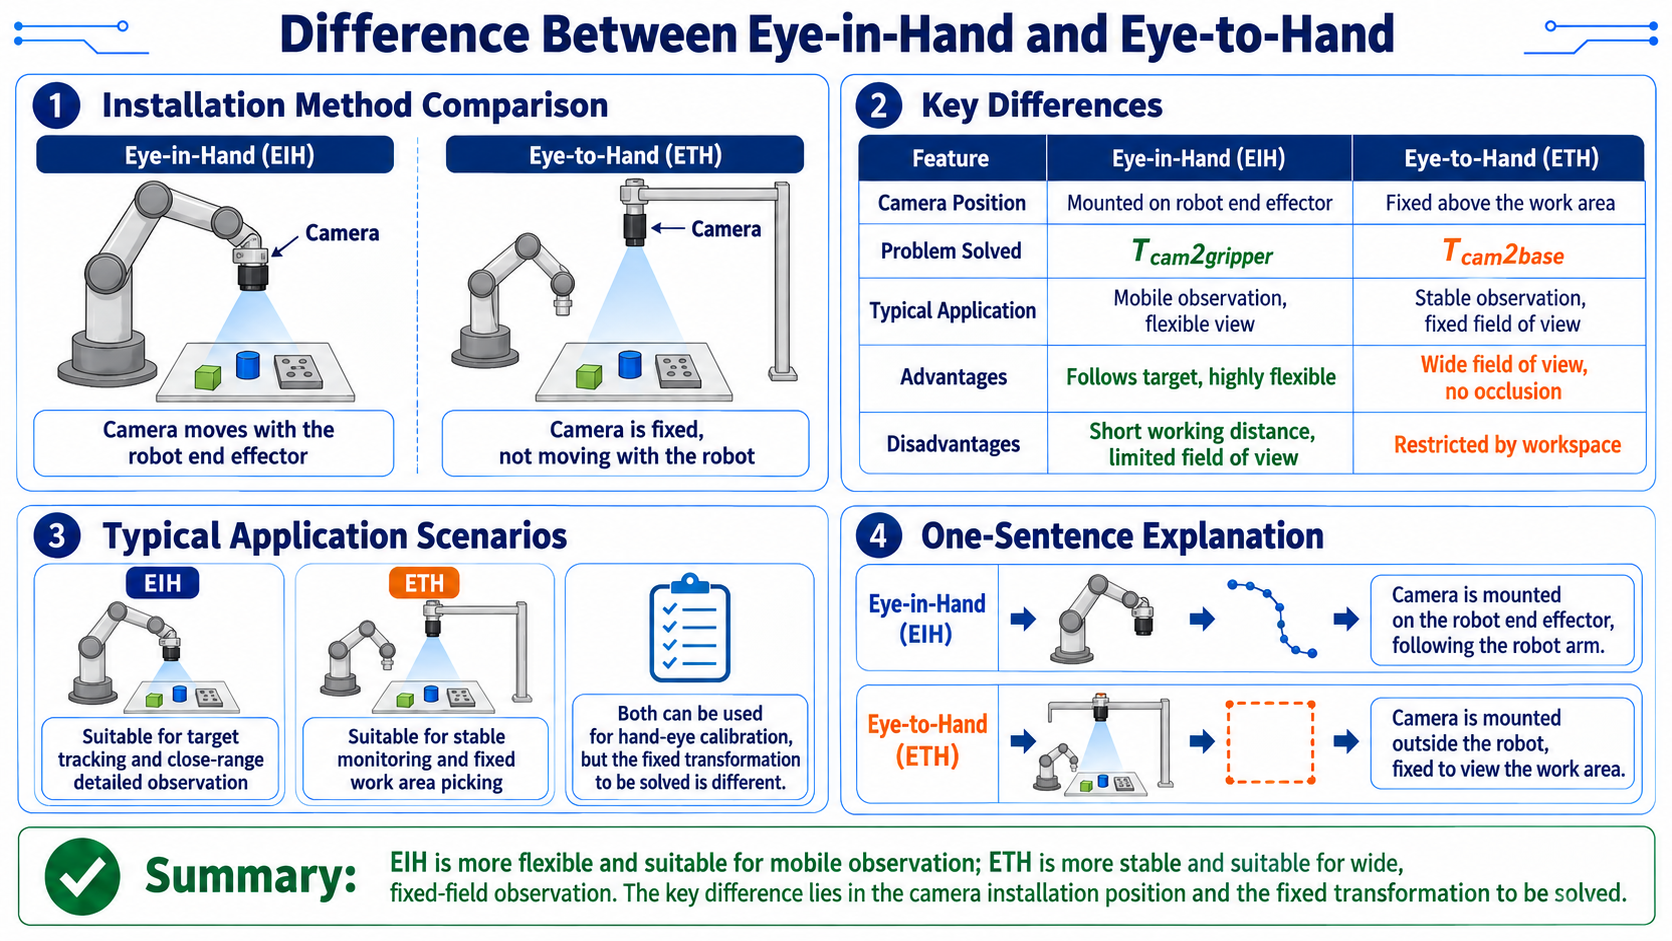
[diagram: EIH vs ETH mounting]

Eye-in-Hand:
  arm end -- camera -- looking at workspace
  camera moves with the end

Eye-to-Hand:
  above workspace -- camera -- looking down
  camera fixed, does not move with the end
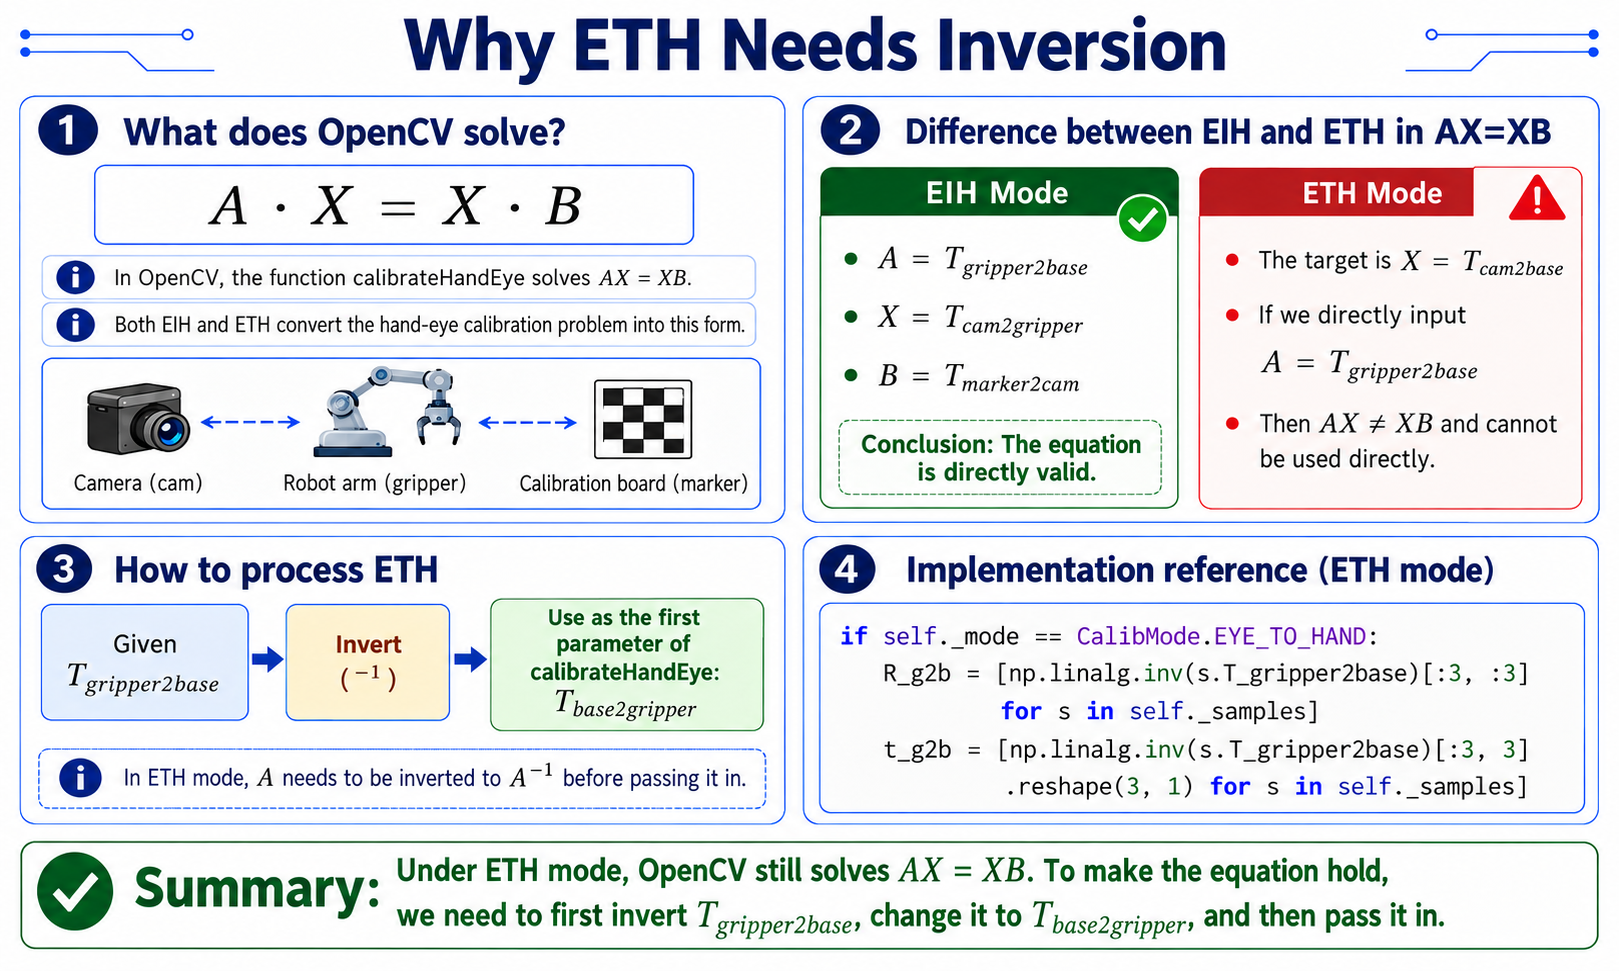
Tratamento especial para ETH (tomando a inversa)
Implementação:
# hand_eye.py L110-114 implementation (ETH mode: invert A)
if self._mode == CalibMode.EYE_TO_HAND:
# OpenCV calibrateHandEye solves AX=XB; in ETH mode, invert
# T_gripper2base and pass it as the first argument; it returns T_cam2base.
    R_g2b = [np.linalg.inv(s.T_gripper2base)[:3, :3] for s in self._samples]
    t_g2b = [np.linalg.inv(s.T_gripper2base)[:3, 3].reshape(3, 1) for s in self._samples]
Por que ETH precisa da inversa:
- O
calibrateHandEyedo OpenCV resolve AX=XB internamente. - Modo EIH: A é T_gripper2base (movimento da extremidade), X é T_cam2gripper (câmera-ferramenta fixa), B é T_marker2cam. A equação vale diretamente.
- Modo ETH: A ainda é T_gripper2base, mas X é T_cam2base (câmera-base fixa). Então AX != XB diretamente; você deve inverter A antes de passá-la.
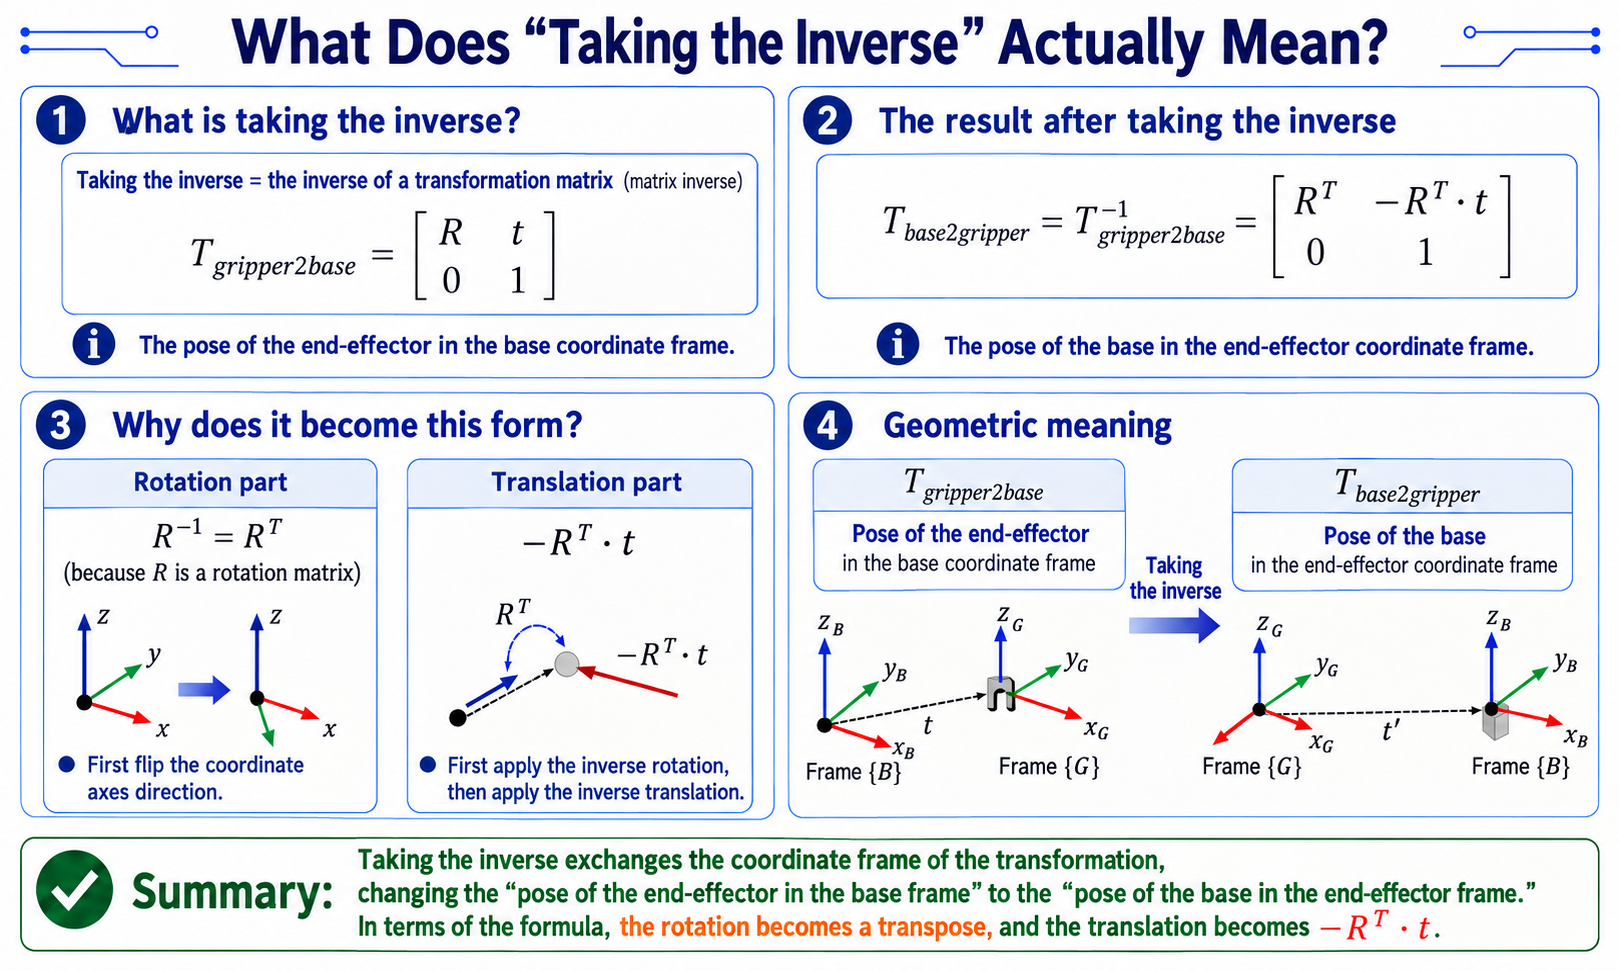
O que significa "tomar a inversa"
-
"Tomar a inversa" = inversa de matriz. No modo ETH, o OpenCV não aceita
T_gripper2base; ele querT_base2gripper, então você toma a inversa da matriz.# what we have (arm FK output)
T_gripper2base = [R t] # end pose (in base frame)
[0 1]
# what OpenCV ETH mode wants (after inversion)
T_base2gripper = T_gripper2base^-1 = [R^T -R^T.t] # base in end frame
[0 1 ] -
Parte de rotação: inversa de R = transposta de R (R é ortogonal)
-
Parte de translação: -R^T . t (primeiro "des-rotacionar", depois "des-transladar")
-
Significado geométrico: "pose da extremidade no referencial da base" torna-se "pose da base no referencial da extremidade" após a inversão.
Princípios de Projeto das Poses de Calibração
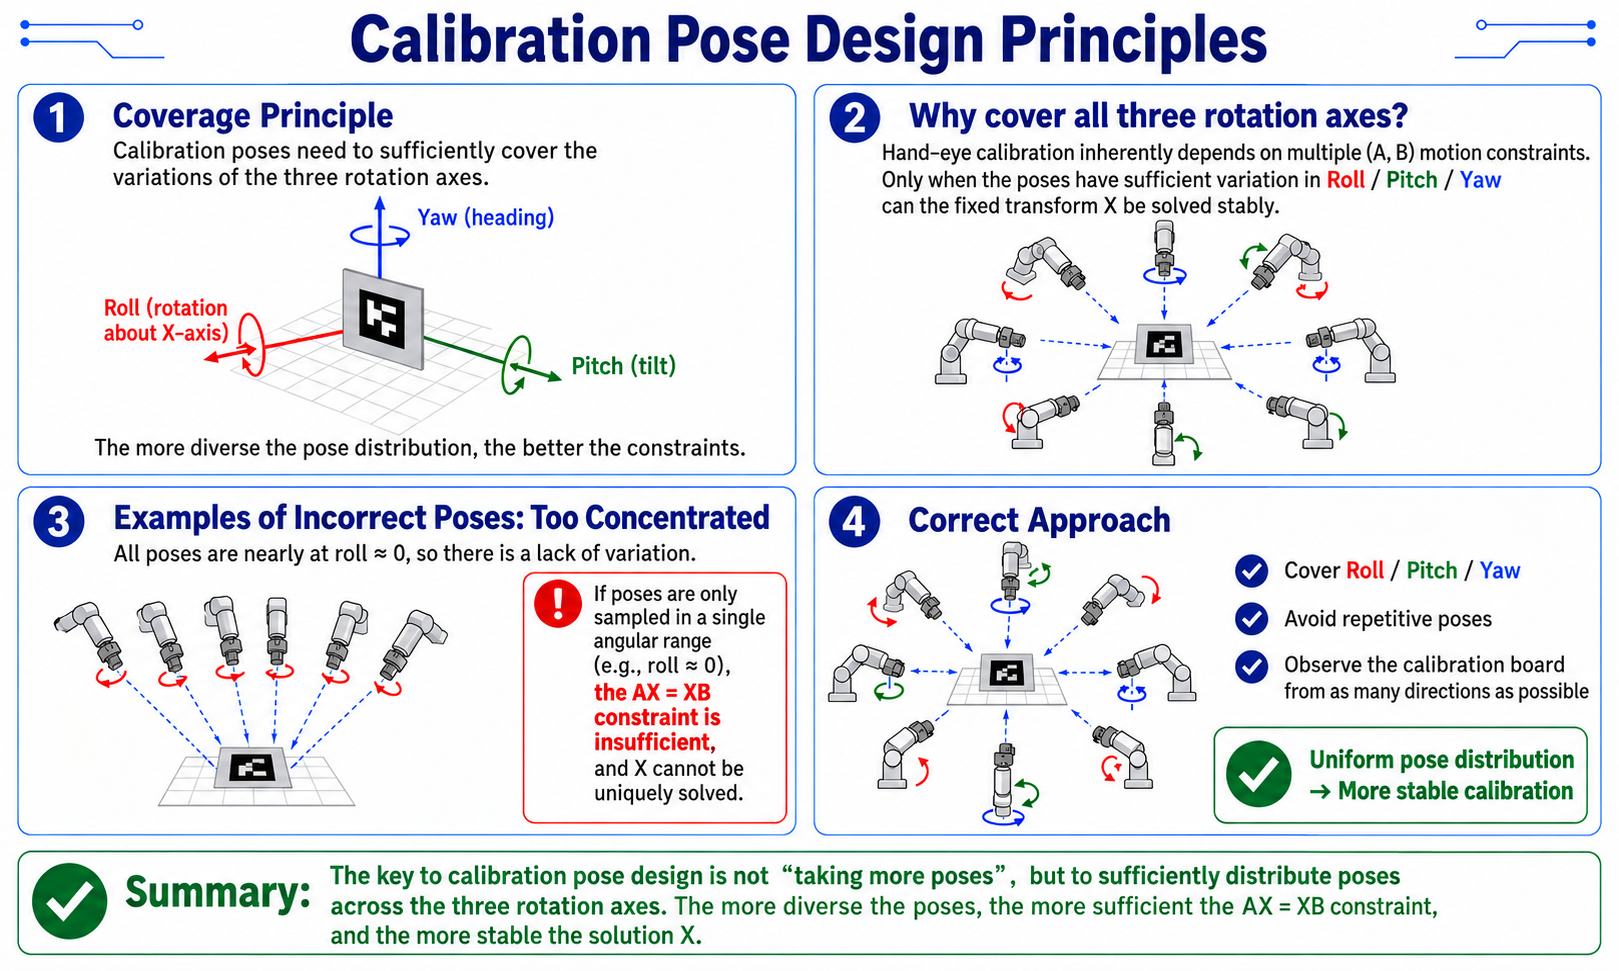
Princípio de cobertura
-
As poses de calibração devem cobrir variações em todos os três eixos de rotação:
[diagram: calibration pose distribution]

      Roll ^
           |
   +-------+-------+
   |       |       |
   |  Yaw -+-->    |
   |       |       |
   +-------+-------+
           |
v Pitch -
Se as poses forem limitadas a uma única faixa angular (por exemplo, todo roll ~ 0), AX=XB fica subdeterminado e X não é único. Portanto, durante a calibração as poses do braço devem envolver variações de Roll, Pitch e Yaw.
Cadeia de Transformações de Coordenadas Após a Calibração
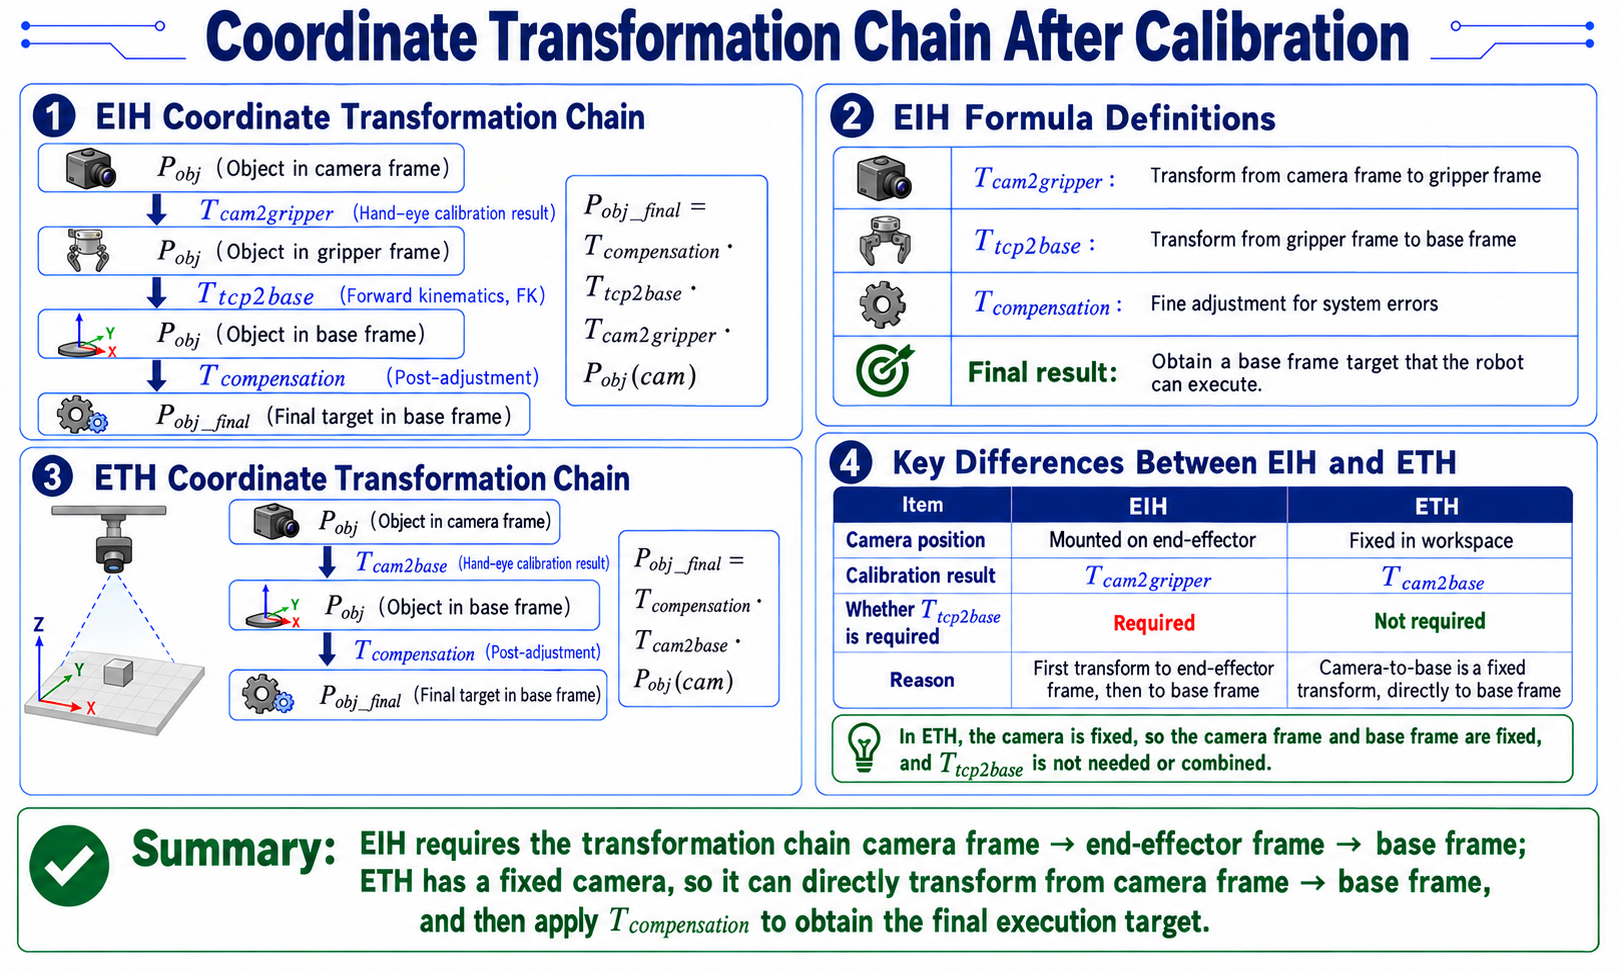
Implementação:
"""Transform a camera-observed pose into the arm base frame"""
    T_compensation = hand_eye_compensation_matrix(cfg)
    T_he = np.asarray(T_hand_eye, dtype=np.float64)

    if hand_eye_mode == "eye_in_hand":
# EIH: T_cam2base = T_comp x T_tcp2base x T_hand_eye
        return T_compensation @ np.asarray(T_tcp2base, dtype=np.float64) @ T_he
    if hand_eye_mode == "eye_to_hand":
# ETH: T_cam2base = T_comp x T_hand_eye
        return T_compensation @ T_he
Significado da fórmula EIH
[diagram: EIH transform chain]

  P_obj (target in camera frame)
       |
       | T_cam2gripper (hand-eye result)
       v
  P_obj (target in end frame)
       |
       | T_tcp2base (forward kinematics)
       v
  P_obj (target in base frame)
       |
       | T_compensation (post-hoc fine tune)
       v
  P_obj_final (final target in base frame)
-
Implementação:
"""Read compensation matrix from config"""
    calibration = cfg.get("calibration") or {}
    compensation = calibration.get("hand_eye_compensation_m") or {}
    T = np.eye(4, dtype=np.float64)
    T[:3, 3] = [
        float(compensation.get("x", 0.0)),
        float(compensation.get("y", 0.0)),
        float(compensation.get("z", 0.0)),
    ]
    return T
Fórmula ETH
- Como a câmera é fixa, a transformação base-câmera é fixa; T_tcp2base não entra na composição.
Erro de Calibração e Análise de Reprojeção
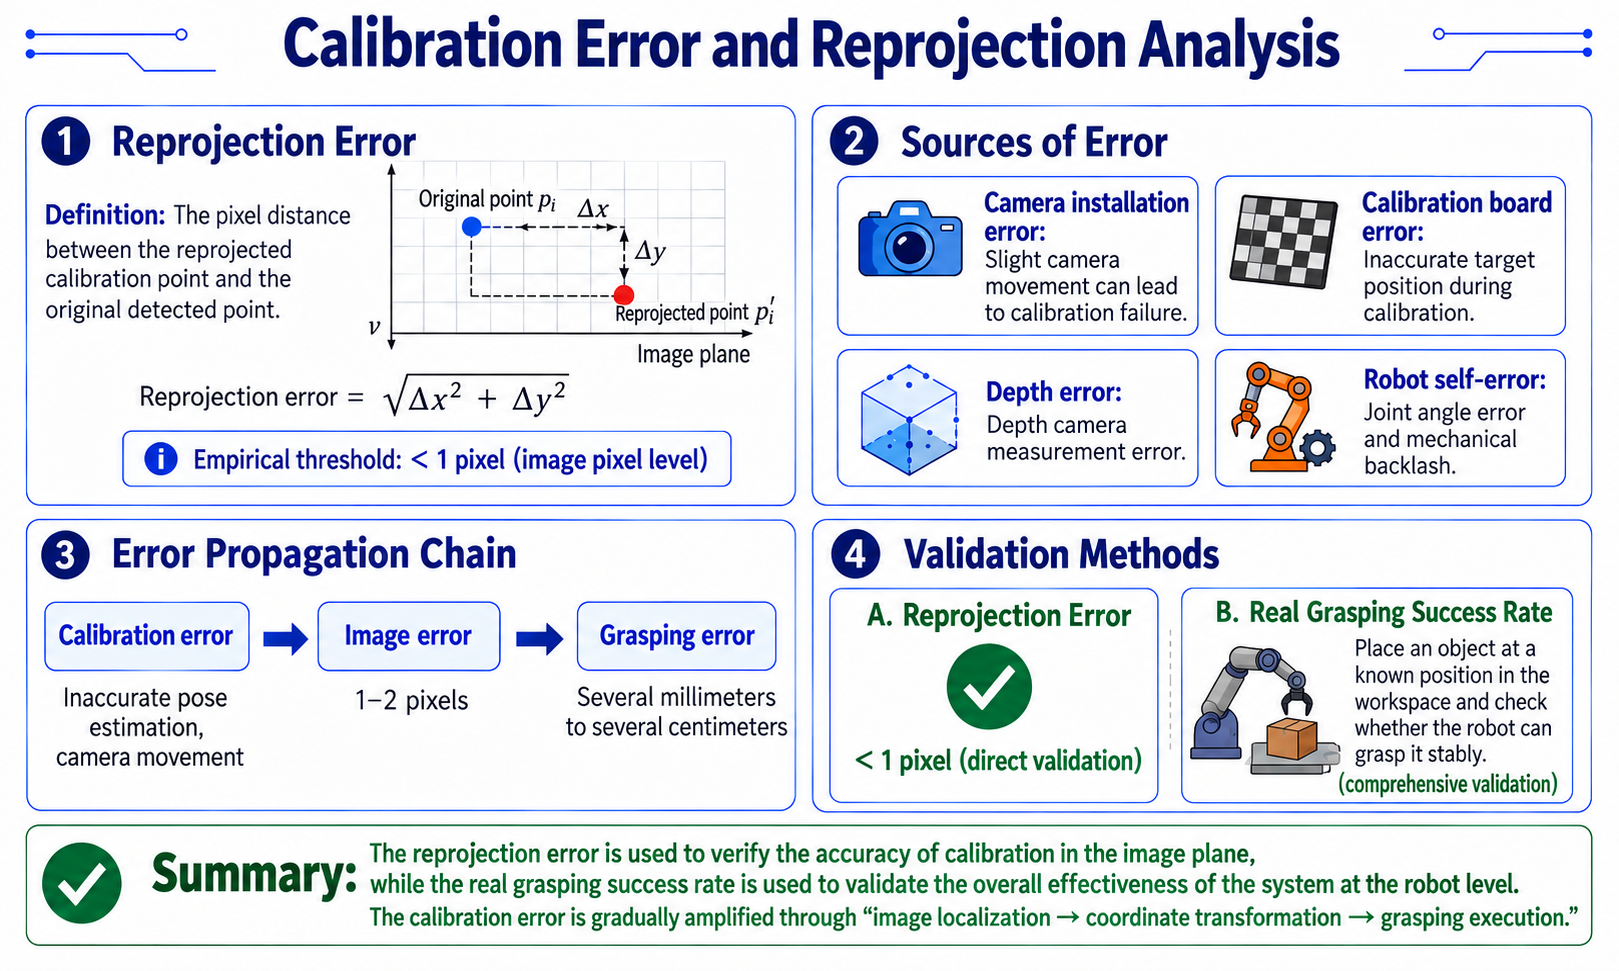
Erro de reprojeção
-
Definição: reprojetar os pontos de calibração na imagem e calcular a distância em pixels até os pontos detectados originalmente.
[diagram: reprojection error]

  original point p_i      reprojected point p_i'
       |                    |
       +---- dx, dy -------+

reprojection error = sqrt(dx^2 + dy^2)-
Limite empírico: < 1 pixel (subpixel).
-
Fontes de erro
Fonte Efeito Erro de montagem da câmera Pequenos movimentos da câmera invalidam a calibração Erro da placa de calibração Posição alvo imprecisa durante a calibração Erro de profundidade Erro de medição da câmera de profundidade Erro do robô Erro nas juntas e folga mecânica
-
Cadeia de propagação de erro
calibration error -> pixel error -> grasp deviation
   ^                  ^              ^
   |                  |              |
   |            1-2 pixels     a few mm to cm
   |
   +-- poor calibration poses, camera moved
Métodos de validação
- Erro de reprojeção: < 1 pixel (validação direta)
- Taxa real de sucesso de pega: colocar objetos em posições conhecidas na área de trabalho e verificar se o robô realiza a pega de forma confiável (validação integrada)
28.6 Estimativa de Pose de Pega em 6 GDL
Convenções de Coordenadas para Pega em 6 GDL
Referencial de visão da pega (convenção GraspNet)
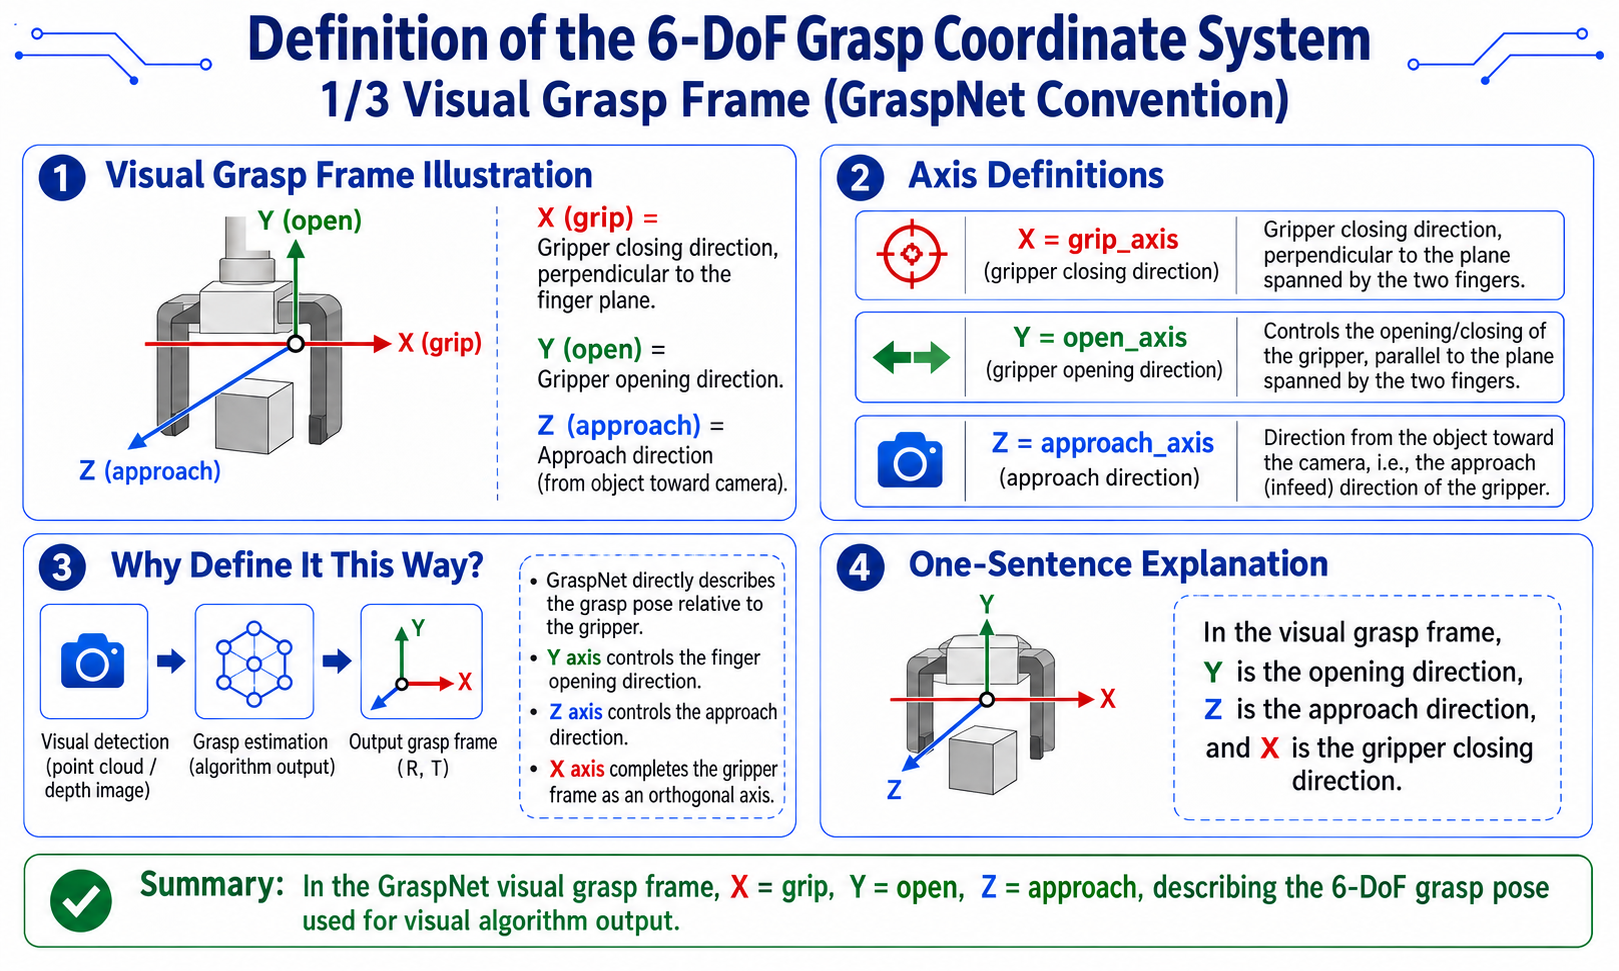
[diagram: vision grasp frame]

Y (open)
|
|   gripper open/close direction
|
+------ X (grip) -> gripper axis (grasp direction)
/
Z (approach)
v approach direction (object toward camera)
- X = grip_axis (eixo do gripper, perpendicular ao plano dos dedos)
- Y = open_axis (direção de abrir/fechar)
- Z = approach_axis (direção de aproximação, do objeto em direção à câmera)
Referencial TCP do robô (convenção reBotArm)
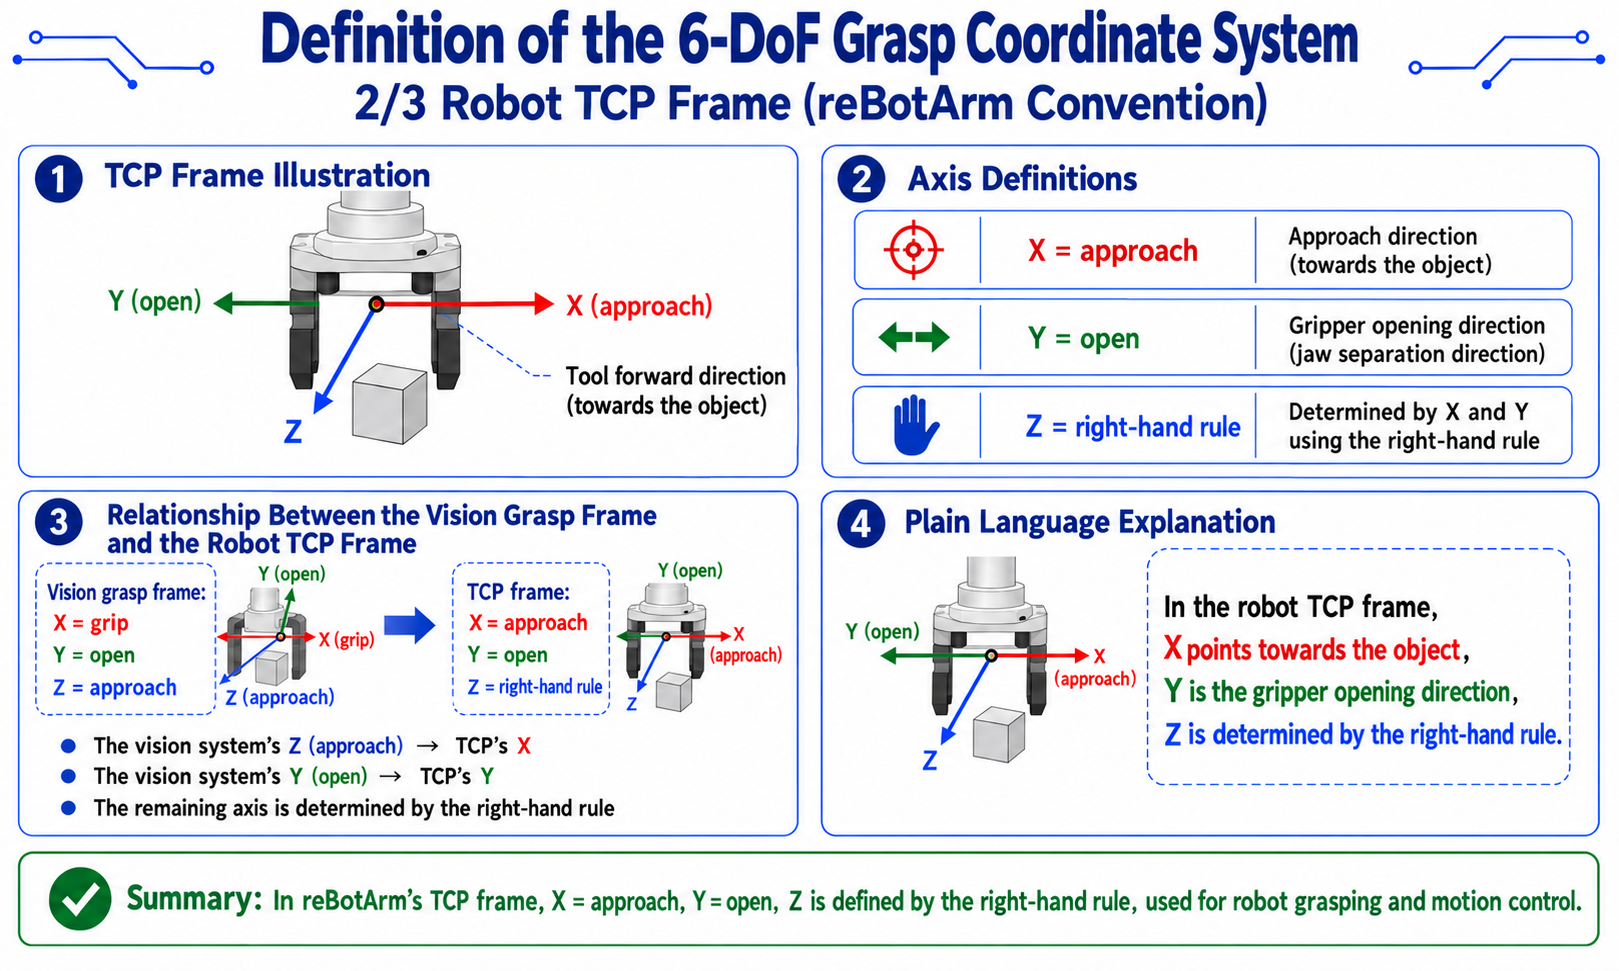
[diagram: TCP frame]

Z
|  / Y (open)
| /
+------ X (approach) -> tool forward direction (approach object)
- X = aproximação
- Y = abertura
- Z = completado pela regra da mão direita
Conversão entre os dois referenciais
-
Implementação:
# transforms.py L141-182 implementation reference
def grasp_axes_to_rebot_tcp_rotation(grip_axis, open_axis, approach_axis):
    """Map grasp-frame axes to the reBotArm TCP frame."""
    grip = grip_axis / norm(grip_axis)
    open_vec = open_axis / norm(open_axis)
    approach = approach_axis / norm(approach_axis)

# tcp_x = tool forward = approach direction (negate, since plane normal faces camera)
    tcp_x = -approach
# tcp_y = open direction, subtract approach component to make orthogonal
    tcp_y = open_vec - dot(open_vec, tcp_x) * tcp_x
    tcp_y = tcp_y / norm(tcp_y)
# tcp_z = right-hand cross product
    tcp_z = cross(tcp_x, tcp_y)
    tcp_z = tcp_z / norm(tcp_z)

# keep tcp_z aligned with grip_axis
    if dot(tcp_z, grip) < 0:
        tcp_y = -tcp_y
        tcp_z = -tcp_z

    R = np.column_stack([tcp_x, tcp_y, tcp_z]).astype(np.float64)
    if np.linalg.det(R) < 0.0:
        R[:, 2] *= -1.0
    return R
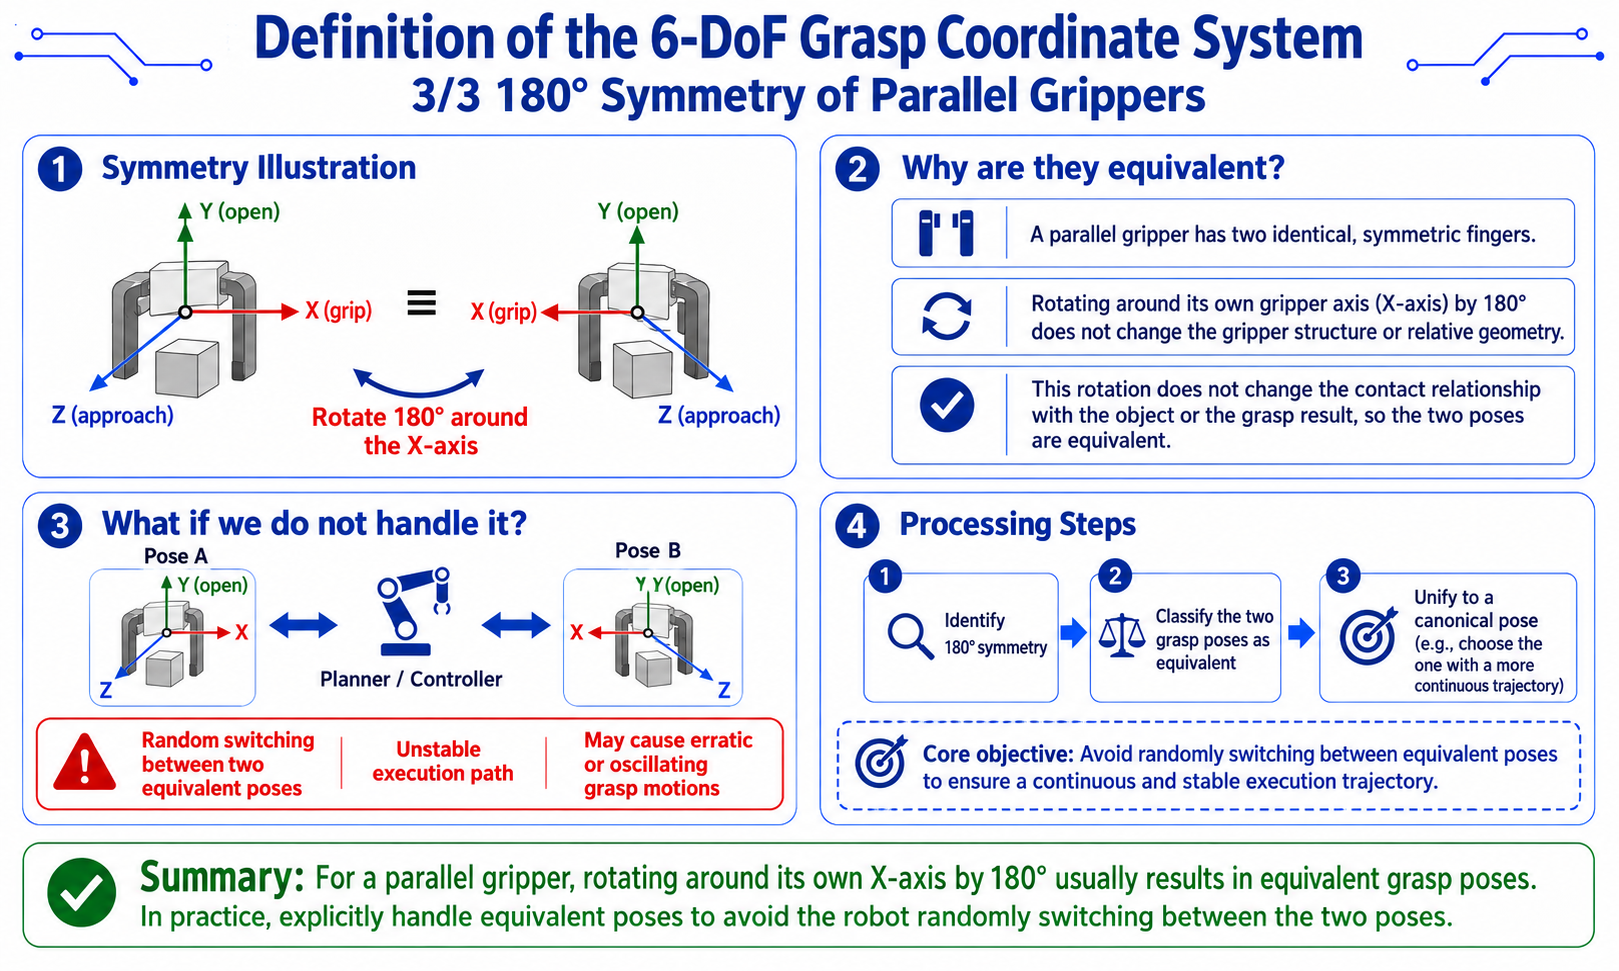
Simetria de 180 graus de um gripper paralelo
-
Um gripper paralelo (de dois dedos) tem uma simetria especial: rotacionar 180 graus em torno do seu próprio eixo X (eixo do gripper) é equivalente.
[diagram: parallel-gripper symmetry]

   X (grip)     X (grip)
   |            |
   +-+    <=>    +-+
   | |   rotate  | |
   +-+  180 deg  +-+
| | -
Se não for tratada, o robô alterna aleatoriamente entre poses equivalentes e o caminho de execução torna-se instável.
-
Implementação:
# transforms.py L125-138 implementation reference
def canonicalize_parallel_gripper_tcp_rotation(R):
    """Pick a stable equivalent pose."""
    alt = R @ Rx(pi)  # rotate 180 deg about X

    roll = rotation_matrix_to_euler_zyx(R)[0]
    alt_roll = rotation_matrix_to_euler_zyx(alt)[0]

# pick the branch with smaller |roll| (roll~0 is usually more stable)
    return alt if abs(alt_roll) < abs(roll) else R
-
Estimativa Geométrica de Pega a partir de OBB + Quantil de Profundidade
Pipeline completo
-
Implementação:
# ordinary_grasp.py L98-219 core pseudocode
def estimate_grasp(result, index, depth_mm, K, depth_quantile=0.75):
# 1. get OBB
    rect_points = _rect_points(result, index, depth_mm.shape, bbox_xyxy)
    center = rect_points.mean(axis=0).astype(np.float32)

# 2. short edge = grasp direction
    short_vec_uv, short_len_px = _short_edge(rect_points)
    short_dir_uv = _normalize(short_vec_uv)

# 3. mask refinement (for curved objects)
    if short_dir_uv is not None:
        refined = _refine_grasp_line_from_mask(mask, center, short_dir_uv, long_len_px)
        if refined is not None:
            center, short_edge_points, grasp_span_px = refined

# 4. depth sampling (75th quantile within mask)
    depth_values = depth_mm[mask > 0]
    depth_values = depth_values[depth_values > 0]
    if len(depth_values) == 0:
        center_depth = get_depth_mm(depth_mm, center_px[0], center_px[1], 5)
        if center_depth > 0:
            depth_values = np.array([center_depth], dtype=np.float32)

    z_m = float(np.quantile(depth_values, depth_quantile) / 1000.0)

# 5. backproject center to 3D
    position = _backproject(float(center[0]), float(center[1]), z_m, K)

# 6. build three axes
    approach = _normalize(-position)       # Z axis: object toward camera
    open_axis = _pixel_vec_to_3d(short_dir_uv, z_m, K)
    open_axis = open_axis - float(np.dot(open_axis, approach)) * approach  # Gram-Schmidt
    open_axis = _normalize(open_axis)

# ensure open_axis[0] >= 0 (avoid symmetry ambiguity)
    if open_axis[0] < 0:
        open_axis = -open_axis

    grip_axis = _normalize(np.cross(open_axis, approach))
    open_axis = _normalize(np.cross(approach, grip_axis))

# 7. assemble rotation matrix
    rotation = np.column_stack([grip_axis, open_axis, approach]).astype(np.float32)

# 8. convert to reBotArm TCP rotation
    tcp_rotation = grasp_axes_to_rebot_tcp_rotation(
        rotation[:, 0], rotation[:, 1], rotation[:, 2]
    ).astype(np.float32)

# 9. estimate grasp width
    jaw_width_m = float(np.linalg.norm(
        _pixel_vec_to_3d(short_dir_uv * grasp_span_px, z_m, K)
    ))

    return grasp_pose
Ortogonalização de três eixos em detalhes
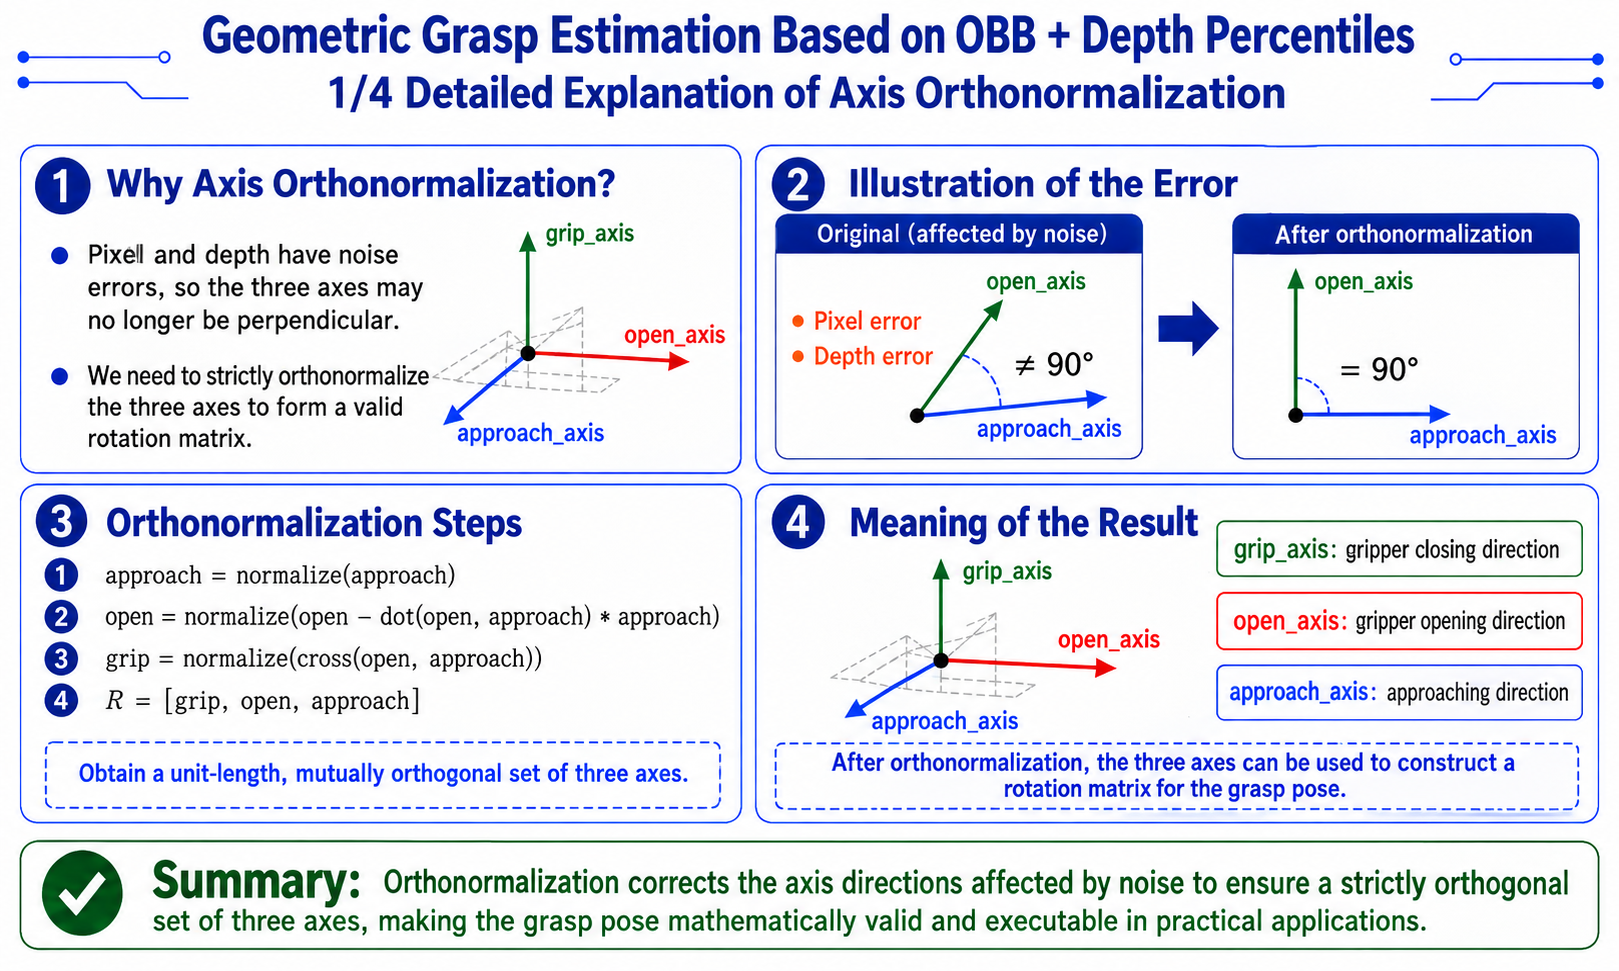
- Por que ortogonalizar:
-
Em computação numérica, vetores de pixels e profundidade carregam erro, então
open_axiseapproachpodem não ser ortogonais. A ortogonalização de Gram-Schmidt garante uma tríade estritamente ortogonal que forma uma matriz de rotação válida.# key steps
approach = -position / norm(position) # object toward camera
open_3d = pixel_to_3d(short_dir_uv, z_m, K) # short-edge direction in 3D
open_axis = open_3d - dot(open_3d, approach) * approach # Gram-Schmidt
open_axis = normalize(open_axis)
grip_axis = normalize(cross(open_axis, approach))
open_axis = normalize(cross(approach, grip_axis)) # re-orthogonalize for numerical stability
-
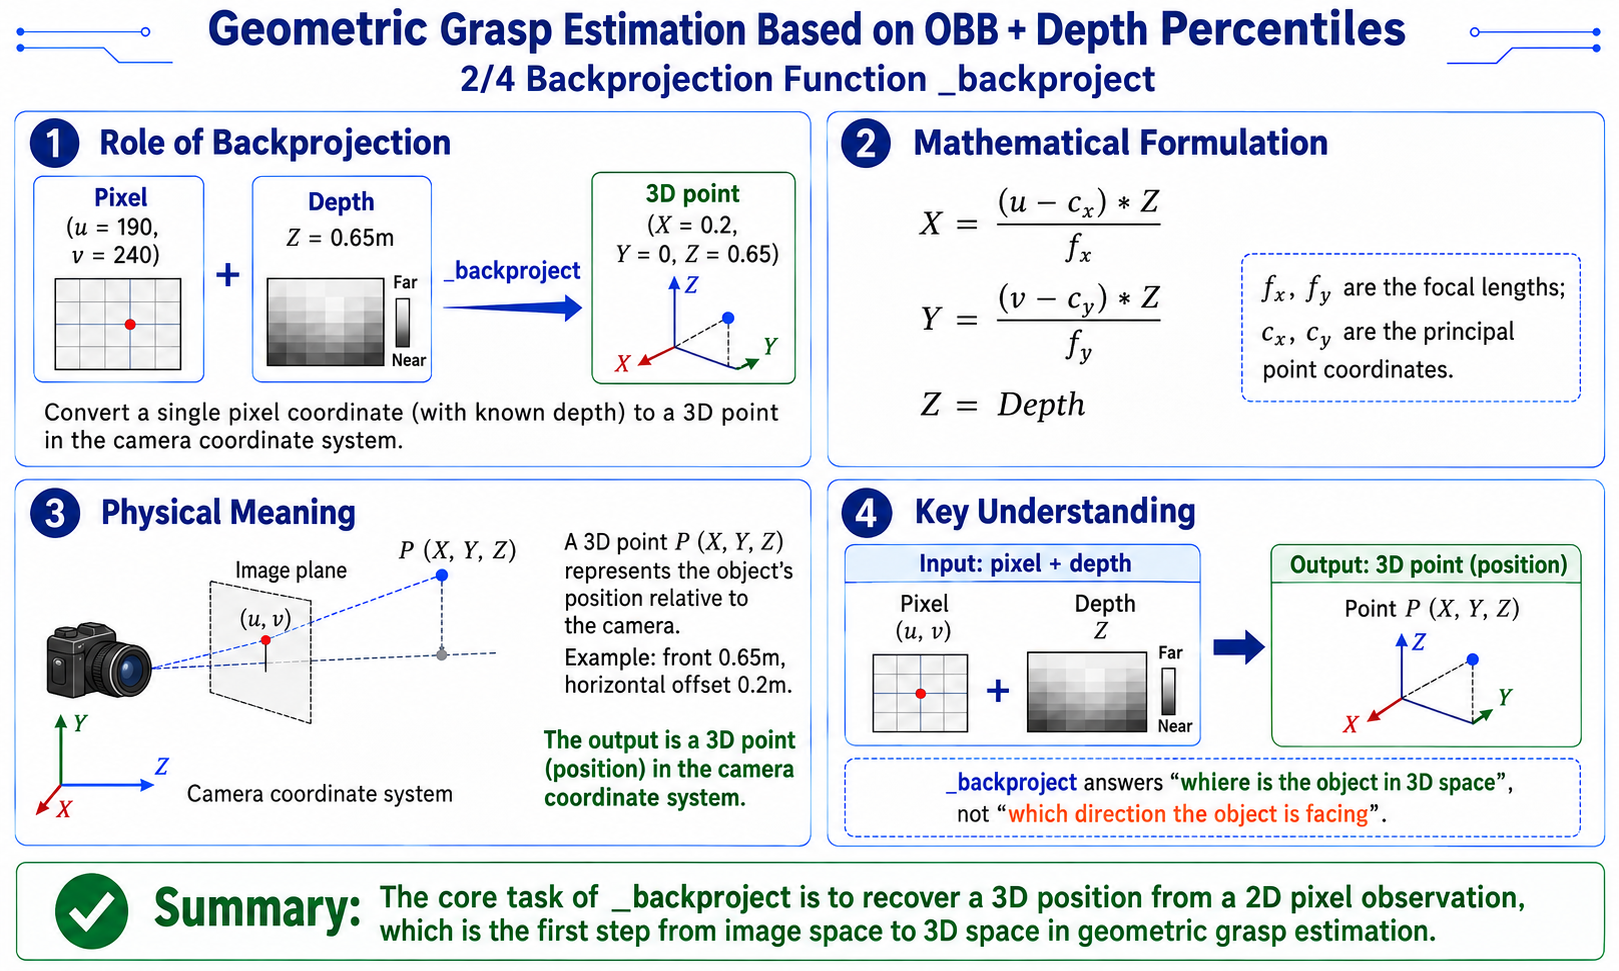
Função de retroprojeção
-
Função: converter uma única coordenada de pixel (com profundidade conhecida) em um ponto 3D (posição) no referencial da câmera.
[diagram: physical meaning of backprojection]

  pixel (u=190, v=240) + depth Z=0.65m
           v _backproject
  3D point (X=0.2, Y=0, Z=0.65)
           v
"object is 0.65m ahead, 0.2m to the right" -
Implementação:
# ordinary_grasp.py L398-403 implementation
def _backproject(u, v, z_m, K):
    fx, fy = float(K[0, 0]), float(K[1, 1])
    cx, cy = float(K[0, 2]), float(K[1, 2])
    x = (u - cx) * z_m / fx
    y = (v - cy) * z_m / fy
    return np.array([x, y, z_m], dtype=np.float32)
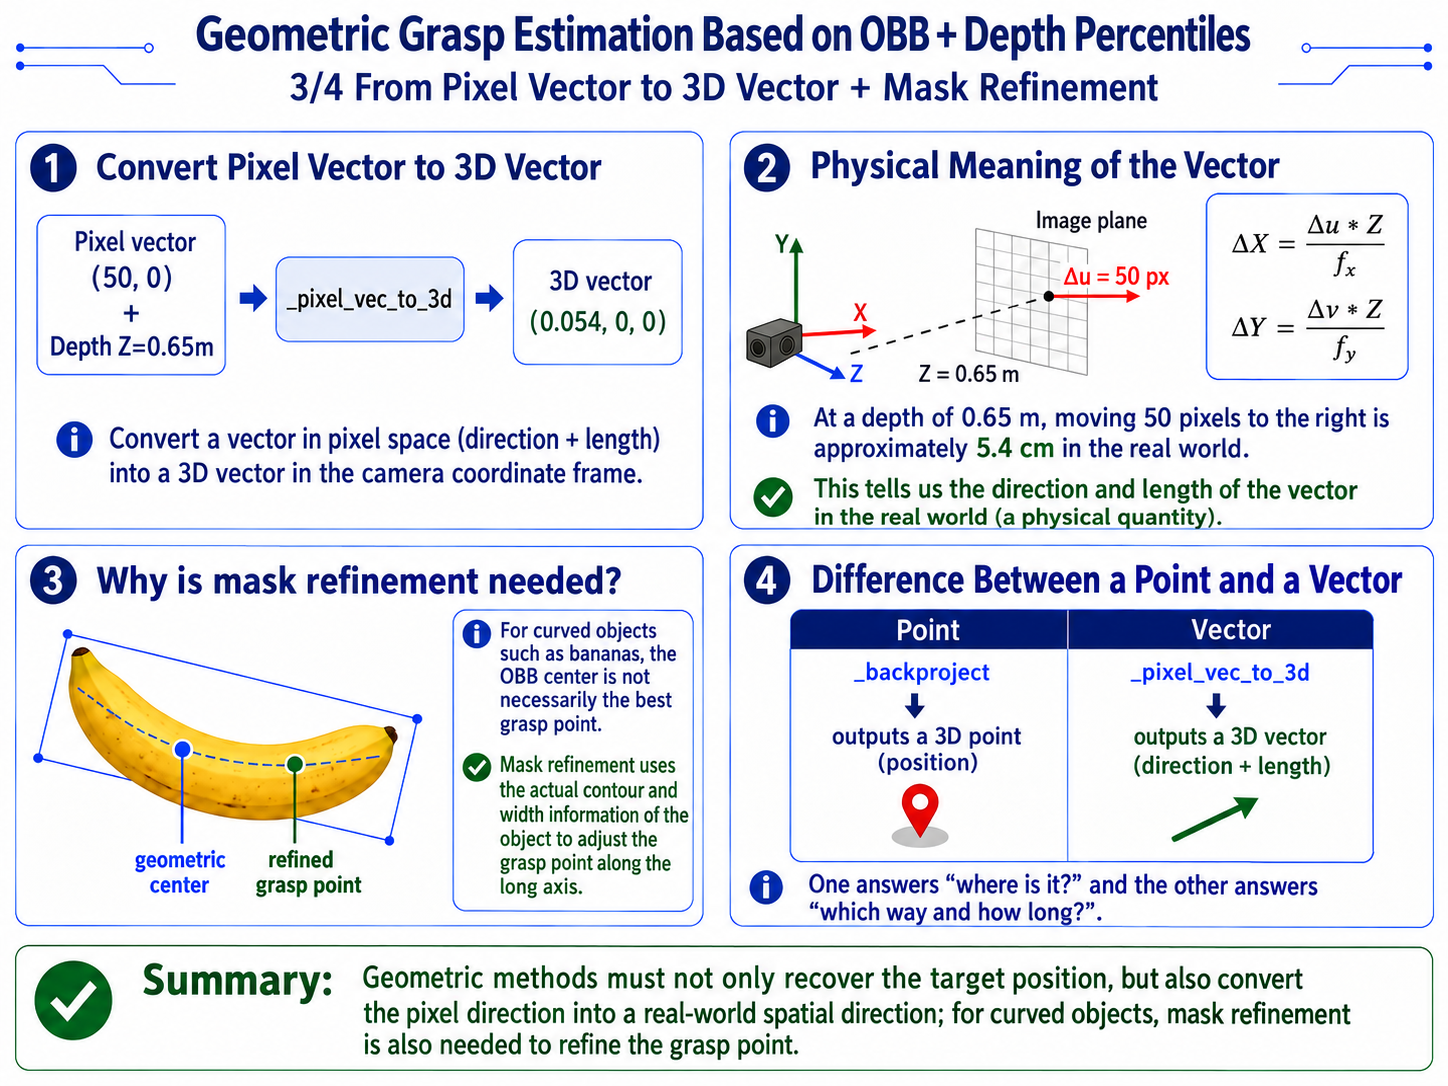
Vetor de pixel para vetor 3D
-
Função: converter um vetor no espaço de pixels (direção + comprimento) em um vetor 3D no referencial da câmera (direção + comprimento).
[diagram: physical meaning of a pixel vector]

  pixel vector (50, 0) + depth Z=0.65m
           v _pixel_vec_to_3d
  3D vector (0.054, 0, 0)
           v
"at depth 0.65m, 50 pixels right = 5.4 cm physical" -
Implementação:
# ordinary_grasp.py L406-408 implementation
def _pixel_vec_to_3d(vec_uv, z_m, K):
    fx, fy = max(float(K[0, 0]), 1e-6), max(float(K[1, 1]), 1e-6)
    return np.array([
        float(vec_uv[0]) * z_m / fx,
        float(vec_uv[1]) * z_m / fy,
        0.0
    ], dtype=np.float32)
Refinamento de máscara (objetos curvos)
- Por que o refinamento de máscara é necessário:
-
O centro da OBB é o centro geométrico do objeto, mas para objetos curvos como uma banana, o melhor ponto de preensão é uma posição específica ao longo do eixo longo (geralmente perto do meio). O refinamento usa a largura real da máscara para ajustar o ponto de preensão.
-
Implementação:
utils/ordinary_grasp.py_refine_grasp_line_from_mask()(L233-275)# ordinary_grasp.py L233-275 implementation
def _refine_grasp_line_from_mask(mask, center, short_dir_uv, long_len_px):
"""Refine the short-axis grasp point using the mask's central cross-section."""
ys, xs = np.nonzero(mask > 0)
if len(xs) < 32:
return None # mask too small, skip refinement
points = np.column_stack([xs, ys]).astype(np.float32)
grip_dir_uv = np.array([-short_dir_uv[1], short_dir_uv[0]], dtype=np.float32)
rel = points - center.reshape(1, 2)
grip_coord = rel @ grip_dir_uv # coordinate along short axis
open_coord = rel @ short_dir_uv # coordinate along long axis
grip_center = float(np.median(grip_coord))
band_half_width = clip(long_len_px * 0.04, 2.0, 12.0)
band_mask = np.abs(grip_coord - grip_center) <= band_half_width
if count(band_mask) < 24:
band_half_width = clip(long_len_px * 0.08, 4.0, 18.0)
band_mask = np.abs(grip_coord - grip_center) <= band_half_width
if count(band_mask) < 24:
return None
# within the band, take 5%/95% quantiles along open direction
open_min = np.percentile(open_coord[band_mask], 5.0)
open_max = np.percentile(open_coord[band_mask], 95.0)
open_center = 0.5 * (open_min + open_max)
# recombine center
refined_center = center + grip_center * grip_dir_uv + open_center * short_dir_uv
short_edge_points = _line_from_center(refined_center, short_dir_uv * (open_max - open_min))
return refined_center, short_edge_points, float(open_max - open_min)
-
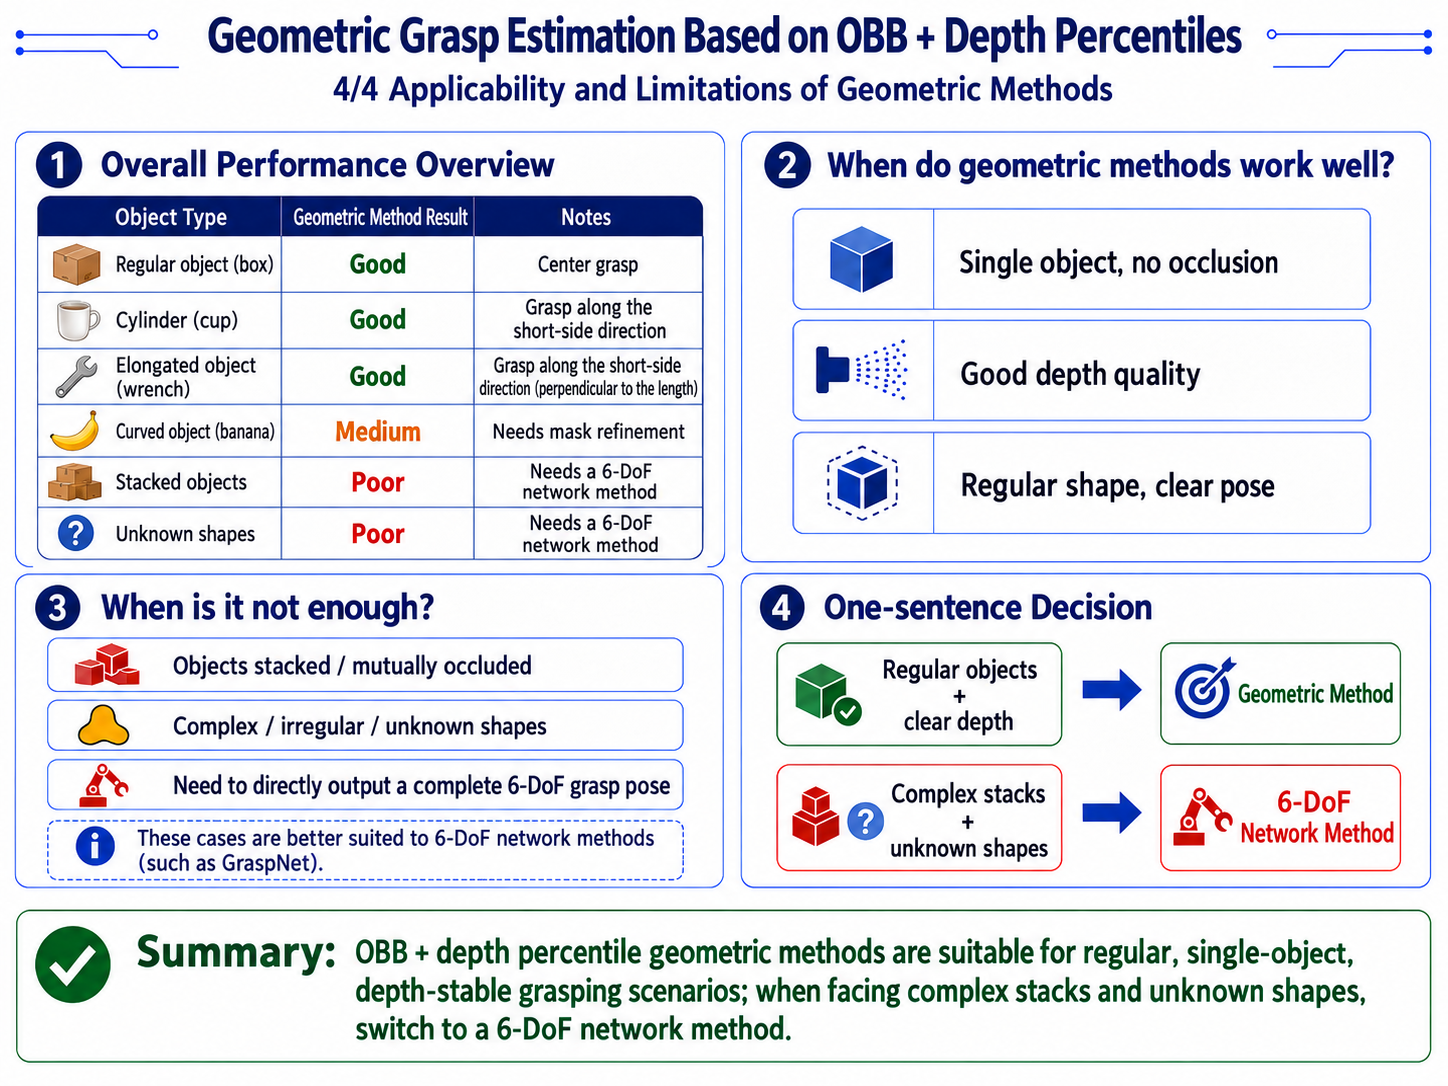
Quando o método geométrico funciona — e seus limites
Estimativa de preensão 6-DoF com redes de nuvem de pontos (GraspNet)
Implementação:
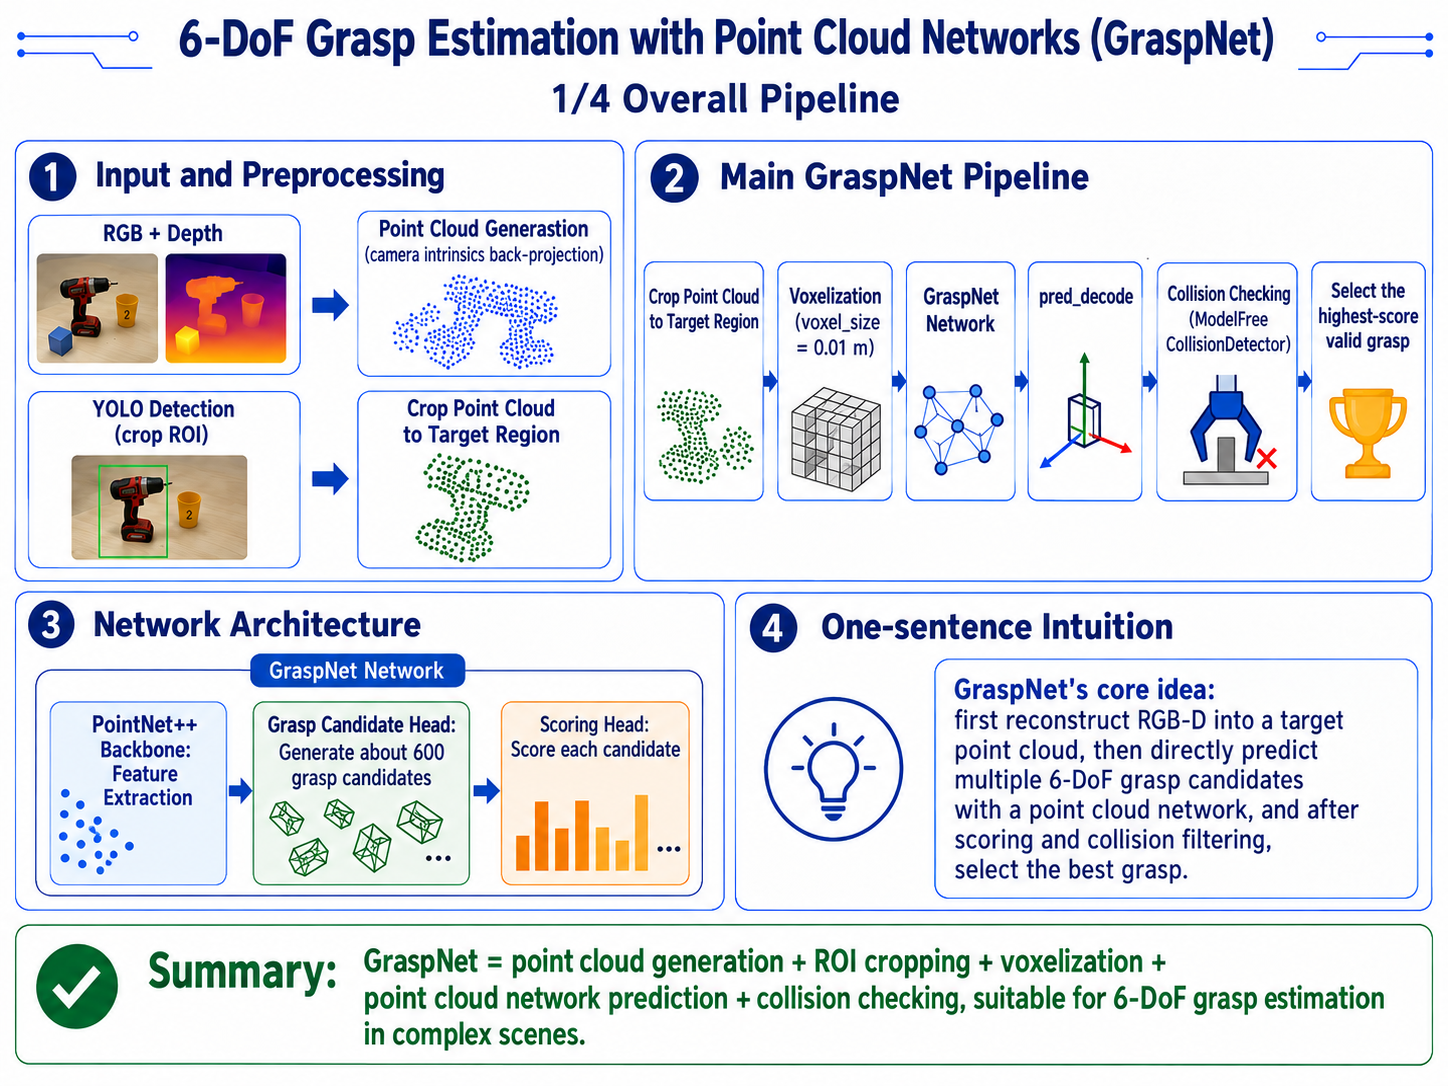
[diagram: GraspNet pipeline]

RGB + depth
  |
  +-> point cloud generation (backproject with camera intrinsics)
  |
  +-> YOLO detection (crop ROI)
       |
       +-> crop point cloud to target region
            |
            +-> voxelize (voxel_size = 0.01 m)
                 |
                 +-> GraspNet network
                      |
                      +-> PointNet++ backbone (feature extraction)
                      |
                      +-> grasp candidate head (~600 candidates)
                      |
                      +-> scoring head (scores each candidate)
                           |
                           +-> pred_decode (parse into Grasp objects)
                                |
                                +-> collision detection (ModelFreeCollisionDetector)
                                     |
                                     +-> pick the highest-scoring valid grasp
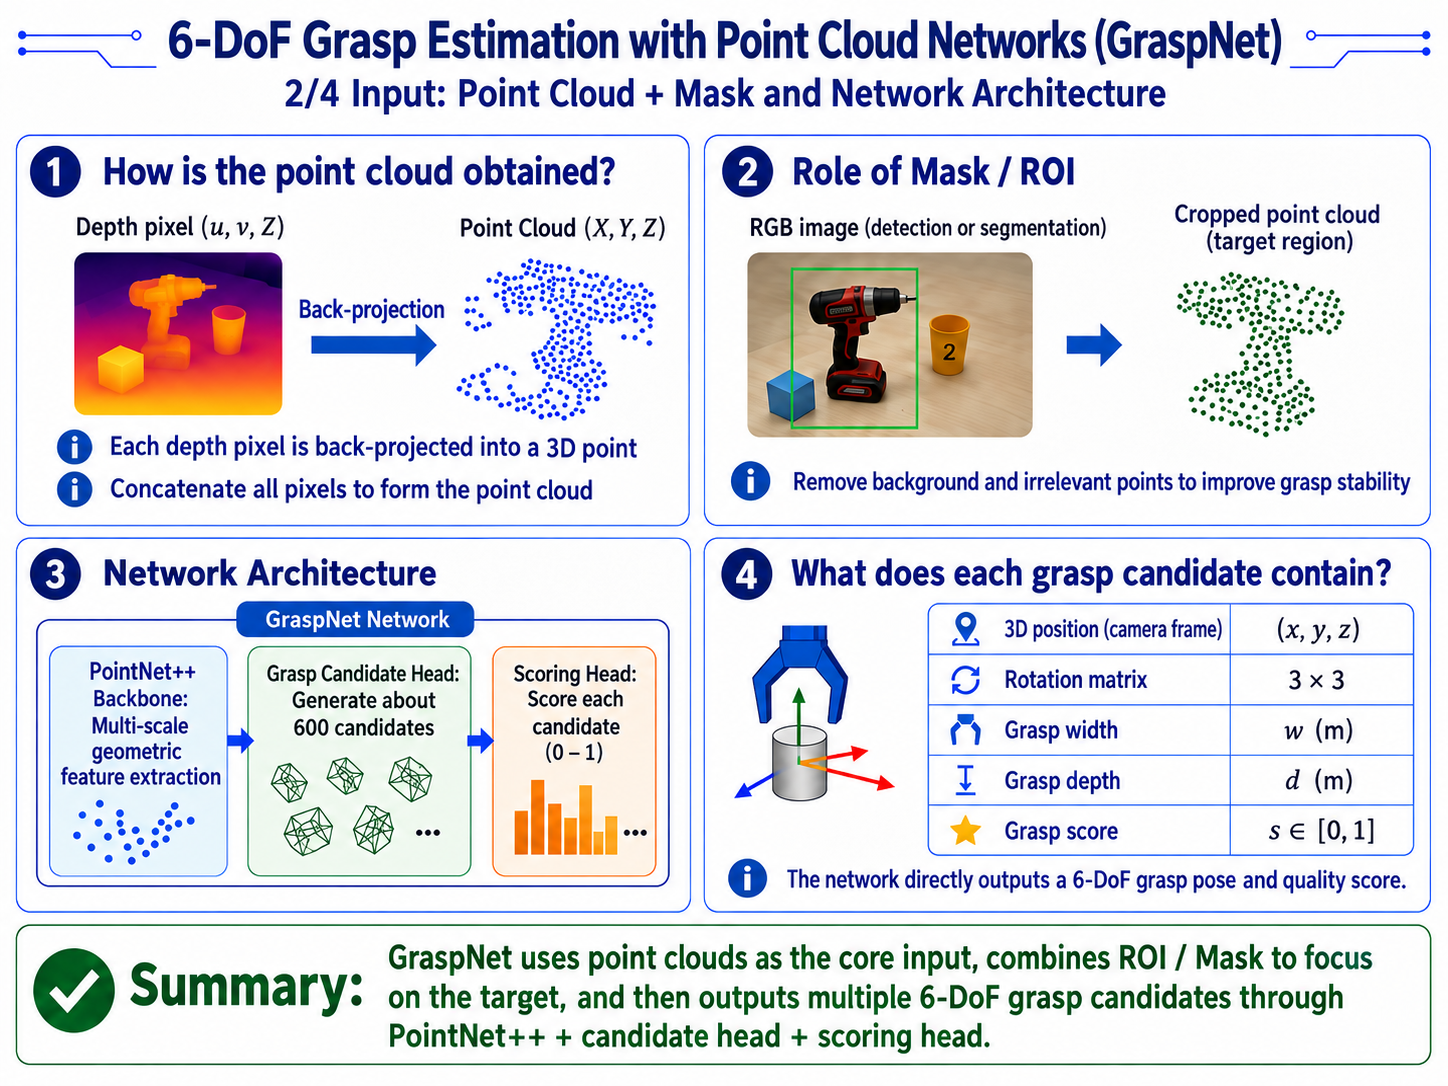
Entrada: nuvem de pontos + máscara
-
Implementação:
# graspnet_utils.py L21-25 implementation
PROJECT_ROOT = Path(__file__).resolve().parents[1]
GRASPNET_ROOT = PROJECT_ROOT / "sdk" / "graspnet-baseline"
DEFAULT_NUM_VIEW = 300
DEFAULT_VOXEL_SIZE = 0.01              # 1 cm voxel
DEFAULT_WARMUP_FRAMES = 20
DISPLAY_FLIP_X = np.diag([1.0, -1.0, -1.0, 1.0]).astype(np.float64) -
Nuvem de pontos retroprojetada a partir do mapa de profundidade:
- Cada pixel de profundidade (u, v, Z) é retroprojetado para (X, Y, Z)
- Concatenar todos os pixels na nuvem de pontos
-
Estrutura da rede
- Backbone PointNet++
- Backbone de características de nuvem de pontos que extrai características geométricas em múltiplas escalas, do local ao global.
- Cabeça de candidatos de preensão
- Produz muitos candidatos de preensão 6-DoF (~600), cada um contendo: posição 3D (referencial da câmera), matriz de rotação, largura de preensão, profundidade de preensão.
- Cabeça de pontuação
- Atribui uma pontuação a cada candidato (0-1); pontuações mais altas significam maior probabilidade de sucesso.
- Backbone PointNet++
Formato de saída
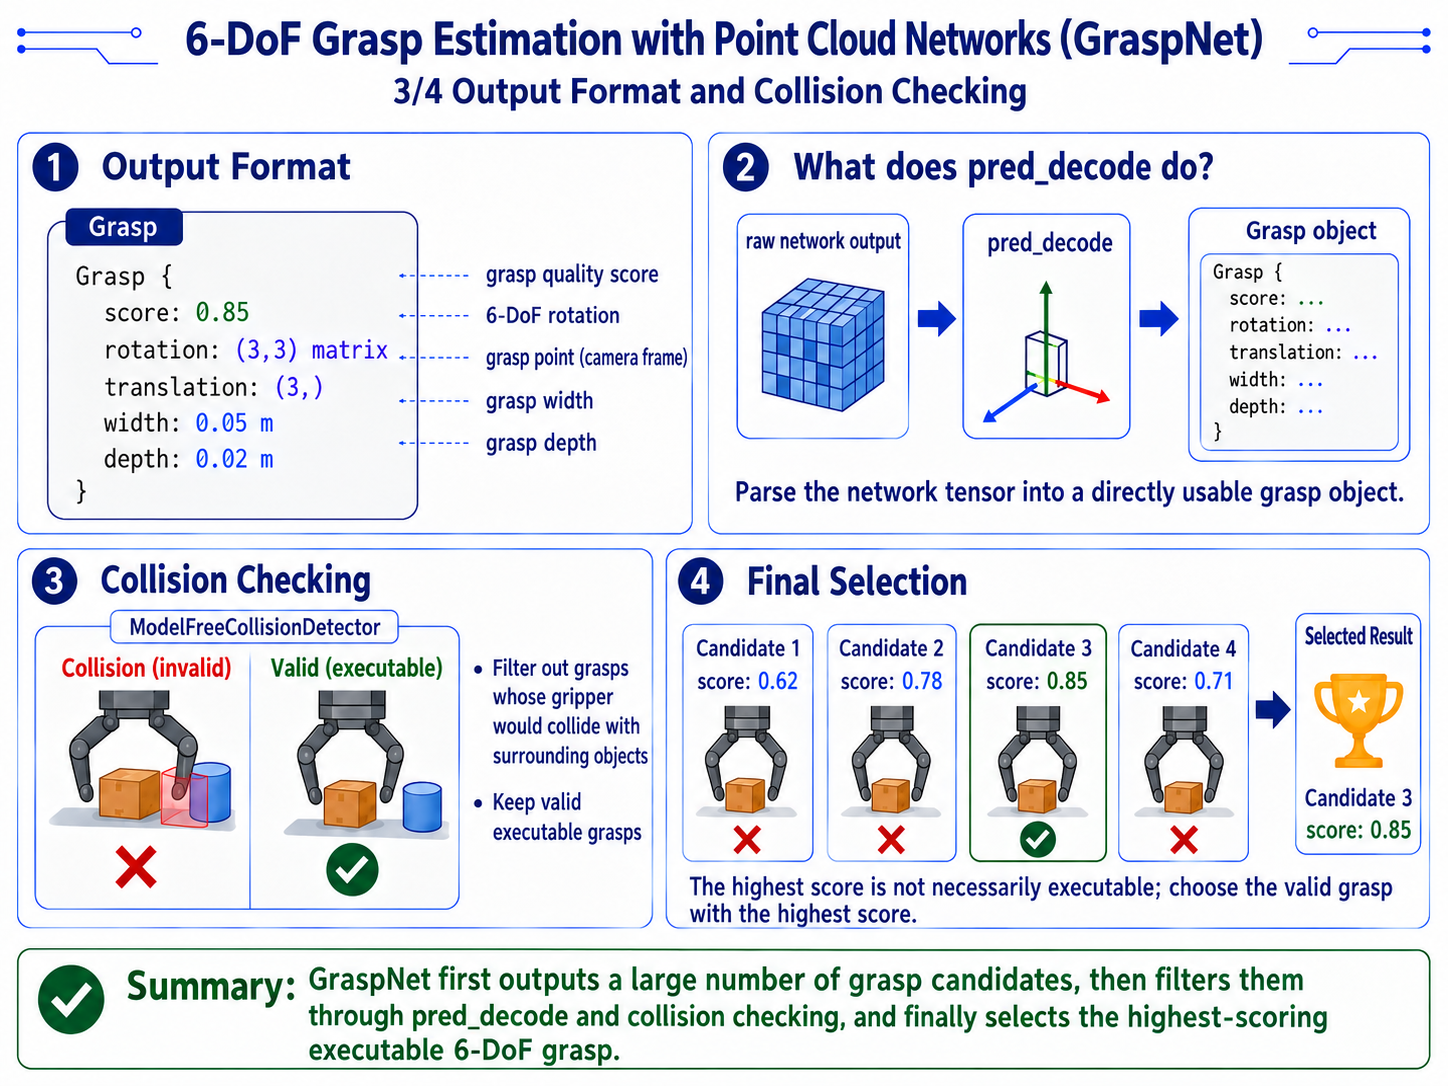
Grasp {
  score: 0.85              # grasp quality score
  rotation: (3, 3) matrix  # 6-DoF rotation
  translation: (3,)        # grasp point (camera frame)
  width: 0.05              # grasp width (m)
  depth: 0.02              # grasp depth (m)
}
Detecção de colisão
-
Implementação:
# graspnet_utils.py L45 implementation
from collision_detector import ModelFreeCollisionDetector # noqa -
O detector de colisão verifica se a garra colidiria com objetos ao redor ao executar a preensão e filtra as preensões que colidem.
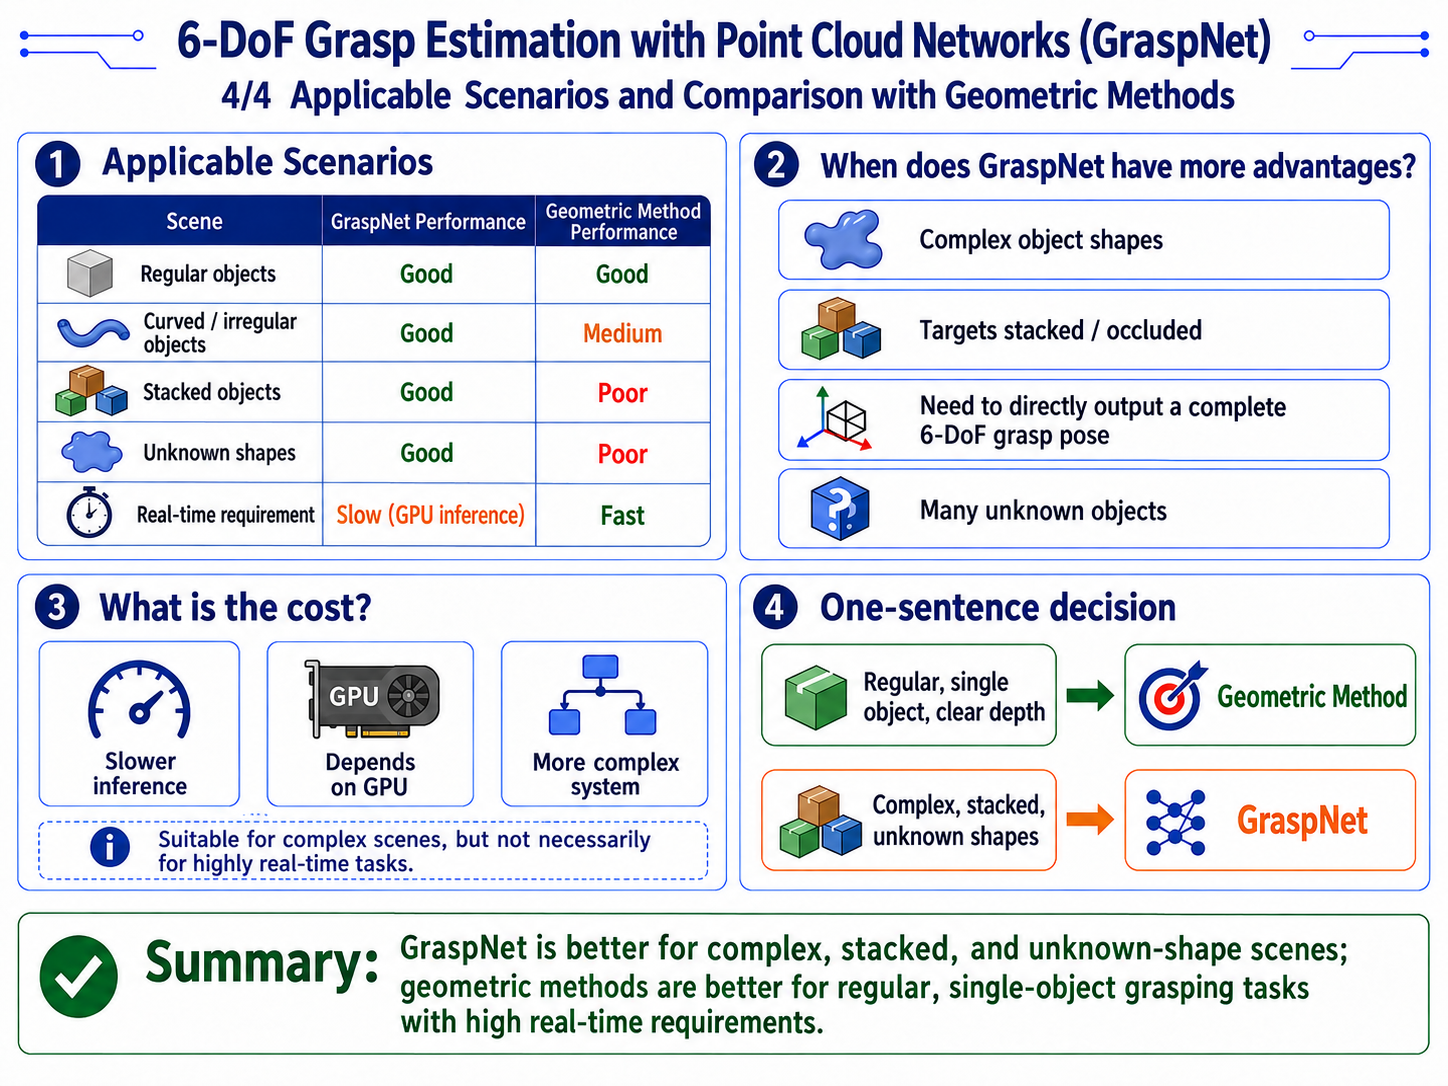
Cenários adequados
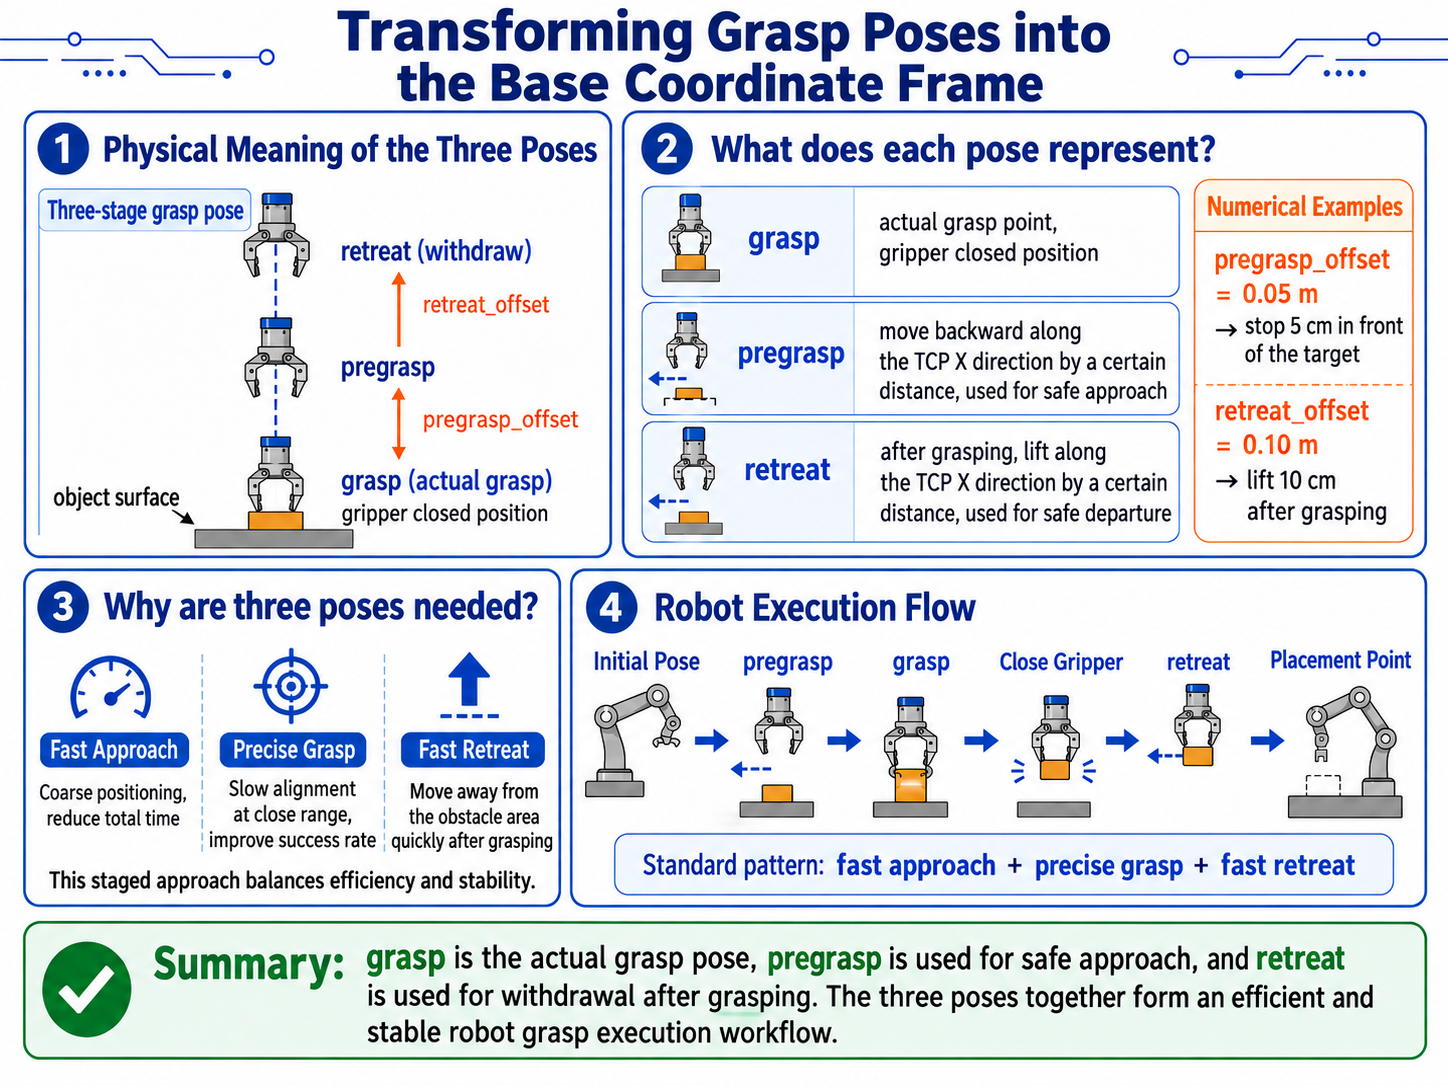
Convertendo a pose de preensão para o referencial da base
-
Implementação:
# transforms.py L227-240 implementation
def transform_grasp_pose_to_base_with_retreat(
    position_cam,           # grasp point (camera frame)
    tcp_rotation_cam,       # TCP rotation (camera frame)
    T_cam2base,             # hand-eye camera->base matrix
    pregrasp_offset_m,      # pregrasp retract distance
    retreat_offset_m,       # retreat distance
    insertion_depth_m=0.0,
):
# 1. transform grasp point to base frame
    T_grasp_cam = make_T(position_cam, tcp_rotation_cam)
    T_grasp_base = T_cam2base @ T_grasp_cam

# 2. canonicalize parallel-gripper symmetry
    T_grasp_base[:3, :3] = canonicalize_parallel_gripper_tcp_rotation(T_grasp_base[:3, :3])

# 3. offset along TCP X to get pregrasp and retreat
    T_grasp_base = offset_along_tool_x(T_grasp_base, -insertion_depth_m)
    T_pregrasp_base = offset_along_tool_x(T_grasp_base, pregrasp_offset_m)
    T_retreat_base = offset_along_tool_x(T_grasp_base, retreat_offset_m)

# 4. convert back to 6D pose
return mat4_to_pose6d(T_grasp_base), mat4_to_pose6d(T_pregrasp_base), mat4_to_pose6d(T_retreat_base)-
Significado físico das três poses
[diagram: three grasp-pose stages]

       retreat
         ^
         | retreat_offset
         |
       pregrasp
         ^
         | pregrasp_offset
         |
       grasp
v object surface- grasp: o ponto real de apreensão, onde a garra se fecha
- pregrasp: ponto de pré-apreensão, recuado ao longo do TCP X por uma certa distância, para uma aproximação livre de obstáculos
- retreat: ponto pós-apreensão, elevado ao longo do TCP X por uma certa distância após a apreensão
- Por exemplo:
- pregrasp_offset = 0.05 m -> parar 5 cm antes de se aproximar
- retreat_offset = 0.10 m -> levantar 10 cm após a apreensão
-
Por que são necessárias três poses
- Fluxo padrão de apreensão do robô:
- Mover da posição inicial para pregrasp (rápido, posicionamento grosseiro)
- Mover lentamente de pregrasp para grasp (alinhamento preciso)
- Fechar a garra
- Elevar de grasp para retreat (retirada rápida)
- Mover de retreat até o ponto de colocação
Esse padrão de "aproximação rápida + apreensão precisa + retirada rápida" garante a precisão da apreensão enquanto melhora a eficiência geral.