14. Modelo ACT e blocos de ação
Capítulo 14 do curso para iniciantes em SO-ARM Physical AI — entrada e saída do ACT, a estrutura ResNet e Transformer, a intuição da atenção, CVAE, bloco de ação vs. horizonte de ação, as duas defesas contra o erro acumulado e os limites do ACT.
14.1 Da clonagem de comportamento ao ACT
14.1 Da clonagem de comportamento ao ACT: só falta "um bom modelo"
O Capítulo 8 cobriu a clonagem de comportamento: gravar demos de teleoperação como dataset e deixar o modelo aprender "fazer o que vê". Ficou uma pergunta — qual modelo merece esses dados? Uma política implantável precisa cruzar ao menos três barreiras:
- Entender imagens.
- Pensar com coerência.
- Resistir ao erro acumulado.
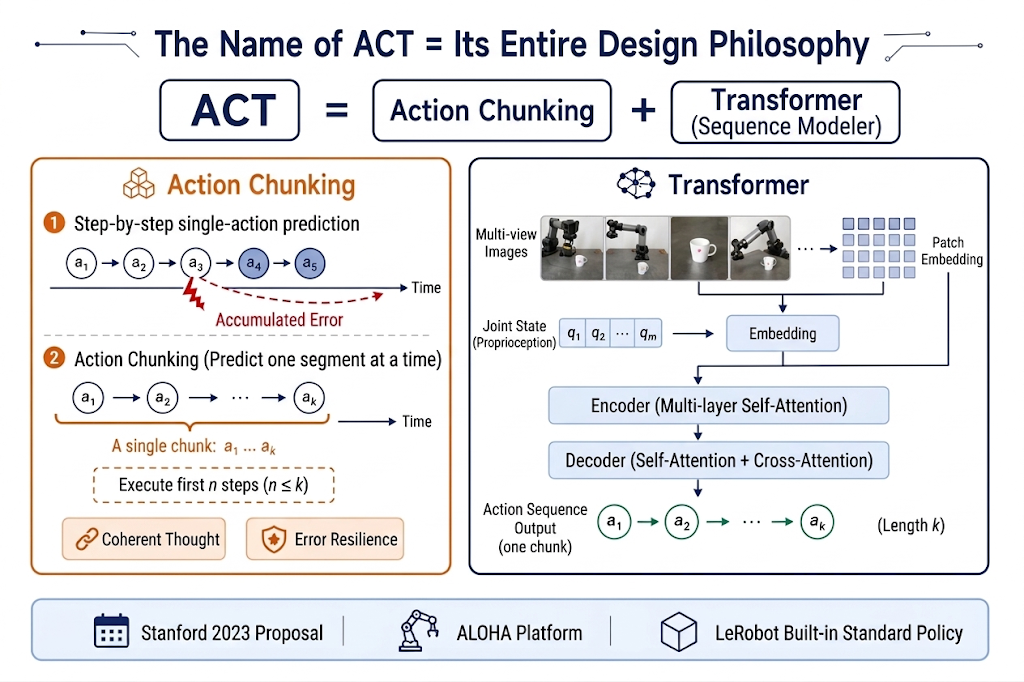
ACT (Action Chunking with Transformers) é o modelo construído para cruzá-las. Proposto por uma equipe de Stanford em 2023, ficou famoso na plataforma de dupla braço ALOHA de baixo custo com tarefas delicadas como abrir tampas e selar sacos; depois, o Mobile ALOHA mostrou tarefas complexas como cozinhar camarão. Hoje é uma das políticas padrão do LeRobot — e o modelo que você vai treinar e implantar nesta fase.
O nome do ACT É toda a sua filosofia de design: Action Chunking + Transformer (modelador de sequências). O resto do capítulo desmonta esses dois termos.
14.2 Entrada e saída do ACT
14.2 Entrada e saída do ACT: veja primeiro as duas pontas
A forma mais confiável de entender um modelo é olhar a "interface" — o que entra, o que sai.
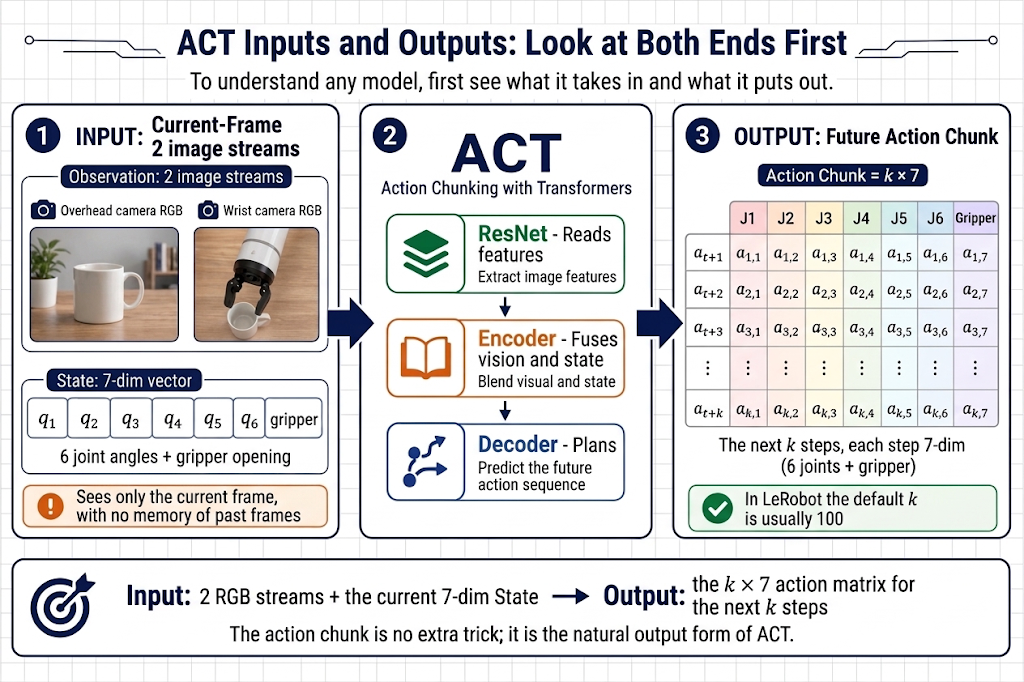
Entrada: a observação atual
Na inferência, o ACT recebe um quadro com dois tipos de informação:
| Entrada | No SO-ARM | Dimensionalidade |
|---|---|---|
| Imagens (observação) | RGB frontal + lateral | 2 × imagens |
| Estado articular (estado) | 5 ângulos + abertura da garras | vetor de 6 |
Note que o ACT é de quadro único: não lembra quadros passados; cada decisão se baseia em "o que vejo agora + onde estão as juntas agora".
Saída: bloco de ações para uma janela curta de futuro
A saída do ACT não é a próxima ação, mas um bloco inteiro (Action Chunk):
Entrada: 2 fluxos de imagem + estado articular de 6 (quadro atual)
Saída: sequência de ações dos próximos k passos, cada passo de 6 (5 juntas + garras)
      ou seja, uma matriz de ações k × 6
Na configuração padrão do LeRobot, k (chunk size) costuma ser 100 — uma inferência entrega o plano completo de uns 100 passos futuros. Isso responde ao gancho do Capítulo 8: o bloco de ações não é um truque abstrato; é a forma natural de saída do ACT.
14.3 Estrutura interna do ACT
14.3 Estrutura interna do ACT: três oficinas numa linha
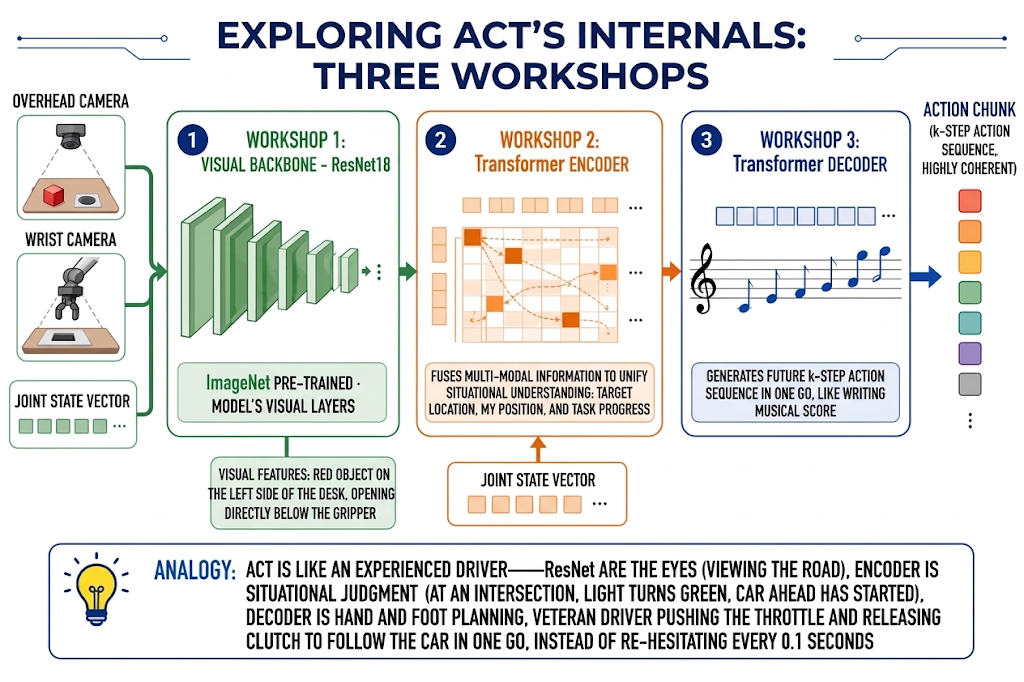
Oficina 1: espinha visual (ResNet) — de pixels a features
As imagens frontal e lateral passam cada uma por um ResNet18 (CNN pré-treinado no ImageNet), comprimidas num conjunto de features visuais. Pense no ResNet como a "córtes visual" do modelo: pixels crus não significam nada para ele; ele extrai informações estruturadas como "tem um objeto vermelho à esquerda" ou "há uma abertura logo abaixo da garras".
Oficina 2: codificador Transformer — entender "o presente"
Features visuais + vetor de estado convergem e entram no codificador Transformer. O trabalho dele é fundir os fluxos num entendimento unificado da situação: "onde está o alvo, onde estou, em que ponto da tarefa vou".
Oficina 3: decodificador Transformer — planejar "o futuro"
O decodificador pega o entendimento do codificador e gera de uma vez a sequência dos próximos k passos. Ele não cospe ações uma a uma; como quem escreve uma partitura, compõe num só fôlego todo o "movimento futuro" — essa é a razão fundamental de os blocos serem internamente tão coerentes.
14.4 O que é um Transformer
14.4 O que é um Transformer: a intuição da atenção
As oficinas 2 e 3 do ACT são Transformer, mas o que É um Transformer?
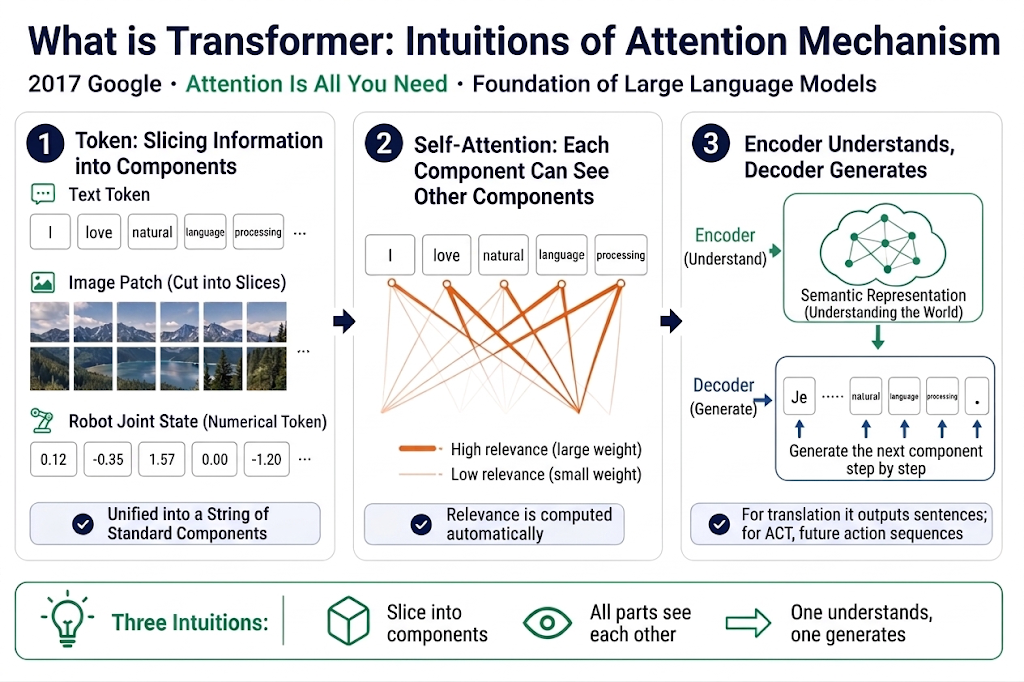
Foi proposto pelo Google em 2017 para tradução automática; o paper se chama "Attention Is All You Need", e depois virou a arquitetura base dos grandes modelos de linguagem. Sem fórmulas — três intuições bastam:
- Token: cortar a informação em "peças". O Transformer não processa frases ou pixels crus; primeiro corta a entrada em peças padronizadas (tokens) — uma frase em palavras, uma imagem em patches, um vetor de estado também pode ser um token. Unificada a informação em "sequência de peças", o mesmo mecanismo processa tudo.
- Auto-atenção: toda peça pode "ver" todas as outras. É o núcleo do Transformer. Ao processar cada peça, ele calcula a relevância dela com todas as outras e se concentra em absorver das mais relevantes — "o que olhar" não é prescrito por humanos; o modelo aprende.
- Codificador e decodificador: um entende, outro gera. O codificador funde uma sequência de entrada em "um entendimento da situação"; o decodificador toma esse entendimento e gera uma nova sequência — na tradução, a frase no idioma alvo; no ACT, a sequência de ações futuras.
14.5 Como o Transformer é usado no ACT
14.5 Como o Transformer é usado no ACT
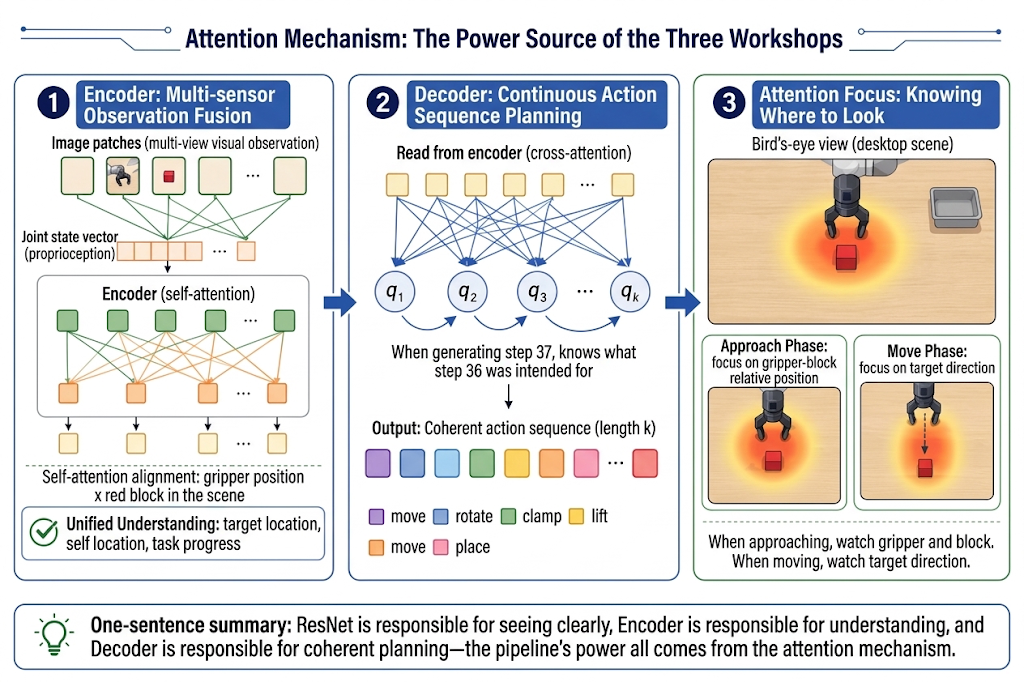
- No codificador: fundir múltiplas observações. Os patches visuais das duas imagens (via ResNet) mais o vetor de estado viram tokens do codificador. A auto-atenção os alinha — "a posição atual da garras" e "aquele bloco vermelho na imagem" se ligam num entendimento único: onde está o alvo, onde estou, como vai a tarefa.
- No decodificador: planejar toda a sequência de uma vez. O decodificador usa k vetores de consulta correspondentes aos k passos futuros; essas consultas extraem do entendimento do codificador e se coordenam entre si por auto-atenção — a ação do passo 37 "sabe" o que o passo 36 pretende. O bloco inteiro é um todo orgânico, não 100 decisões isoladas.
- No foco da atenção: saber "o que olhar". Ao gerar cada ação, o modelo se concentra automaticamente nas regiões mais relevantes — na aproximação, na posição relativa garras-objeto; em movimento, na direção do alvo — sem tratar todas as regiões igualmente.
Numa frase: o ResNet "enxerga direito", o codificador Transformer "entende", o decodificador Transformer "planeja com coerência" — tudo movido a atenção.
14.6 O que é CVAE
14.6 O que é CVAE
CVAE (autoencoder variacional condicional). O ACT do LeRobot na verdade treina com isso — só não aparece na linha lerobot-train --policy.type=act.
O buraco que ele evita: o erro da média
O papel do CVAE não é "reduzir o humano a uma única resposta correta", mas admitir: dada a observação, as ações podem ter vários estilos; no treino ele identifica primeiro qual é, e depois reproduz aquela sequência.
O paper comparou (em tarefas simuladas):
- Se as demonstrações são roteirizadas (um único jeito), tirar o CVAE quase não afeta o sucesso.
- Com dados humanos, tirar derruba o sucesso de ~35% para 2%.
Ou seja, o CVAE não está aí para enfeitar fórmulas, mas para o modelo aguentar dados onde "o humano troca de método e treme a mão".
"Condicional" significa: as ações geradas devem se fundamentar no que se vê — tenha um bloco ou uma caneta na mesa, ele não pode inventar. O CVAE é "dado o que você vê, compor como se mover".
14.7 Bloco de ação vs. horizonte de ação
14.7 Bloco de ação vs. horizonte de ação
Os dois conceitos melhor distinguidos do capítulo; dois parâmetros ajustáveis de forma independente:
- Bloco de ação (Action Chunk): o comprimento da sequência que o modelo prevê numa passada, isto é, as linhas k da matriz de saída. No LeRobot, o ACT usa 100 por padrão.
- Horizonte de ação (Action Horizon): previstos esses 100 passos, quantos são de fato executados em malha aberta antes de reobservar e reprever.
A relação: o bloco previsto pode ser longo, mas cada vez só se confia no primeiríssimo trecho.
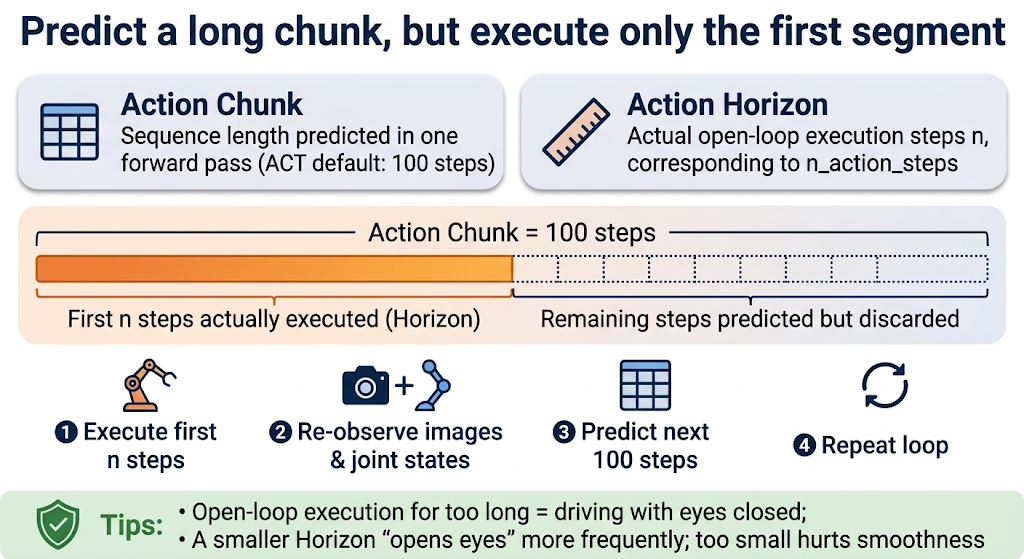
Por que não executar os 100? Porque prever longe é menos confiável — o ambiente muda, objetos são empurrados, e na segunda metade a "situação assumida" já se afastou da realidade. Malha aberta longa demais = dirigir de olhos fechados. Quanto menor o horizonte, mais vezes o modelo "abre os olhos para re-conferir", ficando mais robusto a perturbações; porém pequeno demais perde a suavidade do chunking.
É como navegar com o celular dirigindo. O navegador (o modelo) calcula a rota inteira (bloco) de uma vez, mas você não trava o volante — a cada poucos quilômetros espia o trânsito (reobserva) e o navegador replaneja (reprevê). A distância em que você "confia na rota velha e segue" é o horizonte.
14.8 Continuidade da ação e erro acumulado: as duas defesas do ACT
14.8 Continuidade da ação e erro acumulado: as duas defesas do ACT
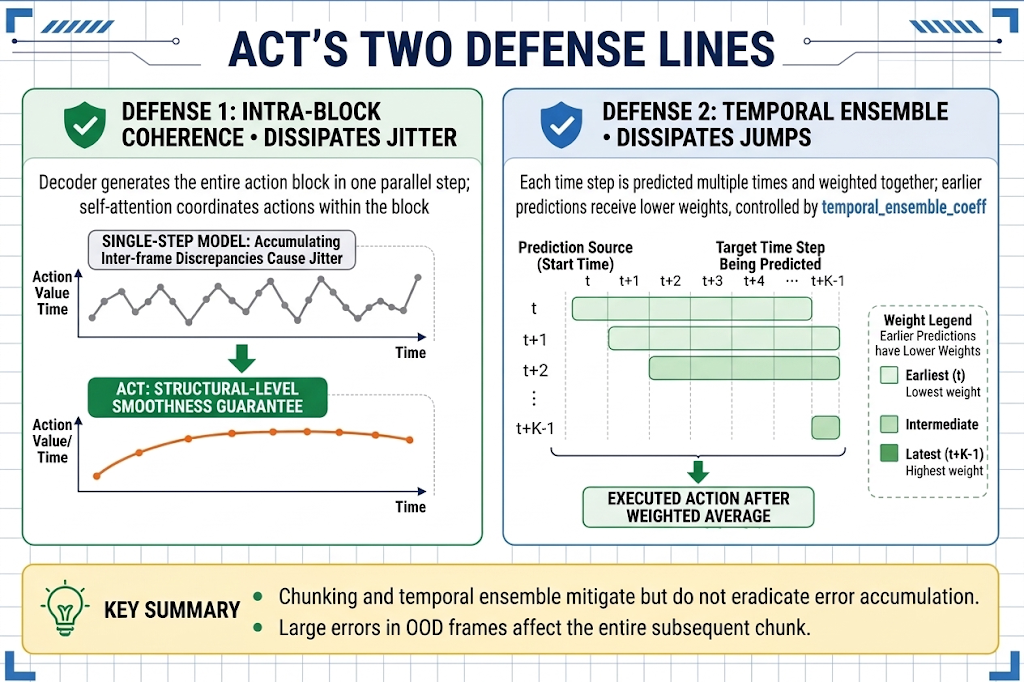
O Capítulo 8 deixou duas ameaças à estabilidade real: tremor de ação e erro acumulado. Vejamos como o ACT as aborda de forma estruturada.
- Defesa 1: coerência intra-bloco corrige o tremor.
- Defesa 2: ensemble temporal corrige as descontinuidades.
14.9 Para quais tarefas o ACT serve?
14.9 Para quais tarefas o ACT serve?
Dadas as características do ACT, sua "zona de conforto" é clara — e o SO-ARM está bem no meio dela:
| Serve para | Motivo |
|---|---|
| Manipulação de mesa (pegar, colocar, organizar, encaixar) | O ACT nasceu dessas tarefas; dados e tamanho combinam |
| Uma ou poucas tarefas | A clonagem aprende mapeamentos específicos; mais tarefas = mais dados |
| Tarefas curtas (segundos a ~1 minuto) | O erro acumula com o tempo; curtas são mais estáveis |
| Cenas com informação visual suficiente | Frontal + lateral cobrindo o essencial |
| Hardware limitado | O ACT tem poucos parâmetros; GPUs de consumo treinam e inferem; CPU também infere |
14.10 Os limites do ACT
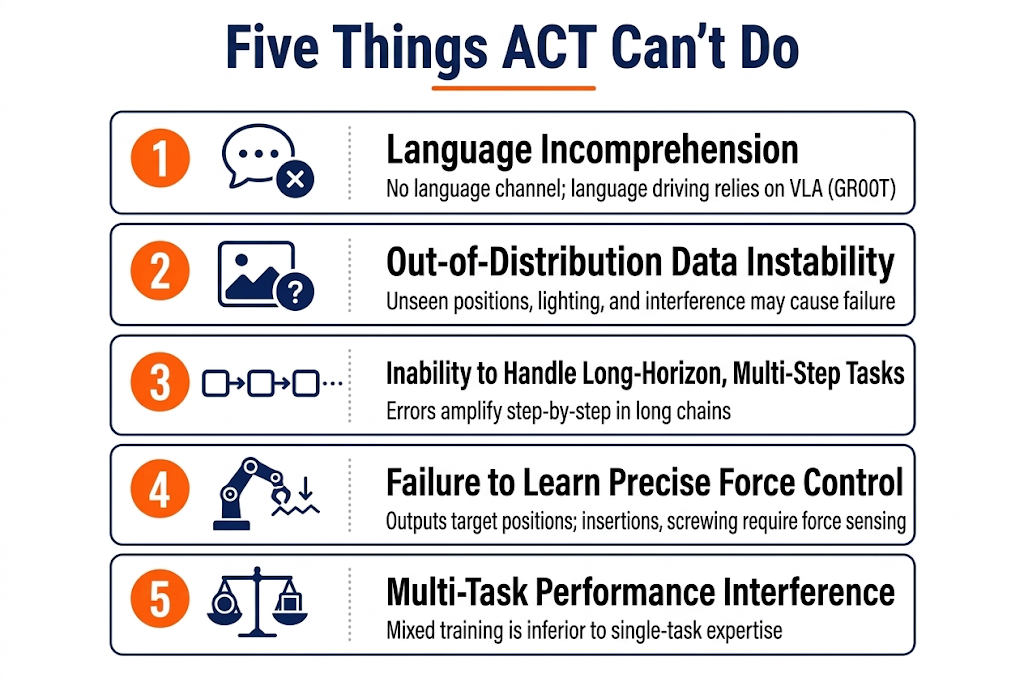
14.10 Os limites do ACT
Tão importante quanto saber o que ele não consegue fazer: