18. Aprendizado multimodal e fundamentos de VLA
Capítulo 18 do curso para iniciantes em SO-ARM Physical AI — visão/linguagem/ação, VLM vs. VLA, ACT vs. VLA, tarefas condicionadas a linguagem, níveis de generalização, ações contínuas vs. tokens, e capacidades e limites da VLA.
Hardware necessário para esta fase
A lista completa de cada fase está no Capítulo 3.
Unidade de controle principal
| Item | Comprar | Qtd. |
|---|---|---|
| NVIDIA Jetson AGX Thor 128G | 🛒 | 1 |
Também um desktop ou notebook: Ubuntu 22.04, GPU de 12GB+ (para o ajuste fino do GR00T, ~25GB de VRAM — ver 18.8) e 16GB+ de RAM.
Para esta fase
| Item | Comprar | Qtd. |
|---|---|---|
| Kit SO-ARM101 (líder + seguidor) | 🛒 | 1 |
| Câmera USB de 32 × 32 mm | - | 2 |
Nos capítulos anteriores, você usou políticas como ACT (Action Chunking with Transformers) no SO-ARM para completar um aprendizado por imitação que "olha a imagem e emite ações de junta". Esses métodos costumam ser treinados para uma tarefa única: o modelo só aprende "colocar o cubo vermelho na caixa", e trocar de tarefa exige recoletar e retreinar.
Este capítulo introduz a ideia central da VLA (Visão-Linguagem-Ação): fazer o robô não só "ver", mas também "entender" instruções em linguagem natural, e compartilhar uma única rede de política entre várias tarefas.
18.1 O que é um modelo multimodal
18.1 O que é um modelo multimodal?
Um modelo multimodal funde mais de um tipo de informação — imagens, texto e estado do robô — numa decisão unificada. No contexto VLA, as três modalidades abaixo são combinadas e decodificadas em ações do robô.
18.2 Visão, linguagem e ação
18.2 Visão, linguagem e ação
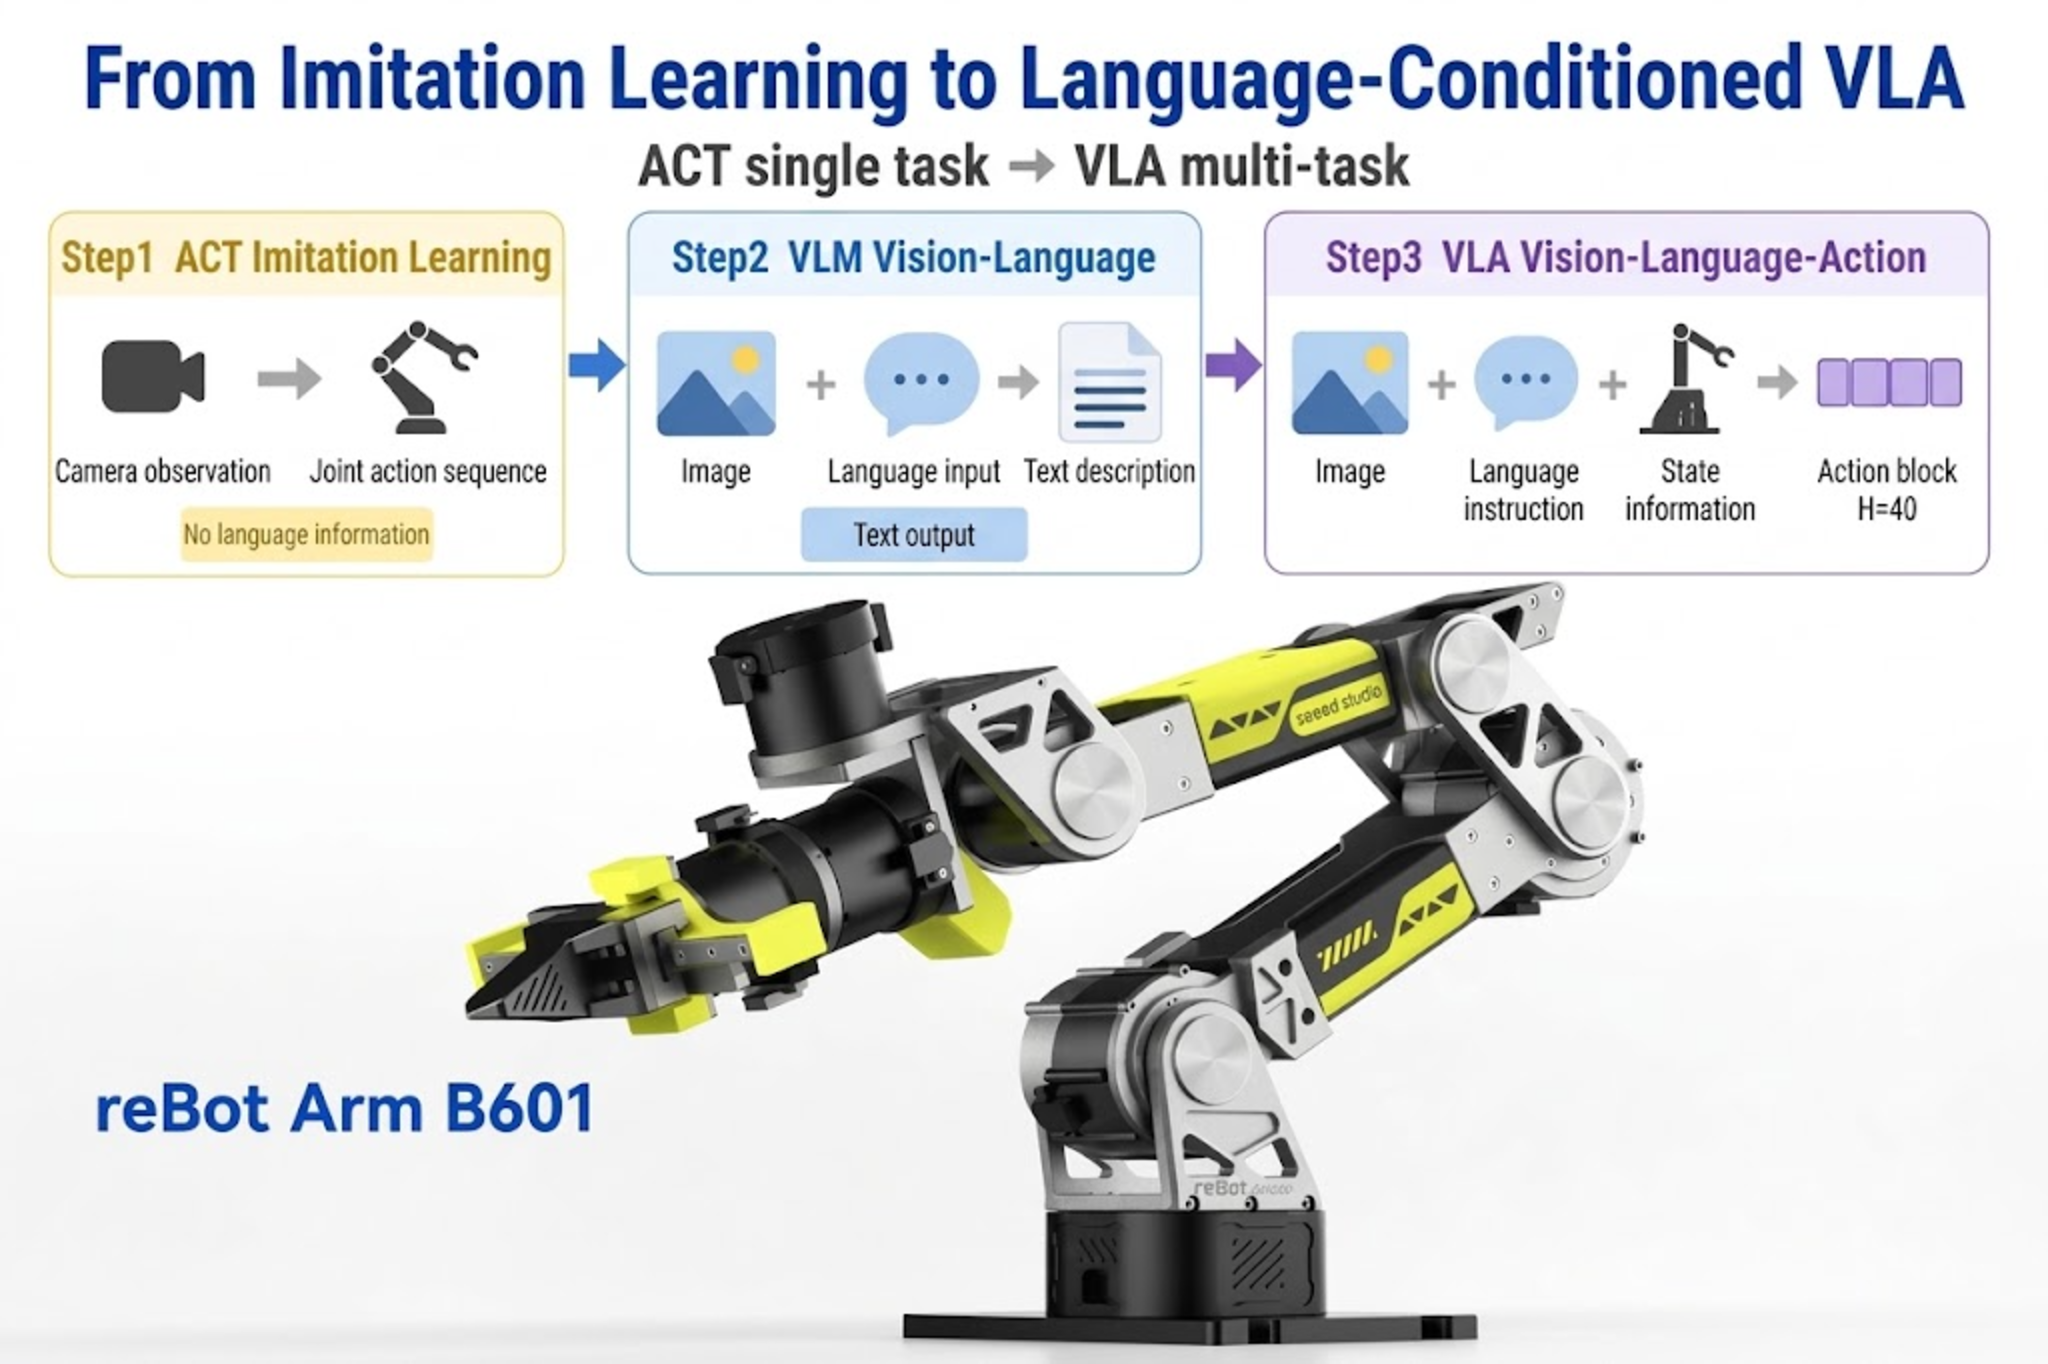
No arcabouço VLA, cada modalidade tem papel claro:
| Modalidade | Significado | Origem típica no SO-ARM |
|---|---|---|
| Visão | Imagens RGB das câmeras | Câmeras USB frontal e lateral |
| Linguagem | Descrição natural da tarefa | "Coloque a chave de fenda na caixa de ferramentas" |
| Ação | Comandos de controle do robô | Ângulos-alvo das 5 juntas + abertura da garras |
O Estado costuma aparecer em par com a Ação: o Estado descreve "onde o robô está agora", a Ação "para onde vai em seguida". Nos datasets LeRobot, ficam nos campos observation.state e action; no GR00T são divididos via meta/modality.json em subchaves como state.single_arm e state.gripper.
A diferença-chave entre VLA e políticas puramente visuais: a linguagem vira variável de condicionamento. No treino, toda trajetória de demonstração se liga a uma descrição de tarefa; na inferência, basta trocar o texto da instrução, sem trocar os pesos (dentro da cobertura dos dados).
18.3 Diferença entre VLM e VLA
18.3 Diferença entre VLM e VLA
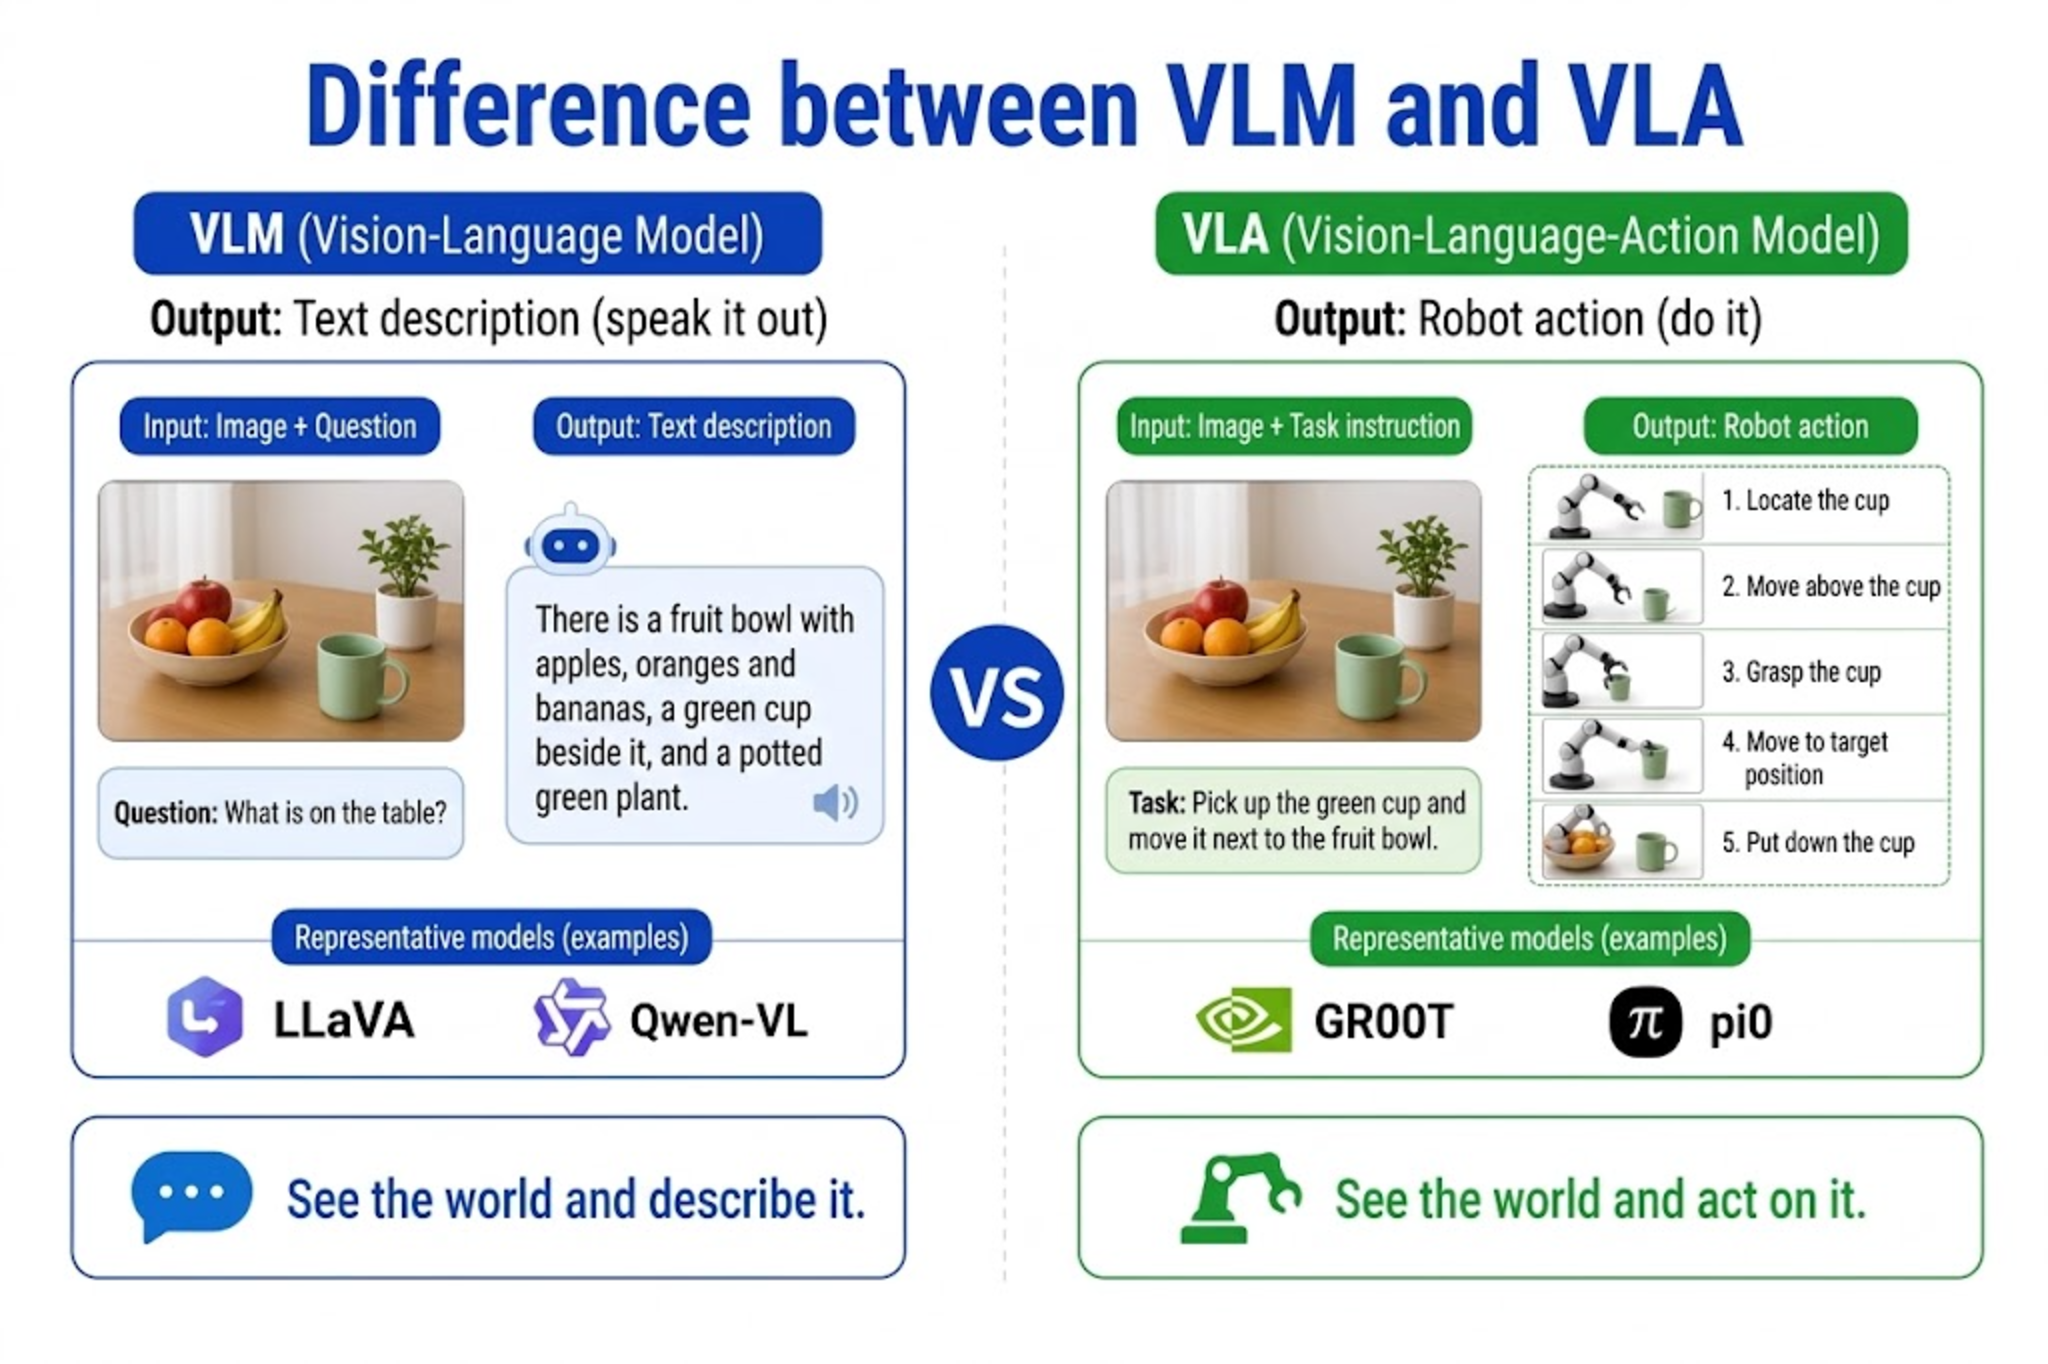
| Aspecto | VLM (Vision-Language Model) | VLA (Vision-Language-Action) |
|---|---|---|
| Saída | Texto, descrições, resultados de raciocínio | Sequência de ações do robô |
| Uso típico | QA de imagem, compreensão de cena, legendas | Preensão, colocação, abrir/fechar e outras manipulações |
| Modelos representantes | LLaVA, Qwen-VL, Cosmos-Reason | GR00T, pi0, OpenVLA |
| Relação com o robô | Pode ajudar no planejamento; não aciona motores | Emite comandos de controle ponta a ponta |
Dá para entender simplesmente: o VLM cuida de "entender o mundo e falar dele"; a VLA, de "entender o mundo e agir".
O Isaac GR00T reutiliza capacidades VLM na arquitetura: um backbone VLM codifica imagens e linguagem, seguido de uma cabeça de ação Diffusion Transformer (DiT) que decodifica as representações semânticas em blocos contínuos de ação. O GR00T é, portanto, uma VLA que também embute forte capacidade de representação VLM.
18.4 Diferença entre ACT e VLA
18.4 Diferença entre ACT e VLA
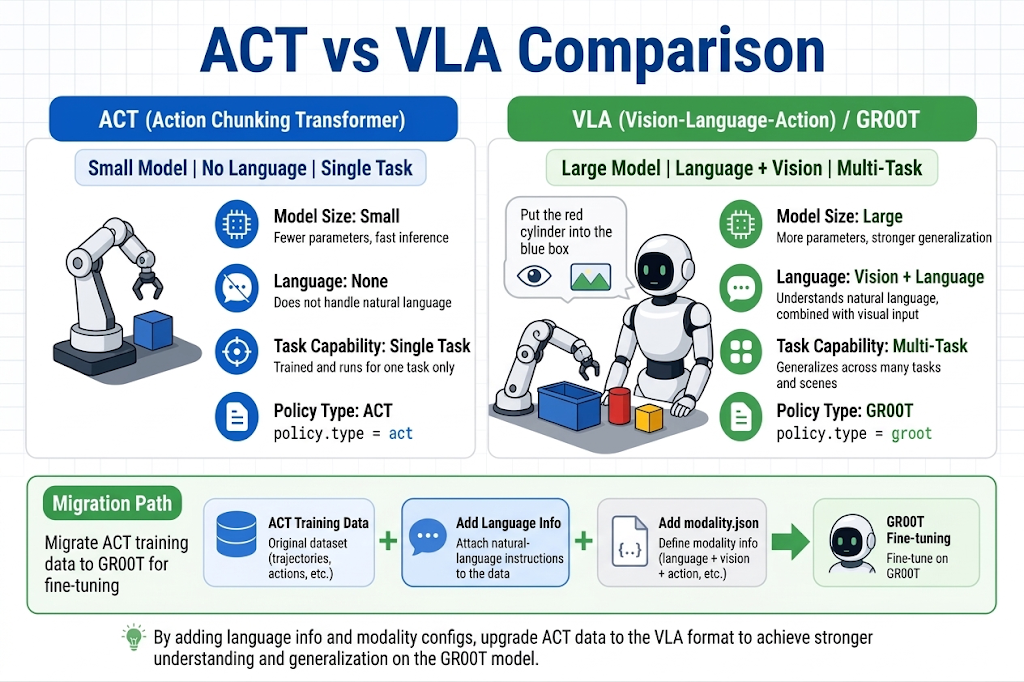
O ACT dos capítulos anteriores e a VLA deste pertencem à família do aprendizado por imitação (clonagem de comportamento), mas os objetivos diferem:
| Aspecto | ACT | VLA (GR00T como exemplo) |
|---|---|---|
| Condição da tarefa | Normalmente sem linguagem, tarefa única implícita | Linguagem + visão, multitarefa explícita |
| Tamanho do modelo | Menor (dezenas de milhões de parâmetros) | Maior (modelo fundacional de bilhões) |
| Treinamento | Do zero ou ajuste leve | Pré-treino fundacional + ajuste fino |
| Representação de ação | Bloco de ações | Bloco de ações + denoise Flow Matching |
| Generalização | Bom dentro da distribuição; retreina ao trocar de tarefa | O condicionamento por linguagem apoia transferência zero/few-shot |
| Tipo de política LeRobot | act | groot |
A técnica central do ACT é o bloqueio de ações: prever de uma vez vários passos futuros para reduzir o erro acumulado da inferência passo a passo. O GR00T também prevê blocos (o comprimento da janela varia por versão — N1.5: action_horizon = 16).
Rota de migração: se você já tem um dataset ACT do SO-ARM (formato LeRobot), o Capítulo 20 só exige acrescentar anotações de linguagem e a configuração de Modality para usá-lo no ajuste fino do GR00T, sem recoletar todas as demos.
O GR00T N1.5 roda no SO-ARM pela configuração de dados so100_dualcam oficialmente suportada e pela etiqueta new_embodiment — o SO-ARM é um dos embodiments de baixo custo melhor suportados do ecossistema GR00T, com um guia oficial de ajuste para SO101 da NVIDIA.
18.5 Tarefas robóticas condicionadas a linguagem
18.5 Tarefas robóticas condicionadas a linguagem
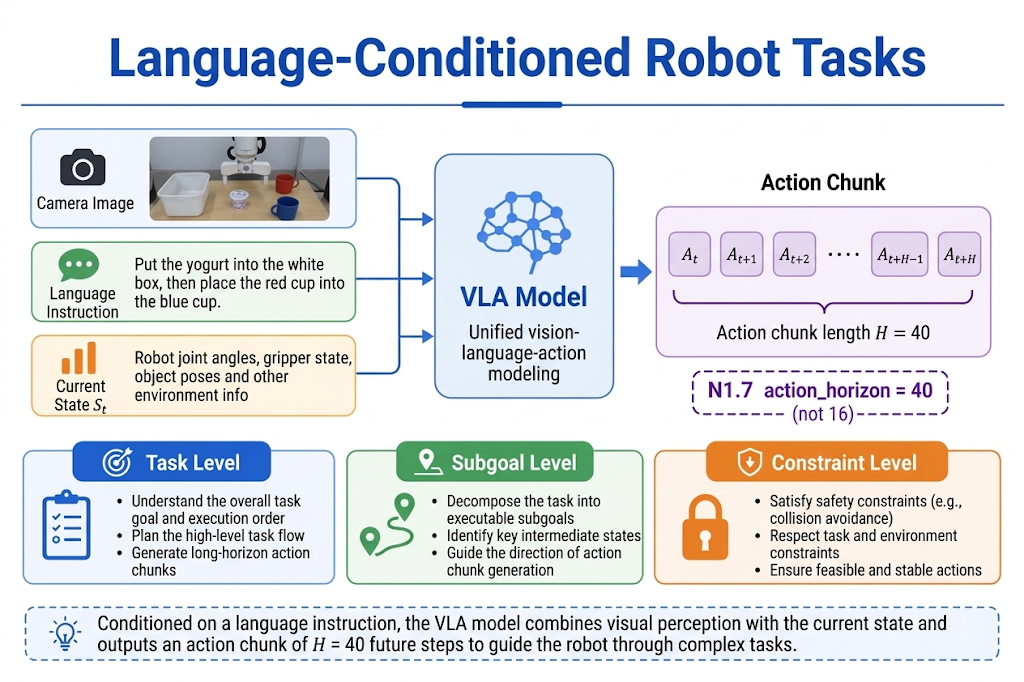
A forma padrão de uma tarefa condicionada:
Entrada: imagem I_t + instrução L + estado atual S_t
Saída: ações A_{t:t+H} (bloqueio dos próximos H passos)
A granularidade da instrução pode variar:
- Nível tarefa: "coloque o cubo vermelho na caixa azul" (uma frase compartilhada pela trajetória inteira)
- Nível subobjetivo: "primeiro aproxime-se do objeto" -> "depois feche a garras" (anotação por segmentos, avançado)
- Nível restrição: "coloque com delicadeza", "evite obstáculos" (modifica como a ação é executada)
No LeRobot, a linguagem costuma ficar em meta/tasks.jsonl ou no campo annotation. O GR00T lê pela chave annotation do modality.json; duas formas comuns:
| Chave | Datasets típicos | Recomendação SO-ARM |
|---|---|---|
human.task_description | SO-100 / SO101, cube_to_bowl e tarefas simples de mesa | Recomendada: coerente com o exemplo do Capítulo 20 |
human.action.task_description | LIBERO, SimplerEnv e benchmarks de simulação | Só se seus dados vêm desses benchmarks |
As duas chaves são válidas, mas precisam casar com os campos reais do dataset; não misture entre treino e inferência.
Conselhos práticos (SO-ARM):
- Ao gravar cada demonstração, descreva a tarefa em uma frase curta começando por verbo, em chinês ou inglês.
- Mantenha a redação consistente em tarefas parecidas, ex.: sempre "coloque X em Y".
- Evite que um mesmo dado corresponda a várias redações; quanto mais consistente no começo do ajuste, melhor.
18.6 Tarefa única, multitarefa e generalização
18.6 Tarefa única, multitarefa e generalização
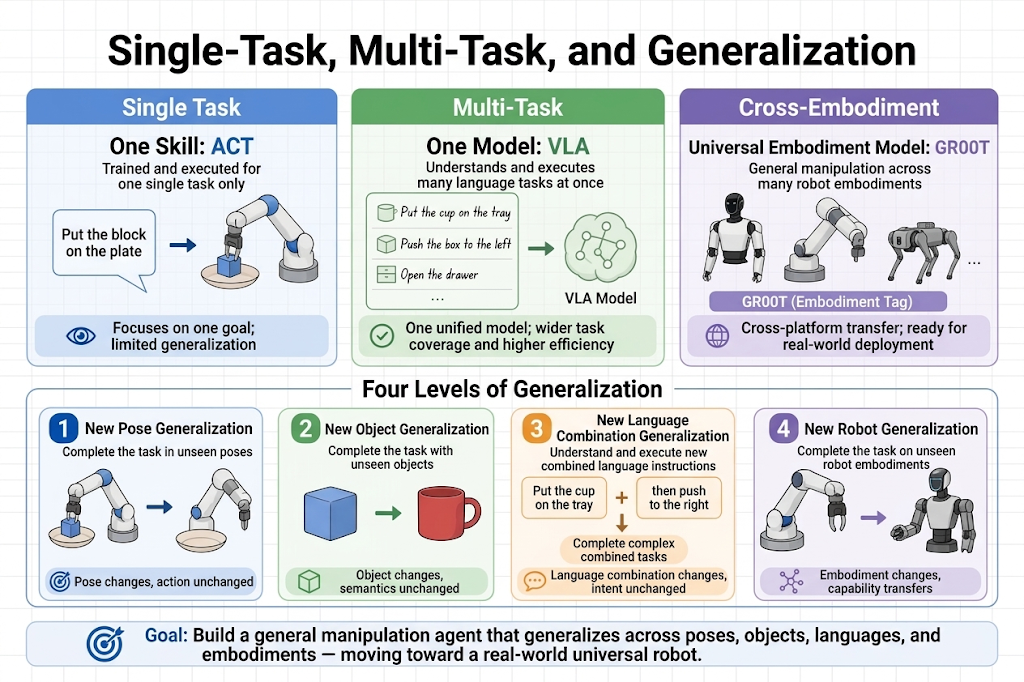
| Paradigma | Descrição | Cenários |
|---|---|---|
| Tarefa única | Aprende uma habilidade só | Padrão do ACT; poucos dados, objetivo claro |
| Multitarefa | O mesmo modelo aprende várias habilidades, distinguidas por linguagem | Ajuste fino VLA; arrumar mesa, separar |
| Generalização entre embodiments | Robôs diferentes compartilham um modelo fundacional | Pré-treino GR00T; adaptação via embodiment_tag |
A "generalização" em VLA tem vários níveis — não os confunda:
- Mesma tarefa, nova pose inicial: continua agarrando com o objeto em outro lugar — o ACT normalmente também consegue.
- Objetos e recipientes novos: depende da generalização visual — exige diversidade suficiente no treino.
- Combinações novas de instrução: "coloque A em B" nunca vista mas de padrão familiar — a vantagem do condicionamento por linguagem.
- Novo embodiment: continua servindo ao trocar de braço — exige a camada de projeção de embodiment do GR00T mais uma pequena quantidade de dados de ajuste.
Para usuários do SO-ARM, a expectativa realista é: após o ajuste, alternar entre as tarefas de linguagem já coletadas; para objetos ou padrões de frase totalmente novos, ainda serão necessários dados de demonstração adicionais.
18.7 Ações contínuas e tokens de ação
18.7 Ações contínuas e tokens de ação
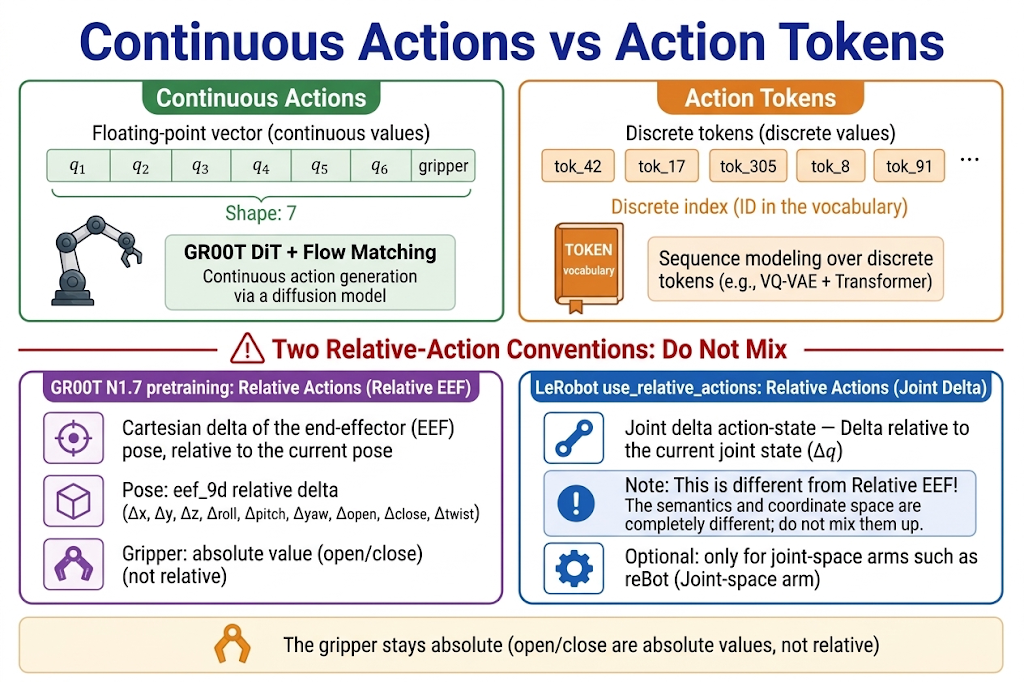
Há duas representações principais para os comandos do robô:
Ações contínuas
Devolve diretamente um vetor de ponto flutuante, ex.: 5 ângulos + 1 abertura de garras:
action = [q1, q2, q3, q4, q5, gripper] # shape: (6,)
- Vantagem: precisão alta, coerente com a interface real dos motores.
- Desvantagem: regressão em espaço de alta dimensão é difícil.
- O GR00T usa: DiT + Flow Matching para denoise em espaço contínuo, emitindo blocos.
Tokens de ação (ações discretizadas)
Quantiza valores contínuos em símbolos discretos, como um modelo de linguagem prevendo o próximo token:
action_tokens = [tok_42, tok_17, tok_89, ...]
- Vantagem: reutiliza arquiteturas LLM autorregressivas; adotado por VLAs como pi0-FAST.
- Desvantagem: perda por quantização, vocabulário complexo.
Relativas vs. absolutas: o espaço pré-treinado do GR00T usa ações relativas (incrementos em relação ao estado atual) para alguns grupos de embodiment e posições articulares absolutas para outros; a garras permanece absoluta. Trajetórias relativas são mais suaves, mas a execução prolongada pode derivar. No ajuste do SO-ARM você se apoia sobretudo nos padrões da configuração so100_dualcam — a moral é uma só: não edite à mão transformações do espaço de ações que você não entende.
18.8 Capacidades e limites da VLA
18.8 Capacidades e limites da VLA
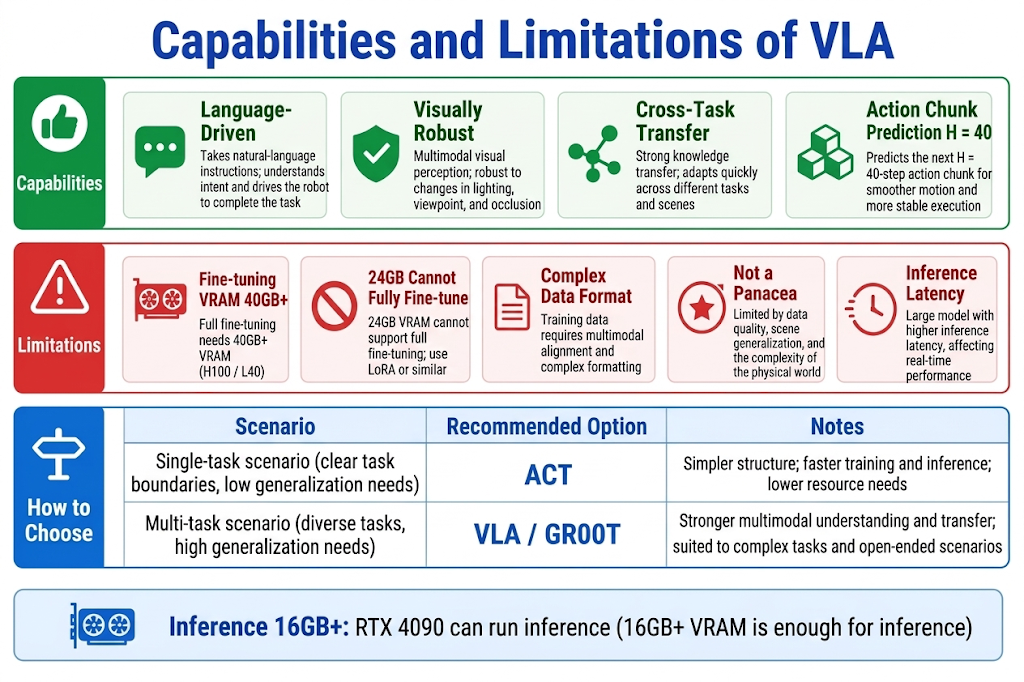
Capacidades
- Guiada por linguagem: um modelo, muitas tarefas; troque a instrução e muda o comportamento.
- Robustez visual: o pré-treino em larga escala traz compreensão de cena melhor que um ACT pequeno.
- Transferência entre tarefas: representações compartilháveis entre padrões e objetos parecidos.
- Predição por blocos: uma inferência emite vários passos, adequada ao controle em tempo real.
Limites
- Alta exigência de compute: o ajuste do GR00T N1.5-3B precisa de uns 25GB de VRAM (Ampere ou mais novo — ex.: RTX 4090 / A6000; V100 sem suporte), reduzíveis com
--no-tune_diffusion_model. A inferência é mais leve e roda no Jetson AGX Thor (Capítulo 21) — e o Capítulo 22 nem precisa de GPU. - Formato de dados mais complexo: além dos campos LeRobot padrão, exige
modality.jsone etiqueta de embodiment. - Não é panaceia: objetos, instruções e bancadas fora da cobertura do treino ainda podem falhar.
- Latência: inferir um modelo grande é mais lento que o ACT; ajuste bem a janela de ações e os parâmetros de inferência.
- Gap sim-real: o pré-treino é dominado por plataformas específicas; braços de mesa exigem ajuste suficiente.
Quando escolher ACT, quando VLA?
| Cenário | Recomendação |
|---|---|
| Tarefa repetitiva única, dispositivo de borda, baixa latência | ACT |
| Multitarefa, interação por linguagem, disposto a investir GPU e anotação | VLA / GR00T |
| Já tem dados ACT e quer expandir para multitarefa | Some linguagem aos dados LeRobot -> ajuste GR00T (Capítulo 20) |
| Sem GPU de treino | VLA sem código no SenseCraft Robotics (Capítulo 22) |
18.9 Resumo do capítulo
18.9 Resumo do capítulo
- Modelos multimodais fundem visão, linguagem e estado em decisões unificadas.
- A VLA acrescenta saída de ação sobre a VLM, apoiando manipulação condicionada a linguagem.
- ACT é a solução leve de tarefa única; GR00T, a solução VLA de pré-treino em larga escala + ajuste.
- O SO-ARM é suportado oficialmente no GR00T via
so100_dualcam+new_embodiment. - O próximo capítulo explica como aterrar a VLA geral neste embodiment específico, o SO-ARM.