8. Fundamentos do aprendizado em robótica e imitação
Capítulo 8 do curso para iniciantes em SO-ARM Physical AI — por que o braço precisa aprender, controle por regras vs. por aprendizado, observação/estado/ação, blocos de ação, distribuição de dados e as três fases de treinamento, inferência e avaliação.
Hardware necessário para esta fase
A lista completa de cada fase está no Capítulo 3.
Unidade de controle principal
| Item | Comprar | Qtd. |
|---|---|---|
| reComputer Robotics J4012 | 🛒 | 1 |
Também é preciso um desktop ou notebook: Ubuntu 22.04, CUDA 12+ e, para treinar, GPU NVIDIA com 12GB+ de VRAM e 16GB+ de RAM.
Para esta fase
| Item | Comprar | Qtd. |
|---|---|---|
| Kit SO-ARM101 (líder + seguidor) | 🛒 | 1 |
| Câmera USB de 32 × 32 mm | - | 2 |
| Tapete de mouse / de mesa | - | 1 |
8.1 Por que braços robóticos precisam de aprendizado?
8.1 Por que braços robóticos precisam de aprendizado?
Na Fase 2 você já consegue ler e escrever cada servo do SO-ARM: consultar posições de juntas, enviar ângulos-alvo, abrir e fechar a garras. Então é natural pensar — basta escrever um programa que faça o braço pegar os blocos da mesa automaticamente, certo?
Você escreve esse programa. Na primeira demonstração do laboratório, funciona muito bem. Mas no dia seguinte as coisas mudam — e para lidar com essas mudanças, mais e mais "ifs" vão sendo adicionados, até virar um catálogo gigante de casos especiais que ninguém consegue manter.
Este é o dilema fundamental do controle programático tradicional: o mundo real muda continuamente, enquanto o if-else é discreto. Não é possível enumerar todos os estados do mundo.
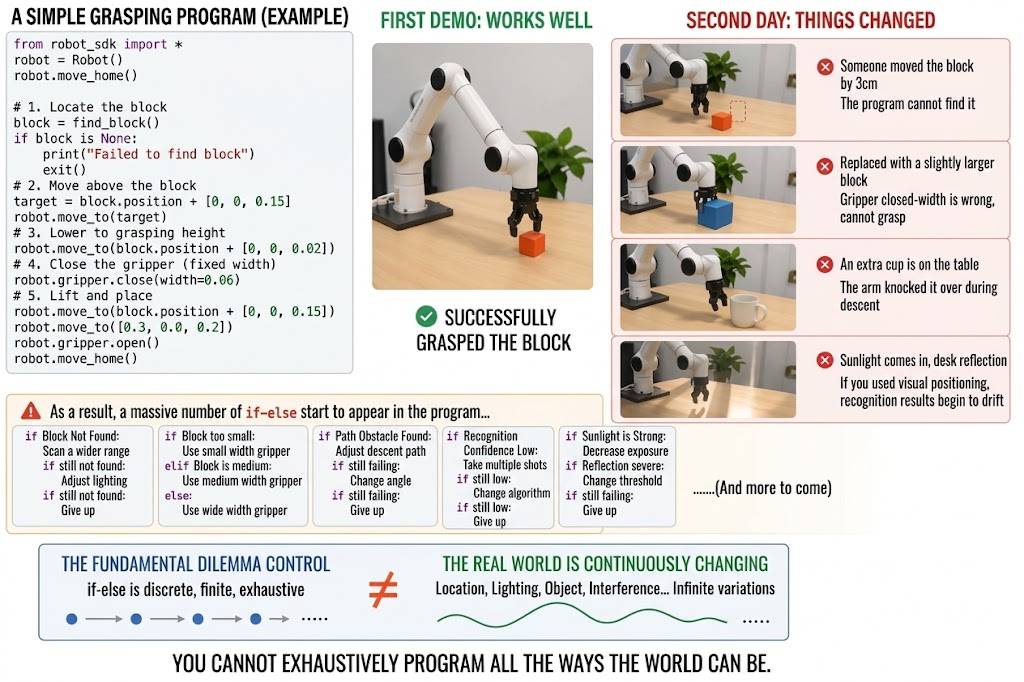
Fazer braços robóticos adquirirem habilidades dessa forma é exatamente o que o Robot Learning se propõe a resolver. E o aprendizado por imitação desta fase é a abordagem mais madura e mais fácil de levar ao hardware real.
8.2 Controle por regras vs. por aprendizado
8.2 Controle por regras vs. por aprendizado
Antes de continuar, coloquemos os dois enfoques lado a lado.
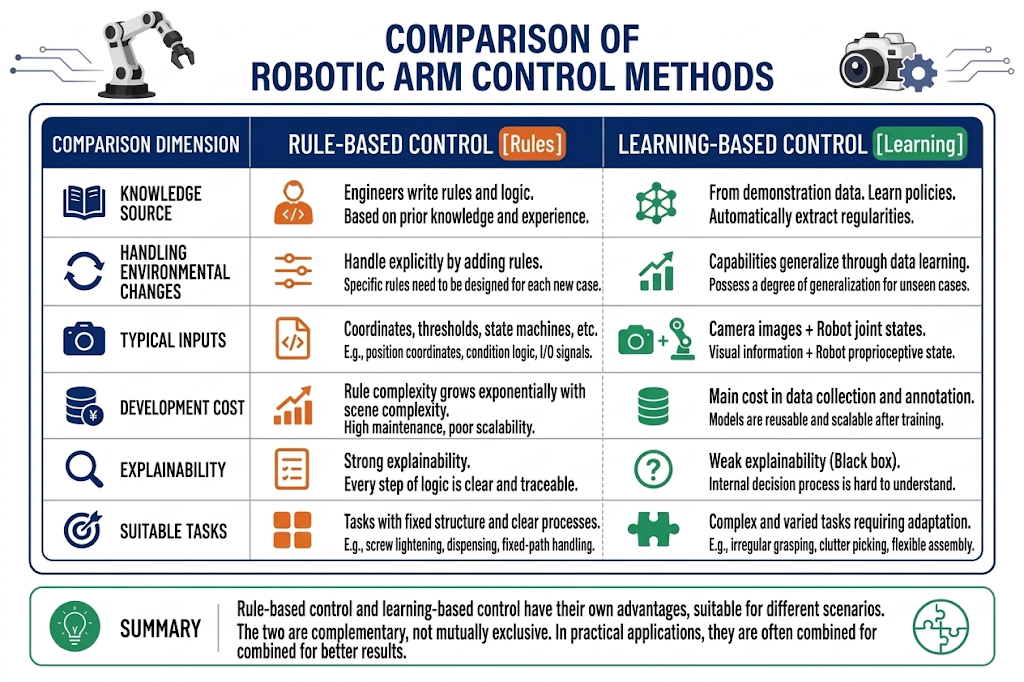
As Fases 3 e 4 deste curso seguem o caminho do "controle por aprendizado". Mas lembre-se: mesmo no futuro, seus sistemas de aprendizado ainda manterão muitas regras — limites de junta e restrições de velocidade segura, por exemplo. Aprendizado e regras são complementares.
8.3 Aprendizado por imitação e clonagem de comportamento
8.3 Aprendizado por imitação e clonagem de comportamento
O que é aprendizado por imitação
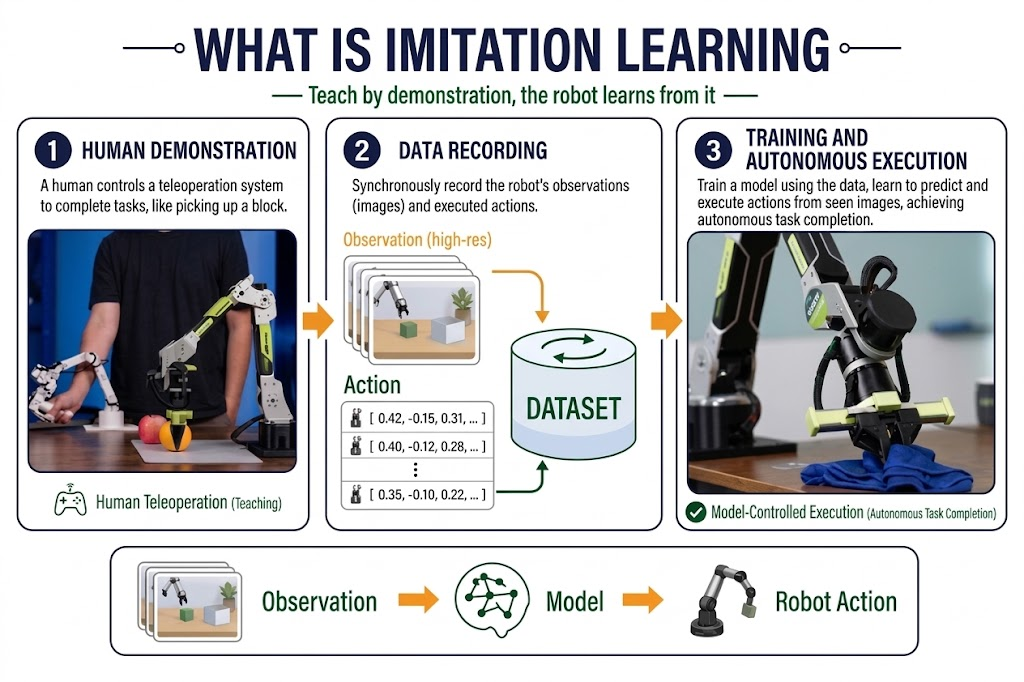
O que é clonagem de comportamento
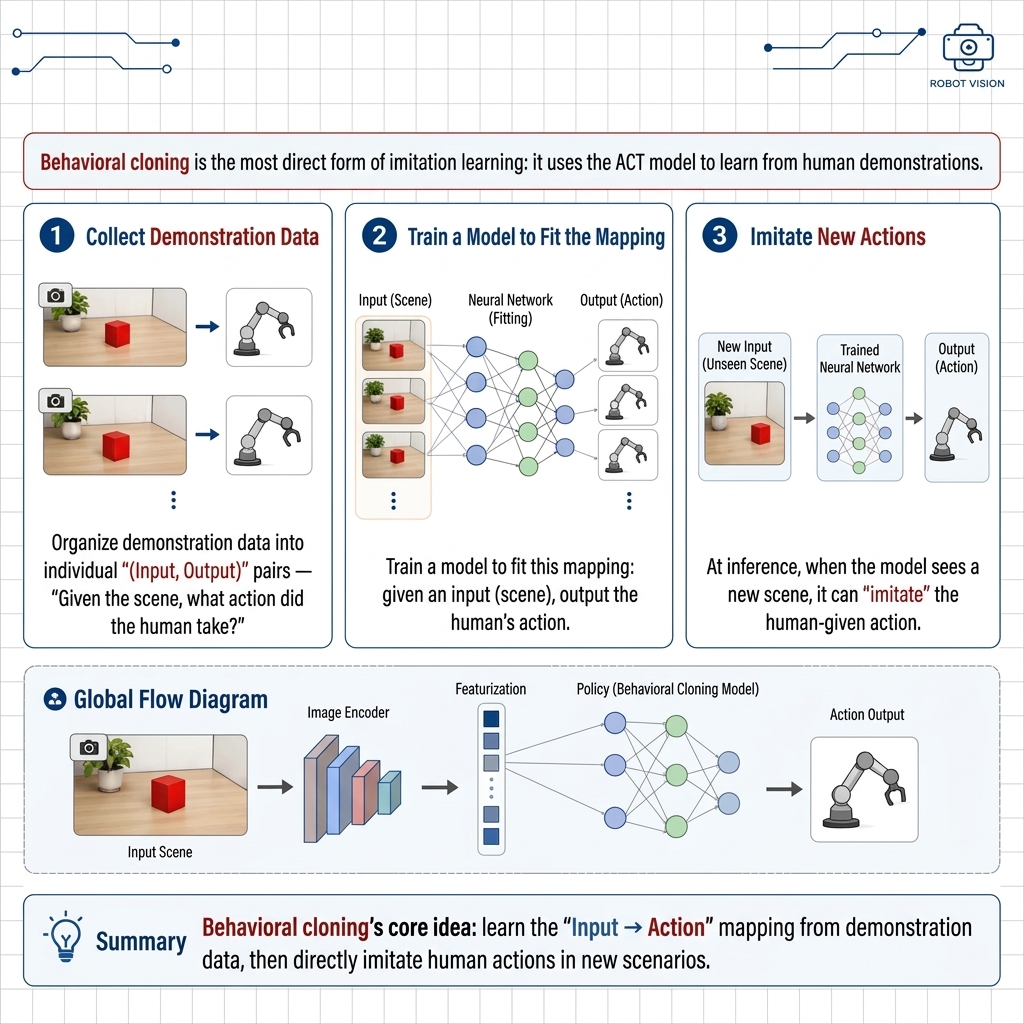
8.4 Observação, estado e ação
8.4 Observação, estado e ação
Todos os dados do aprendizado por imitação se enquadram em três conceitos. Estes termos aparecerão em todo capítulo seguinte, então construa aqui uma intuição precisa.
- Observação: o mundo que o robô "vê";
- Estado: a condição "própria" do robô;
- Ação: o que o robô "vai fazer".
No SO-ARM: a observação são as duas imagens de câmera, o estado são as 6 leituras de juntas do seguidor (5 juntas + garras), e a ação são os 6 valores-alvo seguintes.
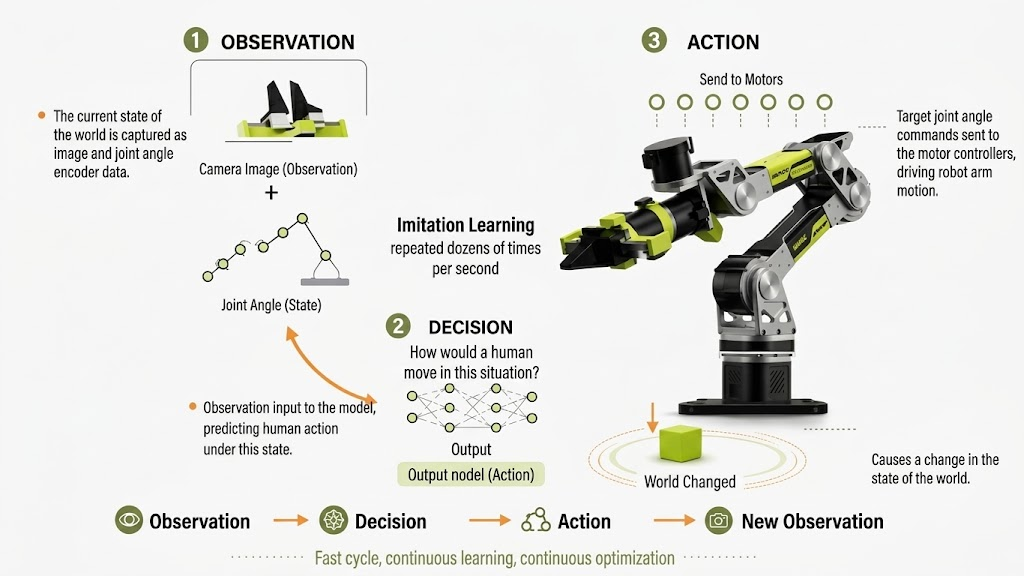
8.5 Ações de um passo vs. blocos de ação
8.5 Ações de um passo vs. blocos de ação
- Ação de um passo: uma decisão por quadro;
- Bloco de ação: prever de uma vez uma sequência de ações.
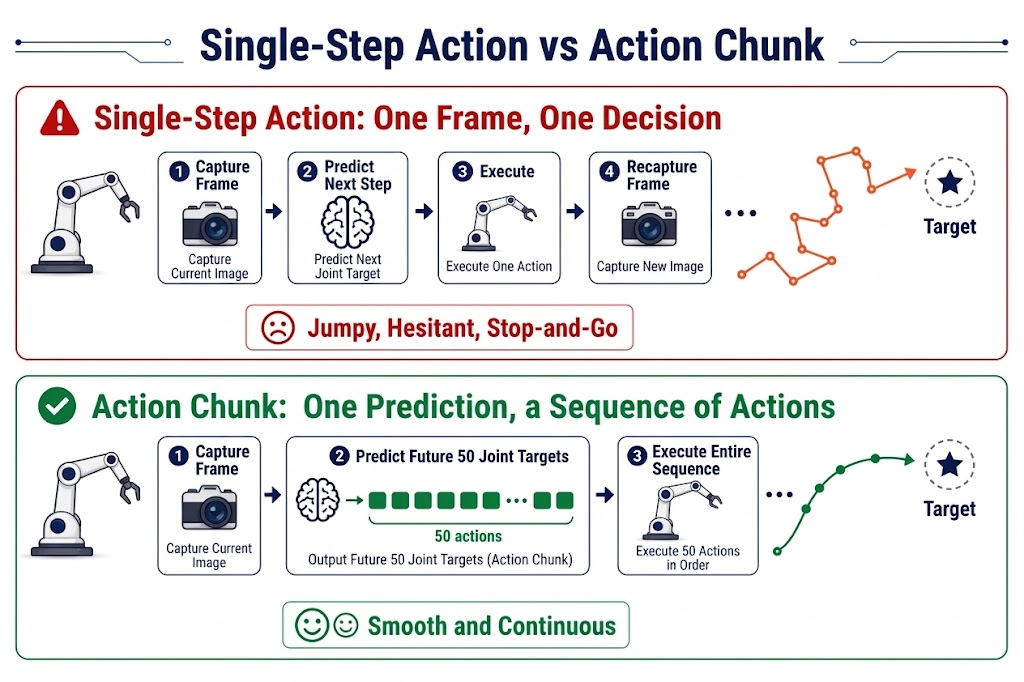
Claro, blocos mais longos nem sempre são melhores. Prever longe demais significa que o ambiente pode mudar no meio da execução (um objeto é empurrado) enquanto o braço ainda executa ações "defasadas". Sistemas reais usam um compromisso: executar em malha aberta um trecho curto, e então reobservar e reprever.
8.6 Distribuição de dados e generalização do modelo
8.6 Distribuição de dados e generalização do modelo
Esta é a seção mais importante do capítulo, a mais fácil de ser ignorada por iniciantes, e a que decide o sucesso na prática. Grave primeiro esta frase:
Um modelo de aprendizado por imitação só aprende o que está nos dados, e só funciona dentro do intervalo coberto pelos dados.
- Todos os pares (observação, ação) vistos no treinamento formam uma distribuição de dados. Na inferência, se as imagens e estados encontrados pelo braço caem dentro dessa distribuição, o modelo costuma render bem; ao sair dela, a saída perde fundamento e o comportamento fica imprevisível.
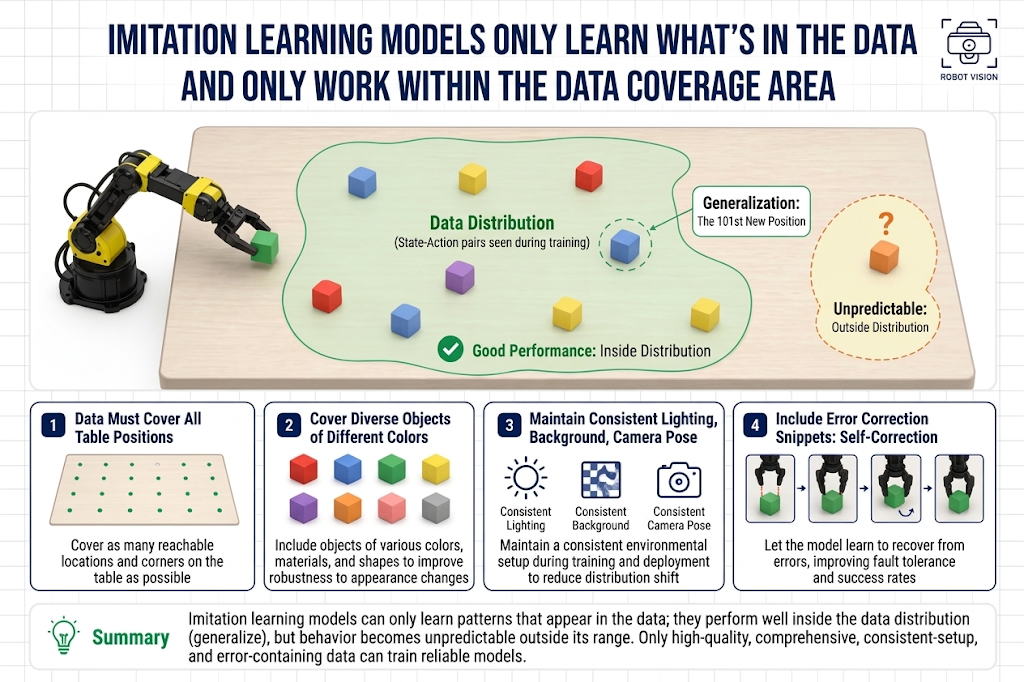
Daí vêm várias implicações práticas:
- Se quer que ele pegue blocos em qualquer posição da mesa, os dados precisam cobrir a mesa toda — coletando só no centro, o modelo só pega no centro;
- Se quer que pegue objetos de cores diferentes, os dados precisam conter essas cores — senão a cor nova é um mundo desconhecido;
- Iluminação, fundo e posição de câmera devem ficar o mais consistentes possível com a coleta — um modelo treinado com dados da tarde pode falhar por completo sob luz noturna.
E a generalização é a capacidade de aplicar padrões aprendidos a situações novas dentro da distribuição que não foram vistas uma a uma. Se o treinamento viu blocos em 100 posições e na inferência um bloco surge na 101ª (ainda na mesa), o modelo ainda pega — isso é generalização. Generalização não é mágica; vem da diversidade dos dados: quanto mais rica e contínua a cobertura, menores as "lacunas" e melhor a generalização.
O teto do aprendizado por imitação fica essencialmente decidido no momento da coleta. O treinamento apenas se aproxima desse teto.
8.7 Treinamento, inferência e avaliação
8.7 Treinamento, inferência e avaliação
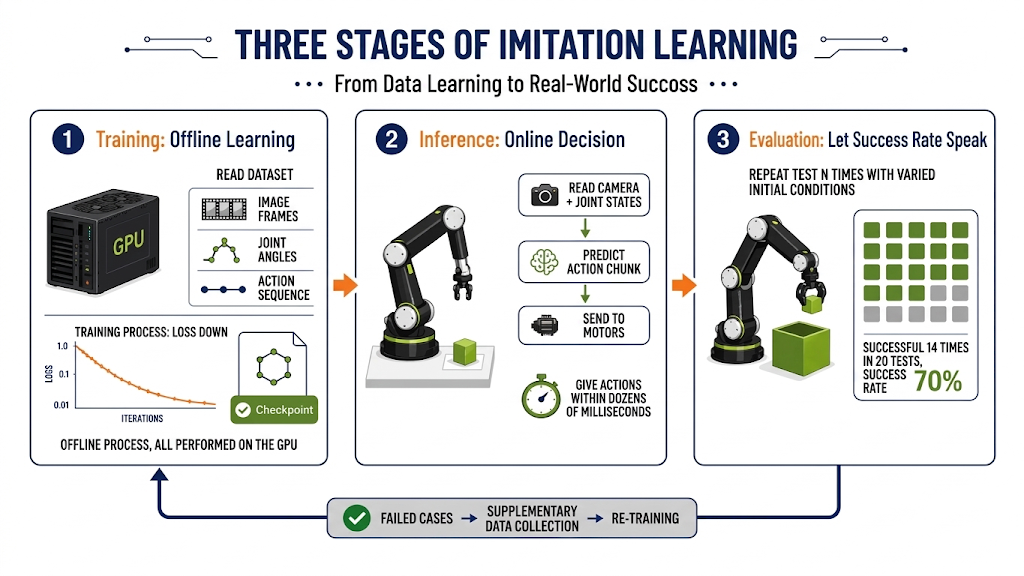
Treinamento: aprendizado offline
Acontece após a coleta; é um processo offline: o braço pode ser desligado e posto de lado; todo o trabalho é na GPU.
- Entrada: o dataset coletado (séries temporais de imagens, estado e ação);
- Processo: o modelo relê os dados repetidamente, ajustando os parâmetros para que as ações previstas se pareçam cada vez mais com as demonstrações humanas;
- Saída: um arquivo de modelo treinado.
A qualidade se observa principalmente pela Loss: conforme a Loss cai, as ações previstas se assemelham cada vez mais às demonstrações.
Inferência: decisão online
A inferência é o processo em que o modelo é implantado no robô real e opera em tempo real: ler câmeras e juntas → o modelo prevê um bloco de ações → enviar aos servos. A inferência tem requisitos de tempo real — o modelo precisa emitir ações em dezenas de milissegundos, senão o braço engasga.
Avaliação: julgada pela taxa de sucesso
O modelo treinou, a Loss está baixa — ele dá conta do trabalho? Não necessariamente.
Loss baixa só significa que o modelo é "parecido com humano", não que "ele consegue completar a tarefa". O único método confiável é o teste no robô real:
- Definir critérios claros de sucesso (ex.: "o bloco acaba dentro da caixa");
- Variar condições iniciais (posição do bloco, luz), repetir N vezes;
- Calcular a taxa de sucesso — ex.: 14 acertos em 20 testes = 70%.
As falhas encontradas na avaliação não são o fim; são insumo da próxima rodada de coleta — onde falha, colete mais ali, e retreine. Esse é o ciclo de iteração de dados, a rotina diária dos projetos reais.
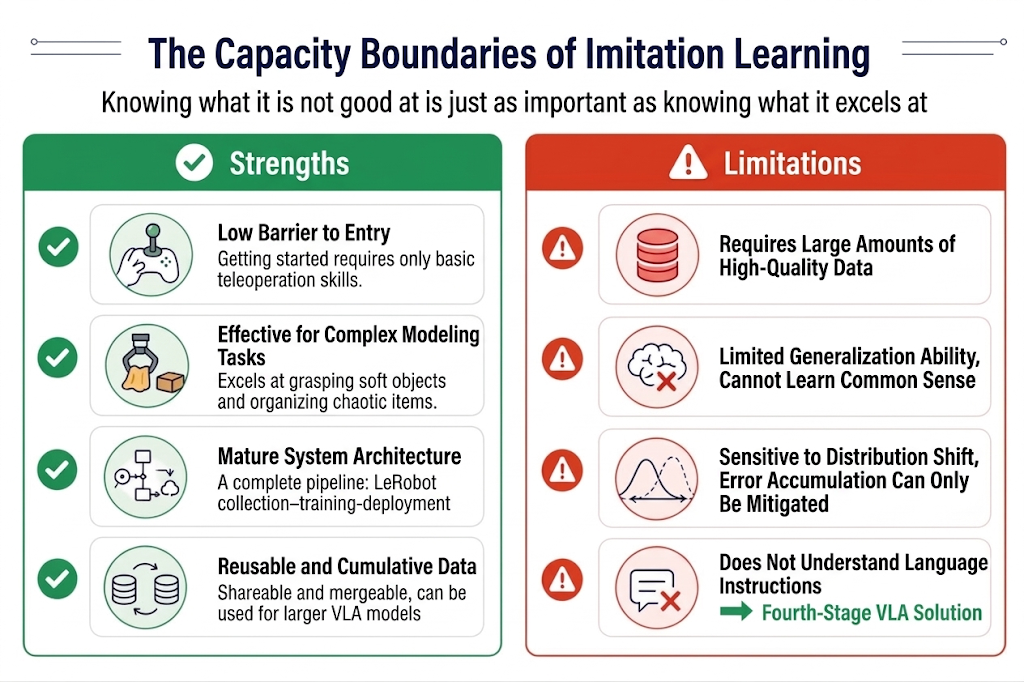
8.8 Vantagens e limitações do aprendizado por imitação
8.8 Vantagens e limitações do aprendizado por imitação