Transcrição privada local para reSpeaker Clip — seleção, implantação e dados medidos
Um Clip pareia apenas com este host e não pode ser pareado com o app de celular ao mesmo tempo. Se os resumos de IA usarem um serviço em nuvem, o texto da transcrição é enviado para ele (o áudio não é).
O que esta solução faz
Conversas, consultas e atendimentos de balcão gravados em um reSpeaker Clip são sincronizados via Bluetooth com seu próprio host reComputer e transcritos ali, cada turno com carimbo de tempo e rótulo de falante, em chinês, inglês ou japonês. O áudio não sai do local; os resultados são vistos na página web do host ou puxados para o seu próprio sistema via MQTT e HTTP. Encaixa em balcões de loja, entrevistas e reuniões, clínicas e trabalhos jurídicos — lugares onde as gravações não podem sair das dependências.
- Pacote de implantação (Docker Compose e configuração): github.com/suharvest/sensecraft-solutions
- Código-fonte do mecanismo de voz: github.com/Seeed-Solution/openvoicestream
- Seleção e implantação: página de reference design
Áudio permanece no local
As gravações são sincronizadas do Clip para o host via Bluetooth e transcritas ali, sem serviço em nuvem.
26 s de áudio em 1,2 s
Medição com áudio em chinês de dois falantes em um reComputer J40 Series; veja "Performance e dados medidos".
Quem disse o quê
Cada turno traz um carimbo de tempo e rótulo de falante; clique em uma linha para reproduzir a partir dali.
Dentro do seu próprio sistema
Um aviso MQTT é disparado quando uma transcrição fica pronta; seu programa busca o texto completo via HTTP.
Em um dispositivo real
A página de resultados no host: a transcrição é dividida por falante com um carimbo de tempo em cada turno; o painel de resumo por IA fica à direita (desligado nesta execução).
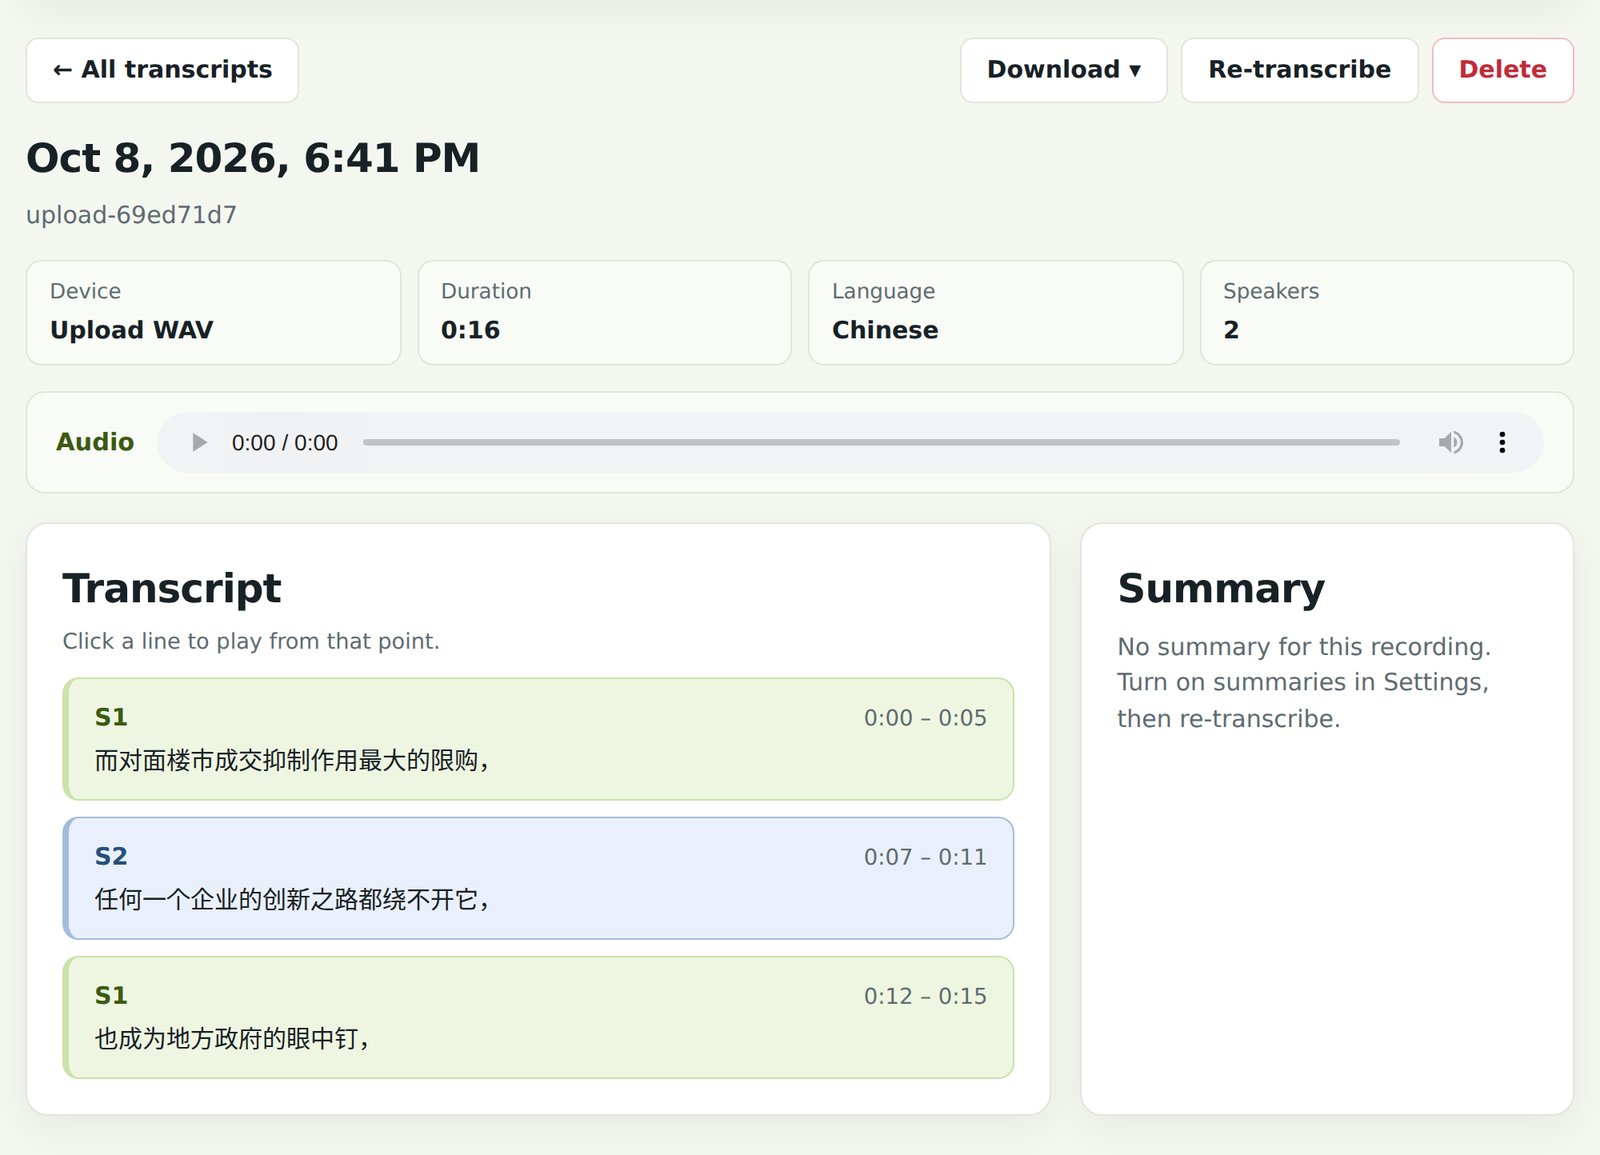
Esta gravação de 16 s junta dois falantes do AISHELL-1 e foi enviada como WAV; ela foi transcrita em 1,2 s. A primeira linha tem um caractere extra.
Hardware necessário
Duas coisas no local: um reSpeaker Clip e um host de transcrição.
① reSpeaker Clip: um gravador vestível que sincroniza com o host via Bluetooth. Página da loja
② Host de transcrição: escolha um com base no tamanho do local e no volume de crachás.
| Host de transcrição | Tempo de resposta de um único áudio (30 s em chinês com dois falantes) | Capacidade de lote no fim do turno (10 crachás enviando de uma vez) | Escolha quando | |
|---|---|---|---|---|
 | reComputer Super J4012 Jetson Orin NX 16GB, JetPack 6.2 | 1,2 s | ~3,5 s de tempo total (espera em fila < 3,5 s) | Escolha principal para 10~50 crachás; 16 GB de memória unificada permitem sumarização local com LLM de 8B e auditoria de conformidade |
 | reComputer Super J3011 Jetson Orin Nano 8GB, JetPack 6.2 | 1,3 s | ~4,1 s de tempo total (espera em fila < 4,1 s) | Opção principal econômica para 5~20 crachás; experiência de usuário idêntica, uso de VRAM de apenas 486 MB |
 | reComputer RK3588 Series (8 GB) RK3588 NPU de 3 núcleos | 3,0 s | ~14,5 s de tempo total (3 pipelines paralelos) | Opção de estação de trabalho de médio porte para 5~15 crachás; 3 núcleos NPU independentes executam 3 workers em paralelo |
 | reComputer RK3576 Series (8 GB) NPU on-board | 4,6 s | ~46 s de tempo total (fila de um único worker) | Opção de baixo custo para 1~3 crachás; pico de RSS de apenas 442 MB (W4A16), ideal para clínicas privadas e salas de aconselhamento |
- Série Jetson: requer JetPack 6.2, pelo menos 15 GB de disco livre.
- RK3576: versão com 8 GB de memória, executa pesos quantizados W4A16, usando ~442 MB de memória; o host precisa de Bluetooth.
- Wi-Fi rápido opcional para sincronização: o host entra no hotspot próprio do Clip para baixar gravações. Se o próprio host estiver em Wi-Fi, adicione um adaptador Wi-Fi USB.
Implantando no local
1. Coloque o host onde os Clips retornam
Um Clip sincroniza apenas dentro do alcance de Bluetooth do host, então coloque o host onde a equipe devolve ou carrega seus Clips. A primeira implantação baixa os modelos de fala (cerca de 1,8 GB em Jetson, 155 MB em RK3576); depois disso a transcrição não precisa de internet.
2. Instale o software: três etapas
As etapas por dispositivo estão na página de reference design; isto é o resumo.
- Implante o serviço de transcrição: escolha o idioma de gravação e defina um token de acesso; para resumos, insira um endereço de serviço compatível com OpenAI.
- Faça o pareamento do Clip: pareie-o com o host; as gravações então sincronizam automaticamente.
- Verifique: abra a página de resultados na porta 8631, envie um WAV ou sincronize uma gravação e veja uma transcrição separada por falante.
Interfaces
A página de resultados e a API ficam na porta 8631 do host, e solicitações não autorizadas recebem 401; avisos de conclusão são enviados no broker MQTT do host.
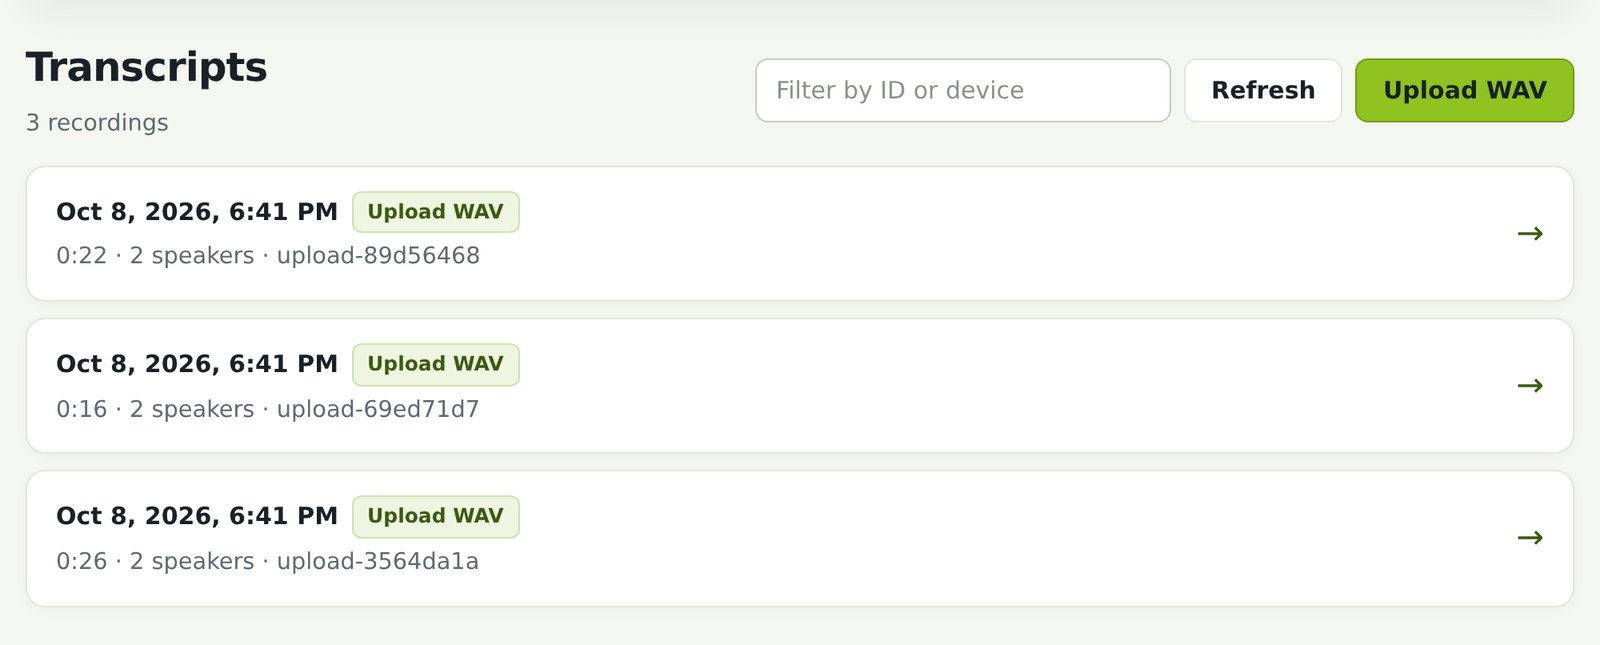
- Apenas ler resultados: abra a página de resultados, filtre por ID ou dispositivo, baixe, retranscreva ou exclua.
- Arquivamento automático: assine o aviso de conclusão e depois busque o texto completo por ID via HTTP em um ticket ou registro de cliente.
- Áudio extra: envie um WAV pelo endpoint de upload; ele passa pelo mesmo pipeline.
| Tópico / porta | Conteúdo |
|---|---|
HTTP 8631 / | Página de resultados: lista e detalhes de transcrições |
HTTP 8631 POST /v1/transcribe | Enviar um WAV para transcrição |
HTTP 8631 /healthz | Se o serviço está pronto |
MQTT clip-pt/<host-id>/transcript/<transcript-id>/ready | Aviso de transcrição pronta |
Performance e dados medidos
O modelo principal é o SenseVoice-Small da Alibaba DAMO Academy (multilíngue: chinês, cantonês, inglês, japonês, coreano com saída rica em texto / pontuação) emparelhado com CAM++ para diarização de falantes e Silero VAD.
1. Interação em tempo real com um único crachá (diálogo de 30 s)
As gravações foram enviadas ao host como WAV e cronometradas desde o envio até a transcrição e diarização concluídas; o tempo de sincronização via Bluetooth a partir do Clip não está incluído.
| Dispositivo e modelo | Idioma e amostra | Duração do áudio | Tempo de processamento | Locutores / Segmentos | Experiência no local |
|---|---|---|---|---|---|
| reComputer J40 Series (Orin NX 16GB) | Diálogo longo em chinês (FLEURS-A) | 30,5 s | 1,17 s (medido) | 2 / 4 turnos (medido) | Velocidade 175x em relação ao tempo real, texto aparece imediatamente |
| reComputer J40 Series | Atendimento ao cliente em chinês (FLEURS-B) | 26,1 s | 1,21 s (medido) | 2 / 5 turnos (medido) | Quase instantâneo: rotulado como S1 / S2 |
| reComputer J40 Series | Consulta clínica em chinês (AISHELL-1) | 16,5 s | 1,17 s (medido) | 2 / 3 turnos (medido) | Sem tempo de espera perceptível |
| reComputer J30 Series (Orin Nano 8GB) | Atendimento ao cliente em chinês (FLEURS-B) | 26,1 s | 1,32 s (medido) | 2 / 5 turnos (medido) | Opção principal, experiência idêntica à J40 |
| reComputer J40 Series | Áudio de balcão em japonês (FLEURS) | 34,0 s | 1,71 s (medido) | 2 segmentos (medido) | Processamento multilíngue rápido para revisão |
| reComputer J40 Series | Duas frases em inglês (LibriSpeech) | 6,3 s | 1,24 s (medido) | 2 / 2 turnos (medido) | Retorno rápido |
| reComputer RK3588 Series (8 GB) | Diálogo longo em chinês (FLEURS-A) | 30,5 s | 3,0 s (medido) | 2 / 4 turnos (medido) | Velocidade 10x em relação ao tempo real, paralelismo multi-core |
| reComputer RK3576 Series (8 GB) | Diálogo longo em chinês (FLEURS-A) | 30,5 s | 4,61 s (medido) | 2 / 4 turnos (medido) | Concluído em menos de 5 s, adequado para registros não urgentes |
| reComputer RK3576 Series | Atendimento ao cliente em chinês (FLEURS-B) | 26,1 s | 4,67 s (medido) | 2 / 5 turnos (medido) | Execução estável com um único worker |
2. Concorrência de upload em lote no fim do turno (10 badges enviando 10 min de áudio no total)
O cenário mais exigente no local é a devolução no fim do turno (por exemplo, 10 funcionários devolvendo badges aos carregadores simultaneamente). Tratamento de concorrência e latência máxima de espera na fila entre plataformas:
| Opção de hardware | Badges recomendados | Tempo total para 10 badges | Latência máxima de espera na fila | Mecanismo de agendamento e confiabilidade | Local recomendado |
|---|---|---|---|---|---|
| reComputer J40 Series (Orin NX 16GB) | 10 ~ 50 badges | ~3,5 s | < 3,5 s (imperceptível) | Esvaziamento de fila em sub-segundo: trava de fila de contexto único CUDA Graph protege contra OOM e 429 | Supermercados, redes de lojas, balcões de atendimento |
| reComputer J30 Series (Orin Nano 8GB) | 5 ~ 20 badges | ~4,1 s | < 4,1 s (imperceptível) | Mesma arquitetura, throughput de GPU de 29,5 QPS, apenas 486 MB de VRAM | Lojas de varejo padrão com 8~15 funcionários |
| reComputer RK3588 Series (RK3588 8GB) | 5 ~ 15 badges | ~14,5 s | ~5,0 s (3 pipelines paralelos) | Concorrência multi-core em hardware: 3 núcleos NPU independentes executam 3 workers em paralelo | |
| reComputer RK3576 Series (RK3576 8GB) | 1 ~ 3 badges | ~46 s | ~46 s (sequencial) | Worker único leve: pico de RSS de apenas 442 MB (W4A16), processamento sequencial | Clínicas particulares, salas de aconselhamento, pequenos balcões |
Por que Jetson usa uma trava de fila de contexto único em vez de concorrência multi-processo:
Em Orin Nano / NX, SenseVoice TensorRT FP16 com CUDA Graph já satura o processamento da GPU (GR3D98%, apenas 3033 ms de inferência pura, 175x em relação ao tempo real). Abrir vários contextos de execução apenas adiciona 200~300 MB de VRAM e causa contenção de enfileiramento na CPU, degradando a latência por fluxo para 135 ms. Uma trava de fila de contexto único esvazia em milissegundos os blocos de áudio enviados concorrentemente, lidando com dezenas de conexões simultâneas enquanto elimina exaustão de memória e erros 429.
3. Comparação de uso de recursos
| Plataforma host | Formato e precisão do modelo | Tamanho do weight e do engine | Pico de memória / VRAM | Arquitetura do worker |
|---|---|---|---|---|
| reComputer J40 Series | TensorRT 10.3 FP16 | Engine de 470 MB | 483 MB de VRAM / 1,1 GB de RAM | Trava de fila de contexto único (seguro contra OOM) |
| reComputer J30 Series | TensorRT 10.3 FP16 | Engine de 469 MB | 486 MB de VRAM / 1,1 GB de RAM | Trava de fila de contexto único (alta estabilidade) |
| reComputer RK3588 Series | RKNPU2 FP16 | 505 MB RKNN | ~1,2 GB de RAM / worker | 3 workers em núcleos de hardware independentes |
| reComputer RK3576 Series | RKNPU2 W4A16 | 155 MB RKNN | 442 MB de pico de RSS (medido) | Worker único (cabe no orçamento de 8 GB) |
4. Um Clip real
Um reSpeaker Clip baixou 3 sessões de gravação via Bluetooth; foram montadas em WAV de 16 kHz e transcritas em um reComputer J40 Series, o reconhecimento SenseVoice levou 534 ms e a separação de locutores 706 ms (medido).
- Reprodução: Os testes de desempenho e concorrência estão localizados no repositório
benchmarks/eval_transcription.py; executepython3 benchmarks/eval_transcription.py --device j40 --batch 10.
5. Modelos e runtimes
| Dispositivo | Reconhecimento de fala | Diarização | Runtime |
|---|---|---|---|
| reComputer J40 / J30 Series | SenseVoice-Small (texto rico) | CAM++ | TensorRT 10.3 FP16, GPU |
| reComputer RK3588 Series | SenseVoice-Small (multilíngue) | CAM++ | RKNPU2 FP16, NPU, 3 workers |
| reComputer RK3576 Series | SenseVoice-Small (multilíngue) | CAM++ | RKNPU2 W4A16, NPU, 1 worker |
Parâmetros que afetam os resultados:
- Idioma da gravação: escolhido na implantação e aplicado tanto às gravações do Clip quanto aos arquivos WAV enviados; "auto" deixa o modelo decidir.
- Locutores esperados: 0 (automático) por padrão. Defina quando você souber o número para uma divisão mais estável.
- Resumo por IA: desativado por padrão; quando ativado, o texto da transcrição vai para o serviço que você configurar.
6. Degradações conhecidas e condições de contorno
- Limite de concorrência em lote no fim do turno: Devido ao limite de 8 GB de memória do sistema no RK3576, apenas 1 worker SenseVoice é implantado (~442 MB de RSS). 10 badges devolvidos de uma vez ficarão em fila por ~45 s. Para implantações com mais de 5 badges devolvidos de uma vez, reComputer J30 ou J40 Series é fortemente recomendado.
- Queda de palavras no início de frases: SenseVoice pode ocasionalmente descartar palavras iniciais em áudios longos devido a limiares de corte do VAD.
- Fala sobreposta: Quando 2 ou mais pessoas falam simultaneamente, a precisão da diarização cai e os turnos podem ser fragmentados ou mesclados.
- Ruído ambiente e distância de uso: Em ambientes extremamente barulhentos (por exemplo, sistemas de som de varejo), a fala pode ser filtrada pela supressão de ruído; use o badge a 20–40 cm do locutor.
Fontes de dados e assets
- FLEURS (Conneau et al., 2022): huggingface.co/datasets/google/fleurs, divisão dev cmn_hans_cn, CC BY 4.0.
- AISHELL-1 (Bu et al., 2017): openslr.org/33, Apache 2.0.
- LibriSpeech: openslr.org/12, CC BY 4.0 (amostra em inglês).