Inspeção de Defeitos de Superfície na Borda: Seis Classes, Modbus e MQTT
Os pesos NEU-DET pré-empacotados (ONNX / HEF) servem como benchmarks de referência de design para avaliação e verificação do pipeline. Para produção comercial, recomendamos retreinar ou recalibrar os modelos em imagens de defeitos específicas do local. Este não é um instrumento certificado de qualidade ou segurança.
O que esta solução faz
Uma câmera fixa observa a tira de aço ou uma peça. O dispositivo decide quadro a quadro se a superfície tem um defeito e envia o veredito OK/NG por dois caminhos ao mesmo tempo: uma bobina Modbus TCP que um CLP pode travar, e uma mensagem JSON MQTT por quadro contendo todas as caixas de detecção naquele quadro.
-
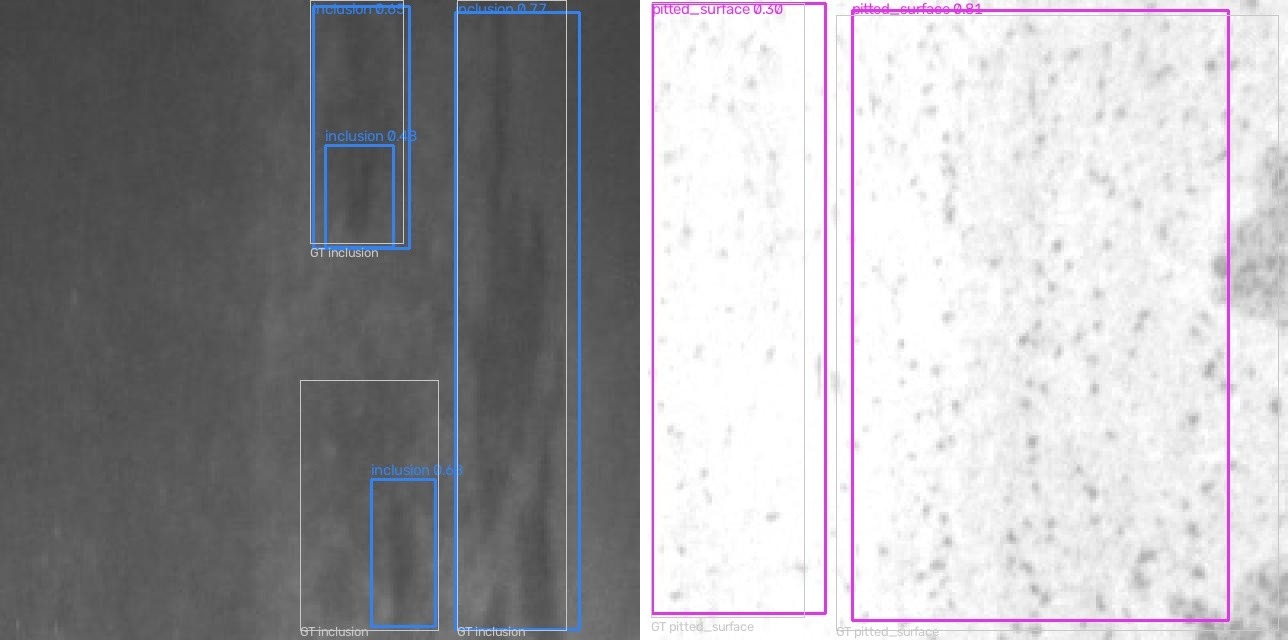
Seis classes de defeitos — crazing, inclusion, patches, pitted surface, rolled-in scale, scratches.
-
A detecção, a regra OK/NG e ambas as saídas rodam no dispositivo. As imagens permanecem no dispositivo. O broker MQTT, o servidor Modbus TCP e uma página de depuração somente leitura rodam no mesmo host.
-
Opções de detector e acelerador. No Jetson: YOLOX-Tiny (padrão), D-FINE-S ou RT-DETRv2-S; no reComputer série R2000 (Hailo-8): YOLOX-Tiny INT8.
-
Código-fonte do empacotamento e guia de implantação: sensecraft-solutions / solutions/edge_inspection_surface
-
Escolhendo uma configuração e implantando: página de design de referência
Pronto para rodar no dispositivo
Instale o pacote de aplicativo em um reComputer série J30 / J40 e ele roda; a primeira implantação leva cerca de 40 minutos. Medido no Orin NX 16GB: da captura do quadro à escrita da bobina P50 9,3 ms, nenhuma das 3000 amostras acima de 20 ms.
Código aberto
O código de runtime é Apache-2.0; o detector padrão é YOLOX (Apache-2.0), e nenhum código ou peso da Ultralytics é usado em nenhum lugar.
Sua própria câmera, CLP e MES
Qualquer câmera RTSP. O CLP lê bobinas e registradores diretamente na unidade 1 Modbus TCP e o MES assina via MQTT, sem middleware.
Roda totalmente no local
As imagens permanecem no dispositivo; a cadeia principal não precisa de acesso à internet.
O que a demonstração mostra
O pacote não inclui nenhuma imagem derivada de conjunto de dados. Seu único recurso é um diagrama desenhado para esta solução (caminho de dados, nomes de dispositivos, nomes de protocolos e números de porta), sem fotografias e sem saída do detector.
Para ver a saída do detector, abra a página de depuração incluída no seu próprio vídeo: /preview.mjpg na porta 8080 desenha as caixas em um stream MJPEG ao vivo, e /events lista veredictos recentes.
De que hardware você precisa
Duas coisas no local: uma câmera e um host.
① Uma câmera RTSP — fixa na tira ou peça, com os defeitos ocupando uma parte utilizável do quadro. Todos os dados medidos foram obtidos em 640×640, 10 FPS. A iluminação deve ser estável: o modelo foi treinado sob a iluminação de um único conjunto de dados.
② Host de inspeção — decide quantas câmeras você pode rodar e quais detectores você pode escolher:
| Host | Streams medidos | Quando escolhê-lo | |
|---|---|---|---|
 | reComputer J3011 (Jetson Orin Nano 8GB) Host de entrada para uma única câmera | 1–2 estáveis | Uma câmera, sensível a custo. Medido captura→bobina P50 10,56 ms |
 | reComputer J4012 (Jetson Orin NX 16GB) O host medido | 8 estáveis | Mais de uma câmera; todos os dados abaixo foram medidos neste host |
 | reComputer Industrial J4012 (Orin NX 16GB, sem ventoinha) | igual ao J4012 | O host vai em um quadro de controle; mesmo módulo e runtime, gabinete diferente |
Um terceiro host é o reComputer série R2000 com um Hailo-8. Existem etapas de implantação para ele; o configurador ainda não o inclui.
A capacidade de streams foi medida no Orin NX 16GB, 640² / 10 FPS por stream: 8 estáveis, 12 degradando, 24 falhando. A partir de 12 streams, a vazão total permanece em 110–112 FPS: o contexto do acelerador não é thread-safe e a inferência roda em série, então mais computação não adiciona streams.
Você também precisa de um CLP ou controlador de linha na mesma rede que possa atuar como mestre Modbus TCP (opcional; o mapa de registradores é fixo na unidade 1), e alimentação elétrica próxima à linha ou no quadro. A cadeia principal não precisa de acesso à internet.
Limites de Seleção Negativa
- Concorrência e limite de memória: Se conectar mais de 2 câmeras industriais ou encadear modelos de classificação de defeitos, evite o J3011 de 8GB. Escolha o J4012 de 16GB para evitar OOM no buffer de vídeo.
- Compatibilidade de operadores: No reComputer R2000 com Hailo-8, operadores ONNX personalizados não padronizados e não suportados pelo Hailo irão fazer fallback para a CPU do host, adicionando latência significativa.
Como implantar no local
Fixe primeiro a câmera e a iluminação, depois instale o software.
Um: instale primeiro o hardware, a câmera e a luz
Os dados de treinamento vêm de um conjunto de dados sob uma condição de iluminação. A precisão sob outra lâmpada, ângulo ou acabamento de superfície não foi avaliada, e nenhum limiar compensa isso. Mantenha a câmera e a fonte de luz como instaladas.
Requisitos de enquadramento:
- Os defeitos devem ocupar uma parte utilizável do quadro 640×640. Em um campo de visão amplo, um arranhão tem poucos pixels de largura, e os dados de precisão abaixo não se aplicam.
- Montagem fixa. Reapontar ou refocar muda a escala assumida pelas medições.
- Taxa de linha configurada em 10 FPS. O runtime pode ir mais rápido; a precisão e a latência foram medidas em 10 FPS.
Dois: instale o software
As etapas por dispositivo estão na página de design de referência; esta seção lista o fluxo.
- Escolha uma configuração — quantas câmeras por host, e se o host fica ao lado da linha ou em um quadro. Essas duas respostas decidem o módulo e o gabinete.
- Instale o pacote de aplicativo — imagem de contêiner, modelo e o limiar de score congelado (0,35) estão todos no pacote. No Jetson a primeira implantação constrói o engine TensorRT no dispositivo, medido em 291 s no Orin NX 16GB + TensorRT 10.3; o engine é vinculado à arquitetura da GPU e à versão do TensorRT e não é distribuído separadamente. O reComputer série R2000 baixa um HEF INT8, sem build na placa.
- Preencha a configuração — URL RTSP,
device_nameestream_id(para diferenciar as fontes quando várias linhas compartilham um broker ou um host executa várias câmeras), taxa de quadros da fonte, ID de unidade Modbus e, no Jetson, o Detector Track: YOLOX-Tiny (padrão, com dados medidos), D-FINE-S ou RT-DETRv2-S. O limiar de score vem em três etapas, 0,25 / 0,35 / 0,45; 0,35 é o valor de implantação, calibrado para YOLOX. - Verifique — abra
/preview.mjpgna porta 8080 e confirme que as caixas aparecem no seu próprio vídeo; depois verifique o tempo de inferência, a latência captura→bobina e os contadores MQTT / Modbus em/healthz.
Reserve 40 minutos para a primeira implantação. No Orin, a maior parte é a construção do engine; o caminho Hailo tem três pré-requisitos: uma versão secundária de Python correspondente; HailoRT 4.21.x na mesma versão entre driver, biblioteca e bindings Python; e o parâmetro de kernel hailo_pci force_desc_page_size=4096. As etapas de implantação verificam cada um deles.
Quais interfaces estão disponíveis
Todos os dados são servidos pelo próprio host de inspeção: Modbus TCP 502, MQTT 1883, HTTP 8080. Não há etapa em nuvem na cadeia principal.
- CLP ou controlador de linha — leia diretamente a unidade Modbus TCP 1. A bobina 0 é NG, a bobina 1 é OK, mutuamente exclusivas. Os registradores são atualizados de forma atômica antes de a bobina ser escrita, então, quando o CLP vê a bobina mudar, os HR 0–7 já contêm a classe, contagem de defeitos, caixa primária e heartbeat do mesmo quadro. Faça polling dos registradores primeiro e use a bobina como gatilho.
- MES ou historiador — assine
<device-name>/inspection/<stream-id>/results. Um JSON por quadro, com veredito, motivo, contagem de defeitos e todas as caixas daquele quadro em um único payload. Com vários streams em um host, esta é a única fonte por stream: o Modbus mantém apenas o último veredito escrito. - Notebook de comissionamento ou dashboard de chão de fábrica — a porta 8080 serve
/preview.mjpg(MJPEG com caixas),/healthz(tempo de inferência, latência captura→bobina, contadores MQTT e Modbus) e/events(vereditos recentes), somente leitura.
<device-name> e <stream-id> são definidos nas etapas de implantação; stream_id também está no payload, então o código a jusante não precisa analisar o tópico.
Tabela completa de interfaces
| Tópico / porta | Conteúdo | retained |
|---|---|---|
| Modbus TCP 502, unidade 1, bobinas 0–1 | Bobina 0 = NG, bobina 1 = OK, mutuamente exclusivas, escrita após os registradores | n/a (estado dos registradores) |
| Modbus TCP 502, unidade 1, HR 0–7 | HR 0 ID de classe primária; HR 1 contagem de defeitos; HR 2–5 caixa primária cx/cy/w/h normalizada ×10000; HR 6–7 heartbeat, segundos Unix como uma palavra alta e baixa uint32 | n/a |
<device-name>/inspection/<stream-id>/results | type, version, device, stream_id, frame_id, verdict, verdict_reason, defect_count, primary_class_id, coordinate_space, inference_time_ms, pipeline_ms, detections[] (slot, class_id, class_name, score, bbox) | no |
HTTP 8080 /preview.mjpg /healthz /events /snapshot.jpg | Pré-visualização MJPEG com caixas, contadores de integridade, vereditos recentes, snapshot de quadro único | n/a |
Dois campos a observar: slot é o índice dentro do quadro, ordenado por score; o pipeline não faz rastreamento, então slot 0 em dois quadros adjacentes não é necessariamente o mesmo defeito físico. Com o módulo opcional de anomalia ativado, anomaly_score é um campo adicional separado e não alimenta o verdict de nível superior.
Cada mensagem MQTT é validada em relação ao schema do contrato no caminho de publicação; falhas são contadas e descartadas. O broker empacotado é configurado com allow_anonymous true; aponte uma linha de produção para um broker com credenciais.
Desempenho e dados medidos
Velocidade e latência
| Dispositivo | Modelo / precisão | Vazão do detector | Pipeline completo | Captura ponta a ponta → bobina Modbus |
|---|---|---|---|---|
| reComputer J40 series (J4012, Orin NX 16GB) | YOLOX-Tiny 640², TensorRT 10.3 FP16 | 113,7 FPS (detect() P50 8,797 ms, P95 9,097, P99 9,223) | 9,999 FPS com 0 descartados quando limitado a 10 FPS; 76,5–104,3 FPS sem limitação | P50 9,298 / P95 9,441 / P99 9,549 ms; 3000 amostras, máximo 9,926 ms |
| reComputer J30 series (J3011, Orin Nano 8GB) | YOLOX-Tiny 640², TensorRT 10.3 FP16 | 105,2 FPS (cálculo puro 198,5 FPS, GPU 5,03 ms) | 9,999 FPS com 0 descartados quando limitado a 10 FPS; 75,3 FPS sem limitação | P50 10,56 / P95 10,82 / P99 11,10 ms; cadência estável, 18,2 W MAXN |
| reComputer R2000 series + Hailo-8 | YOLOX-Tiny 640², HailoRT INT8 HEF | Hardware 106,75 FPS (hailortcli run, latência de hardware 8,47 ms); aplicação 91,49 FPS (P50 10,93 ms, P95 13,19 ms) | 46,14 FPS sem limitação | P50 11,61 / P95 14,99 / P99 16,63 ms |
Condições: a entrada é um vídeo sintético montado a partir de 290 imagens de validação em 640×640 / 10 FPS, sem continuidade temporal entre quadros. Os números do detector no Orin são 500 chamadas detect() em 60 quadros pré-decodificados, incluindo letterbox, execução e NMS na CPU; a execução do engine é cerca de 5,0–5,6 ms (cerca de 178–198 FPS) disso. Sem limitação, a captura→bobina P50 sobe para 35,90 ms (J4012) / 41,3 ms (J3011); os ~26–30 ms extras são enfileiramento em uma fila de profundidade 2. As medições da aplicação Hailo foram feitas em bare metal, não no contêiner, RSS cerca de 126 MB.
| Nível multi-stream | Streams | FPS por stream | Descartados | Latência P95 |
|---|---|---|---|---|
| Estável | 8 | 9,989 | 0,02% | 72,3 ms |
| Degradando | 12 | 9,306 | 6,83% | 104,0 ms |
Multi-stream: reComputer J40 series, 640² / 10 FPS por stream, cinco minutos por nível. 24 streams é o nível de falha: 4,593 FPS por stream e 53,95% descartados. O processo não trava, mas mais da metade da entrada é silenciosamente descartada e essas partes nunca são inspecionadas.
Reproduzir: solutions/edge_inspection_surface/evaluation/runs/2026-09-05-m2-orin/results.md (Orin), evaluation/runs/2026-09-06-rpi-hailo/results.md (Hailo-8)
Precisão de detecção
| Métrica | Valor | Condições |
|---|---|---|
| mAP50, reComputer J40 series, TensorRT FP16 | 0,7577 | 290 imagens de validação / 706 caixas, uma única passagem de inferência em score 0,01 |
| Precisão / recall no limiar de implantação 0,35 | P 0,7652 / R 0,6969 | Pós-filtrado a partir da mesma passagem. VP 492 / FP 151 / FN 214; 7 de 290 quadros não produzem nenhuma saída |
| Recall no limiar 0,6 | 0,5807 | FN 214 → 296, quadros totalmente perdidos 7 → 39 (13,4%); a precisão sobe para 0,865 |
| Recall no limiar 0,9 | 0,0241 | 273 de 290 quadros não produzem nada (94%); recall de crazing e rolled-in scale 0 |
| TensorRT FP16 vs CPU onnxruntime, caixa a caixa | Diferença de mAP50 0,0003 | 643 pares correspondentes, IoU médio 0,9972 (mín 0,8311), diferença média de score 0,0011; o veredito de nenhum quadro mudou |
| mAP50, reComputer R2000 series + Hailo-8, INT8 HEF | 0,7091 | As mesmas 290 imagens; referência na CPU 0,7574, −0,0483 |
| Taxa de correspondência de caixas Hailo vs referência na CPU | 86,66% | 523 de 684 caixas corresponderam com IoU ≥ 0,5 |
| mAP50, emulador Hailo Dataflow Compiler, INT8 nível-1 (build enviado) | 0,7266 | 20 imagens de validação / 45 caixas, CPU no mesmo subconjunto 0,7228; não diretamente comparável com as linhas de 290 imagens |
Conjunto de dados: NEU6 (uma cópia re-hospedada de NEU-DET, licença no final da página), dividido 70/15/15 agrupado por fonte para que quadros adjacentes de uma faixa nunca cruzem uma divisão. As linhas de limiar são pós-filtros de uma única passagem, não testes separados.
AP50 por classe a partir da mesma passagem:
| Classe | Caixas | AP50 | Recall em 0,35 |
|---|---|---|---|
| scratches | 95 | 0,9685 | 0,9263 |
| pitted_surface | 70 | 0,9301 | 0,8857 |
| patches | 122 | 0,9065 | 0,8689 |
| inclusion | 184 | 0,7658 | 0,6902 |
| rolled-in_scale | 104 | 0,6149 | 0,5481 |
| crazing | 131 | 0,3603 | 0,3969 |
Reproduzir: solutions/edge_inspection_surface/evaluation/runs/
Comparação de tracks de detector
| Detector | mAP50 | P / R em 0,35 fixo | Quadros totalmente perdidos |
|---|---|---|---|
| YOLOX-Tiny (padrão) | 0,7574 | 0,7632 / 0,6983 | 7/290 |
| D-FINE-S | 0,7499 | 0,4956 / 0,8017 | 0/290 |
| RT-DETRv2-S | 0,7317 | 0,4575 / 0,7847 | 1/290 |
Condições: referência CPU onnxruntime, não um número de dispositivo; as mesmas 290 imagens de validação, entrada estática 640×640 batch-1, uma seed por track. O limiar 0,35 é calibrado na distribuição de score obj × cls do YOLOX; os scores do DETR são distribuídos de forma diferente, daí o P/R desequilibrado. Em precisão combinada (P ≈ 0,81–0,87), o recall do D-FINE fica 2–7 pontos acima do YOLOX e os quadros totalmente perdidos caem de 38 para 20.
Reproduzir: solutions/edge_inspection_surface/evaluation/runs/
Módulo opcional de anomalia (EfficientAD-S)
| Métrica | Valor | Condições |
|---|---|---|
| Pixel AUROC | 0,8752 | DeepPCB divisão OK/anomalia pcb: 205 OK val + 213 OK teste + 213 defeito teste |
| Pixel AUPRO (FPR ≤ 0,30) | 0,6494 | Mesma execução, 1177 regiões de defeito conectadas |
| Image AUROC | 0,5201 | Mesma execução; 0,5 é acaso |
| Recall em classes de defeito não vistas (leave-one-out, nível de pixel/região) | 0,225 – 0,955 | Grande variação por classe (open 0,955, spur 0,225) |
| Sobrecarga de latência dual-path (detector + EfficientAD, referência CPU) | +139 ms P95 por quadro | queue=2, timeout 500 ms (padrões do pacote); 120/120 quadros mesclados |
A pontuação em nível de pixel/região é utilizável, em nível de imagem não é: doze maneiras de reduzir o mapa de calor a um único score todas dão Image AUROC 0,495–0,530. O conjunto OK acima (templates escaneados) e o conjunto de defeitos (fotos de placas reais) vêm de fontes diferentes.
Reproduzir: solutions/edge_inspection_surface/evaluation/runs/
Pegada de implantação
| Item | Valor | Condições |
|---|---|---|
| Construção do engine TensorRT no dispositivo | 291 s | reComputer J40 series, JetPack 6.2, TensorRT 10.3, YOLOX-Tiny 640² FP16, shape estático |
| Imagem Jetson | 375 MB | TensorRT e CUDA do host são montados no contêiner, não empacotados na imagem |
| Pegada adicional no reComputer R2000 series | cerca de 452 MB | imagem de runtime de 443 MB + 8,9 MB HEF + config |
Tempos de execução e parâmetros principais
| Dispositivo | Modelo | Precisão | Runtime | Como o modelo chega ao dispositivo |
|---|---|---|---|---|
| reComputer J30 / J40 series | YOLOX-Tiny 640² (opcional D-FINE-S, RT-DETRv2-S) | FP16 | TensorRT 10.3 | Engine construída no dispositivo no primeiro deploy (medido 291 s), vinculada à arquitetura da GPU e à versão do TensorRT, não distribuída separadamente |
| reComputer R2000 series + Hailo-8 | YOLOX-Tiny 640² | INT8 | HailoRT 4.21.0 | HEF compilado fora do dispositivo com Dataflow Compiler 3.31.0 em optimization_level=1, baixado no momento do deploy |
D-FINE-S e RT-DETRv2-S estão disponíveis apenas em Jetson: o Hailo Dataflow Compiler 3.31.0 não oferece suporte aos seus operadores de deformable-attention (GridSample, GatherElements, TopK).
min_score: valor de deploy 0.35; a etapa de deploy oferece 0.25 / 0.35 / 0.45min_defects: padrão 1; um frame com pelo menos essa quantidade de detecções é NGanomaly.enabled: padrãofalse;anomaly_scoreé um campo MQTT separado e não entra noverdictde nível superior
Degradações conhecidas
- Mude a iluminação e os números acima deixam de se aplicar: o modelo foi treinado e avaliado sob a iluminação de um único dataset.
- O AP50 de crazing é 0,30–0,36 em todas as três arquiteturas (YOLOX 0,360, D-FINE 0,302, RT-DETRv2 0,310) e não se move com limiar ou cabeça de detecção; uma linha cujo defeito principal é crazing precisa de re-treinamento em suas próprias imagens.
- INT8 na reComputer R2000 series perde 0,0483 mAP50; as maiores perdas são nas duas classes mais fracas (crazing AP50 0,3873, rolled-in_scale 0,4483).
- O teto de streams está no loop de inferência: a partir de 12 streams o throughput total permanece em 110–112 FPS; o contexto do acelerador não é thread-safe e a inferência roda em série, então mais computação não adiciona streams.
- Todos os streams compartilham um bloco único de registradores Modbus, e o último verdict prevalece; os resultados por stream vêm do MQTT.
- Os scores de anomalia em nível de imagem estão próximos do acaso. Antes de ativar
anomaly.enabled, colete suas próprias imagens OK com a câmera de inspeção real e recalibreanomaly.thresholdnelas.
Próximas etapas
- Reexecutar a comparação de detectores com três seeds por trilha para confirmar a vantagem de recall do D-FINE-S em precisão equivalente.
Fontes de dados e assets
- NEU-DET (Northeastern University surface defect database), via cópia no Roboflow — dados de treinamento e validação para o detector base fornecido e fonte dos números de acurácia acima. Pesos de modelo pré-convertidos são hospedados no CDN oficial para avaliação do reference design e verificação do pipeline de ponta a ponta. Deploys em produção devem re-treinar modelos em imagens reais da linha para corresponder às peças-alvo e às condições de iluminação.
- DeepPCB —— github.com/tangsanli5201/DeepPCB, licença MIT. Usado apenas pela trilha opcional de anomalia não supervisionada, e distinto do NEU-DET. A licença MIT permite redistribuição e uso comercial e exige que o aviso de copyright acompanhe cópias e trabalhos derivados.
- YOLOX —— github.com/Megvii-BaseDetection/YOLOX, Apache-2.0. O backbone de detecção padrão, escolhido em vez de Ultralytics para evitar termos AGPL. Nenhum código ou peso da Ultralytics é usado em qualquer parte desta solução.
- D-FINE —— github.com/Peterande/D-FINE, Apache-2.0, e RT-DETRv2 —— github.com/lyuwenyu/RT-DETR, Apache-2.0. As duas trilhas opcionais de detecção, ajustadas apenas a partir de seus checkpoints licenciados sob COCO. Nenhum peso treinado em Objects365 é baixado ou distribuído, já que o próprio upstream declara que essa licença é não confirmada. Fixação de licença e commit está em
tracks/detector/PROVENANCE.md. - anomalib EfficientAD-S —— Apache-2.0, incluindo seus pesos de teacher pré-treinados (
tracks/anomaly/PROVENANCE.md, anomaliblib/v2.6.0). - Diagrama de arquitetura —— desenhado a partir do catálogo de dispositivos do pacote e das interfaces de saída; não contém conteúdo de dataset.
O código de runtime é Apache-2.0. Os pesos fornecidos servem como baselines de avaliação; deploys em produção devem re-treinar com dados específicos do local.