Voz no Varejo: Transcrição no Dispositivo ou uma Pilha de Servidor Redatora e Apagável
Esta é uma implementação de referência, não um produto de transcrição certificado nem uma ferramenta de conformidade. Os rótulos de locutor são resultados de clusterização, não identidades.
Ambos os modos gravam resultados no backend de varejo. Eles diferem em onde o ASR é executado: o dispositivo transcreve e envia apenas o JSON de texto, ou um Clip envia o áudio por meio de um telefone e o servidor executa o ASR.
- Transcrição no dispositivo: a caixa executa o ASR e envia o JSON de texto final para o backend de varejo; o WAV pode, opcionalmente, ser mantido localmente.
- Pilha de servidor: um host arm64 adiciona redação antes da inserção, MySQL, MinIO, um console de administração, exportação por titular e endpoints de exclusão definitiva. O áudio vem de uma matriz de microfones em um coletor de borda ou de um app de telefone que você já tem.
Um site que começa com o preset de transcrição no dispositivo pode migrar para a pilha de servidor depois sem mudar a matriz, o host ou o reconhecedor.
O que esta solução faz
Predefinição: Transcrição no dispositivo
Uma matriz de microfones no balcão capta a conversa, e uma pequena caixa ao lado converte o áudio em texto e envia o JSON da transcrição final para o backend de varejo para armazenamento e exibição. No modo Clip, o SenseCraft Voice App envia o áudio pelo gateway para o voice-service, que chama o OpenVoiceStream para ASR e grava o resultado no mesmo backend.
Adequado para: lojas únicas ou lojas piloto em que as gravações não podem sair do prédio; locais com link de subida instável; regras de compras que proíbem processamento de voz por terceiros; validar o caminho de áudio e a qualidade de reconhecimento no local antes de migrar para a nuvem.
- Escolher uma configuração e implantar: página de design de referência
Microfone plug-and-play
O reSpeaker XVF3800 é enumerado como um dispositivo de áudio USB padrão. Cancelamento de eco, formação de feixe e supressão de ruído são executados no próprio DSP da matriz, não na CPU do host.
O áudio pode permanecer na loja
A transcrição no dispositivo envia apenas o JSON de texto. Clipes WAV são gravados somente quando a saída para arquivo está ativada; com ela desativada, o dispositivo mantém apenas o texto.
Redação antes da inserção, apagável por pessoa
A pilha de servidor substitui nomes e números de telefone por placeholders antes de gravar no banco de dados. A exclusão por titular retorna uma contagem de resíduos; a exportação por titular também está disponível.
Funciona com seu app e sistemas de negócio
O reSpeaker Clip com SenseCraft Voice App envia o áudio diretamente; sistemas de BI, CRM e de tíquetes leem o texto redatado e chamam apagar e exportar via HTTP.
Predefinição: Pilha de Servidor
O áudio chega e a transcrição redatada é gravada no banco de dados; o conteúdo armazenado pode ser apagado por titular, com uma contagem de resíduos retornada. O pacote é um Docker compose com versões fixadas: reconhecimento, impressão de voz, o serviço que redige e armazena, MySQL, MinIO e o console de administração, além de um endpoint WebSocket de ASR para ingestão de áudio.
Há dois caminhos de captura. No modo de envio de transcrição pelo dispositivo, uma matriz reSpeaker XVF3800 na caixa de borda captura o áudio, executa detecção de atividade de voz e transcreve localmente com OpenVoiceStream; o app então envia apenas o JSON de texto para o backend de varejo, e o WAV pode, opcionalmente, permanecer no dispositivo. No modo Clip, o reSpeaker Clip entrega o áudio ao SenseCraft Voice App, o app o envia para o backend, e o voice-service chama o OpenVoiceStream e armazena o resultado. O app usa a chave de operador do .env do host de implantação; as credenciais do banco de dados e o segredo JWT são gerados pela implantação.
Casos de uso: funcionários e clientes conversam no balcão e o operador quer saber o que foi perguntado sem manter quem perguntou; pedidos de exclusão devem ser respondidos com prova de que linhas de banco de dados, objetos e impressões de voz foram removidos; um app já captura áudio e a cadeia de backend está faltando; pilotos que exigem que o áudio permaneça no local.
O que o console mostra
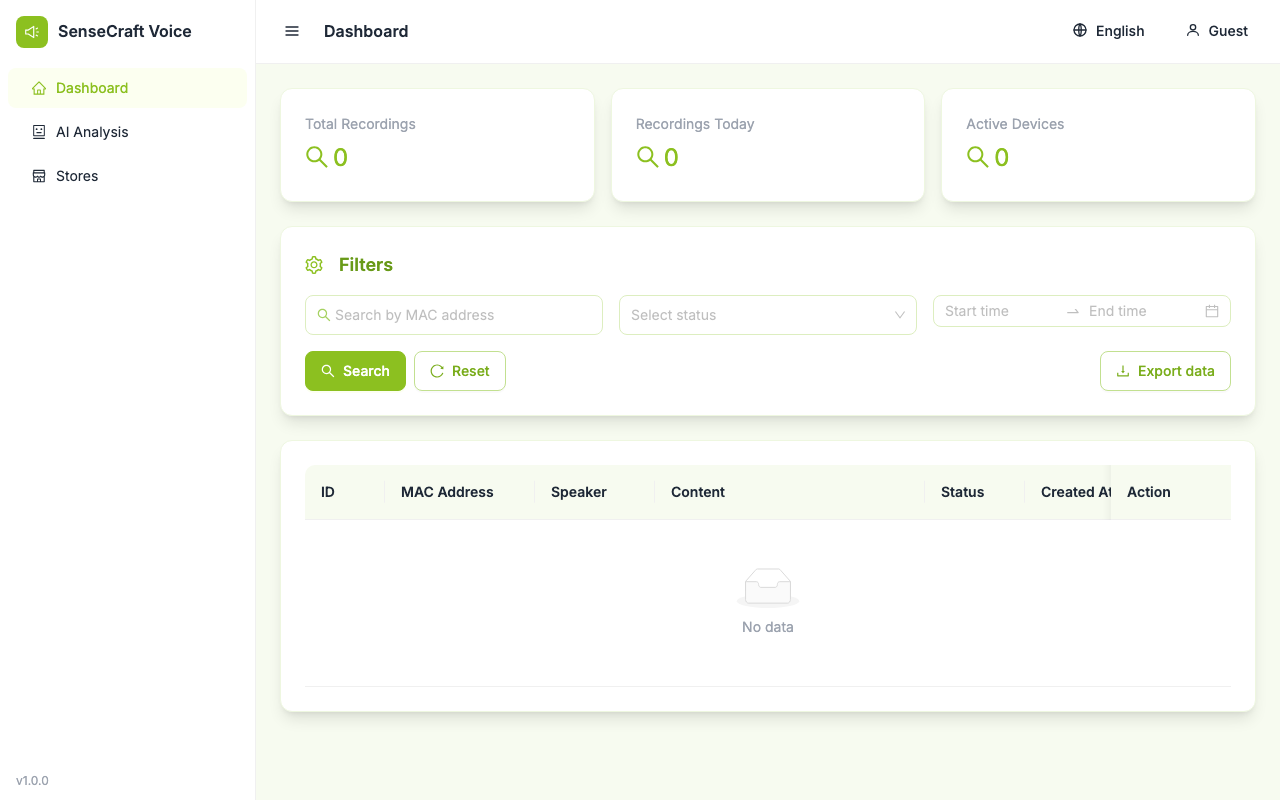
No preset Pilha de Servidor, após entrar no console de administração, a lista de gravações mostra a transcrição, a duração e o dispositivo de origem de cada enunciado em ordem temporal.
O texto na lista já está redatado: nomes e números de telefone são substituídos por placeholders antes da inserção, e o original nunca é armazenado.
De que hardware você precisa
Predefinição: Transcrição no dispositivo
Dois dispositivos por zona de fala, mais um diretório gravável.
① Matriz de microfones: um reSpeaker XVF3800 em uma porta host USB. Cancelamento de eco, formação de feixe e supressão de ruído são executados no DSP XMOS da matriz; o host recebe um fluxo mono de 16 kHz, e o processamento de front-end não consome CPU do host. A matriz é enumerada como um dispositivo de áudio USB padrão.
② Host de transcrição: determina se você tem dados medidos e se pontuação e rótulos de locutor podem ser executados junto com o reconhecimento.
| Host | Onde o ASR é executado | Quando escolhê-lo | |
|---|---|---|---|
 | reRouter CM4 Caixa apenas com CPU, BCM2711, 4 núcleos, 4 GB | 4 núcleos Cortex-A72, Paraformer em streaming | O orçamento vem primeiro e o primeiro site é um piloto |
 | reComputer RK3576-30 NPU de 6 TOPS, 8 GB | NPU RK3576, SenseVoice RKNN fp16 | Você precisa de um host com dados medidos ou de pontuação e rótulos de locutor juntos |
Cobertura. Uma matriz cobre uma zona de fala: com ruído de fundo constante em ou abaixo de 70 dB, a formação de feixe do XVF3800 cobre locutores a até 3 m. Não há modo multi-matriz; um segundo balcão precisa de uma segunda matriz e uma segunda caixa.
Também é necessário: uma porta host USB livre; um diretório gravável para transcrições (e áudio opcional) — o compose limita o tamanho do log dos contêineres e mantém os modelos em volumes nomeados, então apenas o diretório de transcrições cresce com o uso; uma rede para envio ao backend e o download de modelos na primeira inicialização.
Predefinição: Pilha de Servidor
No máximo duas coisas: o host que executa a pilha e uma matriz de microfones no caminho do coletor de borda.
① Host da pilha: qualquer host Linux arm64 com Docker e 20 GB livres. As imagens fixadas são apenas arm64, e a imagem de reconhecimento incluída é construída para a NPU RK3576; um host sem uma NPU RKNN precisa da imagem de reconhecimento correspondente.
| Host | Função | Quando escolhê-lo | |
|---|---|---|---|
| — | reComputer RK3576-30 (SKU 100052518) | Host da pilha; também o coletor no caminho do coletor de borda | As imagens incluídas são construídas para esta placa, e o reconhecimento é executado na NPU |
| — | reRouter CM4 (SKU 110110110) | Apenas coletor | Você já tem um CM4; o reconhecimento é executado na CPU e o pacote não inclui imagem fixada para este caminho, então você a fornece |
② Matriz de microfones (somente caminho do coletor de borda): reSpeaker XVF3800 USB 4-Mic Array (SKU 101991441). Supressão de ruído, cancelamento de eco e formação de feixe são executados no DSP da matriz; o host recebe um fluxo mono de 16 kHz via USB.
Inicie um host de stack com 1–2 streams. A simultaneidade somente de ASR está na tabela de cinco dispositivos em "Desempenho e dados medidos".
Outros pré-requisitos: o coletor deve alcançar a porta de ASR do host da stack; coloque a terminação TLS na frente ao atravessar uma rede não confiável, porque o token pode trafegar como um parâmetro de consulta de URL.
Limites de seleção negativa
- Limite de canais de áudio: o reComputer RK3576 é aferido para até 12 streams de áudio simultâneos. Para lojas de varejo com mais de 16 caixas, adicione um segundo gateway ou faça o scale-up para uma stack de servidor Jetson.
- Redação de PII: as transcrições mantêm números brutos por padrão. Para conformidade financeira e com o GDPR, ative explicitamente o pipeline local de redação na camada de servidor.
Como implantar no local
Predefinição: Transcrição no dispositivo
Posicione o array primeiro e depois inicie os dois containers.
Parte um — posicionando o array
Alto-falantes dentro de 3 m do array, ruído de fundo constante em 70 dB ou menos (aproximadamente o nível de fala normal). Além disso, a supressão de ruído do array não consegue separar o locutor do ambiente, os erros de reconhecimento aumentam e um host mais rápido não ajuda.
Coloque o array no balcão voltado para a zona de fala, não atrás de uma tela ou sob um beiral. Ele é conectado a uma porta USB host na caixa, portanto os dois devem estar dentro do comprimento do cabo.
Parte dois — iniciando o software
As etapas por dispositivo estão na página de design de referência. O fluxo:
- Escolha uma configuração: a página pergunta o que a transcrição deve conter (somente texto / texto com pontuação / mais rótulos de locutor) e se você precisa de um host com dados medidos antes da entrada em produção. O host e o array decorrem dessas duas respostas.
- Implante o pacote: ambas as predefinições executam os mesmos dois containers, o serviço de voz e o cliente de voz. Alternar predefinições muda a tag da imagem e o perfil, não o formato de saída.
- Preencha as entradas do dispositivo: diretório de saída, se deve manter o WAV, se deve ativar a restauração de pontuação e vetores de impressão de voz. Cada um dos dois últimos carrega um modelo; ativar ambos em uma placa somente CPU de 4 GB reduz a margem de segurança.
- Verifique: envie um WAV curto para
POST /asr. Texto correto e um campobackendnomeando o runtime real significam que a cadeia está funcionando. A página web local na porta 8090 então mostra transcrições em tempo real, status do microfone e o registro de impressões de voz.
Tempo: cerca de 40 minutos por implantação depois que os modelos são baixados. Com o volume de modelos já populado, o tempo de reinicialização até saudável no RK3576 mediu cerca de 25 s.
Predefinição: Pilha de Servidor
Duas predefinições, ambas classificadas como intermediárias, cerca de 60 minutos, ambas terminando em uma etapa de aceitação manual. As operações por dispositivo estão na página de design de referência, onde você escolhe uma configuração para o seu local e baixa o pacote de aplicativo correspondente.
Server Stack + aplicativo móvel: implante a stack no host arm64 (Etapa 1), configure o app com http://<deployment-device-IP>:18621 e a chave de operador do .env do host (Etapa 2), abra o console de administração (Etapa 3) e então verifique (Etapa 4). Para o caminho Clip, o SenseCraft Voice App recebe o áudio do Clip e envia um arquivo de áudio compatível para POST http://<stt-host>:18621/v1/audio/transcriptions; o backend transcreve, redige, armazena e exibe o resultado.
Server Stack + Edge Collector: implante o coletor (Etapa 1); o compose fixado é uma unidade, então o coletor traz a stack inteira com ele. Abra o console de administração (Etapa 2) e verifique (Etapa 3).
Quais verificações de aceitação manual. Que o texto armazenado é redigido e que nada permanece após a exclusão. Alguém diz uma frase contendo um número de telefone no app ou no array de microfones. Em seguida: leia a linha que chegou (o número deve aparecer como um placeholder), chame o endpoint de exclusão para esse sujeito e leia a contagem de resíduo que ele retorna, e verifique a exportação.
Antes de entrar em uma loja: escolha a família de dispositivos e tenha o dispositivo e o acesso SSH prontos. A implantação gera credenciais de banco de dados, segredos JWT e a chave de operador. A chave de operador é armazenada como OPERATOR_TOKEN no .env do diretório de implantação; use-a com http://<deployment-device-IP>:18621 no app.
Interfaces disponíveis
Predefinição: Transcrição no dispositivo
O modo de dispositivo produz JSON de transcrição final e o envia para o backend de varejo; o modo Clip envia áudio pelo telefone e gateway para o voice-service. Você fornece a URL do backend cliente e a chave de acesso na implantação; o banco de dados interno e os segredos JWT são gerados automaticamente.
- Somente texto: leia os arquivos JSON.
<output dir>/cache/asr/recebe um arquivo por enunciado segmentado com transcrição, carimbos de tempo e idioma, além de um rótulo de locutor quando a correspondência de impressão de voz está ativada. - Texto em tempo real: conecte-se ao WebSocket na porta 8621. Envie frames PCM mono de 16 kHz e finalize um enunciado com um frame vazio; cada resultado traz transcrição, pontuação e um vetor CAM++ de 192 dimensões.
- Entrada de arquivo inteiro: faça
POSTde um WAV para 8621. A etapa de aceitação no guia de implantação chama isso.
Tabela completa de interface e payload
| Interface / porta | Conteúdo | Sai do dispositivo? |
|---|---|---|
<output dir>/cache/asr/<id>.json | {"id","text","lang","start_ms","end_ms","speaker"}, um arquivo por enunciado segmentado | Não |
<output dir>/voice/*.wav | Clipes WAV mono de 16 kHz, gravados somente quando a saída para arquivo está ativada | Não |
ws://<device-IP>:8621/asr/stream?vad=none&punctuate=true&speaker_embedding=true | ASR em streaming: PCM de entrada, transcrição, pontuação e vetor CAM++ de 192 dimensões de saída | Não |
POST http://<device-IP>:8621/asr | Transcrição de arquivo inteiro, por exemplo {"text":"这个多少钱","backend":"rk:sensevoice_rknn"} | Não |
http://<device-IP>:8090/ | Página local: transcrições em tempo real, status do microfone, registro de impressões de voz; acessível somente na LAN da loja | Não |
O campo speaker aparece somente quando a correspondência de impressão de voz está ativada. Ele é um rótulo de cluster do registro local e não identifica uma pessoa. O campo backend na resposta offline nomeia o runtime que atendeu à solicitação, para que você possa distinguir o SenseVoice no NPU de um fallback em CPU.
Predefinição: Pilha de Servidor
Todos os dados são lidos de endpoints HTTP ou WebSocket no host da stack. Os tokens são entradas name:role:token em .env (VOICE_API_TOKENS, ASR_API_TOKENS), e a função define quais rotas um token pode alcançar.
- SenseCraft Voice App: o app converte o áudio do reSpeaker Clip para um formato compatível e o envia com
POST /v1/audio/transcriptions; o JSON de transcrição retorna para o telefone. - Cliente de streaming PCM: WebSocket na porta 8080, função operator. Frames binários PCM brutos de entrada, mensagens JSON de saída.
- Sistema de BI ou CRM:
GET /api/v1/recordingsna porta 8081, função viewer. O texto já está redigido; nenhum endpoint retorna o original. - Fluxo de trabalho de privacidade ou de tickets:
POST /api/v1/privacy/eraseeGET /api/v1/privacy/exportna porta 8081, função admin. - Pessoas: o console de administração na porta 3000.
Tabela completa de interface e payload
| Interface | Porta | Caminho | Função | Conteúdo |
|---|---|---|---|---|
| WebSocket | 8080 | /ws?token=<operator> | operator | Cliente→servidor: frames binários PCM brutos, 16 kHz, mono, 16 bits com sinal little-endian, ≤ 2 MiB cada. Servidor→cliente: JSON com type de connection, vad, final, error |
| HTTP | 8081 | /api/v1/recordings | operator (POST), viewer (GET) | Upload e consulta de transcrições; a redação acontece antes da inserção |
| HTTP | 8081 | /api/v1/privacy/erase | admin | Exclusão definitiva por sujeito / dispositivo / sessão |
| HTTP | 8081 | /api/v1/privacy/export | admin | JSON de texto redigido mais um manifesto de áudio |
| HTTP | 3000 | / | viewer e acima | Console de administração: gravações, palavras-chave, dispositivos, exportação, exclusão |
| HTTP | 8621 | /health | — | Verificação de integridade do OpenVoiceStream para sondas de orquestração |
Uma mensagem final:
{"type":"final","text":"我想找[[NAME]]咨询一下","timestamp":1757030400000,
 "textLength":12,"wordCount":2,"sessionID":"a1b2","audioID":"c3d4",
 "speaker":{"identified":true,"speaker_id":"spk-7","speaker_name":"staff-a","confidence":0.83}}
O que três campos significam:
texté o texto redigido. O banco de dados armazena o próprio placeholder[[NAME]]; o original não é gravado em nenhum lugar e não há cópia criptografada.speaker.identifiedéfalsena implantação padrão. Escolha o perfil de impressão de voz se você precisar de correspondência de locutor; o endpoint e a chave são fornecidos após a implantação.- Tokens podem ir em um cabeçalho. Tanto
X-API-TokenquantoAuthorization: Bearersão aceitos; o parâmetro de consulta?token=existe para clientes WebSocket em navegador que não conseguem definir cabeçalhos personalizados.
A autenticação separa duas falhas: credenciais ausentes retornam 401, função insuficiente retorna 403, para que um integrador saiba se deve alterar o token ou a função. Rotas sem uma regra explícita exigem pelo menos viewer, portanto novos endpoints não são públicos por padrão; tokens legados sem função são rebaixados para viewer.
Desempenho e dados medidos
Predefinição: Transcrição no dispositivo
Tempos de execução e parâmetros principais
O repositório do serviço de voz OpenVoiceStream não é público, portanto não há link do GitHub.
| Host | Modelo de reconhecimento | Precisão | Runtime | Como o modelo chega ao dispositivo |
|---|---|---|---|---|
| reRouter CM4 | Paraformer streaming | CPU | ONNX / sherpa-onnx em 4 núcleos Cortex-A72 | Baixado na primeira inicialização a partir do espelho escolhido na implantação |
| reComputer RK3576 series | SenseVoice | fp16 | RKNN no NPU de 6 TOPS | Mesmo; o .rknn é compilado para este SoC |
A pontuação CT-Transformer e a impressão de voz CAM++ são executadas na CPU via sherpa-onnx em ambos os hosts, portanto ativar ambos em uma placa somente CPU de 4 GB compete com o reconhecimento pelos mesmos núcleos e memória.
vad(parâmetro de URL de stream): onde um enunciado é dividido;vad=nonedeixa a segmentação para o chamador, que é a configuração usada nas medições abaixo.punctuate=true: carrega CT-Transformer e retorna frases pontuadas.speaker_embedding=true: carrega CAM++ e emite um rótulospeakerapós comparar com o registro local com um limite fixo. A correspondência é heurística, sem procedimento de cadastro, verificação de vivacidade ou garantia de confiança; não use isso para controle de acesso, pagamento ou qualquer decisão sobre um indivíduo.
Medições da série reComputer RK3576
| Métrica | Valor | Condições |
|---|---|---|
| Latência de transcrição offline | 3,0 s de áudio → cerca de 780 ms aquecido (RTF 0,26) | SenseVoice RKNN fp16 no NPU; POST /asr, contêiner aquecido |
| Memória | RSS do contêiner 1,71 GiB | ASR + pontuação + impressão de voz todos carregados |
| Reinício até saudável | Cerca de 25 s | Volume de modelo populado |
| Transcrição de enunciados curtos | 5 enunciados curtos (3 zh + 2 en) todos retornaram "backend":"rk:sensevoice_rknn" com texto correto; p50 678 ms, p95 810 ms (n=5, inclui overhead de HTTP) | compose não modificado deste pacote e perfil rk3576-sensevoice, entrada por arquivo |
| Precisão de reconhecimento em streaming ▲ | CER chinês 9,4%, WER inglês 34,6% | conjunto curto bench/perf/corpus (5 zh + 5 en), codificador Paraformer híbrido RKNN + decodificador RKNN, caminho ao vivo /asr/stream |
| Fim da fala até resultado final ▲ | 326 ms / 347 ms (média zh / en) | Mesma execução, /asr/stream com 500 ms de antecedência de preparação |
| Vetor de impressão de voz | RTF 0,09–0,13 (1 s → 125 ms, 3 s → 255 ms, 5 s → 428 ms) | CAM++ via sherpa-onnx em CPU, 2 threads; clusterização de 10 locutores 1,45 ms |
| Vetor de impressão de voz, classe A72 * | RTF cerca de 0,10 (1 s → 114 ms, 3 s → 303 ms, 5 s → 508 ms), carga fria 1,66 s | reComputer série R10 (Cortex-A72, 4 núcleos), mesma geração de SoC que o CM4 no reRouter; CAM++ via sherpa-onnx em CPU |
Reprodução: assets/docker/docker-compose.local-rk3576.yml (cabeçalho do arquivo), openvoicestream/docs/perf/paraformer-rk3576-streaming-ab-20260608.md, openvoicestream/docs/specs/diarization-capability.md
▲ Essas duas linhas são do perfil de streaming Paraformer, não do perfil SenseVoice implantado aqui; a latência delas não é a latência do pipeline atual. Para os números de fim da fala até o resultado final do pipeline atual, veja a tabela de concorrência de cinco dispositivos na seção Server Stack.
* Placa diferente, mesma geração de SoC, portanto esta linha é derivada: ela mostra o custo de CPU de vetores de impressão de voz em núcleos classe A72.
Degradação conhecida
- Fora da faixa de captação. Além de cerca de 3 m, ou com ruído constante acima de cerca de 70 dB, o arranjo não consegue separar o locutor e os erros de reconhecimento aumentam; ajustar os parâmetros acima não ajuda.
- Inglês é mais fraco que chinês no perfil de streaming Paraformer. No mesmo conjunto curto: WER inglês 34,6%, CER chinês 9,4%.
Predefinição: Pilha de Servidor
Capacidade e latência de ASR: cinco dispositivos comparados
| Família de dispositivos | Modelo | Streams concorrentes recomendados | p50 / p95 |
|---|---|---|---|
| reComputer J4012 | SenseVoice | 48 | 505 / 789 ms |
| reComputer J3011 | SenseVoice | 32 | 167 / 293 ms |
| reComputer RK3576 | SenseVoice | 12 | 583 / 1067 ms |
| reComputer RK3588 | SenseVoice | 8 | 659 / 902 ms |
| reComputer série R2000 | SenseVoice | 6 | 625 / 1173 ms |
| reComputer J4012 | Whisper base | 16 | 584 / 1177 ms |
| reComputer J3011 | Whisper base | 8 | 492 / 837 ms |
| reComputer RK3576 | Whisper base | 2 | 809 / 1380 ms |
| reComputer RK3588 | Whisper base | 4 | 655 / 1380 ms |
| reComputer série R2000 | Whisper base | 16 | 752 / 1465 ms |
Condições: cada clipe com menos de 4 s; SenseVoice com um corpus de concorrência de 200 streams (Jetson) e 100 streams (RK), Whisper com 72 streams (Jetson/RK) e 100 streams (R2000). p50 / p95 são medidos do fim da fala de ASR até o resultado final e excluem VAD, impressão de voz, pontuação, upload, redação e inserção; isto é capacidade apenas de ASR.
Precisão (em um corpus separado de 100 clipes, não misturado com o corpus de concorrência): CER chinês agregado 4,82%; WER inglês 7,62% no J4012, 7,62% no J3011, 8,51% no RK3576, 7,50% no RK3588, 8,39% na série R2000.
Reprodução: openvoicestream/bench/asr_bench/build_unified_report.py
Limites conhecidos
- O texto original nunca é armazenado. Números de celular, números de identificação, nomes e endereços são substituídos por placeholders tipados antes da gravação no MySQL; apenas entidades com confiança ≥ 0,85 são mascaradas, e aquelas abaixo do limite são sinalizadas para uma fila de revisão sem mascaramento.
- A pontuação de redação é em nível de texto. Em um conjunto de referência de 114 itens de texto escrito em chinês e inglês: precisão 0,98, recall 0,95. A pontuação é calculada em texto escrito; na saída de ASR, erros de transcrição deslocam os limites das entidades. Reprodução:
tools/pii_eval.py - Sequências de dígitos falados têm uma lacuna. A regra
cn_mobile_spokencobre números de celular de 11 dígitos lidos em numerais chineses (incluindo 幺); números de identificação, números de telefone fixo e outros identificadores numéricos lidos como numerais chineses não são cobertos. - O áudio não é redigido. Ele é retido por 24 horas por padrão, com 6 horas ou 1 hora selecionáveis na implantação; a exportação contém JSON de texto redigido mais um manifesto de áudio, não o próprio áudio.
- Apagar por titular não deixa resíduo algum no banco de dados, no armazenamento de objetos e no áudio local; o que permanece é uma lápide contendo apenas o SHA-256 do titular, mais um registro de auditoria. Reprodução:
assets/tools/delete_proof.sh - Análises fora da caixa estão desativadas por padrão. O contêiner
c4-cloud-analyticsroda apenas quando o perfilcloud-analyticsé escolhido.
Próximas etapas
- Medir a cadeia completa de ingestão do server stack no reComputer RK3576: 1 / 2 / 4 / 8 / 16 streams concorrentes, e latência de fim da fala → redação → inserção (p50 / p95 / p99).
- Medir a precisão de transcrição em chinês e inglês (WER) no server stack, e captura contínua por 1 / 10 / 60 / 240 minutos e 24 horas.
- Construir a imagem de contêiner de impressão de voz e então medir a taxa de erro de locutor.
Fontes de dados e ativos
Predefinição: Transcrição no dispositivo
- Modelos de reconhecimento, pontuação, detecção de ponto final e impressão de voz: SenseVoice e Paraformer para reconhecimento, CT-Transformer para pontuação, CAM++ para impressão de voz, Silero VAD para detecção de ponto final. Cada um segue sua licença upstream; verifique a licença de cada modelo que você usar antes de implantação comercial. Os modelos são baixados na primeira inicialização a partir do espelho escolhido na implantação.
- Corpora de teste: as linhas de precisão usam o conjunto curto
bench/perf/corpus(5 zh + 5 en); a linha de enunciados curtos usa 5 enunciados (3 zh + 2 en). Nenhum deles é fornecido com o pacote. - Fontes de dados de desempenho:
openvoicestream/docs/perf/paraformer-rk3576-streaming-ab-20260608.md,openvoicestream/docs/specs/diarization-capability.md,openvoicestream/docs/perf-test-runbook.md. O repositório OpenVoiceStream não é público, portanto esses documentos não têm link público. - Diagrama de arquitetura: gerado a partir do catálogo aprovado de adesivos de produto. O nó de microfone usa um símbolo de função genérico, não o gabinete real do XVF3800.
Predefinição: Pilha de Servidor
- Conjunto de referência de PII: 114 amostras em chinês e inglês por trás dos números de precisão e recall; não é fornecido com o pacote.
- Listas de palavras para redação: o Hundred Family Surnames e a lista de divisões chinesas em nível provincial, ambas em domínio público. A redação não usa nenhum modelo de terceiros.
- Serviços da pilha:
sensecraft-asr-service,sensecraft-voice-client,sensecraft-voice-serviceesensecraft-voice-websão de propriedade da Seeed; o reconhecimento usa OpenVoiceStream. MySQL é obtido sob GPLv2 com a exceção FOSS, e a versão atual do MinIO é AGPLv3; verifique essa licença antes de incorporar o armazenamento de objetos em um produto comercial. - O diagrama de arquitetura na página de design de referência é renderizado a partir de IR estruturado neste repositório.