Design de Arquitetura de Agente Incorporado para o Braço Robótico reBot B601 RS


Configuração do ambiente → Download de modelo → Troca de LLM → Calibração mão‑olho → Execução da demo → Solução de problemas
Este tutorial é o guia de operação para o projeto wrc_demo. Siga as etapas deste guia para ir do clone inicial até uma demo em execução em 1–2 horas.
wrc_demo é uma demonstração de preensão visual para o reBot Arm B601-RS (barramento RobStride), executando em Ubuntu 22.04 + Python 3.10 + ambiente conda wrc-demo. A demo recebe instruções em linguagem natural (por exemplo, "pegue o bloco vermelho"), planeja automaticamente a preensão e a executa.
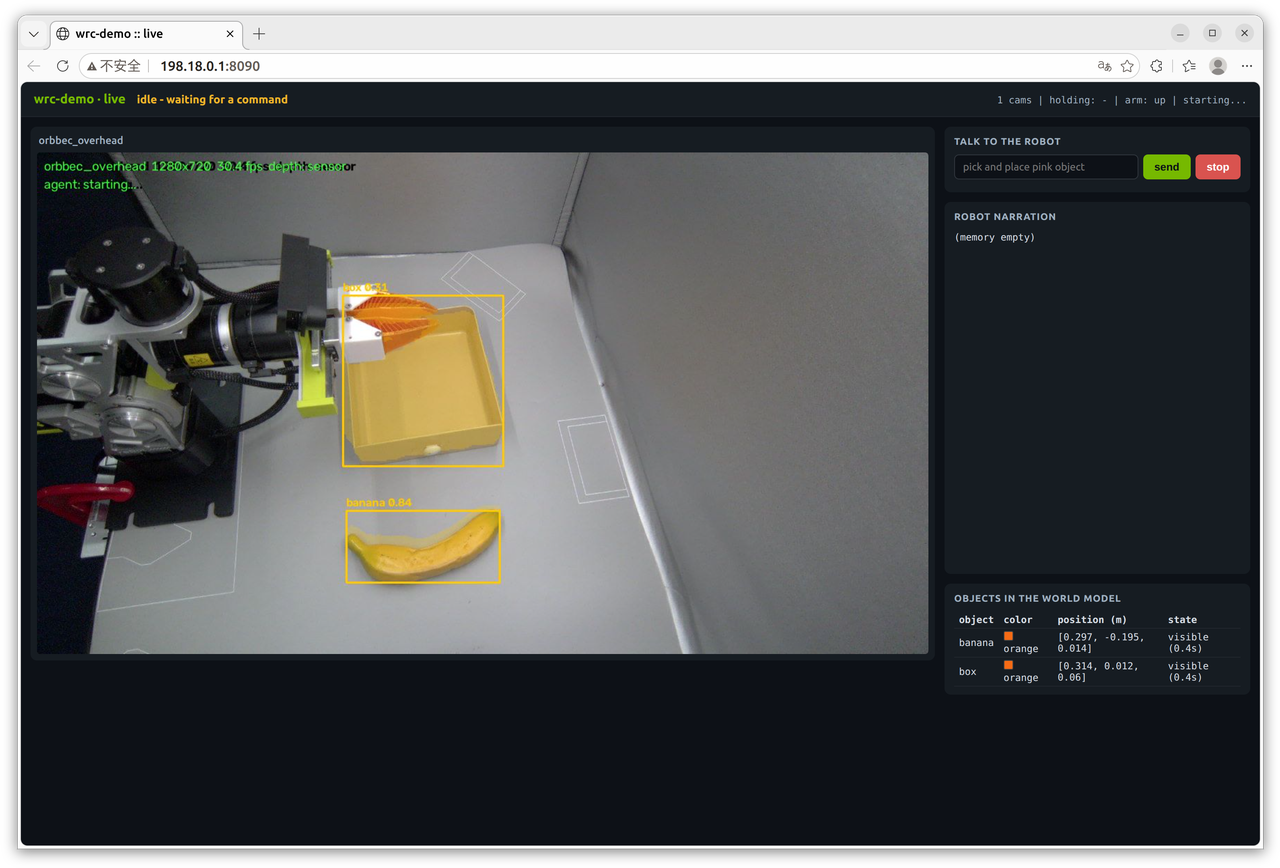
0. Resumo Rápido
Requisitos do Sistema
| Item | Requisito |
|---|---|
| Sistema Operacional | Ubuntu 22.04+ / Debian 12+ / WSL2 |
| Python | 3.10 (dentro do ambiente conda) |
| Memória | ≥ 16 GB (mock inicia em 8 GB) |
| Disco | ≥ 10 GB |
| GPU (Opcional) | NVIDIA RTX 5070 / 4090 / H100, etc. |
| VRAM | ≥ 8 GB |
1. Objetivos do Projeto e Público-Alvo
- Objetivos do Projeto: Conectar um Vision Language Model (VLM) ao reBot Arm B601-RS, de modo que instruções em linguagem natural sejam automaticamente convertidas em ações de preensão — o VLM seleciona objetos, o Pinocchio resolve a cinemática inversa (IK),
SafetyHarnessrealiza verificação fail‑closed em cada waypoint de 50 Hz. - Público-Alvo: Desenvolvedores com GPU NVIDIA + Ubuntu 22.04 + noções básicas de Python 3.10, que queiram executar a demo / modificar o detector / adicionar habilidades.
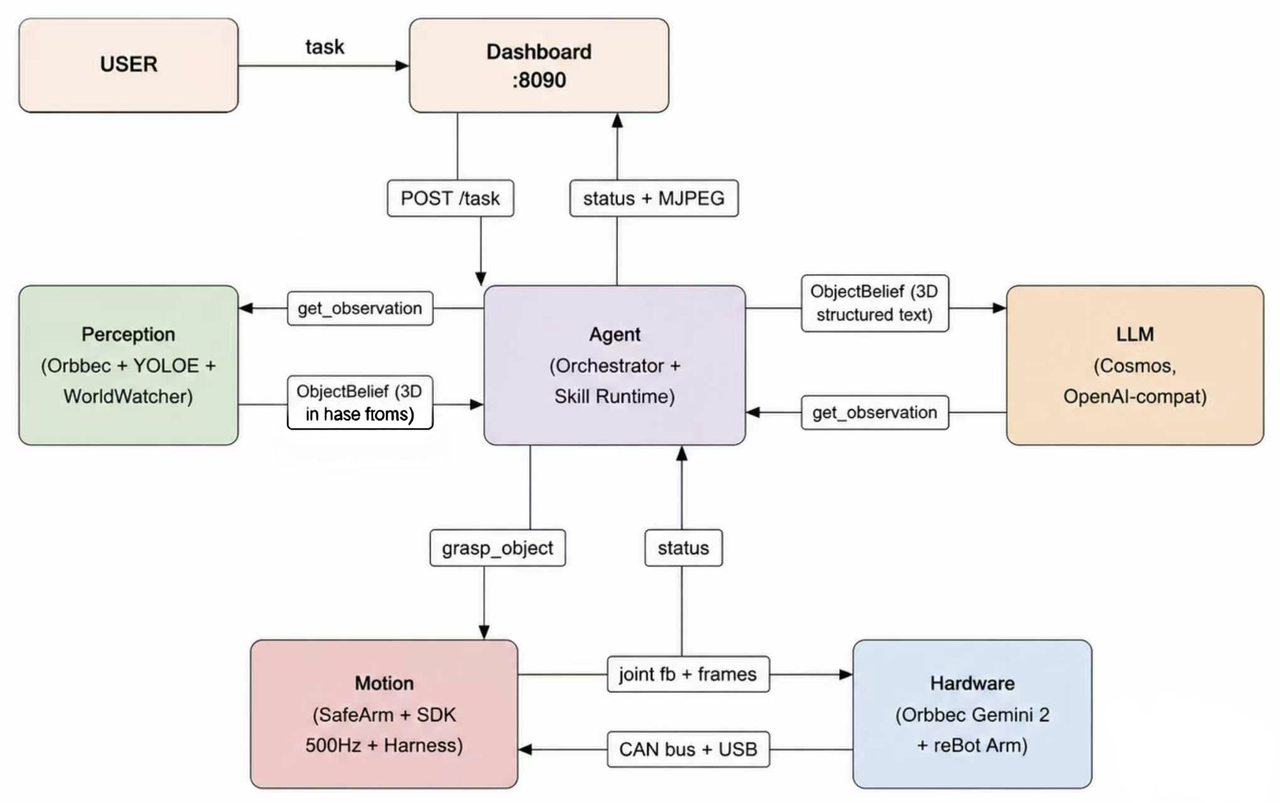
2. Visão Geral do Projeto
2.1 Funcionalidades do Projeto
-
Modelo de Linguagem de Visão como Motor, Tomada de Decisão em Três Níveis
Qwen3-VL-2B-Instruct-AWQ-4bit é usado como cérebro padrão de planejamento de tarefas, podendo ser executado nativamente em dispositivos com 8 GB de VRAM. A análise de comandos segue o caminho de três níveis rápido‑lento Reflex → Hábito → LLM — instruções comuns (por exemplo, "pegue o bloco vermelho") passam diretamente pela sintaxe de template Reflex sem chamar o LLM; apenas novas tarefas envolverão o VLM. -
Calibração Mão‑Olho + Planejamento de Preensão 6‑DoF (fail‑closed)
Script de calibração mão‑olho embutido (tabuleiro ArUco + Pinocchio FK + otimização conjunta SE(3) via LM), com suporte para layout de câmera superior (ETH). Cada ponto da trajetória em streaming é verificado porSafetyHarness— se qualquer verificação falhar, o braço robótico para imediatamente no meio do movimento. -
6 TOOL_SPECS + 5 Gateways MCP
A camada superior expõe 6 ferramentas com segurança controlada:pick_and_place/grasp_object/place_at/on/move_t/teach_record/replay+task_done; o gateway MCP expõe adicionalmente 5 ferramentas:camera_snapshot/world_state/live_view_url/emergency_stop/reset_stop. Não é necessário nenhum trabalho de adaptação de protocolo para adicionar novas habilidades. -
Rastreamento Completo + Memória Episódica
Cada chamada de habilidade é gravada em um trace multimodal estilo ASPIRE (trace.jsonl+ quadros‑chave JPEG antes e depois), com uma janela de eventos de 15 segundos + crença de persistência de objetos, de modo que o "copo visto há 10 segundos" ainda possa ser manipulado após oclusão. -
Experiência de Desenvolvimento Mock‑First
Mock full‑stack (--camera mock --arm mock --llm mock) permite executar o pipeline completo de decisão sem qualquer hardware. Testes em mock e hardware real executam o mesmo código de segurança.
2.2 Especificações
| Categoria | Parâmetro | Especificação |
|---|---|---|
| Hardware | Braço Robótico | reBot Arm B601-RS (barramento RobStride, 6 DOF + garra) |
| Câmera | Orbbec Gemini 2 / Intel RealSense D435i / D405 | |
| Comunicação | Barramento CAN via USB2CAN; câmera USB 3.0 | |
| Host de Controle | PC com Ubuntu 22.04+ / DGX Spark | |
| LLM Local | Perfil padrão | local_qwen3_vl (Qwen3-VL-2B-Instruct-AWQ-4bit) |
| Framework de Inferência | vLLM 0.6+ (inferência multimodal) | |
| Requisito de VRAM | ≥ 8 GB (aproximadamente 30 tokens/s) | |
| Tamanho dos Pesos | ~2.4 GB | |
| LLM em Nuvem | Anthropic | Claude (visão + ferramentas; variável de ambiente ANTHROPIC_API_KEY) |
| Compatível com OpenAI | Qualquer endpoint compatível com OpenAI (OPENAI_API_KEY env) | |
| MiniMax | api.minimax.com (MINIMAX_API_KEY env; apenas texto) | |
| Detector | Padrão | YOLOE-11s-seg (detecção de vocabulário aberto + segmentação de instâncias) |
| Opcional | YOLOE-26l-seg (mais preciso, porém 2× mais lento) | |
| Codificação de Texto | MobileCLIP2-B torchscript (Apple apple/MobileCLIP2-B → gere o trace você mesmo) | |
| Pilha de Software | Cinemática | Pinocchio 3.x (FK/IK, DLS + reinício aleatório) |
| Driver RobStride | motorbridge (SocketCAN) + SDK incorporado | |
| Backend de Preensão | camera-camera / GraspGen-X (ZMQ) / OBB analítico (três camadas) | |
| Python | 3.10 | |
| Sistema de Habilidades | Total de TOOL_SPECS | 6 (incluindo 1 terminador task_done + 5 habilidades reais) |
| Habilidades de Movimento do Braço | 18 literais de string em _MOTION_SKILLS | |
| Conjunto de Ferramentas MCP | TOOL_SPECS - _EXCLUDED_TOOLS + _EXTRA_TOOLS = 6 - 1 + 5 = 10 | |
| Segurança | Verificação de Trajetória | Cada waypoint em streaming de 50 Hz passa por SafetyHarness.approve() |
| Modo de Falha | fail‑closed (qualquer violação → abortar no meio do movimento) | |
| Reserva de Junta | IK limit_margin=0.025 > harness joint_margin=0.02 (invariante) |
2.3 Lista de Materiais (BOM)
| Componente | Quantidade | Incluído |
|---|---|---|
| Braço Robótico reBot Arm B601-RS | 1 | ✅ |
| Garra (pré‑instalada) | 1 | ✅ |
| Ponte Serial USB2CAN | 1 | ✅ |
| Fonte de Alimentação 48V | 1 | ✅ |
| Cabo USB‑C / Comunicação | 1 | ✅ |
| Câmera de Profundidade RGB‑D (Orbbec Gemini 2 recomendada) | 1 | ✅ |
| Conector / Suporte de Montagem da Câmera | 1 | ✅ |
| Host de Controle com Ubuntu 22.04+ (GPU NVIDIA ≥ 8 GB) | 1 | ❌ Fornecido pelo usuário |
Instruções de Fiação
- Braço Robótico: alimentação 48V → braço robótico; USB2CAN → porta USB do host (no primeiro uso é necessário
sudo ip link set can0 up type can bitrate 1000000) - Câmera: Orbbec USB 3.0 → porta USB 3.0 do host
- Configuração de Permissões:
# One-time read/write permission for USB devices
sudo chmod a+rw /dev/bus/usb/*/*

# Orbbec udev rules (recommended for first installation)
sudo bash scripts/install_udev_rules.sh
sudo udevadm control --reload-rules
sudo udevadm trigger
# The kit includes PCAN-USB, usually can0 or can1 should appear directly
sudo modprobe peak_usb
ip -br link

# If can0 appears, set the bitrate
sudo ip link set can0 down 2>/dev/null
sudo ip link set can0 type can bitrate 1000000
sudo ip link set can0 up
2.4 Requisitos de Ambiente
Hardware
| Item | Requisito |
|---|---|
| CPU | x86_64 (aarch64 não coberto pelos testes) |
| Memória | ≥ 16 GB (mock inicia em 8 GB, 16 GB recomendados para LLM local) |
| Disco | ≥ 10 GB (pesos de modelo + ambiente conda + acúmulo de traces) |
| GPU (para inferência de LLM local) | NVIDIA RTX 5070 / 4090 / H100 |
Software
| Item | Requisito |
|---|---|
| Python | 3.10 (dentro do ambiente conda) |
| Conda | miniforge3 / miniconda / anaconda |
| Pacotes de Sistema | libusb-1.0-0-dev, ffmpeg, git, can-utils |
Rede
| Recurso | Descrição |
|---|---|
| GitHub | Clonar github.com/TheMoonAstronaut/wrc |
| HuggingFace | Baixar pesos de YOLOE / MobileCLIP2 / Qwen3-VL |
| PyPI | Instalar ultralytics / openai / anthropic / pin / motorbridge |
3. Configuração do Ambiente
3.0 Caminho Mínimo: Executar Mock em 5 Minutos
Se você só quer executar o mock para verificar a instalação (sem ler outros conteúdos), três comandos são suficientes:
git clone https://github.com/TheMoonAstronaut/wrc.git
cd wrc
conda env create -f environment.yml && conda activate wrc-demo

# Run mock test (17 passed, 1 skipped ≈ 30 seconds)
pytest tests/test_extrinsics_loader.py \
        tests/test_hand_eye_compensation_per_camera.py \
        tests/test_demo_yaml_llm_profile.py -q
O nome do ambiente é fixo como wrc-demo. Se você precisar personalizar o nome (por exemplo, convenção de nomenclatura da equipe), modifique o campo name: em environment.yml e substitua os comandos subsequentes de acordo.
pyorbbecsdk2 não está incluído em environment.yml ** — sua cadeia de dependências pyorbbecsdk2 → open3d==0.18.0 → dash → plotly → ipywidgets → ... frequentemente faz o pip disparar resolution-too-deep. Instale o Orbbec SDK separadamente.
torch também não está incluído em environment.yml ** — ultralytics marca torch como opcional, mas import ultralytics acionará import torch.
3.1 Pré-requisitos
- Conclusão do Guia Rápido do reBot Arm B601-RS (montagem do braço robótico, inicialização do ponto zero, configuração de ID dos motores) — necessário apenas para hardware real
- GPU NVIDIA + driver CUDA instalado (necessário apenas para inferência de LLM local) |
- miniforge3 ou ferramenta conda similar instalada
- Ubuntu 22.04+ / Debian 12+ / WSL2
3.2 Dependências de Sistema (necessárias para hardware real)
sudo apt update
sudo apt install -y libusb-1.0-0-dev ffmpeg git can-utils
libusb-1.0-0-dev: câmera de profundidade Orbbecffmpeg: stream RGB UVC4K / RealSensecan-utils: inicialização SocketCAN (braço robótico)
3.3 pós-instalação: Instalar o PyTorch separadamente (versão CUDA)
Diretório de trabalho: A partir desta seção, todos os comandos assumem que você está no diretório raiz do repositório wrc. Se você abrir um novo shell, primeiro execute cd wrc.
# You should have already cd wrc now; if not:
cd /path/to/wrc
conda activate wrc-demo
3.3.1 Instalar Pytorch e Torchvision
De acordo com a versão CUDA do seu dispositivo, instale Pytorch e Torchvision seguindo o tutorial oficial
Se você precisar instalar stable CUDA 12.8, execute o seguinte comando
PYTHONNOUSERSITE=1 pip install --force-reinstall \
  torch torchvision torchaudio \
  --index-url https://download.pytorch.org/whl/cu128
3.3.2 Carregar PyTorch no ambiente conda
O PyTorch coloca pacotes da nvidia em site-packages/nvidia/lib/, mas o conda não adiciona automaticamente esses caminhos ao LD_LIBRARY_PATH. Sem esse hook, import torch em qualquer novo shell irá gerar OSError: libcudart.so.13: cannot open shared object file
Execute o seguinte comando para instalar o nvidia LD_LIBRARY_PATH conda hook
bash scripts/install_nvidia_libs_hook.sh
Verifique se o hook está efetivo (funciona em novos shells)
source /home/seeed/miniforge3/envs/wrc-demo/etc/conda/activate.d/nvidia_libs.sh
python -c "import torch; print('torch:', torch.__version__, 'cuda:', torch.cuda.is_available())"
# Expected: torch: 2.13.0+cu130 cuda: True
3.4 Instalar o SDK da Câmera de Profundidade
Este projeto oferece suporte às câmeras de profundidade RGB-D Orbbec Gemini 2, RealSense D435i / D405 e outras.
Orbbec Gemini 2
A Orbbec Gemini 2 depende de pyorbbecsdk (versão Python do Orbbec SDK v2). O Método 1 é recomendado:
Método 1: Instalar via pip (recomendado)
conda activate wrc-demo
PYTHONNOUSERSITE=1 pip install pyorbbecsdk2
Você deve adicionar PYTHONNOUSERSITE=1, caso contrário o pip instalará o pacote em ~/.local/lib/python3.10/site-packages/ (site-packages em nível de usuário), e o ambiente conda continuará vazio.
Método 2: Instalar a partir do código-fonte no GitHub (quando houver problemas de rede ou você quiser a versão mais recente)
sudo apt-get install -y cmake build-essential libusb-1.0-0-dev

# Switch to ~/sdk directory (not the wrc directory)
mkdir -p ~/sdk && cd ~/sdk
git clone https://github.com/orbbec/pyorbbecsdk.git
cd pyorbbecsdk
PYTHONNOUSERSITE=1 pip install -e .

# Return to the wrc directory after installation
cd -
Usuários na China continental podem usar o espelho gitee para acelerar: git clone https://gitee.com/orbbecdeveloper/pyorbbecsdk.git
RealSense D435i / D405
O SDK RealSense (pyrealsense2) geralmente precisa ser compilado a partir do código-fonte, é recomendável consultar a documentação oficial da Intel.
4. Aquisição de Pesos de Modelo
4.1 Instalar o Codificador de Texto MobileCLIP2
A Apple publicou pesos de PyTorch no HuggingFace apple/MobileCLIP2-B, e a detecção por prompt de texto do YOLOE requer a versão .ts.
conda activate wrc-demo

# Download MobileCLIP2 .pt
PYTHONNOUSERSITE=1 python scripts/setup_models.py --fetch
Converter formato trace .pt → .ts (manual) **
PYTHONNOUSERSITE=1 pip install "open_clip_torch>=2.30"

PYTHONNOUSERSITE=1 python <<'PY'
import torch, open_clip
full = open_clip.create_model_from_pretrained("MobileCLIP2-B", pretrained="models/mobileclip2_b.pt", return_transform=False)
class Wrap(torch.nn.Module):
    def __init__(self, m): super().__init__(); self.m = m
    def forward(self, t):
        f = self.m(t); return f / f.norm(dim=-1, keepdim=True)
torch.jit.trace(Wrap(full.text).eval(), torch.zeros(2, 77, dtype=torch.long), strict=False).save("models/mobileclip2_b.ts")
PY
Verificação manual
PYTHONNOUSERSITE=1 python -c "import torch; m=torch.jit.load('models/mobileclip2_b.ts'); o=m(torch.zeros(2,77,dtype=torch.long)); print(o.shape, o.norm(dim=-1).tolist())"
# Expected: torch.Size([2, 512]) [1.0, 1.0]
4.1.1 Sobre o caminho de busca do codificador de texto YOLOE
ultralytics carrega mobileclip*.ts apenas olhando para o diretório de trabalho atual (CWD), não procura em models/.
Se você executar python -m wrc_demo.apps.demo ... diretamente, se o CWD não estiver sob models/, será exibido o erro "Download failure for ... mobileclip_*.ts".
Você pode executar o seguinte comando para resolver o problema de erro acima
# Two processing methods when running python directly (choose one)
ln -sf models/mobileclip2_b.ts mobileclip2_b.ts     # Project root symlink
4.2 Baixar Pesos Locais do LLM Qwen3-VL
Se você planeja usar API em nuvem, pode pular esta etapa:
Este tutorial usa por padrão llm.profile=local_qwen3_vl correspondente à versão quantizada AWQ-4bit (roda com 8 GB de VRAM).
hf download cyankiwi/Qwen3-VL-2B-Instruct-AWQ-4bit \
  --local-dir models/qwen3-vl-2b-awq-4bit
# → https://huggingface.co/cyankiwi/Qwen3-VL-2B-Instruct-AWQ-4bit
Se você tiver problemas de rede ao usar hf download, pode usar o repositório do github para baixar
git clone https://huggingface.co/cyankiwi/Qwen3-VL-2B-Instruct-AWQ-4bit models/qwen3-vl-2b-awq-4bit
# If it gets stuck for too long, just press ctrl + c to stop
cd models/qwen3-vl-2b-awq-4bit && git lfs pull
4.3 Tabela de Referência Rápida
| Recurso | Tamanho | Necessidade | Método de Aquisição |
|---|---|---|---|
qwen3-vl-2b-awq-4bit/ | ~2. | 4 GB | Necessário para implantação local de LLM (8 GB de VRAM) |
yoloe-26s-seg.pt | ~31 MB | Detecção de vocabulário aberto (recomendado para 2026-09+) | Extraído via cp após clonar Seeed-Projects/reBot-DevArm-Grasp; usa o mobileclip2_b.ts existente, não requer blt.ts |
yoloe-26l-seg.pt | ~75 MB | Opcional (maior precisão, ~2x mais lento) | Igual ao acima; também usa mobileclip2_b.ts |
yoloe-11s-seg.pt | ~28 MB | Não recomendado — requer mobileclip_blt.ts (572 MB, ~1,5 h de download no primeiro uso) | Use apenas quando pesos de modelo legados forem necessários; para voltar, modifique o campo model: em configs/demo.yaml |
mobileclip2_b.pt | ~571 MB | Fonte de codificação de texto YOLOE 26s/l (versão PyTorch bruta) | Obtido automaticamente de apple/MobileCLIP2-B via python scripts/setup_models.py --fetch |
mobileclip2_b.ts | ~253 MB | Codificação de texto YOLOE 26s/l (efetivamente carregada em tempo de execução) | Traçado manualmente (veja §4.1); após o download deve ser colocado em models/ ou no CWD — veja §4.1.1 |
mobileclip_blt.ts | ~572 MB | Codificação de texto YOLOE 11s (não recomendado, fonte é difícil de baixar) | Traçado manualmente, fonte apple/MobileCLIP-B-LT; necessário apenas ao usar o modelo 11s |
pyrealsense2 | Artefato compilado | Apenas para usuários de RealSense | Compile conforme a documentação oficial da Intel |
5. Calibração Mão-Olho
O objetivo da calibração é permitir que o demo conheça a transformação entre coordenadas de pixel ↔ sistema de coordenadas da base do robô. data/clip/hand_eye_top.json é uma matriz de referência dessensibilizada, sua câmera deve ser recalibrada.
5.1 Preparação
1. Imprimir o Tabuleiro ArUco
Imprima um tabuleiro de xadrez do dicionário ArUco 4x4, ID = 0, comprimento de lado = 0,10 m (10 cm). Fonte recomendada: ~/wrc/aruco100x100.pdf
Após a impressão, meça com precisão o comprimento do lado (impressoras podem escalar a imagem), use o valor medido como o parâmetro --marker-size.
2. Conexão da Câmera + barramento CAN
# Plug Orbbec into USB 3.0, grant camera permissions
sudo chmod a+rw /dev/bus/usb/*/*

# CAN bus (robotic arm)
sudo ip link set can0 down 2>/dev/null
sudo ip link set can0 type can bitrate 1000000
sudo ip link set can0 up
3. Listar Dispositivos
wrc-calib-top --list
# Expected: lists Orbbec device index + serial number

# Write camera serial number
wrc-calib-top --bind top --serial `xxxx`
# Replace the content in `xxxx` with the listed camera serial number
5.2 Calibração ETH da Câmera Superior
ETH = Eye-To-Hand: A câmera é montada em uma posição fixa fora do braço robótico. Coloque o tabuleiro de calibração como mostrado na figura.
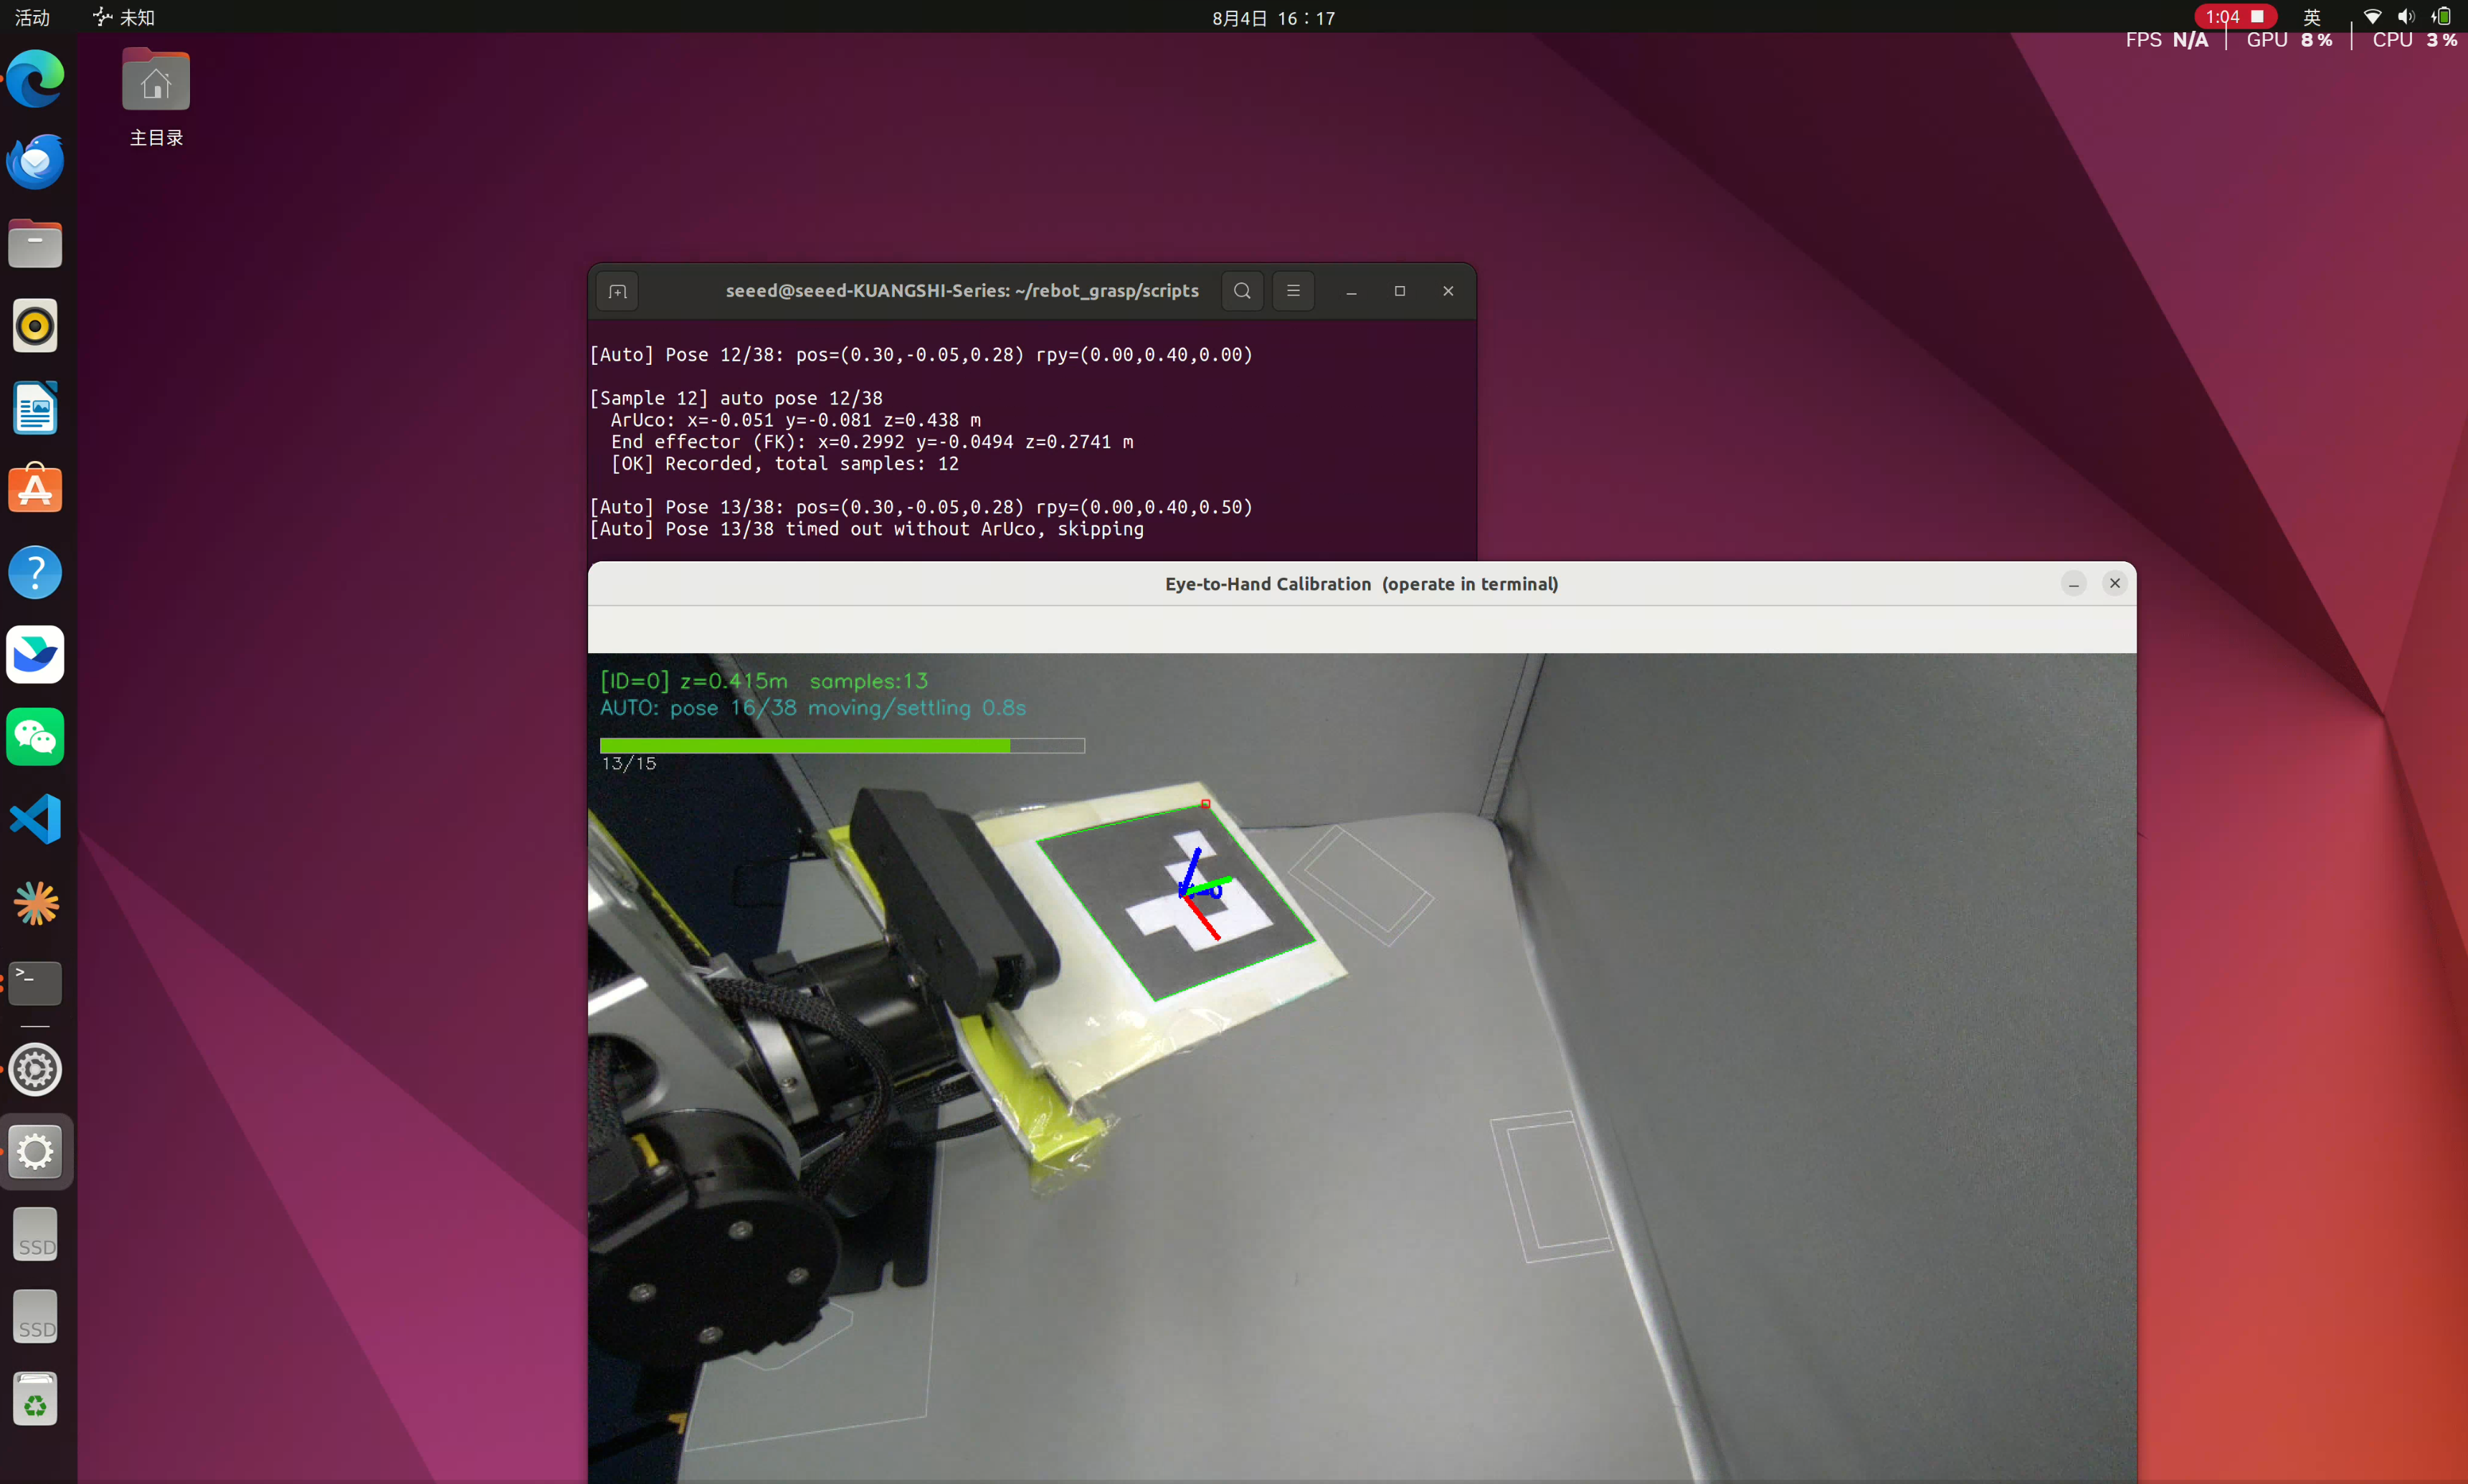
# Automatic mode (automatically runs 25+ sampling points with preset poses)
wrc-calib-top --marker-size 0.10 --n 30 \
  --out data/calibration/hand_eye_top.local.json

# Manual mode (press ENTER to sample each time)
wrc-calib-top --marker-size 0.10 --manual --n 30 \
  --out data/calibration/hand_eye_top.local.json
O arquivo hand_eye_top.local.json é automaticamente ignorado pelo .gitignore (não polui o repositório) e é o resultado real de calibração do dispositivo.
Este demo possui uma área de trabalho segura predefinida para o braço robótico. Se a resolução de IK falhar durante operações de preensão e posicionamento em uma área grande, você precisa ajustar a posição fixa da câmera e recalibrar (uma posição estável da câmera fica aproximadamente a 36 cm * 36 cm da base do braço robótico).
Princípio de Calibração
A ferramenta executa joint_solve internamente (SE(3) LM + Huber + rejeição de outliers 3*MAD):
- FK de
wrc_demo.control.kinematics.Kinematics(Pinocchio em RS URDF,joint_signs=[-1]*6,ee_frame='gripper_end') - PnP de cv2.aruco + intrínsecos do SDK
Saída:
data/calibration/hand_eye_top.json— Matriz de referência dessensibilizada (não usar, serial=REDACTED)data/calibration/hand_eye_top.local.json— Seu resultado real de calibração do dispositivo
5.3 Verificar RMSE da Calibração
Não recalibre, verifique diretamente com pontos conhecidos do sistema de coordenadas da base:
wrc-calib-top --verify \
  --json data/calibration/hand_eye_top.local.json \
  --known-points "0.30,0.00,0.02;0.25,-0.05,0.02;0.35,0.05,0.02"
# Expected: RMSE < 10 mm (reference set.py:320)
6. Configuração do LLM
6.1 Árvore de decisão
What is your VRAM size?
├─ ≥ 8 GB  → Option A: Local model (local_qwen3_vl)
├─ Have API key → Option B: Cloud API (anthropic / openai / minimax)
└─ Neither → Option C: mock (test only)
6.2 Opção A: Modelo local (recomendado, 8 GB+ de VRAM)
Inicie o serviço vLLM (em outro terminal):
conda activate wrc-demo
bash scripts/start_cosmos3_server.sh --bg    # Start in background
sleep 60                                    # Wait for vLLM to load the model (~60s for first run)

# Health check
bash scripts/start_cosmos3_server.sh --status
# Expected: [status] vllm running, PID <xxx>
vLLM 0.6+ oferece suporte à inferência multimodal para Qwen3-VL. A versão quantizada AWQ-4bit pode rodar a ~30 tokens/s em 8 GB de VRAM.
6.3 Opção B: API em nuvem (sem GPU)
Configuração em duas camadas — arquivo de perfil YAML + chave em variável de ambiente:
a. Arquivo de perfil YAML (configs/llm/*.yaml)
| Arquivo | Finalidade | Campos principais |
|---|---|---|
anthropic.yaml | Claude | type: anthropic, model: claude-sonnet-5 |
openai.yaml | OpenAI / compatível com OpenAI | type: openai_compat, base_url, model |
minimax.yaml | MiniMax | type: openai_compat + base_url: https://api.minimax.chat/v1 fixo + env_key: MINIMAX_API_KEY |
local_qwen3_vl.yaml | vLLM local (padrão) | Nenhuma chave necessária |
mock.yaml | mock roteirizado | Para testes |
b. Selecionar qual perfil usar (configs/demo.yaml)
llm:
  profile: local_qwen3_vl    # ← Modify this line (mock / anthropic / openai / minimax / local_qwen3_vl)
Troca temporária via CLI: wrc-demo --llm anthropic --task "..."
c. Chave de API (variável de ambiente)
| perfil | Qual variável de ambiente é lida |
|---|---|
anthropic | ANTHROPIC_API_KEY |
openai | OPENAI_API_KEY (modifique o endpoint via OPENAI_BASE_URL) |
minimax | MINIMAX_API_KEY (lida do campo env_key: no YAML) |
local_qwen3_vl | Não é necessário |
Executar
conda activate wrc-demo

# ⚠ Important: `PUT_KEY_HERE` below is a **placeholder**, must be replaced with your real key

# Claude (Anthropic key format: sk-ant-api03-...)
export ANTHROPIC_API_KEY=PUT_KEY_HERE

# OpenAI (or any OpenAI compatible endpoint; key format: sk-...)
export OPENAI_API_KEY=PUT_KEY_HERE

# MiniMax (key format: sk-cp-...)
export MINIMAX_API_KEY=PUT_KEY_HERE

# Verify env var is set correctly
echo "ANTHROPIC_API_KEY prefix: ${ANTHROPIC_API_KEY:0:10}..."
echo "MINIMAX_API_KEY prefix: ${MINIMAX_API_KEY:0:10}..."
A API_KEY da nuvem configurada com export só é válida no terminal atual. Se quiser persistir a key em ~/.bashrc (export só funciona para o shell atual, novos shells precisam ser reconfigurados):
# Replace PUT_KEY_HERE with your real key (one full line)
echo 'export ANTHROPIC_API_KEY=PUT_KEY_HERE' >> ~/.bashrc

# Immediately reload and verify bashrc syntax is correct (will not expose key content)
bash -n ~/.bashrc && echo "✓ bashrc syntax OK"

source ~/.bashrc
# Verify env var is actually set
echo "ANTHROPIC_API_KEY prefix: ${ANTHROPIC_API_KEY:0:10}..."
Como alternativa, você pode escrever a chave diretamente no YAML (não recomendado):
# configs/llm/minimax.yaml has two writing methods:

# Method A (recommended, key is in env var)
type: openai_compat
base_url: https://api.minimax.chat/v1
model: MiniMax-M3
env_key: MINIMAX_API_KEY          # ← This is the "name of the env var", not the value

# Method B (key written directly in YAML, but will be tracked by git)
type: openai_compat
base_url: https://api.minimax.chat/v1
model: MiniMax-M3
api_key: PUT_KEY_HERE             # ← Write real key here (**not recommended**, will be tracked by git)
6.4 Dois métodos para alternar o LLM
Método 1: Sobrescrever temporariamente via CLI
# Single run with cloud model, tip: minimax can be replaced with the actual cloud model you use
wrc-demo --llm minimax --task "go to home" --no-view --no-serve

# Single run with local model (overrides default in demo.yaml)
wrc-demo --llm local_qwen3_vl --task "go to home" --no-view --no-serve
Os dois scripts de teste acima são usados apenas para verificar se o link do modelo está conectado e não irão realmente controlar o braço robótico.
7. Execução da demonstração
7.1 Iniciar demo
# Start the project
bash /home/seeed/wrc/scripts/start_all.sh --repl --real
Exemplo de saída do terminal após execução bem-sucedida:
# Output example:
(wrc-demo) seeed@seeed-KUANGSHI-Series:~/wrc$ bash /home/seeed/wrc/scripts/start_all.sh --repl --real
============================================================
  wrc_demo + Qwen3-VL-AWQ-4bit one-shot launcher
============================================================
  mode:    real hardware
  camera:  orbbec_overhead
  arm:     rebot_rs
  task:    <interactive>

[1/3] check vLLM...
  vLLM already running (skipped)

[2/3] start wrc_demo...
[wrc-demo] cameras=['orbbec_overhead'] arm=rebot_rs llm=local_qwen3_vl view=False
[wrc-demo] traces -> /home/seeed/wrc/runs/20260903_153216
load extensions from /home/seeed/miniforge3/envs/wrc-demo/lib/python3.10/site-packages/pyorbbecsdk/extensions
[stream] live view on http://192.168.3.175:8090/
[wrc-demo] LIVESTREAM dashboard: http://192.168.3.175:8090/
Type a task (empty line to quit).
task>
Abra a página da web, clique no link [wrc-demo] LIVESTREAM dashboard: http:xxxx exibido no terminal e você poderá controlar o braço robótico por meio de diálogo.
Exemplo de saída do terminal após enviar um comando de diálogo:
=== task report ===
task:    go to home
success: True
path:    reflex (3.08s)
steps:   1
summary: done via reflex path in 3.08s: move_home()

[✓ done] task complete — arm parked at home. Enter a new task or press Enter to quit.

=== task report ===
task:    Wave and say hello
success: True
path:    llm (14.66s)
steps:   3
summary: Robot waved hello three times as requested.
Esta demonstração possui uma área de trabalho segura predefinida para o braço robótico. Se a resolução de IK falhar durante operações de agarrar e posicionar em uma área grande, você precisa ajustar a posição fixa da câmera e recalibrar (uma posição estável da câmera fica aproximadamente a 36 cm * 36 cm da base do braço robótico).
7.2 Tarefas executáveis
Existem dois caminhos para controle por diálogo de texto, path: llm & path: reflex
reflex refere-se a texto pré-carregado (modo mock), que garante que as operações correspondentes sejam executadas sem LLM em execução, usando texto fixo pré-escrito para controlar o rebot para concluir diferentes tarefas.
Comandos de reflexo estáveis são os seguintes:
pick up X and put in Y  # Complete pick+place

open the gripper        # Open the gripper

look around             # List objects recognized by the camera

go home                 # Return to origin
llm refere-se à análise por um modelo real conectado na nuvem ou modelo implantado localmente, que pode entender o texto em linguagem de forma mais flexível e chamar habilidades correspondentes.
As habilidades e funções correspondentes são as seguintes:
skill_get_observation	 # Take photo + recognize
skill_localize_object	 # Single object localization
skill_grasp_object	     # Grasp only
skill_place_at	         # Place to coordinates
skill_place_on_object	 # Place on object
skill_open_gripper	     # Open gripper
skill_close_gripper	     # Close gripper
8. Configuração personalizada
8.1 Adicionar novo perfil de LLM
O backend de LLM do wrc-demo é plugável. Se você precisar adicionar um novo perfil de LLM, um arquivo configs/llm/<name>.yaml é um perfil.
Modifique uma linha profile: <name> em demo.yaml para alternar.
Atualmente há 5 perfis embutidos:
| perfil | Finalidade | Variável de ambiente necessária |
|---|---|---|
local_qwen3_vl | Padrão, Qwen3-VL-2B-AWQ-4bit local (vLLM 8080) | Não é necessário |
mock | Script offline, teste puro (usado na §7.4 de solução de problemas) | Não é necessário |
anthropic | Anthropic Claude | ANTHROPIC_API_KEY |
openai | Protocolo OpenAI / compatível com OpenAI | OPENAI_API_KEY |
minimax | MiniMax em nuvem (migrado para variável de ambiente) | MINIMAX_API_KEY |
Se você precisar adicionar um novo perfil, siga as etapas abaixo:
Etapa 1: Copiar yaml como modelo
(1) A maioria dos LLMs domésticos (DeepSeek / Moonshot Kimi / DashScope Qwen / Zhipu / SiliconFlow) segue o protocolo OpenAI Chat Completions. Copie de openai.yaml:
cp configs/llm/openai.yaml configs/llm/kimi.yaml
(2) Para o protocolo Anthropic, copie de anthropic.yaml.
Etapa 2: Modificar 4 campos no yaml
Abra configs/llm/kimi.yaml, é necessário modificar apenas 4 campos:
type: openai                # Protocol type (see "How to choose type" below)
model: moonshot-v1-8k       # Model name (check vendor documentation)
base_url: https://api.moonshot.cn/v1   # API endpoint, **do not miss the trailing /v1**
env_key: MOONSHOT_API_KEY   # Which env var to read
supports_vision: false      # Whether it supports images (critical, see below)
temperature: 0.0            # Generally no need to modify
max_tokens: 1024            # Generally no need to modify
timeout_s: 30               # Can be adjusted to 60 for slow networks
Etapa 3: Alternar perfil em demo.yaml
Abra configs/demo.yaml, encontre o bloco llm: e modifique apenas uma linha:
llm:
  profile: kimi    # ← Change to new profile name (remove .yaml suffix)
Etapa 4: Definir variável de ambiente + verificar
(1) Export temporário (válido para o shell atual)
export MOONSHOT_API_KEY=sk-...
(2) Verificar se a variável de ambiente entrou em vigor
echo "${MOONSHOT_API_KEY:0:8}"
(3) Testar execução com a flag --llm, sem modificar demo.yaml
conda activate wrc-demo
python -m wrc_demo.apps.demo --llm kimi --task "list the objects" --no-view --no-serve
(4) Verifique se o stdout imprime "[wrc-demo] llm=kimi". Uma mensagem de resposta do LLM conta como sucesso (cena vazia também é OK).
8.2 Modificar precisão de agarrar
Edite o bloco grasp.* em configs/demo.yaml:
grasp:
  backend: obb                          # obb (default fallback) / graspgenx (learning-based)
  pregrasp_offset_m: 0.08              # Hover height (along -approach direction)
  insertion_depth_m: 0.0              # TCP offset along +tool-x
  depth_fraction: 0.35                 # How deep to grasp from the top of the object
  exempt_radius_m: 0.15                # Grasp safety cylinder radius
  move_duration_s: 2.5
  descend_duration_s: 2.0
  release_height_m: 0.05
  air_grasp_frac: 0.04                # Gripper opening below this = empty grasp
  approach_pitch_rad: 1.2             # Angle between approach direction and +z (~69°)
Mais conservador (mais preciso, mais lento) → aumente n_samples (mais tempo de raciocínio do vLLM); mais agressivo (mais rápido) → diminua.
Compensação mão-olho (hand_eye_compensation_m), edite extrinsics em configs/cameras/orbbec_overhead.yaml.
A pose de preensão é convertida das coordenadas da câmera para o sistema de coordenadas da base via T_cam2base — desvios nesta etapa serão transmitidos diretamente para o ponto de aterrissagem da preensão. O ajuste fino do desvio neste elo pode ser feito ajustando o valor de hand_eye_compensation_m.
# configs/cameras/orbbec_overhead.yaml
extrinsics:
  source: "${repo}/data/calibration/hand_eye_top.json"
  mode: eye_to_hand
  hand_eye_compensation_m:    # Meters; default [0, 0, 0] = identity (no effect)
    x: 0.00
    y: 0.
```00
    z: 0.00
The three values X, Y, and Z are used to add a manual translation offset on top of the calibrated T_hand_eye to ensure stable grasping of objects.
8.3 Modify detector configuration
# configs/demo.yaml
detector:
  type: yoloe                          # yoloe / yolo-world
  model: ${repo}/models/yoloe-11s-seg.pt
  conf: 0.20                           # Limite de confiança (menor = mais detecções, mas mais falsos positivos)

detect_classes: ["banana", "cracker box", "soup can", "cube", "box", "pen", "toy"]
# ↑ Esta lista diz ao YOLOE quais rótulos procurar no modo de vocabulário aberto
8.4 Modify safety thresholds
Invariant: The limit_margin=0.025 parameter of Kinematics.ik (in src/wrc_demo/control/kinematics.py) must be strictly greater than the harness's joint_margin=0.02. Adjusting only one of these values will break the boundary between IK and safety verification. Adjust both together!
# configs/demo.yaml
safety:
  workspace:                          # AABB da área de trabalho do TCP (metros)
    min: [0.10, -0.30, -0.01]
    max: [0.50, 0.30, 0.55]
  table_z: 0.0                        # Altura da mesa (sistema de coordenadas da base)
  table_clearance: 0.02              # Folga do TCP em relação à mesa
  max_joint_vel: 1.2                  # rad/s (aplicado por ponto de passagem)
  joint_margin: 0.02                  # rad (reserva dentro dos limites do URDF)
  watchdog_s: 5.0                     # Tempo de parada por expiração da percepção
  keep_out: []                        # Lista de AABBs de parada de emergência
9. Add new skills
Prerequisites: Familiarity with Python + Pinocchio + ultralytics. This section is a 30-minute quick start; to understand the underlying design, refer to src/wrc_demo/skills/runtime.py.
9.1 5 steps to add a new skill
All skills are added to the SkillRuntime class in src/wrc_demo/skills/runtime.py (no need to create a new .py file).
Step 1: Write the skill_<name>() method
# src/wrc_demo/skills/runtime.py
from ..types import SkillError, SafetyViolation

class SkillRuntime:
    # ... existing methods ...

    def skill_my_skill(self, foo: str, bar: int = 0) -> dict:
        """Descrição em uma linha. Retorna: {...}"""
        if not foo:
            raise SkillError("foo must be non-empty")
        # ... sua lógica (deve usar self.arm (SafeArm), não acesse diretamente self.arm.raw) ...
        return {"ok": True, "result": "..."}
Step 2: Add an entry to TOOL_SPECS
# src/wrc_demo/skills/runtime.py
TOOL_SPECS.append({
    "name": "my_skill",
    "description": "...",
    "parameters": {
        "type": "object",
        "properties": {
            "foo": {"type": "string"},
            "bar": {"type": "integer", "default": 0},
        },
        "required": ["foo"],
    },
})
Step 3: Add motion skills to _MOTION_SKILLS
_MOTION_SKILLS = {
    # ... 18 existing entries ...
    "my_skill",
}
This is the only location where WorldWatcher belief fusion is paused — if fusion is not paused during arm movement, held objects will be incorrectly re-fused to their in-air position.
Step 4: Automatic tracing and MCP exposure
SkillRuntime.execute() is the single scheduling entry point; mcp_server.py serves TOOL_SPECS minus _EXCLUDED_TOOLS plus _EXTRA_TOOLS — once added, the skill can be called by LLM/MCP.
Step 5: (Optional) Add regex to _RULES
Enable common commands to use the fast reflex path (no LLM call):
# src/wrc_demo/agent/reflex.py
_RULES.append((
    re.compile(r"^my command pattern\s+(\w+)", re.IGNORECASE),
    "my_skill",
))
9.2 Add a new detector
Implement the new detector class in src/wrc_demo/perception/detector.py:
from .detector import Detector

class MyDetector:
    def __init__(self, model_path: str, **kwargs):
        # Carregar modelo
        ...

    def detect(self, frame) -> list[Detection]:
        # Retornar lista de objetos Detection
        ...
Add a branch in apps/demo.py::_make_detector():
if dcfg.type == "my_detector":
    from wrc_demo.perception.my_detector import MyDetector
    return MyDetector(dcfg.model)
9.3 Add a new grasp planner
src/wrc_demo/grasping/my_planner.py:
from .selector import Grasp

def plan_my_grasps(fix, cloud, cfg) -> list[Grasp]:
    # Retornar lista de objetos Grasp
    ...
Add a layer in SkillRuntime._plan_grasps() (stacked by default on top of the camera-frame, graspgenx, and obb layers).
10. Architecture Overview
This chapter is reference material — a guide to understanding how
wrc_demoorganizes code. Read the process in §9.1 before writing code; to understand the design rationale, refer to §10.3 Key Design Decisions.
10.1 Three-tier decision making (Reflex → Habit → LLM)
wrc_demo splits decision making into a three-tier fast/slow path system, similar to human fast/slow thinking:
N câmeras ──CameraStream (uma thread cada, slot de último frame, descarta antigos)
   │
   ├── WorldWatcher (thread, ~3 Hz): detector + marca de cor HSV
   │     └─> BeliefStore (thread-safe): rótulo+cor+3D+atualidade
   └── StreamServer (dashboard MJPEG): grade de câmeras + narração + tabela de objetos

comando de chat ("pick and place pink object")
   ├─ nível 1 REFLEX    Sintaxe de template → chamadas de skill                          (~µs)
   ├─ nível 2 HABIT     Memória de experiência (cosseno BoW-hash ≥ 0.9)              (~ms)
   └─ nível 3 LLM       Loop de orquestração bruto (2-15 s/turno)
        Todos os níveis usam o mesmo SkillRuntime com proteção de segurança
Key mechanisms:
- Latest-slot streaming: Consumers always receive the most recent frame; sensors never fall behind (
perception/stream.py) - Always-hot world model: WorldWatcher continuously fuses depth and extrinsic parameters from each camera into BeliefStore, turning command parsing into a dictionary lookup instead of an observe→detect round trip. Fusion is paused during movement (to avoid in-air re-fusion) and sends heartbeats to the safety watchdog.
- Color matching without CLIP: Detection results map the median HSV value of masks to color names, which are stored in the belief store and matched against color terms in queries — "pink object" works even with a closed-set COCO detector. VLMs can still be consulted (tier 3/advisor), but are never used in the hot path.
- One-call pick-and-place:
skill_pick_and_place= resolve → grasp → place → home, total execution time = robot arm movement time. - LazyArm: The MCP gateway preheats cameras, detectors, and the world model on startup, but motors are not enabled until the first motion command is received — starting the chat server does not power on the robot.
10.2 Module diagram (simplified)
src/wrc_demo/
├── types.py            Frame / Detection / ObjectFix / Grasp / RobotState
├── config.py           Perfis YAML (cameras/, arms/, llm/) mesclados em Cfg
│
├── perception/         # 4 backends de câmera + detector YOLOE + alinhamento de profundidade
├── calibration/        # Calibração mão-olho (ArUco + Pinocchio FK + LM)
├── memory/             # episódica + crença + resultado de preensão
├── control/            # Pinocchio FK/IK + mock + lazy + RS real + SafeArm
├── safety/             # verificação de waypoint com falha segura
├── grasping/           # planejamento de preensão em 3 camadas
├── agent/              # orquestrador + reflexo + advisor + clientes LLM + trace
├── skills/              # SkillRuntime + TOOL_SPECS + lógica de negócio (teach, master_arm, etc.)
└── apps/                # demo / record / viewer / stream_server / mcp_server
10.3 Key design decisions
| Decision | Rationale |
|---|---|
Frame.rgb is BGR, depth_m is metric float32 | Unit differences between L515 (0.25 mm/unit) and D4xx (1 mm/unit) caused bugs in the baseline; conversion at the camera boundary ensures unit safety for all downstream consumers. |
| Grasp planning in base coordinate system, not camera coordinate system | The baseline derived approach vectors from camera ray direction, making grasp quality dependent on camera pose. Here, mask points are lifted to 3D, transformed to the base coordinate system, and the OBB in the base frame provides yaw, width, and height — camera pose only affects visibility, not grasp geometry. |
| Learned grasping as default, analytical grasping always available | grasp.backend: graspgenx sends the object's base-frame point cloud to the GraspGen-X ZMQ service (scripts/serve_graspgenx.sh, port :5556), prioritizing ranked 6-DoF grasps before analytical OBB candidates. Any server error silently falls back to OBB — the demo will never freeze due to a dead model server. |
| Custom kinematics wrapper | The ReBotArm SDK's kinematics silently reads its own global config file (ignoring the passed hw_yaml), causing the DM installation URDF to be loaded for RS arms (incorrect tool coordinate system). We explicitly load the RS URDF from assets/. |
| Feedback, no sleep | The baseline used sleep(duration + 0.6); the RS motor's motorbridge get_state() never decodes type-0x18 report frames, so actual position is obtained from mechPos (0x7019) parameter reads — verified on this rig. |
| Fail-closed safety | The SDK does not execute anything outside of IK. Our harness gates every streaming waypoint; grasp descent only occurs within an explicit exemption cylinder around the target, allowing "do not touch the table" and "grasp objects on the table" to coexist. |
10.4 Module dependency graph
            ┌──────────────────────────────────────────────────────────────┐
            │                apps/  (pontos de entrada)                    │
            │   demo.py (build_runtime)   mcp_server.py   dashboard_runner │
            └────────────┬──────────────────────┬────────────────┬─────────┘
                         │                      │                │
        ┌────────────────▼─────────┐   ┌────────▼────────┐  ┌────▼─────────┐
        │   agent/  (orquestrador) │   │  skills/        │  │  perception/ │
        │   orchestrator.py        │◄──│  runtime.py     │  │  camera_base │
        │   reflex.py (tier1)      │   │   6 skills      │  │  + cameras/  │
        │   advisor.py  (tier3)    │   │  TOOL_SPECS     │  │  detector    │
        │   llm.py                 │   │  trace auto     │  │  depth_prov  │
        └────────┬─────────────────┘   └────────┬─────────┘  └────┬─────────┘
                 │                            │                │
                 ▼                            ▼                ▼
        ┌─────────────────────────────────────────────────────────────────┐
        │              memory/  +  grasping/  +  control/                 │
        │   BeliefStore   GraspMemory   camera_grasp + obb_grasp + graspgenx│
        │   EpisodicMem   (3 camadas)      Kinematics + MockArm + SafeArm  │
        └────────────────────────────┬────────────────────────────────────┘
                                     │
                                     ▼
        ┌─────────────────────────────────────────────────────────────────┐
        │                       safety/  (fail-closed)                    │
        │   SafetyHarness.approve(waypoint)  vet_pose()  estop latch   │
        └─────────────────────────────────────────────────────────────────┘
                                     │
                                     ▼
              SDK incorporado + pyorbbecsdk + ultralytics + pin + motorbridge
10.5 Trace sequence diagram (one pick_and_place call)
t=0.0s  usuário  ──→  build_runtime()
                   ├─ Kinematics(urdf, joint_signs)
                   ├─ make_arm(cfg) ── RebotArm.connect()
                   ├─ CameraRig(N) ── Open + warm_up
                   ├─ LockedDetector(YOLOE weights)
                   ├─ EpisodicMemory / BeliefStore / TraceLogger
                   └─ SkillRuntime(...)

t=0.5s  thread WorldWatcher inicia (passagem do detector a 3 Hz → crenças)

t=1.0s  usuário --task "pick up red block"
        AgentOrchestrator.run_task()
        ├─ tier1 REFLEX: correspondência regex ──→ acerto de pick_and_place?  ──→ executar
        └─ (fallback) tier2 HABIT ──→ tier3 LLM ──→ tool_calls

t=1.1s  SkillRuntime.execute("pick_and_place")
        ├─ tracer.start()
        ├─ belief.find("red block")  ── aguardar prazo de 5s
        ├─ _plan_grasps() ── camera + graspgenx + obb ── reclassificar
        ├─ select_grasps() ── IK ── pré-avaliação do arnês
        ├─ safe_arm.move_joints() ── cada waypoint de 50Hz ── SafetyHarness.approve
        ├─ garra fecha em duas etapas ── detecção de estol
        ├─ levantar + posicionar + voltar para home
        └─ tracer.finish()  ── trace.jsonl + quadros-chave + narração

t=N.5s  report.success ── print "✓ done — arm parked at home"
10.6 Comparison of the three grasp planning layers
| Layer | Trigger condition | Data source | Output | Failure behavior |
|---|---|---|---|---|
1. camera-frame planner (camera_grasp.py::plan_grasp_from_mask) | Always — as long as detection has mask + depth | segmentation mask + depth → cv2.minAreaRect → depth-quantile back-project → camera-frame Grasp | Grasp(approach, position, width, height) | Fall back to layer 2 |
2. GraspGen-X ZMQ (graspgenx_backend.py) | grasp.backend == "graspgenx" and server at :5556 is reachable | base-frame point cloud → learned 6-DoF grasp | List of Grasp (top-k=32) | Server timeout / disconnect → silent fallthrough |
3. analytic OBB (obb_grasp.py::plan_grasps_from) | Always | base-frame OBB (yaw, width, height) | List of Grasp | No failure — always returns |
All layers output the same Grasp dataclass; GraspOutcomeMemory re-ranks across layers; select_grasp() performs jaw-width filtering + IK walk + harness pre-vet (including 7 samples along the descent path).
10.7 Verification status (as of 2026-08-28)
- 17 unit + integration tests passed, 1 skipped (mock stack, ~30s)
- Full suite: ~290 unit + integration tests passed (hardware-tagged tests deselected by default)
- 2 adversarial multi-view reviews: 2026-07-16 (4 reviewers × skeptic verification, 29 confirmed defects) + 2026-07-18 livestreaming redesign (45-agent workflow, 33 confirmed findings)
- Real robot verification: L515 streaming, RobStride
mechPosparameter reads (can0 read-only), YOLO inference (CUDA, GB10), GraspGen-X backend (first-light verification) - Not verified: Real robot motion (requires on-site gripper re-verification + hand-eye calibration)